分类 软件开发 下的文章

我一直在慢慢地撰写关于 Git 工作原理的文章。尽管我曾认为自己对 Git 非常了解,但像往常一样,当我尝试解释某事的时候,我又学到一些新东西。

现在回想起来,这些事情都不算太令人吃惊,但我以前并没有清楚地思考过它们。

事实是:

  • “索引”、“暂存区” 和 -cached 是一回事
  • 隐匿文件就是一堆提交
  • 并非所有引用都是分支或标签
  • 合并提交不是空的

下面我们来详细了解这些内容。

“索引”、“暂存区” 和 -cached 是一回事

当你运行 git add file.txt,然后运行 git status,你会看到类似以下的输出:

$ git add content/post/2023-10-20-some-miscellaneous-git-facts.markdown
$ git status
Changes to be committed:
    (use "git restore --staged <file>..." to unstage)
    new file:   content/post/2023-10-20-some-miscellaneous-git-facts.markdown

人们通常称这个过程为“暂存文件”或“将文件添加到暂存区”。

当你使用 git add 命令来暂存文件时,Git 在后台将文件添加到其对象数据库(在 .git/objects 目录下),并更新一个名为 .git/index 的文件以引用新添加的文件。

Git 中的这个“暂存区”事实上有 3 种不同的名称,但它们都指的是同一个东西(即 .git/index 文件):

  • git diff --cached
  • git diff --staged
  • .git/index 文件

我觉得我早该早点认识到这一点,但我之前并没有,所以在这里提醒一下。

隐匿文件就是一堆提交

当我运行 git stash 命令来保存更改时,我一直对这些更改究竟去了哪里感到有些困惑。事实上,当你运行 git stash 命令时,Git 会根据你的更改创建一些提交,并用一个名为 stash 的引用来标记它们(在 .git/refs/stash 目录下)。

让我们将此博客文章隐匿起来,然后查看 stash 引用的日志:

$ git log stash --oneline
6cb983fe (refs/stash) WIP on main: c6ee55ed wip
2ff2c273 index on main: c6ee55ed wip
... some more stuff

现在我们可以查看提交 2ff2c273 以查看其包含的内容:

$ git show 2ff2c273  --stat
commit 2ff2c273357c94a0087104f776a8dd28ee467769
Author: Julia Evans <[email protected]>
Date:   Fri Oct 20 14:49:20 2023 -0400

    index on main: c6ee55ed wip

    content/post/2023-10-20-some-miscellaneous-git-facts.markdown | 40 ++++++++++++++++++++++++++++++++++++++++

毫不意外,它包含了这篇博客文章。这很合理!

实际上,git stash 会创建两个独立的提交:一个是索引提交,另一个是你尚未暂存的改动提交。这让我感到很振奋,因为我一直在开发一款工具,用于快照和恢复 Git 仓库的状态(也许永远不会发布),而我提出的设计与 Git 的隐匿实现非常相似,所以我对自己的选择感到满意。

显然 stash 中的旧提交存储在 reflog 中。

并非所有引用都是分支或标签

Git 文档中经常泛泛地提到 “引用”,这使得我有时觉得很困惑。就个人而言,我在 Git 中处理 “引用” 的 99% 时间是指分支或 HEAD,而剩下的 1% 时间是指标签。事实上,我以前完全不知道任何不是分支、标签或 HEAD 的引用示例。

但现在我知道了一个例子—— stash 是一种引用,而它既不是分支也不是标签!所以这太酷啦!

以下是我博客的 Git 仓库中的所有引用(除了 HEAD):

$ find .git/refs -type f
.git/refs/heads/main
.git/refs/remotes/origin/HEAD
.git/refs/remotes/origin/main
.git/refs/stash

人们在本帖回复中提到的其他一些参考资料:

  • refs/notes/*,来自 git notes
  • refs/pull/123/head 和 refs/pull/123/head` 用于 GitHub 拉取请求(可通过 git fetch origin refs/pull/123/merge 获取)
  • refs/bisect/*,来自 git bisect

合并提交不是空的

这是一个示例 Git 仓库,其中我创建了两个分支 x 和 y,每个分支都有一个文件(x.txt 和 y.txt),然后将它们合并。让我们看看合并提交。

$ git log --oneline
96a8afb (HEAD -> y) Merge branch 'x' into y
0931e45 y
1d8bd2d (x) x

如果我运行 git show 96a8afb,合并提交看起来是“空的”:没有差异!

git show 96a8afb
commit 96a8afbf776c2cebccf8ec0dba7c6c765ea5d987 (HEAD -> y)
Merge: 0931e45 1d8bd2d
Author: Julia Evans <[email protected]>
Date:   Fri Oct 20 14:07:00 2023 -0400

    Merge branch 'x' into y

但是,如果我单独比较合并提交与其两个父提交之间的差异,你会发现当然有差异:

$ git diff 0931e45 96a8afb   --stat
    x.txt | 1 +
    1 file changed, 1 insertion(+)
$ git diff 1d8bd2d 96a8afb   --stat
    y.txt | 1 +
    1 file changed, 1 insertion(+)

现在回想起来,合并提交并不是实际上“空的”(它们是仓库当前状态的快照,就像任何其他提交一样),这一点似乎很明显,只是我以前从未思考为什么它们看起来为空。

显然,这些合并差异为空的原因是合并差异只显示冲突 —— 如果我创建一个带有合并冲突的仓库(一个分支在同一文件中添加了 x,而另一个分支添加了 y),然后查看我解决冲突的合并提交,它看起来会像这样:

$ git show HEAD
commit 3bfe8311afa4da867426c0bf6343420217486594
Merge: 782b3d5 ac7046d
Author: Julia Evans <[email protected]>
Date:   Fri Oct 20 15:29:06 2023 -0400

    Merge branch 'x' into y

diff --cc file.txt
index 975fbec,587be6b..b680253
--- a/file.txt
+++ b/file.txt
@@@ -1,1 -1,1 +1,1 @@@
- y
    -x
++z

这似乎是在告诉我,一个分支添加了 x,另一个分支添加了 y,合并提交通过将 z 替代冲突解决了它。但在前面的示例中,没有冲突,所以 Git 并未显示任何差异。

(感谢 Jordi 告诉我合并差异的工作原理)

先这样吧

些写到这里吧,也许我将在学到更多 Git 知识时撰写另一篇关于 Git 的知识的博客文章。

(题图:MJ/03bfecc3-944e-47a0-a4fd-575293d2ba92)


via: https://jvns.ca/blog/2023/10/20/some-miscellaneous-git-facts/

作者:Julia Evans 选题:lujun9972 译者:KaguyaQiang 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

大家好!前段时间我写了一篇关于“如何用 Go 语言建立一个简易的 DNS 解析器”的帖子。

那篇帖子里我没写有关“如何生成以及解析 DNS 查询请求”的内容,因为我觉得这很无聊,不过一些伙计指出他们不知道如何解析和生成 DNS 查询请求,并且对此很感兴趣。

我开始好奇了——解析 DNS 能 花多大功夫?事实证明,编写一段 120 行精巧的 Ruby 语言代码组成的程序就可以做到,这并不是很困难。

所以,在这里有一个如何生成 DNS 查询请求,以及如何解析 DNS 响应报文的速成教学!我们会用 Ruby 语言完成这项任务,主要是因为不久以后我将在一场 Ruby 语言大会上发表观点,而这篇博客帖的部分内容是为了那场演讲做准备的。?

(我尽量让不懂 Ruby 的人也能读懂,我只使用了非常基础的 Ruby 语言代码。)

最后,我们就能制作一个非常简易的 Ruby 版本的 dig 工具,能够查找域名,就像这样:

$ ruby dig.rb example.com
example.com    20314    A    93.184.216.34

整个程序大概 120 行左右,所以 并不 算多。(如果你想略过讲解,单纯想去读代码的话,最终程序在这里:dig.rb。)

我们不会去实现之前帖中所说的“一个 DNS 解析器是如何运作的?”,因为我们已经做过了。

那么我们开始吧!

如果你想从头开始弄明白 DNS 查询是如何格式化的,我将尝试解释如何自己弄明白其中的一些东西。大多数情况下的答案是“用 Wireshark 去解包”和“阅读 RFC 1035,即 DNS 的规范”。

生成 DNS 查询请求

步骤一:打开一个 UDP 套接字

我们需要实际发送我们的 DNS 查询,因此我们就需要打开一个 UDP 套接字。我们会将我们的 DNS 查询发送至 8.8.8.8,即谷歌的服务器。

下面是用于建立与 8.8.8.8 的 UDP 连接,端口为 53(DNS 端口)的代码。

require 'socket'
sock = UDPSocket.new

sock.bind('0.0.0.0', 12345)
sock.connect('8.8.8.8', 53)

关于 UDP 的说明

关于 UDP,我不想说太多,但是我要说的是,计算机网络的基础单位是“ 数据包 packet ”(即一串字节),而在这个程序中,我们要做的是计算机网络中最简单的事情:发送 1 个数据包,并接收 1 个数据包作为响应。

所以 UDP 是一个传递数据包的最简单的方法。

它是发送 DNS 查询最常用的方法,不过你还可以用 TCP 或者 DNS-over-HTTPS。

步骤二:从 Wireshark 复制一个 DNS 查询

下一步:假设我们都不知道 DNS 是如何运作的,但我们还是想尽快发送一个能运行的 DNS 查询。获取 DNS 查询并确保 UDP 连接正常工作的最简单方法就是复制一个已经正常工作的 DNS 查询!

所以这就是我们接下来要做的,使用 Wireshark (一个绝赞的数据包分析工具)。

我的操作大致如下:

  1. 打开 Wireshark,点击 “ 捕获 capture ” 按钮。
  2. 在搜索栏输入 udp.port == 53 作为筛选条件,然后按下回车。
  3. 在我的终端运行 ping example.com(用来生成一个 DNS 查询)。
  4. 点击 DNS 查询(显示 “Standard query A example.com”)。 (“A”:查询类型;“example.com”:域名;“Standard query”:查询类型描述)
  5. 右键点击位于左下角面板上的 “ 域名系统(查询) Domain Name System (query) ”。
  6. 点击 “ 复制 Copy ” ——> “ 作为十六进制流 as a hex stream ”。
  7. 现在 b96201000001000000000000076578616d706c6503636f6d0000010001 就放到了我的剪贴板上,之后会用在我的 Ruby 程序里。好欸!

步骤三:解析 16 进制数据流并发送 DNS 查询

现在我们能够发送我们的 DNS 查询到 8.8.8.8 了!就像这样,我们只需要再加 5 行代码:

hex_string = "b96201000001000000000000076578616d706c6503636f6d0000010001"
bytes = [hex_string].pack('H*')
sock.send(bytes, 0)

# get the reply
reply, _ = sock.recvfrom(1024)
puts reply.unpack('H*')

[hex_string].pack('H*') 意思就是将我们的 16 位字符串转译成一个字节串。此时我们不知道这组数据到底是什么意思,但是很快我们就会知道了。

我们还可以借此机会运用 tcpdump ,确认程序是否正常进行以及发送有效数据。我是这么做的:

  1. 在一个终端选项卡下执行 sudo tcpdump -ni any port 53 and host 8.8.8.8 命令
  2. 在另一个不同的终端指标卡下,运行 这个程序(ruby dns-1.rb)

以下是输出结果:

$ sudo tcpdump -ni any port 53 and host 8.8.8.8
08:50:28.287440 IP 192.168.1.174.12345 > 8.8.8.8.53: 47458+ A? example.com. (29)
08:50:28.312043 IP 8.8.8.8.53 > 192.168.1.174.12345: 47458 1/0/0 A 93.184.216.34 (45)

非常棒 —— 我们可以看到 DNS 请求(”这个 example.com 的 IP 地址在哪里?“)以及响应(“在93.184.216.34”)。所以一切运行正常。现在只需要(你懂的)—— 搞清我们是如何生成并解析这组数据的。

步骤四:学一点点 DNS 查询的格式

现在我们有一个关于 example.com 的 DNS 查询,让我们了解它的含义。

下方是我们的查询(16 位进制格式):

b96201000001000000000000076578616d706c6503636f6d0000010001

如果你在 Wireshark 上搜索,你就能看见这个查询它由两部分组成:

  • 请求头:b96201000001000000000000
  • 语句本身:076578616d706c6503636f6d0000010001

步骤五:制作请求头

我们这一步的目标就是制作字节串 b96201000001000000000000(借助一个 Ruby 函数,而不是把它硬编码出来)。

(LCTT 译注: 硬编码 hardcode 指在软件实现上,将输出或输入的相关参数(例如:路径、输出的形式或格式)直接以常量的方式撰写在源代码中,而非在运行期间由外界指定的设置、资源、数据或格式做出适当回应。)

那么:请求头是 12 个字节。那些个 12 字节到底意味着什么呢?如果你在 Wireshark 里看看(亦或者阅读 RFC-1035),你就能理解:它是由 6 个 2 字节大小的数字串联在一起组成的。

这六个数字分别对应查询 ID、标志,以及数据包内的问题计数、回答资源记录数、权威名称服务器记录数、附加资源记录数。

我们还不需要在意这些都是些什么东西 —— 我们只需要把这六个数字输进去就行。

但所幸我们知道该输哪六位数,因为我们就是为了直观地生成字符串 b96201000001000000000000。

所以这里有一个制作请求头的函数(注意:这里没有 return,因为在 Ruby 语言里,如果处在函数最后一行是不需要写 return 语句的):

def make_question_header(query_id)
  # id, flags, num questions, num answers, num auth, num additional
  [query_id, 0x0100, 0x0001, 0x0000, 0x0000, 0x0000].pack('nnnnnn')
end

上面内容非常的短,主要因为除了查询 ID ,其余所有内容都由我们硬编码写了出来。

什么是 nnnnnn?

可能能想知道 .pack('nnnnnn') 中的 nnnnnn 是个什么意思。那是一个向 .pack() 函数解释如何将那个 6 个数字组成的数据转换成一个字节串的一个格式字符串。

.pack 的文档在 这里,其中描述了 n 的含义其实是“将其表示为” 16 位无符号、网络(大端序)字节序’”。

(LCTT 译注: 大端序 Big-endian :指将高位字节存储在低地址,低位字节存储在高地址的方式。)

16 个位等同于 2 字节,同时我们需要用网络字节序,因为这属于计算机网络范畴。我不会再去解释什么是字节序了(尽管我确实有 一幅自制漫画尝试去描述它)。

测试请求头代码

让我们快速检测一下我们的 make_question_header 函数运行情况。

puts make_question_header(0xb962) == ["b96201000001000000000000"].pack("H*")

这里运行后输出 true 的话,我们就成功了。

好了我们接着继续。

步骤六:为域名进行编码

下一步我们需要生成 问题本身(“example.com 的 IP 是什么?”)。这里有三个部分:

  • 域名(比如说 example.com)
  • 查询类型(比如说 A 代表 “IPv4 Address”)
  • 查询类(总是一样的,1 代表 INternet)

最麻烦的就是域名,让我们写个函数对付这个。

example.com 以 16 进制被编码进一个 DNS 查询中,如 076578616d706c6503636f6d00。这有什么含义吗?

如果我们把这些字节以 ASCII 值翻译出来,结果会是这样:

076578616d706c6503636f6d00
 7 e x a m p l e 3 c o m 0

因此,每个段(如 example)的前面都会显示它的长度(7)。

下面是有关将 example.com 翻译成 7 e x a m p l e 3 c o m 0 的 Ruby 代码:

def encode_domain_name(domain)
  domain
    .split(".")
    .map { |x| x.length.chr + x }
    .join + "\0"
end

除此之外,,要完成问题部分的生成,我们只需要在域名结尾追加上(查询)的类型和类。

步骤七:编写 make\_dns\_query

下面是制作一个 DNS 查询的最终函数:

def make_dns_query(domain, type)
  query_id = rand(65535)
  header = make_question_header(query_id)
  question =  encode_domain_name(domain) + [type, 1].pack('nn')
  header + question
end

这是目前我们写的所有代码 dns-2.rb —— 目前仅 29 行。

接下来是解析的阶段

现在我尝试去解析一个 DNS 查询,我们到了硬核的部分:解析。同样的,我们会将其分成不同部分:

  • 解析一个 DNS 的请求头
  • 解析一个 DNS 的名称
  • 解析一个 DNS 的记录

这几个部分中最难的(可能跟你想的不一样)就是:“解析一个 DNS 的名称”。

步骤八:解析 DNS 的请求头

让我们先从最简单的部分开始:DNS 的请求头。我们之前已经讲过关于它那六个数字是如何串联在一起的了。

那么我们现在要做的就是:

  • 读其首部 12 个字节
  • 将其转换成一个由 6 个数字组成的数组
  • 为方便起见,将这些数字放入一个类中

以下是具体进行工作的 Ruby 代码:

class DNSHeader
  attr_reader :id, :flags, :num_questions, :num_answers, :num_auth, :num_additional
  def initialize(buf)
    hdr = buf.read(12)
    @id, @flags, @num_questions, @num_answers, @num_auth, @num_additional = hdr.unpack('nnnnnn')
  end
end

注: attr_reader 是 Ruby 的一种说法,意思是“使这些实例变量可以作为方法使用”。所以我们可以调用 header.flags 来查看@flags变量。

我们也可以借助 DNSheader(buf) 调用这个,也不差。

让我们往最难的那一步挪挪:解析一个域名。

步骤九:解析一个域名

首先,让我们写其中的一部分:

def read_domain_name_wrong(buf)
  domain = []
  loop do
    len = buf.read(1).unpack('C')[0]
    break if len == 0
    domain << buf.read(len)
  end
  domain.join('.')
end

这里会反复读取一个字节的数据,然后将该长度读入字符串,直到读取的长度为 0。

这里运行正常的话,我们在我们的 DNS 响应头第一次看见了域名(example.com)。

关于域名方面的麻烦:压缩!

但当 example.com 第二次出现的时候,我们遇到了麻烦 —— 在 Wireshark 中,它报告上显示输出的域的值为含糊不清的 2 个字节的 c00c。

这种情况就是所谓的 DNS 域名压缩,如果我们想解析任何 DNS 响应我们就要先把这个实现完。

幸运的是,这没那么难。这里 c00c 的含义就是:

  • 前两个比特(0b11.....)意思是“前面有 DNS 域名压缩!”
  • 而余下的 14 比特是一个整数。这种情况下这个整数是 12(0x0c),意思是“返回至数据包中的第 12 个字节处,使用在那里找的域名”

如果你想阅读更多有关 DNS 域名压缩之类的内容。我找到了相关更容易让你理解这方面内容的文章: 关于 DNS RFC 的释义。

步骤十:实现 DNS 域名压缩

因此,我们需要一个更复杂的 read_domain_name 函数。

如下所示:

domain = []
loop do
  len = buf.read(1).unpack('C')[0]
  break if len == 0
  if len & 0b11000000 == 0b11000000
    # weird case: DNS compression!
    second_byte = buf.read(1).unpack('C')[0]
    offset = ((len & 0x3f) << 8) + second_byte
    old_pos = buf.pos
    buf.pos = offset
    domain << read_domain_name(buf)
    buf.pos = old_pos
    break
  else
    # normal case
    domain << buf.read(len)
  end
end
domain.join('.')

这里具体是:

  • 如果前两个位为 0b11,那么我们就需要做 DNS 域名压缩。那么:

    • 读取第二个字节并用一点儿运算将其转化为偏移量。
    • 在缓冲区保存当前位置。
    • 在我们计算偏移量的位置上读取域名
    • 在缓冲区存储我们的位置。

可能看起来很乱,但是这是解析 DNS 响应的部分中最难的一处了,我们快搞定了!

一个关于 DNS 压缩的漏洞

有些人可能会说,有恶意行为者可以借助这个代码,通过一个带 DNS 压缩条目的 DNS 响应指向这个响应本身,这样 read_domain_name 就会陷入无限循环。我才不会改进它(这个代码已经够复杂了好吗!)但一个真正的 DNS 解析器确实会更巧妙地处理它。比如,这里有个 能够避免在 miekg/dns 中陷入无限循环的代码。

如果这是一个真正的 DNS 解析器,可能还有其他一些边缘情况会造成问题。

步骤十一:解析一个 DNS 查询

你可能在想:“为什么我们需要解析一个 DNS 查询?这是一个响应啊!”

但每一个 DNS 响应包含它自己的原始查询,所以我们有必要去解析它。

这是解析 DNS 查询的代码:

class DNSQuery
  attr_reader :domain, :type, :cls
  def initialize(buf)
    @domain = read_domain_name(buf)
    @type, @cls = buf.read(4).unpack('nn')
  end
end

内容不是太多:类型和类各占 2 个字节。

步骤十二:解析一个 DNS 记录

最让人兴奋的部分 —— DNS 记录是我们的查询数据存放的地方!即这个 “rdata 区域”(“记录数据字段”)就是我们会在 DNS 查询对应的响应中获得的 IP 地址所驻留的地方。

代码如下:

class DNSRecord
  attr_reader :name, :type, :class, :ttl, :rdlength, :rdata
  def initialize(buf)
    @name = read_domain_name(buf)
    @type, @class, @ttl, @rdlength = buf.read(10).unpack('nnNn')
    @rdata = buf.read(@rdlength)
  end

我们还需要让这个 rdata 区域更加可读。记录数据字段的实际用途取决于记录类型 —— 比如一个“A” 记录就是一个四个字节的 IP 地址,而一个 “CNAME” 记录则是一个域名。

所以下面的代码可以让请求数据更可读:

def read_rdata(buf, length)
  @type_name = TYPES[@type] || @type
  if @type_name == "CNAME" or @type_name == "NS"
    read_domain_name(buf)
  elsif @type_name == "A"
    buf.read(length).unpack('C*').join('.')
  else
    buf.read(length)
  end
end

这个函数使用了 TYPES 这个哈希表将一个记录类型映射为一个更可读的名称:

TYPES = {
  1 => "A",
  2 => "NS",
  5 => "CNAME",
  # there are a lot more but we don't need them for this example
}

read.rdata 中最有趣的一部分可能就是这一行 buf.read(length).unpack('C*').join('.') —— 像是在说:“嘿!一个 IP 地址有 4 个字节,就将它转换成一组四个数字组成的数组,然后数字互相之间用 ‘.’ 联个谊吧。”

步骤十三:解析 DNS 响应的收尾工作

现在我们正式准备好解析 DNS 响应了!

工作代码如下所示:

class DNSResponse
  attr_reader :header, :queries, :answers, :authorities, :additionals
  def initialize(bytes)
    buf = StringIO.new(bytes)
    @header = DNSHeader.new(buf)
    @queries = ([email protected]_questions).map { DNSQuery.new(buf) }
    @answers = ([email protected]_answers).map { DNSRecord.new(buf) }
    @authorities = ([email protected]_auth).map { DNSRecord.new(buf) }
    @additionals = ([email protected]_additional).map { DNSRecord.new(buf) }
  end
end

这里大部分内容就是在调用之前我们写过的其他函数来协助解析 DNS 响应。

如果 @header.num_answers 的值为 2,代码会使用了 ([email protected]_answers).map 这个巧妙的结构创建一个包含两个 DNS 记录的数组。(这可能有点像 Ruby 魔法,但我就是觉得有趣,但愿不会影响可读性。)

我们可以把这段代码整合进我们的主函数中,就像这样:

sock.send(make_dns_query("example.com", 1), 0) # 1 is "A", for IP address
reply, _ = sock.recvfrom(1024)
response = DNSResponse.new(reply) # parse the response!!!
puts response.answers[0]

尽管输出结果看起来有点辣眼睛(类似于 #<DNSRecord:0x00000001368e3118>),所以我们需要编写一些好看的输出代码,提升它的可读性。

步骤十四:对于我们输出的 DNS 记录进行美化

我们需要向 DNS 记录增加一个 .to_s 字段,从而让它有一个更良好的字符串展示方式。而者只是做为一行方法的代码在 DNSRecord 中存在。

def to_s
  "#{@name}\t\t#{@ttl}\t#{@type_name}\t#{@parsed_rdata}"
end

你可能也注意到了我忽略了 DNS 记录中的 class 区域。那是因为它总是相同的(IN 表示 “internet”),所以我觉得它是个多余的。虽然很多 DNS 工具(像真正的 dig)会输出 class。

大功告成!

这是我们最终的主函数:

def main
  # connect to google dns
  sock = UDPSocket.new
  sock.bind('0.0.0.0', 12345)
  sock.connect('8.8.8.8', 53)

  # send query
  domain = ARGV[0]
  sock.send(make_dns_query(domain, 1), 0)

  # receive & parse response
  reply, _ = sock.recvfrom(1024)
  response = DNSResponse.new(reply)
  response.answers.each do |record|
    puts record
  end

我不觉得我们还能再补充什么 —— 我们建立连接、发送一个查询、输出每一个回答,然后退出。完事儿!

$ ruby dig.rb example.com
example.com   18608   A   93.184.216.34

你可以在这里查看最终程序:dig.rb。可以根据你的喜好给它增加更多特性,就比如说:

  • 为其他查询类型添加美化输出。
  • 输出 DNS 响应时增加“授权”和“可追加”的选项
  • 重试查询
  • 确保我们看到的 DNS 响应匹配我们的查询(ID 信息必须是对的上的!)

另外如果我在这篇文章中出现了什么错误,就 在推特和我聊聊吧。(我写的比较赶所以可能还是会有些错误)

(题图:MJ/449d049d-6bdd-448b-a61d-17138f8551bc)


via: https://jvns.ca/blog/2022/11/06/making-a-dns-query-in-ruby-from-scratch/

作者:Julia Evans 选题:lujun9972 译者:Drwhooooo 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

观察你的代码在其他解释器下运行的表现或许是一项有趣的尝试。

作为最受欢迎的编程语言之一,Python 需要一个解释器来执行其代码所定义的命令。与其他可直接编译成机器代码的语言不同,Python 代码需要解释器读取它并把它转译给进行相关操作的 CPU。那么,哪些解释器有哪些呢?本文将对其中几种进行介绍。

解释器简介

提到 Python 解释器,我们通常会想到 /usr/bin/python 这个二进制文件。它使你能够执行 .py 文件。然而,解释操作仅仅是其中一环。在 Python 代码真正被 CPU 执行之前,都需要经过以下四个步骤:

  1. 词法分析 - 将人类编写的源代码转换为一序列逻辑实体,被称为 词法标记 lexical token 。
  2. 解析 - 解析器会检查词法标记的语法和语义规则生成 抽象语法树 abstract syntax tree (AST)。
  3. 编译 - 编译器会根据 AST 创建 Python 字节码,这些字节码由非常基础的,和平台无关的指令组成。
  4. 解释 - 解释器处理字节码并执行特定的操作。

如你所见,在任何实质性的操作发生之前,我们需要走过这些步骤。这也解释了深入研究不同解释器的重要性。

1、CPython

作为 Python 的参考实现,CPython 默认地被许多系统所采用。如其名称所示,CPython 是用 C 语言编写的。这也意味着,我们可以 以 C 语言编写扩展,从而让 Python 打通到广泛使用的 C 语言库代码。CPython 广泛应用于各种平台,包括 ARM 和 RISC。然而,作为 Python 的参考实现,CPython 更注重精细的优化,而非运行速度。

2、Pyston

Pyston 是一个从 CPython 解释器衍生出的分支,其中实现了性能优化。该项目定位自己为标准 CPython 解释器在处理大型、真实世界应用时的替代品,并有可能加速高达 30%。由于缺乏兼容的二进制包,Pyston 在下载过程中需要重新编译。

3、PyPy

采用了 RPython 编写的 PyPy 是一个专为 Python 配备的 即时(JIT) 编译器,RPython 是 Python 的一个静态类型的子集。不同于 CPython 解释器,PyPy 对源代码进行编译,生成 CPU 可直接执行的机器码。PyPy 是 Python 开发者的实验室,在这里他们能更容易地测试新特性。

相较于 CPython,PyPy 的执行速度更快。由于 JIT 编译器的特性,长时间运行的应用更能从缓存中受益。PyPy 可以被视为 CPython 的有效替代。虽然其中存在一些缺点,大部分的 C 扩展模块在 PyPy 中也得到支持,但运行速度会相对慢一些。PyPy 扩展模块使用 Python(而不是 C)编写,这使 JIT 编译器能够对其进行优化。只要你的应用程序不依赖于不兼容的模块,PyPy 就是替换 CPython 的理想选择。你可以在项目官网找到一个专门的页面,详细描述 PyPy 与 CPython 的不同之处:PyPy 与 CPython 的差异

4、RustPython

顾名思义,RustPython 是一个由 Rust 编写的 Python 解释器。尽管 Rust 如今还是一个相对年轻的编程语言,但因其优良特性已逐步受到开发者的推崇,甚至被视为 C 和 C++ 的可能接班人。默认情况下,RustPython 的行为与 CPython 的解释器类似,但它也可以选择启用 JIT 编译器。值得一提的是,Rust 工具链能直接编译为 WebAssembly ,进而允许在浏览器中全面运行解释器。你可以在 这里 看到它的在线演示。

5、Stackless Python

Stackless Python 自称是 Python 编程语言的增强版本。该项目基本上是 CPython 解释器衍生的一个项目,其为该语言添加了微线程、通道和调度器。微线程可以帮助你将代码组织成可以并行运行的 “ 小任务 tasklet ”。这与采用 greenlet 模块的绿色线程模型相似。通道可以用作 “小任务” 之间的双向通信。Stackless Python 的一个知名用户是大型多人在线角色扮演游戏 Eve Online。

6、Micro Python

如果你的目标平台是微控制器,那么 MicroPython 将是你的首选。它是一种极简的实现,只需要 16kB 的内存和 256kB 的存储空间。由于其主要面向的是嵌入式环境,MicroPython 的标准库只包含 CPython 丰富的 STL 的一部分。对于开发和测试,或者作为轻量级替代品,MicroPython 也可以在普通的 x86 和 x64 系统上运行。MicroPython 支持 Linux、Windows,以及多种微控制器。

性能

就其设计而言,Python 本质上是一种运行速度不够快的语言。根据任务性质的不同,各种解释器间存在明显的性能差异。要想弄清楚哪种解释器最适合特定任务,可以参考 pybenchmarks.org。与使用解释器相比,另一种选择是直接将 Python 二进制代码编译成机器码,例如,Nuitka 就是能够完成这种工作的项目之一,它可以将 Python 代码编译成 C 代码,然后将 C 代码通过常规的 C 编译器编译成机器码。Python 编译器的主题范围广泛,值得一篇独立的文章来详述。

总结

Python 是构建快速原型和自动化任务的优秀语言,同时它又易于学习,对初学者友好。如果你平时维持使用 CPython,那么尝试看看你的代码在另一解释器上运行会是什么样子也许会很有趣。如果你是 Fedora 用户,你可以轻松地测试几种其他解释器,因为其包管理器已经提供了需要的二进制文件。你可以在 fedora.developer.org 上查找更多信息。

(题图:MJ/9b24f27b-bd2b-4916-9f33-bcfb9e2b1d33)


via: https://opensource.com/article/22/9/python-interpreters-2022

作者:Stephan Avenwedde 选题:lkxed 译者:ChatGPT 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出
数据分析已成为企业的当务之急,并且对具有用户友好界面的数据驱动应用程序有巨大的需求。本文介绍如何使用 R 语言中的 Shiny 包开发交互式 Web 应用程序,R 语言是一种流行的数据科学编程语言。

如今,世界各地几乎所有企业都以某种形式依赖于数据。数据科学通过使用数据驱动的应用程序帮助许多企业实现转型,无论是在金融、银行、零售、物流、电子商务、运输、航空还是任何其他领域。

高性能计算机和低成本存储使我们现在能够在几分钟内预测结果,而不是像以前一样以前需要花费很多时间。数据科学家着眼于未来,正在开发具有高性能和多维可视化的便捷应用。这一切都始于大数据,它由三个组成部分组成:数量、多样性和速度。算法和模型都是根据这些数据提供的。机器学习和人工智能领域最前沿的数据科学家正在创建能够自我改进、检测错误并从中学习的模型。

在数据科学领域,统计和计算用于将数据转化为有用的信息,通常称为数据驱动科学。数据科学是来自各个领域的方法的综合,用于收集、分析和解释数据,以形成新的见解并做出选择。构成数据科学的技术学科包括统计学、概率、数学、机器学习、商业智能和一些编程。

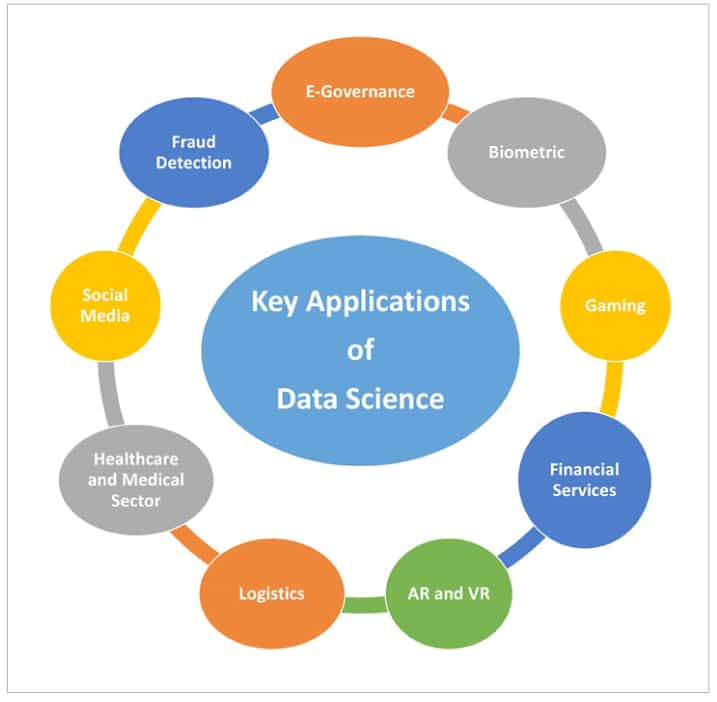
数据科学可以应用于各个领域(图 1)。对大型、复杂数据集的分析是数据科学的重点。它帮助我们创建了一个以全新方式看待数据的新宇宙。亚马逊、谷歌和 Facebook 等科技巨头利用数据科学原理进行商业智能和商业决策。

Figure 1 Key applications-and use cases of data science

R 语言:为数据科学量身打造的语言

由于海量的可用信息,我们迫切需要数据分析以得到新的见解,在多种技术的帮助下,原始数据转化为成品数据产品。在数据研究、处理、转换和可视化方面,没有比 R 语言更好的工具了。

R 语言用于数据科学的主要功能包括:

  • 数据预处理
  • 社交媒体数据获取和分析
  • 对数据结构的各种操作
  • 提取、转换、加载(ETL)
  • 连接到各种数据库,包括 SQL 和电子表格
  • 与 NoSQL 数据库交互
  • 使用模型进行训练和预测
  • 机器学习模型
  • 聚类
  • 傅里叶变换
  • 网页抓取

R 语言是一种强大的编程语言,常用于统计计算和数据分析。有关优化 R 语言用户界面的努力由来已久。从简单的文本编辑器到更现代的交互式 R Studio 和 Jupyter Notebooks,世界各地的多个数据科学小组都在关注 R 语言的发展。

只有全世界 R 用户的贡献才使这一切成为可能。R 语言中包含的强大软件包使其日益强大。许多开源软件包使处理大型数据集和可视化数据变得更加容易和高效。

使用 Shiny 在 R 语言中开发交互式 Web 应用

你可以使用 Shiny 包在 R 语言中构建交互式 Web 应用程序。应用程序可以托管在网站上、嵌入 R Markdown 文档中,或用于开发控制面板板和可视化。CSS 主题、HTML 小部件和 JavaScript 操作都可以用于进一步自定义你的 Shiny 应用程序。

Shiny 是一款 R 语言工具,它可以轻松创建交互式的 Web 应用程序。它允许你将你的 R 代码扩展到 Web 上,从而使更多的人能够使用它,从中获益。

除了 Shiny 内置的功能外,还有许多第三方扩展包可用,例如 shinythemes、shinydashboard 和 shinyjs。

使用 Shiny 可以开发各种应用程序。以下是其中一些:

  • 基于 Web 应用的机器学习
  • 具有动态控件的 Web 应用程序
  • 数据驱动的仪表盘
  • 多重数据集的交互式应用
  • 实时数据可视化面板
  • 数据收集表单

Shiny Web 应用程序可以分为以下几类:

  • 用户接口
  • 服务功能逻辑
  • Shiny 应用逻辑

获取更深理解,请访问以下网站 https://shiny.rstudio.com/gallery/ 。

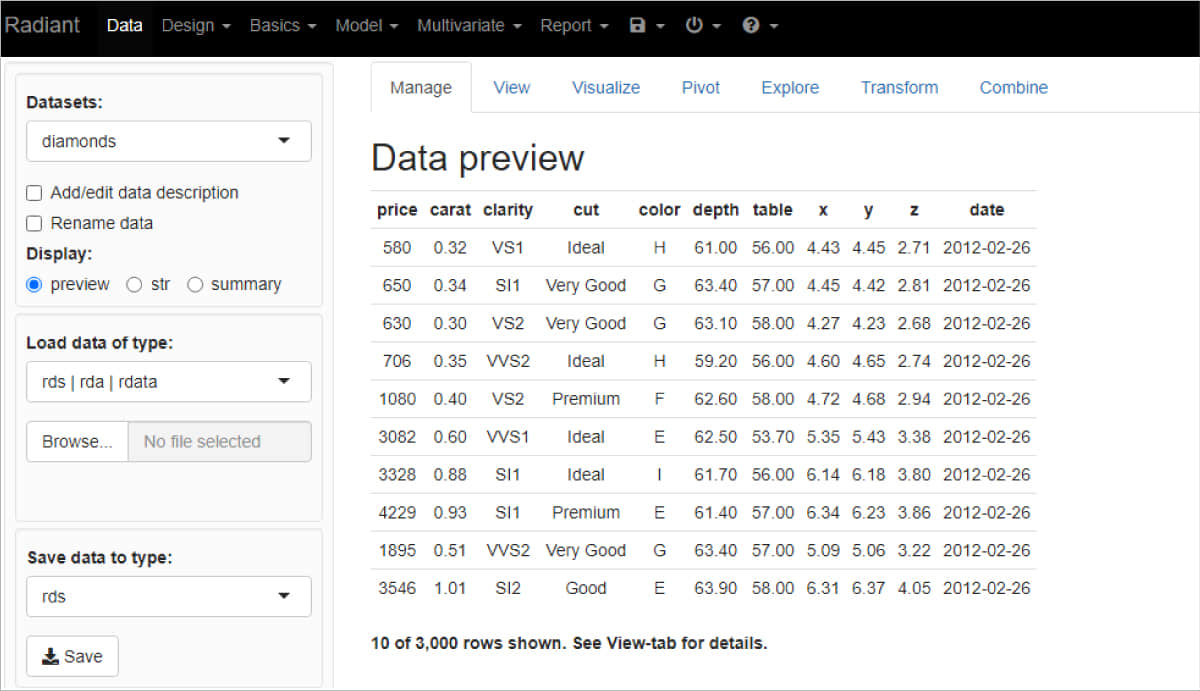
其中某个用 Shiny 开发的应用如图 2(https://shiny.rstudio.com/gallery/radiant.html )。

Figure 2: Shiny based app

销售仪表盘的生成

下面是一个与销售仪表盘相关的 Web 应用程序的代码片段。该仪表板具有多个控件和用户界面模块,用于查看数据。

首先,安装 Shiny 包,然后在代码中调用它,以便将输出呈现为 Web 页面的形式。

library(shiny)
library(dplyr)

sales <- vroom::vroom(“salesdata.csv”, na = “”)
ui <- fluidPage(
    titlePanel(“Dashboard for Sales Data”),
    sidebarLayout(
        sidebarPanel(
            selectInput(“territories”, “territories”, choices = unique(sales$territories)),
            selectInput(“Customers”, “Customer”, choices = NULL),
            selectInput(“orders”, “Order number”, choices = NULL, size = 5, selectize = FALSE),
        ),
        mainPanel(
            uiOutput(“customer”),
            tableOutput(“data”)
        )
    )
)
server <- function(input, output, session) {
    territories <- reactive({
        req(input$territories)
        filter(sales, territories == input$territories)
    })
    customer <- reactive({
        req(input$Customers)
        filter(territories(), Customers == input$Customers)
    })

    output$customer <- renderUI({
        row <- customer()[1, ]
        tags$div(
            class = “well”,
            tags$p(tags$strong(“Name: “), row$customers),
            tags$p(tags$strong(“Phone: “), row$contact),
            tags$p(tags$strong(“Contact: “), row$fname, “ “, row$lname)
        )
    })

    order <- reactive({
        req(input$order)
        customer() %>%
        filter(ORDER == input$order) %>%
        arrange(OLNUMBER) %>%
        select(pline, qty, price, sales, status)
    })

    output$data <- renderTable(order())

    observeEvent(territories(), {
        updateSelectInput(session, “Customers”, choices = unique(territories()$Customers), selected = character())
    })
    observeEvent(customer(), {
        updateSelectInput(session, “order”, choices = unique(customer()$order))
    })
}
shinyApp(ui, server)

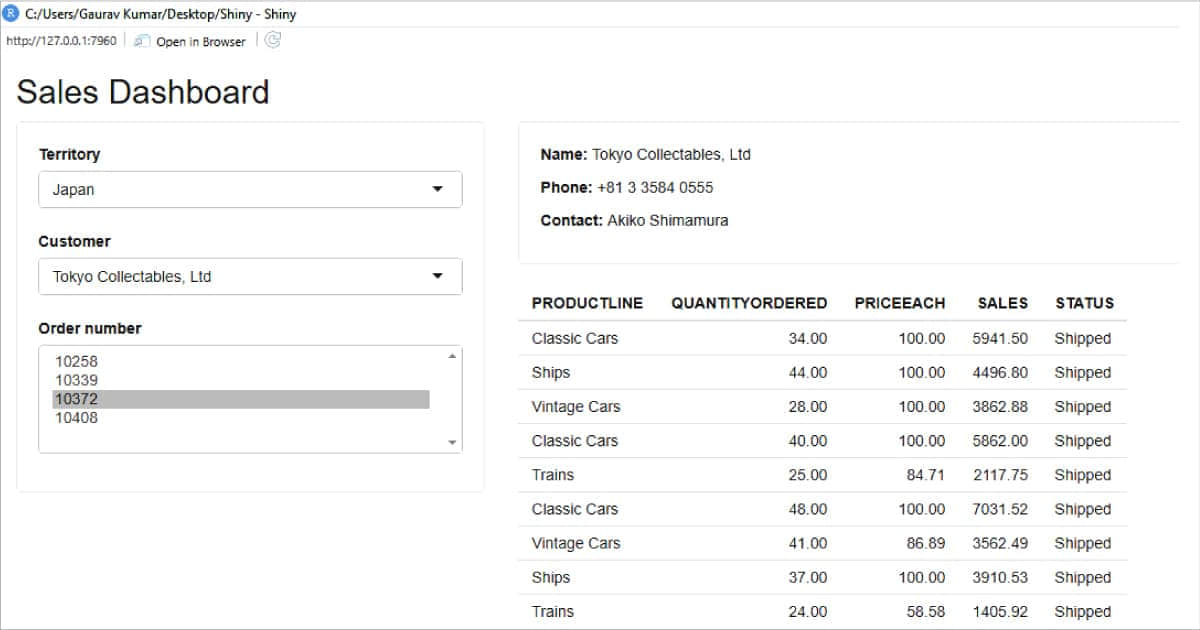
运行 Shiny 应用程序的代码后,生成了图 3 所示的输出,可以在任何 Web 浏览器上查看。销售仪表盘具有多个控件,并且具有不同的用户界面模块,非常互动。

Figure 3: Sales dashboard with multiple controls

通过使用 Shiny Cloud,可以将这个应用程序部署和托管在云上,以便随时随地在互联网上使用。

Figure 4: Cloud for hosting and deployment of Shiny app

Shiny Cloud 的免费版本允许在 25 个活动小时内部署五个应用程序。研究人员和数据科学家可以使用 R 的 Shiny 库开发基于实时数据驱动的用户友好应用程序。这个库也可以用于在 Web 平台上部署他们的机器学习应用程序。

(题图:MJ/1a76ad20-e56d-480b-b28b-8cf74d2230a1)


via: https://www.opensourceforu.com/2022/10/using-r-for-building-an-interactive-web-app/

作者:Dr Kumar Gaurav 选题:lkxed 译者:Charonxin 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出
以下是一个简单的编程项目,能够帮助你开始学习 Tcl/Tk。

探索 Tcl/Tk 的基础构造,包括用户输入、输出、变量、条件评估、简单函数和基础事件驱动编程。

我写这篇文章的初衷源于我想更深入地利用基于 Tcl 的 Expect。这让我写下了以下两篇文章:通过编写一个简单的游戏学习 Tcl 和 通过编写一个简单的游戏学习 Expect。

我进行了一些 Ansible 自动化工作,逐渐积累了一些本地脚本。有些脚本我频繁使用,以至于以下循环操作变得有些烦人:

  • 打开终端
  • 使用 cd 命令跳转至合适的目录
  • 输入一条带有若干选项的长命令启动所需的自动化流程

我日常使用的是 macOS。实际上我更希望有一个菜单项或者一个图标,能够弹出一个简单的界面接受参数并执行我需要的操作,这就像在 Linux 的 KDE 中一样。

经典的 Tcl 类书籍都包含了关于流行的 Tk 扩展的文档。既然我已经深入研究了这个主题,我尝试着对其(即 wish)进行编程。

虽然我并非一名 GUI 或者前端开发者,但我发现 Tcl/Tk 脚本编写的方式相当直接易懂。我很高兴能重新审视这个 UNIX 历史的古老且稳定的部分,这种技术在现代平台上依然有用且可用。

安装 Tcl/Tk

对于 Linux 系统,你可以按照下面的方式安装:

$ sudo dnf install tcl
$ which wish
/bin/wish

而在 macOS 上,你可以通过 Homebrew 来安装最新版的 Tcl/Tk:

$ brew install tcl-tk
$ which wish
/usr/local/bin/wish

编程理念

许多编写游戏的教程都会介绍到典型的编程语言结构,如循环、条件判断、变量、函数和过程等等。

在此篇文章中,我想要介绍的是 事件驱动编程。当你的程序使用事件驱动编程,它会进入一个特殊的内置循环,等待特定的事件发生。当这个特定的事件发生时,相应的代码就会被触发,产生预期的结果。

这些事件可以包括键盘输入、鼠标移动、点击按钮、定时器触发,甚至是任何你的电脑硬件能够识别的事件(可能来自特殊的设备)。你的程序中的代码决定了用户看到了什么,以及程序需要监听什么输入,当这些输入被接收后程序会怎么做,然后进入事件循环等待输入。

这篇文章的理念并没有脱离我之前的 Tcl 文章太远。这里最大的不同在于用 GUI 设置和用于处理用户输入的事件循环替代了循环结构。其他的不同则是 GUI 开发需要采取的各种方式来制作一个可用的用户界面。在采用 Tk GUI 开发的时候,你需要了解两个基础的概念: 部件 widget 和 几何管理器 geometry manager 。

部件是构成可视化元素的 UI 元素,通过这些元素用户可以与程序进行交互。这其中包括了按钮、文本区域、标签和文本输入框。部件还包括了一些选项选择,如菜单、复选框、单选按钮等。最后,部件也包括了其他的可视化元素,如边框和线性分隔符。

几何管理器在放置部件在显示窗口中的位置上扮演着至关重要的角色。有一些不同的几何管理器可以供你使用。在这篇文章中,我主要使用了 grid 几何来让部件在整齐的行中进行布局。我会在这篇文章的结尾地方解释一些几何管理器的不同之处。

用 wish 进行猜数字游戏

这个示例游戏代码与我其他文章中的示例有所不同,我将它分解为若干部分以方便解释。

首先创建一个基本的可执行脚本 numgame.wish :

$ touch numgame.wish
$ chmod 755 numgame.wish

使用你喜欢的文本编辑器打开此文件,输入下列代码的第一部分:

#!/usr/bin/env wish
set LOW 1
set HIGH 100
set STATUS ""
set GUESS ""
set num [expr round(rand()*100)]

第一行定义了该脚本将通过 wish 执行。接下来,创建了几个全局变量。这里我使用全部大写字母定义全局变量,这些变量将绑定到跟踪这些值的窗口小部件(LOW、HIGH等等)。

全局变量 num 是游戏玩家要猜测的随机数值,这个值是通过 Tcl 的命令执行得到并保存到变量中的:

proc Validate {var} {
    if { [string is integer $var] } {
        return 1
    }
    return 0
}

这是一个验证用户输入的特殊函数,它只接受整数并拒绝其他所有类型的输入:

proc check_guess {guess num} {
    global STATUS LOW HIGH GUESS

    if { $guess < $LOW } {
        set STATUS "What?"
    } elseif { $guess > $HIGH } {
        set STATUS "Huh?"
    } elseif { $guess < $num } {
        set STATUS "Too low!"
        set LOW $guess
    } elseif { $guess > $num } {
        set STATUS "Too high!"
        set HIGH $guess
    } else {
        set LOW $guess
        set HIGH $guess
        set STATUS "That's Right!"
        destroy .guess .entry
        bind all <Return> {.quit invoke}
    }

    set GUESS ""
}

这是主要的猜数逻辑循环。global 语句让我们能够修改在文件开头创建的全局变量(关于此主题后面将会有更多解释)。这个条件判断寻找入力范围在 1 至 100 之外以及已经被用户猜过的值。有效的猜测和随机值进行比较。LOW 和 HIGH 的猜测会被追踪,作为 UI 中的全局变量进行报告。在每一步,全局 STATUS 变量都会被更新,这个状态信息会自动在 UI 中显示。

对于正确的猜测,destroy 语句会移除 “Guess” 按钮以及输入窗口,并重新绑定回车键,以激活 “Quit” 按钮。

最后的语句 set GUESS "" 用于在下一个猜测之前清空输入窗口。

label .inst -text "Enter a number between: "
label .low -textvariable LOW
label .dash -text "-"
label .high -textvariable HIGH
label .status -text "Status:"
label .result -textvariable STATUS
button .guess -text "Guess" -command { check_guess $GUESS $num }
entry .entry -width 3 -relief sunken -bd 2 -textvariable GUESS -validate all \
    -validatecommand { Validate %P }
focus .entry
button .quit -text "Quit" -command { exit }
bind all <Return> {.guess invoke}

这是设置用户界面的部分。前六个标签语句在你的 UI 上创建了不同的文本展示元素,-textvariable 选项监控给定的变量,并自动更新标签的值,这展示了全局变量 LOW、HIGH、STATUS 的绑定。

button 行创建了 “Guess” 和 “Quit” 按钮, -command 选项设定了当按钮被按下时要执行的操作。按下 “Guess” 按钮执行了上面的 check_guess 函数以检查用户输入的值。

entry 部件更有趣。它创建了一个三字符宽的输入框,并将输入绑定到 GUESS 全局变量。它还通过 -validatecommand 选项设置了验证,阻止输入部件接收除数字以外的任何内容。

focus 命令是用户界面的一项改进,使程序启动时输入部件处于激活状态。没有此命令,你需要先点击输入部件才可以输入。

bind 命令允许你在按下回车键时自动点击 “Guess” 按钮。如果你记得 check_guess 中的内容,猜测正确之后会重新绑定回车键到 “Quit” 按钮。

最后,这部分设定了图形用户界面的布局:

grid .inst
grid .low .dash .high
grid .status .result
grid .guess .entry
grid .quit

grid 几何管理器被逐步调用,以逐渐构建出预期的用户体验。它主要设置了五行部件。前三行是显示不同值的标签,第四行是 “Guess” 按钮和 entry 部件,最后是 “Quit” 按钮。

程序到此已经初始化完毕,wish shell 进入事件循环,等待用户输入整数并按下按钮。基于其在被监视的全局变量中找到的变化,它会更新标签。

注意,输入光标开始就在输入框中,而且按下回车键将调用适当且可用的按钮。

这只是一个初级的例子,Tcl/Tk 有许多可以让间隔、字体、颜色和其他用户界面方面更具有吸引力的选项,这超出了本文中简单 UI 的示例。

运行这个应用,你可能会注意到这些部件看起来并不很精致或现代。这是因为我正在使用原始的经典部件集,它们让人回忆起 X Windows Motif 的时代。不过,还有一些默认的部件扩展,被称为主题部件,它们可以让你的应用程序有更现代、更精致的外观和感觉。

启动游戏!

保存文件之后,在终端中运行它:

$ ./numgame.wish

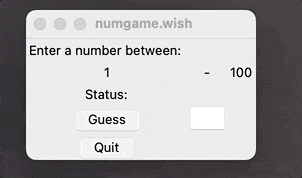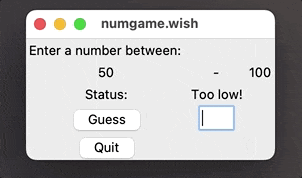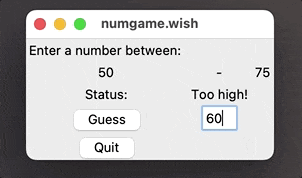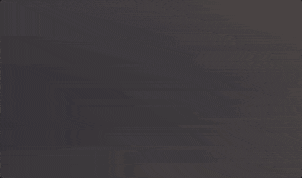
在这种情况下,我无法给出控制台的输出,因此这里有一个动画 GIF 来展示如何玩这个游戏:

用 Wish 编写的猜数游戏

进一步了解 Tcl

Tcl 支持命名空间的概念,所以在这里使用的变量并不必须是全局的。你可以把绑定的部件变量组织进不同的命名空间。对于像这样的简单程序,可能并不太需要这么做。但对于更大规模的项目,你可能会考虑这种方法。

proc check_guess 函数体内有一行 global 代码我之前没有解释。在 Tcl 中,所有变量都按值传递,函数体内引用的变量的范围是局部的。在这个情况下,我希望修改的是全局变量,而不是局部范围的版本。Tcl 提供了许多方法来引用变量,在执行堆栈的更高级别执行代码。在一些情况下,像这样的简单引用可能带来一些复杂性和错误,但是调用堆栈的操作非常有力,允许 Tcl 实现那些在其他语言中实现起来可能较为复杂的新的条件和循环结构。

最后,在这篇文章中,我没有提到几何管理器,它们用于以特定的顺序展示部件。只有被某种几何管理器管理的部件才能显示在屏幕上。grid 管理器相当简洁,它按照从左到右的方式放置部件。我使用了五个 grid 定义来创建了五行。另外还有两个几何管理器:place 和 pack。pack 管理器将部件围绕窗口边缘排列,而 place 管理器允许固定部件的位置。除这些几何管理器外,还有一些特殊的部件,如 canvas ,text 和 panedwindow,它们可以容纳并管理其他部件。你可以在经典的 Tcl/Tk 参考指南,以及 Tk 命令 文档页上找到这些部件的全面描述。

继续学习编程

Tcl 和 Tk 提供了一个简单有效的方法来构建图形用户界面和事件驱动应用程序。这个简单的猜数游戏只是你能用这些工具做到的事情的起点。通过继续学习和探索 Tcl 和 Tk,你可以打开构建强大且用户友好的应用程序的无数可能性。继续尝试,继续学习,看看你新习得的 Tcl 和 Tk 技能能带你到哪里。

(题图:MJ/40621c50-6577-4033-9f3c-8013bd0286f1)


via: https://opensource.com/article/23/4/learn-tcltk-wish-simple-game

作者:James Farrell 选题:lkxed 译者:ChatGPT 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出
在 Bash 基础系列的最后一章中学习函数的全部知识。

大多数编程语言都支持函数的概念。

函数帮助你避免在同一个程序中反复编写同一段代码。你只需将代码写为一个函数,然后在需要特定代码片段的地方使用这个函数。

在 Bash 基础知识系列的最后一章中,你将学习在 Bash 脚本中使用函数。

Bash 中的函数

下面是声明 Bash 函数的通用语法:

function_name() {
    commands
}

只有在 “调用函数” 的脚本中,函数内的命令才会被执行。

这里有一个伪代码来演示这个情况:

function_name() {
    commands
}

some_other_commands

# 函数调用
function_name argument;
? 函数定义必须在你调用函数之前。

让我们通过一个简单的例子来看看这个:

#!/bin/bash

fun() {
    echo "This is a function"
}

echo "This is a script"
fun

当你运行脚本时,你应该看到这样的输出:

This is a script
This is a function

函数是在没有任何参数的情况下被调用的。接下来,让我们看看在 bash 中如何处理函数的参数。

向函数传递参数

向函数传递参数和向 Bash 脚本传递参数是一样的。你在调用函数时,可以在函数名旁边写上参数。

function_name argument;

让我们用一个例子来看看这个:

#!/bin/bash

sum() {
    sum=$(($1+$2))
    echo "The sum of $1 and $2 is: $sum"
}

echo "Let's use the sum function"
sum 1 5

如果你运行这个脚本,你会看到以下输出:

Let's use the sum function
The sum of 1 and 5 is: 6

请记住,传递给脚本的参数和传递给函数的参数是不同的。

在下面的例子中,我在调用函数时交换了参数。

#!/bin/bash

arg() {
    echo "1st argument to function is $1 and 2nd is $2"
}

echo "1st argument to script is $1 and 2nd is $2"
arg $2 $1

当你运行这个脚本时,你会看到这样的交换:

$ ./function.sh abhi shek
1st argument to script is abhi and 2nd is shek
1st argument to function is shek and 2nd is abhi

Bash 中的递归函数

一个递归函数会调用它自己。这就是递归的含义。这个梗图可能会帮助你理解它。

递归功能非常强大,可以帮助你编写复杂的程序。

让我们用一个计算阶乘的样本脚本来看看它的应用。如果你忘记了,阶乘的定义是这样的。

n 的阶乘:

(n!) = 1 * 2 * 3 * 4 *...  * n

所以,5 的阶乘是 1 * 2 * 3 * 4 * 5,计算结果是 120。

这是我用递归计算给定数字的阶乘的脚本。

#!/bin/bash

factorial() {

    if [ $1 -gt 1 ]; then
        echo $(( $1 * $(factorial $(( $1 -1 ))) ))
    else
        echo 1
    fi

}

echo -n "Factorial of $1 is: "
factorial $1

注意到 echo $(( $1 * $(factorial $(( $1 -1 ))) )),代码使用比输入值小 1 的值调用了函数自身。这个过程会一直持续到值变为 1。所以,如果你运行脚本并输入参数 5,它最终会返回 5 * 4 * 3 * 2 *1 的结果。

$ ./factorial.sh 5
Factorial of 5 is: 120

非常好。现在,让我们来做些练习吧。

?️ 练习时间

以下是一些示例编程挑战,用来帮助你实践你所学。

练习 1:写一个 Bash 脚本,使用一个名为 is_even 的函数来检查给定的数字是否是偶数。

练习 2:类似的练习,你需要编写一个脚本,该脚本具有一个名为 is_prime 的函数,并检查给定数字是否是质数。如果你还不知道,质数只能被 1 和它自身整除。

练习 3:编写一个生成给定数字的斐波那契序列的脚本。序列从 1 开始,脚本必须接受大于 3 的数字。

所以,如果你运行 fibonacci.sh 5,它应该输出 “1 1 2 3 5”。

就这些了,伙计们!这是 Bash 基础系列的最后一节。当然,你在这里学到的只是冰山一角;Bash 编程还有更多需要学习的内容。

但是现在,你应该对 Bash Shell 有了一定的理解。你应该能够理解大多数 Bash 脚本,并能编写简单的脚本,即便不能编写复杂的。

如果你想深入学习,没有什么比阅读 GNU Bash 手册更好的了。

GNU Bash 手册

? 希望你喜欢这个 Bash 基础知识系列。我们正在创建更多的教程系列,以给你提供更流畅的学习体验。请提供你的反馈,帮助我们帮助其他人学习 Linux。

(题图:MJ/f0022a50-85fe-40cc-afdd-285d976ec98c)


via: https://itsfoss.com/bash-function/

作者:Abhishek Prakash 选题:lujun9972 译者:ChatGPT 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出