分类 技术 下的文章

摘要

在 Chrome 59 中开始搭载 Headless Chrome。这是一种在 无需显示 headless 的环境下运行 Chrome 浏览器的方式。从本质上来说,就是不用 chrome 浏览器来运行 Chrome 的功能!它将 Chromium 和 Blink 渲染引擎提供的所有现代 Web 平台的功能都带入了命令行。

它有什么用?

无需显示 headless 的浏览器对于自动化测试和不需要可视化 UI 界面的服务器环境是一个很好的工具。例如,你可能需要对真实的网页运行一些测试,创建一个 PDF,或者只是检查浏览器如何呈现 URL。

注意: Mac 和 Linux 上的 Chrome 59 都可以运行无需显示模式。对 Windows 的支持将在 Chrome 60 中提供。要检查你使用的 Chrome 版本,请在浏览器中打开 chrome://version。

开启 无需显示 headless 模式(命令行界面)

开启 无需显示 headless 模式最简单的方法是从命令行打开 Chrome 二进制文件。如果你已经安装了 Chrome 59 以上的版本,请使用 --headless 标志启动 Chrome:

chrome \
  --headless \                   # Runs Chrome in headless mode.
  --disable-gpu \                # Temporarily needed for now.
  --remote-debugging-port=9222 \
  https://www.chromestatus.com   # URL to open. Defaults to about:blank.
注意:目前你仍然需要使用 --disable-gpu 标志。但它最终会不需要的。

chrome 二进制文件应该指向你安装 Chrome 的位置。确切的位置会因平台差异而不同。当前我在 Mac 上操作,所以我为安装的每个版本的 Chrome 都创建了方便使用的别名。

如果您使用 Chrome 的稳定版,并且无法获得测试版,我建议您使用 chrome-canary 版本:

alias chrome="/Applications/Google\ Chrome.app/Contents/MacOS/Google\ Chrome"
alias chrome-canary="/Applications/Google\ Chrome\ Canary.app/Contents/MacOS/Google\ Chrome\ Canary"
alias chromium="/Applications/Chromium.app/Contents/MacOS/Chromium"

在这里下载 Chrome Cannary。

命令行的功能

在某些情况下,你可能不需要以脚本编程的方式操作 Headless Chrome。可以使用一些有用的命令行标志来执行常见的任务。

打印 DOM

--dump-dom 标志将打印 document.body.innerHTML 到标准输出:

chrome --headless --disable-gpu --dump-dom https://www.chromestatus.com/

创建一个 PDF

--print-to-pdf 标志将页面转出为 PDF 文件:

chrome --headless --disable-gpu --print-to-pdf https://www.chromestatus.com/

截图

要捕获页面的屏幕截图,请使用 --screenshot 标志:

chrome --headless --disable-gpu --screenshot https://www.chromestatus.com/

# Size of a standard letterhead.
chrome --headless --disable-gpu --screenshot --window-size=1280,1696 https://www.chromestatus.com/

# Nexus 5x
chrome --headless --disable-gpu --screenshot --window-size=412,732 https://www.chromestatus.com/

使用 --screenshot 标志运行 Headless Chrome 将在当前工作目录中生成一个名为 screenshot.png 的文件。如果你正在寻求整个页面的截图,那么会涉及到很多事情。来自 David Schnurr 的一篇很棒的博文已经介绍了这一内容。请查看 使用 headless Chrome 作为自动截屏工具。

REPL 模式 (read-eval-print loop)

--repl 标志可以使 Headless Chrome 运行在一个你可以使用浏览器评估 JS 表达式的模式下。执行下面的命令:

$ chrome --headless --disable-gpu --repl https://www.chromestatus.com/
[0608/112805.245285:INFO:headless_shell.cc(278)] Type a Javascript expression to evaluate or "quit" to exit.
>>> location.href
{"result":{"type":"string","value":"https://www.chromestatus.com/features"}}
>>> quit

在没有浏览器界面的情况下调试 Chrome

当你使用 --remote-debugging-port=9222 运行 Chrome 时,它会启动一个支持 DevTools 协议的实例。该协议用于与 Chrome 进行通信,并且驱动 Headless Chrome 浏览器实例。它也是一个类似 Sublime、VS Code 和 Node 的工具,可用于应用程序的远程调试。#协同效应

由于你没有浏览器用户界面可用来查看网页,请在另一个浏览器中输入 http://localhost:9222,以检查一切是否正常。你将会看到一个 可检查的 inspectable 页面的列表,可以点击它们来查看 Headless Chrome 正在呈现的内容:
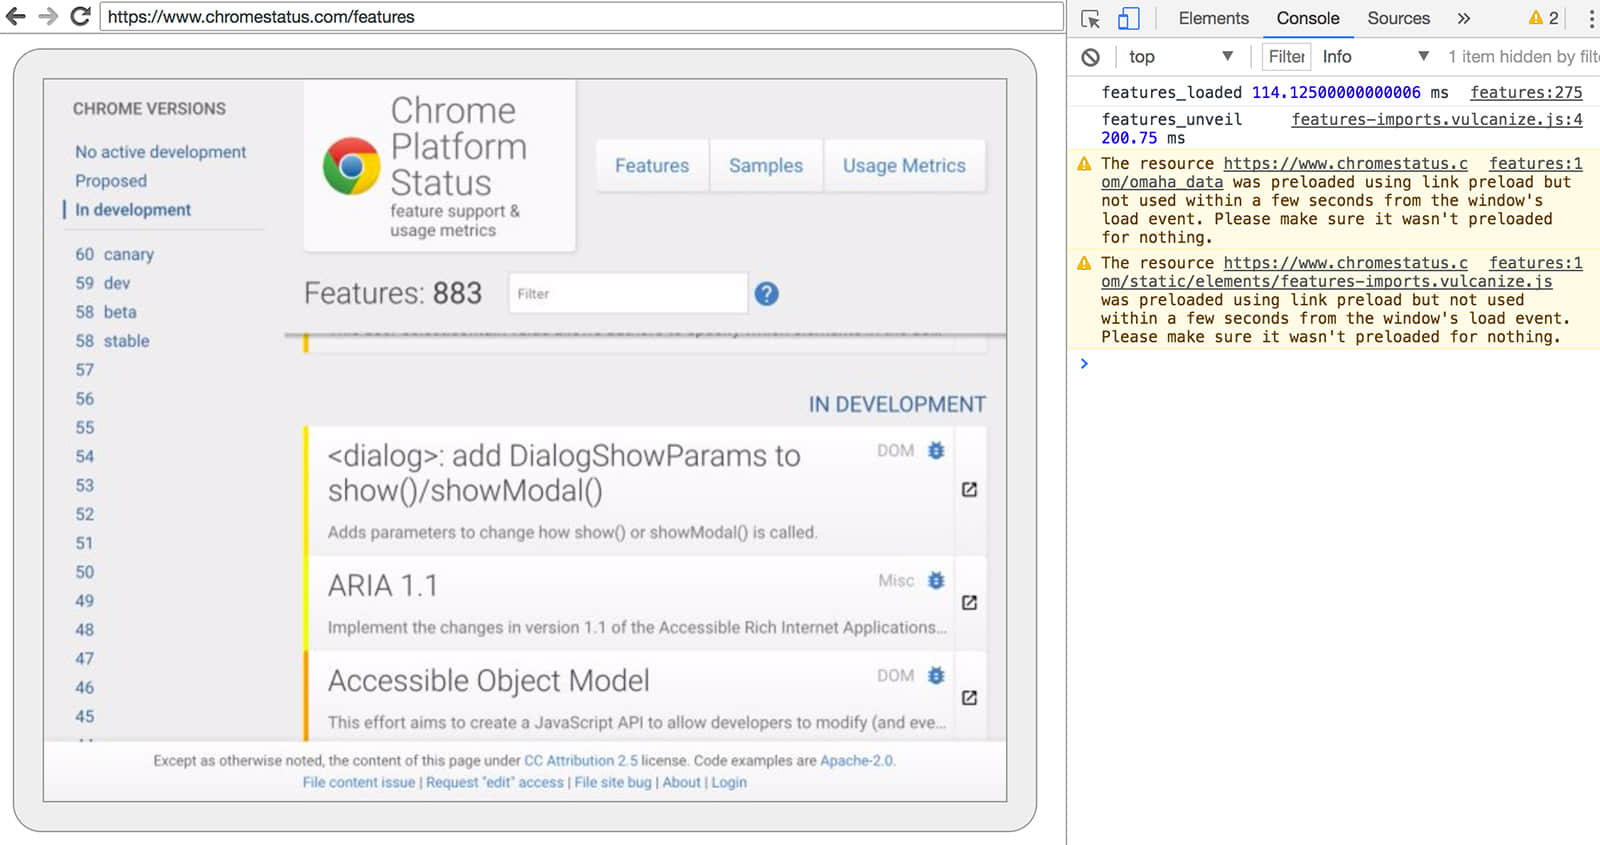
DevTools 远程调试界面

从这里,你就可以像往常一样使用熟悉的 DevTools 来检查、调试和调整页面了。如果你以编程方式使用 Headless Chrome,这个页面也是一个功能强大的调试工具,用于查看所有通过网络与浏览器交互的原始 DevTools 协议命令。

使用编程模式 (Node)

Puppeteer 库 API

Puppeteer 是一个由 Chrome 团队开发的 Node 库。它提供了一个高层次的 API 来控制无需显示版(或 完全版)的 Chrome。它与其他自动化测试库,如 Phantom 和 NightmareJS 相类似,但是只适用于最新版本的 Chrome。

除此之外,Puppeteer 还可用于轻松截取屏幕截图,创建 PDF,页面间导航以及获取有关这些页面的信息。如果你想快速地自动化进行浏览器测试,我建议使用该库。它隐藏了 DevTools 协议的复杂性,并可以处理诸如启动 Chrome 调试实例等繁冗的任务。

安装:

yarn add puppeteer

例子 - 打印用户代理:

const puppeteer = require('puppeteer');

(async() => {
  const browser = await puppeteer.launch();
  console.log(await browser.version());
  browser.close();
})();

例子 - 获取页面的屏幕截图:

const puppeteer = require('puppeteer');

(async() => {

const browser = await puppeteer.launch();
const page = await browser.newPage();
await page.goto('https://www.chromestatus.com', {waitUntil: 'networkidle'});
await page.pdf({path: 'page.pdf', format: 'A4'});

browser.close();
})();

查看 Puppeteer 的文档,了解完整 API 的更多信息。

CRI 库

chrome-remote-interface 是一个比 Puppeteer API 更低层次的库。如果你想要更接近原始信息和更直接地使用 DevTools 协议的话,我推荐使用它。

启动 Chrome

chrome-remote-interface 不会为你启动 Chrome,所以你要自己启动它。

在前面的 CLI 章节中,我们使用 --headless --remote-debugging-port=9222 手动启动了 Chrome。但是,要想做到完全自动化测试,你可能希望从你的应用程序中启动 Chrome。

其中一种方法是使用 child_process:

const execFile = require('child_process').execFile;

function launchHeadlessChrome(url, callback) {
  // Assuming MacOSx.
  const CHROME = '/Applications/Google\ Chrome.app/Contents/MacOS/Google\ Chrome';
  execFile(CHROME, ['--headless', '--disable-gpu', '--remote-debugging-port=9222', url], callback);
}

launchHeadlessChrome('https://www.chromestatus.com', (err, stdout, stderr) => {
  ...
});

但是如果你想要在多个平台上运行可移植的解决方案,事情会变得很棘手。请注意 Chrome 的硬编码路径:

使用 ChromeLauncher

Lighthouse 是一个令人称奇的网络应用的质量测试工具。Lighthouse 内部开发了一个强大的用于启动 Chrome 的模块,现在已经被提取出来单独使用。chrome-launcher NPM 模块 可以找到 Chrome 的安装位置,设置调试实例,启动浏览器和在程序运行完之后将其杀死。它最好的一点是可以跨平台工作,感谢 Node!

默认情况下,chrome-launcher 会尝试启动 Chrome Canary(如果已经安装),但是你也可以更改它,手动选择使用的 Chrome 版本。要想使用它,首先从 npm 安装:

yarn add chrome-launcher

例子 - 使用 chrome-launcher 启动 Headless Chrome:

const chromeLauncher = require('chrome-launcher');

// Optional: set logging level of launcher to see its output.
// Install it using: yarn add lighthouse-logger
// const log = require('lighthouse-logger');
// log.setLevel('info');

/**
 * Launches a debugging instance of Chrome.
 * @param {boolean=} headless True (default) launches Chrome in headless mode.
 *     False launches a full version of Chrome.
 * @return {Promise<ChromeLauncher>}
 */
function launchChrome(headless=true) {
  return chromeLauncher.launch({
    // port: 9222, // Uncomment to force a specific port of your choice.
    chromeFlags: [
      '--window-size=412,732',
      '--disable-gpu',
      headless ? '--headless' : ''
    ]
  });
}

launchChrome().then(chrome => {
  console.log(`Chrome debuggable on port: ${chrome.port}`);
  ...
  // chrome.kill();
});

运行这个脚本没有做太多的事情,但你应该能在任务管理器中看到启动了一个 Chrome 的实例,它加载了页面 about:blank。记住,它不会有任何的浏览器界面,我们是无需显示的。

为了控制浏览器,我们需要 DevTools 协议!

检索有关页面的信息

警告: DevTools 协议可以做一些有趣的事情,但是起初可能有点令人生畏。我建议先花点时间浏览 DevTools 协议查看器。然后,转到 chrome-remote-interface 的 API 文档,看看它是如何包装原始协议的。

我们来安装该库:

yarn add chrome-remote-interface

例子 - 打印用户代理:

const CDP = require('chrome-remote-interface');

...

launchChrome().then(async chrome => {
  const version = await CDP.Version({port: chrome.port});
  console.log(version['User-Agent']);
});

结果是类似这样的东西:HeadlessChrome/60.0.3082.0。

例子 - 检查网站是否有 Web 应用程序清单:

const CDP = require('chrome-remote-interface');

...

(async function() {

const chrome = await launchChrome();
const protocol = await CDP({port: chrome.port});

// Extract the DevTools protocol domains we need and enable them.
// See API docs: https://chromedevtools.github.io/devtools-protocol/
const {Page} = protocol;
await Page.enable();

Page.navigate({url: 'https://www.chromestatus.com/'});

// Wait for window.onload before doing stuff.
Page.loadEventFired(async () => {
  const manifest = await Page.getAppManifest();

  if (manifest.url) {
    console.log('Manifest: ' + manifest.url);
    console.log(manifest.data);
  } else {
    console.log('Site has no app manifest');
  }

  protocol.close();
  chrome.kill(); // Kill Chrome.
});

})();

例子 - 使用 DOM API 提取页面的 <title>:

const CDP = require('chrome-remote-interface');

...

(async function() {

const chrome = await launchChrome();
const protocol = await CDP({port: chrome.port});

// Extract the DevTools protocol domains we need and enable them.
// See API docs: https://chromedevtools.github.io/devtools-protocol/
const {Page, Runtime} = protocol;
await Promise.all([Page.enable(), Runtime.enable()]);

Page.navigate({url: 'https://www.chromestatus.com/'});

// Wait for window.onload before doing stuff.
Page.loadEventFired(async () => {
  const js = "document.querySelector('title').textContent";
  // Evaluate the JS expression in the page.
  const result = await Runtime.evaluate({expression: js});

  console.log('Title of page: ' + result.result.value);

  protocol.close();
  chrome.kill(); // Kill Chrome.
});

})();

使用 Selenium、WebDriver 和 ChromeDriver

现在,Selenium 开启了 Chrome 的完整实例。换句话说,这是一个自动化的解决方案,但不是完全无需显示的。但是,Selenium 只需要进行小小的配置即可运行 Headless Chrome。如果你想要关于如何自己设置的完整说明,我建议你阅读“使用 Headless Chrome 来运行 Selenium”,不过你可以从下面的一些示例开始。

使用 ChromeDriver

ChromeDriver 2.3.0 支持 Chrome 59 及更新版本,可与 Headless Chrome 配合使用。在某些情况下,你可能需要等到 Chrome 60 以解决 bug。例如,Chrome 59 中屏幕截图已知存在问题。

安装:

yarn add selenium-webdriver chromedriver

例子:

const fs = require('fs');
const webdriver = require('selenium-webdriver');
const chromedriver = require('chromedriver');

// This should be the path to your Canary installation.
// I'm assuming Mac for the example.
const PATH_TO_CANARY = '/Applications/Google Chrome Canary.app/Contents/MacOS/Google Chrome Canary';

const chromeCapabilities = webdriver.Capabilities.chrome();
chromeCapabilities.set('chromeOptions', {
  binary: PATH_TO_CANARY // Screenshots require Chrome 60\. Force Canary.
  'args': [
    '--headless',
  ]
});

const driver = new webdriver.Builder()
  .forBrowser('chrome')
  .withCapabilities(chromeCapabilities)
  .build();

// Navigate to google.com, enter a search.
driver.get('https://www.google.com/');
driver.findElement({name: 'q'}).sendKeys('webdriver');
driver.findElement({name: 'btnG'}).click();
driver.wait(webdriver.until.titleIs('webdriver - Google Search'), 1000);

// Take screenshot of results page. Save to disk.
driver.takeScreenshot().then(base64png => {
  fs.writeFileSync('screenshot.png', new Buffer(base64png, 'base64'));
});

driver.quit();

使用 WebDriverIO

WebDriverIO 是一个在 Selenium WebDrive 上构建的更高层次的 API。

安装:

yarn add webdriverio chromedriver

例子:过滤 chromestatus.com 上的 CSS 功能:

const webdriverio = require('webdriverio');
const chromedriver = require('chromedriver');

// This should be the path to your Canary installation.
// I'm assuming Mac for the example.
const PATH_TO_CANARY = '/Applications/Google Chrome Canary.app/Contents/MacOS/Google Chrome Canary';
const PORT = 9515;

chromedriver.start([
  '--url-base=wd/hub',
  `--port=${PORT}`,
  '--verbose'
]);

(async () => {

const opts = {
  port: PORT,
  desiredCapabilities: {
    browserName: 'chrome',
    chromeOptions: {
      binary: PATH_TO_CANARY // Screenshots require Chrome 60\. Force Canary.
      args: ['--headless']
    }
  }
};

const browser = webdriverio.remote(opts).init();

await browser.url('https://www.chromestatus.com/features');

const title = await browser.getTitle();
console.log(`Title: ${title}`);

await browser.waitForText('.num-features', 3000);
let numFeatures = await browser.getText('.num-features');
console.log(`Chrome has ${numFeatures} total features`);

await browser.setValue('input[type="search"]', 'CSS');
console.log('Filtering features...');
await browser.pause(1000);

numFeatures = await browser.getText('.num-features');
console.log(`Chrome has ${numFeatures} CSS features`);

const buffer = await browser.saveScreenshot('screenshot.png');
console.log('Saved screenshot...');

chromedriver.stop();
browser.end();

})();

更多资源

以下是一些可以带你入门的有用资源:

文档

工具

样例

  • "The Headless Web" - Paul Kinlan 发布的使用了 Headless 和 api.ai 的精彩博客

常见问题

我需要 --disable-gpu 标志吗?

目前是需要的。--disable-gpu 标志在处理一些 bug 时是需要的。在未来版本的 Chrome 中就不需要了。查看 https://crbug.com/546953#c152 和 https://crbug.com/695212 获取更多信息。

所以我仍然需要 Xvfb 吗?

不。Headless Chrome 不使用窗口,所以不需要像 Xvfb 这样的显示服务器。没有它你也可以愉快地运行你的自动化测试。

什么是 Xvfb?Xvfb 是一个用于类 Unix 系统的运行于内存之内的显示服务器,可以让你运行图形应用程序(如 Chrome),而无需附加的物理显示器。许多人使用 Xvfb 运行早期版本的 Chrome 进行 “headless” 测试。

如何创建一个运行 Headless Chrome 的 Docker 容器?

查看 lighthouse-ci。它有一个使用 Ubuntu 作为基础镜像的 Dockerfile 示例,并且在 App Engine Flexible 容器中安装和运行了 Lighthouse。

我可以把它和 Selenium / WebDriver / ChromeDriver 一起使用吗?

是的。查看 Using Selenium, WebDrive, or ChromeDriver。

它和 PhantomJS 有什么关系?

Headless Chrome 和 PhantomJS 是类似的工具。它们都可以用来在无需显示的环境中进行自动化测试。两者的主要不同在于 Phantom 使用了一个较老版本的 WebKit 作为它的渲染引擎,而 Headless Chrome 使用了最新版本的 Blink。

目前,Phantom 提供了比 DevTools protocol 更高层次的 API。

我在哪儿提交 bug?

对于 Headless Chrome 的 bug,请提交到 crbug.com。

对于 DevTools 协议的 bug,请提交到 github.com/ChromeDevTools/devtools-protocol。


作者简介

Eric Bidelman 谷歌工程师,Lighthouse 开发,Web 和 Web 组件开发,Chrome 开发


via: https://developers.google.com/web/updates/2017/04/headless-chrome

作者:Eric Bidelman 译者:firmianay 校对:wxy
本文由 LCTT 原创编译,Linux中国 荣誉推出

如果你的运维团队在使用 Docker 和 Kubernetes,那么建议开发上采用相同或相似的技术。这将减少不兼容性和可移植性问题的数量,并使每个人都会认识到应用程序容器是开发和运维团队的共同责任。

这篇博客文章介绍了 Kubernetes 在开发模式中的用法,它的灵感来自于一个视频教程,你可以在“无痛 Docker 教程”中找到它。

Minikube 是一个允许开发人员在本地使用和运行 Kubernetes 集群的工具,从而使开发人员的生活变得轻松。

在这篇博客中,对于我测试的例子,我使用的是 Linux Mint 18,但其它 Linux 发行版在安装部分没有区别。

cat /etc/lsb-release 
DISTRIB_ID=LinuxMint
DISTRIB_RELEASE=18.1
DISTRIB_CODENAME=serena
DISTRIB_DESCRIPTION=”Linux Mint 18.1 Serena”

先决条件

为了与 Minkube 一起工作,我们应该安装 Kubectl 和 Minikube 和一些虚拟化驱动程序。

curl -LO https://storage.googleapis.com/kubernetes-release/release/$(curl -s https://storage.googleapis.com/kubernetes-release/release/stable.txt)/bin/darwin/amd64/kubectl

chmod +x ./kubectl

sudo mv ./kubectl /usr/local/bin/kubectl

curl -Lo minikube https://storage.googleapis.com/minikube/releases/v0.21.0/minikube-darwin-amd64 && chmod +x minikube && sudo mv minikube /usr/local/bin/
  • 对于 Windows,安装 VirtualBox 或者 Hyper-V,然后再安装 Kubectl 和 Minkube。
curl -LO https://storage.googleapis.com/kubernetes-release/release/v1.7.0/bin/windows/amd64/kubectl.exe

将二进制文件添加到你的 PATH 中(这篇文章解释了如何修改 PATH)

下载 minikube-windows-amd64.exe,将其重命名为 minikube.exe,并将其添加到你的 PATH 中。在这可以找到最新版本。

  • 对于 Linux,安装 VirtualBox 或者 KVM,然后再安装 Kubectl 和 Minkube。
curl -LO https://storage.googleapis.com/kubernetes-release/release/$(curl -s https://storage.googleapis.com/kubernetes-release/release/stable.txt)/bin/linux/amd64/kubectl

chmod +x ./kubectl

sudo mv ./kubectl /usr/local/bin/kubectl

curl -Lo minikube https://storage.googleapis.com/minikube/releases/v0.21.0/minikube-linux-amd64 && chmod +x minikube && sudo mv minikube /usr/local/bin/

使用 Minikube

我们先从这个 Dockerfile 创建一个镜像:

FROM busybox
ADD index.html /www/index.html
EXPOSE 8000
CMD httpd -p 8000 -h /www; tail -f /dev/null

添加你希望在 index.html 中看到的内容。

构建镜像:

docker build -t eon01/hello-world-web-server .

我们来运行容器来测试它:

docker run -d --name webserver -p 8000:8000 eon01/hello-world-web-server

这是 docker ps 的输出:

docker ps

CONTAINER ID        IMAGE                          COMMAND                  CREATED             STATUS              PORTS                    NAMES
2ad8d688d812        eon01/hello-world-web-server   "/bin/sh -c 'httpd..."   3 seconds ago       Up 2 seconds        0.0.0.0:8000->8000/tcp   webserver

让我们提交镜像并将其上传到公共 Docker Hub 中。你也可以使用自己的私有仓库:

docker commit webserver
docker push eon01/hello-world-web-server

删除容器,因为我们将与 Minikube 一起使用它。

docker rm -f webserver

启动 Minikube:

minkube start

检查状态:

minikube status

我们运行一个单一节点:

kubectl get node

运行 webserver:

kubectl run webserver --image=eon01/hello-world-web-server --port=8000

webserver 应该会暴露它的端口:

kubectl expose deployment webserver --type=NodePort

为了得到服务 url 输入:

minikube service webserver --url

使用下面的命令得到 Web 页面的内容:

curl $(minikube service webserver --url)

显示运行中集群的摘要:

kubectl cluster-info

更多细节:

kubectl cluster-info dump

我们还可以使用以下方式列出 pod:

kubectl get pods

使用下面的方式访问面板:

minikube dashboard

如果你想访问 Web 程序的前端,输入:

kubectl proxy

如果我们要在容器内部执行一个命令,请使用以下命令获取 pod id:

kubetctl get pods

然后像这样使用:

kubectl exec webserver-2022867364-0v1p9 -it -- /bin/sh

最后完成了,请删除所有部署:

kubectl delete deployments --all

删除所有 pod:

kubectl delete pods --all

并且停止 Minikube。

minikube stop

我希望你享受这个介绍。

更加深入

如果你对本文感到共鸣,您可以在无痛 Docker 教程中找到更多有趣的内容。

我们 Eralabs 将很乐意为你的 Docker 和云计算项目提供帮助,联系我们,我们将很乐意听到你的项目。

请订阅 DevOpsLinks:成千上万的 IT 专家和 DevOps 爱好者在线社区。

你可能也有兴趣加入我们的新闻订阅 Shipped,一个专注于容器,编排和无服务技术的新闻订阅。

你可以在 Twitter、Clarity 或我的网站上找到我,你也可以看看我的书:SaltStack For DevOps。

不要忘记加入我的最后一个项目 DevOps 的职位!

如果你喜欢本文,请推荐它,并与你的关注者分享。


作者简介:

Aymen El Amri - 云和软件架构师、企业家、作者、www.eralabs.io 的 CEO、www.devopslinks.com 的创始人,个人页面:www.aymenelamri.com


via: https://medium.com/devopslinks/using-kubernetes-minikube-for-local-development-c37c6e56e3db

作者:Aymen El Amri 译者:geekpi 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

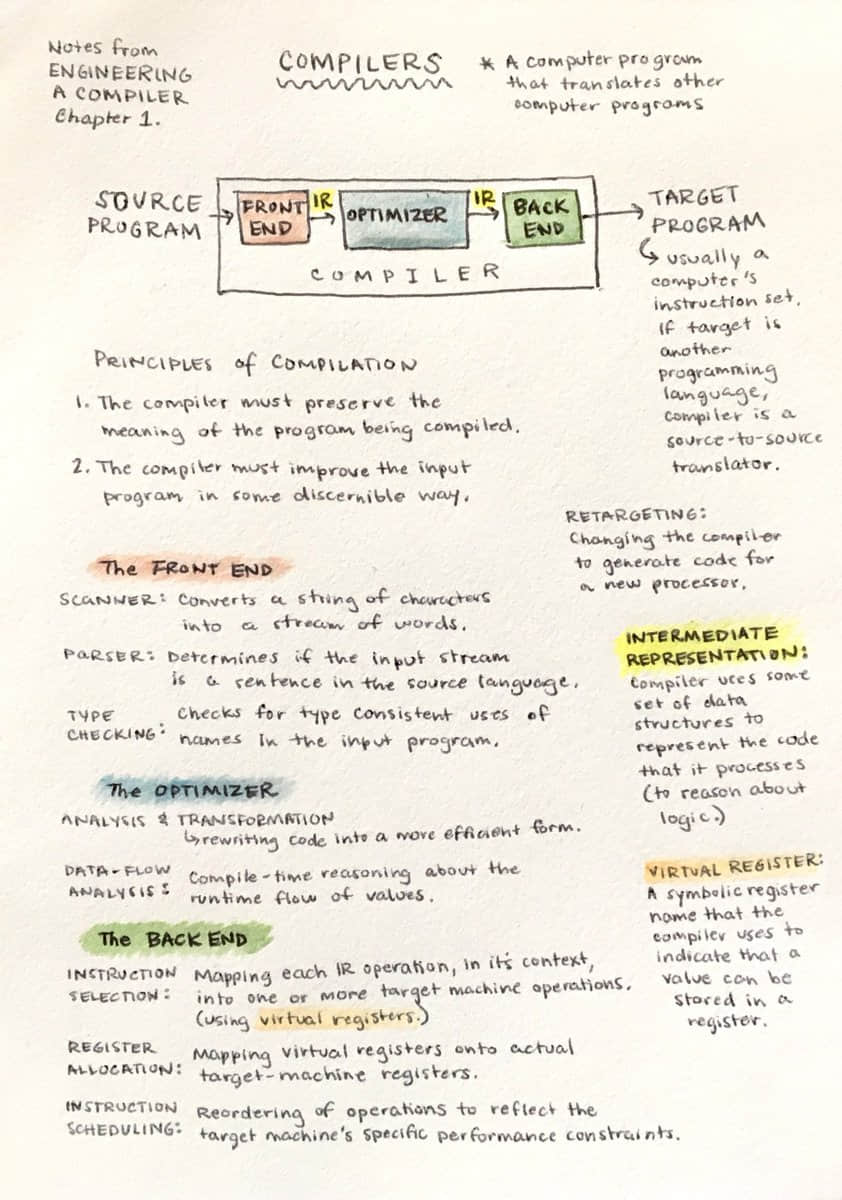
简单说来,一个 编译器 compiler 不过是一个可以翻译其他程序的程序。传统的编译器可以把源代码翻译成你的计算机能够理解的可执行机器代码。(一些编译器将源代码翻译成别的程序语言,这样的编译器称为源到源翻译器或 转化器 transpilers 。)LLVM 是一个广泛使用的编译器项目,包含许多模块化的编译工具。

传统的编译器设计包含三个部分:

  • 前端 Frontend 将源代码翻译为 中间表示 intermediate representation (IR)* 。clang 是 LLVM 中用于 C 家族语言的前端工具。
  • 优化器 Optimizer 分析 IR 然后将其转化为更高效的形式。opt 是 LLVM 的优化工具。
  • 后端 Backend 通过将 IR 映射到目标硬件指令集从而生成机器代码。llc 是 LLVM 的后端工具。

注:LLVM 的 IR 是一种和汇编类似的低级语言。然而,它抽离了特定硬件信息。

Hello, Compiler

下面是一个打印 “Hello, Compiler!” 到标准输出的简单 C 程序。C 语法是人类可读的,但是计算机却不能理解,不知道该程序要干什么。我将通过三个编译阶段使该程序变成机器可执行的程序。

// compile_me.c
// Wave to the compiler. The world can wait.

#include <stdio.h>

int main() {
  printf("Hello, Compiler!\n");
  return 0;
}

前端

正如我在上面所提到的,clang 是 LLVM 中用于 C 家族语言的前端工具。Clang 包含 C 预处理器 C preprocessor 、 词法分析器 lexer 、 语法解析器 parser 、 语义分析器 semantic analyzer 和 IR 生成器 IR generator 。

C 预处理器在将源程序翻译成 IR 前修改源程序。预处理器处理外部包含文件,比如上面的 #include <stdio.h>。 它将会把这一行替换为 stdio.h C 标准库文件的完整内容,其中包含 printf 函数的声明。

通过运行下面的命令来查看预处理步骤的输出:

clang -E compile_me.c -o preprocessed.i

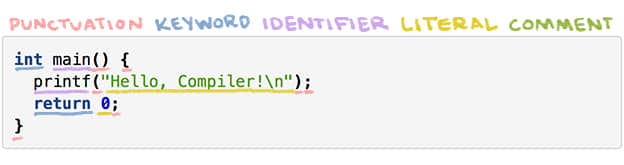
词法分析器(或 扫描器 scanner 或 分词器 tokenizer )将一串字符转化为一串单词。每一个单词或 记号 token ,被归并到五种语法类别之一:标点符号、关键字、标识符、文字或注释。

compile\_me.c 的分词过程:

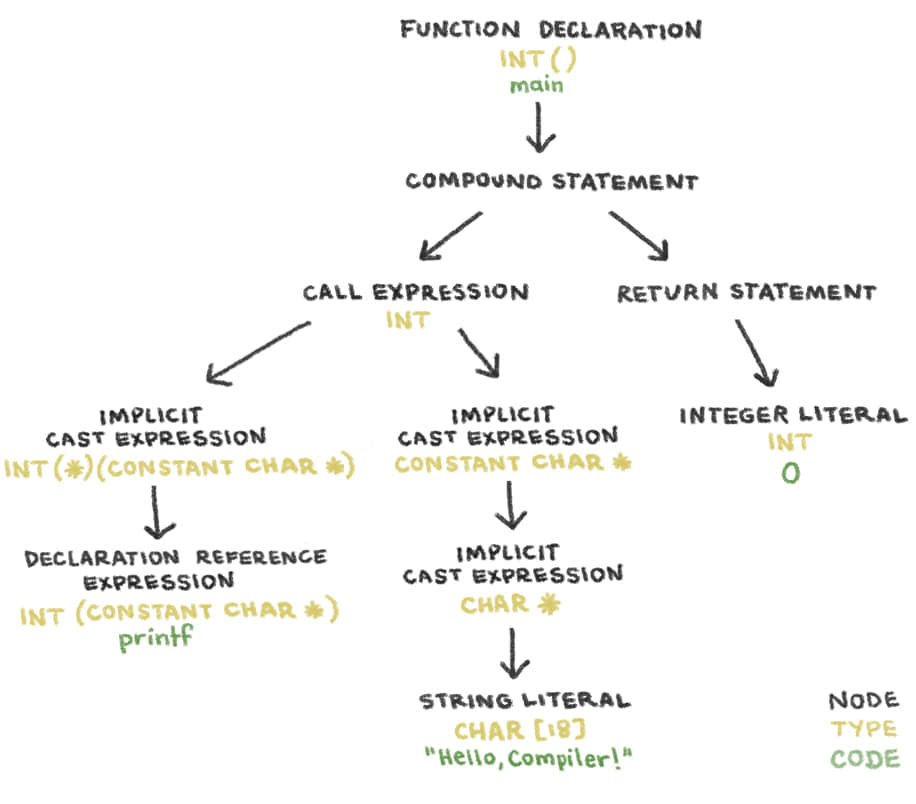
语法分析器确定源程序中的单词流是否组成了合法的句子。在分析记号流的语法后,它会输出一个 抽象语法树 abstract syntax tree (AST)。Clang 的 AST 中的节点表示声明、语句和类型。

compile\_me.c 的语法树:

语义分析器会遍历抽象语法树,从而确定代码语句是否有正确意义。这个阶段会检查类型错误。如果 compile_me.c 的 main 函数返回 "zero"而不是 0, 那么语义分析器将会抛出一个错误,因为 "zero" 不是 int 类型。

IR 生成器将抽象语法树翻译为 IR。

对 compile\_me.c 运行 clang 来生成 LLVM IR:

clang -S -emit-llvm -o llvm_ir.ll compile_me.c

在 llvm_ir.ll 中的 main 函数:

; llvm_ir.ll
@.str = private unnamed_addr constant [18 x i8] c"Hello, Compiler!\0A\00", align 1

define i32 @main() {
  %1 = alloca i32, align 4 ; <- memory allocated on the stack
  store i32 0, i32* %1, align 4
  %2 = call i32 (i8*, ...) @printf(i8* getelementptr inbounds ([18 x i8], [18 x i8]* @.str, i32 0, i32 0))
  ret i32 0
}

declare i32 @printf(i8*, ...)

优化程序

优化程序的工作是基于其对程序的运行时行为的理解来提高代码效率。优化程序将 IR 作为输入,然后生成改进后的 IR 作为输出。LLVM 的优化工具 opt 将会通过标记 -O2(大写字母 o,数字 2)来优化处理器速度,通过标记 Os(大写字母 o,小写字母 s)来减少指令数目。

看一看上面的前端工具生成的 LLVM IR 代码和运行下面的命令生成的结果之间的区别:

opt -O2 -S llvm_ir.ll -o optimized.ll

在 optimized.ll 中的 main 函数:

optimized.ll

@str = private unnamed_addr constant [17 x i8] c"Hello, Compiler!\00"

define i32 @main() {
  %puts = tail call i32 @puts(i8* getelementptr inbounds ([17 x i8], [17 x i8]* @str, i64 0, i64 0))
  ret i32 0
}

declare i32 @puts(i8* nocapture readonly)

优化后的版本中, main 函数没有在栈中分配内存,因为它不使用任何内存。优化后的代码中调用 puts 函数而不是 printf 函数,因为程序中并没有使用 printf 函数的格式化功能。

当然,优化程序不仅仅知道何时可以把 printf 函数用 puts 函数代替。优化程序也能展开循环并内联简单计算的结果。考虑下面的程序,它将两个整数相加并打印出结果。

// add.c
#include <stdio.h>

int main() {
  int a = 5, b = 10, c = a + b;
  printf("%i + %i = %i\n", a, b, c);
}

下面是未优化的 LLVM IR:

@.str = private unnamed_addr constant [14 x i8] c"%i + %i = %i\0A\00", align 1

define i32 @main() {
  %1 = alloca i32, align 4 ; <- allocate stack space for var a
  %2 = alloca i32, align 4 ; <- allocate stack space for var b
  %3 = alloca i32, align 4 ; <- allocate stack space for var c
  store i32 5, i32* %1, align 4  ; <- store 5 at memory location %1
  store i32 10, i32* %2, align 4 ; <- store 10 at memory location %2
  %4 = load i32, i32* %1, align 4 ; <- load the value at memory address %1 into register %4
  %5 = load i32, i32* %2, align 4 ; <- load the value at memory address %2 into register %5
  %6 = add nsw i32 %4, %5 ; <- add the values in registers %4 and %5\. put the result in register %6
  store i32 %6, i32* %3, align 4 ; <- put the value of register %6 into memory address %3
  %7 = load i32, i32* %1, align 4 ; <- load the value at memory address %1 into register %7
  %8 = load i32, i32* %2, align 4 ; <- load the value at memory address %2 into register %8
  %9 = load i32, i32* %3, align 4 ; <- load the value at memory address %3 into register %9
  %10 = call i32 (i8*, ...) @printf(i8* getelementptr inbounds ([14 x i8], [14 x i8]* @.str, i32 0, i32 0), i32 %7, i32 %8, i32 %9)
  ret i32 0
}

declare i32 @printf(i8*, ...)

下面是优化后的 LLVM IR:

@.str = private unnamed_addr constant [14 x i8] c"%i + %i = %i\0A\00", align 1

define i32 @main() {
  %1 = tail call i32 (i8*, ...) @printf(i8* getelementptr inbounds ([14 x i8], [14 x i8]* @.str, i64 0, i64 0), i32 5, i32 10, i32 15)
  ret i32 0
}

declare i32 @printf(i8* nocapture readonly, ...)

优化后的 main 函数本质上是未优化版本的第 17 行和 18 行,伴有变量值内联。opt 计算加法,因为所有的变量都是常数。很酷吧,对不对?

后端

LLVM 的后端工具是 llc。它分三个阶段将 LLVM IR 作为输入生成机器代码。

  • 指令选择是将 IR 指令映射到目标机器的指令集。这个步骤使用虚拟寄存器的无限名字空间。
  • 寄存器分配是将虚拟寄存器映射到目标体系结构的实际寄存器。我的 CPU 是 x86 结构,它只有 16 个寄存器。然而,编译器将会尽可能少的使用寄存器。
  • 指令安排是重排操作,从而反映出目标机器的性能约束。

运行下面这个命令将会产生一些机器代码:

llc -o compiled-assembly.s optimized.ll
_main:
    pushq   %rbp
    movq    %rsp, %rbp
    leaq    L_str(%rip), %rdi
    callq   _puts
    xorl    %eax, %eax
    popq    %rbp
    retq
L_str:
    .asciz  "Hello, Compiler!"

这个程序是 x86 汇编语言,它是计算机所说的语言,并具有人类可读语法。某些人最后也许能理解我。


相关资源:

  1. 设计一个编译器
  2. 开始探索 LLVM 核心库

(题图:deviantart.net)


via: https://nicoleorchard.com/blog/compilers

作者:Nicole Orchard 译者:ucasFL 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

写 Go 的人往往对它的错误处理模式有一定的看法。按不同的语言经验,人们可能有不同的习惯处理方法。这就是为什么我决定要写这篇文章,尽管有点固执己见,但我认为听取我的经验是有用的。我想要讲的主要问题是,很难去强制执行良好的错误处理实践,错误经常没有堆栈追踪,并且错误处理本身太冗长。不过,我已经看到了一些潜在的解决方案,或许能帮助解决一些问题。

与其他语言的快速比较

在 Go 中,所有的错误都是值。因为这点,相当多的函数最后会返回一个 error, 看起来像这样:

func (s *SomeStruct) Function() (string, error)

因此这导致调用代码通常会使用 if 语句来检查它们:

bytes, err := someStruct.Function()
if err != nil {
  // Process error
}

另外一种方法,是在其他语言中,如 Java、C#、Javascript、Objective C、Python 等使用的 try-catch 模式。如下你可以看到与先前的 Go 示例类似的 Java 代码,声明 throws 而不是返回 error:

public String function() throws Exception

它使用的是 try-catch 而不是 if err != nil:

try {
  String result = someObject.function()
  // continue logic
}
catch (Exception e) {
  // process exception
}

当然,还有其他的不同。例如,error 不会使你的程序崩溃,然而 Exception 会。还有其他的一些,在本篇中会专门提到这些。

实现集中式错误处理

退一步,让我们看看为什么要在一个集中的地方处理错误,以及如何做到。

大多数人或许会熟悉的一个例子是 web 服务 - 如果出现了一些未预料的的服务端错误,我们会生成一个 5xx 错误。在 Go 中,你或许会这么实现:

func init() {
    http.HandleFunc("/users", viewUsers)
    http.HandleFunc("/companies", viewCompanies)
}

func viewUsers(w http.ResponseWriter, r *http.Request) {
    user // some code
    if err := userTemplate.Execute(w, user); err != nil {
        http.Error(w, err.Error(), 500)
    }
}

func viewCompanies(w http.ResponseWriter, r *http.Request) {
    companies = // some code
    if err := companiesTemplate.Execute(w, companies); err != nil {
        http.Error(w, err.Error(), 500)
    }
}

这并不是一个好的解决方案,因为我们不得不重复地在所有的处理函数中处理错误。为了能更好地维护,最好能在一处地方处理错误。幸运的是,在 Go 语言的官方博客中,Andrew Gerrand 提供了一个替代方法,可以完美地实现。我们可以创建一个处理错误的 Type:

type appHandler func(http.ResponseWriter, *http.Request) error

func (fn appHandler) ServeHTTP(w http.ResponseWriter, r *http.Request) {
    if err := fn(w, r); err != nil {
        http.Error(w, err.Error(), 500)
    }
}

这可以作为一个封装器来修饰我们的处理函数:

func init() {
    http.Handle("/users", appHandler(viewUsers))
    http.Handle("/companies", appHandler(viewCompanies))
}

接着我们需要做的是修改处理函数的签名来使它们返回 errors。这个方法很好,因为我们做到了 DRY 原则,并且没有重复使用不必要的代码 - 现在我们可以在单独一个地方返回默认错误了。

错误上下文

在先前的例子中,我们可能会收到许多潜在的错误,它们中的任何一个都可能在调用堆栈的许多环节中生成。这时候事情就变得棘手了。

为了演示这点,我们可以扩展我们的处理函数。它可能看上去像这样,因为模板执行并不是唯一一处会发生错误的地方:

func viewUsers(w http.ResponseWriter, r *http.Request) error {
    user, err := findUser(r.formValue("id")) 
    if err != nil {
      return err;
    }
    return userTemplate.Execute(w, user);
}

调用链可能会相当深,在整个过程中,各种错误可能在不同的地方实例化。Russ Cox的这篇文章解释了如何避免遇到太多这类问题的最佳实践:

“在 Go 中错误报告的部分约定是函数包含相关的上下文,包括正在尝试的操作(比如函数名和它的参数)。”

这个给出的例子是对 OS 包的一个调用:

err := os.Remove("/tmp/nonexist")
fmt.Println(err)

它会输出:

remove /tmp/nonexist: no such file or directory

总结一下,执行后,输出的是被调用的函数、给定的参数、特定的出错信息。当在其他语言中创建一个 Exception 消息时,你也可以遵循这个实践。如果我们在 viewUsers 处理中坚持这点,那么几乎总是能明确错误的原因。

问题来自于那些不遵循这个最佳实践的人,并且你经常会在第三方的 Go 库中看到这些消息:

Oh no I broke

这没什么帮助 - 你无法了解上下文,这使得调试很困难。更糟糕的是,当这些错误被忽略或返回时,这些错误会被备份到堆栈中,直到它们被处理为止:

if err != nil {
  return err
}

这意味着错误何时发生并没有被传递出来。

应该注意的是,所有这些错误都可以在 Exception 驱动的模型中发生 - 糟糕的错误信息、隐藏异常等。那么为什么我认为该模型更有用?

即便我们在处理一个糟糕的异常消息,我们仍然能够了解它发生在调用堆栈中什么地方。因为堆栈跟踪,这引发了一些我对 Go 不了解的部分 - 你知道 Go 的 panic 包含了堆栈追踪,但是 error 没有。我推测可能是 panic 会使你的程序崩溃,因此需要一个堆栈追踪,而处理错误并不会,因为它会假定你在它发生的地方做一些事。

所以让我们回到之前的例子 - 一个有糟糕错误信息的第三方库,它只是输出了调用链。你认为调试会更容易吗?

panic: Oh no I broke
[signal 0xb code=0x1 addr=0x0 pc=0xfc90f]

goroutine 1103 [running]:
panic(0x4bed00, 0xc82000c0b0)
/usr/local/go/src/runtime/panic.go:481 +0x3e6
github.com/Org/app/core.(_app).captureRequest(0xc820163340, 0x0, 0x55bd50, 0x0, 0x0)
/home/ubuntu/.go_workspace/src/github.com/Org/App/core/main.go:313 +0x12cf
github.com/Org/app/core.(_app).processRequest(0xc820163340, 0xc82064e1c0, 0xc82002aab8, 0x1)
/home/ubuntu/.go_workspace/src/github.com/Org/App/core/main.go:203 +0xb6
github.com/Org/app/core.NewProxy.func2(0xc82064e1c0, 0xc820bb2000, 0xc820bb2000, 0x1)
/home/ubuntu/.go_workspace/src/github.com/Org/App/core/proxy.go:51 +0x2a
github.com/Org/app/core/vendor/github.com/rusenask/goproxy.FuncReqHandler.Handle(0xc820da36e0, 0xc82064e1c0, 0xc820bb2000, 0xc5001, 0xc820b4a0a0)
/home/ubuntu/.go_workspace/src/github.com/Org/app/core/vendor/github.com/rusenask/goproxy/actions.go:19 +0x30

我认为这可能是 Go 的设计中被忽略的东西 - 不是所有语言都不会忽视的。

如果我们使用 Java 作为一个随意的例子,其中人们犯的一个最愚蠢的错误是不记录堆栈追踪:

LOGGER.error(ex.getMessage()) // 不记录堆栈追踪
LOGGER.error(ex.getMessage(), ex) // 记录堆栈追踪

但是 Go 似乎在设计中就没有这个信息。

在获取上下文信息方面 - Russ 还提到了社区正在讨论一些潜在的接口用于剥离上下文错误。关于这点,了解更多或许会很有趣。

堆栈追踪问题解决方案

幸运的是,在做了一些查找后,我发现了这个出色的 Go 错误库来帮助解决这个问题,来给错误添加堆栈跟踪:

if errors.Is(err, crashy.Crashed) {
  fmt.Println(err.(*errors.Error).ErrorStack())
}

不过,我认为这个功能如果能成为语言的 第一类公民 first class citizenship 将是一个改进,这样你就不必做一些类型修改了。此外,如果我们像先前的例子那样使用第三方库,它可能没有使用 crashy - 我们仍有相同的问题。

我们对错误应该做什么?

我们还必须考虑发生错误时应该发生什么。这一定有用,它们不会让你的程序崩溃,通常也会立即处理它们:

err := method()
if err != nil {
  // some logic that I must do now in the event of an error!
}

如果我们想要调用大量方法,它们会产生错误,然后在一个地方处理所有错误,这时会发生什么?看上去像这样:

err := doSomething()
if err != nil {
  // handle the error here
}

func doSomething() error {
  err := someMethod()
  if err != nil {
    return err
  }
  err = someOther()
  if err != nil {
    return err
  }
  someOtherMethod()
}

这感觉有点冗余,在其他语言中你可以将多条语句作为一个整体处理。

try {
  someMethod()
  someOther()
  someOtherMethod()
}
catch (Exception e) {
  // process exception
}

或者只要在方法签名中传递错误:

public void doSomething() throws SomeErrorToPropogate {
  someMethod()
  someOther()
  someOtherMethod()
}

我个人认为这两个例子实现了一件事情,只是 Exception 模式更少冗余,更加弹性。如果有什么的话,我觉得 if err!= nil 感觉像样板。也许有一种方法可以清理?

将失败的多条语句做为一个整体处理错误

首先,我做了更多的阅读,并在 Rob Pike 写的 Go 博客中发现了一个比较务实的解决方案。

他定义了一个封装了错误的方法的结构体:

type errWriter struct {
    w   io.Writer
    err error
}

func (ew *errWriter) write(buf []byte) {
    if ew.err != nil {
        return
    }
    _, ew.err = ew.w.Write(buf)
}

让我们这么做:

ew := &errWriter{w: fd}
ew.write(p0[a:b])
ew.write(p1[c:d])
ew.write(p2[e:f])
// and so on
if ew.err != nil {
    return ew.err
}

这也是一个很好的方案,但是我感觉缺少了点什么 - 因为我们不能重复使用这个模式。如果我们想要一个含有字符串参数的方法,我们就不得不改变函数签名。或者如果我们不想执行写操作会怎样?我们可以尝试使它更通用:

type errWrapper struct {
    err error
}
func (ew *errWrapper) do(f func() error) {
    if ew.err != nil {
        return
    }
    ew.err = f();
}

但是我们有一个相同的问题,如果我们想要调用含有不同参数的函数,它就无法编译了。然而你可以简单地封装这些函数调用:

w := &errWrapper{}

w.do(func() error {
    return someFunction(1, 2);
})

w.do(func() error {
    return otherFunction("foo");
})

err := w.err

if err != nil {
// process error here
}

这可以用,但是并没有太大帮助,因为它最终比标准的 if err != nil 检查带来了更多的冗余。如果有人能提供其他解决方案,我会很有兴趣听。或许这个语言本身需要一些方法来以不那么臃肿的方式传递或者组合错误 - 但是感觉似乎是特意设计成不那么做。

总结

看完这些之后,你可能会认为我在对 error 挑刺儿,由此推论我反对 Go。事实并非如此,我只是将它与我使用 try catch 模型的经验进行比较。它是一个用于系统编程很好的语言,并且已经出现了一些优秀的工具。仅举几例,有 Kubernetes、Docker、Terraform、Hoverfly 等。还有小型、高性能、本地二进制的优点。但是,error 难以适应。 我希望我的推论是有道理的,而且一些方案和解决方法可能会有帮助。


作者简介:

Andrew 是 OpenCredo 的顾问,于 2015 年加入公司。Andrew 在多个行业工作多年,开发基于 Web 的企业应用程序。


via: https://opencredo.com/why-i-dont-like-error-handling-in-go

作者:Andrew Morgan 译者:geekpi 校对:jasminepeng

本文由 LCTT 原创编译,Linux中国 荣誉推出

无服务 serverless 是 托管服务 managed service 发展方向的又一步,并且与 Ansible 的无代理体系结构相得益彰。

Ansible 被设计为实际工作中的最简化的部署工具。这意味着它不是一个完整的编程语言。你需要编写定义任务的 YAML 模板,并列出任何需要自动完成的任务。

大多数人认为 Ansible 是一种更强大的“处于 for 循环中的 SSH”,在简单的使用场景下这是真的。但其实 Ansible 是任务,而非 SSH。在很多情况下,我们通过 SSH 进行连接,但它也支持 Windows 机器上的 Windows 远程管理(WinRM),以及作为云服务的通用语言的 HTTPS API 之类的东西。

在云中,Ansible 可以在两个独立的层面上操作: 控制面 control plane 和 实例资源 on-instance resource 。控制面由所有没有运行在操作系统上的东西组成。包括设置网络、新建实例、供给更高级别的服务,如亚马逊的 S3 或 DynamoDB,以及保持云基础设施安全和服务客户​​所需的一切。

实例上的工作是你已经知道 Ansible 可以做的:启动和停止服务、配置文件 模版化 templating 、安装软件包以及通过 SSH 执行的所有与操作系统相关的操作。

现在,什么是 无服务 serverless 呢?这要看你问谁,无服务要么是对公有云的无限延伸,或者是一个全新的范例,其中所有的东西都是 API 调用,以前从来没有这样做过。

Ansible 采取第一种观点。在 “无服务” 是专门术语之前,用户不得不管理和配置 EC2 实例、虚拟私有云 (VPC) 网络以及其他所有内容。无服务是托管服务方向迈出的另一步,并且与 Ansible 的无代理体系结构相得益彰。

在我们开始 Lambda 示例之前,让我们来看一个简单的配置 CloudFormation 栈任务:

- name: Build network
  cloudformation:
    stack_name: prod-vpc
    state: present
    template: base_vpc.yml

编写这样的任务只需要几分钟,但它是构建基础架构所涉及的最后的半手动步骤 - 点击 “Create Stack” - 这将 playbook 与其他放在一起。现在你的 VPC 只是在建立新区域时可以调用的另一项任务了。

由于云提供商是你帐户中发生些什么的真相来源,因此 Ansible 有许多方法来取回并使用 ID、名称和其他参数来过滤和查询运行的实例或网络。以 cloudformation_facts 模块为例,我们可以从我们刚刚创建的模板中得到子网 ID、网络范围和其他数据。

- name: Pull all new resources back in as a variable
  cloudformation_facts:
    stack_name: prod-vpc
  register: network_stack

对于无服务应用,除了 DynamoDB 表,S3 bucket 和其他任何其他功能之外,你肯定还需要一个 Lambda 函数的补充。幸运的是,通过使用 lambda 模块, Lambda 函数可以以上次任务的堆栈相同的方式创建:

- lambda:
    name: sendReportMail
    zip_file: "{{ deployment_package }}"
    runtime: python3.6
    handler: report.send
    memory_size: 1024
    role: "{{ iam_exec_role }}"
  register: new_function

如果你有其他想用来交付无服务应用的工具,这也是可以的。开源的无服务框架有自己的 Ansible 模块,它也可以工作:

- serverless:
    service_path: '{{ project_dir }}'
    stage: dev
  register: sls
- name: Serverless uses CloudFormation under the hood, so you can easily pull info back into Ansible
  cloudformation_facts:
    stack_name: "{{ sls.service_name }}"
  register: sls_facts

这不是你需要的全部,因为无服务项目也必须存在,你将在那里大量的定义你的函数和事件源。对于此例,我们将制作一个响应 HTTP 请求的函数。无服务框架使用 YAML 作为其配置语言(和 Ansible 一样),所以这应该看起来很熟悉。

# serverless.yml
service: fakeservice

provider:
  name: aws
  runtime: python3.6

functions:
  main:
    handler: test_function.handler
    events:
      - http:
          path: /
          method: get

在 AnsibleFest 中,我将介绍这个例子和其他深入的部署策略,以最大限度地利用你已经拥有的 playbook 和基础设施,还有新的无服务实践。无论你是否能到,我希望这些例子可以让你开始使用 Ansible,无论你是否有任何服务要管理。

AnsibleFest 是一个单日会议,汇集了数百名 Ansible 用户、开发人员和行业合作伙伴。加入我们吧,这里有产品更新、鼓舞人心的交谈、技术深度潜水,动手演示和整天的网络。

(题图: opensource.com)


via: https://opensource.com/article/17/8/ansible-serverless-applications

作者:Ryan Scott Brown 译者:geekpi 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

像大多数新手一样,我一开始是在 StackOverflow 上搜索 Git 命令,然后把答案复制粘贴,并没有真正理解它们究竟做了什么。

Image credit: XKCD

我曾经想过:“如果有一个最常见的 Git 命令的列表,以及它们的功能是什么,这不是极好的吗?”

多年之后,我编制了这样一个列表,并且给出了一些最佳实践,让新手们甚至中高级开发人员都能从中发现有用的东西。

为了保持实用性,我将这个列表与我过去一周实际使用的 Git 命令进行了比较。

几乎每个开发人员都在使用 Git,当然很可能是 GitHub。但大多数开发者大概有 99% 的时间只是使用这三个命令:

git add --all
git commit -am "<message>"
git push origin master

如果你只是单枪匹马,或者参加一场黑客马拉松或开发一次性的应用时,它工作得很好,但是当稳定性和可维护性开始成为一个优先考虑的事情后,清理提交、坚持分支策略和提交信息的规范性就变得很重要。

我将从常用命令的列表开始,使新手更容易了解 Git 能做什么,然后进入更高级的功能和最佳实践。

经常使用的命令

要想在 仓库 ( repo ) 中初始化 Git,你只需输入以下命令即可。如果你没有初始化 Git,则不能在该仓库内运行任何其他的 Git 命令。

git init

如果你在使用 GitHub,而且正在将代码推送到在线存储的 GitHub 仓库中,那么你正在使用的就是 远程 ( remote ) 仓库。该远程仓库的默认名称(也称为别名)为 origin。如果你已经从 Github 复制了一个项目,它就有了一个 origin。你可以使用命令 git remote -v 查看该 origin,该命令将列出远程仓库的 URL。

如果你初始化了自己的 Git 仓库,并希望将其与 GitHub 仓库相关联,则必须在 GitHub 上创建一个,复制新仓库提供的 URL,并使用 git remote add origin <URL> 命令,这里使用 GitHub 提供的 URL 替换 <URL>。这样,你就可以添加、提交和推送更改到你的远程仓库了。

最后一条命令用在当你需要更改远程仓库时。如果你从其他人那里复制了一个仓库,并希望将远程仓库从原始所有者更改为你自己的 GitHub 帐户。除了改用 set-url 来更改远程仓库外,流程与 git remote add origin 相同。

git remote -v
git remote add origin <url>
git remote set-url origin <url>

复制仓库最常见的方式是使用 git clone,后跟仓库的 URL。

请记住,远程仓库将连接到克隆仓库原属于的帐户。所以,如果你克隆了一个属于别人的仓库,你将无法推送到 GitHub,除非你使用上面的命令改变了 origin。

git clone <url>

你很快就会发现自己正在使用分支。如果你还不理解什么是分支,有许多其他更深入的教程,你应该先阅读它们,再继续下面的操作。(这里是一个教程)

命令 git branch 列出了本地机器上的所有分支。如果要创建一个新的分支,可以使用命令 git branch <name>,其中 <name> 表示分支的名字,比如说 master。

git checkout <name> 命令可以切换到现有的分支。你也可以使用 git checkout -b 命令创建一个新的分支并立即切换到它。大多数人都使用此命令而不是单独的 branch 和 checkout 命令。

git branch
git branch <name>
git checkout <name>
git checkout -b <name>

如果你对一个分支进行了一系列的更改,假如说此分支名为 develop,如果想要将该分支合并回主分支(master)上,则使用 git merge <branch> 命令。你需要先检出(checkout)主分支,然后运行 git merge develop 将 develop 合并到主分支中。

git merge <branch>

如果你正在与多个人进行协作,你会发现有时 GitHub 的仓库上已经更新了,但你的本地却没有做相应的更改。如果是这样,你可以使用 git pull origin <branch> 命令从远程分支中拉取最新的更改。

git pull origin <branch>

如果您好奇地想看到哪些文件已被更改以及哪些内存正在被跟踪,可以使用 git status 命令。如果要查看每个文件的更改,可以使用 git diff 来查看每个文件中更改的行。

git status
git diff --stat

高级命令和最佳实践

很快你会到达一个阶段,这时你希望你的提交看起来整洁一致。你可能还需要调整你的提交记录,使得提交更容易理解或者能还原一个意外的有破坏性的更改。

git log 命令可以输出提交的历史记录。你将使用它来查看提交的历史记录。

你的提交会附带消息和一个哈希值,哈希值是一串包含数字和字母的随机序列。一个哈希值示例如下:c3d882aa1aa4e3d5f18b3890132670fbeac912f7。

git log

假设你推送了一些可能破坏了你应用程序的东西。你最好回退一个提交然后再提交一次正确的,而不是修复它和推送新的东西。

如果你希望及时回退并从之前的提交中检出(checkout)你的应用程序,则可以使用该哈希作为分支名直接执行此操作。这将使你的应用程序与当前版本分离(因为你正在编辑历史记录的版本,而不是当前版本)。

git checkout c3d88eaa1aa4e4d5f

然后,如果你在那个历史分支中做了更改,并且想要再次推送,你必须使用强制推送。

注意:强制推送是危险的,只有在绝对必要的时候才能执行它。它将覆盖你的应用程序的历史记录,你将失去之后版本的任何信息。

git push -f origin master

在其他时候,将所有内容保留在一个提交中是不现实的。也行你想在尝试有潜在风险的操作之前保存当前进度,或者也许你犯了一个错误,但希望在你的版本历史中避免尴尬地留着这个错误。对此,我们有 git rebase。

假设你在本地历史记录上有 4 个提交(没有推送到 GitHub),你要回退这是个提交。你的提交记录看起来很乱很拖拉。这时你可以使用 rebase 将所有这些提交合并到一个简单的提交中。

git rebase -i HEAD~4

上面的命令会打开你计算机的默认编辑器(默认为 Vim,除非你将默认修改为其他的),提供了几个你准备如何修改你的提交的选项。它看起来就像下面的代码:

pick 130deo9 oldest commit message
pick 4209fei second oldest commit message
pick 4390gne third oldest commit message
pick bmo0dne newest commit message

为了合并这些提交,我们需要将 pick 选项修改为 fixup(如代码下面的文档所示),以将该提交合并并丢弃该提交消息。请注意,在 Vim 中,你需要按下 a 或 i 才能编辑文本,要保存退出,你需要按下 Esc 键,然后按 shift + z + z。不要问我为什么,它就是这样。

pick 130deo9 oldest commit message
fixup 4209fei second oldest commit message
fixup 4390gne third oldest commit message
fixup bmo0dne newest commit message

这将把你的所有提交合并到一个提交中,提交消息为 oldest commit message。

下一步是重命名你的提交消息。这完全是一个建议的操作,但只要你一直遵循一致的模式,都可以做得很好。这里我建议使用 Google 为 Angular.js 提供的提交指南。

为了更改提交消息,请使用 amend 标志。

git commit --amend

这也会打开 Vim,文本编辑和保存规则如上所示。为了给出一个良好的提交消息的例子,下面是遵循该指南中规则的提交消息:

feat: add stripe checkout button to payments page

- add stripe checkout button
- write tests for checkout

保持指南中列出的 类型 ( type ) 的一个优点是它使编写更改日志更加容易。你还可以在 页脚 ( footer ) (再次,在指南中规定的)中包含信息来引用 问题 ( issue ) 。

注意:如果你正在协作一个项目,并将代码推送到了 GitHub,你应该避免重新引用(rebase)并压缩(squash)你的提交。如果你开始在人们的眼皮子底下更改版本历史,那么你可能会遇到难以追踪的错误,从而给每个人都带来麻烦。

Git 有无数的命令,但这里介绍的命令可能是您最初几年编程所需要知道的所有。


Sam Corcos 是 Sightline Maps 的首席开发工程师和联合创始人,Sightline Maps 是最直观的 3D 打印地形图的平台,以及用于构建 Phoenix 和 React 的可扩展生产应用程序的中级高级教程网站 LearnPhoenix.io。使用优惠码:freecodecamp 取得 LearnPhoenix 的20美元。

(题图:GitHub Octodex)


via: https://medium.freecodecamp.org/git-cheat-sheet-and-best-practices-c6ce5321f52

作者:Sam Corcos 译者:firmianay 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出