分类 技术 下的文章

在内存地址上设置断点虽然不错,但它并没有提供最方便用户的工具。我们希望能够在源代码行和函数入口地址上设置断点,以便我们可以在与代码相同的抽象级别中进行调试。

这篇文章将会添加源码级断点到我们的调试器中。通过所有我们已经支持的功能,这要比起最初听起来容易得多。我们还将添加一个命令来获取符号的类型和地址,这对于定位代码或数据以及理解链接概念非常有用。

系列索引

随着后面文章的发布,这些链接会逐渐生效。

  1. 准备环境
  2. 断点
  3. 寄存器和内存
  4. Elves 和 dwarves
  5. 源码和信号
  6. 源码级逐步执行
  7. 源码级断点
  8. 调用栈
  9. 读取变量
  10. 之后步骤

断点

DWARF

Elves 和 dwarves 这篇文章,描述了 DWARF 调试信息是如何工作的,以及如何用它来将机器码映射到高层源码中。回想一下,DWARF 包含了函数的地址范围和一个允许你在抽象层之间转换代码位置的行表。我们将使用这些功能来实现我们的断点。

函数入口

如果你考虑重载、成员函数等等,那么在函数名上设置断点可能有点复杂,但是我们将遍历所有的编译单元,并搜索与我们正在寻找的名称匹配的函数。DWARF 信息如下所示:

< 0><0x0000000b>  DW_TAG_compile_unit
                    DW_AT_producer              clang version 3.9.1 (tags/RELEASE_391/final)
                    DW_AT_language              DW_LANG_C_plus_plus
                    DW_AT_name                  /super/secret/path/MiniDbg/examples/variable.cpp
                    DW_AT_stmt_list             0x00000000
                    DW_AT_comp_dir              /super/secret/path/MiniDbg/build
                    DW_AT_low_pc                0x00400670
                    DW_AT_high_pc               0x0040069c

LOCAL_SYMBOLS:
< 1><0x0000002e>    DW_TAG_subprogram
                      DW_AT_low_pc                0x00400670
                      DW_AT_high_pc               0x0040069c
                      DW_AT_name                  foo
                      ...
...
<14><0x000000b0>    DW_TAG_subprogram
                      DW_AT_low_pc                0x00400700
                      DW_AT_high_pc               0x004007a0
                      DW_AT_name                  bar
                      ...

我们想要匹配 DW_AT_name 并使用 DW_AT_low_pc(函数的起始地址)来设置我们的断点。

void debugger::set_breakpoint_at_function(const std::string& name) {
    for (const auto& cu : m_dwarf.compilation_units()) {
        for (const auto& die : cu.root()) {
            if (die.has(dwarf::DW_AT::name) && at_name(die) == name) {
                auto low_pc = at_low_pc(die);
                auto entry = get_line_entry_from_pc(low_pc);
                ++entry; //skip prologue
                set_breakpoint_at_address(entry->address);
            }
        }
    }
}

这代码看起来有点奇怪的唯一一点是 ++entry。 问题是函数的 DW_AT_low_pc 不指向该函数的用户代码的起始地址,它指向 prologue 的开始。编译器通常会输出一个函数的 prologue 和 epilogue,它们用于执行保存和恢复堆栈、操作堆栈指针等。这对我们来说不是很有用,所以我们将入口行加一来获取用户代码的第一行而不是 prologue。DWARF 行表实际上具有一些功能,用于将入口标记为函数 prologue 之后的第一行,但并不是所有编译器都输出它,因此我采用了原始的方法。

源码行

要在高层源码行上设置一个断点,我们要将这个行号转换成 DWARF 中的一个地址。我们将遍历编译单元,寻找一个名称与给定文件匹配的编译单元,然后查找与给定行对应的入口。

DWARF 看上去有点像这样:

.debug_line: line number info for a single cu
Source lines (from CU-DIE at .debug_info offset 0x0000000b):

NS new statement, BB new basic block, ET end of text sequence
PE prologue end, EB epilogue begin
IS=val ISA number, DI=val discriminator value
<pc>        [lno,col] NS BB ET PE EB IS= DI= uri: "filepath"
0x004004a7  [   1, 0] NS uri: "/super/secret/path/a.hpp"
0x004004ab  [   2, 0] NS
0x004004b2  [   3, 0] NS
0x004004b9  [   4, 0] NS
0x004004c1  [   5, 0] NS
0x004004c3  [   1, 0] NS uri: "/super/secret/path/b.hpp"
0x004004c7  [   2, 0] NS
0x004004ce  [   3, 0] NS
0x004004d5  [   4, 0] NS
0x004004dd  [   5, 0] NS
0x004004df  [   4, 0] NS uri: "/super/secret/path/ab.cpp"
0x004004e3  [   5, 0] NS
0x004004e8  [   6, 0] NS
0x004004ed  [   7, 0] NS
0x004004f4  [   7, 0] NS ET

所以如果我们想要在 ab.cpp 的第五行设置一个断点,我们将查找与行 (0x004004e3) 相关的入口并设置一个断点。

void debugger::set_breakpoint_at_source_line(const std::string& file, unsigned line) {
    for (const auto& cu : m_dwarf.compilation_units()) {
        if (is_suffix(file, at_name(cu.root()))) {
            const auto& lt = cu.get_line_table();

            for (const auto& entry : lt) {
                if (entry.is_stmt && entry.line == line) {
                    set_breakpoint_at_address(entry.address);
                    return;
                }
            }
        }
    }
}

我这里做了 is_suffix hack,这样你可以输入 c.cpp 代表 a/b/c.cpp 。当然你实际上应该使用大小写敏感路径处理库或者其它东西,但是我比较懒。entry.is_stmt 是检查行表入口是否被标记为一个语句的开头,这是由编译器根据它认为是断点的最佳目标的地址设置的。

符号查找

当我们在对象文件层时,符号是王者。函数用符号命名,全局变量用符号命名,你得到一个符号,我们得到一个符号,每个人都得到一个符号。 在给定的对象文件中,一些符号可能引用其他对象文件或共享库,链接器将从符号引用创建一个可执行程序。

可以在正确命名的符号表中查找符号,它存储在二进制文件的 ELF 部分中。幸运的是,libelfin 有一个不错的接口来做这件事,所以我们不需要自己处理所有的 ELF 的事情。为了让你知道我们在处理什么,下面是一个二进制文件的 .symtab 部分的转储,它由 readelf 生成:

Num:    Value          Size Type    Bind   Vis      Ndx Name
 0: 0000000000000000     0 NOTYPE  LOCAL  DEFAULT  UND
 1: 0000000000400238     0 SECTION LOCAL  DEFAULT    1
 2: 0000000000400254     0 SECTION LOCAL  DEFAULT    2
 3: 0000000000400278     0 SECTION LOCAL  DEFAULT    3
 4: 00000000004002c8     0 SECTION LOCAL  DEFAULT    4
 5: 0000000000400430     0 SECTION LOCAL  DEFAULT    5
 6: 00000000004004e4     0 SECTION LOCAL  DEFAULT    6
 7: 0000000000400508     0 SECTION LOCAL  DEFAULT    7
 8: 0000000000400528     0 SECTION LOCAL  DEFAULT    8
 9: 0000000000400558     0 SECTION LOCAL  DEFAULT    9
10: 0000000000400570     0 SECTION LOCAL  DEFAULT   10
11: 0000000000400714     0 SECTION LOCAL  DEFAULT   11
12: 0000000000400720     0 SECTION LOCAL  DEFAULT   12
13: 0000000000400724     0 SECTION LOCAL  DEFAULT   13
14: 0000000000400750     0 SECTION LOCAL  DEFAULT   14
15: 0000000000600e18     0 SECTION LOCAL  DEFAULT   15
16: 0000000000600e20     0 SECTION LOCAL  DEFAULT   16
17: 0000000000600e28     0 SECTION LOCAL  DEFAULT   17
18: 0000000000600e30     0 SECTION LOCAL  DEFAULT   18
19: 0000000000600ff0     0 SECTION LOCAL  DEFAULT   19
20: 0000000000601000     0 SECTION LOCAL  DEFAULT   20
21: 0000000000601018     0 SECTION LOCAL  DEFAULT   21
22: 0000000000601028     0 SECTION LOCAL  DEFAULT   22
23: 0000000000000000     0 SECTION LOCAL  DEFAULT   23
24: 0000000000000000     0 SECTION LOCAL  DEFAULT   24
25: 0000000000000000     0 SECTION LOCAL  DEFAULT   25
26: 0000000000000000     0 SECTION LOCAL  DEFAULT   26
27: 0000000000000000     0 SECTION LOCAL  DEFAULT   27
28: 0000000000000000     0 SECTION LOCAL  DEFAULT   28
29: 0000000000000000     0 SECTION LOCAL  DEFAULT   29
30: 0000000000000000     0 SECTION LOCAL  DEFAULT   30
31: 0000000000000000     0 FILE    LOCAL  DEFAULT  ABS init.c
32: 0000000000000000     0 FILE    LOCAL  DEFAULT  ABS crtstuff.c
33: 0000000000600e28     0 OBJECT  LOCAL  DEFAULT   17 __JCR_LIST__
34: 00000000004005a0     0 FUNC    LOCAL  DEFAULT   10 deregister_tm_clones
35: 00000000004005e0     0 FUNC    LOCAL  DEFAULT   10 register_tm_clones
36: 0000000000400620     0 FUNC    LOCAL  DEFAULT   10 __do_global_dtors_aux
37: 0000000000601028     1 OBJECT  LOCAL  DEFAULT   22 completed.6917
38: 0000000000600e20     0 OBJECT  LOCAL  DEFAULT   16 __do_global_dtors_aux_fin
39: 0000000000400640     0 FUNC    LOCAL  DEFAULT   10 frame_dummy
40: 0000000000600e18     0 OBJECT  LOCAL  DEFAULT   15 __frame_dummy_init_array_
41: 0000000000000000     0 FILE    LOCAL  DEFAULT  ABS /super/secret/path/MiniDbg/
42: 0000000000000000     0 FILE    LOCAL  DEFAULT  ABS crtstuff.c
43: 0000000000400818     0 OBJECT  LOCAL  DEFAULT   14 __FRAME_END__
44: 0000000000600e28     0 OBJECT  LOCAL  DEFAULT   17 __JCR_END__
45: 0000000000000000     0 FILE    LOCAL  DEFAULT  ABS
46: 0000000000400724     0 NOTYPE  LOCAL  DEFAULT   13 __GNU_EH_FRAME_HDR
47: 0000000000601000     0 OBJECT  LOCAL  DEFAULT   20 _GLOBAL_OFFSET_TABLE_
48: 0000000000601028     0 OBJECT  LOCAL  DEFAULT   21 __TMC_END__
49: 0000000000601020     0 OBJECT  LOCAL  DEFAULT   21 __dso_handle
50: 0000000000600e20     0 NOTYPE  LOCAL  DEFAULT   15 __init_array_end
51: 0000000000600e18     0 NOTYPE  LOCAL  DEFAULT   15 __init_array_start
52: 0000000000600e30     0 OBJECT  LOCAL  DEFAULT   18 _DYNAMIC
53: 0000000000601018     0 NOTYPE  WEAK   DEFAULT   21 data_start
54: 0000000000400710     2 FUNC    GLOBAL DEFAULT   10 __libc_csu_fini
55: 0000000000400570    43 FUNC    GLOBAL DEFAULT   10 _start
56: 0000000000000000     0 NOTYPE  WEAK   DEFAULT  UND __gmon_start__
57: 0000000000400714     0 FUNC    GLOBAL DEFAULT   11 _fini
58: 0000000000000000     0 FUNC    GLOBAL DEFAULT  UND __libc_start_main@@GLIBC_
59: 0000000000400720     4 OBJECT  GLOBAL DEFAULT   12 _IO_stdin_used
60: 0000000000601018     0 NOTYPE  GLOBAL DEFAULT   21 __data_start
61: 00000000004006a0   101 FUNC    GLOBAL DEFAULT   10 __libc_csu_init
62: 0000000000601028     0 NOTYPE  GLOBAL DEFAULT   22 __bss_start
63: 0000000000601030     0 NOTYPE  GLOBAL DEFAULT   22 _end
64: 0000000000601028     0 NOTYPE  GLOBAL DEFAULT   21 _edata
65: 0000000000400670    44 FUNC    GLOBAL DEFAULT   10 main
66: 0000000000400558     0 FUNC    GLOBAL DEFAULT    9 _init

你可以在对象文件中看到用于设置环境的很多符号,最后还可以看到 main 符号。

我们对符号的类型、名称和值(地址)感兴趣。我们有一个该类型的 symbol_type 枚举,并使用一个 std::string 作为名称,std::uintptr_t 作为地址:

enum class symbol_type {
    notype,            // No type (e.g., absolute symbol)
    object,            // Data object
    func,              // Function entry point
    section,           // Symbol is associated with a section
    file,              // Source file associated with the
};                     // object file

std::string to_string (symbol_type st) {
    switch (st) {
    case symbol_type::notype: return "notype";
    case symbol_type::object: return "object";
    case symbol_type::func: return "func";
    case symbol_type::section: return "section";
    case symbol_type::file: return "file";
    }
}

struct symbol {
    symbol_type type;
    std::string name;
    std::uintptr_t addr;
};

我们需要将从 libelfin 获得的符号类型映射到我们的枚举,因为我们不希望依赖关系破环这个接口。幸运的是,我为所有的东西选了同样的名字,所以这样很简单:

symbol_type to_symbol_type(elf::stt sym) {
    switch (sym) {
    case elf::stt::notype: return symbol_type::notype;
    case elf::stt::object: return symbol_type::object;
    case elf::stt::func: return symbol_type::func;
    case elf::stt::section: return symbol_type::section;
    case elf::stt::file: return symbol_type::file;
    default: return symbol_type::notype;
    }
};

最后我们要查找符号。为了说明的目的,我循环查找符号表的 ELF 部分,然后收集我在其中找到的任意符号到 std::vector 中。更智能的实现可以建立从名称到符号的映射,这样你只需要查看一次数据就行了。

std::vector<symbol> debugger::lookup_symbol(const std::string& name) {
    std::vector<symbol> syms;

    for (auto &sec : m_elf.sections()) {
        if (sec.get_hdr().type != elf::sht::symtab && sec.get_hdr().type != elf::sht::dynsym)
            continue;

        for (auto sym : sec.as_symtab()) {
            if (sym.get_name() == name) {
                auto &d = sym.get_data();
                syms.push_back(symbol{to_symbol_type(d.type()), sym.get_name(), d.value});
            }
        }
    }

    return syms;
}

添加命令

一如往常,我们需要添加一些更多的命令来向用户暴露功能。对于断点,我使用 GDB 风格的接口,其中断点类型是通过你传递的参数推断的,而不用要求显式切换:

  • 0x<hexadecimal> -> 断点地址
  • <line>:<filename> -> 断点行号
  • <anything else> -> 断点函数名
    else if(is_prefix(command, "break")) {
        if (args[1][0] == '0' && args[1][1] == 'x') {
            std::string addr {args[1], 2};
            set_breakpoint_at_address(std::stol(addr, 0, 16));
        }
        else if (args[1].find(':') != std::string::npos) {
            auto file_and_line = split(args[1], ':');
            set_breakpoint_at_source_line(file_and_line[0], std::stoi(file_and_line[1]));
        }
        else {
            set_breakpoint_at_function(args[1]);
        }
    }

对于符号,我们将查找符号并打印出我们发现的任何匹配项:

else if(is_prefix(command, "symbol")) {
    auto syms = lookup_symbol(args[1]);
    for (auto&& s : syms) {
        std::cout << s.name << ' ' << to_string(s.type) << " 0x" << std::hex << s.addr << std::endl;
    }
}

测试一下

在一个简单的二进制文件上启动调试器,并设置源代码级别的断点。在一些 foo 函数上设置一个断点,看到我的调试器停在它上面是我这个项目最有价值的时刻之一。

符号查找可以通过在程序中添加一些函数或全局变量并查找它们的名称来进行测试。请注意,如果你正在编译 C++ 代码,你还需要考虑名称重整。

本文就这些了。下一次我将展示如何向调试器添加堆栈展开支持。

你可以在这里找到这篇文章的代码。


via: https://blog.tartanllama.xyz/c++/2017/06/19/writing-a-linux-debugger-source-break/

作者:Simon Brand 译者:geekpi 校对:wxy
本文由 LCTT 原创编译,Linux中国 荣誉推出

本文旨在高屋建瓴地来讨论 Linux 文件系统概念,而不是对某种特定的文件系统,比如 EXT4 是如何工作的进行具体的描述。另外,本文也不是一个文件系统命令的教程。

每台通用计算机都需要将各种数据存储在硬盘驱动器(HDD)或其他类似设备上,比如 USB 存储器。这样做有两个原因。首先,当计算机关闭以后,内存(RAM)会失去存于它里面的内容。尽管存在非易失类型的 RAM,在计算机断电以后还能把数据存储下来(比如采用 USB 闪存和固态硬盘的闪存),但是,闪存和标准的、易失性的 RAM,比如 DDR3 以及其他相似类型的 RAM 相比,要贵很多。

数据需要存储在硬盘驱动上的另一个原因是,即使是标准的 RAM 也要比普通硬盘贵得多。尽管 RAM 和硬盘的价格都在迅速下降,但是 RAM 的价格依旧在以字节为单位来计算。让我们进行一个以字节为单位的快速计算:基于 16 GB 大的 RAM 的价格和 2 TB 大的硬盘驱动的价格。计算显示 RAM 的价格大约比硬盘驱动贵 71 倍。今天,一个典型的 RAM 的价格大约是 0.000000004373750 美元/每字节。

直观的展示一下在很久以前 RAM 的价格,在计算机发展的非常早的时期,其中一种类型的 RAM 是基于在 CRT 屏幕上的点。这种 RAM 非常昂贵,大约 1 美元/每字节。

定义

你可能听过其他人以各种不同和令人迷惑的方式谈论过文件系统。文件系统这个单词本身有多重含义,你需要从一个讨论或文件的上下文中理解它的正确含义。

我将根据我所观察到的在不同情况下使用“文件系统”这个词来定义它的不同含义。注意,尽管我试图遵循标准的“官方”含义,但是我打算基于它的不同用法来定义这个术语(如下)。这就是说我将在本文的后续章节中进行更详细的探讨。

  1. 始于顶层 root(/)目录的整个 Linux 目录结构。
  2. 特定类型的数据存储格式,比如 EXT3、EXT4、BTRFS 以及 XFS 等等。Linux 支持近百种类型的文件系统,包括一些非常老的以及一些最新的。每一种文件系统类型都使用它自己独特的元数据结构来定义数据是如何存储和访问的。
  3. 用特定类型的文件系统格式化后的分区或逻辑卷,可以挂载到 Linux 文件系统的指定挂载点上。

文件系统的基本功能

磁盘存储是文件系统必须的功能,它与之伴生的有一些有趣而且不可或缺的细节。很明显,文件系统是用来为非易失数据的存储提供空间,这是它的基本功能。然而,它还有许多从需求出发的重要功能。

所有文件系统都需要提供一个名字空间,这是一种命名和组织方法。它定义了文件应该如何命名、文件名的最大长度,以及所有可用字符集中可用于文件名中字符集子集。它也定义了一个磁盘上数据的逻辑结构,比如使用目录来组织文件而不是把所有文件聚集成一个单一的、巨大的文件混合体。

定义名字空间以后,元数据结构是为该名字空间提供逻辑基础所必须的。这包括所需数据结构要能够支持分层目录结构,同时能够通过结构来确定硬盘空间中的块是已用的或可用的,支持修改文件或目录的名字,提供关于文件大小、创建时间、最后访问或修改时间等信息,以及位置或数据所属的文件在磁盘空间中的位置。其他的元数据用来存储关于磁盘细分的高级信息,比如逻辑卷和分区。这种更高层次的元数据以及它所代表的结构包含描述文件系统存储在驱动器或分区中的信息,但与文件系统元数据无关,与之独立。

文件系统也需要一个应用程序接口(API),从而提供了对文件系统对象,比如文件和目录进行操作的系统功能调用的访问。API 也提供了诸如创建、移动和删除文件的功能。它也提供了算法来确定某些信息,比如文件存于文件系统中的位置。这样的算法可以用来解释诸如磁盘速度和最小化磁盘碎片等术语。

现代文件系统还提供一个安全模型,这是一个定义文件和目录的访问权限的方案。Linux 文件系统安全模型确保用户只能访问自己的文件,而不能访问其他用户的文件或操作系统本身。

最后一块组成部分是实现这些所有功能所需要的软件。Linux 使用两层软件实现的方式来提高系统和程序员的效率。

图片 1:Linux 两层文件系统软件实现。

这两层中的第一层是 Linux 虚拟文件系统。虚拟文件系统提供了内核和开发者访问所有类型文件系统的的单一命令集。虚拟文件系统软件通过调用特殊设备驱动来和不同类型的文件系统进行交互。特定文件系统的设备驱动是第二层实现。设备驱动程序将文件系统命令的标准集解释为在分区或逻辑卷上的特定类型文件系统命令。

目录结构

作为一个通常来说非常有条理的处女座,我喜欢将东西存储在更小的、有组织的小容器中,而不是存于同一个大容器中。目录的使用使我能够存储文件并在我想要查看这些文件的时候也能够找到它们。目录也被称为文件夹,之所以被称为文件夹,是因为其中的文件被类比存放于物理桌面上。

在 Linux 和其他许多操作系统中,目录可以被组织成树状的分层结构。在 Linux 文件系统层次标准中定义了 Linux 的目录结构(LCTT 译注:可参阅这篇)。当通过目录引用来访问目录时,更深层目录名字是通过正斜杠(/)来连接,从而形成一个序列,比如 /var/log 和 /var/spool/mail 。这些被称为路径。

下表提供了标准的、众所周知的、预定义的顶层 Linux 目录及其用途的简要清单。

目录描述
/ (root 文件系统)root 文件系统是文件系统的顶级目录。它必须包含在挂载其它文件系统前需要用来启动 Linux 系统的全部文件。它必须包含需要用来启动剩余文件系统的全部可执行文件和库。文件系统启动以后,所有其他文件系统作为 root 文件系统的子目录挂载到标准的、预定义好的挂载点上。
/bin/bin 目录包含用户的可执行文件。
/boot包含启动 Linux 系统所需要的静态引导程序和内核可执行文件以及配置文件。
/dev该目录包含每一个连接到系统的硬件设备的设备文件。这些文件不是设备驱动,而是代表计算机上的每一个计算机能够访问的设备。
/etc包含主机计算机的本地系统配置文件。
/home主目录存储用户文件,每一个用户都有一个位于 /home 目录中的子目录(作为其主目录)。
/lib包含启动系统所需要的共享库文件。
/media一个挂载外部可移动设备的地方,比如主机可能连接了一个 USB 驱动器。
/mnt一个普通文件系统的临时挂载点(如不可移动的介质),当管理员对一个文件系统进行修复或在其上工作时可以使用。
/opt可选文件,比如供应商提供的应用程序应该安装在这儿。
/root这不是 root(/)文件系统。它是 root 用户的主目录。
/sbin系统二进制文件。这些是用于系统管理的可执行文件。
/tmp临时目录。被操作系统和许多程序用来存储临时文件。用户也可能临时在这儿存储文件。注意,存储在这儿的文件可能在任何时候在没有通知的情况下被删除。
/usr该目录里面包含可共享的、只读的文件,包括可执行二进制文件和库、man 文件以及其他类型的文档。
/var可变数据文件存储在这儿。这些文件包括日志文件、MySQL 和其他数据库的文件、Web 服务器的数据文件、邮件以及更多。

表 1:Linux 文件系统层次结构的顶层

这些目录以及它们的子目录如表 1 所示,在所有子目录中,粗体的目录组成了 root 文件系统的必需部分。也就是说,它们不能创建为一个分离的文件系统并且在开机时进行挂载。这是因为它们(特别是它们包含的内容)必须在系统启动的时候出现,从而系统才能正确启动。

/media 目录和 /mnt 目录是 root 文件系统的一部分,但是它们从来不包含任何数据,因为它们只是一个临时挂载点。

表 1 中剩下的非粗体的目录不需要在系统启动过程中出现,但会在之后挂载到 root 文件系统上,在开机阶段,它们为主机进行准备,从而执行有用的工作。

请参考官方 Linux 文件系统层次标准(FHS)网页来了解这些每一个目录以及它们的子目录的更多细节。维基百科上也有关于 FHS 的一个很好的介绍。应该尽可能的遵循这些标准,从而确保操作和功能的一致性。无论在主机上使用什么类型的文件系统,该层次目录结构都是相同的。

Linux 统一目录结构

在一些非 Linux 操作系统的个人电脑上,如果有多个物理硬盘驱动器或多个分区,每一个硬盘或分区都会分配一个驱动器号。知道文件或程序位于哪一个硬盘驱动器上是很有必要的,比如 C: 或 D: 。然后,你可以在命令中使用驱动器号,以 D: 为例,为了进入 D: 驱动器,你可以使用 cd 命令来更改工作目录为正确的目录,从而定位需要的文件。每一个硬盘驱动器都有自己单独的、完整的目录树。

Linux 文件系统将所有物理硬盘驱动器和分区统一为一个目录结构。它们均从顶层 root 目录(/)开始。所有其它目录以及它们的子目录均位于单一的 Linux 根目录下。这意味着只有一棵目录树来搜索文件和程序。

因为只有一个文件系统,所以 /home、/tmp、/var、/opt 或 /usr 能够创建在和 root(/)文件系统不同的物理硬盘驱动器、分区或逻辑分区上,然后挂载到一个挂载点(目录)上,从而作为 root 文件系统树的一部分。甚至可移动驱动器,比如 USB 驱动器或一个外接的 USB 或 ESATA 硬盘驱动器均可以挂载到 root 文件系统上,成为目录树不可或缺的部分。

当从 Linux 发行版的一个版本升级到另一个版本或从一个发行版更改到另一个发行版的时候,就会很清楚地看到这样创建到不同分区的好处。通常情况下,除了任何像 Fedora 中的 dnf-upgrade 之类的升级工具,会明智地在升级过程中偶尔重新格式化包含操作系统的硬盘驱动来删除那些长期积累的垃圾。如果 /home 目录是 root 文件系统的一部分(位于同一个硬盘驱动器),那么它也会被格式化,然后需要通过之前的备份恢复。如果 /home 目录作为一个分离的文件系统,那么安装程序将会识别到,并跳过它的格式化。对于存储数据库、邮箱、网页和其它可变的用户以及系统数据的 /var 目录也是这样的。

将 Linux 系统目录树的某些部分作为一个分离的文件系统还有一些其他原因。比如,在很久以前,我还不知道将所有需要的 Linux 目录均作为 root(/)文件系统的一部分可能存在的问题,于是,一些非常大的文件填满了 /home 目录。因为 /home 目录和 /tmp 目录均不是分离的文件系统,而是 root 文件系统的简单子目录,整个 root 文件系统就被填满了。于是就不再有剩余空间可以让操作系统用来存储临时文件或扩展已存在数据文件。首先,应用程序开始抱怨没有空间来保存文件,然后,操作系统也开始异常行动。启动到单用户模式,并清除了 /home 目录中的多余文件之后,终于又能够重新工作了。然后,我使用非常标准的多重文件系统设置来重新安装 Linux 系统,从而避免了系统崩溃的再次发生。

我曾经遇到一个情况,Linux 主机还在运行,但是却不允许用户通过 GUI 桌面登录。我可以通过使用虚拟控制台之一,通过命令行界面(CLI)本地登录,然后远程使用 SSH 。问题的原因是因为 /tmp 文件系统满了,因此 GUI 桌面登录时所需要的一些临时文件不能被创建。因为命令行界面登录不需要在 /tmp 目录中创建文件,所以无可用空间并不会阻止我使用命令行界面来登录。在这种情况下,/tmp 目录是一个分离的文件系统,在 /tmp 所位于的逻辑卷上还有大量的可用空间。我简单地扩展了 /tmp 逻辑卷的容量到能够容纳主机所需要的临时文件,于是问题便解决了。注意,这个解决方法不需要重启,当 /tmp 文件系统扩大以后,用户就可以登录到桌面了。

当我在一家很大的科技公司当实验室管理员的时候,遇到过另外一个故障。开发者将一个应用程序安装到了一个错误的位置(/var)。结果该应用程序崩溃了,因为 /var 文件系统满了,由于缺乏空间,存储于 /var/log 中的日志文件无法附加新的日志消息。然而,系统仍然在运行,因为 root 文件系统和 /tmp 文件系统还没有被填满。删除了该应用程序并重新安装在 /opt 文件系统后,问题便解决了。

文件系统类型

Linux 系统支持大约 100 种分区类型的读取,但是只能对很少的一些进行创建和写操作。但是,可以挂载不同类型的文件系统在同一个 root 文件系统上,并且是很常见的。在这样的背景下,我们所说的文件系统一词是指在硬盘驱动器或逻辑卷上的一个分区中存储和管理用户数据所需要的结构和元数据。能够被 Linux 系统的 fdisk 命令识别的文件系统类型的完整列表在此,你可以感受一下 Linux 系统对许多类型的系统的高度兼容性。

Linux 支持读取这么多类型的分区系统的主要目的是为了提高兼容性,从而至少能够与一些其他计算机系统的文件系统进行交互。下面列出了在 Fedora 中创建一个新的文件系统时的所有可选类型:

  • btrfs
  • cramfs
  • ext2
  • ext3
  • ext4
  • fat
  • gfs2
  • hfsplus
  • minix
  • msdos
  • ntfs
  • reiserfs
  • vfat
  • xfs

其他发行版支持创建的文件系统类型不同。比如,CentOS 6 只支持创建上表中标为黑体的文件系统类型。

挂载

在 Linux 系统上“ 挂载 mount ”文件系统的术语是指在计算机发展的早期,磁带或可移动的磁盘组需要需要物理地挂载到一个合适的驱动器设备上。当通过物理的方式放置到驱动器上以后,操作系统会逻辑地挂载位于磁盘上的文件系统,从而操作系统、应用程序和用户才能够访问文件系统中的内容。

一个挂载点简单的来说就是一个目录,就像任何其它目录一样,是作为 root 文件系统的一部分创建的。所以,比如,home 文件系统是挂载在目录 /home 下。文件系统可以被挂载到其他非 root 文件系统的挂载点上,但是这并不常见。

在 Linux 系统启动阶段的最初阶段,root 文件系统就会被挂载到 root 目录下(/)。其它文件系统在之后通过 SystemV 下的 rc 或更新一些的 Linux 发行版中的 systemd 等 Linux 启动程序挂载。在启动进程中文件系统的挂载是由 /etc/fstab 配置文件管理的。一个简单的记忆方法是,fstab 代表“ 文件系统表 file system table ”,它包含了需要挂载的文件系统的列表,这些文件系统均指定了挂载点,以及针对特定文件系统可能需要的选项。

使用 mount 命令可以把文件系统挂载到一个已有的目录/挂载点上。通常情况下,任何作为挂载点的目录都应该是空的且不包含任何其他文件。Linux 系统不会阻止用户挂载一个已被挂载了文件系统的目录或将文件系统挂载到一个包含文件的目录上。如果你将文件系统挂载到一个已有的目录或文件系统上,那么其原始内容将会被隐藏,只有新挂载的文件系统的内容是可见的。

结论

我希望通过这篇文章,阐明了围绕文件系统这个术语的一些可能的模糊之处。我花费了很长的时间,以及在一个良师的帮助下才真正理解和欣赏到 Linux 文件系统的复杂性、优雅性和功能以及它的全部含义。

如果你有任何问题,请写到下面的评论中,我会尽力来回答它们。

下个月

Linux 的另一个重要概念是:万物皆为文件。这个概念对用户和系统管理员来说有一些有趣和重要的实际应用。当我说完这个理由之后,你可能会想阅读我的文章:万物皆为文件,这篇文章会在我下个月计划写的关于 /dev 目录的文章之前写完。(LCTT 译注,也可参阅这篇)

(题图 : wallup.net)


作者简介:

David Both 居住在美国北卡罗纳州的首府罗利,是一个 Linux 开源贡献者。他已经从事 IT 行业 40 余年,在 IBM 教授 OS/2 20 余年。1981 年,他在 IBM 开发了第一个关于最初的 IBM 个人电脑的培训课程。他也曾在 Red Hat 教授 RHCE 课程,也曾供职于 MCI worldcom,Cico 以及北卡罗纳州等。他已经为 Linux 开源社区工作近 20 年。


via: https://opensource.com/life/16/10/introduction-linux-filesystems

作者:David Both 译者:ucasFL 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

Swarm,听起来像是一个朋克摇滚乐队。但它确实是个新的编排机制,抑或者是,一个 Docker 现有编排体制的改进。简单来讲,如果你在用一个旧版本的 Docker,你必须手动配置 Swarm 来创建 Docker 集群。从 1.12 版开始,Docker 引擎集成了一个原生的实现(LCTT 译注:见下文)来支持无缝的集群设置。也就是为什么会有这篇文章。

在这篇教程中,我将带你体验一下编排后的 Docker 将能做的事情。这篇文章并不是包含所有细节(如 BnB 一般)或是让你对其全知全能,但它能带你踏上你的集群之路。在我的带领下开始吧。

Teaser

技术概要

如果把 Docker 详细而又好用的文档照搬到这里那将太丢人了,所以我将简要概括下这个技术的概要。我们已经有了 Docker,对吧。现在,你想要更多的服务器作为 Docker 主机,但同时你希望它们属于同一个逻辑上的实体。也就是说,你想建立一个集群。

我们先从一个主机组成的集群开始。当你在一个主机上初始化一个 Swarm 集群,这台主机将成为这个集群的 管理者 ( manager ) 。从技术角度来讲,它成为了 共识组 ( consensus group ) 中的一个 节点 node 。其背后的数学逻辑建立在 Raft 算法之上。 管理者 ( manager ) 负责调度任务。而具体的任务则会委任给各个加入了 Swarm 集群的 工作者 ( worker ) 节点。这些操作将由 Node API 所管理。虽说我讨厌 API 这个词汇,但我必须在这里用到它。

Service API 是这个实现中的第二个组件。它允许 管理者 ( manager ) 节点在所有的 Swarm 集群节点上创建一个分布式的服务。这个服务可以 被复制 ( replicated ) ,也就是说它们(LCTT 译注:指这些服务)会由平衡机制被分配到集群中(LCTT 译注:指 replicated 模式,多个容器实例将会自动调度任务到集群中的一些满足条件的节点),或者可以分配给全局(LCTT 译注:指 global 模式),也就是说每个节点都会运行一个容器实例。

此外还有更多的功课需要做,但这些信息已经足够你上路了。现在,我们开始整些实际的。我们的目标平台是 CentOS 7.2,有趣的是在我写这篇教程的时候,它的软件仓库中只有 1.10 版的 Docker,也就是说我必须手动更新以使用 Swarm。我们将在另一篇教程中讨论这个问题。接下来我们还有一个跟进的指南,其中涵盖了如何将新的节点加入我们现有的集群(LCTT 译注:指刚刚建立的单节点集群),并且我们将使用 Fedora 进行一个非对称的配置。至此,请确保正确的配置已经就位,并有一个工作的集群启动并正在运行(LCTT 译注:指第一个节点的 Docker 已经安装并已进入 Swarm 模式,但到这里笔者并没有介绍如何初始化 Swarm 集群,不过别担心下章会讲)。

配置镜像和服务

我将尝试配置一个负载均衡的 Apache 服务,并使用多个容器实例通过唯一的 IP 地址提供页面内容。挺标准的吧(LCTT 译注:指这个负载均衡的网页服务器)。这个例子同时也突出了你想要使用集群的大多数原因:可用性、冗余、横向扩展以及性能。当然,你同时需要考虑网络和储存这两块,但它们超出了这篇指南所涉及的范围了。

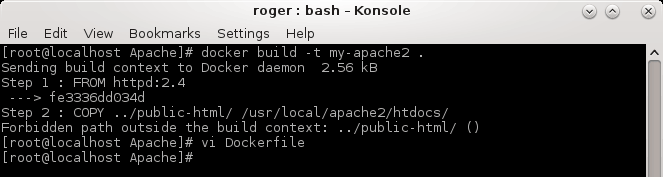
这个 Dockerfile 模板其实可以在官方镜像仓库里的 httpd 下找到。你只需一个最简单的设置来起步。至于如何下载或创建自己的镜像,请参考我的入门指南,链接可以在这篇教程的顶部可以找到。

docker build -t my-apache2 .
Sending build context to Docker daemon 2.048 kB
Step 1 : FROM httpd:2.4
Trying to pull repository docker.io/library/httpd ...
2.4: Pulling from docker.io/library/httpd

8ad8b3f87b37: Pull complete
c95e1f92326d: Pull complete
96e8046a7a4e: Pull complete
00a0d292c371: Pull complete
3f7586acab34: Pull complete
Digest: sha256:3ad4d7c4f1815bd1c16788a57f81b413...a915e50a0d3a4
Status: Downloaded newer image for docker.io/httpd:2.4
 ---> fe3336dd034d
Step 2 : COPY ../public-html/ /usr/local/apache2/htdocs/
...

Image created

在你继续下面的步骤之前,你应该确保你能无错误的启动一个容器实例并能链接到这个网页服务器上(LCTT 译注:使用下面的命令)。一旦你确保你能连上,我们就可以开始着手创建一个分布式的服务。

docker run -dit --name my-running-app my-apache2

将这个 IP 地址输入浏览器,看看会出现什么。

Swarm 初始化和配置

下一步就是启动 Swarm 集群了。你将需要这些最基础的命令来开始,它们与 Docker 博客中的例子非常相似:

docker service create --name frontend --replicas 5 -p 80:80/tcp my-apache2:latest

这里我们做了什么?我们创建了一个叫做 frontent 的服务,它有五个容器实例。同时我们还将主机的 80 端口和这些容器的 80 端口相绑定。我们将使用刚刚新创建的 Apache 镜像来做这个测试。然而,当你在自己的电脑上直接键入上面的指令时,你将看到下面的错误:

docker service create --name frontend --replicas 5 -p 80:80/tcp my-apache2:latest
Error response from daemon: This node is not a swarm manager. Use "docker swarm init" or "docker swarm join" to connect this node to swarm and try again.

这意味着你没有将你的主机(节点)配置成一个 Swarm 管理者 ( manager ) 。你可以在这台主机上初始化 Swarm 集群或是让它加入一个现有的集群。由于我们目前还没有一个现成的集群,我们将初始化它(LCTT 译注:指初始化 Swarm 集群并使当前节点成为 manager):

docker swarm init
Swarm initialized: current node (dm58mmsczqemiikazbfyfwqpd) is now a manager.

为了向这个 Swarm 集群添加一个 工作者 ( worker ) ,请执行下面的指令:

docker swarm join \
--token SWMTKN-1-4ofd46a2nfyvrqwu8w5oeetukrbylyznxla
9srf9vxkxysj4p8-eu5d68pu5f1ci66s7w4wjps1u \
10.0.2.15:2377

为了向这个 Swarm 集群添加一个 管理者 ( manager ) ,请执行 docker swarm join-token manager 并按照指示操作。

操作后的输出不用解释已经很清楚明了。我们成功的创建了一个 Swarm 集群。新的节点们将需要正确的 令牌 ( token ) 来加入这个 Swarm 集群。如果你需要配置防火墙,你还需找到它的 IP 地址和端口(LCTT 译注:指 Docker 的 Swarm 模式通讯所需的端口,默认 2377)。此外,你还可以向 Swarm 集群中添加管理者节点。现在,重新执行刚刚的服务创建指令:

docker service create --name frontend --replicas 5 -p 80:80/tcp my-apache2:latest
6lrx1vhxsar2i50is8arh4ud1

测试连通性

现在,我们来验证下我们的服务是否真的工作了。从某些方面讲,这很像我们在 Vagrant 和 coreOS 中做的事情那样。毕竟它们的原理几乎相同。相同指导思想的不同实现罢了(LCTT 译注:笔者观点,无法苟同)。首先需要确保 docker ps 能够给出正确的输出。你应该能看到所创建服务的多个容器副本。

docker ps
CONTAINER ID        IMAGE               COMMAND              CREATED             STATUS              PORTS              
NAMES
cda532f67d55        my-apache2:latest   "httpd-foreground"  
2 minutes ago       Up 2 minutes        80/tcp              frontend.1.2sobjfchdyucschtu2xw6ms9a
75fe6e0aa77b        my-apache2:latest   "httpd-foreground"  
2 minutes ago       Up 2 minutes        80/tcp              frontend.4.ag77qtdeby9fyvif5v6c4zcpc
3ce824d3151f        my-apache2:latest   "httpd-foreground"  
2 minutes ago       Up 2 minutes        80/tcp              frontend.2.b6fqg6sf4hkeqs86ps4zjyq65
eda01569181d        my-apache2:latest   "httpd-foreground"  
2 minutes ago       Up 2 minutes        80/tcp              frontend.5.0rmei3zeeh8usagg7fn3olsp4
497ef904e381        my-apache2:latest   "httpd-foreground"  
2 minutes ago       Up 2 minutes        80/tcp              frontend.3.7m83qsilli5dk8rncw3u10g5a

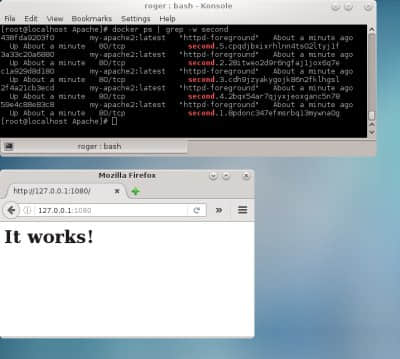
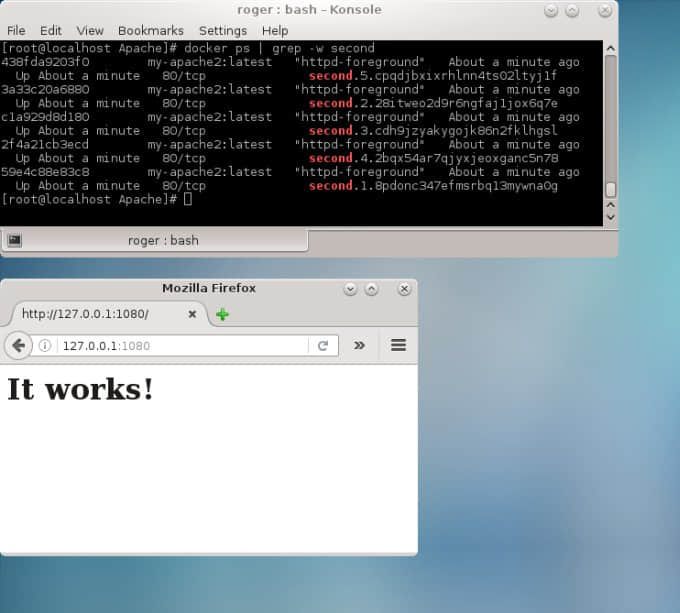
我也测试了不同的、非常规的端口,它们都能正常工作。对于你如何连接服务器和收取请求你将会有很多可配置的余地。你可以使用 localhost 或者 Docker 网络接口(笔者注:应该是指 Docker 的默认网桥 docker0,其网关为 172.17.0.1) 的 IP 地址的正确端口去访问。下面的例子使用了端口 1080:

Replicated Web service works

至此,这是一个非常粗略、简单的开始。真正的挑战是创建一个优化过的、可扩展的服务,但是它们需要一个准确的技术用例。此外,你还会用到 docker info 和 docker service(还有 inspect 和 ps)命令来详细了解你的集群是如何工作的。

可能会遇到的问题

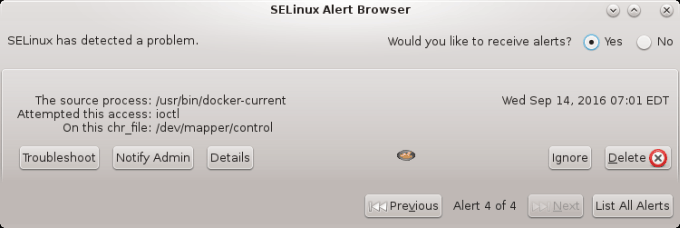
你可能会在把玩 Docker 和 Swarm 时遇到一些小的问题(也许没那么小)。比如 SELinux 也许会抱怨你正在执行一些非法的操作(LCTT 译注:指在强制访问控制策略中没有权限的操作)。然而,这些错误和警告应该不会对你造成太多阻碍。

SELinux alert

  • docker service 不是一条命令(docker service is not a docker command)

当你尝试执行必须的命令去创建一个 复制模式 ( replicated ) 的服务时,你可能会遇到一条错误说 docker: 'service' is not a docker command(LCTT 译注:见下面的例子)。这表示你的 Docker 版本不对(使用 -v 选项来检查)。我们将在将来的教程讨论如何修复这个问题。

docker service create --name frontend --replicas 5 -p 80:80/tcp my-apache2:latest
docker: 'service' is not a docker command.
  • docker tag 无法识别(docker tag not recognized)

你也许会看到下面的错误:

docker service create -name frontend -replicas 5 -p 80:80/tcp my-apache2:latest
Error response from daemon: rpc error: code = 3 desc = ContainerSpec: "-name" is not a valid repository/tag

关于这个错误已经有多个相关的讨论和帖子了。其实这个错误也许相当无辜。你也许是从浏览器粘贴的命令,在浏览器中的横线也许没被正确解析(笔者注:应该用 --name 而不是 -name)。就是这么简单的原因所导致的。

扩展阅读

关于这个话题还有很多可谈的,包含 1.12 版之前的 Swarm 集群实现(笔者注:旧的 Swarm 集群实现,下文亦作独立版本,需要 Consul 等应用提供服务发现),以及当前的 Docker 版本提供的(笔者注:新的 Swarm 集群实现,亦被称为 Docker 引擎的 Swarm 模式)。也就是说,请别偷懒花些时间阅读以下内容:

  • Docker Swarm 概述(独立版本的 Swarm 集群安装)
  • 构建一个生产环境的 Swarm 集群(独立版本安装)
  • 安装并创建一个 Docker Swarm 集群(独立版本安装)
  • Docker 引擎 Swarm 概述(对于 1.12 版)
  • Swarm 模式入门(对于 1.12 版)

总结

你总算看到这里了。到这里仍然无法保证你学到了什么,但我相信你还是会觉得这篇文章有些用的。它涵盖了一些基础的概念,以及一个 Swarm 集群模式是如何工作的以及它能做什么的概述,与此同时我们也成功的下载了并创建了我们的网页服务器的镜像,并且在之后基于它运行了多个集群式的容器实例。虽然我们目前只在单一节点做了以上实验,但是我们会在将来解释清楚(LCTT 译注:以便解释清楚多节点的 Swarm 集群操作)。并且我们解决了一些常见的问题。

我希望你能认为这篇指南足够有趣。结合着我过去所写的关于 Docker 的文章,这些文章应该能给你一个像样的解释,包括:怎么样操作镜像、网络栈、储存、以及现在的集群。就当热身吧。的确,请享受并期待在新的 Docker 教程中与你见面。我控几不住我记几啊。

祝你愉快。


via: http://www.dedoimedo.com/computers/docker-swarm-intro.html

作者:Dedoimedo 译者:Viz 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

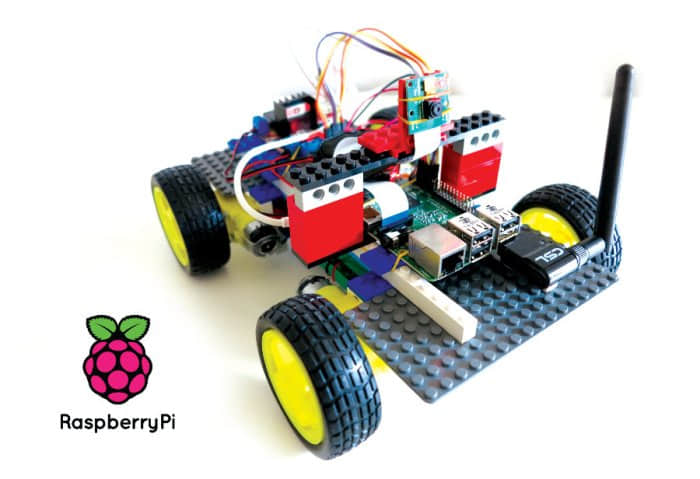
树莓派是一种微型的单板电脑(SBC),已经在学校的计算机科学教学中掀起了一场革命,但同样,它也给软件开发者带来了福音。目前,树莓派获得的知名度远远超出了它原本的目标市场,而且正在应用于机器人项目中。

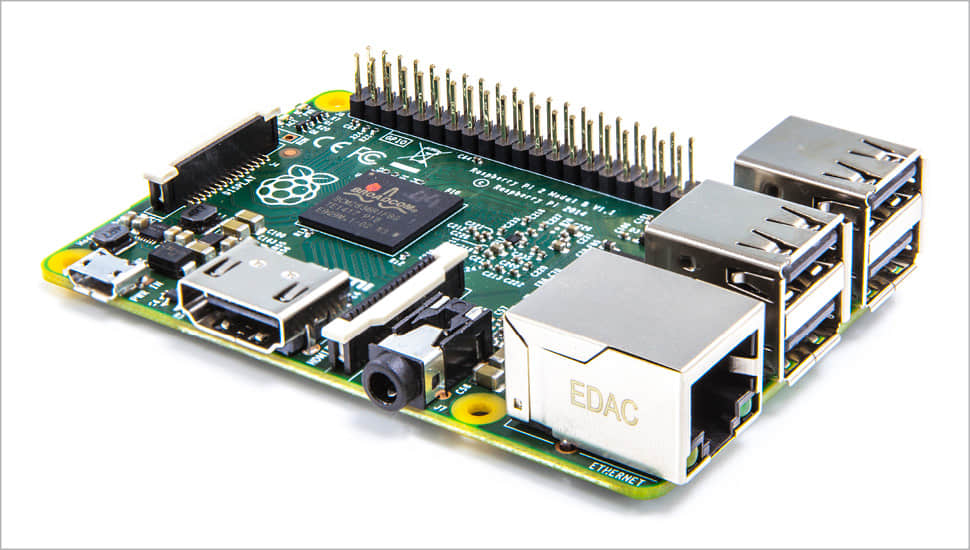
树莓派是一个可以运行 Linux 操作系统的微型开发板计算机,由英国树莓派基金会开发,用来在英国和发展中国家促进学校的基础计算机科学教育。树莓派拥有 USB 接口,能够支持多种即插即用外围设备,比如键盘、鼠标、打印机等。它包含了一个 HDMI(高清多媒体界面)端口,可以为用户提供视频输出。信用卡大小的尺寸使得树莓派非常便携且价格便宜。仅需一个 5V 的 micro-USB 电源供电,类似于给手机用的充电器一样。

多年来,树莓派基金会已经推出了几个不同版本的树莓派产品。 第一个版本是树莓派 1B 型,随后是一个相对简单便宜的 A 型。在 2014 年,基金会推出了一个增强版本 —— 树莓派 1B+。在 2015 年,基金会推出了全新设计的版本,售价为 5 美元,命名为树莓派 Zero。

在 2016 年 2 月,树莓派 3B 型发布,这也是现在可用的主要型号。在 2017 年,基金会发布了树莓派 Zero 的新型号树莓派 Zero W (W = wireless 无线)。

在不久的将来,一个提高了技术规格的型号将会到来,为嵌入式系统发烧友、研究员、爱好者和工程师们用其开发多种功能的实时应用提供一个稳健的平台。

图 1 :树莓派

树莓派是一个高效的编程设备

在给树莓派供电后,启动运行 LXDE 窗口管理器,用户会获得一个完整的基于 Debian 的 Linux 操作系统,即 Raspbian。Raspbian 操作系统为用户提供了众多自由开源的程序,涵盖了程序设计、游戏、应用以及教育方面。

树莓派的官方编程语言是 Python ,并已预装在了 Paspbian 操作系统上。结合树莓派和 Python 的集成开发环境 IDLE3 ,可以让程序员能够开发各种基于 Python 的程序。

除了 Python ,树莓派还支持多种其它语言。并且可以使用一些自由开源的 IDE (集成开发环境)。允许程序员、开发者和应用工程师在树莓派上开发程序和应用。

树莓派上的最佳 IDE

作为一名程序员和开发者,你需要的首先就是有一个 IDE ,这是一个集成了开发者和程序员编写、编译和测试软件所需的的基本工具的综合软件套件。IDE 包含了代码编辑器、编译或解释程序和调试器,并允许开发者通过一个图形用户界面(GUI)来访问。IDE 的主要目的之一是提供一个整合单元来统一功能设置,减少组合多个开发工具的必要配置。

IDE 的用户界面与文字处理程序相似,在工具栏提供颜色编码、源代码格式化、错误诊断、报告以及智能代码补全工具。IDE 被设计用来整合第三方版本控制库如 GitHub 或 Apache Subversion 。一些 IDE 专注于特定的编程语言,支持一个匹配该编程语言的功能集,当然也有一些是支持多种语言的。

树莓派上拥有丰富的 IDE ,为程序员提供友好界面来开发源代码、应用程序以及系统程序。

就让我们来探索最适合树莓派的 IDE 吧。

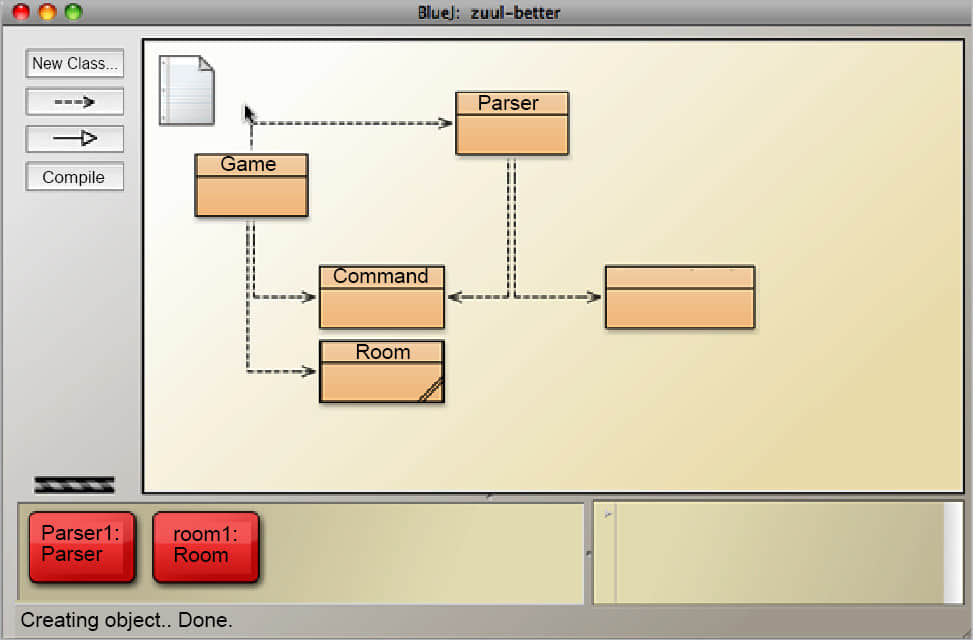
BlueJ

图 2 :BlueJ 的 GUI 界面

BlueJ 是一款致力于 Java 编程语言的 IDE ,主要是为教育目的而开发的。它也支持小型的软件开发项目。BlueJ 由澳大利亚的莫纳什大学的 Michael Kolling 和 John Rosenburg 在 2000 年作为 Blue 系统的继任者而开发的,后来在 2009 年 3 月成为自由开源软件。

BlueJ 提供一种学习面向对象的编程概念的高效的方式,图形用户界面为应用程序提供像 UML 图一样的类结构。每一个像类、对象和函数调用这样基于 OOPS 的概念,都可以通过基于交互的设计来表示。

特性:

  • 简单的交互界面: 与 NetBeans 或 Eclipse 这样的专业界面相比,BlueJ 的用户界面更加简易学。使开发者可以专注于编程而不是环境。
  • 便携: BlueJ 支持多种平台如 Windows、Linux 以及 Mac OS X , 可以免安装直接运行。
  • 新的创新: BlueJ IDE 在对象工作台、代码块和范围着色方面有着大量的创新,使新手体验到开发的乐趣。
  • 强大的技术支持: BlueJ 拥有一个核心功能团队来解答疑问,并且在 24 小时内为开发者的各种问题提供解决方案。

最新版本: 4.0.1

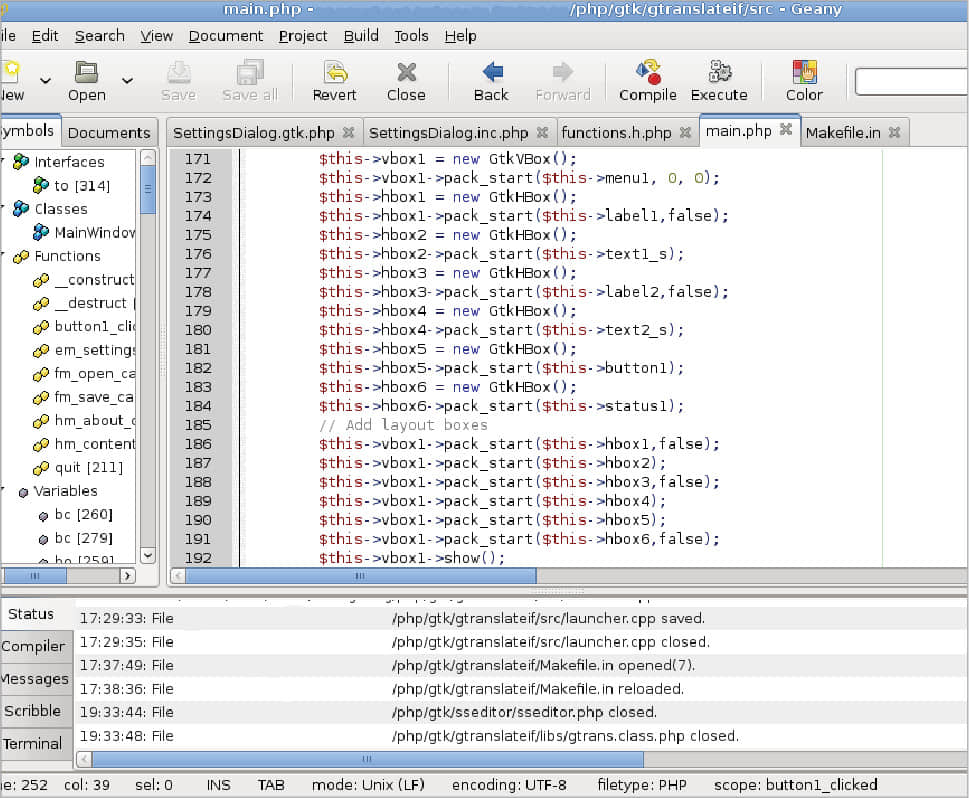
Geany IDE

图 3 : Geany IDE 的 GUI 界面

Geany IDE 使用了 Scintilla 和 GTK+ 的集成开发环境支持,被认为是一个非常轻量级的基于 GUI 的文本编辑器。 Geany 的独特之处在于它被设计为独立于特定的桌面环境,并且仅需要较少数量的依赖包。只需要 GTK2 运行库就可以运行。Geany IDE 支持多种编程语言如 C、C++、C#、Java、HTML、PHP、Python、Perl、Ruby、Erlang 和 LaTeX 。

特性:

  • 代码自动补全和简单的代码导航。
  • 高效的语法高亮和代码折叠。
  • 支持嵌入式终端仿真器,拥有高度可扩展性,可以免费下载大量功能丰富的插件。
  • 简单的项目管理并支持多种文件类型,包括 C、Java、PHP、HTML、Python、Perl 等。
  • 高度定制的界面,可以添加或删除设置、栏及窗口。

最新版本: 1.30.1

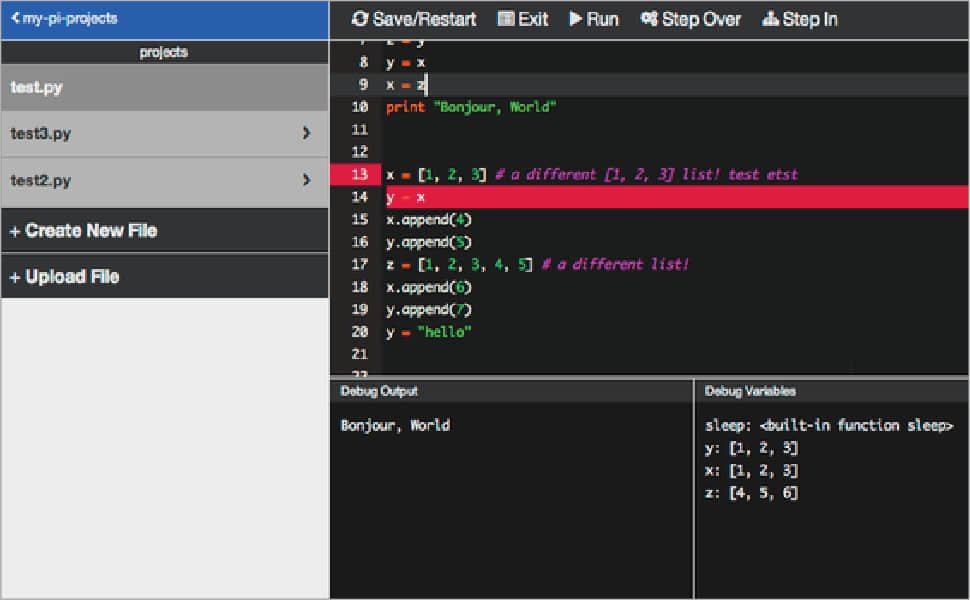
Adafruit WebIDE

图 4 :Adafruit WebIDE 的 GUI 界面

Adafruit WebIDE 为树莓派用户提供一个基于 Web 的界面来执行编程功能,并且允许开发者编译多种语言的源代码如 Python、Ruby、JavaScript 等。

Adafruit IDE 允许开发者把代码放在 GIT 仓库,这样就可以通过 GitHub 在任何地方进行访问。

特性:

  • 可以通过 Web 浏览器的 8080 端口或 80 端口进行访问。
  • 支持源代码的简单编译和运行。
  • 配备一个调试器和可视器来进行正确追踪,代码导航以及测试源代码。

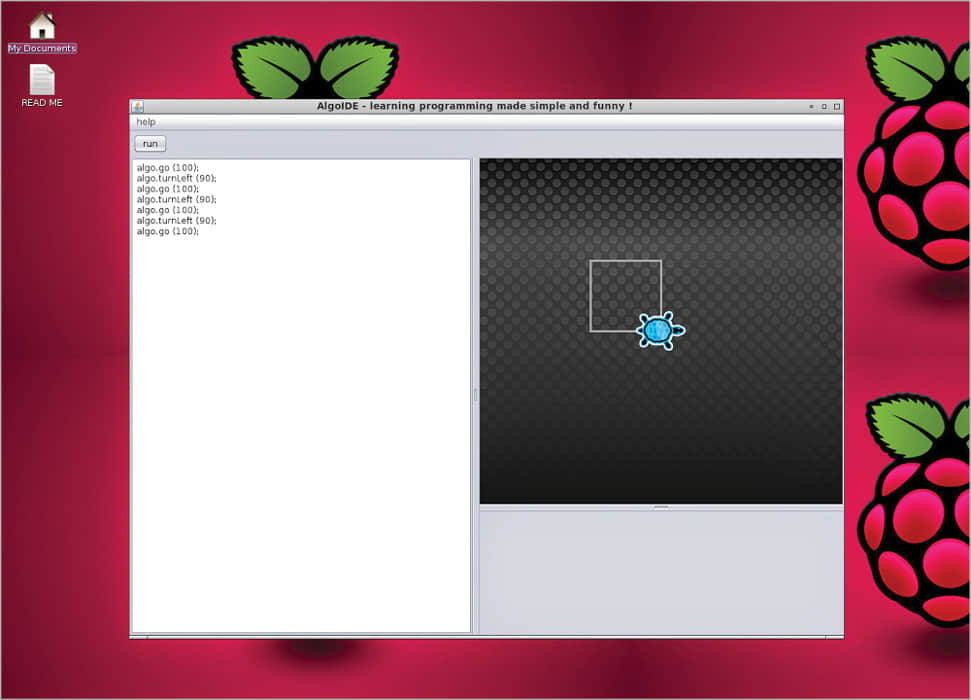
AlgoIDE

图 5 :AlgoIDE 的 GUI 界面

AlgoIDE 结合了一个脚本语言和一个 IDE 环境,它被设计用来将编程与下一步的示例一起来运行。AlgoIDE 包含了一个强大的调试器、 实时范围管理器并且一步一步的执行代码。针对全年龄人群而设计,用来设计程序以及对算法进行大量的研究。

AlgoIDE 支持多种类型的语言如 C、C++、Python、Java、Smalltalk、Objective C、ActionScript 等。

特性:

  • 代码自动缩进和补全。
  • 高效的语法高亮和错误管理。
  • 包含了一个调试器、范围管理器和动态帮助系统。
  • 支持 GUI 和传统的 Logo 程序语言 Turtle 来进行源代码开发。

最新版本: 2016-12-08 (上次更新时间)

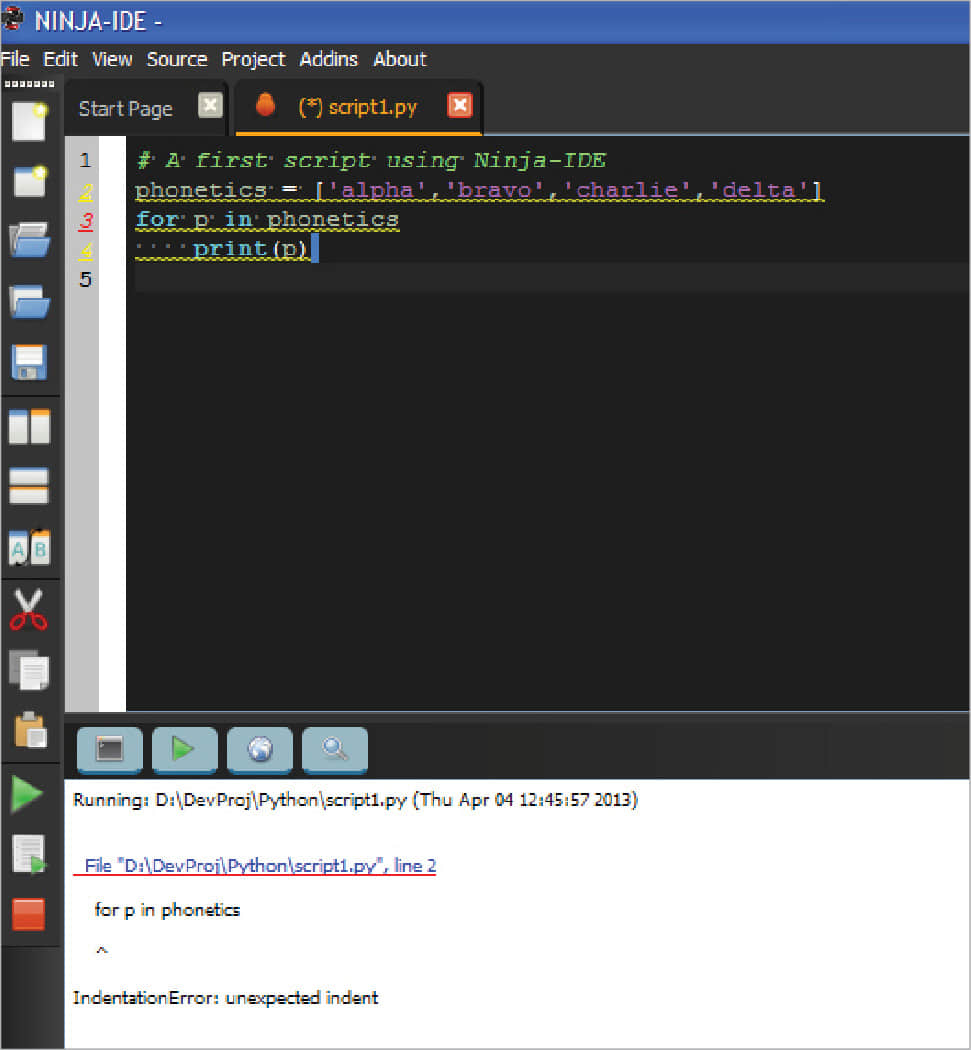
Ninja IDE

图 6 :Ninja IDE 的 GUI 界面

Ninja IDE (“Ninja-IDE Is Not Just Another IDE”的缩写),由 Diego Sarmentero 、Horacio Duranm Gabriel Acosta 、Pedro Mourelle 和 Jose Rostango 设计,使用纯 Python 编写并且支持多种平台运行如 Linux 、Mac OS X 和 Windows 。Ninja IDE 被认为是一个跨平台的 IDE 软件,尤其是用来设计基于 Python 的应用程序。

Ninja IDE 是非常轻量级的,并能执行多种功能如文件处理、代码定位、跳转行、标签、代码自动缩进和编辑器缩放。除了 Python ,这款 IDE 也支持几种其他语言。

特性:

  • 高效的代码编辑器: Ninja-IDE 被认为是最有效的代码编辑器,因为它能执行多种功能如代码补全和缩进,以及助手功能。
  • 错误和 PEP8 查找器: 高亮显示文件中的静态和 PEP8 错误。
  • 代码定位器: 使用此功能,快速直接访问能够访问的文件。用户可以使用快捷键 “CTRL+K” 进行输入,IDE 会找到特定的文本。
  • 独特的项目管理功能以及大量的插件使得具有 Ninja-IDE 高度可扩展性。

最新版本: 2.3

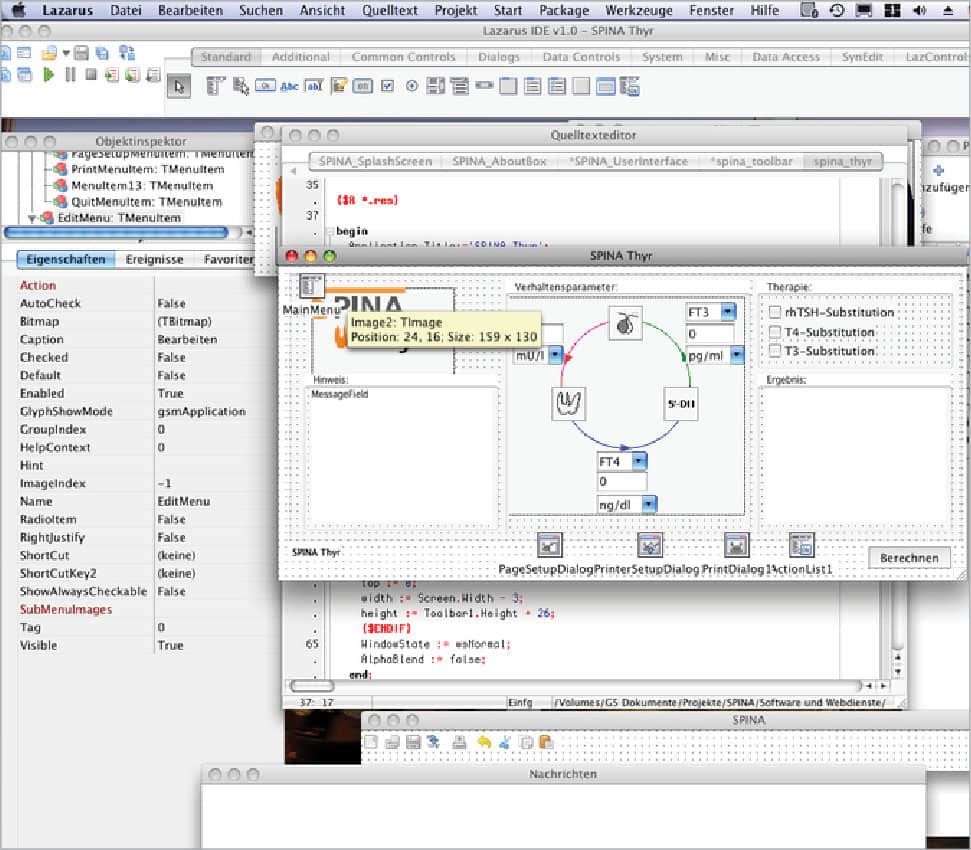
Lazarus IDE

图 7 :Lazarus IDE 的 GUI 界面

Lazarus IDE 是由 Cliff Baeseman、Shane Miller 和 Michael A. Hess 于 1999 年 2 月 开发。它被视为是一款用于应用程序快速开发的基于 GUI 的跨平台 IDE ,使用的是 Free Pascal 编译器。Lazarus IDE 继承了 Free Pascal 的三个主要特性 —— 编译速度、执行速度和交叉编译。可以在多种操作系统上对应用程序进行交叉编译,如 Windows 、Linux 、Mac OS X 等。

这款 IDE 由 Lazarus 组件库组成。这些组件库以一个单一和带有不同的特定平台实现的统一接口的形式为开发者提供了多种配套设施。它支持“一次编写,随处编译”的原则。

特性:

  • 强大而快速的处理各种类型的源代码,同时支持性能测试。
  • 易用的 GUI ,支持组件拖拽功能。可以通过 Lazarus 包文件为 IDE 添加附加组件。
  • 使用新功能加强的 Free Pascal ,可以用来开发 Android 应用。
  • 高可扩展性、开放源代码并支持多种框架来编译其他语言。

最新版本: 1.6.4

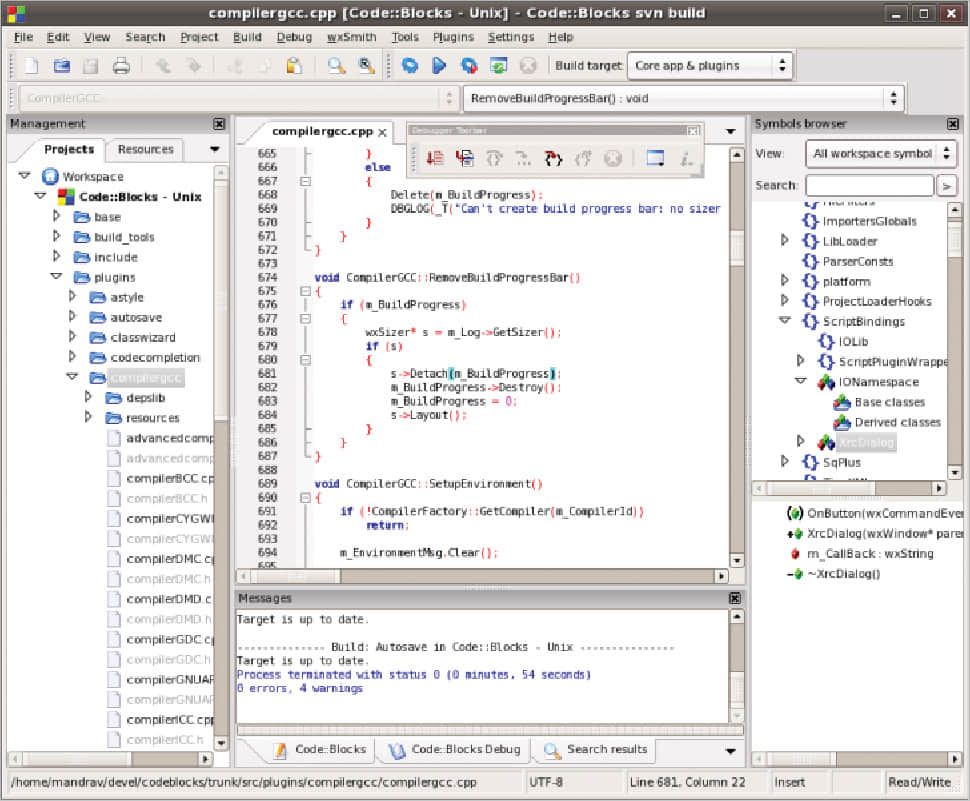
Codeblock IDE

图 8 : Codeblock IDE 界面

Codeblock IDE 是用 C++ 编写的,使用了 wxWidgets 作为 GUI 库,发布于 2005 年。它是一款自由开源、跨平台的 IDE ,支持多种类型的编译器如 GCC 、Clang 和 Visual C++ 。

Codeblock IDE 高度智能并且可以支持多种功能,如语法高亮、代码折叠、代码补全和缩进,同时也拥有一些扩展插件来进行定制。它可以在 Windows 、Mac OS X 和 Linux 操作系统上运行。

特性:

  • 支持多种类型的编译器如 GCC 、Visual C++ 、Borland C++ 、Watcom 、Intel C++ 等。主要针对 C++ 而设计,不过现在也支持其他的一些语言。
  • 智能的调试器,允许用户通过访问本地函数符号和参数显示,用户自定义监视、调用堆栈、自定义内存转储、线程切换以及 GNU 调试接口调试程序。
  • 支持多种功能用来从 Dev-C++ 、Visual C++ 等平台迁移代码。
  • 使用自定义系统和 XML 扩展文件来存储信息。

最新版本: 16.01

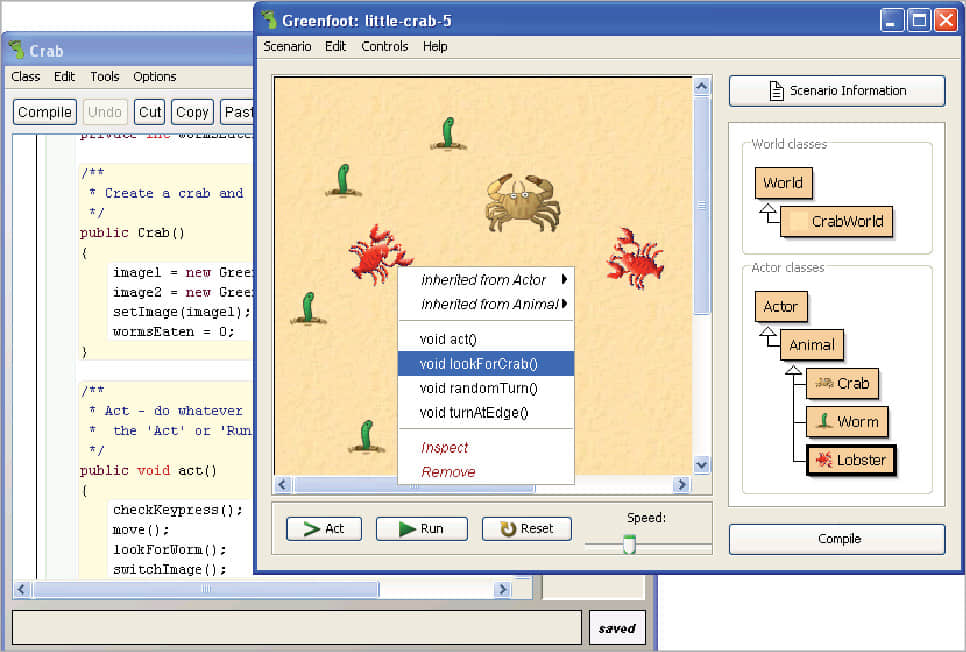
Greenfoot IDE

图 9 : Greenfoot IDE 界面

Greenfoot IDE 是由肯特大学的 Michael Kolling 设计。它是一款基于 Java 的跨平台 IDE ,针对中学和大学教育目的而设计。Greenfoot IDE 的功能有项目管理、代码自动补全、语法高亮并提供一个简易的 GUI 界面。

Greenfoot IDE 编程包括两个主类的子类 —— World 和 Actor 。 World 表示主要执行发生的类,Actors 是已经存在且活动于 World 中的对象。

特性:

  • 简单易用的 GUI ,比 BlueJ 和其他的 IDE 交互性更强。
  • 易于新手和初学者上手。
  • 在执行 Java 代码方面非常强大。
  • 支持 GNOME/KDE/X11 图形环境。
  • 其他功能包括项目管理、自动补全、语法高亮以及错误自动校正。

最新版本: 3.1.0


作者简介:

Anand Nayyar

作者是位于印度旁遮普邦的贾朗达尔学院计算机应用与 IT 系的教授助理。他热爱开源技术、嵌入式系统、云计算、无线传感器网络以及模拟器。可以在 anand\[email protected] 联系他。


via: http://opensourceforu.com/2017/06/top-ides-raspberry-pi/

作者:Anand Nayyar 译者:softpaopao 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

作为一名开发者,我会尝试留意那些我可能不会每天使用的技术的进步。了解这些技术至关重要,因为它们可能会间接影响到我的工作。比如由 Docker 推动的、近期正在兴起的容器化技术,可用于上规模地托管 Web 应用。从技术层面来讲,我并不是一个 DevOps,但当我每天构建 Web 应用时,多去留意这些技术如何去发展,会对我有所裨益。

这种进步的一个绝佳的例子,是近一段时间高速发展的容器编排平台。它允许你轻松地部署、管理容器化应用,并对它们的规模进行调整。目前看来,容器编排的流行工具有 Kubernetes (来自 Google),Docker Swarm 和 Apache Mesos。如果你想较好的了解上面那些技术以及它们的区别,我推荐你看一下这篇文章。

在这篇文章中,我们将会从一些简单的操作开始,了解一下 Kubernetes 平台,看看如何将一个 WordPress 网站部署在本地机器上的一个单节点集群中。

安装 Kubernetes

在 Kubernetes 文档中有一个很好的互动教程,涵盖了很多东西。但出于本文的目的,我只会介绍在 MacOS 中 Kuberentes 的安装和使用。

我们要做的第一件事是在你的本地主机中安装 Kubernetes。我们将使用一个叫做 MiniKube 的工具,它专门用于在你的机器上方便地设置一个用于测试的 Kubernetes 集群。

根据 Minikube 文档,在我们开始之前,有一些先决条件。首先要保证你已经安装了一个 Hypervisor (我将会使用 Virtualbox)。接下来,我们需要安装 Kubernetes 命令行工具(也就是 kubectl)。如果你在用 Homebrew,这一步非常简单,只需要运行命令:

$ brew install kubectl

现在我们可以真正 安装 Minikube 了:

$ curl -Lo minikube https://storage.googleapis.com/minikube/releases/v0.21.0/minikube-darwin-amd64 && chmod +x minikube && sudo mv minikube /usr/local/bin/

最后,我们要启动 Minicube 创建一个虚拟机,来作为我们的单节点 Kubernetes 集群。现在我要说一点:尽管我们在本文中只在本地运行它,但是在真正的服务器上运行 Kubernetes 集群时,后面提到的大多数概念都会适用。在多节点集群上,“主节点”将负责管理其它工作节点(虚拟机或物理服务器),并且 Kubernetes 将会在集群中自动进行容器的分发和调度。

$ minikube start --vm-driver=virtualbox

安装 Helm

现在,本机中应该有一个正在运行的(单节点)Kubernetes 集群了。我们现在可以用任何方式来与 Kubernetes 交互。如果你想现在可以体验一下,我觉得 kubernetesbyexample.com 可以很好地向你介绍 Kubernetes 的概念和术语。

虽然我们可以手动配置这些东西,但实际上我们将会使用另外的工具,来将我们的 WordPress 应用部署到 Kubernetes 集群中。Helm 被称为“Kubernetes 的包管理工具”,它可以让你轻松地在你的集群中部署预构建的软件包,也就是“ 图表 chart ”。你可以把图表看做一组专为特定应用(如 WordPress)而设计的容器定义和配置。首先我们在本地主机上安装 Helm:

$ brew install kubernetes-helm

然后我们需要在集群中安装 Helm。 幸运的是,只需要运行下面的命令就好:

$ helm init

安装 WordPress

现在 Helm 已经在我们的集群中运行了,我们可以安装 WordPress 图表。运行:

$ helm install --namespace wordpress --name wordpress --set serviceType=NodePort stable/wordpress  

这条命令将会在容器中安装并运行 WordPress,并在容器中运行 MariaDB 作为数据库。它在 Kubernetes 中被称为“Pod”。一个 Pod 基本上可视为一个或多个应用程序容器和这些容器的一些共享资源(例如存储卷,网络等)的组合的抽象。

我们需要给这个部署一个名字和一个命名空间,以将它们组织起来并便于查找。我们同样会将 serviceType 设置为 NodePort 。这一步非常重要,因为在默认设置中,服务类型会被设置为 LoadBalancer。由于我们的集群现在没有负载均衡器,所以我们将无法在集群外访问我们的 WordPress 站点。

在输出数据的最后一部分,你会注意到一些关于访问你的 WordPress 站点的有用的命令。运行那些命令,你可以获取到我们的 WordPress 站点的外部 IP 地址和端口:

$ export NODE_PORT=$(kubectl get --namespace wordpress -o jsonpath="{.spec.ports[0].nodePort}" services wordpress-wordpress)
$ export NODE_IP=$(kubectl get nodes --namespace wordpress -o jsonpath="{.items[0].status.addresses[0].address}")
$ echo http://$NODE_IP:$NODE_PORT/admin

你现在访问刚刚生成的 URL(忽略 /admin 部分),就可以看到 WordPress 已经在你的 Kubernetes 集群中运行了!

扩展 WordPress

Kubernetes 等服务编排平台的一个伟大之处,在于它将应用的扩展和管理变得易如反掌。我们看一下应用的部署状态:

$ kubectl get deployments --namespace=wordpress

kubectl get deployments

可以看到,我们有两个部署,一个是 Mariadb 数据库,一个是 WordPress 本身。现在,我们假设你的 WordPress 开始承载大量的流量,所以我们想将这些负载分摊在多个实例上。我们可以通过一个简单的命令来扩展 wordpress-wordpress 部署:

$ kubectl scale --replicas 2 deployments wordpress-wordpress --namespace=wordpress

再次运行 kubectl get deployments,我们现在应该会看到下面的场景:

kubectl get deployments

你刚刚扩大了你的 WordPress 站点规模!超级简单,对不对?现在我们有了多个 WordPress 容器,可以在它们之中对流量进行负载均衡。想了解 Kubernetes 扩展的更多信息,参见这篇指南。

高可用

Kubernetes 等平台的的另一大特色在于,它不单单能进行方便的扩展,还可以通过自愈组件来提供高可用性。假设我们的一个 WordPress 部署因为某些原因失效了,那 Kubernetes 会立刻自动替换掉这个部署。我们可以通过删除我们 WordPress 部署的一个 pod 来模拟这个过程。

首先运行命令,获取 pod 列表:

$ kubectl get pods --namespace=wordpress

kubectl get pods

然后删除其中一个 pod:

$ kubectl delete pod wordpress-wordpress-876183909-jqc8s --namespace=wordpress

如果你再次运行 kubectl get pods 命令,应该会看到 Kubernetes 立刻换上了新的 pod (3l167)。

kubectl get pods

更进一步

我们只是简单了解了 Kubernetes 能完成工作的表面。如果你想深入研究,我建议你查看以下功能:

你在容器平台上运行过 WordPress 吗?有没有使用过 Kubernetes(或其它容器编排平台),有没有什么好的技巧?你通常会怎么扩展你的 WordPress 站点?请在评论中告诉我们。


作者简介:

Gilbert 喜欢构建软件。从 jQuery 脚本到 WordPress 插件,再到完整的 SaaS 应用程序,Gilbert 一直在创造优雅的软件。 他粗昂做的最有名的的产品,应该是 Nivo Slider.


via: https://deliciousbrains.com/running-wordpress-kubernetes-cluster/

作者:Gilbert Pellegrom 译者:StdioA 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

Tanya Reilly 的五个问题:相互依赖的服务如何使恢复更加困难,为什么有意并预先管理依赖是个好主意。

我最近请 Google 的网站可靠性工程师 Tanya Reilly 分享了她关于如何制定更好的灾难恢复计划的想法。Tanya 将在 10 月 1 日到 4 日在纽约举行的 O'Reilly Velocity Conference 上发表了一个题为《你有没有试着把它关闭之后再打开?》的演讲。

1、 在计划备份系统策略时,人们最常犯的错误是什么?

经典的一条是“你不需要备份策略,你需要一个恢复策略”。如果你有备份,但你尚未测试恢复它们,那么你没有真正的备份。测试不仅仅意味着知道你可以获得数据,还意味着知道如何把它放回数据库,如何处理增量更改,甚至如果你需要的话,如何重新安装整个系统。这意味着确保你的恢复路径不依赖于与数据同时丢失的某些系统。

但测试恢复是枯燥的。这是人们在忙碌时会偷工减料的那类事情。这值得花时间使其尽可能简单、无痛、自动化,永远不要靠任何人的意志力!同时,你必须确保有关人员知道该怎么做,所以定期进行大规模的灾难测试是很好的。恢复演练是个好方法,可以找出该过程的文档是否缺失或过期,或者你是否没有足够的资源(磁盘、网络等)来传输和重新插入数据。

2、 创建 灾难恢复 disaster recovery (DR) 计划最常见的挑战是什么?

我认为很多 DR 是一种事后的想法:“我们有这个很棒的系统,我们的业务依赖它……我猜我们应该为它做 DR?”而且到那时,系统会非常复杂,充满相互依赖关系,很难复制。

第一次安装的东西,它通常是由人手动调整才正常工作的,有时那是个具体特定的版本。当你构建第二个时,很难确定它是完全一样的。即使在具有严格的配置管理的站点中,你也可能丢了某些东西,或者过期了。

例如,如果你已经失去对解密密钥的访问权限,那么加密备份没有太多用处。而且任何只在灾难中使用的部分都可能从你上次检查它们过后就破环了。确保你已经涵盖了所有东西的唯一方法做认真地故障切换。当你准备好了的,就计划一下你的灾难(演练)吧!

如果你可以设计系统,以使灾难恢复模式成为正常运行的一部分,那么情况会更好。如果你的服务从一开始就被设计为可复制的,添加更多的副本就是一个常规的操作并可能是自动化的。没有新的方法,这只是一个容量问题。但是,系统中仍然存在一些只能在一个或两个地方运行的组件。偶然计划中的假灾难能够很好地将它们暴露出来。

顺便说一句,那些被遗忘的组件可能包括仅在一个人的大脑中的信息,所以如果你自己发现说:“我们不能在 X 休假回来前进行 DR 故障切换测试”,那么那个人是一个危险的单点失败。

仅在灾难中使用的部分系统需要最多的测试,否则在需要时会失败。这个部分越少越安全,且辛苦的测试工作也越少。

3、 为什么服务相互依赖使得灾难恢复更加困难?

如果你只有一个二进制文件,那么恢复它是比较容易的:你做个二进制备份就行。但是我们越来越多地将通用功能分解成单独的服务。微服务意味着我们有更多的灵活性和更少地重新发明轮子:如果我们需要一个后端做一些事情,并且有一个已经存在,那么很好,我们就可以使用它。但是一些需要保留很大的依赖关系,因为它很快会变得纠缠。

你可能知道你直接使用的后端,但是你可能不会注意到有新的后端添加到你使用的库中。你可能依赖于某个东西,它也间接依赖于你。在依赖中断之后,你可能会遇到一个死锁:两个系统都不能启动,直到另一个运行并提供一些功能。这是一个困难的恢复情况!

你甚至可以最终遇到间接依赖于自身的东西,例如你需要配置启动网络的设备,但在网络关闭时无法访问该设备。人们通常会提前考虑这些循环依赖,并且有某种后备计划,但是这些本质上是不太行得通的方式:它们只适用于极端情况,并且以不同的方式使用你的系统、进程或代码。这意味着,它们很可能有一个不会被发现的问题,直到你真的,真的需要它们的工作的时候才发现。

4、 你建议人们在感觉需要之前就开始有意管理其依赖关系,以防止潜在的灾难性系统故障。为什么这很重要,你有什么建议有效地做到这一点?

管理你的依赖关系对于确保你可以从灾难中恢复至关重要。它使操作系统更容易。如果你的依赖不可靠,那么你就不可靠,所以你需要知道它们是什么。

虽然在它们变得混乱后也可以开始管理依赖关系,但是如果你早点开始,它会变得更容易一些。你可以设置使用各种服务策略——例如,你必须在堆栈中的这一层依赖于这组系统。你可以通过使其成为设计文件审查的常规部分,引入考虑依赖关系的习惯。但请记住,依赖关系列表将很快变得陈旧。如果你有程序化的发现依赖关系的方式,甚至强制实施依赖,这是最好的。 我的 Velocity 谈话涵盖了我们如何做到这一点。

早期开始的另一个优点是,你可以将服务拆分为垂直“层”,每个层中的功能必须能够在下一个层启动之前完全在线。所以,例如,你可以说网络必须能够完全启动而不借助任何其他服务。然后说,你的存储系统应该仅仅依赖于网络,程序后端应该仅仅依赖于网络和存储,等等。不同的层次对于不同的架构是有意义的。

如果你提前计划,新服务更容易选择依赖关系。每个服务应该只依赖堆栈中较低的服务。你仍然可以结束循环,在相同的层次服务上批次依赖 —— 但是它们可以更加紧密地包含,并且在逐个基础上处理更容易。

5、 你对 Velocity NY 的其他部分感兴趣么?

我整个星期二和星期三的时间表都完成了!正如你可能收集的那样,我非常关心大型相互依赖的系统的可管理性,所以我期待听到 Carin Meier 关于管理系统复杂性的想法、Sarah Wells 的微服务和 Baron 的可观察性 的谈话。我非常着迷听到 Jon Moore 关于 Comcast 如何从年度发布到每天发布的故事。作为一个前系统管理员,我很期待听到 Bryan Liles 对这个职位走向的看法。


作者简介:

Nikki McDonald 是 O'Reilly Media,Inc. 的内容总监。她住在密歇根州的安娜堡市。

Tanya Reilly 自 2005 年以来一直是 Google 的系统管理员和站点可靠性工程师,致力于分布式锁、负载均衡和引导等底层基础架构。在加入 Google 之前,她是爱尔兰最大的 ISP eircom.net 的系统管理员,在这之前她担当了一个小型软件公司的整个 IT 部门。


via: https://www.oreilly.com/ideas/creating-better-disaster-recovery-plans

作者:Nikki McDonald, Tanya Reilly 译者:geekpi 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出