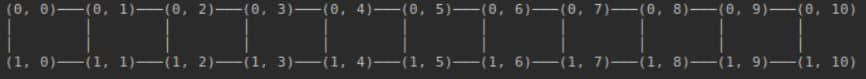
2018年12月

我们即将讨论的内容正如标题所示,本文通过使用 Cirq 的一个开源视角,尝试去了解我们已经在量子计算领域取得多大的成就,和该领域的发展方向,以加快科学和技术研究。

首先,我们将引领你进入量子计算的世界。在我们深入了解 Cirq 在未来的量子计算中扮演什么样的重要角色之前,我们将尽量向你解释其背后的基本概念。你最近可能听说过,在这个领域中有件重大新闻,就是 Cirq。在这篇开放科学栏目的文章中,我们将去尝试找出答案。

在我们开始了解量子计算之前,必须先去了解“量子”这个术语,量子是已知的 亚原子粒子 中最小的物质。 量子 Quantum 这个词来自拉丁语 Quantus,意思是 “有多小”,在下面的短视频链接中有描述:

为了易于我们理解量子计算,我们将 量子计算 Quantum Computing 与 经典计算 Classical Computing (LCTT 译注:也有译做“传统计算”)进行比较。经典计算是指今天的传统计算机如何设计工作的,正如你现在用于阅读本文的设备,就是我们所谓的经典计算设备。

经典计算

经典计算只是描述计算机如何工作的另一种方式。它们通过一个二进制系统工作,即信息使用 1 或 0 来存储。经典计算机不会理解除 1 或 0 之外的任何其它东西。

直白来说,在计算机内部一个晶体管只能是开(1)或关(0)。我们输入的任何信息都被转换为无数个 1 和 0,以便计算机能理解和存储。所有的东西都只能用无数个 1 和 0 的组合来表示。

量子计算

然而,量子计算不再像经典计算那样遵循 “开或关” 的模式。而是,借助量子的名为 叠加和纠缠 的两个现象,能同时处理信息的多个状态,因此能以更快的速率加速计算,并且在信息存储方面效率更高。

请注意,叠加和纠缠 不是同一个现象。
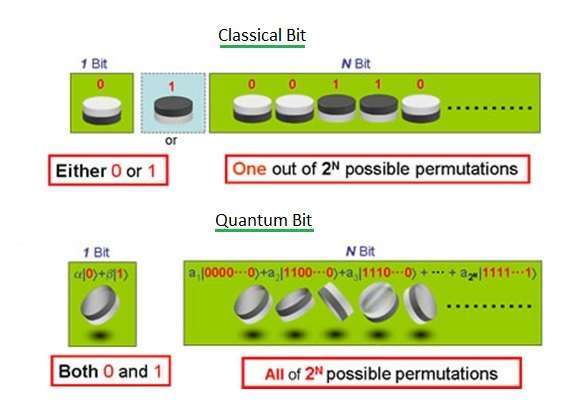
就像在经典计算中,我们有 比特 bit ,在量子计算中,我们相应也有 量子比特 qubit (即 Quantum bit)。想了解它们二者之间的巨大差异之处,请查看这个 页面,从那里的图片中可以得到答案。

量子计算机并不是来替代我们的经典计算机的。但是,有一些非常巨大的任务用我们的经典计算机是无法完成的,而那些正是量子计算机大显身手的好机会。下面链接的视频详细描述了上述情况,同时也描述了量子计算机的原理。

下面的视频全面描述了量子计算领域到目前为止的最新进展:

嘈杂中型量子

根据最新更新的(2018 年 7 月 31 日)研究论文,术语 “ 嘈杂 Noisy ” 是指由于对量子比特未能完全控制所产生的不准确性。正是这种不准确性在短期内严重制约了量子设备实现其目标。

“中型” 指的是在接下来的几年中,量子计算机将要实现的量子规模大小,届时,量子比特的数目将可能从 50 到几百个不等。50 个量子比特是一个重大的量程碑,因为它将超越现有的最强大的 超级计算机 的 暴力破解 所能比拟的计算能力。更多信息请阅读 这里的 论文。

随着 Cirq 出现,许多事情将会发生变化。

Cirq 是什么?

Cirq 是一个 Python 框架,它用于创建、编辑和调用我们前面讨论的嘈杂中型量子(NISQ)。换句话说,Cirq 能够解决挑战,去改善精确度和降低量子计算中的噪声。

Cirq 并不需要必须有一台真实的量子计算机。Cirq 能够使用一个类似模拟器的界面去执行量子电路模拟。

Cirq 的前进步伐越来越快了,Zapata 是使用它的首批用户之一,Zapata 是由来自哈佛大学的专注于量子计算的一群科学家在去年成立的。

Linux 上使用 Cirq 入门

开源的 Cirq 库 开发者建议将它安装在像 virtualenv 这样的一个 虚拟 Python 环境 中。在 Linux 上的开发者安装指南可以在 这里 找到。

但我们在 Ubuntu 16.04 的系统上成功地安装和测试了 Python3 的 Cirq 库,安装步骤如下:

在 Ubuntu 上安装 Cirq
Cirq Framework for Quantum Computing in Linux

首先,我们需要 pip 或 pip3 去安装 Cirq。Pip 是推荐用于安装和管理 Python 包的工具。

对于 Python 3.x 版本,Pip 能够用如下的命令来安装:

sudo apt-get install python3-pip

Python3 包能够通过如下的命令来安装:

pip3 install <package-name>

我们继续去使用 Pip3 为 Python3 安装 Cirq 库:

pip3 install cirq

启用 Plot 和 PDF 生成(可选)

可选系统的依赖没有被 Pip 安装的,可以使用如下命令去安装它:

sudo apt-get install python3-tk texlive-latex-base latexmk
  • python3-tk 是 Python 自有的启用了绘图功能的图形库
  • texlive-latex-base 和 latexmk 启动了 PDF 输出功能。

最后,我们使用如下的命令和代码成功测试了 Cirq:

python3 -c 'import cirq; print(cirq.google.Foxtail)'

我们得到的输出如下图:

为 Cirq 配置 Pycharm IDE

我们也配置了一个 Python IDE PyCharm 去测试同样的结果:

因为在我们的 Linux 系统上为 Python3 安装了 Cirq,我们在 IDE 中配置项目解释器路径为:

/usr/bin/python3
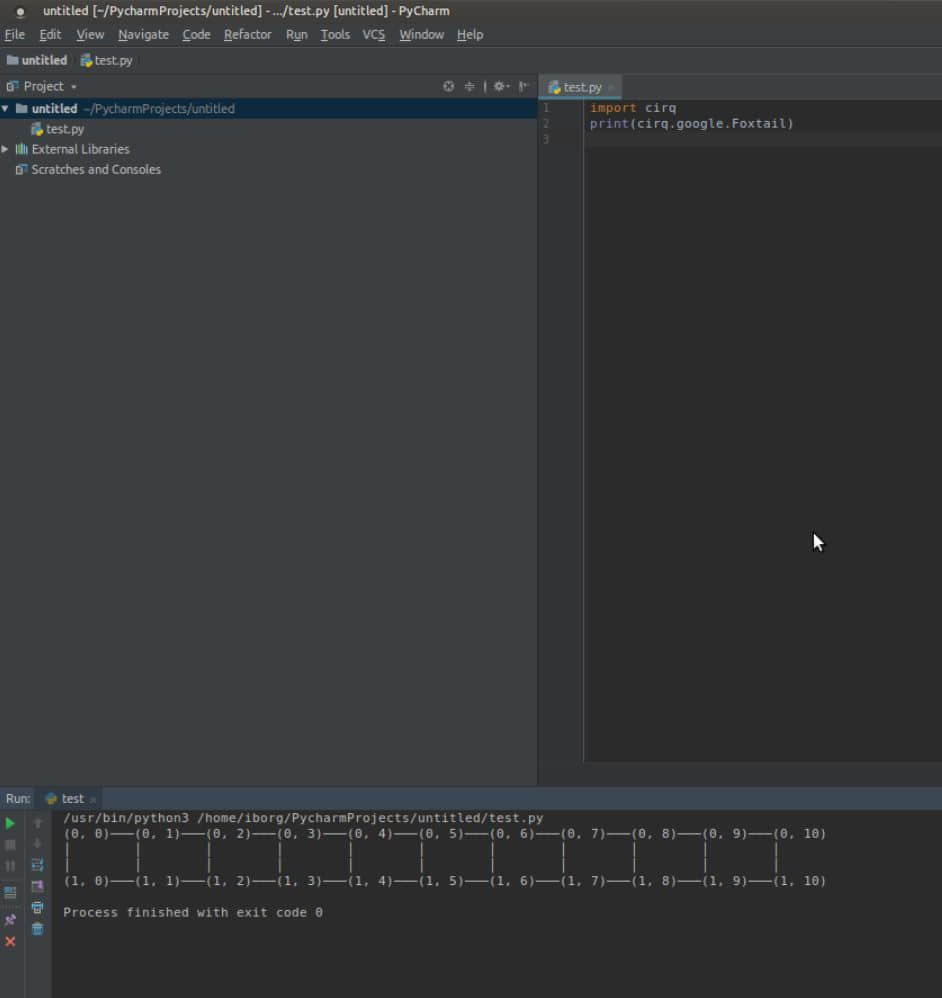
在上面的输出中,你可能注意到我们刚设置的项目解释器路径与测试程序文件(test.py)的路径显示在一起。退出代码 0 表示程序已经成功退出,没有错误。

因此,那是一个已经就绪的 IDE 环境,你可以导入 Cirq 库去开始使用 Python 去编程和模拟量子电路。

Cirq 使用入门

Criq 入门的一个好的开端就是它 GitHub 页面上的 示例。

Cirq 的开发者在 GitHub 上已经放置了学习 教程。如果你想认真地学习量子计算,他们推荐你去看一本非常好的书,它是由 Nielsen 和 Chuang 写的名为 《量子计算和量子信息》。

OpenFermion-Cirq

OpenFermion 是一个开源库,它是为了在量子计算机上模拟获取和操纵代表的费米系统(包含量子化学)。根据 粒子物理学 理论,按照 费米—狄拉克统计,费米系统与 费米子 的产生相关。

OpenFermion 被称为从事 量子化学 的化学家和研究人员的 一个极好的实践工具。量子化学主要专注于 量子力学 在物理模型和化学系统实验中的应用。量子化学也被称为 分子量子力学。

Cirq 的出现使 OpenFermion 通过提供程序和工具去扩展功能成为了可能,通过使用 Cirq 可以去编译和构造仿真量子电路。

Google Bristlecone

2018 年 3 月 5 日,在洛杉矶举行的一年一度的 美国物理学会会议 上,Google 发布了 Bristlecone,这是他们的最新的量子处理器。这个 基于门的超导系统 为 Google 提供了一个测试平台,用以研究 量子比特技术 的 系统错误率 和 扩展性 ,以及在量子 仿真、优化 和 机器学习 方面的应用。

Google 希望在不久的将来,能够制造出它的 云可访问 的 72 个量子比特的 Bristlecone 量子处理器。Bristlecone 将越来越有能力完成一个经典超级计算机无法在合理时间内完成的任务。

Cirq 将让研究人员直接在云上为 Bristlecone 写程序变得很容易,它提供了一个非常方便的、实时的、量子编程和测试的接口。

Cirq 将允许我们去:

  • 量子电路的微调管理
  • 使用原生门去指定 门 行为
  • 在设备上放置适当的门
  • 并调度这个门的时刻

开放科学关于 Cirq 的观点

我们知道 Cirq 是在 GitHub 上开源的,在开源科学社区之外,特别是那些专注于量子研究的人们,都可以通过高效率地合作,通过开发新方法,去降低现有量子模型中的错误率和提升精确度,以解决目前在量子计算中所面临的挑战。

如果 Cirq 不走开源模型的路线,事情可能变得更具挑战。一个伟大的创举可能就此错过,我们可能在量子计算领域止步不前。

总结

最后我们总结一下,我们首先通过与经典计算相比较,介绍了量子计算的概念,然后是一个非常重要的视频来介绍了自去年以来量子计算的最新发展。接着我们简单讨论了嘈杂中型量子,也就是为什么要特意构建 Cirq 的原因所在。

我们看了如何在一个 Ubuntu 系统上安装和测试 Cirq。我们也在一个更好用的 IDE 环境中做了安装测试,并使用一些资源去开始学习有关概念。

最后,我们看了两个示例 OpenFermion 和 Bristlecone,介绍了在量子计算中,Cirq 在开发研究中具有什么样的基本优势。最后我们以 Open Science 社区的视角对 Cirq 进行了一些精彩的思考,结束了我们的话题。

我们希望能以一种易于理解的方式向你介绍量子计算框架 Cirq 的使用。如果你有与此相关的任何反馈,请在下面的评论区告诉我们。感谢阅读,希望我们能在开放科学栏目的下一篇文章中再见。


via: https://itsfoss.com/qunatum-computing-cirq-framework/

作者:Avimanyu Bandyopadhyay 选题:lujun9972 译者:qhwdw 校对:wxy
本文由 LCTT 原创编译,Linux中国 荣誉推出

我知道你在想什么:树莓派只能用在修修补补、原型设计和个人爱好中。它实际不能用在业务中。

毫无疑问,这台电脑的处理能力相对较低、易损坏的 SD 卡、缺乏电池备份以及支持的 DIY 性质,这意味着它不会是一个能在任何时候执行最关键的操作的专业的、已安装好、配置好的商业服务器的可行替代品。

但是它电路板便宜、功耗很小、小到几乎适合任何地方、无限灵活 —— 这实际上是处理办公室一些基本任务的好方法。

而且,更好的是,已经有一些人完成了这些项目并很乐意分享他们是如何做到的。

DNS 服务器

每次在浏览器中输入网站地址或者点击链接时,都需要将域名转换为数字 IP 地址,然后才能显示内容。

通常这意味着向互联网上某处 DNS 服务器发出请求 —— 但你可以通过本地处理来加快浏览速度。

你还可以分配自己的子域,以便本地访问办公室中的计算机。

这里了解它是如何工作的。

厕所占用标志

在厕所排过队吗?

这对于那些等待的人来说很烦人,花在处理它上面的时间会耗费你在办公室的工作效率。

我想你希望在办公室里也悬挂飞机上那个厕所有人的标志。

Occu-pi 是一个非常简单的解决方案,使用磁性开关和树莓派来判断螺栓何时关闭,并在 Slack 频道中更新“厕所在使用中” —— 这意味着整个办公室的人都可以看一眼电脑或者移动设备知道是否有空闲的隔间。

针对黑客的蜜罐陷阱

黑客破坏了网络的第一个线索是一些事情变得糟糕,这应该会吓到大多数企业主。

这就是可以用到蜜罐的地方:一台没有任何服务的计算机位于你的网络,将特定端口打开,伪装成黑客喜欢的目标。

安全研究人员经常在网络外部部署蜜罐,以收集攻击者正在做的事情的数据。

但对于普通的小型企业来说,这些作为一种绊脚石部署在内部更有用。因为普通用户没有真正的理由想要连接到蜜罐,所以任何发生的登录尝试都是正在进行捣乱的非常好的指示。

这可以提供对外部人员入侵的预警,并且也可以提供对值得信赖的内部人员的预警。

在较大的客户端/服务器网络中,将它作为虚拟机运行可能更为实用。但是在无线路由器上运行的点对点的小型办公室/家庭办公网络中,HoneyPi 之类的东西是一个很小的防盗报警器。

打印服务器

联网打印机更方便。

但更换所有打印机可能会很昂贵 —— 特别是如果你对现有的打印机感到满意的话。

将树莓派设置为打印服务器可能会更有意义。

网络附加存储(NAS)

将硬盘变为 NAS 是树莓派最早的实际应用之一,并且它仍然是最好的之一。

这是如何使用树莓派创建 NAS。

工单服务器

想要在预算不足的情况下在服务台中支持工单?

有一个名为 osTicket 的完全开源的工单程序,它可以安装在你的树莓派上,它甚至还有随时可用的 SD 卡镜像。

数字标牌

无论是用于活动、广告、菜单还是其他任何东西,许多企业都需要一种显示数字标牌的方式 —— 而树莓派的廉价和省电使其成为一个非常有吸引力的选择。

这有很多可供选择的选项。

目录和信息亭

FullPageOS 是一个基于 Raspbian 的 Linux 发行版,它直接引导到 Chromium 的全屏版本 —— 这非常适合导购、图书馆目录等。

基本的内联网 Web 服务器

对于托管一个面向公众的网站,你最好有一个托管帐户。树莓派不适合面对真正的网络流量。

但对于小型办公室,它可以托管内部业务维基或基本的公司内网。它还可以用作沙箱环境,用于试验代码和服务器配置。

这里是如何在树莓派上运行 Apache、MySQL 和 PHP。

渗透测试器

Kali Linux 是专为探测网络安全漏洞而构建的操作系统。通过将其安装在树莓派上,你就拥有了一个超便携式穿透测试器,其中包含 600 多种工具。

你可以在这里找到树莓派镜像的种子链接。

绝对要小心只在你自己的网络或你有权对它安全审计的网络中使用它 —— 使用此方法来破解其他网络是严重的犯罪行为。

VPN 服务器

当你外出时,依靠的是公共无线互联网,你无法控制还有谁在网络中、谁在窥探你的所有流量。这就是为什么通过 VPN 连接加密所有内容可以让人放心。

你可以订阅任意数量的商业 VPN 服务,并且你可以在云中安装自己的服务,但是在办公室运行一个 VPN,这样你也可以从任何地方访问本地网络。

对于轻度使用 —— 比如偶尔的商务旅行 —— 树莓派是一种强大的,节约能源的设置 VPN 服务器的方式。(首先要检查一下你的路由器是不是不支持这个功能,许多路由器是支持的。)

这是如何在树莓派上安装 OpenVPN。

无线咖啡机

啊,美味:好喝的饮料是神赐之物,也是公司内工作效率的支柱。

那么,为什么不将办公室的咖啡机变成可以精确控制温度和无线连接的智能咖啡机呢?


via: https://blog.dxmtechsupport.com.au/11-uses-for-a-raspberry-pi-around-the-office/

作者:James Mawson 选题:lujun9972 译者:geekpi 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

初学者可以在此教程中了解环境变量。

bash 变量,尤其是讨厌的环境变量,已经是一个老生常谈的话题了。我们也更应该对它有一个详细的了解,让它为我们所用。

下面就打开终端,开始吧。

环境变量

HOME (LCTT 译注:双关语)除了是你脱下帽子惬意休息的地方,同时也是 Linux 中的一个变量,它是当前用户主目录的路径:

echo $HOME

以上这个命令会显示当前用户的主目录路径,通常都在 /home/<your username> 下。

顾名思义,变量的值是可以根据上下文变化的。实际上,Linux 系统中每一个用户的 HOME 变量都是不一样的,当然你也可以这样自行更改 HOME 变量的值:

HOME=/home/<your username>/Documents

以上这个命令将会把 HOME 变量设置为你的 Documents 目录。

其中有三点需要留意:

  1. = 符号和其两侧的内容之间不加空格。空格在 shell 中有专门的意义,不能随意地在任何地方添加空格。
  2. 如果你需要对变量进行赋值,只需要使用变量名称就可以了。但如果需要读取或者使用变量的值,需要在变量前面加上一个 $ 号。
  3. 更改 HOME 变量具有一定的风险。有很多程序是依赖于 HOME 变量的,更改 HOME 变量可能会导致一些不可预见的结果。例如,如果按照上面的方式更改了 HOME 变量,然后执行不带有任何参数的 cd 命令,在通常情况下,会跳转到用户的主目录下,但在这个时候,会跳转到 HOME 变量指定的目录下。

上面第 3 点中环境变量的更改并不是持久有效的,在终端关闭后重新打开终端,又或者是新建一个终端,执行 echo $HOME 命令输出的仍然会是初始的值,而不是重新自定义的值。

在讨论如何持久地更改一个环境变量之前,我们先来看一下另一个比较重要的环境变量。

PATH 变量

在 PATH 变量中存放了一系列目录,而且是放置了可执行程序的目录。正是由于 PATH 变量的存在,让你不需要知道应用程序具体安装到了什么目录,而 shell 却可以正确地找到这些应用程序。

如果你查看 PATH 变量的值,大概会是以下这样:

$ echo $PATH
/usr/local/sbin:/usr/local/bin:/usr/bin:/usr/sbin:/bin:/sbin

每两个目录之间使用冒号 : 分隔。如果某个应用程序的所在目录不在 PATH 变量中,那么运行的时候就需要声明应用程序的目录让 shell 能够找到。

/home/<user name>/bin/my_program.sh

例如以上命令就会执行当前用户 bin/ 目录下的 my_program.sh 文件。

有一个常见的问题:如果你不希望弄乱系统的 bin/ 目录,同时也不希望你自己的文件被其它人运行,还不想每次运行的时候都要输入完整的路径,那么,你可以在你的主目录中创建一个独立的 bin/ 目录:

mkdir $HOME/bin

然后将这个目录添加到 PATH 变量中:

PATH=$PATH:$HOME/bin

然后 /home/<user name>/bin/ 目录就会出现在 PATH 变量中了。但正如之前所说,这个变更只会在当前的 shell 生效,当前的 shell 一旦关闭,环境变量的值就又恢复原状了。

如果要让变更对当前用户持续生效,就不能在 shell 中直接执行对应的变更,而是应该将这些变更操作写在每次启动 shell 时都会运行的文件当中。这个文件就是当前用户主目录中的 .bashrc 文件。文件名前面的点号表明这是一个隐藏文件,执行普通的 ls 命令是不会将这个文件显示出来的,但只要在 ls 命令中加入 -a 参数就可以看到这个文件了。

你可以使用诸如 kate、gedit、nano 或者 vim 这些文本编辑器来打开 .bashrc 文件(但不要用 LibreOffice Writer,它是一个文字处理软件,跟前面几个文字编辑器完全不同)。打开 .bashrc 文件之后,你会看见里面放置了一些 shell 命令,是用于为当前用户设置环境的。

在文件的末尾添加新行并输入以下内容:

export PATH=$PATH:$HOME/bin

保存并关闭 .bashrc 文件,接下来你就会看到 export 语句的效果。执行以下的命令让刚才的修改立即生效:

source .bashrc

刚才执行的 source 命令让 .bashrc 文件在当前的 shell 立即生效,并且对于之后打开的 shell 都会有效。因此另一个等效的方法是退出并重新进入 shell,但这样也太麻烦了。

现在,你的 shell 就能自动寻找到 /home/<user name>/bin/ 下的程序了,执行这个目录下的程序也不需要完整地写出程序的路径。

自定义变量

当然,你也可以定义自己的变量。刚才我们看到的变量名称都是全大写的,实际上变量名称的定义还是比较灵活的。

定义新变量的过程非常直观,直接对它赋值就可以了:

new_variable="Hello"

然后可以用以下的方式读取到已定义变量的值:

echo $new_variable

程序的正常工作离不开各种变量,例如要将某个选项设置为打开,又或者让程序找到所需的代码库,都需要使用变量。在 bash 中运行程序的时候会生成一个子 shell,这个子 shell 和执行原程序的父 shell 并不是完全一样的,只是继承了父 shell 的部分内容,而且默认是不继承父 shell 中的变量的。因为变量默认情况下是局部变量,出于安全原因,一个 shell 中的局部变量不会被另一个 shell 读取到,即使是子 shell 也不可以。

下面举一个例子。首先定义一个变量:

robots="R2D2 & C3PO"

然后执行:

bash

现在是在 bash shell 中创建了一个子 shell。

执行这个命令看看还能不能读取到刚才定义的变量:

echo $robots

你会发现读取不到。

还是在这个子 shell 中,为 robots 变量赋一个不同的值:

robots="These aren't the ones you are looking for"

再读取一次:

$ echo $robots
These aren't the ones you are looking for

退出这个子 shell:

exit

然后再看一下现在 robots 变量的值:

$ echo $robots
R2D2 & C3P0

这一个特性可以有效避免配置过程中产生混乱,同时也会导致一个问题:如果程序中需要设置变量,但却由于子 shell 的原因无法正常访问到这个变量,该如何解决呢?这个时候就需要用到 export 了。

重复一次刚才的过程,但这一次不是通过 robots="R2D2 & C3PO" 方式来设置变量,而是使用 export 命令:

export robots="R2D2 & C3PO"

现在你会发现,在进入子 shell 之后,robots 变量的值仍然是最初赋予的值。

要注意的是,尽管子 shell 会继承通过 export 导出的变量,但如果在子 shell 中对这个变量重新赋值,是不会影响到父 shell 中对应变量的。

如果要查看所有通过 export 导出的变量,可以执行以下命令:

export -p

自定义的变量会显示在这个列表的末尾。这个列表中还有一些常见的变量:例如 USER 的值是当前用户的用户名,PWD 的值是当前用户当前所在的目录,而 OLDPWD 的值则是当前用户上一个访问过的目录。因此如果执行:

cd -

就会切换到上一个访问过的目录,那是因为 cd 命令读取到了 OLDPWD 变量的值。

你也可以使用 env 命令查看所有环境变量。

如果要取消导出一个变量,可以加上 -n 参数:

export -n robots

接下来

了解过环境变量的知识之后,你已经到达了可能对自己和他人造成危险的水平,接下来就需要了解如何通过使用别名来让环境变得更安全、更友好以保护自己了。


via: https://www.linux.com/blog/learn/2018/12/bash-variables-environmental-and-otherwise

作者:Paul Brown 选题:lujun9972 译者:HankChow 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

如果我没弄错,Putty 可能是 Windows 最受欢迎的 SSH 客户端。

在 IT 公司中,开发环境通常在远程 Linux 系统上,而开发人员则使用 Windows 作为本地系统。Putty 用于从 Windows 机器连接到远程 Linux 系统。

Putty 不是限定于 Windows 的。你也可以在 Linux 和 macOS 上使用此开源软件。

但是等等!当你已经拥有“真正的” Linux 终端时,为什么要在 Linux 上使用单独的 SSH 客户端?这有几个想在 Linux 上使用 Putty 的原因。

  • 你在 Windows 上使用 Putty 已经很久了,你觉得它更舒服。
  • 你发现很难手动编辑 SSH 配置文件以保存各种 SSH 会话。你更喜欢 Putty 图形化保存 SSH 连接的方式。
  • 你想通过连接到原始套接字和串口进行调试。

无论是什么原因,如果你想在 Ubuntu 或任何其他 Linux 上使用 Putty,你当然可以这样做。让我告诉你如何做到。

在 Ubuntu Linux 上安装 Putty

Installing Putty on Linux

对于 Ubuntu 用户来说,好消息是 Putty 可以在 Ubuntu 的 universe 仓库中找到。

要在 Ubuntu上安装 Putty,首先应确保已启用 universe 仓库。

sudo add-apt-repository universe

启用 universe 仓库后,应使用以下命令更新 Ubuntu:

sudo apt update

之后,你可以使用以下命令安装 Putty:

sudo apt install putty

安装后,你可以在菜单中找到它来启动 Putty。

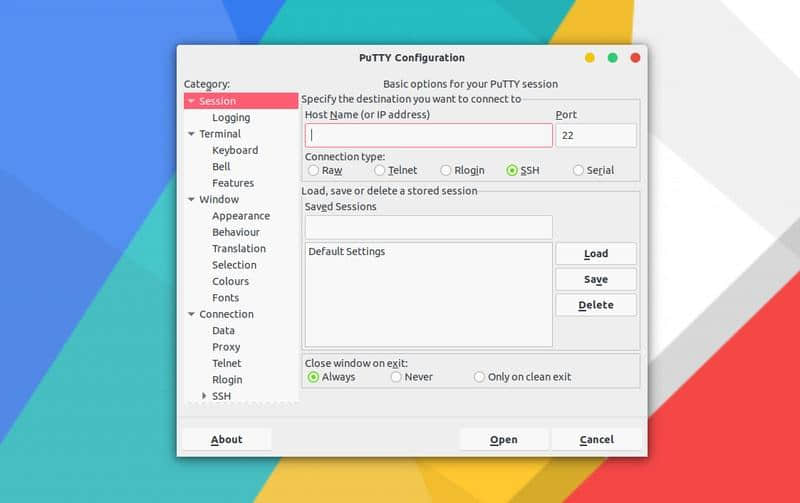
正如你在下面的截图中看到的,Putty 的 Linux 版本看起来与 Windows 版本相同。这让你松了一口气, 因为你不必再尝试新的设置。

Putty in Linux

当你输入远程系统的主机名或 IP 地址并连接到它时,Putty 将使用你已保存在主目录中的 SSH 密钥。

Using Putty in Ubuntu Linux

在其他 Linux 发行版上安装 Putty

Putty 可用于 Debian,所以你只需要使用 apt-get 或 aptitude 来安装它。

sudo apt-get install putty

Putty 也适用于 Fedora/Red Hat,并可以使用默认的包管理器进行安装。

sudo dnf install putty

你还可以在基于 Arch Linux 的发行版中轻松安装 Putty。

sudo pacman -S putty

请记住,Putty 是一款开源软件。如果你真的想要,你也可以通过源代码安装它。你可以从下面的链接获取 Putty 的源代码。

我一直喜欢原生 Linux 终端而不是像 Putty 这样的 SSH 客户端。我觉得 GNOME 终端或 Terminator 更有家的感觉。但是,在 Linux 中使用默认终端或 Putty 是个人选择。

你在 Linux 上管理多个 SSH 连接时使用了什么?


via: https://itsfoss.com/putty-linux/

作者:Abhishek Prakash 选题:lujun9972 译者:geekpi 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

“密室逃脱”是近年来流行的益智解密游戏。我们的主人公就进入了这样的一个游戏,然而,发现谜题是——如何退出 Vim!!!

“如何退出 Vim”这个话题,已经成了众多 Linux 初学者经常听说的一个梗了,比如说,“如何制造乱码?——新手退出 Vim”。

甚至在国外著名的问答网站 Stack Overflow 上,从 2012 年 8 月 6 日,jclancy 发了“如何退出 Vim 编辑器”求救。6 年过去了,这个帖子已经有 170 万的阅读了。(2017 年 5 月 24 日,Stack Overflow 官方博客还专门发文纪念了该贴阅读量突破 100 百万次)


via: http://turnoff.us/geek/escape-room/

作者:Daniel Stori 译者 & 点评:wxy 校对 & 合成:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

了解自动化,使用 Git 存储库以及参数化 Jenkins 管道。

本文涵盖了三个关键主题:自动化 CI/CD 配置、使用 Git 存储库处理常见的 CI/CD 工件、参数化 Jenkins 管道。

术语

首先,我们定义一些术语。CI/CD 是允许团队快速自动化测试、打包、部署其应用程序的实践。它通常通过利用名为 Jenkins 的服务器来实现,该服务器充当 CI/CD 协调器。Jenkins 侦听特定输入(通常是代码签入后的 Git 挂钩),并在触发时启动一个管道。

管道 pipeline 由开发和/或运营团队编写的代码组成,这些代码指导 Jenkins 在 CI/CD 过程中采取哪些操作。这个流水线通常类似于“构建我的代码,然后测试我的代码,如果这些测试通过,则把我的应用程序部署到下一个最高环境(通常是开发、测试或生产环境)”。组织通常具有更复杂的管道,并入了诸如工件存储库和代码分析器之类的工具,这里提供了一个高级示例。

现在我们了解了关键术语,让我们深入研究一些最佳实践。

1、自动化是关键

要在 PaaS 上运行 CI/CD,需要在集群上配置适当的基础设施。在这个例子中,我将使用 OpenShift。

“Hello, World” 的实现很容易实现。简单地运行 oc new-app jenkins-<persistent/ephemeral>,然后,你就有了一个已经就绪的运行中的 Jenkins 服务器了。然而,在企业中的使用要复杂得多。除了 Jenkins 服务器之外,管理员通常还需要部署代码分析工具(如 SonarQube)和工件库(如 Nexus)。然后,它们必须创建管道来执行 CI/CD 和 Jenkins 从服务器,以减少主服务器的负载。这些实体中的大多数都由 OpenShift 资源支持,需要创建这些资源来部署所需的 CI/CD 基础设施。

最后,部署 CI/CD 组件所需要的手动步骤可能是需要重复进行的,而且你可能不想成为执行那些重复步骤的人。为了确保结果能够像以前一样快速、无错误和准确地产生,应该在创建基础设施的方式中结合自动化方法。这可以是一个 Ansible 剧本、一个 Bash 脚本,或者任何您希望自动化 CI/CD 基础设施部署的其它方式。我已经使用 Ansible 和 OpenShift-Applier 角色来自动化我的实现。您可能会发现这些工具很有价值,或者您可能会发现其他一些对您和组织更有效的工具。无论哪种方式,您都将发现自动化显著地减少了重新创建 CI/CD 组件所需的工作量。

配置 Jenkins 主服务器

除了一般的“自动化”之外,我想单独介绍一下 Jenkins 主服务器,并讨论管理员如何利用 OpenShift 来自动化配置 Jenkins。来自 Red Hat Container Catalog 的 Jenkins 镜像已经安装了 OpenShift-Sync plugin。在 该视频 中,我们将讨论如何使用这个插件来创建 Jenkins 管道和从设备。

要创建 Jenkins 管道,请创建一个类似于下面的 OpenShift BuildConfig:

apiVersion: v1
kind: BuildConfig
...
spec:  
  source:      
    git:  
      ref: master      
      uri: <repository-uri>  
  ...  
  strategy:    
    jenkinsPipelineStrategy:    
      jenkinsfilePath: Jenkinsfile      
    type: JenkinsPipeline

OpenShift-Sync 插件将注意到已经创建了带有 jenkinsPipelineStrategy 策略的 BuildConfig,并将其转换为 Jenkins 管道,从 Git 源指定的 Jenkinsfile 中提取。也可以使用内联 Jenkinsfile,而不是从 Git 存储库中提取。有关更多信息,请参阅文档。

要创建 Jenkins 从站,请创建一个 OpenShift ImageStream,它从以下定义开始:

apiVersion: v1
kind: ImageStream
metadata:
  annotations:
    slave-label: jenkins-slave
    labels:
      role: jenkins-slave
...

注意在这个 ImageStream 中定义的元数据。OpenShift-Sync 插件将把带有标签 role: jenkins-slave 的任何 ImageStream 转换为 Jenkins 从站。Jenkins 从站将以 slave-label 注释中的值命名。

ImageStreams 对于简单的 Jenkins 从属配置工作得很好,但是一些团队会发现有必要配置一些细节详情,比如资源限制、准备就绪和活动性探测,以及实例上限。这就是 ConfigMap 发挥作用的地方:

apiVersion: v1
kind: ConfigMap
metadata:
  labels:
  role: jenkins-slave
...
data:
  template1: |-
    <Kubernetes pod template>

注意,仍然需要角色:jenkins-slave 标签来将 ConfigMap 转换为 Jenkins 从站。Kubernetes pod 模板由一长段 XML 组成,它将根据组织的喜好配置每个细节。要查看此 XML,以及有关将 ImageStreams 和 ConfigMaps 转换为 Jenkins 从站的更多信息,请参阅文档。

请注意上面所示的三个示例,其中没有一个操作需要管理员对 Jenkins 控制台进行手动更改。通过使用 OpenShift 资源,可以简单的自动化方式配置 Jenkins。

2、分享就是关爱

第二个最佳实践是维护一个公共 CI/CD 工件的 Git 存储库。主要思想是防止团队重新发明轮子。假设您的团队需要执行到 OpenShift 环境的蓝/绿部署,作为管道 CD 阶段的一部分。负责编写管道的团队成员可能不是 OpenShift 专家,也不可能具有从头开始编写此功能的能力。幸运的是,有人已经编写了一个将此功能合并到一个公共 CI/CD 存储库中的函数,因此您的团队可以使用该函数而不是花时间编写一个函数。

为了更进一步,您的组织可能决定维护整个管道。您可能会发现团队正在编写具有相似功能的管道。对于那些团队来说,使用来自公共存储库的参数化管道要比从头开始编写自己的管道更有效。

3、少即是多

正如我在前一节中提到的,第三个也是最后一个最佳实践是参数化您的 CI/CD 管道。参数化将防止过多的管道,使您的 CI/CD 系统更容易维护。假设我有多个区域可以部署应用程序。如果没有参数化,我需要为每个区域设置单独的管道。

要参数化一个作为 OpenShift 构建配置编写的管道,请将 env 节添加到配置:

...
spec:
  ...
  strategy:
    jenkinsPipelineStrategy:
      env:
      - name: REGION
        value: US-West          
      jenkinsfilePath: Jenkinsfile      
    type: JenkinsPipeline

使用此配置,我可以传递 REGION 参数给管道以将我的应用程序部署到指定区域。

这有一个视频提供了一个更实质性的情况,其中参数化是必须的。一些组织决定把他们的 CI/CD 管道分割成单独的 CI 和 CD 管道,通常是因为在部署之前有一些审批过程。假设我有四个镜像和三个不同的环境要部署。如果没有参数化,我需要 12 个 CD 管道来允许所有部署可能性。这会很快失去控制。为了使 CD 流水线的维护更容易,组织会发现将镜像和环境参数化以便允许一个流水线执行多个流水线的工作会更好。

总结

企业级的 CI/CD 往往比许多组织预期的更加复杂。幸运的是,对于 Jenkins,有很多方法可以无缝地提供设置的自动化。维护一个公共 CI/CD 工件的 Git 存储库也会减轻工作量,因为团队可以从维护的依赖项中提取而不是从头开始编写自己的依赖项。最后,CI/CD 管道的参数化将减少必须维护的管道的数量。

如果您找到了其他不可或缺的做法,请在评论中分享。


via: https://opensource.com/article/18/11/best-practices-cicd

作者:Austin Dewey 选题:lujun9972 译者:ChiZelin 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出