标签 Go 下的文章

写 Go 的人往往对它的错误处理模式有一定的看法。按不同的语言经验,人们可能有不同的习惯处理方法。这就是为什么我决定要写这篇文章,尽管有点固执己见,但我认为听取我的经验是有用的。我想要讲的主要问题是,很难去强制执行良好的错误处理实践,错误经常没有堆栈追踪,并且错误处理本身太冗长。不过,我已经看到了一些潜在的解决方案,或许能帮助解决一些问题。

与其他语言的快速比较

在 Go 中,所有的错误都是值。因为这点,相当多的函数最后会返回一个 error, 看起来像这样:

func (s *SomeStruct) Function() (string, error)

因此这导致调用代码通常会使用 if 语句来检查它们:

bytes, err := someStruct.Function()
if err != nil {
  // Process error
}

另外一种方法,是在其他语言中,如 Java、C#、Javascript、Objective C、Python 等使用的 try-catch 模式。如下你可以看到与先前的 Go 示例类似的 Java 代码,声明 throws 而不是返回 error:

public String function() throws Exception

它使用的是 try-catch 而不是 if err != nil:

try {
  String result = someObject.function()
  // continue logic
}
catch (Exception e) {
  // process exception
}

当然,还有其他的不同。例如,error 不会使你的程序崩溃,然而 Exception 会。还有其他的一些,在本篇中会专门提到这些。

实现集中式错误处理

退一步,让我们看看为什么要在一个集中的地方处理错误,以及如何做到。

大多数人或许会熟悉的一个例子是 web 服务 - 如果出现了一些未预料的的服务端错误,我们会生成一个 5xx 错误。在 Go 中,你或许会这么实现:

func init() {
    http.HandleFunc("/users", viewUsers)
    http.HandleFunc("/companies", viewCompanies)
}

func viewUsers(w http.ResponseWriter, r *http.Request) {
    user // some code
    if err := userTemplate.Execute(w, user); err != nil {
        http.Error(w, err.Error(), 500)
    }
}

func viewCompanies(w http.ResponseWriter, r *http.Request) {
    companies = // some code
    if err := companiesTemplate.Execute(w, companies); err != nil {
        http.Error(w, err.Error(), 500)
    }
}

这并不是一个好的解决方案,因为我们不得不重复地在所有的处理函数中处理错误。为了能更好地维护,最好能在一处地方处理错误。幸运的是,在 Go 语言的官方博客中,Andrew Gerrand 提供了一个替代方法,可以完美地实现。我们可以创建一个处理错误的 Type:

type appHandler func(http.ResponseWriter, *http.Request) error

func (fn appHandler) ServeHTTP(w http.ResponseWriter, r *http.Request) {
    if err := fn(w, r); err != nil {
        http.Error(w, err.Error(), 500)
    }
}

这可以作为一个封装器来修饰我们的处理函数:

func init() {
    http.Handle("/users", appHandler(viewUsers))
    http.Handle("/companies", appHandler(viewCompanies))
}

接着我们需要做的是修改处理函数的签名来使它们返回 errors。这个方法很好,因为我们做到了 DRY 原则,并且没有重复使用不必要的代码 - 现在我们可以在单独一个地方返回默认错误了。

错误上下文

在先前的例子中,我们可能会收到许多潜在的错误,它们中的任何一个都可能在调用堆栈的许多环节中生成。这时候事情就变得棘手了。

为了演示这点,我们可以扩展我们的处理函数。它可能看上去像这样,因为模板执行并不是唯一一处会发生错误的地方:

func viewUsers(w http.ResponseWriter, r *http.Request) error {
    user, err := findUser(r.formValue("id")) 
    if err != nil {
      return err;
    }
    return userTemplate.Execute(w, user);
}

调用链可能会相当深,在整个过程中,各种错误可能在不同的地方实例化。Russ Cox的这篇文章解释了如何避免遇到太多这类问题的最佳实践:

“在 Go 中错误报告的部分约定是函数包含相关的上下文,包括正在尝试的操作(比如函数名和它的参数)。”

这个给出的例子是对 OS 包的一个调用:

err := os.Remove("/tmp/nonexist")
fmt.Println(err)

它会输出:

remove /tmp/nonexist: no such file or directory

总结一下,执行后,输出的是被调用的函数、给定的参数、特定的出错信息。当在其他语言中创建一个 Exception 消息时,你也可以遵循这个实践。如果我们在 viewUsers 处理中坚持这点,那么几乎总是能明确错误的原因。

问题来自于那些不遵循这个最佳实践的人,并且你经常会在第三方的 Go 库中看到这些消息:

Oh no I broke

这没什么帮助 - 你无法了解上下文,这使得调试很困难。更糟糕的是,当这些错误被忽略或返回时,这些错误会被备份到堆栈中,直到它们被处理为止:

if err != nil {
  return err
}

这意味着错误何时发生并没有被传递出来。

应该注意的是,所有这些错误都可以在 Exception 驱动的模型中发生 - 糟糕的错误信息、隐藏异常等。那么为什么我认为该模型更有用?

即便我们在处理一个糟糕的异常消息,我们仍然能够了解它发生在调用堆栈中什么地方。因为堆栈跟踪,这引发了一些我对 Go 不了解的部分 - 你知道 Go 的 panic 包含了堆栈追踪,但是 error 没有。我推测可能是 panic 会使你的程序崩溃,因此需要一个堆栈追踪,而处理错误并不会,因为它会假定你在它发生的地方做一些事。

所以让我们回到之前的例子 - 一个有糟糕错误信息的第三方库,它只是输出了调用链。你认为调试会更容易吗?

panic: Oh no I broke
[signal 0xb code=0x1 addr=0x0 pc=0xfc90f]

goroutine 1103 [running]:
panic(0x4bed00, 0xc82000c0b0)
/usr/local/go/src/runtime/panic.go:481 +0x3e6
github.com/Org/app/core.(_app).captureRequest(0xc820163340, 0x0, 0x55bd50, 0x0, 0x0)
/home/ubuntu/.go_workspace/src/github.com/Org/App/core/main.go:313 +0x12cf
github.com/Org/app/core.(_app).processRequest(0xc820163340, 0xc82064e1c0, 0xc82002aab8, 0x1)
/home/ubuntu/.go_workspace/src/github.com/Org/App/core/main.go:203 +0xb6
github.com/Org/app/core.NewProxy.func2(0xc82064e1c0, 0xc820bb2000, 0xc820bb2000, 0x1)
/home/ubuntu/.go_workspace/src/github.com/Org/App/core/proxy.go:51 +0x2a
github.com/Org/app/core/vendor/github.com/rusenask/goproxy.FuncReqHandler.Handle(0xc820da36e0, 0xc82064e1c0, 0xc820bb2000, 0xc5001, 0xc820b4a0a0)
/home/ubuntu/.go_workspace/src/github.com/Org/app/core/vendor/github.com/rusenask/goproxy/actions.go:19 +0x30

我认为这可能是 Go 的设计中被忽略的东西 - 不是所有语言都不会忽视的。

如果我们使用 Java 作为一个随意的例子,其中人们犯的一个最愚蠢的错误是不记录堆栈追踪:

LOGGER.error(ex.getMessage()) // 不记录堆栈追踪
LOGGER.error(ex.getMessage(), ex) // 记录堆栈追踪

但是 Go 似乎在设计中就没有这个信息。

在获取上下文信息方面 - Russ 还提到了社区正在讨论一些潜在的接口用于剥离上下文错误。关于这点,了解更多或许会很有趣。

堆栈追踪问题解决方案

幸运的是,在做了一些查找后,我发现了这个出色的 Go 错误库来帮助解决这个问题,来给错误添加堆栈跟踪:

if errors.Is(err, crashy.Crashed) {
  fmt.Println(err.(*errors.Error).ErrorStack())
}

不过,我认为这个功能如果能成为语言的 第一类公民 first class citizenship 将是一个改进,这样你就不必做一些类型修改了。此外,如果我们像先前的例子那样使用第三方库,它可能没有使用 crashy - 我们仍有相同的问题。

我们对错误应该做什么?

我们还必须考虑发生错误时应该发生什么。这一定有用,它们不会让你的程序崩溃,通常也会立即处理它们:

err := method()
if err != nil {
  // some logic that I must do now in the event of an error!
}

如果我们想要调用大量方法,它们会产生错误,然后在一个地方处理所有错误,这时会发生什么?看上去像这样:

err := doSomething()
if err != nil {
  // handle the error here
}

func doSomething() error {
  err := someMethod()
  if err != nil {
    return err
  }
  err = someOther()
  if err != nil {
    return err
  }
  someOtherMethod()
}

这感觉有点冗余,在其他语言中你可以将多条语句作为一个整体处理。

try {
  someMethod()
  someOther()
  someOtherMethod()
}
catch (Exception e) {
  // process exception
}

或者只要在方法签名中传递错误:

public void doSomething() throws SomeErrorToPropogate {
  someMethod()
  someOther()
  someOtherMethod()
}

我个人认为这两个例子实现了一件事情,只是 Exception 模式更少冗余,更加弹性。如果有什么的话,我觉得 if err!= nil 感觉像样板。也许有一种方法可以清理?

将失败的多条语句做为一个整体处理错误

首先,我做了更多的阅读,并在 Rob Pike 写的 Go 博客中发现了一个比较务实的解决方案。

他定义了一个封装了错误的方法的结构体:

type errWriter struct {
    w   io.Writer
    err error
}

func (ew *errWriter) write(buf []byte) {
    if ew.err != nil {
        return
    }
    _, ew.err = ew.w.Write(buf)
}

让我们这么做:

ew := &errWriter{w: fd}
ew.write(p0[a:b])
ew.write(p1[c:d])
ew.write(p2[e:f])
// and so on
if ew.err != nil {
    return ew.err
}

这也是一个很好的方案,但是我感觉缺少了点什么 - 因为我们不能重复使用这个模式。如果我们想要一个含有字符串参数的方法,我们就不得不改变函数签名。或者如果我们不想执行写操作会怎样?我们可以尝试使它更通用:

type errWrapper struct {
    err error
}
func (ew *errWrapper) do(f func() error) {
    if ew.err != nil {
        return
    }
    ew.err = f();
}

但是我们有一个相同的问题,如果我们想要调用含有不同参数的函数,它就无法编译了。然而你可以简单地封装这些函数调用:

w := &errWrapper{}

w.do(func() error {
    return someFunction(1, 2);
})

w.do(func() error {
    return otherFunction("foo");
})

err := w.err

if err != nil {
// process error here
}

这可以用,但是并没有太大帮助,因为它最终比标准的 if err != nil 检查带来了更多的冗余。如果有人能提供其他解决方案,我会很有兴趣听。或许这个语言本身需要一些方法来以不那么臃肿的方式传递或者组合错误 - 但是感觉似乎是特意设计成不那么做。

总结

看完这些之后,你可能会认为我在对 error 挑刺儿,由此推论我反对 Go。事实并非如此,我只是将它与我使用 try catch 模型的经验进行比较。它是一个用于系统编程很好的语言,并且已经出现了一些优秀的工具。仅举几例,有 Kubernetes、Docker、Terraform、Hoverfly 等。还有小型、高性能、本地二进制的优点。但是,error 难以适应。 我希望我的推论是有道理的,而且一些方案和解决方法可能会有帮助。


作者简介:

Andrew 是 OpenCredo 的顾问,于 2015 年加入公司。Andrew 在多个行业工作多年,开发基于 Web 的企业应用程序。


via: https://opencredo.com/why-i-dont-like-error-handling-in-go

作者:Andrew Morgan 译者:geekpi 校对:jasminepeng

本文由 LCTT 原创编译,Linux中国 荣誉推出

Apex 是一个将开发和部署 AWS Lambda 函数的过程打包了的工具。它提供了一个本地命令行工具来创建安全上下文、部署函数,甚至追踪云端日志。由于 AWS Lambda 服务将函数看成独立的单元,Apex 提供了一个框架层将一系列函数作为一个项目。另外,它将服务拓展到不仅仅是 Java,Javascript 和 Ptyhon 语言,甚至包括 Go 语言。

两年前 Express (基本上是 NodeJS 事实标准上的网络框架层)的作者,离开了 Node 社区,而将其注意力转向 Go (谷歌创造的后端服务语言),以及 Lambda(由 AWS 提供的函数即服务)。尽管一个开发者的行为无法引领一股潮流,但是来看看他正在做的名叫 Apex 项目会很有趣,因为它可能预示着未来很大一部分网络开发的改变。

什么是 Lambda?

如今,人们如果不能使用自己的硬件,他们会选择付费使用一些云端的虚拟服务器。在云上,他们会部署一个完整的协议栈如 Node、Express,和一个自定义应用。或者如果他们更进一步使用了诸如 Heroku 或者 Bluemix 之类的新玩意,也可能在某些已经预配置好 Node 的容器中仅仅通过部署应用代码来部署他们完整的应用。

在这个抽象的阶梯上的下一步是单独部署函数到云端而不是一个完整的应用。这些函数之后可以被一大堆外部事件触发。例如,AWS 的 API 网关服务可以将代理 HTTP 请求作为触发函数的事件,而函数即服务(FaaS)的供应方根据要求执行匹配的函数。

Apex 起步

Apex 是一个将 AWS 命令行接口封装起来的命令行工具。因此,开始使用 Apex 的第一步就是确保你已经安装和配置了从 AWS 获取的命令行工具(详情请查看 AWS CLI Getting Started 或者 Apex documentation)。

接下来,安装 Apex:

curl https://raw.githubusercontent.com/apex/apex/master/install.sh | sh

然后为你的新项目创建一个目录并运行:

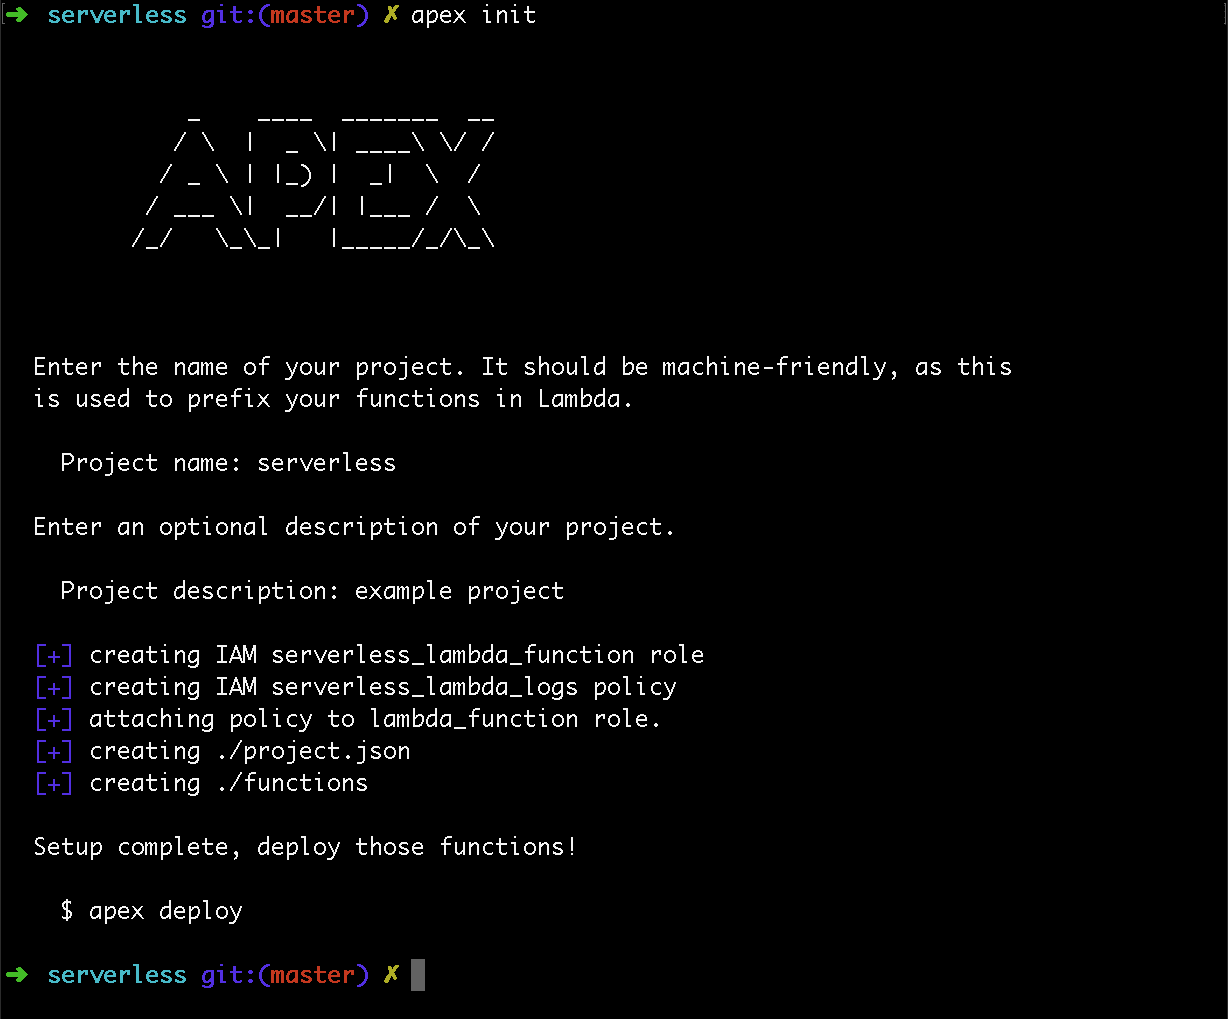
apex init

apexInit

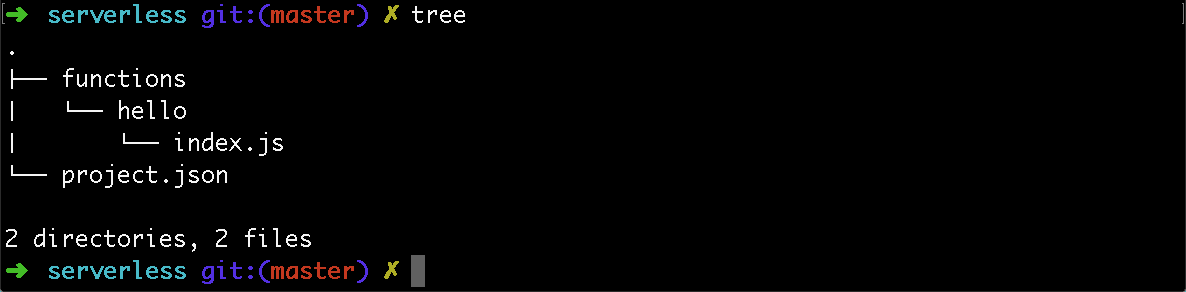
这步会配置好一些必须的安全策略,并且将项目名字附在函数名后,因为 Lambda 使用扁平化的命名空间。同时它也会创建一些配置文件和默认的 “Hello World" 风格的 Javascript 函数的 functions 目录。

tree

Apex/Lambda 一个非常友好的特性是创建函数非常直观。创建一个以你函数名为名的新目录,然后在其中创建项目。如果想要使用 Go 语言,你可以创建一个叫 simpleGo 的目录然后在其中创建一个小型的 main 函数:

//  serverless/functions/simpleGo/main.go
package main

import (  
    "encoding/json"
    "github.com/apex/go-apex"
    "log"
)

type helloEvent struct {  
    Hello string `json:"hello"`
}

func main() {  
    apex.HandleFunc(func(event json.RawMessage, ctx *apex.Context) (interface{}, error) {
        var h helloEvent
        if err := json.Unmarshal(event, &h); err != nil {
            return nil, err
        }
        log.Print("event.hello:", h.Hello)
        return h, nil
    })
}

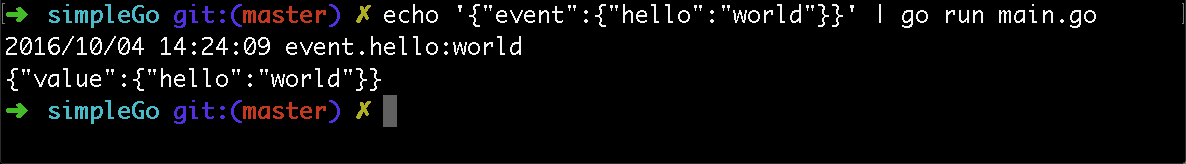
Node 是 Lambda 所支持的运行环境,Apex 使用 NodeJS shim 来调用由上述程序产生的二进制文件。它将 event 传入二进制文件的 STDIN,将从二进制返回的 STDOUT 作为 value。通过 STDERR 来显示日志。apex.HandleFunc 用来为你管理所有的管道。事实上在 Unix 惯例里这是一个非常简单的解决方案。你甚至可以通过在本地命令行执行 go run main.go 来测试它。

goRun

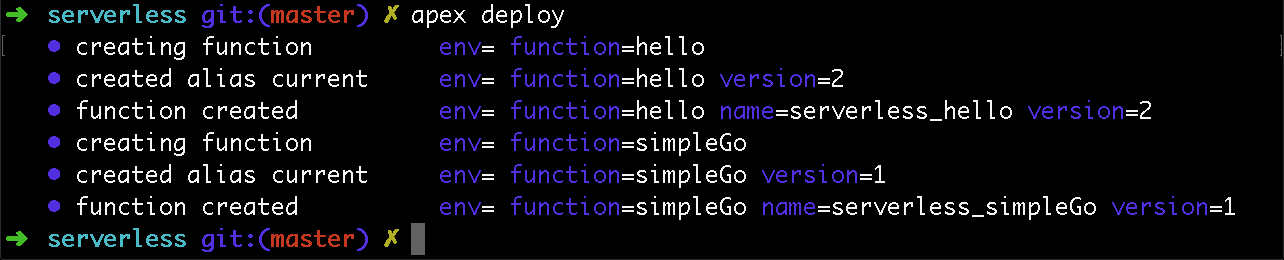
通过 Apex 向云端部署稍显琐碎:

apexDeploy

注意,这将会对你的函数指定命名空间,控制版本,甚至为其他多开发环境如 staging 和 production配置env。

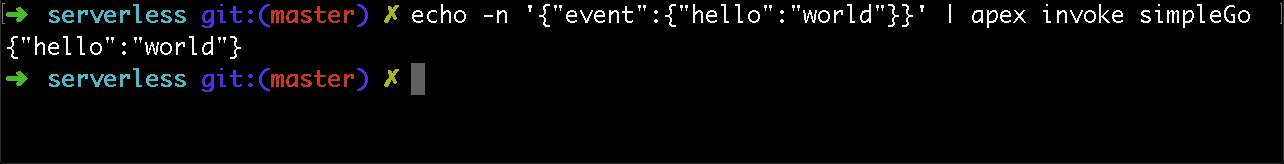
通过 apex invoke 在云端执行也比较琐碎:

apexInvoke

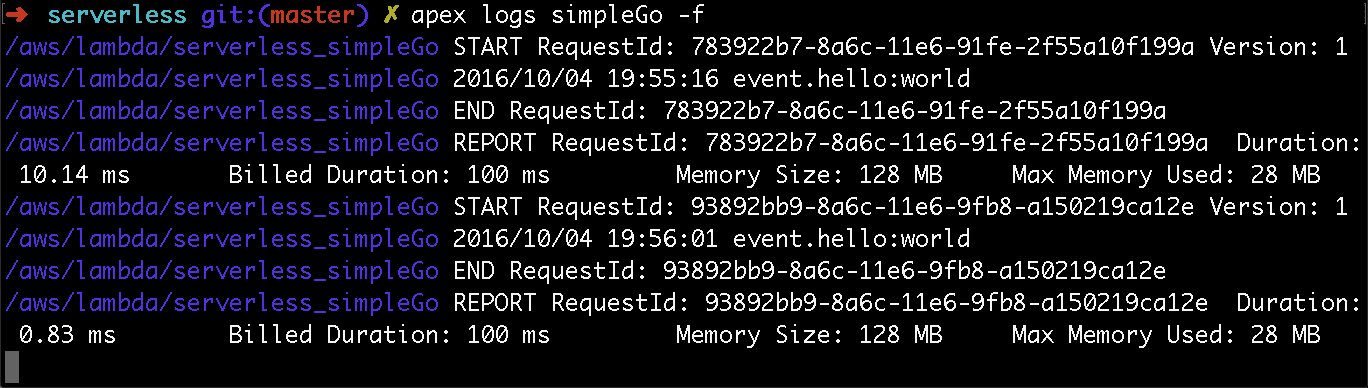
当然我们也可以追踪一些日志:

apexLog

这些是从 AWS CloudWatch 返回的结果。它们都在 AWS 的 UI 中可见,但是当在另一个终端参照此结果来署它会更快。

窥探内部的秘密

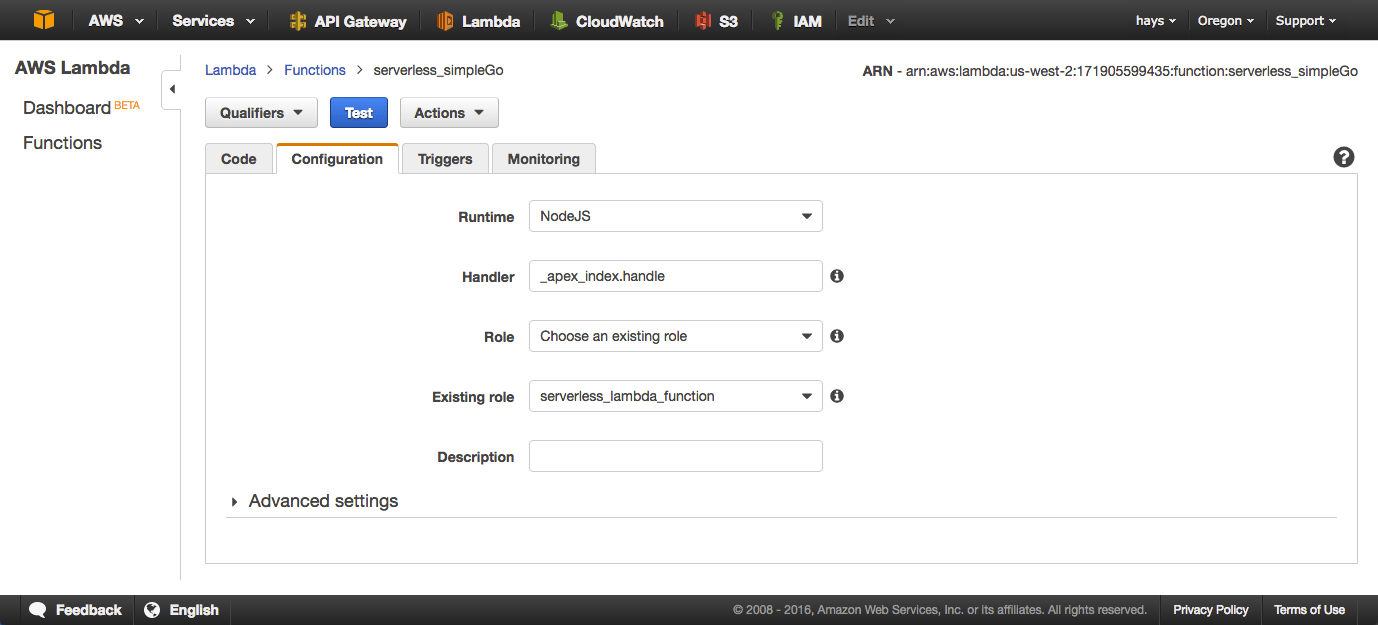
来看看它内部到底部署了什么很具有指导性。Apex 将 shim 和所有需要用来运行函数的东西打包起来。另外,它会提前做好配置如入口与安全条例:

lambdaConfig

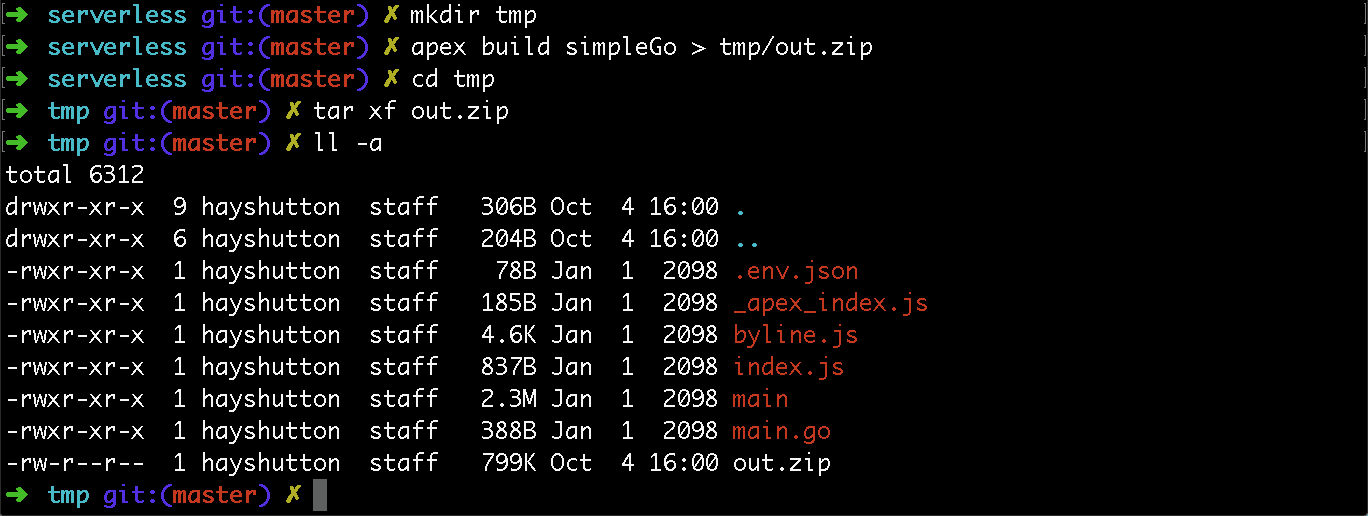
Lambda 服务实际上接受一个包含所有依赖的 zip 压缩包,它会被部署到服务器来执行指定的函数。我们可以使用 apex build <functionName> 在本地创建一个压缩包用来在以后解压以探索。

apexBuild

这里的 _apex_index.js handle 函数是原始的入口。它会配置好一些环境变量然后进入 index.js。

而 index.js 孕育一个 main Go 的二进制文件的子进程并且将所有关联联结在一起。

使用 mgo 继续深入

mgo 是 Go 语言的 MongoDB 驱动。使用 Apex 来创建一个函数来连接到 Compose 的 MongoDB 就如同我们已经学习过的 simpleGo 函数一样直观。这里我们会通过增加一个 mgoGo 目录和另一个 main.go 来创建一个新函数。

// serverless/functions/mgoGo/main.go

package main

import (  
    "crypto/tls"
    "encoding/json"
    "github.com/apex/go-apex"
    "gopkg.in/mgo.v2"
    "log"
    "net"
)

type person struct {  
  Name  string `json:"name"`
  Email string `json:"email"`
}

func main() {  
    apex.HandleFunc(func(event json.RawMessage, ctx *apex.Context) (interface{}, error) {
        tlsConfig := &tls.Config{}
        tlsConfig.InsecureSkipVerify = true

        //connect URL:
        // "mongodb://<username>:<password>@<hostname>:<port>,<hostname>:<port>/<db-name>
        dialInfo, err := mgo.ParseURL("mongodb://apex:[email protected]:15188, aws-us-west-2-portal.1.dblayer.com:15188/signups")
        dialInfo.DialServer = func(addr *mgo.ServerAddr) (net.Conn, error) {
            conn, err := tls.Dial("tcp", addr.String(), tlsConfig)
            return conn, err
        }
        session, err := mgo.DialWithInfo(dialInfo)
        if err != nil {
            log.Fatal("uh oh. bad Dial.")
            panic(err)
        }
        defer session.Close()
        log.Print("Connected!")

    var p person
    if err := json.Unmarshal(event, &p); err != nil {
            log.Fatal(err)
    }

        c := session.DB("signups").C("people")
        err = c.Insert(&p) 
        if err != nil {
            log.Fatal(err)
        }

    log.Print("Created: ", p.Name," - ", p.Email)
        return p, nil
    })
}

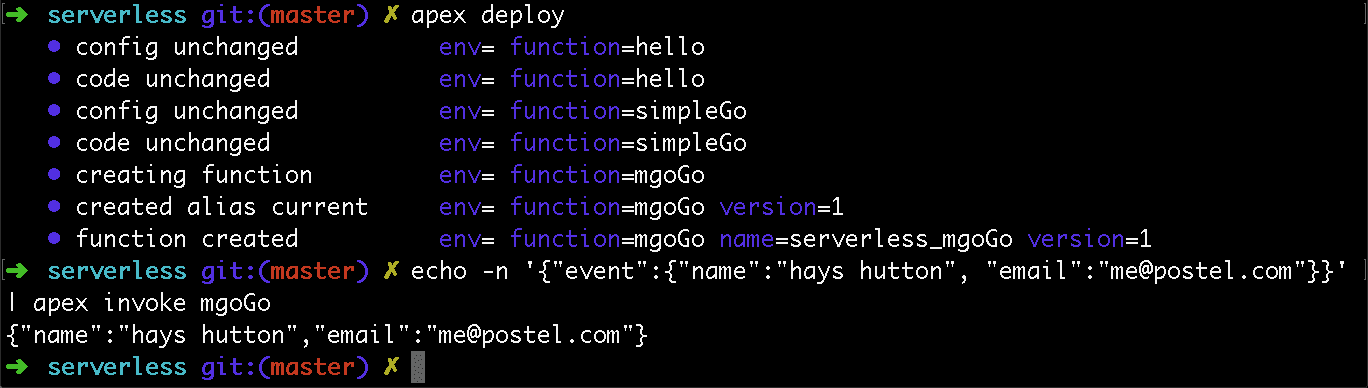
发布部署,我们可以通过使用正确类型的事件来模拟调用了一个 API:

apexMgo

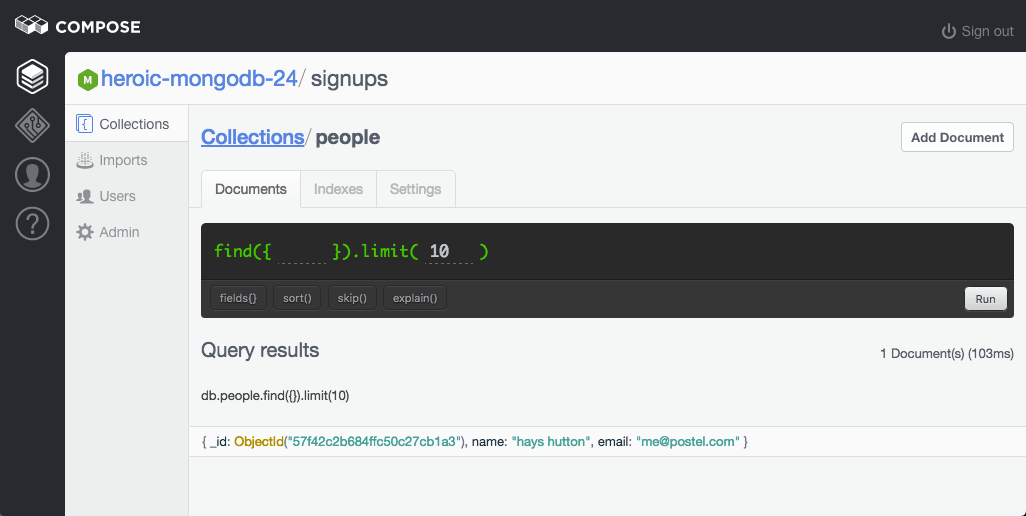
最终结果是 insert 到在 Compose 之上 的 MongoDB 中。

composeDeploy

还有更多……

尽管目前我们已经涉及了 Apex 的方方面面,但是仍然有很多值得我们去探索的东西。它还和 Terraform 进行了整合。如果你真的希望,你可以发布一个多语言项目包括 Javascript、Java、Python 以及 Go。你也可以为开发、演示以及产品环境配置多种环境。你可以调整运行资源如调整存储大小和运行时间来调整成本。而且你可以把函数勾连到 API 网关上来传输一个 HTTP API 或者使用一些类似 SNS (简单通知服务)来为云端的函数创建管道。

和大多数事物一样,Apex 和 Lambda 并不是在所有场景下都完美。 但是,在你的工具箱中增加一个完全不需要你来管理底层建设的工具完全没有坏处。


作者简介:

Hays Hutton 喜欢写代码并写一些与其相关的东西。喜欢这篇文章?请前往Hays Hutton’s author page 继续阅读其他文章。


via: https://www.compose.com/articles/go-serverless-with-apex-and-composes-mongodb/

作者:Hays Hutton 译者:xiaow6 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

我们公司 Mobile Jazz 从一个内部试验性项目开始使用 Go。如公司名暗示的那样,我们是开发移动应用的。

在发布一个应用给公众后,我们很快意识到我们缺失一个工具来检查用户实际发生的情况以及他们是如何与应用交互的 - 如果有任何问题或者 bug 的报告,这将会相当方便。

现在有几款工具声称能在这个方面帮助开发者,但是没有一个能完全满足要求,因此我们决定自己构建一个。我们开始创建一组基础的脚本,如今它很快进化成了完整的工具,称为 Bugfender!

由于这最初是一个实验,我们决定使用一种新的趋势技术。对学习以及持续教育的热爱是 Mobile Jazz 的核心价值的之一,因此我们决定使用 Go 构建。这是一个由 Google 开发的相对较新的编程语言。它是编程世界的的新玩家,已经有许多受尊敬的开发者对它赞不绝口。

一年后,这个实验变成了一个初创项目,我们拥有了一个已经帮助了来自全世界的数以千计的开发者的令人难以置信的工具。我们的服务器每天处理来自 700 万台设备的超过 200GB 的数据。

在使用 Go 一年之后,我们想要分享我们将一个小小的实验变成处理百万日志的生产服务器的一些想法和经验。

Go 生态系统

公司中没有人有使用 Go 的经验。Bugfender 是我们第一次深入这个语言。

学习基本上相当直接的。我们之前在 C/C++/Java/Objective-C/PHP 的经验让我们学习 Go 相当快,并且在几天内就开始开发了。当然会有一些新的和不常见的东西需要学习,包括 GOPATH 还有如何处理包,但这在我们的预期之内。

几天之内,我们意识到即使是一个以简化为设计目的的语言,Go 也是非常强大的。它能够做任何现代编程语言应该能做的事:能够处理 JSON、服务器之间通讯甚至访问数据库也没问题(并且只需要几行代码)。

在构建一个服务器时,你应该首先决定是否使用任何第三方库或者框架。对于 Bugfender,我们决定使用:

Martini

Martini 是一个强大的 Go 的 web 框架。我们开始这个实验时,它是一个很棒的解决方案,至今也是,我们还没遇到任何问题。然而如果我们今天再次开始这个实验的话,我们会选择一个不同的框架,因为 Martini 不在维护了。

我们还试验了 Iris(我们目前的最爱)还有 Gin。Gin 是 Martini 继任者,并且迁移到这上能让我们重用已有的代码。

在过去的一年中,我们意识到 Go 的标准库是非常强大的,你不必依靠一个臃肿的 web 框架来构建一个服务器。最好在特定任务上使用专门的高性能库。

Iris 是我们目前最喜欢的,并且将来我们将使用它重写服务来替代 Martini/Gin,但这目前并不是优先的。

修改: 在讨论了 Iris 的各个方面之后,我们意识到 Iris 或许不是最好的选择。如果我们决定重写我们的 web 组件,我们或许会研究其他的选择,我们欢迎你的建议。

Gorm

有些人喜欢 ORM,而有些人则不喜欢。我们决定使用 ORM,更确切地说是 GORM。我们的实现只针对 web 前端,对于日志提取 API 仍然继续使用手工优化的 SQL。在一开始,我们确实很喜欢它,但是随着时间的推移,我们开始发现问题,并且我们很快将它从代码中完全移除,并且使用 sqlx 这个标准 SQL 库。

GORM 的一个主要问题是 Go 的生态系统。作为一个新语言,自我们开始开发产品以来 Go 已经有很多新版本。在这些新版本中的一些改变并不向后兼容,因此要使用最新的库版本,我们要经常重写已有代码并检查我们为解决版本问题所做的 hack。

上述这两个库是大多数 web 服务的主要组件,因此做一个好的选择很重要,因为将来更改会很困难,并且会影响你服务器的性能。

第三方服务

在创建一个实际使用的产品的另外一个重要方面是考虑库、第三方服务和工具的可用性。在这方面,Go 还缺乏成熟度,大多数公司还没有提供 Go 库,因此你或许需要依赖其他人写的不能一直保证质量的库。

比如,对于使用 Redis 和 ElasticSearch 有很好的库,但是对于其他服务比如 Mixpanel 或者 Stripe 还没有好的。

我们建议在使用 Go 之前事先检查对于你需要的产品是否有好的库可用。

我们在 Go 的包管理系统上也遇到了很多问题。它处理版本的方式远没有达到最好,并且在过去的一年中,我们在不同的团队成员之间使用同一个库的不同版本上遇到了很多问题。然而,最近要归功于 Go 新支持的 vendor 包特性,除了 gopkg.in 服务外,这个问题基本被解决了。

开发者工具

由于 Go 是一门相对新的语言,你或许发现相比其他成熟的语言像 Java,它可用的开发工具并不很好。当我们开始 Bugfender 时,使用任何 IDE 都很困难,似乎没有 IDE 支持 Go。但是在过去的一年中,随着 IntelliJ 和 Visual Studio Code Go 插件的引入,这一切改善了很多。

最后看下其他的 Go 工具,调试器并不很好,而分析器甚至更糟,因此有时调试你的代码或者尝试优化它会很困难。

前往生产

这确实是 Go 最好的东西之一,如果你想要部署一些东西到生产环境中,你只需要构建你的二进制并发送到服务器中,没有依赖,不需要安装额外的软件,你只需要能在服务器中运行二进制文件就行。

如果你习惯于处理那些需要包管理器或者需要小心你使用的语言解释器的语言,用 Go 工作会感到很高兴。

我们对 Go 的稳定性也很满意,因为服务器似乎从没有崩溃过。我们在发送大量数据给 Go Routines 时遇到过一个问题,但是我们几乎没见到任何崩溃。注意:如果你需要发送大量数据给 Go Routine,你需要小心堆溢出。

如果你对性能感兴趣,我们没法与其他语言相比较,因为我们从零开始使用 Go,但是对于我们处理的数据量,我们感觉性能是非常好的,我们绝对不能如此轻松地使用 PHP 处理同等数量的请求。

总结

在过去的一年中,我们对 Go 的感觉起起伏伏。最初我们是兴奋的,但是在实验变成真实的产品后我们开始发现问题。我们几次考虑过用 Java 完全重写,但是目前为止,仍旧使用的是 Go,并且过去的一年中, Go 生态已经有了很大的提升,这简化了我们的工作。

如果你想要使用 Go 构建你的产品,你可以保证它可以工作,但是你确实需要小心一件事:可以雇佣的开发者。硅谷中只有很少的高级 Go 开发者,并且在其他地方寻找也是一件非常困难的任务。


via: https://bugfender.com/one-year-using-go

作者:ALEIX VENTAYOL 译者:geekpi 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

LCTT 译注: 终端节点 ( Endpoint ) ,详情请见: http://docs.amazonaws.cn/general/latest/gr/rande.html

最新发布的 GO 的 SDK v1.6.0 版本,加入了获取区域与终端节点信息的功能。它可以很方便地列出区域、服务和终端节点的相关信息。可以通过 github.com/aws/aws-sdk-go/aws/endpoints 包使用这些功能。

endpoints 包提供了一个易用的接口,可以获取到一个服务的终端节点的 url 列表和区域列表信息。并且我们将相关信息根据 AWS 服务区域进行了分组,如 AWS 标准、AWS 中国和 AWS GovCloud(美国)。

解析终端节点

设置 SDK 的默认配置时, SDK 会自动地使用 endpoints.DefaultResolver 函数。你也可以自己调用包中的EndpointFor 方法来解析终端节点。

// 解析在us-west-2区域的S3服务的终端节点
resolver := endpoints.DefaultResolver()
endpoint, err := resolver.EndpointFor(endpoints.S3ServiceID, endpoints.UsWest2RegionID)
if err != nil {
        fmt.Println("failed to resolve endpoint", err)
        return
}

fmt.Println("Resolved URL:", endpoint.URL)

如果你需要自定义终端节点的解析逻辑,你可以实现 endpoints.Resolver 接口,并传值给aws.Config.EndpointResolver。当你打算编写自定义的终端节点逻辑,让 SDK 可以用来解析服务的终端节点时候,这个功能就会很有用。

以下示例,创建了一个配置好的 Session,然后 Amazon S3 服务的客户端就可以使用这个自定义的终端节点。

s3CustResolverFn := func(service, region string, optFns ...func(*endpoints.Options)) (endpoints.ResolvedEndpoint, error) {
        if service == "s3" {
               return endpoints.ResolvedEndpoint{
                       URL:           "s3.custom.endpoint.com",
                       SigningRegion: "custom-signing-region",
               }, nil
        }

        return defaultResolver.EndpointFor(service, region, optFns...)
}
sess := session.Must(session.NewSessionWithOptions(session.Options{
        Config: aws.Config{
               Region:           aws.String("us-west-2"),
               EndpointResolver: endpoints.ResolverFunc(s3CustResolverFn),
        },
}))

分区

endpoints.DefaultResolver 函数的返回值可以被 endpoints.EnumPartitions接口使用。这样就可以获取 SDK 使用的分区片段,也可以列出每个分区的分区信息。

// 迭代所有分区表打印每个分区的ID
resolver := endpoints.DefaultResolver()
partitions := resolver.(endpoints.EnumPartitions).Partitions()

for _, p := range partitions {
        fmt.Println("Partition:", p.ID())
}

除了分区表之外,endpoints 包也提供了每个分区组的 getter 函数。这些工具函数可以方便列出指定分区,而不用执行默认解析器列出所有的分区。

partition := endpoints.AwsPartition()
region := partition.Regions()[endpoints.UsWest2RegionID]

fmt.Println("Services in region:", region.ID())
for id, _ := range region.Services() {
        fmt.Println(id)
}

当你获取区域和服务值后,可以调用 ResolveEndpoint。这样解析端点时,就可以提供分区的过滤视图。

获取更多 AWS SDK for GO 信息, 请关注其开源仓库。若你有更好的看法,请留言评论。


via: https://aws.amazon.com/cn/blogs/developer/using-the-aws-sdk-for-gos-regions-and-endpoints-metadata

作者:Jason Del Ponte 译者:Vic020 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

几个星期前,我一个朋友问我:“为什么要关心 Go 语言”? 因为他们知道我热衷于 Go 语言,但他们想知道为什么我认为其他人也应该关心。本文包含三个我认为 Go 是重要的编程语言的原因。

安全

个人而言,你和我或许完全有能力在 C 中编写程序,既不会泄漏内存,也不会不安全地重复使用内存。然而,整体上,即使有超过 40 年)的经验,用 C 的程序员也无法可靠地这样做。

尽管静态代码分析、valgrind、tsan 以及 “-Werror” 已经存在了几十年,却很少有证据表明这些工具被广泛认可,更不用说广泛采用。总而言之,事实表明,程序员根本无法安全地管理自己的内存。现在是离开 C 的时候了。

Go 不需要程序员直接管理内存,所有内存分配都由语言运行时自行管理,使用前初始化,必要时检查边界。它肯定不是提供这些安全保障的第一个主流语言,Java(1995)可能是该冠军的竞争者。关键是,世界对不安全的编程语言没有胃口,所以人们默认认为,Go 是内存安全的。

开发人员生产力

从 20 世纪 70 年代末,开发人员的时间变得比硬件所耗费的时间更昂贵了。开发人员的生产力是一个不断扩展的话题,但它归结为这一点:你花了多少时间做有用的工作,又有多少时间等待编译器或者失望地迷失在外部代码库中。

有个笑话说 Go 是在等待 C ++ 程序编译时开发的。快速编译是 Go 的一个重要功能,也是吸引新开发人员的关键工具。虽然编译速度仍然是一个永久的战场,但公平地说,在其他语言中需要几分钟的编译,在 Go 中只需要几秒钟。

Go 程序员意识到生产力的更根本的问题是代码是为了读而写的,所以将代码的阅读行为放在编写之上。Go 通过工具和自定义来强制所有代码格式化成特定的样式。这消除了学习项目特定语言的方言时的困难,并有助于发现错误,因为它们看上去就是不正确。

由于专注于分析和机器辅助,Go 开发人员开始采用越来越多的工具来发现常见的编码错误,这种工具从来没有在 C 语言开发者中产生共鸣 - Go 开发人员希望工具帮助他们保持代码清洁。

并发性

十多年来,芯片设计师一直在警告免费午餐将会结束。从最低端的手机到最耗电的服务器,硬件的并行性以更多、更慢、堆砌 cpu 内核的形式出现,但只有当你的语言可以利用它们才有意义。因此,并发特性需要内置到我们编写的要在今天的硬件上运行的软件中。

通过提供一种基于协程的轻量级并发模型,或者是 Go 中已知的 goroutines,Go 超越了那些暴露操作系统的多进程或多线程并行模型的语言。goroutines 允许程序员避开复杂的回调,而语言运行时确保有足够的线程来保持你的内核的活跃。

总结

我给朋友推荐 Go 有三个原因:安全性、生产力和并发性。有些语言可以涵盖一个也有可能是两个方面,但是这三个方面的结合使得 Go 成为主流程序员的绝佳选择。

相关文章:

  1. 为什么 Go 和 Rust 不是竞争对手
  2. 听听我在 OSCON 上谈 Go 语言性能
  3. 我在 GopherChina 和 GopherCon Singapore 中的演讲
  4. 压力测试你 Go 包

via: https://dave.cheney.net/2017/03/20/why-go

作者:Dave Cheney 译者:geekpi 校对:jasminepeng
本文由 LCTT 原创编译,Linux中国 荣誉推出

这篇文章是关于一个鲜为人知的让 Go 在编译期断言的方法。你可能不会使用它,但是了解一下也很有趣。

作为一个热身,来看一个在 Go 中熟知的编译期断言:接口满意度检查。

在这段代码(playground)中,var _ = 行确保类型 W 是一个 stringWriter,其由 io.WriteString 检查。

package main

import "io"

type W struct{}

func (w W) Write(b []byte) (int, error)       { return len(b), nil }
func (w W) WriteString(s string) (int, error) { return len(s), nil }

type stringWriter interface {
    WriteString(string) (int, error)
}

var _ stringWriter = W{}

func main() {
    var w W
    io.WriteString(w, "very long string")
}

如果你注释掉了 W 的 WriteString 方法,代码将无法编译:

main.go:14: cannot use W literal (type W) as type stringWriter in assignment:
    W does not implement stringWriter (missing WriteString method)

这是很有用的。对于大多数同时满足 io.Writer 和 stringWriter 的类型,如果你删除 WriteString 方法,一切都会像以前一样继续工作,但性能较差。

你可以使用编译期断言保护你的代码,而不是试图使用`testing.T.AllocsPerRun'为性能回归编写一个脆弱的测试。

这是一个实际的 io 包中的技术例子。


好的,让我们低调一点!

接口满意检查是很棒的。但是如果你想检查一个简单的布尔表达式,如 1 + 1 == 2 ?

考虑这个代码(playground):

package main

import "crypto/md5"

type Hash [16]byte

func init() {
    if len(Hash{}) < md5.Size {
        panic("Hash is too small")
    }
}

func main() {
    // ...
}

Hash 可能是某种抽象的哈希结果。init 函数确保它将与 crypto/md5 一起工作。如果你改变 Hash 为(比如说)[8]byte,它会在进程启动时发生崩溃。但是,这是一个运行时检查。如果我们想要早点发现怎么办?

如下。(没有 playground 链接,因为这在 playground 上不起作用。)

package main

import "C"

import "crypto/md5"

type Hash [16]byte

func hashIsTooSmall()

func init() {
    if len(Hash{}) < md5.Size {
        hashIsTooSmall()
    }
}

func main() {
    // ...
}

现在如果你改变 Hash 为 [8]byte,它将在编译过程中失败。(实际上,它在链接过程中失败。足够接近我们的目标了。)

$ go build .
# demo
main.hashIsTooSmall: call to external function
main.init.1: relocation target main.hashIsTooSmall not defined
main.init.1: undefined: "main.hashIsTooSmall"

这里发生了什么?

hashIsTooSmall 是一个没有函数体的声明。编译器假定别人将提供一个实现,也许是一个汇编程序。

当编译器可以证明 len(Hash {})< md5.Size 时,它消除了 if 语句中的代码。结果,没有人使用函数 hashIsTooSmall,所以链接器会消除它。没有其他损害。一旦断言失败,if 语句中的代码将被保留。不会消除 hashIsTooSmall。链接器然后注意到没有人提供了函数的实现然后链接失败,并出现错误,这是我们的目标。

最后一个奇怪的点:为什么是 import "C"? go 工具知道在正常的 Go 代码中,所有函数都必须有主体,并指示编译器强制执行。通过切换到 cgo,我们删除该检查。(如果你在上面的代码中运行 go build -x,而没有添加 import "C" 这行,你会看到编译器是用 -complete 标志调用的。)另一种方法是添加 import "C" 来向包中添加一个名为 foo.s 的空文件。

我仅见过一次这种技术的使用,是在编译器测试套件中。还有其他可以发挥想象力的使用,但我还没见到过。

可能就是这样吧。 :)


via: http://commaok.xyz/post/compile-time-assertions

作者:Josh Bleecher Snyder 译者:geekpi 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出