标签 Go 下的文章

cmd/compile 包含构成 Go 编译器主要的包。编译器在逻辑上可以被分为四个阶段,我们将简要介绍这几个阶段以及包含相应代码的包的列表。

在谈到编译器时,有时可能会听到 前端 front-end 和 后端 back-end 这两个术语。粗略地说,这些对应于我们将在此列出的前两个和后两个阶段。第三个术语 中间端 middle-end 通常指的是第二阶段执行的大部分工作。

请注意,go/parser 和 go/types 等 go/* 系列的包与编译器无关。由于编译器最初是用 C 编写的,所以这些 go/* 包被开发出来以便于能够写出和 Go 代码一起工作的工具,例如 gofmt 和 vet。

需要澄清的是,名称 “gc” 代表 “ Go 编译器 Go compiler ”,与大写 GC 无关,后者代表 垃圾收集 garbage collection 。

1、解析

  • cmd/compile/internal/syntax( 词法分析器 lexer 、 解析器 parser 、 语法树 syntax tree )

在编译的第一阶段,源代码被标记化(词法分析)、解析(语法分析),并为每个源文件构造语法树(LCTT 译注:这里标记指 token,它是一组预定义的、能够识别的字符串,通常由名字和值构成,其中名字一般是词法的类别,如标识符、关键字、分隔符、操作符、文字和注释等;语法树,以及下文提到的 抽象语法树 Abstract Syntax Tree (AST),是指用树来表达程序设计语言的语法结构,通常叶子节点是操作数,其它节点是操作码)。

每个语法树都是相应源文件的确切表示,其中节点对应于源文件的各种元素,例如表达式、声明和语句。语法树还包括位置信息,用于错误报告和创建调试信息。

2、类型检查和 AST 变换

  • cmd/compile/internal/gc(创建编译器 AST, 类型检查 type-checking , AST 变换 AST transformation )

gc 包中包含一个继承自(早期)C 语言实现的版本的 AST 定义。所有代码都是基于它编写的,所以 gc 包必须做的第一件事就是将 syntax 包(定义)的语法树转换为编译器的 AST 表示法。这个额外步骤可能会在将来重构。

然后对 AST 进行类型检查。第一步是名字解析和类型推断,它们确定哪个对象属于哪个标识符,以及每个表达式具有的类型。类型检查包括特定的额外检查,例如“声明但未使用”以及确定函数是否会终止。

特定变换也基于 AST 完成。一些节点被基于类型信息而细化,例如把字符串加法从算术加法的节点类型中拆分出来。其它一些例子是 死代码消除 dead code elimination , 函数调用内联 function call inlining 和 逃逸分析 escape analysis (LCTT 译注:逃逸分析是一种分析指针有效范围的方法)。

3、通用 SSA

  • cmd/compile/internal/gc(转换成 SSA)
  • cmd/compile/internal/ssa(SSA 相关的 环节 pass 和规则)

(LCTT 译注:许多常见高级语言的编译器无法通过一次扫描源代码或 AST 就完成所有编译工作,取而代之的做法是多次扫描,每次完成一部分工作,并将输出结果作为下次扫描的输入,直到最终产生目标代码。这里每次扫描称作一个 环节 pass ;最后一个环节之前所有的环节得到的结果都可称作中间表示法,本文中 AST、SSA 等都属于中间表示法。SSA,静态单赋值形式,是中间表示法的一种性质,它要求每个变量只被赋值一次且在使用前被定义)。

在此阶段,AST 将被转换为 静态单赋值 Static Single Assignment (SSA)形式,这是一种具有特定属性的低级 中间表示法 intermediate representation ,可以更轻松地实现优化并最终从它生成机器码。

在这个转换过程中,将完成 内置函数 function intrinsics 的处理。这些是特殊的函数,编译器被告知逐个分析这些函数并决定是否用深度优化的代码替换它们(LCTT 译注:内置函数指由语言本身定义的函数,通常编译器的处理方式是使用相应实现函数的指令序列代替对函数的调用指令,有点类似内联函数)。

在 AST 转化成 SSA 的过程中,特定节点也被低级化为更简单的组件,以便于剩余的编译阶段可以基于它们工作。例如,内建的拷贝被替换为内存移动,range 循环被改写为 for 循环。由于历史原因,目前这里面有些在转化到 SSA 之前发生,但长期计划则是把它们都移到这里(转化 SSA)。

然后,一系列机器无关的规则和编译环节会被执行。这些并不考虑特定计算机体系结构,因此对所有 GOARCH 变量的值都会运行。

这类通用的编译环节的一些例子包括,死代码消除、移除不必要的空值检查,以及移除无用的分支等。通用改写规则主要考虑表达式,例如将一些表达式替换为常量,优化乘法和浮点操作。

4、生成机器码

  • cmd/compile/internal/ssa(SSA 低级化和架构特定的环节)
  • cmd/internal/obj(机器码生成)

编译器中机器相关的阶段开始于“低级”的编译环节,该阶段将通用变量改写为它们的特定的机器码形式。例如,在 amd64 架构中操作数可以在内存中操作,这样许多 加载-存储 load-store 操作就可以被合并。

注意低级的编译环节运行所有机器特定的重写规则,因此当前它也应用了大量优化。

一旦 SSA 被“低级化”并且更具体地针对目标体系结构,就要运行最终代码优化的编译环节了。这包含了另外一个死代码消除的环节,它将变量移动到更靠近它们使用的地方,移除从来没有被读过的局部变量,以及 寄存器 register 分配。

本步骤中完成的其它重要工作包括 堆栈布局 stack frame layout ,它将堆栈偏移位置分配给局部变量,以及 指针活性分析 pointer liveness analysis ,后者计算每个垃圾收集安全点上的哪些堆栈上的指针仍然是活动的。

在 SSA 生成阶段结束时,Go 函数已被转换为一系列 obj.Prog 指令。它们被传递给汇编程序(cmd/internal/obj),后者将它们转换为机器码并输出最终的目标文件。目标文件还将包含反射数据,导出数据和调试信息。

扩展阅读

要深入了解 SSA 包的工作方式,包括它的环节和规则,请转到 cmd/compile/internal/ssa/README.md。


via: https://github.com/golang/go/blob/master/src/cmd/compile/README.md

作者:mvdan 译者:stephenxs 校对:pityonline, wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

Go 是一个内置支持并发编程的语言。借助使用 go 关键字去创建 协程 goroutine (轻量级线程)和在 Go 中提供的 使用 信道 和 其它的并发 同步方法,使得并发编程变得很容易、很灵活和很有趣。

另一方面,Go 并不会阻止一些因 Go 程序员粗心大意或者缺乏经验而造成的并发编程错误。在本文的下面部分将展示一些在 Go 编程中常见的并发编程错误,以帮助 Go 程序员们避免再犯类似的错误。

需要同步的时候没有同步

代码行或许 不是按出现的顺序运行的。

在下面的程序中有两个错误。

  • 第一,在 main 协程中读取 b 和在新的 协程 中写入 b 可能导致数据争用。
  • 第二,条件 b == true 并不能保证在 main 协程 中的 a != nil。在新的协程中编译器和 CPU 可能会通过 重排序指令 进行优化,因此,在运行时 b 赋值可能发生在 a 赋值之前,在 main 协程 中当 a 被修改后,它将会让部分 a 一直保持为 nil。
package main

import (
    "time"
    "runtime"
)

func main() {
    var a []int // nil
    var b bool  // false

    // a new goroutine
    go func () {
        a = make([]int, 3)
        b = true // write b
    }()

    for !b { // read b
        time.Sleep(time.Second)
        runtime.Gosched()
    }
    a[0], a[1], a[2] = 0, 1, 2 // might panic
}

上面的程序或者在一台计算机上运行的很好,但是在另一台上可能会引发异常。或者它可能运行了 N 次都很好,但是可能在第 (N+1) 次引发了异常。

我们将使用 sync 标准包中提供的信道或者同步方法去确保内存中的顺序。例如,

package main

func main() {
    var a []int = nil
    c := make(chan struct{})

    // a new goroutine
    go func () {
        a = make([]int, 3)
        c <- struct{}{}
    }()

    <-c
    a[0], a[1], a[2] = 0, 1, 2
}

使用 time.Sleep 调用去做同步

我们先来看一个简单的例子。

package main

import (
    "fmt"
    "time"
)

func main() {
    var x = 123

    go func() {
        x = 789 // write x
    }()

    time.Sleep(time.Second)
    fmt.Println(x) // read x
}

我们预期程序将打印出 789。如果我们运行它,通常情况下,它确定打印的是 789。但是,这个程序使用的同步方式好吗?No!原因是 Go 运行时并不保证 x 的写入一定会发生在 x 的读取之前。在某些条件下,比如在同一个操作系统上,大部分 CPU 资源被其它运行的程序所占用的情况下,写入 x 可能就会发生在读取 x 之后。这就是为什么我们在正式的项目中,从来不使用 time.Sleep 调用去实现同步的原因。

我们来看一下另外一个示例。

package main

import (
    "fmt"
    "time"
)

var x = 0

func main() {
    var num = 123
    var p = &num

    c := make(chan int)

    go func() {
        c <- *p + x
    }()

    time.Sleep(time.Second)
    num = 789
    fmt.Println(<-c)
}

你认为程序的预期输出是什么?123 还是 789?事实上它的输出与编译器有关。对于标准的 Go 编译器 1.10 来说,这个程序很有可能输出是 123。但是在理论上,它可能输出的是 789,或者其它的随机数。

现在,我们来改变 c <- *p + x 为 c <- *p,然后再次运行这个程序。你将会发现输出变成了 789 (使用标准的 Go 编译器 1.10)。这再次说明它的输出是与编译器相关的。

是的,在上面的程序中存在数据争用。表达式 *p 可能会被先计算、后计算、或者在处理赋值语句 num = 789 时计算。time.Sleep 调用并不能保证 *p 发生在赋值语句处理之前进行。

对于这个特定的示例,我们将在新的协程创建之前,将值保存到一个临时值中,然后在新的协程中使用临时值去消除数据争用。

...
    tmp := *p + x
    go func() {
        c <- tmp
    }()
...

使协程挂起

挂起协程是指让协程一直处于阻塞状态。导致协程被挂起的原因很多。比如,

  • 一个协程尝试从一个 nil 信道中或者从一个没有其它协程给它发送值的信道中检索数据。
  • 一个协程尝试去发送一个值到 nil 信道,或者发送到一个没有其它的协程接收值的信道中。
  • 一个协程被它自己死锁。
  • 一组协程彼此死锁。
  • 当运行一个没有 default 分支的 select 代码块时,一个协程被阻塞,以及在 select 代码块中 case 关键字后的所有信道操作保持阻塞状态。

除了有时我们为了避免程序退出,特意让一个程序中的 main 协程保持挂起之外,大多数其它的协程挂起都是意外情况。Go 运行时很难判断一个协程到底是处于挂起状态还是临时阻塞。因此,Go 运行时并不会去释放一个挂起的协程所占用的资源。

在 谁先响应谁获胜 的信道使用案例中,如果使用的 future 信道容量不够大,当尝试向 Future 信道发送结果时,一些响应较慢的信道将被挂起。比如,如果调用下面的函数,将有 4 个协程处于永远阻塞状态。

func request() int {
    c := make(chan int)
    for i := 0; i < 5; i++ {
        i := i
        go func() {
            c <- i // 4 goroutines will hang here.
        }()
    }
    return <-c
}

为避免这 4 个协程一直处于挂起状态, c 信道的容量必须至少是 4。

在 实现谁先响应谁获胜的第二种方法 的信道使用案例中,如果将 future 信道用做非缓冲信道,那么有可能这个信息将永远也不会有响应而挂起。例如,如果在一个协程中调用下面的函数,协程可能会挂起。原因是,如果接收操作 <-c 准备就绪之前,五个发送操作全部尝试发送,那么所有的尝试发送的操作将全部失败,因此那个调用者协程将永远也不会接收到值。

func request() int {
    c := make(chan int)
    for i := 0; i < 5; i++ {
        i := i
        go func() {
            select {
            case c <- i:
            default:
            }
        }()
    }
    return <-c
}

将信道 c 变成缓冲信道将保证五个发送操作中的至少一个操作会发送成功,这样,上面函数中的那个调用者协程将不会被挂起。

在 sync 标准包中拷贝类型值

在实践中,sync 标准包中的类型值不会被拷贝。我们应该只拷贝这个值的指针。

下面是一个错误的并发编程示例。在这个示例中,当调用 Counter.Value 方法时,将拷贝一个 Counter 接收值。作为接收值的一个字段,Counter 接收值的各个 Mutex 字段也会被拷贝。拷贝不是同步发生的,因此,拷贝的 Mutex 值可能会出错。即便是没有错误,拷贝的 Counter 接收值的访问保护也是没有意义的。

import "sync"

type Counter struct {
    sync.Mutex
    n int64
}

// This method is okay.
func (c *Counter) Increase(d int64) (r int64) {
    c.Lock()
    c.n += d
    r = c.n
    c.Unlock()
    return
}

// The method is bad. When it is called, a Counter
// receiver value will be copied.
func (c Counter) Value() (r int64) {
    c.Lock()
    r = c.n
    c.Unlock()
    return
}

我们只需要改变 Value 接收类型方法为指针类型 *Counter,就可以避免拷贝 Mutex 值。

在官方的 Go SDK 中提供的 go vet 命令将会报告潜在的错误值拷贝。

在错误的地方调用 sync.WaitGroup 的方法

每个 sync.WaitGroup 值维护一个内部计数器,这个计数器的初始值为 0。如果一个 WaitGroup 计数器的值是 0,调用 WaitGroup 值的 Wait 方法就不会被阻塞,否则,在计数器值为 0 之前,这个调用会一直被阻塞。

为了让 WaitGroup 值的使用有意义,当一个 WaitGroup 计数器值为 0 时,必须在相应的 WaitGroup 值的 Wait 方法调用之前,去调用 WaitGroup 值的 Add 方法。

例如,下面的程序中,在不正确位置调用了 Add 方法,这将使最后打印出的数字不总是 100。事实上,这个程序最后打印的数字可能是在 [0, 100) 范围内的一个随意数字。原因就是 Add 方法的调用并不保证一定会发生在 Wait 方法调用之前。

package main

import (
    "fmt"
    "sync"
    "sync/atomic"
)

func main() {
    var wg sync.WaitGroup
    var x int32 = 0
    for i := 0; i < 100; i++ {
        go func() {
            wg.Add(1)
            atomic.AddInt32(&x, 1)
            wg.Done()
        }()
    }

    fmt.Println("To wait ...")
    wg.Wait()
    fmt.Println(atomic.LoadInt32(&x))
}

为让程序的表现符合预期,在 for 循环中,我们将把 Add 方法的调用移动到创建的新协程的范围之外,修改后的代码如下。

...
    for i := 0; i < 100; i++ {
        wg.Add(1)
        go func() {
            atomic.AddInt32(&x, 1)
            wg.Done()
        }()
    }
...

不正确使用 futures 信道

在 信道使用案例 的文章中,我们知道一些函数将返回 futures 信道。假设 fa 和 fb 就是这样的两个函数,那么下面的调用就使用了不正确的 future 参数。

doSomethingWithFutureArguments(<-fa(), <-fb())

在上面的代码行中,两个信道接收操作是顺序进行的,而不是并发的。我们做如下修改使它变成并发操作。

ca, cb := fa(), fb()
doSomethingWithFutureArguments(<-c1, <-c2)

没有等协程的最后的活动的发送结束就关闭信道

Go 程序员经常犯的一个错误是,还有一些其它的协程可能会发送值到以前的信道时,这个信道就已经被关闭了。当这样的发送(发送到一个已经关闭的信道)真实发生时,将引发一个异常。

这种错误在一些以往的著名 Go 项目中也有发生,比如在 Kubernetes 项目中的 这个 bug 和 这个 bug。

如何安全和优雅地关闭信道,请阅读 这篇文章。

在值上做 64 位原子操作时没有保证值地址 64 位对齐

到目前为止(Go 1.10),在标准的 Go 编译器中,在一个 64 位原子操作中涉及到的值的地址要求必须是 64 位对齐的。如果没有对齐则导致当前的协程异常。对于标准的 Go 编译器来说,这种失败仅发生在 32 位的架构上。请阅读 内存布局 去了解如何在一个 32 位操作系统上保证 64 位对齐。

没有注意到大量的资源被 time.After 函数调用占用

在 time 标准包中的 After 函数返回 一个延迟通知的信道。这个函数在某些情况下用起来很便捷,但是,每次调用它将创建一个 time.Timer 类型的新值。这个新创建的 Timer 值在通过传递参数到 After 函数指定期间保持激活状态,如果在这个期间过多的调用了该函数,可能会有太多的 Timer 值保持激活,这将占用大量的内存和计算资源。

例如,如果调用了下列的 longRunning 函数,将在一分钟内产生大量的消息,然后在某些周期内将有大量的 Timer 值保持激活,即便是大量的这些 Timer 值已经没用了也是如此。

import (
    "fmt"
    "time"
)

// The function will return if a message arrival interval
// is larger than one minute.
func longRunning(messages <-chan string) {
    for {
        select {
        case <-time.After(time.Minute):
            return
        case msg := <-messages:
            fmt.Println(msg)
        }
    }
}

为避免在上述代码中创建过多的 Timer 值,我们将使用一个单一的 Timer 值去完成同样的任务。

func longRunning(messages <-chan string) {
    timer := time.NewTimer(time.Minute)
    defer timer.Stop()

    for {
        select {
        case <-timer.C:
            return
        case msg := <-messages:
            fmt.Println(msg)
            if !timer.Stop() {
                <-timer.C
            }
        }

        // The above "if" block can also be put here.

        timer.Reset(time.Minute)
    }
}

不正确地使用 time.Timer 值

在最后,我们将展示一个符合语言使用习惯的 time.Timer 值的使用示例。需要注意的一个细节是,那个 Reset 方法总是在停止或者 time.Timer 值释放时被使用。

在 select 块的第一个 case 分支的结束部分,time.Timer 值被释放,因此,我们不需要去停止它。但是必须在第二个分支中停止定时器。如果在第二个分支中 if 代码块缺失,它可能至少在 Reset 方法调用时,会(通过 Go 运行时)发送到 timer.C 信道,并且那个 longRunning 函数可能会早于预期返回,对于 Reset 方法来说,它可能仅仅是重置内部定时器为 0,它将不会清理(耗尽)那个发送到 timer.C 信道的值。

例如,下面的程序很有可能在一秒内而不是十秒时退出。并且更重要的是,这个程序并不是 DRF 的(LCTT 译注:data race free,多线程程序的一种同步程度)。

package main

import (
    "fmt"
    "time"
)

func main() {
    start := time.Now()
    timer := time.NewTimer(time.Second/2)
    select {
    case <-timer.C:
    default:
        time.Sleep(time.Second) // go here
    }
    timer.Reset(time.Second * 10)
    <-timer.C
    fmt.Println(time.Since(start)) // 1.000188181s
}

当 time.Timer 的值不再被其它任何一个东西使用时,它的值可能被停留在一种非停止状态,但是,建议在结束时停止它。

在多个协程中如果不按建议使用 time.Timer 值并发,可能会有 bug 隐患。

我们不应该依赖一个 Reset 方法调用的返回值。Reset 方法返回值的存在仅仅是为了兼容性目的。


via: https://go101.org/article/concurrent-common-mistakes.html

作者:<go101.org> 译者:qhwdw 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出
Google 最有趣的部分之一就是我们规模庞大的持续分析服务。我们可以看到谁在使用 CPU 和内存,我们可以持续地监控我们的生产服务以争用和阻止配置文件,并且我们可以生成分析和报告,并轻松地告诉我们可以进行哪些有重要影响的优化。

我简单研究了 Stackdriver Profiler,这是我们的新产品,它填补了针对云端用户在云服务范围内分析服务的空白。请注意,你无需在 Google 云平台上运行你的代码即可使用它。实际上,我现在每天都在开发时使用它。它也支持 Java 和 Node.js。

在生产中分析

pprof 可安全地用于生产。我们针对 CPU 和堆分配分析的额外会增加 5% 的开销。一个实例中每分钟收集 10 秒。如果你有一个 Kubernetes Pod 的多个副本,我们确保进行分摊收集。例如,如果你拥有一个 pod 的 10 个副本,模式,那么开销将变为 0.5%。这使用户可以一直进行分析。

我们目前支持 Go 程序的 CPU、堆、互斥和线程分析。

为什么?

在解释如何在生产中使用分析器之前,先解释为什么你想要在生产中进行分析将有所帮助。一些非常常见的情况是:

  • 调试仅在生产中可见的性能问题。
  • 了解 CPU 使用率以减少费用。
  • 了解争用的累积和优化的地方。
  • 了解新版本的影响,例如看到 canary 和产品级之间的区别。
  • 通过关联分析样本以了解延迟的根本原因来丰富你的分布式经验。

启用

Stackdriver Profiler 不能与 net/http/pprof 处理程序一起使用,并要求你在程序中安装和配置一个一行的代理。

go get cloud.google.com/go/profiler

在你的主函数中,启动分析器:

if err := profiler.Start(profiler.Config{
   Service:        "indexing-service",
   ServiceVersion: "1.0",
   ProjectID:      "bamboo-project-606", // optional on GCP
}); err != nil {
   log.Fatalf("Cannot start the profiler: %v", err) 
}

当你运行你的程序后,profiler 包将每分钟报告给分析器 10 秒钟。

可视化

当分析被报告给后端后,你将在 https://console.cloud.google.com/profiler 上看到火焰图。你可以按标签过滤并更改时间范围,也可以按服务名称和版本进行细分。数据将会长达 30 天。

你可以选择其中一个分析,按服务,区域和版本分解。你可以在火焰中移动并通过标签进行过滤。

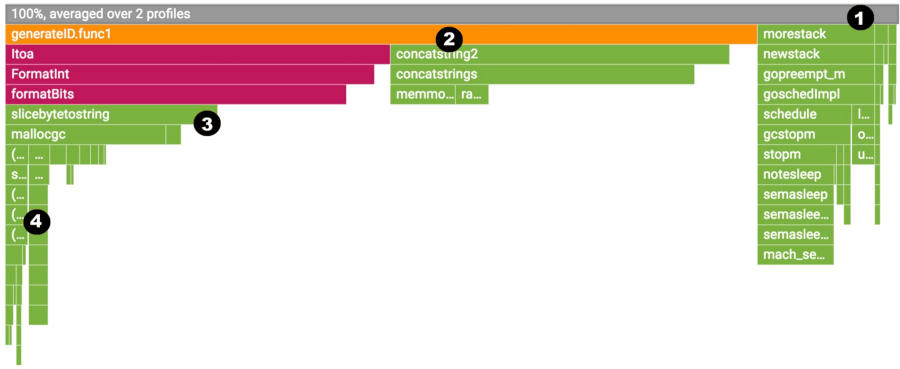
阅读火焰图

Brendan Gregg 非常全面地解释了火焰图可视化。Stackdriver Profiler 增加了一点它自己的特点。

我们将查看一个 CPU 分析,但这也适用于其他分析。

  1. 最上面的 x 轴表示整个程序。火焰上的每个框表示调用路径上的一帧。框的宽度与执行该函数花费的 CPU 时间成正比。
  2. 框从左到右排序,左边是花费最多的调用路径。
  3. 来自同一包的帧具有相同的颜色。这里所有运行时功能均以绿色表示。
  4. 你可以单击任何框进一步展开执行树。

你可以将鼠标悬停在任何框上查看任何帧的详细信息。

过滤

你可以显示、隐藏和高亮符号名称。如果你特别想了解某个特定调用或包的消耗,这些信息非常有用。

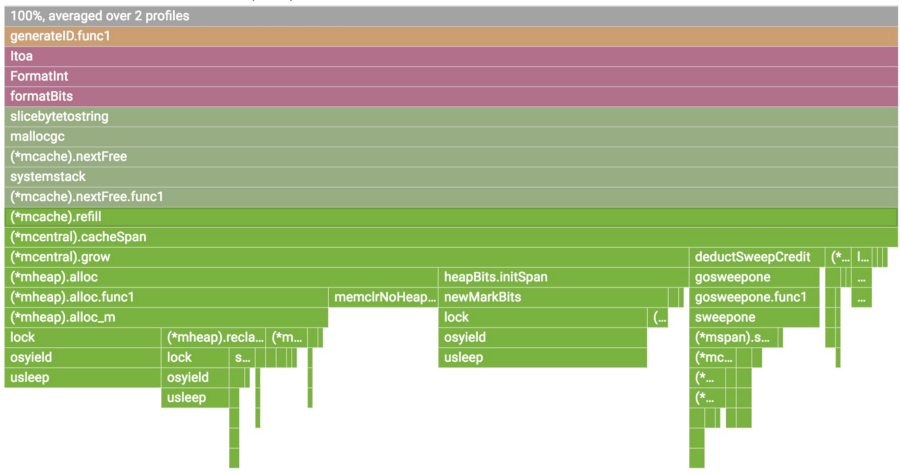
  1. 选择你的过滤器。你可以组合多个过滤器。在这里,我们将高亮显示 runtime.memmove。
  2. 火焰将使用过滤器过滤帧并可视化过滤后的框。在这种情况下,它高亮显示所有 runtime.memmove 框。

via: https://medium.com/google-cloud/continuous-profiling-of-go-programs-96d4416af77b

作者:JBD 译者:geekpi 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

介绍

这篇文章是我在 CI 环境(特别是在 Gitlab 中)的 Docker 容器中构建 Go 项目的研究总结。我发现很难解决私有依赖问题(来自 Node/.NET 背景),因此这是我写这篇文章的主要原因。如果 Docker 镜像上存在任何问题或提交请求,请随时与我们联系。

dep

由于 dep 是现在管理 Go 依赖关系的最佳选择,因此在构建前之前运行 dep ensure。

注意:我个人不会将我的 vendor/ 文件夹提交到源码控制,如果你这样做,我不确定这个步骤是否可以跳过。

使用 Docker 构建的最好方法是使用 dep ensure -vendor-only。 见这里。

Docker 构建镜像

我第一次尝试使用 golang:1.10,但这个镜像没有:

  • curl
  • git
  • make
  • dep
  • golint

我已经创建好了用于构建的镜像(github / dockerhub),我会保持更新,但我不提供任何担保,因此你应该创建并管理自己的 Dockerhub。

内部依赖关系

我们完全有能力创建一个有公共依赖关系的项目。但是如果你的项目依赖于另一个私人 Gitlab 仓库呢?

在本地运行 dep ensure 应该可以和你的 git 设置一起工作,但是一旦在 CI 上不适用,构建就会失败。

Gitlab 权限模型

这是在 Gitlab 8.12 中添加的,这个我们最关心的有用的功能是在构建期提供的 CI_JOB_TOKEN 环境变量。

这基本上意味着我们可以像这样克隆依赖仓库:

git clone https://gitlab-ci-token:${CI_JOB_TOKEN}@gitlab.com/myuser/mydependentrepo

然而,我们希望使这更友好一点,因为 dep 在试图拉取代码时不会奇迹般地添加凭据。

我们将把这一行添加到 .gitlab-ci.yml 的 before_script 部分。

before_script:
  - echo -e "machine gitlab.com\nlogin gitlab-ci-token\npassword ${CI_JOB_TOKEN}" > ~/.netrc

使用 .netrc 文件可以指定哪个凭证用于哪个服务器。这种方法可以避免每次从 Git 中拉取(或推送)时输入用户名和密码。密码以明文形式存储,因此你不应在自己的计算机上执行此操作。这实际用于 Git 在背后使用 cURL。 在这里阅读更多。

项目文件

Makefile

虽然这是可选的,但我发现它使事情变得更容易。

配置这些步骤意味着在 CI 脚本(和本地)中,我们可以运行 make lint、make build 等,而无需每次重复步骤。

GOFILES = $(shell find . -name '*.go' -not -path './vendor/*')
GOPACKAGES = $(shell go list ./...  | grep -v /vendor/)

default: build

workdir:
    mkdir -p workdir

build: workdir/scraper

workdir/scraper: $(GOFILES)
    GOOS=linux GOARCH=amd64 CGO_ENABLED=0 go build -o workdir/scraper .

test: test-all

test-all:
    @go test -v $(GOPACKAGES)

lint: lint-all

lint-all:
    @golint -set_exit_status $(GOPACKAGES)

.gitlab-ci.yml

这是 Gitlab CI 魔术发生的地方。你可能想使用自己的镜像。

image: sjdweb/go-docker-build:1.10

stages:
  - test
  - build

before_script:
  - cd $GOPATH/src
  - mkdir -p gitlab.com/$CI_PROJECT_NAMESPACE
  - cd gitlab.com/$CI_PROJECT_NAMESPACE
  - ln -s $CI_PROJECT_DIR
  - cd $CI_PROJECT_NAME
  - echo -e "machine gitlab.com\nlogin gitlab-ci-token\npassword ${CI_JOB_TOKEN}" > ~/.netrc
  - dep ensure -vendor-only

lint_code:
  stage: test
  script:
    - make lint

unit_tests:
  stage: test
  script:
    - make test

build:
  stage: build
  script:
    - make

缺少了什么

我通常会用我的二进制文件构建 Docker 镜像,并将其推送到 Gitlab 容器注册库中。

你可以看到我正在构建二进制文件并退出,你至少需要将该二进制文件(例如生成文件)存储在某处。


via: https://seandrumm.co.uk/blog/building-go-projects-with-docker-on-gitlab-ci/

作者:SEAN DRUMM 译者:geekpi 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出
我的上一篇博文《与 C 语言长别离》引来了我的老朋友,一位 C++ 专家的评论。在评论里,他推荐把 C++ 作为 C 的替代品。这是不可能发生的,如果 C++ 代替 C 是趋势的话,那么 Go 和 Rust 也就不会出现了。

但是我不能只给我的读者一个光秃秃的看法(LCTT 译注:此处是双关语)。所以,在这篇文章中,我来讲述一下为什么我不再碰 C++ 的故事。这是关于计算机语言设计经济学专题文章的起始点。这篇文章会讨论为什么一些真心不好的决策会被做出来,然后进入语言的基础设计之中,以及我们该如何修正这些问题。

在这篇文章中,我会一点一点的指出人们(当然也包括我)自从 20 世纪 80 年代以来就存在的关于未来的编程语言的预见失误。直到最近,我们才找到了证明我们错了的证据。

我记得我第一次学习 C++ 是因为我需要使用 GNU eqn 输出 MathXML,而 eqn 是使用 C++ 写的。那个项目不错。在那之后,21 世纪初,我在 韦诺之战 Battle For Wesnoth 那边当了多年的资深开发人生,并且与 C++ 相处甚欢。

在那之后啊,有一天我们发现一个不小心被我们授予提交权限的人已经把游戏的 AI 核心搞崩掉了。显然,在团队中只有我是不那么害怕查看代码的。最终,我把一切都恢复正常了 —— 我折腾了整整两周。再那之后,我就发誓我再也不靠近 C++ 了。

在那次经历过后,我发现这个语言的问题就是它在尝试使得本来就复杂的东西更加复杂,来粗陋补上因为基础概念的缺失造成的漏洞。对于裸指针这样东西,它说“别这样做”,这没有问题。对于小规模的个人项目(比如我的魔改版 eqn),遵守这些规定没有问题。

但是对于大型项目,或者开发者水平参差不齐的多人项目(这是我经常要处理的情况)就不能这样。随着时间的推移以及代码行数的增加,有的人就会捅篓子。当别人指出有 BUG 时,因为诸如 STL 之类的东西给你增加了一层复杂度,你处理这种问题所需要的精力就比处理同等规模的 C 语言的问题就要难上很多。我在韦诺之战时,我就知道了,处理这种问题真的相当棘手。

我给 Stell Heller(我的老朋友,C++ 的支持者)写代码时不会发生的问题在我与非 Heller 们合作时就被放大了,我和他们合作的结局可能就是我得给他们擦屁股。所以我就不用 C++ ,我觉得不值得为了其花时间。 C 是有缺陷的,但是 C 有 C++ 没有的优点 —— 如果你能在脑内模拟出硬件,那么你就能很简单的看出程序是怎么运行的。如果 C++ 真的能解决 C 的问题(也就是说,C++ 是类型安全以及内存安全的),那么失去其透明性也是值得的。但是,C++ 并没有这样。

我们判断 C++ 做的还不够的方法之一是想象一个 C++ 已经搞得不错的世界。在那个世界里,老旧的 C 语言项目会被迁移到 C++ 上来。主流的操作系统内核会是 C++ 写就,而现存的内核实现,比如 Linux 会渐渐升级成那样。在现实世界,这些都没有发生。C++ 不仅没有打消语言设计者设想像 D、Go 以及 Rust 那样的新语言的想法,它甚至都没有取代它的前辈。不改变 C++ 的核心思想,它就没有未来,也因此,C++ 的 抽象泄露 leaky abstraction 也不会消失。

既然我刚刚提到了 D 语言,那我就说说为什么我不把 D 视为一个够格的 C 语言竞争者的原因吧。尽管它比 Rust 早出现了八年(和 Rust 相比是九年)Walter Bright 早在那时就有了构建那样一个语言的想法。但是在 2001 年,以 Python 和 Perl 为首的语言的出现已经确定了,专有语言能和开源语言抗衡的时代已经过去。官方 D 语言库/运行时和 Tangle 的无谓纷争也打击了其发展。它从未修正这些错误。

然后就是 Go 语言(我本来想说“以及 Rust”。但是如前文所述,我认为 Rust 还需要几年时间才能有竞争力)。它的确是类型安全以及内存安全的(好吧,是在大多数时候是这样,但是如果你要使用接口的话就不是如此了,但是自找麻烦可不是正常人的做法)。我的一位好友,Mark Atwood,曾指出过 Go 语言是脾气暴躁的老头子因为愤怒而创造出的语言,主要是 C 语言的作者之一(Ken Thompson) 因为 C++ 的混乱臃肿造成的愤怒,我深以为然。

我能理解 Ken 恼火的原因。这几十年来我就一直认为 C++ 搞错了需要解决的问题。C 语言的后继者有两条路可走。其一就是 C++ 那样,接受 C 的抽象泄漏、裸指针等等,以保证兼容性。然后以此为基础,构建一个最先进的语言。还有一条道路,就是从根源上解决问题 —— 修正 C语言的抽象泄露。这一来就会破环其兼容性,但是也会杜绝 C/C++ 现有的问题。

对于第二条道路,第一次严谨的尝试就是 1995 年出现的 Java。Java 搞得不错,但是在语言解释器上构建这门语言使其不适合系统编程。这就在系统编程那留下一个巨大的洞,在 Go 以及 Rust 出现之前的 15 年里,都没有语言来填补这个空白。这也就是我的 GPSD 和 NTPsec 等软件在 2017 年仍然主要用 C 写成的原因,尽管 C 的问题也很多。

在许多方面这都是很糟糕的情况。尽管由于缺少足够多样化的选择,我们很难认识到 C/C++ 做的不够好的地方。我们都认为在软件里面出现缺陷以及基于安全方面考虑的妥协是理所当然的,而不是想想这其中多少是真的由于语言的设计问题导致的,就像缓存区溢出漏洞一样。

所以,为什么我们花了这么长时间才开始解决这个问题?从 C 1972 年面世到 Go 2009 年出现,这其中隔了 37 年;Rust 也是在其仅仅一年之前出现。我想根本原因还是经济。

从最早的计算机语言开始,人们就已经知道,每种语言的设计都体现了程序员时间与机器资源的相对价值的权衡。在机器这端,就是汇编语言,以及之后的 C 语言,这些语言以牺牲开发人员的时间为代价来提高性能。 另一方面,像 Lisp 和(之后的)Python 这样的语言则试图自动处理尽可能多的细节,但这是以牺牲机器性能为代价的。

广义地说,这两端的语言的最重要的区别就是有没有自动内存管理。这与经验一致,内存管理缺陷是以机器为中心的语言中最常见的一类缺陷,程序员需要手动管理资源。

当相对价值断言与软件开发在某个特定领域的实际成本动因相匹配时,这个语言就是在经济上可行的。语言设计者通过设计一个适合处理现在或者不远的将来出现的情况的语言,而不是使用现有的语言来解决他们遇到的问题。

随着时间的推移,时兴的编程语言已经渐渐从需要手动管理内存的语言变为带有自动内存管理以及垃圾回收(GC)机制的语言。这种变化对应了摩尔定律导致的计算机硬件成本的降低,使得程序员的时间与之前相比更加的宝贵。但是,除了程序员的时间以及机器效率的变化之外,至少还有两个维度与这种变化相关。

其一就是距离底层硬件的距离。底层软件(内核与服务代码)的低效率会被成倍地扩大。因此我们可以发现,以机器为中心的语言向底层推进,而以程序员为中心的语言向着高级发展。因为大多数情况下面向用户的语言仅仅需要以人类的反应速度(0.1 秒)做出回应即可。

另一个维度就是项目的规模。由于程序员抽象发生的问题的漏洞以及自身的疏忽,任何语言都会有可预期的每千行代码的出错率。这个比率在以机器为中心的语言上很高,而在程序员为中心的带有 GC 的语言里就大大降低。随着项目规模的增大,带有 GC 的语言作为一个防止出错率不堪入目的策略就显得愈发重要起来。

当我们使用这三种维度来看当今的编程语言的形势 —— C 语言在底层,蓬勃发展的带有 GC 的语言在上层,我们会发现这基本上很合理。但是还有一些看似不合理的是 —— C 语言的应用不合理地广泛。

我为什么这么说?想想那些经典的 Unix 命令行工具吧。那些小程序通常都可以使用带有完整的 POSIX 支持的脚本语言快速实现出来。重新编码那些程序将使得它们调试、维护和拓展起来都会更加简单。

但是为什么还是使用 C (或者某些像 eqn 的项目,使用 C++)?因为有转换成本。就算是把相当小、相当简单的程序使用新的语言重写并且确认你已经忠实地保留了所有非错误行为都是相当困难的。笼统地说,在任何一个领域的应用编程或者系统编程在一种语言的权衡过时之后,仍然坚持使用它。

这就是我和其他预测者犯的大错。 我们认为,降低机器资源成本(增加程序员时间的相对成本)本身就足以取代 C 语言(以及没有 GC 的语言)。 在这个过程中,我们有一部分或者甚至一大部分都是错误的 —— 自 20 世纪 90 年代初以来,脚本语言、Java 以及像 Node.js 这样的东西的兴起显然都是这样兴起的。

但是,竞争系统编程语言的新浪潮并非如此。 Rust 和 Go 都明确地回应了增加项目规模 这一需求。 脚本语言是先是作为编写小程序的有效途径,并逐渐扩大规模,而 Rust 和 Go 从一开始就定位为减少大型项目中的缺陷率。 比如 Google 的搜索服务和 Facebook 的实时聊天复用。

我认为这就是对 “为什么不再早点儿” 这个问题的回答。Rust 和 Go 实际上并不算晚,它们相对迅速地回应了一个直到最近才被发现低估的成本动因问题。

好,说了这么多理论上的问题。按照这些理论我们能预言什么?它告诉我们在 C 之后会出现什么?

推动 GC 语言发展的趋势还没有扭转,也不要期待其扭转。这是大势所趋。因此:最终我们将拥有具有足够低延迟的 GC 技术,可用于内核和底层固件,这些技术将以语言实现方式被提供。 这些才是真正结束 C 长期统治的语言应有的特性。

我们能从 Go 语言开发团队的工作文件中发现端倪,他们正朝着这个方向前进 —— 可参见关于并发 GC 的学术研究 —— 从未停止研究。 如果 Go 语言自己没有选择这么做,其他的语言设计师也会这样。 但我认为他们会这么做 —— 谷歌推动他们的项目的能力是显而易见的(我们从 “Android 的发展”就能看出来)。

在我们拥有那么理想的 GC 之前,我把能替换 C 语言的赌注押在 Go 语言上。因为其 GC 的开销是可以接受的 —— 也就是说不只是应用,甚至是大部分内核外的服务都可以使用。原因很简单: C 的出错率无药可医,转化成本还很高。

上周我尝试将 C 语言项目转化到 Go 语言上,我发现了两件事。其一就是这活很简单, C 的语言和 Go 对应的很好。还有就是写出的代码相当简单。由于 GC 的存在以及把集合视为首要的数据结构,人们会预期代码减少,但是我意识到我写的代码比我最初期望的减少的更多,比例约为 2:1 —— 和 C 转 Python 类似。

抱歉呐,Rust 粉们。你们在内核以及底层固件上有着美好的未来,但是你们在别的 C 领域被 Go 压的很惨。没有 GC ,再加上难以从 C 语言转化过来,还有就是 API 的标准部分还是不够完善。(我的 select(2) 又哪去了啊?)。

对你们来说,唯一的安慰就是,C++ 粉比你们更糟糕 —— 如果这算是安慰的话。至少 Rust 还可以在 Go 顾及不到的 C 领域内大展宏图。C++ 可不能。

本站按:本文由著名开源领袖 ESR 撰写,了解 ESR 事迹的同学知道他拒绝去大公司荣养,而仍然主要负责一些互联网基础性项目的开发维护(如 NTPsec),所以,他在创造者赞助网站 Patreon 上有一份生活赞助计划,大家可以考虑献出一些微薄之力支持他,每个月 $20 也不过你一餐饭而已。

via: http://esr.ibiblio.org/?p=7724

作者:Eric Raymond 译者:name1e5s 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出
Gogs 是由 Go 语言编写的,自由开源的 Git 服务。Gogs 是一款无痛式自托管的 Git 服务器,能在尽可能小的硬件资源开销上搭建并运行您的私有 Git 服务器。Gogs 的网页界面和 GitHub 十分相近,且提供 MySQL、PostgreSQL 和 SQLite 数据库支持。

在本教程中,我们将使用 Gogs 在 Ununtu 16.04 上按步骤指导您安装和配置您的私有 Git 服务器。这篇教程中涵盖了如何在 Ubuntu 上安装 Go 语言、PostgreSQL 和安装并且配置 Nginx 网页服务器作为 Go 应用的反向代理的细节内容。

搭建环境

  • Ubuntu 16.04
  • Root 权限

我们将会接触到的事物

  1. 更新和升级系统
  2. 安装和配置 PostgreSQL
  3. 安装 Go 和 Git
  4. 安装 Gogs
  5. 配置 Gogs
  6. 运行 Gogs 服务器
  7. 安装和配置 Nginx 反向代理
  8. 测试

步骤 1 - 更新和升级系统

继续之前,更新 Ubuntu 所有的库,升级所有包。

运行下面的 apt 命令:

sudo apt update
sudo apt upgrade

步骤 2 - 安装和配置 PostgreSQL

Gogs 提供 MySQL、PostgreSQL、SQLite 和 TiDB 数据库系统支持。

此步骤中,我们将使用 PostgreSQL 作为 Gogs 程序的数据库。

使用下面的 apt 命令安装 PostgreSQL。

sudo apt install -y postgresql postgresql-client libpq-dev

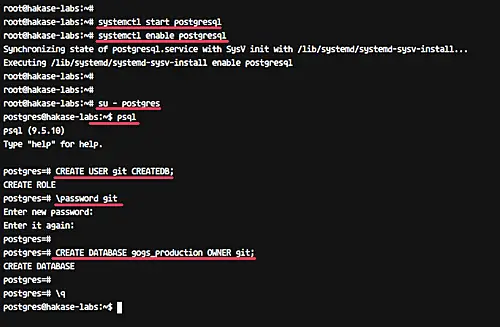
安装完成之后,启动 PostgreSQL 服务并设置为开机启动。

systemctl start postgresql
systemctl enable postgresql

此时 PostgreSQL 数据库在 Ubuntu 系统上完成安装了。

之后,我们需要为 Gogs 创建数据库和用户。

使用 postgres 用户登录并运行 psql 命令以访问 PostgreSQL 操作界面。

su - postgres
psql

创建一个名为 git 的新用户,给予此用户 CREATEDB 权限。

CREATE USER git CREATEDB;
\password git

创建名为 gogs_production 的数据库,设置 git 用户作为其所有者。

CREATE DATABASE gogs_production OWNER git;

创建 Gogs 数据库

用于 Gogs 的 gogs_production PostgreSQL 数据库和 git 用户已经创建完毕。

步骤 3 - 安装 Go 和 Git

使用下面的 apt 命令从库中安装 Git。

sudo apt install git

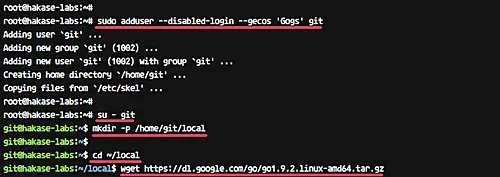
此时,为系统创建名为 git 的新用户。

sudo adduser --disabled-login --gecos 'Gogs' git

登录 git 账户并且创建名为 local 的目录。

su - git
mkdir -p /home/git/local

切换到 local 目录,依照下方所展示的内容,使用 wget 命令下载 Go(最新版)。

cd ~/local
wget https://dl.google.com/go/go1.9.2.linux-amd64.tar.gz

安装 Go 和 Git

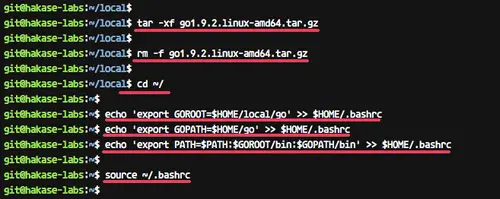
解压并且删除 go 的压缩文件。

tar -xf go1.9.2.linux-amd64.tar.gz
rm -f go1.9.2.linux-amd64.tar.gz

Go 二进制文件已经被下载到 ~/local/go 目录。此时我们需要设置环境变量 - 设置 GOROOT 和 GOPATH 目录到系统环境,这样,我们就可以在 git 用户下执行 go 命令。

执行下方的命令。

cd ~/
echo 'export GOROOT=$HOME/local/go' >> $HOME/.bashrc
echo 'export GOPATH=$HOME/go' >> $HOME/.bashrc
echo 'export PATH=$PATH:$GOROOT/bin:$GOPATH/bin' >> $HOME/.bashrc

之后通过运行 source ~/.bashrc 重载 Bash,如下:

source ~/.bashrc

确定您使用的 Bash 是默认的 shell。

安装 Go 编程语言

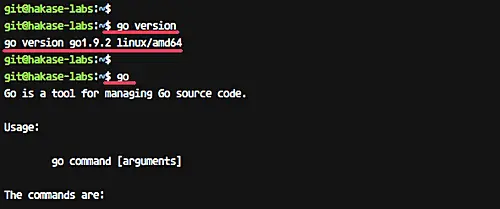
现在运行 go 的版本查看命令。

go version

之后确保您得到下图所示的结果。

检查 go 版本

现在,Go 已经安装在系统的 git 用户下了。

步骤 4 - 使用 Gogs 安装 Git 服务

使用 git 用户登录并且使用 go 命令从 GitHub 下载 Gogs。

su - git
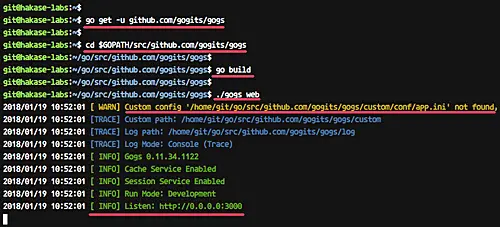
go get -u github.com/gogits/gogs

此命令将在 GOPATH/src 目录下载 Gogs 的所有源代码。

切换至 $GOPATH/src/github.com/gogits/gogs 目录,并且使用下列命令搭建 Gogs。

cd $GOPATH/src/github.com/gogits/gogs
go build

确保您没有遇到错误。

现在使用下面的命令运行 Gogs Go Git 服务器。

./gogs web

此命令将会默认运行 Gogs 在 3000 端口上。

安装 Gogs Go Git 服务

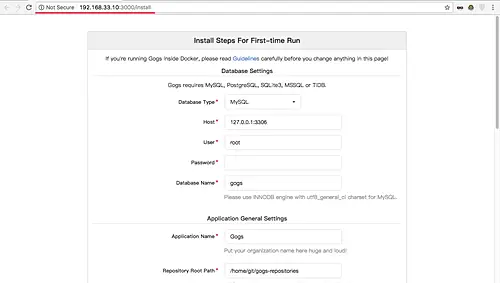
打开网页浏览器,键入您的 IP 地址和端口号,我的是 http://192.168.33.10:3000/ 。

您应该会得到与下方一致的反馈。

Gogs 网页服务器

Gogs 已经在您的 Ubuntu 系统上安装完毕。现在返回到您的终端,并且键入 Ctrl + C 中止服务。

步骤 5 - 配置 Gogs Go Git 服务器

本步骤中,我们将为 Gogs 创建惯例配置。

进入 Gogs 安装目录并新建 custom/conf 目录。

cd $GOPATH/src/github.com/gogits/gogs
mkdir -p custom/conf/

复制默认的配置文件到 custom 目录,并使用 vim 修改。

cp conf/app.ini custom/conf/app.ini
vim custom/conf/app.ini

在 [server] 小节中,修改 HOST_ADDR 为 127.0.0.1。

[server]
 PROTOCOL = http
 DOMAIN = localhost
 ROOT_URL = %(PROTOCOL)s://%(DOMAIN)s:%(HTTP_PORT)s/
 HTTP_ADDR = 127.0.0.1
 HTTP_PORT = 3000

在 [database] 选项中,按照您的数据库信息修改。

[database]
 DB_TYPE = postgres
 HOST = 127.0.0.1:5432
 NAME = gogs_production
 USER = git
 PASSWD = aqwe123@#

保存并退出。

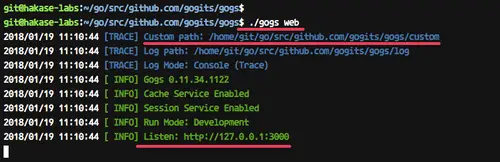
运行下面的命令验证配置项。

./gogs web

并且确保您得到如下的结果。

配置服务器

Gogs 现在已经按照自定义配置下运行在 localhost 的 3000 端口上了。

步骤 6 - 运行 Gogs 服务器

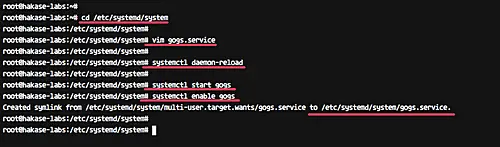
这一步,我们将在 Ubuntu 系统上配置 Gogs 服务器。我们会在 /etc/systemd/system 目录下创建一个新的服务器配置文件 gogs.service。

切换到 /etc/systemd/system 目录,使用 vim 创建服务器配置文件 gogs.service。

cd /etc/systemd/system
vim gogs.service

粘贴下面的代码到 Gogs 服务器配置文件中。

[Unit]
Description=Gogs
After=syslog.target
After=network.target
After=mariadb.service mysqld.service postgresql.service memcached.service redis.service

[Service]
# Modify these two values and uncomment them if you have
# repos with lots of files and get an HTTP error 500 because
# of that
###
#LimitMEMLOCK=infinity
#LimitNOFILE=65535
Type=simple
User=git
Group=git
WorkingDirectory=/home/git/go/src/github.com/gogits/gogs
ExecStart=/home/git/go/src/github.com/gogits/gogs/gogs web
Restart=always
Environment=USER=git HOME=/home/git

[Install]
WantedBy=multi-user.target

之后保存并且退出。

现在可以重载系统服务器。

systemctl daemon-reload

使用下面的命令开启 Gogs 服务器并设置为开机启动。

systemctl start gogs
systemctl enable gogs

运行 Gogs 服务器

Gogs 服务器现在已经运行在 Ubuntu 系统上了。

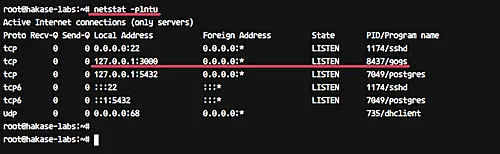
使用下面的命令检测:

netstat -plntu
systemctl status gogs

您应该会得到下图所示的结果。

Gogs is listening on the network interface

步骤 7 - 为 Gogs 安装和配置 Nginx 反向代理

在本步中,我们将为 Gogs 安装和配置 Nginx 反向代理。我们会在自己的库中调用 Nginx 包。

使用下面的命令添加 Nginx 库。

sudo add-apt-repository -y ppa:nginx/stable

此时更新所有的库并且使用下面的命令安装 Nginx。

sudo apt update
sudo apt install nginx -y

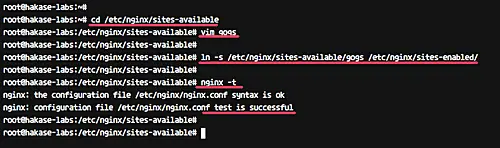
之后,进入 /etc/nginx/sites-available 目录并且创建虚拟主机文件 gogs。

cd /etc/nginx/sites-available
vim gogs

粘贴下面的代码到配置文件。

server {
     listen 80;
     server_name git.hakase-labs.co;

     location / {
         proxy_pass http://localhost:3000;
     }
 }

保存退出。

注意: 请使用您的域名修改 server_name 项。

现在激活虚拟主机并且测试 nginx 配置。

ln -s /etc/nginx/sites-available/gogs /etc/nginx/sites-enabled/
nginx -t

确保没有遇到错误,重启 Nginx 服务器。

systemctl restart nginx

安装和配置 Nginx 反向代理

步骤 8 - 测试

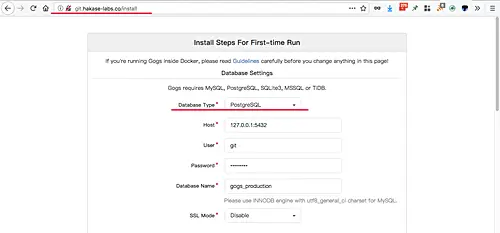
打开您的网页浏览器并且输入您的 Gogs URL,我的是 http://git.hakase-labs.co

现在您将进入安装界面。在页面的顶部,输入您所有的 PostgreSQL 数据库信息。

Gogs 安装

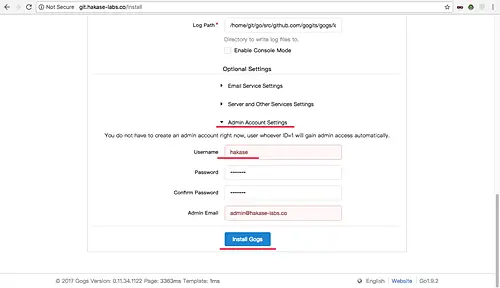
之后,滚动到底部,点击 “Admin account settings” 下拉选项。

输入您的管理者用户名和邮箱。

键入 gogs 安装设置

之后点击 “Install Gogs” 按钮。

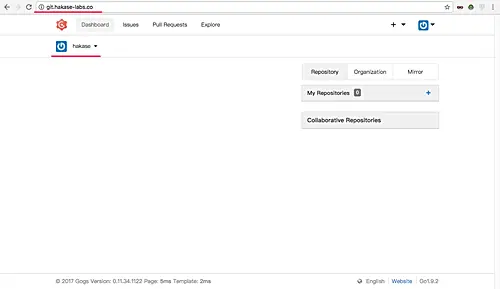
然后您将会被重定向到下图显示的 Gogs 用户面板。

Gogs 面板

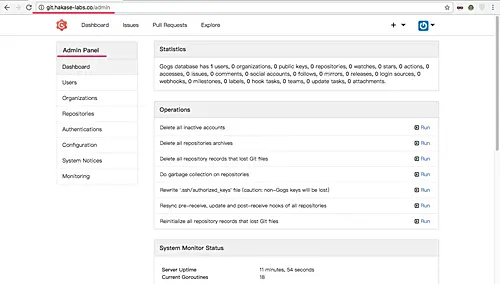
下面是 Gogs 的 “Admin Dashboard(管理员面板)”。

浏览 Gogs 面板

现在,Gogs 已经通过 PostgreSQL 数据库和 Nginx 网页服务器在您的 Ubuntu 16.04 上完成安装。


via: https://www.howtoforge.com/tutorial/how-to-install-gogs-go-git-service-on-ubuntu-1604/

作者:Muhammad Arul 译者:CYLeft 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出