如果你是关注计算机领域最新趋势的学生或从业者,你应该听说过人工智能、数据科学、机器学习、深度学习等术语。作为人工智能系列文章的第一篇,本文将解释这些术语,并搭建一个帮助初学者入门的简易教学平台。
如今,计算机科学领域的学生和从业者绝对有必要了解 人工智能 、 数据科学 、 机器学习 、 深度学习 方面的基本知识。但是应该从哪里开始呢?
为了找到答案,我浏览了大量人工智能的教材和教程。它们有的从大量数学理论开始,有的用编程语言无关的方式(不要求你了解某一门特定的编程语言)讲解,有的假设你是线性代数、概率论和统计学专家。在很大程度上,它们都很有用。但它们都没有回答最重要的问题:真正的初学者应该从哪里开始学习人工智能?
开始学习人工智能的方式多种多样,但是我对它们各有担忧。涉及太多的数学会让人分心,但如果数学介绍得太少就好像驾驶员不知道汽车引擎在哪里一样。对于未来的人工智能工程师和数据科学家来说,从进阶概念开始讲解是最有效率的方式,因为他们精通线性代数、概率论和统计学。如果从基础知识开始,然后在中间某个地方结束也可以,只要学员想要在这里结束学习。考虑到所有这些事实,我认为初学者的人工智能教程应该从基础知识开始,并以一个实际的人工智能项目结束。这个项目可能很小,但是在相同任务上它将会超越任何传统项目。
本系列将从最基础的知识讲到中等水平内容。除了讨论人工智能,我还希望对相关的话题进行一些澄清,因为人们对人工智能、机器学习、数据科学等术语有很多困惑。人工智能程序是必要的,因为我们每天会产生海量的数据。根据互联网上查询到的结果,我们每天大约会产生 2.5x10 18 字节的数据。但是,这些数据中的大多数与我们完全无关,包括大量没有价值的 YouTube 视频,不经思考就发送的电子邮件,琐碎的新闻报道等等。然而,这片浩瀚的数据海洋中同样蕴含着无价的宝贵知识。传统软件无法完成处理这些数据的艰巨任务。人工智能是少数能够应对这种信息过载的技术之一。
当谈到到人工智能时,我们还需要区分事实和假象。我记得几年前听一位人工智能专家的演讲。他讲述了一个人工智能图像识别系统,它能近乎绝对准确地分辨西伯利亚雪橇犬和西伯利亚雪狼的图像。在互联网上搜索一下,你会看到这两种动物有多么相似。如果这个系统确实那么准确,它将是人工智能的奇迹。可惜的是,事实并非如此。该图像识别系统只是对图像的背景进行了分类。西伯利亚雪橇犬是家养动物,它的图像背景中几乎总会有一些矩形或圆形的物体。而西伯利亚雪狼是野生动物,它所在的背景中有雪。这些例子导致近年来人们对人工智能提出了准确性担保要求。
确实,最近几年人工智能展现了一些真正的力量。举个简单例子就是 YouTube、Amazon 等网站的推荐系统。很多时候我惊讶于它们的推荐结果,就好像它们会读心术一样。然而不论这些推荐的质量如何,“人工智能到底是好是坏?”都是一个很热门话题。我认为,一个像《终结者》中机器有意识地攻击人类的未来还遥遥无期。然而,前面那句话中的“有意识地”一词非常重要。目前的人工智能系统可能发生故障,并且意外地伤害到人类。但是,许多号称具有人工智能能力的系统实际上只是包含大量分支和循环的常规软件。因此目前可以安全地说,我们还没有在日常生活中看到人工智能的真正威力。不论是好的影响(如治愈癌症),还是坏的影响(合成的世界领导人视频导致的暴动和战争),我们都只能拭目以待了。就个人而言,我相信人工智能是一种福祉,并将大大提高未来几代人的生活质量。
什么是人工智能?
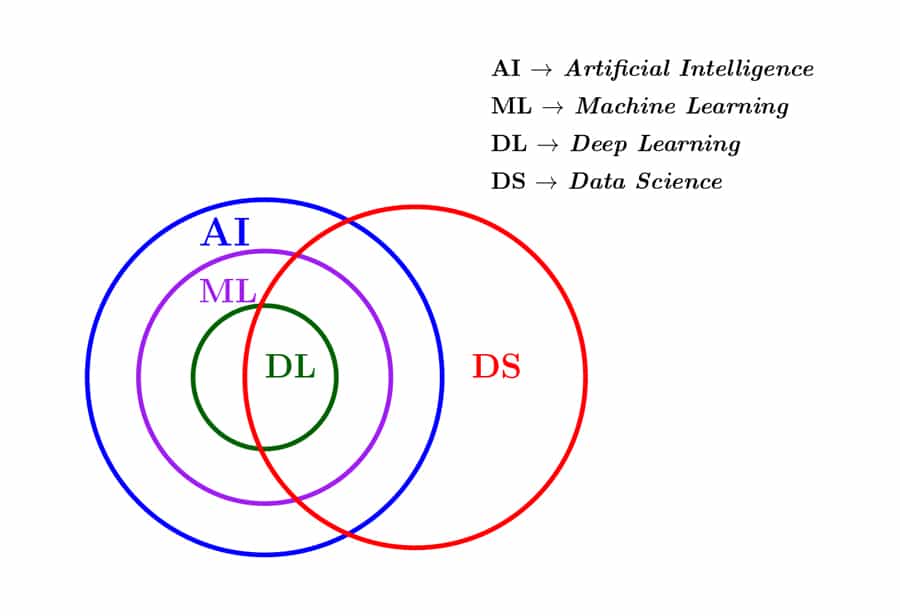
在我们进一步探讨之前,让我们试着理解人工智能(AI)、机器学习(ML)、深度学习(DL)、数据科学(DS)等之间的联系和区别。这些术语经常被误用为同义词。图 1 表示了人工智能、机器学习、深度学习和数据科学之间的关系。当然这不是唯一的划分方式,你可能会看到其它的划分图。但在我看来,图 1 是最贴切的,它能够最大程度地概括这些领域之间关系。
在本系列的第一篇文章中,我不会对每个术语定义进行精确的定义。我认为在现阶段,精确地定义它们是适得其反的,是浪费时间。但在后续的文章中,我们将重新讨论这些术语并正式定义它们。目前我们可以暂时把人工智能看作是可以在某种程度上模仿人类智能的程序。那人类智能又是指什么呢?
想象一下你的人工智能程序是一个一岁大的婴儿。这个宝宝会通过听周围人说话来学习母语。他/她将很快学会识别形状,颜色,物体等,没有任何困难。此外,他/她将能够对周围人的情绪做出反应。例如,任何一个三岁的婴儿都知道如何用甜言蜜语让父母给他/她巧克力和棒棒糖。同样,人工智能程序也将能够感知并适应环境,就像婴儿一样。然而,这种真正的人工智能只能在遥远的未来实现。
图 1 显示机器学习是人工智能的真子集,它也是实现人工智能系统的技术之一。机器学习是使用大量数据来训练程序的技术,以便有效地执行必要的任务。它的准确性随着训练集的增大而增加。请注意,还有其它技术用于开发人工智能系统,如基于布尔逻辑的系统,基于模糊逻辑的系统,基于遗传编程的系统等。然而,如今机器学习是实现人工智能系统的最主流的技术。图 1 还显示深度学习是机器学习的真子集,它只是众多机器学习技术中的一种。但目前实际上大多数严肃的机器学习技术都用到了深度学习。在这一点上,我甚至避免尝试定义深度学习。请记住,深度学习涉及到使用大型人工神经网络。
那数据科学(图 1 中的红圈)是做什么的呢?数据科学是计算机科学/数学领域中的一门处理和解读大规模数据的学科。我说的“大”,有多大呢?早在 2010 年,Facebook 等一些企业巨头就声称它们的服务器可以处理几 Pb 的数据。当我们说大数据时,通常指的是 Tb 或 Pb 级的数据规模,而不是 Gb 级的。许多数据科学应用涉及人工智能、机器学习和深度学习技术的使用。因此,当我们讨论人工智能时,很难不提到数据科学。数据科学也使用很多传统的编程和数据库管理技术,比如使用 Apache Hadoop 进行大数据分析。
本系列的讨论将主要集中在人工智能和机器学习上,并涉及数据科学。
教学环境搭建
在表明了本系列文章的主题后,现在说说本教程的前置条件。你需要一台 Linux 电脑(当然 Windows 或 macOS 机器也可以,只是在一些安装步骤上可能需要额外的协助),并了解基本的数学和计算机编程知识。我希望在细心地阅读本系列文章后,你会感受到人工智能的强大。
用编程语言无关的方式来学习人工智能是可能的,但本系列将基于一门编程语言并涉及大量的编程。在决定使用哪一门编程语言之前,我们先来回顾一下人工智能、机器学习、深度学习和数据科学领域流行的编程语言。Lisp 是一种函数式编程语言,它是最早用于开发人工智能程序的语言之一。Prolog 是一种逻辑编程语言,在 20 世纪 70 年代也被用于同样的目的。我们将在接下来的介绍人工智能历史的文章中更详细地介绍 Lisp 和 Prolog。
如今,Java、C、C++、Scala、Haskell、MATLAB、R、Julia 等编程语言也被用于开发人工智能程序。Python 在人工智能程序开发中被广泛使用,这使我们选择它作为本教程的编程语言。但我必须声明,从这里开始做的选择(更确切地说,是我替你做的选择),主要考虑的因素是易用性、受欢迎程度、(在少数情况下)我自己对该软件/技术的适应和熟悉程度、对本教程效率的提升。但同时,我也鼓励你尝试其它的编程语言、软件和工具。也许从长远来看,它们对你来说可能是更好的选择。
现在我们需要立即做出另一个选择:使用 Python 2 还是 Python 3?考虑到本系列有许多年轻的读者,他们还有漫长的职业生涯,我将选择使用 Python 3。在 Ubuntu 系统终端中执行命令 sudo apt install python3 安装最新版本的 Python 3(你的系统中可能已经安装了 Python 3)。在其它 Linux 发行版、Windows 和 macOS 机器上安装 Python 3 也非常容易。执行下面的命令查看安装的 Python 3 的版本:
python3 --version
Python 3.8.10
在后续的教程中,我们需要安装许多 Python 包,所以需要一个包管理器。目前主流的包管理器有 pip、Conda 和 Mamba 等。我选择 pip 作为包在本教程的管理器。它相对简单,也是推荐的 Python 安装工具。我认为 Conda 和 Mamba 是比 pip 更强大的工具,你可以尝试一下它们。运行命令 sudo apt install python3-pip 将在 Ubuntu 系统中安装 pip。pip、Conda 和 Mamba 是跨平台软件,它们可以安装在 Linux、Windows 和 macOS 系统上。运行命令 pip3 --version 查看系统中安装的 pip 版本,如下所示:
pip 20.0.2 from /usr/lib/python3/dist-packages/pip (python 3.8)
现在我们需要一个 Python 集成开发环境(IDE)。IDE 能帮助程序员更容易地编写、编译、调试和执行代码。PyCharm、IDLE、Spyder 等都是流行的 Python IDE。然而,由于我们的主要目的是开发人工智能和数据科学程序,这里考虑另外两个强有力的竞争者 —— JupyterLab 和谷歌 Colab。严格地说,它们不仅仅是 IDE;它们是非常强大的基于网络的交互式开发环境。两者都可以在网络浏览器上工作,并提供强大的功能。JupyterLab 是由非营利组织 Project Jupyter 支持的免费开源软件。谷歌 Colab 遵循 免费增值 模式,即基本功能免费,附加功能收费。我认为谷歌 Colab 比 JupyterLab 功能更强大。但是由于谷歌 Colab 的免费增值模式,以及我相对缺乏谷歌 Colab 的使用经验,在本教程中我选择 JupyterLab。但我仍然强烈建议你去了解一下谷歌 Colab。
可以使用命令 pip3 install JupyterLab 在本地安装 JupyterLab。执行命令 jupyter-lab 将在系统的默认网络浏览器中运行 JupyterLab。Project Jupyter 还提供一个更老的类似系统,称为Jupyter Notebook。可以通过 pip3 install Notebook 命令在本地安装 Jupyter Notebook,用Jupyter Notebook 运行它。但 Jupyter Notebook 的功能不如 JupyterLab 强大,且官方宣布它最终会被 JupyterLab 取代。在本教程中,我们将在合适的阶段使用 JupyterLab。但在开始阶段,我们将使用 Linux 终端来运行 Python 程序,因此急需的是包管理器 pip。
Anaconda 是一个非常流行的 Python 和 R 编程语言发行版,它主要用于机器学习和数据科学领域。作为未来的人工智能工程师和数据科学家,熟悉使用 Anaconda 也是一个不错的选择。
现在我们需要确定最重要的一点 —— 本教程的风格。有大量人工智能开发相关的 Python 库,比如 NumPy、SciPy、Pandas、Matplotlib、Seaborn、TensorFlow、Keras、Scikit-learn 和 PyTorch。许多关于人工智能、机器学习和数据科学的教材和教程都是基于对其中一个或多个库的完整讲解。尽管对特定包的功能进行这样的覆盖讲解是一种高效的方式,但我的教程是更面向数学的。我们将首先讨论开发人工智能程序所需的数学概念,然后再介绍需要的 Python 基础知识和 Python 库。我们会为了探索实现这些数学概念所需的特性而不断回顾这些 Python 库。有时我也会要求你自己学习一些 Python 和数学的基本概念。
在完成这些准备工作之后,如果我们就在这里结束,任何代码或数学概念都不讲,那将是一种罪过。因此,我们将继续学习人工智能和机器学习中最重要的数学概念:向量和矩阵。
向量和矩阵
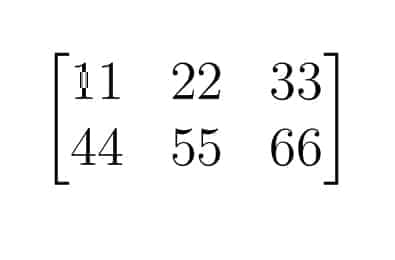
矩阵是按行和列排列的数字、符号或数学表达式构成的矩形阵列。图 2 显示了一个 2 × 3 矩阵,它有 2 行和 3 列。如果你熟悉编程,在许多流行的编程语言中这个矩阵可以表示为一个二维数组。只有一行的矩阵称为行向量,只有一列的矩阵称为列向量。  就是一个行向量。
为什么矩阵和向量在人工智能和机器学习中如此重要呢?人工智能和机器学习中广泛使用线性代数,而矩阵和向量是线性代数的核心。几个世纪以来,数学家们一直在研究矩阵和向量的性质和应用。高斯、欧拉、莱布尼茨、凯利、克莱姆和汉密尔顿等数学家在线性代数和矩阵论领域都有以他们的名字命名的定理。多年来,线性代数中发展出了许多分析矩阵和向量性质的技术。
复杂的数据通常可以很容易用向量或矩阵来表示。举一个简单的例子,从一个人的医疗记录中,可以得到详细的年龄、身高(厘米)、体重(公斤)、收缩压、舒张压和空腹血糖(毫克/分升)。这些信息可以很容易用行向量来表示,  。人工智能和机器学习的第一个挑战来了:如果医疗记录有十亿条怎么办?即使动用成千上万的专业人员从中手动提取数据,这项任务也是无法完成的。因此,人工智能和机器学习利用程序来提取数据。
人工智能和机器学习的第二个挑战是数据解读。这是一个广阔的领域,有许多技术值得探索。我将在后续文章中介绍相关内容。人工智能和机器学习应用除了面临数学/计算方面的挑战外,还面临硬件方面的挑战。随着处理的数据量的增加,数据存储、处理器速度、功耗等也成为人工智能应用面临的重要挑战。但现在让我们先抛开这些挑战,动手编写第一行人工智能代码。
我们将编写一个简单的 Python 脚本,用来将两个向量相加。我们将用到名为 NumPy 的 Python 库,它支持多维矩阵(数组)的数学运算。用命令 pip3 install numpy 为 Python 3 安装 NumPy 包。如果你使用的是 JupyterLab、谷歌 Colab 或 Anaconda,那么 NumPy 应该已经被预安装了。但是为了演示,在本系列的前几篇文章中,我们都将在 Linux 终端上操作。在 Linux 终端上执行命令 python3 进入 Python 控制台。在这个控制台中可以逐行执行 Python 代码。图 3 展示了在控制台中逐行运行 Python 代码,将两个向量相加,并输出结果。
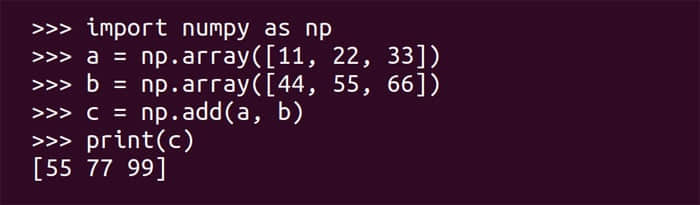
首先,让我们试着逐行理解这些代码。由于本教程假定的编程经验很少,所以我将代码行标记为【基本】或【AI】。标记为【基本】的行是经典 Python 代码,标记为【AI】的行是用于开发人工智能程序的代码。通过区分基本和进阶的 Python 代码,我希望具有基本知识和中级编程技能的程序员都能够高效地使用本教程。
import numpy as np         #【基本】
a = np.array([11, 22, 33]) #【AI】
b = np.array([44, 55, 66]) #【AI】
c = np.add(a, b)           #【AI】
print(c)                   #【基本】
import numpy as np 导入 numpy 库并将其命名为 np。Python 中的 import 语句类似于在 C/C++ 用 #include 来包含头文件,或者在 Java 中用import 来使用包。
a = np.array([11, 22, 33]) 和 b = np.array([44, 55, 66]) 分别创建了名为 a 和 b 的一维数组(为了便于理解,目前假设向量等价于一维数组)。
c = np.add(a, b) 将向量 a 和b 相加,并将结果存储在名为 c 的向量中。当然,用 a,b,c 作为变量名是一种糟糕的编程实践,但数学家倾向于将向量命名为  、
 、
 等。如果你完全没有 Python 编程经验,请自行了解 Python 变量的相关知识。
print(c) 在终端上打印对象的值,即向量 [55 77 99]。你可以暂时这样理解向量相加, c = [55=11+44 77=22+55 99=33+66]。如果你想正式地了解向量和矩阵是如何相加的,但手头又没有相关的教材,我建议阅读维基百科上关于矩阵加法的文章。在网上搜索一下就会发现,用经典的 C/C++ 或 Java 程序来实现向量相加需要更多的代码。这说明 Python 很适合处理向量和矩阵。当我们执行越来越复杂的向量运算时,Python 的强大将进一步显现。
在我们结束本文之前,我要做两个声明。第一,上面讨论的示例只处理了两个行向量(确切地说是 1 x 3 的矩阵)的相加,但真正的机器学习应用可能要处理 1000000 X 1000000 的矩阵。但不用担心,通过练习和耐心,我们将能够处理这些问题。第二,本文中给出许多定义包含了粗略的简化和不充分的描述。但如前面所说,在本系列结束之前,我将给这些模糊的术语下一个正式的定义。
现在我们该结束这篇文章了。我希望所有人都安装文中提到的必要软件,并运行本文中的代码。在下一篇文章中,我们将首先讨论人工智能的历史、范畴和未来,然后深入探讨线性代数的支柱——矩阵论。
(题图:MJ/25071901-abc4-4144-bf27-4d98bb1d9301/)
via: https://www.opensourceforu.com/2022/08/artificial-intelligence-explaining-the-basics/
作者:Deepu Benson 选题:lkxed 译者:toknow-gh 校对:wxy
本文由 LCTT 原创编译,Linux中国 荣誉推出