分类 软件开发 下的文章

在我的上一篇文章中,我试图解释为什么我认为 Hyperapp 是一个 React 或 Vue 的可用替代品,原因是,我发现它易于起步。许多人批评这篇文章,认为它自以为是,并没有给其它框架一个展示自己的机会。因此,在这篇文章中,我将尽可能客观的通过提供一些最小化的例子来比较这三个框架,以展示它们的能力。

耳熟能详的计时器例子

计时器可能是响应式编程中最常用的例子之一,极其易于理解:

  • 你需要一个变量 count 保持对计数器的追踪。
  • 你需要两个方法来增加或减少 count 变量的值。
  • 你需要一种方法来渲染 count 变量,并将其呈现给用户。
  • 你需要挂载到这两个方法上的两个按钮,以便在用户和它们产生交互时变更 count 变量。

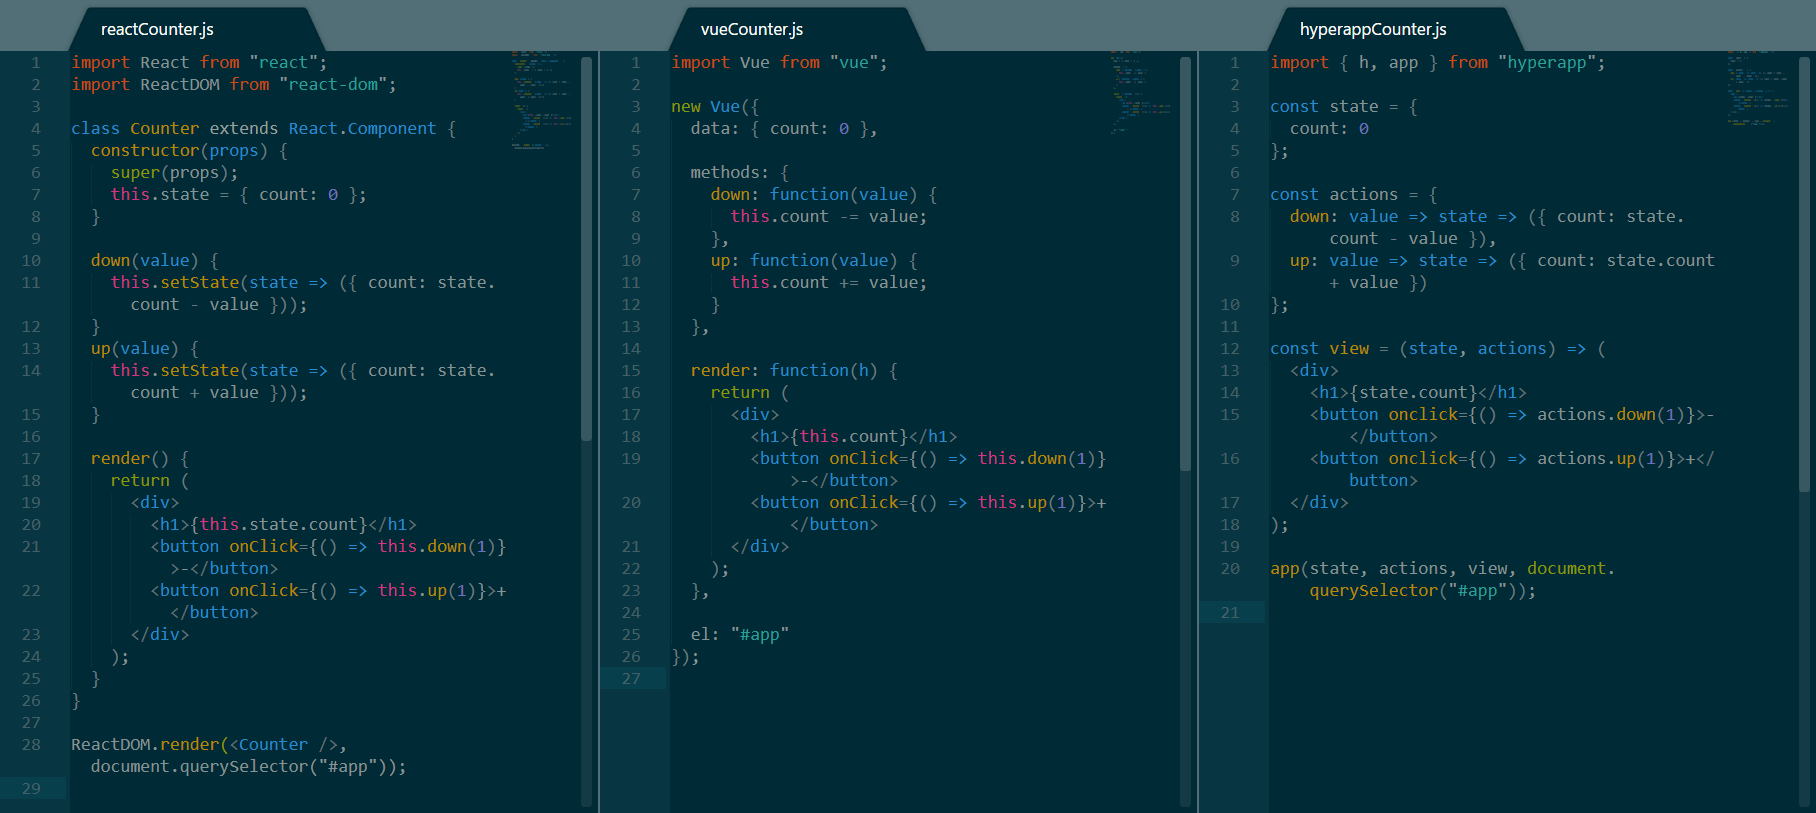
下述代码是上述所有三个框架的实现:

使用 React、Vue 和 Hyperapp 实现的计数器

这里或许会有很多要做的事情,特别是当你并不熟悉其中的一个或多个步骤的时候,因此,我们来一步一步解构这些代码:

  • 这三个框架的顶部都有一些 import 语句
  • React 更推崇面向对象的范式,就是创建一个 Counter 组件的 class。Vue 遵循类似的范式,通过创建一个新的 Vue 类的实例并将信息传递给它来实现。最后,Hyperapp 坚持函数范式,同时完全彼此分离 view、state和action。
  • 就 count 变量而言, React 在组件的构造函数内对其进行实例化,而 Vue 和 Hyperapp 则分别是在它们的 data 和 state 中设置这些属性。
  • 继续看,你可能注意到 React 和 Vue 有相同的方法来与 count 变量进行交互。 React 使用继承自 React.Component 的 setState 方法来修改它的状态,而 Vue 直接修改 this.count。 Hyperapp 使用 ES6 的双箭头语法来实现这个方法,而据我所知,这是唯一一个推荐使用这种语法的框架,React 和 Vue 需要在它们的方法内使用 this。另一方面,Hyperapp 的方法需要将状态作为参数,这意味着可以在不同的上下文中重用它们。
  • 这三个框架的渲染部分实际上是相同的。唯一的细微差别是 Vue 需要一个函数 h 作为参数传递给渲染器,事实上 Hyperapp 使用 onclick 替代 onClick ,以及基于每个框架中实现状态的方式引用 count 变量。
  • 最后,所有的三个框架都被挂载到了 #app 元素上。每个框架都有稍微不同的语法,Vue 则使用了最直接的语法,通过使用元素选择器而不是使用元素来提供最大的通用性。

计数器案例对比意见

同时比较所有的三个框架,Hyperapp 需要最少的代码来实现计数器,并且它是唯一一个使用函数范式的框架。然而,Vue 的代码在绝对长度上似乎更短一些,元素选择器的挂载方式是一个很好的增强。React 的代码看起来最多,但是并不意味着代码不好理解。

使用异步代码

偶尔你可能需要处理异步代码。最常见的异步操作之一是发送请求给一个 API。为了这个例子的目的,我将使用一个[占位 API] 以及一些假数据来渲染一个文章列表。必须做的事情如下:

  • 在状态里保存一个 posts 的数组
  • 使用一个方法和正确的 URL 来调用 fetch() ,等待返回数据,转化为 JSON,并最终使用接收到的数据更新 posts 变量。
  • 渲染一个按钮,这个按钮将调用抓取文章的方法。
  • 渲染有主键的 posts 列表。

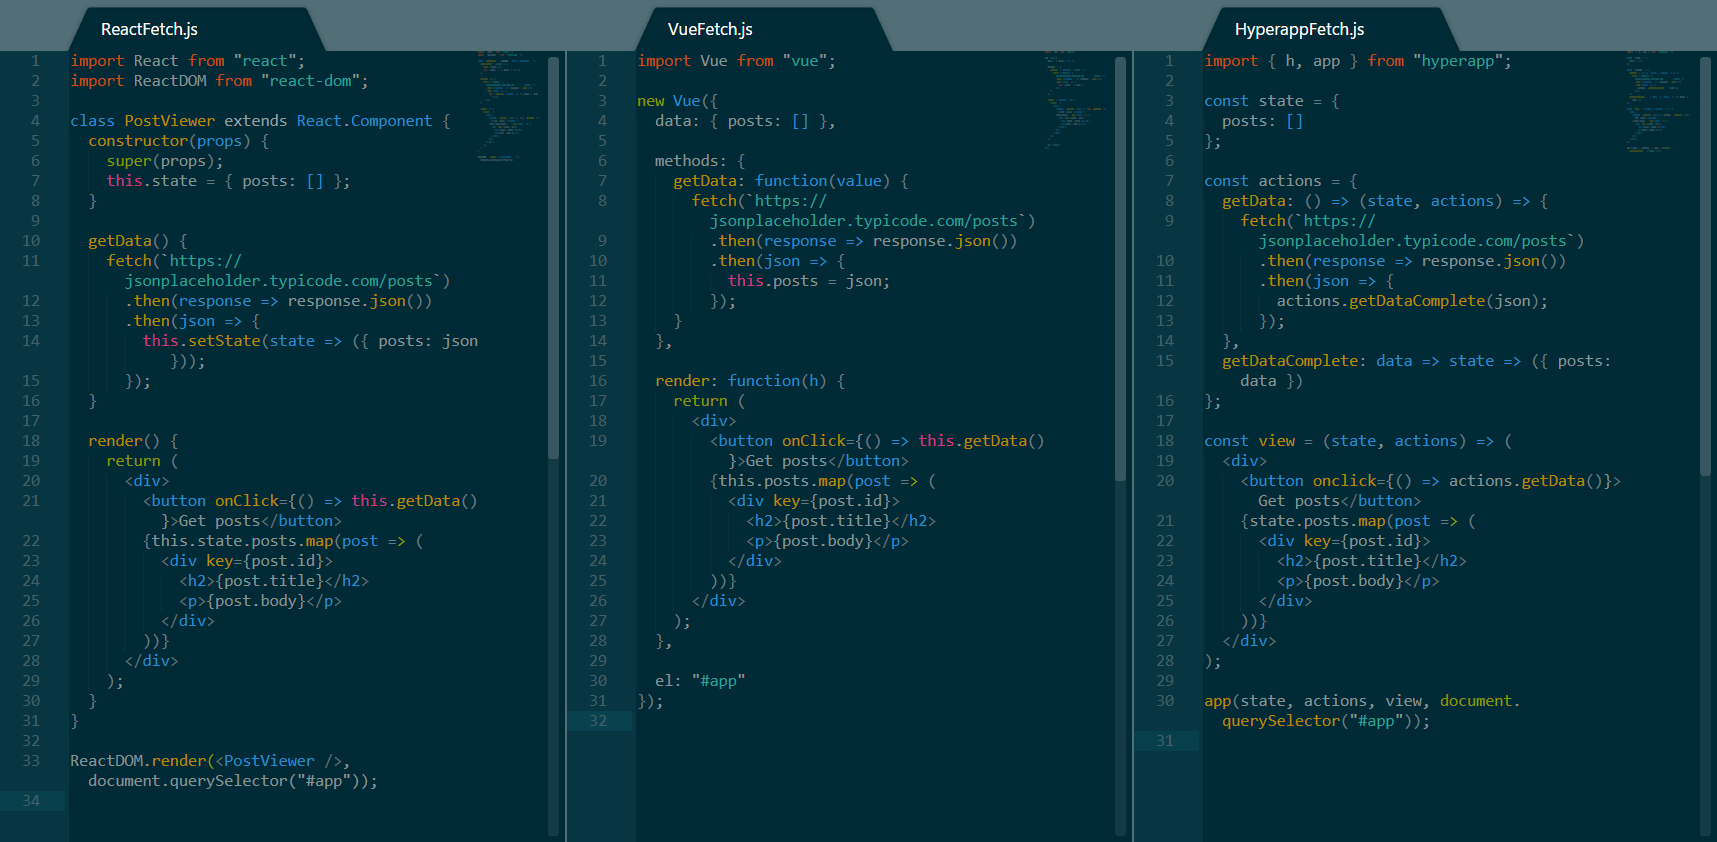
从一个 RESTFul API 抓取数据

让我们分解上面的代码,并比较三个框架:

  • 与上面的技术里例子类似,这三个框架之间的存储状态、渲染视图和挂载非常相似。这些差异与上面的讨论相同。
  • 在三个框架中使用 fetch() 抓取数据都非常简单,并且可以像预期一样工作。然而其中的关键在于, Hyperapp 处理异步操作和其它两种框架有些不同。当数据被接收到并转换为 JSON 时,该操作将调用不同的同步动作以取代直接在异步操作中修改状态。
  • 就代码长度而言,Hyperapp 依然只用最少的代码行数实现了相同的结果,但是 Vue 的代码看起来不那么的冗长,同时拥有最少的绝对字符长度。

异步代码对比意见

无论你选择哪种框架,异步操作都非常简单。在应用异步操作时, Hyperapp 可能会迫使你去遵循编写更加函数化和模块化的代码的方式。但是另外两个框架也确实可以做到这一点,并且在这一方面给你提供更多的选择。

To-Do 列表组件案例

在响应式编程中,最出名的例子可能是使用每一个框架里来实现 To-Do 列表。我不打算在这里实现整个部分,我只实现一个无状态的组件,来展示三个框架如何创建更小的可复用的块来协助构建应用程序。
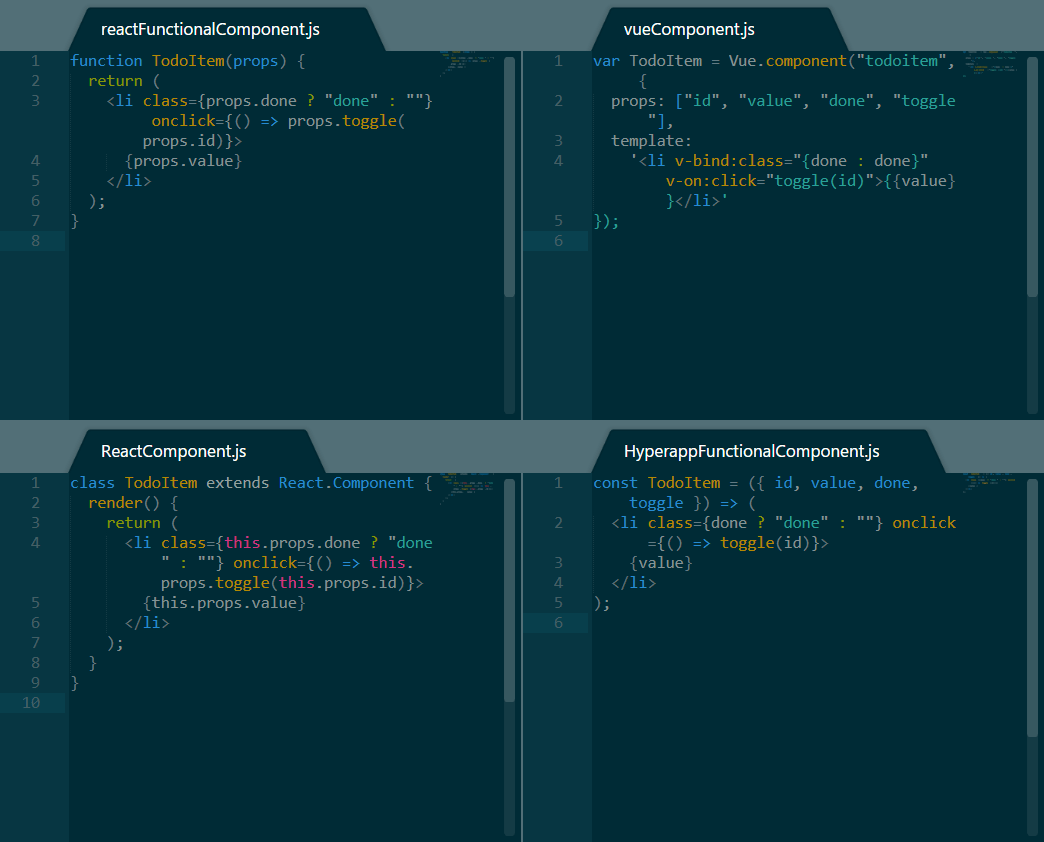
示例 TodoItem 实现

上面的图片展示了每一个框架一个例子,并为 React 提供了一个额外的例子。接下来是我们从它们四个中看到的:

  • React 在编程范式上最为灵活。它支持函数组件,也支持类组件。它还支持你在右下角看到的 Hyperapp 组件,无需任何修改。
  • Hyperapp 还支持 React 的函数组件实现,这意味着两个框架之间还有很多的实验空间。
  • 最后出现的 Vue 有着其合理而又奇怪的语法,即使是对另外两个框架很有经验的人,也不能马上理解其含义。
  • 在长度方面,所有的案例代码长度非常相似,在 React 的一些方法中稍微冗长一些。

To-Do 列表项目对比意见

Vue 需要花费一些时间来熟悉,因为它的模板和其它两个框架有一些不同。React 非常的灵活,支持多种不同的方法来创建组件,而 HyperApp 保持一切简单,并提供与 React 的兼容性,以免你希望在某些时刻进行切换。

生命周期方法比较

另一个关键对比是组件的生命周期事件,每一个框架允许你根据你的需要来订阅和处理事件。下面是我根据各框架的 API 参考手册创建的表格:
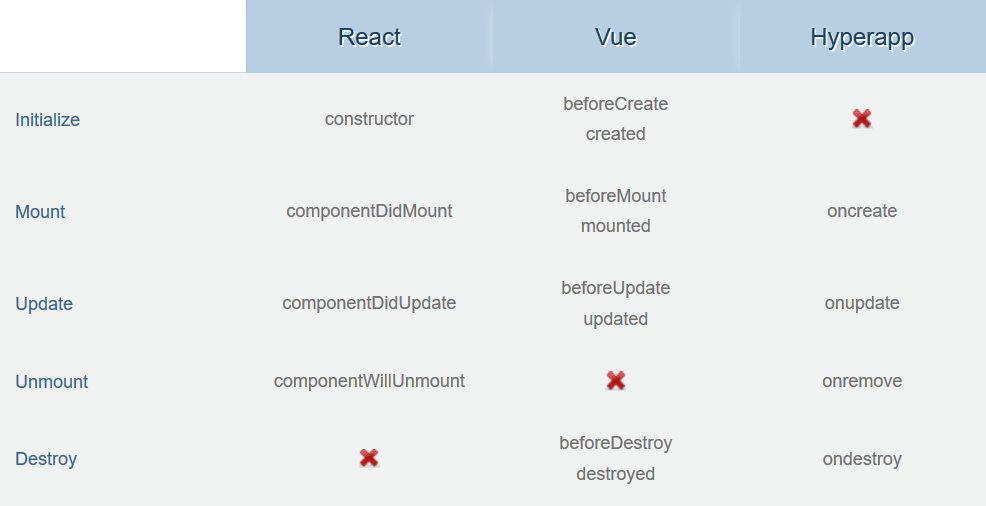
生命周期方式比较

  • Vue 提供了最多的生命周期钩子,提供了处理生命周期事件之前或之后发生的任何事件的机会。这能有效帮助管理复杂的组件。
  • React 和 Hyperapp 的生命周期钩子非常类似,React 将 unmount 和 destory 绑定在了一起,而 Hyperapp 则将 create 和 mount 绑定在了一起。两者在处理生命周期事件方面都提供了相当多的控制。
  • Vue 根本没有处理 unmount (据我所理解),而是依赖于 destroy 事件在组件稍后的生命周期进行处理。 React 不处理 destory 事件,而是选择只处理 unmount 事件。最终,HyperApp 不处理 create 事件,取而代之的是只依赖 mount 事件。

生命周期对比意见

总的来说,每个框架都提供了生命周期组件,它们帮助你处理组件生命周期中的许多事情。这三个框架都为它们的生命周期提供了钩子,其之间的细微差别,可能源自于实现和方案上的根本差异。通过提供更细粒度的时间处理,Vue 可以更进一步的允许你在开始或结束之后处理生命周期事件。

性能比较

除了易用性和编码技术以外,性能也是大多数开发人员考虑的关键因素,尤其是在进行更复杂的应用程序时。js-framework-benchmark 是一个很好的用于比较框架的工具,所以让我们看看每一组测评数据数组都说了些什么:
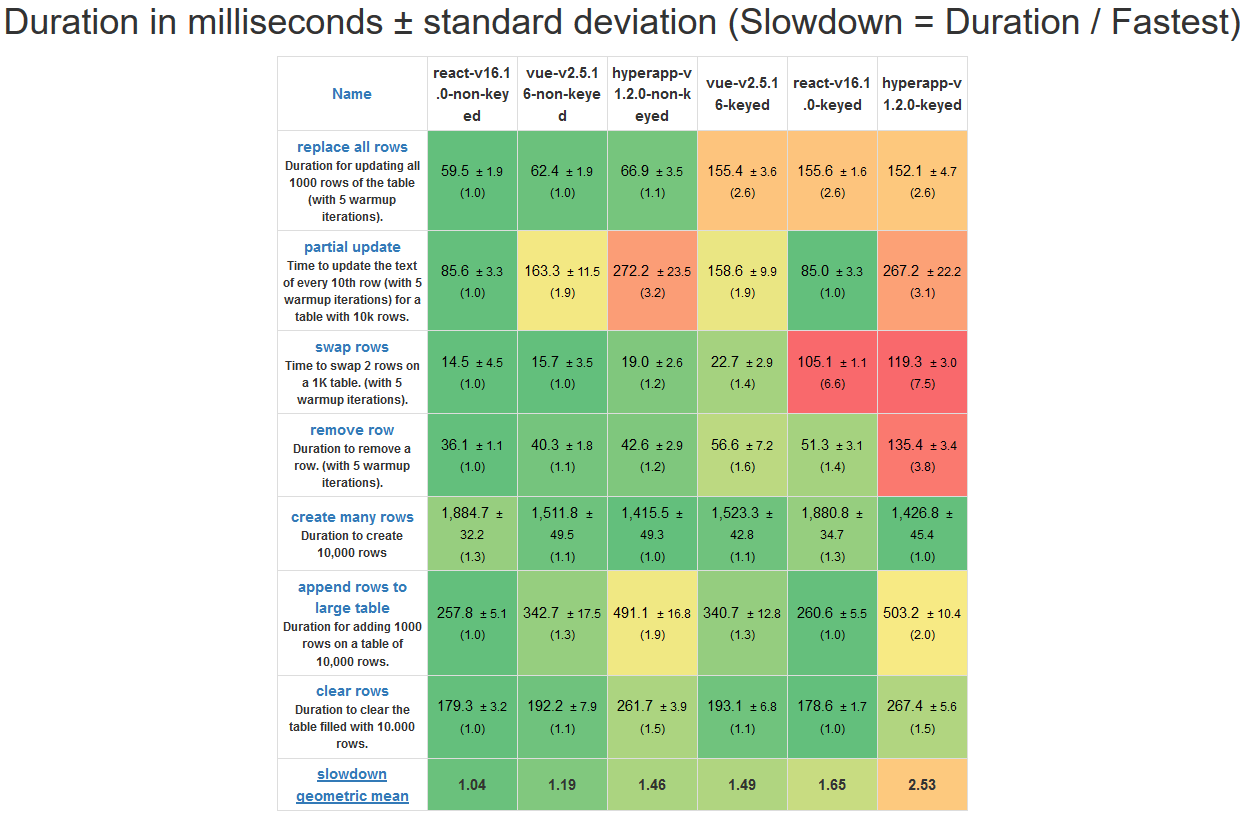
测评操作表

  • 与三个框架的有主键操作相比,无主键操作更快。
  • 无主键的 React 在所有六种对比中拥有最强的性能,它在所有测试上都有令人深刻的表现。
  • 有主键的 Vue 只比有主键的 React 性能稍强,而无主键的 Vue 要比无主键的 React 性能明显差。
  • Vue 和 Hyperapp 在进行局部更新的性能测试时遇见了一些问题,与此同时,React 似乎对该问题进行很好的优化。
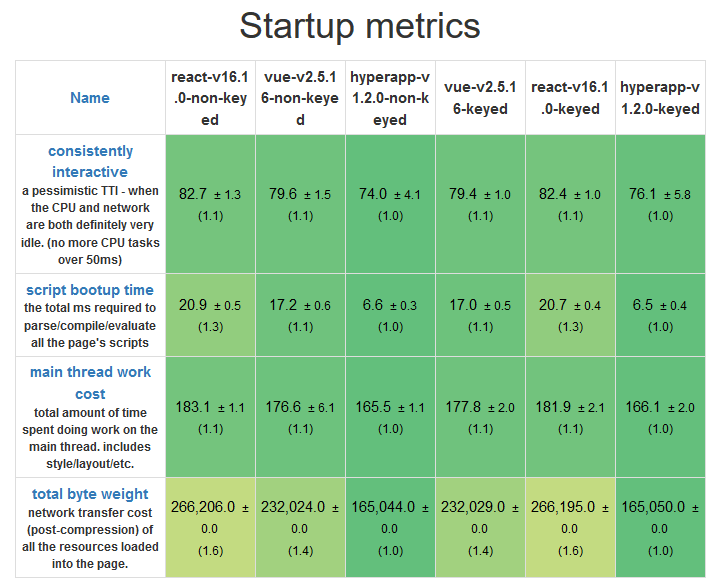
启动测试

  • Hyperapp 是三个框架中最轻量的,而 React 和 Vue 有非常小的大小差异。
  • Hyperapp 具有最快的启动时间,这得益于它极小的大小和极简的 API
  • Vue 在启动上比 React 好一些,但是差异非常小。

内存分配测试

  • Hyperapp 是三者中对资源依赖最小的一个,与其它两者相比,任何一个操作都需要更少的内存。
  • 资源消耗不是非常高,三者都应该在现代硬件上进行类似的操作。

性能对比意见

如果性能是一个问题,你应该考虑你正在使用什么样的应用程序以及你的需求是什么。看起来 Vue 和 React 用于更复杂的应用程序更好,而 Hyperapp 更适合于更小的应用程序、更少的数据处理和需要快速启动的应用程序,以及需要在低端硬件上工作的应用程序。

但是,要记住,这些测试远不能代表一般场景,所以在现实场景中可能会看到不同的结果。

额外备注

比较 React、Vue 和 Hyperapp 可能像在许多方面比较苹果、橘子。关于这些框架还有一些其它的考虑,它们可以帮助你决定使用另一个框架。

  • React 通过引入片段,避免了相邻的 JSX 元素必须封装在父元素中的问题,这些元素允许你将子元素列表分组,而无需向 DOM 添加额外的节点。
  • React 还为你提供更高级别的组件,而 VUE 为你提供重用组件功能的 MIXIN。
  • Vue 允许使用模板来分离结构和功能,从而更好的分离关注点。
  • 与其它两个相比,Hyperapp 感觉像是一个较低级别的 API,它的代码短得多,如果你愿意调整它并学习它的工作原理,那么它可以提供更多的通用性。

结论

我认为如果你已经阅读了这么多,你已经知道哪种工具更适合你的需求。毕竟,这不是讨论哪一个更好,而是讨论哪一个更适合每种情况。总而言之:

  • React 是一个非常强大的工具,围绕它有大规模的开发者社区,可能会帮助你找到一个工作。入门并不难,但是掌握它肯定需要很多时间。然而,这是非常值得去花费你的时间全面掌握的。
  • 如果你过去曾使用过另外的 JavaScript 框架,Vue 可能看起来有点奇怪,但它也是一个非常有趣的工具。如果 React 不是你所喜欢的,那么它可能是一个可行的、值得学习的选择。它有一些非常酷的内置功能,其社区也在增长中,甚至可能要比 React 增长还要快。
  • 最后,Hyperapp 是一个为小型项目而生的很酷的小框架,也是初学者入门的好地方。它提供比 React 或 Vue 更少的工具,但是它能帮助你快速构建原型并理解许多基本原理。你为它编写的许多代码和其它两个框架兼容,要么立即能用,或者是稍做更改就行,你可以在对它们中另外一个有信心时切换框架。

作者简介:

喜欢编码的 Web 开发者,“30 秒编码” ( https://30secondsofcode.org/)和mini.css框架(http://minicss.org ) 的创建者。


via: https://hackernoon.com/javascript-framework-comparison-with-examples-react-vue-hyperapp-97f064fb468d

作者:Angelos Chalaris
译者:Bestony
校对:wxy
本文由 LCTT 原创编译,Linux中国 荣誉推出

这篇文章受到了我与同事讨论使用 切片 slice 作为 栈 stack 的一次聊天的启发。后来话题聊到了 Go 语言中的切片是如何工作的。我认为这些信息对别人也有用,所以就把它记录了下来。

数组

任何关于 Go 语言切片的讨论都要从另一个数据结构也就是 数组 array 开始。Go 的数组有两个特性:

  1. 数组的长度是固定的;[5]int 是由 5 个 int 构成的数组,和 [3]int 不同。
  2. 数组是值类型。看下面这个示例:
package main

import "fmt"

func main() {
        var a [5]int
        b := a
        b[2] = 7
        fmt.Println(a, b) // prints [0 0 0 0 0] [0 0 7 0 0]
}

语句 b := a 定义了一个类型是 [5]int 的新变量 b,然后把 a 中的内容 复制 到 b 中。改变 b 对 a 中的内容没有影响,因为 a 和 b 是相互独立的值。 1

切片

Go 语言的切片和数组的主要有如下两个区别:

  1. 切片没有一个固定的长度。切片的长度不是它类型定义的一部分,而是由切片内部自己维护的。我们可以使用内置的 len 函数知道它的长度。 2
  2. 将一个切片赋值给另一个切片时 不会 对切片内容进行复制操作。这是因为切片没有直接持有其内部数据,而是保留了一个指向 底层数组 3 的指针。数据都保留在底层数组里。

基于第二个特性,两个切片可以享有共同的底层数组。看下面的示例:

  1. 对切片取切片
package main

import "fmt"

func main() {
        var a = []int{1,2,3,4,5}
        b := a[2:]
        b[0] = 0
        fmt.Println(a, b) // prints [1 2 0 4 5] [0 4 5]
}

在这个例子里,a 和 b 享有共同的底层数组 —— 尽管 b 在数组里的起始偏移量不同,两者的长度也不同。通过 b 修改底层数组的值也会导致 a 里的值的改变。

  1. 将切片传进函数
package main

import "fmt"

func negate(s []int) {
        for i := range s {
                s[i] = -s[i]
        }
}

func main() {
        var a = []int{1, 2, 3, 4, 5}
        negate(a)
        fmt.Println(a) // prints [-1 -2 -3 -4 -5]
}

在这个例子里,a 作为形参 s 的实参传进了 negate 函数,这个函数遍历 s 内的元素并改变其符号。尽管 nagate 没有返回值,且没有访问到 main 函数里的 a。但是当将之传进 negate 函数内时,a 里面的值却被改变了。

大多数程序员都能直观地了解 Go 语言切片的底层数组是如何工作的,因为它与其它语言中类似数组的工作方式类似。比如下面就是使用 Python 重写的这一小节的第一个示例:

Python 2.7.10 (default, Feb  7 2017, 00:08:15)
[GCC 4.2.1 Compatible Apple LLVM 8.0.0 (clang-800.0.34)] on darwin
Type "help", "copyright", "credits" or "license" for more information.
>>> a = [1,2,3,4,5]
>>> b = a
>>> b[2] = 0
>>> a
[1, 2, 0, 4, 5]

以及使用 Ruby 重写的版本:

irb(main):001:0> a = [1,2,3,4,5]
=> [1, 2, 3, 4, 5]
irb(main):002:0> b = a
=> [1, 2, 3, 4, 5]
irb(main):003:0> b[2] = 0
=> 0
irb(main):004:0> a
=> [1, 2, 0, 4, 5]

在大多数将数组视为对象或者是引用类型的语言也是如此。 4

切片头

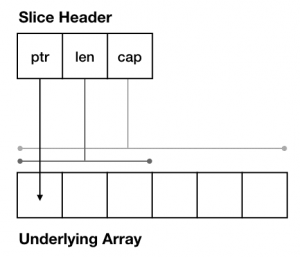
切片同时拥有值和指针特性的神奇之处在于理解切片实际上是一个 结构体 struct 类型。通常在 反射 reflect 包内相应部分之后的这个结构体被称作 切片头 slice header 。切片头的定义大致如下:

package runtime

type slice struct {
        ptr   unsafe.Pointer
        len   int
        cap   int
}

这很重要,因为和 map 以及 chan 这两个类型不同,切片是值类型,当被赋值或者被作为参数传入函数时候会被复制过去。

程序员们都能理解 square 的形参 v 和 main 中声明的 v 的是相互独立的。请看下面的例子:

package main

import "fmt"

func square(v int) {
        v = v * v
}

func main() {
        v := 3
        square(v)
        fmt.Println(v) // prints 3, not 9
}

因此 square 对自己的形参 v 的操作没有影响到 main 中的 v。下面这个示例中的 s 也是 main 中声明的切片 s 的独立副本, 而不是 指向 main 的 s 的指针。

package main

import "fmt"

func double(s []int) {
        s = append(s, s...)
}

func main() {
        s := []int{1, 2, 3}
        double(s)
        fmt.Println(s, len(s)) // prints [1 2 3] 3
}

Go 的切片是作为值传递而不是指针这一点不太寻常。当你在 Go 内定义一个结构体时,90% 的时间里传递的都是这个结构体的指针 5 。切片的传递方式真的很不寻常,我能想到的唯一与之相同的例子只有 time.Time。

切片作为值传递而不是作为指针传递这一特殊行为会让很多想要理解切片的工作原理的 Go 程序员感到困惑。你只需要记住,当你对切片进行赋值、取切片、传参或者作为返回值等操作时,你是在复制切片头结构的三个字段:指向底层数组的指针、长度,以及容量。

总结

我们来用引出这一话题的切片作为栈的例子来总结下本文的内容:

package main

import "fmt"

func f(s []string, level int) {
        if level > 5 {
               return
        }
        s = append(s, fmt.Sprint(level))
        f(s, level+1)
        fmt.Println("level:", level, "slice:", s)
}

func main() {
        f(nil, 0)
}

在 main 函数的最开始我们把一个 nil 切片传给了函数 f 作为 level 0 。在函数 f 里我们把当前的 level 添加到切片的后面,之后增加 level 的值并进行递归。一旦 level 大于 5,函数返回,打印出当前的 level 以及它们复制到的 s 的内容。

level: 5 slice: [0 1 2 3 4 5]
level: 4 slice: [0 1 2 3 4]
level: 3 slice: [0 1 2 3]
level: 2 slice: [0 1 2]
level: 1 slice: [0 1]
level: 0 slice: [0]

你可以注意到在每一个 level 内 s 的值没有被别的 f 的调用影响,尽管当计算更高的 level 时作为 append 的副产品,调用栈内的四个 f 函数创建了四个底层数组 6 ,但是没有影响到当前各自的切片。

扩展阅读

如果你想要了解更多 Go 语言内切片运行的原理,我建议看看 Go 博客里的这些文章:

相关文章:

  1. If a map isn't a reference variable, what is it?
  2. What is the zero value, and why is it useful?
  3. The empty struct
  4. Should methods be declared on T or *T

  1. 这不是数组才有的特性,在 Go 语言里中 一切 赋值都是复制过去的。 ↩
  2. 你也可以在对数组使用 len 函数,但是其结果本来就人尽皆知。 ↩
  3. 有时也叫做 后台数组 backing array ,以及更不严谨的说法是后台切片。 ↩
  4. Go 语言里我们倾向于说值类型以及指针类型,因为 C++ 的 引用 reference 类型这个词产生误会。但在这里我认为调用数组作为引用类型是没有问题的。 ↩
  5. 如果你的结构体有定义在其上的方法或者用于满足某个接口,那么你传入结构体指针的比率可以飙升到接近 100%。 ↩
  6. 证明留做习题。 ↩

via: https://dave.cheney.net/2018/07/12/slices-from-the-ground-up

作者:Dave Cheney 译者:name1e5s 校对:pityonline

本文由 LCTT 原创编译,Linux中国 荣誉推出

在我前面的博客文章 “我的第一个 Go 微服务:使用 MongoDB 和 Docker 多阶段构建” 中,我创建了一个 Go 微服务示例,它发布一个 REST 式的 http 端点,并将从 HTTP POST 中接收到的数据保存到 MongoDB 数据库。

在这个示例中,我将数据的保存和 MongoDB 分离,并创建另一个微服务去处理它。我还添加了 Kafka 为消息层服务,这样微服务就可以异步处理它自己关心的东西了。

如果你有时间去看,我将这个博客文章的整个过程录制到 这个视频中了 :)

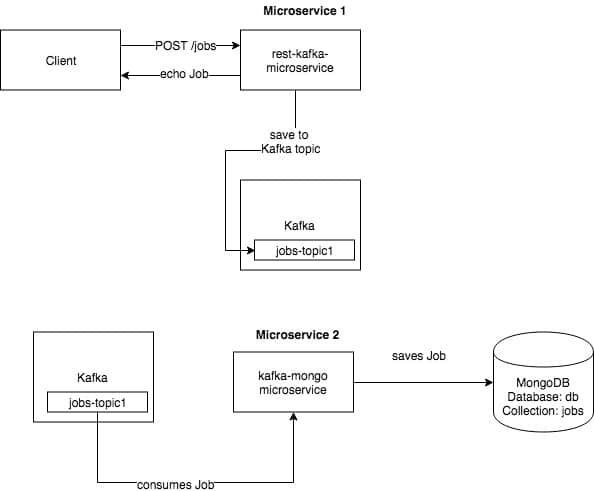
下面是这个使用了两个微服务的简单的异步处理示例的上层架构图。

rest-kafka-mongo-microservice-draw-io

微服务 1 —— 是一个 REST 式微服务,它从一个 /POST http 调用中接收数据。接收到请求之后,它从 http 请求中检索数据,并将它保存到 Kafka。保存之后,它通过 /POST 发送相同的数据去响应调用者。

微服务 2 —— 是一个订阅了 Kafka 中的一个主题的微服务,微服务 1 的数据保存在该主题。一旦消息被微服务消费之后,它接着保存数据到 MongoDB 中。

在你继续之前,我们需要能够去运行这些微服务的几件东西:

  1. 下载 Kafka —— 我使用的版本是 kafka\_2.11-1.1.0
  2. 安装 librdkafka —— 不幸的是,这个库应该在目标系统中
  3. 安装 Kafka Go 客户端
  4. 运行 MongoDB。你可以去看我的 以前的文章 中关于这一块的内容,那篇文章中我使用了一个 MongoDB docker 镜像。

我们开始吧!

首先,启动 Kafka,在你运行 Kafka 服务器之前,你需要运行 Zookeeper。下面是示例:

$ cd /<download path>/kafka_2.11-1.1.0
$ bin/zookeeper-server-start.sh config/zookeeper.properties

接着运行 Kafka —— 我使用 9092 端口连接到 Kafka。如果你需要改变端口,只需要在 config/server.properties 中配置即可。如果你像我一样是个新手,我建议你现在还是使用默认端口。

$ bin/kafka-server-start.sh config/server.properties

Kafka 跑起来之后,我们需要 MongoDB。它很简单,只需要使用这个 docker-compose.yml 即可。

version: '3'
services:
  mongodb:
    image: mongo
    ports:
      - "27017:27017"
    volumes:
      - "mongodata:/data/db"
    networks:
      - network1

volumes:
   mongodata:

networks:
   network1:

使用 Docker Compose 去运行 MongoDB docker 容器。

docker-compose up

这里是微服务 1 的相关代码。我只是修改了我前面的示例去保存到 Kafka 而不是 MongoDB:

rest-to-kafka/rest-kafka-sample.go

func jobsPostHandler(w http.ResponseWriter, r *http.Request) {

    //Retrieve body from http request
    b, err := ioutil.ReadAll(r.Body)
    defer r.Body.Close()
    if err != nil {
        panic(err)
    }

    //Save data into Job struct
    var _job Job
    err = json.Unmarshal(b, &_job)
    if err != nil {
        http.Error(w, err.Error(), 500)
        return
    }

    saveJobToKafka(_job)

    //Convert job struct into json
    jsonString, err := json.Marshal(_job)
    if err != nil {
        http.Error(w, err.Error(), 500)
        return
    }

    //Set content-type http header
    w.Header().Set("content-type", "application/json")

    //Send back data as response
    w.Write(jsonString)

}

func saveJobToKafka(job Job) {

    fmt.Println("save to kafka")

    jsonString, err := json.Marshal(job)

    jobString := string(jsonString)
    fmt.Print(jobString)

    p, err := kafka.NewProducer(&kafka.ConfigMap{"bootstrap.servers": "localhost:9092"})
    if err != nil {
        panic(err)
    }

    // Produce messages to topic (asynchronously)
    topic := "jobs-topic1"
    for _, word := range []string{string(jobString)} {
        p.Produce(&kafka.Message{
            TopicPartition: kafka.TopicPartition{Topic: &topic, Partition: kafka.PartitionAny},
            Value:          []byte(word),
        }, nil)
    }
}

这里是微服务 2 的代码。在这个代码中最重要的东西是从 Kafka 中消费数据,保存部分我已经在前面的博客文章中讨论过了。这里代码的重点部分是从 Kafka 中消费数据:

kafka-to-mongo/kafka-mongo-sample.go

func main() {

    //Create MongoDB session
    session := initialiseMongo()
    mongoStore.session = session

    receiveFromKafka()

}

func receiveFromKafka() {

    fmt.Println("Start receiving from Kafka")
    c, err := kafka.NewConsumer(&kafka.ConfigMap{
        "bootstrap.servers": "localhost:9092",
        "group.id":          "group-id-1",
        "auto.offset.reset": "earliest",
    })

    if err != nil {
        panic(err)
    }

    c.SubscribeTopics([]string{"jobs-topic1"}, nil)

    for {
        msg, err := c.ReadMessage(-1)

        if err == nil {
            fmt.Printf("Received from Kafka %s: %s\n", msg.TopicPartition, string(msg.Value))
            job := string(msg.Value)
            saveJobToMongo(job)
        } else {
            fmt.Printf("Consumer error: %v (%v)\n", err, msg)
            break
        }
    }

    c.Close()

}

func saveJobToMongo(jobString string) {

    fmt.Println("Save to MongoDB")
    col := mongoStore.session.DB(database).C(collection)

    //Save data into Job struct
    var _job Job
    b := []byte(jobString)
    err := json.Unmarshal(b, &_job)
    if err != nil {
        panic(err)
    }

    //Insert job into MongoDB
    errMongo := col.Insert(_job)
    if errMongo != nil {
        panic(errMongo)
    }

    fmt.Printf("Saved to MongoDB : %s", jobString)

}

我们来演示一下,运行微服务 1。确保 Kafka 已经运行了。

$ go run rest-kafka-sample.go

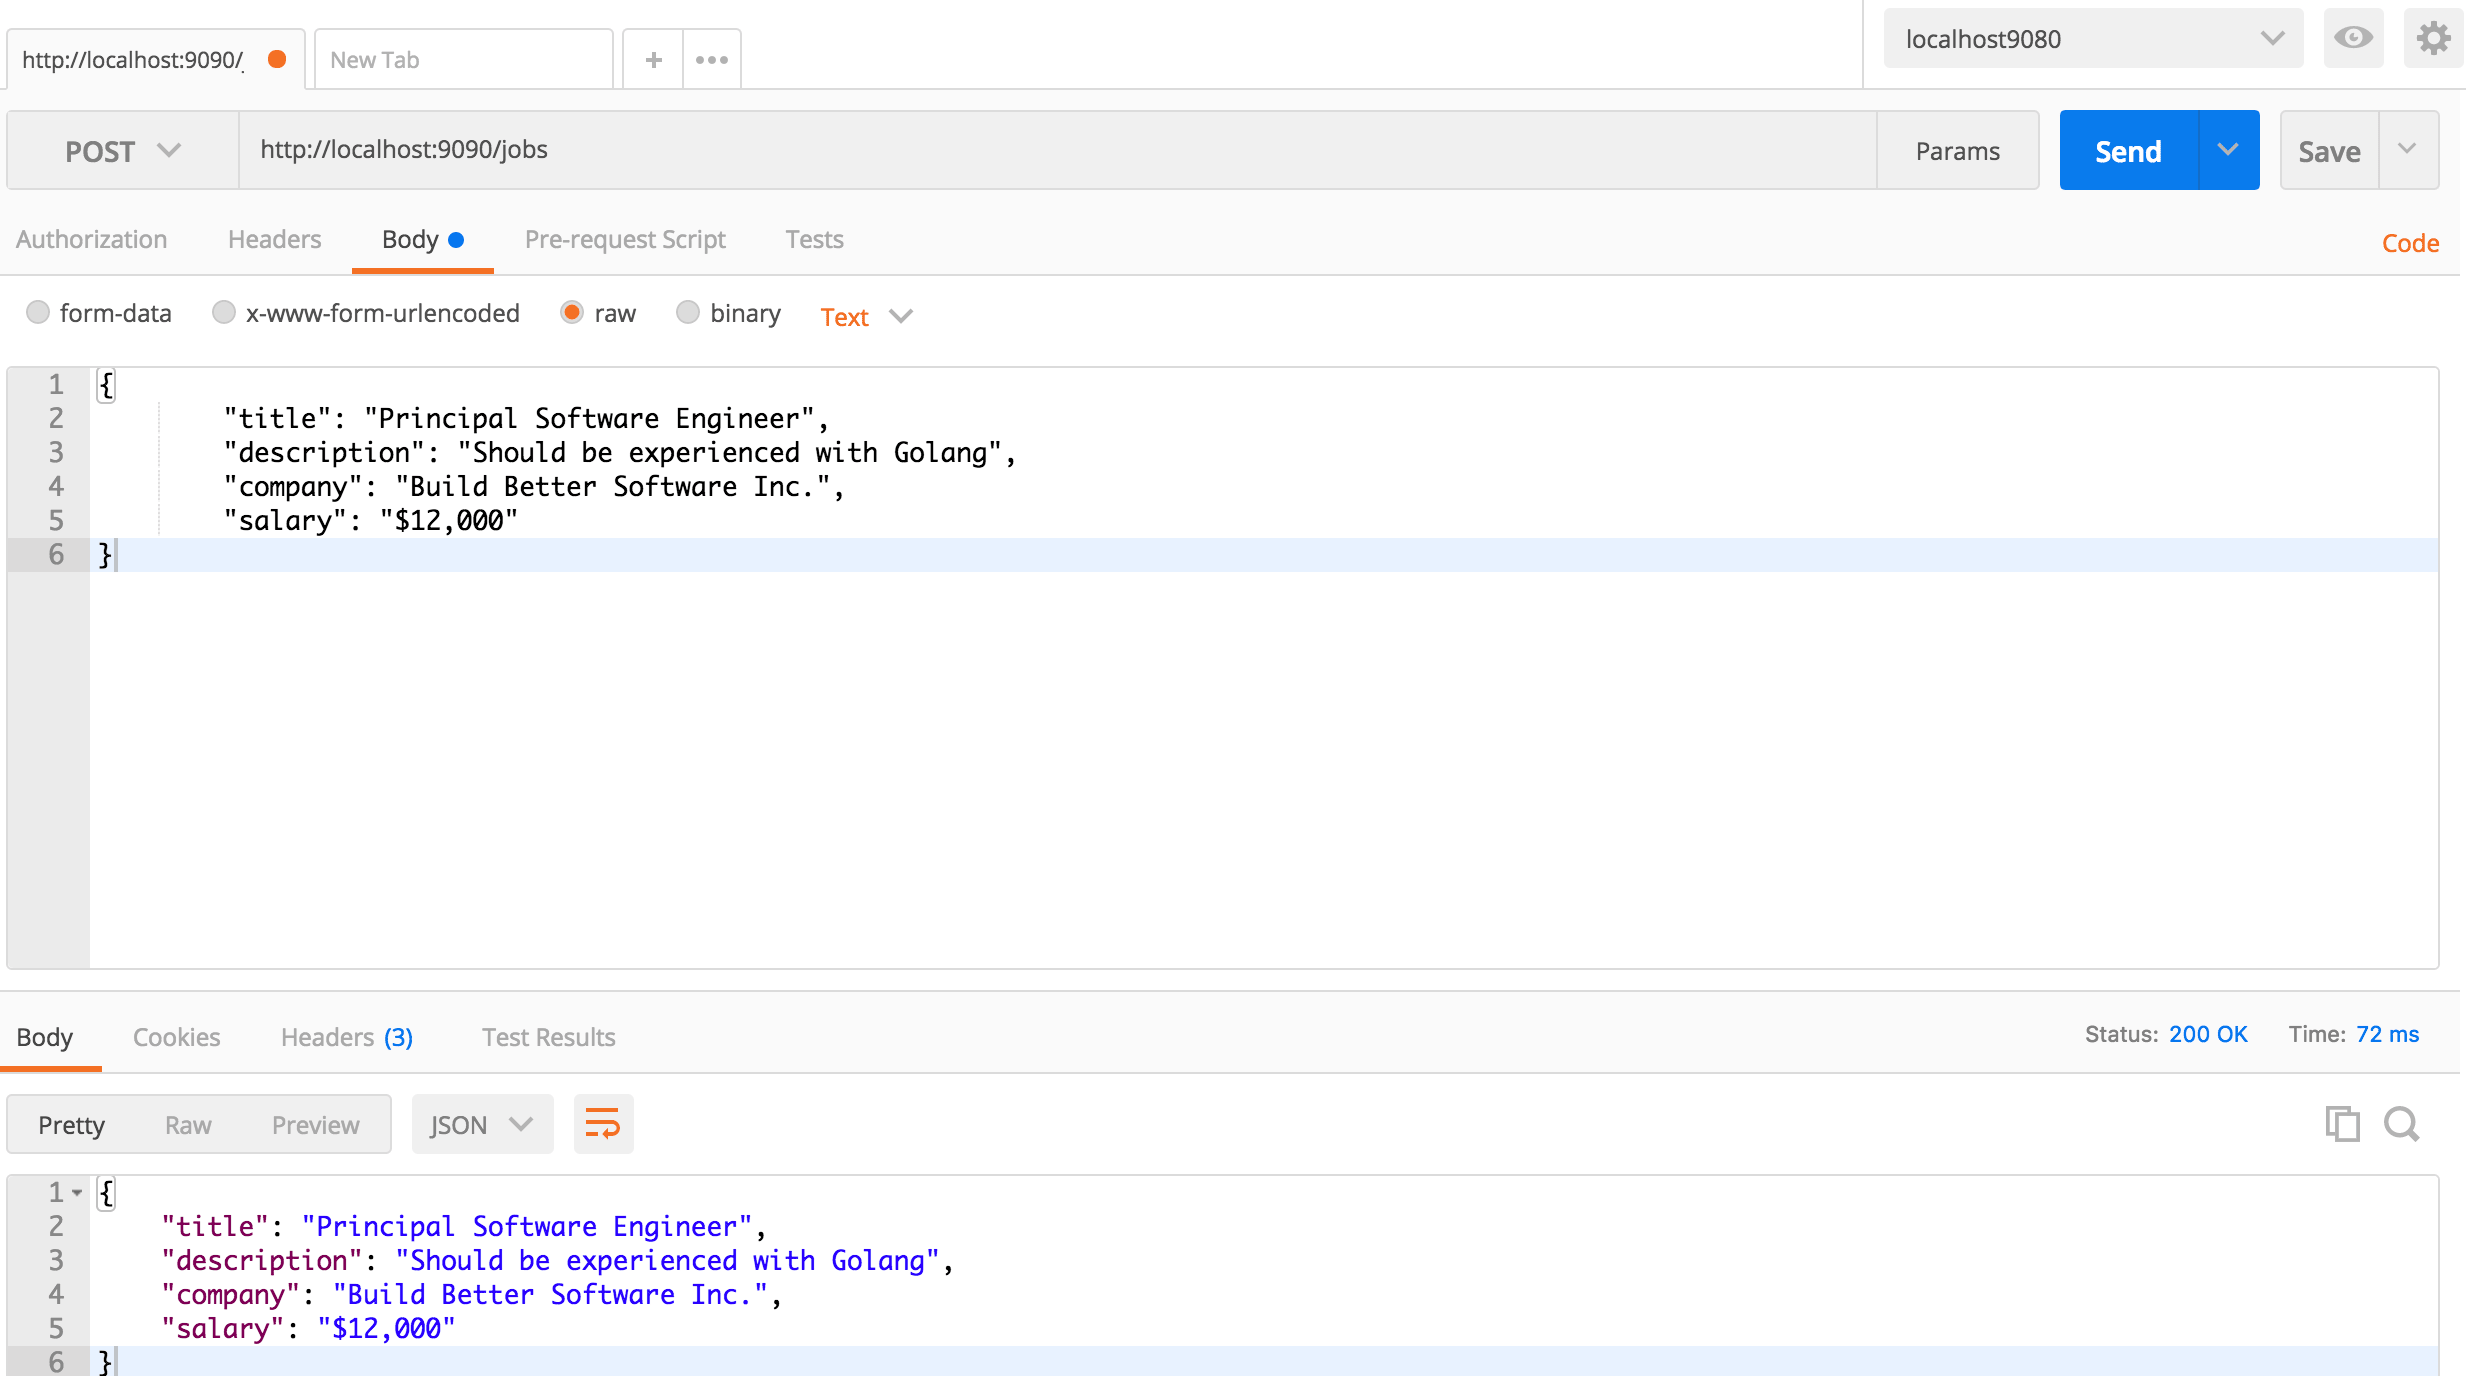
我使用 Postman 向微服务 1 发送数据。

Screenshot-2018-04-29-22.20.33

这里是日志,你可以在微服务 1 中看到。当你看到这些的时候,说明已经接收到了来自 Postman 发送的数据,并且已经保存到了 Kafka。

Screenshot-2018-04-29-22.22.00

因为我们尚未运行微服务 2,数据被微服务 1 只保存在了 Kafka。我们来消费它并通过运行的微服务 2 来将它保存到 MongoDB。

$ go run kafka-mongo-sample.go

现在,你将在微服务 2 上看到消费的数据,并将它保存到了 MongoDB。

Screenshot-2018-04-29-22.24.15

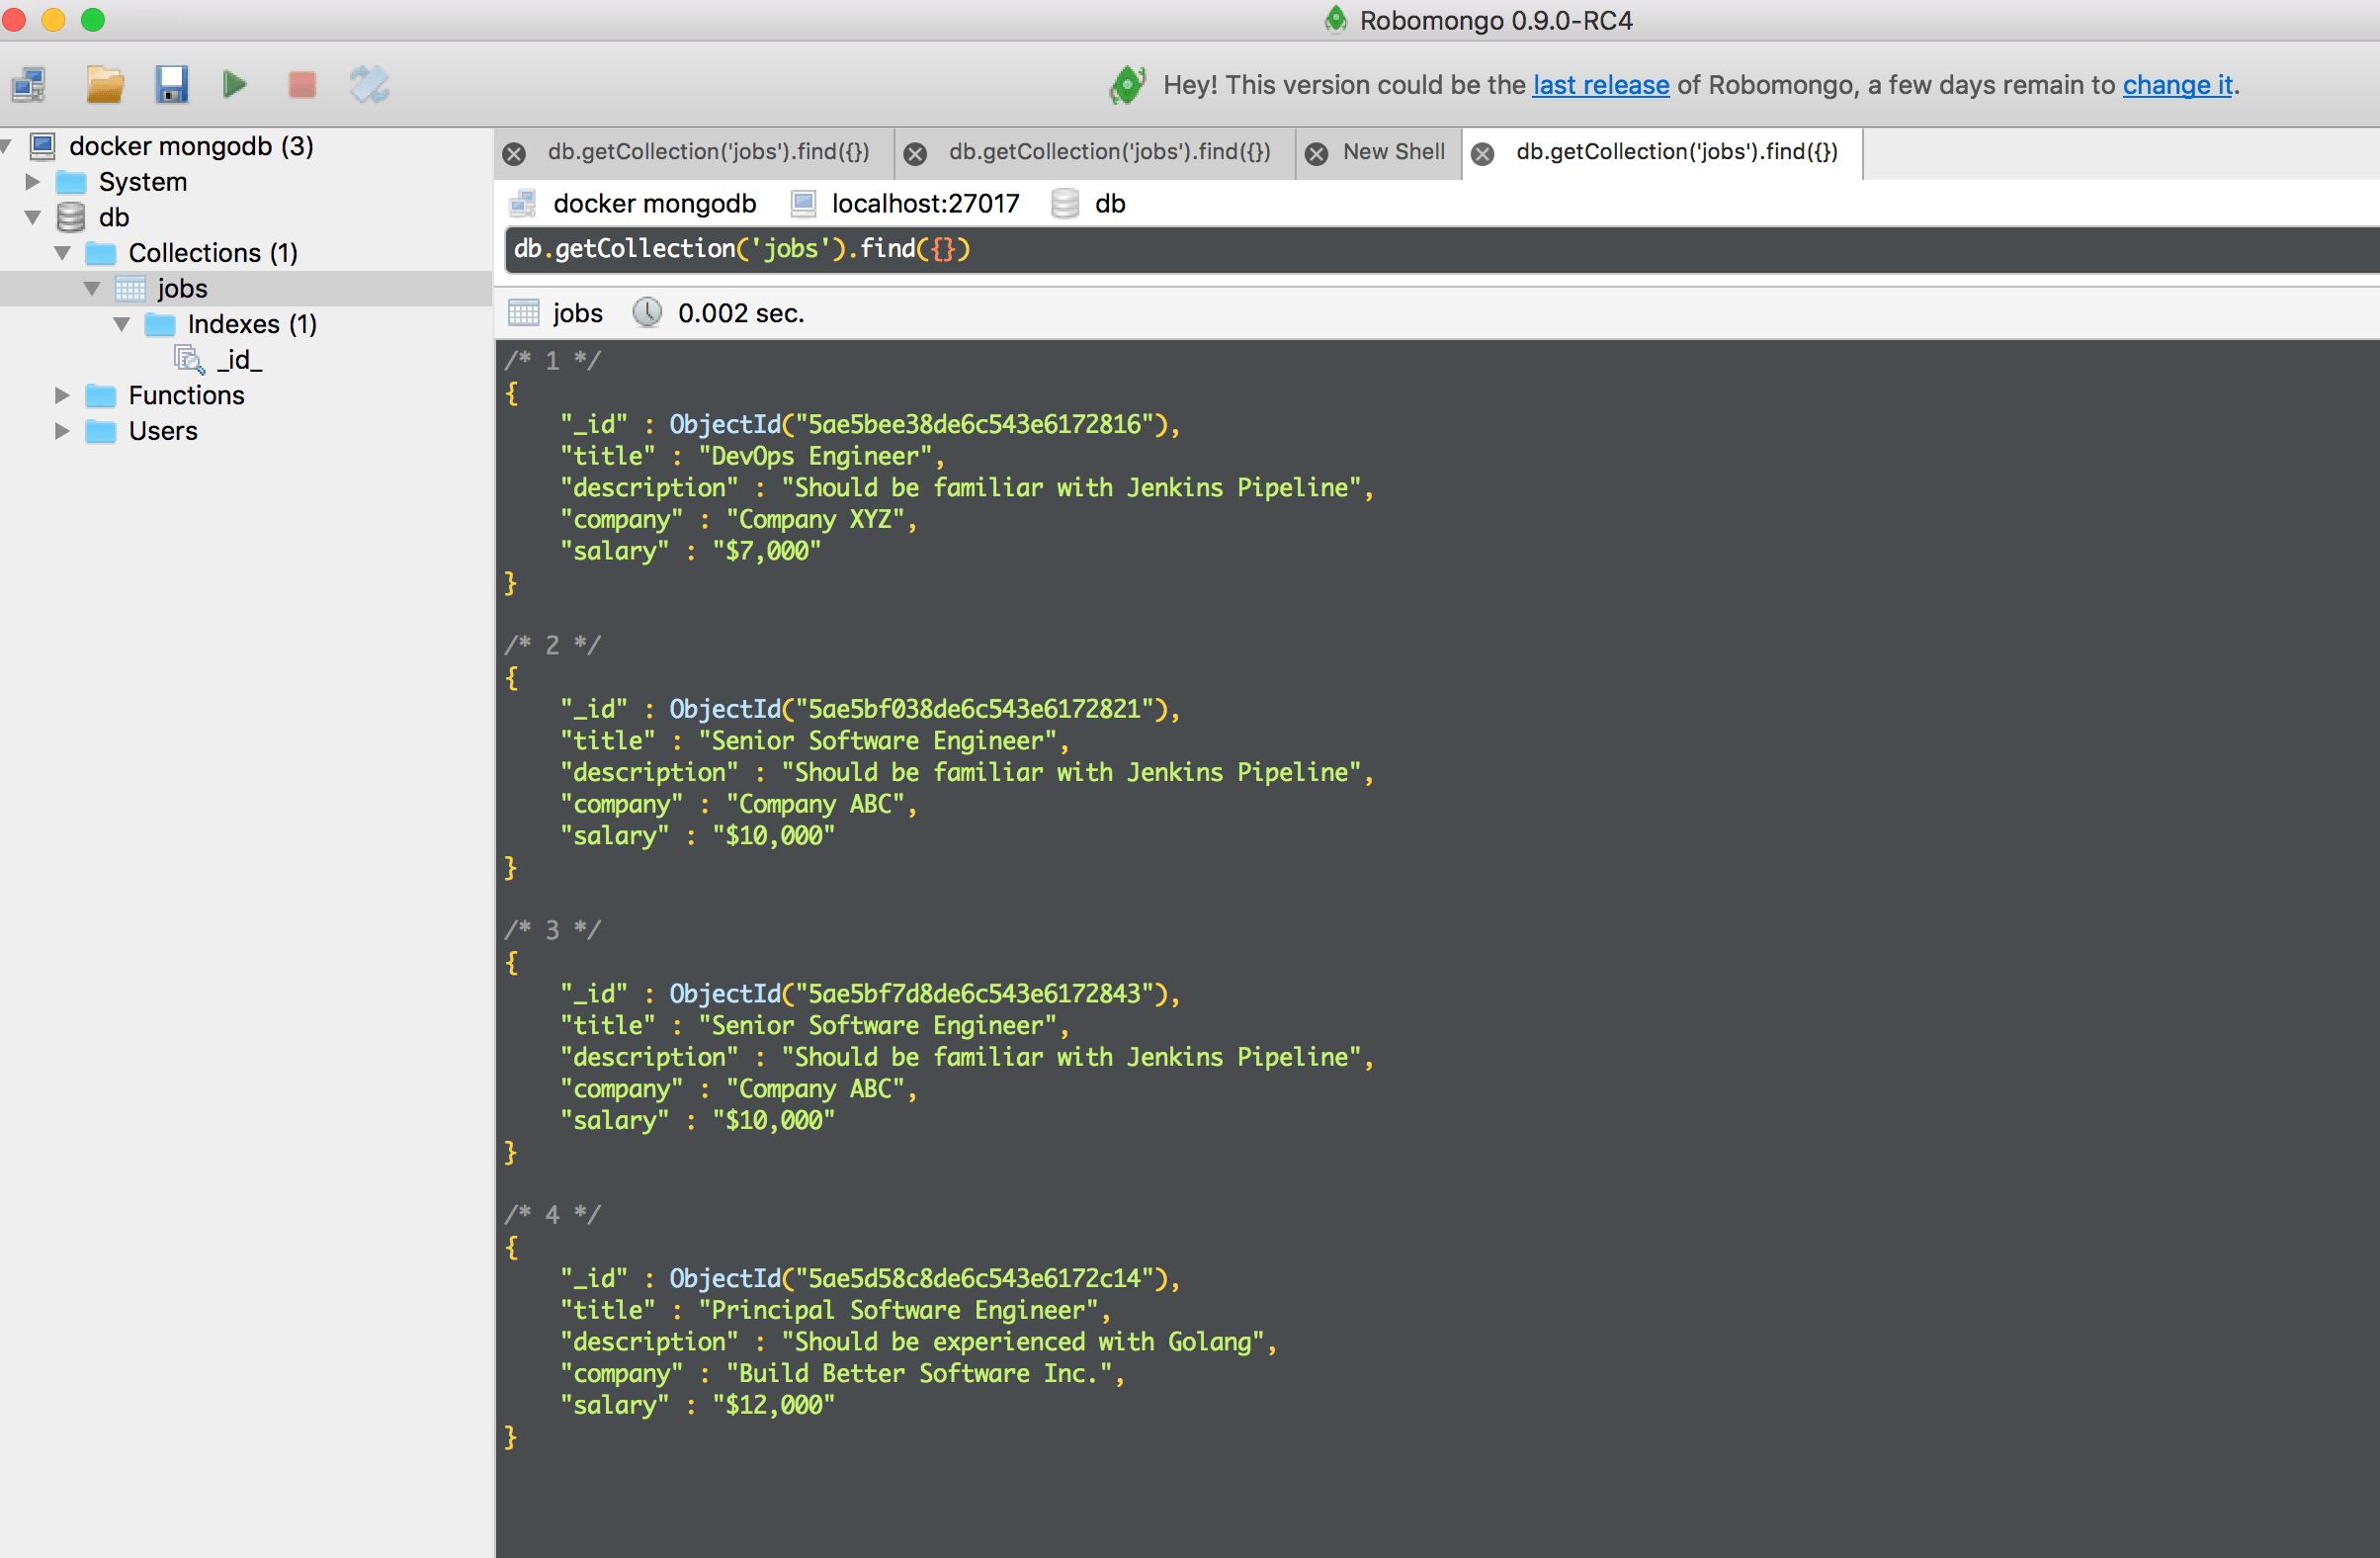
检查一下数据是否保存到了 MongoDB。如果有数据,我们成功了!

Screenshot-2018-04-29-22.26.39

完整的源代码可以在这里找到:

https://github.com/donvito/learngo/tree/master/rest-kafka-mongo-microservice

现在是广告时间:如果你喜欢这篇文章,请在 Twitter @donvito 上关注我。我的 Twitter 上有关于 Docker、Kubernetes、GoLang、Cloud、DevOps、Agile 和 Startups 的内容。欢迎你们在 GitHub 和 LinkedIn 关注我。

开心地玩吧!


via: https://www.melvinvivas.com/developing-microservices-using-kafka-and-mongodb/

作者:Melvin Vivas 译者:qhwdw 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

从开源数据到开源事件流,了解一下 MQTT 发布/订阅(pubsub)线路协议。

去年 11 月我们购买了一辆电动汽车,同时也引发了有趣的思考:我们应该什么时候为电动汽车充电?对于电动汽车充电所用的电,我希望能够对应最小的二氧化碳排放,归结为一个特定的问题:对于任意给定时刻,每千瓦时对应的二氧化碳排放量是多少,一天中什么时间这个值最低?

寻找数据

我住在纽约州,大约 80% 的电力消耗可以自给自足,主要来自天然气、水坝(大部分来自于 尼亚加拉 Niagara 大瀑布)、核能发电,少部分来自风力、太阳能和其它化石燃料发电。非盈利性组织 纽约独立电网运营商 New York Independent System Operator (NYISO)负责整个系统的运作,实现发电机组发电与用电之间的平衡,同时也是纽约路灯系统的监管部门。

尽管没有为公众提供公开 API,NYISO 还是尽责提供了不少公开数据供公众使用。每隔 5 分钟汇报全州各个发电机组消耗的燃料数据。数据以 CSV 文件的形式发布于公开的档案库中,全天更新。如果你了解不同燃料对发电瓦数的贡献比例,你可以比较准确的估计任意时刻的二氧化碳排放情况。

在构建收集处理公开数据的工具时,我们应该时刻避免过度使用这些资源。相比将这些数据打包并发送给所有人,我们有更好的方案。我们可以创建一个低开销的 事件流 event stream ,人们可以订阅并第一时间得到消息。我们可以使用 MQTT 实现该方案。我的项目(ny-power.org)目标是收录到 Home Assistant 项目中;后者是一个开源的 家庭自动化 home automation 平台,拥有数十万用户。如果所有用户同时访问 CSV 文件服务器,估计 NYISO 不得不增加访问限制。

MQTT 是什么?

MQTT 是一个 发布订阅线路协议 publish/subscription wire protocol ,为小规模设备设计。发布订阅系统工作原理类似于消息总线。你将一条消息发布到一个 主题 topic 上,那么所有订阅了该主题的客户端都可以获得该消息的一份拷贝。对于消息发送者而言,无需知道哪些人在订阅消息;你只需将消息发布到一系列主题,并订阅一些你感兴趣的主题。就像参加了一场聚会,你选取并加入感兴趣的对话。

MQTT 能够构建极为高效的应用。客户端订阅有限的几个主题,也只收到它们感兴趣的内容。不仅节省了处理时间,还降低了网络带宽使用。

作为一个开放标准,MQTT 有很多开源的客户端和服务端实现。对于你能想到的每种编程语言,都有对应的客户端库;甚至有嵌入到 Arduino 的库,可以构建传感器网络。服务端可供选择的也很多,我的选择是 Eclipse 项目提供的 Mosquitto 服务端,这是因为它体积小、用 C 编写,可以承载数以万计的订阅者。

为何我喜爱 MQTT

在过去二十年间,我们为软件应用设计了可靠且准确的模型,用于解决服务遇到的问题。我还有其它邮件吗?当前的天气情况如何?我应该此刻购买这种产品吗?在绝大多数情况下,这种 问答式 ask/receive 的模型工作良好;但对于一个数据爆炸的世界,我们需要其它的模型。MQTT 的发布订阅模型十分强大,可以将大量数据发送到系统中。客户可以订阅数据中的一小部分并在订阅数据发布的第一时间收到更新。

MQTT 还有一些有趣的特性,其中之一是 遗嘱 last-will-and-testament 消息,可以用于区分两种不同的静默,一种是没有主题相关数据推送,另一种是你的数据接收器出现故障。MQTT 还包括 保留消息 retained message ,当客户端初次连接时会提供相关主题的最后一条消息。这对那些更新缓慢的主题来说很有必要。

我在 Home Assistant 项目开发过程中,发现这种消息总线模型对 异构系统 heterogeneous systems 尤为适合。如果你深入 物联网 Internet of Things 领域,你会发现 MQTT 无处不在。

我们的第一个 MQTT 流

NYSO 公布的 CSV 文件中有一个是实时的燃料混合使用情况。每 5 分钟,NYSO 发布这 5 分钟内发电使用的燃料类型和相应的发电量(以兆瓦为单位)。

这个 CSV 文件看起来像这样:

时间戳时区燃料类型兆瓦为单位的发电量
05/09/2018 00:05:00EDT混合燃料1400
05/09/2018 00:05:00EDT天然气2144
05/09/2018 00:05:00EDT核能4114
05/09/2018 00:05:00EDT其它化石燃料4
05/09/2018 00:05:00EDT其它可再生资源226
05/09/2018 00:05:00EDT风力1
05/09/2018 00:05:00EDT水力3229
05/09/2018 00:10:00EDT混合燃料1307
05/09/2018 00:10:00EDT天然气2092
05/09/2018 00:10:00EDT核能4115
05/09/2018 00:10:00EDT其它化石燃料4
05/09/2018 00:10:00EDT其它可再生资源224
05/09/2018 00:10:00EDT风力40
05/09/2018 00:10:00EDT水力3166

表中唯一令人不解就是燃料类别中的混合燃料。纽约的大多数天然气工厂也通过燃烧其它类型的化石燃料发电。在冬季寒潮到来之际,家庭供暖的优先级高于发电;但这种情况出现的次数不多,(在我们计算中)可以将混合燃料类型看作天然气类型。

CSV 文件全天更新。我编写了一个简单的数据泵,每隔 1 分钟检查是否有数据更新,并将新条目发布到 MQTT 服务器的一系列主题上,主题名称基本与 CSV 文件有一定的对应关系。数据内容被转换为 JSON 对象,方便各种编程语言处理。

ny-power/upstream/fuel-mix/Hydro {"units": "MW", "value": 3229, "ts": "05/09/2018 00:05:00"}
ny-power/upstream/fuel-mix/Dual Fuel {"units": "MW", "value": 1400, "ts": "05/09/2018 00:05:00"}
ny-power/upstream/fuel-mix/Natural Gas {"units": "MW", "value": 2144, "ts": "05/09/2018 00:05:00"}
ny-power/upstream/fuel-mix/Other Fossil Fuels {"units": "MW", "value": 4, "ts": "05/09/2018 00:05:00"}
ny-power/upstream/fuel-mix/Wind {"units": "MW", "value": 41, "ts": "05/09/2018 00:05:00"}
ny-power/upstream/fuel-mix/Other Renewables {"units": "MW", "value": 226, "ts": "05/09/2018 00:05:00"}
ny-power/upstream/fuel-mix/Nuclear {"units": "MW", "value": 4114, "ts": "05/09/2018 00:05:00"}

这种直接的转换是种不错的尝试,可将公开数据转换为公开事件。我们后续会继续将数据转换为二氧化碳排放强度,但这些原始数据还可被其它应用使用,用于其它计算用途。

MQTT 主题

主题和 主题结构 topic structure 是 MQTT 的一个主要特色。与其它标准的企业级消息总线不同,MQTT 的主题无需事先注册。发送者可以凭空创建主题,唯一的限制是主题的长度,不超过 220 字符。其中 / 字符有特殊含义,用于创建主题的层次结构。我们即将看到,你可以订阅这些层次中的一些分片。

基于开箱即用的 Mosquitto,任何一个客户端都可以向任何主题发布消息。在原型设计过程中,这种方式十分便利;但一旦部署到生产环境,你需要增加 访问控制列表 access control list (ACL)只允许授权的应用发布消息。例如,任何人都能以只读的方式访问我的应用的主题层级,但只有那些具有特定 凭证 credentials 的客户端可以发布内容。

主题中不包含 自动样式 automatic schema ,也没有方法查找客户端可以发布的全部主题。因此,对于那些从 MQTT 总线消费数据的应用,你需要让其直接使用已知的主题和消息格式样式。

那么应该如何设计主题呢?最佳实践包括使用应用相关的根名称,例如在我的应用中使用 ny-power。接着,为提高订阅效率,构建足够深的层次结构。upstream 层次结构包含了直接从数据源获取的、不经处理的原始数据,而 fuel-mix 层次结构包含特定类型的数据;我们后续还可以增加其它的层次结构。

订阅主题

在 MQTT 中,订阅仅仅是简单的字符串匹配。为提高处理效率,只允许如下两种通配符:

  • # 以递归方式匹配,直到字符串结束
  • + 匹配下一个 / 之前的内容

为便于理解,下面给出几个例子:

ny-power/#  - 匹配 ny-power 应用发布的全部主题
ny-power/upstream/#  - 匹配全部原始数据的主题
ny-power/upstream/fuel-mix/+  - 匹配全部燃料类型的主题
ny-power/+/+/Hydro - 匹配全部两次层级之后为 Hydro 类型的主题(即使不位于 upstream 层次结构下)

类似 ny-power/# 的大范围订阅适用于 低数据量 low-volume 的应用,应用从网络获取全部数据并处理。但对 高数据量 high-volume 应用而言则是一个灾难,由于绝大多数消息并不会被使用,大部分的网络带宽被白白浪费了。

在大数据量情况下,为确保性能,应用需要使用恰当的主题筛选(如 ny-power/+/+/Hydro)尽量准确获取业务所需的数据。

增加我们自己的数据层次

接下来,应用中的一切都依赖于已有的 MQTT 流并构建新流。第一个额外的数据层用于计算发电对应的二氧化碳排放。

利用 美国能源情报署 U.S. Energy Information Administration 给出的 2016 年纽约各类燃料发电及排放情况,我们可以给出各类燃料的平均排放率,单位为克/兆瓦时。

上述结果被封装到一个专用的微服务中。该微服务订阅 ny-power/upstream/fuel-mix/+,即数据泵中燃料组成情况的原始数据,接着完成计算并将结果(单位为克/千瓦时)发布到新的主题层次结构上:

ny-power/computed/co2 {"units": "g / kWh", "value": 152.9486, "ts": "05/09/2018 00:05:00"}

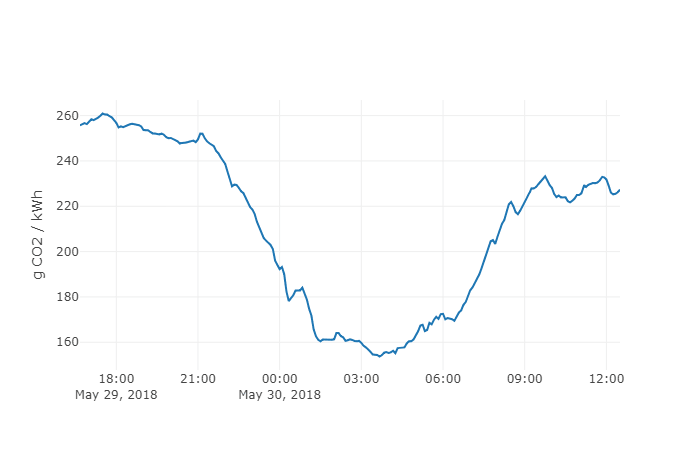
接着,另一个服务会订阅该主题层次结构并将数据打包到 InfluxDB 进程中;同时,发布 24 小时内的时间序列数据到 ny-power/archive/co2/24h 主题,这样可以大大简化当前变化数据的绘制。

这种层次结构的主题模型效果不错,可以将上述程序之间的逻辑解耦合。在复杂系统中,各个组件可能使用不同的编程语言,但这并不重要,因为交换格式都是 MQTT 消息,即主题和 JSON 格式的消息内容。

从终端消费数据

为了更好的了解 MQTT 完成了什么工作,将其绑定到一个消息总线并查看消息流是个不错的方法。mosquitto-clients 包中的 mosquitto_sub 可以让我们轻松实现该目标。

安装程序后,你需要提供服务器名称以及你要订阅的主题。如果有需要,使用参数 -v 可以让你看到有新消息发布的那些主题;否则,你只能看到主题内的消息数据。

mosquitto_sub -h mqtt.ny-power.org -t ny-power/# -v

只要我编写或调试 MQTT 应用,我总会在一个终端中运行 mosquitto_sub。

从网页直接访问 MQTT

到目前为止,我们已经有提供公开事件流的应用,可以用微服务或命令行工具访问该应用。但考虑到互联网仍占据主导地位,因此让用户可以从浏览器直接获取事件流是很重要。

MQTT 的设计者已经考虑到了这一点。协议标准支持三种不同的传输协议:TCP、UDP 和 WebSockets。主流浏览器都支持 WebSockets,可以维持持久连接,用于实时应用。

Eclipse 项目提供了 MQTT 的一个 JavaScript 实现,叫做 Paho,可包含在你的应用中。工作模式为与服务器建立连接、建立一些订阅,然后根据接收到的消息进行响应。

// ny-power web console application

var client = new Paho.MQTT.Client(mqttHost, Number("80"), "client-" + Math.random());

// set callback handlers
client.onMessageArrived = onMessageArrived;

// connect the client
client.reconnect = true;
client.connect({onSuccess: onConnect});

// called when the client connects
function onConnect() {
    // Once a connection has been made, make a subscription and send a message.
    console.log("onConnect");
    client.subscribe("ny-power/computed/co2");
    client.subscribe("ny-power/archive/co2/24h");
    client.subscribe("ny-power/upstream/fuel-mix/#");
}

// called when a message arrives
function onMessageArrived(message) {
    console.log("onMessageArrived:"+message.destinationName + message.payloadString);
    if (message.destinationName == "ny-power/computed/co2") {
        var data = JSON.parse(message.payloadString);
        $("#co2-per-kwh").html(Math.round(data.value));
        $("#co2-units").html(data.units);
        $("#co2-updated").html(data.ts);
    }

    if (message.destinationName.startsWith("ny-power/upstream/fuel-mix")) {
        fuel_mix_graph(message);
    }

    if (message.destinationName == "ny-power/archive/co2/24h") {
        var data = JSON.parse(message.payloadString);
        var plot = [
            {
                x: data.ts,
                y: data.values,
                type: 'scatter'
            }
        ];
        var layout = {
            yaxis: {
                title: "g CO2 / kWh",
            }
        };
        Plotly.newPlot('co2_graph', plot, layout);
    }

上述应用订阅了不少主题,因为我们将要呈现若干种不同类型的数据;其中 ny-power/computed/co2 主题为我们提供当前二氧化碳排放的参考值。一旦收到该主题的新消息,网站上的相应内容会被相应替换。

 title=

ny-power.org 网站提供的 NYISO 二氧化碳排放图。

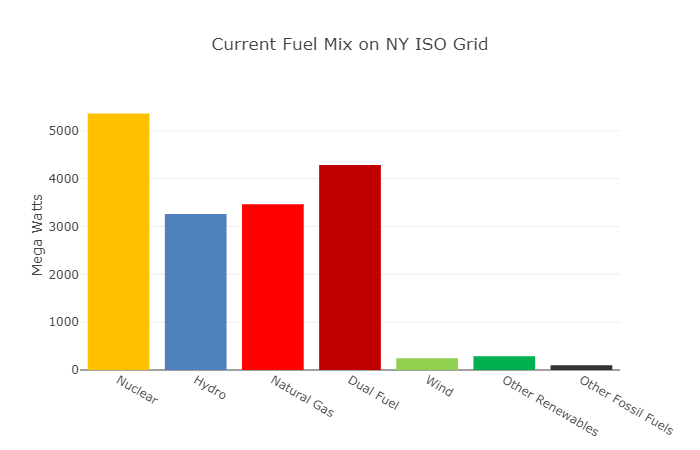
ny-power/archive/co2/24h 主题提供了时间序列数据,用于为 Plotly 线表提供数据。ny-power/upstream/fuel-mix 主题提供当前燃料组成情况,为漂亮的柱状图提供数据。

 title=

ny-power.org 网站提供的燃料组成情况。

这是一个动态网站,数据不从服务器拉取,而是结合 MQTT 消息总线,监听对外开放的 WebSocket。就像数据泵和打包器程序那样,网站页面也是一个发布订阅客户端,只不过是在你的浏览器中执行,而不是在公有云的微服务上。

你可以在 http://ny-power.org 站点点看到动态变更,包括图像和可以看到消息到达的实时 MQTT 终端。

继续深入

ny-power.org 应用的完整内容开源在 GitHub 中。你也可以查阅 架构简介,学习如何使用 Helm 部署一系列 Kubernetes 微服务构建应用。另一个有趣的 MQTT 示例使用 MQTT 和 OpenWhisk 进行实时文本消息翻译, 代码模式 code pattern 参考链接。

MQTT 被广泛应用于物联网领域,更多关于 MQTT 用途的例子可以在 Home Assistant 项目中找到。

如果你希望深入了解协议内容,可以从 mqtt.org 获得该公开标准的全部细节。

想了解更多,可以参加 Sean Dague 在 OSCON 上的演讲,主题为 将 MQTT 加入到你的工具箱,会议将于 7 月 16-19 日在奥尔良州波特兰举办。


via: https://opensource.com/article/18/6/mqtt

作者:Sean Dague 选题:lujun9972 译者:pinewall 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

超过 3 亿用户正在使用 Stream。这些用户全都依赖我们的框架,而我们十分擅长测试要放到生产环境中的任何东西。我们大部分的代码库是用 Go 语言编写的,剩下的部分则是用 Python 编写。

我们最新的展示应用,Winds 2.0,是用 Node.js 构建的,很快我们就了解到测试 Go 和 Python 的常规方法并不适合它。而且,创造一个好的测试套件需要用 Node.js 做很多额外的工作,因为我们正在使用的框架没有提供任何内建的测试功能。

不论你用什么语言,要构建完好的测试框架可能都非常复杂。本文我们会展示 Node.js 测试过程中的困难部分,以及我们在 Winds 2.0 中用到的各种工具,并且在你要编写下一个测试集合时为你指明正确的方向。

为什么测试如此重要

我们都向生产环境中推送过糟糕的提交,并且遭受了其后果。碰到这样的情况不是好事。编写一个稳固的测试套件不仅仅是一个明智的检测,而且它还让你能够完全地重构代码,并自信重构之后的代码仍然可以正常运行。这在你刚刚开始编写代码的时候尤为重要。

如果你是与团队共事,达到测试覆盖率极其重要。没有它,团队中的其他开发者几乎不可能知道他们所做的工作是否导致重大变动(或破坏)。

编写测试同时会促进你和你的队友把代码分割成更小的片段。这让别人去理解你的代码和修改 bug 变得容易多了。产品收益变得更大,因为你能更早的发现 bug。

最后,没有测试,你的基本代码还不如一堆纸片。基本不能保证你的代码是稳定的。

困难的部分

在我看来,我们在 Winds 中遇到的大多数测试问题是 Node.js 中特有的。它的生态系统一直在变大。例如,如果你用的是 macOS,运行 brew upgrade(安装了 homebrew),你看到你一个新版本的 Node.js 的概率非常高。由于 Node.js 迭代频繁,相应的库也紧随其后,想要与最新的库保持同步非常困难。

以下是一些马上映入脑海的痛点:

  1. 在 Node.js 中进行测试是非常主观而又不主观的。人们对于如何构建一个测试架构以及如何检验成功有不同的看法。沮丧的是还没有一个黄金准则规定你应该如何进行测试。
  2. 有一堆框架能够用在你的应用里。但是它们一般都很精简,没有完好的配置或者启动过程。这会导致非常常见的副作用,而且还很难检测到;所以你最终会想要从零开始编写自己的 测试执行平台 test runner 测试执行平台。
  3. 几乎可以保证你 需要 编写自己的测试执行平台(马上就会讲到这一节)。

以上列出的情况不是理想的,而且这是 Node.js 社区应该尽管处理的事情。如果其他语言解决了这些问题,我认为也是作为广泛使用的语言, Node.js 解决这些问题的时候。

编写你自己的测试执行平台

所以……你可能会好奇test runner测试执行平台 是 什么,说实话,它并不复杂。测试执行平台是测试套件中最高层的容器。它允许你指定全局配置和环境,还可以导入配置。可能有人觉得做这个很简单,对吧?别那么快下结论。

我们所了解到的是,尽管现在就有足够多的测试框架了,但没有一个测试框架为 Node.js 提供了构建你的测试执行平台的标准方式。不幸的是,这需要开发者来完成。这里有个关于测试执行平台的需求的简单总结:

  • 能够加载不同的配置(比如,本地的、测试的、开发的),并确保你 永远不会 加载一个生产环境的配置 —— 你能想象出那样会出什么问题。
  • 播种数据库——产生用于测试的数据。必须要支持多种数据库,不论是 MySQL、PostgreSQL、MongoDB 或者其它任何一个数据库。
  • 能够加载配置(带有用于开发环境测试的播种数据的文件)。

开发 Winds 的时候,我们选择 Mocha 作为测试执行平台。Mocha 提供了简单并且可编程的方式,通过命令行工具(整合了 Babel)来运行 ES6 代码的测试。

为了进行测试,我们注册了自己的 Babel 模块引导器。这为我们提供了更细的粒度,更强大的控制,在 Babel 覆盖掉 Node.js 模块加载过程前,对导入的模块进行控制,让我们有机会在所有测试运行前对模块进行模拟。

此外,我们还使用了 Mocha 的测试执行平台特性,预先把特定的请求赋给 HTTP 管理器。我们这么做是因为常规的初始化代码在测试中不会运行(服务器交互是用 Chai HTTP 插件模拟的),还要做一些安全性检查来确保我们不会连接到生产环境数据库。

尽管这不是测试执行平台的一部分,有一个 配置 fixture 加载器也是我们测试套件中的重要的一部分。我们试验过已有的解决方案;然而,我们最终决定编写自己的助手程序,这样它就能贴合我们的需求。根据我们的解决方案,在生成或手动编写配置时,通过遵循简单专有的协议,我们就能加载数据依赖很复杂的配置。

Winds 中用到的工具

尽管过程很冗长,我们还是能够合理使用框架和工具,使得针对后台 API 进行的适当测试变成现实。这里是我们选择使用的工具:

Mocha

Mocha,被称为 “运行在 Node.js 上的特性丰富的测试框架”,是我们用于该任务的首选工具。拥有超过 15K 的星标,很多支持者和贡献者,我们知道对于这种任务,这是正确的框架。

Chai

然后是我们的断言库。我们选择使用传统方法,也就是最适合配合 Mocha 使用的 —— Chai。Chai 是一个用于 Node.js,适合 BDD 和 TDD 模式的断言库。拥有简单的 API,Chai 很容易整合进我们的应用,让我们能够轻松地断言出我们 期望 从 Winds API 中返回的应该是什么。最棒的地方在于,用 Chai 编写测试让人觉得很自然。这是一个简短的例子:

describe('retrieve user', () => {
    let user;

    before(async () => {
        await loadFixture('user');
        user = await User.findOne({email: authUser.email});
        expect(user).to.not.be.null;
    });

    after(async () => {
        await User.remove().exec();
    });

    describe('valid request', () => {
        it('should return 200 and the user resource, including the email field, when retrieving the authenticated user', async () => {
            const response = await withLogin(request(api).get(`/users/${user._id}`), authUser);

            expect(response).to.have.status(200);
            expect(response.body._id).to.equal(user._id.toString());
        });

        it('should return 200 and the user resource, excluding the email field, when retrieving another user', async () => {
            const anotherUser = await User.findOne({email: '[email protected]'});

            const response = await withLogin(request(api).get(`/users/${anotherUser.id}`), authUser);

            expect(response).to.have.status(200);
            expect(response.body._id).to.equal(anotherUser._id.toString());
            expect(response.body).to.not.have.an('email');
        });

    });

    describe('invalid requests', () => {

        it('should return 404 if requested user does not exist', async () => {
            const nonExistingId = '5b10e1c601e9b8702ccfb974';
            expect(await User.findOne({_id: nonExistingId})).to.be.null;

            const response = await withLogin(request(api).get(`/users/${nonExistingId}`), authUser);
            expect(response).to.have.status(404);
        });
    });

});

Sinon

拥有与任何单元测试框架相适应的能力,Sinon 是模拟库的首选。而且,精简安装带来的超级整洁的整合,让 Sinon 把模拟请求变成了简单而轻松的过程。它的网站有极其良好的用户体验,并且提供简单的步骤,供你将 Sinon 整合进自己的测试框架中。

Nock

对于所有外部的 HTTP 请求,我们使用健壮的 HTTP 模拟库 nock,在你要和第三方 API 交互时非常易用(比如说 Stream 的 REST API)。它做的事情非常酷炫,这就是我们喜欢它的原因,除此之外关于这个精妙的库没有什么要多说的了。这是我们的速成示例,调用我们在 Stream 引擎中提供的 personalization:

nock(config.stream.baseUrl)
    .get(/winds_article_recommendations/)
    .reply(200, { results: [{foreign_id:`article:${article.id}`}] });

Mock-require

mock-require 库允许依赖外部代码。用一行代码,你就可以替换一个模块,并且当代码尝试导入这个库时,将会产生模拟请求。这是一个小巧但稳定的库,我们是它的超级粉丝。

Istanbul

Istanbul 是 JavaScript 代码覆盖工具,在运行测试的时候,通过模块钩子自动添加覆盖率,可以计算语句,行数,函数和分支覆盖率。尽管我们有相似功能的 CodeCov(见下一节),进行本地测试时,这仍然是一个很棒的工具。

最终结果 — 运行测试

有了这些库,还有之前提过的测试执行平台,现在让我们看看什么是完整的测试(你可以在 这里 看看我们完整的测试套件):

import nock from 'nock';
import { expect, request } from 'chai';

import api from '../../src/server';
import Article from '../../src/models/article';
import config from '../../src/config';
import { dropDBs, loadFixture, withLogin } from '../utils.js';

describe('Article controller', () => {
    let article;

    before(async () => {
        await dropDBs();
        await loadFixture('initial-data', 'articles');
        article = await Article.findOne({});
        expect(article).to.not.be.null;
        expect(article.rss).to.not.be.null;
    });

    describe('get', () => {
        it('should return the right article via /articles/:articleId', async () => {
            let response = await withLogin(request(api).get(`/articles/${article.id}`));
            expect(response).to.have.status(200);
        });
    });

    describe('get parsed article', () => {
        it('should return the parsed version of the article', async () => {
            const response = await withLogin(
                request(api).get(`/articles/${article.id}`).query({ type: 'parsed' })
            );
            expect(response).to.have.status(200);
        });
    });

    describe('list', () => {
        it('should return the list of articles', async () => {
            let response = await withLogin(request(api).get('/articles'));
            expect(response).to.have.status(200);
        });
    });

    describe('list from personalization', () => {
        after(function () {
            nock.cleanAll();
        });

        it('should return the list of articles', async () => {
            nock(config.stream.baseUrl)
                .get(/winds_article_recommendations/)
                .reply(200, { results: [{foreign_id:`article:${article.id}`}] });

            const response = await withLogin(
                request(api).get('/articles').query({
                    type: 'recommended',
                })
            );
            expect(response).to.have.status(200);
            expect(response.body.length).to.be.at.least(1);
            expect(response.body[0].url).to.eq(article.url);
        });
    });
});

持续集成

有很多可用的持续集成服务,但我们钟爱 Travis CI,因为他们和我们一样喜爱开源环境。考虑到 Winds 是开源的,它再合适不过了。

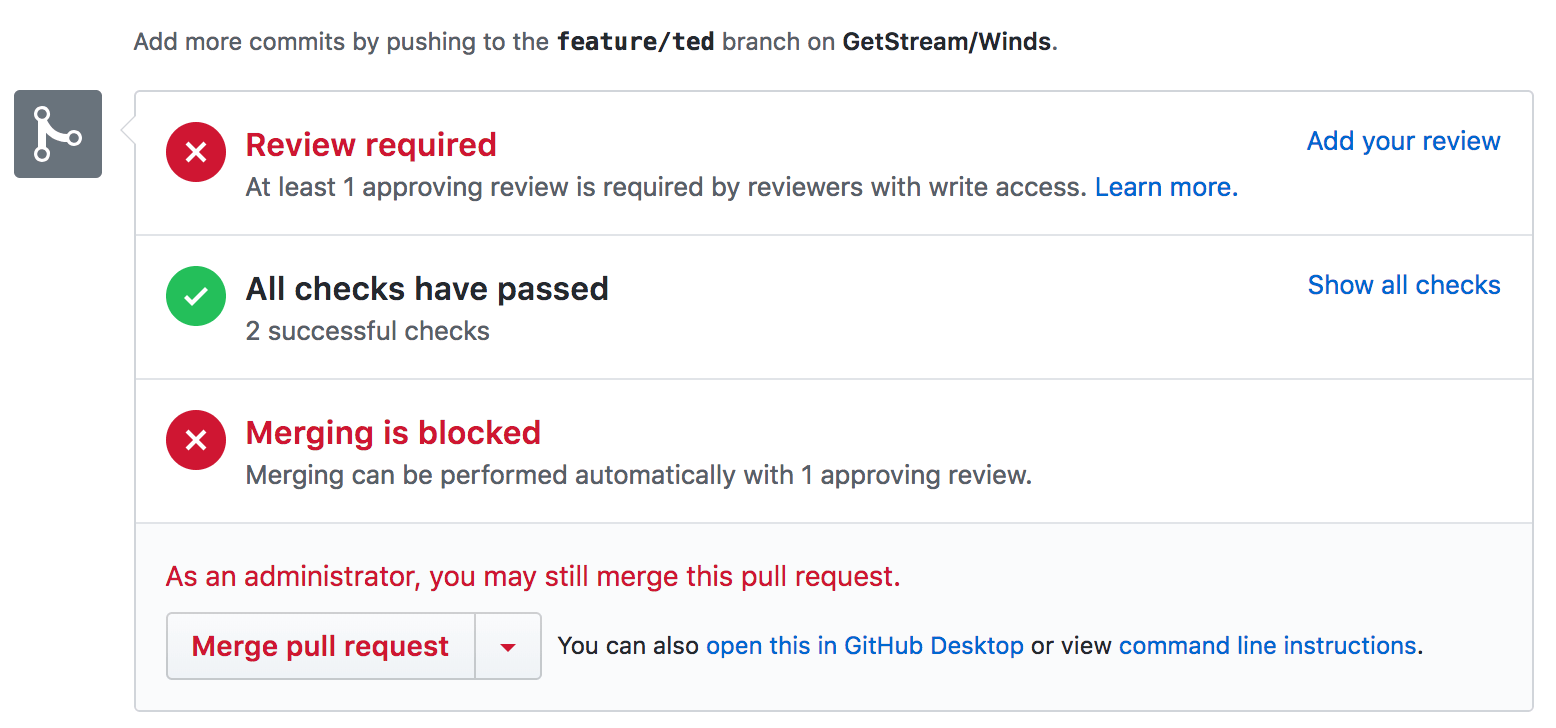
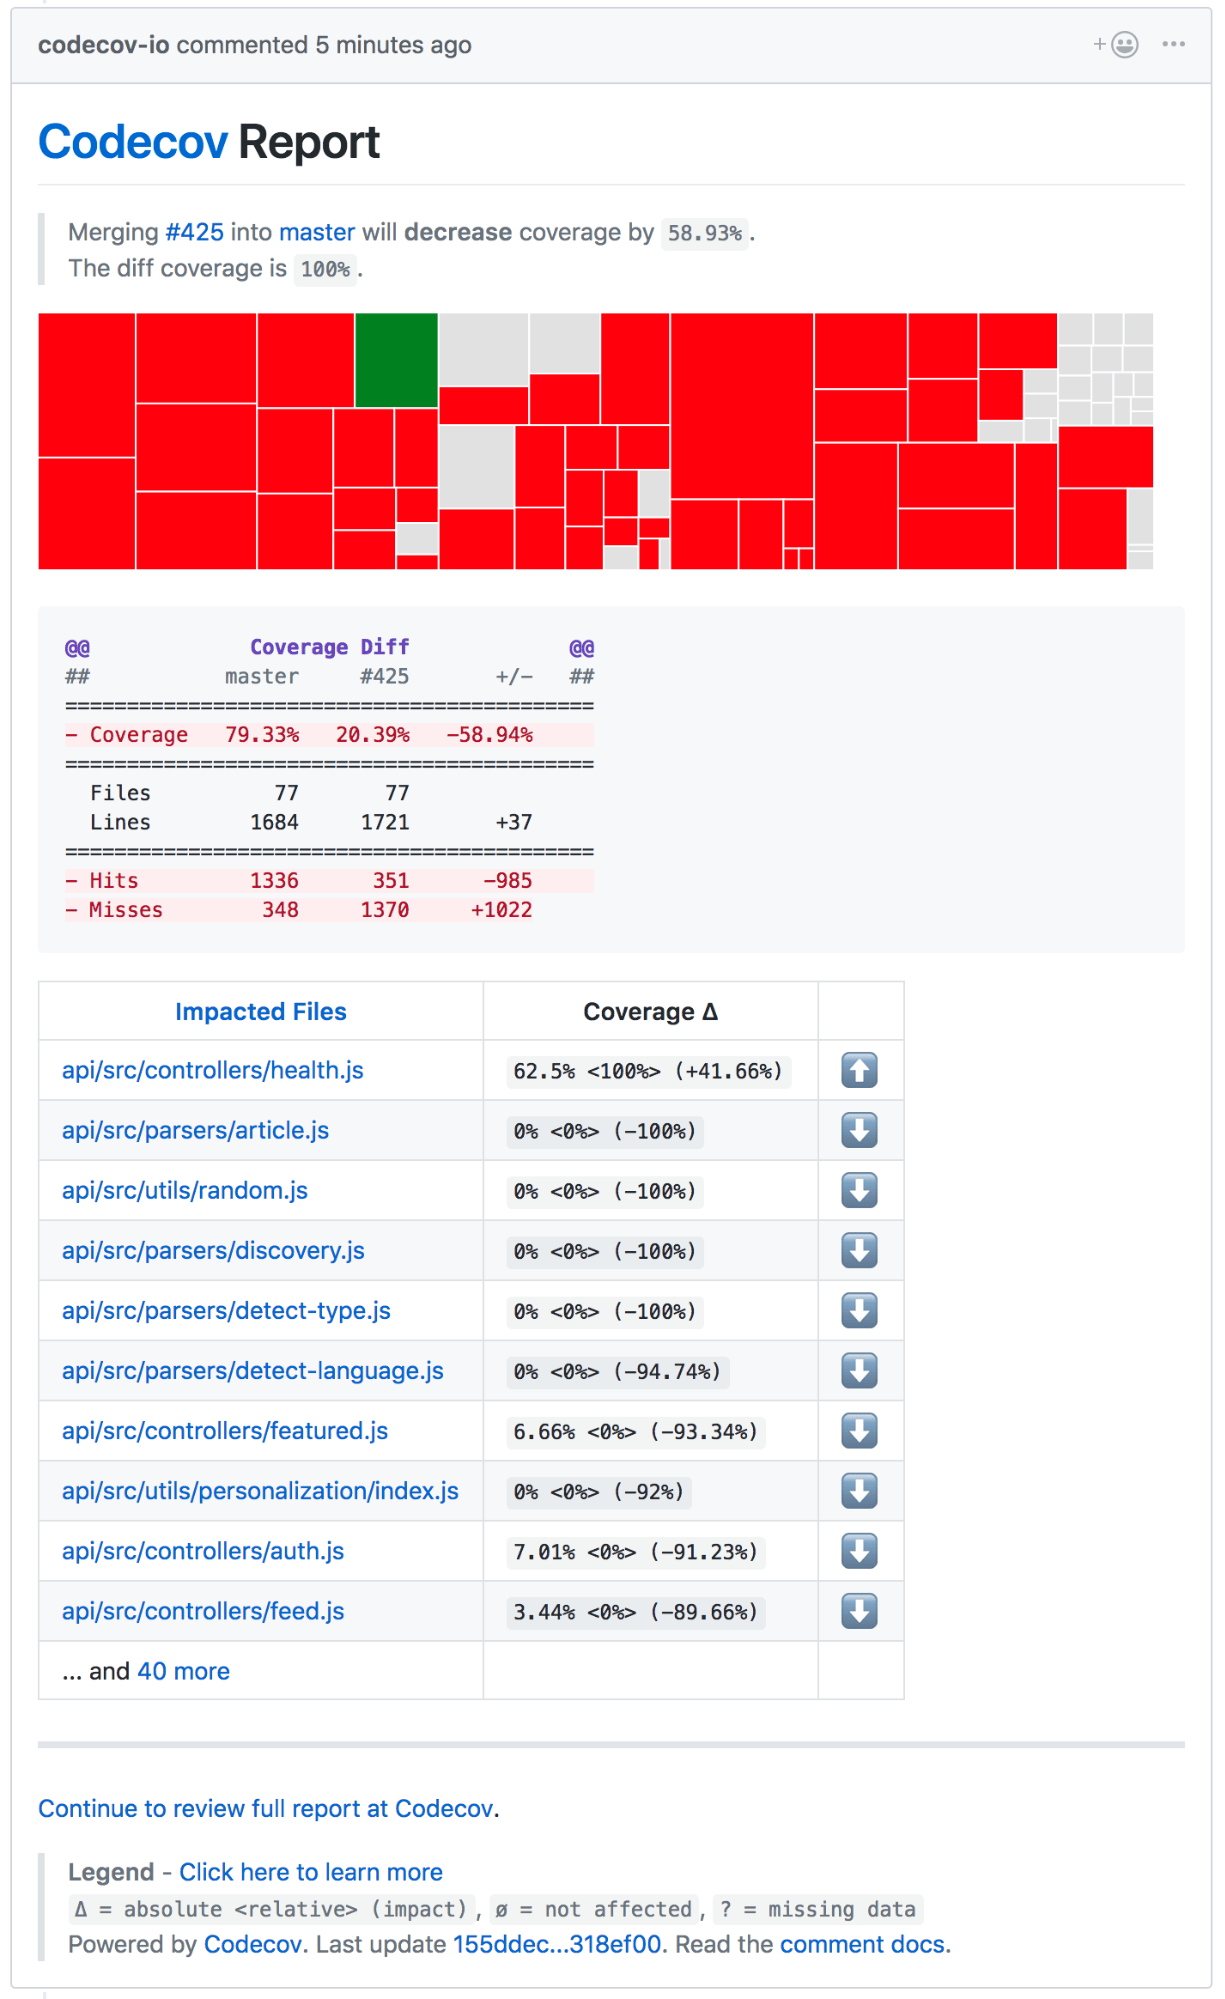
我们的集成非常简单 —— 我们用 [.travis.yml] 文件设置环境,通过简单的 npm 命令进行测试。测试覆盖率反馈给 GitHub,在 GitHub 上我们将清楚地看出我们最新的代码或者 PR 是不是通过了测试。GitHub 集成很棒,因为它可以自动查询 Travis CI 获取结果。以下是一个在 GitHub 上看到 (经过了测试的) PR 的简单截图:

除了 Travis CI,我们还用到了叫做 CodeCov 的工具。CodeCov 和 [Istanbul] 很像,但它是个可视化的工具,方便我们查看代码覆盖率、文件变动、行数变化,还有其他各种小玩意儿。尽管不用 CodeCov 也可以可视化数据,但把所有东西囊括在一个地方也很不错。

我们学到了什么

在开发我们的测试套件的整个过程中,我们学到了很多东西。开发时没有所谓“正确”的方法,我们决定开始创造自己的测试流程,通过理清楚可用的库,找到那些足够有用的东西添加到我们的工具箱中。

最终我们学到的是,在 Node.js 中进行测试不是听上去那么简单。还好,随着 Node.js 持续完善,社区将会聚集力量,构建一个坚固稳健的库,可以用“正确”的方式处理所有和测试相关的东西。

但在那时到来之前,我们还会接着用自己的测试套件,它开源在 Winds 的 GitHub 仓库。

局限

创建配置没有简单的方法

有的框架和语言,就如 Python 中的 Django,有简单的方式来创建配置。比如,你可以使用下面这些 Django 命令,把数据导出到文件中来自动化配置的创建过程:

以下命令会把整个数据库导出到 db.json 文件中:

./manage.py dumpdata > db.json

以下命令仅导出 django 中 admin.logentry 表里的内容:

./manage.py dumpdata admin.logentry > logentry.json

以下命令会导出 auth.user 表中的内容:

./manage.py dumpdata auth.user > user.json

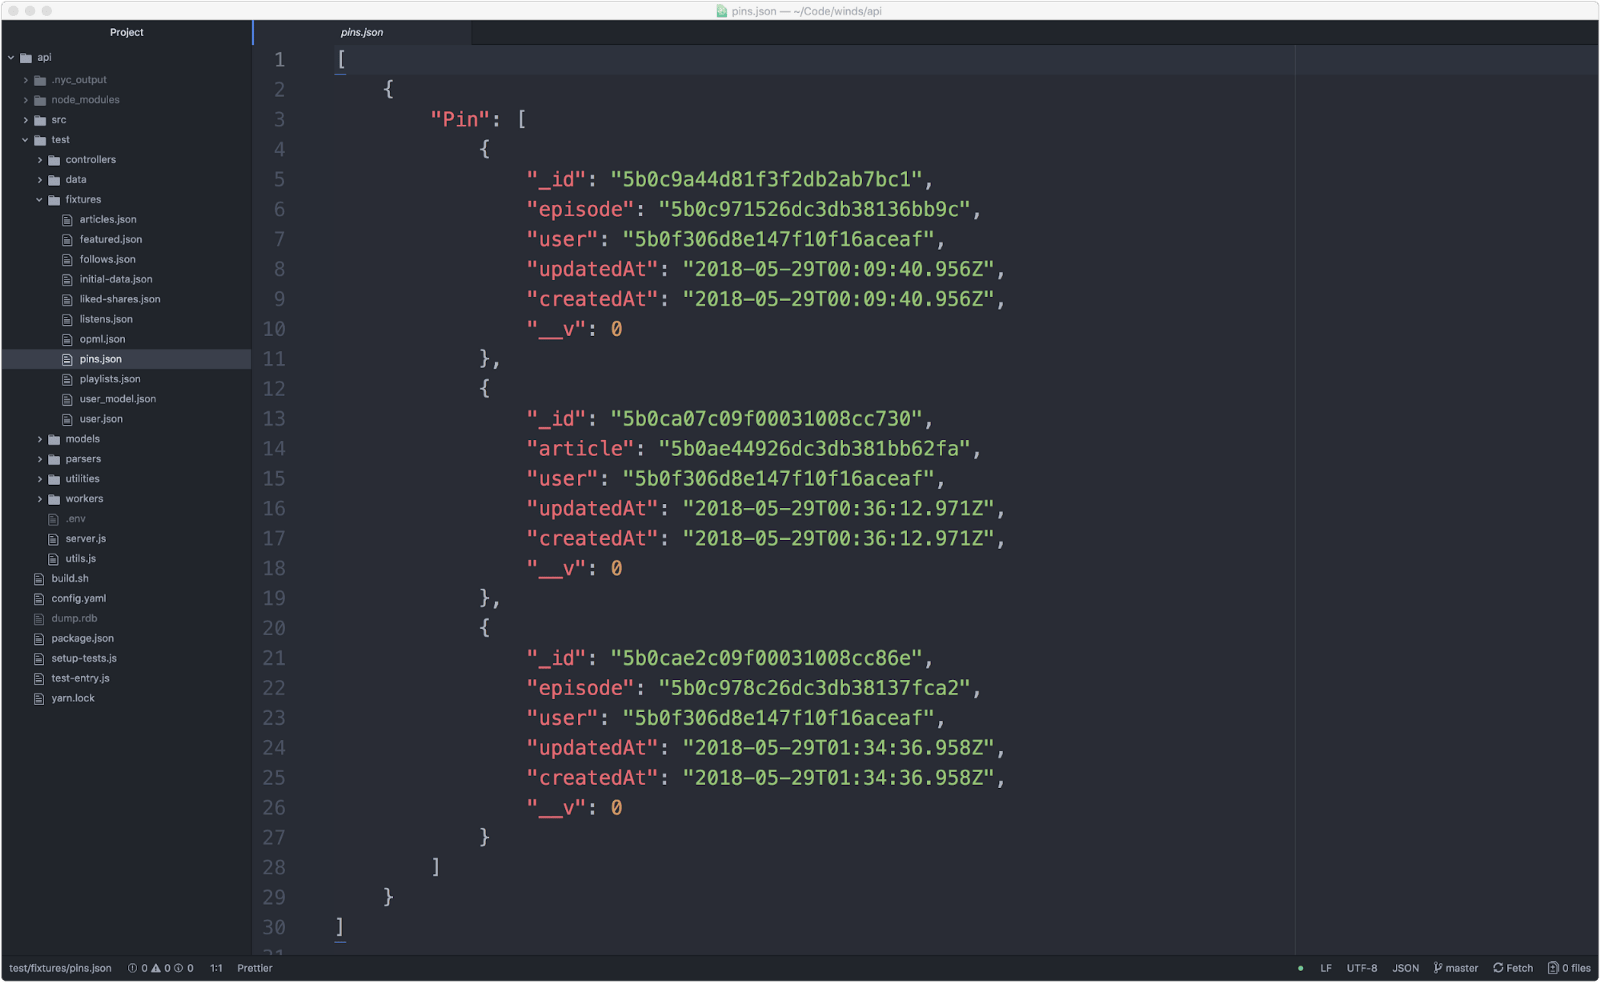
Node.js 里面没有创建配置的简单方式。我们最后做的事情是用 MongoDB Compass 工具导出数据到 JSON 中。这生成了不错的配置,如下图(但是,这是个乏味的过程,肯定会出错):

使用 Babel,模拟模块和 Mocha 测试执行平台时,模块加载不直观

为了支持多种 node 版本,和获取 JavaScript 标准的最新附件,我们使用 Babel 把 ES6 代码转换成 ES5。Node.js 模块系统基于 CommonJS 标准,而 ES6 模块系统中有不同的语义。

Babel 在 Node.js 模块系统的顶层模拟 ES6 模块语义,但由于我们要使用 mock-require 来介入模块的加载,所以我们经历了罕见的怪异的模块加载过程,这看上去很不直观,而且能导致在整个代码中,导入的、初始化的和使用的模块有不同的版本。这使测试时的模拟过程和全局状态管理复杂化了。

在使用 ES6 模块时声明的函数,模块内部的函数,都无法模拟

当一个模块导出多个函数,其中一个函数调用了其他的函数,就不可能模拟使用在模块内部的函数。原因在于当你引用一个 ES6 模块时,你得到的引用集合和模块内部的是不同的。任何重新绑定引用,将其指向新值的尝试都无法真正影响模块内部的函数,内部函数仍然使用的是原始的函数。

最后的思考

测试 Node.js 应用是复杂的过程,因为它的生态系统总在发展。掌握最新和最好的工具很重要,这样你就不会掉队了。

如今有很多方式获取 JavaScript 相关的新闻,导致与时俱进很难。关注邮件新闻刊物如 JavaScript Weekly 和 Node Weekly 是良好的开始。还有,关注一些 reddit 子模块如 /r/node 也不错。如果你喜欢了解最新的趋势,State of JS 在测试领域帮助开发者可视化趋势方面就做的很好。

最后,这里是一些我喜欢的博客,我经常在这上面发文章:

觉得我遗漏了某些重要的东西?在评论区或者 Twitter @NickParsons 让我知道。

还有,如果你想要了解 Stream,我们的网站上有很棒的 5 分钟教程。点 这里 进行查看。


作者简介:

Nick Parsons

Dreamer. Doer. Engineer. Developer Evangelist https://getstream.io.


via: https://hackernoon.com/testing-node-js-in-2018-10a04dd77391

作者:Nick Parsons 译者:BriFuture 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

Python Sets: What, Why and How

Python 配备了几种内置数据类型来帮我们组织数据。这些结构包括列表、字典、元组和集合。

根据 Python 3 文档:

集合是一个无序集合,没有重复元素。基本用途包括成员测试和消除重复的条目。集合对象还支持数学运算,如并集、交集、差集和对等差分。

在本文中,我们将回顾并查看上述定义中列出的每个要素的示例。让我们马上开始,看看如何创建它。

初始化一个集合

有两种方法可以创建一个集合:一个是给内置函数 set() 提供一个元素列表,另一个是使用花括号 {}。

使用内置函数 set() 来初始化一个集合:

>>> s1 = set([1, 2, 3])
>>> s1
{1, 2, 3}
>>> type(s1)
<class 'set'>

使用 {}:

>>> s2 = {3, 4, 5}
>>> s2
{3, 4, 5}
>>> type(s2)
<class 'set'>
>>>

如你所见,这两种方法都是有效的。但问题是,如果我们想要一个空的集合呢?

>>> s = {}
>>> type(s)
<class 'dict'>

没错,如果我们使用空花括号,我们将得到一个字典而不是一个集合。=)

值得一提的是,为了简单起见,本文中提供的所有示例都将使用整数集合,但集合可以包含 Python 支持的所有 可哈希的 hashable 数据类型。换句话说,即整数、字符串和元组,而不是列表或字典这样的可变类型。

>>> s = {1, 'coffee', [4, 'python']}
Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
TypeError: unhashable type: 'list'

既然你知道了如何创建一个集合以及它可以包含哪些类型的元素,那么让我们继续看看为什么我们总是应该把它放在我们的工具箱中。

为什么你需要使用它

写代码时,你可以用不止一种方法来完成它。有些被认为是相当糟糕的,另一些则是清晰的、简洁的和可维护的,或者是 “ Python 式的 pythonic ”。

根据 Hitchhiker 对 Python 的建议:

当一个经验丰富的 Python 开发人员( Python 人 Pythonista )调用一些不够 “ Python 式的 pythonic ” 的代码时,他们通常认为着这些代码不遵循通用指南,并且无法被认为是以一种好的方式(可读性)来表达意图。

让我们开始探索 Python 集合那些不仅可以帮助我们提高可读性,还可以加快程序执行时间的方式。

无序的集合元素

首先你需要明白的是:你无法使用索引访问集合中的元素。

>>> s = {1, 2, 3}
>>> s[0]
Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
TypeError: 'set' object does not support indexing

或者使用切片修改它们:

>>> s[0:2]
Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
TypeError: 'set' object is not subscriptable

但是,如果我们需要删除重复项,或者进行组合列表(与)之类的数学运算,那么我们可以,并且应该始终使用集合。

我不得不提一下,在迭代时,集合的表现优于列表。所以,如果你需要它,那就加深对它的喜爱吧。为什么?好吧,这篇文章并不打算解释集合的内部工作原理,但是如果你感兴趣的话,这里有几个链接,你可以阅读它:

没有重复项

写这篇文章的时候,我总是不停地思考,我经常使用 for 循环和 if 语句检查并删除列表中的重复元素。记得那时我的脸红了,而且不止一次,我写了类似这样的代码:

>>> my_list = [1, 2, 3, 2, 3, 4]
>>> no_duplicate_list = []
>>> for item in my_list:
...     if item not in no_duplicate_list:
...             no_duplicate_list.append(item)
...
>>> no_duplicate_list
[1, 2, 3, 4]

或者使用列表解析:

>>> my_list = [1, 2, 3, 2, 3, 4]
>>> no_duplicate_list = []
>>> [no_duplicate_list.append(item) for item in my_list if item not in no_duplicate_list]
[None, None, None, None]
>>> no_duplicate_list
[1, 2, 3, 4]

但没关系,因为我们现在有了武器装备,没有什么比这更重要的了:

>>> my_list = [1, 2, 3, 2, 3, 4]
>>> no_duplicate_list = list(set(my_list))
>>> no_duplicate_list
[1, 2, 3, 4]
>>>

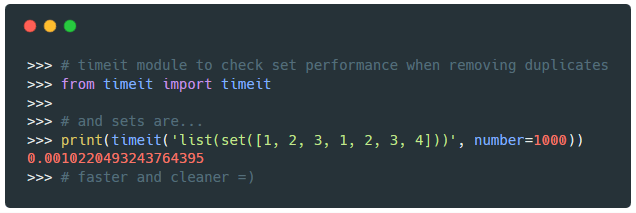
现在让我们使用 timeit 模块,查看列表和集合在删除重复项时的执行时间:

>>> from timeit import timeit
>>> def no_duplicates(list):
...     no_duplicate_list = []
...     [no_duplicate_list.append(item) for item in list if item not in no_duplicate_list]
...     return no_duplicate_list
...
>>> # 首先,让我们看看列表的执行情况:
>>> print(timeit('no_duplicates([1, 2, 3, 1, 7])', globals=globals(), number=1000))
0.0018683355819786227
>>> from timeit import timeit
>>> # 使用集合:
>>> print(timeit('list(set([1, 2, 3, 1, 2, 3, 4]))', number=1000))
0.0010220493243764395
>>> # 快速而且干净 =)

使用集合而不是列表推导不仅让我们编写更少的代码,而且还能让我们获得更具可读性和高性能的代码。

注意:请记住集合是无序的,因此无法保证在将它们转换回列表时,元素的顺序不变。

Python 之禅:

优美胜于丑陋 Beautiful is better than ugly.

明了胜于晦涩 Explicit is better than implicit.

简洁胜于复杂 Simple is better than complex.

扁平胜于嵌套 Flat is better than nested.

集合不正是这样美丽、明了、简单且扁平吗?

成员测试

每次我们使用 if 语句来检查一个元素,例如,它是否在列表中时,意味着你正在进行成员测试:

my_list = [1, 2, 3]
>>> if 2 in my_list:
...     print('Yes, this is a membership test!')
...
Yes, this is a membership test!

在执行这些操作时,集合比列表更高效:

>>> from timeit import timeit
>>> def in_test(iterable):
...     for i in range(1000):
...             if i in iterable:
...                     pass
...
>>> timeit('in_test(iterable)',
... setup="from __main__ import in_test; iterable = list(range(1000))",
... number=1000)
12.459663048726043
>>> from timeit import timeit
>>> def in_test(iterable):
...     for i in range(1000):
...             if i in iterable:
...                     pass
...
>>> timeit('in_test(iterable)',
... setup="from __main__ import in_test; iterable = set(range(1000))",
... number=1000)
.12354438152988223

注意:上面的测试来自于这个 StackOverflow 话题。

因此,如果你在巨大的列表中进行这样的比较,尝试将该列表转换为集合,它应该可以加快你的速度。

如何使用

现在你已经了解了集合是什么以及为什么你应该使用它,现在让我们快速浏览一下,看看我们如何修改和操作它。

添加元素

根据要添加的元素数量,我们要在 add() 和 update() 方法之间进行选择。

add() 适用于添加单个元素:

>>> s = {1, 2, 3}
>>> s.add(4)
>>> s
{1, 2, 3, 4}

update() 适用于添加多个元素:

>>> s = {1, 2, 3}
>>> s.update([2, 3, 4, 5, 6])
>>> s
{1, 2, 3, 4, 5, 6}

请记住,集合会移除重复项。

移除元素

如果你希望在代码中尝试删除不在集合中的元素时收到警报,请使用 remove()。否则,discard() 提供了一个很好的选择:

>>> s = {1, 2, 3}
>>> s.remove(3)
>>> s
{1, 2}
>>> s.remove(3)
Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
KeyError: 3

discard() 不会引起任何错误:

>>> s = {1, 2, 3}
>>> s.discard(3)
>>> s
{1, 2}
>>> s.discard(3)
>>> # 什么都不会发生

我们也可以使用 pop() 来随机丢弃一个元素:

>>> s = {1, 2, 3, 4, 5}
>>> s.pop()  # 删除一个任意的元素
1
>>> s
{2, 3, 4, 5}

或者 clear() 方法来清空一个集合:

>>> s = {1, 2, 3, 4, 5}
>>> s.clear()  # 清空集合
>>> s
set()

union()

union() 或者 | 将创建一个新集合,其中包含我们提供集合中的所有元素:

>>> s1 = {1, 2, 3}
>>> s2 = {3, 4, 5}
>>> s1.union(s2)  # 或者 's1 | s2'
{1, 2, 3, 4, 5}

intersection()

intersection 或 & 将返回一个由集合共同元素组成的集合:

>>> s1 = {1, 2, 3}
>>> s2 = {2, 3, 4}
>>> s3 = {3, 4, 5}
>>> s1.intersection(s2, s3)  # 或者 's1 & s2 & s3'
{3}

difference()

使用 diference() 或 - 创建一个新集合,其值在 “s1” 中但不在 “s2” 中:

>>> s1 = {1, 2, 3}
>>> s2 = {2, 3, 4}
>>> s1.difference(s2)  # 或者 's1 - s2'
{1}

symmetric\_diference()

symetric_difference 或 ^ 将返回集合之间的不同元素。

>>> s1 = {1, 2, 3}
>>> s2 = {2, 3, 4}
>>> s1.symmetric_difference(s2)  # 或者 's1 ^ s2'
{1, 4}

结论

我希望在阅读本文之后,你会知道集合是什么,如何操纵它的元素以及它可以执行的操作。知道何时使用集合无疑会帮助你编写更清晰的代码并加速你的程序。

如果你有任何疑问,请发表评论,我很乐意尝试回答。另外,不要忘记,如果你已经理解了集合,它们在 Python Cheatsheet 中有自己的一席之地,在那里你可以快速参考并重新认知你已经知道的内容。


via: https://www.pythoncheatsheet.org/blog/python-sets-what-why-how

作者:wilfredinni 译者:MjSeven 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出