标签 数据结构 下的文章

Python Sets: What, Why and How

Python 配备了几种内置数据类型来帮我们组织数据。这些结构包括列表、字典、元组和集合。

根据 Python 3 文档:

集合是一个无序集合,没有重复元素。基本用途包括成员测试和消除重复的条目。集合对象还支持数学运算,如并集、交集、差集和对等差分。

在本文中,我们将回顾并查看上述定义中列出的每个要素的示例。让我们马上开始,看看如何创建它。

初始化一个集合

有两种方法可以创建一个集合:一个是给内置函数 set() 提供一个元素列表,另一个是使用花括号 {}。

使用内置函数 set() 来初始化一个集合:

>>> s1 = set([1, 2, 3])
>>> s1
{1, 2, 3}
>>> type(s1)
<class 'set'>

使用 {}:

>>> s2 = {3, 4, 5}
>>> s2
{3, 4, 5}
>>> type(s2)
<class 'set'>
>>>

如你所见,这两种方法都是有效的。但问题是,如果我们想要一个空的集合呢?

>>> s = {}
>>> type(s)
<class 'dict'>

没错,如果我们使用空花括号,我们将得到一个字典而不是一个集合。=)

值得一提的是,为了简单起见,本文中提供的所有示例都将使用整数集合,但集合可以包含 Python 支持的所有 可哈希的 hashable 数据类型。换句话说,即整数、字符串和元组,而不是列表或字典这样的可变类型。

>>> s = {1, 'coffee', [4, 'python']}
Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
TypeError: unhashable type: 'list'

既然你知道了如何创建一个集合以及它可以包含哪些类型的元素,那么让我们继续看看为什么我们总是应该把它放在我们的工具箱中。

为什么你需要使用它

写代码时,你可以用不止一种方法来完成它。有些被认为是相当糟糕的,另一些则是清晰的、简洁的和可维护的,或者是 “ Python 式的 pythonic ”。

根据 Hitchhiker 对 Python 的建议:

当一个经验丰富的 Python 开发人员( Python 人 Pythonista )调用一些不够 “ Python 式的 pythonic ” 的代码时,他们通常认为着这些代码不遵循通用指南,并且无法被认为是以一种好的方式(可读性)来表达意图。

让我们开始探索 Python 集合那些不仅可以帮助我们提高可读性,还可以加快程序执行时间的方式。

无序的集合元素

首先你需要明白的是:你无法使用索引访问集合中的元素。

>>> s = {1, 2, 3}
>>> s[0]
Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
TypeError: 'set' object does not support indexing

或者使用切片修改它们:

>>> s[0:2]
Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
TypeError: 'set' object is not subscriptable

但是,如果我们需要删除重复项,或者进行组合列表(与)之类的数学运算,那么我们可以,并且应该始终使用集合。

我不得不提一下,在迭代时,集合的表现优于列表。所以,如果你需要它,那就加深对它的喜爱吧。为什么?好吧,这篇文章并不打算解释集合的内部工作原理,但是如果你感兴趣的话,这里有几个链接,你可以阅读它:

没有重复项

写这篇文章的时候,我总是不停地思考,我经常使用 for 循环和 if 语句检查并删除列表中的重复元素。记得那时我的脸红了,而且不止一次,我写了类似这样的代码:

>>> my_list = [1, 2, 3, 2, 3, 4]
>>> no_duplicate_list = []
>>> for item in my_list:
...     if item not in no_duplicate_list:
...             no_duplicate_list.append(item)
...
>>> no_duplicate_list
[1, 2, 3, 4]

或者使用列表解析:

>>> my_list = [1, 2, 3, 2, 3, 4]
>>> no_duplicate_list = []
>>> [no_duplicate_list.append(item) for item in my_list if item not in no_duplicate_list]
[None, None, None, None]
>>> no_duplicate_list
[1, 2, 3, 4]

但没关系,因为我们现在有了武器装备,没有什么比这更重要的了:

>>> my_list = [1, 2, 3, 2, 3, 4]
>>> no_duplicate_list = list(set(my_list))
>>> no_duplicate_list
[1, 2, 3, 4]
>>>

现在让我们使用 timeit 模块,查看列表和集合在删除重复项时的执行时间:

>>> from timeit import timeit
>>> def no_duplicates(list):
...     no_duplicate_list = []
...     [no_duplicate_list.append(item) for item in list if item not in no_duplicate_list]
...     return no_duplicate_list
...
>>> # 首先,让我们看看列表的执行情况:
>>> print(timeit('no_duplicates([1, 2, 3, 1, 7])', globals=globals(), number=1000))
0.0018683355819786227
>>> from timeit import timeit
>>> # 使用集合:
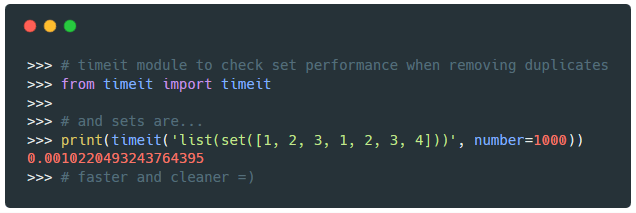
>>> print(timeit('list(set([1, 2, 3, 1, 2, 3, 4]))', number=1000))
0.0010220493243764395
>>> # 快速而且干净 =)

使用集合而不是列表推导不仅让我们编写更少的代码,而且还能让我们获得更具可读性和高性能的代码。

注意:请记住集合是无序的,因此无法保证在将它们转换回列表时,元素的顺序不变。

Python 之禅:

优美胜于丑陋 Beautiful is better than ugly.

明了胜于晦涩 Explicit is better than implicit.

简洁胜于复杂 Simple is better than complex.

扁平胜于嵌套 Flat is better than nested.

集合不正是这样美丽、明了、简单且扁平吗?

成员测试

每次我们使用 if 语句来检查一个元素,例如,它是否在列表中时,意味着你正在进行成员测试:

my_list = [1, 2, 3]
>>> if 2 in my_list:
...     print('Yes, this is a membership test!')
...
Yes, this is a membership test!

在执行这些操作时,集合比列表更高效:

>>> from timeit import timeit
>>> def in_test(iterable):
...     for i in range(1000):
...             if i in iterable:
...                     pass
...
>>> timeit('in_test(iterable)',
... setup="from __main__ import in_test; iterable = list(range(1000))",
... number=1000)
12.459663048726043
>>> from timeit import timeit
>>> def in_test(iterable):
...     for i in range(1000):
...             if i in iterable:
...                     pass
...
>>> timeit('in_test(iterable)',
... setup="from __main__ import in_test; iterable = set(range(1000))",
... number=1000)
.12354438152988223

注意:上面的测试来自于这个 StackOverflow 话题。

因此,如果你在巨大的列表中进行这样的比较,尝试将该列表转换为集合,它应该可以加快你的速度。

如何使用

现在你已经了解了集合是什么以及为什么你应该使用它,现在让我们快速浏览一下,看看我们如何修改和操作它。

添加元素

根据要添加的元素数量,我们要在 add() 和 update() 方法之间进行选择。

add() 适用于添加单个元素:

>>> s = {1, 2, 3}
>>> s.add(4)
>>> s
{1, 2, 3, 4}

update() 适用于添加多个元素:

>>> s = {1, 2, 3}
>>> s.update([2, 3, 4, 5, 6])
>>> s
{1, 2, 3, 4, 5, 6}

请记住,集合会移除重复项。

移除元素

如果你希望在代码中尝试删除不在集合中的元素时收到警报,请使用 remove()。否则,discard() 提供了一个很好的选择:

>>> s = {1, 2, 3}
>>> s.remove(3)
>>> s
{1, 2}
>>> s.remove(3)
Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
KeyError: 3

discard() 不会引起任何错误:

>>> s = {1, 2, 3}
>>> s.discard(3)
>>> s
{1, 2}
>>> s.discard(3)
>>> # 什么都不会发生

我们也可以使用 pop() 来随机丢弃一个元素:

>>> s = {1, 2, 3, 4, 5}
>>> s.pop()  # 删除一个任意的元素
1
>>> s
{2, 3, 4, 5}

或者 clear() 方法来清空一个集合:

>>> s = {1, 2, 3, 4, 5}
>>> s.clear()  # 清空集合
>>> s
set()

union()

union() 或者 | 将创建一个新集合,其中包含我们提供集合中的所有元素:

>>> s1 = {1, 2, 3}
>>> s2 = {3, 4, 5}
>>> s1.union(s2)  # 或者 's1 | s2'
{1, 2, 3, 4, 5}

intersection()

intersection 或 & 将返回一个由集合共同元素组成的集合:

>>> s1 = {1, 2, 3}
>>> s2 = {2, 3, 4}
>>> s3 = {3, 4, 5}
>>> s1.intersection(s2, s3)  # 或者 's1 & s2 & s3'
{3}

difference()

使用 diference() 或 - 创建一个新集合,其值在 “s1” 中但不在 “s2” 中:

>>> s1 = {1, 2, 3}
>>> s2 = {2, 3, 4}
>>> s1.difference(s2)  # 或者 's1 - s2'
{1}

symmetric\_diference()

symetric_difference 或 ^ 将返回集合之间的不同元素。

>>> s1 = {1, 2, 3}
>>> s2 = {2, 3, 4}
>>> s1.symmetric_difference(s2)  # 或者 's1 ^ s2'
{1, 4}

结论

我希望在阅读本文之后,你会知道集合是什么,如何操纵它的元素以及它可以执行的操作。知道何时使用集合无疑会帮助你编写更清晰的代码并加速你的程序。

如果你有任何疑问,请发表评论,我很乐意尝试回答。另外,不要忘记,如果你已经理解了集合,它们在 Python Cheatsheet 中有自己的一席之地,在那里你可以快速参考并重新认知你已经知道的内容。


via: https://www.pythoncheatsheet.org/blog/python-sets-what-why-how

作者:wilfredinni 译者:MjSeven 校对:wxy
本文由 LCTT 原创编译,Linux中国 荣誉推出

直到几个月以前,对于我来说,在消息传递的环境中, 流 streams 只是一个有趣且相对简单的概念。这个概念在 Kafka 流行之后,我主要研究它们在 Disque 案例中的应用,Disque 是一个消息队列,它将在 Redis 4.2 中被转换为 Redis 的一个模块。后来我决定让 Disque 都用 AP 消息(LCTT 译注:参见 CAP 定理),也就是说,它将在不需要客户端过多参与的情况下实现容错和可用性,这样一来,我更加确定地认为流的概念在那种情况下并不适用。

然而在那时 Redis 有个问题,那就是缺省情况下导出数据结构并不轻松。它在 Redis 列表 list 、 有序集 sorted list 、 发布/订阅 Pub/Sub 功能之间有某些缺陷。你可以权衡使用这些工具对一系列消息或事件建模。

有序集是内存消耗大户,那自然就不能对投递的相同消息进行一次又一次的建模,客户端不能阻塞新消息。因为有序集并不是一个序列化的数据结构,它是一个元素可以根据它们量的变化而移动的集合:所以它不像时序性的数据那样。

列表有另外的问题,它在某些特定的用例中会产生类似的适用性问题:你无法浏览列表中间的内容,因为在那种情况下,访问时间是线性的。此外,没有任何指定输出的功能,列表上的阻塞操作仅为单个客户端提供单个元素。列表中没有固定的元素标识,也就是说,不能指定从哪个元素开始给我提供内容。

对于一对多的工作任务,有发布/订阅机制,它在大多数情况下是非常好的,但是,对于某些不想 “即发即弃” fire-and-forget 的东西:保留一个历史是很重要的,不只是因为是断开之后会重新获得消息,也因为某些如时序性的消息列表,用范围查询浏览是非常重要的:比如在这 10 秒范围内温度读数是多少?

我试图解决上述问题,我想规划一个通用的有序集合,并列入一个独特的、更灵活的数据结构,然而,我的设计尝试最终以生成一个比当前的数据结构更加矫揉造作的结果而告终。Redis 有个好处,它的数据结构导出更像自然的计算机科学的数据结构,而不是 “Salvatore 发明的 API”。因此,我最终停止了我的尝试,并且说,“ok,这是我们目前能提供的”,或许我会为发布/订阅增加一些历史信息,或者为列表访问增加一些更灵活的方式。然而,每次在会议上有用户对我说 “你如何在 Redis 中模拟时间系列” 或者类似的问题时,我的脸就绿了。

起源

在 Redis 4.0 中引入模块之后,用户开始考虑他们自己怎么去修复这些问题。其中一个用户 Timothy Downs 通过 IRC 和我说道:

\<forkfork> 我计划给这个模块增加一个事务日志式的数据类型 —— 这意味着大量的订阅者可以在不导致 redis 内存激增的情况下做一些像发布/订阅那样的事情
\<forkfork> 订阅者持有他们在消息队列中的位置,而不是让 Redis 必须维护每个消费者的位置和为每个订阅者复制消息

他的思路启发了我。我想了几天,并且意识到这可能是我们马上同时解决上面所有问题的契机。我需要去重新构思 “日志” 的概念是什么。日志是个基本的编程元素,每个人都使用过它,因为它只是简单地以追加模式打开一个文件,并以一定的格式写入数据。然而 Redis 数据结构必须是抽象的。它们在内存中,并且我们使用内存并不是因为我们懒,而是因为使用一些指针,我们可以概念化数据结构并把它们抽象,以使它们摆脱明确的限制。例如,一般来说日志有几个问题:偏移不是逻辑化的,而是真实的字节偏移,如果你想要与条目插入的时间相关的逻辑偏移应该怎么办?我们有范围查询可用。同样,日志通常很难进行垃圾回收:在一个只能进行追加操作的数据结构中怎么去删除旧的元素?好吧,在我们理想的日志中,我们只需要说,我想要数字最大的那个条目,而旧的元素一个也不要,等等。

当我从 Timothy 的想法中受到启发,去尝试着写一个规范的时候,我使用了 Redis 集群中的 radix 树去实现,优化了它内部的某些部分。这为实现一个有效利用空间的日志提供了基础,而且仍然有可能在 对数时间 logarithmic time 内访问范围。同时,我开始去读关于 Kafka 的流相关的内容以获得另外的灵感,它也非常适合我的设计,最后借鉴了 Kafka 消费组 consumer groups 的概念,并且再次针对 Redis 进行优化,以适用于 Redis 在内存中使用的情况。然而,该规范仅停留在纸面上,在一段时间后我几乎把它从头到尾重写了一遍,以便将我与别人讨论的所得到的许多建议一起增加到 Redis 升级中。我希望 Redis 流能成为对于时间序列有用的特性,而不仅是一个常见的事件和消息类的应用程序。

让我们写一些代码吧

从 Redis 大会回来后,整个夏天我都在实现一个叫 listpack 的库。这个库是 ziplist.c 的继任者,那是一个表示在单个分配中的字符串元素列表的数据结构。它是一个非常特殊的序列化格式,其特点在于也能够以逆序(从右到左)解析:以便在各种用例中替代 ziplists。

结合 radix 树和 listpacks 的特性,它可以很容易地去构建一个空间高效的日志,并且还是可索引的,这意味着允许通过 ID 和时间进行随机访问。自从这些就绪后,我开始去写一些代码以实现流数据结构。我还在完成这个实现,不管怎样,现在在 Github 上的 Redis 的 streams 分支里它已经可以跑起来了。我并没有声称那个 API 是 100% 的最终版本,但是,这有两个有意思的事实:一,在那时只有消费群组是缺失的,加上一些不太重要的操作流的命令,但是,所有的大的方面都已经实现了。二,一旦各个方面比较稳定了之后,我决定大概用两个月的时间将所有的流的特性 向后移植 backport 到 4.0 分支。这意味着 Redis 用户想要使用流,不用等待 Redis 4.2 发布,它们在生产环境马上就可用了。这是可能的,因为作为一个新的数据结构,几乎所有的代码改变都出现在新的代码里面。除了阻塞列表操作之外:该代码被重构了,我们对于流和列表阻塞操作共享了相同的代码,而极大地简化了 Redis 内部实现。

教程:欢迎使用 Redis 的 streams

在某些方面,你可以认为流是 Redis 列表的一个增强版本。流元素不再是一个单一的字符串,而是一个 字段 field 和 值 value 组成的对象。范围查询更适用而且更快。在流中,每个条目都有一个 ID,它是一个逻辑偏移量。不同的客户端可以 阻塞等待 blocking-wait 比指定的 ID 更大的元素。Redis 流的一个基本的命令是 XADD。是的,所有的 Redis 流命令都是以一个 X 为前缀的。

> XADD mystream * sensor-id 1234 temperature 10.5
1506871964177.0

这个 XADD 命令将追加指定的条目作为一个指定的流 —— “mystream” 的新元素。上面示例中的这个条目有两个字段:sensor-id 和 temperature,每个条目在同一个流中可以有不同的字段。使用相同的字段名可以更好地利用内存。有意思的是,字段的排序是可以保证顺序的。XADD 仅返回插入的条目的 ID,因为在第三个参数中是星号(*),表示由命令自动生成 ID。通常这样做就够了,但是也可以去强制指定一个 ID,这种情况用于复制这个命令到 从服务器 slave server 和 AOF append-only file 文件。

这个 ID 是由两部分组成的:一个毫秒时间和一个序列号。1506871964177 是毫秒时间,它只是一个毫秒级的 UNIX 时间戳。圆点(.)后面的数字 0 是一个序号,它是为了区分相同毫秒数的条目增加上去的。这两个数字都是 64 位的无符号整数。这意味着,我们可以在流中增加所有想要的条目,即使是在同一毫秒中。ID 的毫秒部分使用 Redis 服务器的当前本地时间生成的 ID 和流中的最后一个条目 ID 两者间的最大的一个。因此,举例来说,即使是计算机时间回跳,这个 ID 仍然是增加的。在某些情况下,你可以认为流条目的 ID 是完整的 128 位数字。然而,事实上它们与被添加到的实例的本地时间有关,这意味着我们可以在毫秒级的精度的范围随意查询。

正如你想的那样,快速添加两个条目后,结果是仅一个序号递增了。我们可以用一个 MULTI/EXEC 块来简单模拟“快速插入”:

> MULTI
OK
> XADD mystream * foo 10
QUEUED
> XADD mystream * bar 20
QUEUED
> EXEC
1) 1506872463535.0
2) 1506872463535.1

在上面的示例中,也展示了无需指定任何初始 模式 schema 的情况下,对不同的条目使用不同的字段。会发生什么呢?就像前面提到的一样,只有每个块(它通常包含 50-150 个消息内容)的第一个消息被使用。并且,相同字段的连续条目都使用了一个标志进行了压缩,这个标志表示与“它们与这个块中的第一个条目的字段相同”。因此,使用相同字段的连续消息可以节省许多内存,即使是字段集随着时间发生缓慢变化的情况下也很节省内存。

为了从流中检索数据,这里有两种方法:范围查询,它是通过 XRANGE 命令实现的; 流播 streaming ,它是通过 XREAD 命令实现的。XRANGE 命令仅取得包括从开始到停止范围内的全部条目。因此,举例来说,如果我知道它的 ID,我可以使用如下的命名取得单个条目:

> XRANGE mystream 1506871964177.0 1506871964177.0
1) 1) 1506871964177.0
   2) 1) "sensor-id"
      2) "1234"
      3) "temperature"
      4) "10.5"

不管怎样,你都可以使用指定的开始符号 - 和停止符号 + 表示最小和最大的 ID。为了限制返回条目的数量,也可以使用 COUNT 选项。下面是一个更复杂的 XRANGE 示例:

> XRANGE mystream - + COUNT 2
1) 1) 1506871964177.0
   2) 1) "sensor-id"
      2) "1234"
      3) "temperature"
      4) "10.5"
2) 1) 1506872463535.0
   2) 1) "foo"
      2) "10"

这里我们讲的是 ID 的范围,然后,为了取得在一个给定时间范围内的特定范围的元素,你可以使用 XRANGE,因为 ID 的“序号” 部分可以省略。因此,你可以只指定“毫秒”时间即可,下面的命令的意思是:“从 UNIX 时间 1506872463 开始给我 10 个条目”:

127.0.0.1:6379> XRANGE mystream 1506872463000 + COUNT 10
1) 1) 1506872463535.0
   2) 1) "foo"
      2) "10"
2) 1) 1506872463535.1
   2) 1) "bar"
      2) "20"

关于 XRANGE 需要注意的最重要的事情是,假设我们在回复中收到 ID,随后连续的 ID 只是增加了序号部分,所以可以使用 XRANGE 遍历整个流,接收每个调用的指定个数的元素。Redis 中的*SCAN 系列命令允许迭代 Redis 数据结构,尽管事实上它们不是为迭代设计的,但这样可以避免再犯相同的错误。

使用 XREAD 处理流播:阻塞新的数据

当我们想通过 ID 或时间去访问流中的一个范围或者是通过 ID 去获取单个元素时,使用 XRANGE 是非常完美的。然而,在使用流的案例中,当数据到达时,它必须由不同的客户端来消费时,这就不是一个很好的解决方案,这需要某种形式的 汇聚池 pooling 。(对于 某些 应用程序来说,这可能是个好主意,因为它们仅是偶尔连接查询的)

XREAD 命令是为读取设计的,在同一个时间,从多个流中仅指定我们从该流中得到的最后条目的 ID。此外,如果没有数据可用,我们可以要求阻塞,当数据到达时,就解除阻塞。类似于阻塞列表操作产生的效果,但是这里并没有消费从流中得到的数据,并且多个客户端可以同时访问同一份数据。

这里有一个典型的 XREAD 调用示例:

> XREAD BLOCK 5000 STREAMS mystream otherstream $ $

它的意思是:从 mystream 和 otherstream 取得数据。如果没有数据可用,阻塞客户端 5000 毫秒。在 STREAMS 选项之后指定我们想要监听的关键字,最后的是指定想要监听的 ID,指定的 ID 为 $ 的意思是:假设我现在需要流中的所有元素,因此,只需要从下一个到达的元素开始给我。

如果我从另一个客户端发送这样的命令:

> XADD otherstream * message “Hi There”

在 XREAD 侧会出现什么情况呢?

1) 1) "otherstream"
   2) 1) 1) 1506935385635.0
         2) 1) "message"
            2) "Hi There"

与收到的数据一起,我们也得到了数据的关键字。在下次调用中,我们将使用接收到的最新消息的 ID:

> XREAD BLOCK 5000 STREAMS mystream otherstream $ 1506935385635.0

依次类推。然而需要注意的是使用方式,客户端有可能在一个非常大的延迟之后再次连接(因为它处理消息需要时间,或者其它什么原因)。在这种情况下,期间会有很多消息堆积,为了确保客户端不被消息淹没,以及服务器不会因为给单个客户端提供大量消息而浪费太多的时间,使用 XREAD 的 COUNT 选项是非常明智的。

流封顶

目前看起来还不错……然而,有些时候,流需要删除一些旧的消息。幸运的是,这可以使用 XADD 命令的 MAXLEN 选项去做:

> XADD mystream MAXLEN 1000000 * field1 value1 field2 value2

它是基本意思是,如果在流中添加新元素后发现消息数量超过了 1000000 个,那么就删除旧的消息,以便于元素总量重新回到 1000000 以内。它很像是在列表中使用的 RPUSH + LTRIM,但是,这次我们是使用了一个内置机制去完成的。然而,需要注意的是,上面的意思是每次我们增加一个新的消息时,我们还需要另外的工作去从流中删除旧的消息。这将消耗一些 CPU 资源,所以在计算 MAXLEN 之前,尽可能使用 ~ 符号,以表明我们不要求非常 精确 的 1000000 个消息,就是稍微多一些也不是大问题:

> XADD mystream MAXLEN ~ 1000000 * foo bar

这种方式的 XADD 仅当它可以删除整个节点的时候才会删除消息。相比普通的 XADD,这种方式几乎可以自由地对流进行封顶。

消费组(开发中)

这是第一个 Redis 中尚未实现而在开发中的特性。灵感也是来自 Kafka,尽管在这里是以不同的方式实现的。重点是使用了 XREAD,客户端也可以增加一个 GROUP <name> 选项。相同组的所有客户端将自动得到 不同的 消息。当然,同一个流可以被多个组读取。在这种情况下,所有的组将收到流中到达的消息的相同副本。但是,在每个组内,消息是不会重复的。

当指定组时,能够指定一个 RETRY <milliseconds> 选项去扩展组:在这种情况下,如果消息没有通过 XACK 进行确认,它将在指定的毫秒数后进行再次投递。这将为消息投递提供更佳的可靠性,这种情况下,客户端没有私有的方法将消息标记为已处理。这一部分也正在开发中。

内存使用和节省加载时间

因为用来建模 Redis 流的设计,内存使用率是非常低的。这取决于它们的字段、值的数量和长度,对于简单的消息,每使用 100MB 内存可以有几百万条消息。此外,该格式设想为需要极少的序列化:listpack 块以 radix 树节点方式存储,在磁盘上和内存中都以相同方式表示的,因此它们可以很轻松地存储和读取。例如,Redis 可以在 0.3 秒内从 RDB 文件中读取 500 万个条目。这使流的复制和持久存储非常高效。

我还计划允许从条目中间进行部分删除。现在仅实现了一部分,策略是在条目在标记中标识条目为已删除,并且,当已删除条目占全部条目的比例达到指定值时,这个块将被回收重写,如果需要,它将被连到相邻的另一个块上,以避免碎片化。

关于最终发布时间的结论

Redis 的流特性将包含在年底前(LCTT 译注:本文原文发布于 2017 年 10 月)推出的 Redis 4.0 系列的稳定版中。我认为这个通用的数据结构将为 Redis 提供一个巨大的补丁,以用于解决很多现在很难以解决的情况:那意味着你(之前)需要创造性地“滥用”当前提供的数据结构去解决那些问题。一个非常重要的使用场景是时间序列,但是,我觉得对于其它场景来说,通过 TREAD 来流播消息将是非常有趣的,因为对于那些需要更高可靠性的应用程序,可以使用发布/订阅模式来替换“即用即弃”,还有其它全新的使用场景。现在,如果你想在有问题环境中评估这个新数据结构,可以更新 GitHub 上的 streams 分支开始试用。欢迎向我们报告所有的 bug。:-)

如果你喜欢观看视频的方式,这里有一个现场演示:https://www.youtube.com/watch?v=ELDzy9lCFHQ


via: http://antirez.com/news/114

作者:antirez 译者:qhwdw 校对:wxy, pityonline

本文由 LCTT 原创编译,Linux中国 荣誉推出

Linux 内核中的位数组和位操作

除了不同的基于链式和树的数据结构以外,Linux 内核也为位数组(或称为 位图 ( bitmap ) )提供了 API。位数组在 Linux 内核里被广泛使用,并且在以下的源代码文件中包含了与这样的结构搭配使用的通用 API:

除了这两个文件之外,还有体系结构特定的头文件,它们为特定的体系结构提供优化的位操作。我们将探讨 x86\_64 体系结构,因此在我们的例子里,它会是

头文件。正如我上面所写的,位图在 Linux 内核中被广泛地使用。例如,位数组常常用于保存一组在线/离线处理器,以便系统支持热插拔的 CPU(你可以在 cpumasks 部分阅读更多相关知识 ),一个 位数组 ( bit array ) 可以在 Linux 内核初始化等期间保存一组已分配的中断处理。

因此,本部分的主要目的是了解 位数组 ( bit array ) 是如何在 Linux 内核中实现的。让我们现在开始吧。

位数组声明

在我们开始查看位图操作的 API 之前,我们必须知道如何在 Linux 内核中声明它。有两种声明位数组的通用方法。第一种简单的声明一个位数组的方法是,定义一个 unsigned long 的数组,例如:

unsigned long my_bitmap[8]

第二种方法,是使用 DECLARE_BITMAP 宏,它定义于 include/linux/types.h 头文件:

#define DECLARE_BITMAP(name,bits) \
    unsigned long name[BITS_TO_LONGS(bits)]

我们可以看到 DECLARE_BITMAP 宏使用两个参数:

  • name - 位图名称;
  • bits - 位图中位数;

并且只是使用 BITS_TO_LONGS(bits) 元素展开 unsigned long 数组的定义。 BITS_TO_LONGS 宏将一个给定的位数转换为 long 的个数,换言之,就是计算 bits 中有多少个 8 字节元素:

#define BITS_PER_BYTE           8
#define DIV_ROUND_UP(n,d) (((n) + (d) - 1) / (d))
#define BITS_TO_LONGS(nr)       DIV_ROUND_UP(nr, BITS_PER_BYTE * sizeof(long))

因此,例如 DECLARE_BITMAP(my_bitmap, 64) 将产生:

>>> (((64) + (64) - 1) / (64))
1

与:

unsigned long my_bitmap[1];

在能够声明一个位数组之后,我们便可以使用它了。

体系结构特定的位操作

我们已经看了上面提及的一对源文件和头文件,它们提供了位数组操作的 API。其中重要且广泛使用的位数组 API 是体系结构特定的且位于已提及的头文件中 arch/x86/include/asm/bitops.h。

首先让我们查看两个最重要的函数:

  • set_bit;
  • clear_bit.

我认为没有必要解释这些函数的作用。从它们的名字来看,这已经很清楚了。让我们直接查看它们的实现。如果你浏览 arch/x86/include/asm/bitops.h 头文件,你将会注意到这些函数中的每一个都有原子性和非原子性两种变体。在我们开始深入这些函数的实现之前,首先,我们必须了解一些有关 原子 ( atomic ) 操作的知识。

简而言之,原子操作保证两个或以上的操作不会并发地执行同一数据。x86 体系结构提供了一系列原子指令,例如, xchg、cmpxchg 等指令。除了原子指令,一些非原子指令可以在 lock 指令的帮助下具有原子性。现在你已经对原子操作有了足够的了解,我们可以接着探讨 set_bit 和 clear_bit 函数的实现。

我们先考虑函数的 非原子性 ( non-atomic ) 变体。非原子性的 set_bit 和 clear_bit 的名字以双下划线开始。正如我们所知道的,所有这些函数都定义于 arch/x86/include/asm/bitops.h 头文件,并且第一个函数就是 __set_bit:

static inline void __set_bit(long nr, volatile unsigned long *addr)
{
    asm volatile("bts %1,%0" : ADDR : "Ir" (nr) : "memory");
}

正如我们所看到的,它使用了两个参数:

  • nr - 位数组中的位号(LCTT 译注:从 0 开始)
  • addr - 我们需要置位的位数组地址

注意,addr 参数使用 volatile 关键字定义,以告诉编译器给定地址指向的变量可能会被修改。 __set_bit 的实现相当简单。正如我们所看到的,它仅包含一行内联汇编代码。在我们的例子中,我们使用 bts 指令,从位数组中选出一个第一操作数(我们的例子中的 nr)所指定的位,存储选出的位的值到 CF 标志寄存器并设置该位(LCTT 译注:即 nr 指定的位置为 1)。

注意,我们了解了 nr 的用法,但这里还有一个参数 addr 呢!你或许已经猜到秘密就在 ADDR。 ADDR 是一个定义在同一个头文件中的宏,它展开为一个包含给定地址和 +m 约束的字符串:

#define ADDR                BITOP_ADDR(addr)
#define BITOP_ADDR(x) "+m" (*(volatile long *) (x))

除了 +m 之外,在 __set_bit 函数中我们可以看到其他约束。让我们查看并试着理解它们所表示的意义:

  • +m - 表示内存操作数,这里的 + 表明给定的操作数为输入输出操作数;
  • I - 表示整型常量;
  • r - 表示寄存器操作数

除了这些约束之外,我们也能看到 memory 关键字,其告诉编译器这段代码会修改内存中的变量。到此为止,现在我们看看相同的 原子性 ( atomic ) 变体函数。它看起来比 非原子性 ( non-atomic ) 变体更加复杂:

static __always_inline void
set_bit(long nr, volatile unsigned long *addr)
{
    if (IS_IMMEDIATE(nr)) {
        asm volatile(LOCK_PREFIX "orb %1,%0"
            : CONST_MASK_ADDR(nr, addr)
            : "iq" ((u8)CONST_MASK(nr))
            : "memory");
    } else {
        asm volatile(LOCK_PREFIX "bts %1,%0"
            : BITOP_ADDR(addr) : "Ir" (nr) : "memory");
    }
}

(LCTT 译注:BITOP\_ADDR 的定义为:#define BITOP_ADDR(x) "=m" (*(volatile long *) (x)),ORB 为字节按位或。)

首先注意,这个函数使用了与 __set_bit 相同的参数集合,但额外地使用了 __always_inline 属性标记。 __always_inline 是一个定义于 include/linux/compiler-gcc.h 的宏,并且只是展开为 always_inline 属性:

#define __always_inline inline __attribute__((always_inline))

其意味着这个函数总是内联的,以减少 Linux 内核映像的大小。现在让我们试着了解下 set_bit 函数的实现。首先我们在 set_bit 函数的开头检查给定的位的数量。IS_IMMEDIATE 宏定义于相同的头文件,并展开为 gcc 内置函数的调用:

#define IS_IMMEDIATE(nr)        (__builtin_constant_p(nr))

如果给定的参数是编译期已知的常量,__builtin_constant_p 内置函数则返回 1,其他情况返回 0。假若给定的位数是编译期已知的常量,我们便无须使用效率低下的 bts 指令去设置位。我们可以只需在给定地址指向的字节上执行 按位或 操作,其字节包含给定的位,掩码位数表示高位为 1,其他位为 0 的掩码。在其他情况下,如果给定的位号不是编译期已知常量,我们便做和 __set_bit 函数一样的事。CONST_MASK_ADDR 宏:

#define CONST_MASK_ADDR(nr, addr)   BITOP_ADDR((void *)(addr) + ((nr)>>3))

展开为带有到包含给定位的字节偏移的给定地址,例如,我们拥有地址 0x1000 和位号 0x9。因为 0x9 代表 一个字节 + 一位,所以我们的地址是 addr + 1:

>>> hex(0x1000 + (0x9 >> 3))
'0x1001'

CONST_MASK 宏将我们给定的位号表示为字节,位号对应位为高位 1,其他位为 0:

#define CONST_MASK(nr)          (1 << ((nr) & 7))
>>> bin(1 << (0x9 & 7))
'0b10'

最后,我们应用 按位或 运算到这些变量上面,因此,假如我们的地址是 0x4097 ,并且我们需要置位号为 9 的位为 1:

>>> bin(0x4097)
'0b100000010010111'
>>> bin((0x4097 >> 0x9) | (1 << (0x9 & 7)))
'0b100010'

第 9 位 将会被置位。(LCTT 译注:这里的 9 是从 0 开始计数的,比如0010,按照作者的意思,其中的 1 是第 1 位)

注意,所有这些操作使用 LOCK_PREFIX 标记,其展开为 lock 指令,保证该操作的原子性。

正如我们所知,除了 set_bit 和 __set_bit 操作之外,Linux 内核还提供了两个功能相反的函数,在原子性和非原子性的上下文中清位。它们是 clear_bit 和 __clear_bit。这两个函数都定义于同一个头文件 并且使用相同的参数集合。不仅参数相似,一般而言,这些函数与 set_bit 和 __set_bit 也非常相似。让我们查看非原子性 __clear_bit 的实现吧:

static inline void __clear_bit(long nr, volatile unsigned long *addr)
{
    asm volatile("btr %1,%0" : ADDR : "Ir" (nr));
}

没错,正如我们所见,__clear_bit 使用相同的参数集合,并包含极其相似的内联汇编代码块。它只是使用 btr 指令替换了 bts。正如我们从函数名所理解的一样,通过给定地址,它清除了给定的位。btr 指令表现得像 bts(LCTT 译注:原文这里为 btr,可能为笔误,修正为 bts)。该指令选出第一操作数所指定的位,存储它的值到 CF 标志寄存器,并且清除第二操作数指定的位数组中的对应位。

__clear_bit 的原子性变体为 clear_bit:

static __always_inline void
clear_bit(long nr, volatile unsigned long *addr)
{
    if (IS_IMMEDIATE(nr)) {
        asm volatile(LOCK_PREFIX "andb %1,%0"
            : CONST_MASK_ADDR(nr, addr)
            : "iq" ((u8)~CONST_MASK(nr)));
    } else {
        asm volatile(LOCK_PREFIX "btr %1,%0"
            : BITOP_ADDR(addr)
            : "Ir" (nr));
    }
}

并且正如我们所看到的,它与 set_bit 非常相似,只有两处不同。第一处差异为 clear_bit 使用 btr 指令来清位,而 set_bit 使用 bts 指令来置位。第二处差异为 clear_bit 使用否定的位掩码和 按位与 在给定的字节上置位,而 set_bit 使用 按位或 指令。

到此为止,我们可以在任意位数组置位和清位了,我们将看看位掩码上的其他操作。

在 Linux 内核中对位数组最广泛使用的操作是设置和清除位,但是除了这两个操作外,位数组上其他操作也是非常有用的。Linux 内核里另一种广泛使用的操作是知晓位数组中一个给定的位是否被置位。我们能够通过 test_bit 宏的帮助实现这一功能。这个宏定义于 arch/x86/include/asm/bitops.h 头文件,并根据位号分别展开为 constant_test_bit 或 variable_test_bit 调用。

#define test_bit(nr, addr)          \
    (__builtin_constant_p((nr))                 \
     ? constant_test_bit((nr), (addr))          \
     : variable_test_bit((nr), (addr)))

因此,如果 nr 是编译期已知常量,test_bit 将展开为 constant_test_bit 函数的调用,而其他情况则为 variable_test_bit。现在让我们看看这些函数的实现,让我们从 variable_test_bit 开始看起:

static inline int variable_test_bit(long nr, volatile const unsigned long *addr)
{
    int oldbit;

    asm volatile("bt %2,%1\n\t"
             "sbb %0,%0"
             : "=r" (oldbit)
             : "m" (*(unsigned long *)addr), "Ir" (nr));

    return oldbit;
}

variable_test_bit 函数使用了与 set_bit 及其他函数使用的相似的参数集合。我们也可以看到执行 bt 和 sbb 指令的内联汇编代码。bt (或称 bit test)指令从第二操作数指定的位数组选出第一操作数指定的一个指定位,并且将该位的值存进标志寄存器的 CF 位。第二个指令 sbb 从第二操作数中减去第一操作数,再减去 CF 的值。因此,这里将一个从给定位数组中的给定位号的值写进标志寄存器的 CF 位,并且执行 sbb 指令计算: 00000000 - CF,并将结果写进 oldbit 变量。

constant_test_bit 函数做了和我们在 set_bit 所看到的一样的事:

static __always_inline int constant_test_bit(long nr, const volatile unsigned long *addr)
{
    return ((1UL << (nr & (BITS_PER_LONG-1))) &
        (addr[nr >> _BITOPS_LONG_SHIFT])) != 0;
}

它生成了一个位号对应位为高位 1,而其他位为 0 的字节(正如我们在 CONST_MASK 所看到的),并将 按位与 应用于包含给定位号的字节。

下一个被广泛使用的位数组相关操作是改变一个位数组中的位。为此,Linux 内核提供了两个辅助函数:

  • __change_bit;
  • change_bit.

你可能已经猜测到,就拿 set_bit 和 __set_bit 例子说,这两个变体分别是原子和非原子版本。首先,让我们看看 __change_bit 函数的实现:

static inline void __change_bit(long nr, volatile unsigned long *addr)
{
    asm volatile("btc %1,%0" : ADDR : "Ir" (nr));
}

相当简单,不是吗? __change_bit 的实现和 __set_bit 一样,只是我们使用 btc 替换 bts 指令而已。 该指令从一个给定位数组中选出一个给定位,将该为位的值存进 CF 并使用求反操作改变它的值,因此值为 1 的位将变为 0,反之亦然:

>>> int(not 1)
0
>>> int(not 0)
1

__change_bit 的原子版本为 change_bit 函数:

static inline void change_bit(long nr, volatile unsigned long *addr)
{
    if (IS_IMMEDIATE(nr)) {
        asm volatile(LOCK_PREFIX "xorb %1,%0"
            : CONST_MASK_ADDR(nr, addr)
            : "iq" ((u8)CONST_MASK(nr)));
    } else {
        asm volatile(LOCK_PREFIX "btc %1,%0"
            : BITOP_ADDR(addr)
            : "Ir" (nr));
    }
}

它和 set_bit 函数很相似,但也存在两点不同。第一处差异为 xor 操作而不是 or。第二处差异为 btc( LCTT 译注:原文为 bts,为作者笔误) 而不是 bts。

目前,我们了解了最重要的体系特定的位数组操作,是时候看看一般的位图 API 了。

通用位操作

除了 arch/x86/include/asm/bitops.h 中体系特定的 API 外,Linux 内核提供了操作位数组的通用 API。正如我们本部分开头所了解的一样,我们可以在 include/linux/bitmap.h 头文件和 lib/bitmap.c 源文件中找到它。但在查看这些源文件之前,我们先看看 include/linux/bitops.h 头文件,其提供了一系列有用的宏,让我们看看它们当中一部分。

首先我们看看以下 4 个 宏:

  • for_each_set_bit
  • for_each_set_bit_from
  • for_each_clear_bit
  • for_each_clear_bit_from

所有这些宏都提供了遍历位数组中某些位集合的迭代器。第一个宏迭代那些被置位的位。第二个宏也是一样,但它是从某一个确定的位开始。最后两个宏做的一样,但是迭代那些被清位的位。让我们看看 for_each_set_bit 宏:

#define for_each_set_bit(bit, addr, size) \
    for ((bit) = find_first_bit((addr), (size));        \
         (bit) < (size);                    \
         (bit) = find_next_bit((addr), (size), (bit) + 1))

正如我们所看到的,它使用了三个参数,并展开为一个循环,该循环从作为 find_first_bit 函数返回结果的第一个置位开始,到小于给定大小的最后一个置位为止。

除了这四个宏, arch/x86/include/asm/bitops.h 也提供了 64-bit 或 32-bit 变量循环的 API 等等。

下一个 头文件 提供了操作位数组的 API。例如,它提供了以下两个函数:

  • bitmap_zero;
  • bitmap_fill.

它们分别可以清除一个位数组和用 1 填充位数组。让我们看看 bitmap_zero 函数的实现:

static inline void bitmap_zero(unsigned long *dst, unsigned int nbits)
{
    if (small_const_nbits(nbits))
        *dst = 0UL;
    else {
        unsigned int len = BITS_TO_LONGS(nbits) * sizeof(unsigned long);
        memset(dst, 0, len);
    }
}

首先我们可以看到对 nbits 的检查。 small_const_nbits 是一个定义在同一个头文件 的宏:

#define small_const_nbits(nbits) \
    (__builtin_constant_p(nbits) && (nbits) <= BITS_PER_LONG)

正如我们可以看到的,它检查 nbits 是否为编译期已知常量,并且其值不超过 BITS_PER_LONG 或 64。如果位数目没有超过一个 long 变量的位数,我们可以仅仅设置为 0。在其他情况,我们需要计算有多少个需要填充位数组的 long 变量并且使用 memset 进行填充。

bitmap_fill 函数的实现和 biramp_zero 函数很相似,除了我们需要在给定的位数组中填写 0xff 或 0b11111111:

static inline void bitmap_fill(unsigned long *dst, unsigned int nbits)
{
    unsigned int nlongs = BITS_TO_LONGS(nbits);
    if (!small_const_nbits(nbits)) {
        unsigned int len = (nlongs - 1) * sizeof(unsigned long);
        memset(dst, 0xff,  len);
    }
    dst[nlongs - 1] = BITMAP_LAST_WORD_MASK(nbits);
}

除了 bitmap_fill 和 bitmap_zero,include/linux/bitmap.h 头文件也提供了和 bitmap_zero 很相似的 bitmap_copy,只是仅仅使用 memcpy 而不是 memset 这点差异而已。它也提供了位数组的按位操作,像 bitmap_and, bitmap_or, bitamp_xor等等。我们不会探讨这些函数的实现了,因为如果你理解了本部分的所有内容,这些函数的实现是很容易理解的。无论如何,如果你对这些函数是如何实现的感兴趣,你可以打开并研究 include/linux/bitmap.h 头文件。

本部分到此为止。

链接


via: https://github.com/0xAX/linux-insides/blob/master/DataStructures/bitmap.md

作者:0xAX 译者:cposture 校对:wxy

本文由 LCTT 原创翻译,Linux中国 荣誉推出

"相较于其它方式,我一直热衷于推崇围绕数据设计代码,我想这也是Git能够如此成功的一大原因[…]在我看来,区别程序员优劣的一大标准就在于他是否认为自己设计的代码还是数据结构更为重要。"

-- Linus Torvalds


"优秀的数据结构与简陋的代码组合远比反之的组合更好。"

-- Eric S. Raymond, The Cathedral and The Bazaar

数据结构与算法分析

学习数据结构与算法分析会让您成为一名出色的程序员。

数据结构与算法分析是一种解决问题的思维模式。 在您的个人知识库中,数据结构与算法分析的相关知识储备越多,您将越多具备应对并解决各类繁杂问题的能力。掌握了这种思维模式,您还将有能力针对新问题提出更多以前想不到的漂亮的解决方案。

您将更深入地了解,计算机如何完成各项操作。无论您是否是直接使用给定的算法,它都影响着您作出的各种技术决定。从计算机操作系统的内存分配到RDBMS的内在工作机制,以及网络协议如何实现将数据从地球的一个角落发送至另一个角落,这些大大小小的工作的完成,都离不开基础的数据结构与算法,理解并掌握它将会让您更了解计算机的运作机理。

对算法广泛深入的学习能为您储备解决方案来应对大体系的问题。之前建模困难时遇到的问题如今通常都能融合进经典的数据结构中得到很好地解决。即使是最基础的数据结构,只要对它进行足够深入的钻研,您将会发现在每天的编程任务中都能经常用到这些知识。

有了这种思维模式,在遇到磨棱两可的问题时,您将能够想出新奇的解决方案。即使最初并没有打算用数据结构与算法解决相应问题的情况,当真正用它们解决这些问题时您会发现它们将非常有用。要意识到这一点,您至少要对数据结构与算法分析的基础知识有深入直观的认识。

理论认识就讲到这里,让我们一起看看下面几个例子。

最短路径问题

我们想要开发一个软件来计算从一个国际机场出发到另一个国际机场的最短距离。假设我们受限于以下路线:

Dijkstra 算法

从这张画出机场各自之间的距离以及目的地的图中,我们如何才能找到最短距离,比方说从赫尔辛基到伦敦?Dijkstra算法是能让我们在最短的时间得到正确答案的适用算法。

在所有可能的解法中,如果您曾经遇到过这类问题,知道可以用Dijkstra算法求解,您大可不必从零开始实现它,只需知道该算法的代码库能帮助您解决相关的实现问题。

如果你深入到该算法的实现中,您将深入理解一项著名的重要图论算法。您会发现实际上该算法比较消耗资源,因此名为A*的扩展经常用于代替该算法。这个算法应用广泛,从机器人寻路的功能实现到TCP数据包路由,以及GPS寻径问题都能应用到这个算法。

先后排序问题

您想要在 开放式在线课程 ( MOOC,Massive Open Online Courses ) 平台上(如Udemy或Khan学院)学习某课程,有些课程之间彼此依赖。例如,用户学习 牛顿力学 ( Newtonian Mechanics ) 课程前必须先修 微积分 ( Calculus ) 课程,课程之间可以有多种依赖关系。用YAML表述举例如下:

# Mapping from course name to requirements
#
# If you're a physcist or a mathematicisn and you're reading this, sincere
# apologies for the completely made-up dependency tree :)
courses:
  arithmetic:         []
  algebra:            [arithmetic]
  trigonometry:       [algebra]
  calculus:           [algebra, trigonometry]
  geometry:           [algebra]
  mechanics:          [calculus, trigonometry]
  atomic_physics:     [mechanics, calculus]
  electromagnetism:   [calculus, atomic_physics]
  radioactivity:      [algebra, atomic_physics]
  astrophysics:       [radioactivity, calculus]
  quantumn_mechanics: [atomic_physics, radioactivity, calculus]

鉴于以上这些依赖关系,作为一名用户,我希望系统能帮我列出必修课列表,让我在之后可以选择任意一门课程学习。如果我选择了微积分(calculus)课程,我希望系统能返回以下列表:

arithmetic -> algebra -> trigonometry -> calculus

这里有两个潜在的重要约束条件:

  • 返回的必修课列表中,每门课都与下一门课存在依赖关系
  • 我们不希望列表中有任何重复课程

这是解决数据间依赖关系的例子,解决该问题的排序算法称作 拓扑排序算法 ( tsort,topological sort ) 。它适用于解决上述我们用YAML列出的依赖关系图的情况,以下是在图中显示的相关结果(其中箭头代表需要先修的课程):

拓扑排序算法

拓扑排序算法的实现就是从如上所示的图中找到满足各层次要求的依赖关系。因此如果我们只列出包含radioactivity和与它有依赖关系的子图,运行tsort排序,会得到如下的顺序表:

arithmetic
algebra
trigonometry
calculus
mechanics
atomic_physics
radioactivity

这符合我们上面描述的需求,用户只需选出radioactivity,就能得到在此之前所有必修课程的有序列表。

在运用该排序算法之前,我们甚至不需要深入了解算法的实现细节。一般来说,你可能选择的各种编程语言在其标准库中都会有相应的算法实现。即使最坏的情况,Unix也会默认安装tsort程序,运行man tsort 来了解该程序。

其它拓扑排序适用场合

  • 类似make的工具 可以让您声明任务之间的依赖关系,这里拓扑排序算法将从底层实现具有依赖关系的任务顺序执行的功能。
  • 具有require指令的编程语言适用于要运行当前文件需先运行另一个文件的情况。这里拓扑排序用于识别文件运行顺序以保证每个文件只加载一次,且满足所有文件间的依赖关系要求。
  • 带有甘特图的项目管理工具。甘特图能直观列出给定任务的所有依赖关系,在这些依赖关系之上能提供给用户任务完成的预估时间。我不常用到甘特图,但这些绘制甘特图的工具很可能会用到拓扑排序算法。

霍夫曼编码实现数据压缩

霍夫曼编码 ( Huffman coding ) 是一种用于无损数据压缩的编码算法。它的工作原理是先分析要压缩的数据,再为每个字符创建一个二进制编码。字符出现的越频繁,编码赋值越小。因此在一个数据集中e可能会编码为111,而x会编码为10010。创建了这种编码模式,就可以串联无定界符,也能正确地进行解码。

在gzip中使用的DEFLATE算法就结合了霍夫曼编码与LZ77一同用于实现数据压缩功能。gzip应用领域很广,特别适用于文件压缩(以.gz为扩展名的文件)以及用于数据传输中的http请求与应答。

学会实现并使用霍夫曼编码有如下益处:

  • 您会理解为什么较大的压缩文件会获得较好的整体压缩效果(如压缩的越多,压缩率也越高)。这也是SPDY协议得以推崇的原因之一:在复杂的HTTP请求/响应过程数据有更好的压缩效果。
  • 您会了解数据传输过程中如果想要压缩JavaScript/CSS文件,运行压缩软件是完全没有意义的。PNG文件也是类似,因为它们已经使用DEFLATE算法完成了压缩。
  • 如果您试图强行破译加密的信息,您可能会发现由于重复数据压缩质量更好,密文给定位的数据压缩率将帮助您确定相关的 分组密码工作模式 ( block cipher mode of operation ) 。

下一步选择学习什么是困难的

作为一名程序员应当做好持续学习的准备。为了成为一名web开发人员,您需要了解标记语言以及Ruby/Python、正则表达式、SQL、JavaScript等高级编程语言,还需要了解HTTP的工作原理,如何运行UNIX终端以及面向对象的编程艺术。您很难有效地预览到未来的职业全景,因此选择下一步要学习哪些知识是困难的。

我没有快速学习的能力,因此我不得不在时间花费上非常谨慎。我希望尽可能地学习到有持久生命力的技能,即不会在几年内就过时的技术。这意味着我也会犹豫这周是要学习JavaScript框架还是那些新的编程语言。

只要占主导地位的计算模型体系不变,我们如今使用的数据结构与算法在未来也必定会以另外的形式继续适用。您可以放心地将时间投入到深入掌握数据结构与算法知识中,它们将会成为您作为一名程序员的职业生涯中一笔长期巨大的财富。


via: http://www.happybearsoftware.com/how-learning-data-structures-and-algorithms-makes-you-a-better-developer

作者:Happy Bear 译者:icybreaker 校对:Caroline

本文由 LCTT 原创翻译,Linux中国 荣誉推出