分类 软件开发 下的文章

通过学习这些关键的术语和概念来理解 Python 应用监测。

 title=

当我第一次看到术语“ 计数器 counter ”和“ 计量器 gauge ”和使用颜色及标记着“平均数”和“大于 90%”的数字图表时,我的反应之一是逃避。就像我看到它们一样,我并不感兴趣,因为我不理解它们是干什么的或如何去使用。因为我的工作不需要我去注意它们,它们被我完全无视。

这都是在两年以前的事了。随着我的职业发展,我希望去了解更多关于我们的网络应用程序的知识,而那个时候就是我开始去学习 监测指标 metrics 的时候。

我的理解监测的学习之旅共有三个阶段(到目前为止),它们是:

  • 阶段 1:什么?(王顾左右)
  • 阶段 2:没有指标,我们真的是瞎撞。
  • 阶段 3:出现不合理的指标我们该如何做?

我现在处于阶段 2,我将分享到目前为止我学到了些什么。我正在向阶段 3 进发,在本文结束的位置我提供了一些我正在使用的学习资源。

我们开始吧!

需要的软件

在文章中讨论时用到的 demo 都可以在 我的 GitHub 仓库 中找到。你需要安装 docker 和 docker-compose 才能使用它们。

为什么要监测?

关于监测的主要原因是:

  • 理解 正常的 和 不正常的 系统和服务的特征
  • 做容量规划、弹性伸缩
  • 有助于排错
  • 了解软件/硬件改变的效果
  • 测量响应中的系统行为变化
  • 当系统出现意外行为时发出警报

指标和指标类型

从我们的用途来看,一个指标就是在一个给定时间点上的某些数量的 测量 值。博客文章的总点击次数、参与讨论的总人数、在缓存系统中数据没有被找到的次数、你的网站上的已登录用户数 —— 这些都是指标的例子。

它们总体上可以分为三类:

计数器

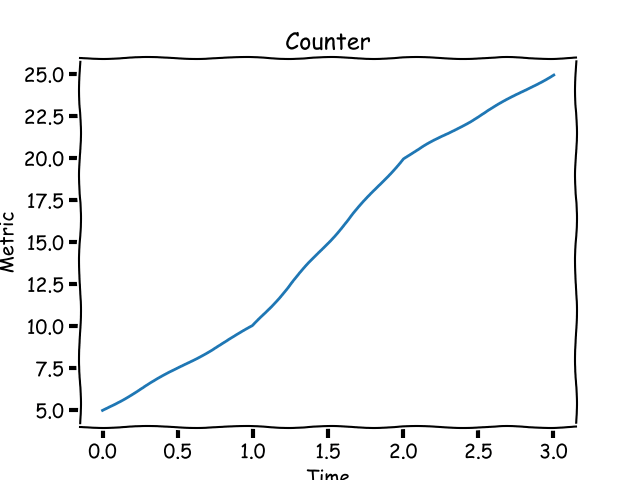
以你的个人博客为例。你发布一篇文章后,过一段时间后,你希望去了解有多少点击量,这是一个只会增加的数字。这就是一个 计数器 counter 指标。在你的博客文章的生命周期中,它的值从 0 开始增加。用图表来表示,一个计数器看起来应该像下面的这样:
 title=

一个计数器指标总是在增加的。

计量器

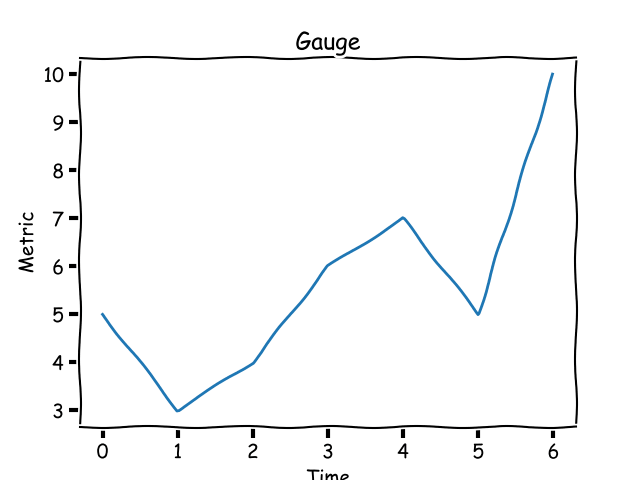
如果你想去跟踪你的博客每天或每周的点击量,而不是基于时间的总点击量。这种指标被称为一个 计量器 gauge ,它的值可上可下。用图表来表示,一个计量器看起来应该像下面的样子:

 title=

一个计量器指标可以增加或减少。

一个计量器的值在某些时间窗口内通常有一个 最大值 ceiling 和<ruby最小值floor。

柱状图和计时器

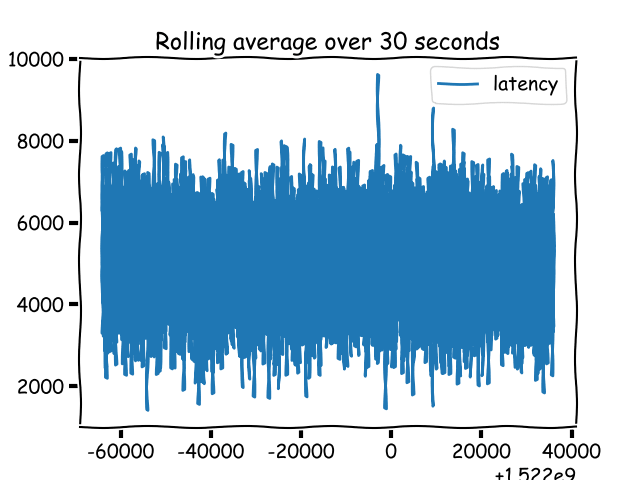
柱状图 histogram (在 Prometheus 中这么叫它)或 计时器 timer (在 StatsD 中这么叫它)是一个跟踪 已采样的观测结果 的指标。不像一个计数器类或计量器类指标,柱状图指标的值并不是显示为上或下的样式。我知道这可能并没有太多的意义,并且可能和一个计量器图看上去没有什么不同。它们的不同之处在于,你期望使用柱状图数据来做什么,而不是与一个计量器图做比较。因此,监测系统需要知道那个指标是一个柱状图类型,它允许你去做哪些事情。
 title=

一个柱状图指标可以增加或减少。

Demo 1:计算和报告指标

Demo 1 是使用 Flask 框架写的一个基本的 web 应用程序。它演示了我们如何去 计算 和 报告 指标。

在 src 目录中有 app.py 和 src/helpers/middleware.py 应用程序,包含以下内容:

from flask import request
import csv
import time


def start_timer():
    request.start_time = time.time()


def stop_timer(response):
    # convert this into milliseconds for statsd
    resp_time = (time.time() - request.start_time)*1000
    with open('metrics.csv', 'a', newline='') as f:
        csvwriter = csv.writer(f)
        csvwriter.writerow([str(int(time.time())), str(resp_time)])

    return response


def setup_metrics(app):
    app.before_request(start_timer)
    app.after_request(stop_timer)

当在应用程序中调用 setup_metrics() 时,它配置在一个请求被处理之前调用 start_timer() 函数,然后在该请求处理之后、响应发送之前调用 stop_timer() 函数。在上面的函数中,我们写了时间戳并用它来计算处理请求所花费的时间。

当我们在 demo1 目录中运行 docker-compose up,它会启动这个 web 应用程序,然后在一个客户端容器中可以生成一些对 web 应用程序的请求。你将会看到创建了一个 src/metrics.csv 文件,它有两个字段:timestamp 和 request_latency。

通过查看这个文件,我们可以推断出两件事情:

  • 生成了很多数据
  • 没有观测到任何与指标相关的特征

没有观测到与指标相关的特征,我们就不能说这个指标与哪个 HTTP 端点有关联,或这个指标是由哪个应用程序的节点所生成的。因此,我们需要使用合适的元数据去限定每个观测指标。

《Statistics 101》

(LCTT 译注:这是一本统计学入门教材的名字)

假如我们回到高中数学,我们应该回忆起一些统计术语,虽然不太确定,但应该包括平均数、中位数、百分位和柱状图。我们来简要地回顾一下它们,不用去管它们的用法,就像是在上高中一样。

平均数

平均数 mean ,即一系列数字的平均值,是将数字汇总然后除以列表的个数。3、2 和 10 的平均数是 (3+2+10)/3 = 5。

中位数

中位数 median 是另一种类型的平均,但它的计算方式不同;它是列表从小到大排序(反之亦然)后取列表的中间数字。以我们上面的列表中(2、3、10),中位数是 3。计算并不是非常直观,它取决于列表中数字的个数。

百分位

百分位 percentile 是指那个百(千)分比数字低于我们给定的百分数的程度。在一些场景中,它是指这个测量值低于我们数据的百(千)分比数字的程度。比如,上面列表中 95% 是 9.29999。百分位的测量范围是 0 到 100(不包括)。0% 是一组数字的最小分数。你可能会想到它的中位数是 50%,它的结果是 3。

一些监测系统将百分位称为 upper_X,其中 X 就是百分位;upper 90 指的是在 90% 的位置的值。

分位数

“q-分位数”是将有 N 个数的集合等分为 qN 级。q 的取值范围为 0 到 1(全部都包括)。当 q 取值为 0.5 时,值就是中位数。( 分位数 quantile )和百分位数的关系是,分位数值 q 等于 100 百分位值。

柱状图

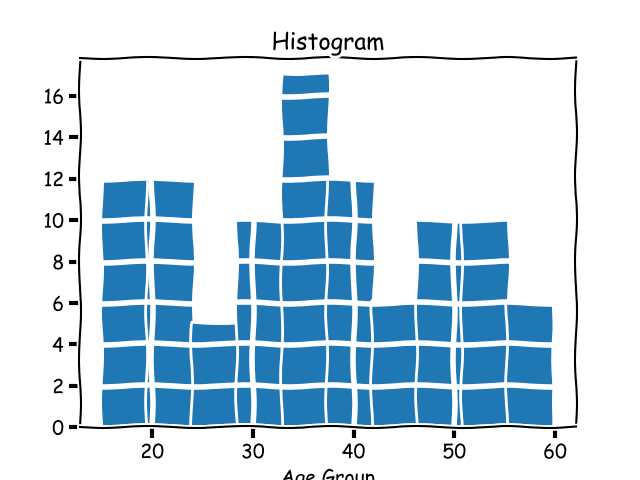
<ruby柱状图histogram这个指标,我们前面学习过,它是监测系统中一个实现细节。在统计学中,一个柱状图是一个将数据分组为 桶 的图表。我们来考虑一个人为的不同示例:阅读你的博客的人的年龄。如果你有一些这样的数据,并想将它进行大致的分组,绘制成的柱状图将看起来像下面的这样:
 title=

累积柱状图

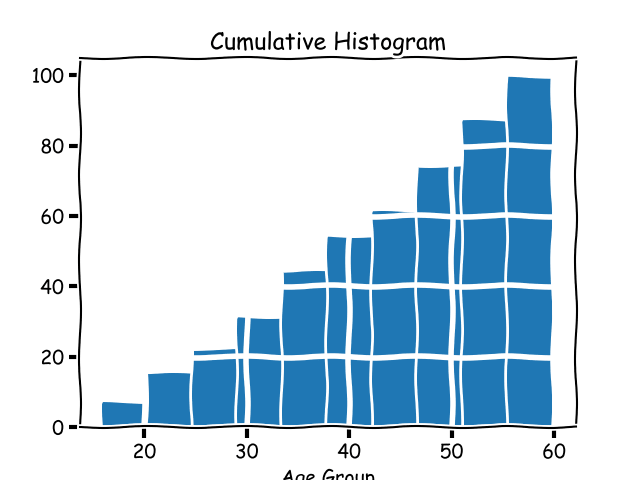
一个 累积柱状图 cumulative histogram 也是一个柱状图,它的每个桶的数包含前一个桶的数,因此命名为累积。将上面的数据集做成累积柱状图后,看起来应该是这样的:
 title=

我们为什么需要做统计?

在上面的 Demo 1 中,我们注意到在我们报告指标时,这里生成了许多数据。当我们将它们用于指标时我们需要做统计,因为它们实在是太多了。我们需要的是整体行为,我们没法去处理单个值。我们预期展现出来的值的行为应该是代表我们观察的系统的行为。

Demo 2:在指标上增加特征

在我们上面的的 Demo 1 应用程序中,当我们计算和报告一个请求的延迟时,它指向了一个由一些特征 唯一标识的特定请求。下面是其中一些:

  • HTTP 端点
  • HTTP 方法
  • 运行它的主机/节点的标识符

如果我们将这些特征附加到要观察的指标上,每个指标将有更多的内容。我们来解释一下 Demo 2 中添加到我们的指标上的特征。

在写入指标时,src/helpers/middleware.py 文件将在 CSV 文件中写入多个列:

node_ids = ['10.0.1.1', '10.1.3.4']


def start_timer():
    request.start_time = time.time()


def stop_timer(response):
    # convert this into milliseconds for statsd
    resp_time = (time.time() - request.start_time)*1000
    node_id = node_ids[random.choice(range(len(node_ids)))]
    with open('metrics.csv', 'a', newline='') as f:
        csvwriter = csv.writer(f)
        csvwriter.writerow([
            str(int(time.time())), 'webapp1', node_id,
            request.endpoint, request.method, str(response.status_code),
            str(resp_time)
        ])

    return response

因为这只是一个演示,在报告指标时,我们将随意的报告一些随机 IP 作为节点的 ID。当我们在 demo2 目录下运行 docker-compose up 时,我们的结果将是一个有多个列的 CSV 文件。

用 pandas 分析指标

我们将使用 pandas 去分析这个 CSV 文件。运行 docker-compose up 将打印出一个 URL,我们将使用它来打开一个 Jupyter 会话。一旦我们上传 Analysis.ipynb notebook 到会话中,我们就可以将 CSV 文件读入到一个 pandas 数据帧 DataFrame 中:

import pandas as pd
metrics = pd.read_csv('/data/metrics.csv', index_col=0)

index_col 表明我们要指定时间戳作为索引。

因为每个特征我们都要在数据帧中添加一个列,因此我们可以基于这些列进行分组和聚合:

import numpy as np
metrics.groupby(['node_id', 'http_status']).latency.aggregate(np.percentile, 99.999)

更多内容请参考 Jupyter notebook 在数据上的分析示例。

我应该监测什么?

一个软件系统有许多的变量,这些变量的值在它的生命周期中不停地发生变化。软件是运行在某种操作系统上的,而操作系统同时也在不停地变化。在我看来,当某些东西出错时,你所拥有的数据越多越好。

我建议去监测的关键操作系统指标有:

  • CPU 使用
  • 系统内存使用
  • 文件描述符使用
  • 磁盘使用

还需要监测的其它关键指标根据你的软件应用程序不同而不同。

网络应用程序

如果你的软件是一个监听客户端请求和为它提供服务的网络应用程序,需要测量的关键指标还有:

  • 入站请求数(计数器)
  • 未处理的错误(计数器)
  • 请求延迟(柱状图/计时器)
  • 排队时间,如果在你的应用程序中有队列(柱状图/计时器)
  • 队列大小,如果在你的应用程序中有队列(计量器)
  • 工作进程/线程用量(计量器)

如果你的网络应用程序在一个客户端请求的环境中向其它服务发送请求,那么它应该有一个指标去记录它与那个服务之间的通讯行为。需要监测的关键指标包括请求数、请求延迟、和响应状态。

HTTP web 应用程序后端

HTTP 应用程序应该监测上面所列出的全部指标。除此之外,还应该按 HTTP 状态代码分组监测所有非 200 的 HTTP 状态代码的大致数据。如果你的 web 应用程序有用户注册和登录功能,同时也应该为这个功能设置指标。

长时间运行的进程

长时间运行的进程如 Rabbit MQ 消费者或任务队列的工作进程,虽然它们不是网络服务,它们以选取一个任务并处理它的工作模型来运行。因此,我们应该监测请求的进程数和这些进程的请求延迟。

不管是什么类型的应用程序,都有指标与合适的元数据相关联。

将监测集成到一个 Python 应用程序中

将监测集成到 Python 应用程序中需要涉及到两个组件:

  • 更新你的应用程序去计算和报告指标
  • 配置一个监测基础设施来容纳应用程序的指标,并允许去查询它们

下面是记录和报告指标的基本思路:

def work():
    requests += 1
    # report counter
    start_time = time.time()
    
    # < do the work >

    # calculate and report latency
    work_latency = time.time() - start_time
    ...

考虑到上面的模式,我们经常使用修饰符、内容管理器、中间件(对于网络应用程序)所带来的好处去计算和报告指标。在 Demo 1 和 Demo 2 中,我们在一个 Flask 应用程序中使用修饰符。

指标报告时的拉取和推送模型

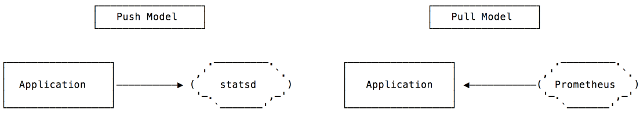
大体来说,在一个 Python 应用程序中报告指标有两种模式。在 拉取 模型中,监测系统在一个预定义的 HTTP 端点上“刮取”应用程序。在推送 模型中,应用程序发送数据到监测系统。
 title=

工作在 拉取 模型中的监测系统的一个例子是 Prometheus。而 StatsD 是 推送 模型的一个例子。

集成 StatsD

将 StatsD 集成到一个 Python 应用程序中,我们将使用 StatsD Python 客户端,然后更新我们的指标报告部分的代码,调用合适的库去推送数据到 StatsD 中。

首先,我们需要去创建一个客户端实例:

statsd = statsd.StatsClient(host='statsd', port=8125, prefix='webapp1')

prefix 关键字参数将为通过这个客户端报告的所有指标添加一个指定的前缀。

一旦我们有了客户端,我们可以使用如下的代码为一个计时器报告值:

statsd.timing(key, resp_time)

增加计数器:

statsd.incr(key)

将指标关联到元数据上,一个键的定义为:metadata1.metadata2.metric,其中每个 metadataX 是一个可以进行聚合和分组的字段。

这个演示应用程序 StatsD 是将 statsd 与 Python Flask 应用程序集成的一个完整示例。

集成 Prometheus

要使用 Prometheus 监测系统,我们使用 Promethius Python 客户端。我们将首先去创建有关的指标类对象:

REQUEST_LATENCY = Histogram('request_latency_seconds', 'Request latency',
    ['app_name', 'endpoint']
)

在上面的语句中的第三个参数是与这个指标相关的标识符。这些标识符是由与单个指标值相关联的元数据定义的。

去记录一个特定的观测指标:

REQUEST_LATENCY.labels('webapp', request.path).observe(resp_time)

下一步是在我们的应用程序中定义一个 Prometheus 能够刮取的 HTTP 端点。这通常是一个被称为 /metrics 的端点:

@app.route('/metrics')
def metrics():
    return Response(prometheus_client.generate_latest(), mimetype=CONTENT_TYPE_LATEST)

这个演示应用程序 Prometheus 是将 prometheus 与 Python Flask 应用程序集成的一个完整示例。

哪个更好:StatsD 还是 Prometheus?

本能地想到的下一个问题便是:我应该使用 StatsD 还是 Prometheus?关于这个主题我写了几篇文章,你可能发现它们对你很有帮助:

指标的使用方式

我们已经学习了一些关于为什么要在我们的应用程序上配置监测的原因,而现在我们来更深入地研究其中的两个用法:报警和自动扩展。

使用指标进行报警

指标的一个关键用途是创建警报。例如,假如过去的五分钟,你的 HTTP 500 的数量持续增加,你可能希望给相关的人发送一封电子邮件或页面提示。对于配置警报做什么取决于我们的监测设置。对于 Prometheus 我们可以使用 Alertmanager,而对于 StatsD,我们使用 Nagios。

使用指标进行自动扩展

在一个云基础设施中,如果我们当前的基础设施供应过量或供应不足,通过指标不仅可以让我们知道,还可以帮我们实现一个自动伸缩的策略。例如,如果在过去的五分钟里,在我们服务器上的工作进程使用率达到 90%,我们可以水平扩展。我们如何去扩展取决于云基础设施。AWS 的自动扩展,缺省情况下,扩展策略是基于系统的 CPU 使用率、网络流量、以及其它因素。然而,让基础设施伸缩的应用程序指标,我们必须发布 自定义的 CloudWatch 指标。

在多服务架构中的应用程序监测

当我们超越一个单应用程序架构时,比如当客户端的请求在响应被发回之前,能够触发调用多个服务,就需要从我们的指标中获取更多的信息。我们需要一个统一的延迟视图指标,这样我们就能够知道响应这个请求时每个服务花费了多少时间。这可以用 分布式跟踪 来实现。

你可以在我的博客文章 《在你的 Python 应用程序中通过 Zipkin 引入分布式跟踪》 中看到在 Python 中进行分布式跟踪的示例。

划重点

总之,你需要记住以下几点:

  • 理解你的监测系统中指标类型的含义
  • 知道监测系统需要的你的数据的测量单位
  • 监测你的应用程序中的大多数关键组件
  • 监测你的应用程序在它的大多数关键阶段的行为

以上要点是假设你不去管理你的监测系统。如果管理你的监测系统是你的工作的一部分,那么你还要考虑更多的问题!

其它资源

以下是我在我的监测学习过程中找到的一些非常有用的资源:

综合的

StatsD/Graphite

Prometheus

避免犯错(即第 3 阶段的学习)

在我们学习监测的基本知识时,时刻注意不要犯错误是很重要的。以下是我偶然发现的一些很有见解的资源:


想学习更多内容,参与到 PyCon Cleveland 2018 上的 Amit Saha 的讨论,Counter, gauge, upper 90—Oh my!

关于作者

Amit Saha — 我是一名对基础设施、监测、和工具感兴趣的软件工程师。我是“用 Python 做数学”的作者和创始人,以及 Fedora Scientific Spin 维护者。

关于我的更多信息


via: https://opensource.com/article/18/4/metrics-monitoring-and-python
作者: Amit Saha 选题者: lujun9972 译者: qhwdw 校对: wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

这些库可以使你更容易构架个人项目。

在 Python/Django 的世界里有这样一个谚语:为语言而来,为社区而留。对绝大多数人来说的确是这样的,但是,还有一件事情使得我们一直停留在 Python 的世界里,不愿离开,那就是我们可以很容易地利用一顿午餐或晚上几个小时的时间,把一个想法快速地实现出来。

这个月,我们来探讨一些我们喜欢用来快速完成 业余项目 side projects 或打发午餐时间的 Python 库。

在数据库中即时保存数据:Dataset

当我们想要在不知道最终数据库表长什么样的情况下,快速收集数据并保存到数据库中的时候,Dataset 库将是我们的最佳选择。Dataset 库有一个简单但功能强大的 API,因此我们可以很容易的把数据保存下来,之后再进行整理。

Dataset 建立在 SQLAlchemy 之上,所以如果需要对它进行扩展,你会感到非常熟悉。使用 Django 内建的 inspectdb 管理命令可以很容易地把底层数据库模型导入 Django 中,这使得和现有数据库一同工作不会出现任何障碍。

从网页抓取数据:Beautiful Soup

Beautiful Soup(一般写作 BS4)库使得从 HTML 网页中提取信息变得非常简单。当我们需要把非结构化或弱结构化的 HTML 转换为结构化数据的时候,就需要使用 Beautiful Soup 。用它来处理 XML 数据也是一个很好的选择,否则 XML 的可读性或许会很差。

和 HTTP 内容打交道:Requests

当需要和 HTTP 内容打交道的时候,Requests 毫无疑问是最好的标准库。当我们想要抓取 HTML 网页或连接 API 的时候,都离不开 Requests 库。同时,它也有很好的文档。

编写命令行工具:Click

当需要写一个简单的 Python 脚本作为命令行工具的时候,Click 是我最喜欢用的库。它的 API 非常直观,并且在实现时经过了深思熟虑,我们只需要记住很少的几个模式。它的文档也很优秀,这使得学习其高级特性更加容易。

对事物命名:Python Slugify

众所周知,命名是一件困难的事情。Python Slugify 是一个非常有用的库,它可以把一个标题或描述转成一个带有特性的唯一标识符。如果你正在做一个 Web 项目,并且你想要使用对 搜索引擎优化友好 SEO-friendly 的链接,那么,使用 Python Slugify 可以让这件事变得很容易。

和插件打交道:Pluggy

Pluggy 库相对较新,但是如果你想添加一个插件系统到现有应用中,那么使用 Pluggy 是最好也是最简单的方式。如果你使用过 pytest,那么实际上相当于已经使用过 Pluggy 了,虽然你还不知道它。

把 CSV 文件转换到 API 中:DataSette

DataSette 是一个神奇的工具,它可以很容易地把 CSV 文件转换为全特性的只读 REST JSON API,同时,不要把它和 Dataset 库混淆。Datasette 有许多特性,包括创建图表和 geo(用于创建交互式地图),并且很容易通过容器或第三方网络主机进行部署。

处理环境变量等:Envparse

如果你不想在源代码中保存 API 密钥、数据库凭证或其他敏感信息,那么你便需要解析环境变量,这时候 envparse 是最好的选择。Envparse 能够处理环境变量、ENV 文件、变量类型,甚至还可以进行预处理和后处理(例如,你想要确保变量名总是大写或小写的)。

有什么你最喜欢的用于业余项目的 Python 库不在这个列表中吗?请在评论中和我们分享。


via: https://opensource.com/article/18/9/python-libraries-side-projects

作者:Jeff Triplett 选题:lujun9972 译者:ucasFL 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

这篇文章介绍 差异文件 diff 和 补丁文件 patch ,以及它们如何在开源项目中使用的例子。

如果你曾有机会在一个使用分布式开发模型的大型代码库上工作过,你就应该听说过类似下面的话,“Sue 刚发过来一个 补丁 patch ”,“Rajiv 正在 签出 checking out 差异 diff ”, 可能这些词(补丁、差异文件)对你而言很陌生,而你确定很想搞懂他们到底指什么。开源软件对上述提到的名词有很大的贡献,作为大型项目从 Apache web 服务器到 Linux 内核的开发模型,“基于补丁文件的开发” 这一模式贯穿了上述项目的始终。实际上,你可能不知道 Apache 的名字就来自“一系列的代码补丁”(LCTT 译注:Apache 英文发音和补丁的英文 patch 相似),它们被一一收集起来并针对原来的 NCSA HTTPd server source code 进行了修订。

你可能认为这只不过是些逸闻,但是一份早期的 Apache 网站的存档中 声称 Apache 的名字就是来自于最早的“补丁”集合;即“ 打了补丁的 APAtCHy ”服务器,简化为 Apache。

好了,言归正传,程序员嘴里说的“差异”和“补丁”到底是什么?

首先,在这篇文章里,我们可以认为这两个术语都指向同一个概念。“diff” 是 ”difference“ 的简写;Unix 下的同名工具程序 diff剖析了一个或多个文件之间的“差异”。下面我们会看到 diff 的例子:

一个“补丁”指的是文件之间一系列差异,这些差异能被 Unix 的 diff 程序应用在源代码树上。我们能使用 diff 工具来创建“差异”(或“补丁”),然后使用该工具将它们 “打” 在一个没有这个补丁的同样的源代码版本上。此外,(我又要开始跑题说些历史轶事了……),“补丁” 这个词真的指在计算机的早期使用打卡机的时候,用来覆盖在打孔纸带上来对软件进行修改的覆盖纸,那个时代打孔纸带就是在计算机处理器上运行的程序。下面来自 维基页面) 的这张图真切的描绘了最初的“打补丁”这个词的出处:

现在你对补丁和差异就了一个基本的概念,让我们来看看软件开发者是怎么使用这些工具的。如果你还没有使用过类似于 Git 或 subversion 这样的源代码版本控制工具的话,我将会一步步展示最流行的软件项目是怎么使用它们的。如果你将一个软件的生命周期看成是一条时间线的话,你就能看见这个软件的点滴变化,比如在何时源代码加上了一个功能,在何时源代码修复了一个功能缺陷。我们称这些改变的点为“ 提交 commit ”,“提交”这个词被当今最流行的源代码版本管理工具 Git 所使用,当你想检查在一个提交前后的代码变化的话,(或者在许多个提交之间的代码变化),你都可以使用工具来观察文件差异。

如果你同样在使用 Git 开发软件的话,你可以在你的本地开发环境做些希望交给别的开发者的提交,以添加到他们的源代码树中。为了给别的开发者你的提交,一个方法就是创建一个你本地文件的差异文件,然后将这个“补丁”发送给和你工作在同一个源代码树的别的开发者。别的开发者在“打”了你的补丁之后,就能看到在你的代码变树上的变化。

Linux、Git 和 GitHub

这种分享补丁的开发模型正是现今 Linux 内核社区如何处理内核修改提议而采用的模型。如果你有机会浏览任何一个主流的 Linux 内核邮件列表 —— 主要是 LKML,也包括 linux-containers、fs-devel、Netdev 等等,你能看到很多开发者会贴出他们想让其他内核开发者审核、测试或者合入 Linux 官方 Git 代码树某个位置的补丁。当然,讨论 Git 不在这篇文章范围之内(Git 是由 Linus Torvalds 开发的源代码控制系统,它支持分布式开发模型以及允许独立于主要代码仓库的补丁包,这些补丁包能被推送或拉取到不同的源代码树上,并遵守这些代码树各自的开发流程。)

在继续我们的话题之前,我们当然不能忽略和补丁和差异这个概念相关的最流行的服务:GitHub。从它的名字就能猜想出 GitHub 是基于 Git 的,而且它还围绕着 Git 对分布式开源代码开发模型提供了基于 Web 和 API 的工作流管理。(LCTT 译注:即 拉取请求 Pull Request )。在 GitHub 上,分享补丁的方式不是像 Linux 内核社区那样通过邮件列表,而是通过创建一个 拉取请求 。当你提交你自己的源代码树的改动时,你能通过创建一个针对软件项目的共享仓库的“拉取请求”来分享你的代码改动(LCTT 译注:即核心开发者维护一个主仓库,开发者去“ 复刻 fork ”这个仓库,待各自的提交后再创建针对这个主仓库的拉取请求,所有的拉取请求由主仓库的核心开发者批准后才能合入主代码库。)GitHub 被当今很多活跃的开源社区所采用,如 Kubernetes、Docker、容器网络接口 (CNI)、Istio 等等。在 GitHub 的世界里,用户会倾向于使用基于 Web 页面的方式来审核一个拉取请求里的补丁或差异,你也可以直接访问原始的补丁并在命令行上直接使用它们。

该说点干货了

我们前面已经讲了在流行的开源社区里是怎么应用补丁和差异的,现在看看一些例子。

第一个例子包括一个源代码树的两个不同副本,其中一个有代码改动,我们想用 diff 来看看这些改动是什么。这个例子里,我们想看的是“ 合并格式 unified ”的补丁,这是现在软件开发世界里最通用的格式。如果想知道更详细参数的用法以及如何生成差异文件,请参考 diff 手册。原始的代码在 sources-orig 目录,而改动后的代码在 sources-fixed 目录。如果要在你的命令行上用“合并格式”来展示补丁,请运行如下命令。(LCTT 译注:参数 -N 代表如果比较的文件不存在,则认为是个空文件, -a 代表将所有文件都作为文本文件对待,-u 代表使用合并格式并输出上下文,-r 代表递归比较目录)

$ diff -Naur sources-orig/ sources-fixed/

……下面是 diff 命令的输出:

diff -Naur sources-orig/officespace/interest.go sources-fixed/officespace/interest.go
--- sources-orig/officespace/interest.go        2018-08-10 16:39:11.000000000 -0400
+++ sources-fixed/officespace/interest.go       2018-08-10 16:39:40.000000000 -0400
@@ -11,15 +11,13 @@
   InterestRate float64
 }

+// compute the rounded interest for a transaction
 func computeInterest(acct *Account, t Transaction) float64 {

   interest := t.Amount * t.InterestRate
   roundedInterest := math.Floor(interest*100) / 100.0
   remainingInterest := interest - roundedInterest

-  // a little extra..
-  remainingInterest *= 1000
-
   // Save the remaining interest into an account we control:
   acct.Balance = acct.Balance + remainingInterest

最开始几行 diff 命令的输出可以这样解释:三个 --- 显示了原来文件的名字;任何在原文件(LCTT 译注:不是源文件)里存在而在新文件里不存在的行将会用前缀 -,用来表示这些行被从源代码里“减去”了。而 +++ 表示的则相反:在新文件里被加上的行会被放上前缀 +,表示这是在新文件里被“加上”的行。补丁文件中的每一个补丁“块”(用 @@ 作为前缀的的部分)都有上下文的行号,这能帮助补丁工具(或其它处理器)知道在代码的哪里应用这个补丁块。你能看到我们已经修改了“Office Space”这部电影里提到的那个函数(移除了三行并加上了一行代码注释),电影里那个有点贪心的工程师可是偷偷的在计算利息的函数里加了点“料”哦。(LCTT译注:剧情详情请见电影 https://movie.douban.com/subject/1296424/)

如果你想找人来测试你的代码改动,你可以将差异保存到一个补丁里:

$ diff -Naur sources-orig/ sources-fixed/ >myfixes.patch

现在你有补丁 myfixes.patch 了,你能把它分享给别的开发者,他们可以将这个补丁打在他们自己的源代码树上从而得到和你一样的代码并测试他们。如果一个开发者的当前工作目录就是他的源代码树的根的话,他可以用下面的命令来打补丁:

$ patch -p1 < ../myfixes.patch
patching file officespace/interest.go

现在这个开发者的源代码树已经打好补丁并准备好构建和测试文件的修改了。那么如果这个开发者在打补丁之前已经改动过了怎么办?只要这些改动没有直接冲突(LCTT 译注:比如改在同一行上),补丁工具就能自动的合并代码的改动。例如下面的interest.go 文件,它有其它几处改动,然后它想打上 myfixes.patch 这个补丁:

$ patch -p1 < ../myfixes.patch
patching file officespace/interest.go
Hunk #1 succeeded at 26 (offset 15 lines).

在这个例子中,补丁警告说代码改动并不在文件原来的地方而是偏移了 15 行。如果你文件改动的很厉害,补丁可能干脆说找不到要应用的地方,还好补丁程序提供了提供了打开“模糊”匹配的选项(这个选项在文档里有预置的警告信息,对其讲解已经超出了本文的范围)。

如果你使用 Git 或者 GitHub 的话,你可能不会直接使用补丁或差异。Git 已经内置了这些功能,你能使用这些功能和共享一个源代码树的其他开发者交互,拉取或合并代码。Git 一个比较相近的功能是可以使用 git diff 来对你的本地代码树生成全局差异,又或者对你的任意两次”引用“(可能是一个代表提交的数字,或一个标记或分支的名字,等等)做全局补丁。你甚至能简单的用管道将 git diff 的输出到一个文件里(这个文件必须严格符合将要被使用它的程序的输入要求),然后将这个文件交给一个并不使用 Git 的开发者应用到他的代码上。当然,GitHub 把这些功能放到了 Web 上,你能直接在 Web 页面上查看一个拉取请求的文件变动。在 Web 上你能看到所展示的合并差异,GitHub 还允许你将这些代码改动下载为原始的补丁文件。

总结

好了,你已经学到了”差异“和”补丁“是什么,以及在 Unix/Linux 上怎么使用命令行工具和它们交互。除非你还在像 Linux 内核开发这样的项目中工作而使用完全基于补丁文件的开发方式,你应该会主要通过你的源代码控制系统(如 Git)来使用补丁。但熟悉像 GitHub 这样的高级别工具的技术背景和技术底层对你的工作也是大有裨益的。谁知道会不会有一天你需要和一个来自 Linux 世界邮件列表的补丁包打交道呢?


via: https://opensource.com/article/18/8/diffs-patches

作者:Phil Estes 选题:lujun9972 译者:David Chen 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

用这个方便的工具来更有效的运行和编译你的程序。

当你需要在一些源文件改变后运行或更新一个任务时,通常会用到 make 工具。make 工具需要读取一个 Makefile(或 makefile)文件,在该文件中定义了一系列需要执行的任务。你可以使用 make 来将源代码编译为可执行程序。大部分开源项目会使用 make 来实现最终的二进制文件的编译,然后使用 make install 命令来执行安装。

本文将通过一些基础和进阶的示例来展示 make 和 Makefile 的使用方法。在开始前,请确保你的系统中安装了 make。

基础示例

依然从打印 “Hello World” 开始。首先创建一个名字为 myproject 的目录,目录下新建 Makefile 文件,文件内容为:

say_hello:
        echo "Hello World"

在 myproject 目录下执行 make,会有如下输出:

$ make
echo "Hello World"
Hello World

在上面的例子中,“say\_hello” 类似于其他编程语言中的函数名。这被称之为 目标 target 。在该目标之后的是预置条件或依赖。为了简单起见,我们在这个示例中没有定义预置条件。echo ‘Hello World' 命令被称为 步骤 recipe 。这些步骤基于预置条件来实现目标。目标、预置条件和步骤共同构成一个规则。

总结一下,一个典型的规则的语法为:

目标: 预置条件
<TAB> 步骤

作为示例,目标可以是一个基于预置条件(源代码)的二进制文件。另一方面,预置条件也可以是依赖其他预置条件的目标。

final_target: sub_target final_target.c
        Recipe_to_create_final_target
        
sub_target: sub_target.c
        Recipe_to_create_sub_target

目标并不要求是一个文件,也可以只是步骤的名字,就如我们的例子中一样。我们称之为“伪目标”。

再回到上面的示例中,当 make 被执行时,整条指令 echo "Hello World" 都被显示出来,之后才是真正的执行结果。如果不希望指令本身被打印处理,需要在 echo 前添加 @。

say_hello:
        @echo "Hello World"

重新运行 make,将会只有如下输出:

$ make
Hello World

接下来在 Makefile 中添加如下伪目标:generate 和 clean:

say_hello:
        @echo "Hello World"

generate:
        @echo "Creating empty text files..."
        touch file-{1..10}.txt

clean:
        @echo "Cleaning up..."
        rm *.txt

随后当我们运行 make 时,只有 say_hello 这个目标被执行。这是因为Makefile 中的第一个目标为默认目标。通常情况下会调用默认目标,这就是你在大多数项目中看到 all 作为第一个目标而出现。all 负责来调用它他的目标。我们可以通过 .DEFAULT_GOAL 这个特殊的伪目标来覆盖掉默认的行为。

在 Makefile 文件开头增加 .DEFAULT_GOAL:

.DEFAULT_GOAL := generate

make 会将 generate 作为默认目标:

$ make
Creating empty text files...
touch file-{1..10}.txt

顾名思义,.DEFAULT_GOAL 伪目标仅能定义一个目标。这就是为什么很多 Makefile 会包括 all 这个目标,这样可以调用多个目标。

下面删除掉 .DEFAULT_GOAL,增加 all 目标:

all: say_hello generate

say_hello:
        @echo "Hello World"

generate:
        @echo "Creating empty text files..."
        touch file-{1..10}.txt

clean:
        @echo "Cleaning up..."
        rm *.txt

运行之前,我们再增加一些特殊的伪目标。.PHONY 用来定义这些不是文件的目标。make 会默认调用这些伪目标下的步骤,而不去检查文件名是否存在或最后修改日期。完整的 Makefile 如下:

.PHONY: all say_hello generate clean

all: say_hello generate

say_hello:
        @echo "Hello World"

generate:
        @echo "Creating empty text files..."
        touch file-{1..10}.txt

clean:
        @echo "Cleaning up..."
        rm *.txt

make 命令会调用 say_hello 和 generate:

$ make
Hello World
Creating empty text files...
touch file-{1..10}.txt

clean 不应该被放入 all 中,或者被放入第一个目标中。clean 应当在需要清理时手动调用,调用方法为 make clean。

$ make clean
Cleaning up...
rm *.txt

现在你应该已经对 Makefile 有了基础的了解,接下来我们看一些进阶的示例。

进阶示例

变量

在之前的实例中,大部分目标和预置条件是已经固定了的,但在实际项目中,它们通常用变量和模式来代替。

定义变量最简单的方式是使用 = 操作符。例如,将命令 gcc 赋值给变量 CC:

CC = gcc

这被称为递归扩展变量,用于如下所示的规则中:

hello: hello.c
    ${CC} hello.c -o hello

你可能已经想到了,这些步骤将会在传递给终端时展开为:

gcc hello.c -o hello

${CC} 和 $(CC) 都能对 gcc 进行引用。但如果一个变量尝试将它本身赋值给自己,将会造成死循环。让我们验证一下:

CC = gcc
CC = ${CC}

all:
    @echo ${CC}

此时运行 make 会导致:

$ make
Makefile:8: *** Recursive variable 'CC' references itself (eventually).  Stop.

为了避免这种情况发生,可以使用 := 操作符(这被称为简单扩展变量)。以下代码不会造成上述问题:

CC := gcc
CC := ${CC}

all:
    @echo ${CC}

模式和函数

下面的 Makefile 使用了变量、模式和函数来实现所有 C 代码的编译。我们来逐行分析下:

# Usage:
# make        # compile all binary
# make clean  # remove ALL binaries and objects

.PHONY = all clean

CC = gcc                        # compiler to use

LINKERFLAG = -lm

SRCS := $(wildcard *.c)
BINS := $(SRCS:%.c=%)

all: ${BINS}

%: %.o
        @echo "Checking.."
        ${CC} ${LINKERFLAG} $< -o $@

%.o: %.c
        @echo "Creating object.."
        ${CC} -c $<

clean:
        @echo "Cleaning up..."
        rm -rvf *.o ${BINS}
  • 以 # 开头的行是评论。
  • .PHONY = all clean 行定义了 all 和 clean 两个伪目标。
  • 变量 LINKERFLAG 定义了在步骤中 gcc 命令需要用到的参数。
  • SRCS := $(wildcard *.c):$(wildcard pattern) 是与文件名相关的一个函数。在本示例中,所有 “.c”后缀的文件会被存入 SRCS 变量。
  • BINS := $(SRCS:%.c=%):这被称为替代引用。本例中,如果 SRCS 的值为 'foo.c bar.c',则 BINS的值为 'foo bar'。
  • all: ${BINS} 行:伪目标 all 调用 ${BINS} 变量中的所有值作为子目标。
  • 规则:
%: %.o
  @echo "Checking.."
  ${CC} ${LINKERFLAG} $&lt; -o $@

下面通过一个示例来理解这条规则。假定 foo 是变量 ${BINS} 中的一个值。% 会匹配到 foo(%匹配任意一个目标)。下面是规则展开后的内容:

foo: foo.o
  @echo "Checking.."
  gcc -lm foo.o -o foo

如上所示,% 被 foo 替换掉了。$< 被 foo.o 替换掉。$<用于匹配预置条件,$@ 匹配目标。对 ${BINS} 中的每个值,这条规则都会被调用一遍。

  • 规则:
%.o: %.c
  @echo "Creating object.."
  ${CC} -c $&lt;

之前规则中的每个预置条件在这条规则中都会都被作为一个目标。下面是展开后的内容:

foo.o: foo.c
  @echo "Creating object.."
  gcc -c foo.c
  • 最后,在 clean 目标中,所有的二进制文件和编译文件将被删除。

下面是重写后的 Makefile,该文件应该被放置在一个有 foo.c 文件的目录下:

# Usage:
# make        # compile all binary
# make clean  # remove ALL binaries and objects

.PHONY = all clean

CC = gcc                        # compiler to use

LINKERFLAG = -lm

SRCS := foo.c
BINS := foo

all: foo

foo: foo.o
        @echo "Checking.."
        gcc -lm foo.o -o foo

foo.o: foo.c
        @echo "Creating object.."
        gcc -c foo.c

clean:
        @echo "Cleaning up..."
        rm -rvf foo.o foo

关于 Makefile 的更多信息,GNU Make 手册提供了更完整的说明和实例。


via: https://opensource.com/article/18/8/what-how-makefile

作者:Sachin Patil 选题:lujun9972 译者:Zafiry 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

Visual Studio Code,简称 VS Code,是一个开源的文本编辑器,包含用于构建和调试应用程序的工具。安装启用 Python 扩展后,VS Code 可以配置成理想的 Python 开发工作环境。本文将介绍一些有用的 VS Code 扩展,并配置它们以充分提高 Python 开发效率。

如果你的计算机上还没有安装 VS Code,可以参考文章 在 Fedora 上使用 VS Code 来安装。

在 VS Code 中安装 Python 扩展

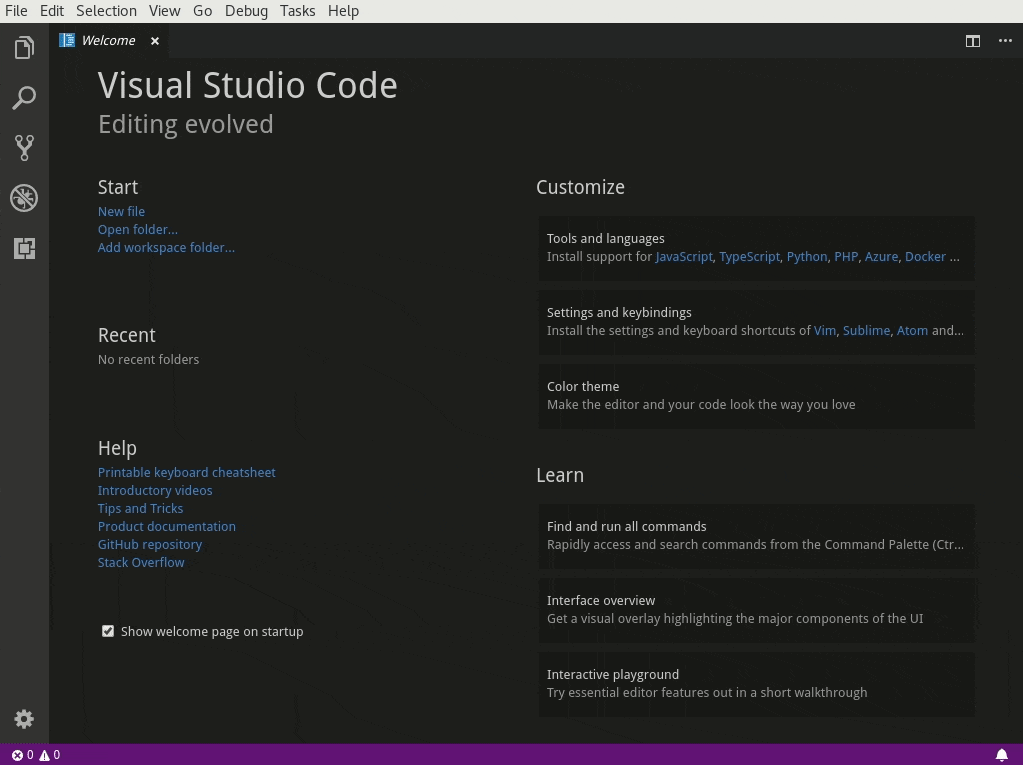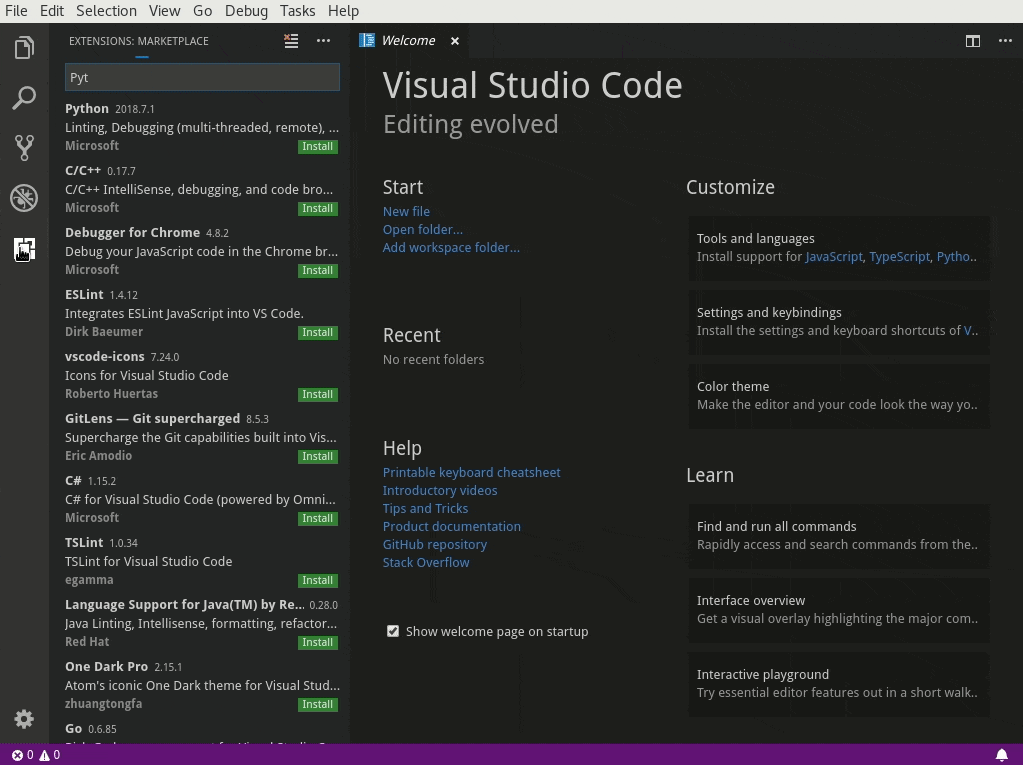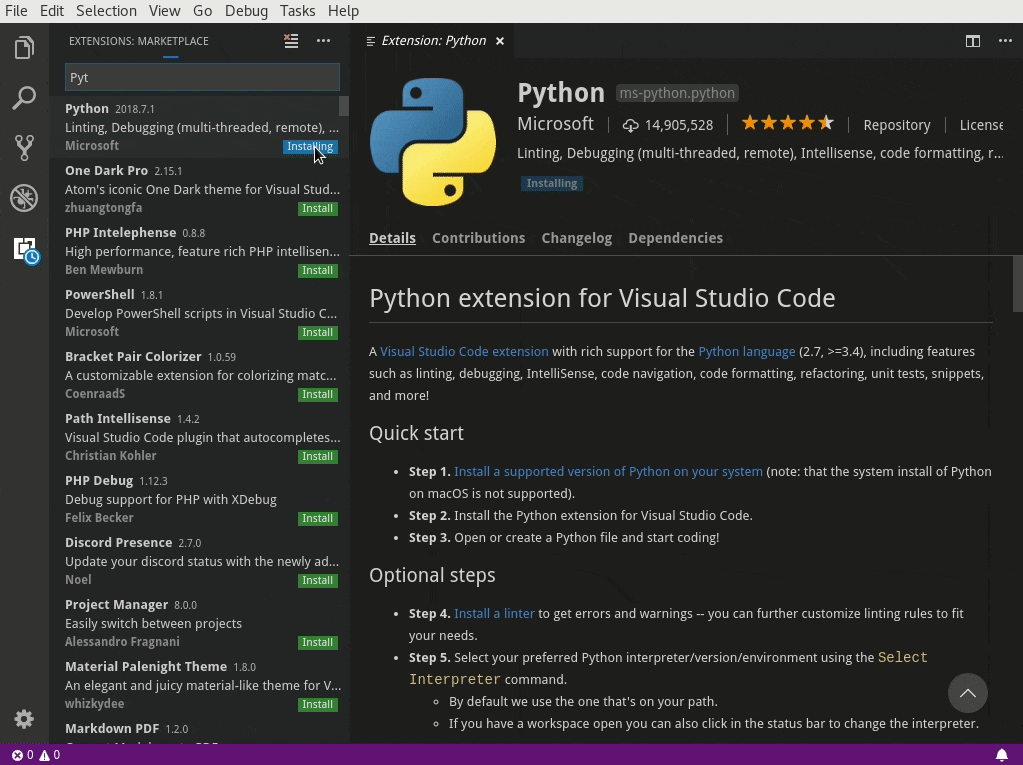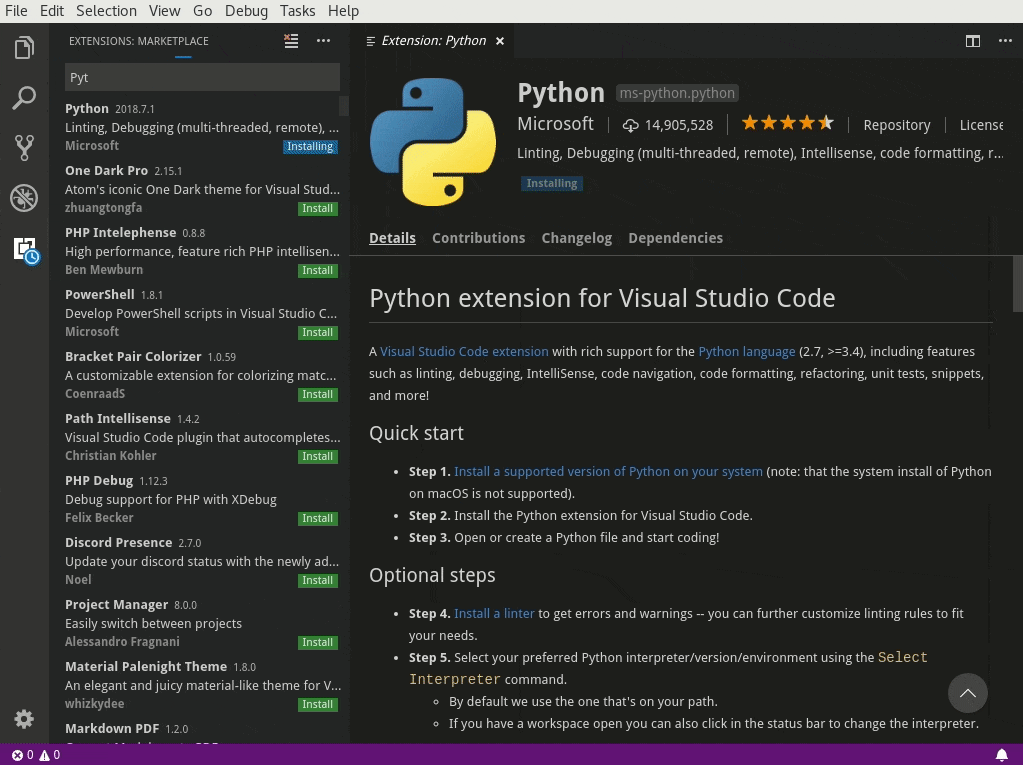
首先,为了更方便地在 VS Code 中进行 Python 开发,需要从 VS Code 扩展商店中安装 Python 扩展。

Python 扩展安装完成后,就可以开始配置 Python 扩展了。

VS Code 通过两个 JSON 文件管理设置:

  • 一个文件用于 VS Code 的全局设置,作用于所有的项目
  • 另一个文件用于特殊设置,作用于单独项目

可以用快捷键 Ctrl+, (逗号)打开全局设置,也可以通过 文件 -> 首选项 -> 设置 来打开。

设置 Python 路径

您可以在全局设置中配置 python.pythonPath 使 VS Code 自动为每个项目选择最适合的 Python 解释器。

// 将设置放在此处以覆盖默认设置和用户设置。
// Path to Python, you can use a custom version of Python by modifying this setting to include the full path.
{
    "python.pythonPath":"${workspaceRoot}/.venv/bin/python",
}

这样,VS Code 将使用虚拟环境目录 .venv 下项目根目录中的 Python 解释器。

使用环境变量

默认情况下,VS Code 使用项目根目录下的 .env 文件中定义的环境变量。 这对于设置环境变量很有用,如:

PYTHONWARNINGS="once"

可使程序在运行时显示警告。

可以通过设置 python.envFile 来加载其他的默认环境变量文件:

// Absolute path to a file containing environment variable definitions.
"python.envFile": "${workspaceFolder}/.env",

代码分析

Python 扩展还支持不同的代码分析工具(pep8、flake8、pylint)。要启用你喜欢的或者正在进行的项目所使用的分析工具,只需要进行一些简单的配置。

扩展默认情况下使用 pylint 进行代码分析。你可以这样配置以使用 flake8 进行分析:

"python.linting.pylintEnabled": false,
"python.linting.flake8Path": "${workspaceRoot}/.venv/bin/flake8",
"python.linting.flake8Enabled": true,
"python.linting.flake8Args": ["--max-line-length=90"],

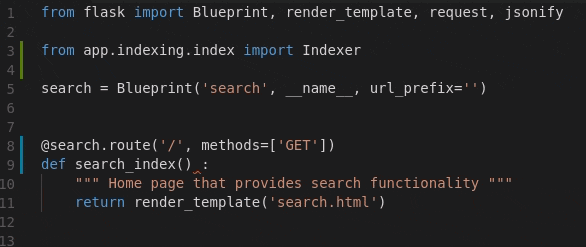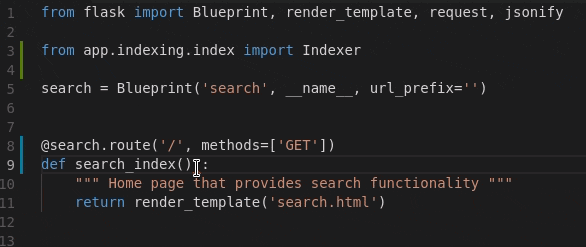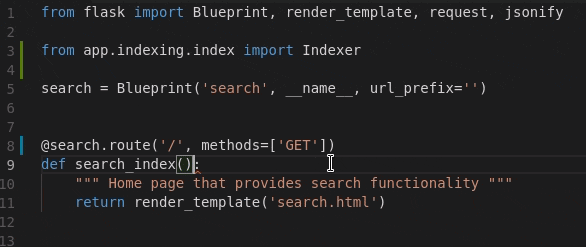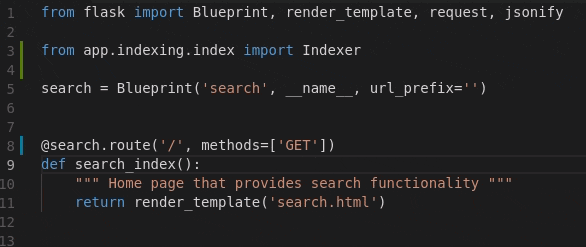
启用代码分析后,分析器会在不符合要求的位置加上波浪线,鼠标置于该位置,将弹窗提示其原因。注意,项目的虚拟环境中需要安装有 flake8,此示例方能有效。

格式化代码

可以配置 VS Code 使其自动格式化代码。目前支持 autopep8、black 和 yapf。下面的设置将启用 “black” 模式。

// Provider for formatting. Possible options include 'autopep8', 'black', and 'yapf'.
"python.formatting.provider": "black",
"python.formatting.blackPath": "${workspaceRoot}/.venv/bin/black"
"python.formatting.blackArgs": ["--line-length=90"],
"editor.formatOnSave": true,

如果不需要编辑器在保存时自动格式化代码,可以将 editor.formatOnSave 设置为 false 并手动使用快捷键 Ctrl + Shift + I 格式化当前文档中的代码。 注意,项目的虚拟环境中需要安装有 black,此示例方能有效。

运行任务

VS Code 的一个重要特点是它可以运行任务。需要运行的任务保存在项目根目录中的 JSON 文件中。

运行 flask 开发服务

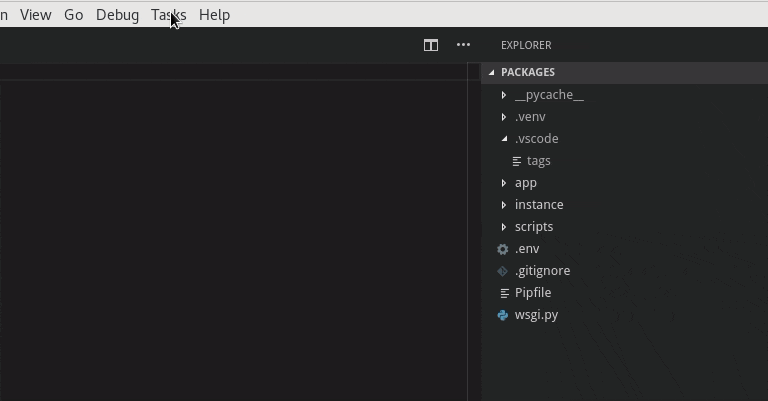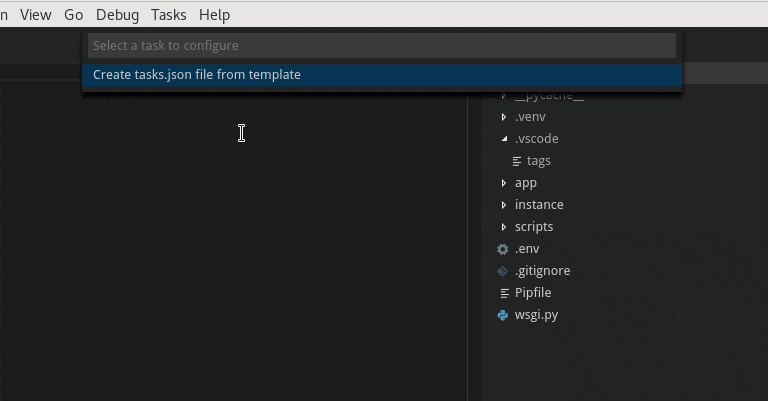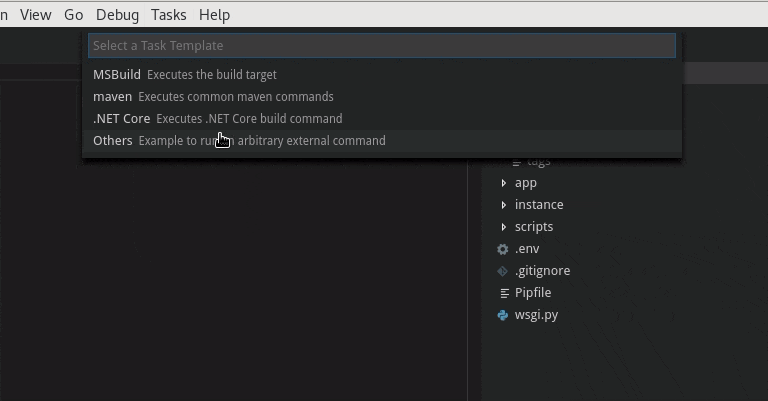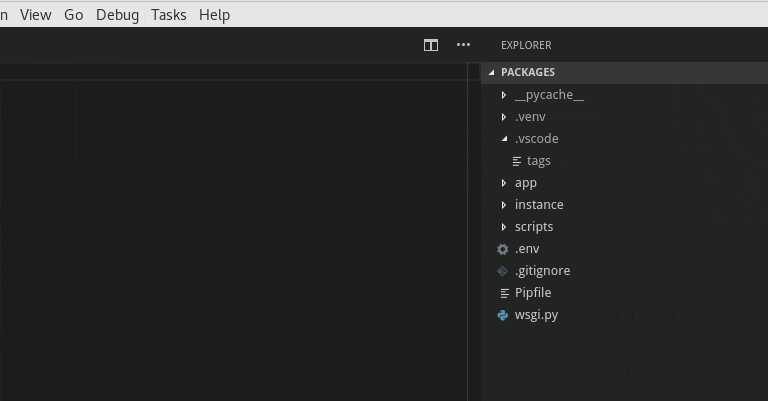
这个例子将创建一个任务来运行 Flask 开发服务器。 使用一个可以运行外部命令的基本模板来创建新的工程:

编辑如下所示的 tasks.json 文件,创建新任务来运行 Flask 开发服务:

{
  // See https://go.microsoft.com/fwlink/?LinkId=733558
  // for the documentation about the tasks.json format
  "version": "2.0.0",
  "tasks": [
    {

      "label": "Run Debug Server",
      "type": "shell",
      "command": "${workspaceRoot}/.venv/bin/flask run -h 0.0.0.0 -p 5000",
      "group": {
          "kind": "build",
          "isDefault": true
       }
    }
  ]
}

Flask 开发服务使用环境变量来获取应用程序的入口点。 如 使用环境变量 一节所说,可以在 .env 文件中声明这些变量:

FLASK_APP=wsgi.py
FLASK_DEBUG=True

这样就可以使用快捷键 Ctrl + Shift + B 来执行任务了。

单元测试

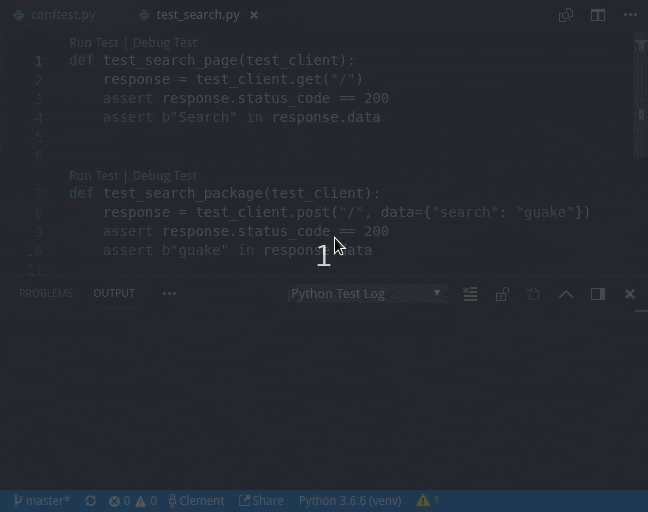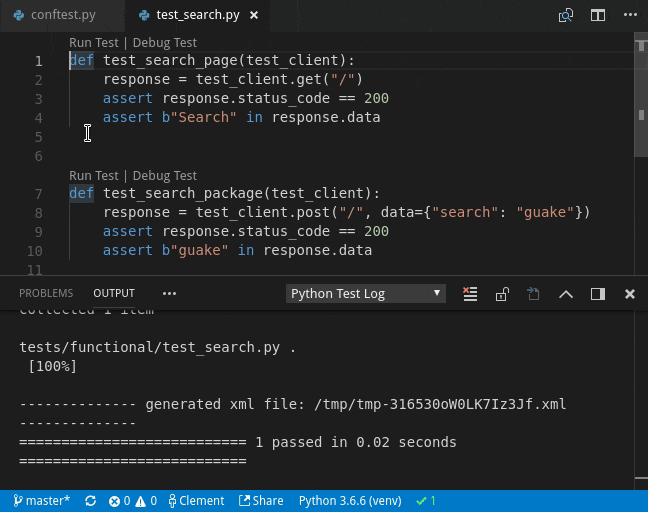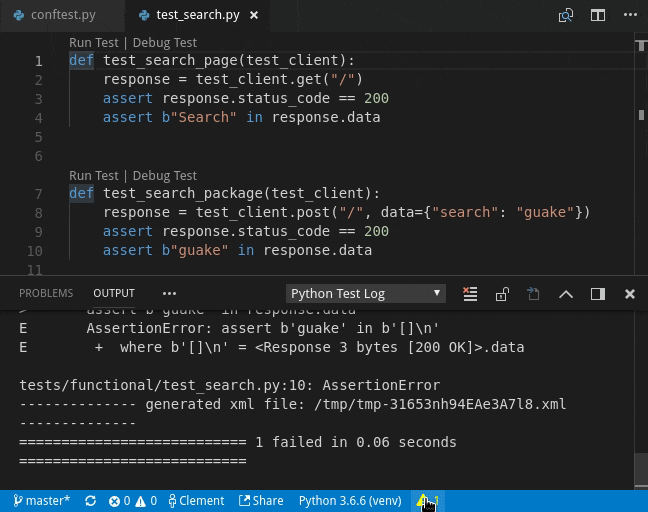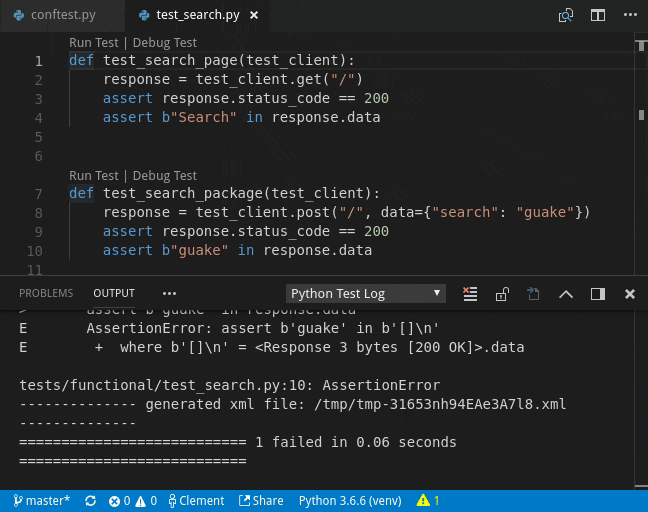
VS Code 还支持单元测试框架 pytest、unittest 和 nosetest。启用测试框架后,可以在 VS Code 中单独运行搜索到的单元测试,通过测试套件运行测试或者运行所有的测试。

例如,可以这样启用 pytest 测试框架:

"python.unitTest.pyTestEnabled": true,
"python.unitTest.pyTestPath": "${workspaceRoot}/.venv/bin/pytest",

注意,项目的虚拟环境中需要安装有 pytest,此示例方能有效。


via: https://fedoramagazine.org/vscode-python-howto/

作者:Clément Verna 选题:lujun9972 译者:idea2act 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

为了在 Python 中快速构建 API,我主要依赖于 Flask。最近我遇到了一个名为 “API Star” 的基于 Python 3 的新 API 框架。由于几个原因,我对它很感兴趣。首先,该框架包含 Python 新特点,如类型提示和 asyncio。而且它再进一步为开发人员提供了很棒的开发体验。我们很快就会讲到这些功能,但在我们开始之前,我首先要感谢 Tom Christie,感谢他为 Django REST Framework 和 API Star 所做的所有工作。

现在说回 API Star —— 我感觉这个框架很有成效。我可以选择基于 asyncio 编写异步代码,或者可以选择传统后端方式就像 WSGI 那样。它配备了一个命令行工具 —— apistar 来帮助我们更快地完成工作。它支持 Django ORM 和 SQLAlchemy,这是可选的。它有一个出色的类型系统,使我们能够定义输入和输出的约束,API Star 可以自动生成 API 的模式(包括文档),提供验证和序列化功能等等。虽然 API Star 专注于构建 API,但你也可以非常轻松地在其上构建 Web 应用程序。在我们自己构建一些东西之前,所有这些可能都没有意义的。

开始

我们将从安装 API Star 开始。为此实验创建一个虚拟环境是一个好主意。如果你不知道如何创建一个虚拟环境,不要担心,继续往下看。

pip install apistar

(译注:上面的命令是在 Python 3 虚拟环境下使用的)

如果你没有使用虚拟环境或者你的 Python 3 的 pip 名为 pip3,那么使用 pip3 install apistar 代替。

一旦我们安装了这个包,我们就应该可以使用 apistar 命令行工具了。我们可以用它创建一个新项目,让我们在当前目录中创建一个新项目。

apistar new .

现在我们应该创建两个文件:app.py,它包含主应用程序,然后是 test.py,它用于测试。让我们来看看 app.py 文件:

from apistar import Include, Route
from apistar.frameworks.wsgi import WSGIApp as App
from apistar.handlers import docs_urls, static_urls

def welcome(name=None):
    if name is None:
        return {'message': 'Welcome to API Star!'}
    return {'message': 'Welcome to API Star, %s!' % name}


routes = [
    Route('/', 'GET', welcome),
    Include('/docs', docs_urls),
    Include('/static', static_urls)
]

app = App(routes=routes)


if __name__ == '__main__':
    app.main()

在我们深入研究代码之前,让我们运行应用程序并查看它是否正常工作。我们在浏览器中输入 http://127.0.0.1:8080/,我们将得到以下响应:

{"message": "Welcome to API Star!"}

如果我们输入:http://127.0.0.1:8080/?name=masnun

{"message": "Welcome to API Star, masnun!"}

同样的,输入 http://127.0.0.1:8080/docs/,我们将看到自动生成的 API 文档。

现在让我们来看看代码。我们有一个 welcome 函数,它接收一个名为 name 的参数,其默认值为 None。API Star 是一个智能的 API 框架。它将尝试在 url 路径或者查询字符串中找到 name 键并将其传递给我们的函数,它还基于其生成 API 文档。这真是太好了,不是吗?

然后,我们创建一个 Route 和 Include 实例的列表,并将列表传递给 App 实例。Route 对象用于定义用户自定义路由。顾名思义,Include 包含了在给定的路径下的其它 url 路径。

路由

路由很简单。当构造 App 实例时,我们需要传递一个列表作为 routes 参数,这个列表应该有我们刚才看到的 Route 或 Include 对象组成。对于 Route,我们传递一个 url 路径,http 方法和可调用的请求处理程序(函数或者其他)。对于 Include 实例,我们传递一个 url 路径和一个 Routes 实例列表。

路径参数

我们可以在花括号内添加一个名称来声明 url 路径参数。例如 /user/{user_id} 定义了一个 url,其中 user_id 是路径参数,或者说是一个将被注入到处理函数(实际上是可调用的)中的变量。这有一个简单的例子:

from apistar import Route
from apistar.frameworks.wsgi import WSGIApp as App


def user_profile(user_id: int):
    return {'message': 'Your profile id is: {}'.format(user_id)}


routes = [
    Route('/user/{user_id}', 'GET', user_profile),
]

app = App(routes=routes)

if __name__ == '__main__':
    app.main()

如果我们访问 http://127.0.0.1:8080/user/23,我们将得到以下响应:

{"message": "Your profile id is: 23"}

但如果我们尝试访问 http://127.0.0.1:8080/user/some_string,它将无法匹配。因为我们定义了 user_profile 函数,且为 user_id 参数添加了一个类型提示。如果它不是整数,则路径不匹配。但是如果我们继续删除类型提示,只使用 user_profile(user_id),它将匹配此 url。这也展示了 API Star 的智能之处和利用类型和好处。

包含/分组路由

有时候将某些 url 组合在一起是有意义的。假设我们有一个处理用户相关功能的 user 模块,将所有与用户相关的 url 分组在 /user 路径下可能会更好。例如 /user/new、/user/1、/user/1/update 等等。我们可以轻松地在单独的模块或包中创建我们的处理程序和路由,然后将它们包含在我们自己的路由中。

让我们创建一个名为 user 的新模块,文件名为 user.py。我们将以下代码放入这个文件:

from apistar import Route


def user_new():
    return {"message": "Create a new user"}


def user_update(user_id: int):
    return {"message": "Update user #{}".format(user_id)}


def user_profile(user_id: int):
    return {"message": "User Profile for: {}".format(user_id)}


user_routes = [
    Route("/new", "GET", user_new),
    Route("/{user_id}/update", "GET", user_update),
    Route("/{user_id}/profile", "GET", user_profile),
]

现在我们可以从 app 主文件中导入 user_routes,并像这样使用它:

from apistar import Include
from apistar.frameworks.wsgi import WSGIApp as App

from user import user_routes

routes = [
    Include("/user", user_routes)
]

app = App(routes=routes)

if __name__ == '__main__':
    app.main()

现在 /user/new 将委托给 user_new 函数。

访问查询字符串/查询参数

查询参数中传递的任何参数都可以直接注入到处理函数中。比如 url /call?phone=1234,处理函数可以定义一个 phone 参数,它将从查询字符串/查询参数中接收值。如果 url 查询字符串不包含 phone 的值,那么它将得到 None。我们还可以为参数设置一个默认值,如下所示:

def welcome(name=None):
    if name is None:
        return {'message': 'Welcome to API Star!'}
    return {'message': 'Welcome to API Star, %s!' % name}

在上面的例子中,我们为 name 设置了一个默认值 None。

注入对象

通过给一个请求程序添加类型提示,我们可以将不同的对象注入到视图中。注入请求相关的对象有助于处理程序直接从内部访问它们。API Star 内置的 http 包中有几个内置对象。我们也可以使用它的类型系统来创建我们自己的自定义对象并将它们注入到我们的函数中。API Star 还根据指定的约束进行数据验证。

让我们定义自己的 User 类型,并将其注入到我们的请求处理程序中:

from apistar import Include, Route
from apistar.frameworks.wsgi import WSGIApp as App
from apistar import typesystem


class User(typesystem.Object):
    properties = {
    'name': typesystem.string(max_length=100),
    'email': typesystem.string(max_length=100),
    'age': typesystem.integer(maximum=100, minimum=18)
    }

    required = ["name", "age", "email"]


def new_user(user: User):
    return user


routes = [
    Route('/', 'POST', new_user),
]

app = App(routes=routes)

if __name__ == '__main__':
    app.main()

现在如果我们发送这样的请求:

curl -X POST \
  http://127.0.0.1:8080/ \
  -H 'Cache-Control: no-cache' \
  -H 'Content-Type: application/json' \
  -d '{"name": "masnun", "email": "[email protected]", "age": 12}'

猜猜发生了什么?我们得到一个错误,说年龄必须等于或大于 18。类型系允许我们进行智能数据验证。如果我们启用了 docs url,我们还将自动记录这些参数。

发送响应

如果你已经注意到,到目前为止,我们只可以传递一个字典,它将被转换为 JSON 并作为默认返回。但是,我们可以使用 apistar 中的 Response 类来设置状态码和其它任意响应头。这有一个简单的例子:

from apistar import Route, Response
from apistar.frameworks.wsgi import WSGIApp as App


def hello():
    return Response(
    content="Hello".encode("utf-8"),
    status=200,
    headers={"X-API-Framework": "API Star"},
    content_type="text/plain"
    )


routes = [
    Route('/', 'GET', hello),
]

app = App(routes=routes)

if __name__ == '__main__':
    app.main()

它应该返回纯文本响应和一个自定义标响应头。请注意,content 应该是字节,而不是字符串。这就是我编码它的原因。

继续

我刚刚介绍了 API Star 的一些特性,API Star 中还有许多非常酷的东西,我建议通过 Github Readme 文件来了解这个优秀框架所提供的不同功能的更多信息。我还将尝试在未来几天内介绍关于 API Star 的更多简短的,集中的教程。


via: http://polyglot.ninja/api-star-python-3-api-framework/

作者:MASNUN 译者:MjSeven 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出