分类 软件开发 下的文章

调试 C 程序,曾让我很困扰。然而当我之前在写我的操作系统时,我有很多的 Bug 需要调试。我很幸运的使用上了 qemu 模拟器,它允许我将调试器附加到我的操作系统。这个调试器就是 gdb。

我得解释一下,你可以使用 gdb 先做一些小事情,因为我发现初学它的时候真的很混乱。我们接下来会在一个小程序中,设置断点,查看内存。

1、 设断点

如果你曾经使用过调试器,那你可能已经会设置断点了。

下面是一个我们要调试的程序(虽然没有任何 Bug):

#include <stdio.h>
void do_thing() {
    printf("Hi!\n");
}
int main() {
    do_thing();
}

另存为 hello.c. 我们可以使用 dbg 调试它,像这样:

bork@kiwi ~> gcc -g hello.c -o hello
bork@kiwi ~> gdb ./hello

以上是带调试信息编译 hello.c(为了 gdb 可以更好工作),并且它会给我们醒目的提示符,就像这样:

(gdb)

我们可以使用 break 命令设置断点,然后使用 run 开始调试程序。

(gdb) break do_thing 
Breakpoint 1 at 0x4004f8
(gdb) run
Starting program: /home/bork/hello 

Breakpoint 1, 0x00000000004004f8 in do_thing ()

程序暂停在了 do_thing 开始的地方。

我们可以通过 where 查看我们所在的调用栈。

(gdb) where
#0  do_thing () at hello.c:3
#1  0x08050cdb in main () at hello.c:6
(gdb) 

2、 阅读汇编代码

使用 disassemble 命令,我们可以看到这个函数的汇编代码。棒级了,这是 x86 汇编代码。虽然我不是很懂它,但是 callq 这一行是 printf 函数调用。

(gdb) disassemble do_thing
Dump of assembler code for function do_thing:
   0x00000000004004f4 <+0>:     push   %rbp
   0x00000000004004f5 <+1>:     mov    %rsp,%rbp
=> 0x00000000004004f8 <+4>:     mov    $0x40060c,%edi
   0x00000000004004fd <+9>:     callq  0x4003f0 
   0x0000000000400502 <+14>:    pop    %rbp
   0x0000000000400503 <+15>:    retq 

你也可以使用 disassemble 的缩写 disas。

3、 查看内存

当调试我的内核时,我使用 gdb 的主要原因是,以确保内存布局是如我所想的那样。检查内存的命令是 examine,或者使用缩写 x。我们将使用x。

通过阅读上面的汇编代码,似乎 0x40060c 可能是我们所要打印的字符串地址。我们来试一下。

(gdb) x/s 0x40060c
0x40060c:        "Hi!"

的确是这样。x/s 中 /s 部分,意思是“把它作为字符串展示”。我也可以“展示 10 个字符”,像这样:

(gdb) x/10c 0x40060c
0x40060c:       72 'H'  105 'i' 33 '!'  0 '\000'        1 '\001'        27 '\033'       3 '\003'        59 ';'
0x400614:       52 '4'  0 '\000'

你可以看到前四个字符是 H、i、! 和 \0,并且它们之后的是一些不相关的东西。

我知道 gdb 很多其他的东西,但是我仍然不是很了解它,其中 x 和 break 让我获得很多。你还可以阅读 do umentation for examining memory。


via: https://jvns.ca/blog/2014/02/10/three-steps-to-learning-gdb/

作者:Julia Evans 译者:Torival 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

大家好!今天我们将去讨论一个调试工具:ftrace,之前我的博客上还没有讨论过它。还有什么能比一个新的调试工具更让人激动呢?

这个非常棒的 ftrace 并不是个新的工具!它大约在 Linux 的 2.6 内核版本中就有了,时间大约是在 2008 年。这一篇是我用谷歌能找到的最早的文档。因此,如果你是一个调试系统的“老手”,可能早就已经使用它了!

我知道,ftrace 已经存在了大约 2.5 年了(LCTT 译注:距本文初次写作时),但是还没有真正的去学习它。假设我明天要召开一个专题研究会,那么,关于 ftrace 应该讨论些什么?因此,今天是时间去讨论一下它了!

什么是 ftrace?

ftrace 是一个 Linux 内核特性,它可以让你去跟踪 Linux 内核的函数调用。为什么要这么做呢?好吧,假设你调试一个奇怪的问题,而你已经得到了你的内核版本中这个问题在源代码中的开始的位置,而你想知道这里到底发生了什么?

每次在调试的时候,我并不会经常去读内核源代码,但是,极个别的情况下会去读它!例如,本周在工作中,我有一个程序在内核中卡死了。查看到底是调用了什么函数,能够帮我更好的理解在内核中发生了什么,哪些系统涉及其中!(在我的那个案例中,它是虚拟内存系统)。

我认为 ftrace 是一个十分好用的工具(它肯定没有 strace 那样使用广泛,也比它难以使用),但是它还是值得你去学习。因此,让我们开始吧!

使用 ftrace 的第一步

不像 strace 和 perf,ftrace 并不是真正的 程序 – 你不能只运行 ftrace my_cool_function。那样太容易了!

如果你去读 使用 ftrace 调试内核,它会告诉你从 cd /sys/kernel/debug/tracing 开始,然后做很多文件系统的操作。

对于我来说,这种办法太麻烦——一个使用 ftrace 的简单例子像是这样:

cd /sys/kernel/debug/tracing
echo function > current_tracer
echo do_page_fault > set_ftrace_filter
cat trace

这个文件系统是跟踪系统的接口(“给这些神奇的文件赋值,然后该发生的事情就会发生”)理论上看起来似乎可用,但是它不是我的首选方式。

幸运的是,ftrace 团队也考虑到这个并不友好的用户界面,因此,它有了一个更易于使用的界面,它就是 trace-cmd!!!trace-cmd 是一个带命令行参数的普通程序。我们后面将使用它!我在 LWN 上找到了一个 trace-cmd 的使用介绍:trace-cmd: Ftrace 的一个前端。

开始使用 trace-cmd:让我们仅跟踪一个函数

首先,我需要去使用 sudo apt-get install trace-cmd 安装 trace-cmd,这一步很容易。

对于第一个 ftrace 的演示,我决定去了解我的内核如何去处理一个页面故障。当 Linux 分配内存时,它经常偷懒,(“你并不是真的计划去使用内存,对吗?”)。这意味着,当一个应用程序尝试去对分配给它的内存进行写入时,就会发生一个页面故障,而这个时候,内核才会真正的为应用程序去分配物理内存。

我们开始使用 trace-cmd 并让它跟踪 do_page_fault 函数!

$ sudo trace-cmd record -p function -l do_page_fault
  plugin 'function'
Hit Ctrl^C to stop recording

我将它运行了几秒钟,然后按下了 Ctrl+C。 让我大吃一惊的是,它竟然产生了一个 2.5MB 大小的名为 trace.dat 的跟踪文件。我们来看一下这个文件的内容!

$ sudo trace-cmd report
          chrome-15144 [000] 11446.466121: function:             do_page_fault
          chrome-15144 [000] 11446.467910: function:             do_page_fault
          chrome-15144 [000] 11446.469174: function:             do_page_fault
          chrome-15144 [000] 11446.474225: function:             do_page_fault
          chrome-15144 [000] 11446.474386: function:             do_page_fault
          chrome-15144 [000] 11446.478768: function:             do_page_fault
 CompositorTileW-15154 [001] 11446.480172: function:             do_page_fault
          chrome-1830  [003] 11446.486696: function:             do_page_fault
 CompositorTileW-15154 [001] 11446.488983: function:             do_page_fault
 CompositorTileW-15154 [001] 11446.489034: function:             do_page_fault
 CompositorTileW-15154 [001] 11446.489045: function:             do_page_fault

看起来很整洁 – 它展示了进程名(chrome)、进程 ID(15144)、CPU ID(000),以及它跟踪的函数。

通过察看整个文件,(sudo trace-cmd report | grep chrome)可以看到,我们跟踪了大约 1.5 秒,在这 1.5 秒的时间段内,Chrome 发生了大约 500 个页面故障。真是太酷了!这就是我们做的第一个 ftrace!

下一个 ftrace 技巧:我们来跟踪一个进程!

好吧,只看一个函数是有点无聊!假如我想知道一个程序中都发生了什么事情。我使用一个名为 Hugo 的静态站点生成器。看看内核为 Hugo 都做了些什么事情?

在我的电脑上 Hugo 的 PID 现在是 25314,因此,我使用如下的命令去记录所有的内核函数:

sudo trace-cmd record --help # I read the help!
sudo trace-cmd record -p function -P 25314 # record for PID 25314

sudo trace-cmd report 输出了 18,000 行。如果你对这些感兴趣,你可以看 这里是所有的 18,000 行的输出。

18,000 行太多了,因此,在这里仅摘录其中几行。

当系统调用 clock_gettime 运行的时候,都发生了什么:

 compat_SyS_clock_gettime
    SyS_clock_gettime
       clockid_to_kclock
       posix_clock_realtime_get
          getnstimeofday64
             __getnstimeofday64
                arch_counter_read
    __compat_put_timespec

这是与进程调试相关的一些东西:

 cpufreq_sched_irq_work
    wake_up_process
       try_to_wake_up
          _raw_spin_lock_irqsave
             do_raw_spin_lock
          _raw_spin_lock
             do_raw_spin_lock
          walt_ktime_clock
             ktime_get
                arch_counter_read
          walt_update_task_ravg
             exiting_task

虽然你可能还不理解它们是做什么的,但是,能够看到所有的这些函数调用也是件很酷的事情。

“function graph” 跟踪

这里有另外一个模式,称为 function_graph。除了它既可以进入也可以退出一个函数外,其它的功能和函数跟踪器是一样的。这里是那个跟踪器的输出

sudo trace-cmd record -p function_graph -P 25314

同样,这里只是一个片断(这次来自 futex 代码):

             |      futex_wake() {
             |        get_futex_key() {
             |          get_user_pages_fast() {
  1.458 us   |            __get_user_pages_fast();
  4.375 us   |          }
             |          __might_sleep() {
  0.292 us   |            ___might_sleep();
  2.333 us   |          }
  0.584 us   |          get_futex_key_refs();
             |          unlock_page() {
  0.291 us   |            page_waitqueue();
  0.583 us   |            __wake_up_bit();
  5.250 us   |          }
  0.583 us   |          put_page();
+ 24.208 us  |        }

我们看到在这个示例中,在 futex_wake 后面调用了 get_futex_key。这是在源代码中真实发生的事情吗?我们可以检查一下!!这里是在 Linux 4.4 中 futex\_wake 的定义 (我的内核版本是 4.4)。

为节省时间我直接贴出来,它的内容如下:

static int
futex_wake(u32 __user *uaddr, unsigned int flags, int nr_wake, u32 bitset)
{
    struct futex_hash_bucket *hb;
    struct futex_q *this, *next;
    union futex_key key = FUTEX_KEY_INIT;
    int ret;
    WAKE_Q(wake_q);

    if (!bitset)
        return -EINVAL;

    ret = get_futex_key(uaddr, flags & FLAGS_SHARED, &key, VERIFY_READ);

如你所见,在 futex_wake 中的第一个函数调用真的是 get_futex_key! 太棒了!相比阅读内核代码,阅读函数跟踪肯定是更容易的找到结果的办法,并且让人高兴的是,还能看到所有的函数用了多长时间。

如何知道哪些函数可以被跟踪

如果你去运行 sudo trace-cmd list -f,你将得到一个你可以跟踪的函数的列表。它很简单但是也很重要。

最后一件事:事件!

现在,我们已经知道了怎么去跟踪内核中的函数,真是太酷了!

还有一类我们可以跟踪的东西!有些事件与我们的函数调用并不相符。例如,你可能想知道当一个程序被调度进入或者离开 CPU 时,都发生了什么事件!你可能想通过“盯着”函数调用计算出来,但是,我告诉你,不可行!

由于函数也为你提供了几种事件,因此,你可以看到当重要的事件发生时,都发生了什么事情。你可以使用 sudo cat /sys/kernel/debug/tracing/available_events 来查看这些事件的一个列表。

我查看了全部的 schedswitch 事件。我并不完全知道 schedswitch 是什么,但是,我猜测它与调度有关。

sudo cat /sys/kernel/debug/tracing/available_events
sudo trace-cmd record -e sched:sched_switch
sudo trace-cmd report

输出如下:

 16169.624862:   Chrome_ChildIOT:24817 [112] S ==> chrome:15144 [120]
 16169.624992:   chrome:15144 [120] S ==> swapper/3:0 [120]
 16169.625202:   swapper/3:0 [120] R ==> Chrome_ChildIOT:24817 [112]
 16169.625251:   Chrome_ChildIOT:24817 [112] R ==> chrome:1561 [112]
 16169.625437:   chrome:1561 [112] S ==> chrome:15144 [120]

现在,可以很清楚地看到这些切换,从 PID 24817 -> 15144 -> kernel -> 24817 -> 1561 -> 15114。(所有的这些事件都发生在同一个 CPU 上)。

ftrace 是如何工作的?

ftrace 是一个动态跟踪系统。当我们开始 ftrace 内核函数时,函数的代码会被改变。让我们假设去跟踪 do_page_fault 函数。内核将在那个函数的汇编代码中插入一些额外的指令,以便每次该函数被调用时去提示跟踪系统。内核之所以能够添加额外的指令的原因是,Linux 将额外的几个 NOP 指令编译进每个函数中,因此,当需要的时候,这里有添加跟踪代码的地方。

这是一个十分复杂的问题,因为,当不需要使用 ftrace 去跟踪我的内核时,它根本就不影响性能。而当我需要跟踪时,跟踪的函数越多,产生的开销就越大。

(或许有些是不对的,但是,我认为的 ftrace 就是这样工作的)

更容易地使用 ftrace:brendan gregg 的工具及 kernelshark

正如我们在文件中所讨论的,你需要去考虑很多的关于单个的内核函数/事件直接使用 ftrace 都做了些什么。能够做到这一点很酷!但是也需要做大量的工作!

Brendan Gregg (我们的 Linux 调试工具“大神”)有个工具仓库,它使用 ftrace 去提供关于像 I/O 延迟这样的各种事情的信息。这是它在 GitHub 上全部的 perf-tools 仓库。

这里有一个权衡,那就是这些工具易于使用,但是你被限制仅能用于 Brendan Gregg 认可并做到工具里面的方面。它包括了很多方面!:)

另一个工具是将 ftrace 的输出可视化,做的比较好的是 kernelshark。我还没有用过它,但是看起来似乎很有用。你可以使用 sudo apt-get install kernelshark 来安装它。

一个新的超能力

我很高兴能够花一些时间去学习 ftrace!对于任何内核工具,不同的内核版本有不同的功效,我希望有一天你能发现它很有用!

ftrace 系列文章的一个索引

最后,这里是我找到的一些 ftrace 方面的文章。它们大部分在 LWN (Linux 新闻周刊)上,它是 Linux 的一个极好的资源(你可以购买一个 订阅!)


via: https://jvns.ca/blog/2017/03/19/getting-started-with-ftrace/

作者:Julia Evans 译者:qhwdw 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出
内存管理是操作系统的核心任务;它对程序员和系统管理员来说也是至关重要的。在接下来的几篇文章中,我将从实践出发着眼于内存管理,并深入到它的内部结构。虽然这些概念很通用,但示例大都来自于 32 位 x86 架构的 Linux 和 Windows 上。这第一篇文章描述了在内存中程序如何分布。

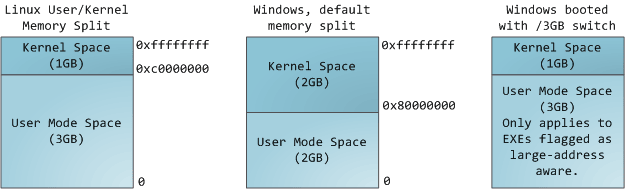
在一个多任务操作系统中的每个进程都运行在它自己的内存“沙箱”中。这个沙箱是一个 虚拟地址空间 virtual address space ,在 32 位的模式中它总共有 4GB 的内存地址块。这些虚拟地址是通过内核 页表 page table 映射到物理地址的,并且这些虚拟地址是由操作系统内核来维护,进而被进程所消费的。每个进程都有它自己的一组页表,但是这里有点玄机。一旦虚拟地址被启用,这些虚拟地址将被应用到这台电脑上的 所有软件,包括内核本身。因此,一部分虚拟地址空间必须保留给内核使用:

Kernel/User Memory Split

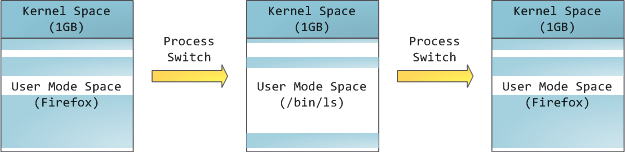
但是,这并不是说内核就使用了很多的物理内存,恰恰相反,它只使用了很少一部分可用的地址空间映射到其所需要的物理内存。内核空间在内核页表中被标记为独占使用于 特权代码 (ring 2 或更低),因此,如果一个用户模式的程序尝试去访问它,将触发一个页面故障错误。在 Linux 中,内核空间是始终存在的,并且在所有进程中都映射相同的物理内存。内核代码和数据总是可寻址的,准备随时去处理中断或者系统调用。相比之下,用户模式中的地址空间,在每次进程切换时都会发生变化:

Process Switch Effects on Virtual Memory

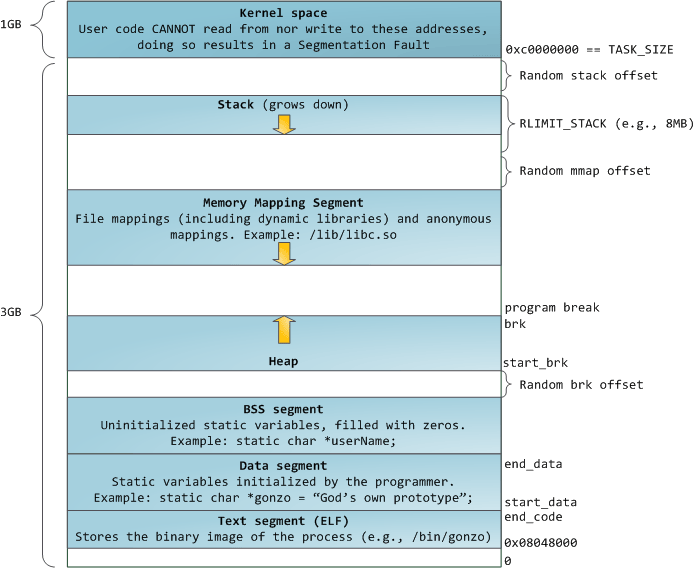
蓝色的区域代表映射到物理地址的虚拟地址空间,白色的区域是尚未映射的部分。在上面的示例中,众所周知的内存“饕餮” Firefox 使用了大量的虚拟内存空间。在地址空间中不同的条带对应了不同的内存段,像 堆 heap 、 栈 stack 等等。请注意,这些段只是一系列内存地址的简化表示,它与 Intel 类型的段 并没有任何关系 。不过,这是一个在 Linux 进程的标准段布局:

Flexible Process Address Space Layout In Linux

当计算机还是快乐、安全的时代时,在机器中的几乎每个进程上,那些段的起始虚拟地址都是完全相同的。这将使远程挖掘安全漏洞变得容易。漏洞利用经常需要去引用绝对内存位置:比如在栈中的一个地址,一个库函数的地址,等等。远程攻击可以闭着眼睛选择这个地址,因为地址空间都是相同的。当攻击者们这样做的时候,人们就会受到伤害。因此,地址空间随机化开始流行起来。Linux 会通过在其起始地址上增加偏移量来随机化栈、内存映射段、以及堆。不幸的是,32 位的地址空间是非常拥挤的,为地址空间随机化留下的空间不多,因此 妨碍了地址空间随机化的效果。

在进程地址空间中最高的段是栈,在大多数编程语言中它存储本地变量和函数参数。调用一个方法或者函数将推送一个新的 栈帧 stack frame 到这个栈。当函数返回时这个栈帧被删除。这个简单的设计,可能是因为数据严格遵循 后进先出(LIFO) 的次序,这意味着跟踪栈内容时不需要复杂的数据结构 —— 一个指向栈顶的简单指针就可以做到。推入和弹出也因此而非常快且准确。也可能是,持续的栈区重用往往会在 CPU 缓存 中保持活跃的栈内存,这样可以加快访问速度。进程中的每个线程都有它自己的栈。

向栈中推送更多的而不是刚合适的数据可能会耗尽栈的映射区域。这将触发一个页面故障,在 Linux 中它是通过 expand_stack() 来处理的,它会去调用 acct_stack_growth() 来检查栈的增长是否正常。如果栈的大小低于 RLIMIT_STACK 的值(一般是 8MB 大小),那么这是一个正常的栈增长和程序的合理使用,否则可能是发生了未知问题。这是一个栈大小按需调节的常见机制。但是,栈的大小达到了上述限制,将会发生一个栈溢出,并且,程序将会收到一个 段故障 Segmentation Fault 错误。当映射的栈区为满足需要而扩展后,在栈缩小时,映射区域并不会收缩。就像美国联邦政府的预算一样,它只会扩张。

动态栈增长是 唯一例外的情况 ,当它去访问一个未映射的内存区域,如上图中白色部分,是允许的。除此之外的任何其它访问未映射的内存区域将触发一个页面故障,导致段故障。一些映射区域是只读的,因此,尝试去写入到这些区域也将触发一个段故障。

在栈的下面,有内存映射段。在这里,内核将文件内容直接映射到内存。任何应用程序都可以通过 Linux 的 mmap() 系统调用( 代码实现)或者 Windows 的 CreateFileMapping().aspx) / MapViewOfFile().aspx) 来请求一个映射。内存映射是实现文件 I/O 的方便高效的方式。因此,它经常被用于加载动态库。有时候,也被用于去创建一个并不匹配任何文件的匿名内存映射,这种映射经常被用做程序数据的替代。在 Linux 中,如果你通过 malloc() 去请求一个大的内存块,C 库将会创建这样一个匿名映射而不是使用堆内存。这里所谓的“大”表示是超过了MMAP_THRESHOLD 设置的字节数,它的缺省值是 128 kB,可以通过 mallopt() 去调整这个设置值。

接下来讲的是“堆”,就在我们接下来的地址空间中,堆提供运行时内存分配,像栈一样,但又不同于栈的是,它分配的数据生存期要长于分配它的函数。大多数编程语言都为程序提供了堆管理支持。因此,满足内存需要是编程语言运行时和内核共同来做的事情。在 C 中,堆分配的接口是 malloc() 一族,然而在支持垃圾回收的编程语言中,像 C#,这个接口使用 new 关键字。

如果在堆中有足够的空间可以满足内存请求,它可以由编程语言运行时来处理内存分配请求,而无需内核参与。否则将通过 brk() 系统调用(代码实现)来扩大堆以满足内存请求所需的大小。堆管理是比较 复杂的,在面对我们程序的混乱分配模式时,它通过复杂的算法,努力在速度和内存使用效率之间取得一种平衡。服务一个堆请求所需要的时间可能是非常可观的。实时系统有一个 特定用途的分配器 去处理这个问题。堆也会出现 碎片化 ,如下图所示:

Fragmented Heap

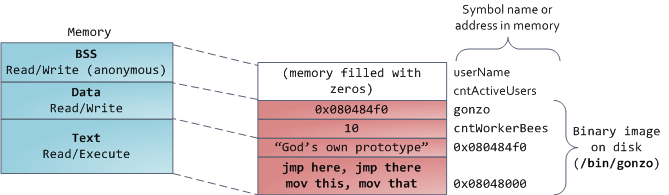
最后,我们抵达了内存的低位段:BSS、数据、以及程序文本。在 C 中,静态(全局)变量的内容都保存在 BSS 和数据中。它们之间的不同之处在于,BSS 保存 未初始化的 静态变量的内容,它的值在源代码中并没有被程序员设置。BSS 内存区域是 匿名 的:它没有映射到任何文件上。如果你在程序中写这样的语句 static int cntActiveUsers,cntActiveUsers 的内容就保存在 BSS 中。

反过来,数据段,用于保存在源代码中静态变量 初始化后 的内容。这个内存区域是 非匿名 的。它映射了程序的二进值镜像上的一部分,包含了在源代码中给定初始化值的静态变量内容。因此,如果你在程序中写这样的语句 static int cntWorkerBees = 10,那么,cntWorkerBees 的内容就保存在数据段中,并且初始值为 10。尽管可以通过数据段映射到一个文件,但是这是一个私有内存映射,意味着,如果改变内存,它并不会将这种变化反映到底层的文件上。必须是这样的,否则,分配的全局变量将会改变你磁盘上的二进制文件镜像,这种做法就太不可思议了!

用图去展示一个数据段是很困难的,因为它使用一个指针。在那种情况下,指针 gonzo 的内容(一个 4 字节的内存地址)保存在数据段上。然而,它并没有指向一个真实的字符串。而这个字符串存在于文本段中,文本段是只读的,它用于保存你的代码中的类似于字符串常量这样的内容。文本段也会在内存中映射你的二进制文件,但是,如果你的程序写入到这个区域,将会触发一个段故障错误。尽管在 C 中,它比不上从一开始就避免这种指针错误那么有效,但是,这种机制也有助于避免指针错误。这里有一个展示这些段和示例变量的图:

ELF Binary Image Mapped Into Memory

你可以通过读取 /proc/pid_of_process/maps 文件来检查 Linux 进程中的内存区域。请记住,一个段可以包含很多的区域。例如,每个内存映射的文件一般都在 mmap 段中的它自己的区域中,而动态库有类似于 BSS 和数据一样的额外的区域。下一篇文章中我们将详细说明“ 区域 area ”的真正含义是什么。此外,有时候人们所说的“ 数据段 data segment ”是指“ 数据 data + BSS + 堆”。

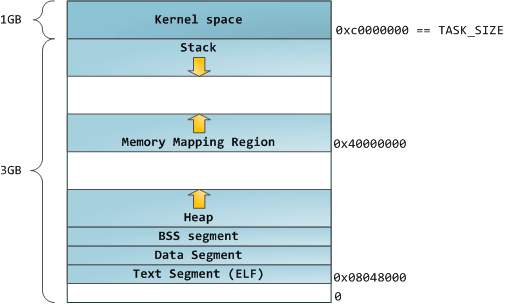
你可以使用 nm 和 objdump 命令去检查二进制镜像,去显示它们的符号、地址、段等等。最终,在 Linux 中上面描述的虚拟地址布局是一个“弹性的”布局,这就是这几年来的缺省情况。它假设 RLIMIT_STACK 有一个值。如果没有值的话,Linux 将恢复到如下所示的“经典” 布局:

Classic Process Address Space Layout In Linux

这就是虚拟地址空间布局。接下来的文章将讨论内核如何对这些内存区域保持跟踪、内存映射、文件如何读取和写入、以及内存使用数据的意义。


via: http://duartes.org/gustavo/blog/post/anatomy-of-a-program-in-memory/

作者:Gustavo Duarte 译者:qhwdw 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出
在 fleetster, 我们搭建了自己的 Gitlab 实例,而且我们大量使用了 Gitlab CI。我们的设计师和测试人员也都在用它,也很喜欢用它,它的那些高级功能特别棒。

Gitlab CI 是一个功能非常强大的持续集成系统,有很多不同的功能,而且每次发布都会增加新的功能。它的技术文档也很丰富,但是对那些要在已经配置好的 Gitlab 上使用它的用户来说,它缺乏一个一般性介绍。设计师或者测试人员是无需知道如何通过 Kubernetes 来实现自动伸缩,也无需知道“镜像”和“服务”之间的不同的。

但是,他仍然需要知道什么是“管道”,知道如何查看部署到一个“环境”中的分支。因此,在本文中,我会尽可能覆盖更多的功能,重点放在最终用户应该如何使用它们上;在过去的几个月里,我向我们团队中的某些人包括开发者讲解了这些功能:不是所有人都知道 持续集成 Continuous Integration (CI)是个什么东西,也不是所有人都用过 Gitlab CI。

如果你想了解为什么持续集成那么重要,我建议阅读一下 这篇文章,至于为什么要选择 Gitlab CI 呢,你可以去看看 Gitlab.com 上的说明。

简介

开发者保存更改代码的动作叫做一次 提交 commit 。然后他可以将这次提交 推送 push 到 Gitlab 上,这样可以其他开发者就可以 复查 review 这些代码了。

Gitlab CI 配置好后,Gitlab 也能对这个提交做出一些处理。该处理的工作由一个 运行器 runner 来执行的。所谓运行器基本上就是一台服务器(也可以是其他的东西,比如你的 PC 机,但我们可以简单称其为服务器)。这台服务器执行 .gitlab-ci.yml 文件中指令,并将执行结果返回给 Gitlab 本身,然后在 Gitlab 的图形化界面上显示出来。

开发者完成一项新功能的开发或完成一个 bug 的修复后(这些动作通常包含了多次的提交),就可以发起一个 合并请求 merge request ,团队其他成员则可以在这个合并请求中对代码及其实现进行 评论 comment 。

我们随后会看到,由于 Gitlab CI 提供的两大特性, 环境 environment 与 制品 artifact ,使得设计者和测试人员也能(而且真的需要)参与到这个过程中来,提供反馈以及改进意见。

管道 pipeline

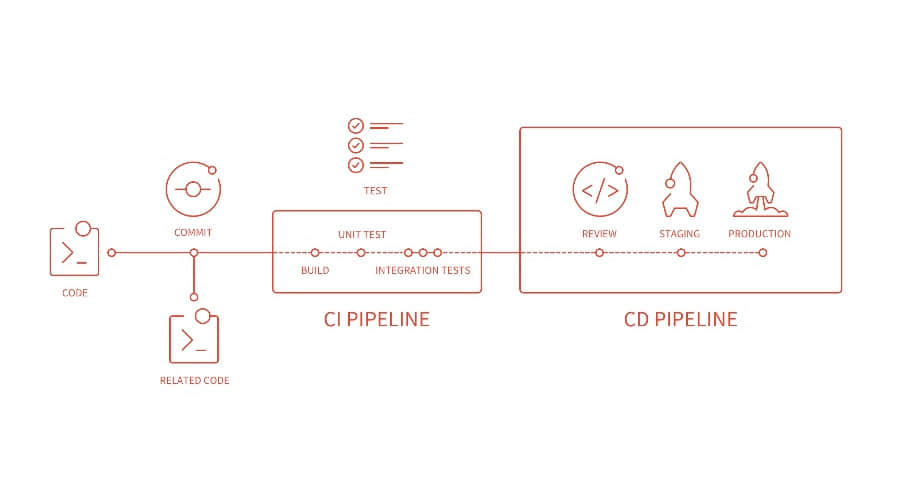
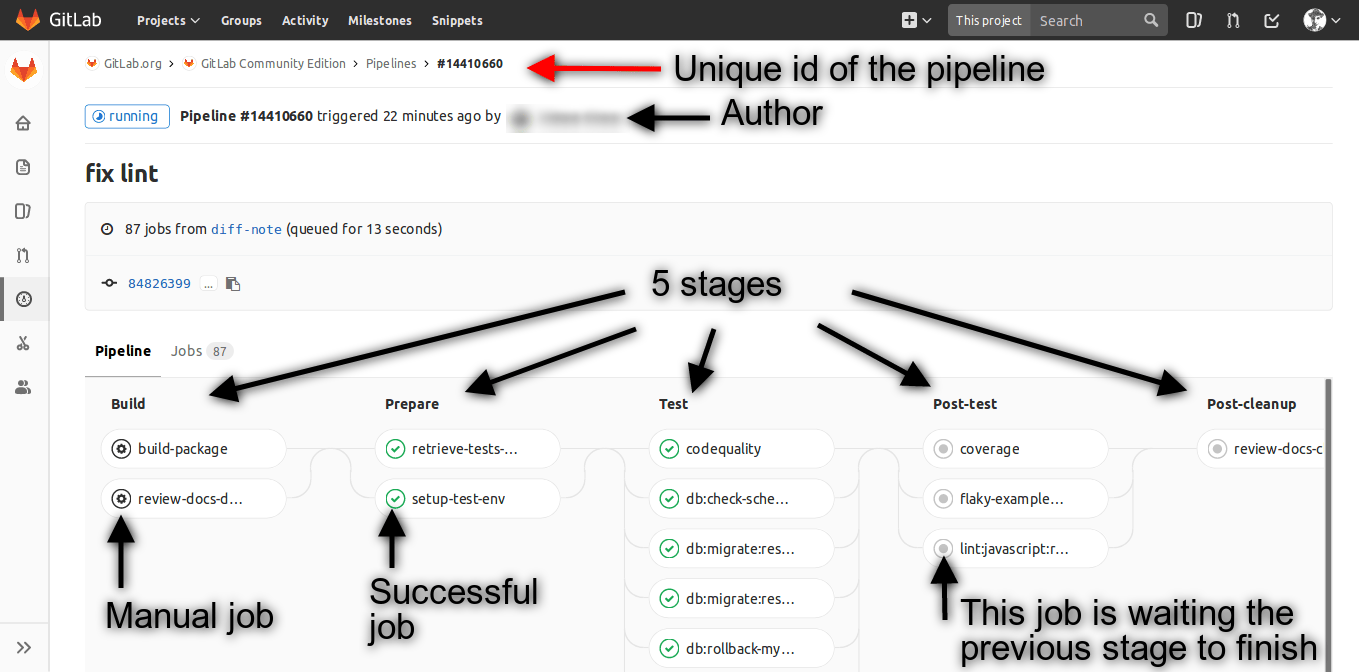
每个推送到 Gitlab 的提交都会产生一个与该提交关联的 管道 pipeline 。若一次推送包含了多个提交,则管道与最后那个提交相关联。管道就是一个分成不同 阶段 stage 的 作业 job 的集合。

同一阶段的所有作业会并发执行(在有足够运行器的前提下),而下一阶段则只会在上一阶段所有作业都运行并返回成功后才会开始。

只要有一个作业失败了,整个管道就失败了。不过我们后面会看到,这其中有一个例外:若某个作业被标注成了手工运行,那么即使失败了也不会让整个管道失败。

阶段则只是对批量的作业的一个逻辑上的划分,若前一个阶段执行失败了,则后一个执行也没什么意义了。比如我们可能有一个 构建 build 阶段和一个 部署 deploy 阶段,在构建阶段运行所有用于构建应用的作业,而在部署阶段,会部署构建出来的应用程序。而部署一个构建失败的东西是没有什么意义的,不是吗?

同一阶段的作业之间不能有依赖关系,但它们可以依赖于前一阶段的作业运行结果。

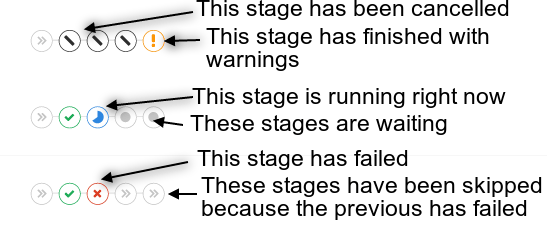
让我们来看一下 Gitlab 是如何展示阶段与阶段状态的相关信息的。

pipeline-overview

pipeline-status

作业 job

作业就是运行器要执行的指令集合。你可以实时地看到作业的输出结果,这样开发者就能知道作业为什么失败了。

作业可以是自动执行的,也就是当推送提交后自动开始执行,也可以手工执行。手工作业必须由某个人手工触发。手工作业也有其独特的作用,比如,实现自动化部署,但只有在有人手工授权的情况下才能开始部署。这是限制哪些人可以运行作业的一种方式,这样只有信赖的人才能进行部署,以继续前面的实例。

作业也可以建构出 制品 artifacts 来以供用户下载,比如可以构建出一个 APK 让你来下载,然后在你的设备中进行测试; 通过这种方式,设计者和测试人员都可以下载应用并进行测试,而无需开发人员的帮助。

除了生成制品外,作业也可以部署环境,通常这个环境可以通过 URL 访问,让用户来测试对应的提交。

做作业状态与阶段状态是一样的:实际上,阶段的状态就是继承自作业的。

running-job

制品 Artifacts

如前所述,作业能够生成制品供用户下载来测试。这个制品可以是任何东西,比如 Windows 上的应用程序,PC 生成的图片,甚至 Android 上的 APK。

那么,假设你是个设计师,被分配了一个合并请求:你需要验证新设计的实现!

要该怎么做呢?

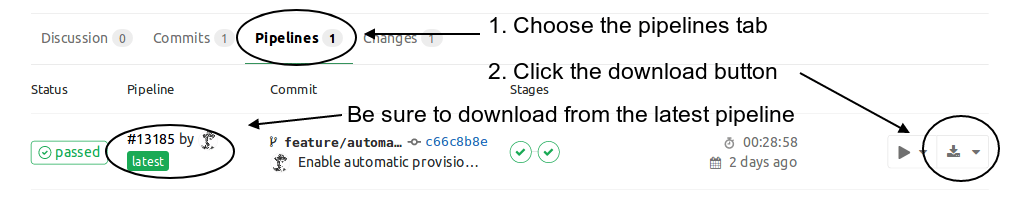
你需要打开该合并请求,下载这个制品,如下图所示。

每个管道从所有作业中搜集所有的制品,而且一个作业中可以有多个制品。当你点击下载按钮时,会有一个下拉框让你选择下载哪个制品。检查之后你就可以评论这个合并请求了。

你也可以从没有合并请求的管道中下载制品 ;-)

我之所以关注合并请求是因为通常这正是测试人员、设计师和相关人员开始工作的地方。

但是这并不意味着合并请求和管道就是绑死在一起的:虽然它们结合的很好,但两者之间并没有什么关系。

download-artifacts

环境 environment

类似的,作业可以将某些东西部署到外部服务器上去,以便你可以通过合并请求本身访问这些内容。

如你所见, 环境 environment 有一个名字和一个链接。只需点击链接你就能够转至你的应用的部署版本上去了(当前,前提是配置是正确的)。

Gitlab 还有其他一些很酷的环境相关的特性,比如 监控 monitoring ,你可以通过点击环境的名字来查看。

environment

总结

这是对 Gitlab CI 中某些功能的一个简单介绍:它非常强大,使用得当的话,可以让整个团队使用一个工具完成从计划到部署的工具。由于每个月都会推出很多新功能,因此请时刻关注 Gitlab 博客。

若想知道如何对它进行设置或想了解它的高级功能,请参阅它的文档。

在 fleetster,我们不仅用它来跑测试,而且用它来自动生成各种版本的软件,并自动发布到测试环境中去。我们也自动化了其他工作(构建应用并将之发布到 Play Store 中等其它工作)。

说起来,你是否想和我以及其他很多超棒的人一起在一个年轻而又富有活力的办公室中工作呢? 看看 fleetster 的这些招聘职位 吧!

赞美 Gitlab 团队 (和其他在空闲时间提供帮助的人),他们的工作太棒了!

若对本文有任何问题或回馈,请给我发邮件:[email protected] 或者发推给我:-) 你可以建议我增加内容,或者以更清晰的方式重写内容(英文不是我的母语)。

那么,再见吧,

R.

P.S:如果你觉得本文有用,而且希望我们写出其他文章的话,请问您是否愿意帮我买杯啤酒给我 让我进入 鲍尔默峰值?


via: https://rpadovani.com/introduction-gitlab-ci

作者:Riccardo 译者:lujun9972 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出
在之前的教程中,我们已经学习了在机器上安装 git。本教程,我们将讨论如何使用 git,比如与 git 一起使用的各种命令。所以我们开始吧。

设置用户信息

这应该是安装完 git 的第一步。我们将添加用户信息 (用户名和邮箱),所以当我们提交代码时,会产生带有用户信息的提交信息,这使得跟踪提交过程变得更容易。要添加用户信息,命令是 git config:

$ git config --global user.name "Daniel"
$ git config --global user.email "[email protected]"

添加完用户信息之后,通过运行下面命令,我们将检查这些信息是否成功更新。

$ git config --list

我们应该能够看到输出的用户信息。

GIT 命令

新建一个仓库

为了建立一个新仓库,运行如下命令:

$ git init

查找一个仓库

为了查找一个仓库,命令如下:

$ git grep "repository"

与远程仓库连接

为了与远程仓库连接,运行如下命令:

$ git remote add origin remote_server

然后检查所有配置的远程服务器,运行如下命令:

$ git remote -v

克隆一个仓库

为了从本地服务器克隆一个仓库,运行如下代码:

$ git clone repository_path

如果我们想克隆远程服务器上的一个仓库,那克隆这个仓库的命令是:

$ git clone repository_path

在仓库中列出分支

为了检查所有可用的和当前工作的分支列表,执行:

$ git branch

创建新分支

创建并使用一个新分支,命令是:

$ git checkout -b 'branchname'

删除一个分支

为了删除一个分支,执行:

$ git branch -d 'branchname'

为了删除远程仓库的一个分支,执行:

$ git push origin:'branchname'

切换到另一个分支

从当前分支切换到另一个分支,使用

$ git checkout 'branchname'

添加文件

添加文件到仓库,执行:

$ git add filename

文件状态

检查文件状态 (那些将要提交或者添加的文件),执行:

$ git status

提交变更

在我们添加一个文件或者对一个文件作出变更之后,我们通过运行下面命令来提交代码:

$ git commit -a

提交变更到 head 但不提交到远程仓库,命令是:

$ git commit -m "message"

推送变更

推送对该仓库 master 分支所做的变更,运行:

$ git push origin master

推送分支到仓库

推送对单一分支做出的变更到远程仓库,运行:

$ git push origin 'branchname'

推送所有分支到远程仓库,运行:

$ git push -all origin

合并两个分支

合并另一个分支到当前活动分支,使用命令:

$ git merge 'branchname'

从远端服务器合并到本地服务器

从远端服务器下载/拉取变更到到本地服务器的工作目录,运行:

$ git pull 

检查合并冲突

查看对库文件的合并冲突,运行:

$ git diff -base 'filename'

查看所有冲突,运行:

$ git diff

如果我们在合并之前想预览所有变更,运行:

$ git diff 'source-branch' 'target-branch' 

创建标记

创建标记来标志任一重要的变更,运行:

$ git tag 'tag number' 'commit id' 

通过运行以下命令,我们可以查找 commit id :

$ git log

推送标记

推送所有创建的标记到远端服务器,运行:

$ git push -tags origin

恢复做出的变更

如果我们想用 head 中最后一次变更来替换对当前工作树的变更,运行:

$ git checkout -'filename'

我们也可以从远端服务器获取最新的历史,并且将它指向本地仓库的 master 分支,而不是丢弃掉所有本地所做所有变更。为了这么做,运行:

$ git fetch origin
$ git reset -hard master

好了,伙计们。这些就是我们使用 git 服务器的命令。我们将会很快为大家带来更有趣的教程。如果你希望我们对某个特定话题写一个教程,请通过下面的评论箱告诉我们。像往常一样, 欢迎您的各种意见和建议。


via: http://linuxtechlab.com/beginners-to-pro-guide-for-git-commands/

作者:Shusain 译者:liuxinyu123 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出
本文假设你具备基本的 C 技能

Linux 完全在你的控制之中。虽然从每个人的角度来看似乎并不总是这样,但是高级用户喜欢去控制它。我将向你展示一个基本的诀窍,在很大程度上你可以去影响大多数程序的行为,它并不仅是好玩,在有时候也很有用。

一个让我们产生兴趣的示例

让我们以一个简单的示例开始。先乐趣,后科学。

random\_num.c:

#include <stdio.h>
#include <stdlib.h>
#include <time.h>

int main(){
  srand(time(NULL));
  int i = 10;
  while(i--) printf("%d\n",rand()%100);
  return 0;
}

我相信,它足够简单吧。我不使用任何参数来编译它,如下所示:

gcc random_num.c -o random_num

我希望它输出的结果是明确的:从 0-99 中选择的十个随机数字,希望每次你运行这个程序时它的输出都不相同。

现在,让我们假装真的不知道这个可执行程序的出处。甚至将它的源文件删除,或者把它移动到别的地方 —— 我们已不再需要它了。我们将对这个程序的行为进行重大的修改,而你并不需要接触到它的源代码,也不需要重新编译它。

因此,让我们来创建另外一个简单的 C 文件:

unrandom.c:

int rand(){
    return 42; //the most random number in the universe
}

我们将编译它进入一个共享库中。

gcc -shared -fPIC unrandom.c -o unrandom.so

因此,现在我们已经有了一个可以输出一些随机数的应用程序,和一个定制的库,它使用一个常数值 42 实现了一个 rand() 函数。现在 …… 就像运行 random_num 一样,然后再观察结果:

LD_PRELOAD=$PWD/unrandom.so ./random_nums

如果你想偷懒或者不想自动亲自动手(或者不知什么原因猜不出发生了什么),我来告诉你 —— 它输出了十次常数 42。

如果先这样执行

export LD_PRELOAD=$PWD/unrandom.so

然后再以正常方式运行这个程序,这个结果也许会更让你吃惊:一个未被改变过的应用程序在一个正常的运行方式中,看上去受到了我们做的一个极小的库的影响 ……

等等,什么?刚刚发生了什么?

是的,你说对了,我们的程序生成随机数失败了,因为它并没有使用 “真正的” rand(),而是使用了我们提供的的那个 —— 它每次都返回 42。

但是,我们告诉过它去使用真实的那个。我们编程让它去使用真实的那个。另外,在创建那个程序的时候,假冒的 rand() 甚至并不存在!

这句话并不完全正确。我们只能告诉它去使用 rand(),但是我们不能去选择哪个 rand() 是我们希望我们的程序去使用的。

当我们的程序启动后,(为程序提供所需要的函数的)某些库被加载。我们可以使用 ldd 去学习它是怎么工作的:

$ ldd random_nums
linux-vdso.so.1 => (0x00007fff4bdfe000)
libc.so.6 => /lib/x86_64-linux-gnu/libc.so.6 (0x00007f48c03ec000)
/lib64/ld-linux-x86-64.so.2 (0x00007f48c07e3000)

正如你看到的输出那样,它列出了被程序 random_nums 所需要的库的列表。这个列表是构建进可执行程序中的,并且它是在编译时决定的。在你的机器上的具体的输出可能与示例有所不同,但是,一个 libc.so 肯定是有的 —— 这个文件提供了核心的 C 函数。它包含了 “真正的” rand()。

我使用下列的命令可以得到一个全部的函数列表,我们看一看 libc 提供了哪些函数:

nm -D /lib/libc.so.6

这个 nm 命令列出了在一个二进制文件中找到的符号。-D 标志告诉它去查找动态符号,因为 libc.so.6 是一个动态库。这个输出是很长的,但它确实在列出的很多标准函数中包括了 rand()。

现在,在我们设置了环境变量 LD_PRELOAD 后发生了什么?这个变量 为一个程序强制加载一些库。在我们的案例中,它为 random_num 加载了 unrandom.so,尽管程序本身并没有这样去要求它。下列的命令可以看得出来:

$ LD_PRELOAD=$PWD/unrandom.so ldd random_nums
linux-vdso.so.1 =>  (0x00007fff369dc000)
/some/path/to/unrandom.so (0x00007f262b439000)
libc.so.6 => /lib/x86_64-linux-gnu/libc.so.6 (0x00007f262b044000)
/lib64/ld-linux-x86-64.so.2 (0x00007f262b63d000)

注意,它列出了我们当前的库。实际上这就是代码为什么得以运行的原因:random_num 调用了 rand(),但是,如果 unrandom.so 被加载,它调用的是我们所提供的实现了 rand() 的库。很清楚吧,不是吗?

更清楚地了解

这还不够。我可以用相似的方式注入一些代码到一个应用程序中,并且用这种方式它能够像个正常的函数一样工作。如果我们使用一个简单的 return 0 去实现 open() 你就明白了。我们看到这个应用程序就像发生了故障一样。这是 显而易见的, 真实地去调用原始的 open():

inspect\_open.c:

int open(const char *pathname, int flags){
  /* Some evil injected code goes here. */
  return open(pathname,flags); // Here we call the "real" open function, that is provided to us by libc.so
}

嗯,不对。这将不会去调用 “原始的” open(...)。显然,这是一个无休止的递归调用。

怎么去访问这个 “真正的” open() 函数呢?它需要去使用程序接口进行动态链接。它比听起来更简单。我们来看一个完整的示例,然后,我将详细解释到底发生了什么:

inspect\_open.c:

#define _GNU_SOURCE
#include <dlfcn.h>

typedef int (*orig_open_f_type)(const char *pathname, int flags);

int open(const char *pathname, int flags, ...)
{
    /* Some evil injected code goes here. */

    orig_open_f_type orig_open;
    orig_open = (orig_open_f_type)dlsym(RTLD_NEXT,"open");
    return orig_open(pathname,flags);
}

dlfcn.h 是我们后面用到的 dlsym 函数所需要的。那个奇怪的 #define 是命令编译器去允许一些非标准的东西,我们需要它来启用 dlfcn.h 中的 RTLD_NEXT。那个 typedef 只是创建了一个函数指针类型的别名,它的参数等同于原始的 open —— 它现在的别名是 orig_open_f_type,我们将在后面用到它。

我们定制的 open(...) 的主体是由一些代码构成。它的最后部分创建了一个新的函数指针 orig_open,它指向原始的 open(...) 函数。为了得到那个函数的地址,我们请求 dlsym 在动态库堆栈上为我们查找下一个 open() 函数。最后,我们调用了那个函数(传递了与我们的假冒 open() 一样的参数),并且返回它的返回值。

我使用下面的内容作为我的 “邪恶的注入代码”:

inspect\_open.c (片段):

printf("The victim used open(...) to access '%s'!!!\n",pathname); //remember to include stdio.h!

要编译它,我需要稍微调整一下编译参数:

gcc -shared -fPIC  inspect_open.c -o inspect_open.so -ldl

我增加了 -ldl,因此,它将这个共享库链接到 libdl —— 它提供了 dlsym 函数。(不,我还没有创建一个假冒版的 dlsym ,虽然这样更有趣)

因此,结果是什么呢?一个实现了 open(...) 函数的共享库,除了它有 输出 文件路径的意外作用以外,其它的表现和真正的 open(...) 函数 一模一样。:-)

如果这个强大的诀窍还没有说服你,是时候去尝试下面的这个示例了:

LD_PRELOAD=$PWD/inspect_open.so gnome-calculator

我鼓励你去看看自己实验的结果,但是简单来说,它实时列出了这个应用程序可以访问到的每个文件。

我相信它并不难想像为什么这可以用于去调试或者研究未知的应用程序。请注意,这个特定诀窍并不完整,因为 open() 并不是唯一一个打开文件的函数 …… 例如,在标准库中也有一个 open64(),并且为了完整地研究,你也需要为它去创建一个假冒的。

可能的用法

如果你一直跟着我享受上面的过程,让我推荐一个使用这个诀窍能做什么的一大堆创意。记住,你可以在不损害原始应用程序的同时做任何你想做的事情!

  1. 获得 root 权限。你想多了!你不会通过这种方法绕过安全机制的。(一个专业的解释是:如果 ruid != euid,库不会通过这种方法预加载的。)
  2. 欺骗游戏:取消随机化。这是我演示的第一个示例。对于一个完整的工作案例,你将需要去实现一个定制的 random() 、rand_r()、random_r(),也有一些应用程序是从 /dev/urandom 之类的读取,你可以通过使用一个修改过的文件路径来运行原始的 open() 来把它们重定向到 /dev/null。而且,一些应用程序可能有它们自己的随机数生成算法,这种情况下你似乎是没有办法的(除非,按下面的第 10 点去操作)。但是对于一个新手来说,它看起来很容易上手。
  3. 欺骗游戏:让子弹飞一会 。实现所有的与时间有关的标准函数,让假冒的时间变慢两倍,或者十倍。如果你为时间测量和与时间相关的 sleep 或其它函数正确地计算了新的值,那么受影响的应用程序将认为时间变慢了(你想的话,也可以变快),并且,你可以体验可怕的 “子弹时间” 的动作。或者 甚至更进一步,你的共享库也可以成为一个 DBus 客户端,因此你可以使用它进行实时的通讯。绑定一些快捷方式到定制的命令,并且在你的假冒的时间函数上使用一些额外的计算,让你可以有能力按你的意愿去启用和禁用慢进或快进任何时间。
  4. 研究应用程序:列出访问的文件。它是我演示的第二个示例,但是这也可以进一步去深化,通过记录和监视所有应用程序的文件 I/O。
  5. 研究应用程序:监视因特网访问。你可以使用 Wireshark 或者类似软件达到这一目的,但是,使用这个诀窍你可以真实地控制基于 web 的应用程序发送了什么,不仅是看看,而是也能影响到交换的数据。这里有很多的可能性,从检测间谍软件到欺骗多用户游戏,或者分析和逆向工程使用闭源协议的应用程序。
  6. 研究应用程序:检查 GTK 结构 。为什么只局限于标准库?让我们在所有的 GTK 调用中注入一些代码,因此我们就可以知道一个应用程序使用了哪些组件,并且,知道它们的构成。然后这可以渲染出一个图像或者甚至是一个 gtkbuilder 文件!如果你想去学习一些应用程序是怎么管理其界面的,这个方法超级有用!
  7. 在沙盒中运行不安全的应用程序。如果你不信任一些应用程序,并且你可能担心它会做一些如 rm -rf / 或者一些其它不希望的文件活动,你可以通过修改传递到文件相关的函数(不仅是 open ,也包括删除目录等)的参数,来重定向所有的文件 I/O 操作到诸如 /tmp 这样地方。还有更难的诀窍,如 chroot,但是它也给你提供更多的控制。它可以更安全地完全 “封装”,但除非你真的知道你在做什么,不要以这种方式真的运行任何恶意软件。
  8. 实现特性 。zlibc 是明确以这种方法运行的一个真实的库;它可以在访问文件时解压文件,因此,任何应用程序都可以在无需实现解压功能的情况下访问压缩数据。
  9. 修复 bug。另一个现实中的示例是:不久前(我不确定现在是否仍然如此)Skype(它是闭源的软件)从某些网络摄像头中捕获视频有问题。因为 Skype 并不是自由软件,源文件不能被修改,这就可以通过使用预加载一个解决了这个问题的库的方式来修复这个 bug。
  10. 手工方式 访问应用程序拥有的内存。请注意,你可以通过这种方式去访问所有应用程序的数据。如果你有类似的软件,如 CheatEngine/scanmem/GameConqueror 这可能并不会让人惊讶,但是,它们都要求 root 权限才能工作,而 LD_PRELOAD 则不需要。事实上,通过一些巧妙的诀窍,你注入的代码可以访问所有的应用程序内存,从本质上看,是因为它是通过应用程序自身得以运行的。你可以修改这个应用程序能修改的任何东西。你可以想像一下,它允许你做许多的底层的侵入…… ,但是,关于这个主题,我将在某个时候写一篇关于它的文章。

这里仅是一些我想到的创意。我希望你能找到更多,如果你做到了 —— 通过下面的评论区共享出来吧!


via: https://rafalcieslak.wordpress.com/2013/04/02/dynamic-linker-tricks-using-ld_preload-to-cheat-inject-features-and-investigate-programs/

作者:Rafał Cieślak 译者:qhwdw 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出