分类 软件开发 下的文章

不论是经验丰富的老程序员,还是没有经验的新手,Python 都是一个非常好的编程语言。

Python 是一个非常流行的编程语言,它可以用于创建桌面应用程序、3D 图形、视频游戏、甚至是网站。它是非常好的首选编程语言,因为它易于学习,不像一些复杂的语言,比如,C、 C++、 或 Java。 即使如此, Python 依然也是强大且健壮的,足以创建高级的应用程序,并且几乎适用于所有使用电脑的行业。不论是经验丰富的老程序员,还是没有经验的新手,Python 都是一个非常好的编程语言。

安装 Python

在学习 Python 之前,你需要先去安装它:

Linux: 如果你使用的是 Linux 系统, Python 是已经包含在里面了。但是,你如果确定要使用 Python 3 。应该去检查一下你安装的 Python 版本,打开一个终端窗口并输入:

python3 -V

如果提示该命令没有找到,你需要从你的包管理器中去安装 Python 3。

MacOS: 如果你使用的是一台 Mac,可以看上面 Linux 的介绍来确认是否安装了 Python 3。MacOS 没有内置的包管理器,因此,如果发现没有安装 Python 3,可以从 python.org/downloads/mac-osx 安装它。即使 macOS 已经安装了 Python 2,你还是应该学习 Python 3。

Windows: 微软 Windows 当前是没有安装 Python 的。从 python.org/downloads/windows 安装它。在安装向导中一定要选择 Add Python to PATH 来将 Python 执行程序放到搜索路径。

在 IDE 中运行

在 Python 中写程序,你需要准备一个文本编辑器,使用一个集成开发环境(IDE)是非常实用的。IDE 在一个文本编辑器中集成了一些方便而有用的 Python 功能。IDLE 3 和 NINJA-IDE 是你可以考虑的两种选择:

IDLE 3

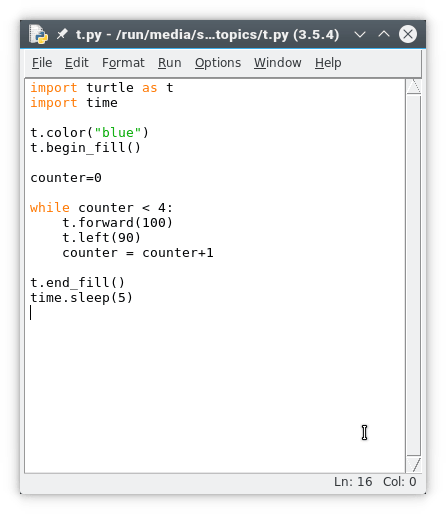
Python 自带的一个基本的 IDE 叫做 IDLE。

 title=

它有关键字高亮功能,可以帮助你检测拼写错误,并且有一个“运行”按钮可以很容易地快速测试代码。

要使用它:

  • 在 Linux 或 macOS 上,启动一个终端窗口并输入 idle3。
  • 在 Windows,从开始菜单中启动 Python 3。

    • 如果你在开始菜单中没有看到 Python,在开始菜单中通过输入 cmd 启动 Windows 命令提示符,然后输入 C:\Windows\py.exe。
    • 如果它没有运行,试着重新安装 Python。并且确认在安装向导中选择了 “Add Python to PATH”。参考 docs.python.org/3/using/windows.html 中的详细介绍。
    • 如果仍然不能运行,那就使用 Linux 吧!它是免费的,只要将你的 Python 文件保存到一个 U 盘中,你甚至不需要安装它就可以使用。

Ninja-IDE

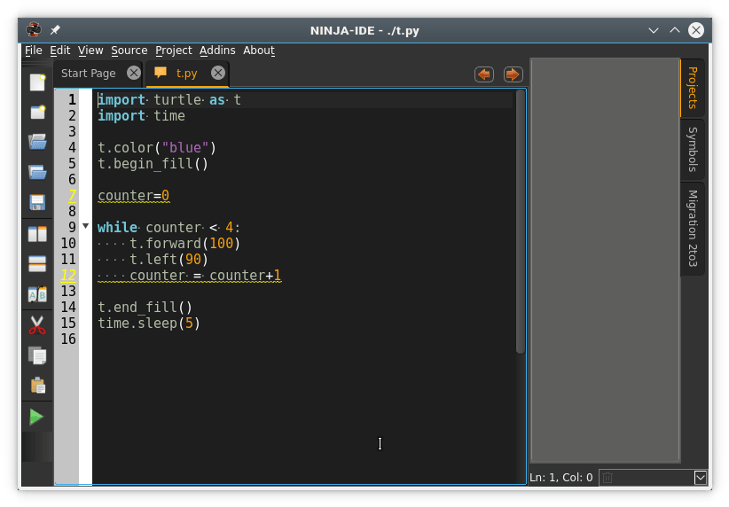
Ninja-IDE 是一个优秀的 Python IDE。它有关键字高亮功能可以帮助你检测拼写错误、引号和括号补全以避免语法错误,行号(在调试时很有帮助)、缩进标记,以及运行按钮可以很容易地进行快速代码测试。

 title=

要使用它:

  1. 安装 Ninja-IDE。如果你使用的是 Linux,使用包管理器安装是非常简单的;否则, 从 NINJA-IDE 的网站上 下载 合适的安装版本。
  2. 启动 Ninja-IDE。
  3. 转到 Edit 菜单,并选择 Preferences 设置。
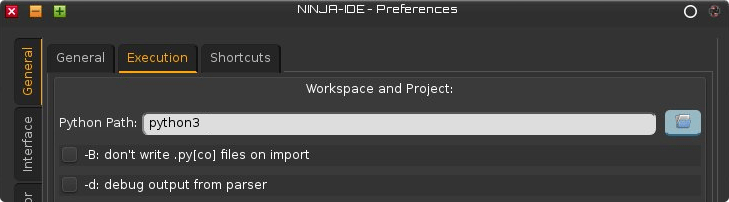
  4. 在 Preferences 窗口中,点击 Execution 选项卡。
  5. 在 Execution 选项卡上,更改 python 为 python3。

 title=

Ninja-IDE 中的 Python3

告诉 Python 想做什么

关键字可以告诉 Python 你想要做什么。不论是在 IDLE 还是在 Ninja 中,转到 File 菜单并创建一个新文件。对于 Ninja 用户:不要创建一个新项目,仅创建一个新文件。

在你的新的空文件中,在 IDLE 或 Ninja 中输入以下内容:

    print("Hello world.")
  • 如果你使用的是 IDLE,转到 Run 菜单并选择 Run module 选项。
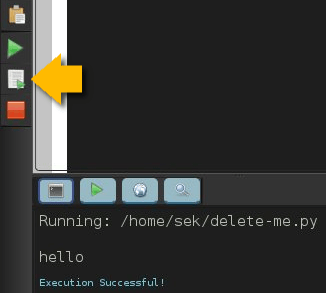
  • 如果你使用的是 Ninja,在左侧按钮条中点击 Run File 按钮。

 title=

在 Ninja 中运行文件

关键字 print 告诉 Python 去打印输出在圆括号中引用的文本内容。

虽然,这并不是特别刺激。在其内部, Python 只能访问基本的关键字,像 print、 help,最基本的数学函数,等等。

可以使用 import 关键字加载更多的关键字。在 IDLE 或 Ninja 中开始一个新文件,命名为 pen.py。

警告:不要命名你的文件名为 turtle.py,因为名为 turtle.py 的文件是包含在你正在控制的 turtle (海龟)程序中的。命名你的文件名为 turtle.py ,将会把 Python 搞糊涂,因为它会认为你将导入你自己的文件。

在你的文件中输入下列的代码,然后运行它:

    import turtle

Turtle 是一个非常有趣的模块,试着这样做:

    turtle.begin_fill()
    turtle.forward(100)
    turtle.left(90)
    turtle.forward(100)
    turtle.left(90)
    turtle.forward(100)
    turtle.left(90)
    turtle.forward(100)
    turtle.end_fill()

看一看你现在用 turtle 模块画出了一个什么形状。

要擦除你的海龟画图区,使用 turtle.clear() 关键字。想想看,使用 turtle.color("blue") 关键字会出现什么情况?

尝试更复杂的代码:

    import turtle as t
    import time

    t.color("blue")
    t.begin_fill()

    counter=0

    while counter < 4:
        t.forward(100)
        t.left(90)
        counter = counter+1

    t.end_fill()
    time.sleep(5)

运行完你的脚本后,是时候探索更有趣的模块了。

通过创建一个游戏来学习 Python

想学习更多的 Python 关键字,和用图形编程的高级特性,让我们来关注于一个游戏逻辑。在这个教程中,我们还将学习一些关于计算机程序是如何构建基于文本的游戏的相关知识,在游戏里面计算机和玩家掷一个虚拟骰子,其中掷的最高的是赢家。

规划你的游戏

在写代码之前,最重要的事情是考虑怎么去写。在他们写代码 之前,许多程序员是先 写简单的文档,这样,他们就有一个编程的目标。如果你想给这个程序写个文档的话,这个游戏看起来应该是这样的:

  1. 启动掷骰子游戏并按下 Return 或 Enter 去掷骰子
  2. 结果打印在你的屏幕上
  3. 提示你再次掷骰子或者退出

这是一个简单的游戏,但是,文档会告诉你需要做的事很多。例如,它告诉你写这个游戏需要下列的组件:

  • 玩家:你需要一个人去玩这个游戏。
  • AI:计算机也必须去掷,否则,就没有什么输或赢了
  • 随机数:一个常见的六面骰子表示从 1-6 之间的一个随机数
  • 运算:一个简单的数学运算去比较一个数字与另一个数字的大小
  • 一个赢或者输的信息
  • 一个再次玩或退出的提示

制作掷骰子游戏的 alpha 版

很少有程序,一开始就包含其所有的功能,因此,它们的初始版本仅实现最基本的功能。首先是几个定义:

变量是一个经常要改变的值,它在 Python 中使用的非常多。每当你需要你的程序去“记住”一些事情的时候,你就要使用一个变量。事实上,运行于代码中的信息都保存在变量中。例如,在数学方程式 x + 5 = 20 中,变量是 x ,因为字母 x 是一个变量占位符。

整数是一个数字, 它可以是正数也可以是负数。例如,1 和 -1 都是整数,因此,14、21,甚至 10947 都是。

在 Python 中变量创建和使用是非常容易的。这个掷骰子游戏的初始版使用了两个变量: player 和 ai。

在命名为 dice_alpha.py 的新文件中输入下列代码:

    import random

    player = random.randint(1,6)
    ai = random.randint(1,6)

    if player > ai :
        print("You win")  # notice indentation
    else:
        print("You lose")

启动你的游戏,确保它能工作。

这个游戏的基本版本已经工作的非常好了。它实现了游戏的基本目标,但是,它看起来不像是一个游戏。玩家不知道他们摇了什么,电脑也不知道摇了什么,并且,即使玩家还想玩但是游戏已经结束了。

这是软件的初始版本(通常称为 alpha 版)。现在你已经确信实现了游戏的主要部分(掷一个骰子),是时候该加入到程序中了。

改善这个游戏

在你的游戏的第二个版本中(称为 beta 版),将做一些改进,让它看起来像一个游戏。

1、 描述结果

不要只告诉玩家他们是赢是输,他们更感兴趣的是他们掷的结果。在你的代码中尝试做如下的改变:

    player = random.randint(1,6)
    print("You rolled " + player)

    ai = random.randint(1,6)
    print("The computer rolled " + ai)

现在,如果你运行这个游戏,它将崩溃,因为 Python 认为你在尝试做数学运算。它认为你试图在 player 变量上加字母 You rolled ,而保存在其中的是数字。

你必须告诉 Python 处理在 player 和 ai 变量中的数字,就像它们是一个句子中的单词(一个字符串)而不是一个数学方程式中的一个数字(一个整数)。

在你的代码中做如下的改变:

    player = random.randint(1,6)
    print("You rolled " + str(player) )

    ai = random.randint(1,6)
    print("The computer rolled " + str(ai) )

现在运行你的游戏将看到该结果。

2、 让它慢下来

计算机运行的非常快。人有时可以很快,但是在游戏中,产生悬念往往更好。你可以使用 Python 的 time 函数,在这个紧张时刻让你的游戏慢下来。

    import random
    import time

    player = random.randint(1,6)
    print("You rolled " + str(player) )

    ai = random.randint(1,6)
    print("The computer rolls...." )
    time.sleep(2)
    print("The computer has rolled a " + str(player) )

    if player > ai :
        print("You win")  # notice indentation
    else:
        print("You lose")

启动你的游戏去测试变化。

3、 检测关系

如果你多玩几次你的游戏,你就会发现,即使你的游戏看起来运行很正确,它实际上是有一个 bug 在里面:当玩家和电脑摇出相同的数字的时候,它就不知道该怎么办了。

去检查一个值是否与另一个值相等,Python 使用 ==。那是个“双”等号标记,不是一个。如果你仅使用一个,Python 认为你尝试去创建一个新变量,但是,实际上你是去尝试做数学运算。

当你想有比两个选项(即,赢或输)更多的选择时,你可以使用 Python 的 elif 关键字,它的意思是“否则,如果”。这允许你的代码去检查,是否在“许多”结果中有一个是 true, 而不是只检查“一个”是 true。

像这样修改你的代码:

    if player > ai :
        print("You win")  # notice indentation
    elif player == ai:
        print("Tie game.")
    else:
        print("You lose")

多运行你的游戏几次,去看一下你能否和电脑摇出一个平局。

编写最终版

你的掷骰子游戏的 beta 版的功能和感觉比起 alpha 版更像游戏了,对于最终版,让我们来创建你的第一个 Python 函数。

函数是可以作为一个独立的单元来调用的一组代码的集合。函数是非常重要的,因为,大多数应用程序里面都有许多代码,但不是所有的代码都只运行一次。函数可以启用应用程序并控制什么时候可以发生什么事情。

将你的代码变成这样:

    import random
    import time

    def dice():
        player = random.randint(1,6)
        print("You rolled " + str(player) )

        ai = random.randint(1,6)
        print("The computer rolls...." )
        time.sleep(2)
        print("The computer has rolled a " + str(player) )

        if player > ai :
            print("You win")  # notice indentation
        else:
            print("You lose")

        print("Quit? Y/N")
        cont = input()

        if cont == "Y" or cont == "y":
            exit()
        elif cont == "N" or cont == "n":
            pass
        else:
            print("I did not understand that. Playing again.")

游戏的这个版本,在他们玩游戏之后会询问玩家是否退出。如果他们用一个 Y 或 y 去响应, Python 就会调用它的 exit 函数去退出游戏。

更重要的是,你将创建一个称为 dice 的你自己的函数。这个 dice 函数并不会立即运行,事实上,如果在这个阶段你尝试去运行你的游戏,它不会崩溃,但它也不会正式运行。要让 dice 函数真正运行起来做一些事情,你必须在你的代码中去调用它。

在你的现有代码下面增加这个循环,前两行就是上文中的前两行,不需要再次输入,并且要注意哪些需要缩进哪些不需要。要注意缩进格式。

        else:
            print("I did not understand that. Playing again.")

    # main loop
    while True:
        print("Press return to roll your die.")
        roll = input()
        dice()

while True 代码块首先运行。因为 True 被定义为总是真,这个代码块将一直运行,直到 Python 告诉它退出为止。

while True 代码块是一个循环。它首先提示用户去启动这个游戏,然后它调用你的 dice 函数。这就是游戏的开始。当 dice 函数运行结束,根据玩家的回答,你的循环再次运行或退出它。

使用循环来运行程序是编写应用程序最常用的方法。循环确保应用程序保持长时间的可用,以便计算机用户使用应用程序中的函数。

下一步

现在,你已经知道了 Python 编程的基础知识。这个系列的下一篇文章将描述怎么使用 PyGame 去编写一个视频游戏,一个比 turtle 模块有更多功能的模块,但它也更复杂一些。


作者简介:

Seth Kenlon - 一个独立的多媒体大师,自由文化的倡导者,和 UNIX 极客。他同时从事电影和计算机行业。他是基于 slackwarers 的多媒体制作项目的维护者之一, http://slackermedia.info


via: https://opensource.com/article/17/10/python-101

作者:Seth Kenlon 译者:qhwdw 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

摘要:这篇文章我们将对一些各种各样的博客的流行度相对于他们在谷歌上的排名进行一个分析。所有代码可以在 github 上找到。

想法来源

我一直在想,各种各样的博客每天到底都有多少页面浏览量,以及在博客阅读受众中最受欢迎的是什么编程语言。我也很感兴趣的是,它们在谷歌的网站排名是否与它们的受欢迎程度直接相关。

为了回答这些问题,我决定做一个 Scrapy 项目,它将收集一些数据,然后对所获得的信息执行特定的数据分析和数据可视化。

第一部分:Scrapy

我们将使用 Scrapy 为我们的工作,因为它为抓取和对该请求处理后的反馈进行管理提供了干净和健壮的框架。我们还将使用 Splash 来解析需要处理的 Javascript 页面。Splash 使用自己的 Web 服务器充当代理,并处理 Javascript 响应,然后再将其重定向到我们的爬虫进程。

我这里没有描述 Scrapy 的设置,也没有描述 Splash 的集成。你可以在这里找到 Scrapy 的示例,而这里还有 Scrapy+Splash 指南。

获得相关的博客

第一步显然是获取数据。我们需要关于编程博客的谷歌搜索结果。你看,如果我们开始仅仅用谷歌自己来搜索,比如说查询 “Python”,除了博客,我们还会得到很多其它的东西。我们需要的是做一些过滤,只留下特定的博客。幸运的是,有一种叫做 Google 自定义搜索引擎(CSE)的东西,它能做到这一点。还有一个网站 www.blogsearchengine.org,它正好可以满足我们需要,它会将用户请求委托给 CSE,这样我们就可以查看它的查询并重复利用它们。

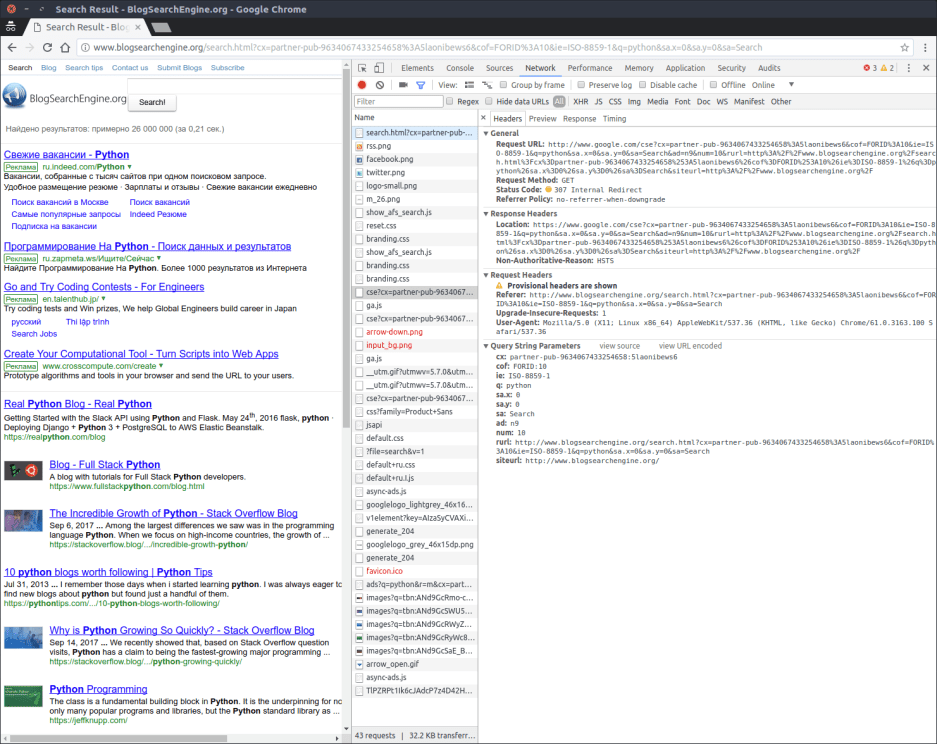
所以,我们要做的是到 www.blogsearchengine.org 网站,搜索 “python”,并在一侧打开 Chrome 开发者工具中的网络标签页。这截图是我们将要看到的:

突出显示的是 blogsearchengine 向谷歌委派的一个搜索请求,所以我们将复制它,并在我们的 scraper 中使用。

这个博客抓取爬行器类会是如下这样的:

class BlogsSpider(scrapy.Spider):
    name = 'blogs'
    allowed_domains = ['cse.google.com']

    def __init__(self, queries):
        super(BlogsSpider, self).__init__()
        self.queries = queries

与典型的 Scrapy 爬虫不同,我们的方法覆盖了 __init__ 方法,它接受额外的参数 queries,它指定了我们想要执行的查询列表。

现在,最重要的部分是构建和执行这个实际的查询。这个过程放在 start_requests 爬虫的方法里面执行,我们愉快地覆盖它:

    def start_requests(self):
        params_dict = {
            'cx': ['partner-pub-9634067433254658:5laonibews6'],
            'cof': ['FORID:10'],
            'ie': ['ISO-8859-1'],
            'q': ['query'],
            'sa.x': ['0'],
            'sa.y': ['0'],
            'sa': ['Search'],
            'ad': ['n9'],
            'num': ['10'],
            'rurl': [
                'http://www.blogsearchengine.org/search.html?cx=partner-pub'
                '-9634067433254658%3A5laonibews6&cof=FORID%3A10&ie=ISO-8859-1&'
                'q=query&sa.x=0&sa.y=0&sa=Search'
            ],
            'siteurl': ['http://www.blogsearchengine.org/']
        }

        params = urllib.parse.urlencode(params_dict, doseq=True)
        url_template = urllib.parse.urlunparse(
            ['https', self.allowed_domains[0], '/cse',
             '', params, 'gsc.tab=0&gsc.q=query&gsc.page=page_num'])
        for query in self.queries:
            for page_num in range(1, 11):
                url = url_template.replace('query', urllib.parse.quote(query))
                url = url.replace('page_num', str(page_num))
                yield SplashRequest(url, self.parse, endpoint='render.html',
                                    args={'wait': 0.5})

在这里你可以看到相当复杂的 params_dict 字典,它控制所有我们之前找到的 Google CSE URL 的参数。然后我们准备好 url_template 里的一切,除了已经填好的查询和页码。我们对每种编程语言请求 10 页,每一页包含 10 个链接,所以是每种语言有 100 个不同的博客用来分析。

在 42-43 行,我使用一个特殊的类 SplashRequest 来代替 Scrapy 自带的 Request 类。它封装了 Splash 库内部的重定向逻辑,所以我们无需为此担心。十分整洁。

最后,这是解析程序:

    def parse(self, response):
        urls = response.css('div.gs-title.gsc-table-cell-thumbnail') \
            .xpath('./a/@href').extract()
        gsc_fragment = urllib.parse.urlparse(response.url).fragment
        fragment_dict = urllib.parse.parse_qs(gsc_fragment)
        page_num = int(fragment_dict['gsc.page'][0])
        query = fragment_dict['gsc.q'][0]
        page_size = len(urls)
        for i, url in enumerate(urls):
            parsed_url = urllib.parse.urlparse(url)
            rank = (page_num - 1) * page_size + i
            yield {
                'rank': rank,
                'url': parsed_url.netloc,
                'query': query
            }

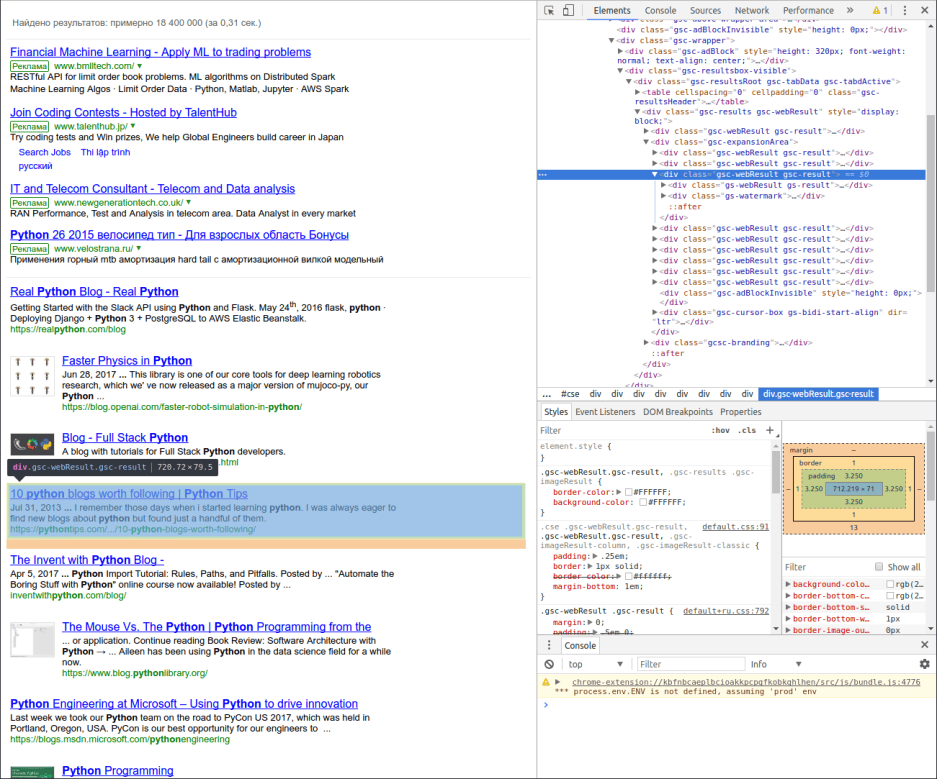
所有 Scraper 的核心和灵魂就是解析器逻辑。可以有多种方法来理解响应页面的结构并构建 XPath 查询字符串。您可以使用 Scrapy shell 尝试并随时调整你的 XPath 查询,而不用运行爬虫。不过我更喜欢可视化的方法。它需要再次用到谷歌 Chrome 开发人员控制台。只需右键单击你想要用在你的爬虫里的元素,然后按下 Inspect。它将打开控制台,并定位到你指定位置的 HTML 源代码。在本例中,我们想要得到实际的搜索结果链接。他们的源代码定位是这样的:

在查看这个元素的描述后我们看到所找的 <div> 有一个 .gsc-table-cell-thumbnail CSS 类,它是 .gs-title <div> 的子元素,所以我们把它放到响应对象的 css 方法(46 行)。然后,我们只需要得到博客文章的 URL。它很容易通过'./a/@href' XPath 字符串来获得,它能从我们的 <div> 直接子元素的 href 属性找到。(LCTT 译注:此处图文对不上)

寻找流量数据

下一个任务是估测每个博客每天得到的页面浏览量。得到这样的数据有各种方式,有免费的,也有付费的。在快速搜索之后,我决定基于简单且免费的原因使用网站 www.statshow.com 来做。爬虫将抓取这个网站,我们在前一步获得的博客的 URL 将作为这个网站的输入参数,获得它们的流量信息。爬虫的初始化是这样的:

class TrafficSpider(scrapy.Spider):
    name = 'traffic'
    allowed_domains = ['www.statshow.com']

    def __init__(self, blogs_data):
        super(TrafficSpider, self).__init__()
        self.blogs_data = blogs_data

blogs_data 应该是以下格式的词典列表:{"rank": 70, "url": "www.stat.washington.edu", "query": "Python"}。

请求构建函数如下:

    def start_requests(self):
        url_template = urllib.parse.urlunparse(
            ['http', self.allowed_domains[0], '/www/{path}', '', '', ''])
        for blog in self.blogs_data:
            url = url_template.format(path=blog['url'])
            request = SplashRequest(url, endpoint='render.html',
                                    args={'wait': 0.5}, meta={'blog': blog})
            yield request

它相当的简单,我们只是把字符串 /www/web-site-url/ 添加到 'www.statshow.com' URL 中。

现在让我们看一下语法解析器是什么样子的:

    def parse(self, response):
        site_data = response.xpath('//div[@id="box_1"]/span/text()').extract()
        views_data = list(filter(lambda r: '$' not in r, site_data))
        if views_data:
            blog_data = response.meta.get('blog')
            traffic_data = {
                'daily_page_views': int(views_data[0].translate({ord(','): None})),
                'daily_visitors': int(views_data[1].translate({ord(','): None}))
            }
            blog_data.update(traffic_data)
            yield blog_data

与博客解析程序类似,我们只是通过 StatShow 示例的返回页面,然后找到包含每日页面浏览量和每日访问者的元素。这两个参数都确定了网站的受欢迎程度,对于我们的分析只需要使用页面浏览量即可 。

第二部分:分析

这部分是分析我们搜集到的所有数据。然后,我们用名为 Bokeh 的库来可视化准备好的数据集。我在这里没有给出运行器和可视化的代码,但是它可以在 GitHub repo 中找到,包括你在这篇文章中看到的和其他一切东西。

最初的结果集含有少许偏离过大的数据,(如 google.com、linkedin.com、Oracle.com 等)。它们显然不应该被考虑。即使其中有些有博客,它们也不是针对特定语言的。这就是为什么我们基于这个 StackOverflow 回答 中所建议的方法来过滤异常值。

语言流行度比较

首先,让我们对所有的语言进行直接的比较,看看哪一种语言在前 100 个博客中有最多的浏览量。

这是能进行这个任务的函数:

def get_languages_popularity(data):
    query_sorted_data = sorted(data, key=itemgetter('query'))
    result = {'languages': [], 'views': []}
    popularity = []
    for k, group in groupby(query_sorted_data, key=itemgetter('query')):
        group = list(group)
        daily_page_views = map(lambda r: int(r['daily_page_views']), group)
        total_page_views = sum(daily_page_views)
        popularity.append((group[0]['query'], total_page_views))
    sorted_popularity = sorted(popularity, key=itemgetter(1), reverse=True)
    languages, views = zip(*sorted_popularity)
    result['languages'] = languages
    result['views'] = views
    return result

在这里,我们首先按语言(词典中的关键字“query”)来分组我们的数据,然后使用 python 的 groupby 函数,这是一个从 SQL 中借来的奇妙函数,从我们的数据列表中生成一组条目,每个条目都表示一些编程语言。然后,在第 14 行我们计算每一种语言的总页面浏览量,然后添加 ('Language', rank) 形式的元组到 popularity 列表中。在循环之后,我们根据总浏览量对流行度数据进行排序,并将这些元组展开到两个单独的列表中,然后在 result 变量中返回它们。

最初的数据集有很大的偏差。我检查了到底发生了什么,并意识到如果我在 blogsearchengine.org 上查询“C”,我就会得到很多无关的链接,其中包含了 “C” 的字母。因此,我必须将 C 排除在分析之外。这种情况几乎不会在 “R” 和其他类似 C 的名称中出现:“C++”、“C”。

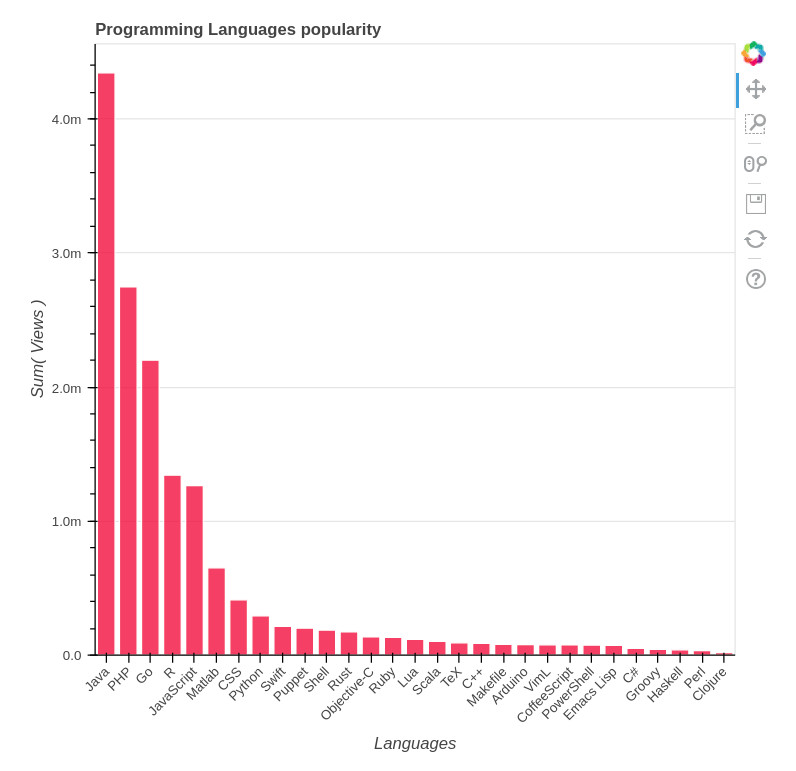
因此,如果我们将 C 从考虑中移除并查看其他语言,我们可以看到如下图:

评估结论:Java 每天有超过 400 万的浏览量,PHP 和 Go 有超过 200 万,R 和 JavaScript 也突破了百万大关。

每日网页浏览量与谷歌排名

现在让我们来看看每日访问量和谷歌的博客排名之间的联系。从逻辑上来说,不那么受欢迎的博客应该排名靠后,但这并没那么简单,因为其他因素也会影响排名,例如,如果在人气较低的博客上的文章更新一些,那么它很可能会首先出现。

数据准备工作以下列方式进行:

def get_languages_popularity(data):
    query_sorted_data = sorted(data, key=itemgetter('query'))
    result = {'languages': [], 'views': []}
    popularity = []
    for k, group in groupby(query_sorted_data, key=itemgetter('query')):
        group = list(group)
        daily_page_views = map(lambda r: int(r['daily_page_views']), group)
        total_page_views = sum(daily_page_views)
        popularity.append((group[0]['query'], total_page_views))
    sorted_popularity = sorted(popularity, key=itemgetter(1), reverse=True)
    languages, views = zip(*sorted_popularity)
    result['languages'] = languages
    result['views'] = views
    return result

该函数接受爬取到的数据和需要考虑的语言列表。我们对这些数据以语言的流行程度进行排序。后来,在类似的语言分组循环中,我们构建了 (rank, views_number) 元组(从 1 开始的排名)被转换为 2 个单独的列表。然后将这一对列表写入到生成的字典中。

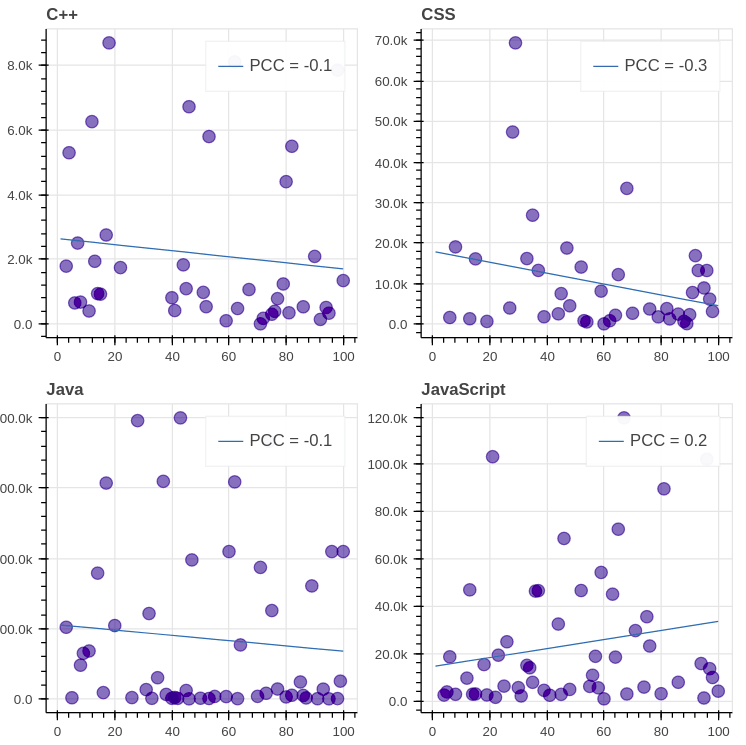
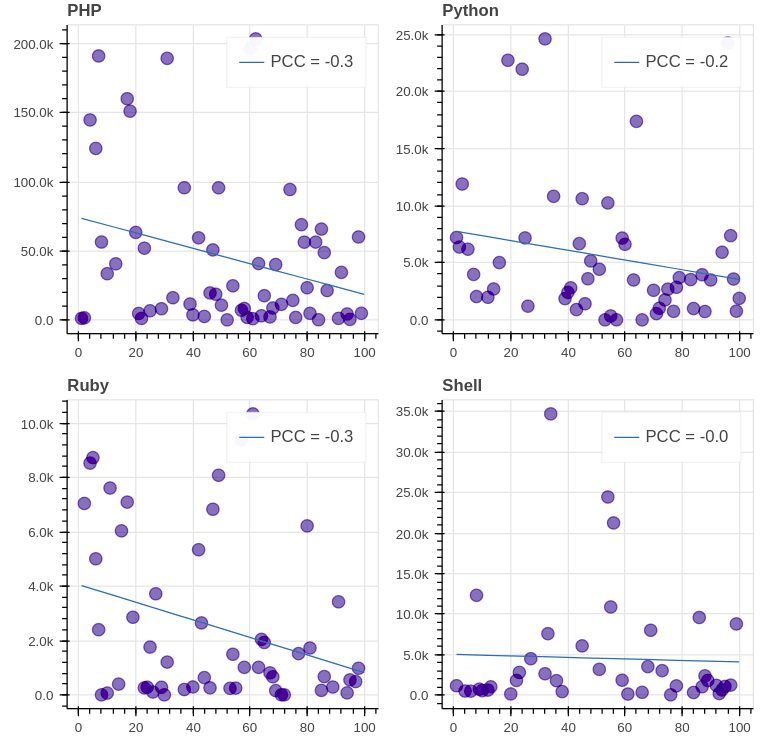
前 8 位 GitHub 语言(除了 C)是如下这些:

评估结论:我们看到,所有图的 PCC (皮尔逊相关系数)都远离 1/-1,这表示每日浏览量与排名之间缺乏相关性。值得注意的是,在大多数图表(8 个中的 7 个)中,相关性是负的,这意味着排名的降低会导致浏览量的减少。

结论

因此,根据我们的分析,Java 是目前最流行的编程语言,其次是 PHP、Go、R 和 JavaScript。在日常浏览量和谷歌排名上,排名前 8 的语言都没有很强的相关性,所以即使你刚刚开始写博客,你也可以在搜索结果中获得很高的评价。不过,成为热门博客究竟需要什么,可以留待下次讨论。

这些结果是相当有偏差的,如果没有更多的分析,就不能过分的考虑这些结果。首先,在较长的一段时间内收集更多的流量信息,然后分析每日浏览量和排名的平均值(中值)值是一个好主意。也许我以后还会再回来讨论这个。

引用

  1. 抓取:

    1. blog.scrapinghub.com: Handling Javascript In Scrapy With Splash
    2. BlogSearchEngine.org
    3. twingly.com: Twingly Real-Time Blog Search
    4. searchblogspot.com: finding blogs on blogspot platform
  2. 流量评估:

    1. labnol.org: Find Out How Much Traffic a Website Gets
    2. quora.com: What are the best free tools that estimate visitor traffic…
    3. StatShow.com: The Stats Maker

via: https://www.databrawl.com/2017/10/08/blog-analysis/

作者:Serge Mosin 译者:Chao-zhi 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

运用这些很棒的 Python 爬虫工具来获取你需要的数据。

 title=

在一个理想的世界里,你需要的所有数据都将以公开而文档完备的格式清晰地展现,你可以轻松地下载并在任何你需要的地方使用。

然而,在真实世界里,数据是凌乱的,极少被打包成你需要的样子,要么经常是过期的。

你所需要的信息经常是潜藏在一个网站里。相比一些清晰地、有调理地呈现数据的网站,更多的网站则不是这样的。 爬取数据 crawling 、 挖掘数据 scraping 、加工数据、整理数据这些是获取整个网站结构来绘制网站拓扑来收集数据所必须的活动,这些可以是以网站的格式储存的或者是储存在一个专有数据库中。

也许在不久的将来,你需要通过爬取和挖掘来获得一些你需要的数据,当然你几乎肯定需要进行一点点的编程来正确的获取。你要怎么做取决于你自己,但是我发现 Python 社区是一个很好的提供者,它提供了工具、框架以及文档来帮助你从网站上获取数据。

在我们进行之前,这里有一个小小的请求:在你做事情之前请思考,以及请耐心。抓取这件事情并不简单。不要把网站爬下来只是复制一遍,并其它人的工作当成是你自己的东西(当然,没有许可)。要注意版权和许可,以及你所爬行的内容应用哪一个标准。尊重 robots.txt 文件。不要频繁的针对一个网站,这将导致真实的访问者会遇到访问困难的问题。

在知晓这些警告之后,这里有一些很棒的 Python 网站爬虫工具,你可以用来获得你需要的数据。

Pyspider

让我们先从 pyspider 开始介绍。这是一个带有 web 界面的网络爬虫,让与使之容易跟踪多个爬虫。其具有扩展性,支持多个后端数据库和消息队列。它还具有一些方便的特性,从优先级到再次访问抓取失败的页面,此外还有通过时间顺序来爬取和其他的一些特性。Pyspider 同时支持 Python 2 和 Python 3。为了实现一个更快的爬取,你可以在分布式的环境下一次使用多个爬虫进行爬取。

Pyspyder 的基本用法都有良好的 文档说明 ,包括简单的代码片段。你能通过查看一个 在线的样例 来体验用户界面。它在 Apache 2 许可证下开源,Pyspyder 仍然在 GitHub 上积极地开发。

MechanicalSoup

MechanicalSoup 是一个基于极其流行而异常多能的 HTML 解析库 Beautiful Soup 建立的爬虫库。如果你的爬虫需要相当的简单,但是又要求检查一些选择框或者输入一些文字,而你又不想为这个任务单独写一个爬虫,那么这会是一个值得考虑的选择。

MechanicalSoup 在 MIT 许可证下开源。查看 GitHub 上该项目的 example.py 样例文件来获得更多的用法。不幸的是,到目前为止,这个项目还没有一个很好的文档。

Scrapy

Scrapy 是一个有着活跃社区支持的抓取框架,在那里你可以建造自己的抓取工具。除了爬取和解析工具,它还能将它收集的数据以 JSON 或者 CSV 之类的格式轻松输出,并存储在一个你选择的后端数据库。它还有许多内置的任务扩展,例如 cookie 处理、代理欺骗、限制爬取深度等等,同时还可以建立你自己附加的 API。

要了解 Scrapy,你可以查看网上的文档或者是访问它诸多的社区资源,包括一个 IRC 频道、Reddit 子版块以及关注他们的 StackOverflow 标签。Scrapy 的代码在 3 句版 BSD 许可证下开源,你可以在 GitHub 上找到它们。

如果你完全不熟悉编程,Portia 提供了一个易用的可视化的界面。scrapinghub.com 则提供一个托管的版本。

其它

  • Cola 自称它是个“高级的分布式爬取框架”,如果你在寻找一个 Python 2 的方案,这也许会符合你的需要,但是注意它已经有超过两年没有更新了。
  • Demiurge 是另一个可以考虑的潜在候选者,它同时支持 Python 2和 Python 3,虽然这个项目的发展较为缓慢。
  • 如果你要解析一些 RSS 和 Atom 数据,Feedparser 或许是一个有用的项目。
  • Lassie 让从网站检索像说明、标题、关键词或者是图片一类的基本内容变得简单。
  • RoboBrowser 是另一个简单的库,它基于 Python 2 或者 Python 3,它具有按钮点击和表格填充的基本功能。虽然它有一段时间没有更新了,但是它仍然是一个不错的选择。

这远不是一个完整的列表,当然,如果你是一个编程专家,你可以选择采取你自己的方法而不是使用这些框架中的一个。或者你发现一个用其他语言编写的替代品。例如 Python 编程者可能更喜欢 Python 附带的 Selenium,它可以在不使用实际浏览器的情况下进行爬取。如果你有喜欢的爬取和挖掘工具,请在下面评论让我们知道。

(题图:You as a Machine. Modified by Rikki Endsley. CC BY-SA 2.0)


via: https://opensource.com/resources/python/web-scraper-crawler

作者:Jason Baker 译者:ZH1122 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

一次掌握一个技巧,更好地学习安卓

距离安迪·鲁宾和他的团队着手开发一个希望颠覆传统手机操作模式的操作系统已经过去 12 年了,这套系统有可能让手机或者智能机给消费者以及软件开发人员带来全新的体验。之前的智能机仅限于收发短信和查看电子邮件(当然还可以打电话),给用户和开发者带来很大的限制。

安卓,作为打破这个枷锁的系统,拥有非常优秀的框架设计,给大家提供的不仅仅是一组有限的功能,更多的是自由的探索。有人会说 iPhone 才是手机产业的颠覆产品,不过我们说的不是 iPhone 有多么酷(或者多么贵,是吧?),它还是有限制的,而这是我们从来都不希望有的。

不过,就像本大叔说的,能力越大责任越大,我们也需要更加认真对待安卓应用的设计方式。我看到很多教程都忽略了向初学者传递这个理念,在动手之前请先充分理解系统架构。他们只是把一堆的概念和代码丢给读者,却没有解释清楚相关的优缺点,它们对系统的影响,以及该用什么不该用什么等等。

在这篇文章里,我们将介绍一些初学者以及中级开发人员都应该掌握的技巧,以帮助更好地理解安卓框架。后续我们还会在这个系列里写更多这样的关于实用技巧的文章。我们开始吧。

1、 @+id 和 @id 的区别

要在 Java 代码里访问一个图形控件(或组件),或者是要让它成为其他控件的依赖,我们需要一个唯一的值来引用它。这个唯一值用 android:id 属性来定义,本质上就是把用户提供的 id 附加到 @+id/ 后面,写入到 id 资源文件,供其他控件使用。一个 Toolbar 的 id 可以这样定义,

android:id="@+id/toolbar"

然后这个 id 值就能被 findViewById(…) 识别,这个函数会在资源文件里查找 id,或者直接从 R.id 路径引用,然后返回所查找的 View 的类型。

而另一种,@id,和 findViewById(…) 行为一样 - 也会根据提供的 id 查找组件,不过仅限于布局时使用。一般用来布置相关控件。

android:layout_below="@id/toolbar"

2、 使用 @string 资源为 XML 提供字符串

简单来说,就是不要在 XML 里直接用字符串。原因很简单。当我们在 XML 里直接使用了字符串,我们一般会在其它地方再次用到同样的字符串。想像一下当我们需要在不同的地方调整同一个字符串的噩梦,而如果使用字符串资源就只改一个地方就够了。另一个好处是,使用资源文件可以提供多国语言支持,因为可以为不同的语言创建相应的字符串资源文件。

android:text="My Awesome Application"

当你直接使用字符串时,你会在 Android Studio 里收到警告,提示说应该把写死的字符串改成字符串资源。可以点击这个提示,然后按下 ALT + ENTER 打开字符串编辑。你也可以直接打开 res 目录下的 values 目录里的 strings.xml 文件,然后像下面这样声明一个字符串资源。

<string name="app_name">My Awesome Application</string>

然后用它来替换写死的字符串,

android:text="@string/app_name"

3、 使用 @android 和 ?attr 常量

尽量使用系统预先定义的常量而不是重新声明。举个例子,在布局中有几个地方要用白色或者 #ffffff 颜色值。不要每次都直接用 #ffffff 数值,也不要自己为白色重新声明资源,我们可以直接用这个,

@android:color/white

安卓预先定义了很多常用的颜色常量,比如白色,黑色或粉色。最经典的应用场景是透明色:

@android:color/transparent

另一个引用常量的方式是 ?attr,用来将预先定义的属性值赋值给不同的属性。举个自定义 Toolbar 的例子。这个 Toolbar 需要定义宽度和高度。宽度通常可以设置为 MATCH_PARENT,但高度呢?我们大多数人都没有注意设计指导,只是简单地随便设置一个看上去差不多的值。这样做不对。不应该随便自定义高度,而应该这样做,

android:layout_height="?attr/actionBarSize"

?attr 的另一个应用是点击视图时画水波纹效果。SelectableItemBackground 是一个预定义的 drawable,任何视图需要增加波纹效果时可以将它设为背景:

android:background="?attr/selectableItemBackground"

也可以用这个:

android:background="?attr/selectableItemBackgroundBorderless"

来显示无边框波纹。

4、 SP 和 DP 的区别

虽然这两个没有本质上的区别,但知道它们是什么以及在什么地方适合用哪个很重要。

SP 的意思是缩放无关像素,一般建议用于 TextView,首先文字不会因为显示密度不同而显示效果不一样,另外 TextView 的内容还需要根据用户设定做拉伸,或者只调整字体大小。

其他需要定义尺寸和位置的地方,可以使用 DP,也就是密度无关像素。之前说过,DP 和 SP 的性质是一样的,只是 DP 会根据显示密度自动拉伸,因为安卓系统会动态计算实际显示的像素,这样就可以让使用 DP 的组件在不同显示密度的设备上都可以拥有相同的显示效果。

5、 Drawable 和 Mipmap 的应用

这两个最让人困惑的是 - drawable 和 mipmap 有多少差异?

虽然这两个好像有同样的用途,但它们设计目的不一样。mipmap 是用来储存图标的,而 drawable 用于任何其他格式。我们可以看一下系统内部是如何使用它们的,就知道为什么不能混用了。

你可以看到你的应用里有几个 mipmap 和 drawable 目录,每一个分别代表不同的显示分辨率。当系统从 drawable 目录读取资源时,只会根据当前设备的显示密度选择确定的目录。然而,在读取 mipmap 时,系统会根据需要选择合适的目录,而不仅限于当前显示密度,主要是因为有些启动器会故意显示较大的图标,所以系统会使用较大分辨率的资源。

总之,用 mipmap 来存放图标或标记图片,可以在不同显示密度的设备上看到分辨率变化,而其它根据需要显示的图片资源都用 drawable。

比如说,Nexus 5 的显示分辨率是 xxhdpi。当我们把图标放到 mipmap 目录里时,所有 mipmap 目录都将读入内存。而如果放到 drawable 里,只有 drawable-xxhdpi 目录会被读取,其他目录都会被忽略。

6、 使用矢量图形

为了支持不同显示密度的屏幕,将同一个资源的多个版本(大小)添加到项目里是一个很常见的技巧。这种方式确实有用,不过它也会带来一定的性能开支,比如更大的 apk 文件以及额外的开发工作。为了消除这种影响,谷歌的安卓团队发布了新增的矢量图形。

矢量图形是用 XML 描述的 SVG(可拉伸矢量图形),是用点、直线和曲线组合以及填充颜色绘制出的图形。正因为矢量图形是由点和线动态画出来的,在不同显示密度下拉伸也不会损失分辨率。而矢量图形带来的另一个好处是更容易做动画。往一个 AnimatedVectorDrawable 文件里添加多个矢量图形就可以做出动画,而不用添加多张图片然后再分别处理。

<vector xmlns:android="http://schemas.android.com/apk/res/android"
    android:width="24dp" 
    android:height="24dp" 
    android:viewportWidth="24.0" 
    android:viewportHeight="24.0">

    <path android:fillColor="#69cdff" android:pathData="M3,18h18v-2L3,16v2zM3,13h18v-2L3,11v2zM3,6v2h18L21,6L3,6z"/>

</vector>

上面的向量定义可以画出下面的图形,

要在你的安卓项目里添加矢量图形,可以右键点击你项目里的应用模块,然后选择 New >> Vector Assets。然后会打开 Assets Studio,你可以有两种方式添加矢量图形。第一种是从 Material 图标里选择,另一种是选择本地的 SVG 或 PSD 文件。

谷歌建议与应用相关都使用 Material 图标,来保持安卓的连贯性和统一体验。这里有全部图标,记得看一下。

7、 设定边界的开始和结束

这是人们最容易忽略的地方之一。边界!增加边界当然很简单,但是如果要考虑支持很旧的平台呢?

边界的“开始”和“结束”分别是“左”和“右”的超集,所以如果应用的 minSdkVersion 是 17 或更低,边界和填充的“开始”和“结束”定义是旧的“左”/“右”所需要的。在那些没有定义“开始”和“结束”的系统上,这两个定义可以被安全地忽略。可以像下面这样声明:

android:layout_marginEnd="20dp"
android:paddingStart="20dp"

8、 使用 Getter/Setter 生成工具

在创建一个容器类(只是用来简单的存放一些变量数据)时很烦的一件事情是写多个 getter 和 setter,复制/粘贴该方法的主体再为每个变量重命名。

幸运的是,Android Studio 有一个解决方法。可以这样做,在类里声明你需要的所有变量,然后打开 Toolbar >> Code。快捷方式是 ALT + Insert。点击 Code 会显示 Generate,点击它会出来很多选项,里面有 Getter 和 Setter 选项。在保持焦点在你的类页面然后点击,就会为当前类添加所有的 getter 和 setter(有需要的话可以再去之前的窗口操作)。很爽吧。

9、 使用 Override/Implement 生成工具

这是另一个很好用的生成工具。自定义一个类然后再扩展很容易,但是如果要扩展你不熟悉的类呢。比如说 PagerAdapter,你希望用 ViewPager 来展示一些页面,那就需要定制一个 PagerAdapter 并实现它的重载方法。但是具体有哪些方法呢?Android Studio 非常贴心地为自定义类强行添加了一个构造函数,或者可以用快捷键(ALT + Enter),但是父类 PagerAdapter 里的其他(虚拟)方法需要自己手动添加,我估计大多数人都觉得烦。

要列出所有可以重载的方法,可以点击 Code >> Generate and Override methods 或者 Implement methods,根据你的需要。你还可以为你的类选择多个方法,只要按住 Ctrl 再选择方法,然后点击 OK。

10、 正确理解 Context

Context 有点恐怖,我估计许多初学者从没有认真理解过 Context 类的结构 - 它是什么,为什么到处都要用到它。

简单地说,它将你能从屏幕上看到的所有内容都整合在一起。所有的视图(或者它们的扩展)都通过 Context 绑定到当前的环境。Context 用来管理应用层次的资源,比如说显示密度,或者当前的关联活动。活动、服务和应用都实现了 Context 类的接口来为其他关联组件提供内部资源。举个添加到 MainActivity 的 TextView 的例子。你应该注意到了,在创建一个对象的时候,TextView 的构造函数需要 Context 参数。这是为了获取 TextView 里定义到的资源。比如说,TextView 需要在内部用到 Roboto 字体。这样的话,TextView 需要 Context。而且在我们将 Context(或者 this)传递给 TextView 的时候,也就是告诉它绑定当前活动的生命周期。

另一个 Context 的关键应用是初始化应用层次的操作,比如初始化一个库。库的生命周期和应用是不相关的,所以它需要用 getApplicationContext() 来初始化,而不是用 getContext 或 this 或 getActivity()。掌握正确使用不同 Context 类型非常重要,可以避免内存泄漏。另外,要用到 Context 来启动一个活动或服务。还记得 startActivity(…) 吗?当你需要在一个非活动类里切换活动时,你需要一个 Context 对象来调用 startActivity 方法,因为它是 Context 类的方法,而不是 Activity 类。

getContext().startActivity(getContext(), SecondActivity.class);

如果你想了解更多 Context 的行为,可以看看这里或这里。第一个是一篇关于 Context 的很好的文章,介绍了在哪些地方要用到它。而另一个是安卓关于 Context 的文档,全面介绍了所有的功能 - 方法,静态标识以及更多。

奖励 #1: 格式化代码

有人会不喜欢整齐,统一格式的代码吗?好吧,几乎我们每一个人,在写一个超过 1000 行的类的时候,都希望我们的代码能有合适的结构。而且,并不仅仅大的类才需要格式化,每一个小模块类也需要让代码保持可读性。

使用 Android Studio,或者任何 JetBrains IDE,你都不需要自己手动整理你的代码,像增加缩进或者 = 之前的空格。就按自己希望的方式写代码,在想要格式化的时候,如果是 Windows 系统可以按下 ALT + CTRL + L,Linux 系统按下 ALT + CTRL + SHIFT + L。代码就自动格式化好了

奖励 #2: 使用库

面向对象编程的一个重要原则是增加代码的可重用性,或者说减少重新发明轮子的习惯。很多初学者错误地遵循了这个原则。这条路有两个方向,

  • 不用任何库,自己写所有的代码。
  • 用库来处理所有事情。

不管哪个方向走到底都是不对的。如果你彻底选择第一个方向,你将消耗大量的资源,仅仅是为了满足自己拥有一切的骄傲。很可能你的代码没有做过替代库那么多的测试,从而增加模块出问题的可能。如果资源有限,不要重复发明轮子。直接用经过测试的库,在有了明确目标以及充分的资源后,可以用自己的可靠代码来替换这个库。

而彻底走向另一个方向,问题更严重 - 别人代码的可靠性。不要习惯于所有事情都依赖于别人的代码。在不用太多资源或者自己能掌控的情况下尽量自己写代码。你不需要用库来自定义一个 TypeFaces(字体),你可以自己写一个。

所以要记住,在这两个极端中间平衡一下 - 不要重新创造所有事情,也不要过分依赖外部代码。保持中立,根据自己的能力写代码。

这篇文章最早发布在 What’s That Lambda 上。请访问网站阅读更多关于 Android、Node.js、Angular.js 等等类似文章。


via: https://android.jlelse.eu/12-practices-every-android-beginner-should-know-cd43c3710027

作者:Nilesh Singh 译者:zpl1025 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

探索函数式编程,通过它让你的程序更具有可读性和易于调试
当 Brendan Eich 在 1995 年创造 JavaScript 时,他原本打算将 Scheme 移植到浏览器里 。Scheme 作为 Lisp 的方言,是一种函数式编程语言。而当 Eich 被告知新的语言应该是一种可以与 Java 相比的脚本语言后,他最终确立了一种拥有 C 风格语法的语言(也和 Java 一样),但将函数视作一等公民。而 Java 直到版本 8 才从技术上将函数视为一等公民,虽然你可以用匿名类来模拟它。这个特性允许 JavaScript 通过函数式范式编程。

JavaScript 是一个多范式语言,允许你自由地混合和使用面向对象式、过程式和函数式的编程范式。最近,函数式编程越来越火热。在诸如 Angular 和 React 这样的框架中,通过使用不可变数据结构可以切实提高性能。不可变是函数式编程的核心原则,它以及纯函数使得编写和调试程序变得更加容易。使用函数来代替程序的循环可以提高程序的可读性并使它更加优雅。总之,函数式编程拥有很多优点。

什么不是函数式编程

在讨论什么是函数式编程前,让我们先排除那些不属于函数式编程的东西。实际上它们是你需要丢弃的语言组件(再见,老朋友):

  • 循环:

    • while
    • do...while
    • for
    • for...of
    • for...in
  • 用 var 或者 let 来声明变量
  • 没有返回值的函数
  • 改变对象的属性 (比如: o.x = 5;)
  • 改变数组本身的方法:

    • copyWithin
    • fill
    • pop
    • push
    • reverse
    • shift
    • sort
    • splice
    • unshift
  • 改变映射本身的方法:

    • clear
    • delete
    • set
  • 改变集合本身的方法:

    • add
    • clear
    • delete

脱离这些特性应该如何编写程序呢?这是我们将在后面探索的问题。

纯函数

你的程序中包含函数不一定意味着你正在进行函数式编程。函数式范式将 纯函数 pure function 和 非纯函数 impure function 区分开。鼓励你编写纯函数。纯函数必须满足下面的两个属性:

  • 引用透明:函数在传入相同的参数后永远返回相同的返回值。这意味着该函数不依赖于任何可变状态。
  • 无副作用:函数不能导致任何副作用。副作用可能包括 I/O(比如向终端或者日志文件写入),改变一个不可变的对象,对变量重新赋值等等。

我们来看一些例子。首先,multiply 就是一个纯函数的例子,它在传入相同的参数后永远返回相同的返回值,并且不会导致副作用。

function multiply(a, b) {
  return a * b;
}

下面是非纯函数的例子。canRide 函数依赖捕获的 heightRequirement 变量。被捕获的变量不一定导致一个函数是非纯函数,除非它是一个可变的变量(或者可以被重新赋值)。这种情况下使用 let 来声明这个变量,意味着可以对它重新赋值。multiply 函数是非纯函数,因为它会导致在 console 上输出。

let heightRequirement = 46;

// Impure because it relies on a mutable (reassignable) variable.
function canRide(height) {
  return height >= heightRequirement;
}

// Impure because it causes a side-effect by logging to the console.
function multiply(a, b) {
  console.log('Arguments: ', a, b);
  return a * b;
}

下面的列表包含着 JavaScript 内置的非纯函数。你可以指出它们不满足两个属性中的哪个吗?

  • console.log
  • element.addEventListener
  • Math.random
  • Date.now
  • $.ajax (这里 $ 代表你使用的 Ajax 库)

理想的程序中所有的函数都是纯函数,但是从上面的函数列表可以看出,任何有意义的程序都将包含非纯函数。大多时候我们需要进行 AJAX 调用,检查当前日期或者获取一个随机数。一个好的经验法则是遵循 80/20 规则:函数中有 80% 应该是纯函数,剩下的 20% 的必要性将不可避免地是非纯函数。

使用纯函数有几个优点:

  • 它们很容易导出和调试,因为它们不依赖于可变的状态。
  • 返回值可以被缓存或者“记忆”来避免以后重复计算。
  • 它们很容易测试,因为没有需要模拟(mock)的依赖(比如日志,AJAX,数据库等等)。

你编写或者使用的函数返回空(换句话说它没有返回值),那代表它是非纯函数。

不变性

让我们回到捕获变量的概念上。来看看 canRide 函数。我们认为它是一个非纯函数,因为 heightRequirement 变量可以被重新赋值。下面是一个构造出来的例子来说明如何用不可预测的值来对它重新赋值。

let heightRequirement = 46;

function canRide(height) {
  return height >= heightRequirement;
}

// Every half second, set heightRequirement to a random number between 0 and 200.
setInterval(() => heightRequirement = Math.floor(Math.random() * 201), 500);

const mySonsHeight = 47;

// Every half second, check if my son can ride.
// Sometimes it will be true and sometimes it will be false.
setInterval(() => console.log(canRide(mySonsHeight)), 500);

我要再次强调被捕获的变量不一定会使函数成为非纯函数。我们可以通过只是简单地改变 heightRequirement 的声明方式来使 canRide 函数成为纯函数。

const heightRequirement = 46;

function canRide(height) {
  return height >= heightRequirement;
}

通过用 const 来声明变量意味着它不能被再次赋值。如果尝试对它重新赋值,运行时引擎将抛出错误;那么,如果用对象来代替数字来存储所有的“常量”怎么样?

const constants = {
  heightRequirement: 46,
  // ... other constants go here
};

function canRide(height) {
  return height >= constants.heightRequirement;
}

我们用了 const ,所以这个变量不能被重新赋值,但是还有一个问题:这个对象可以被改变。下面的代码展示了,为了真正使其不可变,你不仅需要防止它被重新赋值,你也需要不可变的数据结构。JavaScript 语言提供了 Object.freeze 方法来阻止对象被改变。

'use strict';

// CASE 1: 对象的属性是可变的,并且变量可以被再次赋值。
let o1 = { foo: 'bar' };

// 改变对象的属性
o1.foo = 'something different';

// 对变量再次赋值
o1 = { message: "I'm a completely new object" };


// CASE 2: 对象的属性还是可变的,但是变量不能被再次赋值。
const o2 = { foo: 'baz' };

// 仍然能改变对象
o2.foo = 'Something different, yet again';

// 不能对变量再次赋值
// o2 = { message: 'I will cause an error if you uncomment me' }; // Error!


// CASE 3: 对象的属性是不可变的,但是变量可以被再次赋值。
let o3 = Object.freeze({ foo: "Can't mutate me" });

// 不能改变对象的属性
// o3.foo = 'Come on, uncomment me. I dare ya!'; // Error!

// 还是可以对变量再次赋值
o3 = { message: "I'm some other object, and I'm even mutable -- so take that!" };


// CASE 4: 对象的属性是不可变的,并且变量不能被再次赋值。这是我们想要的!!!!!!!!
const o4 = Object.freeze({ foo: 'never going to change me' });

// 不能改变对象的属性
// o4.foo = 'talk to the hand' // Error!

// 不能对变量再次赋值
// o4 = { message: "ain't gonna happen, sorry" }; // Error

不变性适用于所有的数据结构,包括数组、映射和集合。它意味着不能调用例如 Array.prototype.push 等会导致本身改变的方法,因为它会改变已经存在的数组。可以通过创建一个含有原来元素和新加元素的新数组,而不是将新元素加入一个已经存在的数组。其实所有会导致数组本身被修改的方法都可以通过一个返回修改好的新数组的函数代替。

'use strict';

const a = Object.freeze([4, 5, 6]);

// Instead of: a.push(7, 8, 9);
const b = a.concat(7, 8, 9);

// Instead of: a.pop();
const c = a.slice(0, -1);

// Instead of: a.unshift(1, 2, 3);
const d = [1, 2, 3].concat(a);

// Instead of: a.shift();
const e = a.slice(1);

// Instead of: a.sort(myCompareFunction);
const f = R.sort(myCompareFunction, a); // R = Ramda

// Instead of: a.reverse();
const g = R.reverse(a); // R = Ramda

// 留给读者的练习:
// copyWithin
// fill
// splice

映射 和 集合 也很相似。可以通过返回一个新的修改好的映射或者集合来代替使用会修改其本身的函数。

const map = new Map([
  [1, 'one'],
  [2, 'two'],
  [3, 'three']
]);

// Instead of: map.set(4, 'four');
const map2 = new Map([...map, [4, 'four']]);

// Instead of: map.delete(1);
const map3 = new Map([...map].filter(([key]) => key !== 1));

// Instead of: map.clear();
const map4 = new Map();
const set = new Set(['A', 'B', 'C']);

// Instead of: set.add('D');
const set2 = new Set([...set, 'D']);

// Instead of: set.delete('B');
const set3 = new Set([...set].filter(key => key !== 'B'));

// Instead of: set.clear();
const set4 = new Set();

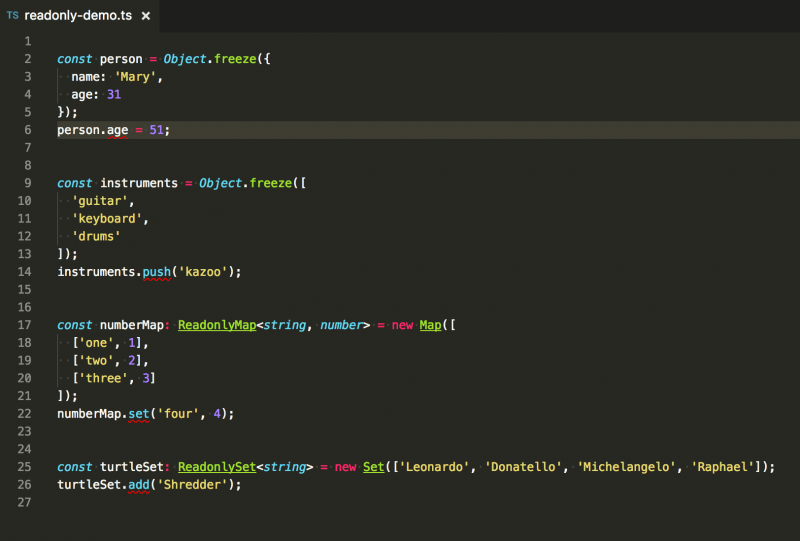
我想提一句如果你在使用 TypeScript(我非常喜欢 TypeScript),你可以用 Readonly<T>、ReadonlyArray<T>、ReadonlyMap<K, V> 和 ReadonlySet<T> 接口来在编译期检查你是否尝试更改这些对象,有则抛出编译错误。如果在对一个对象字面量或者数组调用 Object.freeze,编译器会自动推断它是只读的。由于映射和集合在其内部表达,所以在这些数据结构上调用 Object.freeze 不起作用。但是你可以轻松地告诉编译器它们是只读的变量。
 title=

TypeScript 只读接口

好,所以我们可以通过创建新的对象来代替修改原来的对象,但是这样不会导致性能损失吗?当然会。确保在你自己的应用中做了性能测试。如果你需要提高性能,可以考虑使用 Immutable.js。Immutable.js 用持久的数据结构 实现了链表、堆栈、映射、集合和其他数据结构。使用了如同 Clojure 和 Scala 这样的函数式语言中相同的技术。

// Use in place of `[]`.
const list1 = Immutable.List(['A', 'B', 'C']);
const list2 = list1.push('D', 'E');

console.log([...list1]); // ['A', 'B', 'C']
console.log([...list2]); // ['A', 'B', 'C', 'D', 'E']


// Use in place of `new Map()`
const map1 = Immutable.Map([
  ['one', 1],
  ['two', 2],
  ['three', 3]
]);
const map2 = map1.set('four', 4);

console.log([...map1]); // [['one', 1], ['two', 2], ['three', 3]]
console.log([...map2]); // [['one', 1], ['two', 2], ['three', 3], ['four', 4]]


// Use in place of `new Set()`
const set1 = Immutable.Set([1, 2, 3, 3, 3, 3, 3, 4]);
const set2 = set1.add(5);

console.log([...set1]); // [1, 2, 3, 4]
console.log([...set2]); // [1, 2, 3, 4, 5]

函数组合

记不记得在中学时我们学过一些像 (f ∘ g)(x) 的东西?你那时可能想,“我什么时候会用到这些?”,好了,现在就用到了。你准备好了吗?f ∘ g读作 “函数 f 和函数 g 组合”。对它的理解有两种等价的方式,如等式所示: (f ∘ g)(x) = f(g(x))。你可以认为 f ∘ g 是一个单独的函数,或者视作将调用函数 g 的结果作为参数传给函数 f。注意这些函数是从右向左依次调用的,先执行 g,接下来执行 f。

关于函数组合的几个要点:

  1. 我们可以组合任意数量的函数(不仅限于 2 个)。
  2. 组合函数的一个方式是简单地把一个函数的输出作为下一个函数的输入(比如 f(g(x)))。
// h(x) = x + 1
// number -> number
function h(x) {
  return x + 1;
}

// g(x) = x^2
// number -> number
function g(x) {
  return x * x;
}

// f(x) = convert x to string
// number -> string
function f(x) {
  return x.toString();
}

// y = (f ∘ g ∘ h)(1)
const y = f(g(h(1)));
console.log(y); // '4'

Ramda 和 lodash 之类的库提供了更优雅的方式来组合函数。我们可以在更多的在数学意义上处理函数组合,而不是简单地将一个函数的返回值传递给下一个函数。我们可以创建一个由这些函数组成的单一复合函数(就是 (f ∘ g)(x))。

// h(x) = x + 1
// number -> number
function h(x) {
  return x + 1;
}

// g(x) = x^2
// number -> number
function g(x) {
  return x * x;
}

// f(x) = convert x to string
// number -> string
function f(x) {
  return x.toString();
}

// R = Ramda
// composite = (f ∘ g ∘ h)
const composite = R.compose(f, g, h);

// Execute single function to get the result.
const y = composite(1);
console.log(y); // '4'

好了,我们可以在 JavaScript 中组合函数了。接下来呢?好,如果你已经入门了函数式编程,理想中你的程序将只有函数的组合。代码里没有循环(for, for...of, for...in, while, do),基本没有。你可能觉得那是不可能的。并不是这样。我们下面的两个话题是:递归和高阶函数。

递归

假设你想实现一个计算数字的阶乘的函数。 让我们回顾一下数学中阶乘的定义:

n! = n * (n-1) * (n-2) * ... * 1.

n! 是从 n 到 1 的所有整数的乘积。我们可以编写一个循环轻松地计算出结果。

function iterativeFactorial(n) {
  let product = 1;
  for (let i = 1; i <= n; i++) {
    product *= i;
  }
  return product;
}

注意 product 和 i 都在循环中被反复重新赋值。这是解决这个问题的标准过程式方法。如何用函数式的方法解决这个问题呢?我们需要消除循环,确保没有变量被重新赋值。递归是函数式程序员的最有力的工具之一。递归需要我们将整体问题分解为类似整体问题的子问题。

计算阶乘是一个很好的例子,为了计算 n! 我们需要将 n 乘以所有比它小的正整数。它的意思就相当于:

n! = n * (n-1)!

啊哈!我们发现了一个解决 (n-1)! 的子问题,它类似于整个问题 n!。还有一个需要注意的地方就是基础条件。基础条件告诉我们何时停止递归。 如果我们没有基础条件,那么递归将永远持续。 实际上,如果有太多的递归调用,程序会抛出一个堆栈溢出错误。啊哈!

function recursiveFactorial(n) {
  // Base case -- stop the recursion
  if (n === 0) {
    return 1; // 0! is defined to be 1.
  }
  return n * recursiveFactorial(n - 1);
}

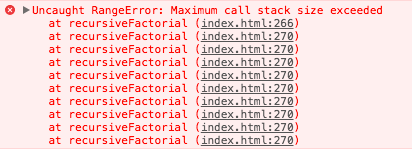
然后我们来计算 recursiveFactorial(20000) 因为……,为什么不呢?当我们这样做的时候,我们得到了这个结果:
 title=

堆栈溢出错误

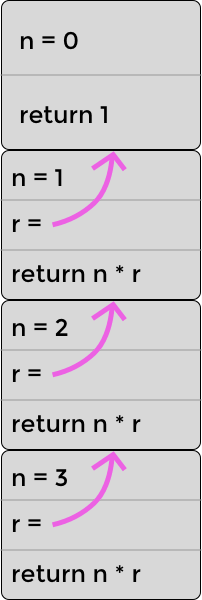
这里发生了什么?我们得到一个堆栈溢出错误!这不是无穷的递归导致的。我们已经处理了基础条件(n === 0 的情况)。那是因为浏览器的堆栈大小是有限的,而我们的代码使用了越过了这个大小的堆栈。每次对 recursiveFactorial 的调用导致了新的帧被压入堆栈中,就像一个盒子压在另一个盒子上。每当 recursiveFactorial 被调用,一个新的盒子被放在最上面。下图展示了在计算 recursiveFactorial(3) 时堆栈的样子。注意在真实的堆栈中,堆栈顶部的帧将存储在执行完成后应该返回的内存地址,但是我选择用变量 r 来表示返回值,因为 JavaScript 开发者一般不需要考虑内存地址。
 title=")

递归计算 3! 的堆栈(三次乘法)

你可能会想象当计算 n = 20000 时堆栈会更高。我们可以做些什么优化它吗?当然可以。作为 ES2015 (又名 ES6) 标准的一部分,有一个优化用来解决这个问题。它被称作 尾调用优化 proper tail calls optimization (PTC)。当递归函数做的最后一件事是调用自己并返回结果的时候,它使得浏览器删除或者忽略堆栈帧。实际上,这个优化对于相互递归函数也是有效的,但是为了简单起见,我们还是来看单一递归函数。

你可能会注意到,在递归函数调用之后,还要进行一次额外的计算(n * r)。那意味着浏览器不能通过 PTC 来优化递归;然而,我们可以通过重写函数使最后一步变成递归调用以便优化。一个窍门是将中间结果(在这里是 product)作为参数传递给函数。

'use strict';

// Optimized for tail call optimization.
function factorial(n, product = 1) {
  if (n === 0) {
    return product;
  }
  return factorial(n - 1, product * n)
}

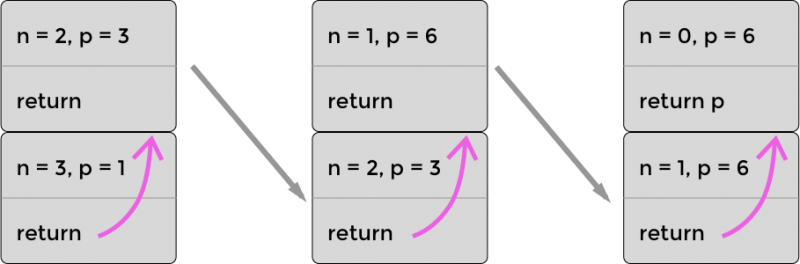
让我们来看看优化后的计算 factorial(3) 时的堆栈。如下图所示,堆栈不会增长到超过两层。原因是我们把必要的信息都传到了递归函数中(比如 product)。所以,在 product 被更新后,浏览器可以丢弃掉堆栈中原先的帧。你可以在图中看到每次最上面的帧下沉变成了底部的帧,原先底部的帧被丢弃,因为不再需要它了。
 title= using PTC")

递归计算 3! 的堆栈(三次乘法)使用 PTC

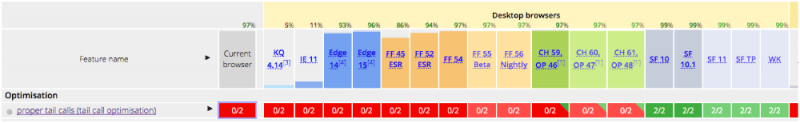
现在选一个浏览器运行吧,假设你在使用 Safari,你会得到 Infinity(它是比在 JavaScript 中能表达的最大值更大的数)。但是我们没有得到堆栈溢出错误,那很不错!现在在其他的浏览器中呢怎么样呢?Safari 可能现在乃至将来是实现 PTC 的唯一一个浏览器。看看下面的兼容性表格:
 title=

PTC 兼容性

其他浏览器提出了一种被称作 语法级尾调用 syntactic tail calls (STC)的竞争标准。“语法级”意味着你需要用新的语法来标识你想要执行尾递归优化的函数。即使浏览器还没有广泛支持,但是把你的递归函数写成支持尾递归优化的样子还是一个好主意。

高阶函数

我们已经知道 JavaScript 将函数视作一等公民,可以把函数像其他值一样传递。所以,把一个函数传给另一个函数也很常见。我们也可以让函数返回一个函数。就是它!我们有高阶函数。你可能已经很熟悉几个在 Array.prototype 中的高阶函数。比如 filter、map 和 reduce 就在其中。对高阶函数的一种理解是:它是接受(一般会调用)一个回调函数参数的函数。让我们来看看一些内置的高阶函数的例子:

const vehicles = [
  { make: 'Honda', model: 'CR-V', type: 'suv', price: 24045 },
  { make: 'Honda', model: 'Accord', type: 'sedan', price: 22455 },
  { make: 'Mazda', model: 'Mazda 6', type: 'sedan', price: 24195 },
  { make: 'Mazda', model: 'CX-9', type: 'suv', price: 31520 },
  { make: 'Toyota', model: '4Runner', type: 'suv', price: 34210 },
  { make: 'Toyota', model: 'Sequoia', type: 'suv', price: 45560 },
  { make: 'Toyota', model: 'Tacoma', type: 'truck', price: 24320 },
  { make: 'Ford', model: 'F-150', type: 'truck', price: 27110 },
  { make: 'Ford', model: 'Fusion', type: 'sedan', price: 22120 },
  { make: 'Ford', model: 'Explorer', type: 'suv', price: 31660 }
];

const averageSUVPrice = vehicles
  .filter(v => v.type === 'suv')
  .map(v => v.price)
  .reduce((sum, price, i, array) => sum + price / array.length, 0);

console.log(averageSUVPrice); // 33399

注意我们在一个数组对象上调用其方法,这是面向对象编程的特性。如果我们想要更函数式一些,我们可以用 Rmmda 或者 lodash/fp 提供的函数。注意如果我们使用 R.compose 的话,需要倒转函数的顺序,因为它从右向左依次调用函数(从底向上);然而,如果我们想从左向右调用函数就像上面的例子,我们可以用 R.pipe。下面两个例子用了 Rmmda。注意 Rmmda 有一个 mean 函数用来代替 reduce 。

const vehicles = [
  { make: 'Honda', model: 'CR-V', type: 'suv', price: 24045 },
  { make: 'Honda', model: 'Accord', type: 'sedan', price: 22455 },
  { make: 'Mazda', model: 'Mazda 6', type: 'sedan', price: 24195 },
  { make: 'Mazda', model: 'CX-9', type: 'suv', price: 31520 },
  { make: 'Toyota', model: '4Runner', type: 'suv', price: 34210 },
  { make: 'Toyota', model: 'Sequoia', type: 'suv', price: 45560 },
  { make: 'Toyota', model: 'Tacoma', type: 'truck', price: 24320 },
  { make: 'Ford', model: 'F-150', type: 'truck', price: 27110 },
  { make: 'Ford', model: 'Fusion', type: 'sedan', price: 22120 },
  { make: 'Ford', model: 'Explorer', type: 'suv', price: 31660 }
];

// Using `pipe` executes the functions from top-to-bottom. 
const averageSUVPrice1 = R.pipe(
  R.filter(v => v.type === 'suv'),
  R.map(v => v.price),
  R.mean
)(vehicles);

console.log(averageSUVPrice1); // 33399

// Using `compose` executes the functions from bottom-to-top.
const averageSUVPrice2 = R.compose(
  R.mean,
  R.map(v => v.price),
  R.filter(v => v.type === 'suv')
)(vehicles);

console.log(averageSUVPrice2); // 33399

使用函数式方法的优点是清楚地分开了数据(vehicles)和逻辑(函数 filter,map 和 reduce)。面向对象的代码相比之下把数据和函数用以方法的对象的形式混合在了一起。

柯里化

不规范地说, 柯里化 currying 是把一个接受 n 个参数的函数变成 n 个每个接受单个参数的函数的过程。函数的 arity 是它接受参数的个数。接受一个参数的函数是 unary,两个的是 binary,三个的是 ternary,n 个的是 n-ary。那么,我们可以把柯里化定义成将一个 n-ary 函数转换成 n 个 unary 函数的过程。让我们通过简单的例子开始,一个计算两个向量点积的函数。回忆一下线性代数,两个向量 [a, b, c] 和 [x, y, z] 的点积是 ax + by + cz。

function dot(vector1, vector2) {
  return vector1.reduce((sum, element, index) => sum += element * vector2[index], 0);
}

const v1 = [1, 3, -5];
const v2 = [4, -2, -1];

console.log(dot(v1, v2)); // 1(4) + 3(-2) + (-5)(-1) = 4 - 6 + 5 = 3

dot 函数是 binary,因为它接受两个参数;然而我们可以将它手动转换成两个 unary 函数,就像下面的例子。注意 curriedDot 是一个 unary 函数,它接受一个向量并返回另一个接受第二个向量的 unary 函数。

function curriedDot(vector1) {
  return function(vector2) {
    return vector1.reduce((sum, element, index) => sum += element * vector2[index], 0);
  }
}

// Taking the dot product of any vector with [1, 1, 1]
// is equivalent to summing up the elements of the other vector.
const sumElements = curriedDot([1, 1, 1]);

console.log(sumElements([1, 3, -5])); // -1
console.log(sumElements([4, -2, -1])); // 1

很幸运,我们不需要把每一个函数都手动转换成柯里化以后的形式。Ramda 和 lodash 等库可以为我们做这些工作。实际上,它们是柯里化的混合形式。你既可以每次传递一个参数,也可以像原来一样一次传递所有参数。

function dot(vector1, vector2) {
  return vector1.reduce((sum, element, index) => sum += element * vector2[index], 0);
}

const v1 = [1, 3, -5];
const v2 = [4, -2, -1];

// Use Ramda to do the currying for us!
const curriedDot = R.curry(dot);

const sumElements = curriedDot([1, 1, 1]);

console.log(sumElements(v1)); // -1
console.log(sumElements(v2)); // 1

// This works! You can still call the curried function with two arguments.
console.log(curriedDot(v1, v2)); // 3

Ramda 和 lodash 都允许你“跳过”一些变量之后再指定它们。它们使用置位符来做这些工作。因为点积的计算可以交换两项。传入向量的顺序不影响结果。让我们换一个例子来阐述如何使用一个置位符。Ramda 使用双下划线作为其置位符。

const giveMe3 = R.curry(function(item1, item2, item3) {
  return `
    1: ${item1}
    2: ${item2}
    3: ${item3}
  `;
});

const giveMe2 = giveMe3(R.__, R.__, 'French Hens');   // Specify the third argument.
const giveMe1 = giveMe2('Partridge in a Pear Tree');  // This will go in the first slot.
const result = giveMe1('Turtle Doves');               // Finally fill in the second argument.

console.log(result);
// 1: Partridge in a Pear Tree
// 2: Turtle Doves
// 3: French Hens

在我们结束探讨柯里化之前最后的议题是 偏函数应用 partial application 。偏函数应用和柯里化经常同时出场,尽管它们实际上是不同的概念。一个柯里化的函数还是柯里化的函数,即使没有给它任何参数。偏函数应用,另一方面是仅仅给一个函数传递部分参数而不是所有参数。柯里化是偏函数应用常用的方法之一,但是不是唯一的。

JavaScript 拥有一个内置机制可以不依靠柯里化来做偏函数应用。那就是 function.prototype.bind 方法。这个方法的一个特殊之处在于,它要求你将 this 作为第一个参数传入。 如果你不进行面向对象编程,那么你可以通过传入 null 来忽略 this。

1function giveMe3(item1, item2, item3) {
  return `
    1: ${item1}
    2: ${item2}
    3: ${item3}
  `;
}

const giveMe2 = giveMe3.bind(null, 'rock');
const giveMe1 = giveMe2.bind(null, 'paper');
const result = giveMe1('scissors');

console.log(result);
// 1: rock
// 2: paper
// 3: scissors

总结

我希望你享受探索 JavaScript 中函数式编程的过程。对一些人来说,它可能是一个全新的编程范式,但我希望你能尝试它。你会发现你的程序更易于阅读和调试。不变性还将允许你优化 Angular 和 React 的性能。

这篇文章基于 Matt 在 OpenWest 的演讲 JavaScript the Good-er Parts. OpenWest 将在 6/12-15 ,2017 在 Salt Lake City, Utah 举行。


作者简介:

Matt Banz - Matt 于 2008 年五月在犹他大学获得了数学学位毕业。一个月后他得到了一份 web 开发者的工作,他从那时起就爱上了它!在 2013 年,他在北卡罗莱纳州立大学获得了计算机科学硕士学位。他在 LDS 商学院和戴维斯学区社区教育计划教授 Web 课程。他现在是就职于 Motorola Solutions 公司的高级前端开发者。


via: https://opensource.com/article/17/6/functional-javascript

作者:Matt Banz 译者:trnhoe 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

这是并发网络服务器系列的第二节。第一节 提出了服务端实现的协议,还有简单的顺序服务器的代码,是这整个系列的基础。

这一节里,我们来看看怎么用多线程来实现并发,用 C 实现一个最简单的多线程服务器,和用 Python 实现的线程池。

该系列的所有文章:

多线程的方法设计并发服务器

说起第一节里的顺序服务器的性能,最显而易见的,是在服务器处理客户端连接时,计算机的很多资源都被浪费掉了。尽管假定客户端快速发送完消息,不做任何等待,仍然需要考虑网络通信的开销;网络要比现在的 CPU 慢上百万倍还不止,因此 CPU 运行服务器时会等待接收套接字的流量,而大量的时间都花在完全不必要的等待中。

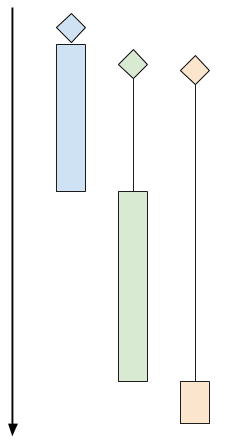
这里是一份示意图,表明顺序时客户端的运行过程:

顺序客户端处理流程

这个图片上有 3 个客户端程序。棱形表示客户端的“到达时间”(即客户端尝试连接服务器的时间)。黑色线条表示“等待时间”(客户端等待服务器真正接受连接所用的时间),有色矩形表示“处理时间”(服务器和客户端使用协议进行交互所用的时间)。有色矩形的末端表示客户端断开连接。

上图中,绿色和橘色的客户端尽管紧跟在蓝色客户端之后到达服务器,也要等到服务器处理完蓝色客户端的请求。这时绿色客户端得到响应,橘色的还要等待一段时间。

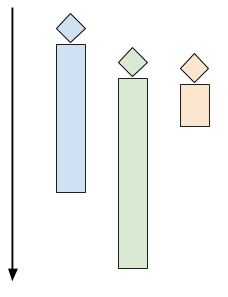
多线程服务器会开启多个控制线程,让操作系统管理 CPU 的并发(使用多个 CPU 核心)。当客户端连接的时候,创建一个线程与之交互,而在主线程中,服务器能够接受其他的客户端连接。下图是该模式的时间轴:

并行客户端处理流程

每个客户端一个线程,在 C 语言里要用 pthread

这篇文章的 第一个示例代码 是一个简单的 “每个客户端一个线程” 的服务器,用 C 语言编写,使用了 phtreads API 用于实现多线程。这里是主循环代码:

while (1) {
  struct sockaddr_in peer_addr;
  socklen_t peer_addr_len = sizeof(peer_addr);

  int newsockfd =
      accept(sockfd, (struct sockaddr*)&peer_addr, &peer_addr_len);

  if (newsockfd < 0) {
    perror_die("ERROR on accept");
  }

  report_peer_connected(&peer_addr, peer_addr_len);
  pthread_t the_thread;

  thread_config_t* config = (thread_config_t*)malloc(sizeof(*config));
  if (!config) {
    die("OOM");
  }
  config->sockfd = newsockfd;
  pthread_create(&the_thread, NULL, server_thread, config);

  // 回收线程 —— 在线程结束的时候,它占用的资源会被回收
  // 因为主线程在一直运行,所以它比服务线程存活更久。
  pthread_detach(the_thread);
}

这是 server_thread 函数:

void* server_thread(void* arg) {
  thread_config_t* config = (thread_config_t*)arg;
  int sockfd = config->sockfd;
  free(config);

  // This cast will work for Linux, but in general casting pthread_id to an 这个类型转换在 Linux 中可以正常运行,但是一般来说将 pthread_id 类型转换成整形不便于移植代码
  // integral type isn't portable.
  unsigned long id = (unsigned long)pthread_self();
  printf("Thread %lu created to handle connection with socket %d\n", id,
         sockfd);
  serve_connection(sockfd);
  printf("Thread %lu done\n", id);
  return 0;
}

线程 “configuration” 是作为 thread_config_t 结构体进行传递的:

typedef struct { int sockfd; } thread_config_t;

主循环中调用的 pthread_create 产生一个新线程,然后运行 server_thread 函数。这个线程会在 server_thread 返回的时候结束。而在 serve_connection 返回的时候 server_thread 才会返回。serve_connection 和第一节完全一样。

第一节中我们用脚本生成了多个并发访问的客户端,观察服务器是怎么处理的。现在来看看多线程服务器的处理结果:

$ python3.6 simple-client.py  -n 3 localhost 9090
INFO:2017-09-20 06:31:56,632:conn1 connected...
INFO:2017-09-20 06:31:56,632:conn2 connected...
INFO:2017-09-20 06:31:56,632:conn0 connected...
INFO:2017-09-20 06:31:56,632:conn1 sending b'^abc$de^abte$f'
INFO:2017-09-20 06:31:56,632:conn2 sending b'^abc$de^abte$f'
INFO:2017-09-20 06:31:56,632:conn0 sending b'^abc$de^abte$f'
INFO:2017-09-20 06:31:56,633:conn1 received b'b'
INFO:2017-09-20 06:31:56,633:conn2 received b'b'
INFO:2017-09-20 06:31:56,633:conn0 received b'b'
INFO:2017-09-20 06:31:56,670:conn1 received b'cdbcuf'
INFO:2017-09-20 06:31:56,671:conn0 received b'cdbcuf'
INFO:2017-09-20 06:31:56,671:conn2 received b'cdbcuf'
INFO:2017-09-20 06:31:57,634:conn1 sending b'xyz^123'
INFO:2017-09-20 06:31:57,634:conn2 sending b'xyz^123'
INFO:2017-09-20 06:31:57,634:conn1 received b'234'
INFO:2017-09-20 06:31:57,634:conn0 sending b'xyz^123'
INFO:2017-09-20 06:31:57,634:conn2 received b'234'
INFO:2017-09-20 06:31:57,634:conn0 received b'234'
INFO:2017-09-20 06:31:58,635:conn1 sending b'25$^ab0000$abab'
INFO:2017-09-20 06:31:58,635:conn2 sending b'25$^ab0000$abab'
INFO:2017-09-20 06:31:58,636:conn1 received b'36bc1111'
INFO:2017-09-20 06:31:58,636:conn2 received b'36bc1111'
INFO:2017-09-20 06:31:58,637:conn0 sending b'25$^ab0000$abab'
INFO:2017-09-20 06:31:58,637:conn0 received b'36bc1111'
INFO:2017-09-20 06:31:58,836:conn2 disconnecting
INFO:2017-09-20 06:31:58,836:conn1 disconnecting
INFO:2017-09-20 06:31:58,837:conn0 disconnecting

实际上,所有客户端同时连接,它们与服务器的通信是同时发生的。

每个客户端一个线程的难点

尽管在现代操作系统中就资源利用率方面来看,线程相当的高效,但前一节中讲到的方法在高负载时却会出现纰漏。

想象一下这样的情景:很多客户端同时进行连接,某些会话持续的时间长。这意味着某个时刻服务器上有很多活跃的线程。太多的线程会消耗掉大量的内存和 CPU 资源,而仅仅是用于上下文切换 注1 。另外其也可视为安全问题:因为这样的设计容易让服务器成为 DoS 攻击 的目标 —— 上百万个客户端同时连接,并且客户端都处于闲置状态,这样耗尽了所有资源就可能让服务器宕机。

当服务器要与每个客户端通信,CPU 进行大量计算时,就会出现更严重的问题。这种情况下,容易想到的方法是减少服务器的响应能力 —— 只有其中一些客户端能得到服务器的响应。

因此,对多线程服务器所能够处理的并发客户端数做一些 速率限制 就是个明智的选择。有很多方法可以实现。最容易想到的是计数当前已经连接上的客户端,把连接数限制在某个范围内(需要通过仔细的测试后决定)。另一种流行的多线程应用设计是使用 线程池。

线程池

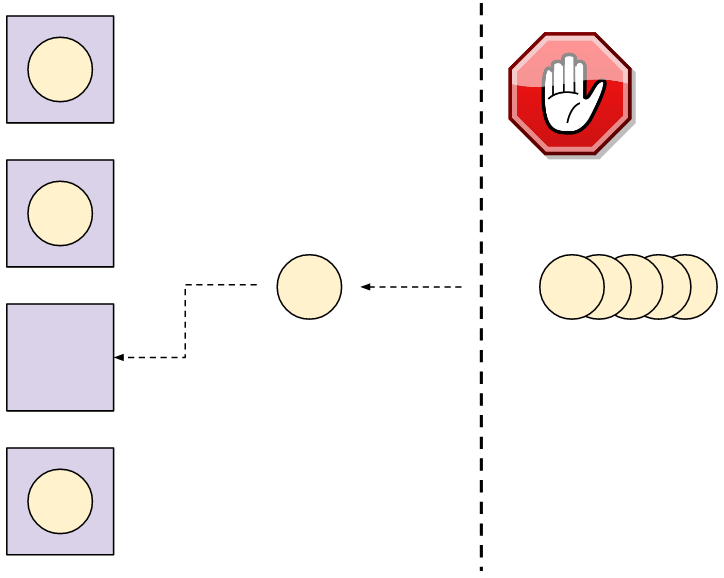
线程池 很简单,也很有用。服务器创建几个任务线程,这些线程从某些队列中获取任务。这就是“池”。然后每一个客户端的连接被当成任务分发到池中。只要池中有空闲的线程,它就会去处理任务。如果当前池中所有线程都是繁忙状态,那么服务器就会阻塞,直到线程池可以接受任务(某个繁忙状态的线程处理完当前任务后,变回空闲的状态)。

这里有个 4 线程的线程池处理任务的图。任务(这里就是客户端的连接)要等到线程池中的某个线程可以接受新任务。

非常明显,线程池的定义就是一种按比例限制的机制。我们可以提前设定服务器所能拥有的线程数。那么这就是并发连接的最多的客户端数 —— 其它的客户端就要等到线程空闲。如果我们的池中有 8 个线程,那么 8 就是服务器可以处理的最多的客户端并发连接数,哪怕上千个客户端想要同时连接。

那么怎么确定池中需要有多少个线程呢?通过对问题范畴进行细致的分析、评估、实验以及根据我们拥有的硬件配置。如果是单核的云服务器,答案只有一个;如果是 100 核心的多套接字的服务器,那么答案就有很多种。也可以在运行时根据负载动态选择池的大小 —— 我会在这个系列之后的文章中谈到这个东西。

使用线程池的服务器在高负载情况下表现出 性能退化 —— 客户端能够以稳定的速率进行连接,可能会比其它时刻得到响应的用时稍微久一点;也就是说,无论多少个客户端同时进行连接,服务器总能保持响应,尽最大能力响应等待的客户端。与之相反,每个客户端一个线程的服务器,会接收多个客户端的连接直到过载,这时它更容易崩溃或者因为要处理所有客户端而变得缓慢,因为资源都被耗尽了(比如虚拟内存的占用)。

在服务器上使用线程池

为了改变服务器的实现,我用了 Python,在 Python 的标准库中带有一个已经实现好的稳定的线程池。(concurrent.futures 模块里的 ThreadPoolExecutor) 注2 。

服务器创建一个线程池,然后进入循环,监听套接字接收客户端的连接。用 submit 把每一个连接的客户端分配到池中:

pool = ThreadPoolExecutor(args.n)
sockobj = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
sockobj.setsockopt(socket.SOL_SOCKET, socket.SO_REUSEADDR, 1)
sockobj.bind(('localhost', args.port))
sockobj.listen(15)

try:
    while True:
        client_socket, client_address = sockobj.accept()
        pool.submit(serve_connection, client_socket, client_address)
except KeyboardInterrupt as e:
    print(e)
    sockobj.close()

serve_connection 函数和 C 的那部分很像,与一个客户端交互,直到其断开连接,并且遵循我们的协议:

ProcessingState = Enum('ProcessingState', 'WAIT_FOR_MSG IN_MSG')

def serve_connection(sockobj, client_address):
    print('{0} connected'.format(client_address))
    sockobj.sendall(b'*')
    state = ProcessingState.WAIT_FOR_MSG

    while True:
        try:
            buf = sockobj.recv(1024)
            if not buf:
                break
        except IOError as e:
            break
        for b in buf:
            if state == ProcessingState.WAIT_FOR_MSG:
                if b == ord(b'^'):
                    state = ProcessingState.IN_MSG
            elif state == ProcessingState.IN_MSG:
                if b == ord(b'$'):
                    state = ProcessingState.WAIT_FOR_MSG
                else:
                    sockobj.send(bytes([b + 1]))
            else:
                assert False

    print('{0} done'.format(client_address))
    sys.stdout.flush()
    sockobj.close()

来看看线程池的大小对并行访问的客户端的阻塞行为有什么样的影响。为了演示,我会运行一个池大小为 2 的线程池服务器(只生成两个线程用于响应客户端)。

$ python3.6 threadpool-server.py -n 2

在另外一个终端里,运行客户端模拟器,产生 3 个并发访问的客户端:

$ python3.6 simple-client.py  -n 3 localhost 9090
INFO:2017-09-22 05:58:52,815:conn1 connected...
INFO:2017-09-22 05:58:52,827:conn0 connected...
INFO:2017-09-22 05:58:52,828:conn1 sending b'^abc$de^abte$f'
INFO:2017-09-22 05:58:52,828:conn0 sending b'^abc$de^abte$f'
INFO:2017-09-22 05:58:52,828:conn1 received b'b'
INFO:2017-09-22 05:58:52,828:conn0 received b'b'
INFO:2017-09-22 05:58:52,867:conn1 received b'cdbcuf'
INFO:2017-09-22 05:58:52,867:conn0 received b'cdbcuf'
INFO:2017-09-22 05:58:53,829:conn1 sending b'xyz^123'
INFO:2017-09-22 05:58:53,829:conn0 sending b'xyz^123'
INFO:2017-09-22 05:58:53,830:conn1 received b'234'
INFO:2017-09-22 05:58:53,831:conn0 received b'2'
INFO:2017-09-22 05:58:53,831:conn0 received b'34'
INFO:2017-09-22 05:58:54,831:conn1 sending b'25$^ab0000$abab'
INFO:2017-09-22 05:58:54,832:conn1 received b'36bc1111'
INFO:2017-09-22 05:58:54,832:conn0 sending b'25$^ab0000$abab'
INFO:2017-09-22 05:58:54,833:conn0 received b'36bc1111'
INFO:2017-09-22 05:58:55,032:conn1 disconnecting
INFO:2017-09-22 05:58:55,032:conn2 connected...
INFO:2017-09-22 05:58:55,033:conn2 sending b'^abc$de^abte$f'
INFO:2017-09-22 05:58:55,033:conn0 disconnecting
INFO:2017-09-22 05:58:55,034:conn2 received b'b'
INFO:2017-09-22 05:58:55,071:conn2 received b'cdbcuf'
INFO:2017-09-22 05:58:56,036:conn2 sending b'xyz^123'
INFO:2017-09-22 05:58:56,036:conn2 received b'234'
INFO:2017-09-22 05:58:57,037:conn2 sending b'25$^ab0000$abab'
INFO:2017-09-22 05:58:57,038:conn2 received b'36bc1111'
INFO:2017-09-22 05:58:57,238:conn2 disconnecting

回顾之前讨论的服务器行为:

  1. 在顺序服务器中,所有的连接都是串行的。一个连接结束后,下一个连接才能开始。
  2. 前面讲到的每个客户端一个线程的服务器中,所有连接都被同时接受并得到服务。

这里可以看到一种可能的情况:两个连接同时得到服务,只有其中一个结束连接后第三个才能连接上。这就是把线程池大小设置成 2 的结果。真实用例中我们会把线程池设置的更大些,取决于机器和实际的协议。线程池的缓冲机制就能很好理解了 —— 我 几个月前 更详细的介绍过这种机制,关于 Clojure 的 core.async 模块。

总结与展望

这篇文章讨论了在服务器中,用多线程作并发的方法。每个客户端一个线程的方法最早提出来,但是实际上却不常用,因为它并不安全。

线程池就常见多了,最受欢迎的几个编程语言有良好的实现(某些编程语言,像 Python,就是在标准库中实现)。这里说的使用线程池的服务器,不会受到每个客户端一个线程的弊端。

然而,线程不是处理多个客户端并行访问的唯一方法。下一节中我们会看看其它的解决方案,可以使用异步处理,或者事件驱动的编程。


  • 注1:老实说,现代 Linux 内核可以承受足够多的并发线程 —— 只要这些线程主要在 I/O 上被阻塞。这里有个示例程序,它产生可配置数量的线程,线程在循环体中是休眠的,每 50 ms 唤醒一次。我在 4 核的 Linux 机器上可以轻松的产生 10000 个线程;哪怕这些线程大多数时间都在睡眠,它们仍然消耗一到两个核心,以便实现上下文切换。而且,它们占用了 80 GB 的虚拟内存(Linux 上每个线程的栈大小默认是 8MB)。实际使用中,线程会使用内存并且不会在循环体中休眠,因此它可以非常快的占用完一个机器的内存。
  • 注2:自己动手实现一个线程池是个有意思的练习,但我现在还不想做。我曾写过用来练手的 针对特殊任务的线程池。是用 Python 写的;用 C 重写的话有些难度,但对于经验丰富的程序员,几个小时就够了。

via: https://eli.thegreenplace.net/2017/concurrent-servers-part-2-threads/

作者:Eli Bendersky 译者:GitFuture 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出