2021年7月

开源软件的发行版和分支是不一样的。了解其中的区别和潜在的风险。

如果你们对开源软件有过一段时间的了解,一定曾在许多相关方面中听说过 分支 fork 和 发行版 distribution 两个词。许多人对这两个词的区别不太清楚,因此我将试着通过这篇文章为大家解答这一疑惑。

(LCTT 译注:fork 一词,按我们之前的倡议,在版本控制工作流中,为了避免和同一个仓库的 branch 一词混淆,我们建议翻译为“复刻”。但是在项目和发行版这个语境下,没有这个混淆,惯例上还是称之为“分支”。)

首先,一些定义

在解释分支与发行版两者的细微区别与相似之处之前,让我们先给一些相关的重要概念下定义。

开源软件 是指具有以下特点的软件:

  • 在特定的 许可证 限制下,软件供所有人免费分发
  • 在特定的许可证限制下,软件源代码可以供所有人查看与修改

开源软件可以按以下方式 使用:

  • 以二进制或者源代码的方式下载,通常是免费的。(例如,Eclipse 开发者环境)
  • 作为一个商业公司的产品,有时向用户提供一些服务并以此收费。(例如,红帽产品)
  • 嵌入在专有的软件解决方案中。(例如一些智能手机和浏览器用于显示字体的 Freetype 软件)

自由开源软件 free and open source software (FOSS)不一定是“零成本”的“ 免费 free ”。自由开源软件仅仅意味着这个软件在遵守软件许可证的前提下可以自由地分发、修改、研究和使用。软件分发者也可能为该软件定价。例如,Linux 可以是 Fedora、Centos、Gentoo 等免费发行版,也可以是付费的发行版,如红帽企业版 Linux(RHEL)、SUSE Linux 企业版(SLES)等。

社区 community 指的是在一个开源项目上协作的团体或个人。任何人或者团体都可以在遵守协议的前提下,通过编写或审查代码/文档/测试套件、管理会议、更新网站等方式为开源项目作出贡献。例如,在 Openhub.net 网站上,我们可以看见政府、非营利性机构、商业公司和教育团队等组织都在 为一些开源项目作出贡献。

一个开源 项目 project 是集协作开发、文档和测试的结果。大多数项目都搭建了一个中央仓库用来存储代码、文档、测试文件和目前正在开发的文件。

发行版 distribution 是指开源项目的一份的二进制或源代码的副本。例如,CentOS、Fedora、红帽企业版 Linux(RHEL)、SUSE Linux、Ubuntu 等都是 Linux 项目的发行版。Tectonic、谷歌的 Kubernetes 引擎(GKE)、亚马逊的容器服务和红帽的 OpenShift 都是 Kubernetes 项目的发行版。

开源项目的商业发行版经常被称作 产品 products ,因此,红帽 OpenStack 平台是红帽 OpenStack 的产品,它是 OpenStack 上游项目的一个发行版,并且是百分百开源的。

主干 trunk 是开发开源项目的社区的主要工作流。

开源分支fork是开源项目主干的一个版本,它是分离自主干的独立工作流。

因此,发行版并不等同于分支。发行版是上游项目的一种包装,由厂商提供,经常作为产品进行销售。然而,发行版的核心代码和文档与上游项目的版本保持一致。分支,以及任何基于分支的的发行版,导致代码和文档的版本与上游项目不同。对上游项目进行了分支的用户必须自己来维护分支项目,这意味着他们失去了上游社区协同工作带来的好处。

为了进一步解释软件分支,让我来用动物迁徙作比喻。鲸鱼和海狮从北极迁徙到加利福尼亚和墨西哥;帝王斑蝶从阿拉斯加迁徙到墨西哥;并且北半球的燕子和许多其他鸟类飞翔南方去过冬。成功迁徙的关键因素在于,团队中的所有动物团结一致,紧跟领导者,找到食物和庇护所,并且不会迷路。

独立前行带来的风险

一只鸟、帝王蝶或者鲸鱼一旦掉队就失去了许多优势,例如团队带来的保护,以及知道哪儿有食物、庇护所和目的地。

相似地,从上游版本获取分支并且独立维护的用户和组织也存在以下风险:

  1. 由于代码不同,分支用户不能够基于上游版本更新代码。 这就是大家熟知的技术债,对分支的代码修改的越多,将这一分支重新归入上游项目需要花费的时间和金钱成本就越高。
  2. 分支用户有可能运行不太安全的代码。 由于代码不同的原因,当开源代码的漏洞被找到,并且被上游社区修复时,分支版本的代码可能无法从这次修复中受益。
  3. 分支用户可能不会从新特性中获益。 拥有众多组织和个人支持的上游版本,将会创建许多符合所有上游项目用户利益的新特性。如果一个组织从上游分支,由于代码不同,它们可能无法纳入新的功能。
  4. 它们可能无法和其他软件包整合在一起。 开源项目很少是作为单一实体开发的;相反地,它们经常被与其他项目打包在一起构成一套解决方案。分支代码可能无法与其他项目整合,因为分支代码的开发者没有与上游的其他参与者们合作。
  5. 它们可能不会得到硬件平台认证。 软件包通常被搭载在硬件平台上进行认证,如果有问题发生,硬件与软件工作人员可以合作找出并解决问题发生的根源。

总之,开源发行版只是一个来自上游的、多组织协同开发的、由供应商销售与支持的打包集合。分支是一个开源项目的独立开发工作流,有可能无法从上游社区协同工作的结果中受益。


via: https://opensource.com/article/18/7/forks-vs-distributions

作者:Jonathan Gershater 选题:lujun9972 译者:Wlzzzz-del 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

我使用 Vim 和 Git 来写小说。是的,你也可以用 Git 来完成非编码任务。

我相信当代的写作者们应该开始思考他们的工作流程了。

在一个注意力高度分散的世界里,作为写作者,我们必须对每天执行的任务链拥有控制权。传统上,作家们会把他们的写作放在分散注意力的事较少、注意力高度集中的时间段。不幸的是,海明威、阿特伍德们的这些建议不再真正适用于我们了。我们所生活的世界联系得更紧密了,因此对作家来说就有了更多的陷阱。这首先要求我们要有足够的自制力,不要让社交媒体或小狗和小猫的可爱视频在我们写作的时候分散我们的注意力。

但是,如果你的写作需要快速地检查事实、拼写不常见和技术性的词汇等,断开与互联网连接并不是一个现实的选项 —— 这正是我写作时的场景。另一个问题是你用于写作的应用程序本身的干扰;作为一个长期使用 MS Word 的人,我发现它越来越漂亮,但速度越来越慢,也越来越让人分心。作为当初我 迁移到 Vim 的主要原因 之一,我曾详细地谈到了这一点,所以我不打算再在这个问题上大谈特谈。重点是,在现代世界中,在现代设备上进行写作,可能远非理想状态。

因为我已经详细介绍过了 我为什么转向 Vim 和开源版本控制,在这篇文章中,我更想谈谈该 怎么做,特别是如何使用开源的版本控制技术,比如 Git(和 GitHub)。

什么是版本控制?再来一次?

Source: https://git-scm.com/

上图是我们如何进行传统版本控制的一个说明。这个图中假设你有一台设备,而且你只在那台设备上写作。但对我而言,我在许多机器上写作,包括我的安卓手机和一些不同年代的笔记本电脑,我会在特定的任务、特定的位置使用到它们。我在所有这些设备上进行的一个共同任务就是写作 —— 因此,我的设备必须以合理的方式捕捉变化并控制文件的版本。不要再让我将 file1V1_device1_date.doc 作为文件名了。

上图也没有考虑到我们用来写作的工具。像 LibreOffice Write 这样的文字处理器可以在 Linux、Mac 和 Windows 系统上使用,但在手机上使用文字处理器将会是一段不愉快的经历。我们中的一些写作者还使用其他文本工具(包括 Gmail 或我们的电子邮件客户端)来为我们的写作打草稿。但按逻辑顺序跟踪所有这些文件和电子邮件是相当折磨人的,我就用这样的流程写过一本书,相信我:我花在弄清文件名、版本变化、评论、给自己的注释以及带有附加注释的电子邮件上的时间,足以让我精神错乱。

读到这里,你们中的一些人可能会正确地指出,有云备份技术呀。虽然云存储的好处是巨大的,而且我也在继续使用它们,但其版本控制几乎不存在,或者说并不强大。

一个更好的工作流程

就像地球上的其它地方一样,大流行病的开始引发了一些焦虑和一些反思。我利用这段时间在 The Odin Project(强烈推荐给那些想学习 html、CSS、JavaScript/Ruby 的人)上自学了网络开发。

在课程的第一个模块中,有一个关于 Git 的介绍:什么是版本控制,以及它试图解决什么问题。读了这一章后,我豁然开朗。我立即意识到,这个 Git 正是我作为一个写作者所要寻找的东西。

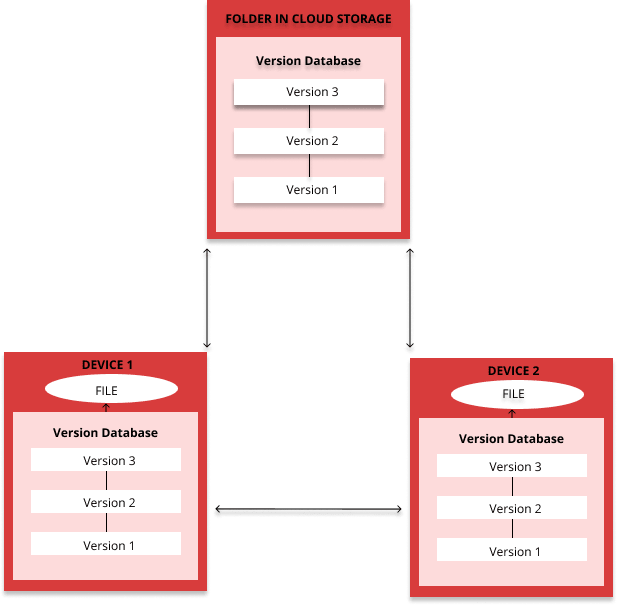
是的,更好的方法不是本地化的版本控制,而是 分布式 的版本控制。“分布式”描述的是设备的分布,而我在这些设备上访问文件,以及之后进行编辑修改。下图是分布式版本控制的一个直观说明。

Source: https://git-scm.com/

我的方法

我为写作建立一个版本控制系统的目标如下:

  • 使我的稿件库可以从任何地方、任何设备上访问
  • 易于使用
  • 减少或消除因在写作、学习和编码各工作流程之间的场景切换而产生的摩擦 —— 尽可能使用同一工具(即 Vim)。
  • 可扩展性
  • 易于维护

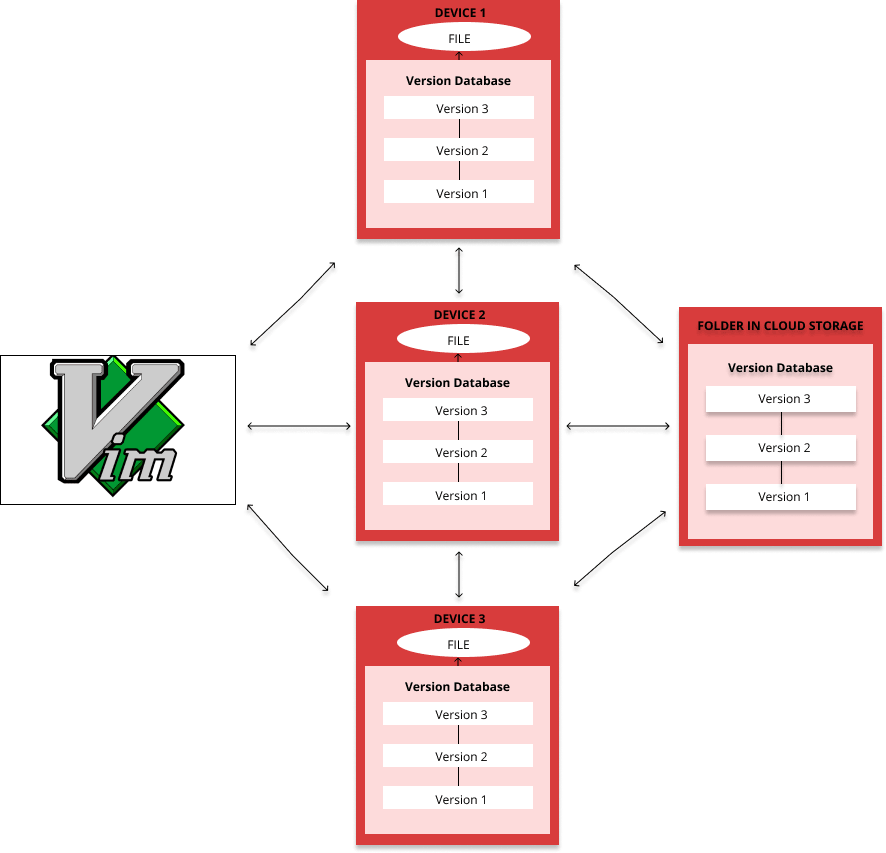
基于以上需求,下图是我进行写作的分布式版本控制系统。

如你所见,我的版本控制系统是分布式版本控制的一个简单的适配。在我的例子中,通过将 Git 版本控制应用到云存储(pCloud)的一个文件夹上,我可以同时利用这两种技术的优点。因此,我的工作流程可以用下图描述:

优势

  1. 我用一个写作(和编码)工具
  2. 我可以对我的手稿进行版本控制,无论我是从什么设备上访问文件的
  3. 超级简单,几乎没有任何不便之处
  4. 易于维护

缺点

你们中的写作者一定想知道这个系统存在什么缺点。以下是我在持续使用和完善这一工作流程时预计到的几个问题。

  • 对草稿的评论:文字处理器的一个更有用的功能是具有评论的功能。当我希望以后再回到文本的某一部分时,我经常在这部分为自己留下一个评论。我仍然没有想出一个解决这个问题的办法。
  • 协作:文字处理程序允许写作者之间进行协作。在我以前做广告相关工作的时候,我会用 Google Docs 来写文案,然后分享链接给我的设计师,从而他可以为广告和网站对文案进行摘录。现在,我的解决方法是用 Markdown 写文案,并通过 Pandoc 将 Markdown 文件导出为 .doc 文件。更关键的是,当我的手稿完成后,我仍然需要将文件以 .doc 格式发送给我的编辑。一旦我的编辑做了一些修改并把它发回来,我再尝试用 Vim 打开它就没有意义了。在这一点上,该系统的局限性变得更加明显。

我并不是说这是最好的方法,但在我职业生涯的这个阶段,这是对我来说最好的方法。我想,随着我对我的新的 用于写作的开源工具 和版本控制越来越熟悉和适应,我将进一步完善这个方法。

我希望这篇文章能为那些想使用 Git 进行文档版本控制的写作者提供一个很好的介绍。这肯定不是一篇详尽的文章,但我将分享一些有用的链接,使你的旅程更容易。

  1. The Odin Project 介绍的 Git 基础知识
  2. 开始使用 Git
  3. GitHub 的 Git 基础知识教程

via: https://news.itsfoss.com/version-control-writers/

作者:Theena 选题:lujun9972 译者:piaoshi 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

特斯拉投资比特币的 15 亿美元账面收益再次化为乌有

根据 CoinDesk 的数据,7 月 20 日,比特币的价格再度跌至 29600 美元,在 24 小时内下跌超过 5%。自 4 月中旬创下近 65000 美元的历史新高以来,其价格已暴跌了 50% 以上。比特币今年以来上涨了 1.87%。

今年 2 月,特斯拉宣布投资 15 亿美元购买比特币,平均价格为 32600 美元。截至一季度末,特斯拉在比特币上账面收益总计为 14.51 亿美元。6 月 22 日,比特币一度跌至 28900 美元,使特斯拉的比特币投资的账面亏损达 1.33 亿美元。7 月 20 日,比特币的价格再度跌至 29600 美元后,如果特斯拉今天卖掉这些比特币,其 15 亿美元的投资也只能做到盈亏相抵。

你猜马一龙会不会马上抛售比特币呢?

Gmail 启用 BIMI 安全功能

邮件认证品牌标识(BIMI)是一项行业标准,旨在为电子邮件生态系统带来更强大的发件人身份验证。认证品牌标识的设计是当一个组织向你发送使用 DMARC 标准认证的电子邮件时,该组织的标志将显示在你的收件箱中。使用发件人政策框架(SPF)或域密钥识别邮件(DKIM)认证其电子邮件并部署 DMARC 的组织可以通过验证标记证书(VMC)向谷歌提供其验证的商标标识。

这只是使 DMARC 更用户友好而已,本质上还是依靠 DMARC 的机制。

存在 6 年的 systemd 安全漏洞被披露

Qualys 发现了一个新的 systemd 安全漏洞,使任何非特权的用户能够通过内核恐慌造成拒绝服务。几乎所有现代 Linux 发行版都使用 systemd。这个特殊的安全漏洞于 2015 年 4 月出现在 systemd 代码中。这种攻击可以由本地攻击者在很长的路径上挂载一个文件系统来实现。这将导致 systemd 堆栈中使用过多的内存空间,从而导致系统崩溃。systemd 的开发者已经修补了这个漏洞。

这是一个严重的安全漏洞,请尽快注意并升级。

进一步学习自然语言处理的基本概念

 title=

在 之前的文章 里,我介绍了 自然语言处理 natural language processing (NLP)和宾夕法尼亚大学研发的 自然语言处理工具包 Natural Language Toolkit (NLTK)。我演示了用 Python 解析文本和定义 停顿词 stopword 的方法,并介绍了 语料库 corpus 的概念。语料库是由文本构成的数据集,通过提供现成的文本数据来辅助文本处理。在这篇文章里,我将继续用各种语料库对文本进行对比和分析。

这篇文章主要包括以下部分:

  • 词网 WordNet 和 同义词集 synset
  • 相似度比较 Similarity comparison
  • 树 Tree 和 树库 treebank
  • 命名实体识别 Named entity recognition

词网和同义词集

词网 WordNet 是 NLTK 里的一个大型词汇数据库语料库。词网包含各单词的诸多 认知同义词 cognitive synonyms (认知同义词常被称作“ 同义词集 synset ”)。在词网里,名词、动词、形容词和副词,各自被组织成一个同义词的网络。

词网是一个很有用的文本分析工具。它有面向多种语言的版本(汉语、英语、日语、俄语和西班牙语等),也使用多种许可证(从开源许可证到商业许可证都有)。初代版本的词网由普林斯顿大学研发,面向英语,使用 类 MIT 许可证 MIT-like license 。

因为一个词可能有多个意义或多个词性,所以可能与多个同义词集相关联。每个同义词集通常提供下列属性:

属性定义例子
名称 Name 此同义词集的名称单词 code 有 5 个同义词集,名称分别是 code.n.01、 code.n.02、 code.n.03、code.v.01 和 code.v.02
词性 POS 此同义词集的词性单词 code 有 3 个名词词性的同义词集和 2 个动词词性的同义词集
定义 Definition 该词作对应词性时的定义动词 code 的一个定义是:(计算机科学)数据或计算机程序指令的 象征性排列 symbolic arrangement
例子 Example 使用该词的例子code 一词的例子:We should encode the message for security reasons
词元 Lemma 与该词相关联的其他同义词集(包括那些不一定严格地是该词的同义词,但可以大体看作同义词的);词元直接与其他词元相关联,而不是直接与 单词 word 相关联code.v.02 的词元是 code.v.02.encipher、code.v.02.cipher、code.v.02.cypher、code.v.02.encrypt、code.v.02.inscribe 和 code.v.02.write_in_code
反义词 Antonym 意思相反的词词元 encode.v.01.encode 的反义词是 decode.v.01.decode
上义词 Hypernym 该词所属的一个范畴更大的词code.v.01 的一个上义词是 tag.v.01
分项词 Meronym 属于该词组成部分的词computer 的一个分项词是 chip
总项词 Holonym 该词作为组成部分所属的词window 的一个总项词是 computer screen

同义词集还有一些其他属性,在 <你的 Python 安装路径>/Lib/site-packages 下的 nltk/corpus/reader/wordnet.py,你可以找到它们。

下面的代码或许可以帮助理解。

这个函数:

from nltk.corpus import wordnet

def synset_info(synset):
    print("Name", synset.name())
    print("POS:", synset.pos())
    print("Definition:", synset.definition())
    print("Examples:", synset.examples())
    print("Lemmas:", synset.lemmas())
    print("Antonyms:", [lemma.antonyms() for lemma in synset.lemmas() if len(lemma.antonyms()) > 0])
    print("Hypernyms:", synset.hypernyms())
    print("Instance Hypernyms:", synset.instance_hypernyms())
    print("Part Holonyms:", synset.part_holonyms())
    print("Part Meronyms:", synset.part_meronyms())
    print()


synsets = wordnet.synsets('code')
print(len(synsets), "synsets:")
for synset in synsets:
    synset_info(synset)

将会显示:

5 synsets:
Name code.n.01
POS: n
Definition: a set of rules or principles or laws (especially written ones)
Examples: []
Lemmas: [Lemma('code.n.01.code'), Lemma('code.n.01.codification')]
Antonyms: []
Hypernyms: [Synset('written_communication.n.01')]
Instance Hpernyms: []
Part Holonyms: []
Part Meronyms: []

...

Name code.n.03
POS: n
Definition: (computer science) the symbolic arrangement of data or instructions in a computer program or the set of such instructions
Examples: []
Lemmas: [Lemma('code.n.03.code'), Lemma('code.n.03.computer_code')]
Antonyms: []
Hypernyms: [Synset('coding_system.n.01')]
Instance Hpernyms: []
Part Holonyms: []
Part Meronyms: []

...

Name code.v.02
POS: v
Definition: convert ordinary language into code
Examples: ['We should encode the message for security reasons']
Lemmas: [Lemma('code.v.02.code'), Lemma('code.v.02.encipher'), Lemma('code.v.02.cipher'), Lemma('code.v.02.cypher'), Lemma('code.v.02.encrypt'), Lemma('code.v.02.inscribe'), Lemma('code.v.02.write_in_code')]
Antonyms: []
Hypernyms: [Synset('encode.v.01')]
Instance Hpernyms: []
Part Holonyms: []
Part Meronyms: []

同义词集 synset 和 词元 lemma 在词网里是按照树状结构组织起来的,下面的代码会给出直观的展现:

def hypernyms(synset):
    return synset.hypernyms()

synsets = wordnet.synsets('soccer')
for synset in synsets:
    print(synset.name() + " tree:")
    pprint(synset.tree(rel=hypernyms))
    print()
code.n.01 tree:
[Synset('code.n.01'),
 [Synset('written_communication.n.01'),
   ...

code.n.02 tree:
[Synset('code.n.02'),
 [Synset('coding_system.n.01'),
   ...

code.n.03 tree:
[Synset('code.n.03'),
   ...

code.v.01 tree:
[Synset('code.v.01'),
 [Synset('tag.v.01'),
   ...

code.v.02 tree:
[Synset('code.v.02'),
 [Synset('encode.v.01'),
   ...

词网并没有涵盖所有的单词和其信息(现今英语有约 17,0000 个单词,最新版的 词网 涵盖了约 15,5000 个),但它开了个好头。掌握了“词网”的各个概念后,如果你觉得它词汇少,不能满足你的需要,可以转而使用其他工具。或者,你也可以打造自己的“词网”!

自主尝试

使用 Python 库,下载维基百科的 “open source” 页面,并列出该页面所有单词的 同义词集 synset 和 词元 lemma 。

相似度比较

相似度比较的目的是识别出两篇文本的相似度,在搜索引擎、聊天机器人等方面有很多应用。

比如,相似度比较可以识别 football 和 soccer 是否有相似性。

syn1 = wordnet.synsets('football')
syn2 = wordnet.synsets('soccer')

# 一个单词可能有多个 同义词集,需要把 word1 的每个同义词集和 word2 的每个同义词集分别比较
for s1 in syn1:
    for s2 in syn2:
        print("Path similarity of: ")
        print(s1, '(', s1.pos(), ')', '[', s1.definition(), ']')
        print(s2, '(', s2.pos(), ')', '[', s2.definition(), ']')
        print("   is", s1.path_similarity(s2))
        print()
Path similarity of:
Synset('football.n.01') ( n ) [ any of various games played with a ball (round or oval) in which two teams try to kick or carry or propel the ball into each other's goal ]
Synset('soccer.n.01') ( n ) [ a football game in which two teams of 11 players try to kick or head a ball into the opponents' goal ]
   is 0.5

Path similarity of:
Synset('football.n.02') ( n ) [ the inflated oblong ball used in playing American football ]
Synset('soccer.n.01') ( n ) [ a football game in which two teams of 11 players try to kick or head a ball into the opponents' goal ]
   is 0.05

两个词各个同义词集之间 路径相似度 path similarity 最大的是 0.5,表明它们关联性很大( 路径相似度 path similarity 指两个词的意义在 上下义关系的词汇分类结构 hypernym/hypnoym taxonomy 中的最短距离)。

那么 code 和 bug 呢?这两个计算机领域的词的相似度是:

Path similarity of:
Synset('code.n.01') ( n ) [ a set of rules or principles or laws (especially written ones) ]
Synset('bug.n.02') ( n ) [ a fault or defect in a computer program, system, or machine ]
   is 0.1111111111111111
...
Path similarity of:
Synset('code.n.02') ( n ) [ a coding system used for transmitting messages requiring brevity or secrecy ]
Synset('bug.n.02') ( n ) [ a fault or defect in a computer program, system, or machine ]
   is 0.09090909090909091
...
Path similarity of:
Synset('code.n.03') ( n ) [ (computer science) the symbolic arrangement of data or instructions in a computer program or the set of such instructions ]
Synset('bug.n.02') ( n ) [ a fault or defect in a computer program, system, or machine ]
   is 0.09090909090909091

这些是这两个词各同义词集之间 路径相似度 path similarity 的最大值,这些值表明两个词是有关联性的。

NLTK 提供多种 相似度计分器 similarity scorers ,比如:

  • path\_similarity
  • lch\_similarity
  • wup\_similarity
  • res\_similarity
  • jcn\_similarity
  • lin\_similarity

要进一步了解这些 相似度计分器 similarity scorers ,请查看 WordNet Interface 的 Similarity 部分。

自主尝试

使用 Python 库,从维基百科的 Category: Lists of computer terms 生成一个术语列表,然后计算各术语之间的相似度。

树和树库

使用 NLTK,你可以把文本表示成树状结构以便进行分析。

这里有一个例子:

这是一份简短的文本,对其做预处理和词性标注:

import nltk

text = "I love open source"
# Tokenize to words
words = nltk.tokenize.word_tokenize(text)
# POS tag the words
words_tagged = nltk.pos_tag(words)

要把文本转换成树状结构,你必须定义一个 语法 grammar 。这个例子里用的是一个基于 Penn Treebank tags 的简单语法。

# A simple grammar to create tree
grammar = "NP: {&lt;JJ&gt;&lt;NN&gt;}"

然后用这个 语法 grammar 创建一颗 树 tree :

# Create tree
parser = nltk.RegexpParser(grammar)
tree = parser.parse(words_tagged)
pprint(tree)

运行上面的代码,将得到:

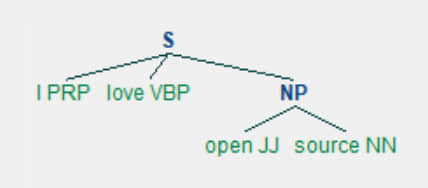
Tree('S', [('I', 'PRP'), ('love', 'VBP'), Tree('NP', [('open', 'JJ'), ('source', 'NN')])])

你也可以图形化地显示结果。

tree.draw()
 title=

这个树状结构有助于准确解读文本的意思。比如,用它可以找到文本的 主语):

subject_tags = ["NN", "NNS", "NP", "NNP", "NNPS", "PRP", "PRP$"]
def subject(sentence_tree):
    for tagged_word in sentence_tree:
        # A crude logic for this case -  first word with these tags is considered subject
        if tagged_word[1] in subject_tags:
            return tagged_word[0]

print("Subject:", subject(tree))

结果显示主语是 I:

Subject: I

这是一个比较基础的文本分析步骤,可以用到更广泛的应用场景中。 比如,在聊天机器人方面,如果用户告诉机器人:“给我妈妈 Jane 预订一张机票,1 月 1 号伦敦飞纽约的”,机器人可以用这种分析方法解读这个指令:

动作: 预订
动作的对象: 机票
乘客: Jane
出发地: 伦敦
目的地: 纽约
日期: (明年)1 月 1 号

树库 treebank 指由许多预先标注好的 树 tree 构成的语料库。现在已经有面向多种语言的树库,既有开源的,也有限定条件下才能免费使用的,以及商用的。其中使用最广泛的是面向英语的宾州树库。宾州树库取材于 华尔街日报 Wall Street Journal 。NLTK 也包含了宾州树库作为一个子语料库。下面是一些使用 树库 treebank 的方法:

words = nltk.corpus.treebank.words()
print(len(words), "words:")
print(words)

tagged_sents = nltk.corpus.treebank.tagged_sents()
print(len(tagged_sents), "sentences:")
print(tagged_sents)

100676 words:
['Pierre', 'Vinken', ',', '61', 'years', 'old', ',', ...]
3914 sentences:
[[('Pierre', 'NNP'), ('Vinken', 'NNP'), (',', ','), ('61', 'CD'), ('years', 'NNS'), ('old', 'JJ'), (',', ','), ('will', 'MD'), ('join', 'VB'), ('the', 'DT'), ('board', 'NN'), ('as', 'IN'), ('a', 'DT'), ('nonexecutive', 'JJ'), ('director', 'NN'), ...]

查看一个句子里的各个 标签 tags :

sent0 = tagged_sents[0]
pprint(sent0)
[('Pierre', 'NNP'),
 ('Vinken', 'NNP'),
 (',', ','),
 ('61', 'CD'),
 ('years', 'NNS'),
...

定义一个 语法 grammar 来把这个句子转换成树状结构:

grammar = '''
    Subject: {<NNP><NNP>}
    SubjectInfo: {<CD><NNS><JJ>}
    Action: {<MD><VB>}
    Object: {<DT><NN>}
    Stopwords: {<IN><DT>}
    ObjectInfo: {<JJ><NN>}
    When: {<NNP><CD>}
'''
parser = nltk.RegexpParser(grammar)
tree = parser.parse(sent0)
print(tree)
(S
  (Subject Pierre/NNP Vinken/NNP)
  ,/,
  (SubjectInfo 61/CD years/NNS old/JJ)
  ,/,
  (Action will/MD join/VB)
  (Object the/DT board/NN)
  as/IN
  a/DT
  (ObjectInfo nonexecutive/JJ director/NN)
  (Subject Nov./NNP)
  29/CD
  ./.)

图形化地显示:

tree.draw()

 title=

树 trees 和 树库 treebanks 的概念是文本分析的一个强大的组成部分。

自主尝试

使用 Python 库,下载维基百科的 “open source” 页面,将得到的文本以图形化的树状结构展现出来。

命名实体识别

无论口语还是书面语都包含着重要数据。文本处理的主要目标之一,就是提取出关键数据。几乎所有应用场景所需要提取关键数据,比如航空公司的订票机器人或者问答机器人。 NLTK 为此提供了一个 命名实体识别 named entity recognition 的功能。

这里有一个代码示例:

sentence = 'Peterson first suggested the name "open source" at Palo Alto, California'

验证这个句子里的 人名 name 和 地名 place 有没有被识别出来。照例先预处理:

import nltk

words = nltk.word_tokenize(sentence)
pos_tagged = nltk.pos_tag(words)

运行 命名实体标注器 named-entity tagger :

ne_tagged = nltk.ne_chunk(pos_tagged)
print("NE tagged text:")
print(ne_tagged)
print()
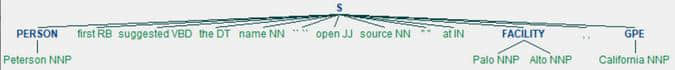
NE tagged text:
(S
  (PERSON Peterson/NNP)
  first/RB
  suggested/VBD
  the/DT
  name/NN
  ``/``
  open/JJ
  source/NN
  ''/''
  at/IN
  (FACILITY Palo/NNP Alto/NNP)
  ,/,
  (GPE California/NNP))

上面的结果里,命名实体被识别出来并做了标注;只提取这个 树 tree 里的命名实体:

print("Recognized named entities:")
for ne in ne_tagged:
    if hasattr(ne, "label"):
        print(ne.label(), ne[0:])
Recognized named entities:
PERSON [('Peterson', 'NNP')]
FACILITY [('Palo', 'NNP'), ('Alto', 'NNP')]
GPE [('California', 'NNP')]

图形化地显示:

ne_tagged.draw()
 title=

NLTK 内置的 命名实体标注器 named-entity tagger ,使用的是宾州法尼亚大学的 Automatic Content Extraction(ACE)程序。该标注器能够识别 组织机构 ORGANIZATION 、人名 PERSON 、地名 LOCATION 、设施 FACILITY 和 地缘政治实体 geopolitical entity 等常见 实体 entites 。

NLTK 也可以使用其他 标注器 tagger ,比如 Stanford Named Entity Recognizer. 这个经过训练的标注器用 Java 写成,但 NLTK 提供了一个使用它的接口(详情请查看 nltk.parse.stanford 或 nltk.tag.stanford)。

自主尝试

使用 Python 库,下载维基百科的 “open source” 页面,并识别出对 开源 open source 有影响力的人的名字,以及他们为 开源 open source 做贡献的时间和地点。

高级实践

如果你准备好了,尝试用这篇文章以及此前的文章介绍的知识构建一个 超级结构 superstructure 。

使用 Python 库,下载维基百科的 “Category: Computer science page”,然后:

  • 找出其中频率最高的 单词 unigrams 、二元搭配 bigrams 和 三元搭配 trigrams ,将它们作为一个关键词列表或者技术列表。相关领域的学生或者工程师需要了解这样一份列表里的内容。
  • 图形化地显示这个领域里重要的人名、技术、日期和地点。这会是一份很棒的信息图。
  • 构建一个搜索引擎。你的搜索引擎性能能够超过维基百科吗?

下一步?

自然语言处理是 应用构建 application building 的典型支柱。NLTK 是经典、丰富且强大的工具集,提供了为现实世界构建有吸引力、目标明确的应用的工作坊。

在这个系列的文章里,我用 NLTK 作为例子,展示了自然语言处理可以做什么。自然语言处理和 NLTK 还有太多东西值得探索,这个系列的文章只是帮助你探索它们的切入点。

如果你的需求增长到 NLTK 已经满足不了了,你可以训练新的模型或者向 NLTK 添加新的功能。基于 NLTK 构建的新的自然语言处理库正在不断涌现,机器学习也正被深度用于自然语言处理。


via: https://opensource.com/article/20/8/nlp-python-nltk

作者:Girish Managoli 选题:lujun9972 译者:tanloong 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

经历了近 30 年的发展, FreeDOS 已经成为了世界先进的 DOS。

 title=

一个大师正在给他的一个弟子讲 编程之道。 “编程之道包含在所有的软件中 —— 不管它多么微不足道,” 大师说道。

“编程之道在手持计算器里面吗?” 弟子问道。

“是的,” 大师回答道。

“编程之道在电子游戏里面吗?” 弟子继续问道。

“即便是电子游戏中,” 大师说。

“那编程之道在个人电脑的 DOS 里面吗?”

大师咳嗽了一下,稍稍改变了一下姿势,说道,“今天的课就到这里吧。”

——《编程之道》,Geoffrey James,InfoBooks,1987

过去,计算仅限于昂贵的大型机和“大铁疙瘩”计算机系统,如 PDP 11。但是微处理器的出现在 20 世纪 70 年代带来了一场计算革命。你终于可以在家里有一台电脑了——“个人电脑”时代已经到了!

我记得看到的最早的个人电脑包括 Commodore、TRS-80 和 Apple。个人电脑成了一个热门话题,所以 IBM 决定进入这个市场。在经历了一个快速开发周期之后,IBM 于 1981 年 8 月发布了 IBM 5150 个人电脑(最初的“IBM PC”)。

从零开始创建一台计算机并非易事,因此 IBM 以用“现成”的硬件来构建 PC 而闻名,并从外部开发商那里获得了其他组件的授权。其中之一是微软授权的操作系统。反过来,微软从西雅图计算机产品公司获得了 86-DOS ,进行了各种更新,并将新版本作为 IBM PC-DOS 与 IBM PC 一起首次亮相。

早期的 DOS

运行在最多只有 640 千字节内存中的 DOS,除了管理硬件和允许用户启动应用程序之外,真的做不了什么。因此,PC-DOS 1.0 命令行非常贫乏,只包含了一些设置日期和时间、管理文件、控制终端和格式化软盘的命令。DOS 还包括一个 BASIC 语言解释器,这是那个时代所有个人计算机的一个标准功能。

直到 PC-DOS 2.0,DOS 才变得更加有趣,为命令行添加了新的命令,并包含了其他有用的工具。但对我来说,直到 1991 年的 MS-DOS 5.0 才有了“现代感”。微软在这个版本中对 DOS 进行了大修,更新了许多命令,并用一个新的全屏编辑器取代了老旧的 Edlin 编辑器,使之更方便用户使用。DOS 5 还包括我喜欢的其他特性,比如基于微软 QuickBASIC 编译器的新 BASIC 解释器,简称 QBASIC. 如果你曾经在 DOS 上玩过 Gorillas 游戏,那可能就是在 MS-DOS 5.0 中运行的。

尽管进行了这些升级,但我对 DOS 命令行并不完全满意。DOS 从来没有偏离原来的设计,有其局限性。DOS 为用户提供了一些工具,可以从命令行执行一些事情 —— 否则,你就得使用 DOS 命令行来启动应用程序。微软认为用户大部分时间都会花在几个关键的应用程序上,比如文字处理器或电子表格。

但是开发人员想要一个功能更强的 DOS,此时一个细分行业正在萌芽,以提供小巧优雅的工具和程序。有些是全屏应用程序,但也有许多是增强 DOS 命令环境的命令行实用程序。当我学会一点 C 语言编程时,我开始编写自己的实用程序,扩展或替换 DOS 命令行。尽管 MS-DOS 的基础相当有限,但我发现第三方实用程序加上我自己的工具创建了一个功能强大的 DOS 命令行。

FreeDOS

1994 年初,我开始在科技杂志上看到很多对微软高管的采访,他们说下一个版本的 Windows 将完全取代 DOS。我以前使用过 Windows,但如果你还记得那个时代,你就知道 Windows 3.1 并不是一个很好的平台。Windows 3.1 很笨重,有很多毛病,如果一个应用程序崩溃,它可能会使整个 Windows 系统瘫痪。我也不喜欢 Windows 的图形用户界面。我更喜欢在命令行做我的工作,而不是用鼠标。

我考虑过 Windows,并决定,“如果 Windows 3.2 或 Windows 4.0 会像 Windows 3.1 一样,我就不会去使用它。” 但我有什么选择?此时,我已经尝试过 Linux,并认为 Linux 很棒,但是 Linux 没有任何应用程序。我的文字处理器、电子表格和其他程序都在 DOS 上。我需要 DOS。

然后我有了个主意!我想,“如果开发人员能够在互联网上共同编写一个完整的 Unix 操作系统,那么我们当然可以对 DOS 做同样的事情。”毕竟,与 Unix 相比,DOS 是一个相当简单的操作系统。DOS 一次运行一个任务(单任务),并且有一个更简单的内存模型。编写我们自己的 DOS 应该不难。

因此,在 1994 年 6 月 29 日,我在一个名为 Usenet 的留言板网络上向 “comp.os.msdos.apps” 发布了一个公告:

PD-DOS 项目公告:

几个月前,我发表了关于启动公共领域版本的 DOS 的文章。 当时大家对此的普遍支持,许多人都同意这样的说法:“开始编写吧!”所以,我就……

宣布首次生产 PD-DOS 的努力。我已经写了一个“清单”,描述了这样一个项目的目标和工作大纲,以及一个“任务列表”,它准确地显示了需要编写什么。我会把这些贴在这里,供大家讨论。

* 关于这个名字的说明 —— 我希望这个新的 DOS 成为每个人都可以使用的东西,我天真地认为,当每个人都可以使用它时,它就是“公共领域”。我很快就意识到了这种差别,所以我们把 “PD-DOS” 改名为 “Free-DOS”,然后去掉连字符变成 “FreeDOS”。

一些开发人员联系我,提供他们为替换或增强 DOS 命令行而创建的实用程序,类似于我自己的努力。就在项目宣布几个月后,我们汇集了我们的实用程序,并创建了一个实用的系统,我们在 1994 年 9 月发布了一个 “Alpha 1” 版本。在那些日子里,发展是相当迅速的,我们在 1994 年 12 月发布了 “Alpha 2”,1995 年 1 月发布了 “Alpha 3”,1995 年 6 月发布了“Alpha 4”。

一个现代的 DOS

从那以后,我们一直致力于使 FreeDOS 成为 “现代” DOS。而这种现代化大部分都集中在创建一个丰富的命令行环境上。是的,DOS 仍然需要支持应用程序,但是我们相信 FreeDOS 也需要一个强大的命令行环境。这就是为什么 FreeDOS 包含了许多有用的工具,包括浏览目录、管理文件、播放音乐、连接网络的命令,……以及类似 Unix 的实用程序集合,如 less、du、head、tail、sed 和 tr。

虽然 FreeDOS 的开发已经放缓,但它并没有停止。开发人员继续为 FreeDOS 编写新程序,并向 FreeDOS 添加新功能。我对 FreeDOS 1.3 RC4 的几个重要补充感到特别兴奋,FreeDOS 1.3 RC4 是即将发布的 FreeDOS 1.3 的最新候选版本。最近的一些更新如下:

  • Mateusz Viste 创建了一个新的电子书阅读器,名为 Ancient Machine Book(AMB),我们利用它作为 FreeDOS 1.3 RC4 中的新帮助系统。
  • Rask Ingemann Lambertsen、Andrew Jenner、TK Chia 和其他人正在更新 GCC 的 IA-16 版本,包括一个新的libi86 库,它提供了与 Borland TurboC++ 编译器的 C 库的某种程度的兼容性。
  • Jason Hood 更新了一个可卸载的 CD-ROM 重定向器,以替代微软的 MSCDEX,最多支持 10 个驱动器。
  • SuperIlu 创建了 DOjS,这是一个 Javascript 开发画布,具有集成的编辑器、图形和声音输出,以及鼠标、键盘和操纵杆输入。
  • Japheth 创建了一个 DOS32PAE 扩展程序,它能够通过 PAE 分页使用大量的内存。

尽管 FreeDOS 有了新的发展,我们仍然忠于我们的 DOS 根基。在我们继续朝着 FreeDOS 1.3 “最终”版本努力时,我们带着几个核心假设,包括:

  • 兼容性是关键 —— 如果 FreeDOS 不能运行经典 DOS 应用程序,它就不是真正的 “DOS”。虽然我们提供了许多优秀的开源工具、应用程序和游戏,但你也可以运行你的传统的 DOS 应用程序。
  • 继续在旧 PC 上运行(XT、286、386 等) —— FreeDOS 1.3 将保持 16 位英特尔架构,但在可能的情况下将支持扩展驱动程序支持的新硬件。为此,我们继续专注于单用户命令行环境。
  • FreeDOS 是开源软件 —— 我一直说,如果人们不能访问、学习和修改源代码,FreeDOS 就不是“自由的 DOS”。FreeDOS 1.3 将包括尽可能多地包括使用公认的开源许可证的软件。但 DOS 实际上早于 GNU 通用公共许可证(1989)和开放源码定义(1998),因此一些 DOS 软件可能会使用它自己的“免费源代码”许可证,而不是标准的“开源”许可。当我们考虑将软件包纳入 FreeDOS 时,我们将继续评估任何许可证,以确保它们是合适的“开放源码”,即使它们没有得到正式承认。

我们欢迎你的帮助,使 FreeDOS 强大!请加入我们的电子邮件列表,我们欢迎所有新来者和贡献者。我们通过电子邮件列表进行交流,不过这个列表的信件量非常小,所以不太可能撑爆你的收件箱。

访问 FreeDOS 网站 www.freedos.org。


via: https://opensource.com/article/21/6/history-freedos

作者:Jim Hall 选题:lujun9972 译者:zxy-wyx 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出
iPhone 被曝不安全:不点击链接也有可能被入侵

一般来说,如果信息中出现未知链接或者钓鱼链接,不要点击就会很安全,但这样做对以色列 NSO Group 公司并不适用。报告发现,iPhone 如果感染 NSO Group 的恶意软件,攻击者就能窃取信息和邮件,甚至可以控制手机麦克风摄像头。NSO Group 的软件可以用苹果不知道的方法窃取数据,即使 iPhone 软件保持在最新状态,如运行 iOS 14.6 系统的 iPhone 12。

这才是专业“黑客”,简直是间谍手段。

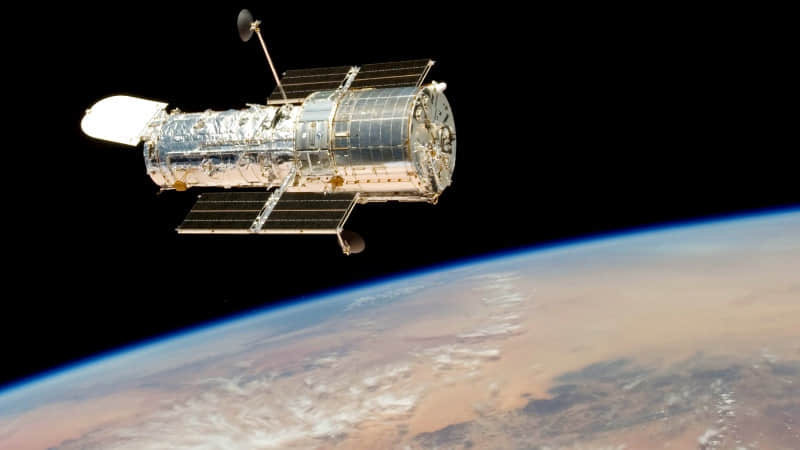
哈勃望远镜在经历了一个月的技术问题后恢复科学操作

NASA 已经成功地重新启动了哈勃太空望远镜,此前该望远镜因技术老化而暂停科学操作一个月。6月13日,哈勃望远镜的有效载荷计算机崩溃了,它自动暂停了科学运行,并将望远镜的仪器置于安全模式。重新启动也未能使其恢复操作。最终,NASA 确定,故障在于监控电源控制单元内电压水平的调节电路。通过切换到备用组件,开启了备用有效载荷计算机,并为其加载飞行软件。再经过一些测试和校准,科学操作终于得以恢复。

这么老的计算机居然还能继续修复好并正常工作,简直是奇迹了。

Canonical 通过了新冠疫情考验,反而扭亏为盈

早在新冠疫情之前,Ubuntu 的发行商 Canonical 就已经拥有一支分布式的全球员工队伍。于是在 Linux 生态持续蓬勃发展的大环境下,除了设法从 2019 年的亏损 200 万美元到 2020 年的实现盈利 2000 万美元,Canonical 甚至将员工数增加到了 500 人以上。

一方面,新冠疫情打乱了一些客户的规划,进而导致销售额可能持续下滑。但另一方面,公有云运营商助其实现了营收的稳定。