标签 python 下的文章

本文讲述的是 Python 中 Mock 的使用。

如何执行单元测试而不用考验你的耐心

很多时候,我们编写的软件会直接与那些被标记为“垃圾”的服务交互。用外行人的话说:服务对我们的应用程序很重要,但是我们想要的是交互,而不是那些不想要的副作用,这里的“不想要”是在自动化测试运行的语境中说的。例如:我们正在写一个社交 app,并且想要测试一下 "发布到 Facebook" 的新功能,但是不想每次运行测试集的时候真的发布到 Facebook。

Python 的 unittest 库包含了一个名为 unittest.mock 或者可以称之为依赖的子包,简称为 mock —— 其提供了极其强大和有用的方法,通过它们可以 模拟 ( mock ) 并去除那些我们不希望的副作用。

注意:mock 最近被收录到了 Python 3.3 的标准库中;先前发布的版本必须通过 PyPI 下载 Mock 库。

恐惧系统调用

再举另一个例子,我们在接下来的部分都会用到它,这是就是系统调用。不难发现,这些系统调用都是主要的模拟对象:无论你是正在写一个可以弹出 CD 驱动器的脚本,还是一个用来删除 /tmp 下过期的缓存文件的 Web 服务,或者一个绑定到 TCP 端口的 socket 服务器,这些调用都是在你的单元测试上下文中不希望产生的副作用。

作为一个开发者,你需要更关心你的库是否成功地调用了一个可以弹出 CD 的系统函数(使用了正确的参数等等),而不是切身经历 CD 托盘每次在测试执行的时候都打开了。(或者更糟糕的是,弹出了很多次,在一个单元测试运行期间多个测试都引用了弹出代码!)

同样,保持单元测试的效率和性能意味着需要让如此多的“缓慢代码”远离自动测试,比如文件系统和网络访问。

对于第一个例子来说,我们要从原始形式换成使用 mock 重构一个标准 Python 测试用例。我们会演示如何使用 mock 写一个测试用例,使我们的测试更加智能、快速,并展示更多关于我们软件的工作原理。

一个简单的删除函数

我们都有过需要从文件系统中一遍又一遍的删除文件的时候,因此,让我们在 Python 中写一个可以使我们的脚本更加轻易完成此功能的函数。

#!/usr/bin/env python
# -*- coding: utf-8 -*-

import os

def rm(filename):
    os.remove(filename)

很明显,我们的 rm 方法此时无法提供比 os.remove 方法更多的相关功能,但我们可以在这里添加更多的功能,使我们的基础代码逐步改善。

让我们写一个传统的测试用例,即,没有使用 mock:

#!/usr/bin/env python
# -*- coding: utf-8 -*-

from mymodule import rm

import os.path
import tempfile
import unittest

class RmTestCase(unittest.TestCase):

    tmpfilepath = os.path.join(tempfile.gettempdir(), "tmp-testfile")

    def setUp(self):
        with open(self.tmpfilepath, "wb") as f:
            f.write("Delete me!")

    def test_rm(self):
        # remove the file
        rm(self.tmpfilepath)
        # test that it was actually removed
        self.assertFalse(os.path.isfile(self.tmpfilepath), "Failed to remove the file.")

我们的测试用例相当简单,但是在它每次运行的时候,它都会创建一个临时文件并且随后删除。此外,我们没有办法测试我们的 rm 方法是否正确地将我们的参数向下传递给 os.remove 调用。我们可以基于以上的测试认为它做到了,但还有很多需要改进的地方。

使用 Mock 重构

让我们使用 mock 重构我们的测试用例:

#!/usr/bin/env python
# -*- coding: utf-8 -*-

from mymodule import rm

import mock
import unittest

class RmTestCase(unittest.TestCase):

    @mock.patch('mymodule.os')
    def test_rm(self, mock_os):
        rm("any path")
        # test that rm called os.remove with the right parameters
        mock_os.remove.assert_called_with("any path")

使用这些重构,我们从根本上改变了测试用例的操作方式。现在,我们有一个可以用于验证其他功能的内部对象。

潜在陷阱

第一件需要注意的事情就是,我们使用了 mock.patch 方法装饰器,用于模拟位于 mymodule.os 的对象,并且将 mock 注入到我们的测试用例方法。那么只是模拟 os 本身,而不是 mymodule.os 下 os 的引用(LCTT 译注:注意 @mock.patch('mymodule.os') 便是模拟 mymodule.os 下的 os),会不会更有意义呢?

当然,当涉及到导入和管理模块,Python 的用法就像蛇一样灵活。在运行时,mymodule 模块有它自己的被导入到本模块局部作用域的 os。因此,如果我们模拟 os,我们是看不到 mock 在 mymodule 模块中的模仿作用的。

这句话需要深刻地记住:

模拟一个东西要看它用在何处,而不是来自哪里。

如果你需要为 myproject.app.MyElaborateClass 模拟 tempfile 模块,你可能需要将 mock 用于 myproject.app.tempfile,而其他模块保持自己的导入。

先将那个陷阱放一边,让我们继续模拟。

向 ‘rm’ 中加入验证

之前定义的 rm 方法相当的简单。在盲目地删除之前,我们倾向于验证一个路径是否存在,并验证其是否是一个文件。让我们重构 rm 使其变得更加智能:

#!/usr/bin/env python
# -*- coding: utf-8 -*-

import os
import os.path

def rm(filename):
    if os.path.isfile(filename):
        os.remove(filename)

很好。现在,让我们调整测试用例来保持测试的覆盖率。

#!/usr/bin/env python
# -*- coding: utf-8 -*-

from mymodule import rm

import mock
import unittest

class RmTestCase(unittest.TestCase):

    @mock.patch('mymodule.os.path')
    @mock.patch('mymodule.os')
    def test_rm(self, mock_os, mock_path):
        # set up the mock
        mock_path.isfile.return_value = False

        rm("any path")

        # test that the remove call was NOT called.
        self.assertFalse(mock_os.remove.called, "Failed to not remove the file if not present.")

        # make the file 'exist'
        mock_path.isfile.return_value = True

        rm("any path")

        mock_os.remove.assert_called_with("any path")

我们的测试用例完全改变了。现在我们可以在没有任何副作用的情况下核实并验证方法的内部功能。

将文件删除作为服务

到目前为止,我们只是将 mock 应用在函数上,并没应用在需要传递参数的对象和实例的方法上。我们现在开始涵盖对象的方法。

首先,我们将 rm 方法重构成一个服务类。实际上将这样一个简单的函数转换成一个对象,在本质上这不是一个合理的需求,但它能够帮助我们了解 mock 的关键概念。让我们开始重构:

#!/usr/bin/env python
# -*- coding: utf-8 -*-

import os
import os.path

class RemovalService(object):
    """A service for removing objects from the filesystem."""

    def rm(filename):
        if os.path.isfile(filename):
            os.remove(filename)

你会注意到我们的测试用例没有太大变化:

#!/usr/bin/env python
# -*- coding: utf-8 -*-

from mymodule import RemovalService

import mock
import unittest

class RemovalServiceTestCase(unittest.TestCase):

    @mock.patch('mymodule.os.path')
    @mock.patch('mymodule.os')
    def test_rm(self, mock_os, mock_path):
        # instantiate our service
        reference = RemovalService()

        # set up the mock
        mock_path.isfile.return_value = False

        reference.rm("any path")

        # test that the remove call was NOT called.
        self.assertFalse(mock_os.remove.called, "Failed to not remove the file if not present.")

        # make the file 'exist'
        mock_path.isfile.return_value = True

        reference.rm("any path")

        mock_os.remove.assert_called_with("any path")

很好,我们知道 RemovalService 会如预期般的工作。接下来让我们创建另一个服务,将 RemovalService 声明为它的一个依赖:

#!/usr/bin/env python
# -*- coding: utf-8 -*-

import os
import os.path

class RemovalService(object):
    """A service for removing objects from the filesystem."""

    def rm(self, filename):
        if os.path.isfile(filename):
            os.remove(filename)


class UploadService(object):

    def __init__(self, removal_service):
        self.removal_service = removal_service

    def upload_complete(self, filename):
        self.removal_service.rm(filename)

因为我们的测试覆盖了 RemovalService,因此我们不会对我们测试用例中 UploadService 的内部函数 rm 进行验证。相反,我们将调用 UploadService 的 RemovalService.rm 方法来进行简单测试(当然没有其他副作用),我们通过之前的测试用例便能知道它可以正确地工作。

这里有两种方法来实现测试:

  1. 模拟 RemovalService.rm 方法本身。
  2. 在 UploadService 的构造函数中提供一个模拟实例。

因为这两种方法都是单元测试中非常重要的方法,所以我们将同时对这两种方法进行回顾。

方法 1:模拟实例的方法

mock 库有一个特殊的方法装饰器,可以模拟对象实例的方法和属性,即 @mock.patch.object decorator 装饰器:

#!/usr/bin/env python
# -*- coding: utf-8 -*-

from mymodule import RemovalService, UploadService

import mock
import unittest

class RemovalServiceTestCase(unittest.TestCase):

    @mock.patch('mymodule.os.path')
    @mock.patch('mymodule.os')
    def test_rm(self, mock_os, mock_path):
        # instantiate our service
        reference = RemovalService()

        # set up the mock
        mock_path.isfile.return_value = False

        reference.rm("any path")

        # test that the remove call was NOT called.
        self.assertFalse(mock_os.remove.called, "Failed to not remove the file if not present.")

        # make the file 'exist'
        mock_path.isfile.return_value = True

        reference.rm("any path")

        mock_os.remove.assert_called_with("any path")


class UploadServiceTestCase(unittest.TestCase):

    @mock.patch.object(RemovalService, 'rm')
    def test_upload_complete(self, mock_rm):
        # build our dependencies
        removal_service = RemovalService()
        reference = UploadService(removal_service)

        # call upload_complete, which should, in turn, call `rm`:
        reference.upload_complete("my uploaded file")

        # check that it called the rm method of any RemovalService
        mock_rm.assert_called_with("my uploaded file")

        # check that it called the rm method of _our_ removal_service
        removal_service.rm.assert_called_with("my uploaded file")

非常棒!我们验证了 UploadService 成功调用了我们实例的 rm 方法。你是否注意到一些有趣的地方?这种修补机制(patching mechanism)实际上替换了我们测试用例中的所有 RemovalService 实例的 rm 方法。这意味着我们可以检查实例本身。如果你想要了解更多,可以试着在你模拟的代码下断点,以对这种修补机制的原理获得更好的认识。

陷阱:装饰顺序

当我们在测试方法中使用多个装饰器,其顺序是很重要的,并且很容易混乱。基本上,当装饰器被映射到方法参数时,装饰器的工作顺序是反向的。思考这个例子:

    @mock.patch('mymodule.sys')
    @mock.patch('mymodule.os')
    @mock.patch('mymodule.os.path')
    def test_something(self, mock_os_path, mock_os, mock_sys):
        pass

注意到我们的参数和装饰器的顺序是反向匹配了吗?这部分是由 Python 的工作方式所导致的。这里是使用多个装饰器的情况下它们执行顺序的伪代码:

patch_sys(patch_os(patch_os_path(test_something)))

因为 sys 补丁位于最外层,所以它最晚执行,使得它成为实际测试方法参数的最后一个参数。请特别注意这一点,并且在运行你的测试用例时,使用调试器来保证正确的参数以正确的顺序注入。

方法 2:创建 Mock 实例

我们可以使用构造函数为 UploadService 提供一个 Mock 实例,而不是模拟特定的实例方法。我更推荐方法 1,因为它更加精确,但在多数情况,方法 2 或许更加有效和必要。让我们再次重构测试用例:

#!/usr/bin/env python
# -*- coding: utf-8 -*-

from mymodule import RemovalService, UploadService

import mock
import unittest

class RemovalServiceTestCase(unittest.TestCase):

    @mock.patch('mymodule.os.path')
    @mock.patch('mymodule.os')
    def test_rm(self, mock_os, mock_path):
        # instantiate our service
        reference = RemovalService()

        # set up the mock
        mock_path.isfile.return_value = False

        reference.rm("any path")

        # test that the remove call was NOT called.
        self.assertFalse(mock_os.remove.called, "Failed to not remove the file if not present.")

        # make the file 'exist'
        mock_path.isfile.return_value = True

        reference.rm("any path")

        mock_os.remove.assert_called_with("any path")


class UploadServiceTestCase(unittest.TestCase):

    def test_upload_complete(self, mock_rm):
        # build our dependencies
        mock_removal_service = mock.create_autospec(RemovalService)
        reference = UploadService(mock_removal_service)

        # call upload_complete, which should, in turn, call `rm`:
        reference.upload_complete("my uploaded file")

        # test that it called the rm method
        mock_removal_service.rm.assert_called_with("my uploaded file")

在这个例子中,我们甚至不需要修补任何功能,只需为 RemovalService 类创建一个 auto-spec,然后将实例注入到我们的 UploadService 以验证功能。

mock.create_autospec 方法为类提供了一个同等功能实例。实际上来说,这意味着在使用返回的实例进行交互的时候,如果使用了非法的方式将会引发异常。更具体地说,如果一个方法被调用时的参数数目不正确,将引发一个异常。这对于重构来说是非常重要。当一个库发生变化的时候,中断测试正是所期望的。如果不使用 auto-spec,尽管底层的实现已经被破坏,我们的测试仍然会通过。

陷阱:mock.Mock 和 mock.MagicMock 类

mock 库包含了两个重要的类 mock.Mock 和 mock.MagicMock,大多数内部函数都是建立在这两个类之上的。当在选择使用 mock.Mock 实例、mock.MagicMock 实例还是 auto-spec 的时候,通常倾向于选择使用 auto-spec,因为对于未来的变化,它更能保持测试的健全。这是因为 mock.Mock 和 mock.MagicMock 会无视底层的 API,接受所有的方法调用和属性赋值。比如下面这个用例:

class Target(object):
    def apply(value):
        return value

def method(target, value):
    return target.apply(value)

我们可以像下面这样使用 mock.Mock 实例进行测试:

class MethodTestCase(unittest.TestCase):

    def test_method(self):
        target = mock.Mock()

        method(target, "value")

        target.apply.assert_called_with("value")

这个逻辑看似合理,但如果我们修改 Target.apply 方法接受更多参数:

class Target(object):
    def apply(value, are_you_sure):
        if are_you_sure:
            return value
        else:
            return None

重新运行你的测试,你会发现它仍能通过。这是因为它不是针对你的 API 创建的。这就是为什么你总是应该使用 create_autospec 方法,并且在使用 @patch和 @patch.object 装饰方法时使用 autospec 参数。

现实例子:模拟 Facebook API 调用

作为这篇文章的结束,我们写一个更加适用的现实例子,一个在介绍中提及的功能:发布消息到 Facebook。我将写一个不错的包装类及其对应的测试用例。

import facebook

class SimpleFacebook(object):

    def __init__(self, oauth_token):
        self.graph = facebook.GraphAPI(oauth_token)

    def post_message(self, message):
        """Posts a message to the Facebook wall."""
        self.graph.put_object("me", "feed", message=message)

这是我们的测试用例,它可以检查我们发布的消息,而不是真正地发布消息:

import facebook
import simple_facebook
import mock
import unittest

class SimpleFacebookTestCase(unittest.TestCase):

    @mock.patch.object(facebook.GraphAPI, 'put_object', autospec=True)
    def test_post_message(self, mock_put_object):
        sf = simple_facebook.SimpleFacebook("fake oauth token")
        sf.post_message("Hello World!")

        # verify
        mock_put_object.assert_called_with(message="Hello World!")

正如我们所看到的,在 Python 中,通过 mock,我们可以非常容易地动手写一个更加智能的测试用例。

Python Mock 总结

即使对它的使用还有点不太熟悉,对单元测试来说,Python 的 mock 库可以说是一个规则改变者。我们已经演示了常见的用例来了解了 mock 在单元测试中的使用,希望这篇文章能够帮助 Python 开发者克服初期的障碍,写出优秀、经受过考验的代码。


via: https://www.toptal.com/python/an-introduction-to-mocking-in-python

作者:NAFTULI TZVI KAY 译者:cposture 校对:wxy
本文由 LCTT 原创翻译,Linux中国 荣誉推出

在“Linux 平台下 Python 脚本编程入门”系列之前的文章里,我们向你介绍了 Python 的简介,它的命令行 shell 和 IDLE(LCTT 译注:python 自带的一个 IDE)。我们也演示了如何进行算术运算、如何在变量中存储值、还有如何打印那些值到屏幕上。最后,我们通过一个练习示例讲解了面向对象编程中方法和属性概念。

在 Python 编程中写 Linux Shell 脚本

本篇中,我们会讨论控制流(根据用户输入的信息、计算的结果,或者一个变量的当前值选择不同的动作行为)和循环(自动重复执行任务),接着应用我们目前所学东西来编写一个简单的 shell 脚本,这个脚本会显示操作系统类型、主机名、内核版本、版本号和机器硬件架构。

这个例子尽管很基础,但是会帮助我们证明,比起使用一般的 bash 工具,我们通过发挥 Python 面向对象的特性来编写 shell 脚本会更简单些。

换句话说,我们想从这里出发:

# uname -snrvm

检查 Linux 的主机名

到

用 Python 脚本来检查 Linux 的主机名

或者

用脚本检查 Linux 系统信息

看着不错,不是吗?那我们就挽起袖子,开干吧。

Python 中的控制流

如我们刚说那样,控制流允许我们根据一个给定的条件,选择不同的输出结果。在 Python 中最简单的实现就是一个 if/else 语句。

基本语法是这样的:

if 条件:
    # 动作 1
else:
    # 动作 2

当“条件”求值为真(true),下面的代码块就会被执行(# 动作 1代表的部分)。否则,else 下面的代码就会运行。 “条件”可以是任何表达式,只要可以求得值为真或者假。

举个例子:

  1. 1 < 3 # 真
  2. firstName == "Gabriel" # 对 firstName 为 Gabriel 的人是真,对其他不叫 Gabriel 的人为假
  • 在第一个例子中,我们比较了两个值,判断 1 是否小于 3。
  • 在第二个例子中,我们比较了 firstName(一个变量)与字符串 “Gabriel”,看在当前执行的位置,firstName 的值是否等于该字符串。
  • 条件和 else 表达式都必须跟着一个冒号(:)。
  • 缩进在 Python 中非常重要。同样缩进下的行被认为是相同的代码块。

请注意,if/else 表达式只是 Python 中许多控制流工具的一个而已。我们先在这里了解以下,后面会用在我们的脚本中。你可以在官方文档中学到更多工具。

Python 中的循环

简单来说,一个循环就是一组指令或者表达式序列,可以按顺序一直执行,只要条件为真,或者对列表里每个项目执行一一次。

Python 中最简单的循环,就是用 for 循环迭代一个给定列表的元素,或者对一个字符串从第一个字符开始到执行到最后一个字符结束。

基本语句:

for x in example:
    # do this

这里的 example 可以是一个列表或者一个字符串。如果是列表,变量 x 就代表列表中每个元素;如果是字符串,x 就代表字符串中每个字符。

>>> rockBands = []
>>> rockBands.append("Roxette")
>>> rockBands.append("Guns N' Roses")
>>> rockBands.append("U2")
>>> for x in rockBands:
        print(x)
或
>>> firstName = "Gabriel"
>>> for x in firstName:
        print(x)

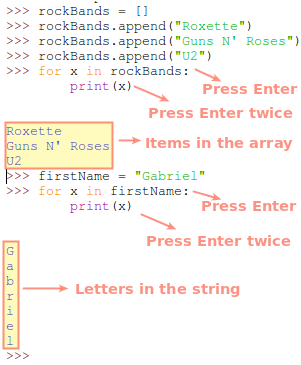
上面例子的输出如下图所示:

学习 Python 中的循环

Python 模块

很明显,必须有个办法将一系列的 Python 指令和表达式保存到文件里,然后在需要的时候取出来。

准确来说模块就是这样的。比如,os 模块提供了一个到操作系统的底层的接口,可以允许我们做许多通常在命令行下执行的操作。

没错,os 模块包含了许多可以用来调用的方法和属性,就如我们之前文章里讲解的那样。不过,我们需要使用 import 关键词导入(或者叫包含)模块到运行环境里来:

>>> import os

我们来打印出当前的工作目录:

>>> os.getcwd()

学习 Python 模块

现在,让我们把这些结合在一起(包括之前文章里讨论的概念),编写需要的脚本。

Python 脚本

以一段声明文字开始一个脚本是个不错的想法,它可以表明脚本的目的、发布所依据的许可证,以及一个列出做出的修改的修订历史。尽管这主要是个人喜好,但这会让我们的工作看起来比较专业。

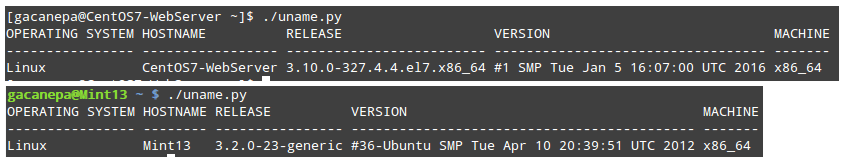
这里有个脚本,可以输出这篇文章最前面展示的那样。脚本做了大量的注释,可以让大家可以理解发生了什么。

在进行下一步之前,花点时间来理解它。注意,我们是如何使用一个 if/else 结构,判断每个字段标题的长度是否比字段本身的值还大。

基于比较结果,我们用空字符去填充一个字段标题和下一个之间的空格。同时,我们使用一定数量的短线作为字段标题与其值之间的分割符。

#!/usr/bin/python3
# 如果你没有安装 Python 3 ,那么修改这一行为 #!/usr/bin/python

# Script name: uname.py
# Purpose: Illustrate Python OOP capabilities to write shell scripts more easily
# License: GPL v3 (http://www.gnu.org/licenses/gpl.html)

# Copyright (C) 2016 Gabriel Alejandro Cánepa
# ​Facebook / Skype / G+ / Twitter / Github: gacanepa
# Email: gacanepa (at) gmail (dot) com

# This program is free software: you can redistribute it and/or modify
# it under the terms of the GNU General Public License as published by
# the Free Software Foundation, either version 3 of the License, or
# (at your option) any later version.

# This program is distributed in the hope that it will be useful,
# but WITHOUT ANY WARRANTY; without even the implied warranty of
# MERCHANTABILITY or FITNESS FOR A PARTICULAR PURPOSE.  See the
# GNU General Public License for more details.

# You should have received a copy of the GNU General Public License
# along with this program.  If not, see .

# REVISION HISTORY
# DATE        VERSION AUTHOR         CHANGE DESCRIPTION
# ---------- ------- --------------
# 2016-05-28 1.0     Gabriel Cánepa    Initial version

### 导入 os 模块
import os

### 将 os.uname() 的输出赋值给 systemInfo 变量
### os.uname() 会返回五个字符串元组(sysname, nodename, release, version, machine)
### 参见文档:https://docs.python.org/3.2/library/os.html#module-os
systemInfo = os.uname()

### 这是一个固定的数组,用于描述脚本输出的字段标题
headers = ["Operating system","Hostname","Release","Version","Machine"]

### 初始化索引值,用于定义每一步迭代中
### systemInfo 和字段标题的索引
index = 0

### 字段标题变量的初始值
caption = ""

### 值变量的初始值
values = ""

### 分隔线变量的初始值
separators = ""

### 开始循环
for item in systemInfo:
    if len(item) < len(headers[index]):
     ### 一个包含横线的字符串,横线长度等于item[index] 或 headers[index]
     ### 要重复一个字符,用引号圈起来并用星号(*)乘以所需的重复次数 
     separators = separators + "-" * len(headers[index]) + " "
     caption = caption + headers[index] + " "
     values = values + systemInfo[index] + " " * (len(headers[index]) - len(item)) + " "
    else:
     separators = separators + "-" * len(item) + " "
     caption =  caption + headers[index] + " " * (len(item) - len(headers[index]) + 1)
     values = values + item + " "
    ### 索引加 1
    index = index + 1
### 终止循环

### 输出转换为大写的变量(字段标题)名
print(caption.upper())

### 输出分隔线
print(separators)

# 输出值(systemInfo 中的项目)
print(values)

### 步骤:
### 1) 保持该脚本为 uname.py (或任何你想要的名字)
### 并通过如下命令给其执行权限:
### chmod +x uname.py
### 2) 执行它;
### ./uname.py

如果你已经按照上述描述将上面的脚本保存到一个文件里,并给文件增加了执行权限,那么运行它:

# chmod +x uname.py
# ./uname.py

如果试图运行脚本时你得到了如下的错误:

-bash: ./uname.py: /usr/bin/python3: bad interpreter: No such file or directory

这意味着你没有安装 Python3。如果那样的话,你要么安装 Python3 的包,要么替换解释器那行(如果如之前文章里概述的那样,跟着下面的步骤去更新 Python 执行文件的软连接,要特别注意并且非常小心):

#!/usr/bin/python3

为

#!/usr/bin/python

这样会通过使用已经安装好的 Python 2 去执行该脚本。

注意:该脚本在 Python 2.x 与 Pyton 3.x 上都测试成功过了。

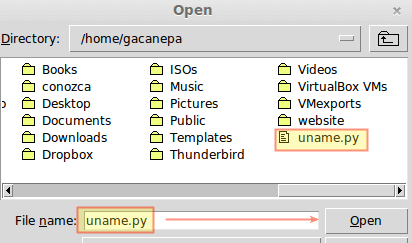
尽管比较粗糙,你可以认为该脚本就是一个 Python 模块。这意味着你可以在 IDLE 中打开它(File → Open… → Select file):

在 IDLE 中打开 Python

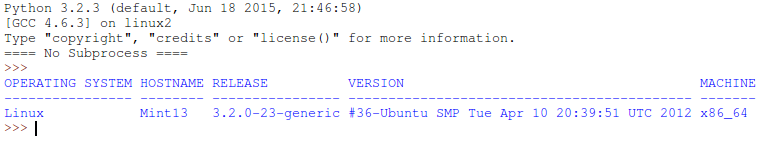
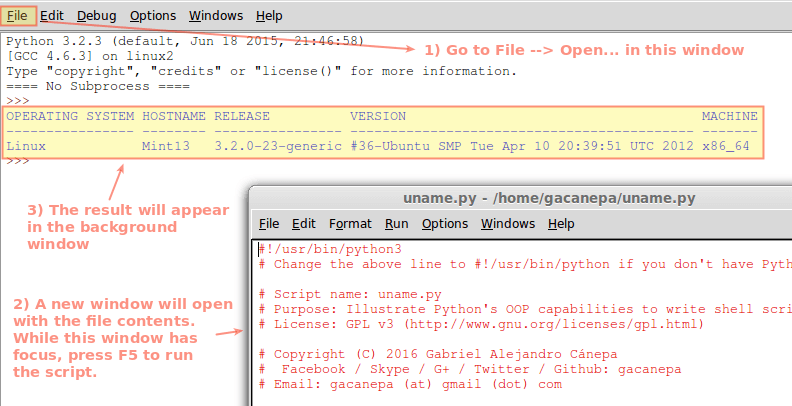
一个包含有文件内容的新窗口就会打开。然后执行 Run → Run module(或者按 F5)。脚本的输出就会在原始的 Shell 里显示出来:

执行 Python 脚本

如果你想纯粹用 bash 写一个脚本,也获得同样的结果,你可能需要结合使用 awk、sed,并且借助复杂的方法来存储与获得列表中的元素(不要忘了使用 tr 命令将小写字母转为大写)。

另外,在所有的 Linux 系统版本中都至少集成了一个 Python 版本(2.x 或者 3.x,或者两者都有)。你还需要依赖 shell 去完成同样的目标吗?那样你可能需要为不同的 shell 编写不同的版本。

这里演示了面向对象编程的特性,它会成为一个系统管理员得力的助手。

注意:你可以在我的 Github 仓库里获得 这个 python 脚本(或者其他的)。

总结

这篇文章里,我们讲解了 Python 中控制流、循环/迭代、和模块的概念。我们也演示了如何利用 Python 中面向对象编程的方法和属性来简化复杂的 shell 脚本。

你有任何其他希望去验证的想法吗?开始吧,写出自己的 Python 脚本,如果有任何问题可以咨询我们。不必犹豫,在分割线下面留下评论,我们会尽快回复你。


via: http://www.tecmint.com/learn-python-programming-to-write-linux-shell-scripts/

作者:Gabriel Cánepa 译者:wi-cuckoo 校对:wxy
本文由 LCTT 原创编译,Linux中国 荣誉推出

众所周知,系统管理员需要精通一门脚本语言,而且招聘机构列出的职位需求上也会这么写。大多数人会认为 Bash (或者其他的 shell 语言)用起来很方便,但一些强大的语言(比如 Python)会给你带来一些其它的好处。

在 Linux 中学习 Python 脚本编程

首先,我们会使用 Python 的命令行工具,还会接触到 Python 的面向对象特性(这篇文章的后半部分会谈到它)。

学习 Python 可以助力于你在桌面应用开发及数据科学领域的职业发展。

容易上手,广泛使用,拥有海量“开箱即用”的模块(它是一组包含 Python 语句的外部文件),Python 理所当然地成为了美国计算机专业大学生在一年级时所上的程序设计课所用语言的不二之选。

在这个由两篇文章构成的系列中,我们将回顾 Python 的基础部分,希望初学编程的你能够将这篇实用的文章作为一个编程入门的跳板,和日后使用 Python 时的一篇快速指引。

Linux 中的 Python

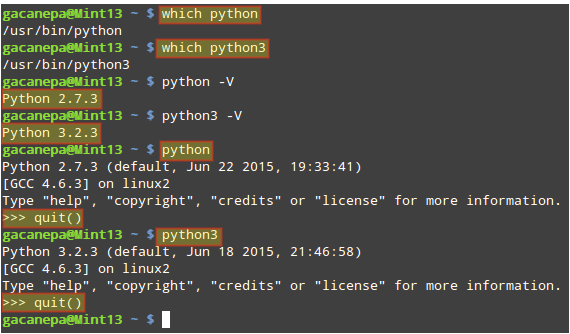
Python 2.x 和 3.x 通常已经内置在现代 Linux 发行版中,你可以立刻使用它。你可以终端模拟器中输入 python 或 python3 来进入 Python shell, 并输入 quit() 退出。

$ which python
$ which python3
$ python -v
$ python3 -v
$ python
>>> quit()
$ python3
>>> quit()

在 Linux 中运行 Python 命令

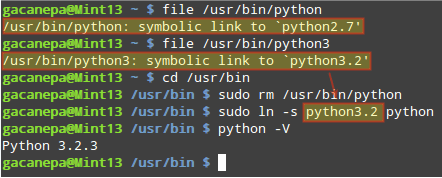
如果你希望在键入 python 时使用 Python 3.x 而不是 2.x,你可以像下面一样更改对应的符号链接:

$ sudo rm /usr/bin/python 
$ cd /usr/bin
$ ln -s python3.2 python # Choose the Python 3.x binary here

删除 Python 2,使用 Python 3

顺便一提,有一点需要注意:尽管 Python 2.x 仍旧被使用,但它并不会被积极维护。因此,你可能要考虑像上面指示的那样来切换到 3.x。2.x 和 3.x 的语法有一些不同,我们会在这个系列文章中使用后者。

另一个在 Linux 中使用 Python 的方法是通过 IDLE ( Python 集成开发环境 ( the Python Integrated Development Environment ) ),这是一个为编写 Python 代码而生的图形用户界面。在安装它之前,你最好查看一下适用于你的 Linux 发行版的 IDLE 可用版本。

# aptitude search idle     [Debian 及其衍生发行版]
# yum search idle          [CentOS 和 Fedora]
# dnf search idle          [Fedora 23+ 版本]

然后,你可以像下面一样安装它:

$ sudo aptitude install idle-python3.2    # I'm using Linux Mint 13

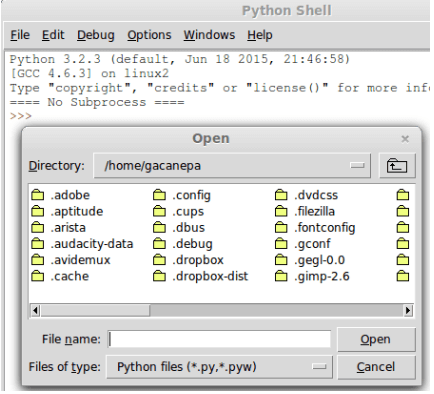
安装成功后,你会看到 IDLE 的运行画面。它很像 Python shell,但是你可以用它做更多 Python shell 做不了的事。

比如,你可以:

  1. 轻松打开外部文件 (File → Open);

Python Shell

  1. 复制 (Ctrl + C) 和粘贴 (Ctrl + V) 文本;
  2. 查找和替换文本;
  3. 显示可能的代码补全(一个在其他 IDE 里可能叫做“智能感知”或者“自动补完”的功能);
  4. 更改字体和字号,等等。

最厉害的是,你可以用 IDLE 创建桌面应用。

我们在这两篇文章中不会开发桌面应用,所以你可以根据喜好来选择 IDLE 或 Python shell 去运行下面的例子。

Python 中的基本运算

就像你预料的那样,你能够直接进行算术操作(你可以在你的所有运算中使用足够多的括号!),还可以轻松地使用 Python 拼接字符串。

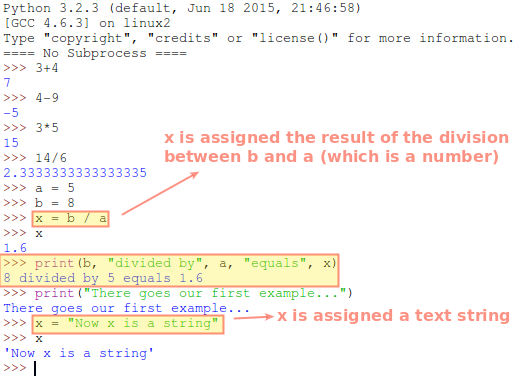
你还可以将运算结果赋给一个变量,然后在屏幕上显示它。Python 有一个叫做拼接 (concatenation) 的实用功能——给 print 函数提供一串用逗号分隔的变量和/或字符串,它会返回一个由你刚才提供的变量依序构成的句子:

>>> a = 5
>>> b = 8
>>> x = b / a
>>> x
1.6
>>> print(b, "divided by", a, "equals", x)

注意,你可以将不同类型的变量(数字,字符串,布尔符号等等)混合在一起。当你将一个值赋给一个变量后,你可以随后更改它的类型,不会有任何问题(因此,Python 被称为动态类型语言)。

如果你尝试在静态类型语言中(如 Java 或 C#)做这件事,它将抛出一个错误。

学习 Python 的基本操作

面向对象编程的简单介绍

在面向对象编程(OOP)中,程序中的所有实体都会由对象的形式呈现,并且它们可以与其他对象交互。因此,对象拥有属性,而且大多数对象可以执行动作(这被称为对象的方法)。

举个例子:我们来想象一下,创建一个对象“狗”。它可能拥有的一些属性有颜色、品种、年龄等等,而它可以完成的动作有 叫()、吃()、睡觉(),诸如此类。

你可以看到,方法名后面会跟着一对括号,括号当中可能会包含一个或多个参数(向方法中传递的值),也有可能什么都不包含。

我们用 Python 的基本对象类型之一——列表来解释这些概念。

解释对象的属性和方法:Python 中的列表

列表是条目的有序组合,而这些条目所属的数据类型并不需要相同。我们像下面一样来使用一对方括号,来创建一个名叫 rockBands 的列表:

你可以向 rockBands 的 append() 方法传递条目,来将它添加到列表的尾部,就像下面这样:

>>> rockBands = []
>>> rockBands.append("The Beatles")
>>> rockBands.append("Pink Floyd")
>>> rockBands.append("The Rolling Stones")

为了从列表中移除元素,我们可以向 remove() 方法传递特定元素,或向 pop() 中传递列表中待删除元素的位置(从 0 开始计数)。

换句话说,我们可以用下面这种方法来从列表中删除 “The Beatles”:

>>> rockBands.remove("The Beatles")

或者用这种方法:

>>> rockBands.pop(0)

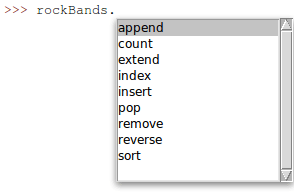
如果你输入了对象的名字,然后在后面输入了一个点,你可以按 Ctrl + space 来显示这个对象的可用方法列表。

列出可用的 Python 方法

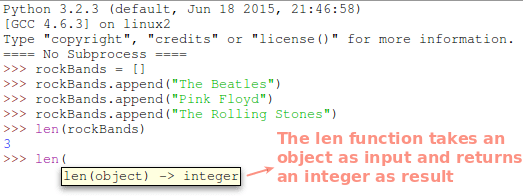
列表中含有的元素个数是它的一个属性。它通常被叫做“长度”,你可以通过向内建函数 len 传递一个列表作为它的参数来显示该列表的长度(顺便一提,之前的例子中提到的 print 语句,是 Python 的另一个内建函数)。

如果你在 IDLE 中输入 len,然后跟上一个不闭合的括号,你会看到这个函数的默认语法:

Python 的 len 函数

现在我们来看看列表中的特定条目。它们也有属性和方法吗?答案是肯定的。比如,你可以将一个字符串条目转换为大写形式,并获取这个字符串所包含的字符数量。像下面这样做:

>>> rockBands[0].upper()
'THE BEATLES'
>>> len(rockBands[0])
11

总结

在这篇文章中,我们简要介绍了 Python、它的命令行 shell、IDLE,展示了如何执行算术运算,如何在变量中存储数据,如何使用 print 函数在屏幕上重新显示那些数据(无论是它们本身还是它们的一部分),还通过一个实际的例子解释了对象的属性和方法。

下一篇文章中,我们会展示如何使用条件语句和循环语句来实现流程控制。我们也会解释如何编写一个脚本来帮助我们完成系统管理任务。

你是不是想继续学习一些有关 Python 的知识呢?敬请期待本系列的第二部分(我们会在脚本中将 Python 和命令行工具的优点结合在一起),你还可以考虑购买我们的《终极 Python 编程》系列教程(这里有详细信息)。

像往常一样,如果你对这篇文章有什么问题,可以向我们寻求帮助。你可以使用下面的联系表单向我们发送留言,我们会尽快回复你。


via: http://www.tecmint.com/learn-python-programming-and-scripting-in-linux/

作者:Gabriel Cánepa 译者:StdioA 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

在第一部分中,我提出了一个问题:“如何在你刚刚搭建起来的 Web 服务器上适配 Django, Flask 或 Pyramid 应用,而不用单独对 Web 服务器做做出改动以适应各种不同的 Web 框架呢?”我们可以从这一篇中找到答案。

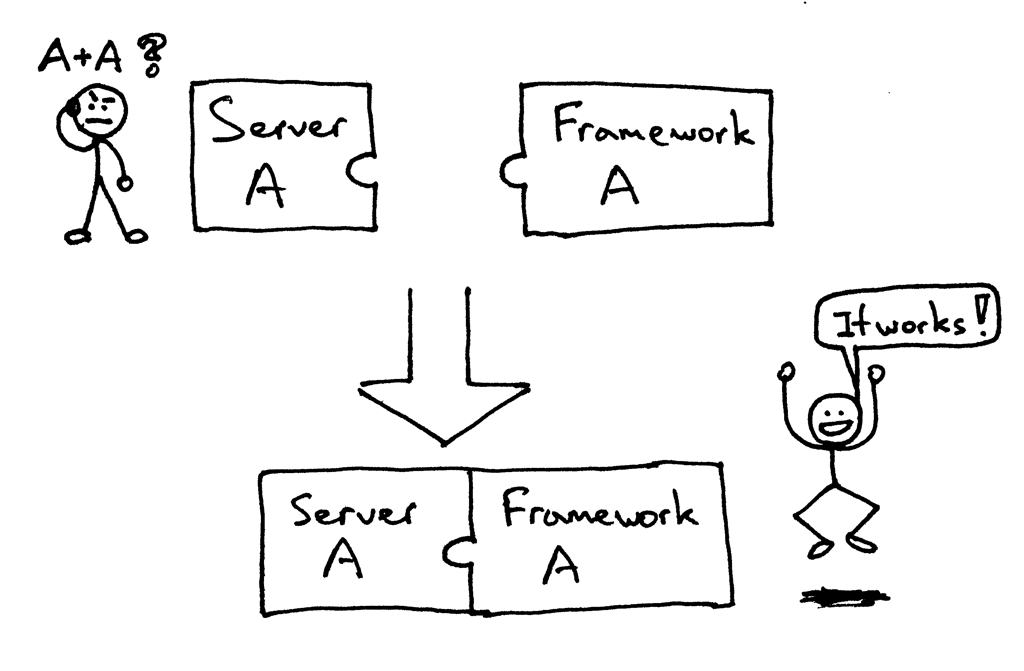
曾几何时,你所选择的 Python Web 框架会限制你所可选择的 Web 服务器,反之亦然。如果某个框架及服务器设计用来协同工作的,那么一切正常:

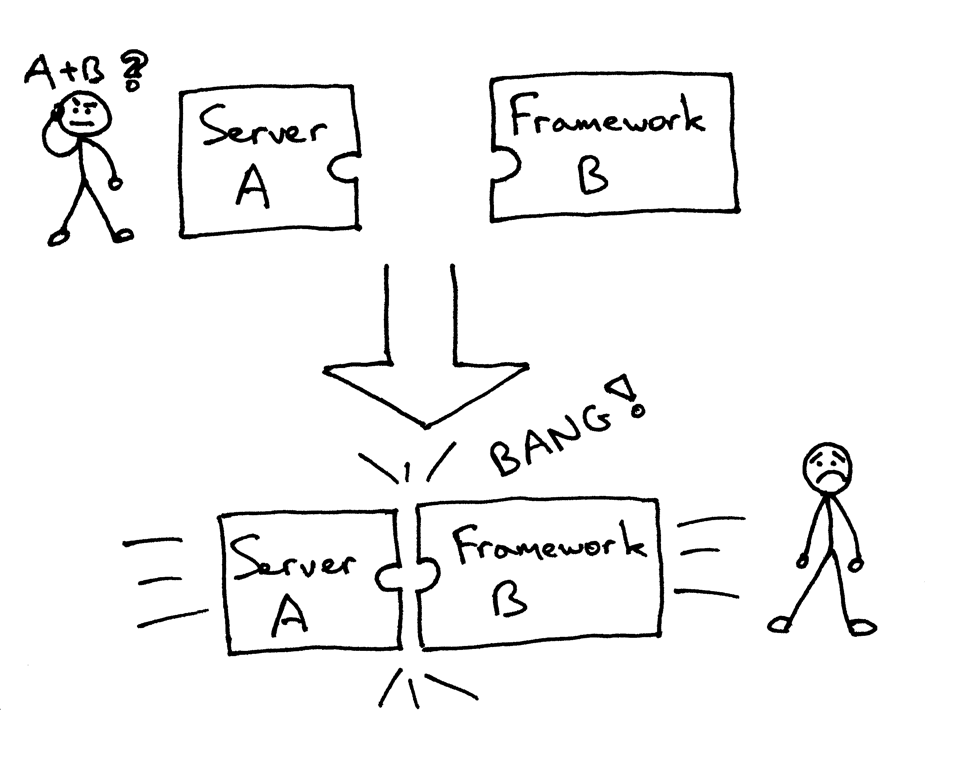
但你可能正面对着(或者曾经面对过)尝试将一对无法适配的框架和服务器搭配在一起的问题:

基本上,你需要选择那些能够一起工作的框架和服务器,而不能选择你想用的那些。

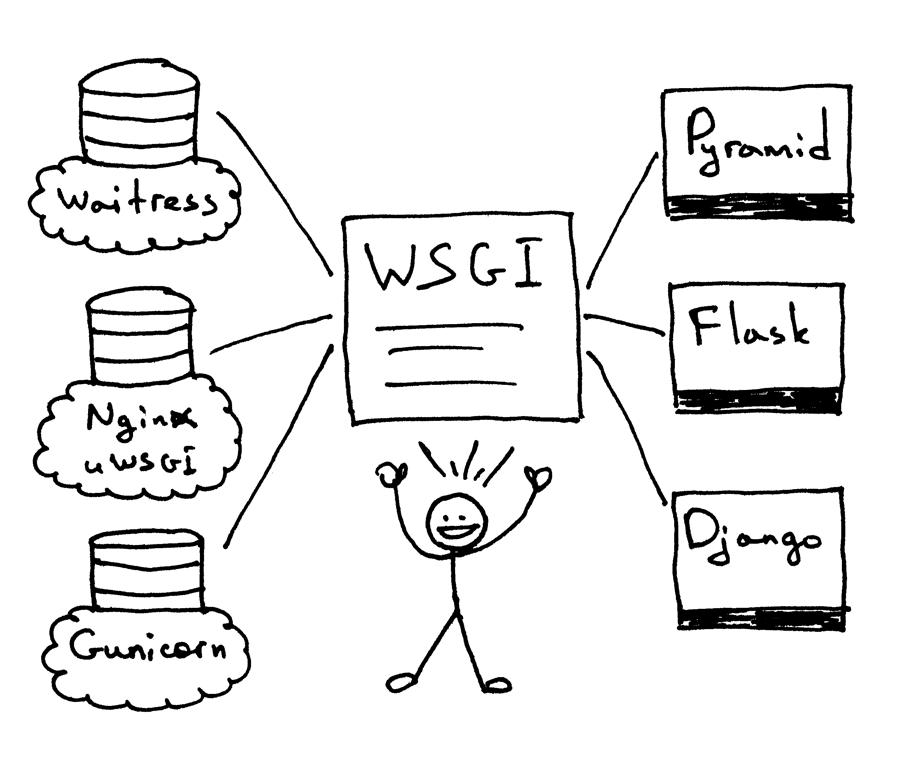
所以,你该如何确保在不对 Web 服务器或框架的代码做任何更改的情况下,让你的 Web 服务器和多个不同的 Web 框架一同工作呢?这个问题的答案,就是 Python Web 服务器网关接口 ( Web Server Gateway Interface ) (缩写为 WSGI,念做“wizgy”)。

WSGI 允许开发者互不干扰地选择 Web 框架及 Web 服务器的类型。现在,你可以真正将 Web 服务器及框架任意搭配,然后选出你最中意的那对组合。比如,你可以使用 Django,Flask 或者 Pyramid,与 Gunicorn,Nginx/uWSGI 或 Waitress 进行结合。感谢 WSGI 同时对服务器与框架的支持,我们可以真正随意选择它们的搭配了。

所以,WSGI 就是我在第一部分中提出,又在本文开头重复了一遍的那个问题的答案。你的 Web 服务器必须实现 WSGI 接口的服务器部分,而现代的 Python Web 框架均已实现了 WSGI 接口的框架部分,这使得你可以直接在 Web 服务器中使用任意框架,而不需要更改任何服务器代码,以对特定的 Web 框架实现兼容。

现在,你已经知道 Web 服务器及 Web 框架对 WSGI 的支持使得你可以选择最合适的一对来使用,而且它也有利于服务器和框架的开发者,这样他们只需专注于其擅长的部分来进行开发,而不需要触及另一部分的代码。其它语言也拥有类似的接口,比如:Java 拥有 Servlet API,而 Ruby 拥有 Rack。

这些理论都不错,但是我打赌你在说:“Show me the code!” 那好,我们来看看下面这个很小的 WSGI 服务器实现:

### 使用 Python 2.7.9,在 Linux 及 Mac OS X 下测试通过
import socket
import StringIO
import sys

class WSGIServer(object):

    address_family = socket.AF_INET
    socket_type = socket.SOCK_STREAM
    request_queue_size = 1

    def __init__(self, server_address):
        ### 创建一个监听的套接字
        self.listen_socket = listen_socket = socket.socket(
            self.address_family,
            self.socket_type
        )
        ### 允许复用同一地址
        listen_socket.setsockopt(socket.SOL_SOCKET, socket.SO_REUSEADDR, 1)
        ### 绑定地址
        listen_socket.bind(server_address)
        ### 激活套接字
        listen_socket.listen(self.request_queue_size)
        ### 获取主机的名称及端口
        host, port = self.listen_socket.getsockname()[:2]
        self.server_name = socket.getfqdn(host)
        self.server_port = port
        ### 返回由 Web 框架/应用设定的响应头部字段
        self.headers_set = []

    def set_app(self, application):
        self.application = application

    def serve_forever(self):
        listen_socket = self.listen_socket
        while True:
            ### 获取新的客户端连接
            self.client_connection, client_address = listen_socket.accept()
            ### 处理一条请求后关闭连接,然后循环等待另一个连接建立
            self.handle_one_request()

    def handle_one_request(self):
        self.request_data = request_data = self.client_connection.recv(1024)
        ### 以 'curl -v' 的风格输出格式化请求数据
        print(''.join(
            '< {line}\n'.format(line=line)
            for line in request_data.splitlines()
        ))

        self.parse_request(request_data)

        ### 根据请求数据构建环境变量字典
        env = self.get_environ()

        ### 此时需要调用 Web 应用来获取结果,
        ### 取回的结果将成为 HTTP 响应体
        result = self.application(env, self.start_response)

        ### 构造一个响应,回送至客户端
        self.finish_response(result)

    def parse_request(self, text):
        request_line = text.splitlines()[0]
        request_line = request_line.rstrip('
')
        ### 将请求行分成几个部分
        (self.request_method,  # GET
         self.path,            # /hello
         self.request_version  # HTTP/1.1
         ) = request_line.split()

    def get_environ(self):
        env = {}
        ### 以下代码段没有遵循 PEP8 规则,但这样排版,是为了通过强调
        ### 所需变量及它们的值,来达到其展示目的。
        ###
        ### WSGI 必需变量
        env['wsgi.version']      = (1, 0)
        env['wsgi.url_scheme']   = 'http'
        env['wsgi.input']        = StringIO.StringIO(self.request_data)
        env['wsgi.errors']       = sys.stderr
        env['wsgi.multithread']  = False
        env['wsgi.multiprocess'] = False
        env['wsgi.run_once']     = False
        ### CGI 必需变量
        env['REQUEST_METHOD']    = self.request_method    # GET
        env['PATH_INFO']         = self.path              # /hello
        env['SERVER_NAME']       = self.server_name       # localhost
        env['SERVER_PORT']       = str(self.server_port)  # 8888
        return env

    def start_response(self, status, response_headers, exc_info=None):
        ### 添加必要的服务器头部字段
        server_headers = [
            ('Date', 'Tue, 31 Mar 2015 12:54:48 GMT'),
            ('Server', 'WSGIServer 0.2'),
        ]
        self.headers_set = [status, response_headers + server_headers]
        ### 为了遵循 WSGI 协议,start_response 函数必须返回一个 'write'
        ### 可调用对象(返回值.write 可以作为函数调用)。为了简便,我们
        ### 在这里无视这个细节。
        ### return self.finish_response

    def finish_response(self, result):
        try:
            status, response_headers = self.headers_set
            response = 'HTTP/1.1 {status}
'.format(status=status)
            for header in response_headers:
                response += '{0}: {1}
'.format(*header)
            response += '
'
            for data in result:
                response += data
            ### 以 'curl -v' 的风格输出格式化请求数据
            print(''.join(
                '> {line}\n'.format(line=line)
                for line in response.splitlines()
            ))
            self.client_connection.sendall(response)
        finally:
            self.client_connection.close()

SERVER_ADDRESS = (HOST, PORT) = '', 8888

def make_server(server_address, application):
    server = WSGIServer(server_address)
    server.set_app(application)
    return server

if __name__ == '__main__':
    if len(sys.argv) < 2:
        sys.exit('Provide a WSGI application object as module:callable')
    app_path = sys.argv[1]
    module, application = app_path.split(':')
    module = __import__(module)
    application = getattr(module, application)
    httpd = make_server(SERVER_ADDRESS, application)
    print('WSGIServer: Serving HTTP on port {port} ...\n'.format(port=PORT))
    httpd.serve_forever()

当然,这段代码要比第一部分的服务器代码长不少,但它仍然很短(只有不到 150 行),你可以轻松理解它,而不需要深究细节。上面的服务器代码还可以做更多——它可以用来运行一些你喜欢的框架写出的 Web 应用,可以是 Pyramid,Flask,Django 或其它 Python WSGI 框架。

不相信吗?自己来试试看吧。把以上的代码保存为 webserver2.py,或直接从 Github 上下载它。如果你打算不加任何参数而直接运行它,它会抱怨一句,然后退出。

$ python webserver2.py
Provide a WSGI application object as module:callable

它想做的其实是为你的 Web 应用服务,而这才是重头戏。为了运行这个服务器,你唯一需要的就是安装好 Python。不过,如果你希望运行 Pyramid,Flask 或 Django 应用,你还需要先安装那些框架。那我们把这三个都装上吧。我推荐的安装方式是通过 virtualenv 安装。按照以下几步来做,你就可以创建并激活一个虚拟环境,并在其中安装以上三个 Web 框架。

$ [sudo] pip install virtualenv
$ mkdir ~/envs
$ virtualenv ~/envs/lsbaws/
$ cd ~/envs/lsbaws/
$ ls
bin  include  lib
$ source bin/activate
(lsbaws) $ pip install pyramid
(lsbaws) $ pip install flask
(lsbaws) $ pip install django

现在,你需要创建一个 Web 应用。我们先从 Pyramid 开始吧。把以下代码保存为 pyramidapp.py,并与刚刚的 webserver2.py 放置在同一目录,或直接从 Github 下载该文件:

from pyramid.config import Configurator
from pyramid.response import Response

def hello_world(request):
    return Response(
        'Hello world from Pyramid!\n',
        content_type='text/plain',
    )

config = Configurator()
config.add_route('hello', '/hello')
config.add_view(hello_world, route_name='hello')
app = config.make_wsgi_app()

现在,你可以用你自己的 Web 服务器来运行你的 Pyramid 应用了:

(lsbaws) $ python webserver2.py pyramidapp:app
WSGIServer: Serving HTTP on port 8888 ...

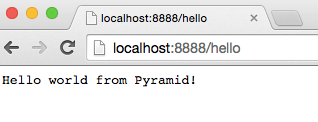
你刚刚让你的服务器去加载 Python 模块 pyramidapp 中的可执行对象 app。现在你的服务器可以接收请求,并将它们转发到你的 Pyramid 应用中了。在浏览器中输入 http://localhost:8888/hello ,敲一下回车,然后看看结果:

你也可以使用命令行工具 curl 来测试服务器:

$ curl -v http://localhost:8888/hello
...

看看服务器和 curl 向标准输出流打印的内容吧。

现在来试试 Flask。运行步骤跟上面的一样。

from flask import Flask
from flask import Response
flask_app = Flask('flaskapp')

@flask_app.route('/hello')
def hello_world():
    return Response(
        'Hello world from Flask!\n',
        mimetype='text/plain'
    )

app = flask_app.wsgi_app

将以上代码保存为 flaskapp.py,或者直接从 Github 下载,然后输入以下命令运行服务器:

(lsbaws) $ python webserver2.py flaskapp:app
WSGIServer: Serving HTTP on port 8888 ...

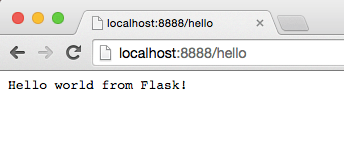
现在在浏览器中输入 http://localhost:8888/hello ,敲一下回车:

同样,尝试一下 curl,然后你会看到服务器返回了一条 Flask 应用生成的信息:

$ curl -v http://localhost:8888/hello
...

这个服务器能处理 Django 应用吗?试试看吧!不过这个任务可能有点复杂,所以我建议你将整个仓库克隆下来,然后使用 Github 仓库中的 djangoapp.py 来完成这个实验。这里的源代码主要是将 Django 的 helloworld 工程(已使用 Django 的 django-admin.py startproject 命令创建完毕)添加到了当前的 Python 路径中,然后导入了这个工程的 WSGI 应用。(LCTT 译注:除了这里展示的代码,还需要一个配合的 helloworld 工程才能工作,代码可以参见 Github 仓库。)

import sys
sys.path.insert(0, './helloworld')
from helloworld import wsgi

app = wsgi.application

将以上代码保存为 djangoapp.py,然后用你的 Web 服务器运行这个 Django 应用:

(lsbaws) $ python webserver2.py djangoapp:app
WSGIServer: Serving HTTP on port 8888 ...

输入以下链接,敲回车:

你这次也可以在命令行中测试——你之前应该已经做过两次了——来确认 Django 应用处理了你的请求:

$ curl -v http://localhost:8888/hello
...

你试过了吗?你确定这个服务器可以与那三个框架搭配工作吗?如果没试,请去试一下。阅读固然重要,但这个系列的内容是重新搭建,这意味着你需要亲自动手干点活。去试一下吧。别担心,我等着你呢。不开玩笑,你真的需要试一下,亲自尝试每一步,并确保它像预期的那样工作。

好,你已经体验到了 WSGI 的威力:它可以使 Web 服务器及 Web 框架随意搭配。WSGI 在 Python Web 服务器及框架之间提供了一个微型接口。它非常简单,而且在服务器和框架端均可以轻易实现。下面的代码片段展示了 WSGI 接口的服务器及框架端实现:

def run_application(application):
    """服务器端代码。"""
    ### Web 应用/框架在这里存储 HTTP 状态码以及 HTTP 响应头部,
    ### 服务器会将这些信息传递给客户端
    headers_set = []
    ### 用于存储 WSGI/CGI 环境变量的字典
    environ = {}

    def start_response(status, response_headers, exc_info=None):
        headers_set[:] = [status, response_headers]

    ### 服务器唤醒可执行变量“application”,获得响应头部
    result = application(environ, start_response)
    ### 服务器组装一个 HTTP 响应,将其传送至客户端
    …

def app(environ, start_response):
    """一个空的 WSGI 应用"""
    start_response('200 OK', [('Content-Type', 'text/plain')])
    return ['Hello world!']

run_application(app)

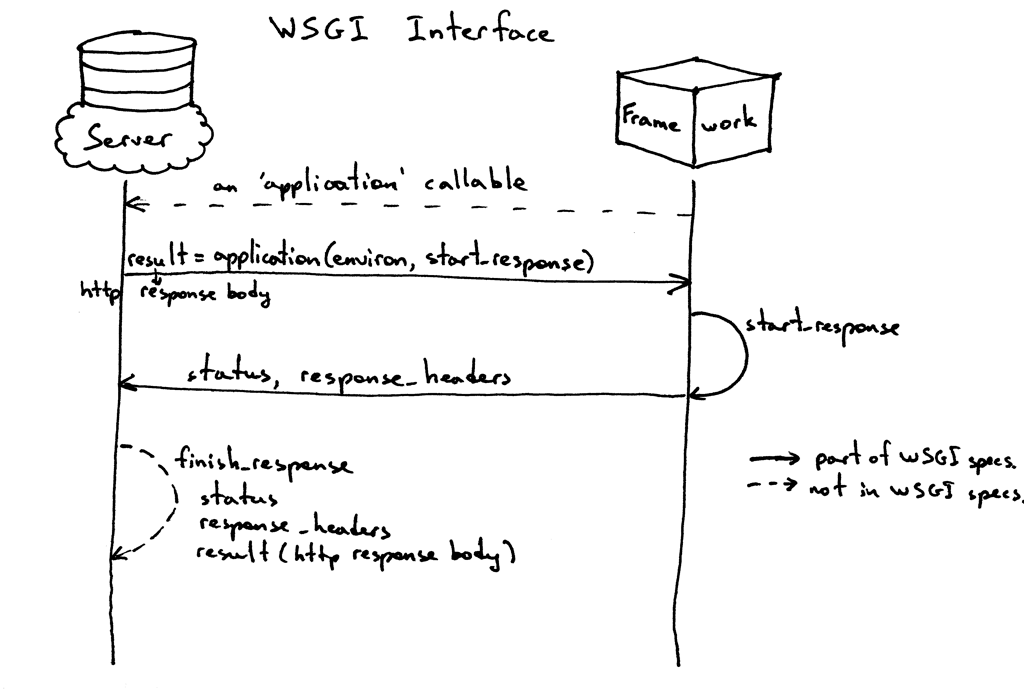
这是它的工作原理:

  1. Web 框架提供一个可调用对象 application (WSGI 规范没有规定它的实现方式)。
  2. Web 服务器每次收到来自客户端的 HTTP 请求后,会唤醒可调用对象 applition。它会向该对象传递一个包含 WSGI/CGI 变量的环境变量字典 environ,以及一个可调用对象 start_response。
  3. Web 框架或应用生成 HTTP 状态码和 HTTP 响应头部,然后将它传给 start_response 函数,服务器会将其存储起来。同时,Web 框架或应用也会返回 HTTP 响应正文。
  4. 服务器将状态码、响应头部及响应正文组装成一个 HTTP 响应,然后将其传送至客户端(这一步并不在 WSGI 规范中,但从逻辑上讲,这一步应该包含在工作流程之中。所以为了明确这个过程,我把它写了出来)

这是这个接口规范的图形化表达:

到现在为止,你已经看过了用 Pyramid、Flask 和 Django 写出的 Web 应用的代码,你也看到了一个 Web 服务器如何用代码来实现另一半(服务器端的) WSGI 规范。你甚至还看到了我们如何在不使用任何框架的情况下,使用一段代码来实现一个最简单的 WSGI Web 应用。

其实,当你使用上面的框架编写一个 Web 应用时,你只是在较高的层面工作,而不需要直接与 WSGI 打交道。但是我知道你一定也对 WSGI 接口的框架部分感兴趣,因为你在看这篇文章呀。所以,我们不用 Pyramid、Flask 或 Django,而是自己动手来创造一个最朴素的 WSGI Web 应用(或 Web 框架),然后将它和你的服务器一起运行:

def app(environ, start_response):
    """一个最简单的 WSGI 应用。

    这是你自己的 Web 框架的起点 ^_^
    """
    status = '200 OK'
    response_headers = [('Content-Type', 'text/plain')]
    start_response(status, response_headers)
    return ['Hello world from a simple WSGI application!\n']

同样,将上面的代码保存为 wsgiapp.py 或直接从 Github 上下载该文件,然后在 Web 服务器上运行这个应用,像这样:

(lsbaws) $ python webserver2.py wsgiapp:app
WSGIServer: Serving HTTP on port 8888 ...

在浏览器中输入下面的地址,然后按下回车。这是你应该看到的结果:

你刚刚在学习如何创建一个 Web 服务器的过程中自己编写了一个最朴素的 WSGI Web 框架!棒极了!

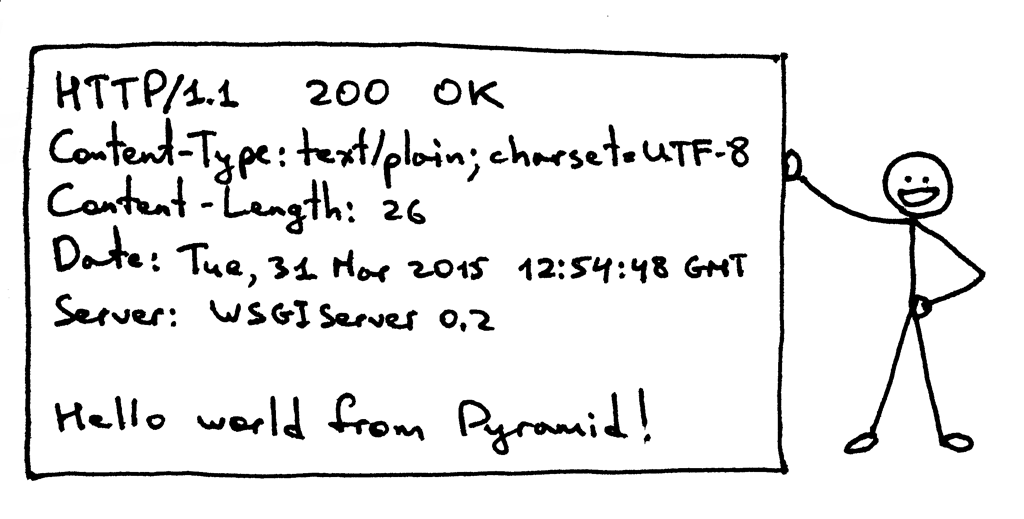
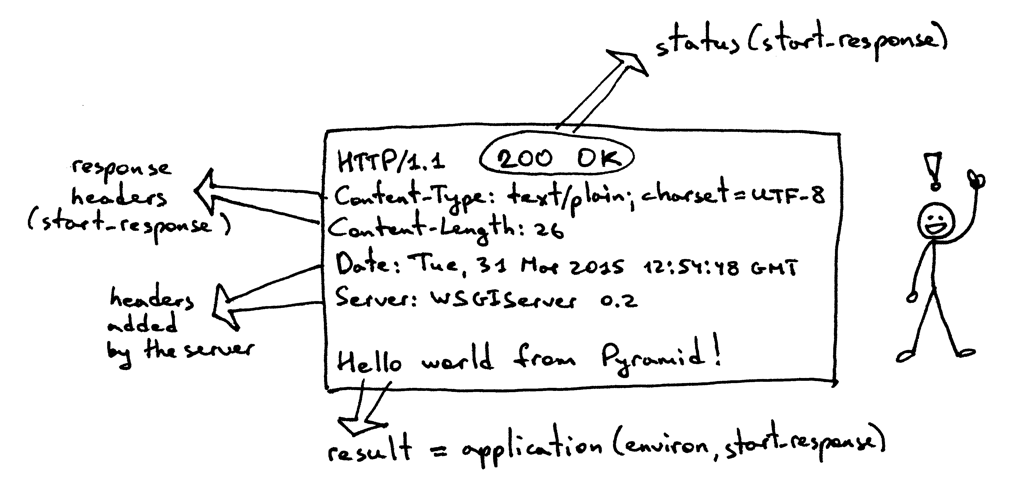
现在,我们再回来看看服务器传给客户端的那些东西。这是在使用 HTTP 客户端调用你的 Pyramid 应用时,服务器生成的 HTTP 响应内容:

这个响应和你在本系列第一部分中看到的 HTTP 响应有一部分共同点,但它还多出来了一些内容。比如说,它拥有四个你曾经没见过的 HTTP 头部:Content-Type, Content-Length, Date 以及 Server。这些头部内容基本上在每个 Web 服务器返回的响应中都会出现。不过,它们都不是被严格要求出现的。这些 HTTP 请求/响应头部字段的目的在于它可以向你传递一些关于 HTTP 请求/响应的额外信息。

既然你对 WSGI 接口了解的更深了一些,那我再来展示一下上面那个 HTTP 响应中的各个部分的信息来源:

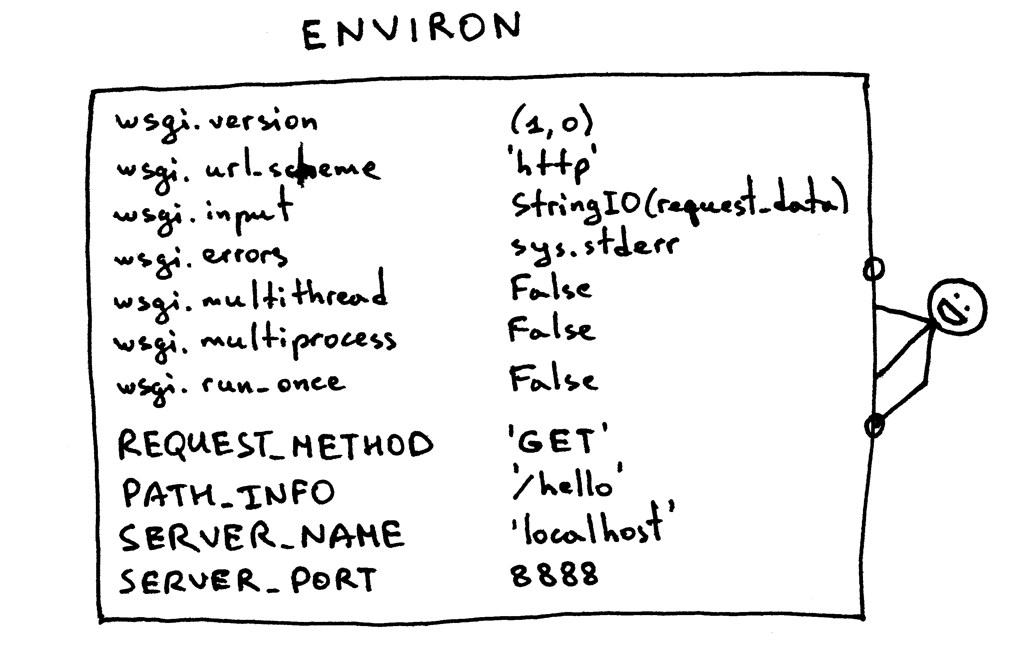
我现在还没有对上面那个 environ 字典做任何解释,不过基本上这个字典必须包含那些被 WSGI 规范事先定义好的 WSGI 及 CGI 变量值。服务器在解析 HTTP 请求时,会从请求中获取这些变量的值。这是 environ 字典应该有的样子:

Web 框架会利用以上字典中包含的信息,通过字典中的请求路径、请求动作等等来决定使用哪个视图来处理响应、在哪里读取请求正文、在哪里输出错误信息(如果有的话)。

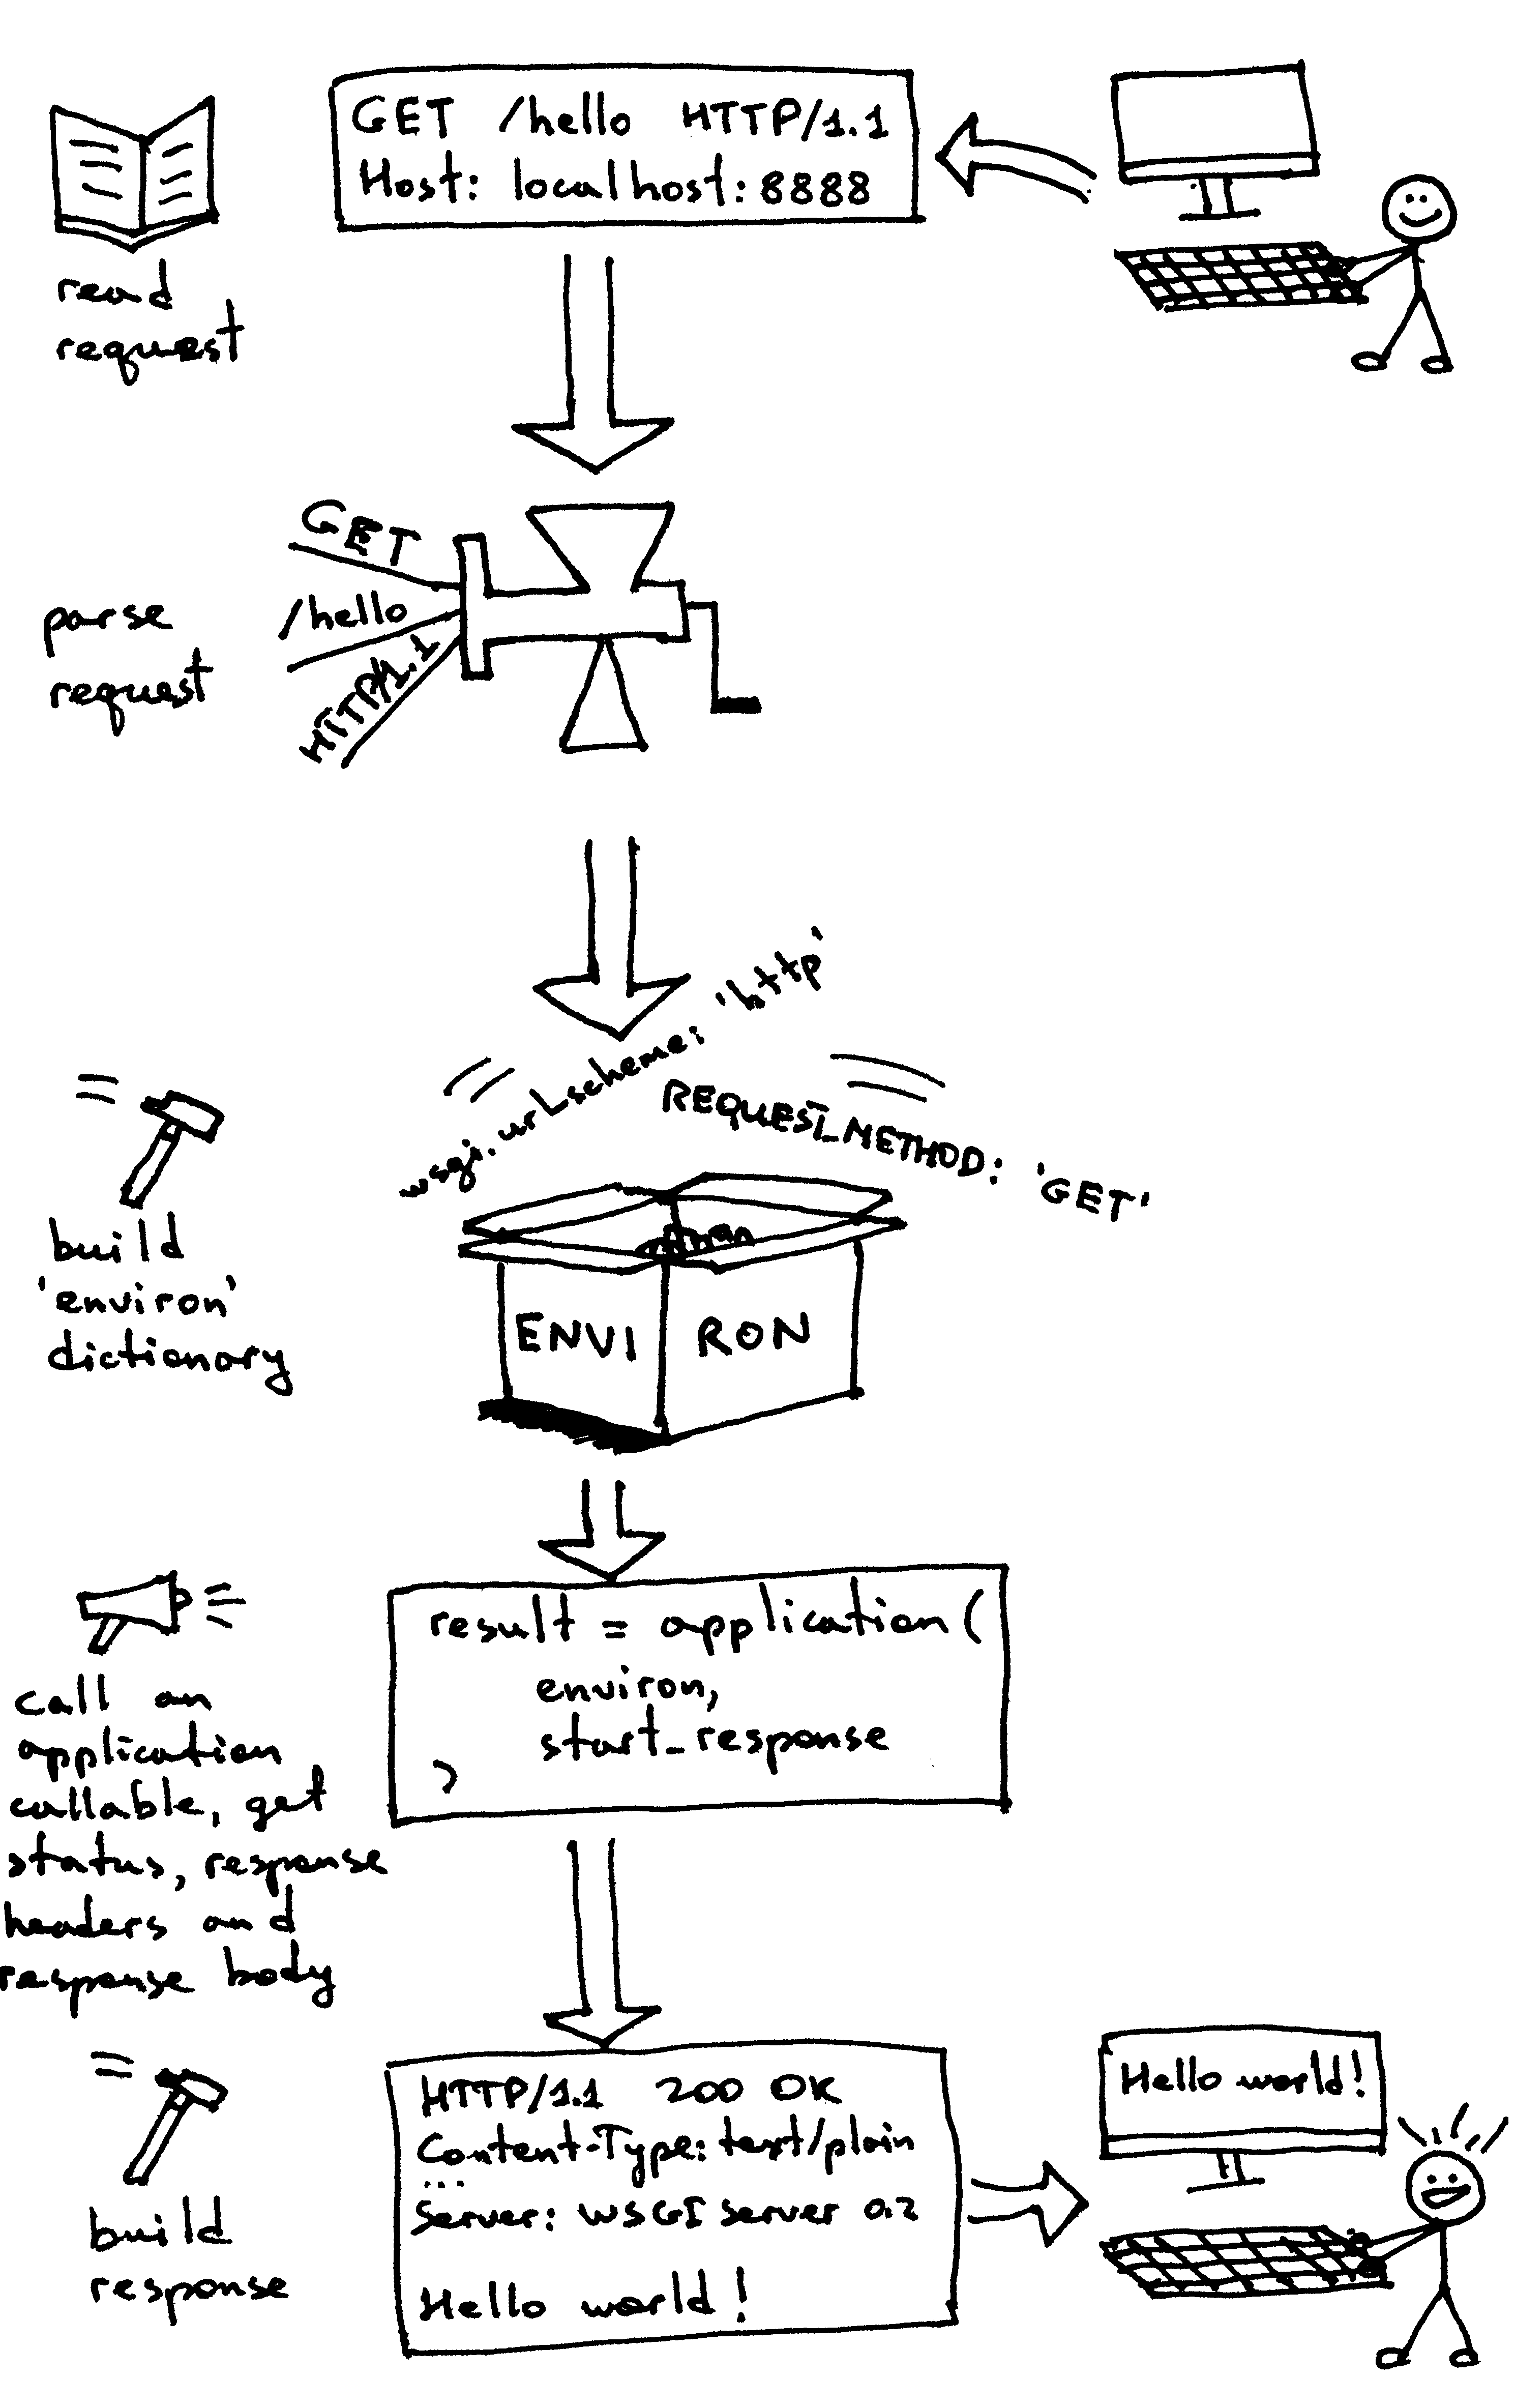
现在,你已经创造了属于你自己的 WSGI Web 服务器,你也使用不同 Web 框架做了几个 Web 应用。而且,你在这个过程中也自己创造出了一个朴素的 Web 应用及框架。这个过程真是累人。现在我们来回顾一下,你的 WSGI Web 服务器在服务请求时,需要针对 WSGI 应用做些什么:

  • 首先,服务器开始工作,然后会加载一个可调用对象 application,这个对象由你的 Web 框架或应用提供
  • 然后,服务器读取一个请求
  • 然后,服务器会解析这个请求
  • 然后,服务器会使用请求数据来构建一个 environ 字典
  • 然后,它会用 environ 字典及一个可调用对象 start_response 作为参数,来调用 application,并获取响应体内容。
  • 然后,服务器会使用 application 返回的响应体,和 start_response 函数设置的状态码及响应头部内容,来构建一个 HTTP 响应。
  • 最终,服务器将 HTTP 响应回送给客户端。

这基本上是服务器要做的全部内容了。你现在有了一个可以正常工作的 WSGI 服务器,它可以为使用任何遵循 WSGI 规范的 Web 框架(如 Django、Flask、Pyramid,还有你刚刚自己写的那个框架)构建出的 Web 应用服务。最棒的部分在于,它可以在不用更改任何服务器代码的情况下,与多个不同的 Web 框架一起工作。真不错。

在结束之前,你可以想想这个问题:“你该如何让你的服务器在同一时间处理多个请求呢?”

敬请期待,我会在第三部分向你展示一种解决这个问题的方法。干杯!

顺便,我在撰写一本名为《搭个 Web 服务器:从头开始》的书。这本书讲解了如何从头开始编写一个基本的 Web 服务器,里面包含本文中没有的更多细节。订阅邮件列表,你就可以获取到这本书的最新进展,以及发布日期。


via: https://ruslanspivak.com/lsbaws-part2/

作者:Ruslan 译者:StdioA 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

构建图像搜索引擎并不是一件容易的任务。这里有几个概念、工具、想法和技术需要实现。主要的图像处理概念之一是 逆图像查询 ( reverse image querying ) (RIQ)。Google、Cloudera、Sumo Logic 和 Birst 等公司在使用逆图像搜索中名列前茅。通过分析图像和使用数据挖掘 RIQ 提供了很好的洞察分析能力。

顶级公司与逆图像搜索

有很多顶级的技术公司使用 RIQ 来取得了不错的收益。例如:在 2014 年 Pinterest 第一次带来了视觉搜索。随后在 2015 年发布了一份白皮书,披露了其架构。逆图像搜索让 Pinterest 获得了时尚品的视觉特征,并可以显示相似产品的推荐。

众所周知,谷歌图片使用逆图像搜索允许用户上传一张图片然后搜索相关联的图片。通过使用先进的算法对提交的图片进行分析和数学建模,然后和谷歌数据库中无数的其他图片进行比较得到相似的结果。

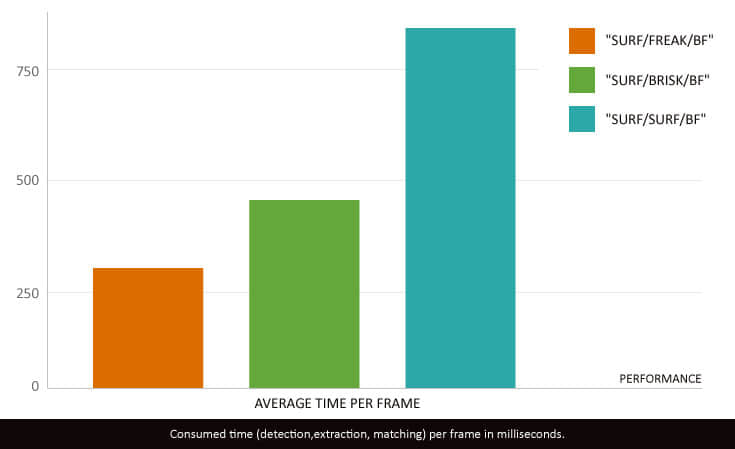
这是 OpenCV 2.4.9 特征比较报告一个图表:

算法 & Python库

在我们使用它工作之前,让我们过一遍构建图像搜索引擎的 Python 库的主要元素:

专利算法

尺度不变特征变换 ( Scale-Invariant Feature Transform ) (SIFT)算法

  1. 带有非自由功能的一个专利技术,利用图像识别符,以识别相似图像,甚至那些来自不同的角度,大小,深度和尺度的图片,也会被包括在搜索结果中。点击这里查看 SIFT 详细视频。
  2. SIFT 能与从许多图片中提取了特征的大型数据库正确地匹配搜索条件。
  3. 能匹配不同视角的相同图像和匹配不变特征来获得搜索结果是 SIFT 的另一个特征。了解更多关于尺度不变关键点。

加速鲁棒特征 ( Speeded Up Robust Features ) (SURF)算法

  1. SURF 也是一种带有非自由功能的专利技术,而且还是一种“加速”的 SIFT 版本。不像 SIFT,SURF 接近于带有 箱式过滤器 ( Box Filter ) 的 高斯拉普拉斯算子 ( Laplacian of Gaussian ) 。
  2. SURF 依赖于 黑塞矩阵 ( Hessian Matrix ) 的位置和尺度。
  3. 在许多应用中,旋转不变性不是一个必要条件,所以不按这个方向查找加速了处理。
  4. SURF 包括了几种特性,提升了每一步的速度。SIFT 在旋转和模糊化方面做的很好,比 SIFT 的速度快三倍。然而它不擅长处理照明和变换视角。
  5. OpenCV 程序功能库提供了 SURF 功能,SURF.compute() 和 SURF.Detect() 可以用来找到描述符和要点。阅读更多关于SURF点击这里

开源算法

KAZE 算法

  1. KAZE是一个开源的非线性尺度空间的二维多尺度和新的特征检测和描述算法。在 加性算子分裂 ( Additive Operator Splitting ) (AOS)和可变电导扩散中的有效技术被用来建立非线性尺度空间。
  2. 多尺度图像处理的基本原理很简单:创建一个图像的尺度空间,同时用正确的函数过滤原始图像,以提高时间或尺度。

加速的 KAZE ( Accelerated-KAZE ) (AKAZE) 算法

  1. 顾名思义,这是一个更快的图像搜索方式,它会在两幅图像之间找到匹配的关键点。AKAZE 使用二进制描述符和非线性尺度空间来平衡精度和速度。

二进制鲁棒性不变尺度可变关键点 ( Binary Robust Invariant Scalable Keypoints ) (BRISK)算法

  1. BRISK 非常适合关键点的描述、检测与匹配。
  2. 是一种高度自适应的算法,基于尺度空间 FAST 的快速检测器和一个位字符串描述符,有助于显著加快搜索。
  3. 尺度空间关键点检测与关键点描述帮助优化当前相关任务的性能。

快速视网膜关键点 ( Fast Retina Keypoint ) (FREAK)

  1. 这个新的关键点描述的灵感来自人的眼睛。通过图像强度比能有效地计算一个二进制串级联。FREAK 算法相比 BRISK、SURF 和 SIFT 算法可以更快的计算与内存负载较低。

定向 FAST 和旋转 BRIEF ( Oriented FAST and Rotated BRIEF ) (ORB)

  1. 快速的二进制描述符,ORB 具有抗噪声和旋转不变性。ORB 建立在 FAST 关键点检测器和 BRIEF 描述符之上,有成本低、性能好的元素属性。
  2. 除了快速和精确的定位元件,有效地计算定向的 BRIEF,分析变动和面向 BRIEF 特点相关,是另一个 ORB 的特征。

Python库

OpenCV

  1. OpenCV 支持学术和商业用途,它是一个开源的机器学习和计算机视觉库,OpenCV 便于组织利用和修改代码。
  2. 超过 2500 个优化的算法,包括当前最先进的机器学习和计算机视觉算法服务与各种图像搜索--人脸检测、目标识别、摄像机目标跟踪,从图像数据库中寻找类似图像、眼球运动跟随、风景识别等。
  3. 像谷歌,IBM,雅虎,索尼,本田,微软和英特尔这样的大公司广泛的使用 OpenCV。
  4. OpenCV 拥有 python,java,C,C++ 和 MATLAB 接口,同时支持 Windows,Linux,Mac OS 和 Android。

Python 图像库 (PIL)

  1. Python 图像库(PIL)支持多种文件格式,同时提供图像处理和图形解决方案。开源的 PIL 为你的 Python解释器添加了图像处理能力。
  2. 标准的图像处理能力包括图像增强、透明和遮罩处理、图像过滤、像素操作等。

详细的数据和图表,请看这里的 OpenCV 2.4.9 特征比较报告。

构建图像搜索引擎

图像搜索引擎可以从预置的图像库选择相似的图像。其中最受欢迎的是谷歌的著名的图像搜索引擎。对于初学者来说,有不同的方法来建立这样的系统。提几个如下:

  1. 采用图像提取、图像描述提取、元数据提取和搜索结果提取,建立图像搜索引擎。
  2. 定义你的图像描述符,数据集索引,定义你的相似性度量,然后进行搜索和排名。
  3. 选择要搜索的图像,选择用于进行搜索的目录,搜索所有图片的目录,创建图片特征索引,评估搜索图片的相同特征,匹配搜索的图片并获得匹配的图片。

我们的方法基本上从比较灰度版本的图像,逐渐演变到复杂的特征匹配算法如 SIFT 和 SURF,最后采用的是开源的解决方案 BRISK 。所有这些算法都提供了有效的结果,但在性能和延迟有细微变化。建立在这些算法上的引擎有许多应用,如分析流行统计的图形数据,在图形内容中识别对象,等等。

举例:一个 IT 公司为其客户建立了一个图像搜索引擎。因此,如果如果搜索一个品牌的标志图像,所有相关的品牌形象也应该显示在搜索结果。所得到的结果也能够被客户用于分析,使他们能够根据地理位置估计品牌知名度。但它还比较年轻,RIQ(反向图像搜索)的潜力尚未被完全挖掘利用。

这就结束了我们的文章,使用 Python 构建图像搜索引擎。浏览我们的博客部分来查看最新的编程技术。

数据来源:OpenCV 2.4.9 特征比较报告(computer-vision-talks.com)

(感谢 Ananthu Nair 的指导与补充)


via: http://www.cuelogic.com/blog/advanced-image-processing-with-python/

作者:Snehith Kumbla 译者:Johnny-Liao 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

Django 围绕“可重用应用”的思想建立:自包含的包提供了可重复使用的特性。你可以将这些可重用应用组装起来,在加上适用于你的网站的特定代码,来搭建你自己的网站。Django 具有一个丰富多样的、由可供你使用的可重用应用组建起来的生态系统——PyPI 列出了超过 8000个 Django 应用——可你该如何知道哪些是最好的呢?

为了节省你的时间,我们总结了五个最受喜爱的 Django 应用。它们是:

  • Cookiecutter: 建立 Django 网站的最佳方式。
  • Whitenoise: 最棒的静态资源服务器。
  • Django Rest Framework: 使用 Django 开发 REST API 的最佳方式。
  • Wagtail: 基于 Django 的最佳内容管理系统(CMS)。
  • django-allauth: 提供社交账户登录的最佳应用(如 Twitter, Facebook, GitHub 等)。

我们同样推荐你看看 Django Packages,这是一个可重用 Django 应用的目录。Django Packages 将 Django 应用组织成“表格”,你可以在功能相似的不同应用之间进行比较并做出选择。你可以查看每个包中提供的特性和使用统计情况。(比如:这是 REST 工具的表格,也许可以帮助你理解我们为何推荐 Django REST Framework。

为什么你应该相信我们?

我们使用 Django 的时间几乎比任何人都长。在 Django 发布之前,我们当中的两个人(Frank 和 Jacob)就在 Lawrence Journal-World (Django 的发源地)工作(事实上,是他们两人推动了 Django 开源发布的进程)。我们在过去的八年当中运行着一个咨询公司,来建议公司怎样最好地应用 Django。

所以,我们见证了 Django 项目和社群的完整历史,我们见证了那些流行的软件包的兴起和没落。在我们三个之中,我们个人可能试用了 8000 个应用中至少一半以上,或者我们知道谁试用过这些。我们对如何使应用变得坚实可靠有着深刻的理解,并且我们对给予这些应用持久力量的来源也有着深入的了解。

建立 Django 网站的最佳方式:Cookiecutter

建立一个新项目或应用总是有些痛苦。你可以用 Django 内建的 startproject。不过,如果你像我们一样,对如何做事比较挑剔。Cookiecutter 为你提供了一个快捷简单的方式来构建项目或易于重用的应用模板,从而解决了这个问题。一个简单的例子:键入 pip install cookiecutter,然后在命令行中运行以下命令:

$ cookiecutter https://github.com/marcofucci/cookiecutter-simple-django

接下来你需要回答几个简单的问题,比如你的项目名称、 目录 ( repo ) 、作者名字、E-Mail 和其他几个关于配置的小问题。这些能够帮你补充项目相关的细节。我们使用最最原始的 “foo” 作为我们的目录名称。所以 cokkiecutter 在子目录 “foo” 下建立了一个简单的 Django 项目。

如果你在 “foo” 项目中闲逛,你会看见你刚刚选择的其它设置已通过模板,连同所需的子目录一同嵌入到文件当中。这个“模板”在我们刚刚在执行 cookiecutter 命令时输入的唯一一个参数 Github 仓库 URL 中定义。这个样例工程使用了一个 Github 远程仓库作为模板;不过你也可以使用本地的模板,这在建立非重用项目时非常有用。

我们认为 cookiecutter 是一个极棒的 Django 包,但是,事实上其实它在面对纯 Python 甚至非 Python 相关需求时也极为有用。你能够将所有文件以一种可重复的方式精确地摆放在任何位置上,使得 cookiecutter 成为了一个简化(DRY)工作流程的极佳工具。

最棒的静态资源服务器:Whitenoise

多年来,托管网站的静态资源——图片、Javascript、CSS——都是一件很痛苦的事情。Django 内建的 django.views.static.serve 视图,就像 Django 文章所述的那样,“在生产环境中不可靠,所以只应为开发环境的提供辅助功能。”但使用一个“真正的” Web 服务器,如 NGINX 或者借助 CDN 来托管媒体资源,配置起来会比较困难。

Whitenoice 很简洁地解决了这个问题。它可以像在开发环境那样轻易地在生产环境中设置静态服务器,并且针对生产环境进行了加固和优化。它的设置方法极为简单:

  1. 确保你在使用 Django 的 contrib.staticfiles 应用,并确认你在配置文件中正确设置了 STATIC_ROOT 变量。
  2. 在 wsgi.py 文件中启用 Whitenoise:
from django.core.wsgi import get_wsgi_application
from whitenoise.django import DjangoWhiteNoise

application = get_wsgi_application()
application = DjangoWhiteNoise(application)

配置它真的就这么简单!对于大型应用,你可能想要使用一个专用的媒体服务器和/或一个 CDN,但对于大多数小型或中型 Django 网站,Whitenoise 已经足够强大。

如需查看更多关于 Whitenoise 的信息,请查看文档。

开发 REST API 的最佳工具:Django REST Framework

REST API 正在迅速成为现代 Web 应用的标准功能。 API 就是简单的使用 JSON 对话而不是 HTML,当然你可以只用 Django 做到这些。你可以制作自己的视图,设置合适的 Content-Type,然后返回 JSON 而不是渲染后的 HTML 响应。这是在像 Django Rest Framework(下称 DRF)这样的 API 框架发布之前,大多数人所做的。

如果你对 Django 的视图类很熟悉,你会觉得使用 DRF 构建 REST API 与使用它们很相似,不过 DRF 只针对特定 API 使用场景而设计。一般的 API 设置只需要一点代码,所以我们没有提供一份让你兴奋的示例代码,而是强调了一些可以让你生活的更舒适的 DRF 特性:

  • 可自动预览的 API 可以使你的开发和人工测试轻而易举。你可以查看 DRF 的示例代码。你可以查看 API 响应,并且不需要你做任何事就可以支持 POST/PUT/DELETE 类型的操作。
  • 便于集成各种认证方式,如 OAuth, Basic Auth, 或API Tokens。
  • 内建请求速率限制。
  • 当与 django-rest-swagger 组合使用时,API 文档几乎可以自动生成。
  • 广泛的第三方库生态。

当然,你可以不依赖 DRF 来构建 API,但我们无法想象你不去使用 DRF 的原因。就算你不使用 DRF 的全部特性,使用一个成熟的视图库来构建你自己的 API 也会使你的 API 更加一致、完全,更能提高你的开发速度。如果你还没有开始使用 DRF, 你应该找点时间去体验一下。

基于 Django 的最佳 CMS:Wagtail

Wagtail 是当下 Django CMS(内容管理系统)世界中最受人青睐的应用,并且它的热门有足够的理由。就像大多数的 CMS 一样,它具有极佳的灵活性,可以通过简单的 Django 模型来定义不同类型的页面及其内容。使用它,你可以从零开始在几个小时而不是几天之内来和建造一个基本可以运行的内容管理系统。举一个小例子,为你公司的员工定义一个员工页面类型可以像下面一样简单:

from wagtail.wagtailcore.models import Page
from wagtail.wagtailcore.fields import RichTextField
from wagtail.wagtailadmin.edit_handlers import FieldPanel, MultiFieldPanel
from wagtail.wagtailimages.edit_handlers import ImageChooserPanel 

class StaffPage(Page):
    name = models.CharField(max_length=100)
    hire_date = models.DateField()
    bio = models.RichTextField()
    email = models.EmailField()
    headshot = models.ForeignKey('wagtailimages.Image', null=True, blank=True) 
    content_panels = Page.content_panels + [
                                FieldPanel('name'),
                                FieldPanel('hire_date'),
                                FieldPanel('email'),
                                FieldPanel('bio',classname="full"),
                                ImageChoosePanel('headshot'),
                                ] 

然而,Wagtail 真正出彩的地方在于它的灵活性及其易于使用的现代化管理页面。你可以控制不同类型的页面在哪网站的哪些区域可以访问,为页面添加复杂的附加逻辑,还天生就支持标准的适应/审批工作流。在大多数 CMS 系统中,你会在开发时在某些点上遇到困难。而使用 Wagtail 时,我们经过不懈努力找到了一个突破口,使得让我们轻易地开发出一套简洁稳定的系统,使得程序完全依照我们的想法运行。如果你对此感兴趣,我们写了一篇[深入理解 Wagtail][17。

提供社交账户登录的最佳工具:django-allauth

django-allauth 是一个能够解决你的注册和认证需求的、可重用的 Django 应用。无论你需要构建本地注册系统还是社交账户注册系统,django-allauth 都能够帮你做到。

这个应用支持多种认证体系,比如用户名或电子邮件。一旦用户注册成功,它还可以提供从无需认证到电子邮件认证的多种账户验证的策略。同时,它也支持多种社交账户和电子邮件账户。它还支持插拔式注册表单,可让用户在注册时回答一些附加问题。

django-allauth 支持多于 20 种认证提供者,包括 Facebook、Github、Google 和 Twitter。如果你发现了一个它不支持的社交网站,很有可能通过第三方插件提供该网站的接入支持。这个项目还支持自定义后端,可以支持自定义的认证方式,对每个有定制认证需求的人来说这都很棒。

django-allauth 易于配置,且有完善的文档。该项目通过了很多测试,所以你可以相信它的所有部件都会正常运作。

你有最喜爱的 Django 包吗?请在评论中告诉我们。

关于作者

Jeff Triplett 劳伦斯,堪萨斯州 http://www.jefftriplett.com/

我在 2007 年搬到了堪萨斯州的劳伦斯,在 Django 的发源地—— Lawrence Journal-World 工作。我现在在劳伦斯市的 Revolution Systems (Revsys) 工作,做一位开发者兼顾问。

我是北美 Django 运动基金会(DEFNA)的联合创始人,2015 和 2016 年 DjangoCon US 的会议主席,而且我在 Django 的发源地劳伦斯参与组织了 Django Birthday 来庆祝 Django 的 10 岁生日。

我是当地越野跑小组的成员,我喜欢篮球,我还喜欢梦见自己随着一道气流游遍美国。

Jacob Kaplan-Moss 和 Frank Wiles 也参与了本文的写作。


via: https://opensource.com/business/15/12/5-favorite-open-source-django-packages

作者:Jeff Triplett 译者:StdioA 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出