标签 python 下的文章

Python 生态系统包含丰富的工具和库,可以让开发人员更加舒适。 例如,我们之前已经介绍了如何使用交互式 shell 增强 Python。本文重点介绍另一种可以节省时间并提高 Python 技能的工具:Python 调试器。

Python 调试器

Python 标准库提供了一个名为 pdb 的调试器。此调试器提供了调试所需的大多数功能,如断点、单行步进、堆栈帧的检查等等。

了解一些pdb 的基本知识很有用,因为它是标准库的一部分。 你可以在无法安装其他增强的调试器的环境中使用它。

运行 pdb

运行 pdb 的最简单方法是从命令行,将程序作为参数传递来调试。 看看以下脚本:

# pdb_test.py
#!/usr/bin/python3

from time import sleep

def countdown(number):
    for i in range(number, 0, -1):
        print(i)
        sleep(1)


if __name__ == "__main__":
    seconds = 10
    countdown(seconds)

你可以从命令行运行 pdb,如下所示:

$ python3 -m pdb pdb_test.py
> /tmp/pdb_test.py(1)<module>()
-> from time import sleep
(Pdb)

使用 pdb 的另一种方法是在程序中设置断点。为此,请导入 pdb 模块并使用set_trace 函数:

# pdb_test.py
#!/usr/bin/python3

from time import sleep


def countdown(number):
    for i in range(number, 0, -1):
        import pdb; pdb.set_trace()
        print(i)
        sleep(1)


if __name__ == "__main__":
    seconds = 10
    countdown(seconds)
$ python3 pdb_test.py
> /tmp/pdb_test.py(6)countdown()
-> print(i)
(Pdb)

脚本在断点处停止,pdb 显示脚本中的下一行。 你也可以在失败后执行调试器。 这称为 事后调试 postmortem debugging 。

穿行于执行堆栈

调试中的一个常见用例是在执行堆栈中穿行。 Python 调试器运行后,可以使用以下命令:

  • w(here):显示当前执行的行以及执行堆栈的位置。
$ python3 test_pdb.py
> /tmp/test_pdb.py(10)countdown()
-> print(i)
(Pdb) w
/tmp/test_pdb.py(16)<module>()
-> countdown(seconds)
> /tmp/test_pdb.py(10)countdown()
-> print(i)
(Pdb)
  • l(ist):显示当前位置周围更多的上下文(代码)。
$ python3 test_pdb.py
> /tmp/test_pdb.py(10)countdown()
-> print(i)
(Pdb) l
5
6
7     def countdown(number):
8         for i in range(number, 0, -1):
9             import pdb; pdb.set_trace()
10  ->         print(i)
11             sleep(1)
12
13
14     if __name__ == "__main__":
15         seconds = 10
  • u(p)/d(own):向上或向下穿行调用堆栈。
$ py3 test_pdb.py
> /tmp/test_pdb.py(10)countdown()
-> print(i)
(Pdb) up
> /tmp/test_pdb.py(16)<module>()
-> countdown(seconds)
(Pdb) down
> /tmp/test_pdb.py(10)countdown()
-> print(i)
(Pdb)

单步执行程序

pdb提供以下命令来执行和单步执行代码:

  • n(ext):继续执行,直到达到当前函数中的下一行,或者返回
  • s(tep):执行当前行并在第一个可能的场合停止(在被调用的函数或当前函数中)
  • c(ontinue):继续执行,仅在断点处停止。
$ py3 test_pdb.py
> /tmp/test_pdb.py(10)countdown()
-> print(i)
(Pdb) n
10
> /tmp/test_pdb.py(11)countdown()
-> sleep(1)
(Pdb) n
> /tmp/test_pdb.py(8)countdown()
-> for i in range(number, 0, -1):
(Pdb) n
> /tmp/test_pdb.py(9)countdown()
-> import pdb; pdb.set_trace()
(Pdb) s
--Call--
> /usr/lib64/python3.6/pdb.py(1584)set_trace()
-> def set_trace():
(Pdb) c
> /tmp/test_pdb.py(10)countdown()
-> print(i)
(Pdb) c
9
> /tmp/test_pdb.py(9)countdown()
-> import pdb; pdb.set_trace()
(Pdb)

该示例显示了 next 和 step 之间的区别。 实际上,当使用 step 时,调试器会进入 pdb 模块源代码,而接下来就会执行 set_trace 函数。

检查变量内容

  • pdb 非常有用的地方是检查执行堆栈中存储的变量的内容。 例如,a(rgs) 命令打印当前函数的变量,如下所示:
py3 test_pdb.py
> /tmp/test_pdb.py(10)countdown()
-> print(i)
(Pdb) where
/tmp/test_pdb.py(16)<module>()
-> countdown(seconds)
> /tmp/test_pdb.py(10)countdown()
-> print(i)
(Pdb) args
number = 10
(Pdb)

pdb 打印变量的值,在本例中是 10。

  • 可用于打印变量值的另一个命令是 p(rint)。
$ py3 test_pdb.py
> /tmp/test_pdb.py(10)countdown()
-> print(i)
(Pdb) list
5
6
7     def countdown(number):
8         for i in range(number, 0, -1):
9             import pdb; pdb.set_trace()
10  ->         print(i)
11             sleep(1)
12
13
14     if __name__ == "__main__":
15         seconds = 10
(Pdb) print(seconds)
10
(Pdb) p i
10
(Pdb) p number - i
0
(Pdb)

如示例中最后的命令所示,print 可以在显示结果之前计算表达式。

Python 文档包含每个 pdb 命令的参考和示例。 对于开始使用 Python 调试器人来说,这是一个有用的读物。

增强的调试器

一些增强的调试器提供了更好的用户体验。 大多数为 pdb 添加了有用的额外功能,例如语法突出高亮、更好的回溯和自省。 流行的增强调试器包括 IPython 的 ipdb 和 pdb++。

这些示例显示如何在虚拟环境中安装这两个调试器。 这些示例使用新的虚拟环境,但在调试应用程序的情况下,应使用应用程序的虚拟环境。

安装 IPython 的 ipdb

要安装 IPython ipdb,请在虚拟环境中使用 pip:

$ python3 -m venv .test_pdb
$ source .test_pdb/bin/activate
(test_pdb)$ pip install ipdb

要在脚本中调用 ipdb,必须使用以下命令。 请注意,该模块称为 ipdb 而不是 pdb:

import ipdb; ipdb.set_trace()

IPython 的 ipdb 也可以用 Fedora 包安装,所以你可以使用 Fedora 的包管理器 dnf 来安装它:

$ sudo dnf install python3-ipdb

安装 pdb++

你可以类似地安装 pdb++:

$ python3 -m venv .test_pdb
$ source .test_pdb/bin/activate
(test_pdb)$ pip install pdbp

pdb++ 重写了 pdb 模块,因此你可以使用相同的语法在程序中添加断点:

import pdb; pdb.set_trace()

总结

学习如何使用 Python 调试器可以节省你在排查应用程序问题时的时间。 对于了解应用程序或某些库的复杂部分如何工作也是有用的,从而提高 Python 开发人员的技能。


via: https://fedoramagazine.org/getting-started-python-debugger/

作者:Clément Verna 选题:lujun9972 译者:Flowsnow 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

如果你正在阅读本文,那么你已经意识到了 Python 3.7 以及它所包含的新特性。就我个人而言,我对 Dataclasses 感到非常兴奋,因为我等了它一段时间了。

本系列包含两部分:

  1. Dataclass 特点概述
  2. 在下一篇文章概述 Dataclass 的 fields

介绍

Dataclasses 是 Python 的类(LCTT 译注:更准确的说,它是一个模块),适用于存储数据对象。你可能会问什么是数据对象?下面是定义数据对象的一个不太详细的特性列表:

  • 它们存储数据并代表某种数据类型。例如:一个数字。对于熟悉 ORM 的人来说,模型实例就是一个数据对象。它代表一种特定的实体。它包含那些定义或表示实体的属性。
  • 它们可以与同一类型的其他对象进行比较。例如:一个数字可以是 greater than(大于)、less than(小于) 或 equal(等于) 另一个数字。

当然还有更多的特性,但是这个列表足以帮助你理解问题的关键。

为了理解 Dataclasses,我们将实现一个包含数字的简单类,并允许我们执行上面提到的操作。

首先,我们将使用普通类,然后我们再使用 Dataclasses 来实现相同的结果。

但在我们开始之前,先来谈谈 Dataclasses 的用法。

Python 3.7 提供了一个装饰器 dataclass,用于将类转换为 dataclass。

你所要做的就是将类包在装饰器中:

from dataclasses import dataclass

@dataclass
class A:
 ...

现在,让我们深入了解一下 dataclass 带给我们的变化和用途。

初始化

通常是这样:

class Number:

    def __init__(self, val):
        self.val = val

>>> one = Number(1)
>>> one.val
>>> 1

用 dataclass 是这样:

@dataclass
class Number:
    val:int 

>>> one = Number(1)
>>> one.val
>>> 1

以下是 dataclass 装饰器带来的变化:

  1. 无需定义 __init__,然后将值赋给 self,dataclass 负责处理它(LCTT 译注:此处原文可能有误,提及一个不存在的 d)
  2. 我们以更加易读的方式预先定义了成员属性,以及类型提示。我们现在立即能知道 val 是 int 类型。这无疑比一般定义类成员的方式更具可读性。
Python 之禅: 可读性很重要

它也可以定义默认值:

@dataclass
class Number:
    val:int = 0

表示

对象表示指的是对象的一个有意义的字符串表示,它在调试时非常有用。

默认的 Python 对象表示不是很直观:

class Number:
    def __init__(self, val = 0):
    self.val = val

>>> a = Number(1)
>>> a
>>> <__main__.Number object at 0x7ff395b2ccc0>

这让我们无法知悉对象的作用,并且会导致糟糕的调试体验。

一个有意义的表示可以通过在类中定义一个 __repr__ 方法来实现。

def __repr__(self):
    return self.val

现在我们得到这个对象有意义的表示:

>>> a = Number(1)
>>> a
>>> 1

dataclass 会自动添加一个 __repr__ 函数,这样我们就不必手动实现它了。

@dataclass
class Number:
    val: int = 0
>>> a = Number(1)
>>> a
>>> Number(val = 1)

数据比较

通常,数据对象之间需要相互比较。

两个对象 a 和 b 之间的比较通常包括以下操作:

  • a < b
  • a > b
  • a == b
  • a >= b
  • a <= b

在 Python 中,能够在可以执行上述操作的类中定义方法。为了简单起见,不让这篇文章过于冗长,我将只展示 == 和 < 的实现。

通常这样写:

class Number:
    def __init__( self, val = 0):
       self.val = val

    def __eq__(self, other):
        return self.val == other.val

    def __lt__(self, other):
        return self.val < other.val

使用 dataclass:

@dataclass(order = True)
class Number:
    val: int = 0

是的,就是这样简单。

我们不需要定义 __eq__ 和 __lt__ 方法,因为当 order = True 被调用时,dataclass 装饰器会自动将它们添加到我们的类定义中。

那么,它是如何做到的呢?

当你使用 dataclass 时,它会在类定义中添加函数 __eq__ 和 __lt__ 。我们已经知道这点了。那么,这些函数是怎样知道如何检查相等并进行比较呢?

生成 __eq__ 函数的 dataclass 类会比较两个属性构成的元组,一个由自己属性构成的,另一个由同类的其他实例的属性构成。在我们的例子中,自动生成的 __eq__ 函数相当于:

def __eq__(self, other):
    return (self.val,) == (other.val,)

让我们来看一个更详细的例子:

我们会编写一个 dataclass 类 Person 来保存 name 和 age。

@dataclass(order = True)
class Person:
    name: str
    age:int = 0

自动生成的 __eq__ 方法等同于:

def __eq__(self, other):
    return (self.name, self.age) == ( other.name, other.age)

请注意属性的顺序。它们总是按照你在 dataclass 类中定义的顺序生成。

同样,等效的 __le__ 函数类似于:

def __le__(self, other):
    return (self.name, self.age) <= (other.name, other.age)

当你需要对数据对象列表进行排序时,通常会出现像 __le__ 这样的函数的定义。Python 内置的 sorted 函数依赖于比较两个对象。

>>> import random

>>> a = [Number(random.randint(1,10)) for _ in range(10)] #generate list of random numbers

>>> a

>>> [Number(val=2), Number(val=7), Number(val=6), Number(val=5), Number(val=10), Number(val=9), Number(val=1), Number(val=10), Number(val=1), Number(val=7)]

>>> sorted_a = sorted(a) #Sort Numbers in ascending order

>>> [Number(val=1), Number(val=1), Number(val=2), Number(val=5), Number(val=6), Number(val=7), Number(val=7), Number(val=9), Number(val=10), Number(val=10)]

>>> reverse_sorted_a = sorted(a, reverse = True) #Sort Numbers in descending order 

>>> reverse_sorted_a

>>> [Number(val=10), Number(val=10), Number(val=9), Number(val=7), Number(val=7), Number(val=6), Number(val=5), Number(val=2), Number(val=1), Number(val=1)]

dataclass 作为一个可调用的装饰器

定义所有的 dunder(LCTT 译注:这是指双下划线方法,即魔法方法)方法并不总是值得的。你的用例可能只包括存储值和检查相等性。因此,你只需定义 __init__ 和 __eq__ 方法。如果我们可以告诉装饰器不生成其他方法,那么它会减少一些开销,并且我们将在数据对象上有正确的操作。

幸运的是,这可以通过将 dataclass 装饰器作为可调用对象来实现。

从官方文档来看,装饰器可以用作具有如下参数的可调用对象:

@dataclass(init=True, repr=True, eq=True, order=False, unsafe_hash=False, frozen=False)
class C:
 …
  1. init:默认将生成 __init__ 方法。如果传入 False,那么该类将不会有 __init__ 方法。
  2. repr:__repr__ 方法默认生成。如果传入 False,那么该类将不会有 __repr__ 方法。
  3. eq:默认将生成 __eq__ 方法。如果传入 False,那么 __eq__ 方法将不会被 dataclass 添加,但默认为 object.__eq__。
  4. order:默认将生成 __gt__、__ge__、__lt__、__le__ 方法。如果传入 False,则省略它们。

我们在接下来会讨论 frozen。由于 unsafe_hash 参数复杂的用例,它值得单独发布一篇文章。

现在回到我们的用例,以下是我们需要的:

  1. __init__

    1. __eq__

默认会生成这些函数,因此我们需要的是不生成其他函数。那么我们该怎么做呢?很简单,只需将相关参数作为 false 传入给生成器即可。

@dataclass(repr = False) # order, unsafe_hash and frozen are False
class Number:
    val: int = 0


>>> a = Number(1)

>>> a

>>> <__main__.Number object at 0x7ff395afe898>

>>> b = Number(2)

>>> c = Number(1)

>>> a == b

>>> False

>>> a < b

>>> Traceback (most recent call last):
 File “<stdin>”, line 1, in <module>
TypeError: ‘<’ not supported between instances of ‘Number’ and ‘Number’

Frozen(不可变) 实例

Frozen 实例是在初始化对象后无法修改其属性的对象。

无法创建真正不可变的 Python 对象

在 Python 中创建对象的不可变属性是一项艰巨的任务,我将不会在本篇文章中深入探讨。

以下是我们期望不可变对象能够做到的:

>>> a = Number(10) #Assuming Number class is immutable

>>> a.val = 10 # Raises Error

有了 dataclass,就可以通过使用 dataclass 装饰器作为可调用对象配合参数 frozen=True 来定义一个 frozen 对象。

当实例化一个 frozen 对象时,任何企图修改对象属性的行为都会引发 FrozenInstanceError。

@dataclass(frozen = True)
class Number:
    val: int = 0

>>> a = Number(1)

>>> a.val

>>> 1

>>> a.val = 2

>>> Traceback (most recent call last):
 File “<stdin>”, line 1, in <module>
 File “<string>”, line 3, in __setattr__
dataclasses.FrozenInstanceError: cannot assign to field ‘val’

因此,一个 frozen 实例是一种很好方式来存储:

  • 常数
  • 设置

这些通常不会在应用程序的生命周期内发生变化,任何企图修改它们的行为都应该被禁止。

后期初始化处理

有了 dataclass,需要定义一个 __init__ 方法来将变量赋给 self 这种初始化操作已经得到了处理。但是我们失去了在变量被赋值之后立即需要的函数调用或处理的灵活性。

让我们来讨论一个用例,在这个用例中,我们定义一个 Float 类来包含浮点数,然后在初始化之后立即计算整数和小数部分。

通常是这样:

import math

class Float:
    def __init__(self, val = 0):
        self.val = val
        self.process()

    def process(self):
        self.decimal, self.integer = math.modf(self.val)

>>> a = Float( 2.2)

>>> a.decimal

>>> 0.2000

>>> a.integer

>>> 2.0

幸运的是,使用 post\_init 方法已经能够处理后期初始化操作。

生成的 __init__ 方法在返回之前调用 __post_init__ 返回。因此,可以在函数中进行任何处理。

import math

@dataclass
class FloatNumber:
    val: float = 0.0

    def __post_init__(self):
        self.decimal, self.integer = math.modf(self.val)

>>> a = Number(2.2)

>>> a.val

>>> 2.2

>>> a.integer

>>> 2.0

>>> a.decimal

>>> 0.2

多么方便!

继承

Dataclasses 支持继承,就像普通的 Python 类一样。

因此,父类中定义的属性将在子类中可用。

@dataclass
class Person:
    age: int = 0
    name: str

@dataclass
class Student(Person):
    grade: int

>>> s = Student(20, "John Doe", 12)

>>> s.age

>>> 20

>>> s.name

>>> "John Doe"

>>> s.grade

>>> 12

请注意,Student 的参数是在类中定义的字段的顺序。

继承过程中 __post_init__ 的行为是怎样的?

由于 __post_init__ 只是另一个函数,因此必须以传统方式调用它:

@dataclass
class A:
    a: int

    def __post_init__(self):
        print("A")

@dataclass
class B(A):
    b: int

    def __post_init__(self):
        print("B")

>>> a = B(1,2)

>>> B

在上面的例子中,只有 B 的 __post_init__ 被调用,那么我们如何调用 A 的 __post_init__ 呢?

因为它是父类的函数,所以可以用 super 来调用它。

@dataclass
class B(A):
    b: int

    def __post_init__(self):
        super().__post_init__() # 调用 A 的 post init
        print("B")

>>> a = B(1,2)

>>> A
    B

结论

因此,以上是 dataclass 使 Python 开发人员变得更轻松的几种方法。

我试着彻底覆盖大部分的用例,但是,没有人是完美的。如果你发现了错误,或者想让我注意相关的用例,请联系我。

我将在另一篇文章中介绍 dataclasses.field 和 unsafe_hash。

在 Github 和 Twitter 关注我。

更新:dataclasses.field 的文章可以在这里找到。


via: https://medium.com/mindorks/understanding-python-dataclasses-part-1-c3ccd4355c34

作者:Shikhar Chauhan 译者:MjSeven 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

Python 是为谁设计的?

几年前,我在 python-dev 邮件列表中,以及在活跃的 CPython 核心开发人员和认为参与这一过程不是有效利用个人时间和精力的人中强调说,“CPython 的发展太快了也太慢了” 是很多冲突的原因之一。

我一直认为事实确实如此,但这也是一个要点,在这几年中我也花费了很多时间去反思它。在我写那篇文章的时候,我还在波音防务澳大利亚公司(Boeing Defence Australia)工作。下个月,我离开了波音进入红帽亚太(Red Hat Asia-Pacific),并且开始在大企业的开源供应链管理方面取得了 再分发者 redistributor 层面的视角。

Python 的参考解析器使用情况

我尝试将 CPython 的使用情况分解如下,尽管看起来有些过于简化(注意,这些分类的界线并不是很清晰,他们仅关注于考虑新软件特性和版本发布后不同因素的影响):

  • 教育类:教育工作者的主要兴趣在于建模方法的教学和计算操作方面,不会去编写或维护生产级别的软件。例如:

  • 个人类的自动化和爱好者的项目:主要且经常是一类自写自用的软件。例如:

  • 组织 organisational 过程自动化:主要且经常是为组织利益而编写的。例如:

  • “ 一劳永逸 Set-and-forget ” 的基础设施:这类软件在其生命周期中几乎不会升级,但在底层平台可能会升级(这种说法有时候有些争议)。例如:

    • 大多数自我管理的企业或机构的基础设施(在那些资金充足的可持续工程计划中,这种情况是让人非常不安的)
    • 拨款资助的软件(当最初的拨款耗尽时,维护通常会终止)
    • 有严格认证要求的软件(如果没有绝对必要的话,从经济性考虑,重新认证比常规升级来说要昂贵很多)
    • 没有自动升级功能的嵌入式软件系统
  • 持续升级的基础设施:具有健壮支撑的工程学模型的软件,对于依赖和平台升级通常是例行的,不必关心源码变更。例如:

    • Facebook 的 Python 服务基础设施
    • 滚动发布的 Linux 分发版
    • 大多数的公共 PaaS 无服务器环境(Heroku、OpenShift、AWS Lambda、Google Cloud Functions、Azure Cloud Functions 等等)
  • 长周期性升级的标准的操作环境:对其核心组件进行常规升级,但这些升级以年为单位进行,而不是周或月。例如:

    • VFX 平台
    • 长期支持(LTS)的 Linux 分发版
    • CPython 和 Python 标准库
    • 基础设施管理和编排工具(如 OpenStack、Ansible)
    • 硬件控制系统
  • 短生命周期的软件:软件仅被使用一次,然后就丢弃或忽略,而不是随后接着升级。例如:

    • 临时 Ad hoc 自动化脚本
    • 被确定为 “终止” 的单用户游戏(你玩了一次后,甚至都忘了去卸载它们,或许在一个新的设备上都不打算再去安装了)
    • 不具备(或不完整)状态保存的单用户游戏(如果你卸载并重安装它们,游戏体验也不会有什么大的变化)
    • 特定事件的应用程序(这些应用程序与特定的事件捆绑,一旦事件结束,这些应用程序就不再有用了)
  • 常规用途的应用程序:部署后定期升级的软件。例如:

    • 业务管理软件
    • 个人和专业的生产力应用程序(如 Blender)
    • 开发工具和服务(如 Mercurial、Buildbot、Roundup)
    • 多用户游戏,和其它明显处于持续状态还没有被定义为 “终止” 的游戏
    • 有自动升级功能的嵌入式软件系统
  • 共享的抽象层:在一个特定的问题领域中,设计用于让工作更高效的软件组件。即便是你没有亲自掌握该领域的所有错综复杂的东西。例如:

    • 大多数的 运行时 runtime 库和框架都归入这一类(如 Django、Flask、Pyramid、SQL Alchemy、NumPy、SciPy、requests)
    • 适合归入这一类的许多测试和类型推断工具(如 pytest、Hypothesis、vcrpy、behave、mypy)
    • 其它应用程序的插件(如 Blender plugins、OpenStack hardware adapters)
    • 本身就代表了 “Python 世界” 基准的标准库(那是一个难以置信的复杂的世界观)

CPython 主要服务于哪些受众?

从根本上说,CPython 和标准库的主要受众是哪些呢?是那些不管出于什么原因,将有限的标准库和从 PyPI 显式声明安装的第三方库组合起来所提供的服务还不能够满足需求的那些人。

为了更进一步简化上面回顾的不同用法和部署模型,宏观地将最大的 Python 用户群体分开来看,一类是在一些感兴趣的环境中将 Python 作为一种 脚本语言 使用的人;另外一种是将它用作一个 应用程序开发语言 的人,他们最终发布的是一种产品而不是他们的脚本。

把 Python 作为一种脚本语言来使用的开发者的典型特性包括:

  • 主要的工作单元是由一个 Python 文件组成的(或 Jupyter notebook),而不是一个 Python 和元数据文件的目录
  • 没有任何形式的单独的构建步骤 —— 是作为一个脚本分发的,类似于分发一个独立的 shell 脚本的方式
  • 没有单独的安装步骤(除了下载这个文件到一个合适的位置),因为在目标系统上要求预配置运行时环境
  • 没有显式的规定依赖关系,除了最低的 Python 版本,或一个预期的运行环境声明。如果需要一个标准库以外的依赖项,他们会通过一个环境脚本去提供(无论是操作系统、数据分析平台、还是嵌入 Python 运行时的应用程序)
  • 没有单独的测试套件,使用 “通过你给定的输入,这个脚本是否给出了你期望的结果?” 这种方式来进行测试
  • 如果在执行前需要测试,它将以 试运行 dry run> 和 预览 preview 模式来向用户展示软件将怎样运行
  • 如果使用静态代码分析工具,则通过集成到用户的软件开发环境中,而不是为每个脚本单独设置

相比之下,使用 Python 作为一个应用程序开发语言的开发者特征包括:

  • 主要的工作单元是由 Python 和元数据文件组成的目录,而不是单个 Python 文件
  • 在发布之前有一个单独的构建步骤去预处理应用程序,哪怕是把它的这些文件一起打包进一个 Python sdist、wheel 或 zipapp 中
  • 应用程序是否有独立的安装步骤做预处理,取决于它是如何打包的,和支持的目标环境
  • 外部的依赖明确存在于项目目录下的一个元数据文件中,要么是直接在项目目录中(如 pyproject.toml、requirements.txt、Pipfile),要么是作为生成的发行包的一部分(如 setup.py、flit.ini)
  • 有独立的测试套件,或者作为一个 Python API 的一个单元测试,或者作为功能接口的集成测试,或者是两者都有
  • 静态分析工具的使用是在项目级配置的,并作为测试管理的一部分,而不是作为依赖

作为以上分类的一个结果,CPython 和标准库的主要用途是,在相应的 CPython 特性发布后,为教育和 临时 ad hoc 的 Python 脚本环境提供 3-5 年基础维护服务。

对于临时脚本使用的情况,这个 3-5 年的延迟是由于再分发者给用户开发新版本的延迟造成的,以及那些再分发版本的用户们花在修改他们的标准操作环境上的时间。

对于教育环境中的情况是,教育工作者需要一些时间去评估新特性,然后决定是否将它们包含进教学的课程中。

这些相关问题的原因是什么?

这篇文章很大程度上是受 Twitter 上对我的这个评论的讨论的启发,它援引了定义在 PEP 411 中 临时 Provisional API 的情形,作为一个开源项目的例子,对用户发出事实上的邀请,请其作为共同开发者去积极参与设计和开发过程,而不是仅被动使用已准备好的最终设计。

这些回复包括一些在更高级别的库中支持临时 API 的困难程度的一些沮丧性表述,没有这些库做临时状态的传递,因此而被限制为只有临时 API 的最新版本才支持这些相关特性,而不是任何早期版本的迭代。

我的主要回应是,建议开源提供者应该强制实施有限支持,通过这种强制的有限支持可以让个人的维护努力变得可持续。这意味着,如果对临时 API 的老版本提供迭代支持是非常痛苦的,那么,只有在项目开发人员自己需要、或有人为此支付费用时,他们才会去提供支持。这与我的这个观点是类似的,那就是,志愿者提供的项目是否应该免费支持老的、商业性质的、长周期的 Python 版本,这对他们来说是非常麻烦的事,我不认为他们应该这样做,正如我所期望的那样,大多数这样的需求都来自于管理差劲的惯性,而不是真正的需求(真正的需求,应该去支付费用来解决问题)。

而我的第二个回应是去实现这一点,尽管多年来一直在讨论这个问题(比如,在上面链接中最早在 2011 年的一篇的文章中,以及在 Python 3 问答的回复中的这里、这里、和这里,以及去年的这篇文章 Python 包生态系统中也提到了一些),但我从来没有真实地尝试直接去解释它在标准库设计过程中的影响。

如果没有这些背景,设计过程中的一部分,比如临时 API 的引入,或者是 受启发而不同于它 inspired-by-not-the-same-as 的引入,看起来似乎是完全没有意义的,因为他们看起来似乎是在尝试对 API 进行标准化,而实际上并没有。

适合进入 PyPI 规划的方面有哪些?

任何提交给 python-ideas 或 python-dev 的提案所面临的第一个门槛就是清楚地回答这个问题:“为什么 PyPI 上的模块不够好?”。绝大多数的提案都在这一步失败了,为了通过这一步,这里有几个常见的话题:

  • 比起下载一个合适的第三方库,新手一般可能更倾向于从互联网上 “复制粘贴” 错误的指导。(这就是为什么存在 secrets 库的原因:它使得人们很少去使用 random 模块,由于安全敏感的原因,它预期用于游戏和模拟统计)
  • 该模块旨在提供一个参考实现,并允许与其它的竞争实现之间提供互操作性,而不是对所有人的所有事物都是必要的。(如 asyncio、wsgiref、unittest、和 logging 都是这种情况)
  • 该模块是预期用于标准库的其它部分(如 enum 就是这种情况,像 unittest 一样)
  • 该模块是被设计用于支持语言之外的一些语法(如 contextlib、asyncio 和 typing)
  • 该模块只是普通的临时的脚本用途(如 pathlib 和 ipaddress)
  • 该模块被用于一个教育环境(例如,statistics 模块允许进行交互式地探索统计的概念,尽管你可能根本就不会用它来做完整的统计分析)

只通过了前面的 “PyPI 是不是明显不够好” 的检查,一个模块还不足以确保被纳入标准库中,但它已经足以将问题转变为 “在未来几年中,你所推荐的要包含的库能否对一般的入门级 Python 开发人员的经验有所提升?”

标准库中的 ensurepip 和 venv 模块的引入也明确地告诉再分发者,我们期望的 Python 级别的打包和安装工具在任何平台的特定分发机制中都予以支持。

当添加它们到标准库中时,为什么一些 API 会被修改?

现有的第三方模块有时候会被批量地采用到标准库中,在其它情况下,实际上添加的是吸收了用户对现有 API 体验之后进行重新设计和重新实现的 API,但是会根据另外的设计考虑和已经成为其中一部分的语言实现参考来进行一些删除或细节修改。

例如,与流行的第三方库 path.py、pathlib 的前身不同,它们并没有定义字符串子类,而是以独立的类型替代。作为解决文件互操作性问题的结果,定义了文件系统路径协议,它允许使用文件系统路径的接口去使用更多的对象。

为了在 “IP 地址” 这个概念的教学上提供一个更好的工具,ipaddress 模块设计调整为明确地将主机接口定义与地址和网络的定义区分开(IP 地址被关联到特定的 IP 网络),而最原始的 ipaddr 模块中,在网络术语的使用方式上不那么严格。

另外的情况是,标准库将综合多种现有的方法的来构建,以及为早已存在的库定义 API 时,还有可能依赖不存在的语法特性。比如,asyncio 和 typing 模块就全部考虑了这些因素,虽然在 PEP 557 中正在考虑将后者所考虑的因素应用到 dataclasses API 上。(它可以被总结为 “像属性一样,但是使用可变注释作为字段声明”)。

这类修改的原理是,这类库不会消失,并且它们的维护者对标准库维护相关的那些限制通常并不感兴趣(特别是相对缓慢的发布节奏)。在这种情况下,在标准库文档的更新版本中使用 “See Also” 链接指向原始模块的做法非常常见,尤其是在第三方版本额外提供了标准库模块中忽略的那些特性时。

为什么一些 API 是以临时的形式被添加的?

虽然 CPython 维护了 API 的弃用策略,但在没有正当理由的情况下,我们通常不会去使用该策略(在其他项目试图与 Python 2.7 保持兼容性时,尤其如此)。

然而在实践中,当添加这种受已有的第三方启发而不是直接精确拷贝第三方设计的新 API 时,所承担的风险要高于一些正常设计决定可能出现问题的风险。

当我们考虑到这种改变的风险比平常要高,我们将相关的 API 标记为临时,表示保守的终端用户要避免完全依赖它们,而共享抽象层的开发者可能希望对他们准备去支持的那个临时 API 的版本考虑实施比平时更严格的限制。

为什么只有一些标准库 API 被升级?

这里简短的回答得到升级的主要 API 有哪些:

  • 不太可能有大量的外部因素干扰的附加更新的
  • 无论是对临时脚本用例还是对促进将来多个第三方解决方案之间的互操作性,都有明显好处的
  • 对这方面感兴趣的人提交了一个可接受的建议的

如果在将模块用于应用程序开发目的时(如 datetime),现有模块的限制主要是显而易见的,如果再分发者通过第三方方案很容易地实现了改进,(如 requests),或者如果标准库的发布节奏与所需要的包之间真的存在冲突,(如 certifi),那么,建议对标准库版本进行改变的因素将显著减少。

从本质上说,这和上面关于 PyPI 问题正好相反:因为从应用程序开发人员体验的角度来说,PyPI 的分发机制通常已经够好了,这种分发方式的改进是有意义的,允许再分发者和平台提供者自行决定将哪些内容作为他们缺省提供的一部分。

假设在 3-5 年时间内,缺省出现了被认为是改变带来的可感知的价值时,才会将这些改变纳入到 CPython 和标准库中。

标准库任何部分都有独立的版本吗?

是的,就像是 ensurepip 使用的捆绑模式(CPython 发行了一个 pip 的最新捆绑版本,而并没有把它放进标准库中),将来可能被应用到其它模块中。

最有可能的第一个候选者是 distutils 构建系统,因为切换到这种模式将允许构建系统在多个发行版本之间保持一致。

这种处理方式的其它可能候选者是 Tcl/Tk 图形套件和 IDLE 编辑器,它们已经被拆分,并且一些开发者将其改为可选安装项。

这些注意事项为什么很重要?

从本质上说,那些积极参与开源开发的人就是那些致力于开源应用程序和共享抽象层的人。

那些写一些临时脚本或为学生设计一些教学习题的人,通常不认为他们是软件开发人员 —— 他们是教师、系统管理员、数据分析人员、金融工程师、流行病学家、物理学家、生物学家、市场研究员、动画师、平面设计师等等。

对于一种语言,当我们全部的担心都是开发人员的经验时,那么我们就可以根据人们所知道的内容、他们使用的工具种类、他们所遵循的开发流程种类、构建和部署他们软件的方法等假定,来做大量的简化。

当应用程序运行时作为脚本引擎广泛流行时,事情会变得更加复杂。做好任何一项工作已经很困难,并且作为单个项目的一部分来平衡两个受众的需求会导致双方经常不理解和不相信。

这篇文章不是为了说明我们在开发 CPython 过程中从来没有做出过不正确的决定 —— 它只是去合理地回应那些对添加到 Python 标准库中的看上去很荒谬的特性的质疑,它将是 “我不是那个特性的预期目标受众的一部分”,而不是 “我对它没有兴趣,因此它对所有人都是毫无用处和没有价值的,添加它纯属骚扰我”。


via: http://www.curiousefficiency.org/posts/2017/10/considering-pythons-target-audience.html

作者:Nick Coghlan 译者:qhwdw 校对:wxy、pityonline

本文由 LCTT 原创编译,Linux中国 荣誉推出

EduBlocks 提供了 Scratch 式的图形界面来编写 Python 3 代码。

如果你正在寻找一种方法将你的学生(或你自己)从使用 Scratch 编程转移到学习 Python,我建议你了解一下 EduBlocks。它为 Python 3 编程带来了熟悉的拖放式图形用户界面(GUI)。

从 Scratch 过渡到 Python 的一个障碍是缺少拖放式 GUI,而正是这种拖放式 GUI 使得 Scratch 成为 K-12 学校的首选程序。EduBlocks 的拖放版的 Python 3 改变了这种范式。它的目的是“帮助教师在较早的时候向儿童介绍基于文本的编程语言,如 Python。”

EduBlocks 的硬件要求非常适中 —— 一个树莓派和一条互联网连接 —— 应该可以在许多教室中使用。

EduBlocks 是由来自英国的 14 岁 Python 开发人员 Joshua Lowe 开发的。我看到 Joshua 在 2018 年 5 月的 PyCon 2018 上展示了他的项目。

入门

安装 EduBlocks 很容易。该网站提供了清晰的安装说明,你可以在项目的 GitHub 仓库中找到详细的截图。

使用以下命令在 Raspberry Pi 命令行安装 EduBlocks:

curl -sSL get.edublocks.org | bash

在 EduBlocks 中编程

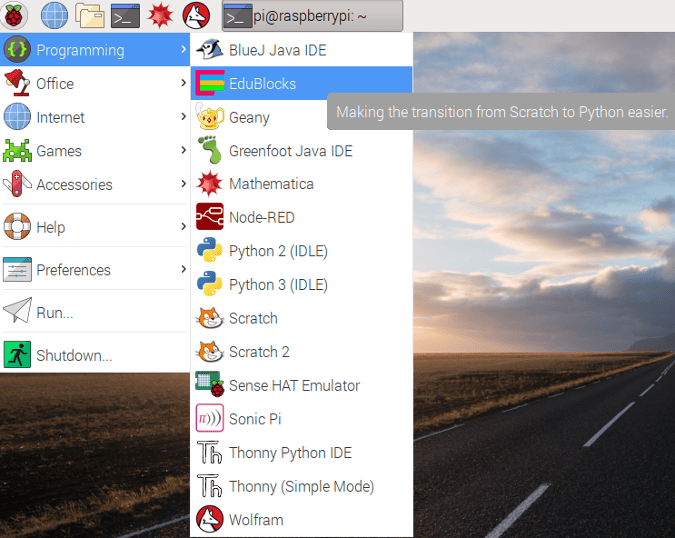
安装完成后,从桌面快捷方式或 Raspberry Pi 上的“编程”菜单启动 EduBlocks。

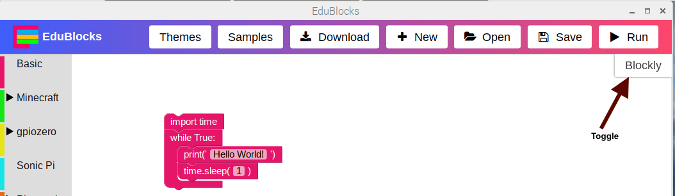
启动程序后,你可以使用 EduBlocks 的拖放界面开始创建 Python 3 代码。它的菜单有清晰的标签。你可以通过单击 Samples 菜单按钮使用示例代码。你还可以通过单击 Theme 为你的编程界面选择不同的配色方案。使用 Save 菜单,你可以保存你的作品,然后 Download 你的 Python 代码。单击 Run 来执行并测试你的代码。

你可以通过单击最右侧的 Blockly 按钮来查看代码。它让你在 ”Blockly” 界面和普通的 Python 代码视图之间切换(正如你在任何其他 Python 编辑器中看到的那样)。

EduBlocks 附带了一系列代码库,包括 EduPython、Minecraft、Sonic Pi、GPIO Zero 和 Sense Hat。

学习和支持

该项目维护了一个学习门户网站,其中包含教程和其他资源,可以轻松地 hack 树莓派版本的 Minecraft,编写 GPIOZero 和 Sonic Pi,并使用 Micro:bit 代码编辑器控制 LED。可以在 Twitter @edu\_blocks 和 @allaboutcode 以及 email 提供对 EduBlocks 的支持。

为了更深入的了解,你可以在 GitHub 上访问 EduBlocks 的源代码。该程序在 GNU Affero Public License v3.0 下许可。EduBlocks 的创建者(项目负责人 Joshua Lowe 和开发人员 Chris Dell 和 Les Pounder)希望它成为一个社区项目,并邀请人们提出问题,提供反馈,以及提交 pull request 以向项目添加功能或修复。


via: https://opensource.com/article/18/8/edublocks

作者:Don Watkins 选题:lujun9972 译者:geekpi 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

相识 Mu —— 一个可以使学生学习 Python 更轻松的开源编辑器。

Mu 是一个给初学者的 Python 编辑器,它旨在使学习体验更加愉快。它使学生​​能够在早期体验成功,这在你学习任何新知识的时候都很重要。

如果你曾试图教年轻人如何编程,你会立即把握到 Mu 的重要性。大多数编程工具都是由开发人员为开发人员编写的,不管他们的年龄如何,它们并不适合初学者。然而,Mu 是由老师为学生写的。

Mu 的起源

Mu 是 Nicholas Tollervey 的心血结晶(我听过他 5 月份在 PyCon2018 上发言)。Nicholas 是一位受过古典音乐训练的音乐家,在担任音乐老师期间,他在职业生涯早期就开始对 Python 和开发感兴趣。他还写了 Python in Education,这是一本可以从 O'Reilly 下载的免费书。

Nicholas 曾经寻找过一个更简单的 Python 编程界面。他想要一些没有其他编辑器(甚至是 Python 附带的 IDLE3 编辑器 )复杂性的东西,所以他与 Raspberry Pi 基金会(赞助他的工作)的教育总监 Carrie Ann Philbin 合作开发了 Mu 。

Mu 是一个用 Python 编写的开源程序(在 GNU GPLv3 许可证下)。它最初是为 Micro:bit 迷你计算机开发的,但是其他老师的反馈和请求促使他将 Mu 重写为通用的 Python 编辑器。

受音乐启发

Nicholas 对 Mu 的启发来自于他教授音乐的方法。他想知道如果我们按照教授音乐的方式教授编程会如何,并立即看出了差别。与编程不同,我们没有音乐训练营,我们也不会书上学习如何演奏乐器,比如说如何演奏长笛。

Nicholas 说,Mu “旨在成为真实的东西”,因为没有人可以在 30 分钟内学习 Python。当他开发 Mu 时,他与老师一起工作,观察编程俱乐部,并观看中学生使用 Python。他发现少即多,保持简单可以改善成品的功能。Nicholas 说,Mu 只有大约 3,000 行代码。

使用 Mu

要尝试它,下载 Mu 并按照 Linux、Windows 和 Mac OS的简易安装说明进行操作。如果像我一样,你想在 Raspberry Pi 上安装,请在终端中输入以下内容:

$ sudo apt-get update
$ sudo apt-get install mu

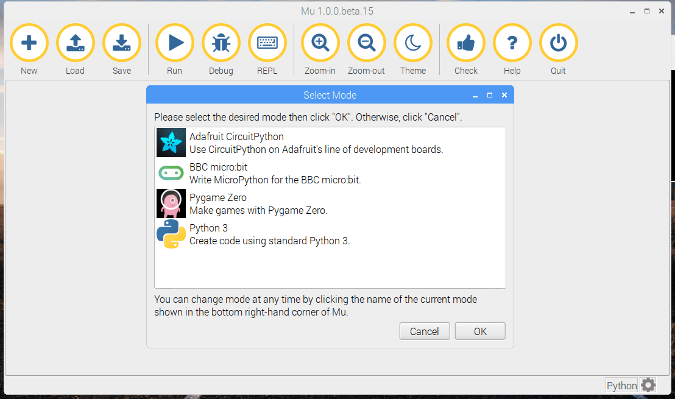
从编程菜单启动 Mu。然后你就可以选择如何使用 Mu。

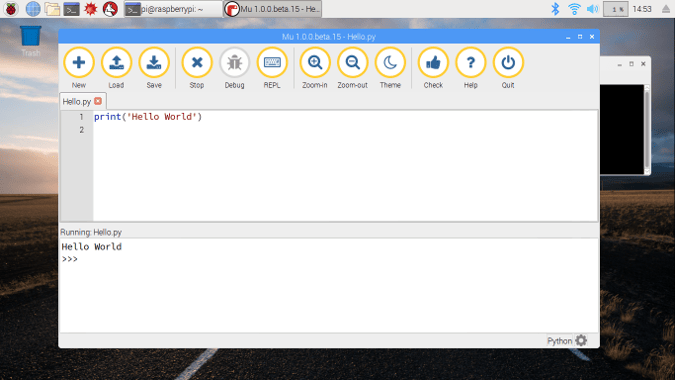
我选择了Python 3,它启动了编写代码的环境。Python shell 直接在下面,它允许你查看代码执行。

菜单使用和理解非常简单,这实现了 Mu 的目标 —— 让编写代码对初学者简单。

在 Mu 用户的网站上可找到教程和其他资源。在网站上,你还可以看到一些帮助开发 Mu 的志愿者的名字。如果你想成为其中之一并为 Mu 的发展做出贡献,我们非常欢迎您。


via: https://opensource.com/article/18/8/getting-started-mu-python-editor-beginners

作者:Don Watkins 选题:lujun9972 译者:geekpi 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

了解区块链是如何工作的最快的方法是构建一个。
你看到这篇文章是因为和我一样,对加密货币的大热而感到兴奋。并且想知道区块链是如何工作的 —— 它们背后的技术基础是什么。

但是理解区块链并不容易 —— 至少对我来说是这样。我徜徉在各种难懂的视频中,并且因为示例太少而陷入深深的挫败感中。

我喜欢在实践中学习。这会使得我在代码层面上处理主要问题,从而可以让我坚持到底。如果你也是这么做的,在本指南结束的时候,你将拥有一个功能正常的区块链,并且实实在在地理解了它的工作原理。

开始之前 …

记住,区块链是一个 不可更改的、有序的 记录(被称为区块)的链。它们可以包括 交易 transaction 、文件或者任何你希望的真实数据。最重要的是它们是通过使用哈希链接到一起的。

如果你不知道哈希是什么,这里有解释。

本指南的目标读者是谁? 你应该能轻松地读、写一些基本的 Python 代码,并能够理解 HTTP 请求是如何工作的,因为我们讨论的区块链将基于 HTTP。

我需要做什么? 确保安装了 Python 3.6+(以及 pip),还需要去安装 Flask 和非常好用的 Requests 库:

pip install Flask==0.12.2 requests==2.18.4 

当然,你也需要一个 HTTP 客户端,像 Postman 或者 cURL。哪个都行。

最终的代码在哪里可以找到? 源代码在 这里。

第 1 步:构建一个区块链

打开你喜欢的文本编辑器或者 IDE,我个人喜欢 PyCharm。创建一个名为 blockchain.py 的新文件。我将仅使用一个文件,如果你看晕了,可以去参考 源代码。

描述一个区块链

我们将创建一个 Blockchain 类,它的构造函数将去初始化一个空列表(去存储我们的区块链),以及另一个列表去保存交易。下面是我们的类规划:

class Blockchain(object):
    def __init__(self):
        self.chain = []
        self.current_transactions = []

    def new_block(self):
        # Creates a new Block and adds it to the chain
        pass

    def new_transaction(self):
        # Adds a new transaction to the list of transactions
        pass

    @staticmethod
    def hash(block):
        # Hashes a Block
        pass

    @property
    def last_block(self):
        # Returns the last Block in the chain
        pass

我们的 Blockchain 类的原型

我们的 Blockchain 类负责管理链。它将存储交易并且有一些为链中增加新区块的辅助性质的方法。现在我们开始去充实一些类的方法。

区块是什么样子的?

每个区块有一个索引、一个时间戳(Unix 时间)、一个交易的列表、一个证明(后面会详细解释)、以及前一个区块的哈希。

单个区块的示例应该是下面的样子:

block = {
    'index': 1,
    'timestamp': 1506057125.900785,
    'transactions': [
        {
            'sender': "8527147fe1f5426f9dd545de4b27ee00",
            'recipient': "a77f5cdfa2934df3954a5c7c7da5df1f",
            'amount': 5,
        }
    ],
    'proof': 324984774000,
    'previous_hash': "2cf24dba5fb0a30e26e83b2ac5b9e29e1b161e5c1fa7425e73043362938b9824"
}

我们的区块链中的块示例

此刻,链的概念应该非常明显 —— 每个新区块包含它自身的信息和前一个区域的哈希。这一点非常重要,因为这就是区块链不可更改的原因:如果攻击者修改了一个早期的区块,那么所有的后续区块将包含错误的哈希。

这样做有意义吗?如果没有,就让时间来埋葬它吧 —— 这就是区块链背后的核心思想。

添加交易到一个区块

我们将需要一种区块中添加交易的方式。我们的 new_transaction() 就是做这个的,它非常简单明了:

class Blockchain(object):
    ...

    def new_transaction(self, sender, recipient, amount):
        """
        Creates a new transaction to go into the next mined Block
        :param sender: <str> Address of the Sender
        :param recipient: <str> Address of the Recipient
        :param amount: <int> Amount
        :return: <int> The index of the Block that will hold this transaction
        """

        self.current_transactions.append({
            'sender': sender,
            'recipient': recipient,
            'amount': amount,
        })

        return self.last_block['index'] + 1

在 new_transaction() 运行后将在列表中添加一个交易,它返回添加交易后的那个区块的索引 —— 那个区块接下来将被挖矿。提交交易的用户后面会用到这些。

创建新区块

当我们的 Blockchain 被实例化后,我们需要一个创世区块(一个没有祖先的区块)来播种它。我们也需要去添加一些 “证明” 到创世区块,它是挖矿(工作量证明 PoW)的成果。我们在后面将讨论更多挖矿的内容。

除了在我们的构造函数中创建创世区块之外,我们还需要写一些方法,如 new_block()、new_transaction() 以及 hash():

import hashlib
import json
from time import time


class Blockchain(object):
    def __init__(self):
        self.current_transactions = []
        self.chain = []

        # Create the genesis block
        self.new_block(previous_hash=1, proof=100)

    def new_block(self, proof, previous_hash=None):
        """
        Create a new Block in the Blockchain
        :param proof: <int> The proof given by the Proof of Work algorithm
        :param previous_hash: (Optional) <str> Hash of previous Block
        :return: <dict> New Block
        """

        block = {
            'index': len(self.chain) + 1,
            'timestamp': time(),
            'transactions': self.current_transactions,
            'proof': proof,
            'previous_hash': previous_hash or self.hash(self.chain[-1]),
        }

        # Reset the current list of transactions
        self.current_transactions = []

        self.chain.append(block)
        return block

    def new_transaction(self, sender, recipient, amount):
        """
        Creates a new transaction to go into the next mined Block
        :param sender: <str> Address of the Sender
        :param recipient: <str> Address of the Recipient
        :param amount: <int> Amount
        :return: <int> The index of the Block that will hold this transaction
        """
        self.current_transactions.append({
            'sender': sender,
            'recipient': recipient,
            'amount': amount,
        })

        return self.last_block['index'] + 1

    @property
    def last_block(self):
        return self.chain[-1]

    @staticmethod
    def hash(block):
        """
        Creates a SHA-256 hash of a Block
        :param block: <dict> Block
        :return: <str>
        """

        # We must make sure that the Dictionary is Ordered, or we'll have inconsistent hashes
        block_string = json.dumps(block, sort_keys=True).encode()
        return hashlib.sha256(block_string).hexdigest()

上面的内容简单明了 —— 我添加了一些注释和文档字符串,以使代码清晰可读。到此为止,表示我们的区块链基本上要完成了。但是,你肯定想知道新区块是如何被创建、打造或者挖矿的。

理解工作量证明

工作量证明 Proof of Work (PoW)算法是在区块链上创建或者挖出新区块的方法。PoW 的目标是去撞出一个能够解决问题的数字。这个数字必须满足“找到它很困难但是验证它很容易”的条件 —— 网络上的任何人都可以计算它。这就是 PoW 背后的核心思想。

我们来看一个非常简单的示例来帮助你了解它。

我们来解决一个问题,一些整数 x 乘以另外一个整数 y 的结果的哈希值必须以 0 结束。因此,hash(x * y) = ac23dc…0。为简单起见,我们先把 x = 5 固定下来。在 Python 中的实现如下:

from hashlib import sha256

x = 5
y = 0  # We don't know what y should be yet...

while sha256(f'{x*y}'.encode()).hexdigest()[-1] != "0":
    y += 1

print(f'The solution is y = {y}')

在这里的答案是 y = 21。因为它产生的哈希值是以 0 结尾的:

hash(5 * 21) = 1253e9373e...5e3600155e860

在比特币中,工作量证明算法被称之为 Hashcash。与我们上面的例子没有太大的差别。这就是矿工们进行竞赛以决定谁来创建新块的算法。一般来说,其难度取决于在一个字符串中所查找的字符数量。然后矿工会因其做出的求解而得到奖励的币——在一个交易当中。

网络上的任何人都可以很容易地去核验它的答案。

实现基本的 PoW

为我们的区块链来实现一个简单的算法。我们的规则与上面的示例类似:

找出一个数字 p,它与前一个区块的答案进行哈希运算得到一个哈希值,这个哈希值的前四位必须是由 0 组成。
import hashlib
import json

from time import time
from uuid import uuid4


class Blockchain(object):
    ...

    def proof_of_work(self, last_proof):
        """
        Simple Proof of Work Algorithm:
         - Find a number p' such that hash(pp') contains leading 4 zeroes, where p is the previous p'
         - p is the previous proof, and p' is the new proof
        :param last_proof: <int>
        :return: <int>
        """

        proof = 0
        while self.valid_proof(last_proof, proof) is False:
            proof += 1

        return proof

    @staticmethod
    def valid_proof(last_proof, proof):
        """
        Validates the Proof: Does hash(last_proof, proof) contain 4 leading zeroes?
        :param last_proof: <int> Previous Proof
        :param proof: <int> Current Proof
        :return: <bool> True if correct, False if not.
        """

        guess = f'{last_proof}{proof}'.encode()
        guess_hash = hashlib.sha256(guess).hexdigest()
        return guess_hash[:4] == "0000"

为了调整算法的难度,我们可以修改前导 0 的数量。但是 4 个零已经足够难了。你会发现,将前导 0 的数量每增加一,那么找到正确答案所需要的时间难度将大幅增加。

我们的类基本完成了,现在我们开始去使用 HTTP 请求与它交互。

第 2 步:以 API 方式去访问我们的区块链

我们将使用 Python Flask 框架。它是个微框架,使用它去做端点到 Python 函数的映射很容易。这样我们可以使用 HTTP 请求基于 web 来与我们的区块链对话。

我们将创建三个方法:

  • /transactions/new 在一个区块上创建一个新交易
  • /mine 告诉我们的服务器去挖矿一个新区块
  • /chain 返回完整的区块链

配置 Flask

我们的 “服务器” 将在我们的区块链网络中产生一个单个的节点。我们来创建一些样板代码:

import hashlib
import json
from textwrap import dedent
from time import time
from uuid import uuid4

from flask import Flask


class Blockchain(object):
    ...


# Instantiate our Node
app = Flask(__name__)

# Generate a globally unique address for this node
node_identifier = str(uuid4()).replace('-', '')

# Instantiate the Blockchain
blockchain = Blockchain()


@app.route('/mine', methods=['GET'])
def mine():
    return "We'll mine a new Block"

@app.route('/transactions/new', methods=['POST'])
def new_transaction():
    return "We'll add a new transaction"

@app.route('/chain', methods=['GET'])
def full_chain():
    response = {
        'chain': blockchain.chain,
        'length': len(blockchain.chain),
    }
    return jsonify(response), 200

if __name__ == '__main__':
    app.run(host='0.0.0.0', port=5000)

对上面的代码,我们做添加一些详细的解释:

  • Line 15:实例化我们的节点。更多关于 Flask 的知识读 这里。
  • Line 18:为我们的节点创建一个随机的名字。
  • Line 21:实例化我们的区块链类。
  • Line 24–26:创建 /mine 端点,这是一个 GET 请求。
  • Line 28–30:创建 /transactions/new 端点,这是一个 POST 请求,因为我们要发送数据给它。
  • Line 32–38:创建 /chain 端点,它返回全部区块链。
  • Line 40–41:在 5000 端口上运行服务器。

交易端点

这就是对一个交易的请求,它是用户发送给服务器的:

{
 "sender": "my address",
 "recipient": "someone else's address",
 "amount": 5
}

因为我们已经有了添加交易到块中的类方法,剩下的就很容易了。让我们写个函数来添加交易:

import hashlib
import json
from textwrap import dedent
from time import time
from uuid import uuid4

from flask import Flask, jsonify, request

...

@app.route('/transactions/new', methods=['POST'])
def new_transaction():
    values = request.get_json()

    # Check that the required fields are in the POST'ed data
    required = ['sender', 'recipient', 'amount']
    if not all(k in values for k in required):
        return 'Missing values', 400

    # Create a new Transaction
    index = blockchain.new_transaction(values['sender'], values['recipient'], values['amount'])

    response = {'message': f'Transaction will be added to Block {index}'}
    return jsonify(response), 201

创建交易的方法

挖矿端点

我们的挖矿端点是见证奇迹的地方,它实现起来很容易。它要做三件事情:

  1. 计算工作量证明
  2. 因为矿工(我们)添加一个交易而获得报酬,奖励矿工(我们) 1 个币
  3. 通过将它添加到链上而打造一个新区块
import hashlib
import json

from time import time
from uuid import uuid4

from flask import Flask, jsonify, request

...

@app.route('/mine', methods=['GET'])
def mine():
    # We run the proof of work algorithm to get the next proof...
    last_block = blockchain.last_block
    last_proof = last_block['proof']
    proof = blockchain.proof_of_work(last_proof)

    # We must receive a reward for finding the proof.
    # The sender is "0" to signify that this node has mined a new coin.
    blockchain.new_transaction(
        sender="0",
        recipient=node_identifier,
        amount=1,
    )

    # Forge the new Block by adding it to the chain
    previous_hash = blockchain.hash(last_block)
    block = blockchain.new_block(proof, previous_hash)

    response = {
        'message': "New Block Forged",
        'index': block['index'],
        'transactions': block['transactions'],
        'proof': block['proof'],
        'previous_hash': block['previous_hash'],
    }
    return jsonify(response), 200

注意,挖掘出的区块的接收方是我们的节点地址。现在,我们所做的大部分工作都只是与我们的 Blockchain 类的方法进行交互的。到目前为止,我们已经做完了,现在开始与我们的区块链去交互。

第 3 步:与我们的区块链去交互

你可以使用简单的 cURL 或者 Postman 通过网络与我们的 API 去交互。

启动服务器:

$ python blockchain.py
* Running on http://127.0.0.1:5000/ (Press CTRL+C to quit)

我们通过生成一个 GET 请求到 http://localhost:5000/mine 去尝试挖一个区块:
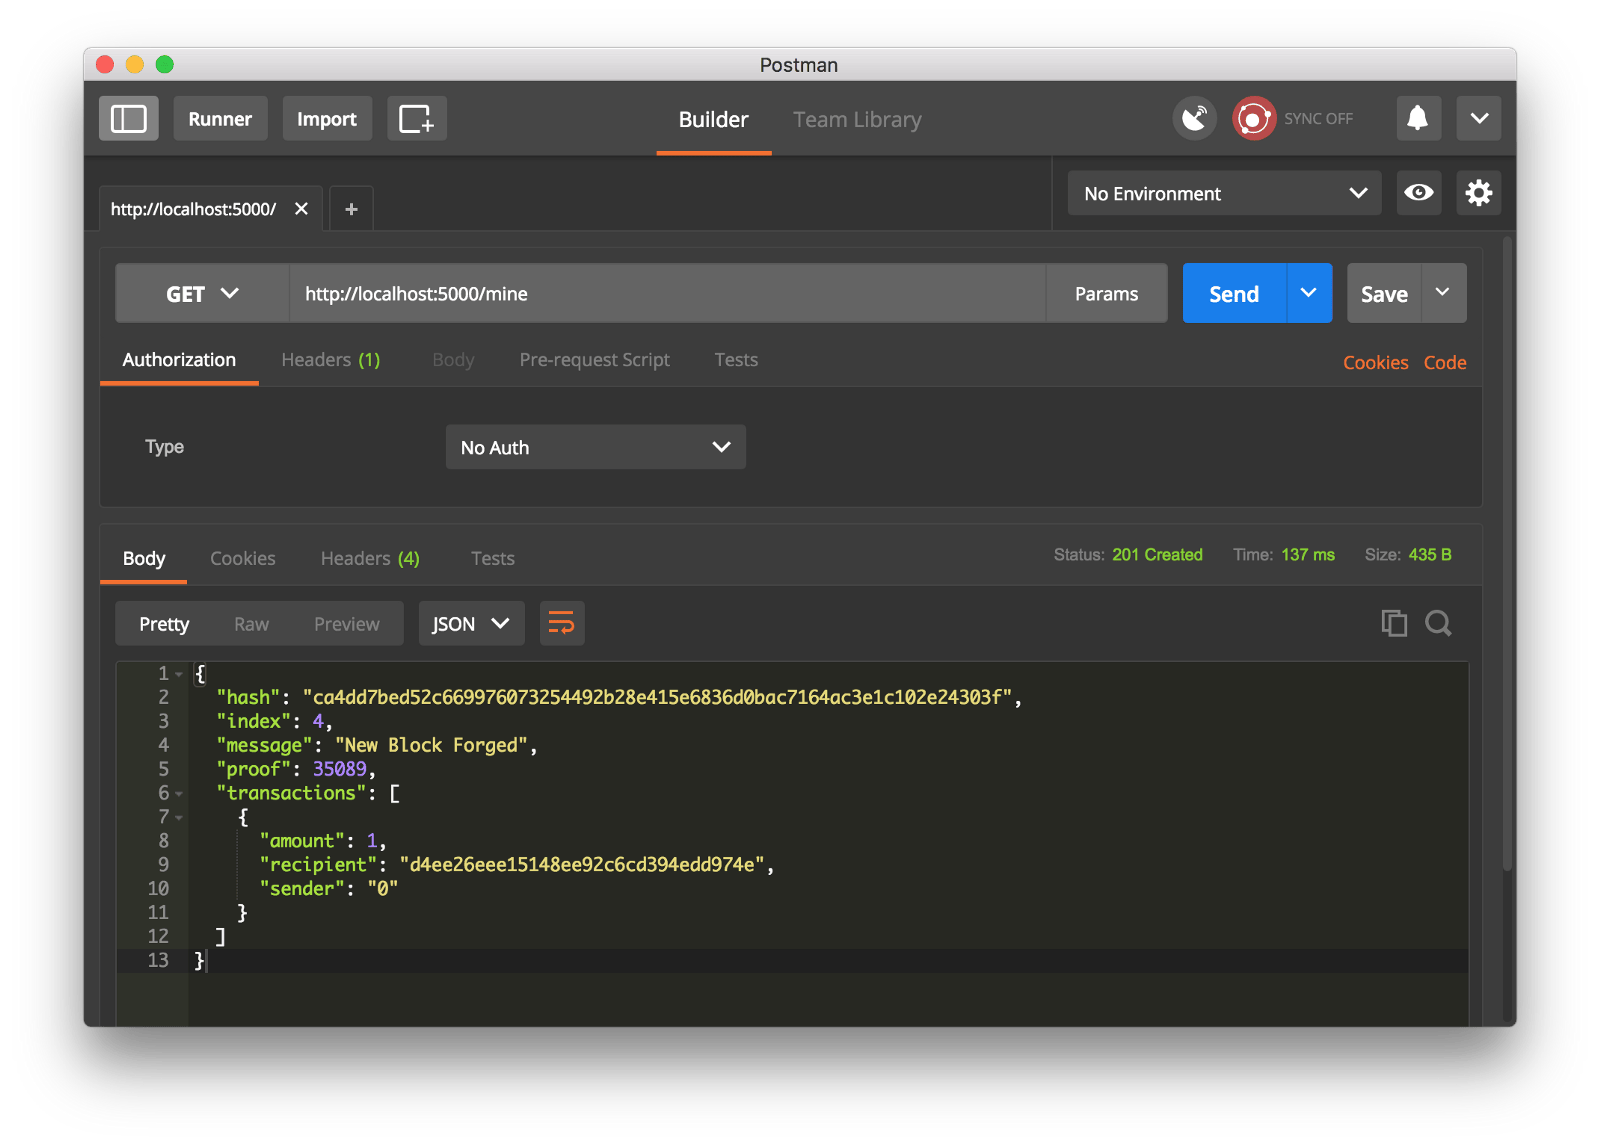
使用 Postman 去生成一个 GET 请求

我们通过生成一个 POST 请求到 http://localhost:5000/transactions/new 去创建一个区块,请求数据包含我们的交易结构:
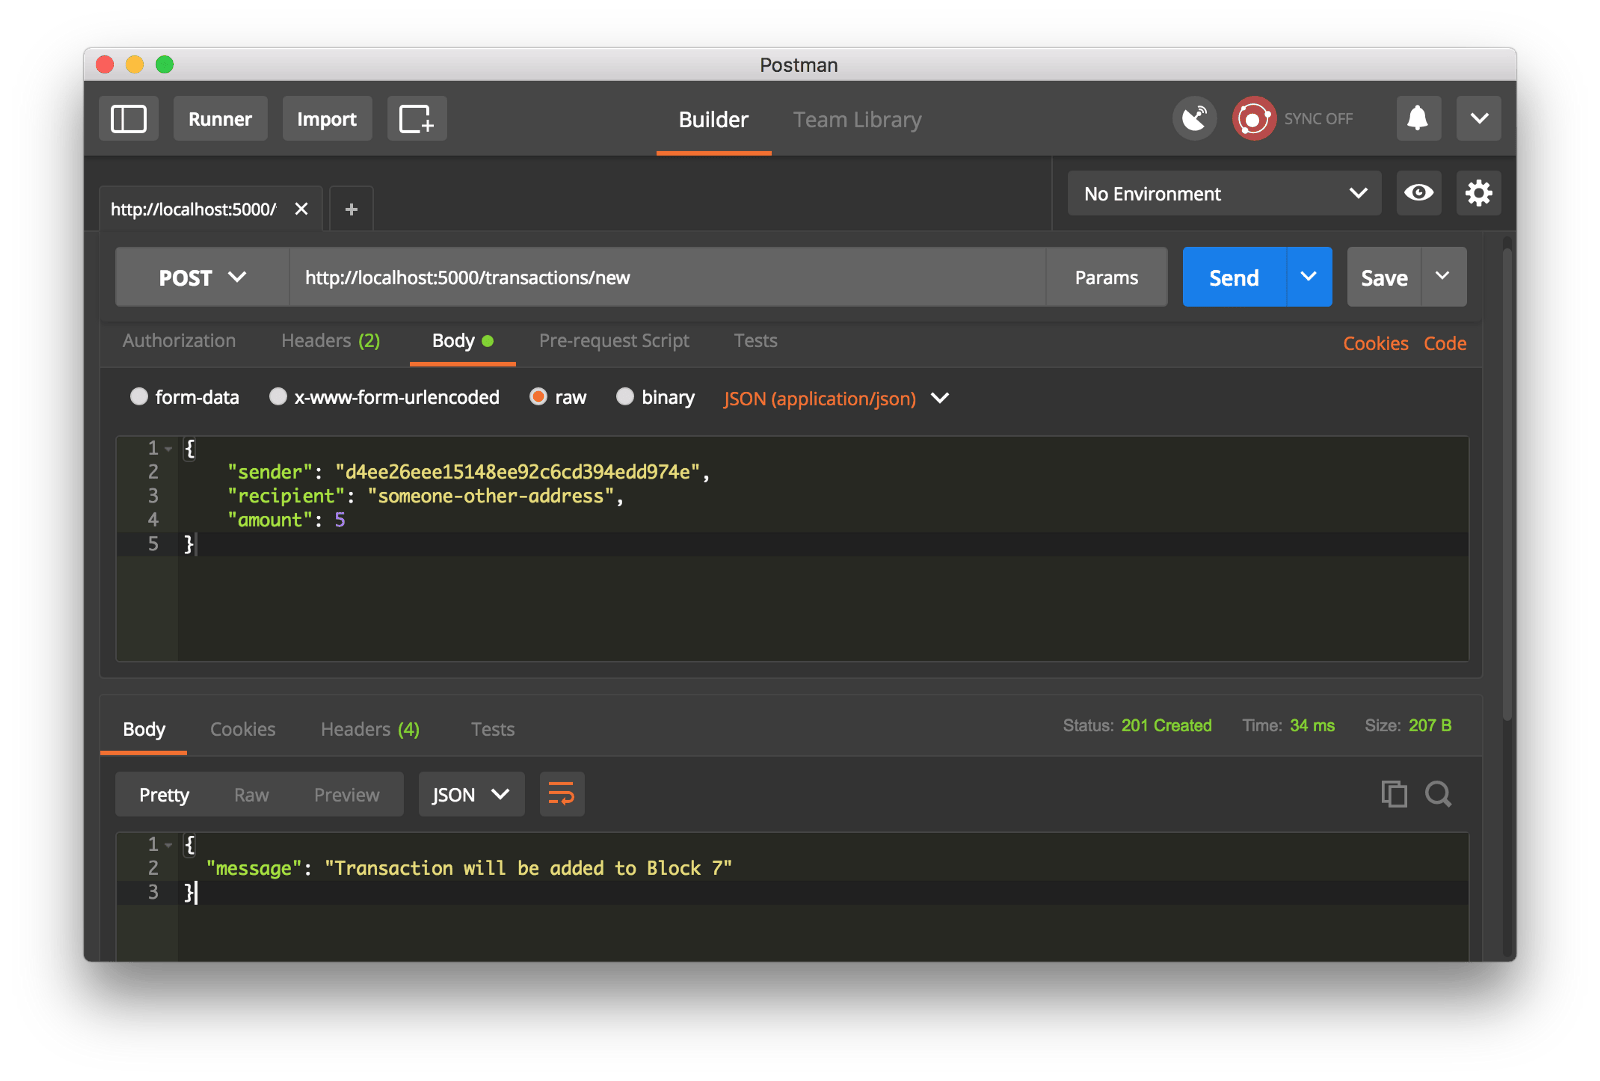
使用 Postman 去生成一个 POST 请求

如果你不使用 Postman,也可以使用 cURL 去生成一个等价的请求:

$ curl -X POST -H "Content-Type: application/json" -d '{
 "sender": "d4ee26eee15148ee92c6cd394edd974e",
 "recipient": "someone-other-address",
 "amount": 5
}' "http://localhost:5000/transactions/new"

我重启动我的服务器,然后我挖到了两个区块,这样总共有了 3 个区块。我们通过请求 http://localhost:5000/chain 来检查整个区块链:

{
  "chain": [
    {
      "index": 1,
      "previous_hash": 1,
      "proof": 100,
      "timestamp": 1506280650.770839,
      "transactions": []
    },
    {
      "index": 2,
      "previous_hash": "c099bc...bfb7",
      "proof": 35293,
      "timestamp": 1506280664.717925,
      "transactions": [
        {
          "amount": 1,
          "recipient": "8bbcb347e0634905b0cac7955bae152b",
          "sender": "0"
        }
      ]
    },
    {
      "index": 3,
      "previous_hash": "eff91a...10f2",
      "proof": 35089,
      "timestamp": 1506280666.1086972,
      "transactions": [
        {
          "amount": 1,
          "recipient": "8bbcb347e0634905b0cac7955bae152b",
          "sender": "0"
        }
      ]
    }
  ],
  "length": 3
}

第 4 步:共识

这是很酷的一个地方。我们已经有了一个基本的区块链,它可以接收交易并允许我们去挖掘出新区块。但是区块链的整个重点在于它是 去中心化的 decentralized 。而如果它们是去中心化的,那我们如何才能确保它们表示在同一个区块链上?这就是 共识 Consensus 问题,如果我们希望在我们的网络上有多于一个的节点运行,那么我们将必须去实现一个共识算法。

注册新节点

在我们能实现一个共识算法之前,我们需要一个办法去让一个节点知道网络上的邻居节点。我们网络上的每个节点都保留有一个该网络上其它节点的注册信息。因此,我们需要更多的端点:

  1. /nodes/register 以 URL 的形式去接受一个新节点列表
  2. /nodes/resolve 去实现我们的共识算法,由它来解决任何的冲突 —— 确保节点有一个正确的链。

我们需要去修改我们的区块链的构造函数,来提供一个注册节点的方法:

...
from urllib.parse import urlparse
...


class Blockchain(object):
    def __init__(self):
        ...
        self.nodes = set()
        ...

    def register_node(self, address):
        """
        Add a new node to the list of nodes
        :param address: <str> Address of node. Eg. 'http://192.168.0.5:5000'
        :return: None
        """

        parsed_url = urlparse(address)
        self.nodes.add(parsed_url.netloc)

一个添加邻居节点到我们的网络的方法

注意,我们将使用一个 set() 去保存节点列表。这是一个非常合算的方式,它将确保添加的节点是 幂等 idempotent 的 —— 这意味着不论你将特定的节点添加多少次,它都是精确地只出现一次。

实现共识算法

正如前面提到的,当一个节点与另一个节点有不同的链时就会产生冲突。为解决冲突,我们制定一个规则,即最长的有效的链才是权威的链。换句话说就是,网络上最长的链就是事实上的区块链。使用这个算法,可以在我们的网络上节点之间达到共识。

...
import requests


class Blockchain(object)
    ...

    def valid_chain(self, chain):
        """
        Determine if a given blockchain is valid
        :param chain: <list> A blockchain
        :return: <bool> True if valid, False if not
        """

        last_block = chain[0]
        current_index = 1

        while current_index < len(chain):
            block = chain[current_index]
            print(f'{last_block}')
            print(f'{block}')
            print("\n-----------\n")
            # Check that the hash of the block is correct
            if block['previous_hash'] != self.hash(last_block):
                return False

            # Check that the Proof of Work is correct
            if not self.valid_proof(last_block['proof'], block['proof']):
                return False

            last_block = block
            current_index += 1

        return True

    def resolve_conflicts(self):
        """
        This is our Consensus Algorithm, it resolves conflicts
        by replacing our chain with the longest one in the network.
        :return: <bool> True if our chain was replaced, False if not
        """

        neighbours = self.nodes
        new_chain = None

        # We're only looking for chains longer than ours
        max_length = len(self.chain)

        # Grab and verify the chains from all the nodes in our network
        for node in neighbours:
            response = requests.get(f'http://{node}/chain')

            if response.status_code == 200:
                length = response.json()['length']
                chain = response.json()['chain']

                # Check if the length is longer and the chain is valid
                if length > max_length and self.valid_chain(chain):
                    max_length = length
                    new_chain = chain

        # Replace our chain if we discovered a new, valid chain longer than ours
        if new_chain:
            self.chain = new_chain
            return True

        return False

第一个方法 valid_chain() 是负责来检查链是否有效,它通过遍历区块链上的每个区块并验证它们的哈希和工作量证明来检查这个区块链是否有效。

resolve_conflicts() 方法用于遍历所有的邻居节点,下载它们的链并使用上面的方法去验证它们是否有效。如果找到有效的链,确定谁是最长的链,然后我们就用最长的链来替换我们的当前的链。

在我们的 API 上来注册两个端点,一个用于添加邻居节点,另一个用于解决冲突:

@app.route('/nodes/register', methods=['POST'])
def register_nodes():
    values = request.get_json()

    nodes = values.get('nodes')
    if nodes is None:
        return "Error: Please supply a valid list of nodes", 400

    for node in nodes:
        blockchain.register_node(node)

    response = {
        'message': 'New nodes have been added',
        'total_nodes': list(blockchain.nodes),
    }
    return jsonify(response), 201


@app.route('/nodes/resolve', methods=['GET'])
def consensus():
    replaced = blockchain.resolve_conflicts()

    if replaced:
        response = {
            'message': 'Our chain was replaced',
            'new_chain': blockchain.chain
        }
    else:
        response = {
            'message': 'Our chain is authoritative',
            'chain': blockchain.chain
        }

    return jsonify(response), 200

这种情况下,如果你愿意,可以使用不同的机器来做,然后在你的网络上启动不同的节点。或者是在同一台机器上使用不同的端口启动另一个进程。我是在我的机器上使用了不同的端口启动了另一个节点,并将它注册到了当前的节点上。因此,我现在有了两个节点:http://localhost:5000 和 http://localhost:5001。
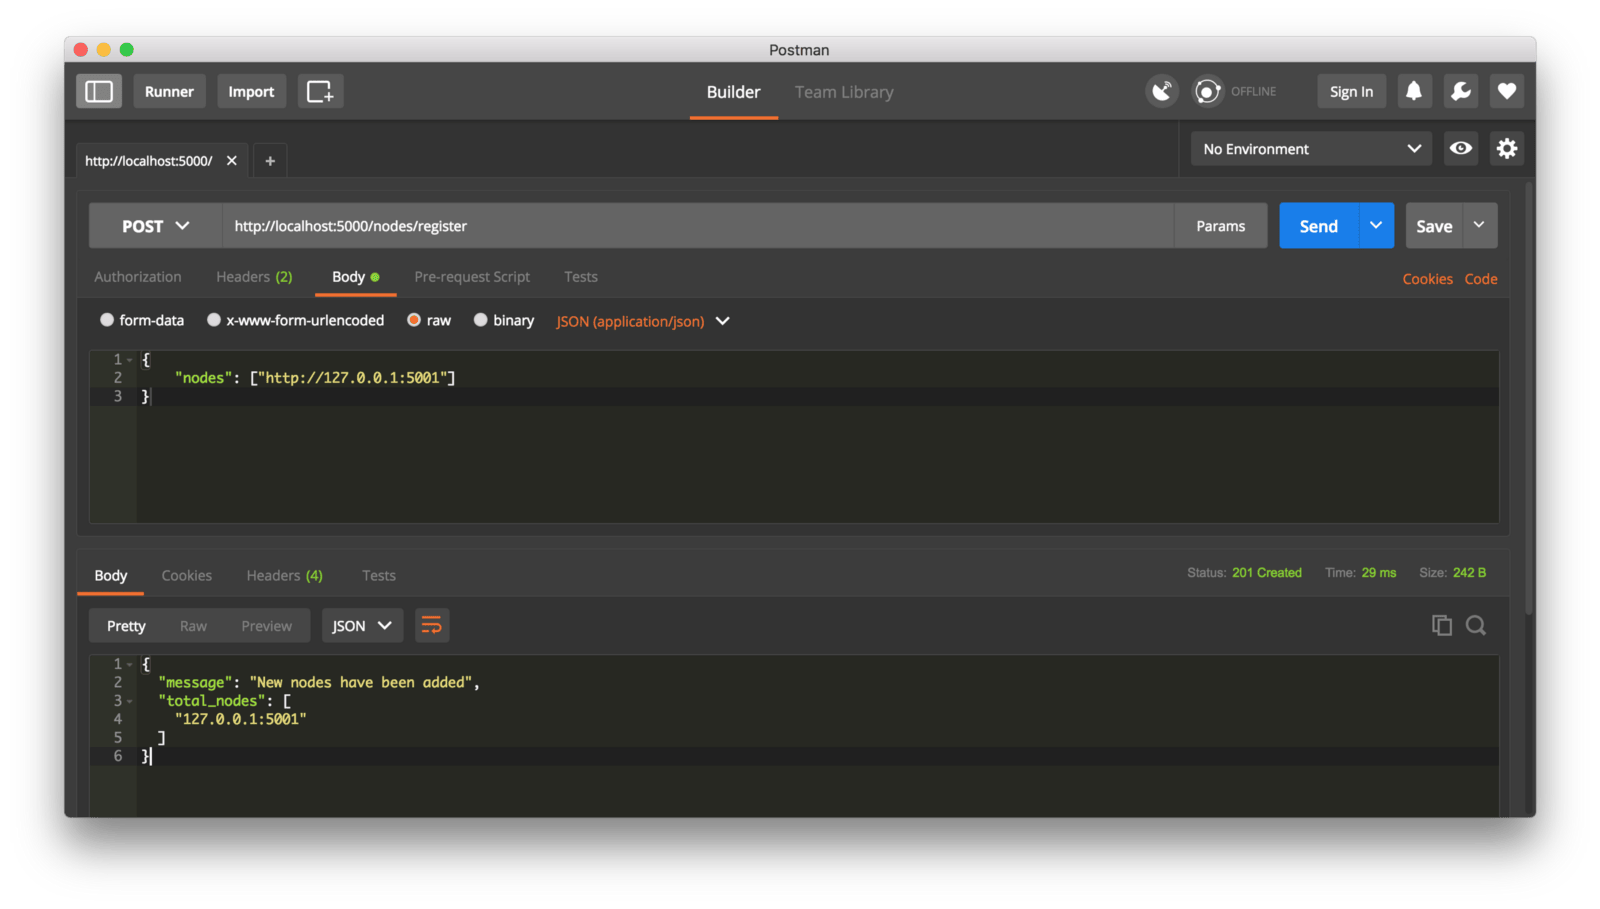
注册一个新节点

我接着在节点 2 上挖出一些新区块,以确保这个链是最长的。之后我在节点 1 上以 GET 方式调用了 /nodes/resolve,这时,节点 1 上的链被共识算法替换成节点 2 上的链了:
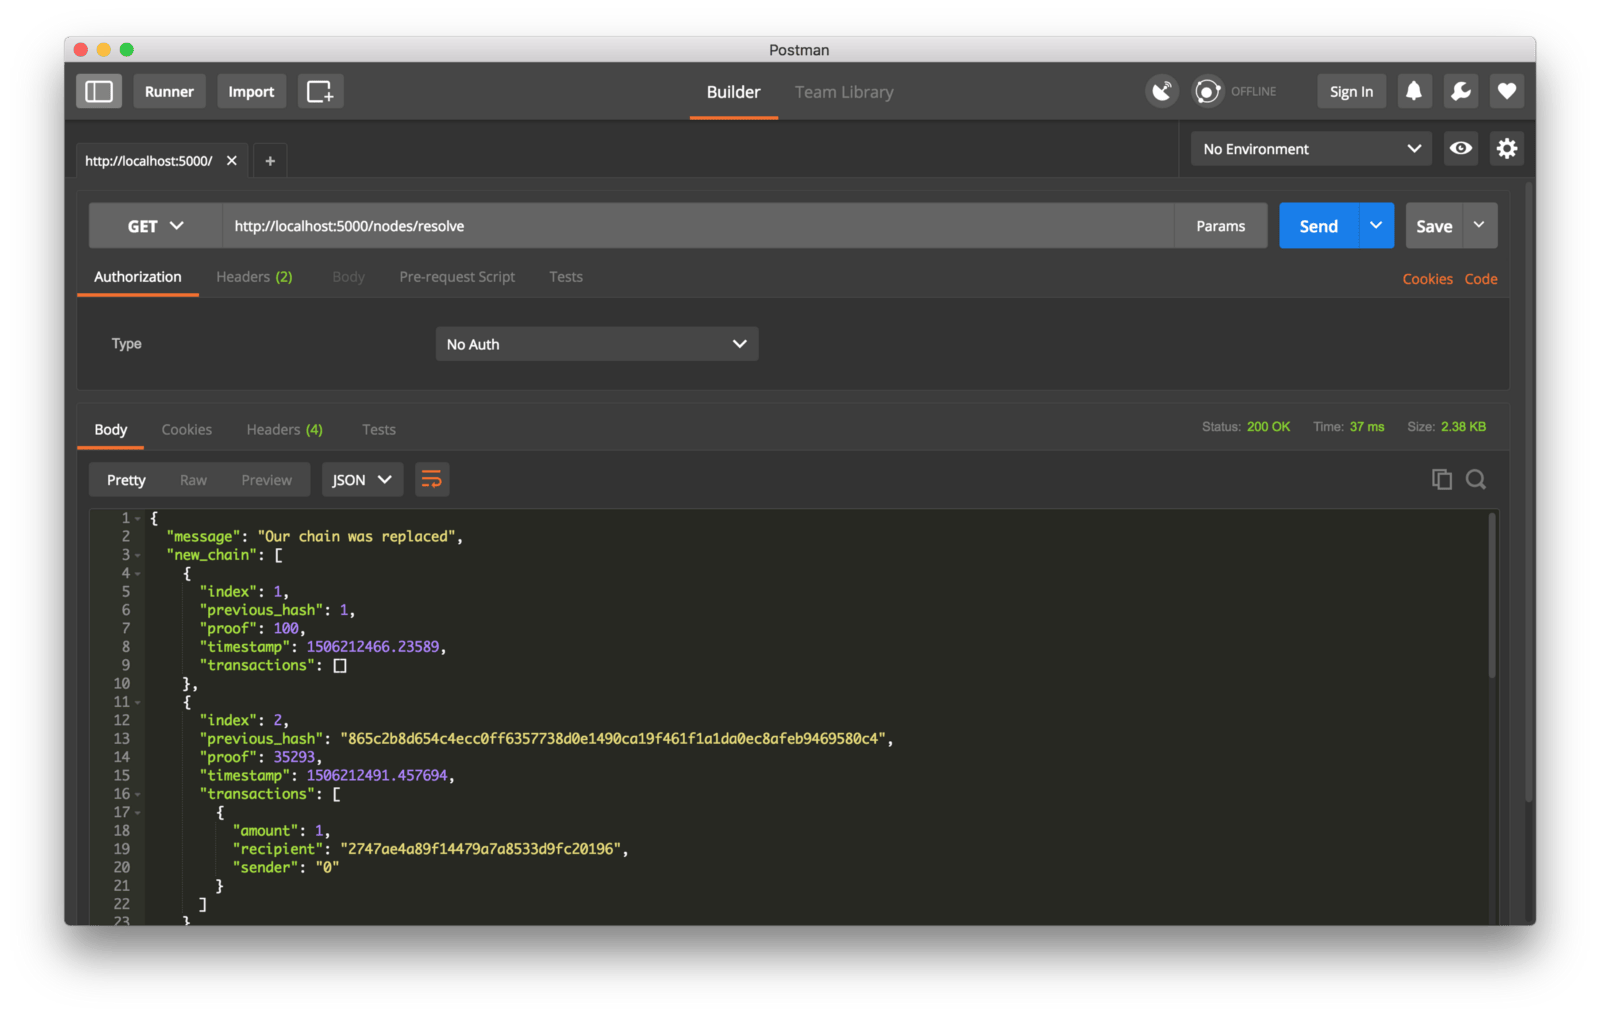
工作中的共识算法

然后将它们封装起来 … 找一些朋友来帮你一起测试你的区块链。


我希望以上内容能够鼓舞你去创建一些新的东西。我是加密货币的狂热拥护者,因此我相信区块链将迅速改变我们对经济、政府和记录保存的看法。

更新: 我正计划继续它的第二部分,其中我将扩展我们的区块链,使它具备交易验证机制,同时讨论一些你可以在其上产生你自己的区块链的方式。(LCTT 译注:第二篇并没有~!)


via: https://hackernoon.com/learn-blockchains-by-building-one-117428612f46

作者:Daniel van Flymen 译者:qhwdw 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出