标签 Web 下的文章

“只有在创造中才能够学到更多。” ——皮亚杰

在本系列的第二部分中,你创造了一个可以处理基本 HTTP GET 请求的、朴素的 WSGI 服务器。当时我问了一个问题:“你该如何让你的服务器在同一时间处理多个请求呢?”在这篇文章中,你会找到答案。系好安全带,我们要认真起来,全速前进了!你将会体验到一段非常快速的旅程。准备好你的 Linux、Mac OS X(或者其他 *nix 系统),还有你的 Python。本文中所有源代码均可在 GitHub 上找到。
服务器的基本结构及如何处理请求

首先,我们来回顾一下 Web 服务器的基本结构,以及服务器处理来自客户端的请求时,所需的必要步骤。你在第一部分及第二部分中创建的轮询服务器只能够一次处理一个请求。在处理完当前请求之前,它不能够接受新的客户端连接。所有请求为了等待服务都需要排队,在服务繁忙时,这个队伍可能会排的很长,一些客户端可能会感到不开心。
这是轮询服务器 webserver3a.py 的代码:

#####################################################################
# 轮询服务器 - webserver3a.py                                       #
#                                                                   #
# 使用 Python 2.7.9 或 3.4                                          #
# 在 Ubuntu 14.04 及 Mac OS X 环境下测试通过                        #
#####################################################################
import socket

SERVER_ADDRESS = (HOST, PORT) = '', 8888
REQUEST_QUEUE_SIZE = 5


def handle_request(client_connection):
    request = client_connection.recv(1024)
    print(request.decode())
    http_response = b"""\
HTTP/1.1 200 OK

Hello, World!
"""
    client_connection.sendall(http_response)


def serve_forever():
    listen_socket = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
    listen_socket.setsockopt(socket.SOL_SOCKET, socket.SO_REUSEADDR, 1)
    listen_socket.bind(SERVER_ADDRESS)
    listen_socket.listen(REQUEST_QUEUE_SIZE)
    print('Serving HTTP on port {port} ...'.format(port=PORT))

    while True:
        client_connection, client_address = listen_socket.accept()
        handle_request(client_connection)
        client_connection.close()

if __name__ == '__main__':
    serve_forever()

为了观察到你的服务器在同一时间只能处理一个请求的行为,我们对服务器的代码做一点点修改:在将响应发送至客户端之后,将程序阻塞 60 秒。这个修改只需要一行代码,来告诉服务器进程暂停 60 秒钟。
这是我们更改后的代码,包含暂停语句的服务器 webserver3b.py:

######################################################################
# 轮询服务器 - webserver3b.py                                         #
#                                                                    #
# 使用 Python 2.7.9 或 3.4                                            #
# 在 Ubuntu 14.04 及 Mac OS X 环境下测试通过                           #
#                                                                    #
# - 服务器向客户端发送响应之后,会阻塞 60 秒                             #
######################################################################
import socket
import time

SERVER_ADDRESS = (HOST, PORT) = '', 8888
REQUEST_QUEUE_SIZE = 5


def handle_request(client_connection):
    request = client_connection.recv(1024)
    print(request.decode())
    http_response = b"""\
HTTP/1.1 200 OK

Hello, World!
"""
    client_connection.sendall(http_response)
    time.sleep(60)  ### 睡眠语句,阻塞该进程 60 秒


def serve_forever():
    listen_socket = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
    listen_socket.setsockopt(socket.SOL_SOCKET, socket.SO_REUSEADDR, 1)
    listen_socket.bind(SERVER_ADDRESS)
    listen_socket.listen(REQUEST_QUEUE_SIZE)
    print('Serving HTTP on port {port} ...'.format(port=PORT))

    while True:
        client_connection, client_address = listen_socket.accept()
        handle_request(client_connection)
        client_connection.close()

if __name__ == '__main__':
    serve_forever()

用以下命令启动服务器:

$ python webserver3b.py

现在,打开一个新的命令行窗口,然后运行 curl 语句。你应该可以立刻看到屏幕上显示的字符串“Hello, World!”:

$ curl http://localhost:8888/hello
Hello, World!

然后,立刻打开第二个命令行窗口,运行相同的 curl 命令:

$ curl http://localhost:8888/hello

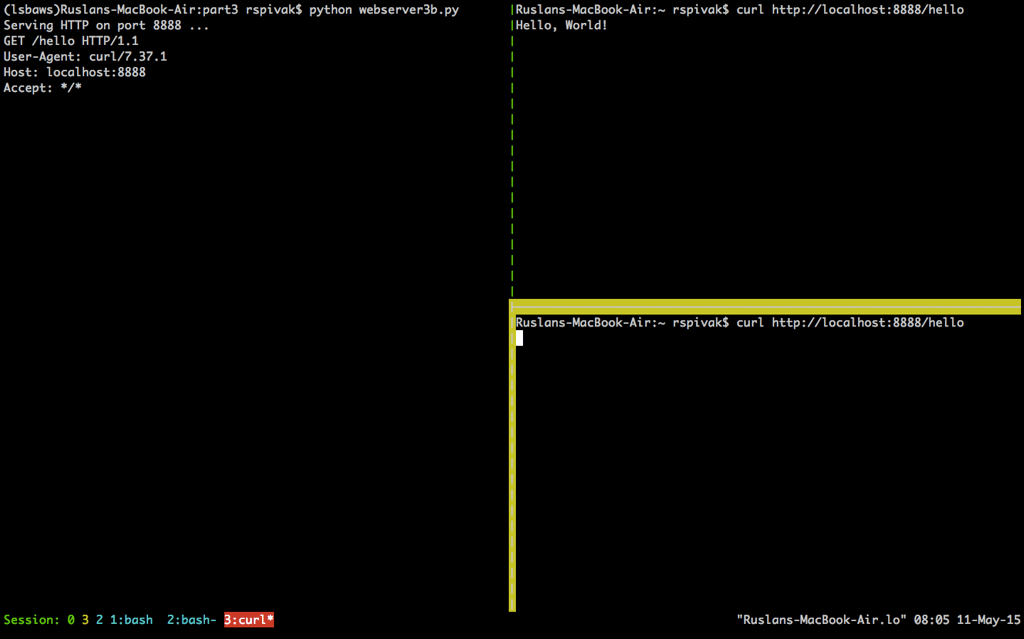
如果你在 60 秒之内完成了以上步骤,你会看到第二条 curl 指令不会立刻产生任何输出,而只是挂在了哪里。同样,服务器也不会在标准输出流中输出新的请求内容。这是这个过程在我的 Mac 电脑上的运行结果(在右下角用黄色框标注出来的窗口中,我们能看到第二个 curl 指令被挂起,正在等待连接被服务器接受):
当你等待足够长的时间(60 秒以上)后,你会看到第一个 curl 程序完成,而第二个 curl 在屏幕上输出了“Hello, World!”,然后休眠 60 秒,进而终止。
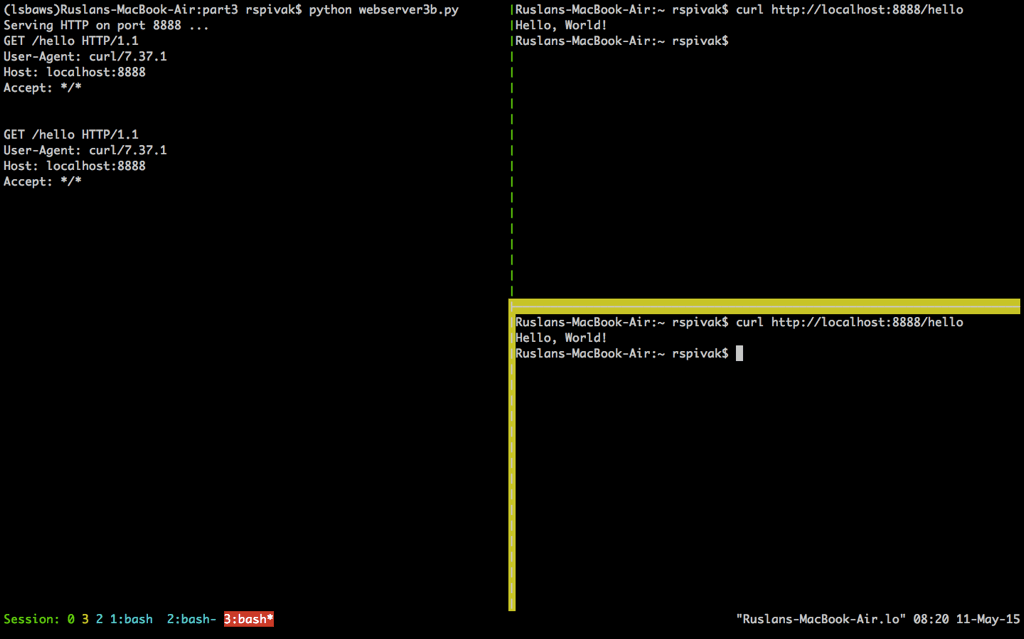
这样运行的原因是因为在服务器在处理完第一个来自 curl 的请求之后,只有等待 60 秒才能开始处理第二个请求。这个处理请求的过程按顺序进行(也可以说,迭代进行),一步一步进行,在我们刚刚给出的例子中,在同一时间内只能处理一个请求。

现在,我们来简单讨论一下客户端与服务器的交流过程。为了让两个程序在网络中互相交流,它们必须使用套接字。你应当在本系列的前两部分中见过它几次了。但是,套接字是什么?
套接字 ( socket ) 是一个通讯通道 端点 ( endpoint ) 的抽象描述,它可以让你的程序通过文件描述符来与其它程序进行交流。在这篇文章中,我只会单独讨论 Linux 或 Mac OS X 中的 TCP/IP 套接字。这里有一个重点概念需要你去理解:TCP 套接字对 ( socket pair ) 。

TCP 连接使用的套接字对是一个由 4 个元素组成的元组,它确定了 TCP 连接的两端:本地 IP 地址、本地端口、远端 IP 地址及远端端口。一个套接字对唯一地确定了网络中的每一个 TCP 连接。在连接一端的两个值:一个 IP 地址和一个端口,通常被称作一个套接字。(引自《UNIX 网络编程 卷1:套接字联网 API (第3版)》)
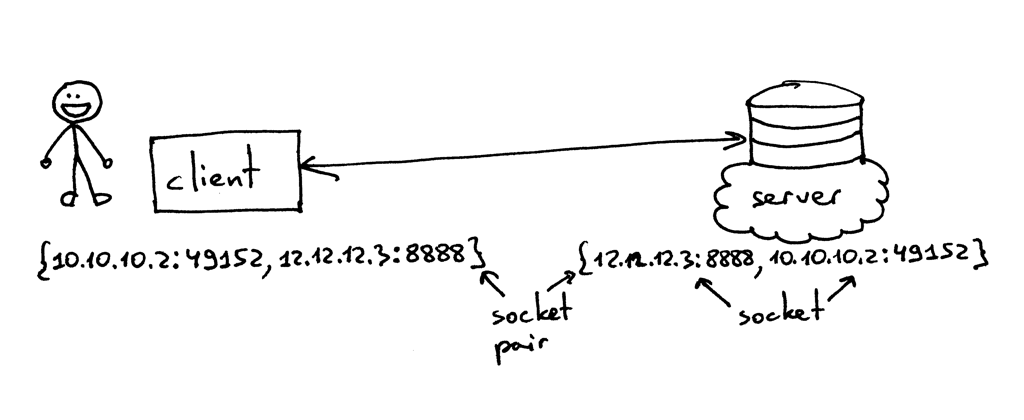
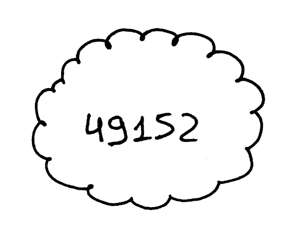
所以,元组 {10.10.10.2:49152, 12.12.12.3:8888} 就是一个能够在客户端确定 TCP 连接两端的套接字对,而元组 {12.12.12.3:8888, 10.10.10.2:49152} 则是在服务端确定 TCP 连接两端的套接字对。在这个例子中,确定 TCP 服务端的两个值(IP 地址 12.12.12.3 及端口 8888),代表一个套接字;另外两个值则代表客户端的套接字。

一个服务器创建一个套接字并开始建立连接的基本工作流程如下:
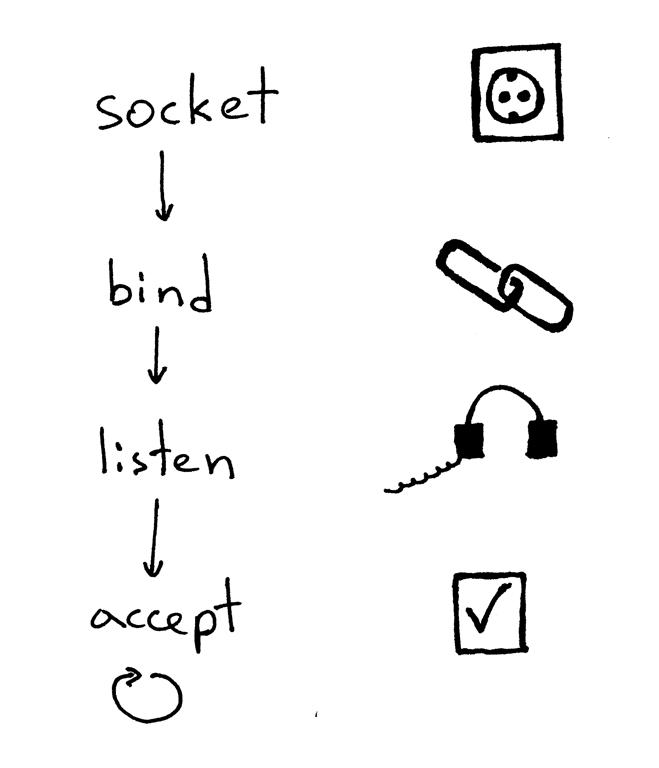
  1. 服务器创建一个 TCP/IP 套接字。我们可以用这条 Python 语句来创建:
listen_socket = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
  1. 服务器可能会设定一些套接字选项(这个步骤是可选的,但是你可以看到上面的服务器代码做了设定,这样才能够在重启服务器时多次复用同一地址):
listen_socket.setsockopt(socket.SOL_SOCKET, socket.SO_REUSEADDR, 1)
  1. 然后,服务器绑定一个地址。绑定函数 bind 可以将一个本地协议地址赋给套接字。若使用 TCP 协议,调用绑定函数 bind 时,需要指定一个端口号,一个 IP 地址,或两者兼有,或两者全无。(引自《UNIX网络编程 卷1:套接字联网 API (第3版)》)
listen_socket.bind(SERVER_ADDRESS)
  1. 然后,服务器开启套接字的监听模式。
listen_socket.listen(REQUEST_QUEUE_SIZE)

监听函数 listen 只应在服务端调用。它会通知操作系统内核,表明它会接受所有向该套接字发送的入站连接请求。

以上四步完成后,服务器将循环接收来自客户端的连接,一次循环处理一条。当有连接可用时,接受请求函数 accept 将会返回一个已连接的客户端套接字。然后,服务器从这个已连接的客户端套接字中读取请求数据,将数据在其标准输出流中输出出来,并向客户端回送一条消息。然后,服务器会关闭这个客户端连接,并准备接收一个新的客户端连接。

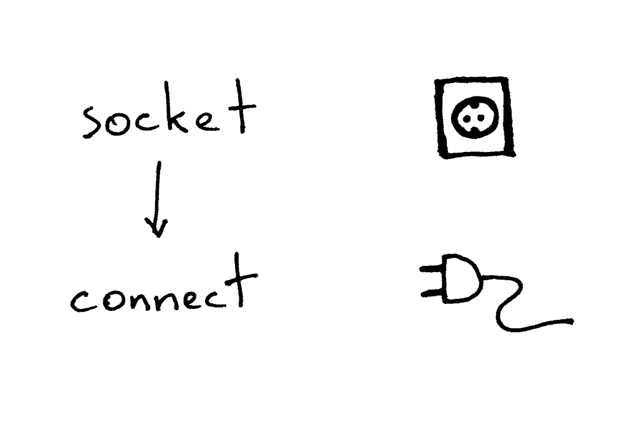
这是客户端使用 TCP/IP 协议与服务器通信的必要步骤:
下面是一段示例代码,使用这段代码,客户端可以连接你的服务器,发送一个请求,并输出响应内容:

import socket

### 创建一个套接字,并连接值服务器
sock = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
sock.connect(('localhost', 8888))

### 发送一段数据,并接收响应数据
sock.sendall(b'test')
data = sock.recv(1024)
print(data.decode())

在创建套接字后,客户端需要连接至服务器。我们可以调用连接函数 connect 来完成这个操作:

sock.connect(('localhost', 8888))

客户端只需提供待连接的远程服务器的 IP 地址(或主机名),及端口号,即可连接至远端服务器。

你可能已经注意到了,客户端不需要调用 bind 及 accept 函数,就可以与服务器建立连接。客户端不需要调用 bind 函数是因为客户端不需要关注本地 IP 地址及端口号。操作系统内核中的 TCP/IP 协议栈会在客户端调用 connect 函数时,自动为套接字分配本地 IP 地址及本地端口号。这个本地端口被称为 临时端口 ( ephemeral port ) ,即一个短暂开放的端口。

服务器中有一些端口被用于承载一些众所周知的服务,它们被称作 通用 ( well-known ) 端口:如 80 端口用于 HTTP 服务,22 端口用于 SSH 服务。打开你的 Python shell,与你在本地运行的服务器建立一个连接,来看看内核给你的客户端套接字分配了哪个临时端口(在尝试这个例子之前,你需要运行服务器程序 webserver3a.py 或 webserver3b.py):

>>> import socket
>>> sock = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
>>> sock.connect(('localhost', 8888))
>>> host, port = sock.getsockname()[:2]
>>> host, port
('127.0.0.1', 60589)

在上面的例子中,内核将临时端口 60589 分配给了你的套接字。

在我开始回答我在第二部分中提出的问题之前,我还需要快速讲解一些概念。你很快就会明白这些概念为什么非常重要。这两个概念,一个是进程,另外一个是文件描述符。

什么是进程?进程就是一个程序执行的实体。举个例子:当你的服务器代码被执行时,它会被载入内存,而内存中表现此次程序运行的实体就叫做进程。内核记录了进程的一系列有关信息——比如进程 ID——来追踪它的运行情况。当你在执行轮询服务器 webserver3a.py 或 webserver3b.py 时,你其实只是启动了一个进程。
我们在终端窗口中运行 webserver3b.py:

$ python webserver3b.py

在另一个终端窗口中,我们可以使用 ps 命令获取该进程的相关信息:

$ ps | grep webserver3b | grep -v grep
7182 ttys003    0:00.04 python webserver3b.py

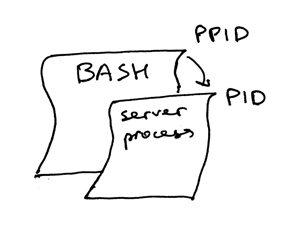
ps 命令显示,我们刚刚只运行了一个 Python 进程 webserver3b.py。当一个进程被创建时,内核会为其分配一个进程 ID,也就是 PID。在 UNIX 中,所有用户进程都有一个父进程;当然,这个父进程也有进程 ID,叫做父进程 ID,缩写为 PPID。假设你默认使用 BASH shell,那当你启动服务器时,就会启动一个新的进程,同时被赋予一个 PID,而它的父进程 PID 会被设为 BASH shell 的 PID。
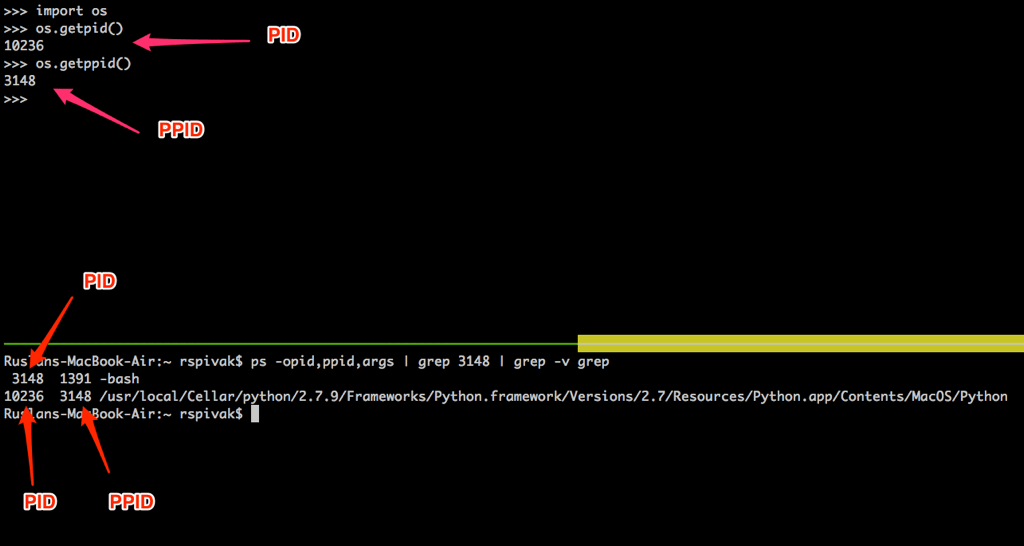
自己尝试一下,看看这一切都是如何工作的。重新开启你的 Python shell,它会创建一个新进程,然后在其中使用系统调用 os.getpid() 及 os.getppid() 来获取 Python shell 进程的 PID 及其父进程 PID(也就是你的 BASH shell 的 PID)。然后,在另一个终端窗口中运行 ps 命令,然后用 grep 来查找 PPID(父进程 ID,在我的例子中是 3148)。在下面的屏幕截图中,你可以看到一个我的 Mac OS X 系统中关于进程父子关系的例子,在这个例子中,子进程是我的 Python shell 进程,而父进程是 BASH shell 进程:
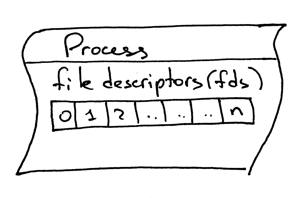
另外一个需要了解的概念,就是文件描述符。什么是文件描述符?文件描述符是一个非负整数,当进程打开一个现有文件、创建新文件或创建一个新的套接字时,内核会将这个数返回给进程。你以前可能听说过,在 UNIX 中,一切皆是文件。内核会按文件描述符来找到一个进程所打开的文件。当你需要读取文件或向文件写入时,我们同样通过文件描述符来定位这个文件。Python 提供了高层次的操作文件(或套接字)的对象,所以你不需要直接通过文件描述符来定位文件。但是,在高层对象之下,我们就是用它来在 UNIX 中定位文件及套接字,通过这个整数的文件描述符。
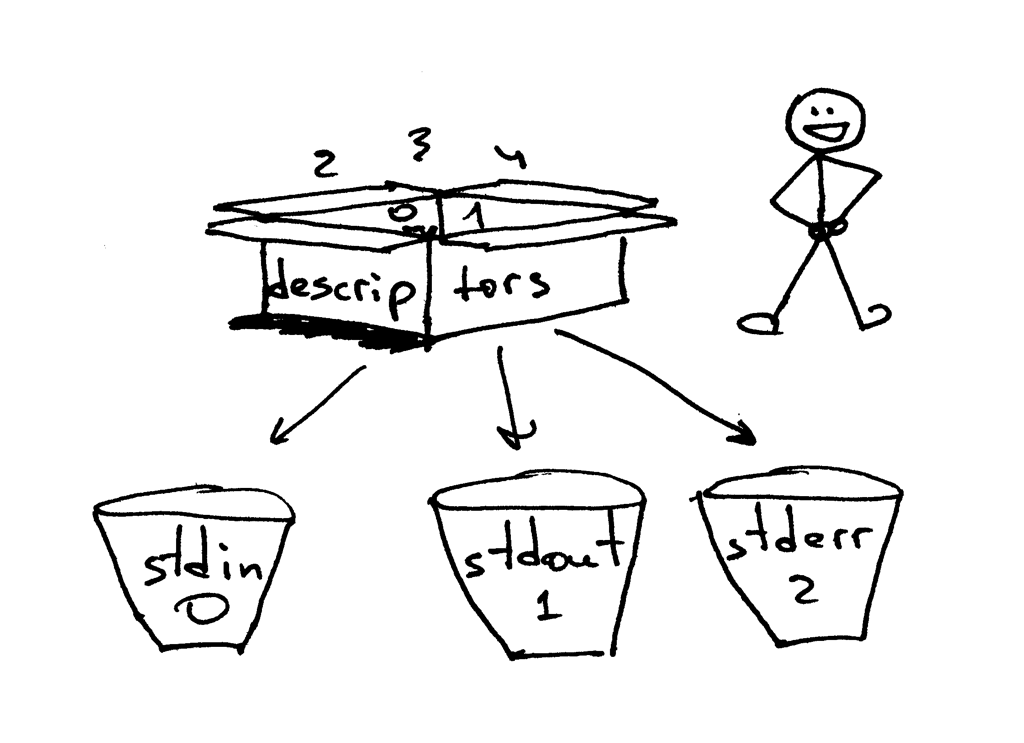
一般情况下,UNIX shell 会将一个进程的标准输入流(STDIN)的文件描述符设为 0,标准输出流(STDOUT)设为 1,而标准错误打印(STDERR)的文件描述符会被设为 2。
我之前提到过,即使 Python 提供了高层次的文件对象或类文件对象来供你操作,你仍然可以在对象上使用 fileno() 方法,来获取与该文件相关联的文件描述符。回到 Python shell 中,我们来看看你该怎么做到这一点:

>>> import sys
>>> sys.stdin
<open file '<stdin>', mode 'r' at 0x102beb0c0>
>>> sys.stdin.fileno()
0
>>> sys.stdout.fileno()
1
>>> sys.stderr.fileno()
2

当你在 Python 中操作文件及套接字时,你可能会使用高层次的文件/套接字对象,但是你仍然有可能会直接使用文件描述符。下面有一个例子,来演示如何用文件描述符做参数来进行一次写入的系统调用:

>>> import sys
>>> import os
>>> res = os.write(sys.stdout.fileno(), 'hello\n')
hello

下面是比较有趣的部分——不过你可能不会为此感到惊讶,因为你已经知道在 Unix 中,一切皆为文件——你的套接字对象同样有一个相关联的文件描述符。和刚才操纵文件时一样,当你在 Python 中创建一个套接字时,你会得到一个对象而不是一个非负整数,但你永远可以用我之前提到过的 fileno() 方法获取套接字对象的文件描述符,并可以通过这个文件描述符来直接操纵套接字。

>>> import socket
>>> sock = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
>>> sock.fileno()
3

我还想再提一件事:不知道你有没有注意到,在我们的第二个轮询服务器 webserver3b.py 中,当你的服务器休眠 60 秒的过程中,你仍然可以通过第二个 curl 命令连接至服务器。当然 curl 命令并没有立刻输出任何内容而是挂在哪里,但是既然服务器没有接受连接,那它为什么不立即拒绝掉连接,而让它还能够继续与服务器建立连接呢?这个问题的答案是:当我在调用套接字对象的 listen 方法时,我为该方法提供了一个 BACKLOG 参数,在代码中用 REQUEST_QUEUE_SIZE 常量来表示。BACKLOG 参数决定了在内核中为存放即将到来的连接请求所创建的队列的大小。当服务器 webserver3b.py 在睡眠的时候,你运行的第二个 curl 命令依然能够连接至服务器,因为内核中用来存放即将接收的连接请求的队列依然拥有足够大的可用空间。

尽管增大 BACKLOG 参数并不能神奇地使你的服务器同时处理多个请求,但当你的服务器很繁忙时,将它设置为一个较大的值还是相当重要的。这样,在你的服务器调用 accept 方法时,不需要再等待一个新的连接建立,而可以立刻直接抓取队列中的第一个客户端连接,并不加停顿地立刻处理它。

欧耶!现在你已经了解了一大块内容。我们来快速回顾一下我们刚刚讲解的知识(当然,如果这些对你来说都是基础知识的话,那我们就当复习好啦)。
  • 轮询服务器
  • 服务端套接字创建流程(创建套接字,绑定,监听及接受)
  • 客户端连接创建流程(创建套接字,连接)
  • 套接字对
  • 套接字
  • 临时端口及通用端口
  • 进程
  • 进程 ID(PID),父进程 ID(PPID),以及进程父子关系
  • 文件描述符
  • 套接字的 listen 方法中,BACKLOG 参数的含义

如何并发处理多个请求

现在,我可以开始回答第二部分中的那个问题了:“你该如何让你的服务器在同一时间处理多个请求呢?”或者换一种说法:“如何编写一个并发服务器?”
在 UNIX 系统中编写一个并发服务器最简单的方法,就是使用系统调用 fork()。
下面是全新出炉的并发服务器 webserver3c.py 的代码,它可以同时处理多个请求(和我们之前的例子 webserver3b.py 一样,每个子进程都会休眠 60 秒):

#######################################################
# 并发服务器 - webserver3c.py                          #
#                                                     #
# 使用 Python 2.7.9 或 3.4                             #
# 在 Ubuntu 14.04 及 Mac OS X 环境下测试通过            #
#                                                     #
# - 完成客户端请求处理之后,子进程会休眠 60 秒             #
# - 父子进程会关闭重复的描述符                           #
#                                                     #
#######################################################
import os
import socket
import time

SERVER_ADDRESS = (HOST, PORT) = '', 8888
REQUEST_QUEUE_SIZE = 5


def handle_request(client_connection):
    request = client_connection.recv(1024)
    print(
        'Child PID: {pid}. Parent PID {ppid}'.format(
            pid=os.getpid(),
            ppid=os.getppid(),
        )
    )
    print(request.decode())
    http_response = b"""\
HTTP/1.1 200 OK

Hello, World!
"""
    client_connection.sendall(http_response)
    time.sleep(60)


def serve_forever():
    listen_socket = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
    listen_socket.setsockopt(socket.SOL_SOCKET, socket.SO_REUSEADDR, 1)
    listen_socket.bind(SERVER_ADDRESS)
    listen_socket.listen(REQUEST_QUEUE_SIZE)
    print('Serving HTTP on port {port} ...'.format(port=PORT))
    print('Parent PID (PPID): {pid}\n'.format(pid=os.getpid()))

    while True:
        client_connection, client_address = listen_socket.accept()
        pid = os.fork()
        if pid == 0:  ### 子进程
            listen_socket.close()  ### 关闭子进程中复制的套接字对象
            handle_request(client_connection)
            client_connection.close()
            os._exit(0)  ### 子进程在这里退出
        else:  ### 父进程
            client_connection.close()  ### 关闭父进程中的客户端连接对象,并循环执行

if __name__ == '__main__':
    serve_forever()

在深入研究代码、讨论 fork 如何工作之前,先尝试运行它,自己看一看这个服务器是否真的可以同时处理多个客户端请求,而不是像轮询服务器 webserver3a.py 和 webserver3b.py 一样。在命令行中使用如下命令启动服务器:

$ python webserver3c.py

然后,像我们之前测试轮询服务器那样,运行两个 curl 命令,来看看这次的效果。现在你可以看到,即使子进程在处理客户端请求后会休眠 60 秒,但它并不会影响其它客户端连接,因为他们都是由完全独立的进程来处理的。你应该看到你的 curl 命令立即输出了“Hello, World!”然后挂起 60 秒。你可以按照你的想法运行尽可能多的 curl 命令(好吧,并不能运行特别特别多 ^_^),所有的命令都会立刻输出来自服务器的响应 “Hello, World!”,并不会出现任何可被察觉到的延迟行为。试试看吧。

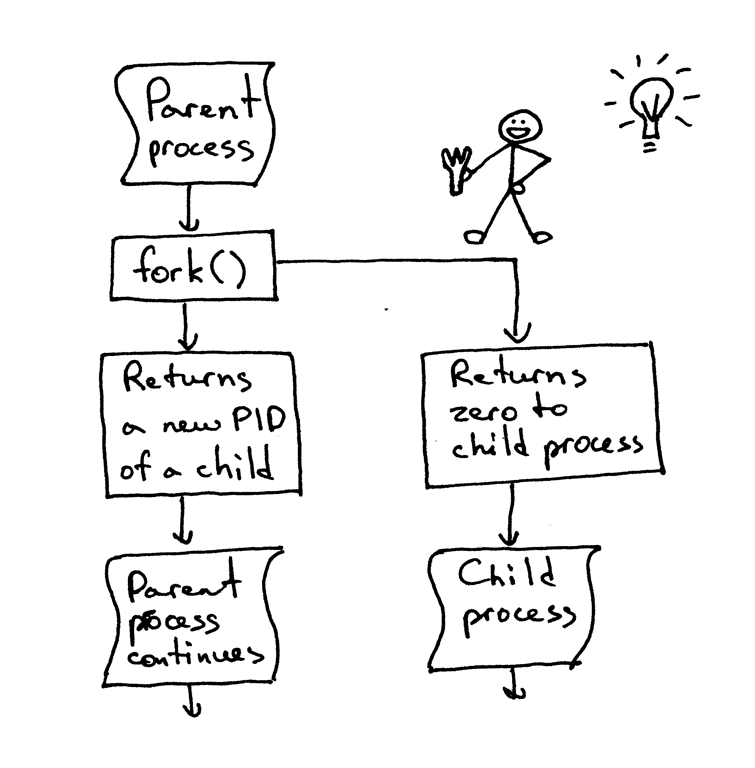
如果你要理解 fork(),那最重要的一点是:你调用了它一次,但是它会返回两次 —— 一次在父进程中,另一次是在子进程中。当你创建了一个新进程,那么 fork() 在子进程中的返回值是 0。如果是在父进程中,那 fork() 函数会返回子进程的 PID。
我依然记得在第一次看到它并尝试使用 fork() 的时候,我是多么的入迷。它在我眼里就像是魔法一样。这就好像我在读一段顺序执行的代码,然后“砰!”地一声,代码变成了两份,然后出现了两个实体,同时并行地运行相同的代码。讲真,那个时候我觉得它真的跟魔法一样神奇。

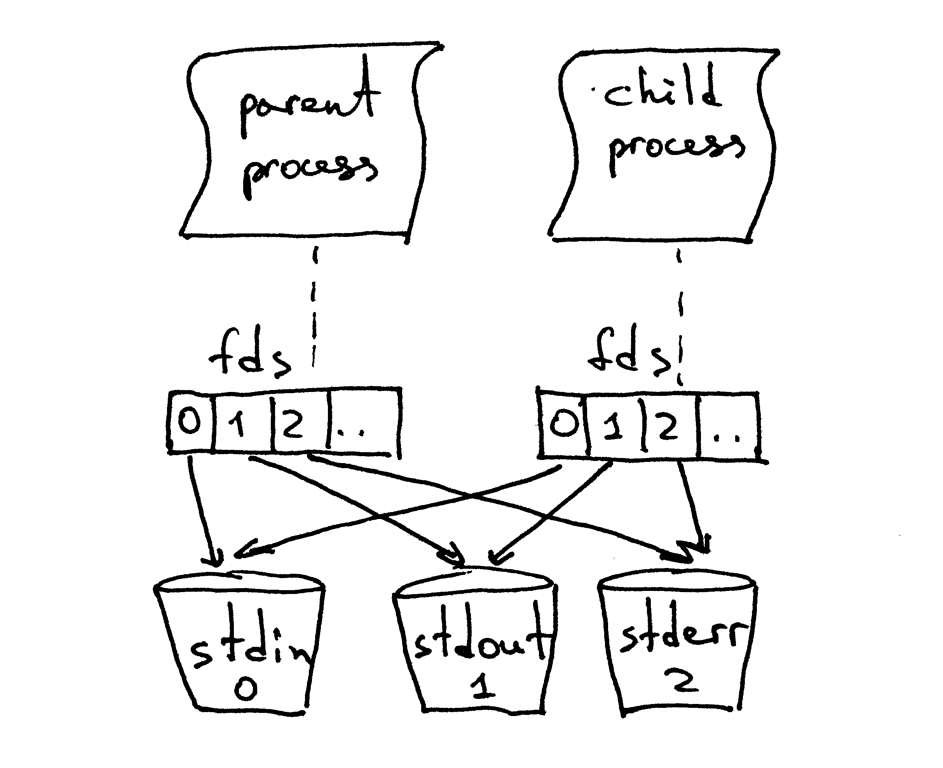
当父进程创建出一个新的子进程时,子进程会复制从父进程中复制一份文件描述符:
你可能注意到,在上面的代码中,父进程关闭了客户端连接:

else:  ### 父进程
    client_connection.close()  # 关闭父进程的副本并循环

不过,既然父进程关闭了这个套接字,那为什么子进程仍然能够从来自客户端的套接字中读取数据呢?答案就在上面的图片中。内核会使用描述符引用计数器来决定是否要关闭一个套接字。当你的服务器创建一个子进程时,子进程会复制父进程的所有文件描述符,内核中该描述符的引用计数也会增加。如果只有一个父进程及一个子进程,那客户端套接字的文件描述符引用数应为 2;当父进程关闭客户端连接的套接字时,内核只会减少它的引用计数,将其变为 1,但这仍然不会使内核关闭该套接字。子进程也关闭了父进程中 listen_socket 的复制实体,因为子进程不需要关注新的客户端连接,而只需要处理已建立的客户端连接中的请求。

listen_socket.close()  ### 关闭子进程中的复制实体

我们将会在后文中讨论,如果你不关闭那些重复的描述符,会发生什么。

你可以从你的并发服务器源码中看到,父进程的主要职责为:接受一个新的客户端连接,复制出一个子进程来处理这个连接,然后继续循环来接受另外的客户端连接,仅此而已。服务器父进程并不会处理客户端连接——子进程才会做这件事。

打个岔:当我们说两个事件并发执行时,我们所要表达的意思是什么?
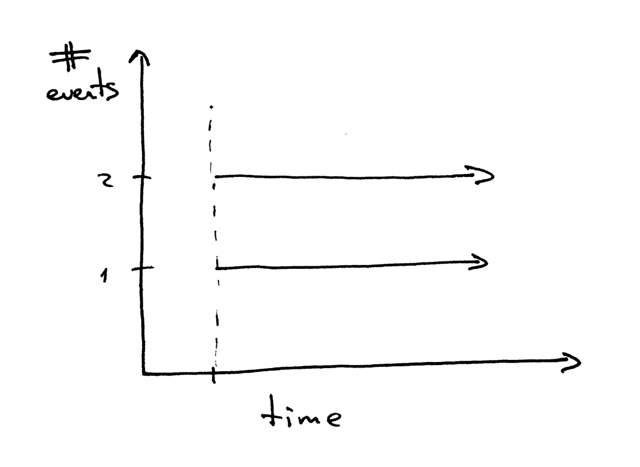
当我们说“两个事件并发执行”时,它通常意味着这两个事件同时发生。简单来讲,这个定义没问题,但你应该记住它的严格定义:

如果你不能在代码中判断两个事件的发生顺序,那这两个事件就是并发执行的。(引自《信号系统简明手册 (第二版): 并发控制深入浅出及常见错误》)

好的,现在你又该回顾一下你刚刚学过的知识点了。

  • 在 Unix 中,编写一个并发服务器的最简单的方式——使用 fork() 系统调用;
  • 当一个进程分叉(fork)出另一个进程时,它会变成刚刚分叉出的进程的父进程;
  • 在进行 fork 调用后,父进程和子进程共享相同的文件描述符;
  • 系统内核通过描述符的引用计数来决定是否要关闭该描述符对应的文件或套接字;
  • 服务器父进程的主要职责:现在它做的只是从客户端接受一个新的连接,分叉出子进程来处理这个客户端连接,然后开始下一轮循环,去接收新的客户端连接。

进程分叉后不关闭重复的套接字会发生什么?

我们来看看,如果我们不在父进程与子进程中关闭重复的套接字描述符会发生什么。下面是刚才的并发服务器代码的修改版本,这段代码(webserver3d.py 中,服务器不会关闭重复的描述符):

#######################################################
# 并发服务器 - webserver3d.py                          #
#                                                     #
# 使用 Python 2.7.9 或 3.4                             #
# 在 Ubuntu 14.04 及 Mac OS X 环境下测试通过            #
#######################################################
import os
import socket

SERVER_ADDRESS = (HOST, PORT) = '', 8888
REQUEST_QUEUE_SIZE = 5


def handle_request(client_connection):
    request = client_connection.recv(1024)
    http_response = b"""\
HTTP/1.1 200 OK

Hello, World!
"""
    client_connection.sendall(http_response)


def serve_forever():
    listen_socket = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
    listen_socket.setsockopt(socket.SOL_SOCKET, socket.SO_REUSEADDR, 1)
    listen_socket.bind(SERVER_ADDRESS)
    listen_socket.listen(REQUEST_QUEUE_SIZE)
    print('Serving HTTP on port {port} ...'.format(port=PORT))

    clients = []
    while True:
        client_connection, client_address = listen_socket.accept()
        ### 将引用存储起来,否则在下一轮循环时,他们会被垃圾回收机制销毁
        clients.append(client_connection)
        pid = os.fork()
        if pid == 0:  ### 子进程
            listen_socket.close()  ### 关闭子进程中多余的套接字
            handle_request(client_connection)
            client_connection.close()
            os._exit(0)  ### 子进程在这里结束
        else:  ### 父进程
            # client_connection.close()
            print(len(clients))

if __name__ == '__main__':
    serve_forever()

用以下命令来启动服务器:

$ python webserver3d.py

用 curl 命令连接服务器:

$ curl http://localhost:8888/hello
Hello, World!

好,curl 命令输出了来自并发服务器的响应内容,但程序并没有退出,而是仍然挂起。到底发生了什么?这个服务器并不会挂起 60 秒:子进程只处理客户端连接,关闭连接然后退出,但客户端的 curl 命令并没有终止。
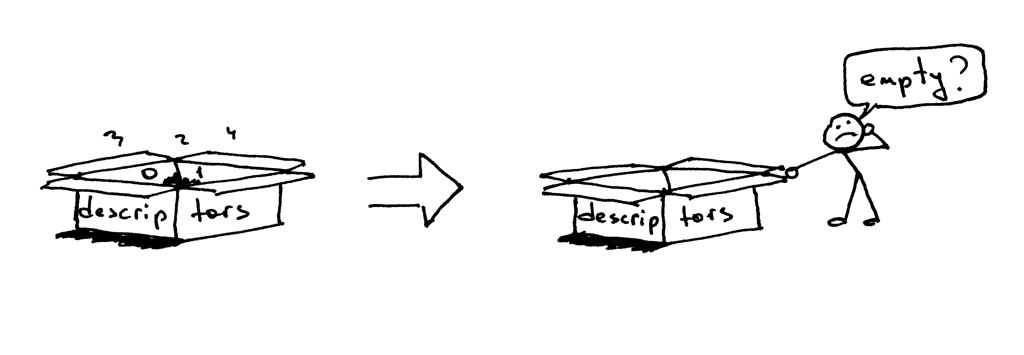
所以,为什么 curl 不终止呢?原因就在于文件描述符的副本。当子进程关闭客户端连接时,系统内核会减少客户端套接字的引用计数,将其变为 1。服务器子进程退出了,但客户端套接字并没有被内核关闭,因为该套接字的描述符引用计数并没有变为 0,所以,这就导致了连接终止包(在 TCP/IP 协议中称作 FIN)不会被发送到客户端,所以客户端会一直保持连接。这里也会出现另一个问题:如果你的服务器长时间运行,并且不关闭文件描述符的副本,那么可用的文件描述符会被消耗殆尽:
使用 Control-C 关闭服务器 webserver3d.py,然后在 shell 中使用内置命令 ulimit 来查看系统默认为你的服务器进程分配的可用资源数:

$ ulimit -a
core file size          (blocks, -c) 0
data seg size           (kbytes, -d) unlimited
scheduling priority             (-e) 0
file size               (blocks, -f) unlimited
pending signals                 (-i) 3842
max locked memory       (kbytes, -l) 64
max memory size         (kbytes, -m) unlimited
open files                      (-n) 1024
pipe size            (512 bytes, -p) 8
POSIX message queues     (bytes, -q) 819200
real-time priority              (-r) 0
stack size              (kbytes, -s) 8192
cpu time               (seconds, -t) unlimited
max user processes              (-u) 3842
virtual memory          (kbytes, -v) unlimited
file locks                      (-x) unlimited

你可以从上面的结果看到,在我的 Ubuntu 机器中,系统为我的服务器进程分配的最大可用文件描述符(文件打开)数为 1024。

现在我们来看一看,如果你的服务器不关闭重复的描述符,它会如何消耗可用的文件描述符。在一个已有的或新建的终端窗口中,将你的服务器进程的最大可用文件描述符设为 256:

$ ulimit -n 256

在你刚刚运行 ulimit -n 256 的终端窗口中运行服务器 webserver3d.py:

$ python webserver3d.py

然后使用下面的客户端 client3.py 来测试你的服务器。

#######################################################
# 测试客户端 - client3.py                              #
#                                                     #
# 使用 Python 2.7.9 或 3.4                             #
# 在 Ubuntu 14.04 及 Mac OS X 环境下测试通过            #
#######################################################
import argparse
import errno
import os
import socket


SERVER_ADDRESS = 'localhost', 8888
REQUEST = b"""\
GET /hello HTTP/1.1
Host: localhost:8888

"""


def main(max_clients, max_conns):
    socks = []
    for client_num in range(max_clients):
        pid = os.fork()
        if pid == 0:
            for connection_num in range(max_conns):
                sock = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
                sock.connect(SERVER_ADDRESS)
                sock.sendall(REQUEST)
                socks.append(sock)
                print(connection_num)
                os._exit(0)


if __name__ == '__main__':
    parser = argparse.ArgumentParser(
        description='Test client for LSBAWS.',
        formatter_class=argparse.ArgumentDefaultsHelpFormatter,
    )
    parser.add_argument(
        '--max-conns',
        type=int,
        default=1024,
        help='Maximum number of connections per client.'
    )
    parser.add_argument(
        '--max-clients',
        type=int,
        default=1,
        help='Maximum number of clients.'
    )
    args = parser.parse_args()
    main(args.max_clients, args.max_conns)

在一个新建的终端窗口中,运行 client3.py 然后让它与服务器同步创建 300 个连接:

$ python client3.py --max-clients=300

过一会,你的服务器进程就该爆了。这是我的环境中出现的异常截图:
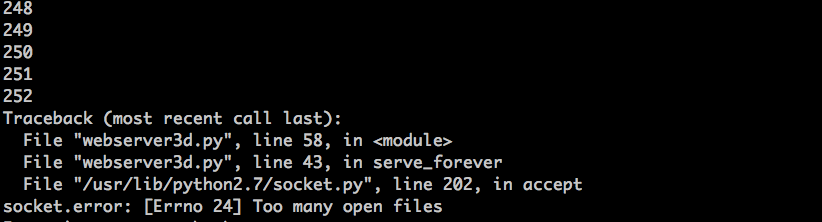
这个例子很明显——你的服务器应该关闭描述符副本。

僵尸进程

但是,即使你关闭了描述符副本,你依然没有摆脱险境,因为你的服务器还有一个问题,这个问题在于“ 僵尸 ( zombies ) ”!

没错,这个服务器代码确实在制造僵尸进程。我们来看看怎么回事。重新运行你的服务器:

$ python webserver3d.py

在另一个终端窗口中运行以下 curl 命令:

$ curl http://localhost:8888/hello

现在,运行 ps 环境,来查看正在运行的 Python 进程。下面是我的环境中 ps 的运行结果:

$ ps auxw | grep -i python | grep -v grep
vagrant   9099  0.0  1.2  31804  6256 pts/0    S+   16:33   0:00 python webserver3d.py
vagrant   9102  0.0  0.0      0     0 pts/0    Z+   16:33   0:00 [python] <defunct>

你看到第二行中,pid 为 9102,状态为 Z+,名字里面有个 <defunct> 的进程了吗?那就是我们的僵尸进程。这个僵尸进程的问题在于:你无法将它杀掉!
就算你尝试使用 kill -9 来杀死僵尸进程,它们仍旧会存活。自己试试看,看看结果。

这个僵尸到底是什么,为什么我们的服务器会造出它们呢?一个 僵尸进程 ( zombie ) 是一个已经结束的进程,但它的父进程并没有等待(waited)它结束,并且也没有收到它的终结状态。如果一个进程在父进程退出之前退出,系统内核会把它变为一个僵尸进程,存储它的部分信息,以便父进程读取。内核保存的进程信息通常包括进程 ID、进程终止状态,以及进程的资源占用情况。OK,所以僵尸进程确实有存在的意义,但如果服务器不管这些僵尸进程,你的系统将会被壅塞。我们来看看这个会如何发生。首先,关闭你运行的服务器;然后,在一个新的终端窗口中,使用 ulimit 命令将最大用户进程数设为 400(同时,要确保你的最大可用描述符数大于这个数字,我们在这里设为 500):

$ ulimit -u 400
$ ulimit -n 500

在你刚刚运行 ulimit -u 400 命令的终端中,运行服务器 webserver3d.py:

$ python webserver3d.py

在一个新的终端窗口中,运行 client3.py,并且让它与服务器同时创建 500 个连接:

$ python client3.py --max-clients=500

然后,过一会,你的服务器进程应该会再次爆了,它会在创建新进程时抛出一个 OSError: 资源暂时不可用 的异常。但它并没有达到系统允许的最大进程数。这是我的环境中输出的异常信息截图:
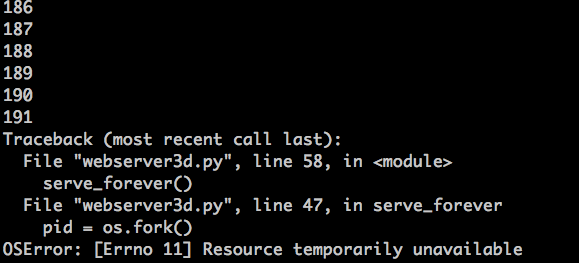
你可以看到,如果服务器不管僵尸进程,它们会引发问题。接下来我会简单探讨一下僵尸进程问题的解决方案。

我们来回顾一下你刚刚掌握的知识点:

  • 如果你不关闭文件描述符副本,客户端就不会在请求处理完成后终止,因为客户端连接没有被关闭;
  • 如果你不关闭文件描述符副本,长久运行的服务器最终会把可用的文件描述符(最大文件打开数)消耗殆尽;
  • 当你创建一个新进程,而父进程不等待(wait)子进程,也不在子进程结束后收集它的终止状态,它会变为一个僵尸进程;
  • 僵尸通常都会吃东西,在我们的例子中,僵尸进程会吃掉资源。如果你的服务器不管僵尸进程,它最终会消耗掉所有的可用进程(最大用户进程数);
  • 你不能杀死(kill)僵尸进程,你需要等待(wait)它。

如何处理僵尸进程?

所以,你需要做什么来处理僵尸进程呢?你需要修改你的服务器代码,来等待(wait)僵尸进程,并收集它们的终止信息。你可以在代码中使用系统调用 wait 来完成这个任务。不幸的是,这个方法离理想目标还很远,因为在没有终止的子进程存在的情况下调用 wait 会导致服务器进程阻塞,这会阻碍你的服务器处理新的客户端连接请求。那么,我们有其他选择吗?嗯,有的,其中一个解决方案需要结合信号处理以及 wait 系统调用。
这是它的工作流程。当一个子进程退出时,内核会发送 SIGCHLD 信号。父进程可以设置一个信号处理器,它可以异步响应 SIGCHLD 信号,并在信号响应函数中等待(wait)子进程收集终止信息,从而阻止了僵尸进程的存在。
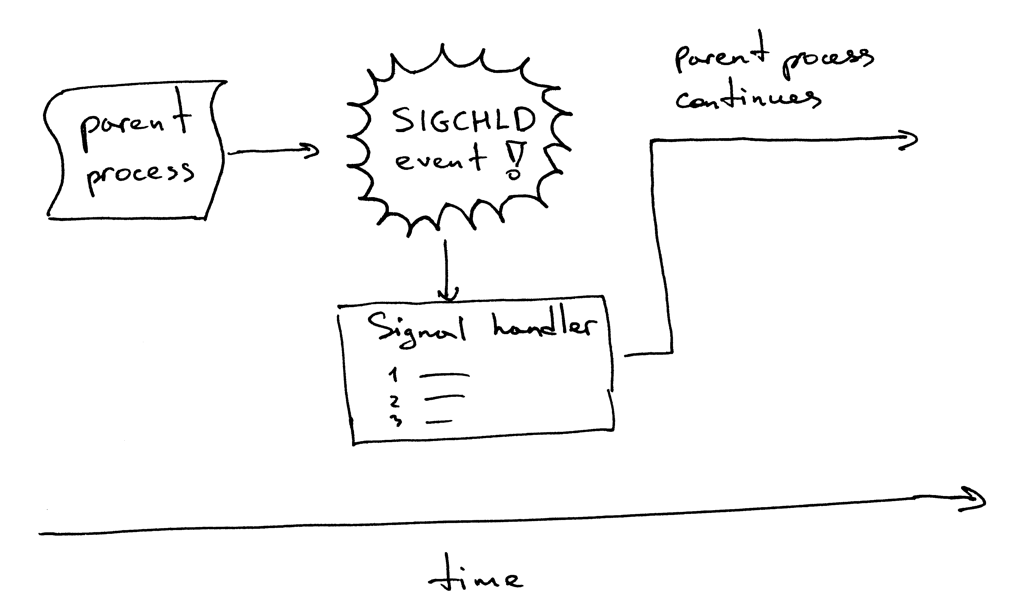
顺便说一下,异步事件意味着父进程无法提前知道事件的发生时间。

修改你的服务器代码,设置一个 SIGCHLD 信号处理器,在信号处理器中等待(wait)终止的子进程。修改后的代码如下(webserver3e.py):

#######################################################
# 并发服务器 - webserver3e.py                          #
#                                                     #
# 使用 Python 2.7.9 或 3.4                             #
# 在 Ubuntu 14.04 及 Mac OS X 环境下测试通过            #
#######################################################
import os
import signal
import socket
import time

SERVER_ADDRESS = (HOST, PORT) = '', 8888
REQUEST_QUEUE_SIZE = 5


def grim_reaper(signum, frame):
    pid, status = os.wait()
    print(
        'Child {pid} terminated with status {status}'
        '\n'.format(pid=pid, status=status)
    )


def handle_request(client_connection):
    request = client_connection.recv(1024)
    print(request.decode())
    http_response = b"""\
HTTP/1.1 200 OK

Hello, World!
"""
    client_connection.sendall(http_response)
    ### 挂起进程,来允许父进程完成循环,并在 "accept" 处阻塞
    time.sleep(3)


def serve_forever():
    listen_socket = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
    listen_socket.setsockopt(socket.SOL_SOCKET, socket.SO_REUSEADDR, 1)
    listen_socket.bind(SERVER_ADDRESS)
    listen_socket.listen(REQUEST_QUEUE_SIZE)
    print('Serving HTTP on port {port} ...'.format(port=PORT))

    signal.signal(signal.SIGCHLD, grim_reaper)

    while True:
        client_connection, client_address = listen_socket.accept()
        pid = os.fork()
        if pid == 0:  ### 子进程
            listen_socket.close()  ### 关闭子进程中多余的套接字
            handle_request(client_connection)
            client_connection.close()
            os._exit(0)
        else:  ### 父进程
            client_connection.close()

if __name__ == '__main__':
    serve_forever()

运行服务器:

$ python webserver3e.py

使用你的老朋友——curl 命令来向修改后的并发服务器发送一个请求:

$ curl http://localhost:8888/hello

再来看看服务器:
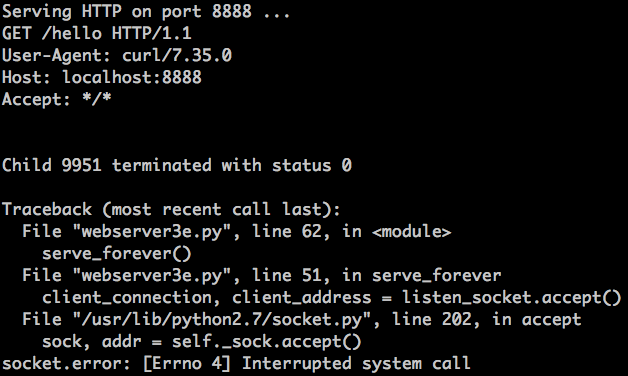
刚刚发生了什么?accept 调用失败了,错误信息为 EINTR。
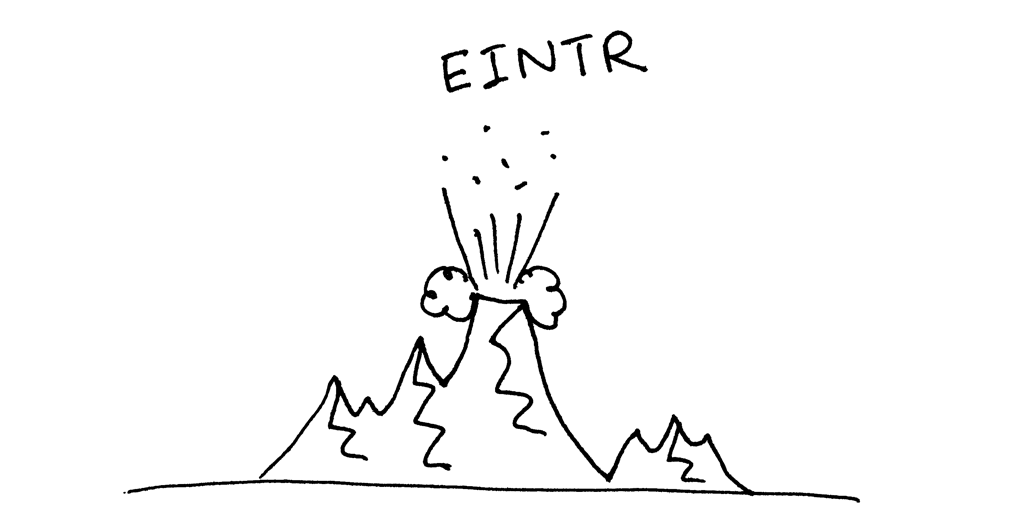
当子进程退出并触发 SIGCHLD 事件时,父进程的 accept 调用被阻塞了,系统转去运行信号处理器,当信号处理函数完成时,accept 系统调用被打断:
别担心,这个问题很好解决。你只需要重新运行 accept 系统调用即可。这是修改后的服务器代码 webserver3f.py,它可以解决这个问题:

#######################################################
# 并发服务器 - webserver3f.py                          #
#                                                     #
# 使用 Python 2.7.9 或 3.4                             #
# 在 Ubuntu 14.04 及 Mac OS X 环境下测试通过            #
#######################################################
import errno
import os
import signal
import socket

SERVER_ADDRESS = (HOST, PORT) = '', 8888
REQUEST_QUEUE_SIZE = 1024


def grim_reaper(signum, frame):
    pid, status = os.wait()


def handle_request(client_connection):
    request = client_connection.recv(1024)
    print(request.decode())
    http_response = b"""\
HTTP/1.1 200 OK

Hello, World!
"""
    client_connection.sendall(http_response)


def serve_forever():
    listen_socket = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
    listen_socket.setsockopt(socket.SOL_SOCKET, socket.SO_REUSEADDR, 1)
    listen_socket.bind(SERVER_ADDRESS)
    listen_socket.listen(REQUEST_QUEUE_SIZE)
    print('Serving HTTP on port {port} ...'.format(port=PORT))

    signal.signal(signal.SIGCHLD, grim_reaper)

    while True:
        try:
            client_connection, client_address = listen_socket.accept()
        except IOError as e:
            code, msg = e.args
            ### 若 'accept' 被打断,那么重启它
            if code == errno.EINTR:
                continue
            else:
                raise

        pid = os.fork()
        if pid == 0:  ### 子进程
            listen_socket.close()  ### 关闭子进程中多余的描述符
            handle_request(client_connection)
            client_connection.close()
            os._exit(0)
        else:  ### 父进程
            client_connection.close()  ### 关闭父进程中多余的描述符,继续下一轮循环


if __name__ == '__main__':
    serve_forever()

运行更新后的服务器 webserver3f.py:

$ python webserver3f.py

用 curl 来向更新后的并发服务器发送一个请求:

$ curl http://localhost:8888/hello

看到了吗?没有 EINTR 异常出现了。现在检查一下,确保没有僵尸进程存活,调用 wait 函数的 SIGCHLD 信号处理器能够正常处理被终止的子进程。我们只需使用 ps 命令,然后看看现在没有处于 Z+ 状态(或名字包含 <defunct> )的 Python 进程就好了。很棒!僵尸进程没有了,我们很安心。

  • 如果你创建了一个子进程,但是不等待它,它就会变成一个僵尸进程;
  • 使用 SIGCHLD 信号处理器可以异步地等待子进程终止,并收集其终止状态;
  • 当使用事件处理器时,你需要牢记,系统调用可能会被打断,所以你需要处理这种情况发生时带来的异常。

正确处理 SIGCHLD 信号

好的,一切顺利。是不是没问题了?额,几乎是。重新尝试运行 webserver3f.py 但我们这次不会只发送一个请求,而是同步创建 128 个连接:

$ python client3.py --max-clients 128

现在再次运行 ps 命令:

$ ps auxw | grep -i python | grep -v grep

看到了吗?天啊,僵尸进程又出来了!
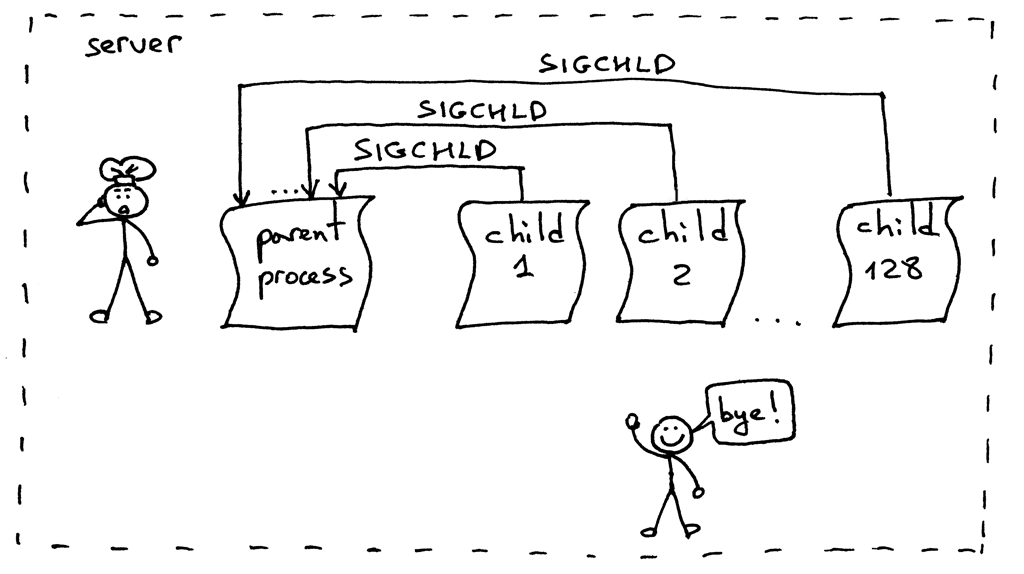
这回怎么回事?当你同时运行 128 个客户端,建立 128 个连接时,服务器的子进程几乎会在同一时间处理好你的请求,然后退出。这会导致非常多的 SIGCHLD 信号被发送到父进程。问题在于,这些信号不会存储在队列中,所以你的服务器进程会错过很多信号,这也就导致了几个僵尸进程处于无主状态:
这个问题的解决方案依然是设置 SIGCHLD 事件处理器。但我们这次将会用 WNOHANG 参数循环调用 waitpid 来替代 wait,以保证所有处于终止状态的子进程都会被处理。下面是修改后的代码,webserver3g.py:

#######################################################
# 并发服务器 - webserver3g.py                          #
#                                                     #
# 使用 Python 2.7.9 或 3.4                             #
# 在 Ubuntu 14.04 及 Mac OS X 环境下测试通过            #
#######################################################
import errno
import os
import signal
import socket

SERVER_ADDRESS = (HOST, PORT) = '', 8888
REQUEST_QUEUE_SIZE = 1024


def grim_reaper(signum, frame):
    while True:
        try:
            pid, status = os.waitpid(
                -1,          ### 等待所有子进程
                 os.WNOHANG  ### 无终止进程时,不阻塞进程,并抛出 EWOULDBLOCK 错误
            )
        except OSError:
            return

        if pid == 0:  ### 没有僵尸进程存在了
            return


def handle_request(client_connection):
    request = client_connection.recv(1024)
    print(request.decode())
    http_response = b"""\
HTTP/1.1 200 OK

Hello, World!
"""
    client_connection.sendall(http_response)


def serve_forever():
    listen_socket = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
    listen_socket.setsockopt(socket.SOL_SOCKET, socket.SO_REUSEADDR, 1)
    listen_socket.bind(SERVER_ADDRESS)
    listen_socket.listen(REQUEST_QUEUE_SIZE)
    print('Serving HTTP on port {port} ...'.format(port=PORT))

    signal.signal(signal.SIGCHLD, grim_reaper)

    while True:
        try:
            client_connection, client_address = listen_socket.accept()
        except IOError as e:
            code, msg = e.args
            ### 若 'accept' 被打断,那么重启它
            if code == errno.EINTR:
                continue
            else:
                raise

        pid = os.fork()
        if pid == 0:  ### 子进程
            listen_socket.close()  ### 关闭子进程中多余的描述符
            handle_request(client_connection)
            client_connection.close()
            os._exit(0)
        else:  ### 父进程
            client_connection.close()  ### 关闭父进程中多余的描述符,继续下一轮循环

if __name__ == '__main__':
    serve_forever()

运行服务器:

$ python webserver3g.py

使用测试客户端 client3.py:

$ python client3.py --max-clients 128

现在来查看一下,确保没有僵尸进程存在。耶!没有僵尸的生活真美好 ^_^。
大功告成

恭喜!你刚刚经历了一段很长的旅程,我希望你能够喜欢它。现在你拥有了自己的简易并发服务器,并且这段代码能够为你在继续研究生产级 Web 服务器的路上奠定基础。

我将会留一个作业:你需要将第二部分中的 WSGI 服务器升级,将它改造为一个并发服务器。你可以在这里找到更改后的代码。但是,当你实现了自己的版本之后,你才应该来看我的代码。你已经拥有了实现这个服务器所需的所有信息。所以,快去实现它吧 ^_^。

然后要做什么呢?乔希·比林斯说过:

“就像一枚邮票一样——专注于一件事,不达目的不罢休。”

开始学习基本知识。回顾你已经学过的知识。然后一步一步深入。
“如果你只学会了方法,你将会被这些方法所困。但如果你学会了原理,那你就能发明出新的方法。”——拉尔夫·沃尔多·爱默生

“有道无术,术尚可求也,有术无道,止于术”——中国古代也有这样的话,LCTT 译注

下面是一份书单,我从这些书中提炼出了这篇文章所需的素材。他们能助你在我刚刚所述的几个方面中发掘出兼具深度和广度的知识。我极力推荐你们去搞到这几本书看看:从你的朋友那里借,在当地的图书馆中阅读,或者直接在亚马逊上把它买回来。下面是我的典藏秘籍:

  1. 《UNIX 网络编程 卷1:套接字联网 API (第3版)》
  2. 《UNIX 环境高级编程(第3版)》
  3. 《Linux/UNIX 系统编程手册》
  4. 《TCP/IP 详解 卷1:协议(第2版)
  5. 《信号系统简明手册 (第二版): 并发控制深入浅出及常见错误》,这本书也可以从作者的个人网站中免费下载到。

顺便,我在撰写一本名为《搭个 Web 服务器:从头开始》的书。这本书讲解了如何从头开始编写一个基本的 Web 服务器,里面包含本文中没有的更多细节。订阅原文下方的邮件列表,你就可以获取到这本书的最新进展,以及发布日期。
via: https://ruslanspivak.com/lsbaws-part3/

作者:Ruslan 译者:StdioA 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

自从我写了上一篇博文之后,就再也找不到空闲时间写文章了。今天我终于可以抽出时间写一些关于 HTTP 的东西。

我认为每一个 web 开发者都应该对这个支撑了整个 Web 世界的 HTTP 协议有所了解,这样才能帮助你更好的完成开发任务。

在这篇文章中,我将讨论什么是 HTTP,它是怎么产生的,它的地位,以及我们应该怎么使用它。

HTTP 是什么

首先我们要明白 HTTP 是什么。HTTP 是一个基于 TCP/IP 的应用层通信协议,它是客户端和服务端在互联网互相通讯的标准。它定义了内容是如何通过互联网进行请求和传输的。HTTP 是在应用层中抽象出的一个标准,使得主机(客户端和服务端)之间的通信得以通过 TCP/IP 来进行请求和响应。TCP 默认使用的端口是 80,当然也可以使用其它端口,比如 HTTPS 使用的就是 443 端口。

HTTP/0.9 - 单行协议 (1991)

HTTP 最早的规范可以追溯到 1991 年,那时候的版本是 HTTP/0.9,该版本极其简单,只有一个叫做 GET的请求方式。如果客户端要访问服务端上的一个页面,只需要如下非常简单的请求:

GET /index.html

服务端对应的返回类似如下:

(response body)
(connection closed)

就这么简单,服务端捕获到请求后立马返回 HTML 并且关闭连接,在这之中

  • 没有 头信息 ( headers )
  • 仅支持 GET 这一种请求方法
  • 必须返回 HTML

如同你所看到的,当时的 HTTP 协议只是一块基础的垫脚石。

HTTP/1.0 - 1996

在 1996 年,新版本的 HTTP 对比之前的版本有了极大的改进,同时也被命名为 HTTP/1.0。

与 HTTP/0.9 只能返回 HTML 不同的是,HTTP/1.0 支持处理多种返回的格式,比如图片、视频、文本或者其他格式的文件。它还增加了更多的请求方法(如 POST 和 HEAD),请求和响应的格式也相应做了改变,两者都增加了头信息;引入了状态码来定义返回的特征;引入了字符集支持;支持 多段类型 ( multi-part ) 、用户验证信息、缓存、内容编码格式等等。

一个简单的 HTTP/1.0 请求大概是这样的:

GET / HTTP/1.0
Host: kamranahmed.info
User-Agent: Mozilla/5.0 (Macintosh; Intel Mac OS X 10_10_5)
Accept: */*

正如你所看到的,在请求中附带了客户端中的一些个人信息、响应类型要求等内容。这些是在 HTTP/0.9 无法实现的,因为那时候没有头信息。

一个对上述请求的响应例子如下所示:

HTTP/1.0 200 OK
Content-Type: text/plain
Content-Length: 137582
Expires: Thu, 05 Dec 1997 16:00:00 GMT
Last-Modified: Wed, 5 August 1996 15:55:28 GMT
Server: Apache 0.84

(response body)
(connection closed)

从 HTTP/1.0 (HTTP 后面跟的是版本号)早期开始,在状态码 200 之后就附带一个原因短语(你可以用来描述状态码)。

在这个较新一点的版本中,请求和响应的头信息仍然必须是 ASCII 编码,但是响应的内容可以是任意类型,如图片、视频、HTML、文本或其他类型,服务器可以返回任意内容给客户端。所以这之后,HTTP 中的“ 超文本 ( Hyper Text ) ”成了名不副实。 HMTP ( 超媒体传输协议 ( Hypermedia transfer protocol ) )可能会更有意义,但是我猜我们还是会一直沿用这个名字。

HTTP/1.0 的一个主要缺点就是它不能在一个连接内拥有多个请求。这意味着,当客户端需要从服务器获取东西时,必须建立一个新的 TCP 连接,并且处理完单个请求后连接即被关闭。需要下一个东西时,你必须重新建立一个新的连接。这样的坏处在哪呢?假设你要访问一个有 10 张图片,5 个 样式表 ( stylesheet ) 和 5 个 JavaScript 的总计 20 个文件才能完整展示的一个页面。由于一个连接在处理完成一次请求后即被关闭,所以将有 20 个单独的连接,每一个文件都将通过各自对应的连接单独处理。当连接数量变得庞大的时候就会面临严重的性能问题,因为 TCP 启动需要经过三次握手,才能缓慢开始。

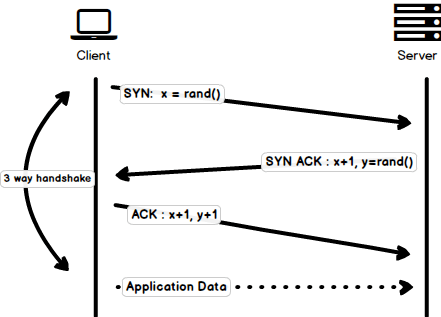
三次握手

三次握手是一个简单的模型,所有的 TCP 连接在传输应用数据之前都需要在三次握手中传输一系列数据包。

  • SYN - 客户端选取一个随机数,我们称为 x,然后发送给服务器。
  • SYN ACK - 服务器响应对应请求的 ACK 包中,包含了一个由服务器随机产生的数字,我们称为 y,并且把客户端发送的 x+1,一并返回给客户端。
  • ACK - 客户端在从服务器接受到 y 之后把 y 加上 1 作为一个 ACK 包返回给服务器。

一旦三次握手完成后,客户端和服务器之间就可以开始交换数据。值得注意的是,当客户端发出最后一个 ACK 数据包后,就可以立刻向服务器发送应用数据包,而服务器则需要等到收到这个 ACK 数据包后才能接受应用数据包。

请注意,上图有点小问题,客户端发回的最后一个 ACK 包仅包含 y+1,上图应该是 ACK:y+1 而不是 ACK:x+1,y+1

然而,某些 HTTP/1.0 的实现试图通过新引入一个称为 Connection: keep-alive 的头信息来克服这一问题,这个头信息意味着告诉服务器“嘿,服务器,请不要关闭此连接,我还要用它”。但是,这并没有得到广泛的支持,问题依然存在。

除了无连接之外,HTTP 还是一个无状态的协议,即服务器不维护有关客户端的信息。因此每个请求必须给服务器必要的信息才能完成请求,每个请求都与之前的旧的请求无关。所以,这增加了推波助澜的作用,客户端除了需要新建大量连接之外,在每次连接中还需要发送许多重复的数据,这导致了带宽的大量浪费。

HTTP/1.1 - 1999

HTTP/1.0 经过仅仅 3 年,下一个版本,即 HTTP/1.1 就在 1999 年发布了,改进了它的前身很多问题,主要的改进包括:

  • 增加了许多 HTTP 请求方法,包括 PUT、PATCH、HEAD、OPTIONS、DELETE。
  • 主机标识符 Host 在 HTTP/1.0 并不是必须的,而在 HTTP/1.1 是必须的。
  • 如上所述的持久连接。在 HTTP/1.0 中每个连接只有一个请求并在该请求结束后被立即关闭,这导致了性能问题和增加了延迟。 HTTP/1.1 引入了持久连接,即连接在默认情况下是不关闭并保持开放的,这允许多个连续的请求使用这个连接。要关闭该连接只需要在头信息加入 Connection: close,客户通常在最后一个请求里发送这个头信息就能安全地关闭连接。
  • 新版本还引入了“ 管线化 ( pipelining ) ”的支持,客户端可以不用等待服务器返回响应,就能在同一个连接内发送多个请求给服务器,而服务器必须以接收到的请求相同的序列发送响应。但是你可能会问了,客户端如何知道哪里是第一个响应下载完成而下一个响应内容开始的地方呢?要解决这个问题,头信息必须有 Content-Length,客户可以使用它来确定哪些响应结束之后可以开始等待下一个响应。

    • 值得注意的是,为了从持久连接或管线化中受益, 头部信息必须包含 Content-Length,因为这会使客户端知道什么时候完成了传输,然后它可以发送下一个请求(持久连接中,以正常的依次顺序发送请求)或开始等待下一个响应(启用管线化时)。
    • 但是,使用这种方法仍然有一个问题。那就是,如果数据是动态的,服务器无法提前知道内容长度呢?那么在这种情况下,你就不能使用这种方法中获益了吗?为了解决这个问题,HTTP/1.1 引进了分块编码。在这种情况下,服务器可能会忽略 Content-Length 来支持分块编码(更常见一些)。但是,如果它们都不可用,那么连接必须在请求结束时关闭。
  • 在动态内容的情况下分块传输,当服务器在传输开始但无法得到 Content-Length 时,它可能会开始按块发送内容(一块接一块),并在传输时为每一个小块添加 Content-Length。当发送完所有的数据块后,即整个传输已经完成后,它发送一个空的小块,比如设置 Content-Length 为 0 ,以便客户端知道传输已完成。为了通知客户端块传输的信息,服务器在头信息中包含了 Transfer-Encoding: chunked。
  • 不像 HTTP/1.0 中只有 Basic 身份验证方式,HTTP/1.1 包括 摘要验证方式 ( digest authentication ) 和 代理验证方式 ( proxy authentication ) 。
  • 缓存。
  • 范围请求 ( Byte Ranges ) 。
  • 字符集。
  • 内容协商 ( Content Negotiation ) 。
  • 客户端 cookies。
  • 支持压缩。
  • 新的状态码。
  • 等等。

我不打算在这里讨论所有 HTTP/1.1 的特性,因为你可以围绕这个话题找到很多关于这些的讨论。我建议你阅读 HTTP/1.0 和 HTTP/1.1 版本之间的主要差异,希望了解更多可以读原始的 RFC。

HTTP/1.1 在 1999 年推出,到现在已经是多年前的标准。虽然,它比前一代改善了很多,但是网络日新月异,它已经垂垂老矣。相比之前,加载网页更是一个资源密集型任务,打开一个简单的网页已经需要建立超过 30 个连接。你或许会说,HTTP/1.1 具有持久连接,为什么还有这么多连接呢?其原因是,在任何时刻 HTTP/1.1 只能有一个未完成的连接。 HTTP/1.1 试图通过引入管线来解决这个问题,但它并没有完全地解决。因为一旦管线遇到了缓慢的请求或庞大的请求,后面的请求便被阻塞住,它们必须等待上一个请求完成。为了克服 HTTP/1.1 的这些缺点,开发人员开始实现一些解决方法,例如使用 spritesheets、在 CSS 中编码图像、单个巨型 CSS / JavaScript 文件、域名切分等。

SPDY - 2009

谷歌走在业界前列,为了使网络速度更快,提高网络安全,同时减少网页的等待时间,他们开始实验替代的协议。在 2009 年,他们宣布了 SPDY。

SPDY 是谷歌的商标,而不是一个缩写。

显而易见的是,如果我们继续增加带宽,网络性能开始的时候能够得到提升,但是到了某个阶段后带来的性能提升就很有限了。但是如果把这些优化放在等待时间上,比如减少等待时间,将会有持续的性能提升。这就是 SPDY 优化之前的协议的核心思想,减少等待时间来提升网络性能。

对于那些不知道其中区别的人,等待时间就是延迟,即数据从源到达目的地需要多长时间(单位为毫秒),而带宽是每秒钟数据的传输量(比特每秒)。

SPDY 的特点包括:复用、压缩、优先级、安全性等。我不打算展开 SPDY 的细节。在下一章节,当我们将介绍 HTTP/2,这些都会被提到,因为 HTTP/2 大多特性是从 SPDY 受启发的。

SPDY 没有试图取代 HTTP,它是处于应用层的 HTTP 之上的一个传输层,它只是在请求被发送之前做了一些修改。它开始成为事实标准,大多数浏览器都开始支持了。

2015年,谷歌不想有两个相互竞争的标准,所以他们决定将其合并到 HTTP 协议,这样就导致了 HTTP/2 的出现和 SPDY 的废弃。

HTTP/2 - 2015

现在想必你明白了为什么我们需要另一个版本的 HTTP 协议了。 HTTP/2 是专为了低延迟地内容传输而设计。主要特点和与 HTTP/1.1 的差异包括:

  • 使用二进制替代明文
  • 多路传输 - 多个异步 HTTP 请求可以使用单一连接
  • 报头使用 HPACK 压缩
  • 服务器推送 - 单个请求多个响应
  • 请求优先级
  • 安全性

1. 二进制协议

HTTP/2 通过使其成为一个二进制协议以解决 HTTP/1.x 中存在的延迟问题。作为一个二进制协议,它更容易解析,但可读性却不如 HTTP/1.x。 帧 ( frames ) 和 流 ( stream ) 的概念组成了 HTTP/2 的主要部分。

帧和流

现在 HTTP 消息是由一个或多个帧组成的。HEADERS 帧承载了 元数据 ( meta data ) ,DATA 帧则承载了内容。还有其他类型的帧(HEADERS、DATA、RST_STREAM、SETTINGS、PRIORITY 等等),这些你可以通过 HTTP/2 规范来了解。

每个 HTTP/2 请求和响应都被赋予一个唯一的流 ID,并切分成帧。帧就是一小片二进制数据。帧的集合称为流,每个帧都有个标识了其所属流的流 ID,所以在同一个流下的每个帧具有共同的报头。值得注意的是,​除了流 ID 是唯一的之外,​由客户端发起的请求使用了奇数作为流 ID,从来自服务器的响应使用了偶数作为流 ID。

除了 HEADERS 帧和 DATA 帧,另一个值得一提的帧是 RST_STREAM。这是一个特殊的帧类型,用来中止流,即客户可以发送此帧让服务器知道,我不再需要这个流了。在 HTTP/1.1 中让服务器停止给客户端发送响应的唯一方法是关闭连接,这样造成了延迟增加,因为之后要发送请求时,就要必须打开一个新的请求。而在 HTTP/2,客户端可以使用 RST_STREAM 来停止接收特定的数据流,而连接仍然打开着,可以被其他请求使用。

2. 多路传输

因为 HTTP/2 是一个二进制协议,而且如上所述它使用帧和流来传输请求与响应,一旦建立了 TCP 连接,相同连接内的所有流都可以同过这个 TCP 连接异步发送,而不用另外打开连接。反过来说,服务器也可以使用同样的异步方式返回响应,也就是说这些响应可以是无序的,客户端使用分配的流 ID 来识别数据包所属的流。这也解决了 HTTP/1.x 中请求管道被阻塞的问题,即客户端不必等待占用时间的请求而其他请求仍然可以被处理。

3. HPACK 请求头部压缩

RFC 花了一篇文档的篇幅来介绍针对发送的头信息的优化,它的本质是当我们在同一客户端上不断地访问服务器时,许多冗余数据在头部中被反复发送,有时候仅仅是 cookies 就能增加头信息的大小,这会占用许多宽带和增加传输延迟。为了解决这个问题,HTTP/2 引入了头信息压缩。

不像请求和响应那样,头信息中的信息不会以 gzip 或者 compress 等格式压缩。而是采用一种不同的机制来压缩头信息,客户端和服务器同时维护一张头信息表,储存了使用了哈夫曼编码进行编码后的头信息的值,并且后续请求中若出现同样的字段则忽略重复值(例如 用户代理 ( user agent ) 等),只发送存在两边信息表中它的引用即可。

我们说的头信息,它们同 HTTP/1.1 中一样,并在此基础上增加了一些伪头信息,如 :scheme,:host 和 :path。

4. 服务器推送

服务器推送是 HTTP/2 的另一个巨大的特点。对于服务器来说,当它知道客户端需要一定的资源后,它可以把数据推送到客户端,即使客户端没有请求它。例如,假设一个浏览器在加载一个网页时,它解析了整个页面,发现有一些内容必须要从服务端获取,然后发送相应的请求到服务器以获取这些内容。

服务器推送减少了传输这些数据需要来回请求的次数。它是如何做到的呢?服务器通过发送一个名字为 PUSH_PROMISE 特殊的帧通知到客户端“嘿,我准备要发送这个资源给你了,不要再问我要了。”这个 PUSH_PROMISE 帧与要产生推送的流联系在一起,并包含了要推送的流 ID,也就是说这个流将会被服务器推送到客户端上。

5. 请求优先级

当流被打开的时候,客户端可以在 HEADERS 帧中包含优先级信息来为流指定优先级。在任何时候,客户端都可以发送 PRIORITY 帧来改变流的优先级。

如果没有任何优先级信息,服务器将异步地无序地处理这些请求。如果流分配了优先级,服务器将基于这个优先级来决定需要分配多少资源来处理这个请求。

6. 安全性

在是否强制使用 TLS 来增加安全性的问题上产生了大范围的讨论,讨论的结果是不强制使用。然而大多数厂商只有在使用 TLS 时才能使用 HTTP/2。所以 HTTP/2 虽然规范上不要求加密,但是加密已经约定俗成了。这样,在 TLS 之上实现 HTTP/2 就有了一些强制要求,比如,TLS 的最低版本为 1.2,必须达到某种级别的最低限度的密钥大小,需要布署 ephemeral 密钥等等。

到现在 HTTP/2 已经完全超越了 SPDY,并且还在不断成长,HTTP/2 有很多关系性能的提升,我们应该开始布署它了。

如果你想更深入的了解细节,请访问该规范的链接和 HTTP/2 性能提升演示的链接。请在留言板写下你的疑问或者评论,最后如果你发现有错误,请同样留言指出。

这就是全部了,我们之后再见~


via: http://kamranahmed.info/blog/2016/08/13/http-in-depth/

作者:Kamran Ahmed 译者:NearTan 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

Nginx 是最快和最强大的 Web 服务器之一,以其高性能和低资源占用率而闻名。它既可以被安装为一个独立的 Web 服务器,也可以安装成反向代理 Web 服务器。在这篇文章,我将讨论在安装了 cPanel 管理系统的 Centos 7 服务器上安装 Nginx 作为 Apache 的反向代理服务器。

Nginx 作为前端服务器用反向代理为静态文件提供服务,Apache 作为后端为动态文件提供服务。这个设置将整体提高服务器的性能。

让我们过一遍在已经安装好 cPanel 11.52 的 CentOS 7 x86\_64 服务器上配置 Nginx 作为反向代理的安装过程。

首先,我们需要安装 EPEL 库来启动这个进程

第一步: 安装 EPEL 库

root@server1 [/usr]# yum -y install epel-release
Loaded plugins: fastestmirror, tsflags, universal-hooks
Loading mirror speeds from cached hostfile
* EA4: 66.23.237.210
* base: mirrors.linode.com
* extras: mirrors.linode.com
* updates: mirrors.linode.com
Resolving Dependencies
--> Running transaction check
---> Package epel-release.noarch 0:7-5 will be installed
--> Finished Dependency Resolution

Dependencies Resolved

========================================================================================
    Package Arch Version Repository Size
========================================================================================
Installing:
epel-release noarch 7-5 extras 14 k

第二步: 可以安装 nDeploy 的 CentOS RPM 库来安装我们所需的 nDeploy Web 类软件和 Nginx 插件

root@server1 [/usr]# yum -y install http://rpm.piserve.com/nDeploy-release-centos-1.0-1.noarch.rpm
Loaded plugins: fastestmirror, tsflags, universal-hooks
nDeploy-release-centos-1.0-1.noarch.rpm | 1.7 kB 00:00:00
Examining /var/tmp/yum-root-ei5tWJ/nDeploy-release-centos-1.0-1.noarch.rpm: nDeploy-release-centos-1.0-1.noarch
Marking /var/tmp/yum-root-ei5tWJ/nDeploy-release-centos-1.0-1.noarch.rpm to be installed
Resolving Dependencies
--> Running transaction check
---> Package nDeploy-release-centos.noarch 0:1.0-1 will be installed
--> Finished Dependency Resolution

Dependencies Resolved

========================================================================================
Package Arch Version Repository Size
========================================================================================
Installing:
nDeploy-release-centos noarch 1.0-1 /nDeploy-release-centos-1.0-1.noarch 110

第三步:安装 nDeploy 和 Nginx nDeploy 插件

root@server1 [/usr]# yum --enablerepo=ndeploy install nginx-nDeploy nDeploy
Loaded plugins: fastestmirror, tsflags, universal-hooks
epel/x86_64/metalink | 9.9 kB 00:00:00
epel | 4.3 kB 00:00:00
ndeploy | 2.9 kB 00:00:00
(1/4): ndeploy/7/x86_64/primary_db | 14 kB 00:00:00
(2/4): epel/x86_64/group_gz | 169 kB 00:00:00
(3/4): epel/x86_64/primary_db | 3.7 MB 00:00:02

Dependencies Resolved

========================================================================================
Package Arch Version Repository Size
========================================================================================
Installing:
nDeploy noarch 2.0-11.el7 ndeploy 80 k
nginx-nDeploy x86_64 1.8.0-34.el7 ndeploy 36 M
Installing for dependencies:
PyYAML x86_64 3.10-11.el7 base 153 k
libevent x86_64 2.0.21-4.el7 base 214 k
memcached x86_64 1.4.15-9.el7 base 84 k
python-inotify noarch 0.9.4-4.el7 base 49 k
python-lxml x86_64 3.2.1-4.el7 base 758 k

Transaction Summary
========================================================================================
Install 2 Packages (+5 Dependent packages)

通过以上这些步骤,我们完成了在我们的服务器上 Nginx 插件的安装。现在我们可以配置 Nginx 作为反向代理和为已有的 cPanel 用户账户创建虚拟主机,为此我们可以运行如下脚本。

第四步:启动 Nginx 作为默认的前端 Web 服务器,并创建默认的配置文件

root@server1 [/usr]# /opt/nDeploy/scripts/cpanel-nDeploy-setup.sh enable
Modifying apache http and https port in cpanel

httpd restarted successfully.
Created symlink from /etc/systemd/system/multi-user.target.wants/nginx.service to /usr/lib/systemd/system/nginx.service.
Created symlink from /etc/systemd/system/multi-user.target.wants/ndeploy_watcher.service to /usr/lib/systemd/system/ndeploy_watcher.service.
Created symlink from /etc/systemd/system/multi-user.target.wants/ndeploy_backends.service to /usr/lib/systemd/system/ndeploy_backends.service.
ConfGen:: saheetha
ConfGen:: satest

你可以看到这个脚本将修改 Apache 的端口从 80 到另一个端口来让 Nginx 作为前端 Web 服务器,并为现有的 cPanel 用户创建虚拟主机配置文件。一旦完成,确认 Apache 和 Nginx 的状态。

Apache 状态:

root@server1 [/var/run/httpd]# systemctl status httpd
● httpd.service - Apache Web Server
Loaded: loaded (/usr/lib/systemd/system/httpd.service; enabled; vendor preset: disabled)
Active: active (running) since Mon 2016-01-18 06:34:23 UTC; 12s ago
Process: 25606 ExecStart=/usr/sbin/apachectl start (code=exited, status=0/SUCCESS)
Main PID: 24760 (httpd)
CGroup: /system.slice/httpd.service
‣ 24760 /usr/local/apache/bin/httpd -k start

Jan 18 06:34:23 server1.centos7-test.com systemd[1]: Starting Apache Web Server...
Jan 18 06:34:23 server1.centos7-test.com apachectl[25606]: httpd (pid 24760) already running
Jan 18 06:34:23 server1.centos7-test.com systemd[1]: Started Apache Web Server.

Nginx 状态:

root@server1 [~]# systemctl status nginx
● nginx.service - nginx-nDeploy - high performance web server
Loaded: loaded (/usr/lib/systemd/system/nginx.service; enabled; vendor preset: disabled)
Active: active (running) since Sun 2016-01-17 17:18:29 UTC; 13h ago
Docs: http://nginx.org/en/docs/
Main PID: 3833 (nginx)
CGroup: /system.slice/nginx.service
├─ 3833 nginx: master process /usr/sbin/nginx -c /etc/nginx/nginx.conf
├─25473 nginx: worker process
├─25474 nginx: worker process
└─25475 nginx: cache manager process

Jan 17 17:18:29 server1.centos7-test.com systemd[1]: Starting nginx-nDeploy - high performance web server...
Jan 17 17:18:29 server1.centos7-test.com nginx[3804]: nginx: the configuration file /etc/nginx/nginx.conf syntax is ok
Jan 17 17:18:29 server1.centos7-test.com nginx[3804]: nginx: configuration file /etc/nginx/nginx.conf test is successful
Jan 17 17:18:29 server1.centos7-test.com systemd[1]: Started nginx-nDeploy - high performance web server.

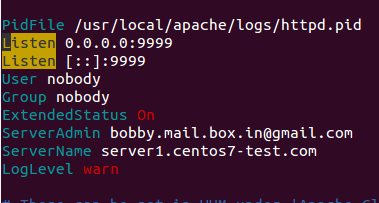
Nginx 作为前端服务器运行在 80 端口,Apache 配置被更改为监听 http 端口 9999 和 https 端口 4430。请看他们的情况:

root@server1 [/usr/local/src]# netstat -plan | grep httpd
tcp 0 0 0.0.0.0:4430 0.0.0.0:* LISTEN 17270/httpd
tcp 0 0 0.0.0.0:9999 0.0.0.0:* LISTEN 17270/httpd
tcp6 0 0 :::4430 :::* LISTEN 17270/httpd
tcp6 0 0 :::9999 :::* LISTEN 17270/httpd

apacheport

root@server1 [/usr/local/src]# netstat -plan | grep nginx
tcp 0 0 127.0.0.1:80 0.0.0.0:* LISTEN 17802/nginx: master
tcp 0 0 45.79.183.73:80 0.0.0.0:* LISTEN 17802/nginx: master

为已有用户创建的虚拟主机的配置文件在 “/etc/nginx/sites-enabled”。 这个文件路径包含了 Nginx 主要配置文件。

root@server1 [/etc/nginx/sites-enabled]# ll | grep .conf
-rw-r--r-- 1 root root 311 Jan 17 09:02 saheetha.com.conf
-rw-r--r-- 1 root root 336 Jan 17 09:02 saheethastest.com.conf

一个域名的示例虚拟主机:

server {

listen 45.79.183.73:80;
#CPIPVSIX:80;

# ServerNames
server_name saheetha.com www.saheetha.com;
access_log /usr/local/apache/domlogs/saheetha.com main;
access_log /usr/local/apache/domlogs/saheetha.com-bytes_log bytes_log;

include /etc/nginx/sites-enabled/saheetha.com.include;

}

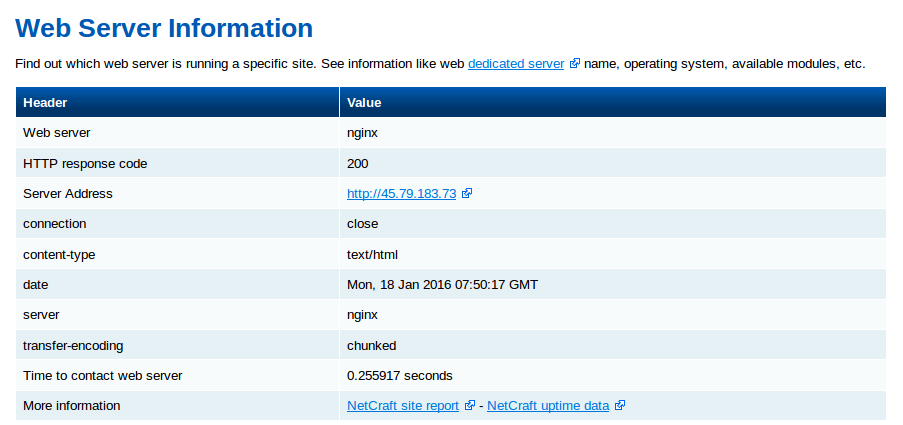
我们可以启动浏览器查看网站来确定 Web 服务器的工作状态。安装后,请阅读服务器上的 web 服务信息。

root@server1 [/home]# ip a | grep -i eth0
3: eth0: <BROADCAST,MULTICAST,UP,LOWER_UP> mtu 1500 qdisc pfifo_fast state UP qlen 1000
inet 45.79.183.73/24 brd 45.79.183.255 scope global dynamic eth0
root@server1 [/home]# nginx -v
nginx version: nginx/1.8.0

webserver-status

Nginx 将会为任何最新在 cPanel 中创建的账户创建虚拟主机。通过这些简单的的步骤,我们能够在一台 CentOS 7 / cPanel 的服务器上配置 Nginx 作为反向代理。

Nginx 作为反向代理的优势

  1. 便于安装和配置。
  2. 效率高、性能好。
  3. 防止 Ddos 攻击。
  4. 支持使用 .htaccess 作为 PHP 的重写规则。

我希望这篇文章对你们有用。感谢你看它。我非常高兴收到你的宝贵意见和建议,并进一步改善。


via: http://linoxide.com/linux-how-to/set-nginx-reverse-proxy-centos-7-cpanel/

作者:Saheetha Shameer 译者:bestony 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

在第一部分中,我提出了一个问题:“如何在你刚刚搭建起来的 Web 服务器上适配 Django, Flask 或 Pyramid 应用,而不用单独对 Web 服务器做做出改动以适应各种不同的 Web 框架呢?”我们可以从这一篇中找到答案。

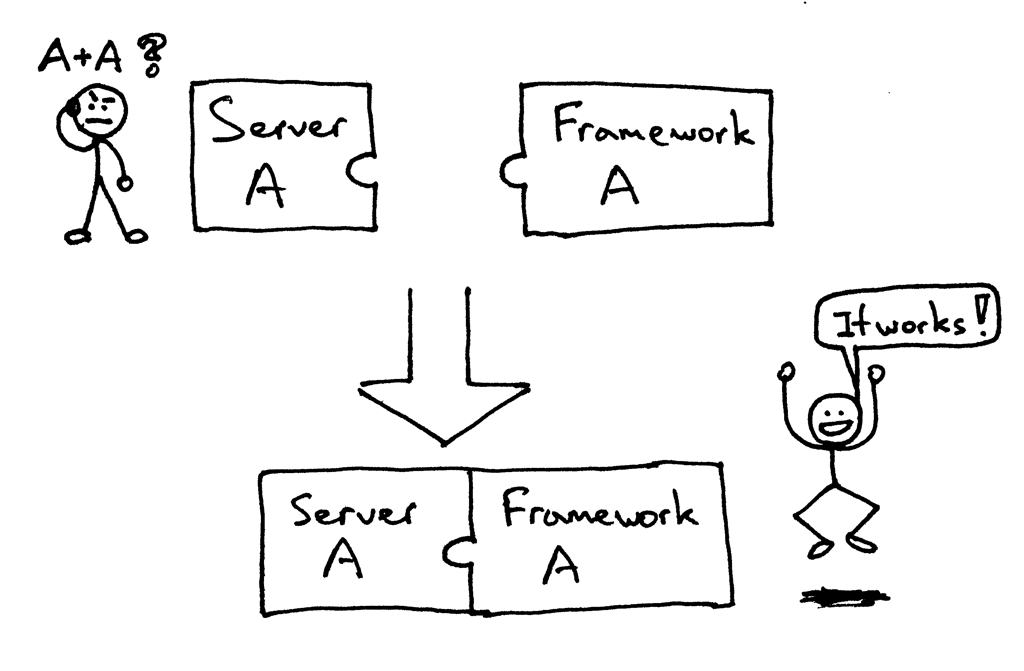
曾几何时,你所选择的 Python Web 框架会限制你所可选择的 Web 服务器,反之亦然。如果某个框架及服务器设计用来协同工作的,那么一切正常:

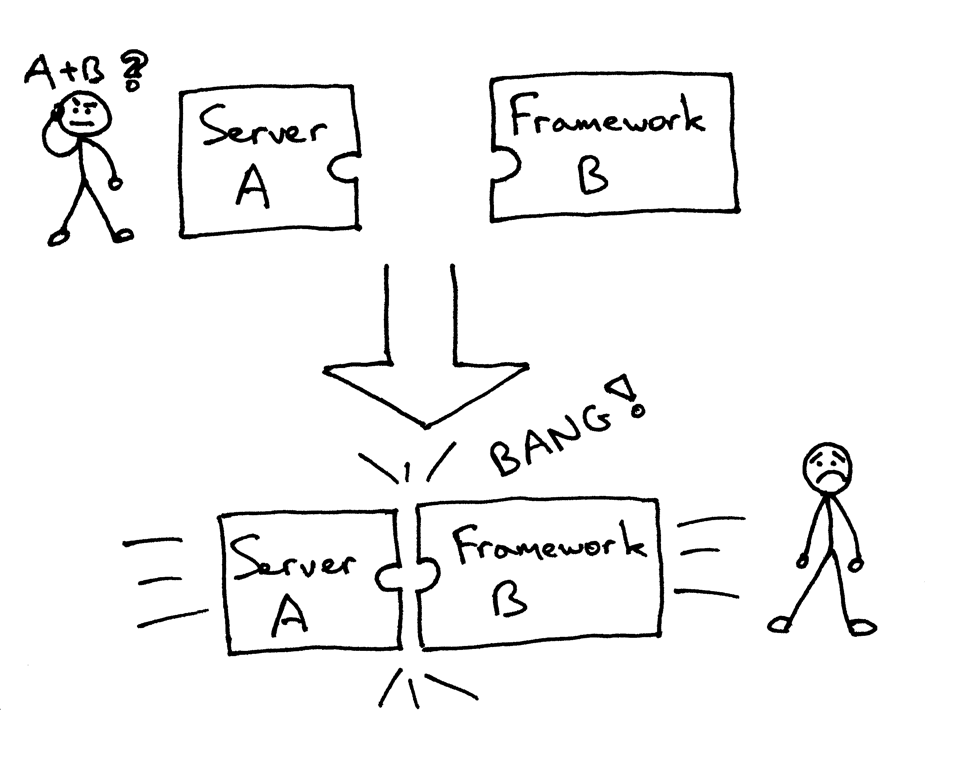
但你可能正面对着(或者曾经面对过)尝试将一对无法适配的框架和服务器搭配在一起的问题:

基本上,你需要选择那些能够一起工作的框架和服务器,而不能选择你想用的那些。

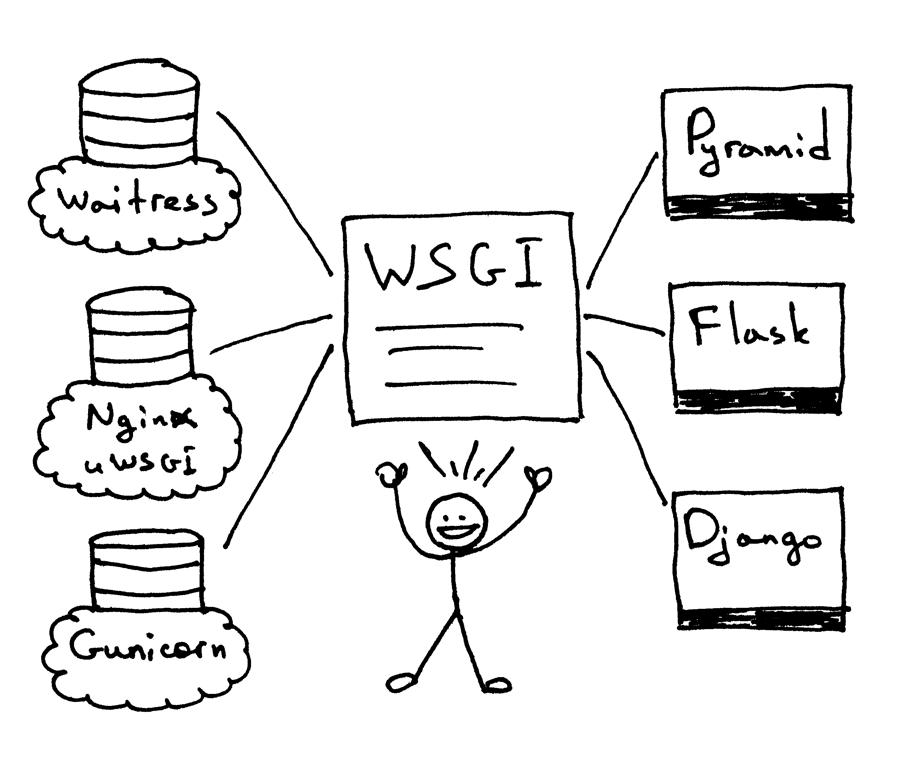
所以,你该如何确保在不对 Web 服务器或框架的代码做任何更改的情况下,让你的 Web 服务器和多个不同的 Web 框架一同工作呢?这个问题的答案,就是 Python Web 服务器网关接口 ( Web Server Gateway Interface ) (缩写为 WSGI,念做“wizgy”)。

WSGI 允许开发者互不干扰地选择 Web 框架及 Web 服务器的类型。现在,你可以真正将 Web 服务器及框架任意搭配,然后选出你最中意的那对组合。比如,你可以使用 Django,Flask 或者 Pyramid,与 Gunicorn,Nginx/uWSGI 或 Waitress 进行结合。感谢 WSGI 同时对服务器与框架的支持,我们可以真正随意选择它们的搭配了。

所以,WSGI 就是我在第一部分中提出,又在本文开头重复了一遍的那个问题的答案。你的 Web 服务器必须实现 WSGI 接口的服务器部分,而现代的 Python Web 框架均已实现了 WSGI 接口的框架部分,这使得你可以直接在 Web 服务器中使用任意框架,而不需要更改任何服务器代码,以对特定的 Web 框架实现兼容。

现在,你已经知道 Web 服务器及 Web 框架对 WSGI 的支持使得你可以选择最合适的一对来使用,而且它也有利于服务器和框架的开发者,这样他们只需专注于其擅长的部分来进行开发,而不需要触及另一部分的代码。其它语言也拥有类似的接口,比如:Java 拥有 Servlet API,而 Ruby 拥有 Rack。

这些理论都不错,但是我打赌你在说:“Show me the code!” 那好,我们来看看下面这个很小的 WSGI 服务器实现:

### 使用 Python 2.7.9,在 Linux 及 Mac OS X 下测试通过
import socket
import StringIO
import sys

class WSGIServer(object):

    address_family = socket.AF_INET
    socket_type = socket.SOCK_STREAM
    request_queue_size = 1

    def __init__(self, server_address):
        ### 创建一个监听的套接字
        self.listen_socket = listen_socket = socket.socket(
            self.address_family,
            self.socket_type
        )
        ### 允许复用同一地址
        listen_socket.setsockopt(socket.SOL_SOCKET, socket.SO_REUSEADDR, 1)
        ### 绑定地址
        listen_socket.bind(server_address)
        ### 激活套接字
        listen_socket.listen(self.request_queue_size)
        ### 获取主机的名称及端口
        host, port = self.listen_socket.getsockname()[:2]
        self.server_name = socket.getfqdn(host)
        self.server_port = port
        ### 返回由 Web 框架/应用设定的响应头部字段
        self.headers_set = []

    def set_app(self, application):
        self.application = application

    def serve_forever(self):
        listen_socket = self.listen_socket
        while True:
            ### 获取新的客户端连接
            self.client_connection, client_address = listen_socket.accept()
            ### 处理一条请求后关闭连接,然后循环等待另一个连接建立
            self.handle_one_request()

    def handle_one_request(self):
        self.request_data = request_data = self.client_connection.recv(1024)
        ### 以 'curl -v' 的风格输出格式化请求数据
        print(''.join(
            '< {line}\n'.format(line=line)
            for line in request_data.splitlines()
        ))

        self.parse_request(request_data)

        ### 根据请求数据构建环境变量字典
        env = self.get_environ()

        ### 此时需要调用 Web 应用来获取结果,
        ### 取回的结果将成为 HTTP 响应体
        result = self.application(env, self.start_response)

        ### 构造一个响应,回送至客户端
        self.finish_response(result)

    def parse_request(self, text):
        request_line = text.splitlines()[0]
        request_line = request_line.rstrip('
')
        ### 将请求行分成几个部分
        (self.request_method,  # GET
         self.path,            # /hello
         self.request_version  # HTTP/1.1
         ) = request_line.split()

    def get_environ(self):
        env = {}
        ### 以下代码段没有遵循 PEP8 规则,但这样排版,是为了通过强调
        ### 所需变量及它们的值,来达到其展示目的。
        ###
        ### WSGI 必需变量
        env['wsgi.version']      = (1, 0)
        env['wsgi.url_scheme']   = 'http'
        env['wsgi.input']        = StringIO.StringIO(self.request_data)
        env['wsgi.errors']       = sys.stderr
        env['wsgi.multithread']  = False
        env['wsgi.multiprocess'] = False
        env['wsgi.run_once']     = False
        ### CGI 必需变量
        env['REQUEST_METHOD']    = self.request_method    # GET
        env['PATH_INFO']         = self.path              # /hello
        env['SERVER_NAME']       = self.server_name       # localhost
        env['SERVER_PORT']       = str(self.server_port)  # 8888
        return env

    def start_response(self, status, response_headers, exc_info=None):
        ### 添加必要的服务器头部字段
        server_headers = [
            ('Date', 'Tue, 31 Mar 2015 12:54:48 GMT'),
            ('Server', 'WSGIServer 0.2'),
        ]
        self.headers_set = [status, response_headers + server_headers]
        ### 为了遵循 WSGI 协议,start_response 函数必须返回一个 'write'
        ### 可调用对象(返回值.write 可以作为函数调用)。为了简便,我们
        ### 在这里无视这个细节。
        ### return self.finish_response

    def finish_response(self, result):
        try:
            status, response_headers = self.headers_set
            response = 'HTTP/1.1 {status}
'.format(status=status)
            for header in response_headers:
                response += '{0}: {1}
'.format(*header)
            response += '
'
            for data in result:
                response += data
            ### 以 'curl -v' 的风格输出格式化请求数据
            print(''.join(
                '> {line}\n'.format(line=line)
                for line in response.splitlines()
            ))
            self.client_connection.sendall(response)
        finally:
            self.client_connection.close()

SERVER_ADDRESS = (HOST, PORT) = '', 8888

def make_server(server_address, application):
    server = WSGIServer(server_address)
    server.set_app(application)
    return server

if __name__ == '__main__':
    if len(sys.argv) < 2:
        sys.exit('Provide a WSGI application object as module:callable')
    app_path = sys.argv[1]
    module, application = app_path.split(':')
    module = __import__(module)
    application = getattr(module, application)
    httpd = make_server(SERVER_ADDRESS, application)
    print('WSGIServer: Serving HTTP on port {port} ...\n'.format(port=PORT))
    httpd.serve_forever()

当然,这段代码要比第一部分的服务器代码长不少,但它仍然很短(只有不到 150 行),你可以轻松理解它,而不需要深究细节。上面的服务器代码还可以做更多——它可以用来运行一些你喜欢的框架写出的 Web 应用,可以是 Pyramid,Flask,Django 或其它 Python WSGI 框架。

不相信吗?自己来试试看吧。把以上的代码保存为 webserver2.py,或直接从 Github 上下载它。如果你打算不加任何参数而直接运行它,它会抱怨一句,然后退出。

$ python webserver2.py
Provide a WSGI application object as module:callable

它想做的其实是为你的 Web 应用服务,而这才是重头戏。为了运行这个服务器,你唯一需要的就是安装好 Python。不过,如果你希望运行 Pyramid,Flask 或 Django 应用,你还需要先安装那些框架。那我们把这三个都装上吧。我推荐的安装方式是通过 virtualenv 安装。按照以下几步来做,你就可以创建并激活一个虚拟环境,并在其中安装以上三个 Web 框架。

$ [sudo] pip install virtualenv
$ mkdir ~/envs
$ virtualenv ~/envs/lsbaws/
$ cd ~/envs/lsbaws/
$ ls
bin  include  lib
$ source bin/activate
(lsbaws) $ pip install pyramid
(lsbaws) $ pip install flask
(lsbaws) $ pip install django

现在,你需要创建一个 Web 应用。我们先从 Pyramid 开始吧。把以下代码保存为 pyramidapp.py,并与刚刚的 webserver2.py 放置在同一目录,或直接从 Github 下载该文件:

from pyramid.config import Configurator
from pyramid.response import Response

def hello_world(request):
    return Response(
        'Hello world from Pyramid!\n',
        content_type='text/plain',
    )

config = Configurator()
config.add_route('hello', '/hello')
config.add_view(hello_world, route_name='hello')
app = config.make_wsgi_app()

现在,你可以用你自己的 Web 服务器来运行你的 Pyramid 应用了:

(lsbaws) $ python webserver2.py pyramidapp:app
WSGIServer: Serving HTTP on port 8888 ...

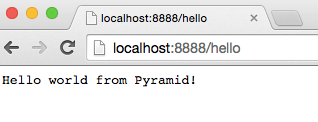
你刚刚让你的服务器去加载 Python 模块 pyramidapp 中的可执行对象 app。现在你的服务器可以接收请求,并将它们转发到你的 Pyramid 应用中了。在浏览器中输入 http://localhost:8888/hello ,敲一下回车,然后看看结果:

你也可以使用命令行工具 curl 来测试服务器:

$ curl -v http://localhost:8888/hello
...

看看服务器和 curl 向标准输出流打印的内容吧。

现在来试试 Flask。运行步骤跟上面的一样。

from flask import Flask
from flask import Response
flask_app = Flask('flaskapp')

@flask_app.route('/hello')
def hello_world():
    return Response(
        'Hello world from Flask!\n',
        mimetype='text/plain'
    )

app = flask_app.wsgi_app

将以上代码保存为 flaskapp.py,或者直接从 Github 下载,然后输入以下命令运行服务器:

(lsbaws) $ python webserver2.py flaskapp:app
WSGIServer: Serving HTTP on port 8888 ...

现在在浏览器中输入 http://localhost:8888/hello ,敲一下回车:

同样,尝试一下 curl,然后你会看到服务器返回了一条 Flask 应用生成的信息:

$ curl -v http://localhost:8888/hello
...

这个服务器能处理 Django 应用吗?试试看吧!不过这个任务可能有点复杂,所以我建议你将整个仓库克隆下来,然后使用 Github 仓库中的 djangoapp.py 来完成这个实验。这里的源代码主要是将 Django 的 helloworld 工程(已使用 Django 的 django-admin.py startproject 命令创建完毕)添加到了当前的 Python 路径中,然后导入了这个工程的 WSGI 应用。(LCTT 译注:除了这里展示的代码,还需要一个配合的 helloworld 工程才能工作,代码可以参见 Github 仓库。)

import sys
sys.path.insert(0, './helloworld')
from helloworld import wsgi

app = wsgi.application

将以上代码保存为 djangoapp.py,然后用你的 Web 服务器运行这个 Django 应用:

(lsbaws) $ python webserver2.py djangoapp:app
WSGIServer: Serving HTTP on port 8888 ...

输入以下链接,敲回车:

你这次也可以在命令行中测试——你之前应该已经做过两次了——来确认 Django 应用处理了你的请求:

$ curl -v http://localhost:8888/hello
...

你试过了吗?你确定这个服务器可以与那三个框架搭配工作吗?如果没试,请去试一下。阅读固然重要,但这个系列的内容是重新搭建,这意味着你需要亲自动手干点活。去试一下吧。别担心,我等着你呢。不开玩笑,你真的需要试一下,亲自尝试每一步,并确保它像预期的那样工作。

好,你已经体验到了 WSGI 的威力:它可以使 Web 服务器及 Web 框架随意搭配。WSGI 在 Python Web 服务器及框架之间提供了一个微型接口。它非常简单,而且在服务器和框架端均可以轻易实现。下面的代码片段展示了 WSGI 接口的服务器及框架端实现:

def run_application(application):
    """服务器端代码。"""
    ### Web 应用/框架在这里存储 HTTP 状态码以及 HTTP 响应头部,
    ### 服务器会将这些信息传递给客户端
    headers_set = []
    ### 用于存储 WSGI/CGI 环境变量的字典
    environ = {}

    def start_response(status, response_headers, exc_info=None):
        headers_set[:] = [status, response_headers]

    ### 服务器唤醒可执行变量“application”,获得响应头部
    result = application(environ, start_response)
    ### 服务器组装一个 HTTP 响应,将其传送至客户端
    …

def app(environ, start_response):
    """一个空的 WSGI 应用"""
    start_response('200 OK', [('Content-Type', 'text/plain')])
    return ['Hello world!']

run_application(app)

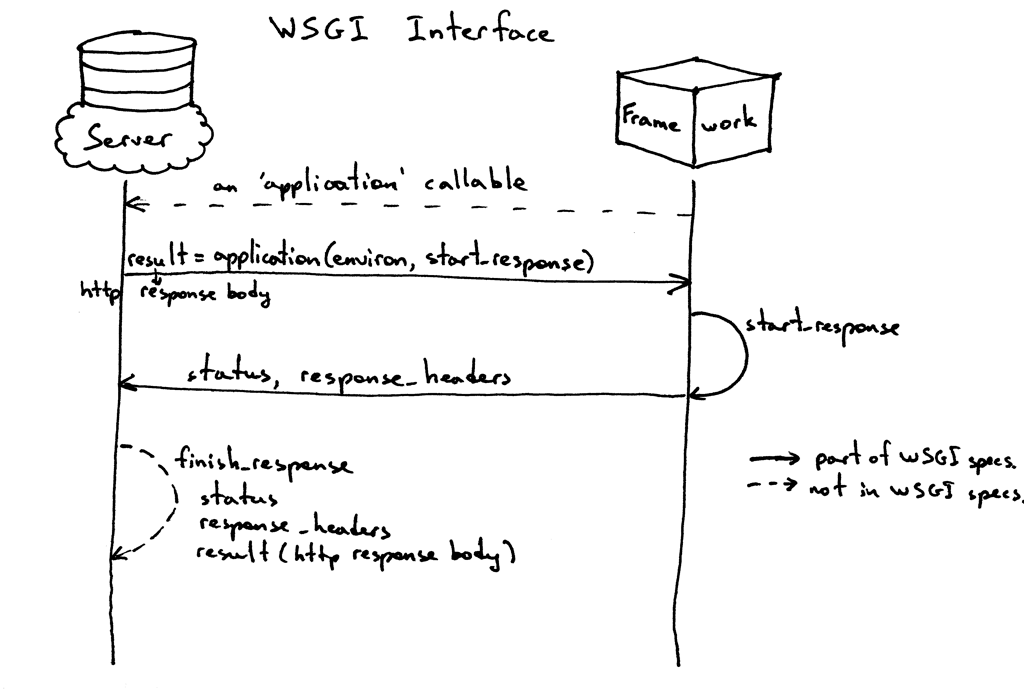
这是它的工作原理:

  1. Web 框架提供一个可调用对象 application (WSGI 规范没有规定它的实现方式)。
  2. Web 服务器每次收到来自客户端的 HTTP 请求后,会唤醒可调用对象 applition。它会向该对象传递一个包含 WSGI/CGI 变量的环境变量字典 environ,以及一个可调用对象 start_response。
  3. Web 框架或应用生成 HTTP 状态码和 HTTP 响应头部,然后将它传给 start_response 函数,服务器会将其存储起来。同时,Web 框架或应用也会返回 HTTP 响应正文。
  4. 服务器将状态码、响应头部及响应正文组装成一个 HTTP 响应,然后将其传送至客户端(这一步并不在 WSGI 规范中,但从逻辑上讲,这一步应该包含在工作流程之中。所以为了明确这个过程,我把它写了出来)

这是这个接口规范的图形化表达:

到现在为止,你已经看过了用 Pyramid、Flask 和 Django 写出的 Web 应用的代码,你也看到了一个 Web 服务器如何用代码来实现另一半(服务器端的) WSGI 规范。你甚至还看到了我们如何在不使用任何框架的情况下,使用一段代码来实现一个最简单的 WSGI Web 应用。

其实,当你使用上面的框架编写一个 Web 应用时,你只是在较高的层面工作,而不需要直接与 WSGI 打交道。但是我知道你一定也对 WSGI 接口的框架部分感兴趣,因为你在看这篇文章呀。所以,我们不用 Pyramid、Flask 或 Django,而是自己动手来创造一个最朴素的 WSGI Web 应用(或 Web 框架),然后将它和你的服务器一起运行:

def app(environ, start_response):
    """一个最简单的 WSGI 应用。

    这是你自己的 Web 框架的起点 ^_^
    """
    status = '200 OK'
    response_headers = [('Content-Type', 'text/plain')]
    start_response(status, response_headers)
    return ['Hello world from a simple WSGI application!\n']

同样,将上面的代码保存为 wsgiapp.py 或直接从 Github 上下载该文件,然后在 Web 服务器上运行这个应用,像这样:

(lsbaws) $ python webserver2.py wsgiapp:app
WSGIServer: Serving HTTP on port 8888 ...

在浏览器中输入下面的地址,然后按下回车。这是你应该看到的结果:

你刚刚在学习如何创建一个 Web 服务器的过程中自己编写了一个最朴素的 WSGI Web 框架!棒极了!

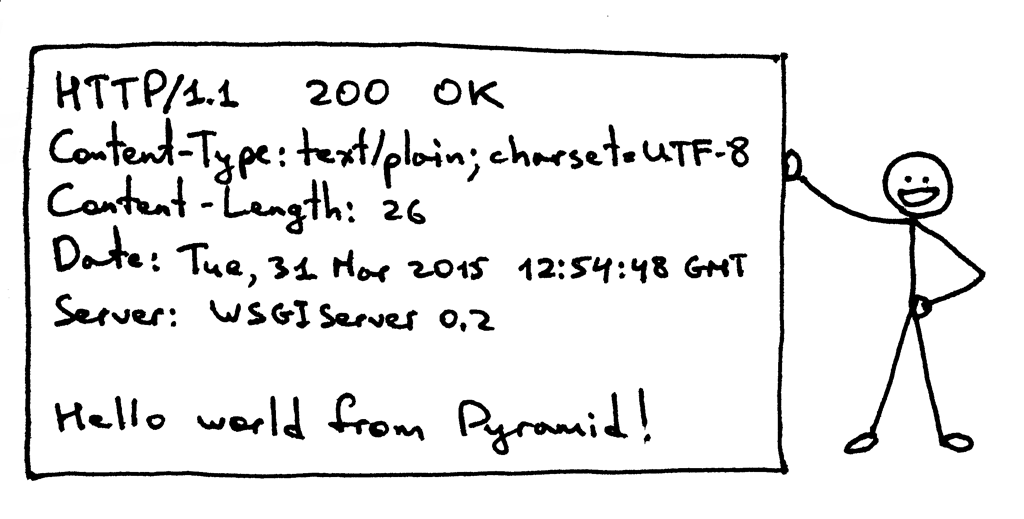
现在,我们再回来看看服务器传给客户端的那些东西。这是在使用 HTTP 客户端调用你的 Pyramid 应用时,服务器生成的 HTTP 响应内容:

这个响应和你在本系列第一部分中看到的 HTTP 响应有一部分共同点,但它还多出来了一些内容。比如说,它拥有四个你曾经没见过的 HTTP 头部:Content-Type, Content-Length, Date 以及 Server。这些头部内容基本上在每个 Web 服务器返回的响应中都会出现。不过,它们都不是被严格要求出现的。这些 HTTP 请求/响应头部字段的目的在于它可以向你传递一些关于 HTTP 请求/响应的额外信息。

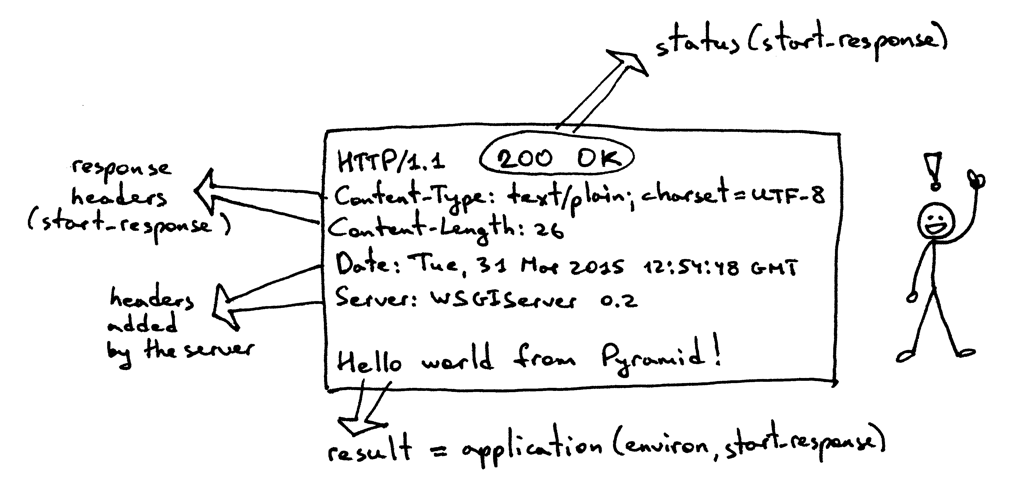
既然你对 WSGI 接口了解的更深了一些,那我再来展示一下上面那个 HTTP 响应中的各个部分的信息来源:

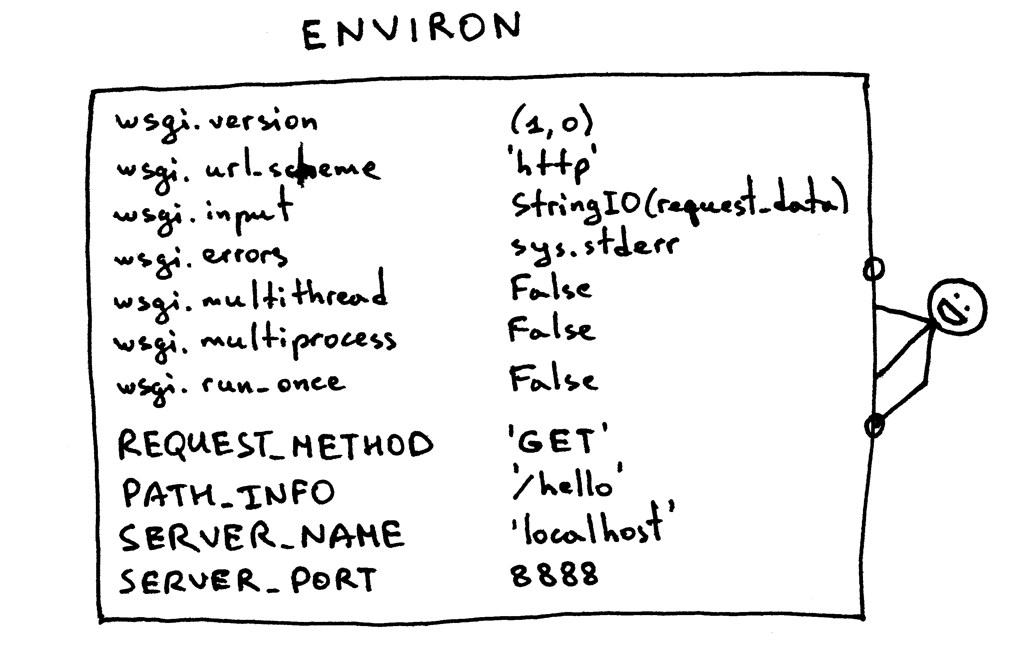
我现在还没有对上面那个 environ 字典做任何解释,不过基本上这个字典必须包含那些被 WSGI 规范事先定义好的 WSGI 及 CGI 变量值。服务器在解析 HTTP 请求时,会从请求中获取这些变量的值。这是 environ 字典应该有的样子:

Web 框架会利用以上字典中包含的信息,通过字典中的请求路径、请求动作等等来决定使用哪个视图来处理响应、在哪里读取请求正文、在哪里输出错误信息(如果有的话)。

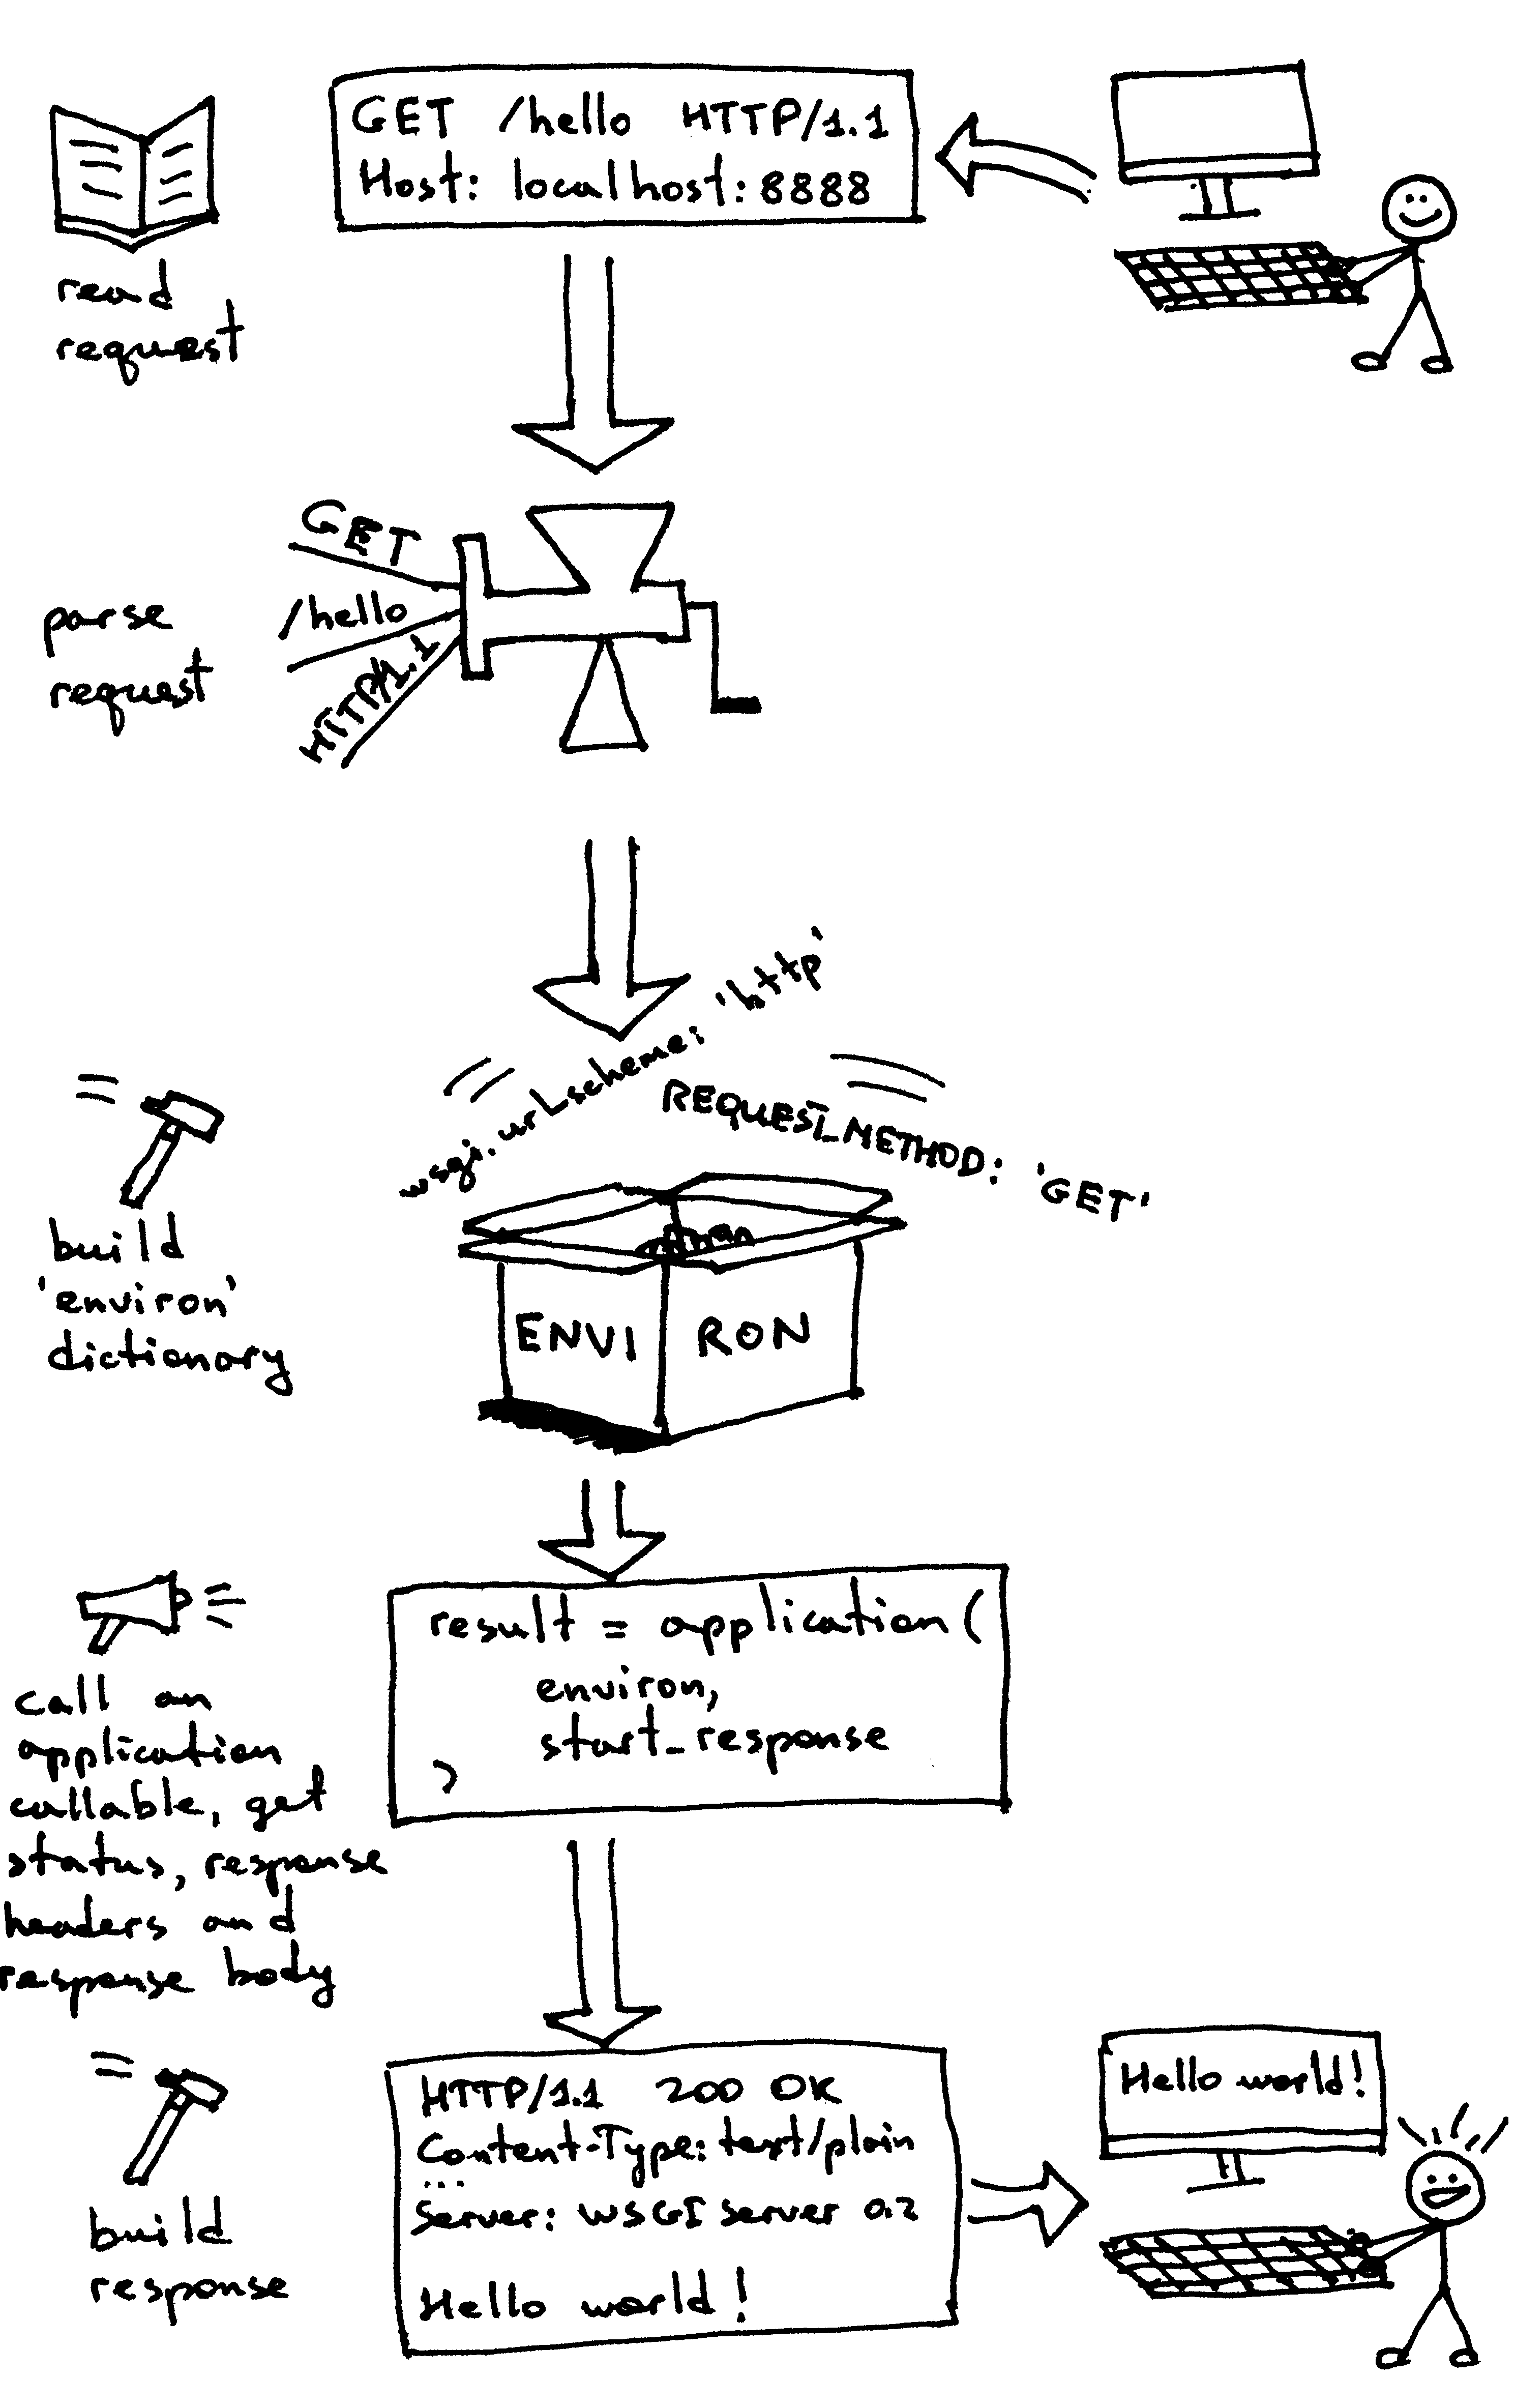
现在,你已经创造了属于你自己的 WSGI Web 服务器,你也使用不同 Web 框架做了几个 Web 应用。而且,你在这个过程中也自己创造出了一个朴素的 Web 应用及框架。这个过程真是累人。现在我们来回顾一下,你的 WSGI Web 服务器在服务请求时,需要针对 WSGI 应用做些什么:

  • 首先,服务器开始工作,然后会加载一个可调用对象 application,这个对象由你的 Web 框架或应用提供
  • 然后,服务器读取一个请求
  • 然后,服务器会解析这个请求
  • 然后,服务器会使用请求数据来构建一个 environ 字典
  • 然后,它会用 environ 字典及一个可调用对象 start_response 作为参数,来调用 application,并获取响应体内容。
  • 然后,服务器会使用 application 返回的响应体,和 start_response 函数设置的状态码及响应头部内容,来构建一个 HTTP 响应。
  • 最终,服务器将 HTTP 响应回送给客户端。

这基本上是服务器要做的全部内容了。你现在有了一个可以正常工作的 WSGI 服务器,它可以为使用任何遵循 WSGI 规范的 Web 框架(如 Django、Flask、Pyramid,还有你刚刚自己写的那个框架)构建出的 Web 应用服务。最棒的部分在于,它可以在不用更改任何服务器代码的情况下,与多个不同的 Web 框架一起工作。真不错。

在结束之前,你可以想想这个问题:“你该如何让你的服务器在同一时间处理多个请求呢?”

敬请期待,我会在第三部分向你展示一种解决这个问题的方法。干杯!

顺便,我在撰写一本名为《搭个 Web 服务器:从头开始》的书。这本书讲解了如何从头开始编写一个基本的 Web 服务器,里面包含本文中没有的更多细节。订阅邮件列表,你就可以获取到这本书的最新进展,以及发布日期。

via: https://ruslanspivak.com/lsbaws-part2/

作者:Ruslan 译者:StdioA 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

一天,有一个正在散步的妇人恰好路过一个建筑工地,看到三个正在工作的工人。她问第一个人:“你在做什么?”第一个人没好气地喊道:“你没看到我在砌砖吗?”妇人对这个答案不满意,于是问第二个人:“你在做什么?”第二个人回答说:“我在建一堵砖墙。”说完,他转向第一个人,跟他说:“嗨,你把墙砌过头了。去把刚刚那块砖弄下来!”然而,妇人对这个答案依然不满意,于是又问了第三个人相同的问题。第三个人仰头看着天,对她说:“我在建造世界上最大的教堂。”当他回答时,第一个人和第二个人在为刚刚砌错的砖而争吵。他转向那两个人,说:“不用管那块砖了。这堵墙在室内,它会被水泥填平,没人会看见它的。去砌下一层吧。”

这个故事告诉我们:如果你能够理解整个系统的构造,了解系统的各个部件如何相互结合(如砖、墙还有整个教堂),你就能够更快地定位及修复问题(那块砌错的砖)。

如果你想从头开始创造一个 Web 服务器,那么你需要做些什么呢?

我相信,如果你想成为一个更好的开发者,你必须对日常使用的软件系统的内部结构有更深的理解,包括编程语言、编译器与解释器、数据库及操作系统、Web 服务器及 Web 框架。而且,为了更好更深入地理解这些系统,你必须从头开始,用一砖一瓦来重新构建这个系统。

荀子曾经用这几句话来表达这种思想:

“ 不闻不若闻之。 ( I hear and I forget. ) ”

“ 闻之不若见之。 ( I see and I remember. ) ”

“ 知之不若行之。 ( I do and I understand. ) ”

我希望你现在能够意识到,重新建造一个软件系统来了解它的工作方式是一个好主意。

在这个由三篇文章组成的系列中,我将会教你构建你自己的 Web 服务器。我们开始吧~

先说首要问题:Web 服务器是什么?

简而言之,它是一个运行在一个物理服务器上的网络服务器(啊呀,服务器套服务器),等待客户端向其发送请求。当它接收请求后,会生成一个响应,并回送至客户端。客户端和服务端之间通过 HTTP 协议来实现相互交流。客户端可以是你的浏览器,也可以是使用 HTTP 协议的其它任何软件。

最简单的 Web 服务器实现应该是什么样的呢?这里我给出我的实现。这个例子由 Python 写成,即使你没听说过 Python(它是一门超级容易上手的语言,快去试试看!),你也应该能够从代码及注释中理解其中的理念:

import socket

HOST, PORT = '', 8888

listen_socket = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
listen_socket.setsockopt(socket.SOL_SOCKET, socket.SO_REUSEADDR, 1)
listen_socket.bind((HOST, PORT))
listen_socket.listen(1)
print 'Serving HTTP on port %s ...' % PORT
while True:
    client_connection, client_address = listen_socket.accept()
    request = client_connection.recv(1024)
    print request

    http_response = """\
HTTP/1.1 200 OK

Hello, World!
"""
    client_connection.sendall(http_response)
    client_connection.close()

将以上代码保存为 webserver1.py,或者直接从 GitHub 上下载这个文件。然后,在命令行中运行这个程序。像这样:

$ python webserver1.py
Serving HTTP on port 8888 …

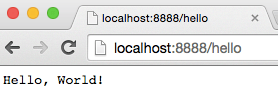
现在,在你的网页浏览器的地址栏中输入 URL:http://localhost:8888/hello ,敲一下回车,然后来见证奇迹。你应该看到“Hello, World!”显示在你的浏览器中,就像下图那样:

说真的,快去试一试。你做实验的时候,我会等着你的。

完成了?不错!现在我们来讨论一下它实际上是怎么工作的。

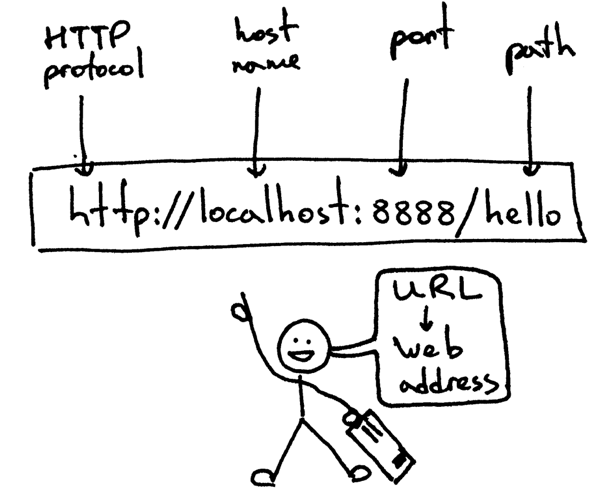
首先我们从你刚刚输入的 Web 地址开始。它叫 URL,这是它的基本结构:

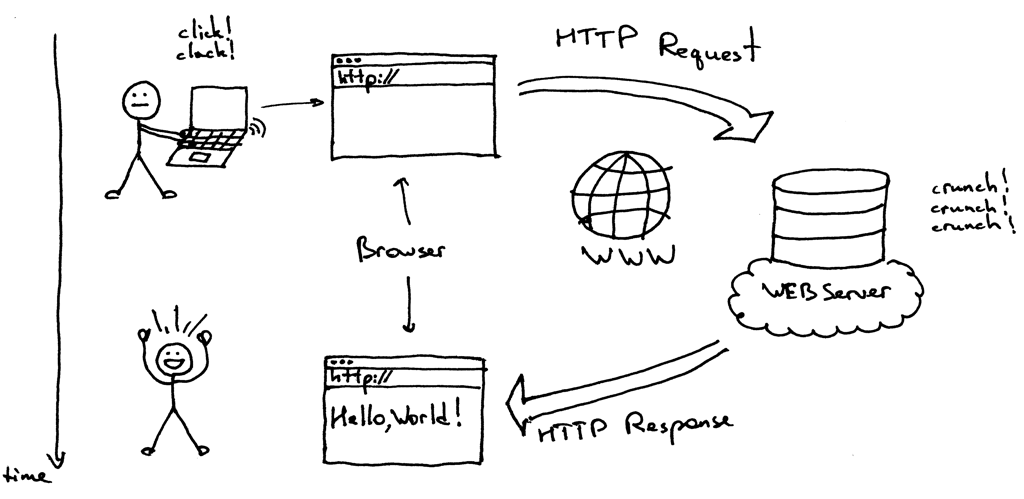
URL 是一个 Web 服务器的地址,浏览器用这个地址来寻找并连接 Web 服务器,并将上面的内容返回给你。在你的浏览器能够发送 HTTP 请求之前,它需要与 Web 服务器建立一个 TCP 连接。然后会在 TCP 连接中发送 HTTP 请求,并等待服务器返回 HTTP 响应。当你的浏览器收到响应后,就会显示其内容,在上面的例子中,它显示了“Hello, World!”。

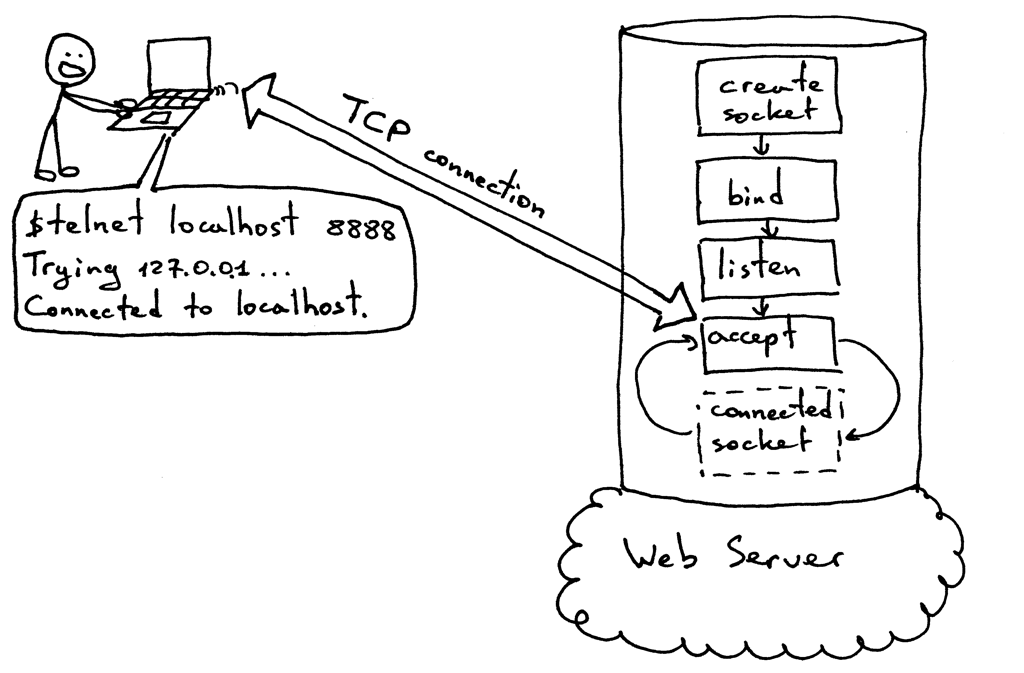
我们来进一步探索在发送 HTTP 请求之前,客户端与服务器建立 TCP 连接的过程。为了建立链接,它们使用了所谓“ 套接字 ( socket ) ”。我们现在不直接使用浏览器发送请求,而在命令行中使用 telnet 来人工模拟这个过程。

在你运行 Web 服务器的电脑上,在命令行中建立一个 telnet 会话,指定一个本地域名,使用端口 8888,然后按下回车:

$ telnet localhost 8888
Trying 127.0.0.1 …
Connected to localhost.

这个时候,你已经与运行在你本地主机的服务器建立了一个 TCP 连接。在下图中,你可以看到一个服务器从头开始,到能够建立 TCP 连接的基本过程。

在同一个 telnet 会话中,输入 GET /hello HTTP/1.1,然后输入回车:

$ telnet localhost 8888
Trying 127.0.0.1 …
Connected to localhost.
GET /hello HTTP/1.1

HTTP/1.1 200 OK
Hello, World!

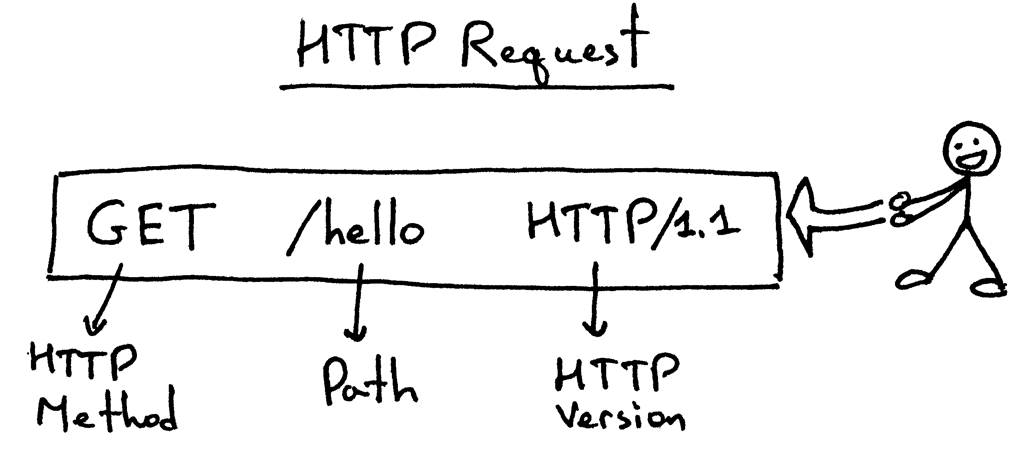
你刚刚手动模拟了你的浏览器(的工作)!你发送了 HTTP 请求,并且收到了一个 HTTP 应答。下面是一个 HTTP 请求的基本结构:

HTTP 请求的第一行由三部分组成:HTTP 方法(GET,因为我们想让我们的服务器返回一些内容),以及标明所需页面的路径 /hello,还有协议版本。

为了简单一些,我们刚刚构建的 Web 服务器完全忽略了上面的请求内容。你也可以试着输入一些无用内容而不是“GET /hello HTTP/1.1”,但你仍然会收到一个“Hello, World!”响应。

一旦你输入了请求行并敲了回车,客户端就会将请求发送至服务器;服务器读取请求行,就会返回相应的 HTTP 响应。

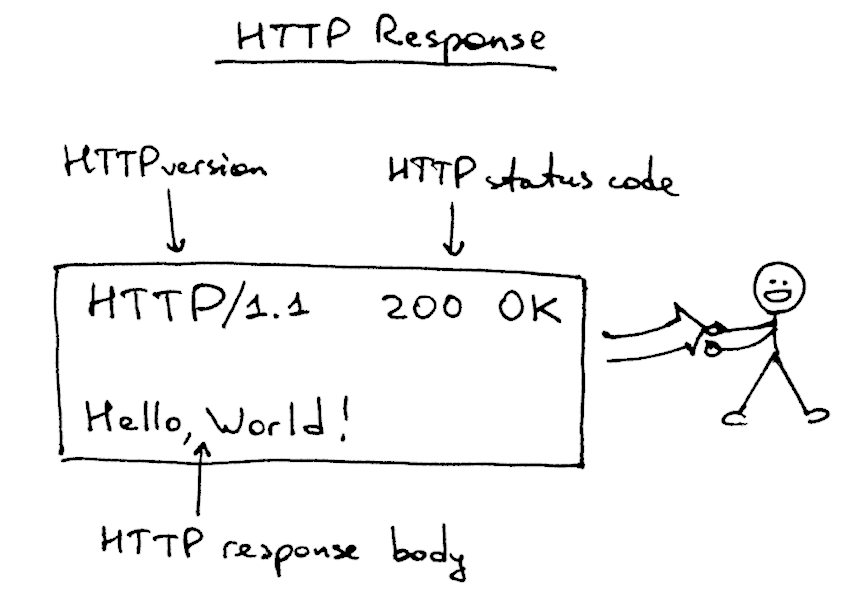
下面是服务器返回客户端(在上面的例子里是 telnet)的响应内容:

我们来解析它。这个响应由三部分组成:一个状态行 HTTP/1.1 200 OK,后面跟着一个空行,再下面是响应正文。

HTTP 响应的状态行 HTTP/1.1 200 OK 包含了 HTTP 版本号,HTTP 状态码以及 HTTP 状态短语“OK”。当浏览器收到响应后,它会将响应正文显示出来,这也就是为什么你会在浏览器中看到“Hello, World!”。

以上就是 Web 服务器的基本工作模型。总结一下:Web 服务器创建一个处于监听状态的套接字,循环接收新的连接。客户端建立 TCP 连接成功后,会向服务器发送 HTTP 请求,然后服务器会以一个 HTTP 响应做应答,客户端会将 HTTP 的响应内容显示给用户。为了建立 TCP 连接,客户端和服务端均会使用套接字。

现在,你应该了解了 Web 服务器的基本工作方式,你可以使用浏览器或其它 HTTP 客户端进行试验。如果你尝试过、观察过,你应该也能够使用 telnet,人工编写 HTTP 请求,成为一个“人形” HTTP 客户端。

现在留一个小问题:“你要如何在不对程序做任何改动的情况下,在你刚刚搭建起来的 Web 服务器上适配 Django, Flask 或 Pyramid 应用呢?”

我会在本系列的第二部分中来详细讲解。敬请期待。

顺便,我在撰写一本名为《搭个 Web 服务器:从头开始》的书。这本书讲解了如何从头开始编写一个基本的 Web 服务器,里面包含本文中没有的更多细节。订阅邮件列表,你就可以获取到这本书的最新进展,以及发布日期。

via: https://ruslanspivak.com/lsbaws-part1/

作者:Ruslan 译者:StdioA 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

提高 web 应用的性能从来没有比现在更重要过。网络经济的比重一直在增长;全球经济超过 5% 的价值是在因特网上产生的(数据参见下面的资料)。这个时刻在线的超连接世界意味着用户对其的期望值也处于历史上的最高点。如果你的网站不能及时的响应,或者你的 app 不能无延时的工作,用户会很快的投奔到你的竞争对手那里。

举一个例子,一份亚马逊十年前做过的研究可以证明,甚至在那个时候,网页加载时间每减少100毫秒,收入就会增加1%。另一个最近的研究特别强调一个事实,即超过一半的网站拥有者在调查中承认它们会因为应用程序性能的问题流失用户。

网站到底需要多快呢?对于页面加载,每增加1秒钟就有4%的用户放弃使用。顶级的电子商务站点的页面在第一次交互时可以做到1秒到3秒加载时间,而这是提供最高舒适度的速度。很明显这种利害关系对于 web 应用来说很高,而且在不断的增加。

想要提高效率很简单,但是看到实际结果很难。为了在你的探索之旅上帮助到你,这篇文章会给你提供10条最高可以提升10倍网站性能的建议。这是一系列介绍提高应用程序性能的第一篇文章,包括充分测试的优化技术和一点 NGINX 的帮助。这个系列也给出了潜在的提高安全性的帮助。

Tip #1: 通过反向代理来提高性能和增加安全性

如果你的 web 应用运行在单个机器上,那么这个办法会明显的提升性能:只需要换一个更快的机器,更好的处理器,更多的内存,更快的磁盘阵列,等等。然后新机器就可以更快的运行你的 WordPress 服务器, Node.js 程序, Java 程序,以及其它程序。(如果你的程序要访问数据库服务器,那么解决方法依然很简单:添加两个更快的机器,以及在两台电脑之间使用一个更快的链路。)

问题是,机器速度可能并不是问题。web 程序运行慢经常是因为计算机一直在不同的任务之间切换:通过成千上万的连接和用户交互,从磁盘访问文件,运行代码,等等。应用服务器可能会 抖动 ( thrashing ) -比如说内存不足、将内存数据交换到磁盘,以及有多个请求要等待某个任务完成,如磁盘I/O。

你可以采取一个完全不同的方案来替代升级硬件:添加一个反向代理服务器来分担部分任务。反向代理服务器 位于运行应用的机器的前端,是用来处理网络流量的。只有反向代理服务器是直接连接到互联网的;和应用服务器的通讯都是通过一个快速的内部网络完成的。

使用反向代理服务器可以将应用服务器从等待用户与 web 程序交互解放出来,这样应用服务器就可以专注于为反向代理服务器构建网页,让其能够传输到互联网上。而应用服务器就不需要等待客户端的响应,其运行速度可以接近于优化后的性能水平。

添加反向代理服务器还可以给你的 web 服务器安装带来灵活性。比如,一个某种类型的服务器已经超载了,那么就可以轻松的添加另一个相同的服务器;如果某个机器宕机了,也可以很容易替代一个新的。

因为反向代理带来的灵活性,所以反向代理也是一些性能加速功能的必要前提,比如:

  • 负载均衡 (参见 Tip #2) – 负载均衡运行在反向代理服务器上,用来将流量均衡分配给一批应用。有了合适的负载均衡,你就可以添加应用服务器而根本不用修改应用。
  • 缓存静态文件 (参见 Tip #3) – 直接读取的文件,比如图片或者客户端代码,可以保存在反向代理服务器,然后直接发给客户端,这样就可以提高速度、分担应用服务器的负载,可以让应用运行的更快。
  • 网站安全 – 反向代理服务器可以提高网站安全性,以及快速的发现和响应攻击,保证应用服务器处于被保护状态。

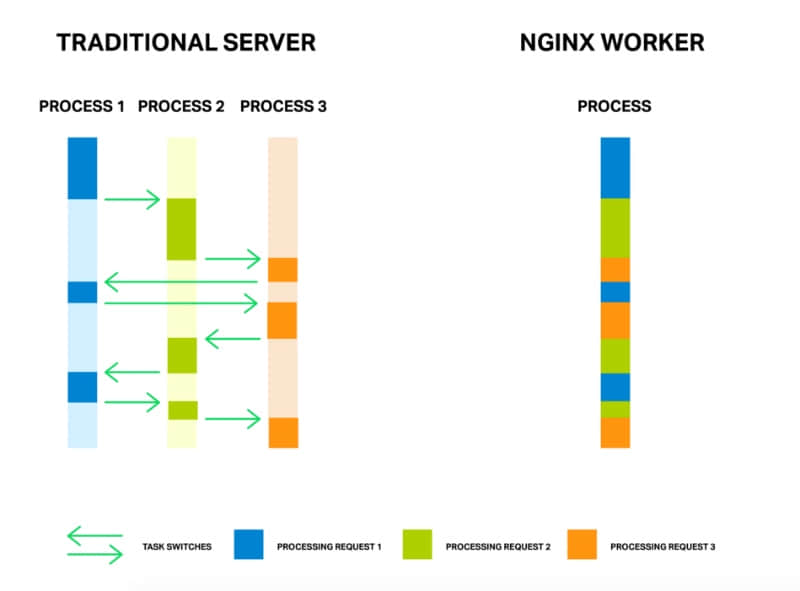
NGINX 软件为用作反向代理服务器而专门设计,也包含了上述的多种功能。NGINX 使用事件驱动的方式处理请求,这会比传统的服务器更加有效率。NGINX plus 添加了更多高级的反向代理特性,比如应用的健康度检查,专门用来处理请求路由、高级缓冲和相关支持。

NGINX Worker Process helps increase application performance

Tip #2: 添加负载平衡

添加一个负载均衡服务器 是一个相当简单的用来提高性能和网站安全性的的方法。与其将核心 Web 服务器变得越来越大和越来越强,不如使用负载均衡将流量分配到多个服务器。即使程序写的不好,或者在扩容方面有困难,仅是使用负载均衡服务器就可以很好的提高用户体验。

负载均衡服务器首先是一个反向代理服务器(参见Tip #1)——它接受来自互联网的流量,然后转发请求给另一个服务器。特别是负载均衡服务器支持两个或多个应用服务器,使用分配算法将请求转发给不同服务器。最简单的负载均衡方法是 轮转法 ( round robin ) ,每个新的请求都会发给列表里的下一个服务器。其它的复制均衡方法包括将请求发给活动连接最少的服务器。NGINX plus 拥有将特定用户的会话分配给同一个服务器的能力。

负载均衡可以很好的提高性能是因为它可以避免某个服务器过载而另一些服务器却没有需要处理的流量。它也可以简单的扩展服务器规模,因为你可以添加多个价格相对便宜的服务器并且保证它们被充分利用了。

可以进行负载均衡的协议包括 HTTP、HTTPS、SPDY、HTTP/2、WebSocket、FastCGI、SCGI、uwsgi、 memcached 等,以及几种其它的应用类型,包括基于 TCP 的应用和其它的第4层协议的程序。分析你的 web 应用来决定你要使用哪些以及哪些地方性能不足。

相同的服务器或服务器群可以被用来进行负载均衡,也可以用来处理其它的任务,如 SSL 末端服务器,支持客户端的 HTTP/1.x 和 HTTP/2 请求,以及缓存静态文件。

NGINX 经常被用于进行负载均衡;要想了解更多的情况,可以下载我们的电子书《选择软件负载均衡器的五个理由》。你也可以从 《使用 NGINX 和 NGINX Plus 配置负载均衡,第一部分》中了解基本的配置指导,在 NGINX Plus 管理员指南中有完整的 NGINX 负载均衡的文档。。我们的商业版本 NGINX Plus 支持更多优化了的负载均衡特性,如基于服务器响应时间的加载路由和 Microsoft’s NTLM 协议上的负载均衡。

Tip #3: 缓存静态和动态的内容

缓存可以通过加速内容的传输速度来提高 web 应用的性能。它可以采用以下几种策略:当需要的时候预处理要传输的内容,保存数据到速度更快的设备,把数据存储在距离客户端更近的位置,或者将这几种方法结合起来使用。

有两种不同类型数据的缓冲:

  • 静态内容缓存。不经常变化的文件,比如图像(JPEG、PNG) 和代码(CSS,JavaScript),可以保存在外围服务器上,这样就可以快速的从内存和磁盘上提取。
  • 动态内容缓存。很多 web 应用会针对每次网页请求生成一个新的 HTML 页面。在短时间内简单的缓存生成的 HTML 内容,就可以很好的减少要生成的内容的数量,而且这些页面足够新,可以满足你的需要。

举个例子,如果一个页面每秒会被浏览10次,你将它缓存 1 秒,90%请求的页面都会直接从缓存提取。如果你分开缓存静态内容,甚至新生成的页面可能都是由这些缓存构成的。

下面由是 web 应用发明的三种主要的缓存技术:

  • 缩短数据与用户的网络距离。把一份内容的拷贝放的离用户更近的节点来减少传输时间。
  • 提高内容服务器的速度。内容可以保存在一个更快的服务器上来减少提取文件的时间。
  • 从过载服务器上移走数据。机器经常因为要完成某些其它的任务而造成某个任务的执行速度比测试结果要差。将数据缓存在不同的机器上可以提高缓存资源和非缓存资源的性能,而这是因为主机没有被过度使用。

对 web 应用的缓存机制可以在 web 应用服务器内部实现。首先,缓存动态内容是用来减少应用服务器加载动态内容的时间。其次,缓存静态内容(包括动态内容的临时拷贝)是为了更进一步的分担应用服务器的负载。而且缓存之后会从应用服务器转移到对用户而言更快、更近的机器,从而减少应用服务器的压力,减少提取数据和传输数据的时间。

改进过的缓存方案可以极大的提高应用的速度。对于大多数网页来说,静态数据,比如大图像文件,构成了超过一半的内容。如果没有缓存,那么这可能会花费几秒的时间来提取和传输这类数据,但是采用了缓存之后不到1秒就可以完成。

举一个在实际中缓存是如何使用的例子, NGINX 和 NGINX Plus 使用了两条指令来设置缓存机制:proxy\_cache\_path 和 proxy\_cache。你可以指定缓存的位置和大小、文件在缓存中保存的最长时间和其它一些参数。使用第三条(而且是相当受欢迎的一条)指令 proxy\_cache\_use\_stale,如果提供新鲜内容的服务器忙碌或者挂掉了,你甚至可以让缓存提供较旧的内容,这样客户端就不会一无所得。从用户的角度来看这可以很好的提高你的网站或者应用的可用时间。

NGINX plus 有个高级缓存特性,包括对缓存清除的支持和在仪表盘上显示缓存状态信息。

要想获得更多关于 NGINX 的缓存机制的信息可以浏览 NGINX Plus 管理员指南中的《参考文档》和《NGINX 内容缓存》。

注意:缓存机制分布于应用开发者、投资决策者以及实际的系统运维人员之间。本文提到的一些复杂的缓存机制从 DevOps 的角度来看很具有价值,即对集应用开发者、架构师以及运维操作人员的功能为一体的工程师来说可以满足它们对站点功能性、响应时间、安全性和商业结果(如完成的交易数)等需要。

Tip #4: 压缩数据

压缩是一个具有很大潜力的提高性能的加速方法。现在已经有一些针对照片(JPEG 和PNG)、视频(MPEG-4)和音乐(MP3)等各类文件精心设计和高压缩率的标准。每一个标准都或多或少的减少了文件的大小。

文本数据 —— 包括HTML(包含了纯文本和 HTML 标签),CSS 和代码,比如 Javascript —— 经常是未经压缩就传输的。压缩这类数据会在对应用程序性能的感觉上,特别是处于慢速或受限的移动网络的客户端,产生更大的影响。

这是因为文本数据经常是用户与网页交互的有效数据,而多媒体数据可能更多的是起提供支持或者装饰的作用。智能的内容压缩可以减少 HTML,Javascript,CSS和其它文本内容对带宽的要求,通常可以减少 30% 甚至更多的带宽和相应的页面加载时间。

如果你使用 SSL,压缩可以减少需要进行 SSL 编码的的数据量,而这些编码操作会占用一些 CPU 时间而抵消了压缩数据减少的时间。

压缩文本数据的方法很多,举个例子,在 HTTP/2 中,小说文本的压缩模式就特别调整了头部数据。另一个例子是可以在 NGINX 里打开使用 GZIP 压缩。你在你的服务里预先压缩文本数据之后,你就可以直接使用 gzip\_static 指令来处理压缩过的 .gz 版本。

Tip #5: 优化 SSL/TLS

安全套接字(SSL) 协议和它的下一代版本传输层安全(TLS)协议正在被越来越多的网站采用。SSL/TLS 对从原始服务器发往用户的数据进行加密提高了网站的安全性。影响这个趋势的部分原因是 Google 正在使用 SSL/TLS,这在搜索引擎排名上是一个正面的影响因素。

尽管 SSL/TLS 越来越流行,但是使用加密对速度的影响也让很多网站望而却步。SSL/TLS 之所以让网站变的更慢,原因有二:

  1. 任何一个连接第一次连接时的握手过程都需要传递密钥。而采用 HTTP/1.x 协议的浏览器在建立多个连接时会对每个连接重复上述操作。
  2. 数据在传输过程中需要不断的在服务器端加密、在客户端解密。

为了鼓励使用 SSL/TLS,HTTP/2 和 SPDY(在下一章会描述)的作者设计了新的协议来让浏览器只需要对一个浏览器会话使用一个连接。这会大大的减少上述第一个原因所浪费的时间。然而现在可以用来提高应用程序使用 SSL/TLS 传输数据的性能的方法不止这些。

web 服务器有对应的机制优化 SSL/TLS 传输。举个例子,NGINX 使用 OpenSSL 运行在普通的硬件上提供了接近专用硬件的传输性能。NGINX 的 SSL 性能 有详细的文档,而且把对 SSL/TLS 数据进行加解密的时间和 CPU 占用率降低了很多。

更进一步,参考这篇文章了解如何提高 SSL/TLS 性能的更多细节,可以总结为一下几点:

  • 会话缓冲。使用指令 ssl\_session\_cache 可以缓存每个新的 SSL/TLS 连接使用的参数。
  • 会话票据或者 ID。把 SSL/TLS 的信息保存在一个票据或者 ID 里可以流畅的复用而不需要重新握手。
  • OCSP 分割。通过缓存 SSL/TLS 证书信息来减少握手时间。

NGINX 和 NGINX Plus 可以被用作 SSL/TLS 服务端,用于处理客户端流量的加密和解密,而同时以明文方式和其它服务器进行通信。要设置 NGINX 和 NGINX Plus 作为 SSL/TLS 服务端,参看 《HTTPS 连接》 和《加密的 TCP 连接》。

Tip #6: 使用 HTTP/2 或 SPDY

对于已经使用了 SSL/TLS 的站点,HTTP/2 和 SPDY 可以很好的提高性能,因为每个连接只需要一次握手。而对于没有使用 SSL/TLS 的站点来说,从响应速度的角度来说 HTTP/2 和 SPDY 将让迁移到 SSL/TLS 没有什么压力(原本会降低效率)。

Google 在2012年开始把 SPDY 作为一个比 HTTP/1.x 更快速的协议来推荐。HTTP/2 是目前 IETF 通过的标准,是基于 SPDY 的。SPDY 已经被广泛的支持了,但是很快就会被 HTTP/2 替代。

SPDY 和 HTTP/2 的关键是用单一连接来替代多路连接。单个连接是被复用的,所以它可以同时携带多个请求和响应的分片。

通过使用单一连接,这些协议可以避免像在实现了 HTTP/1.x 的浏览器中一样建立和管理多个连接。单一连接在对 SSL 特别有效,这是因为它可以最小化 SSL/TLS 建立安全链接时的握手时间。

SPDY 协议需要使用 SSL/TLS,而 HTTP/2 官方标准并不需要,但是目前所有支持 HTTP/2 的浏览器只有在启用了 SSL/TLS 的情况下才能使用它。这就意味着支持 HTTP/2 的浏览器只有在网站使用了 SSL 并且服务器接收 HTTP/2 流量的情况下才会启用 HTTP/2。否则的话浏览器就会使用 HTTP/1.x 协议。

当你实现 SPDY 或者 HTTP/2 时,你不再需要那些常规的 HTTP 性能优化方案,比如按域分割、资源聚合,以及图像拼合。这些改变可以让你的代码和部署变得更简单和更易于管理。要了解 HTTP/2 带来的这些变化可以浏览我们的《白皮书》。

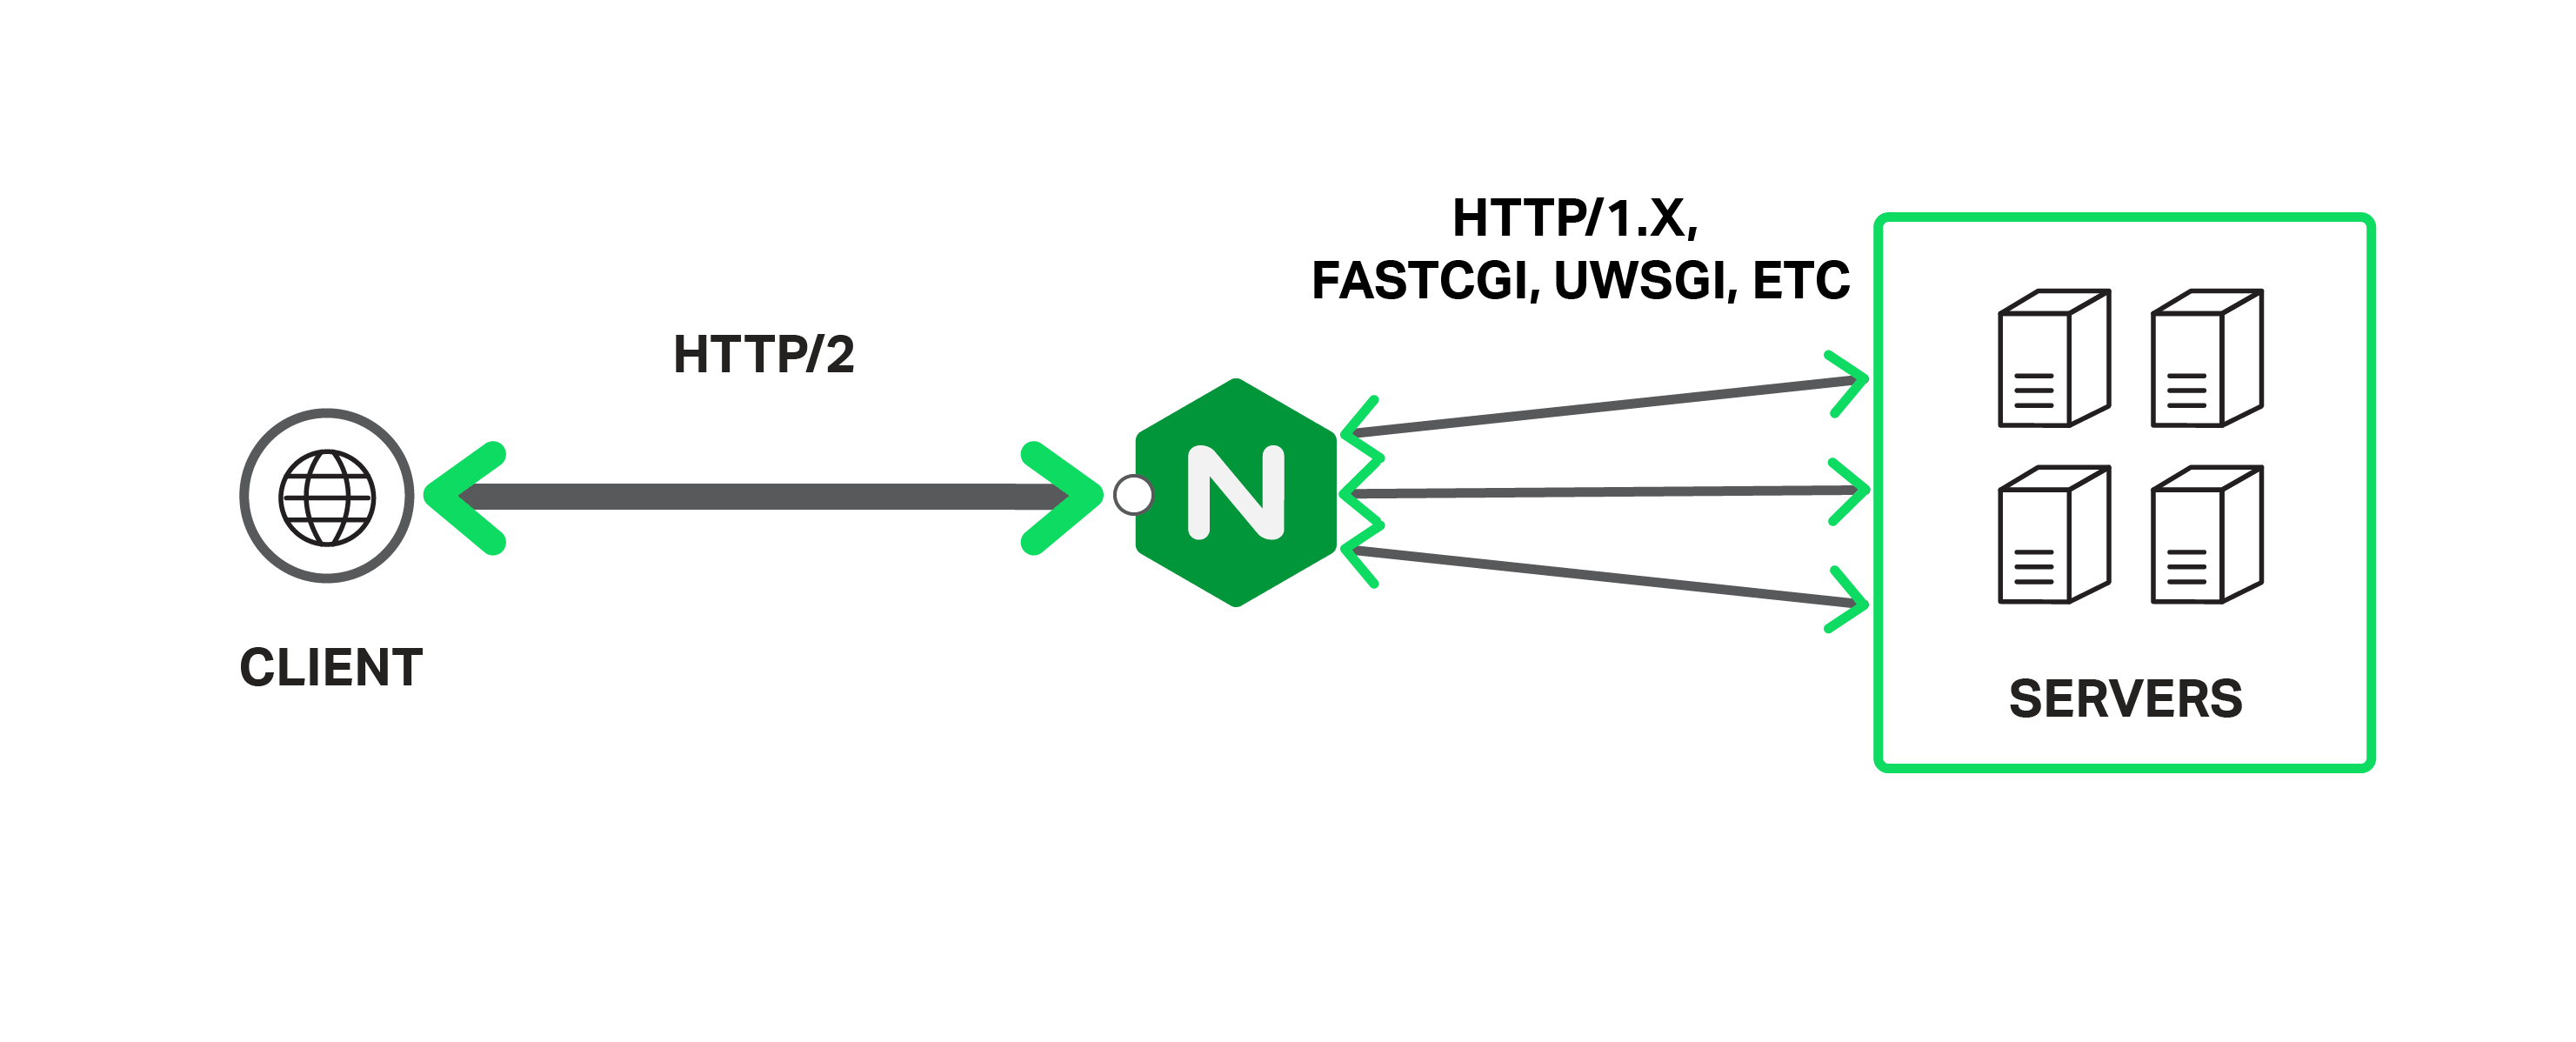
NGINX Supports SPDY and HTTP/2 for increased web application performance

作为支持这些协议的一个样例,NGINX 已经从一开始就支持了 SPDY,而且大部分使用 SPDY 协议的网站都运行的是 NGINX。NGINX 同时也很早对 HTTP/2 的提供了支持,从2015 年9月开始,开源版 NGINX 和 NGINX Plus 就支持它了。

经过一段时间,我们 NGINX 希望更多的站点完全启用 SSL 并且向 HTTP/2 迁移。这将会提高安全性,同时也会找到并实现新的优化手段,简化的代码表现的会更加优异。

Tip #7: 升级软件版本

一个提高应用性能的简单办法是根据软件的稳定性和性能的评价来选在你的软件栈。进一步说,因为高性能组件的开发者更愿意追求更高的性能和解决 bug ,所以值得使用最新版本的软件。新版本往往更受开发者和用户社区的关注。更新的版本往往会利用到新的编译器优化,包括对新硬件的调优。

稳定的新版本通常比旧版本具有更好的兼容性和更高的性能。一直进行软件更新,可以非常简单的保持软件保持最佳的优化,解决掉 bug,以及提高安全性。

一直使用旧版软件也会阻止你利用新的特性。比如上面说到的 HTTP/2,目前要求 OpenSSL 1.0.1。在2016 年中期开始将会要求1.0.2 ,而它是在2015年1月才发布的。

NGINX 用户可以开始迁移到 NGINX 最新的开源软件 或者 NGINX Plus;它们都包含了最新的能力,如 socket 分割和线程池(见下文),这些都已经为性能优化过了。然后好好看看的你软件栈,把它们升级到你能升级到的最新版本吧。

Tip #8: Linux 系统性能调优

Linux 是大多数 web 服务器使用的操作系统,而且作为你的架构的基础,Linux 显然有不少提高性能的可能。默认情况下,很多 Linux 系统都被设置为使用很少的资源,以符合典型的桌面应用使用。这就意味着 web 应用需要一些微调才能达到最大效能。

这里的 Linux 优化是专门针对 web 服务器方面的。以 NGINX 为例,这里有一些在加速 Linux 时需要强调的变化:

  • 缓冲队列。如果你有挂起的连接,那么你应该考虑增加 net.core.somaxconn 的值,它代表了可以缓存的连接的最大数量。如果连接限制太小,那么你将会看到错误信息,而你可以逐渐的增加这个参数直到错误信息停止出现。
  • 文件描述符。NGINX 对一个连接使用最多2个文件描述符。如果你的系统有很多连接请求,你可能就需要提高sys.fs.file\_max ,以增加系统对文件描述符数量整体的限制,这样才能支持不断增加的负载需求。
  • 临时端口。当使用代理时,NGINX 会为每个上游服务器创建临时端口。你可以设置net.ipv4.ip\_local\_port\_range 来提高这些端口的范围,增加可用的端口号。你也可以减少非活动的端口的超时判断来重复使用端口,这可以通过 net.ipv4.tcp\_fin\_timeout 来设置,这可以快速的提高流量。

对于 NGINX 来说,可以查阅 《NGINX 性能调优指南》来学习如果优化你的 Linux 系统,这样它就可以很好的适应大规模网络流量而不会超过工作极限。

Tip #9: web 服务器性能调优

无论你是用哪种 web 服务器,你都需要对它进行优化来提高性能。下面的推荐手段可以用于任何 web 服务器,但是一些设置是针对 NGINX 的。关键的优化手段包括:

  • 访问日志。不要把每个请求的日志都直接写回磁盘,你可以在内存将日志缓存起来然后批量写回磁盘。对于NGINX 来说,给指令 access\_log 添加参数 buffer=size 可以让系统在缓存满了的情况下才把日志写到磁盘。如果你添加了参数 flush=time ,那么缓存内容会每隔一段时间再写回磁盘。
  • 缓存。缓存会在内存中存放部分响应,直到满了为止,这可以让与客户端的通信更加高效。内存放不下的响应会写回磁盘,而这就会降低效能。当 NGINX 启用了缓存机制后,你可以使用指令 proxy\_buffer\_size 和 proxy\_buffers 来管理缓存。
  • 客户端保活。保活连接可以减少开销,特别是使用 SSL/TLS 时。对于 NGINX 来说,你可以从 keepalive\_requests 的默认值 100 开始增加最大连接数,这样一个客户端就可以在一个指定的连接上请求多次,而且你也可以通过增加 keepalive\_timeout 的值来允许保活连接存活更长时间,这样就可以让后来的请求处理的更快速。
  • 上游保活。上游的连接——即连接到应用服务器、数据库服务器等机器的连接——同样也会受益于连接保活。对于上游连接来说,你可以增加 keepalive,即每个工人进程的空闲保活连接个数。这就可以提高连接的复用次数,减少需要重新打开全新连接的次数。更多关于保活连接的信息可以参见这篇“ HTTP 保活连接和性能”。
  • 限制。限制客户端使用的资源可以提高性能和安全性。对于 NGINX 来说,指令 limit\_conn 和 limit\_conn\_zone 限制了给定来源的连接数量,而 limit\_rate 限制了带宽。这些限制都可以阻止合法用户扒取资源,同时也避免了攻击。指令 limit\_req 和 limit\_req\_zone 限制了客户端请求。对于上游服务器来说,可以在 upstream 的配置块里的 server 指令使用 max\_conns 参数来限制连接到上游服务器的连接数。 这样可以避免服务器过载。关联的 queue 指令会创建一个队列来在连接数抵达 max\_connS 限制时在指定长度的时间内保存特定数量的请求。
  • 工人进程。工人进程负责处理请求。NGINX 采用事件驱动模型和操作系统特定的机制来有效的将请求分发给不同的工人进程。这条建议推荐设置 worker\_processes 为每个 CPU 一个 。worker\_connections 的最大数(默认512)可以在大部分系统上根据需要增加,实验性地找到最适合你的系统的值。
  • 套接字分割。通常一个套接字监听器会把新连接分配给所有工人进程。套接字分割会为每个工人进程创建一个套接字监听器,这样一来以当套接字监听器可用时,内核就会将连接分配给它。这可以减少锁竞争,并且提高多核系统的性能,要启用套接字分隔需要在 listen 指令里面加上 reuseport 参数。
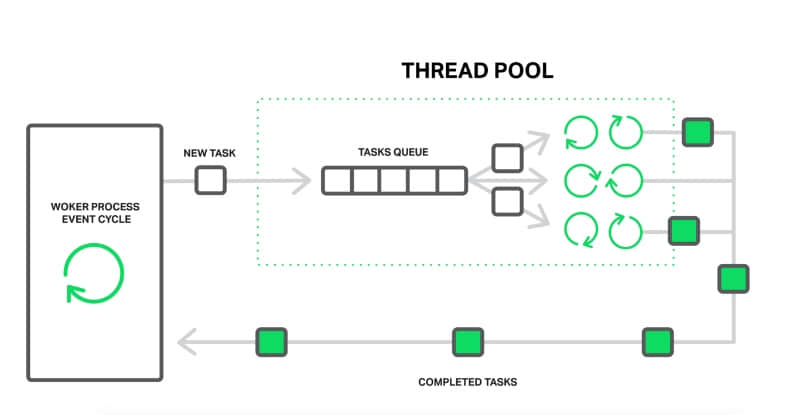
  • 线程池。计算机进程可能被一个单一的缓慢的操作所占用。对于 web 服务器软件来说,磁盘访问会影响很多更快的操作,比如计算或者在内存中拷贝。使用了线程池之后慢操作可以分配到不同的任务集,而主进程可以一直运行快速操作。当磁盘操作完成后结果会返回给主进程的循环。在 NGINX 里有两个操作——read() 系统调用和 sendfile() ——被分配到了线程池

Thread pools help increase application performance by assigning a slow operation to a separate set of tasks

技巧。当改变任何操作系统或支持服务的设置时,一次只改变一个参数然后测试性能。如果修改引起问题了,或者不能让你的系统更快,那么就改回去。

在《调优 NGINX 性能》里可以看到更详细的 NGINX 调优方法。

Tip #10: 监视系统活动来解决问题和瓶颈

在应用开发中要使得系统变得非常高效的关键是监视你的系统在现实世界运行的性能。你必须能通过特定的设备和你的 web 基础设施上监控程序活动。

监视活动是最积极的——它会告诉你发生了什么,把问题留给你发现和最终解决掉。

监视可以发现几种不同的问题。它们包括:

  • 服务器宕机。
  • 服务器出问题一直在丢失连接。
  • 服务器出现大量的缓存未命中。
  • 服务器没有发送正确的内容。

应用的总体性能监控工具,比如 New Relic 和 Dynatrace,可以帮助你监控到从远程加载网页的时间,而 NGINX 可以帮助你监控到应用交付端。当你需要考虑为基础设施添加容量以满足流量需求时,应用性能数据可以告诉你你的优化措施的确起作用了。

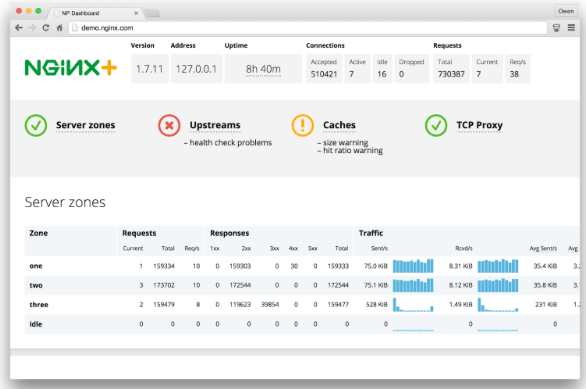
为了帮助开发者快速的发现、解决问题,NGINX Plus 增加了应用感知健康度检查 ——对重复出现的常规事件进行综合分析并在问题出现时向你发出警告。NGINX Plus 同时提供会话过滤功能,这可以阻止当前任务完成之前接受新的连接,另一个功能是慢启动,允许一个从错误恢复过来的服务器追赶上负载均衡服务器群的进度。当使用得当时,健康度检查可以让你在问题变得严重到影响用户体验前就发现它,而会话过滤和慢启动可以让你替换服务器,并且这个过程不会对性能和正常运行时间产生负面影响。下图就展示了内建的 NGINX Plus 模块实时活动监视的仪表盘,包括了服务器群,TCP 连接和缓存信息等 Web 架构信息。

Use real-time application performance monitoring tools to identify and resolve issues quickly

总结: 看看10倍性能提升的效果

这些性能提升方案对任何一个 web 应用都可用并且效果都很好,而实际效果取决于你的预算、你能花费的时间、目前实现方案的差距。所以你该如何对你自己的应用实现10倍性能提升?

为了指导你了解每种优化手段的潜在影响,这里是上面详述的每个优化方法的关键点,虽然你的情况肯定大不相同:

  • 反向代理服务器和负载均衡。没有负载均衡或者负载均衡很差都会造成间歇的性能低谷。增加一个反向代理,比如 NGINX ,可以避免 web 应用程序在内存和磁盘之间波动。负载均衡可以将过载服务器的任务转移到空闲的服务器,还可以轻松的进行扩容。这些改变都可以产生巨大的性能提升,很容易就可以比你现在的实现方案的最差性能提高10倍,对于总体性能来说可能提高的不多,但是也是有实质性的提升。
  • 缓存动态和静态数据。如果你有一个负担过重的 web 服务器,那么毫无疑问肯定是你的应用服务器,只通过缓存动态数据就可以在峰值时间提高10倍的性能。缓存静态文件可以提高几倍的性能。
  • 压缩数据。使用媒体文件压缩格式,比如图像格式 JPEG,图形格式 PNG,视频格式 MPEG-4,音乐文件格式 MP3 可以极大的提高性能。一旦这些都用上了,然后压缩文件数据可以将初始页面加载速度提高两倍。
  • 优化 SSL/TLS。安全握手会对性能产生巨大的影响,对它们的优化可能会对初始响应产生2倍的提升,特别是对于大量文本的站点。优化 SSL/TLS 下媒体文件只会产生很小的性能提升。
  • 使用 HTTP/2 和 SPDY。当你使用了 SSL/TLS,这些协议就可以提高整个站点的性能。
  • 对 Linux 和 web 服务器软件进行调优。比如优化缓存机制,使用保活连接,分配时间敏感型任务到不同的线程池可以明显的提高性能;举个例子,线程池可以加速对磁盘敏感的任务近一个数量级。

我们希望你亲自尝试这些技术。我们希望知道你说取得的各种性能提升案例。请在下面评论栏分享你的结果或者在标签 #NGINX 和 #webperf 下 tweet 你的故事。

网上资源


via: https://www.nginx.com/blog/10-tips-for-10x-application-performance/

作者:Floyd Smith 译者:Ezio 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出