标签 机器学习 下的文章

本文将帮助你理解 情感分析 sentiment analysis 的概念,并且学习如何使用机器学习进行情感分析。我们使用了不同的机器学习算法进行情感分析,然后将各个算法的准确率结果进行比较,以确定哪一种算法最适合这个问题。

情感分析是自然语言处理(NLP)中的一个重要的内容。情感指的是我们对某一事件、物品、情况或事物产生的感觉。情感分析是一个从文本中自动提取人类情感的研究领域。它在上世纪 90 年代初才慢慢地开始发展起来。

本文将让你明白如何将机器学习(ML)用于情感分析,并比较不同机器学习算法的结果。本文的目标不在于研究如何提高算法性能。

如今,我们生活在一个快节奏的社会中,所有的商品都能在网上购买到,每个人都可以在网上发表自己的评论。而一些商品的负面网络评论可能会损害公司的声誉,从而影响公司的销售额。因此对公司来说,通过商品评论来了解客户真正想要什么变得非常重要。但是这些评论数据太多了,无法一个个地手动查看所有的评论。这就是情绪分析诞生的缘由。

现在,就让我们看看如何用机器学习开发一个模型,来进行基本的情绪分析吧。

现在就开始吧!

获取数据

第一步是选择一个数据集。你可以从任何公开的评论中进行选择,例如推文或电影评论。数据集中至少要包含两列:标签和实际的文本段。

下图显示了我们选取的部分数据集。
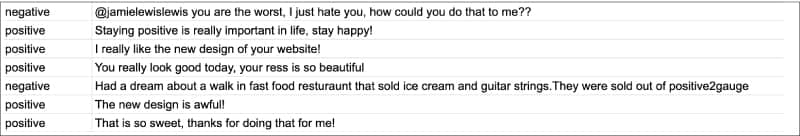
Figure 1: Data sample

接下来,我们导入所需的库:

import pandas as pd
import numpy as np
from nltk.stem.porter import PorterStemmer
import re
import string

正如你在上面代码看到,我们导入了 NumPy 和 Pandas 库来处理数据。至于其他库,我们会在使用到它们时再说明。

数据集已准备就绪,并且已导入所需的库。接着,我们需要用 Pandas 库将数据集读入到我们的项目中去。我们使用以下的代码将数据集读入 Pandas 数据帧 DataFrame 类型:

sentiment_dataframe = pd.read_csv(“/content/drive/MyDrive/Data/sentiments - sentiments.tsv”,sep = ‘\t’)

数据处理

现在我们的项目中已经导入好数据集了。然后,我们要对数据进行处理,以便算法可以更好地理解数据集的特征。我们首先为数据集中的列命名,通过下面的代码来完成:

sentiment_dataframe.columns = [“label”,”body_text”]

然后,我们对 label 列进行数值化:negative 的评论替换为 1,positive 的评论替换为 0。下图显示了经过基本修改后的 sentiment_dataframe 的值。
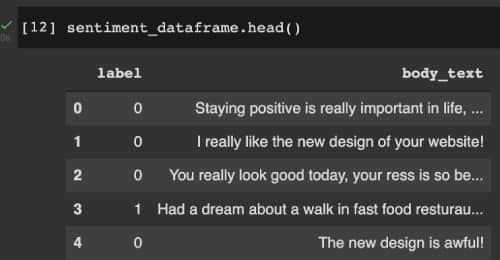
Figure 2: Data frame with basic modifications

准备好特征值、目标值

下一步是数据的预处理。这是非常重要的一步,因为机器学习算法只能理解/处理数值形数据,而不能理解文本,所以此时要进行特征抽取,将字符串/文本转换成数值化的数据。此外,还需要删除冗余和无用的数据,因为这些数据可能会污染我们的训练模型。我们在这一步中去除了噪声数据、缺失值数据和不一致的数据。

对于情感分析,我们在数据帧中添加特征文本的长度和标点符号计数。我们还要进行词干提取,即将所有相似词(如 “give”、“giving” 等)转换为单一形式。完成后,我们将数据集分为两部分:特征值 X 和 目标值 Y。

上述内容是使用以下代码完成的。下图显示了执行这些步骤后的数据帧。
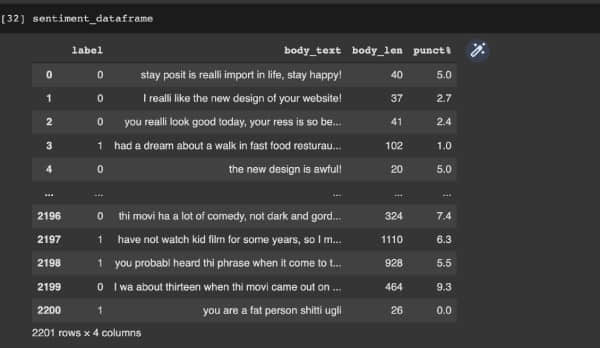
Figure 3: Data frame after the division of the data set

def count_punct(text):
   count = sum([1 for char in text if char in string.punctuation])
   return round(count/(len(text) - text.count(“ “)),3)*100
 
tokenized_tweet = sentiment_dataframe[‘body_text’].apply(lambda x: x.split())
stemmer = PorterStemmer()
tokenized_tweet = tokenized_tweet.apply(lambda x: [stemmer.stem(i) for i in x])
for i in range(len(tokenized_tweet)):
   tokenized_tweet[i] = ‘ ‘.join(tokenized_tweet[i])
sentiment_dataframe[‘body_text’] = tokenized_tweet
sentiment_dataframe[‘body_len’] = sentiment_dataframe[‘body_text’].apply(lambda x:len(x) - x.count(“ “))
sentiment_dataframe[‘punct%’] = sentiment_dataframe[‘body_text’].apply(lambda x:count_punct(x))
X = sentiment_dataframe[‘body_text’]
y = sentiment_dataframe[‘label’]

特征工程:文本特征处理

我们接下来进行文本特征抽取,对文本特征进行数值化。为此,我们使用 计数向量器 CountVectorizer ,它返回词频矩阵。

在此之后,计算数据帧 X 中的文本长度和标点符号计数等特征。X 的示例如下图所示。
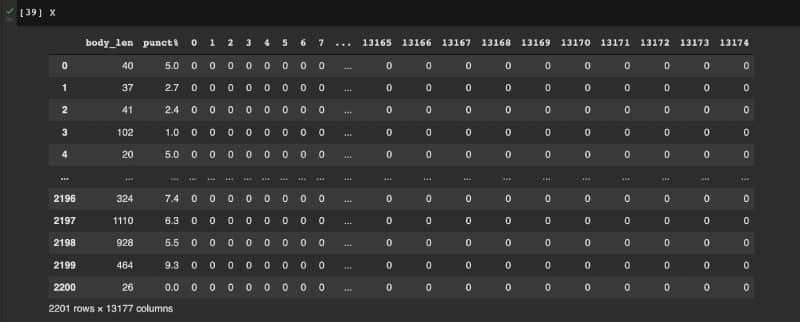
Figure 4: Sample of final features

使用的机器学习算法

现在数据已经可以训练了。下一步是确定使用哪些算法来训练模型。如前所述,我们将尝试多种机器学习算法,并确定最适合情感分析的算法。由于我们打算对文本进行二元分类,因此我们使用以下算法:

  • K-近邻算法(KNN)
  • 逻辑回归算法
  • 支持向量机(SVMs)
  • 随机梯度下降(SGD)
  • 朴素贝叶斯算法
  • 决策树算法
  • 随机森林算法

划分数据集

首先,将数据集划分为训练集和测试集。使用 sklearn 库,详见以下代码:

from sklearn.model_selection import train_test_split
X_train, X_test, y_train, y_test = train_test_split(X,y, test_size = 0.20, random_state = 99)

我们使用 20% 的数据进行测试,80% 的数据用于训练。划分数据的意义在于对一组新数据(即测试集)评估我们训练的模型是否有效。

K-近邻算法

现在,让我们开始训练第一个模型。首先,我们使用 KNN 算法。先训练模型,然后再评估模型的准确率(具体的代码都可以使用 Python 的 sklearn 库来完成)。详见以下代码,KNN 训练模型的准确率大约为 50%。

from sklearn.neighbors import KNeighborsClassifier
model = KNeighborsClassifier(n_neighbors=3)
model.fit(X_train, y_train)
model.score (X_test,y_test)

0.5056689342403629
逻辑回归算法

逻辑回归模型的代码十分类似——首先从库中导入函数,拟合模型,然后对模型进行评估。下面的代码使用逻辑回归算法,准确率大约为 66%。

from sklearn.linear_model import LogisticRegression
model = LogisticRegression()
model.fit (X_train,y_train)
model.score (X_test,y_test)

0.6621315192743764
支持向量机算法

以下代码使用 SVM,准确率大约为 67%。

from sklearn import svm
model = svm.SVC(kernel=’linear’)
model.fit(X_train, y_train)
model.score(X_test,y_test)

0.6780045351473923
随机森林算法

以下的代码使用了随机森林算法,随机森林训练模型的准确率大约为 69%。

from sklearn.ensemble import RandomForestClassifier
model = RandomForestClassifier()
model.fit(X_train, y_train)
model.score(X_test,y_test)

0.6938775510204082
决策树算法

接下来,我们使用决策树算法,其准确率约为 61%。

from sklearn.tree import DecisionTreeClassifier
model = DecisionTreeClassifier()
model = model.fit(X_train,y_train)
model.score(X_test,y_test)

0.6190476190476191
随机梯度下降算法

以下的代码使用随机梯度下降算法,其准确率大约为 49%。

from sklearn.linear_model import SGDClassifier
model = SGDClassifier()
model = model.fit(X_train,y_train)
model.score(X_test,y_test)

0.49206349206349204
朴素贝叶斯算法

以下的代码使用朴素贝叶斯算法,朴素贝叶斯训练模型的准确率大约为 60%。

from sklearn.naive_bayes import GaussianNB
model = GaussianNB()
model.fit(X_train, y_train)
model.score(X_test,y_test)

0.6009070294784581

情感分析的最佳算法

接下来,我们绘制所有算法的准确率图。如下图所示。
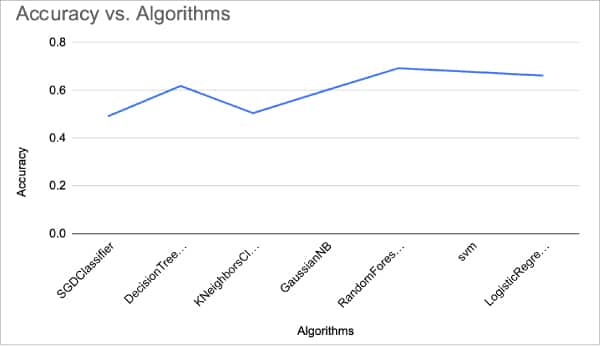
Figure 5: Accuracy performance of the different algorithms

可以看到,对于情感分析这一问题,随机森林算法有最佳的准确率。由此,我们可以得出结论,随机森林算法是所有机器算法中最适合情感分析的算法。我们可以通过处理得到更好的特征、尝试其他矢量化技术、或者使用更好的数据集或更好的分类算法,来进一步提高准确率。

既然,随机森林算法是解决情感分析问题的最佳算法,我将向你展示一个预处理数据的样本。在下图中,你可以看到模型会做出正确的预测!试试这个来改进你的项目吧!
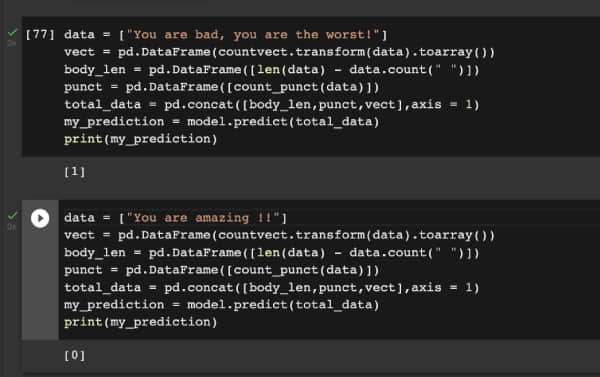
Figure 6: Sample predictions made


via: https://www.opensourceforu.com/2022/09/how-to-analyse-sentiments-using-machine-learning/

作者:Jishnu Saurav Mittapalli 选题:lkxed 译者:chai001125 校对:wxy
本文由 LCTT 原创编译,Linux中国 荣誉推出

机器学习基本上是人工智能的一个子集,它使用以前存在的数据对新数据进行预测。

当然,现在我们所有人都知道这个道理了!这篇文章展示了如何将 Python 中开发的机器学习模型作为 Java 代码的一部分来进行预测。

Machine-learning

本文假设你熟悉基本的开发技巧并理解机器学习。我们将从训练我们的模型开始,然后在 Python 中制作一个机器学习模型。

我以一个洪水预测模型为例。首先,导入以下库:

import pandas as pd
import numpy as np
import matplotlib.pyplot as plt

当我们成功地导入了这些库,我们就需要输入数据集,如下面的代码所示。为了预测洪水,我使用的是河流水位数据集。

from google.colab import files
uploaded = files.upload()
for fn in uploaded.keys(): 
    print('User uploaded file "{name}" with length {length} bytes'.format(name=fn, length=len(uploaded[fn])))

如果没有选择文件的话,选择上传的文件。

只有在当前浏览器会话中执行了该单元格时,上传部件才可用。请重新运行此单元,上传文件 Hoppers Crossing-Hourly-River-Level.csv,大小 2207036 字节。

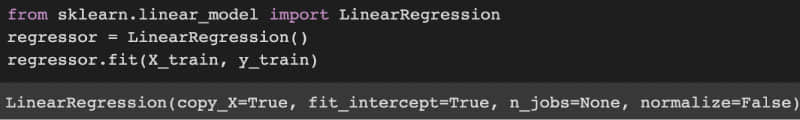
完成后,我们就可以使用 sklearn 库来训练我们的模型。为此,我们首先需要导入该库和算法模型,如图 1 所示。

Figure 1: Training the model

from sklearn.linear_model import LinearRegression
regressor = LinearRegression()
regressor.fit(X_train, y_train)

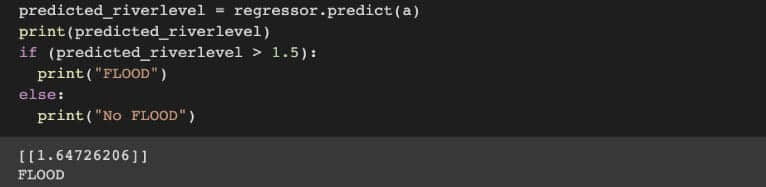
完成后,我们就训练好了我们的模型,现在可以进行预测了,如图 2 所示。

Figure 2: Making predictions

在 Java 中使用 ML 模型

我们现在需要做的是把 ML 模型转换成一个可以被 Java 程序使用的模型。有一个叫做 sklearn2pmml 的库可以帮助我们做到这一点:

# Install the library
pip install sklearn2pmml

库安装完毕后,我们就可以转换我们已经训练好的模型,如下图所示:

sklearn2pmml(pipeline, ‘model.pmml’, with_repr = True)

这就完成了!我们现在可以在我们的 Java 代码中使用生成的 model.pmml 文件来进行预测。请试一试吧!

(LCTT 译注:Java 中有第三方库 jpmml/jpmml-evaluator,它能帮助你使用生成的 model.pmml 进行预测。)


via: https://www.opensourceforu.com/2022/05/using-a-machine-learning-model-to-make-predictions/

作者:Jishnu Saurav Mittapalli 选题:lkxed 译者:geekpi 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

机器学习(ML)就是,分析一组数据以预测结果。Python 被认为是 ML 的最佳编程语言选择之一。在本文中,我们将讨论使用 Python 进行分类的机器学习。

machine-learning-classification

假设你想教孩子区分苹果和橙子。有多种方法可以做到这一点。你可以让孩子触摸这两种水果,让他们熟悉形状和柔软度。你还可以向她展示苹果和橙子的多个例子,以便他们可以直观地发现差异。这个过程的技术等价物被称为机器学习。

机器学习教计算机解决特定问题,并通过经验变得更好。这里讨论的示例是一个分类问题,其中机器被赋予各种标记示例,并期望使用它从标记样本中获得的知识来对未标记样本进行标记。机器学习问题也可以采用回归的形式,其中期望根据已知样本及其解决方案来预测给定问题的 实值 real-valued 解决方案。 分类 Classification 和 回归 Regression 被广泛称为 监督学习 supervised learning 。机器学习也可以是 无监督 unsupervised 的,机器识别未标记数据中的模式,并形成具有相似模式的样本集群。机器学习的另一种形式是 强化学习 reinforcement learning ,机器通过犯错从环境中学习。

分类

分类是根据从已知点获得的信息来预测一组给定点的标签的过程。与一个数据集相关的类别或标签可以是二元的,也可以是多元的。举例来说,如果我们必须给与一个句子相关的情绪打上标签,我们可以把它标记为正面、负面或中性。另一方面,我们必须预测一个水果是苹果还是橘子的问题将有二元标签。表 1 给出了一个分类问题的样本数据集。

在该表中,最后一列的值,即贷款批准,预计将基于其他变量进行预测。在接下来的部分中,我们将学习如何使用 Python 训练和评估分类器。

年龄信用等级工作拥有房产贷款批准
35好是是是
32差是不不
22一般不不不
42好是不是

表 1

训练和评估分类器

为了训练 分类器 classifier ,我们需要一个包含标记示例的数据集。尽管本节不涉及清理数据的过程,但建议你在将数据集输入分类器之前阅读各种数据预处理和清理技术。为了在 Python 中处理数据集,我们将导入 pandas 包和 数据帧 DataFrame 结构。然后,你可以从多种分类算法中进行选择,例如 决策树 decision tree 、 支持向量分类器 support vector classifier 、 随机森林 random forest 、XG boost、ADA boost 等。我们将看看随机森林分类器,它是使用多个决策树形成的集成分类器。

from sklearn.ensemble import RandomForestClassifier
from sklearn import metrics
 
classifier = RandomForestClassifier()
 
#creating a train-test split with a proportion of 70:30
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.33)
 
classifier.fit(X_train, y_train) # 在训练集上训练分类器
 
y_pred = classifier.predict(X_test) # 用未知数据评估分类器
 
print("Accuracy: ", metrics.accuracy_score(y_test, y_pred)) # 用测试计划中的实际值比较准确率

虽然这个程序使用准确性作为性能指标,但应该使用多种指标的组合,因为当测试集不平衡时,准确性往往会产生非代表性的结果。例如,如果模型对每条记录都给出了相同的预测,而用于测试模型的数据集是不平衡的,即数据集中的大多数记录与模型预测的类别相同,我们就会得到很高的准确率。

调整分类器

调优是指修改模型的 超参数 hyperparameter 值以提高其性能的过程。超参数是可以改变其值以改进算法的学习过程的参数。

以下代码描述了随机搜索超参数调整。在此,我们定义了一个搜索空间,算法将从该搜索空间中选择不同的值,并选择产生最佳结果的那个:

from sklearn.model_selection import RandomizedSearchCV

#define the search space
min_samples_split = [2, 5, 10]
min_samples_leaf = [1, 2, 4]
grid = {‘min_samples_split’ : min_samples_split, ‘min_samples_leaf’ : min_samples_leaf}

classifier = RandomizedSearchCV(classifier, grid, n_iter = 100)

# n_iter 代表从搜索空间提取的样本数
# result.best_score 和 result.best_params_ 可以用来获得模型的最佳性能,以及参数的最佳值

classifier.fit(X_train, y_train)

投票分类器

你也可以使用多个分类器和它们的预测来创建一个模型,根据各个预测给出一个预测。这个过程(只考虑为每个预测投票的分类器的数量)被称为硬投票。软投票是一个过程,其中每个分类器产生一个给定记录属于特定类别的概率,而投票分类器产生的预测是获得最大概率的类别。

下面给出了一个创建软投票分类器的代码片段:

soft_voting_clf = VotingClassifier(
estimators=[(‘rf’, rf_clf), (‘ada’, ada_clf), (‘xgb’, xgb_clf), (‘et’, et_clf), (‘gb’, gb_clf)],
voting=’soft’)
soft_voting_clf.fit(X_train, y_train)

这篇文章总结了分类器的使用,调整分类器和结合多个分类器的结果的过程。请将此作为一个参考点,详细探讨每个领域。


via: https://www.opensourceforu.com/2022/05/machine-learning-classification-using-python/

作者:Gayatri Venugopal 选题:lkxed 译者:geekpi 校对:turbokernel

本文由 LCTT 原创编译,Linux中国 荣誉推出

在当今快节奏的数字世界中,机构们使用低代码/无代码(LC/NC)应用来快速构建新的信息系统。本文将介绍 PyCaret,这是一个用 Python 编写的低代码机器学习库。

Featured-image-of-pycaret

PyCaret 是 R 编程语言中 Caret( 分类和回归训练 Classification And REgression Training 的缩写)包的 Python 版本,具有许多优点。

  • 提高工作效率: PyCaret 是一个低代码库,可让你提高工作效率。由于花费更少的时间进行编码,你和你的团队现在可以专注于业务问题。
  • 易于使用: 这个简单易用的机器学习库将帮助你以更少的代码行执行端到端的机器学习实验。
  • 可用于商业: PyCaret 是一个可用于商业的解决方案。它允许你从选择的 notebook 环境中快速有效地进行原型设计。

你可以在 Python 中创建一个虚拟环境并执行以下命令来安装 PyCaret 完整版:

pip install pycaret [full]

机器学习从业者可以使用 PyCaret 进行分类、回归、聚类、异常检测、自然语言处理、关联规则挖掘和时间序列分析。

使用 PyCaret 构建分类模型

本文通过从 PyCaret 的数据仓库中获取 Iris 数据集来解释使用 PyCaret 构建分类模型。

我们将使用 Google Colab 环境使事情变得简单,并按照下面提到的步骤进行操作。

步骤 1

首先,通过给出以下命令安装 PyCaret:

pip install pycaret

步骤 2

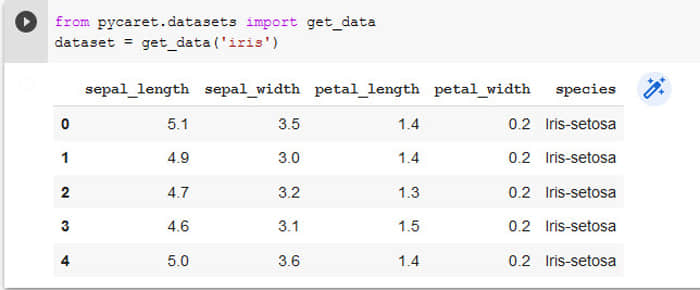
接下来,加载数据集,如图 2 所示:

Loading the data set

from pycaret.datasets import get_data
dataset = get_data('iris') 
(或者)
import pandas as pd 
dataset = pd.read_csv('/path_to_data/file.csv')

步骤 3

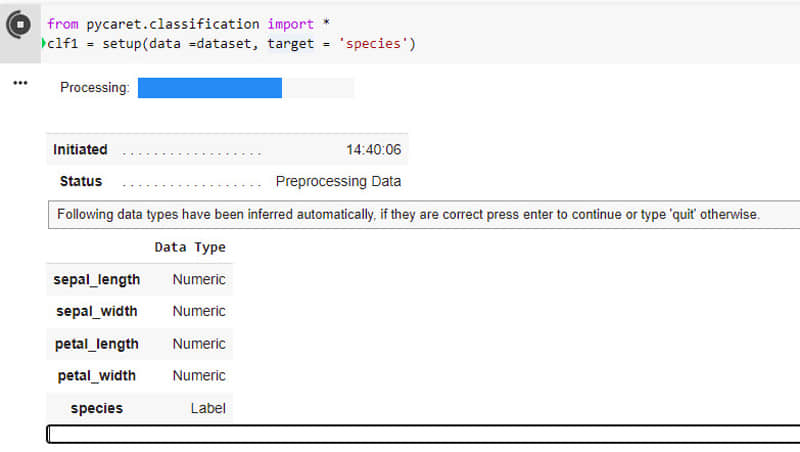
现在设置 PyCaret 环境,如图 2 所示:

PyCaret environment setup

from pycaret.classification import *
clf1 = setup(data=dataset, target = ‘species’)

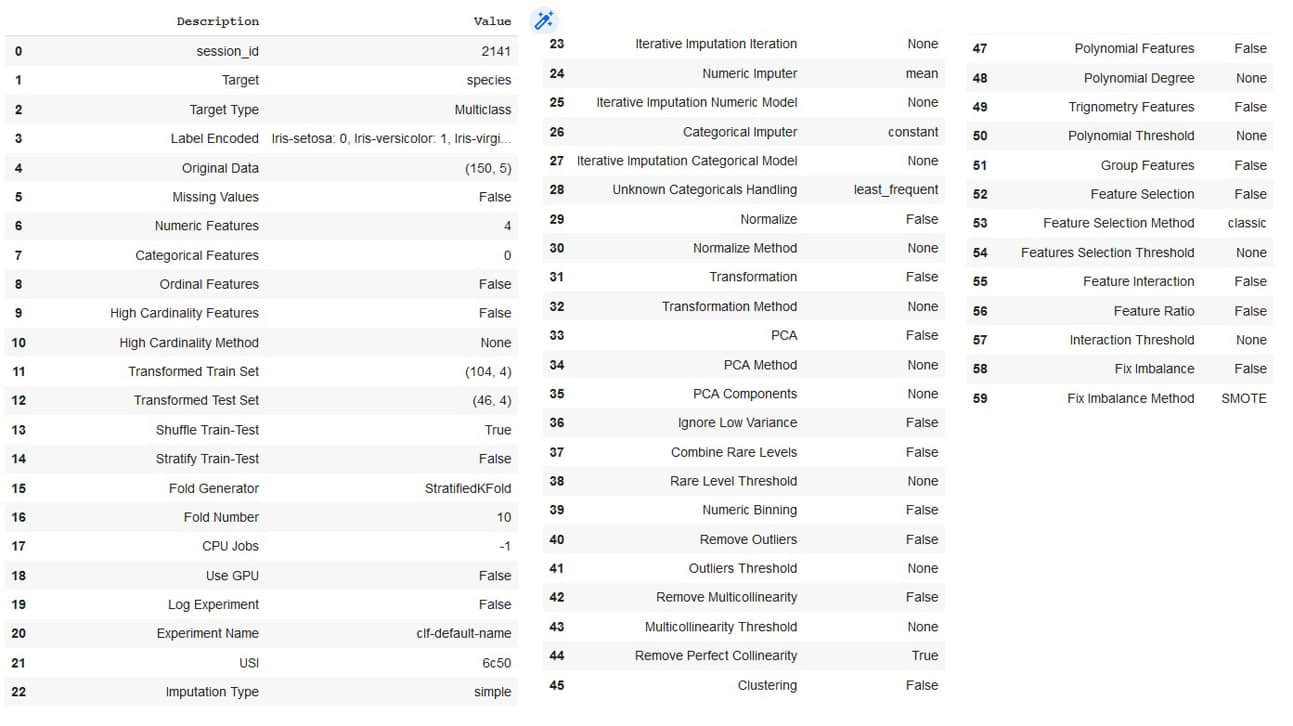
PyCaret environment setup result

使用 PyCaret 构建任何类型的模型,环境设置是最重要的一步。默认情况下,setup() 函数接受参数 data(Pandas 数据帧)和 target(指向数据集中的类标签变量)。setup() 函数的结果如图 3 所示。 setup() 函数默认将 70% 的数据拆分为训练集,30% 作为测试集,并进行数据预处理,如图 3 所示。

步骤 4

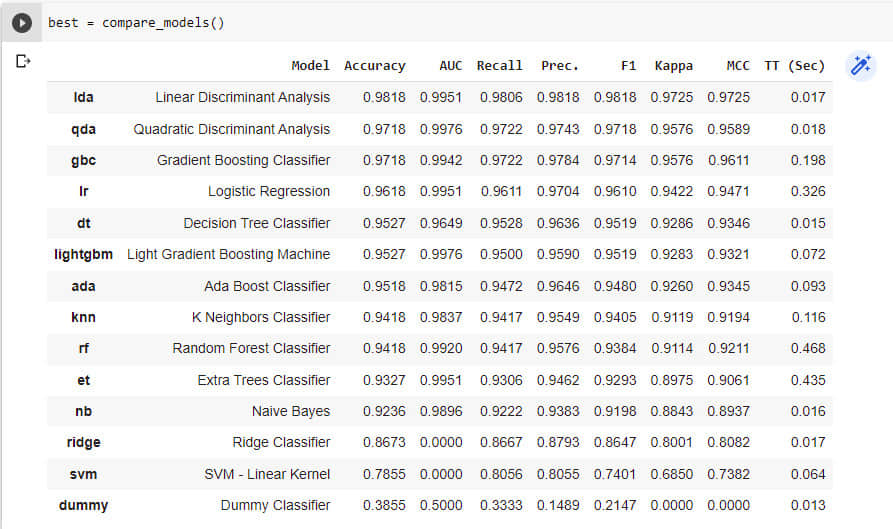
接下来,找到最佳模型,如图 4 所示:

Finding the best model

best = compare_models()

默认情况下,compare_models() 应用十倍交叉验证,并针对具有较少训练时间的不同分类器计算不同的性能指标,如准确度、AUC、召回率、精度、F1 分数、Kappa 和 MCC,如图 4 所示。通过将 tubro=True 传递给 compare_models() 函数,我们可以尝试所有分类器。

步骤 5

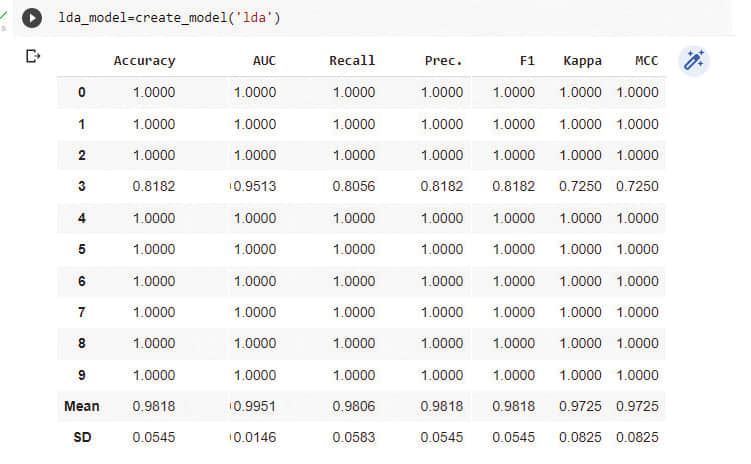
现在创建模型,如图 5 所示:

Creating the model

lda_model=create_model (‘lda’)

线性判别分析分类器表现良好,如图 4 所示。因此,通过将 lda 传递给 create_model() 函数,我们可以拟合模型。

步骤 6

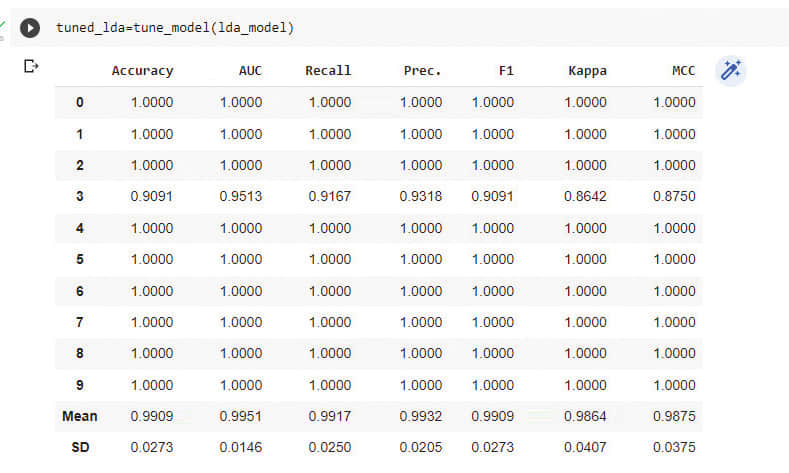
下一步是微调模型,如图 6 所示。

Tuning the model

tuned_lda=tune_model(lda_model)

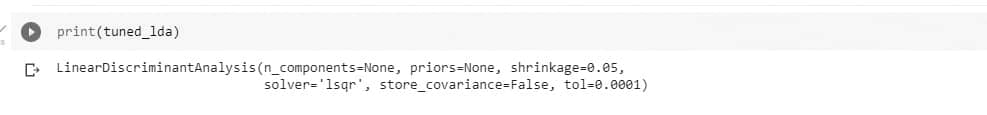
超参数的调整可以提高模型的准确性。tune_model() 函数将线性判别分析模型的精度从 0.9818 提高到 0.9909,如图 7 所示。

Tuned model details

步骤 7

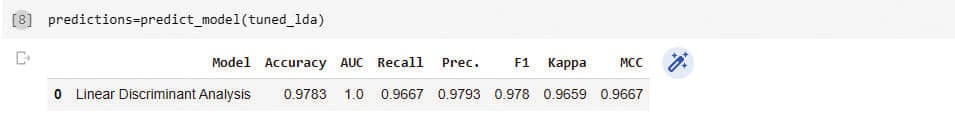
下一步是进行预测,如图 8 所示:

Predictions using the tuned model

predictions=predict_model(tuned_lda)

predict_model() 函数用于对测试数据中存在的样本进行预测。

步骤 8

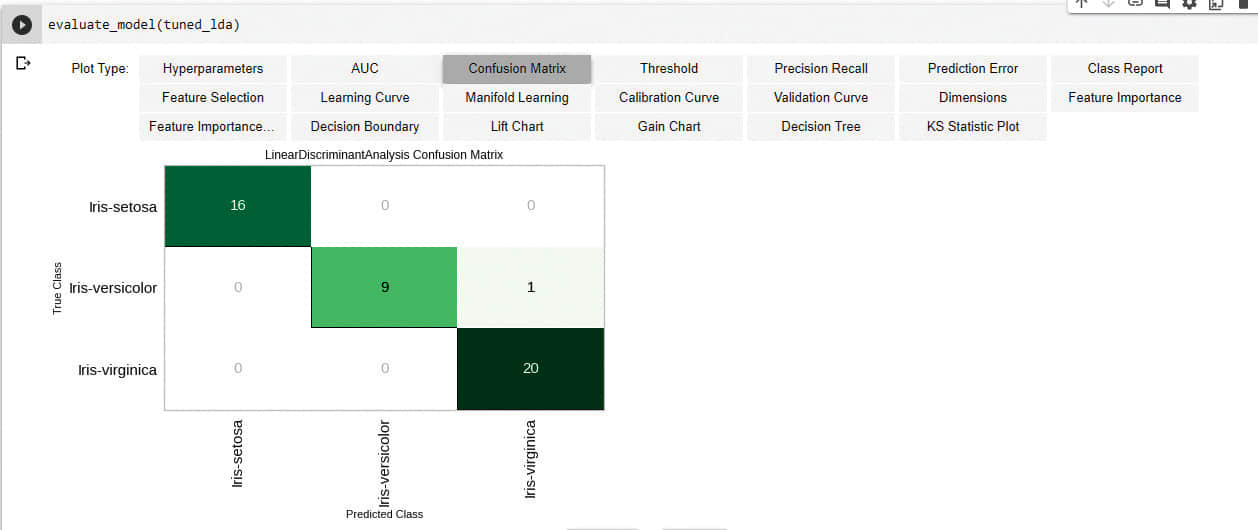
现在绘制模型性能,如图 9 所示:

Evaluating and plotting the model performance — confusion matrix

evaluate_model(tuned_lda)

evaluate_model() 函数用于以最小的努力开发不同的性能指标。你可以尝试它们并查看输出。


via: https://www.opensourceforu.com/2022/05/pycaret-machine-learning-model-development-made-easy/

作者:S Ratan Kumar 选题:lkxed 译者:geekpi 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

在网络钓鱼攻击中,用户会收到一封带有误导性链接的邮件或信息,攻击者可以利用它来收集重要数据,比如你的银行卡密码。本文将会给出一个简短的教程,旨在介绍如何检测这种网络钓鱼的企图。

通过网络钓鱼攻击,攻击者能够获得一些重要凭证,这些凭证可以用来进入你的银行或其他金融账户。攻击者发送的 URL 看起来与我们日常使用的原始应用程序完全相同。这也是人们经常相信它,并在其中输入个人信息的原因。钓鱼网址可以打开一个网页,它看起来与你的银行的原始登录页面相似。最近,这样的网络钓鱼攻击正变得相当普遍,所以,检测钓鱼链接变得非常重要。因此,我将介绍如何在 Python 中使用机器学习来检查一个链接是误导性的还是真实的,因为它可以帮助我们看到网页代码及其输出。注意,本文将使用 Jupyter Notebook。当然,你也可以使用 Google Colab 或 Amazon Sagemaker,如果你对这些更熟悉的话。

下载数据集

第一步,我们需要用于训练数据集。你可以从下面的链接中下载数据集。

训练机器进行预测

当数据集下载完成,我们需要使用以下几行代码来导入所需的库:

import pandas as pd
from sklearn.ensemble import RandomForestClassifier

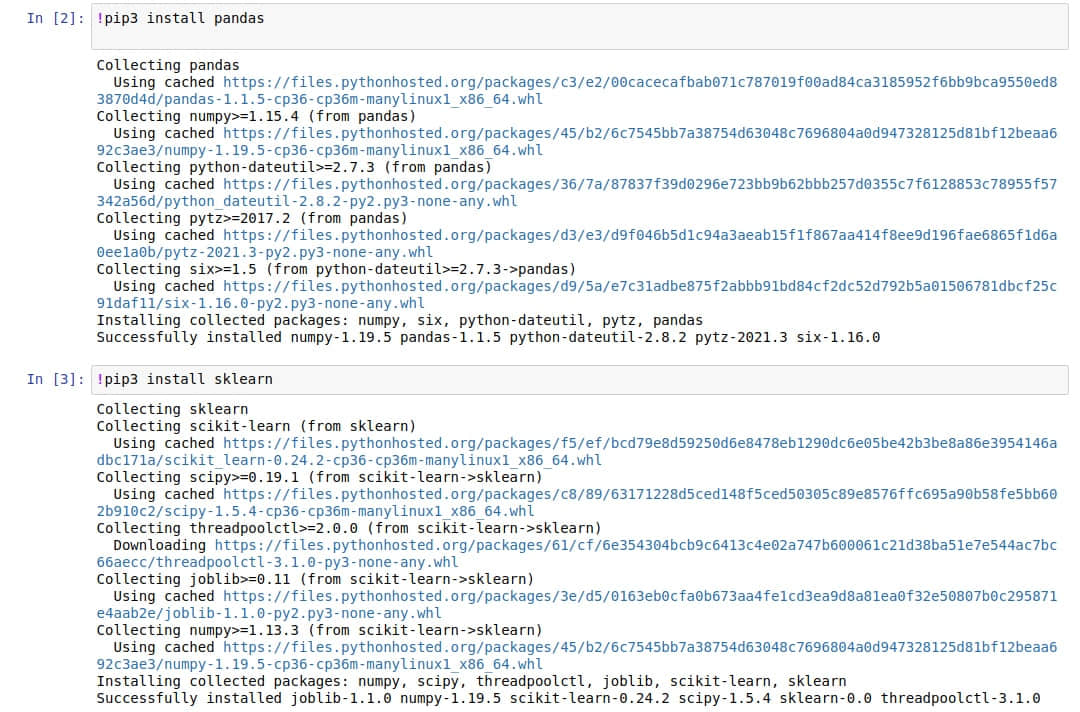
如果你没有这些库,你可以使用 pip 工具来安装这些库,如下图所示:

使用 pip 工具安装依赖库

当依赖安装完成,你就可以导入数据集,并将其转换为 pandas 数据框架,使用以下几行代码进一步处理:

legitimate_urls = pd.read_csv(“/home/jishnusaurav/jupyter/Phishing-Website-Detection/datasets/legitimate-urls.csv”)
phishing_urls = pd.read_csv(“/home/jishnusaurav/jupyter/Phishing-Website-Detection/datasets/phishing-urls.csv”)

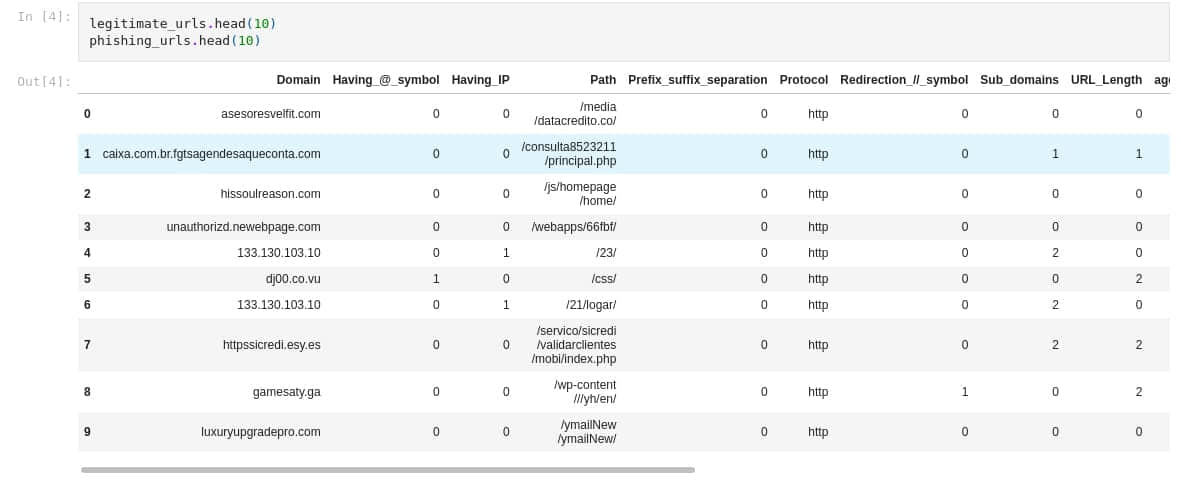
在成功导入后,我们需要把这两个数据集合并,以便形成一个数据集。合并后的数据集的前几行如下图所示:

合并后的数据集的前几行

然后去掉那些我们不需要的列,如路径(path)、协议(protocol)等,以达到预测的目的:

urls = urls.drop(urls.columns[[0,3,5]],axis=1)

在这之后,我们需要使用以下代码将数据集分成测试和训练两部分:

data_train, data_test, labels_train, labels_test = train_test_split(urls_without_labels, labels, test_size=0.30, random_state=110)

接着,我们使用 sklearn 的随机森林分类器建立一个模型,然后使用 fit 函数来训练这个模型。

random_forest_classifier = RandomForestClassifier()
random_forest_classifier.fit(data_train,labels_train)

完成这些后,我们就可以使用 predict 函数来最终预测哪些链接是钓鱼链接。下面这行可用于预测:

prediction_label = random_forest_classifier.predict(test_data)

就是这样啦!你已经建立了一个机器学习模型,它可以预测一个链接是否是钓鱼链接。试一下吧,我相信你会满意的!


via: https://www.opensourceforu.com/2022/04/detect-a-phishing-url-using-machine-learning-in-python/

作者:Jishnu Saurav Mittapalli 选题:lkxed 译者:lkxed 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

Windows 盗版激活软件被黑客植入后门

KMSPico 是一款用于激活盗版的 Windows 及 Office 软件。由于 KMSPico 太受欢迎,现在被黑客盯上了,植入了后门,他们架设了所谓的 KMSPico 官网来推广这个恶意软件,一旦用户下载使用,就会被植入后门。KMSPico 窃取的是各种加密货币钱包。而同时,这个有后门的 KMSPico 软件的激活功能也是能正常工作的。

老王点评:使用盗版软件并使用地下的破解软件,这种风险就需要自己承担了。

统信发布毕昇驱动引擎,支持 2000 多款打印机

统信软件宣布,正式推出“毕昇驱动引擎方案”,将在 12 月 31 日随着统信桌面操作系统 V20(1043)正式推送。此前,统信 UOS 已经完成了 3000 多款打印机产品的适配。新的毕昇驱动引擎方案可以直接在统信 UOS 上运行 Windows 打印机驱动,而无需安装 Windows 虚拟机,或者采购虚拟化解决方案。该引擎支持 2000 多款 Windows 打印驱动,这样统信 UOS 已经可以兼容 90% 以上打印机的新旧设备型号。

老王点评:这是一个不错的改进,对于 UOS 更多进入办公环境很有意义。

少数数据集支配着机器学习研究

研究人员分析了 2015-2020 年之间不同机器学习社区使用的数据集,发现少数数据集被集中使用。在分析 43,140 个样本中,超过五成使用的数据集来自于 12个精英机构。研究人员 认为 这种高度集中化的趋势带来了实用性、伦理甚至政治方面的问题。其中,计算机视觉受政府影响最大,自然语言处理受最少影响。计算机视觉尤其是脸部识别领域常用的数据集得到了企业、军方和政府的资助。

老王点评:如果数据来源是特定的,那么机器学习的结果可能就是偏离的。