标签 容器 下的文章

如果你是容器的新手,不要被那些术语所吓倒。这些关键原则将帮助你把应用迁移到云中。

 title=

一般来说,人们想使用你的应用程序这是一件好事。然而,当应用程序在服务器上运行时,应用程序受欢迎是有代价的。随着用户对资源需求的增加,在某些时候,你可能会发现你需要扩展你的应用程序。一种选择是在这种情况下增加更多的服务器,建立一个像 Nginx 这样的 负载平衡器,以满足需求。但是,这种方法的成本可能很昂贵,因为当需求低的时候,在没有流量的服务器上运行你的应用程序的实例并不会节省资源。容器的优点是它是非持久的,在有需求时启动新实例,而随着需求的减少逐渐消失。如果这听起来像是你需要的功能,那么现在可能是将你的应用程序迁移到容器的时候了。

将应用程序迁移到容器中,很快就会变得迷失方向。虽然容器内的环境可能感觉很熟悉,但许多容器镜像是最小化的,而且它们被设计为无状态的。不过在某种程度上,这也是容器的优势之一。就像 Python 虚拟环境一样,它是一块白板,可以让你构建(或重建)你的应用程序,而没有许多其他环境所提供的无形的默认值。

每一次向云服务的迁移都是独一无二的,但在将你的应用程序移植到容器之前,你应该注意以下几个重要原则。

1、理解你的依赖关系

将你的应用程序移植到容器中是一个很好的机会,可以了解你的应用程序实际依赖的东西。由于除了最基本的系统组件外,很少有默认安装的组件,你的应用程序一开始不太可能在容器中运行。

在重构之前,确定你的依赖关系。首先,在你的源代码中用 grep 查找 include、import、require、use 或你选择的语言中用来声明依赖关系的任何关键词。

$ find ~/Code/myproject -type f \
    -iname ".java" \
    -exec grep import {} \;

不过,仅仅识别你使用的特定语言的库可能是不够的。审计依赖关系,这样你就能知道是否有语言本身运行所需的低级库,或者特定的模块以预期的功能运行。

2、评估你的数据存储

容器是无状态的,当一个容器崩溃或停止运行时,该容器的实例就永远消失了。如果你要在该容器中保存数据,这些数据也会消失。如果你的应用程序存储用户数据,所有的存储必须发生在容器之外,在你的应用程序的实例可以访问的某个位置。

你可以使用映射到容器内某个位置的本地存储来存储简单的应用程序配置文件。这是一种常见的技术,适用于需要管理员提供简单配置值的 Web 应用程序,如管理员的电子邮件地址、网站标题等。比如说:

$ podman run \
    --volume /local/data:/storage:Z \
    mycontainer

然而,你可以配置一个数据库,如 MariaDB 或 PostgreSQL,将大量数据在几个容器中的共享存储。对于私人信息,如密码,你可以配置一个机密存储。

对于你需要如何重构你的代码,相应地调整存储位置,这可能意味着改变路径到新的容器存储映射,移植到不同的数据库,甚至是纳入容器特定的模块。

3、准备好你的 Git 仓库

容器在构建时通常会从 Git 仓库中拉取源代码。一旦你的 Git 仓库成为你的应用程序的生产就绪代码的标准来源,你必须有一个管理 Git 仓库的计划。要有一个发布分支或生产分支,并考虑使用 Git 钩子 来拒绝意外的未经批准的提交。

4、了解你的构建系统

容器化应用程序可能没有传统的发布周期。当容器被构建时,它们会被从 Git 中拉取出来。你可以启动任何数量的构建系统作为容器构建的一部分,但这可能意味着调整你的构建系统,使其比过去更加自动化。你应该重构你的构建过程,使你完全有信心它能在无人值守的情况下工作。

5、构建镜像

构建镜像不一定是复杂的任务。你可以使用 现有的容器镜像 作为基础,用一个简单的 Docker 文件对其进行调整。另外,你也可以使用 Buildah 从头开始构建你自己的镜像。

在某种程度上,构建容器的过程与实际重构代码一样,都是开发的一部分。容器的构建是为了获取、组装和执行你的应用程序,所以这个过程必须是自动化的、健壮的。建立一个好的镜像,你就为你的应用程序建立了一个坚实可靠的基础。

容器化

如果你是容器的新手,不要被术语所吓倒。容器只是另一种环境。容器化开发的感知约束实际上可以帮助你专注于你的应用程序,并更好地了解它是如何运行的、它需要什么才能可靠地运行,以及当出错时有哪些潜在的风险。相反,这导致系统管理员在安装和运行你的应用程序时受到的限制要少得多,因为从本质上讲,容器是一个受控的环境。仔细审查你的代码,了解你的应用程序需要什么,并相应地重构它。


via: https://opensource.com/article/22/2/migrate-application-containers

作者:Alan Smithee 选题:lujun9972 译者:wxy 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

配置你的系统使用无根容器。

 title=

容器是现代计算的一个重要组成部分,随着围绕容器的基础设施的发展,新的和更好的工具开始浮出水面。过去,你只需用 LXC 就可以运行容器,然而随着 Docker 得到了普及,它开始变得越来越复杂。最终,我们在 Podman 得到了我们所期望的容器管理系统:一个无守护进程的容器引擎,它使容器和吊舱易于构建、运行和管理。

容器直接与 Linux 内核能力(如控制组和命名空间)交互,它们在这些命名空间中产生大量的新进程。简而言之,运行一个容器实际上就是在 Linux 系统内部运行一个 Linux 系统。从操作系统的角度来看,它看起来非常像一种管理和特权活动。普通用户通常不能像容器那样自由支配系统资源,所以默认情况下,运行 Podman 需要 root 或 sudo 权限。然而,这只是默认设置,而且这绝不是唯一可用的设置。本文演示了如何配置你的 Linux 系统,使普通用户可以在不使用 sudo 的情况下(“ 无根 rootless ”)运行 Podman。

命名空间的用户 ID

内核命名空间 本质上是一种虚构的结构,可帮助 Linux 跟踪哪些进程属于同一类。这是 Linux 中的“队列护栏”。一个队列中的进程与另一个队列中的进程之间实际上没有区别,但可以将它们用“警戒线”彼此隔离。要声明一组进程为“容器”,而另一组进程为你的操作系统,将它们分开是关键。

Linux 通过用户 ID(UID)和组 ID(GID)来跟踪哪个用户或组拥有的进程。通常情况下,一个用户可以访问一千个左右的从属 UID,以分配给命名空间的子进程。由于 Podman 运行的是分配给启动容器的用户的整个从属操作系统,因此你需要的不仅仅是默认分配的从属 UID 和从属 GID。

你可以用 usermod 命令授予一个用户更多的从属 UID 和从属 GID。例如,要授予用户 tux 更多的从属 UID 和从属 GID,选择一个还没分配用户的适当的高 UID(如 200000),然后将其增加几千:

$ sudo usermod \
    --add-subuids 200000-265536 \
    --add-subgids 200000-265536 \
    tux

命名空间访问

对命名空间数量也有限制。这通常被设置得很高。你可以用 systctl,即内核参数工具来验证用户的命名空间分配:

$ sysctl --all --pattern user_namespaces
user.max_user_namespaces = 28633

这是很充足的命名空间,而且可能是你的发行版默认设置的。如果你的发行版没有这个属性或者设置得很低,那么你可以在文件 /etc/sysctl.d/userns.conf 中输入这样的文本来创建它:

user.max_user_namespaces=28633

加载该设置:

$ sudo sysctl -p /etc/sysctl.d/userns.conf

在没有 root 权限的情况下运行一个容器

当你设置好你的配置,重启你的计算机,以确保你的用户和内核参数的变化被加载和激活。

重启后,试着运行一个容器镜像:

$ podman run -it busybox echo "hello"
hello

容器像命令一样

如果你是第一次接触容器,可能会觉得很神秘,但实际上,它们与你现有的 Linux 系统没有什么不同。它们实际上是在你的系统上运行的进程,没有仿真环境或虚拟机的成本和障碍。容器和你的操作系统之间的区别只是内核命名空间,所以它们实际上只是带有不同标签的本地进程。Podman 使这一点比以往更加明显,当你将 Podman 配置为无根命令,容器感觉更像命令而不是虚拟环境。Podman 使容器和吊舱变得简单,所以请试一试。


via: https://opensource.com/article/22/1/run-containers-without-sudo-podman

作者:Seth Kenlon 选题:lujun9972 译者:geekpi 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

容器化软件包不是 Linux 应用的未来

应用开发者正在 逐渐转向容器化软件包,如 Flatpak、Snap、AppImage、Docker 和 Steam,这种打包格式运用容器技术将所需要的运行时库直接封装在应用内。但这导致占用非常多的磁盘空间和内存,启动时间也更慢。比如计算器应用 KCalc 的 AppImage 软件包高达 152 MB,Flatpak 软件包则需要下载 900 MB,而事实上 KCalc 应用本身只有 4.4 MB,其余都是系统上已安装了的冗余库。启动一个计算器应用你每次需要等待 7 秒钟。

老王点评:将所有依赖打包到一起,在特定用例下是必要的,但是如果推而广之,共享库的优良实践就荡然无存了。

Alpine Linux 砍掉 MIPS64 支持

在 Docker 基础镜像中广泛使用的 Alpine Linux 发布了 3.15 版本,支持最新的 5.15 LTS Linux 内核,但在此版本中放弃了对 MIPS64 架构的支持。发布公告 中说,“这个架构已经失效了,MIPS64 构建器已经消失了。我们没有办法再构建任何软件包,我们也不能再修复任何安全问题,所以让 MIPS64 正式退役是很谨慎的决定。”MIPS64 属于 RISC 架构,它的设计者 MIPS 公司几经周折。随后,它作为同属于 RISC 架构的 RISC-V 的一种开源替代方案来推广,但最终在今年早些时候被放弃,转而支持基于 RISC-V 本身的架构。

老王点评:随着 MIPS 被放弃,它所构建起来的生态也逐一崩塌。

英国出台法律禁止智能设备提供容易猜测的默认密码

英国政府在《产品安全和电信基础设施法案》中 增加了新的规定,禁止在智能设备上预装容易猜测的默认密码。所有的产品现在都需要独特的密码。对于违反此规定的厂商,它将有权对公司处以最高 1000 万英镑或其全球营业额 4% 的罚款,以及对持续违规行为每天处以最高 2 万英镑的罚款。其范围包括一系列设备,从智能手机、路由器、安全摄像机、游戏机、家庭扬声器和联网的白色家电和玩具。但不包括车辆、智能仪表和医疗设备。台式电脑和笔记本电脑也不在其管辖范围内。

老王点评:确实,有相当多的设备出于省心都采用的默认密码,这给被僵尸网络和入侵带来很大便利。

Lima 可以帮助克服在 Mac 上运行容器的挑战。

 title=

在你的 Mac 上运行容器可能是一个挑战。毕竟,容器是基于 Linux 特有的技术,如控制组和命名空间。

幸运的是,macOS 拥有一个内置的 虚拟机监控程序 hypervisor ,允许在 Mac 上运行虚拟机(VM)。虚拟机监控程序是一个底层的内核功能,而不是一个面向用户的功能。

hyperkit 是一个可以使用 macOS 虚拟机监控程序运行虚拟机的 开源项目。hyperkit 被设计成一个“极简化”的虚拟机运行器。与 VirtualBox 不同,它没有花哨的 UI 功能来管理虚拟机。

你可以获取 hyperkit,这是一个运行容器管理器的极简 Linux 发行版,并将所有部分组合在一起。但这将有很多变动组件,且听起来像有很多工作。特别是如果你想通过使用 vpnkit (一个开源项目,用于创建感觉更像是主机网络一部分的虚拟机网络)使网络连接更加无缝。

Lima

当 lima 项目 已经解决了这些细节问题时,就没有理由再去做这些努力了。让 lima 运行的最简单方法之一是使用 Homebrew。你可以用这个命令安装 lima:

$ brew install lima

安装后,可能需要一些时间,就享受一些乐趣了。为了让 lima 知道你已经准备好了,你需要启动它。下面是命令:

$ limactl start

如果这是你第一次运行,你会被问到是否喜欢默认值,或者是否要改变其中的任何一项。默认值是非常安全的,但我喜欢生活在疯狂的一面。这就是为什么我跳进一个编辑器,从以下地方进行修改:

- location: "~"
  # CAUTION: `writable` SHOULD be false for the home directory.
  # Setting `writable` to true is possible but untested and dangerous.
  writable: false

变成:

 - location: "~"
  # I *also* like to live dangerously -- Austin Powers
  writable: true

正如评论中所说,这可能是危险的。可悲的是,许多现有的工作流程都依赖于挂载是可读写的。

默认情况下,lima 运行 containerd 来管理容器。containerd 管理器也是一个非常简洁的管理器。虽然使用一个包装的守护程序,如 dockerd,来增加这些漂亮的工效是很常见的,但也有另一种方法。

nerdctl 工具

nerdctl 工具是 Docker 客户端的直接替换,它将这些功能放在客户端,而不是服务器上。lima 工具允许无需在本地安装就可以直接从虚拟机内部运行 nerdctl。

做完这些后,可以运行一个容器了!这个容器将运行一个 HTTP 服务器。你可以在你的 Mac 上创建这些文件:

$ ls
index.html
$ cat index.html
hello

现在,挂载并转发端口:

$ lima nerdctl run --rm -it -p 8000:8000 -v $(pwd):/html --entrypoint bash python
root@9486145449ab:/#

在容器内,运行一个简单的 Web 服务器:

$ lima nerdctl run --rm -it -p 8000:8000 -v $(pwd):/html --entrypoint bash python
root@9486145449ab:/# cd /html/
root@9486145449ab:/html# python -m http.server 8000
Serving HTTP on 0.0.0.0 port 8000 (<http://0.0.0.0:8000/>) ...

在另一个终端,你可以检查一切看起来都很好:

$ curl localhost:8000
hello

回到容器上,有一条记录 HTTP 客户端连接的日志信息:

10.4.0.1 - - [09/Sep/2021 14:59:08] "GET / HTTP/1.1" 200 -

一个文件是不够的,所以还要做些优化。 在服务器上执行 CTRL-C,并添加另一个文件:

^C
Keyboard interrupt received, exiting.
root@9486145449ab:/html# echo goodbye &gt; foo.html
root@9486145449ab:/html# python -m http.server 8000
Serving HTTP on 0.0.0.0 port 8000 (http://0.0.0.0:8000/) ...

检查你是否能看到新的文件:

$ curl localhost:8000/foo.html
goodbye

总结

总结一下,安装 lima 需要一些时间,但完成后,你可以做以下事情:

  • 运行容器。
  • 将你的主目录中的任意子目录挂载到容器中。
  • 编辑这些目录中的文件。
  • 运行网络服务器,在 Mac 程序看来,它们是在 localhost 上运行的。

这些都是通过 lima nerdctl 实现的。


via: https://opensource.com/article/21/9/run-containers-mac-lima

作者:Moshe Zadka 选题:lujun9972 译者:geekpi 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

命名空间、控制组、seccomp 和 SELinux 构成了在系统上构建和运行一个容器进程的 Linux 技术基础。
 title=

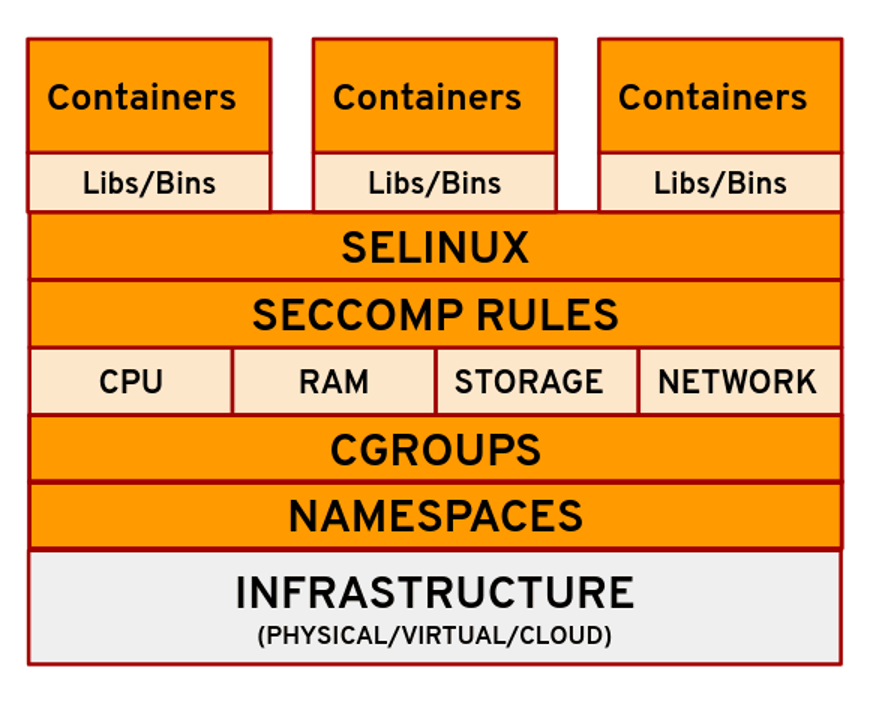
在以前的文章中,我介绍过 容器镜像 及其 运行时。在本文中,我研究了容器是如何在一些特殊的 Linux 技术基础上实现的,这其中包括命名空间和控制组。
 title=

图1:对容器有贡献的 Linux 技术(Nived Velayudhan, CC BY-SA 4.0)

这些 Linux 技术构成了在系统上构建和运行容器进程的基础:

  1. 命名空间
  2. 控制组(cgroups)
  3. Seccomp
  4. SELinux

命名空间

命名空间 namespace 为容器提供了一个隔离层,给容器提供了一个看起来是独占的 Linux 文件系统的视图。这就限制了进程能访问的内容,从而限制了它所能获得的资源。

在创建容器时,Docker 或 Podman 和其他容器技术使用了 Linux 内核中的几个命名空间:

[nivedv@homelab ~]$ docker container run alpine ping 8.8.8.8
[nivedv@homelab ~]$ sudo lsns -p 29413

        NS TYPE   NPROCS   PID USER COMMAND
4026531835 cgroup    299     1 root /usr/lib/systemd/systemd --switched...
4026531837 user      278     1 root /usr/lib/systemd/systemd --switched...
4026533105 mnt         1 29413 root ping 8.8.8.8
4026533106 uts         1 29413 root ping 8.8.8.8
4026533107 ipc         1 29413 root ping 8.8.8.8
4026533108 pid         1 29413 root ping 8.8.8.8
4026533110 net         1 29413 root ping 8.8.8.8

用户

用户(user)命名空间将用户和组隔离在一个容器内。这是通过分配给容器与宿主系统有不同的 UID 和 GID 范围来实现的。用户命名空间使软件能够以 root 用户的身份在容器内运行。如果入侵者攻击容器,然后逃逸到宿主机上,他们就只能以受限的非 root 身份运行了。

挂载

挂载(mnt)命名空间允许容器有自己的文件系统层次结构视图。你可以在 Linux 系统中的 /proc/<PID>/mounts 位置找到每个容器进程的挂载点。

UTS

Unix 分时系统 Unix Timeharing System (UTS)命名空间允许容器拥有一个唯一主机名和域名。当你运行一个容器时,即使使用 - name 标签,也会使用一个随机的 ID 作为主机名。你可以使用 unshare 命令 来了解一下这个工作原理。

nivedv@homelab ~]$ docker container run -it --name nived alpine sh
/ # hostname 
9c9a5edabdd6
/ # 
nivedv@homelab ~]$ sudo unshare -u sh
sh-5.0# hostname isolated.hostname 
sh-5.0# hostname
isolated.hostname
sh-5.0# 
sh-5.0# exit
exit
[nivedv@homelab ~]$ hostname
homelab.redhat.com

IPC

进程间通信 Inter-Process Communication (IPC)命名空间允许不同的容器进程之间,通过访问共享内存或使用共享消息队列来进行通信。

[root@demo /]# ipcmk -M 10M
Shared memory id: 0
[root@demo /]# ipcmk -M 20M
Shared memory id: 1
[root@demo /]# 
[root@demo /]# ipcs
------ Message Queues --------
key        msqid      owner      perms      used-bytes   messages    
------ Shared Memory Segments --------
key        shmid      owner      perms      bytes      nattch     status      
0xd1df416a 0          root       644        10485760   0                       
0xbd487a9d 1          root       644        20971520   0                       
------ Semaphore Arrays --------
key        semid      owner      perms      nsems

PID

进程 ID Process ID (PID)命名空间确保运行在容器内的进程与外部隔离。当你在容器内运行 ps 命令时,由于这个命名空间隔离的存在,你只能看到在容器内运行的进程,而不是在宿主机上。

网络

网络(net)命名空间允许容器有自己网络接口、IP 地址、路由表、端口号等视图。容器如何能够与外部通信?你创建的所有容器都会被附加到一个特殊的虚拟网络接口上进行通信。

[nivedv@homelab ~]$ docker container run --rm -it alpine sh
/ # ping 8.8.8.8
PING 8.8.8.8 (8.8.8.8): 56 data bytes
64 bytes from 8.8.8.8: seq=0 ttl=119 time=21.643 ms
64 bytes from 8.8.8.8: seq=1 ttl=119 time=20.940 ms
^C
[root@homelab ~]# ip link show veth84ea6fc
veth84ea6fc@if22: <BROADCAST,MULTICAST,UP,LOWER_UP> mtu 1500 qdisc noqueue 
master docker0 state UP mode DEFAULT group default

控制组

控制组(cgroup)是组成一个容器的基本模块。控制组会分配和限制容器所使用的资源,如 CPU、内存、网络 I/O 等。容器引擎会自动创建每种类型的控制组文件系统,并在容器运行时为每个容器设置配额。

[root@homelab ~]# lscgroup | grep docker
cpuset:/docker
net_cls,net_prio:/docker
cpu,cpuacct:/docker
hugetlb:/docker
devices:/docker
freezer:/docker
memory:/docker
perf_event:/docker
blkio:/docker
pids:/docker

容器运行时为每个容器设置了控制组值,所有信息都存储在 /sys/fs/cgroup/*/docker。下面的命令将确保容器可以使用 50000 微秒的 CPU 时间片,并将内存的软、硬限制分别设置为 500M 和 1G。

[root@homelab ~]# docker container run -d --name test-cgroups --cpus 0.5 --memory 1G --memory-reservation 500M httpd
[root@homelab ~]# lscgroup cpu,cpuacct:/docker memory:/docker
cpu,cpuacct:/docker/
cpu,cpuacct:/docker/c3503ac704dafea3522d3bb82c77faff840018e857a2a7f669065f05c8b2cc84
memory:/docker/
memory:/docker/c3503ac704dafea3522d3bb82c77faff840018e857a2a7f669065f05c8b2cc84
[root@homelab c....c84]# cat cpu.cfs_period_us 
100000
[root@homelab c....c84]# cat cpu.cfs_quota_us 
50000
[root@homelab c....c84]# cat memory.soft_limit_in_bytes 
524288000
[root@homelab c....c84]# cat memory.limit_in_bytes 
1073741824

SECCOMP

Seccomp 意思是“ 安全计算 secure computing ”。它是一项 Linux 功能,用于限制应用程序进行的系统调用的集合。例如,Docker 的默认 seccomp 配置文件禁用了大约 44 个系统调用(总计超过 300 个)。

这里的思路是让容器只访问所必须的资源。例如,如果你不需要容器改变主机上的时钟时间,你可能不会使用 clock_adjtime 和 clock_settime 系统调用,屏蔽它们是合理的。同样地,你不希望容器改变内核模块,所以没有必要让它们使用 create_module、 delete_module 系统调用。

SELinux

SELinux 是“ 安全增强的 Linux security-enhanced Linux ”的缩写。如果你在你的宿主机上运行的是 Red Hat 发行版,那么 SELinux 是默认启用的。SELinux 可以让你限制一个应用程序只能访问它自己的文件,并阻止任何其他进程访问。因此,如果一个应用程序被破坏了,它将限制该应用程序可以影响或控制的文件数量。通过为文件和进程设置上下文环境以及定义策略来实现,这些策略将限制一个进程可以访问和更改的内容。

容器的 SELinux 策略是由 container-selinux 包定义的。默认情况下,容器以 container_t 标签运行,允许在 /usr 目录下读取(r)和执行(x),并从 /etc 目录下读取大部分内容。标签container_var_lib_t 是与容器有关的文件的通用标签。

总结

容器是当今 IT 基础设施的一个重要组成部分,也是一项相当有趣的技术。即使你的工作不直接涉及容器化,了解一些基本的容器概念和方法,也能让你体会到它们如何帮助你的组织。容器是建立在开源的 Linux 技术之上的,这使它们变得更加美好。

本文基于 techbeatly 的文章,并经授权改编。


via: https://opensource.com/article/21/8/container-linux-technology

作者:Nived V 选题:lujun9972 译者:wxy 校对:turbokernel

本文由 LCTT 原创编译,Linux中国 荣誉推出
通过深入了解容器运行时,理解容器环境是如何建立的。

 title=

在学习 容器镜像 时,我们讨论了容器的基本原理,但现在是深入研究容器 运行时 runtime 的时候了,从而了解容器环境是如何构建的。本文的部分信息摘自 开放容器计划 Open Container Initiative (OCI)的 官方文档,所以无论使用何种容器引擎,这些信息都是一致的。

容器运行机制

那么,当你运行 podman run 或 docker run 命令时,在后台到底发生了什么?一个分步的概述如下:

  1. 如果本地没有镜像,则从镜像 登记仓库 registry 拉取镜像
  2. 镜像被提取到一个写时复制(COW)的文件系统上,所有的容器层相互堆叠以形成一个合并的文件系统
  3. 为容器准备一个挂载点
  4. 从容器镜像中设置元数据,包括诸如覆盖 CMD、来自用户输入的 ENTRYPOINT、设置 SECCOMP 规则等设置,以确保容器按预期运行
  5. 提醒内核为该容器分配某种隔离,如进程、网络和文件系统( 命名空间 namespace )
  6. 提醒内核为改容器分配一些资源限制,如 CPU 或内存限制( 控制组 cgroup )
  7. 传递一个 系统调用 syscall 给内核用于启动容器
  8. 设置 SELinux/AppArmor

容器运行时负责上述所有的工作。当我们提及容器运行时,想到的可能是 runc、lxc、containerd、rkt、cri-o 等等。嗯,你没有错。这些都是容器引擎和容器运行时,每一种都是为不同的情况建立的。

容器运行时 Container runtime 更侧重于运行容器,为容器设置命名空间和控制组(cgroup),也被称为底层容器运行时。高层的容器运行时或容器引擎专注于格式、解包、管理和镜像共享。它们还为开发者提供 API。

开放容器计划(OCI)

开放容器计划 Open Container Initiative (OCI)是一个 Linux 基金会的项目。其目的是设计某些开放标准或围绕如何与容器运行时和容器镜像格式工作的结构。它是由 Docker、rkt、CoreOS 和其他行业领导者于 2015 年 6 月建立的。

它通过两个规范来完成如下任务:

1、镜像规范

该规范的目标是创建可互操作的工具,用于构建、传输和准备运行的容器镜像。

该规范的高层组件包括:

2、运行时规范

该规范用于定义容器的配置、执行环境和生命周期。config.json 文件为所有支持的平台提供了容器配置,并详细定义了用于创建容器的字段。在详细定义执行环境时也描述了为容器的生命周期定义的通用操作,以确保在容器内运行的应用在不同的运行时环境之间有一个一致的环境。

Linux 容器规范使用了各种内核特性,包括 命名空间 namespace 、 控制组 cgroup 、 权能 capability 、LSM 和文件系统 隔离 jail 等来实现该规范。

小结

容器运行时是通过 OCI 规范管理的,以提供一致性和互操作性。许多人在使用容器时不需要了解它们是如何工作的,但当你需要排除故障或优化时,了解容器是一个宝贵的优势。

本文基于 techbeatly 的文章,并经授权改编。


via: https://opensource.com/article/21/9/container-runtimes

作者:Nived V 选题:lujun9972 译者:geekpi 校对:turbokernel

本文由 LCTT 原创编译,Linux中国 荣誉推出