分类 系统运维 下的文章

Tanya Reilly 的五个问题:相互依赖的服务如何使恢复更加困难,为什么有意并预先管理依赖是个好主意。

我最近请 Google 的网站可靠性工程师 Tanya Reilly 分享了她关于如何制定更好的灾难恢复计划的想法。Tanya 将在 10 月 1 日到 4 日在纽约举行的 O'Reilly Velocity Conference 上发表了一个题为《你有没有试着把它关闭之后再打开?》的演讲。

1、 在计划备份系统策略时,人们最常犯的错误是什么?

经典的一条是“你不需要备份策略,你需要一个恢复策略”。如果你有备份,但你尚未测试恢复它们,那么你没有真正的备份。测试不仅仅意味着知道你可以获得数据,还意味着知道如何把它放回数据库,如何处理增量更改,甚至如果你需要的话,如何重新安装整个系统。这意味着确保你的恢复路径不依赖于与数据同时丢失的某些系统。

但测试恢复是枯燥的。这是人们在忙碌时会偷工减料的那类事情。这值得花时间使其尽可能简单、无痛、自动化,永远不要靠任何人的意志力!同时,你必须确保有关人员知道该怎么做,所以定期进行大规模的灾难测试是很好的。恢复演练是个好方法,可以找出该过程的文档是否缺失或过期,或者你是否没有足够的资源(磁盘、网络等)来传输和重新插入数据。

2、 创建 灾难恢复 disaster recovery (DR) 计划最常见的挑战是什么?

我认为很多 DR 是一种事后的想法:“我们有这个很棒的系统,我们的业务依赖它……我猜我们应该为它做 DR?”而且到那时,系统会非常复杂,充满相互依赖关系,很难复制。

第一次安装的东西,它通常是由人手动调整才正常工作的,有时那是个具体特定的版本。当你构建第二个时,很难确定它是完全一样的。即使在具有严格的配置管理的站点中,你也可能丢了某些东西,或者过期了。

例如,如果你已经失去对解密密钥的访问权限,那么加密备份没有太多用处。而且任何只在灾难中使用的部分都可能从你上次检查它们过后就破环了。确保你已经涵盖了所有东西的唯一方法做认真地故障切换。当你准备好了的,就计划一下你的灾难(演练)吧!

如果你可以设计系统,以使灾难恢复模式成为正常运行的一部分,那么情况会更好。如果你的服务从一开始就被设计为可复制的,添加更多的副本就是一个常规的操作并可能是自动化的。没有新的方法,这只是一个容量问题。但是,系统中仍然存在一些只能在一个或两个地方运行的组件。偶然计划中的假灾难能够很好地将它们暴露出来。

顺便说一句,那些被遗忘的组件可能包括仅在一个人的大脑中的信息,所以如果你自己发现说:“我们不能在 X 休假回来前进行 DR 故障切换测试”,那么那个人是一个危险的单点失败。

仅在灾难中使用的部分系统需要最多的测试,否则在需要时会失败。这个部分越少越安全,且辛苦的测试工作也越少。

3、 为什么服务相互依赖使得灾难恢复更加困难?

如果你只有一个二进制文件,那么恢复它是比较容易的:你做个二进制备份就行。但是我们越来越多地将通用功能分解成单独的服务。微服务意味着我们有更多的灵活性和更少地重新发明轮子:如果我们需要一个后端做一些事情,并且有一个已经存在,那么很好,我们就可以使用它。但是一些需要保留很大的依赖关系,因为它很快会变得纠缠。

你可能知道你直接使用的后端,但是你可能不会注意到有新的后端添加到你使用的库中。你可能依赖于某个东西,它也间接依赖于你。在依赖中断之后,你可能会遇到一个死锁:两个系统都不能启动,直到另一个运行并提供一些功能。这是一个困难的恢复情况!

你甚至可以最终遇到间接依赖于自身的东西,例如你需要配置启动网络的设备,但在网络关闭时无法访问该设备。人们通常会提前考虑这些循环依赖,并且有某种后备计划,但是这些本质上是不太行得通的方式:它们只适用于极端情况,并且以不同的方式使用你的系统、进程或代码。这意味着,它们很可能有一个不会被发现的问题,直到你真的,真的需要它们的工作的时候才发现。

4、 你建议人们在感觉需要之前就开始有意管理其依赖关系,以防止潜在的灾难性系统故障。为什么这很重要,你有什么建议有效地做到这一点?

管理你的依赖关系对于确保你可以从灾难中恢复至关重要。它使操作系统更容易。如果你的依赖不可靠,那么你就不可靠,所以你需要知道它们是什么。

虽然在它们变得混乱后也可以开始管理依赖关系,但是如果你早点开始,它会变得更容易一些。你可以设置使用各种服务策略——例如,你必须在堆栈中的这一层依赖于这组系统。你可以通过使其成为设计文件审查的常规部分,引入考虑依赖关系的习惯。但请记住,依赖关系列表将很快变得陈旧。如果你有程序化的发现依赖关系的方式,甚至强制实施依赖,这是最好的。 我的 Velocity 谈话涵盖了我们如何做到这一点。

早期开始的另一个优点是,你可以将服务拆分为垂直“层”,每个层中的功能必须能够在下一个层启动之前完全在线。所以,例如,你可以说网络必须能够完全启动而不借助任何其他服务。然后说,你的存储系统应该仅仅依赖于网络,程序后端应该仅仅依赖于网络和存储,等等。不同的层次对于不同的架构是有意义的。

如果你提前计划,新服务更容易选择依赖关系。每个服务应该只依赖堆栈中较低的服务。你仍然可以结束循环,在相同的层次服务上批次依赖 —— 但是它们可以更加紧密地包含,并且在逐个基础上处理更容易。

5、 你对 Velocity NY 的其他部分感兴趣么?

我整个星期二和星期三的时间表都完成了!正如你可能收集的那样,我非常关心大型相互依赖的系统的可管理性,所以我期待听到 Carin Meier 关于管理系统复杂性的想法、Sarah Wells 的微服务和 Baron 的可观察性 的谈话。我非常着迷听到 Jon Moore 关于 Comcast 如何从年度发布到每天发布的故事。作为一个前系统管理员,我很期待听到 Bryan Liles 对这个职位走向的看法。


作者简介:

Nikki McDonald 是 O'Reilly Media,Inc. 的内容总监。她住在密歇根州的安娜堡市。

Tanya Reilly 自 2005 年以来一直是 Google 的系统管理员和站点可靠性工程师,致力于分布式锁、负载均衡和引导等底层基础架构。在加入 Google 之前,她是爱尔兰最大的 ISP eircom.net 的系统管理员,在这之前她担当了一个小型软件公司的整个 IT 部门。


via: https://www.oreilly.com/ideas/creating-better-disaster-recovery-plans

作者:Nikki McDonald, Tanya Reilly 译者:geekpi 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

构建一个健壮的系统需要为故障而设计。作为 GitHub 的网站可靠性工程师(SRE),我们一直在寻求通过冗余来帮助缓解问题,今天将讨论最近我们所做的工作,以便支持你通过 DNS 来查找我们的服务器。

大型 DNS 提供商在其服务中构建了多级冗余,出现导致中断的问题时,可以采取措施来减轻其影响。最佳选择之一是把你的 区域 zone 的权威服务分割到多个服务提供商中。启用 分割权威 split authority 很简单,你只需在域名注册商配置两套或多套你区域的名称服务器,然后 DNS 请求将分割到整个列表中。但是,你必须在多个提供商之间对这些区域的记录保持同步,并且,根据具体情况这可能要么设置复杂,要么是完全手动的过程。

$ dig NS github.com. @a.gtld-servers.net.

...

;; QUESTION SECTION:
;github.com.            IN  NS

;; AUTHORITY SECTION:
github.com.     172800  IN  NS  ns4.p16.dynect.net.
github.com.     172800  IN  NS  ns-520.awsdns-01.net.
github.com.     172800  IN  NS  ns1.p16.dynect.net.
github.com.     172800  IN  NS  ns3.p16.dynect.net.
github.com.     172800  IN  NS  ns-421.awsdns-52.com.
github.com.     172800  IN  NS  ns-1283.awsdns-32.org.
github.com.     172800  IN  NS  ns2.p16.dynect.net.
github.com.     172800  IN  NS  ns-1707.awsdns-21.co.uk.

...

上面的查询是向 TLD 名称服务器 询问 github.com. 的 NS 记录。它返回了在我们在域名注册商中配置的值,在本例中,一共有两个 DNS 服务提供商,每个四条记录。如果其中一个提供商发生中断,那么其它的仍有希望可以服务请求。我们在各个地方同步记录,并且可以安全地修改它们,而不必担心数据陈旧或状态不正确。

完整地配置分割权威的最后一部分是在两个 DNS 服务提供商中将所有名称服务器作为顶层 NS 记录添加到区域的根中。

$ dig NS github.com. @ns1.p16.dynect.net.

...

;; QUESTION SECTION:
;github.com.            IN  NS

;; ANSWER SECTION:
github.com.     551 IN  NS  ns1.p16.dynect.net.
github.com.     551 IN  NS  ns2.p16.dynect.net.
github.com.     551 IN  NS  ns-520.awsdns-01.net.
github.com.     551 IN  NS  ns3.p16.dynect.net.
github.com.     551 IN  NS  ns-421.awsdns-52.com.
github.com.     551 IN  NS  ns4.p16.dynect.net.
github.com.     551 IN  NS  ns-1283.awsdns-32.org.
github.com.     551 IN  NS  ns-1707.awsdns-21.co.uk.

在 GitHub,我们有几十个区域和数千条记录,而大多数这些区域并没有关键到需要冗余,因此我们只需要处理一部分。我们希望有能够在多个 DNS 服务提供商中保持这些记录同步的方案,并且更一般地管理内部和外部的所有 DNS 记录。所以今天我们宣布了 OctoDNS。

octoDNS logo

配置

OctoDNS 能够让我们重新打造我们的 DNS 工作流程。我们的区域和记录存储在 Git 仓库的配置文件中。对它们的变更使用 GitHub 流,并像个站点一样用分支部署。我们甚至可以做个 “空” 部署来预览哪些记录将在变更中修改。配置文件是 yaml 字典,每个区域一个,它的顶层的键名是记录名称,键值是 ttl、类型和类型特定的数据。例如,当包含在区域文件 github.com.yaml 中时,以下配置将创建 octodns.github.com. 的 A 记录。

octodns:
  type: A
  values:
    - 1.2.3.4
    - 1.2.3.5

配置的第二部分将记录数据的源映射到 DNS 服务提供商。下面的代码片段告诉 OctoDNS 从 config 提供程序加载区域 github.com,并将其结果同步到 dyn 和 route53。

zones:
  github.com.:
    sources:
      - config
    targets:
      - dyn
      - route53

同步

一旦我们的配置完成,OctoDNS 就可以评估当前的状态,并建立一个计划,其中列出将需要将目标状态与源相匹配的一组更改。在下面的例子中,octodns.github.com 是一个新的记录,所以所需的操作是在两者中创建记录。

$ octodns-sync --config-file=./config/production.yaml
...
********************************************************************************
* github.com.
********************************************************************************
* route53 (Route53Provider)
*   Create <ARecord A 60, octodns.github.com., [u'1.2.3.4', '1.2.3.5']>
*   Summary: Creates=1, Updates=0, Deletes=0, Existing Records=0
* dyn (DynProvider)
*   Create <ARecord A 60, octodns.github.com., [u'1.2.3.4', '1.2.3.5']>
*   Summary: Creates=1, Updates=0, Deletes=0, Existing Records=0
********************************************************************************
...

默认情况下 octodns-sync 处于模拟运行模式,因此不会采取任何行动。一旦我们审阅了变更,并对它们感到满意,我们可以添加 `--doit' 标志并再次运行命令。OctoDNS 将继续它的处理流程,这一次将在 Route53 和 Dynect 中进行必要的更改,以便创建新的记录。

$ octodns-sync --config-file=./config/production.yaml --doit
...

此刻,在两个 DNS 服务提供商里我们有了相同的数据记录,并可以轻松地分割我们的 DNS 请求给它们,并知道它们将提供准确的结果。当我们直接运行上面的 OctoDNS 命令时,我们的内部工作流程依赖于部署脚本和 chatops。你可以在 README 的工作流程部分中找到更多信息。

总结

我们认为大多数网站可以从分割权威中受益,并且希望用 OctoDNS,其中最大的障碍已被扫除。即使对分割权威不感兴趣,OctoDNS 仍然值得一看,因为它将基础设施即代码的好处带给了 DNS。

想帮助 GitHub SRE 团队解决有趣的问题吗?我们很乐意加入我们。在这里申请。


via: https://githubengineering.com/enabling-split-authority-dns-with-octodns/

作者:Ross McFarland 译者:geekpi 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

了解运行级别是如何配置的,如何改变系统运行级别以及修改对应状态下运行的服务。

操作 Linux 的运行级别

在 Linux 系统中, 运行级别 run level 是指运维的级别,用于描述一种表明什么服务是可用的系统运行状态。

运行级别 1 是严格限制的,仅仅用于系统维护;该级别下,网络连接将不可操作,但是管理员可以通过控制台连接登录系统。

其他运行级别的系统允许任何人登录和使用,但是不同级别中可使用的服务不同。本文将探索如何配置运行级别,如何交互式改变系统运行级别以及修改该状态下可用的服务。

Linux 系统的默认运行状态是一个在系统开机时使用的运行级别(除非有其他的指示),它通常是在 /etc/inittab 文件中进行配置的,该文件内容通常如下:

id:3:initdefault

包括 Debian 系统在内的一些系统,默认运行级别为 2,而不是上述文件中的 3,甚至都没有 /etc/inittab 文件。

运行级别在默认情况下是如何被配置,其配置依赖于你所运行的 Linux 操作系统的具体发行版本。 例如,在某些系统中, 运行级别 2 是多用户模式,运行级别 3 是多用户模式并支持 NFS (网络文件系统)。 在另外一些系统,运行级别 2 - 5 基本相同,运行级别 1 是单用户模式。例如,Debian 系统的所用运行级别如下:

0 = 停机
1 = 单用户(维护模式)
2 = 多用户模式
3-5 = 同 2 一样
6 = 重启

在 Linux 系统上,运行级别 3 用于共享文件系统给其它系统,可以方便地只通过改变系统的运行级别来启动和停止文件系统共享。系统从运行级别 2 改变到 3 系统将允许文件系统共享,反之从运行级别 3 改变到 2 则系统不支持文件系统共享。

在某个运行级别中,系统运行哪些进程依赖于目录 /etc/rc?.d 目录的内容,其中 ? 可以是 2、 3、 4 或 5 (对应于相应的运行级别)。

在以下示例中(Ubuntu 系统),由于这些目录的配置是相同的,我们将看见上述 4 个级别对应的目录中的内容是一致的。

/etc/rc2.d$ ls
README         S20smartmontools      S50saned      S99grub-common
S20kerneloops  S20speech-dispatcher  S70dns-clean  S99ondemand
S20rsync       S20sysstat            S70pppd-dns   S99rc.local
/etc/rc2.d$ cd ../rc3.d
/etc/rc3.d$ ls
README         S20smartmontools      S50saned      S99grub-common
S20kerneloops  S20speech-dispatcher  S70dns-clean  S99ondemand
S20rsync       S20sysstat            S70pppd-dns   S99rc.local
/etc/rc3.d$ cd ../rc4.d
/etc/rc4.d$ ls
README         S20smartmontools      S50saned      S99grub-common
S20kerneloops  S20speech-dispatcher  S70dns-clean  S99ondemand
S20rsync       S20sysstat            S70pppd-dns   S99rc.local
/etc/rc4.d$ cd ../rc5.d
/etc/rc5.d$ ls
README         S20smartmontools      S50saned      S99grub-common
S20kerneloops  S20speech-dispatcher  S70dns-clean  S99ondemand
S20rsync       S20sysstat            S70pppd-dns   S99rc.local

这些都是什么文件?它们都是指向 /etc/init.d 目录下用于启动服务的脚本符号连接。 这些文件的文件名是至关重要的, 因为它们决定了这些脚本文件的执行顺序,例如, S20 脚本是在 S50 脚本前面运行的。

$ ls -l
total 4
-rw-r--r-- 1 root root 677 Feb 16  2016 README
lrwxrwxrwx 1 root root  20 Aug 30 14:40 S20kerneloops -> ../init.d/kerneloops
lrwxrwxrwx 1 root root  15 Aug 30 14:40 S20rsync -> ../init.d/rsync
lrwxrwxrwx 1 root root  23 Aug 30 16:10 S20smartmontools -> ../init.d/smartmontools
lrwxrwxrwx 1 root root  27 Aug 30 14:40 S20speech-dispatcher -> ../init.d/speech-dispatcher
lrwxrwxrwx 1 root root  17 Aug 31 14:12 S20sysstat -> ../init.d/sysstat
lrwxrwxrwx 1 root root  15 Aug 30 14:40 S50saned -> ../init.d/saned
lrwxrwxrwx 1 root root  19 Aug 30 14:40 S70dns-clean -> ../init.d/dns-clean
lrwxrwxrwx 1 root root  18 Aug 30 14:40 S70pppd-dns -> ../init.d/pppd-dns
lrwxrwxrwx 1 root root  21 Aug 30 14:40 S99grub-common -> ../init.d/grub-common
lrwxrwxrwx 1 root root  18 Aug 30 14:40 S99ondemand -> ../init.d/ondemand
lrwxrwxrwx 1 root root  18 Aug 30 14:40 S99rc.local -> ../init.d/rc.local

如你所想,目录 /etc/rc1.d 因运行级别 1 的特殊而不同。它包含的符号链接指向非常不同的一套脚本。 同样也要注意到其中一些脚本以 K 开头命名,而另一些与其它运行级别脚本一样以 S 开头命名。这是因为当系统进入单用户模式时, 一些服务需要停止。 然而这些 K 开头的符号链接指向了其它级别 S 开头的符号链接的同一文件时, K(kill)表示这个脚本将以指示其停止的参数执行,而不是以启动的参数执行。

/etc/rc1.d$ ls -l
total 4
lrwxrwxrwx 1 root root  20 Aug 30 14:40 K20kerneloops -> ../init.d/kerneloops
lrwxrwxrwx 1 root root  15 Aug 30 14:40 K20rsync -> ../init.d/rsync
lrwxrwxrwx 1 root root  15 Aug 30 14:40 K20saned -> ../init.d/saned
lrwxrwxrwx 1 root root  23 Aug 30 16:10 K20smartmontools -> ../init.d/smartmontools
lrwxrwxrwx 1 root root  27 Aug 30 14:40 K20speech-dispatcher -> ../init.d/speech-dispatcher
-rw-r--r-- 1 root root 369 Mar 12  2014 README
lrwxrwxrwx 1 root root  19 Aug 30 14:40 S30killprocs -> ../init.d/killprocs
lrwxrwxrwx 1 root root  19 Aug 30 14:40 S70dns-clean -> ../init.d/dns-clean
lrwxrwxrwx 1 root root  18 Aug 30 14:40 S70pppd-dns -> ../init.d/pppd-dns
lrwxrwxrwx 1 root root  16 Aug 30 14:40 S90single -> ../init.d/single

你可以改变系统的默认运行级别,尽管这很少被用到。例如,通过修改前文中提到的 /etc/inittab 文件,你能够配置 Debian 系统的默认运行级别为 3 (而不是 2),以下是该文件示例:

id:3:initdefault:

一旦你修改完成并重启系统, runlevel 命令将显示如下:

$ runlevel
N 3

另外一种可选方式,使用 init 3 命令,你也能改变系统运行级别(且无需重启立即生效), runlevel 命令的输出为:

$ runlevel
2 3

当然,除非你修改了系统默认级别的 /etc/rc?.d 目录下的符号链接,使得系统默认运行在一个修改的运行级别之下,否则很少需要通过创建或修改 /etc/inittab 文件改变系统的运行级别。

在 Linux 系统中如何使用运行级别?

为了扼要重述在系统中如何使用运行级别,下面有几个关于运行级别的快速问答问题:

如何查询系统当前的运行级别?

使用 runlevel 命令。

如何查看特定运行级别所关联的服务进程?

查看与该运行级别关联的运行级别开始目录(例如, /etc/rc2.d 对应于运行级别 2)。

如何查看系统的默认运行级别?

首先,查看 /etc/inittab 文件是否存在。如果不存在,就执行 runlevel 命令查询,你一般就已经处在该运行级别。

如何改变系统运行级别?

用 init 命令(例如 init 3)临时改变运行级别,通过修改或创建 /etc/inittab 文件永久改变其运行级别。

能改变特定运行级别下运行的服务么?

当然,通过改变对应的 /etc/rc?.d 目录下的符号连接即可。

还有一些其他的什么需要考虑?

当改变系统运行级别时,你应该特别小心,确保不影响到系统上正在运行的服务或者正在使用的用户。

(题图:Vincent Desjardins (CC BY 2.0))


via: https://www.networkworld.com/article/3222070/linux/maneuvering-around-run-levels-on-linux.html

作者:Sandra Henry-Stocker 译者:penghuster 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

本教程将告诉你如何将 Ubuntu 桌面版机器加入到带有 SSSD 和 Realm 服务的 Samba4 活动目录域中,以在活动目录中认证用户。

要求:

  1. 在 Ubuntu 上用 Samba4 创建一个活动目录架构

第 1 步:初始配置

1、 在把 Ubuntu 加入活动目录前确保主机名被正确设置了。使用 hostnamectl 命令设置机器名字或者手动编辑 /etc/hostname 文件。

$ sudo hostnamectl set-hostname your_machine_short_hostname
$ cat /etc/hostname
$ hostnamectl

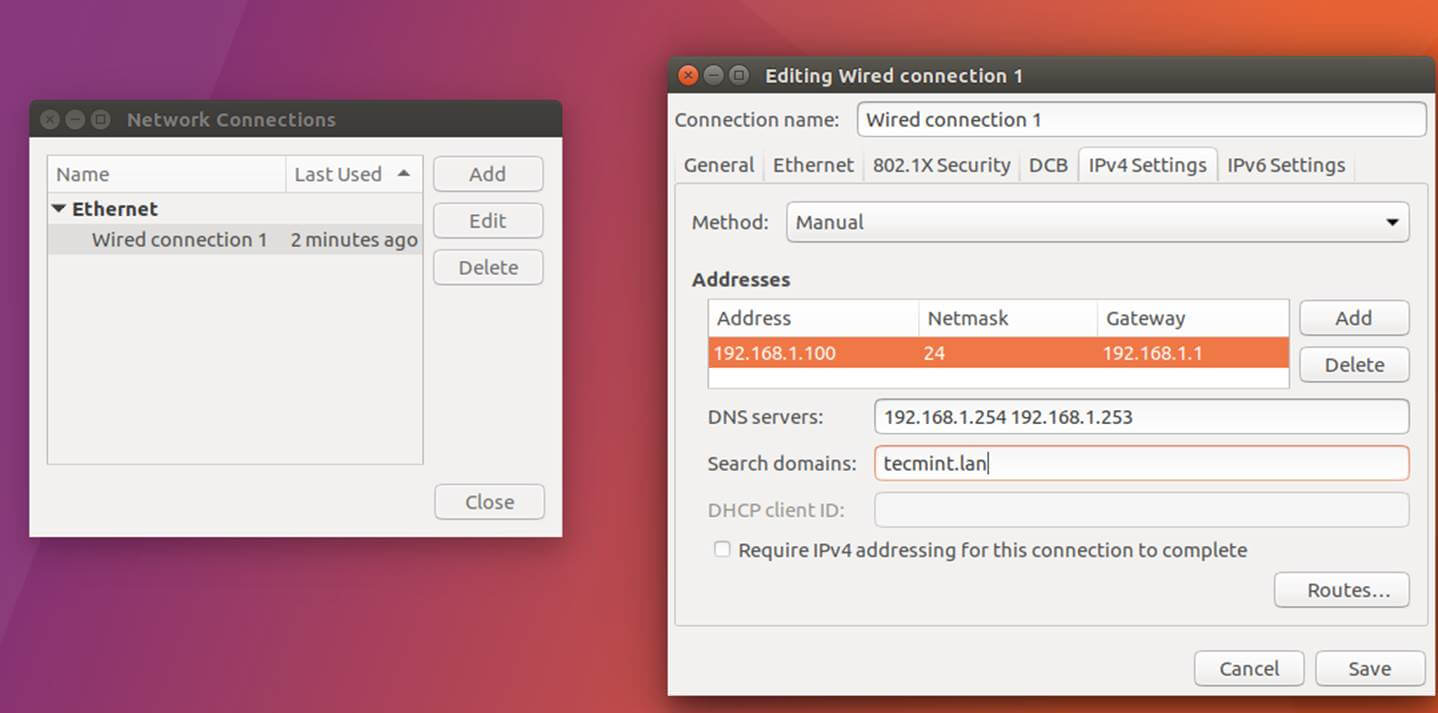
2、 接下来,编辑机器网络接口设置并且添加合适的 IP 设置,并将正确的 DNS IP 服务器地址指向 Samba 活动目录域控制器,如下图所示。

如果你已经配置了 DHCP 服务来为局域网机器自动分配包括合适的 AD DNS IP 地址的 IP 设置,那么你可以跳过这一步。
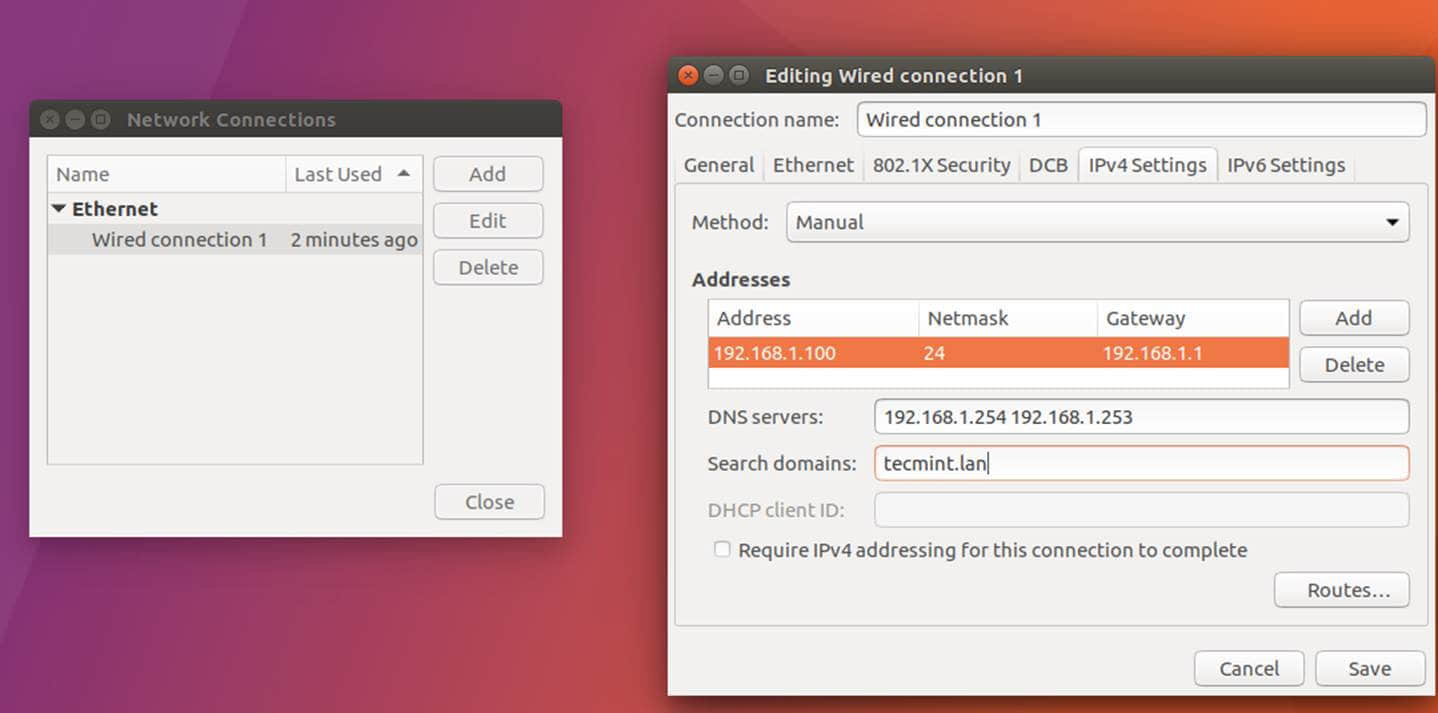
设置网络接口

设置网络接口

上图中,192.168.1.254 和 192.168.1.253 代表 Samba4 域控制器的 IP 地址。

3、 用 GUI(图形用户界面)或命令行重启网络服务来应用修改,并且对你的域名发起一系列 ping 请求来测试 DNS 解析如预期工作。 也用 host 命令来测试 DNS 解析。

$ sudo systemctl restart networking.service
$ host your_domain.tld
$ ping -c2 your_domain_name
$ ping -c2 adc1
$ ping -c2 adc2

4、 最后, 确保机器时间和 Samba4 AD 同步。安装 ntpdate 包并用下列指令和 AD 同步时间。

$ sudo apt-get install ntpdate
$ sudo ntpdate your_domain_name

第 2 步:安装需要的包

5、 这一步将安装将 Ubuntu 加入 Samba4 活动目录域控制器所必须的软件和依赖:Realmd 和 SSSD 服务。

$ sudo apt install adcli realmd krb5-user samba-common-bin samba-libs samba-dsdb-modules sssd sssd-tools libnss-sss libpam-sss packagekit policykit-1 

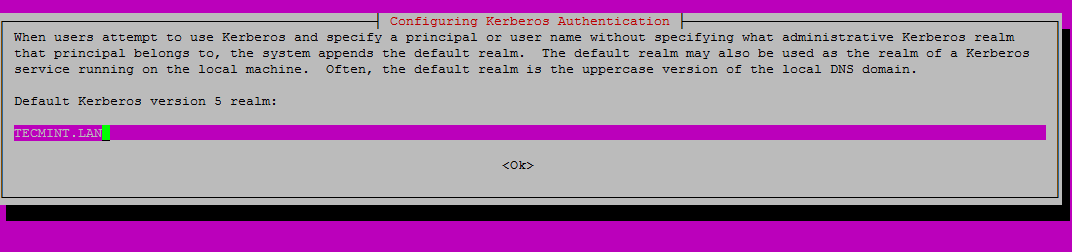
6、 输入大写的默认 realm 名称,然后按下回车继续安装。
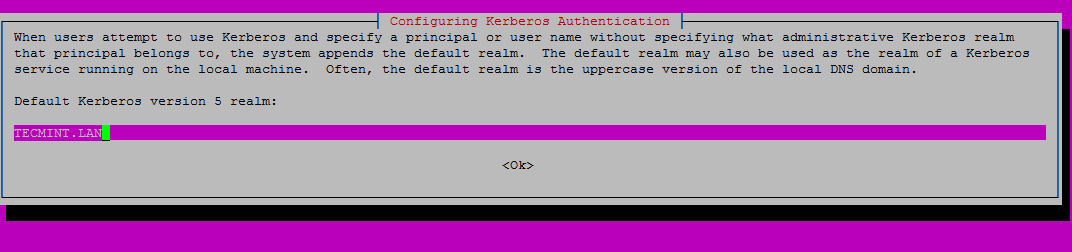
输入 Realm 名称

输入 Realm 名称

7、 接着,创建包含以下内容的 SSSD 配置文件。

$ sudo nano /etc/sssd/sssd.conf

加入下面的内容到 sssd.conf 文件。

[nss]
filter_groups = root
filter_users = root
reconnection_retries = 3
[pam]
reconnection_retries = 3
[sssd]
domains = tecmint.lan
config_file_version = 2
services = nss, pam
default_domain_suffix = TECMINT.LAN
[domain/tecmint.lan]
ad_domain = tecmint.lan
krb5_realm = TECMINT.LAN
realmd_tags = manages-system joined-with-samba
cache_credentials = True
id_provider = ad
krb5_store_password_if_offline = True
default_shell = /bin/bash
ldap_id_mapping = True
use_fully_qualified_names = True
fallback_homedir = /home/%d/%u
access_provider = ad
auth_provider = ad
chpass_provider = ad
access_provider = ad
ldap_schema = ad
dyndns_update = true
dyndsn_refresh_interval = 43200
dyndns_update_ptr = true
dyndns_ttl = 3600

确保你对应地替换了下列参数的域名:

domains = tecmint.lan
default_domain_suffix = TECMINT.LAN
[domain/tecmint.lan]
ad_domain = tecmint.lan
krb5_realm = TECMINT.LAN

8、 接着,用下列命令给 SSSD 配置文件适当的权限:

$ sudo chmod 700 /etc/sssd/sssd.conf

9、 现在,打开并编辑 Realmd 配置文件,输入下面这行:

$ sudo nano /etc/realmd.conf

realmd.conf 文件摘录:

[active-directory]
os-name = Linux Ubuntu
os-version = 17.04
[service]
automatic-install = yes
[users]
default-home = /home/%d/%u
default-shell = /bin/bash
[tecmint.lan]
user-principal = yes
fully-qualified-names = no

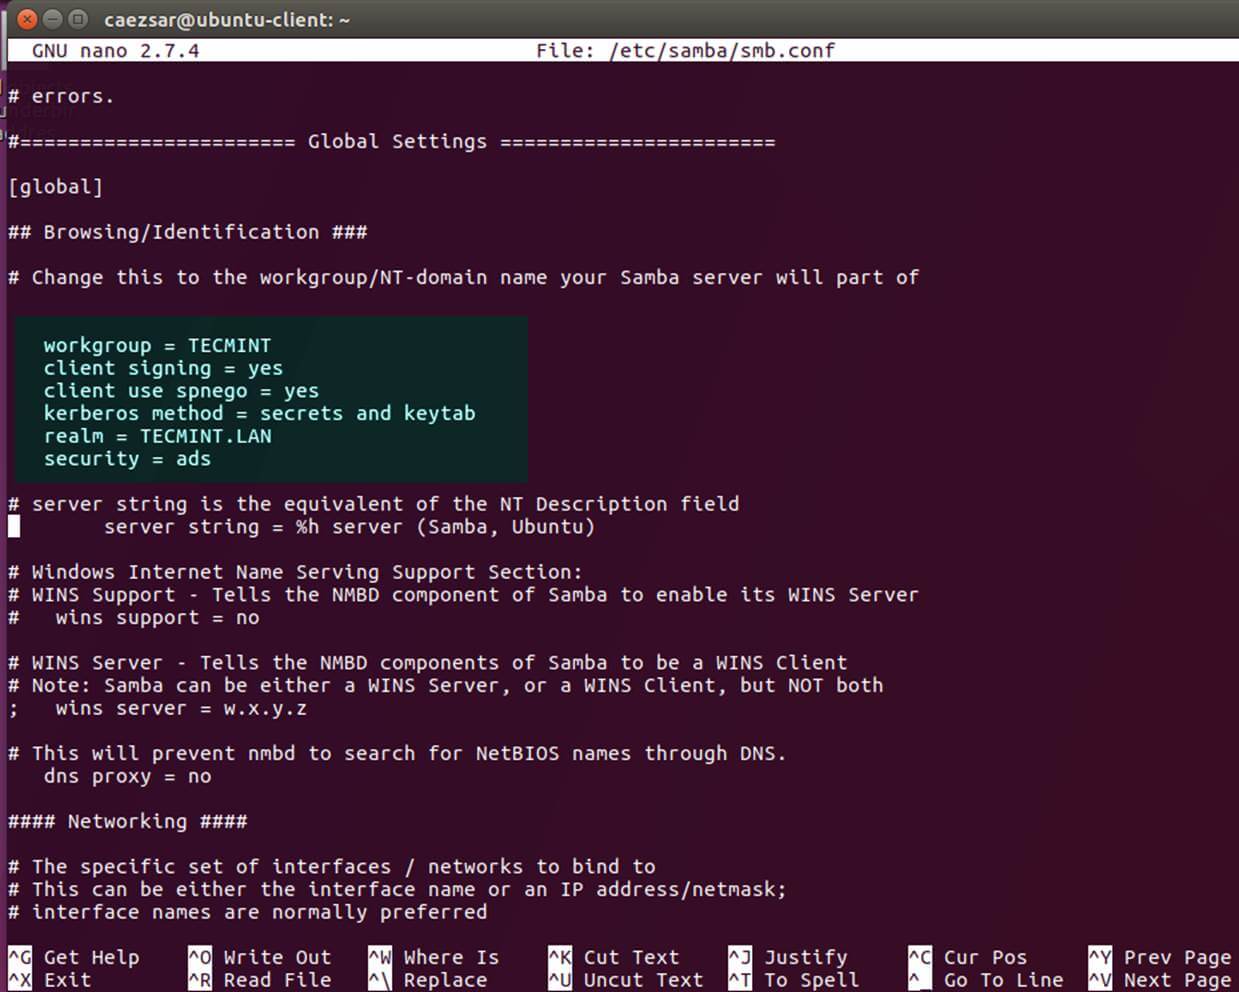
10、 最后需要修改的文件属于 Samba 守护进程。 打开 /etc/samba/smb.conf 文件编辑,然后在文件开头加入下面这块代码,在 [global] 之后的部分如下图所示。

workgroup = TECMINT
client signing = yes
client use spnego = yes
kerberos method = secrets and keytab
realm = TECMINT.LAN
security = ads
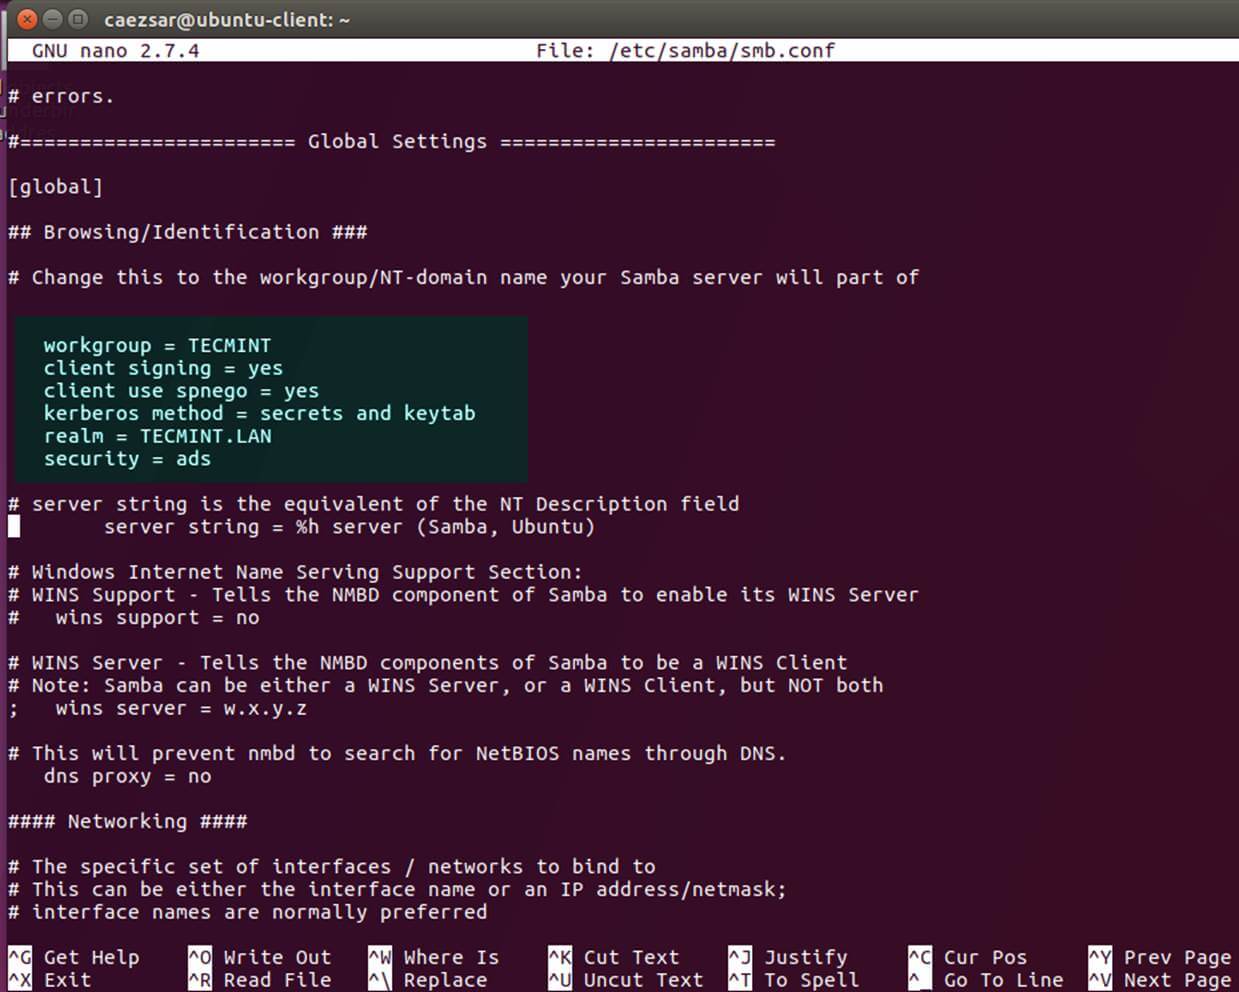
配置 Samba 服务器

配置 Samba 服务器

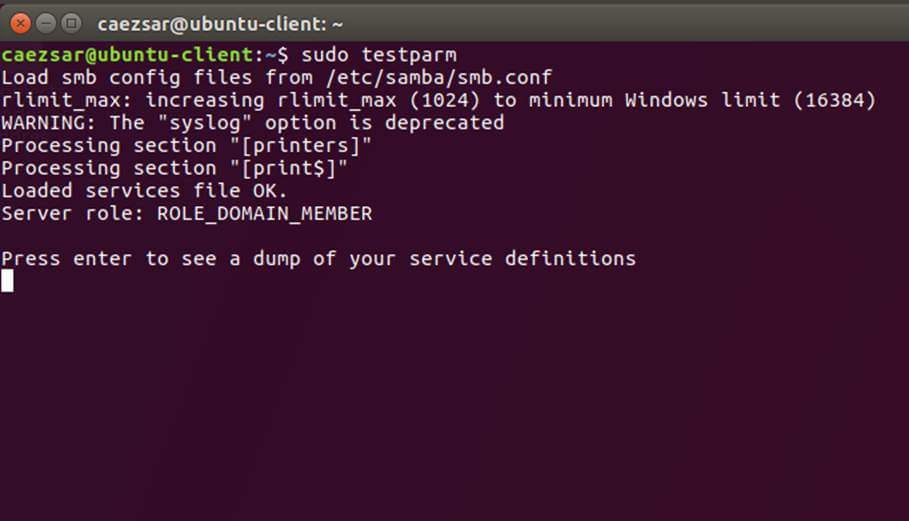
确保你替换了域名值,特别是对应域名的 realm 值,并运行 testparm 命令检验设置文件是否包含错误。

$ sudo testparm
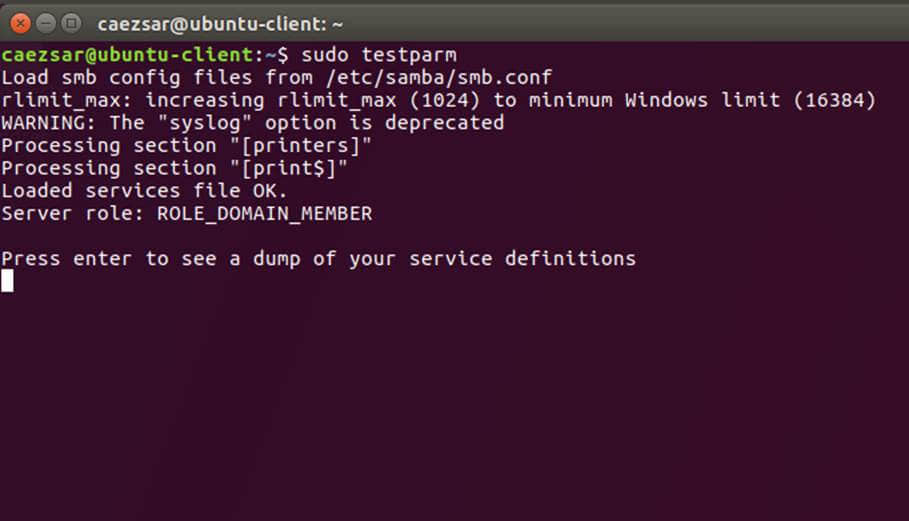
测试 Samba 配置

测试 Samba 配置

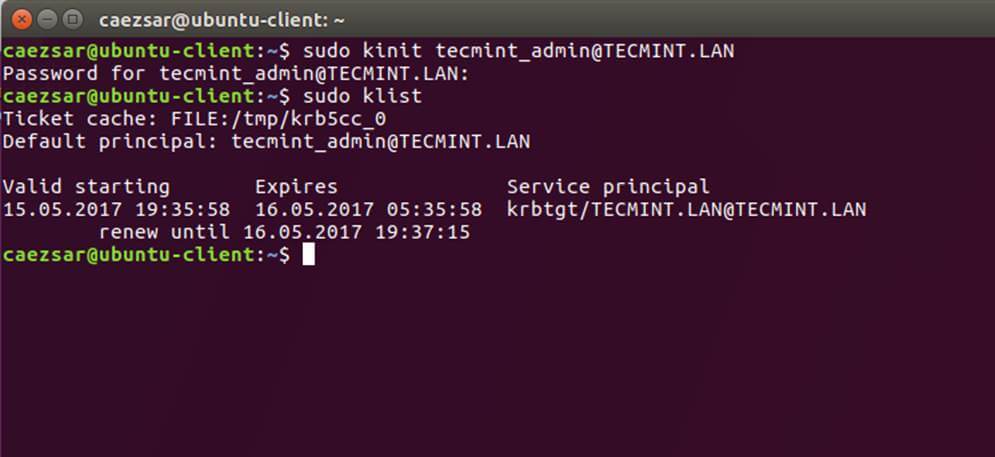
11、 在做完所有必需的修改之后,用 AD 管理员帐号验证 Kerberos 认证并用下面的命令列出票据。

$ sudo kinit [email protected]
$ sudo klist
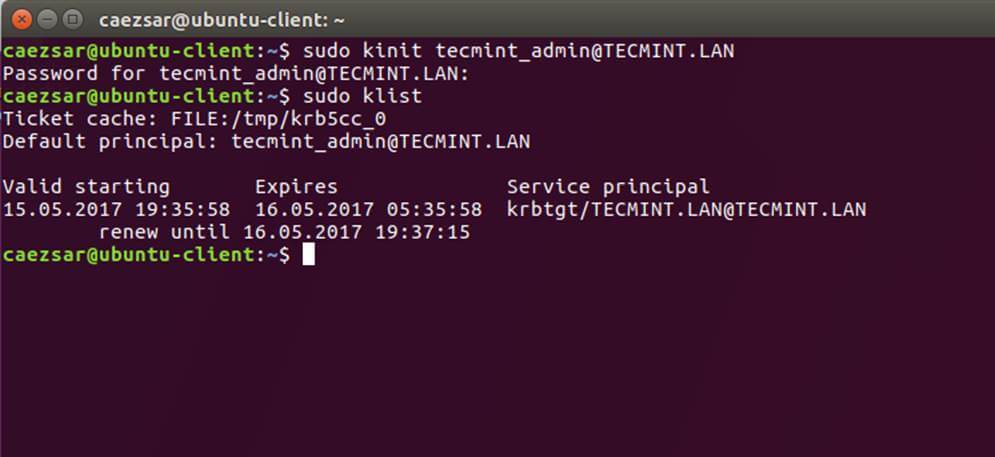
检验 Kerberos 认证

检验 Kerberos 认证

第 3 步: 加入 Ubuntu 到 Samba4 Realm

12、 键入下列命令将 Ubuntu 机器加入到 Samba4 活动目录。用有管理员权限的 AD DC 账户名字,以便绑定 realm 可以如预期般工作,并替换对应的域名值。

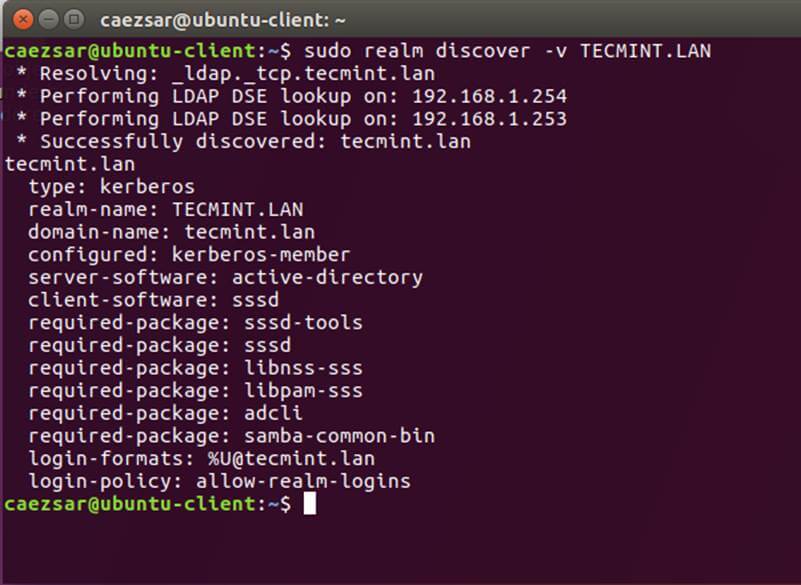
$ sudo realm discover -v DOMAIN.TLD
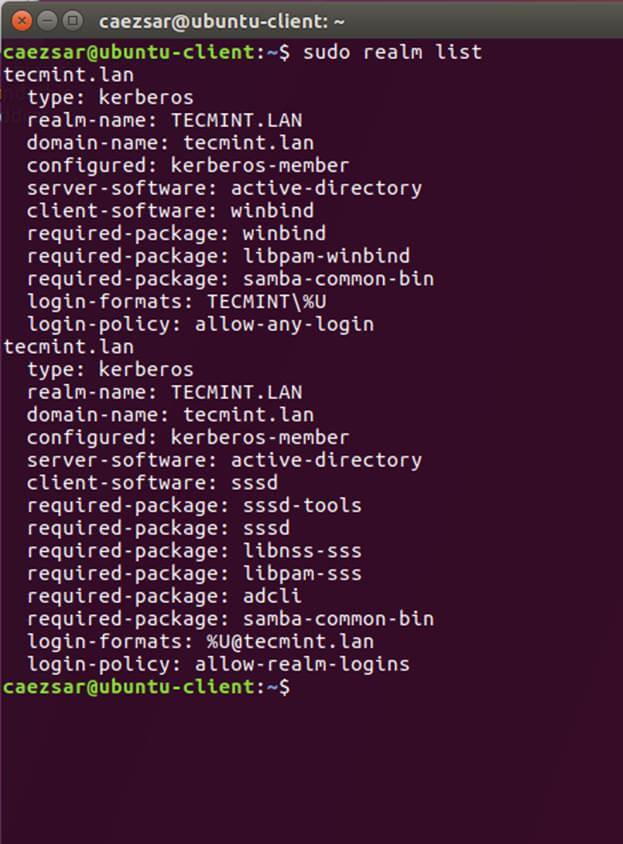
$ sudo realm list
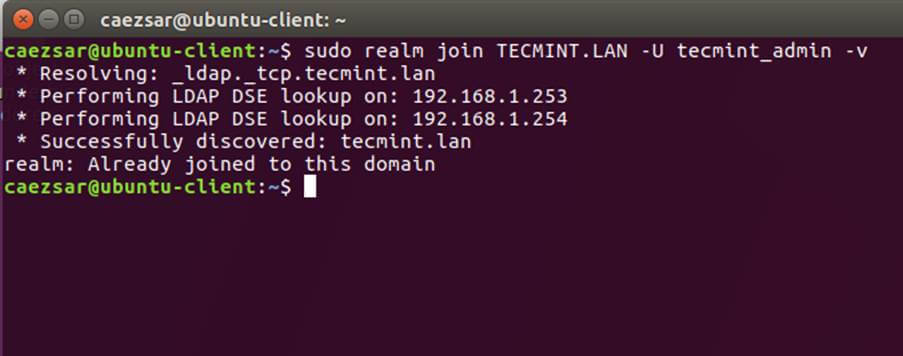
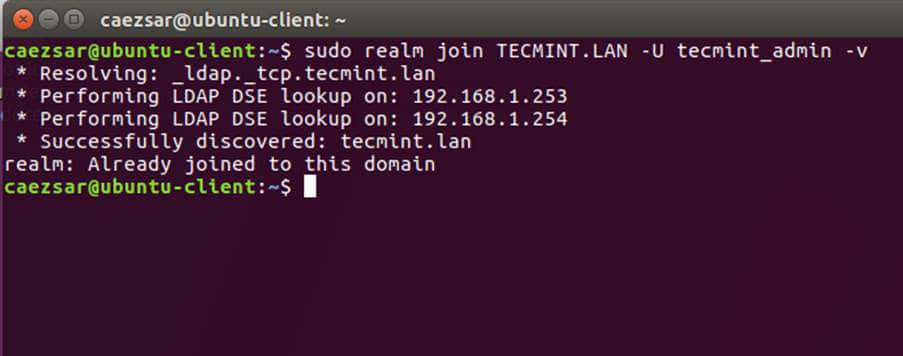
$ sudo realm join TECMINT.LAN -U ad_admin_user -v
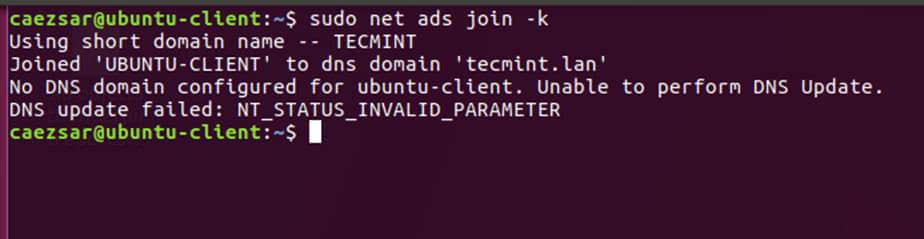
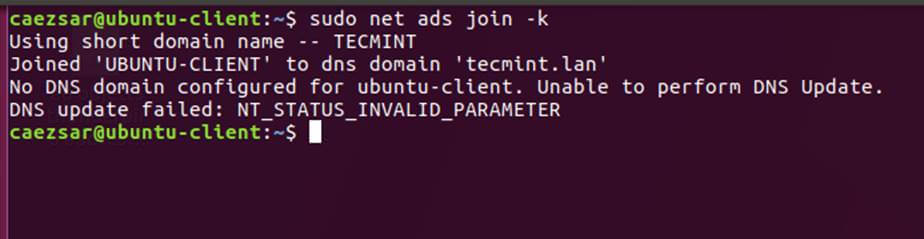
$ sudo net ads join -k
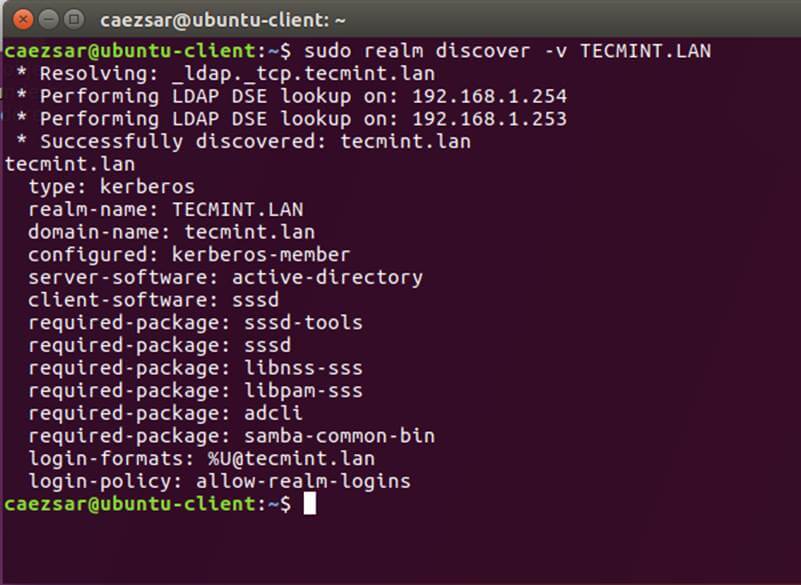
加入 Ubuntu 到 Samba4 Realm
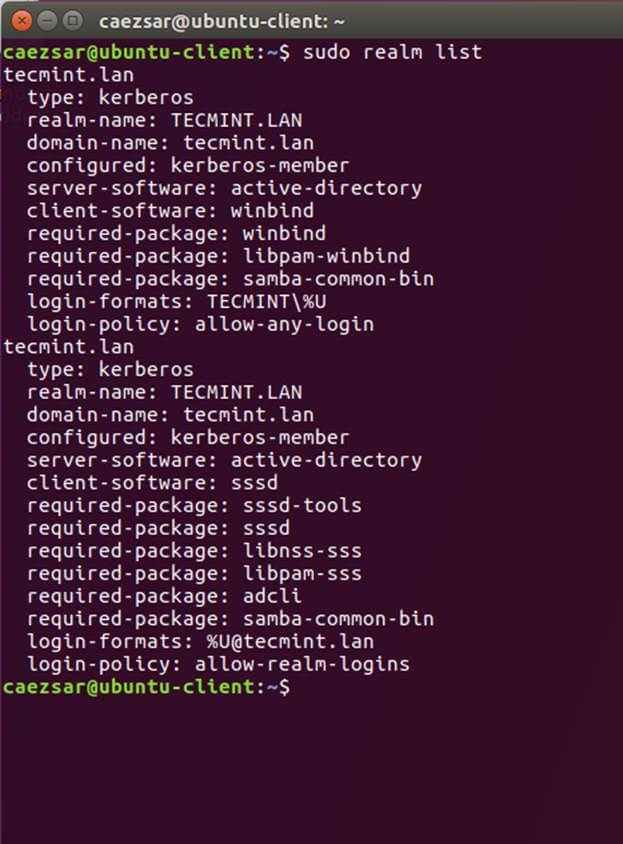
加入 Ubuntu 到 Samba4 Realm

列出 Realm Domain 信息
列出 Realm Domain 信息

加入用户到 Realm Domain

添加用户到 Realm Domain

表列 Realm Domain 信息

添加 Domain 到 Realm

13、 区域绑定好了之后,运行下面的命令确保所有域账户允许在这台机器上认证。

$ sudo realm permit -all

然后你可以使用下面举例的 realm 命令允许或者禁止域用户帐号或群组访问。

$ sudo realm deny -a
$ realm permit --groups ‘domain.tld\Linux Admins’
$ realm permit [email protected]
$ realm permit DOMAIN\\User2

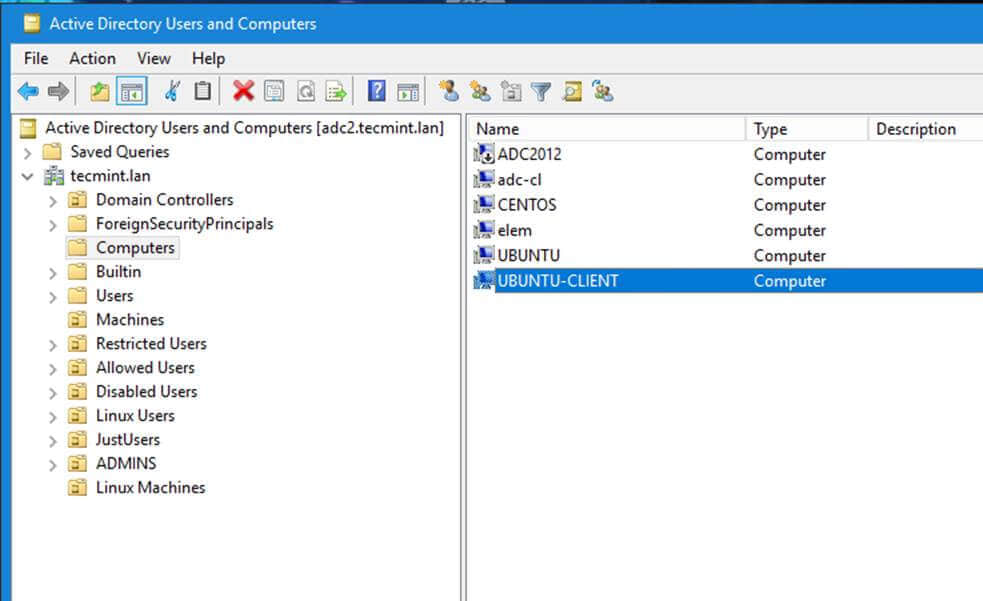
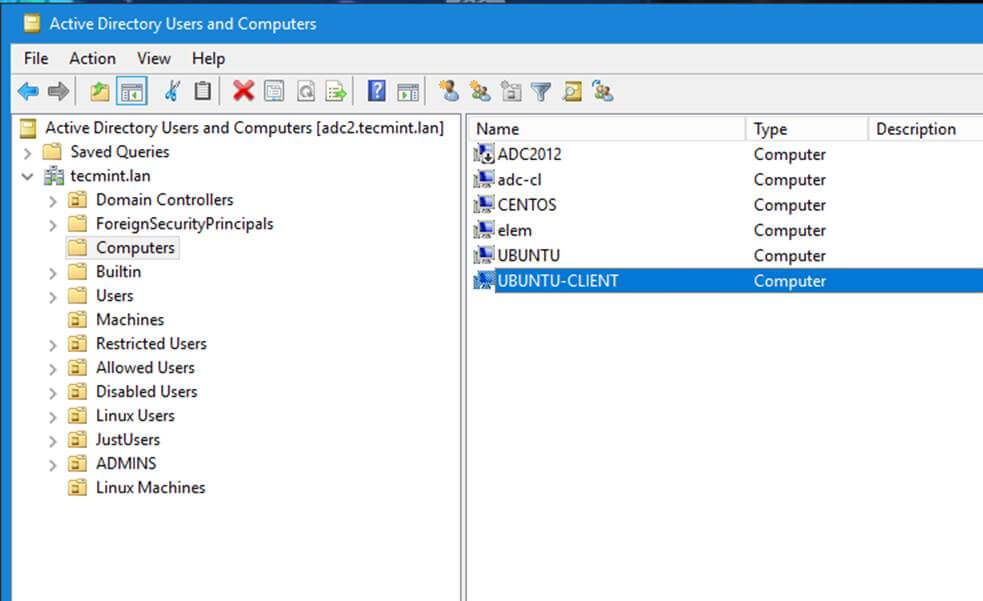
14、 从一个 安装了 RSAT 工具的 Windows 机器上你可以打开 AD UC 并浏览“ 电脑 computers ”容器,并检验是否有一个使用你机器名的对象帐号已经创建。

确保域被加入 AD DC

确保域被加入 AD DC

第 4 步:配置 AD 账户认证

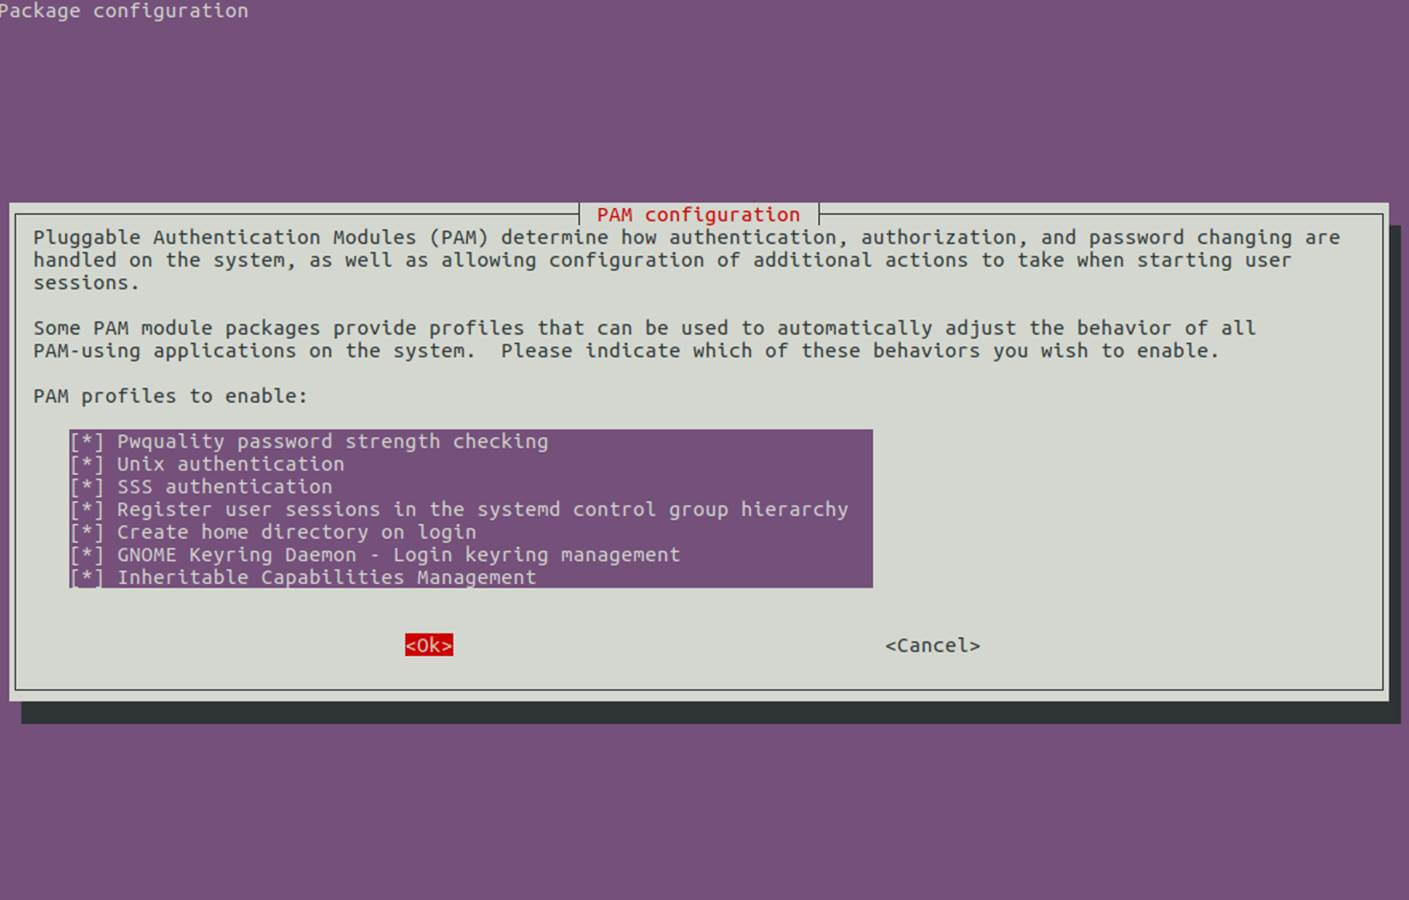
15、 为了在 Ubuntu 机器上用域账户认证,你需要用 root 权限运行 pam-auth-update 命令并允许所有 PAM 配置文件,包括为每个域账户在第一次注册的时候自动创建家目录的选项。

按 [空格] 键检验所有配置项并点击 ok 来应用配置。

$ sudo pam-auth-update
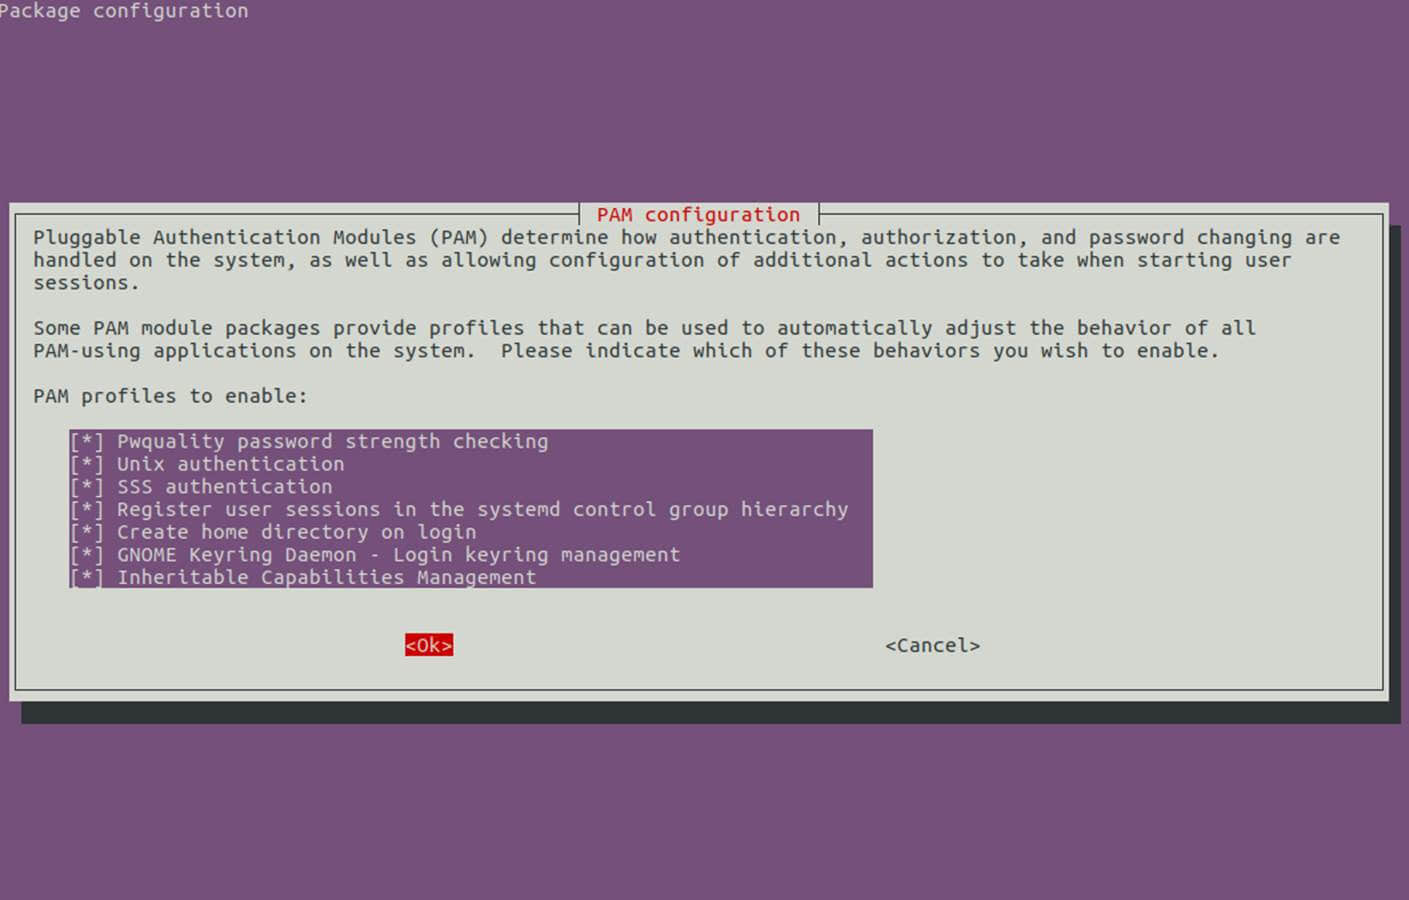
PAM 配置

PAM 配置

16、 在系统上手动编辑 /etc/pam.d/common-account 文件,下面这几行是为了给认证过的域用户自动创建家目录。

session    required    pam_mkhomedir.so    skel=/etc/skel/    umask=0022

17、 如果活动目录用户不能用 linux 命令行修改他们的密码,打开 /etc/pam.d/common-password 文件并在 password 行移除 use_authtok 语句,最后如下:

password       [success=1 default=ignore]      pam_winbind.so try_first_pass

18、 最后,用下面的命令重启并启用以应用 Realmd 和 SSSD 服务的修改:

$ sudo systemctl restart realmd sssd
$ sudo systemctl enable realmd sssd

19、 为了测试 Ubuntu 机器是是否成功集成到 realm ,安装 winbind 包并运行 wbinfo 命令列出域账户和群组,如下所示。

$ sudo apt-get install winbind
$ wbinfo -u
$ wbinfo -g
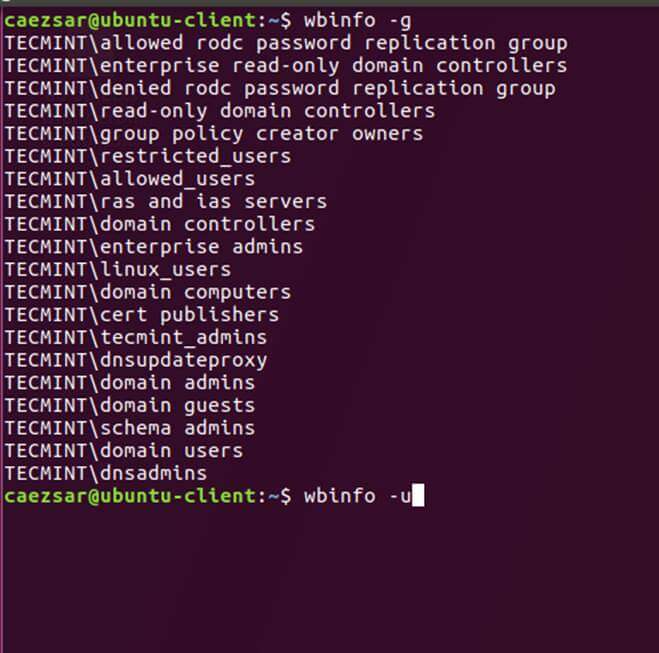
列出域账户

列出域账户

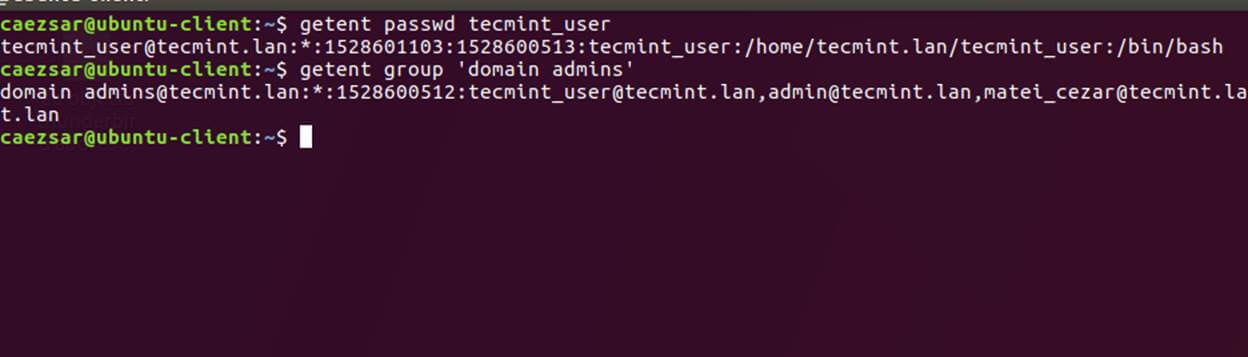
20、 同样,也可以针对特定的域用户或群组使用 getent 命令检验 Winbind nsswitch 模块。

$ sudo getent passwd your_domain_user
$ sudo getent group ‘domain admins’
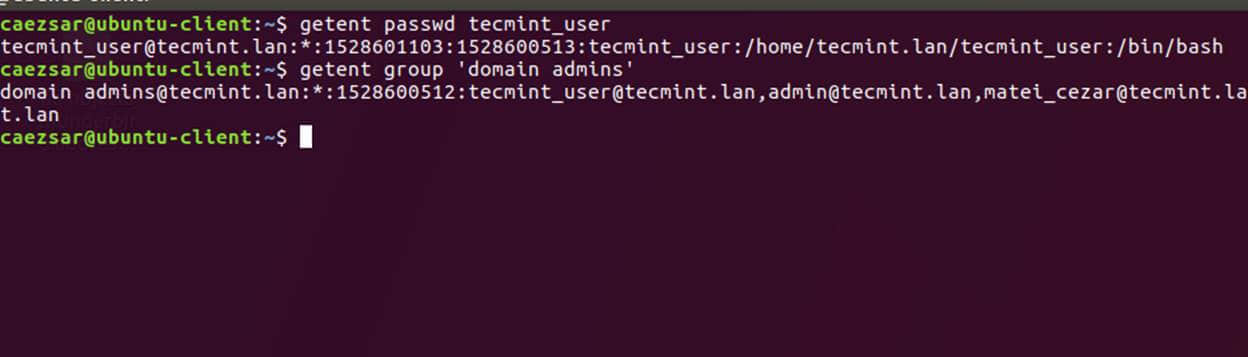
检验 Winbind Nsswitch

检验 Winbind Nsswitch

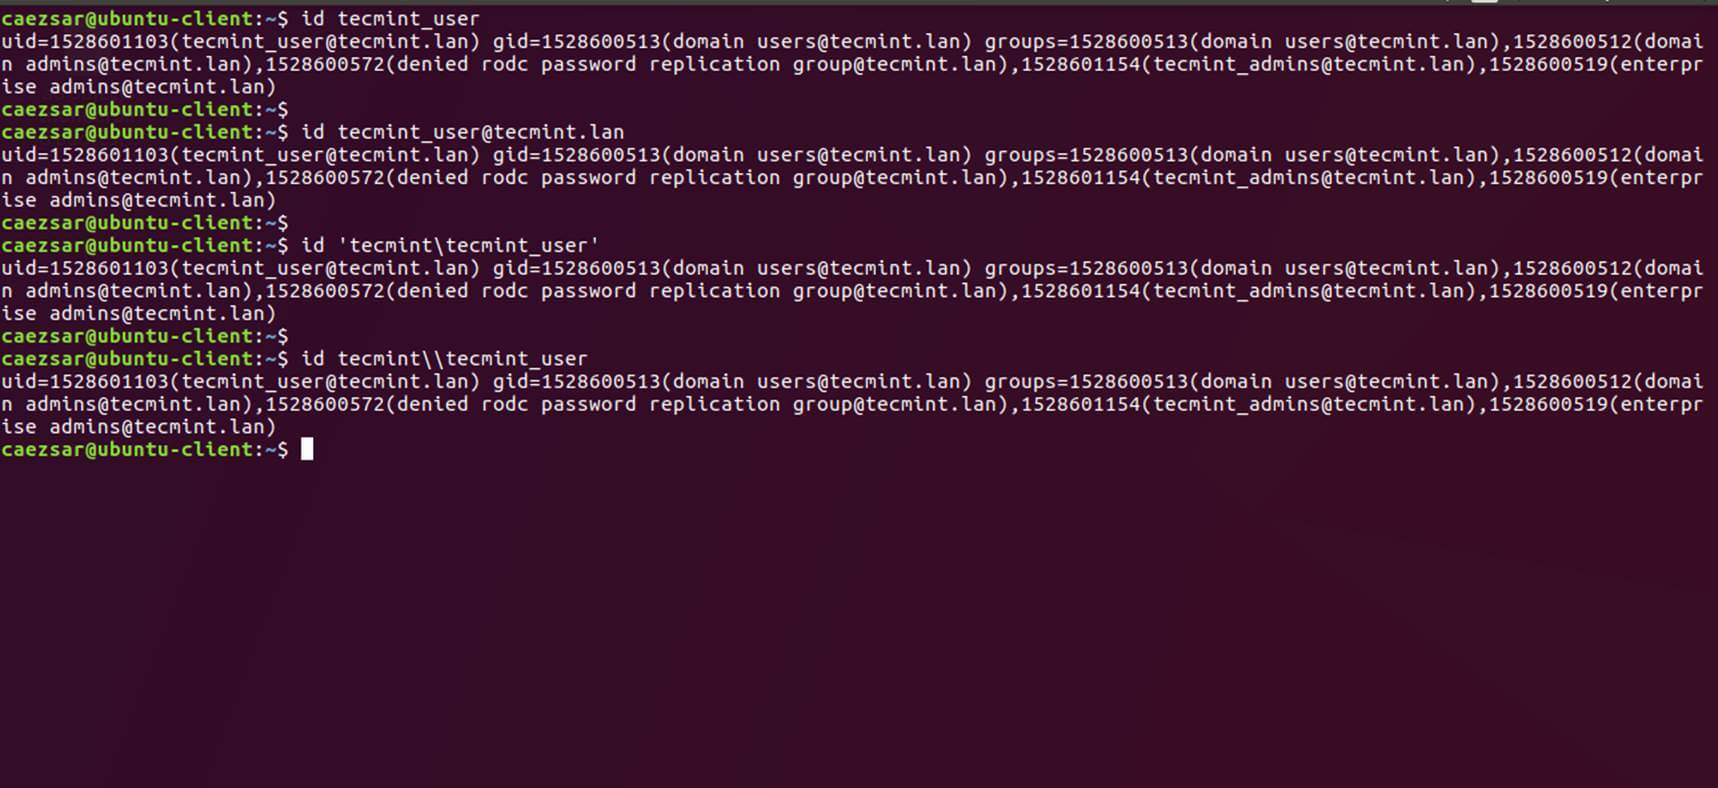
21、 你也可以用 Linux id 命令获取 AD 账户的信息,命令如下:

$ id tecmint_user
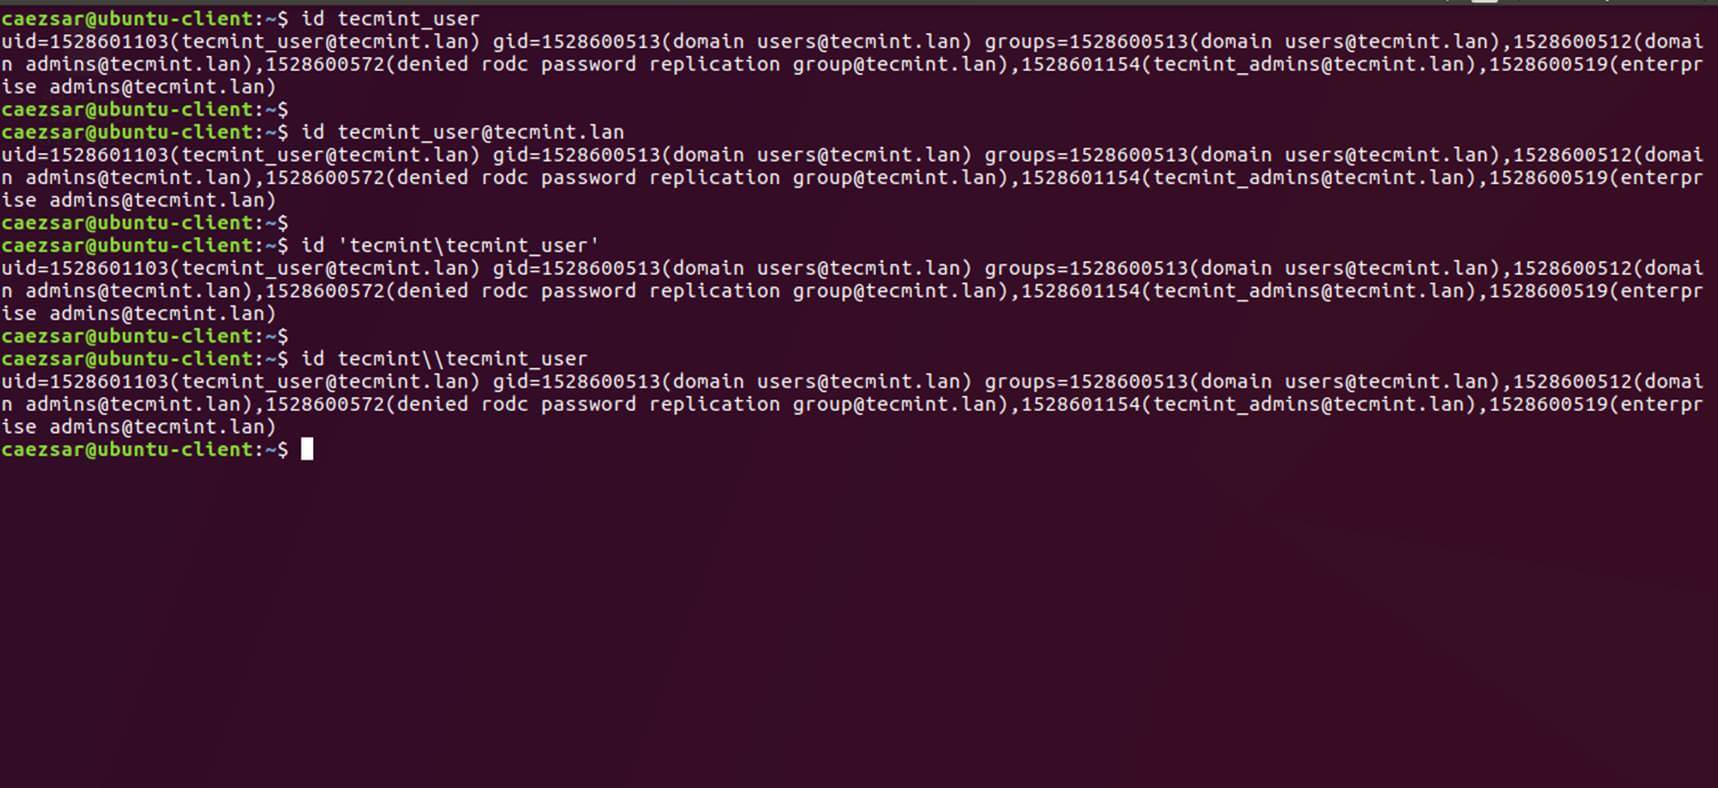
检验 AD 用户信息

检验 AD 用户信息

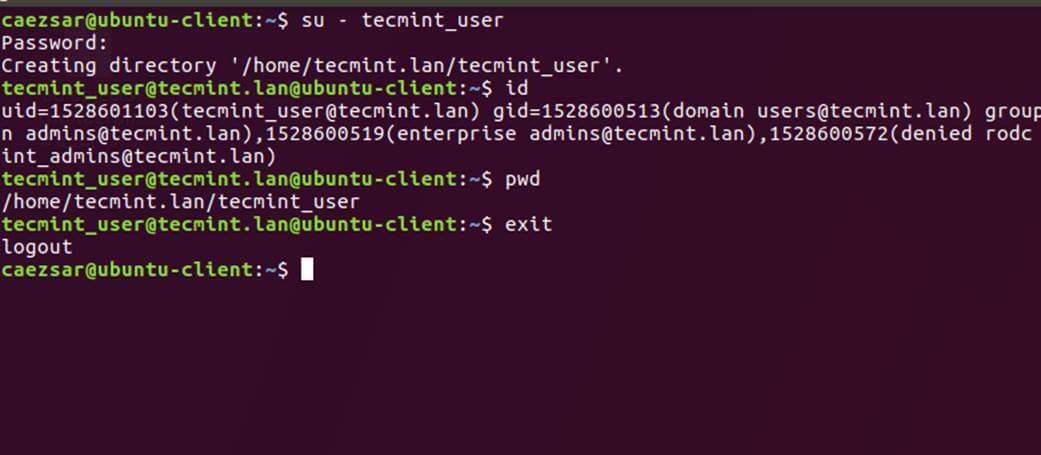
22、 用 su - 后跟上域用户名参数来认证 Ubuntu 主机的一个 Samba4 AD 账户。运行 id 命令获取该 AD 账户的更多信息。

$ su - your_ad_user
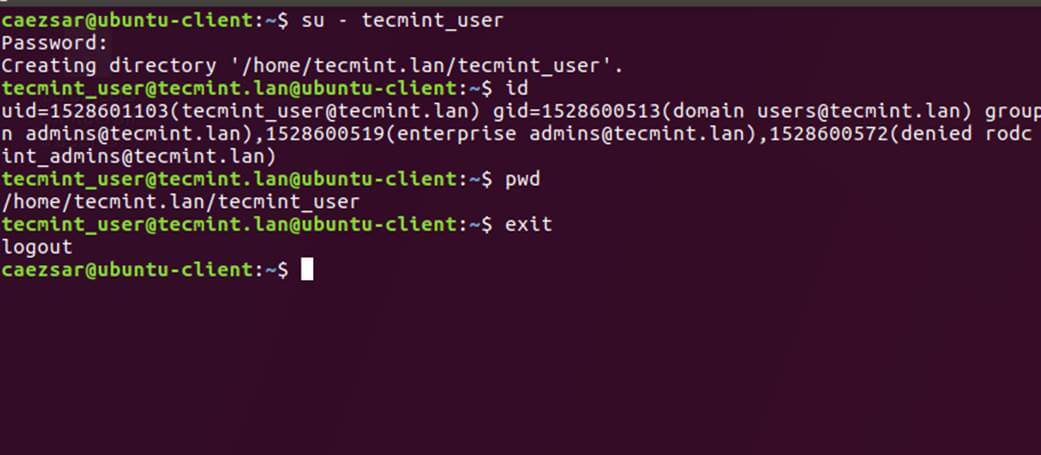
AD 用户认证

AD 用户认证

用 pwd 命令查看你的域用户当前工作目录,和用 passwd 命令修改密码。

23、 在 Ubuntu 上使用有 root 权限的域账户,你需要用下面的命令添加 AD 用户名到 sudo 系统群组:

$ sudo usermod -aG sudo [email protected]

用域账户登录 Ubuntu 并运行 apt update 命令来更新你的系统以检验 root 权限。

24、 给一个域群组 root 权限,用 visudo 命令打开并编辑 /etc/sudoers 文件,并加入如下行:

%domain\ [email protected]              ALL=(ALL:ALL) ALL

25、 要在 Ubuntu 桌面使用域账户认证,通过编辑 /usr/share/lightdm/lightdm.conf.d/50-ubuntu.conf 文件来修改 LightDM 显示管理器,增加以下两行并重启 lightdm 服务或重启机器应用修改。

greeter-show-manual-login=true
greeter-hide-users=true

域账户用“你的域用户”或“你的域用户@你的域” 格式来登录 Ubuntu 桌面。

26、 为使用 Samba AD 账户的简称格式,编辑 /etc/sssd/sssd.conf 文件,在 [sssd] 块加入如下几行命令。

full_name_format = %1$s

并重启 SSSD 守护进程应用改变。

$ sudo systemctl restart sssd

你会注意到 bash 提示符会变成了没有附加域名部分的 AD 用户名。

27、 万一你因为 sssd.conf 里的 enumerate=true 参数设定而不能登录,你得用下面的命令清空 sssd 缓存数据:

$ rm /var/lib/sss/db/cache_tecmint.lan.ldb

这就是全部了!虽然这个教程主要集中于集成 Samba4 活动目录,同样的步骤也能被用于把使用 Realm 和 SSSD 服务的 Ubuntu 整合到微软 Windows 服务器活动目录。


作者简介:

Matei Cezar - 我是一名网瘾少年,开源和基于 linux 系统软件的粉丝,有4年经验在 linux 发行版桌面、服务器和 bash 脚本。


via: https://www.tecmint.com/integrate-ubuntu-to-samba4-ad-dc-with-sssd-and-realm/

作者:Matei Cezar 译者:XYenChi 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出
在 GitHub,我们最近从头改进了 DNS。这包括了我们如何与外部 DNS 提供商交互以及我们如何在内部向我们的主机提供记录。为此,我们必须设计和构建一个新的 DNS 基础设施,它可以随着 GitHub 的增长扩展并跨越多个数据中心。

以前,GitHub 的 DNS 基础设施相当简单直接。它包括每台服务器上本地的、只具备转发功能的 DNS 缓存服务器,以及一对被所有这些主机使用的缓存服务器和权威服务器主机。这些主机在内部网络以及公共互联网上都可用。我们在缓存守护程序中配置了 区域 zone 存根 stub ,以在本地进行查询,而不是在互联网上进行递归。我们还在我们的 DNS 提供商处设置了 NS 记录,它们将特定的内部 域 domain 指向这对主机的公共 IP,以便我们网络外部的查询。

这个配置使用了很多年,但它并非没有缺点。许多程序对于解析 DNS 查询非常敏感,我们遇到的任何性能或可用性问题在最好的情况下也会导致服务排队和性能降级,而最坏情况下客户会遭遇服务中断。配置和代码的更改可能会导致查询率发生大幅度的意外变化。因此超出这两台主机的扩展成为了一个问题。由于这些主机的网络配置,如果我们只是继续添加 IP 和主机的话存在一些本身的问题。在试图解决和补救这些问题的同时,由于缺乏测量指标和可见性,老旧的系统难以识别问题的原因。在许多情况下,我们使用 tcpdump 来识别有问题的流量和查询。另一个问题是在公共 DNS 服务器上运行,我们处于泄露内部网络信息的风险之下。因此,我们决定建立更好的东西,并开始确定我们对新系统的要求。

我们着手设计一个新的 DNS 基础设施,以改善上述包括扩展和可见性在内的运维问题,并引入了一些额外的需求。我们希望通过外部 DNS 提供商继续运行我们的公共 DNS 域,因此我们构建的系统需要与供应商无关。此外,我们希望该系统能够服务于我们的内部和外部域,这意味着内部域仅在我们的内部网络上可用,除非另有特别配置,而外部域也不用离开我们的内部网络就可解析。我们希望新的 DNS 架构不但可以基于部署的工作流进行更改,并可以通过我们的仓库和配置系统使用 API 自动更改 DNS 记录。新系统不能有任何外部依赖,太依赖于 DNS 功能将会陷入级联故障,这包括连接到其他数据中心和其中可能有的 DNS 服务。我们的旧系统将缓存服务器和权威服务器在同一台主机上混合使用。我们想转到具有独立角色的分层设计。最后,我们希望系统能够支持多数据中心环境,无论是 EC2 还是裸机。

实现

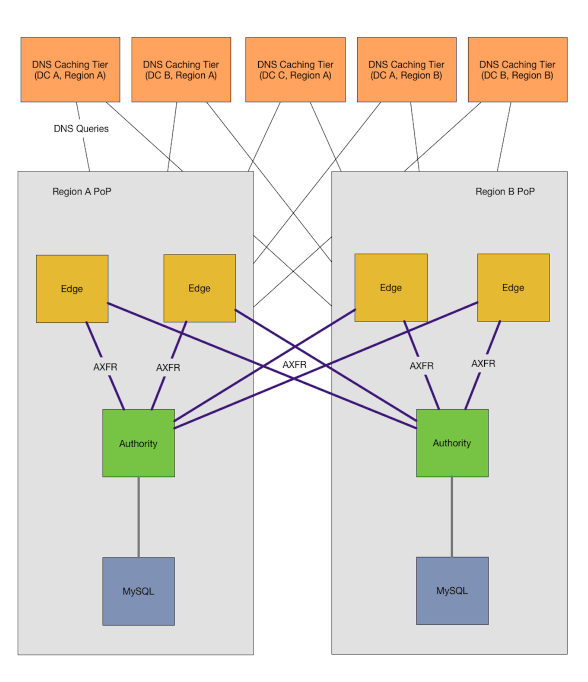
为了构建这个系统,我们确定了三类主机: 缓存主机 cache 、 边缘主机 edge 和 权威主机 authority 。缓存主机作为 递归解析器 recursive resolver 和 DNS “路由器” 缓存来自边缘层的响应。边缘层运行 DNS 权威守护程序,用于响应缓存层对 DNS 区域 zone 的请求,其被配置为来自权威层的 区域传输 zone transfer 。权威层作为隐藏的 DNS 主服务器 master ,作为 DNS 数据的规范来源,为来自边缘主机的 区域传输 zone transfer 提供服务,并提供用于创建、修改或删除记录的 HTTP API。

在我们的新配置中,缓存主机存在于每个数据中心中,这意味着应用主机不需要穿过数据中心边界来检索记录。缓存主机被配置为将 区域 zone 映射到其 地域 region 内的边缘主机,以便将我们的内部 区域 zone 路由到我们自己的主机。未明确配置的任何 区域 zone 将通过互联网递归解析。

边缘主机是地域性的主机,存在我们的网络边缘 PoP( 存在点 Point of Presence )内。我们的 PoP 有一个或多个依赖于它们进行外部连接的数据中心,没有 PoP 数据中心将无法访问互联网,互联网也无法访问它们。边缘主机对所有的权威主机执行 区域传输 zone transfer ,无论它们存在什么 地域 region 或 位置 location ,并将这些区域存在本地的磁盘上。

我们的权威主机也是地域性的主机,只包含适用于其所在 地域 region 的 区域 zone 。我们的仓库和配置系统决定一个 区域 zone 存放在哪个 地域性权威主机 regional authority ,并通过 HTTP API 服务来创建和删除记录。 OctoDNS 将区域映射到地域性权威主机,并使用相同的 API 创建静态记录,以及确保动态源处于同步状态。对于外部域 (如 github.com),我们有另外一个单独的权威主机,以允许我们可以在连接中断期间查询我们的外部域。所有记录都存储在 MySQL 中。

可运维性

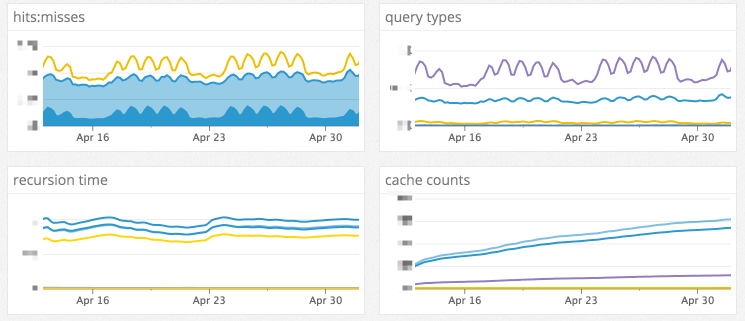
迁移到更现代的 DNS 基础设施的巨大好处是可观察性。我们的旧 DNS 系统几乎没有指标,只有有限的日志。决定使用哪些 DNS 服务器的一个重要因素是它们所产生的指标的广度和深度。我们最终用 Unbound 作为缓存主机,NSD 作为边缘主机,PowerDNS 作为权威主机,所有这些都已在比 GitHub 大得多的 DNS 基础架构中得到了证实。

当在我们的裸机数据中心运行时,缓存通过私有的 任播 anycast IP 访问,从而使之可以到达最近的可用缓存主机。缓存主机已经以机架感知的方式部署,在它们之间提供了一定程度的平衡负载,并且与一些电源和网络故障模式相隔离。当缓存主机出现故障时,通常将用其进行 DNS 查询的服务器现在将自动路由到下一个最接近的缓存主机,以保持低延迟并提供对某些故障模式的容错。任播允许我们扩展单个 IP 地址后面的缓存数量,这与先前的配置不同,使得我们能够按 DNS 需求量运行尽可能多的缓存主机。

无论地域或位置如何,边缘主机使用权威层进行区域传输。我们的 区域 zone 并没有大到在每个 地域 region 保留所有 区域 zone 的副本成为问题。(LCTT 译注:此处原文“Our zones are not large enough that keeping a copy of all of them in every region is a problem.”,根据上下文理解而翻译。)这意味着对于每个区域,即使某个地域处于脱机状态,或者上游服务提供商存在连接问题,所有缓存服务器都可以访问具备所有区域的本地副本的本地边缘服务器。这种变化在面对连接问题方面已被证明是相当有弹性的,并且在不久前本来会导致客户面临停止服务的故障期间帮助保持 GitHub 可用。

那些区域传输包括了内部和外部域从它们相应的权威服务器进行的传输。正如你可能会猜想像 github.com 这样的区域是外部的,像 github.net 这样的区域通常是内部的。它们之间的区别仅在于我们使用的类型和存储在其中的数据。了解哪些区域是内部和外部的,为我们在配置中提供了一些灵活性。

$ dig +short github.com
192.30.253.112
192.30.253.113

公共 区域 zone 被同步到外部 DNS 提供商,并且是 GitHub 用户每天使用的 DNS 记录。另外,公共区域在我们的网络中是完全可解析的,而不需要与我们的外部提供商进行通信。这意味着需要查询 api.github.com 的任何服务都可以这样做,而无需依赖外部网络连接。我们还使用了 Unbound 的 stub-first 配置选项,它给了我们第二次查询的机会,如果我们的内部 DNS 服务由于某些原因在外部查询失败,则可以进行第二次查找。

$ dig +short time.github.net
10.127.6.10

大部分的 github.net 区域是完全私有的,无法从互联网访问,它只包含 RFC 1918 中规定的 IP 地址。每个地域和站点都划分了私有区域。每个地域和/或站点都具有适用于该位置的一组子区域,子区域用于管理网络、服务发现、特定的服务记录,并且还包括在我们仓库中的配置主机。私有区域还包括 PTR 反向查找区域。

总结

用一个新系统替换可以为数百万客户提供服务的旧系统并不容易。使用实用的、基于需求的方法来设计和实施我们的新 DNS 系统,才能打造出一个能够迅速有效地运行、并有望与 GitHub 一起成长的 DNS 基础设施。

想帮助 GitHub SRE 团队解决有趣的问题吗?我们很乐意你加入我们。在这申请。


via: https://githubengineering.com/dns-infrastructure-at-github/

作者:Joe Williams 译者:geekpi 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出
介绍

数据包过滤可让你专注于你感兴趣的确定数据集。如你所见,Wireshark 默认会抓取所有数据包。这可能会妨碍你寻找具体的数据。 Wireshark 提供了两个功能强大的过滤工​​具,让你简单而无痛地获得精确的数据。

Wireshark 可以通过两种方式过滤数据包。它可以通过只收集某些数据包来过滤,或者在抓取数据包后进行过滤。当然,这些可以彼此结合使用,并且它们各自的用处取决于收集的数据和信息的多少。

布尔表达式和比较运算符

Wireshark 有很多很棒的内置过滤器。当开始输入任何一个过滤器字段时,你将看到它们会自动补完。这些过滤器大多数对应于用户对数据包的常见分组方式,比如仅过滤 HTTP 请求就是一个很好的例子。

对于其他的,Wireshark 使用布尔表达式和/或比较运算符。如果你曾经做过任何编程,你应该熟悉布尔表达式。他们是使用 and、or、not 来验证声明或表达式的真假。比较运算符要简单得多,它们只是确定两件或更多件事情是否彼此相等、大于或小于。

过滤抓包

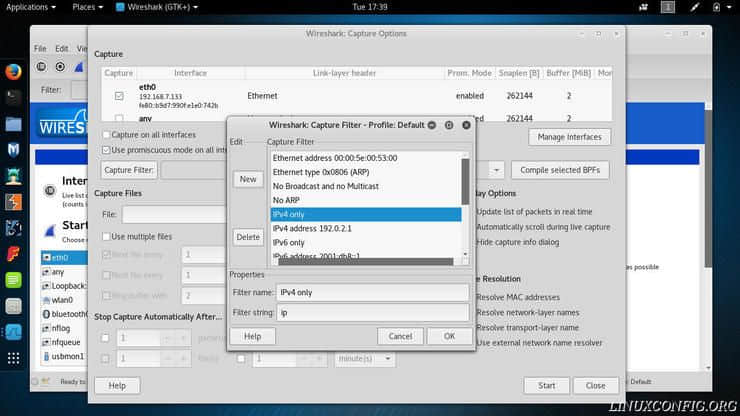
在深入自定义抓包过滤器之前,请先查看 Wireshark 已经内置的内容。单击顶部菜单上的 “Capture” 选项卡,然后点击 “Options”。可用接口下面是可以编写抓包过滤器的行。直接移到左边一个标有 “Capture Filter” 的按钮上。点击它,你将看到一个新的对话框,其中包含内置的抓包过滤器列表。看看里面有些什么。

Wireshark dialog for creating a capture filter

在对话框的底部,有一个用于创建并保存抓包过滤器的表单。按左边的 “New” 按钮。它将创建一个填充有默认数据的新的抓包过滤器。要保存新的过滤器,只需将实际需要的名称和表达式替换原来的默认值,然后单击“Ok”。过滤器将被保存并应用。使用此工具,你可以编写并保存多个不同的过滤器,以便它们将来可以再次使用。

抓包有自己的过滤语法。对于比较,它不使用等于号,并使用 > 和 < 来用于大于或小于。对于布尔值来说,它使用 and、or 和 not。

例如,如果你只想监听 80 端口的流量,你可以使用这样的表达式:port 80。如果你只想从特定的 IP 监听端口 80,你可以使用 port 80 and host 192.168.1.20。如你所见,抓包过滤器有特定的关键字。这些关键字用于告诉 Wireshark 如何监控数据包以及哪一个数据是要找的。例如,host 用于查看来自 IP 的所有流量。src 用于查看源自该 IP 的流量。与之相反,dst 只监听目标到这个 IP 的流量。要查看一组 IP 或网络上的流量,请使用 net。

过滤结果

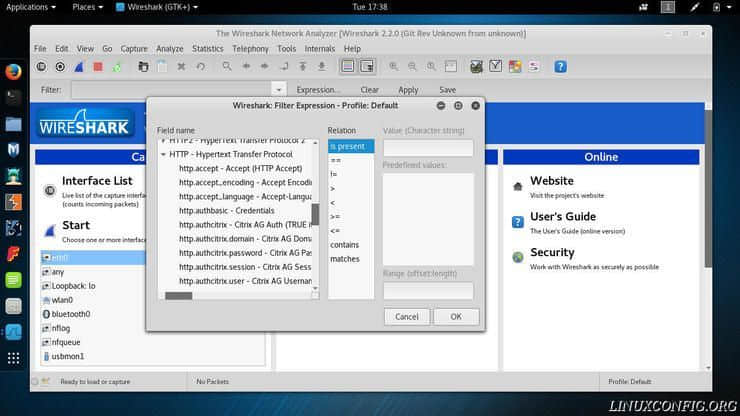
界面的底部菜单栏是专门用于过滤结果的菜单栏。此过滤器不会更改 Wireshark 收集的数据,它只允许你更轻松地对其进行排序。有一个文本字段用于输入新的过滤器表达式,并带有一个下拉箭头以查看以前输入的过滤器。旁边是一个标为 “Expression” 的按钮,另外还有一些用于清除和保存当前表达式的按钮。

点击 “Expression” 按钮。你将看到一个小窗口,其中包含多个选项。左边一栏有大量的条目,每个都有附加的折叠子列表。你可以用这些来过滤所有不同的协议、字段和信息。你不可能看完所有,所以最好是大概看下。你应该注意到了一些熟悉的选项,如 HTTP、SSL 和 TCP。

Wireshark dailog for creating a results filter

子列表包含可以过滤的不同部分和请求方法。你可以看到通过 GET 和 POST 请求过滤 HTTP 请求。

你还可以在中间看到运算符列表。通过从每列中选择条目,你可以使用此窗口创建过滤器,而不用记住 Wireshark 可以过滤的每个条目。对于过滤结果,比较运算符使用一组特定的符号。 == 用于确定是否相等。> 用于确定一件东西是否大于另一个东西,< 找出是否小一些。 >= 和 <= 分别用于大于等于和小于等于。它们可用于确定数据包是否包含正确的值或按大小过滤。使用 == 仅过滤 HTTP GET 请求的示例如下:http.request.method == "GET"。

布尔运算符基于多个条件将小的表达式串到一起。不像是抓包所使用的单词,它使用三个基本的符号来做到这一点。&& 代表 “与”。当使用时,&& 两边的两个语句都必须为真值才行,以便 Wireshark 来过滤这些包。|| 表示 “或”。只要两个表达式任何一个为真值,它就会被过滤。如果你正在查找所有的 GET 和 POST 请求,你可以这样使用 ||:(http.request.method == "GET") || (http.request.method == "POST")。! 是 “非” 运算符。它会寻找除了指定的东西之外的所有东西。例如,!http 将展示除了 HTTP 请求之外的所有东西。

总结思考

过滤 Wireshark 可以让你有效监控网络流量。熟悉可以使用的选项并习惯你可以创建过滤器的强大表达式需要一些时间。然而一旦你学会了,你将能够快速收集和查找你要的网络数据,而无需梳理长长的数据包或进行大量的工作。


via: https://linuxconfig.org/filtering-packets-in-wireshark-on-kali-linux

作者:Nick Congleton 译者:geekpi 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出