分类 软件开发 下的文章

JavaScript 是为 Web 而生的,但它可以做的事远不止于此。本文将带领你了解它的基础知识,然后你可以下载我们的备忘清单,以便随时掌握详细信息。
JavaScript 是一种充满惊喜的编程语言。许多人第一次遇到 JavaScript 时,它通常是作为一种 Web 语言出现的。所有主流浏览器都有一个 JavaScript 引擎;并且,还有一些流行的框架,如 JQuery、Cash 和 Bootstrap 等,它们可以帮助简化网页设计;甚至还有用 JavaScript 编写的编程环境。它似乎在互联网上无处不在,但事实证明,它对于 Electron 等项目来说也是一种有用的语言。Electron 是一个构建跨平台桌面应用程序的开源工具包,它使用的语言就是 JavaScript。

JavaScript 语言的用途多到令人惊讶,它拥有各种各样的库,而不仅仅是用于制作网站。它的基础知识十分容易掌握,因此,它可以作为一个起点,助你跨出构建你想象中的东西的第一步。

安装 JavaScript

随着你的 JavaScript 水平不断提高,你可能会发现自己需要高级的 JavaScript 库和运行时环境。不过,刚开始学习的时候,你是根本不需要安装 JavaScript 环境的。因为所有主流的 Web 浏览器都包含一个 JavaScript 引擎来运行代码。你可以使用自己喜欢的文本编辑器编写 JavaScript,将其加载到 Web 浏览器中,接着你就能看到代码的作用。

上手 JavaScript

要编写你的第一个 JavaScript 代码,请打开你喜欢的文本编辑器,例如 Atom 或 VSCode 等。因为它是为 Web 开发的,所以 JavaScript 可以很好地与 HTML 配合使用。因此,我们先来尝试一些基本的 HTML:

<html>
  <head>
    <title>JS</title>
  </head>
  <body>
    <p id="example">Nothing here.</p>
  </body>
</html>

保存这个文件,然后在 Web 浏览器中打开它。
浏览器中显示的 HTML

要将 JavaScript 添加到这个简单的 HTML 页面,你可以创建一个 JavaScript 文件并在页面的 <head> 中引用它,或者只需使用 <script> 标记将 JavaScript 代码嵌入 HTML 中。在这个例子中,我嵌入了下面的代码:

<html>
  <head>
    <title>JS</title>
  </head>
  <body>
    <p id="example">Nothing here.</p>

    <script>
      let myvariable = "Hello world!";

      document.getElementById("example").innerHTML = myvariable;
    </script>

  </body>
</html>

在浏览器中重新加载页面。
在浏览器中显示带有 JavaScript 的 HTML

如你所见,<p> 标签仍然包含字符串 "Nothing here",但是当它被渲染时,JavaScript 会改变它,使其包含 "Hello world"。是的,JavaScript 具有重建​​(或只是帮助构建)网页的能力。

这个简单脚本中的 JavaScript 做了两件事。首先,它创建一个名为 myvariable 的变量,并将字符串 "Hello world!" 放置其中。然后,它会在当前文档(浏览器呈现的网页)中搜索 ID 为 example 的所有 HTML 元素。当它找到 example 时,它使用了 innerHTML 属性将 HTML 元素的内容替换为 myvariable 的内容。

当然,我们也可以不用自定义变量。因为,使用动态创建的内容来填充 HTML 元素也是容易的。例如,你可以使用当前时间戳来填充它:

<html>
  <head>
    <title>JS</title>
  </head>
  <body>
    <p id="example">Date and time appears here.</p>

    <script>
      document.getElementById("example").innerHTML = Date();
    </script>
    
  </body>
</html>

重新加载页面,你就可以看到在呈现页面时生成的时间戳。再重新加载几次,你可以观察到秒数会不断增加。

JavaScript 语法

在编程中, 语法 syntax 指的是如何编写句子(或“行”)的规则。在 JavaScript 中,每行代码必须以分号(;)结尾,以便运行代码的 JavaScript 引擎知道何时停止阅读。(LCTT 译注:从实用角度看,此处的“必须”其实是不正确的,大多数 JS 引擎都支持不加分号。Vue.js 的作者尤雨溪认为“没有应该不应该,只有你自己喜欢不喜欢”,他同时表示,“Vue.js 的代码全部不带分号”。详情可以查看他在知乎上对于此问题的 回答。)

单词(或 字符串 strings )必须用引号(")括起来,而数字(或 整数 integers )则不用。

几乎所有其他东西都是 JavaScript 语言的约定,例如变量、数组、条件语句、对象、函数等等。

在 JavaScript 中创建变量

变量是数据的容器。你可以将变量视为一个盒子,你在其中放置数据,以便与程序的其他部分共享它。要在 JavaScript 中创建变量,你可以选用关键字 let 和 var 中的一个,请根据你打算如何使用变量来选择:var 关键字用于创建一个供整个程序使用的变量,而 let 只为特定目的创建变量,通常在函数或循环的内部使用。(LCTT 译注:还有 const 关键字,它用于创建一个常量。)

JavaScript 内置的 typeof 函数可以帮助你识别变量包含的数据的类型。使用第一个示例,你可以修改显示文本,来显示 myvariable 包含的数据的类型:

<string>
let myvariable = "Hello world!";
document.getElementById("example").innerHTML = typeof(myvariable);
</string>

接着,你就会发现 Web 浏览器中显示出 “string” 字样,因为该变量包含的数据是 "Hello world!"。在 myvariable 中存储不同类型的数据(例如整数),浏览器就会把不同的数据类型打印到示例网页上。尝试将 myvariable 的内容更改为你喜欢的数字,然后重新加载页面。

在 JavaScript 中创建函数

编程中的函数是独立的数据处理器。正是它们使编程得以 模块化。因为函数的存在,程序员可以编写通用库,例如​​,调整图像大小或统计时间花费的库,以供其他和你一样的程序员在他们的代码中使用。

要创建一个函数,你可以为函数提供一个自定义名称,后面跟着用大括号括起来的、任意数量的代码。

下面是一个简单的网页,其中包含了一个剪裁过的图像,还有一个分析图像并返回真实图像尺寸的按钮。在这个示例代码中,<button> 这个 HTML 元素使用了 JavaScript 的内置函数 onclick 来检测用户交互,它会触发一个名为 get_size 的自定义函数。具体代码如下:

<html>
  <head>
    <title>Imager</title>
  </head>
  <body>

    <div>
      <button onclick="get_size(document.getElementById('myimg'))">
        Get image size
    </button>
    </div>
    
    <div>
      <img style="width: 15%" id="myimg" src="penguin.png" />
    </div>
   
    <script>
      function get_size(i) {
        let w = i.naturalWidth;
        let h = i.naturalHeight;
        alert(w + " by " + h);
      }
    </script>
    
  </body>
</html>

保存这个文件,并将其加载到 Web 浏览器中以尝试这段代码。
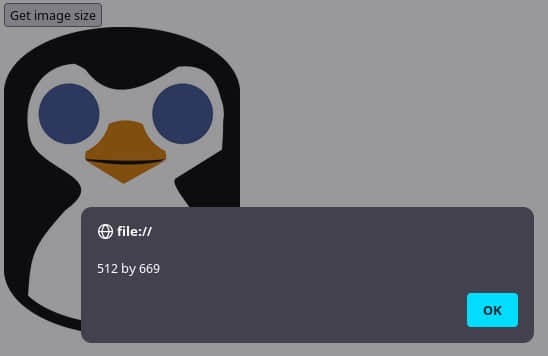
自定义的 get_size 函数返回了图像尺寸

使用 JavaScript 的跨平台应用程序

你可以从代码示例中看到,JavaScript 和 HTML 紧密协作,从而创建了有凝聚力的用户体验。这是 JavaScript 的一大优势。当你使用 JavaScript 编写代码时,你继承了现代计算中最常见的用户界面之一,而它与平台无关,那就是 Web 浏览器。你的代码本质上是跨平台的,因此你的应用程序,无论是简单的图像大小分析器还是复杂的图像编辑器、视频游戏,或者你梦想的任何其他东西,都可以被所有人使用,无论是通过 Web 浏览器,还是桌面(如果你同时提供了一个 Electron 应用)。

学习 JavaScript 既简单又有趣。网络上有很多网站提供了相关教程,还有超过一百万个 JavaScript 库可帮助你与设备、外围设备、物联网、服务器、文件系统等进行交互。在你学习的过程中,请将我们的 JavaScript 备忘单 放在身边,以便记住语法和结构的细节。

JavaScript 备忘单

via: https://opensource.com/article/21/7/javascript-cheat-sheet

作者:Seth Kenlon 选题:lkxed 译者:lkxed 校对:wxy
本文由 LCTT 原创编译,Linux中国 荣誉推出

编译软件在你如何运行你的系统方面给你很大的灵活性。LD_LIBRARY_PATH 变量,以及 GCC 的 -L 和 -l 选项,是这种灵活性的组成部分。

编译软件是开发者经常做的事情,在开源世界中,一些用户甚至选择自己动手。Linux 播客 Dann Washko 称源码为“通用包格式”,因为它包含了使一个应用在任何平台上运行所需的所有组件。当然,并不是所有的源码都是为所有的系统编写的,所以它只是在目标系统的子集内是“通用”的,但问题是,源码是非常灵活的。有了开源,你可以决定代码的编译和运行方式。

当你在编译代码时,你通常要处理多个源文件。开发人员倾向于将不同的类或模块放在不同的文件中,这样它们可以被单独维护,甚至可能被不同的项目使用。但当你编译这些文件时,许多文件会被编译成一个可执行文件。

这通常是通过创建共享库来完成的,然后从可执行文件中动态链接回它们。这样可以通过保持模块化功能的外部性来保持可执行文件的小型化,并确保库可以独立于使用它们的应用而被更新。

在编译过程中定位一个共享对象

当你 用 GCC 编译 时,你通常需要在你的工作站上安装一个库,以便 GCC 能够定位到它。默认情况下,GCC 假定库在系统库路径中,例如 /lib64 和 /usr/lib64。然而,如果你要链接到一个你自己的尚未安装的库,或者你需要链接到一个没有安装在标准位置的库,那么你必须帮助 GCC 找到这些文件。

有两个选项对于在 GCC 中寻找库很重要:

  • -L(大写字母 L)在 GCC 的搜索位置上增加一个额外的库路径。
  • -l(小写字母 L)设置你要链接的库的名字。

例如,假设你写了一个叫做 libexample.so 的库,并且你想在编译你的应用 demo.c 时使用它。首先,从 demo.c 创建一个对象文件:

$ gcc -I ./include -c src/demo.c

-I 选项在 GCC 搜索头文件的路径中增加了一个目录。在这个例子中,我假设自定义头文件在一个名为 include 的本地目录中。-c 选项防止 GCC 运行链接器,因为这个任务只是为了创建一个对象文件。结果如下:

$ ls
demo.o   include/   lib/    src/

现在你可以使用 -L 选项为你的库设置一个路径,然后进行编译:

$ gcc -L`pwd`/lib -o myDemo demo.o -lexample

注意,-L 选项在 -l 选项之前。这很重要,因为如果在你告诉 GCC 查找非默认库之前没有将 -L 添加到 GCC 的搜索路径中,GCC 就不知道要在你的自定义位置上搜索。编译成功了,但当你试图运行它时,却出现了问题:

$ ./myDemo
./myDemo: error while loading shared libraries:
libexample.so: cannot open shared object file:
No such file or directory

用 ldd 排除故障

ldd 工具可以打印出共享对象的依赖关系,它在排除类似问题时很有用:

$ ldd ./myDemo
        linux-vdso.so.1 (0x00007ffe151df000)
        libexample.so => not found
        libc.so.6 => /lib64/libc.so.6 (0x00007f514b60a000)
        /lib64/ld-linux-x86-64.so.2 (0x00007f514b839000)

你已经知道定位不到 libexample,但 ldd 输出至少确认了它对工作库的期望位置。例如,libc.so.6已经被定位,ldd 显示其完整路径。

LD\_LIBRARY\_PATH

LD_LIBRARY_PATH 环境变量 定义了库的路径。如果你正在运行一个依赖于没有安装到标准目录的库的应用程,你可以使用 LD_LIBRARY_PATH 添加到系统的库搜索路径。

有几种设置环境变量的方法,但最灵活的是在运行命令前放置环境变量。看看设置 LD_LIBRARY_PATH 对 ldd 命令在分析一个“损坏”的可执行文件时的作用:

$ LD_LIBRARY_PATH=`pwd`/lib ldd ./
   linux-vdso.so.1 (0x00007ffe515bb000)
   libexample.so => /tmp/Demo/lib/libexample.so (0x0000...
   libc.so.6 => /lib64/libc.so.6 (0x00007eff037ee000)
   /lib64/ld-linux-x86-64.so.2 (0x00007eff03a22000)

这也同样适用于你的自定义命令:

$ LD_LIBRARY_PATH=`pwd`/lib myDemo
hello world!

然而,如果你移动库文件或可执行文件,它又会失效:

$ mv lib/libexample.so ~/.local/lib64
$ LD_LIBRARY_PATH=`pwd`/lib myDemo
./myDemo: error while loading shared libraries...

要修复它,你必须调整 LD_LIBRARY_PATH 以匹配库的新位置:

$ LD_LIBRARY_PATH=~/.local/lib64 myDemo
hello world!

何时使用 LD\_LIBRARY\_PATH

在大多数情况下,LD_LIBRARY_PATH 不是你需要设置的变量。按照设计,库安装到 /usr/lib64 中,因此应用自然会在其中搜索所需的库。在两种情况下,你可能需要使用 LD_LIBRARY_PATH:

  • 你正在编译的软件需要链接到本身刚刚编译但尚未安装的库。良好设计的构建系统,例如 Autotools 和 CMake,可以帮助处理这个问题。
  • 你正在使用设计为在单个目录之外运行的软件,它没有安装脚本,或安装脚本将库放置在非标准目录中。一些应用具有 Linux 用户可以下载、复制到 /opt 并在“不安装”的情况下运行的版本。LD_PATH_LIBRARY 变量是通过封装脚本设置的,因此用户通常甚至不知道它已被设置。

编译软件为你在运行系统方面提供了很大的灵活性。LD_LIBRARY_PATH 变量以及 -L 和 -l GCC 选项是这种灵活性的组成部分。


via: https://opensource.com/article/22/5/compile-code-ldlibrarypath

作者:Seth Kenlon 选题:lkxed 译者:geekpi 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

机器学习基本上是人工智能的一个子集,它使用以前存在的数据对新数据进行预测。

当然,现在我们所有人都知道这个道理了!这篇文章展示了如何将 Python 中开发的机器学习模型作为 Java 代码的一部分来进行预测。

Machine-learning

本文假设你熟悉基本的开发技巧并理解机器学习。我们将从训练我们的模型开始,然后在 Python 中制作一个机器学习模型。

我以一个洪水预测模型为例。首先,导入以下库:

import pandas as pd
import numpy as np
import matplotlib.pyplot as plt

当我们成功地导入了这些库,我们就需要输入数据集,如下面的代码所示。为了预测洪水,我使用的是河流水位数据集。

from google.colab import files
uploaded = files.upload()
for fn in uploaded.keys(): 
    print('User uploaded file "{name}" with length {length} bytes'.format(name=fn, length=len(uploaded[fn])))

如果没有选择文件的话,选择上传的文件。

只有在当前浏览器会话中执行了该单元格时,上传部件才可用。请重新运行此单元,上传文件 Hoppers Crossing-Hourly-River-Level.csv,大小 2207036 字节。

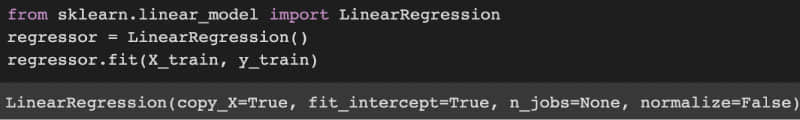
完成后,我们就可以使用 sklearn 库来训练我们的模型。为此,我们首先需要导入该库和算法模型,如图 1 所示。

Figure 1: Training the model

from sklearn.linear_model import LinearRegression
regressor = LinearRegression()
regressor.fit(X_train, y_train)

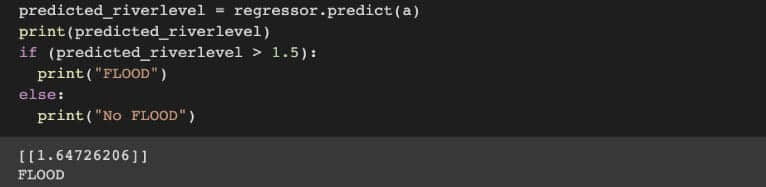
完成后,我们就训练好了我们的模型,现在可以进行预测了,如图 2 所示。

Figure 2: Making predictions

在 Java 中使用 ML 模型

我们现在需要做的是把 ML 模型转换成一个可以被 Java 程序使用的模型。有一个叫做 sklearn2pmml 的库可以帮助我们做到这一点:

# Install the library
pip install sklearn2pmml

库安装完毕后,我们就可以转换我们已经训练好的模型,如下图所示:

sklearn2pmml(pipeline, ‘model.pmml’, with_repr = True)

这就完成了!我们现在可以在我们的 Java 代码中使用生成的 model.pmml 文件来进行预测。请试一试吧!

(LCTT 译注:Java 中有第三方库 jpmml/jpmml-evaluator,它能帮助你使用生成的 model.pmml 进行预测。)


via: https://www.opensourceforu.com/2022/05/using-a-machine-learning-model-to-make-predictions/

作者:Jishnu Saurav Mittapalli 选题:lkxed 译者:geekpi 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

通过一个简单的小游戏比较 13 种编程语言。

 title=

当我开始学习一种新的编程语言时,会把重点放在定义变量、书写声明以及计算表达式,一旦对这些概念有一个大致的了解,通常就能够自己弄清剩下的部分。大多数编程语言都具有相似性,所以如果你掌握了一种编程语言,学习下一种语言的重点就是弄清楚独有的概念以及区分不同。

我喜欢写一些测试程序来帮助练习新的编程语言。其中我经常写的是一个叫做“猜数字”的小游戏,计算机选出 1 到 100 里的任一数字,然后我来猜。程序循环进行,直到猜出正确数字。通过伪代码可以看出,这是个非常简单的程序:

  • 计算机在 1 到 100 之间选出一个随机数字
  • 循环进行直到猜出该随机数字

    • 计算机读取我的猜测
    • 告诉我我的猜测过高还是过低

我们发表了一些文章,用不同的语言写这个程序。这是一个比较不同语言做同样事情的有趣机会。大多数编程语言具有相似性,所以当你在学习下一种新的编程语言时,主要是学习它的独特之处。

C 语言由 Dennis Ritchie 于 1972 年在贝尔实验室创建,是一种早期的通用编程语言。C 语言非常受欢迎,并迅速成为 Unix 系统上的标准编程语言。正是因为它的流行,许多其他编程语言也采用了类似的编程语法。这就是为什么如果你已经知道如何使用 C 语言编程,学习 C++、Rust、Java、Groovy、JavaScript、awk 或 Lua 会更容易。

接下来我们看看这些不同的编程语言是如何实现 “猜数字” 游戏的主要步骤。我将把重点放在基本元素的相似或不同,跳过一些外围代码,如分配临时变量。

计算机在 1 到 100 之间选出一个随机数字

你可以看到这里有许多相似之处。大多数编程语言使用类似 rand() 的函数,你可以设定一个范围来生成随机数。而其他一些语言使用一个特殊的函数来设定范围生成随机数。

C:

// Using the Linux `getrandom` system call
getrandom(&randval, sizeof(int), GRND_NONBLOCK);
number = randval % maxval + 1;

// Using the standard C library
number = rand() % 100 + 1;

C++:

int number = rand() % 100+1;

Rust:

let random = rng.gen_range(1..101);

Java:

private static final int NUMBER = r.nextInt(100) + 1;

Groovy:

int randomNumber = (new Random()).nextInt(100) + 1

JavaScript:

const randomNumber = Math.floor(Math.random() * 100) + 1

awk:

randomNumber = int(rand() * 100) + 1

Lua:

number = math.random(1,100)

循环进行直到我猜出该随机数字

循环通常是用控制流程来实现的,如 while 或 do-while。JavaScript 中的实现没有使用循环,而是 “实时 ”更新 HTML 页面,直到用户猜出正确的数字。Awk 虽然支持循环,但是通过循环读取输入信息是没有意义的,因为 Awk 是基于数据管道的,所以它从文件而不是直接从用户读取输入信息。

C:

do {
    …
} while (guess != number);

C++:

do {
    …
} while ( number != guess );

Rust:

for line in std::io::stdin().lock().lines() {
    …
    break;
}

Java:

while ( guess != NUMBER ) {
    …
}

Groovy:

while ( … ) {
    …
    break;
}

Lua:

while ( player.guess ~= number ) do
    …
end

计算机读取我的猜测

不同编程语言对输入的处理方式不同。例如,JavaScript 直接从 HTML 表单中读取数值,而 Awk 则从数据管道中读取数据。

C:

scanf("%d", &guess);

C++:

cin >> guess;

Rust:

let parsed = line.ok().as_deref().map(str::parse::<i64>);
if let Some(Ok(guess)) = parsed {
    …
}

Java:

guess = player.nextInt();

Groovy:

response = reader.readLine()
int guess = response as Integer

JavaScript:

let myGuess = guess.value

Awk:

guess = int($0)

Lua:

player.answer = io.read()
player.guess = tonumber(player.answer)

告诉我猜测过高还是过低

在这些类 C 语言中,通常是通过 if 语句进行比较的。每种编程语言打印输出的方式有一些变化,但打印语句在每个样本中都是可识别的。

C:

if (guess < number) {
    puts("Too low");
}
else if (guess > number) {
    puts("Too high");
}
…
puts("That's right!");

C++:

if ( guess > number) { cout << "Too high.\n" << endl; }
else if ( guess < number ) { cout << "Too low.\n" << endl; }
else {
    cout << "That's right!\n" << endl;
    exit(0);
}

Rust:

_ if guess < random => println!("Too low"),
_ if guess > random => println!("Too high"),
_ => {
    println!("That's right");
    break;
}

Java:

if ( guess > NUMBER ) {
    System.out.println("Too high");
} else if ( guess < NUMBER ) {
    System.out.println("Too low");
} else {
    System.out.println("That's right!");
    System.exit(0);
}

Groovy:

if (guess < randomNumber)
    print 'too low, try again: '
else if (guess > randomNumber)
    print 'too high, try again: '
else {
    println "that's right"
    break
}

JavaScript:

if (myGuess === randomNumber) {
    feedback.textContent = "You got it right!"
} else if (myGuess > randomNumber) {
    feedback.textContent = "Your guess was " + myGuess + ". That's too high. Try Again!"
} else if (myGuess < randomNumber) {
    feedback.textContent = "Your guess was " + myGuess + ". That's too low. Try Again!"
}

Awk:

if (guess < randomNumber) {
    printf "too low, try again:"
} else if (guess > randomNumber) {
    printf "too high, try again:"
} else {
    printf "that's right\n"
    exit
}

Lua:

if ( player.guess > number ) then
    print("Too high")
elseif ( player.guess < number) then
    print("Too low")
else
    print("That's right!")
    os.exit()
end

非类 C 编程语言会怎么样呢?

非类 C 编程语言会有很大的不同,需要学习特定的语法来完成每一步。Racket 源于 Lisp 和 Scheme,所以它使用 Lisp 的前缀符和大量括号。Python 使用空格而不是括号来表示循环之类的块。Elixir 是一种函数式编程语言,有自己的语法。Bash 是基于 Unix 系统中的 Bourne shell,它本身借鉴了 Algol68,并支持额外的速记符,如 && 作为 and 的变体。Fortran 是在使用打孔卡片输入代码的时期创建的,所以它依赖于一些重要列的 80 列布局。

我将通过比较 if 语句,举例表现这些编程语言的不同。if 判断一个值是否小于或大于另一个值,并向用户打印适当信息。

Racket:

(cond [(> number guess) (displayln "Too low") (inquire-user number)]
    [(< number guess) (displayln "Too high") (inquire-user number)]
    [else (displayln "Correct!")]))

Python:

if guess < random:
    print("Too low")
elif guess > random:
    print("Too high")
else:
    print("That's right!")

Elixir:

cond do
    guess < num ->
        IO.puts "Too low!"
        guess_loop(num)
    guess > num ->
        IO.puts "Too high!"
        guess_loop(num)
    true ->
        IO.puts "That's right!"
end

Bash:

[ "0$guess" -lt $number ] && echo "Too low"
[ "0$guess" -gt $number ] && echo "Too high" 

Fortran:

IF (GUESS.LT.NUMBER) THEN
    PRINT *, 'TOO LOW'
ELSE IF (GUESS.GT.NUMBER) THEN
    PRINT *, 'TOO HIGH'
ENDIF 

更多

当你在学习一种新的编程语言时 “猜数字” 游戏是一个很友好的入门程序,通过一种简单的方式练习了几个常见的编程概念。通过不同编程语言实现这个简单游戏,你可以理解一些核心概念和每种语言的细节。

学习如何用 C 和类 C 语言编写 “猜数字” 游戏:

其他语言:


via: https://opensource.com/article/21/4/compare-programming-languages

作者:Jim Hall 选题:lujun9972 译者:VeryZZJ 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

机器学习(ML)就是,分析一组数据以预测结果。Python 被认为是 ML 的最佳编程语言选择之一。在本文中,我们将讨论使用 Python 进行分类的机器学习。

machine-learning-classification

假设你想教孩子区分苹果和橙子。有多种方法可以做到这一点。你可以让孩子触摸这两种水果,让他们熟悉形状和柔软度。你还可以向她展示苹果和橙子的多个例子,以便他们可以直观地发现差异。这个过程的技术等价物被称为机器学习。

机器学习教计算机解决特定问题,并通过经验变得更好。这里讨论的示例是一个分类问题,其中机器被赋予各种标记示例,并期望使用它从标记样本中获得的知识来对未标记样本进行标记。机器学习问题也可以采用回归的形式,其中期望根据已知样本及其解决方案来预测给定问题的 实值 real-valued 解决方案。 分类 Classification 和 回归 Regression 被广泛称为 监督学习 supervised learning 。机器学习也可以是 无监督 unsupervised 的,机器识别未标记数据中的模式,并形成具有相似模式的样本集群。机器学习的另一种形式是 强化学习 reinforcement learning ,机器通过犯错从环境中学习。

分类

分类是根据从已知点获得的信息来预测一组给定点的标签的过程。与一个数据集相关的类别或标签可以是二元的,也可以是多元的。举例来说,如果我们必须给与一个句子相关的情绪打上标签,我们可以把它标记为正面、负面或中性。另一方面,我们必须预测一个水果是苹果还是橘子的问题将有二元标签。表 1 给出了一个分类问题的样本数据集。

在该表中,最后一列的值,即贷款批准,预计将基于其他变量进行预测。在接下来的部分中,我们将学习如何使用 Python 训练和评估分类器。

年龄信用等级工作拥有房产贷款批准
35好是是是
32差是不不
22一般不不不
42好是不是

表 1

训练和评估分类器

为了训练 分类器 classifier ,我们需要一个包含标记示例的数据集。尽管本节不涉及清理数据的过程,但建议你在将数据集输入分类器之前阅读各种数据预处理和清理技术。为了在 Python 中处理数据集,我们将导入 pandas 包和 数据帧 DataFrame 结构。然后,你可以从多种分类算法中进行选择,例如 决策树 decision tree 、 支持向量分类器 support vector classifier 、 随机森林 random forest 、XG boost、ADA boost 等。我们将看看随机森林分类器,它是使用多个决策树形成的集成分类器。

from sklearn.ensemble import RandomForestClassifier
from sklearn import metrics
 
classifier = RandomForestClassifier()
 
#creating a train-test split with a proportion of 70:30
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.33)
 
classifier.fit(X_train, y_train) # 在训练集上训练分类器
 
y_pred = classifier.predict(X_test) # 用未知数据评估分类器
 
print("Accuracy: ", metrics.accuracy_score(y_test, y_pred)) # 用测试计划中的实际值比较准确率

虽然这个程序使用准确性作为性能指标,但应该使用多种指标的组合,因为当测试集不平衡时,准确性往往会产生非代表性的结果。例如,如果模型对每条记录都给出了相同的预测,而用于测试模型的数据集是不平衡的,即数据集中的大多数记录与模型预测的类别相同,我们就会得到很高的准确率。

调整分类器

调优是指修改模型的 超参数 hyperparameter 值以提高其性能的过程。超参数是可以改变其值以改进算法的学习过程的参数。

以下代码描述了随机搜索超参数调整。在此,我们定义了一个搜索空间,算法将从该搜索空间中选择不同的值,并选择产生最佳结果的那个:

from sklearn.model_selection import RandomizedSearchCV

#define the search space
min_samples_split = [2, 5, 10]
min_samples_leaf = [1, 2, 4]
grid = {‘min_samples_split’ : min_samples_split, ‘min_samples_leaf’ : min_samples_leaf}

classifier = RandomizedSearchCV(classifier, grid, n_iter = 100)

# n_iter 代表从搜索空间提取的样本数
# result.best_score 和 result.best_params_ 可以用来获得模型的最佳性能,以及参数的最佳值

classifier.fit(X_train, y_train)

投票分类器

你也可以使用多个分类器和它们的预测来创建一个模型,根据各个预测给出一个预测。这个过程(只考虑为每个预测投票的分类器的数量)被称为硬投票。软投票是一个过程,其中每个分类器产生一个给定记录属于特定类别的概率,而投票分类器产生的预测是获得最大概率的类别。

下面给出了一个创建软投票分类器的代码片段:

soft_voting_clf = VotingClassifier(
estimators=[(‘rf’, rf_clf), (‘ada’, ada_clf), (‘xgb’, xgb_clf), (‘et’, et_clf), (‘gb’, gb_clf)],
voting=’soft’)
soft_voting_clf.fit(X_train, y_train)

这篇文章总结了分类器的使用,调整分类器和结合多个分类器的结果的过程。请将此作为一个参考点,详细探讨每个领域。


via: https://www.opensourceforu.com/2022/05/machine-learning-classification-using-python/

作者:Gayatri Venugopal 选题:lkxed 译者:geekpi 校对:turbokernel

本文由 LCTT 原创编译,Linux中国 荣誉推出

编程语言往往具有许多共同特征。学习一门新语言的好方法是去写一个熟悉的程序。在本文中,我将会使用 Awk 编写一个“猜数字”程序来展示熟悉的概念。

当你学习一门新的编程语言时,最好把重点放在大多数编程语言都有的共同点上:

  • 变量 —— 存储信息的地方
  • 表达式 —— 计算的方法
  • 语句 —— 在程序中表示状态变化的方法

这些概念是大多是编程语言的基础。

一旦你理解了这些概念,你就可以开始把其他的弄清楚。例如,大多数语言都有由其设计所支持的“处理方式”,这些方式在不同语言之间可能有很大的不同。这些方法包括模块化(将相关功能分组在一起)、声明式与命令式、面向对象、低级与高级语法特性等等。许多程序员比较熟悉的是编程“仪式”,即,在处理问题之前设置场景所需花费的工作。据说 Java 编程语言有一个源于其设计的重要仪式要求,就是所有代码都在一个类中定义。

但从根本上讲,编程语言通常有相似之处。一旦你掌握了一种编程语言,就可以从学习另一种语言的基本知识开始,品味这种新语言的不同之处。

一个好方法是创建一组基本的测试程序。有了这些,就可以从这些相似之处开始学习。

你可以选择创建的一个测试程序是“猜数字”程序。电脑从 1 到 100 之间选择一个数字,让你猜这个数字。程序一直循环,直到你猜对为止。

“猜数字”程序练习了编程语言中的几个概念:

  • 变量
  • 输入
  • 输出
  • 条件判断
  • 循环

这是学习一门新的编程语言的一个很好的实践实验。

注:本文改编自 Moshe Zadka 在 Julia 中使用这种方法和 Jim Hall在 Bash 中使用这种方法的文章。

在 awk 程序中猜数

让我们编写一个实现“猜数字”游戏的 Awk 程序。

Awk 是动态类型的,这是一种面向数据转换的脚本语言,并且对交互使用有着令人惊讶的良好支持。Awk 出现于 20 世纪 70 年代,最初是 Unix 操作系统的一部分。如果你不了解 Awk,但是喜欢电子表格,这就是一个你可以 去学习 Awk 的信号!

您可以通过编写一个“猜数字”游戏版本来开始对 Awk 的探索。

以下是我的实现(带有行号,以便我们可以查看一些特定功能):

     1    BEGIN {
     2        srand(42)
     3        randomNumber = int(rand() * 100) + 1
     4        print "random number is",randomNumber
     5        printf "guess a number between 1 and 100\n"
     6    }
     7    {
     8        guess = int($0)
     9        if (guess &lt; randomNumber) {
    10            printf "too low, try again:"
    11        } else if (guess &gt; randomNumber) {
    12            printf "too high, try again:"
    13        } else {
    14            printf "that's right\n"
    15            exit
    16        }
    17    }

我们可以立即看到 Awk 控制结构与 C 或 Java 的相似之处,但与 Python 不同。 在像 if-then-else、while 这样的语句中,then、else 和 while 部分接受一个语句或一组被 { 和 } 包围的语句。然而,Awk 有一个很大的区别需要从一开始就了解:

根据设计,Awk 是围绕数据管道构建的。

这是什么意思呢?大多数 Awk 程序都是一些代码片段,它们接收一行输入,对数据做一些处理,然后将其写入输出。认识到这种转换管道的需要,Awk 默认情况下提供了所有的转换管道。让我们通过关于上面程序的一个基本问题来探索:“从控制台读取数据”的结构在哪里?

答案是——“内置的”。特别的,第 7-17 行告诉 Awk 如何处理被读取的每一行。在这种情况下,很容易看到第 1-6 行是在读取任何内容之前被执行的。

更具体地说,第 1 行上的 BEGIN 关键字是一种“模式”,在本例中,它指示 Awk 在读取任何数据之前,应该先执行 { ... } 中 BEGIN 后面的内容。另一个类似的关键字 END,在这个程序中没有被使用,它指示 Awk 在读取完所有内容后要做什么。

回到第 7-17 行,我们看到它们创建了一个类似代码块 { ... } 的片段,但前面没有关键字。因为在 { 之前没有任何东西可以让 Awk 匹配,所以它将把这一行用于接收每一行输入。每一行的输入都将由用户输入作为猜测。

让我们看看正在执行的代码。首先,是在读取任何输入之前发生的序言部分。

在第 2 行,我们用数字 42 初始化随机数生成器(如果不提供参数,则使用系统时钟)。为什么要用 42?当然要选 42!#The_Hitchhiker's_Guide_to_the_Galaxy) 第 3 行计算 1 到 100 之间的随机数,第 4 行输出该随机数以供调试使用。第 5 行邀请用户猜一个数字。注意这一行使用的是 printf,而不是 print。和 C 语言一样,printf 的第一个参数是一个用于格式化输出的模板。

既然用户知道程序需要输入,她就可以在控制台上键入猜测。如前所述,Awk 将这种猜测提供给第 7-17 行的代码。第 18 行将输入记录转换为整数;$0 表示整个输入记录,而 $1 表示输入记录的第一个字段,$2 表示第二个字段,以此类推。是的,Awk 使用预定义的分隔符(默认为空格)将输入行分割为组成字段。第 9-15 行将猜测结果与随机数进行比较,打印适当的响应。如果猜对了,第 15 行就会从输入行处理管道中提前退出。

就这么简单!

考虑到 Awk 程序不同寻常的结构,代码片段会对特定的输入行配置做出反应,并处理数据,让我们看看另一种结构,看看过滤部分是如何工作的:

     1    BEGIN {
     2        srand(42)
     3        randomNumber = int(rand() * 100) + 1
     4        print "random number is",randomNumber
     5        printf "guess a number between 1 and 100\n"
     6    }
     7    int($0) &lt; randomNumber {
     8        printf "too low, try again: "
     9    }
    10    int($0) &gt; randomNumber {
    11        printf "too high, try again: "
    12    }
    13    int($0) == randomNumber {
    14        printf "that's right\n"
    15        exit
    16    }

第 1–6 行代码没有改变。但是现在我们看到第 7-9 行是当输入整数值小于随机数时执行的代码,第 10-12 行是当输入整数值大于随机数时执行的代码,第 13-16 行是两者相等时执行的代码。

这看起来“很酷但很奇怪” —— 例如,为什么我们会重复计算 int($0)?可以肯定的是,用这种方法来解决问题会很奇怪。但这些模式确实是分离条件处理的非常好的方式,因为它们可以使用正则表达式或 Awk 支持的任何其他结构。

为了完整起见,我们可以使用这些模式将普通的计算与只适用于特定环境的计算分离开来。下面是第三个版本:

     1    BEGIN {
     2        srand(42)
     3        randomNumber = int(rand() * 100) + 1
     4        print "random number is",randomNumber
     5        printf "guess a number between 1 and 100\n"
     6    }
     7    {
     8        guess = int($0)
     9    }
    10    guess &lt; randomNumber {
    11        printf "too low, try again: "
    12    }
    13    guess &gt; randomNumber {
    14        printf "too high, try again: "
    15    }
    16    guess == randomNumber {
    17        printf "that's right\n"
    18        exit
    19    }

认识到这一点,无论输入的是什么值,都需要将其转换为整数,因此我们创建了第 7-9 行来完成这一任务。现在第 10-12、13-15 和 16-19 行这三组代码,都是指已经定义好的变量 guess,而不是每次都对输入行进行转换。

让我们回到我们想要学习的东西列表:

  • 变量 —— 是的,Awk 有这些;我们可以推断出,输入数据以字符串形式输入,但在需要时可以转换为数值
  • 输入 —— Awk 只是通过它的“数据转换管道”的方式发送输入来读取数据
  • 输出 —— 我们已经使用了 Awk 的 print 和 printf 函数来将内容写入输出
  • 条件判断 —— 我们已经学习了 Awk 的 if-then-else 和对应特定输入行配置的输入过滤器
  • 循环 —— 嗯,想象一下!我们在这里不需要循环,这还是多亏了 Awk 采用的“数据转换管道”方法;循环“就这么发生了”。注意,用户可以通过向 Awk 发送一个文件结束信号(当使用 Linux 终端窗口时可通过快捷键 CTRL-D)来提前退出管道。

不需要循环来处理输入的重要性是非常值得的。Awk 能够长期保持存在的一个原因是 Awk 程序是紧凑的,而它们紧凑的一个原因是不需要从控制台或文件中读取的那些格式代码。

让我们运行下面这个程序:

$ awk -f guess.awk
random number is 25
guess a number between 1 and 100: 50
too high, try again: 30
too high, try again: 10
too low, try again: 25
that's right
$

我们没有涉及的一件事是注释。Awk 注释以 # 开头,以行尾结束。

总结

Awk 非常强大,这种“猜数字”游戏是入门的好方法。但这不应该是你探索 Awk 的终点。你可以看看 Awk 和 Gawk(GNU Awk)的历史,Gawk 是 Awk 的扩展版本,如果你在电脑上运行 Linux,可能会有这个。或者,从它的原始开发者那里阅读关于 最初版本 的各种信息。

你还可以 下载我们的备忘单 来帮你记录下你所学的一切。

Awk 备忘单

via: https://opensource.com/article/21/1/learn-awk

作者:Chris Hermansen 选题:lujun9972 译者:FYJNEVERFOLLOWS 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出