分类 软件开发 下的文章

在编写高效 SQL 时,你可能遇到的最有影响的事情就是索引。但是,一个很重要的事实就是很多 SQL 客户端要求数据库做很多“不必要的强制性工作”。

跟我再重复一遍:

不必要的强制性工作

什么是“不必要的强制性工作”?这个意思包括两个方面:

不必要的

假设你的客户端应用程序需要这些信息:
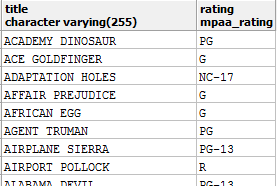
这没什么特别的。我们运行着一个电影数据库(例如 Sakila 数据库),我们想要给用户显示每部电影的名称和评分。

这是能产生上面结果的查询:

SELECT title, rating
FROM film

然而,我们的应用程序(或者我们的 ORM(LCTT 译注: 对象关系映射 ( Object-Relational Mapping ) ))运行的查询却是:

SELECT *
FROM film

我们得到什么?猜一下。我们得到很多无用的信息:
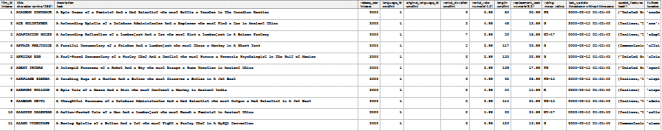
甚至一些复杂的 JSON 数据全程在下列环节中加载:

  • 从磁盘
  • 加载到缓存
  • 通过总线
  • 进入客户端内存
  • 然后被丢弃

是的,我们丢弃了其中大部分的信息。检索它所做的工作完全就是不必要的。对吧?没错。

强制性

这是最糟糕的部分。现今随着优化器变得越来越聪明,这些工作对于数据库来说都是强制执行的。数据库没有办法知道客户端应用程序实际上不需要其中 95% 的数据。这只是一个简单的例子。想象一下如果我们连接更多的表...

你想想那会怎样呢?数据库还快吗?让我们来看看一些之前你可能没有想到的地方:

内存消耗

当然,单次执行时间不会变化很大。可能是慢 1.5 倍,但我们可以忍受,是吧?为方便起见,有时候确实如此。但是如果你每次都为了方便而牺牲性能,这事情就大了。我们不说性能问题(单个查询的速度),而是关注在吞吐量上时(系统响应时间),事情就变得困难而难以解决。你就会受阻于规模的扩大。

让我们来看看执行计划,这是 Oracle 的:

--------------------------------------------------
| Id  | Operation         | Name | Rows  | Bytes |
--------------------------------------------------
|   0 | SELECT STATEMENT  |      |  1000 |   166K|
|   1 |  TABLE ACCESS FULL| FILM |  1000 |   166K|
--------------------------------------------------

对比一下:

--------------------------------------------------
| Id  | Operation         | Name | Rows  | Bytes |
--------------------------------------------------
|   0 | SELECT STATEMENT  |      |  1000 | 20000 |
|   1 |  TABLE ACCESS FULL| FILM |  1000 | 20000 |
--------------------------------------------------

当执行 SELECT * 而不是 SELECT film, rating 的时候,我们在数据库中使用了 8 倍之多的内存。这并不奇怪,对吧?我们早就知道了。在很多我们并不需要其中全部数据的查询中我们都是这样做的。我们为数据库产生了不必要的强制性工作,其后果累加了起来,就是我们使用了多达 8 倍的内存(当然,数值可能有些不同)。

而现在,所有其它的步骤(比如,磁盘 I/O、总线传输、客户端内存消耗)也受到相同的影响,我这里就跳过了。另外,我还想看看...

索引使用

如今大部分数据库都有涵盖索引(LCTT 译注:covering index,包括了你查询所需列、甚至更多列的索引,可以直接从索引中获取所有需要的数据,而无需访问物理表)的概念。涵盖索引并不是特殊的索引。但对于一个特定的查询,它可以“意外地”或人为地转变为一个“特殊索引”。

看看这个查询:

SELECT *
FROM actor
WHERE last_name LIKE 'A%'

执行计划中没有什么特别之处。它只是个简单的查询。索引范围扫描、表访问,就结束了:

-------------------------------------------------------------------
| Id  | Operation                   | Name                | Rows  |
-------------------------------------------------------------------
|   0 | SELECT STATEMENT            |                     |     8 |
|   1 |  TABLE ACCESS BY INDEX ROWID| ACTOR               |     8 |
|*  2 |   INDEX RANGE SCAN          | IDX_ACTOR_LAST_NAME |     8 |
-------------------------------------------------------------------

这是个好计划吗?如果我们只是想要这些,那么它就不是:
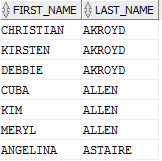
当然,我们浪费了内存之类的。再来看看这个查询:

SELECT first_name, last_name 
FROM actor
WHERE last_name LIKE 'A%'

它的计划是:

----------------------------------------------------
| Id  | Operation        | Name            | Rows  |
----------------------------------------------------
|   0 | SELECT STATEMENT |                 |     8 |
|*  1 |  INDEX RANGE SCAN| IDX_ACTOR_NAMES |     8 |
----------------------------------------------------

现在我们可以完全消除表访问,因为有一个索引涵盖了我们查询需要的所有东西……一个涵盖索引。这很重要吗?当然!这种方法可以将你的某些查询加速一个数量级(如果在某个更改后你的索引不再涵盖,可能会降低一个数量级)。

你不能总是从涵盖索引中获利。索引也有它们自己的成本,你不应该添加太多索引,例如像这种情况就是不明智的。让我们来做个测试:

SET SERVEROUTPUT ON
DECLARE
  v_ts TIMESTAMP;
  v_repeat CONSTANT NUMBER := 100000;
BEGIN
  v_ts := SYSTIMESTAMP;

  FOR i IN 1..v_repeat LOOP
    FOR rec IN (
      -- Worst query: Memory overhead AND table access
      SELECT *
      FROM actor
      WHERE last_name LIKE 'A%'
    ) LOOP
      NULL;
    END LOOP;
  END LOOP;

  dbms_output.put_line('Statement 1 : ' || (SYSTIMESTAMP - v_ts));
  v_ts := SYSTIMESTAMP;

  FOR i IN 1..v_repeat LOOP
    FOR rec IN (
      -- Better query: Still table access
      SELECT /*+INDEX(actor(last_name))*/
        first_name, last_name
      FROM actor
      WHERE last_name LIKE 'A%'
    ) LOOP
      NULL;
    END LOOP;
  END LOOP;

  dbms_output.put_line('Statement 2 : ' || (SYSTIMESTAMP - v_ts));
  v_ts := SYSTIMESTAMP;

  FOR i IN 1..v_repeat LOOP
    FOR rec IN (
      -- Best query: Covering index
      SELECT /*+INDEX(actor(last_name, first_name))*/
        first_name, last_name
      FROM actor
      WHERE last_name LIKE 'A%'
    ) LOOP
      NULL;
    END LOOP;
  END LOOP;

  dbms_output.put_line('Statement 3 : ' || (SYSTIMESTAMP - v_ts));
END;
/

结果是:

Statement 1 : +000000000 00:00:02.479000000
Statement 2 : +000000000 00:00:02.261000000
Statement 3 : +000000000 00:00:01.857000000

注意,表 actor 只有 4 列,因此语句 1 和 2 的差别并不是太令人印象深刻,但仍然很重要。还要注意我使用了 Oracle 的提示来强制优化器为查询选择一个或其它索引。在这种情况下语句 3 明显胜利。这是一个好很多的查询,也是一个十分简单的查询。

当我们写 SELECT * 语句时,我们为数据库带来了不必要的强制性工作,这是无法优化的。它不会使用涵盖索引,因为比起它所使用的 LAST_NAME 索引,涵盖索引开销更多一点,不管怎样,它都要访问表以获取无用的 LAST_UPDATE 列。

使用 SELECT * 会变得更糟。考虑一下……

SQL 转换

优化器工作的很好,因为它们转换了你的 SQL 查询(看我最近在 Voxxed Days Zurich 关于这方面的演讲)。例如,其中有一个称为“表连接消除”的转换,它真的很强大。看看这个辅助视图,我们写了这个视图是因为我们非常讨厌总是连接所有这些表:

CREATE VIEW v_customer AS
SELECT
  c.first_name, c.last_name, 
  a.address, ci.city, co.country
FROM customer c
JOIN address a USING (address_id)
JOIN city ci USING (city_id)
JOIN country co USING (country_id)

这个视图仅仅是把 CUSTOMER 和他们不同的 ADDRESS 部分所有“对一”关系连接起来。谢天谢地,它很工整。

现在,使用这个视图一段时间之后,想象我们非常习惯这个视图,我们都忘了所有它底层的表。然后,我们运行了这个查询:

SELECT *
FROM v_customer

我们得到了一个相当令人印象深刻的计划:

----------------------------------------------------------------
| Id  | Operation            | Name     | Rows  | Bytes | Cost |
----------------------------------------------------------------
|   0 | SELECT STATEMENT     |          |   599 | 47920 |   14 |
|*  1 |  HASH JOIN           |          |   599 | 47920 |   14 |
|   2 |   TABLE ACCESS FULL  | COUNTRY  |   109 |  1526 |    2 |
|*  3 |   HASH JOIN          |          |   599 | 39534 |   11 |
|   4 |    TABLE ACCESS FULL | CITY     |   600 | 10800 |    3 |
|*  5 |    HASH JOIN         |          |   599 | 28752 |    8 |
|   6 |     TABLE ACCESS FULL| CUSTOMER |   599 | 11381 |    4 |
|   7 |     TABLE ACCESS FULL| ADDRESS  |   603 | 17487 |    3 |
----------------------------------------------------------------

当然是这样。我们运行了所有这些表连接以及全表扫描,因为这就是我们让数据库去做的:获取所有的数据。

现在,再一次想一下,对于一个特定场景,我们真正想要的是:
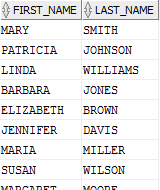
是啊,对吧?现在你应该知道我的意图了。但想像一下,我们确实从前面的错误中学到了东西,现在我们实际上运行下面一个比较好的查询:

SELECT first_name, last_name
FROM v_customer

再来看看结果!

------------------------------------------------------------------
| Id  | Operation          | Name        | Rows  | Bytes | Cost  |
------------------------------------------------------------------
|   0 | SELECT STATEMENT   |             |   599 | 16173 |     4 |
|   1 |  NESTED LOOPS      |             |   599 | 16173 |     4 |
|   2 |   TABLE ACCESS FULL| CUSTOMER    |   599 | 11381 |     4 |
|*  3 |   INDEX UNIQUE SCAN| SYS_C007120 |     1 |     8 |     0 |
------------------------------------------------------------------

这是执行计划一个极大的进步。我们的表连接被消除了,因为优化器可以证明它们是不必要的,因此一旦它可以证明这点(而且你不会因使用 select * 而使其成为强制性工作),它就可以移除这些工作并不执行它。为什么会发生这种情况?

每个 CUSTOMER.ADDRESS_ID 外键保证了有且只有一个 ADDRESS.ADDRESS_ID 主键值,因此可以保证 JOIN 操作是对一连接,它不会产生或者删除行。如果我们甚至不选择行或查询行,当然我们就不需要真正地去加载行。可以证实地移除 JOIN 并不会改变查询的结果。

数据库总是会做这些事情。你可以在大部分数据库上尝试它:

-- Oracle
SELECT CASE WHEN EXISTS (
  SELECT 1 / 0 FROM dual
) THEN 1 ELSE 0 END
FROM dual

-- 更合理的 SQL 语句,例如 PostgreSQL
SELECT EXISTS (SELECT 1 / 0)

在这种情况下,当你运行这个查询时你可能预料到会抛出算术异常:

SELECT 1 / 0 FROM dual

产生了:

ORA-01476: divisor is equal to zero

但它并没有发生。优化器(甚至解析器)可以证明 EXISTS (SELECT ..) 谓词内的任何 SELECT 列表达式不会改变查询的结果,因此也就没有必要计算它的值。呵!

同时……

大部分 ORM 最不幸问题就是事实上他们很随意就写出了 SELECT * 查询。事实上,例如 HQL / JPQL,就设置默认使用它。你甚至可以完全抛弃 SELECT 从句,因为毕竟你想要获取所有实体,正如声明的那样,对吧?

例如:

FROM v_customer

例如 Vlad Mihalcea(一个 Hibernate 专家和 Hibernate 开发倡导者)建议你每次确定不想要在获取后进行任何更改时再使用查询。ORM 使解决对象图持久化问题变得简单。注意:持久化。真正修改对象图并持久化修改的想法是固有的。

但如果你不想那样做,为什么要抓取实体呢?为什么不写一个查询?让我们清楚一点:从性能角度,针对你正在解决的用例写一个查询总是会胜过其它选项。你可以不会在意,因为你的数据集很小,没关系。可以。但最终,你需要扩展并重新设计你的应用程序以便在强制实体图遍历之上支持查询语言,就会变得很困难。你也需要做其它事情。

计算出现次数

资源浪费最严重的情况是在只是想要检验存在性时运行 COUNT(*) 查询。例如:

这个用户有没有订单?

我们会运行:

SELECT count(*)
FROM orders
WHERE user_id = :user_id

很简单。如果 COUNT = 0:没有订单。否则:是的,有订单。

性能可能不会很差,因为我们可能有一个 ORDERS.USER_ID 列上的索引。但是和下面的这个相比你认为上面的性能是怎样呢:

-- Oracle
SELECT CASE WHEN EXISTS (
  SELECT *
  FROM orders
  WHERE user_id = :user_id
) THEN 1 ELSE 0 END
FROM dual

-- 更合理的 SQL 语句,例如 PostgreSQL
SELECT EXISTS (
  SELECT *
  FROM orders
  WHERE user_id = :user_id
)

它不需要火箭科学家来确定,一旦它找到一个,实际存在谓词就可以马上停止寻找额外的行。因此,如果答案是“没有订单”,速度将会是差不多。但如果结果是“是的,有订单”,那么结果在我们不计算具体次数的情况下就会大幅加快。

因为我们不在乎具体的次数。我们告诉数据库去计算它(不必要的),而数据库也不知道我们会丢弃所有大于 1 的结果(强制性)。

当然,如果你在 JPA 支持的集合上调用 list.size() 做同样的事情,情况会变得更糟!

近期我有关于该情况的博客以及在不同数据库上的测试。去看看吧。

总结

这篇文章的立场很“明显”。别让数据库做不必要的强制性工作。

它不必要,因为对于你给定的需求,你知道一些特定的工作不需要完成。但是,你告诉数据库去做。

它强制性,因为数据库无法证明它是不必要的。这些信息只包含在客户端中,对于服务器来说无法访问。因此,数据库需要去做。

这篇文章大部分在介绍 SELECT *,因为这是一个很简单的目标。但是这并不仅限于数据库。这关系到客户端要求服务器完成不必要的强制性工作的任何分布式算法。你的 AngularJS 应用程序平均有多少个 N+1 问题,UI 在服务结果 A 上循环,多次调用服务 B,而不是把所有对 B 的调用打包为一个调用?这是一个复发的模式。

解决方法总是相同。你给执行你命令的实体越多信息,(理论上)它能更快执行这样的命令。每次都写一个好的查询。你的整个系统都会为此感谢你的。

如果你喜欢这篇文章...

再看看近期我在 Voxxed Days Zurich 的演讲,其中我展示了一些在数据处理算法上为什么 SQL 总是会胜过 Java 的双曲线例子。

(题图:Pixabay, CC0)


via: https://blog.jooq.org/2017/03/08/many-sql-performance-problems-stem-from-unnecessary-mandatory-work
作者:jooq 译者:ictlyh 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

在机器学习、计算机视觉以及高性能计算领域,充分利用显卡计算应用程序的能力已成为当前的热门。类似 OpenCL 的技术通过硬件无关的编程模型展现了这种能力,使得你可以编写抽象于不同体系架构的代码。它的目标是“一次编写,到处运行”,不管它是 Intel CPU、AMD 独立显卡还是 DSP 等等。不幸的是,对于日常程序员,OpenCL 的学习曲线陡峭;一个简单的 Hello World 程序可能就需要上百行晦涩难懂的代码。因此,为了减轻这种痛苦,Khronos 组织已经开发了一个称为 SYCL 的新标准,这是一个在 OpenCL 之上的 C++ 抽象层。通过 SYCL,你可以使用干净、现代的 C++ 开发出这些通用 GPU(GPGPU)应用程序,而无需拘泥于 OpenCL。下面是一个使用 SYCL 开发,通过并行 STL 实现的向量乘法事例:

#include <vector>
#include <iostream>

#include <sycl/execution_policy>
#include <experimental/algorithm>
#include <sycl/helpers/sycl_buffers.hpp>

using namespace std::experimental::parallel;
using namespace sycl::helpers;

int main() {
  constexpr size_t array_size = 1024*512;
  std::array<cl::sycl::cl_int, array_size> a;
  std::iota(begin(a),end(a),0);

  {
    cl::sycl::buffer<int> b(a.data(), cl::sycl::range<1>(a.size()));
    cl::sycl::queue q;
    sycl::sycl_execution_policy<class Mul> sycl_policy(q);
    transform(sycl_policy, begin(b), end(b), begin(b),
              [](int x) { return x*2; });
  }
}

为了作为对比,下面是一个通过 C++ API 使用 OpenCL 编写的大概对应版本(无需花过多时间阅读,只需注意到它看起来难看而且冗长)。

#include <iostream>
#include <array>
#include <numeric>
#include <CL/cl.hpp>

int main(){
    std::vector<cl::Platform> all_platforms;
    cl::Platform::get(&all_platforms);
    if(all_platforms.size()==0){
        std::cout<<" No platforms found. Check OpenCL installation!\n";
        exit(1);
    }
    cl::Platform default_platform=all_platforms[0];

    std::vector<cl::Device> all_devices;
    default_platform.getDevices(CL_DEVICE_TYPE_ALL, &all_devices);
    if(all_devices.size()==0){
        std::cout<<" No devices found. Check OpenCL installation!\n";
        exit(1);
    }

    cl::Device default_device=all_devices[0];
    cl::Context context({default_device});

    cl::Program::Sources sources;
    std::string kernel_code=
        "   void kernel mul2(global int* A){"
        "       A[get_global_id(0)]=A[get_global_id(0)]*2;"
        "   }";
    sources.push_back({kernel_code.c_str(),kernel_code.length()});

    cl::Program program(context,sources);
    if(program.build({default_device})!=CL_SUCCESS){
        std::cout<<" Error building: "<<program.getBuildInfo<CL_PROGRAM_BUILD_LOG>(default_device)<<"\n";
        exit(1);
    }

    constexpr size_t array_size = 1024*512;
    std::array<cl_int, array_size> a;
    std::iota(begin(a),end(a),0);

    cl::Buffer buffer_A(context,CL_MEM_READ_WRITE,sizeof(int)*a.size());
    cl::CommandQueue queue(context,default_device);

    if (queue.enqueueWriteBuffer(buffer_A,CL_TRUE,0,sizeof(int)*a.size(),a.data()) != CL_SUCCESS) {
        std::cout << "Failed to write memory;n";
        exit(1);
    }

    cl::Kernel kernel_add = cl::Kernel(program,"mul2");
    kernel_add.setArg(0,buffer_A);

    if (queue.enqueueNDRangeKernel(kernel_add,cl::NullRange,cl::NDRange(a.size()),cl::NullRange) != CL_SUCCESS) {
        std::cout << "Failed to enqueue kernel\n";
        exit(1);
    }

    if (queue.finish() != CL_SUCCESS) {
        std::cout << "Failed to finish kernel\n";
        exit(1);
    }

    if (queue.enqueueReadBuffer(buffer_A,CL_TRUE,0,sizeof(int)*a.size(),a.data()) != CL_SUCCESS) {
        std::cout << "Failed to read result\n";
        exit(1);
    }
}

在这篇博文中我会介绍使用 SYCL 加速你 GPU 上的 C++ 代码。

GPGPU 简介

在我开始介绍如何使用 SYCL 之前,我首先给那些不熟悉这方面的人简要介绍一下为什么你可能想要在 GPU 上运行计算任务。如果已经使用过 OpenCL、CUDA 或类似的库,可以跳过这一节。

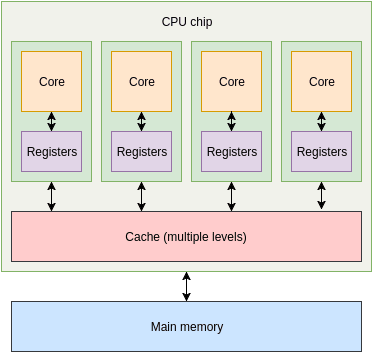
GPU 和 CPU 的一个关键不同就是 GPU 有大量小的、简单的处理单元,而不是少量(对于普通消费者桌面硬件通常是 1-8 个)复杂而强大的核。

CPU 架构

上面是一个 4 核 CPU 的简单漫画示意图。每个核都有一组寄存器以及不同等级的缓存(有些是共享缓存、有些不是),然后是主内存。

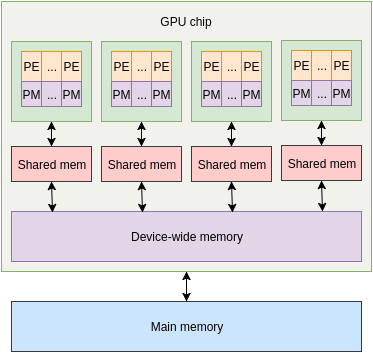
GPU 架构

在 GPU 上,多个小处理单元被组成一个执行单元。每个小处理单元都附有少量内存,每个执行单元都有一些共享内存用于它的处理单元。除此之外,还有一些 GPU 范围的内存,然后是 CPU 使用的主内存。执行单元内部的单元是 lockstep ,每个单元都在不同的数据片上执行相同的指令。

这可以使 GPU 同时处理大量的数据。如果是在 CPU 上,也许你可以使用多线程和向量指令在给定时间内完成大量的工作,但是 GPU 所能处理的远多于此。在 GPU 上一次性能够处理的数据规模使得它非常适合于类似图形(duh)、数学处理、神经网络等等。

GPGPU 编程的很多方面使得它和日常的 CPU 编程完全不同。例如,从主内存传输数据到 GPU 是很慢的。真的很慢。会完全干掉你的性能使你慢下来。因此,GPU 编程的权衡是尽可能多地利用加速器的高吞吐量来掩盖数据来往的延迟。

这里还有一些不那么明显的问题,例如分支的开销。由于执行单元内的处理单元按照 lockstep 工作,使它们执行不同路径(不同的控制流)的嵌套分支就是个真正的问题。这通常通过在所有单元上执行所有分支并标记出无用结果来解决。这是一个基于嵌套级别的指数级的复杂度,这当然是坏事情。当然,有一些优化方法可以拯救该问题,但需要注意:你从 CPU 领域带来的简单假设和知识在 GPU 领域可能导致大问题。

在我们回到 SYCL 之前,需要介绍一些术语。 主机 ( host ) 是主 CPU 运行的机器, 设备 ( device ) 是会运行你 OpenCL 代码的地方。设备可能就是主机,但也可能是你机器上的一些加速器、模拟器等。 内核 ( kernel ) 是一个特殊函数,它是在你设备上运行代码的入口点。通常还会提供一些主机设置好的缓存给它用于输入和输出数据。

回到 SYCL

这里有两个可用的 SYCL 实现:triSYCL,由 Xilinx 开发的实验性开源版本(通常作为标准的试验台使用),以及 ComputeCpp,由 Codeplay(我在 Codeplay 工作,但这篇文章是在没有我雇主建议的情况下使用我自己时间编写的) 开发的工业级实现(当前处于开发测试版)。只有 ComputeCpp 支持在 GPU 上执行内核,因此在这篇文章中我们会使用它。

第一步是在你的机器上配置以及运行 ComputeCpp。主要组件是一个实现了 SYCL API 的运行时库,以及一个基于 Clang 的编译器,它负责编译你的主机代码和设备代码。在本文写作时,已经在 Ubuntu 和 CentOS 上官方支持 Intel CPU 以及某些 AMD GPU。在其它 Linux 发行版上让它工作也非常简单(例如,我让它在我的 Arch 系统上运行)。对更多的硬件和操作系统的支持正在进行中,查看支持平台文档获取最新列表。这里列出了依赖和组件。你也可能想要下载 SDK,其中包括了示例、文档、构建系统集成文件,以及其它。在这篇文章中我会使用 SYCL 并行 STL,如果你想要自己在家学习的话也要下载它。

一旦你设置好了一切,我们就可以开始通用 GPU 编程了!正如简介中提到的,我的第一个示例使用 SYCL 并行 STL 实现。我们现在来看看如何使用纯 SYCL 编写代码。

#include <CL/sycl.hpp>

#include <array>
#include <numeric>
#include <iostream>

int main() {
      const size_t array_size = 1024*512;
      std::array<cl::sycl::cl_int, array_size> in,out;
      std::iota(begin(in),end(in),0);

      {
          cl::sycl::queue device_queue;
          cl::sycl::range<1> n_items{array_size};
          cl::sycl::buffer<cl::sycl::cl_int, 1> in_buffer(in.data(), n_items);
          cl::sycl::buffer<cl::sycl::cl_int, 1> out_buffer(out.data(), n_items);

          device_queue.submit([&](cl::sycl::handler &cgh) {
              constexpr auto sycl_read = cl::sycl::access::mode::read;
              constexpr auto sycl_write = cl::sycl::access::mode::write;

              auto in_accessor = in_buffer.get_access<sycl_read>(cgh);
              auto out_accessor = out_buffer.get_access<sycl_write>(cgh);

              cgh.parallel_for<class VecScalMul>(n_items,
                  [=](cl::sycl::id<1> wiID) {
                      out_accessor[wiID] = in_accessor[wiID]*2;
                  });
         });
     }
}

我会把它划分为一个个片段。

#include <CL/sycl.hpp>

我们做的第一件事就是包含 SYCL 头文件,它会在我们的命令中添加 SYCL 运行时库。

const size_t array_size = 1024*512;
std::array<cl::sycl::cl_int, array_size> in,out;
std::iota(begin(in),end(in),0);

这里我们构造了一个很大的整型数组并用数字 0 到 array_size-1 初始化(这就是 std::iota 所做的)。注意我们使用 cl::sycl::cl_int 确保兼容性。

{
    //...
}

接着我们打开一个新的作用域,其目的为二:

  1. device_queue 将在该作用域结束时解构,它将阻塞,直到内核完成。
  2. in_buffer 和 out_buffer 也将解构,这将强制数据传输回主机并允许我们从 in 和 out 中访问数据。 cl::sycl::queue device_queue;

现在我们创建我们的命令队列。命令队列是所有工作(内核)在分发到设备之前需要入队的地方。有很多方法可以定制队列,例如说提供设备用于入队或者设置异步错误处理器,但对于这个例子默认构造器就可以了;它会查找兼容的 GPU,如果失败的话会回退到主机 CPU。

cl::sycl::range<1> n_items{array_size};

接下来我们创建一个范围,它描述了内核在上面执行的数据的形状。在我们简单的例子中,它是一个一维数组,因此我们使用 cl::sycl::range<1>。如果数据是二维的,我们就会使用 cl::sycl::range<2>,以此类推。除了 cl::sycl::range,还有 cl::sycl::ndrange,它允许你指定工作组大小以及越界范围,但在我们的例子中我们不需要使用它。

cl::sycl::buffer<cl::sycl::cl_int, 1> in_buffer(in.data(), n_items);
cl::sycl::buffer<cl::sycl::cl_int, 1> out_buffer(out.data(), n_items);

为了控制主机和设备之间的数据共享和传输,SYCL 提供了一个 buffer 类。我们创建了两个 SYCL 缓存用于管理我们的输入和输出数组。

      device_queue.submit([&](cl::sycl::handler &cgh) {/*...*/});

设置好了我们所有数据之后,我们就可以入队真正的工作。有多种方法可以做到,但设置并行执行的一个简单方法是在我们的队列中调用 .submit 函数。对于这个函数我们传递了一个运行时调度该任务时会被执行的“命令组伪函数”(伪函数是规范,不是我创造的)。命令组处理器设置任何内核需要的余下资源并分发它。

constexpr auto sycl_read = cl::sycl::access::mode::read_write;
constexpr auto sycl_write = cl::sycl::access::mode::write;

auto in_accessor = in_buffer.get_access<sycl_read>(cgh);
auto out_accessor = out_buffer.get_access<sycl_write>(cgh);

为了控制到我们缓存的访问并告诉该运行时环境我们会如何使用数据,我们需要创建访问器。很显然,我们创建了一个访问器用于从 in_buffer 读入,一个访问器用于写到 out_buffer。

cgh.parallel_for<class VecScalMul>(n_items,
    [=](cl::sycl::id<1> wiID) {
         out_accessor[wiID] = in_accessor[wiID]*2;
    });

现在我们已经完成了所有设置,我们可以真正的在我们的设备上做一些计算了。这里我们根据范围 n_items 在命令组处理器 cgh 之上分发一个内核。实际内核自身是一个使用 work-item 标识符作为输入、输出我们计算结果的 lamda 表达式。在这种情况下,我们从 in_accessor 使用 work-item 标识符作为索引读入,将其乘以 2,然后将结果保存到 out_accessor 相应的位置。<class VecScalMul> 是一个为了在标准 C++ 范围内工作的不幸的副产品,因此我们需要给内核一个唯一的类名以便编译器能完成它的工作。

}

在此之后,我们现在可以访问 out 并期望看到正确的结果。

这里有相当多的新概念在起作用,但使用这些技术你可以看到这些能力和所展现出来的东西。当然,如果你只是想在你的 GPU 上执行一些代码而不关心定制化,那么你就可以使用 SYCL 并行 STL 实现。

SYCL 并行 STL

SYCL 并行 STL 是一个 TS 的并行化实现,它分发你的算法函数对象作为 SYCL 内核。在这个页面前面我们已经看过这样的例子,让我们来快速过一遍。

#include <vector>
#include <iostream>

#include <sycl/execution_policy>
#include <experimental/algorithm>
#include <sycl/helpers/sycl_buffers.hpp>

using namespace std::experimental::parallel;
using namespace sycl::helpers;

int main() {
  constexpr size_t array_size = 1024*512;
  std::array<cl::sycl::cl_int, array_size> in,out;
  std::iota(begin(in),end(in),0);

  {
    cl::sycl::buffer<int> in_buffer(in.data(), cl::sycl::range<1>(in.size()));
    cl::sycl::buffer<int> out_buffer(out.data(), cl::sycl::range<1>(out.size()));
    cl::sycl::queue q;
    sycl::sycl_execution_policy<class Mul> sycl_policy(q);
    transform(sycl_policy, begin(in_buffer), end(in_buffer), begin(out_buffer),
              [](int x) { return x*2; });
  }
}
  constexpr size_t array_size = 1024*512;
  std::array<cl::sycl::cl_int, array_size> in, out;
  std::iota(begin(in),end(in),0);

到现在为止一切如此相似。我们再一次创建一组数组用于保存我们的输入输出数据。

cl::sycl::buffer<int> in_buffer(in.data(), cl::sycl::range<1>(in.size()));
cl::sycl::buffer<int> out_buffer(out.data(), cl::sycl::range<1>(out.size()));
cl::sycl::queue q;

这里我们创建类似上个例子的缓存和队列。

sycl::sycl_execution_policy<class Mul> sycl_policy(q);

这就是有趣的部分。我们从我们的队列中创建 sycl_execution_policy,给它一个名称让内核使用。这个执行策略然后可以像 std::execution::par 或 std::execution::seq 那样使用。

transform(sycl_policy, begin(in_buffer), end(in_buffer), begin(out_buffer),
          [](int x) { return x*2; });

现在我们的内核分发看起来像提供了一个执行策略的 std::transform 调用。我们传递的闭包会被编译并在设备上执行,而不需要我们做其它更加复杂的设置。

当然,除了 transform 你可以做更多。开发的时候,SYCL 并行 STL 支持以下算法:

  • sort
  • transform
  • for_each
  • for_each_n
  • count_if
  • reduce
  • inner_product
  • transform_reduce

这就是这篇短文需要介绍的东西。如果你想和 SYCL 的开发保持同步,那就要看 sycl.tech。最近重要的开发就是移植 Eigen 和 Tensorflow 到 SYCL ,为 OpenCL 设备带来引入关注的人工智能编程。对我个人而言,我很高兴看到高级编程模型可以用于异构程序自动优化,以及它们是怎样支持类似 HPX 或 SkelCL 等更高级的技术。


via: https://blog.tartanllama.xyz/c++/2017/05/19/sycl/

作者:TartanLlama 译者:ictlyh 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

使用 7 条简单的 Git 命令开始你的软件开发之旅

你是否曾经想知道如何学好 Git?你长期以来都是跌跌撞撞地在使用 Git。最终,你总需要掌握它的窍门。这就是我写这篇文章的原因,我将带你去启蒙之旅。这儿是我关于如何加快 Git 学习过程的基本指南。我将介绍 Git 的实际情况以及我使用最多的 7 条 Git 命令。本文主要针对有兴趣的开发人员和大学新生,他们需要关于 Git 的介绍以及如何掌握基础知识。


你可以往前继续阅读整篇文章,或者只读 TLDR; 部分,尽管这将使我很受伤。

TLDR;

在学习 Git 的过程中,请养成下面这些步骤的习惯:

  1. 随时使用 git status!
  2. 只更改那些你真正想更改的文件。
  3. git add -A 会是你的朋友。
  4. 随时使用命令 git commit -m "meaningful messages"。
  5. 做任何推送(push)之前先使用命令 git pull,但是这需要在你提交过一些更改之后。
  6. 最后,git push推送提交的更改。

良宵莫辜负

对任何开发人员来说,通常第一步都是选择一个广泛使用的地方托管他或她的代码库。那就是,GitHub。它是一切有关代码的聚集地。要理解 GitHub 的概念,你先需要知道什么是 Git。

Git 是一款基于命令行的版本控制软件,在 Windows 和 Mac 系统上也有几款可用的桌面应用。 Git 由 Linux 之父 Linus Torvalds 开发,Linus Torvalds 还是是计算机科学中最有影响力的人物之一。因为这一优势,Git 已经成为绝大多数软件开发人员关于共享和维护代码的标准。这一大段话,让我们将其细细道来。正如它的名字所说,版本控制软件 Git 让你可以预览你写过的代码的所有版本。从字面上来说, 开发人员的每个代码库都将永远存储在其各自的仓库中,仓库可以叫做任何名字,从 pineapple 到 express 都行。在此仓库开发代码的过程中,你将进行出无数次的更改,直到第一次正式发布。这就是版本控制软件如此重要的核心原因所在。它让作为开发人员的你可以清楚地了解对代码库进行的所有更改、修订和改进。从另外一个方面说,它使协同合作更容易,下载代码进行编辑,然后将更改上传到仓库。然而,尽管有了这么多好处,然而还有一件事可以锦上添花。你可以下载并使用这些文件,即使你在整个开发过程中什么事也没有做。

让我们回到文章的 GitHub 部分。它只是所有仓库的枢纽(hub),这些仓库可以存储在其中并在线浏览。它是一个让有着共同兴趣的人相聚的地方。

千里之行始于足下

OK,记住,Git 是一款软件,像任何其他软件一样,你首先需要安装它:

Git - 安装 Git,如果你希望从源代码安装 Git,你需要安装这些 Git 的依赖库: autotools —— 来自 git-scm.com

Tips:请点击上面的链接,然后按照说明开始。

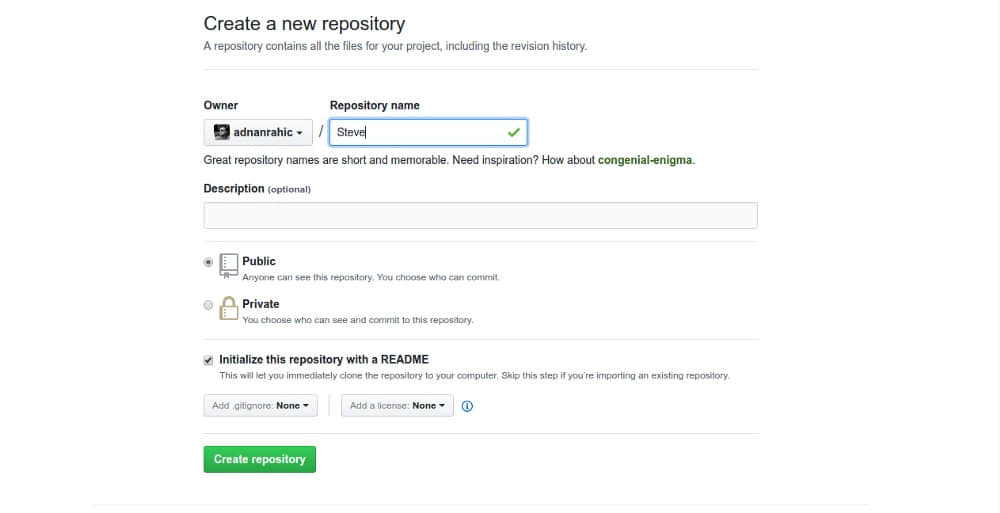
完成了安装过程,很好。现在你需要在你的浏览器地址栏输入 github.com 访问该网站。如果你还没有帐号的话需要新创建一个帐号,这就是你的起舞之处。登录并创建一个新仓库,命名为 Steve ,没有什么理由,只是想要一个名为史蒂夫的仓库好玩而已。选中 “Initialize this repository with a README” 复选框并点击创建按钮。现在你有了一个叫做 Steve 的仓库。我相信你会为你自己感到自豪。

现在开始在使用 Git

现在是比较有趣的部分。你将把 Steve 克隆到你本地的机器上。可以把这个过程看作从 Github 上复制仓库到你的电脑上。点击 “clone or download” 按钮,你将看到一个类似下面这样的 URL:

https://github.com/yourGithubAccountName/Steve.git

复制这个 URL 并打开命令提示符窗口。现在输入并运行条命令:

git clone https://github.com/yourGithubAccountName/Steve.git

Abrakadabra!Steve 仓库已经被自动克隆到了你的电脑上。查看你克隆这个仓库的目录,你会看到一个叫做 Steve 的文件夹。这个本地的文件夹现在已经链接到了它的 “origin” ,也就是 GitHub 上的远程仓库。

记住这个过程,在你的软件开发工程人员的职业生涯中你一定会重复这个过程很多次的。完成所有这些准备工作之后,你就可以开始使用最普通且常用的 Git 命令了。

你现在已经开始在真实场景使用 Git 了

找到 Steve 目录并在该目录中打开命令提示符窗口,运行下面的命令:

git status

这会输出你的工作目录的状态,让你知道所有你编辑过的文件。这意味着它显示了远程库中和本地工作目录中之间的文件差异。status 命令被用来作为 commit 的模版,我将在这篇教程后面进一步谈论 commit 。简单的说,[git status][1] 告诉你你编辑过哪些文件,以给你一个你想要上传到远程库的概述。

但是,在你做任何上传之前,你首先需要做的是选择你需要发送回远程库的文件。使用下面命令完成:

git add

接着在 Steve 目录新建一个文本文件,可以取一个好玩的名字 pineapple.txt。在这个文件里面随便写些你想写的内容,返回命令提示符,然后再次输入 git status。现在,你将看到这个文件以红色出现在标记 “untracked files” 下面。

On branch master
Your branch is up-to-date with 'origin/master'.
Untracked files:
  (use "git add <file>..." to include in what will be commited)

pineapple.txt

下一步就是将它添加到暂存区(staging)。暂存区可以看作是这样的一个环境:你做过的所有更改在提交时都将捆绑为一个更改而被提交。现在,你可以将这个文件加入暂存区:

git add -A

-A 选项意味着所有你更改过的文件都会被加到暂存区等待提交。然而, git add 非常灵活,它也可以像这样一个文件一个文件的添加:

git add pineapple.txt

这种方法让你有能力选择你想要暂存的每一个文件,而不用担心加入那些你不想改变的东西。

再次运行 git status,你会看到如下输出:

On branch master
Your branch is up-to-date with 'origin/master'.
Changes to be committed:
  (use "git reset HEAD <file>..." to unstage)

new file:   pineapple.txt

准备好提交更改了吗?开始吧。

git commit -m "Write your message here"

Git commit 命令会将存储在暂存区中的文件和来自用户的用于描述更改的日志信息一起存储在一个新的地方。-m选项加入了写在双引号内的信息。

再次检查状态,你会看到:

On branch master
Your branch is ahead of 'origin/master' by 1 commit.
  (use "git push" to publish your local commits)
nothing to commit, working directory clean

所有的更改现在都被加入到一次提交当中了,同时会有一条与你所做相关的信息。现在你可以用 git push 将这次提交推送到远程库 “origin”了。这条命令就像字面意义所说,它会把你提交的更改从本地机器上传到 GitHub 的远程仓库中。返回到命令提示符,然后运行:

git push

你会被要求输入你的 GitHub 帐号和密码,之后你会看到类似下面的这些内容:

Counting objects: 3, done.
Delta compression using up to 4 threads.
Compressing objects: 100% (2/2), done.
Writing objects: 100% (3/3), 280 bytes | 0 bytes/s, done.
Total 3 (delta 0), reused 0 (delta 0)
To https://github.com/yourGithubUserName/Steve.git
   c77a97c..08bb95a  master -> master

就是这样。你已经成功上传了你本地的更改。看看你在 GitHub 上的仓库,你会看到它现在包含了一叫做 pineapple.txt 的文件。

如果你是一个开发小组的一员呢?如果他们都推送提交到 “origin”,将会发生什么?这就是 Git 真正开始发挥它的魔力的时候。你可以使用一条简单的命令轻松地将最新版本的代码库 pull 到你本地的机器上:

git pull

但是 Git 也有限制:你需要有相匹配的版本才能推送到 “origin”。这意味着你本地的版本需要和 origin 的版本大致一样。当你从 “origin” 拉取(pull)文件时,在你的工作目录中不能有文件,因为它们将会在这个过程中被覆盖。因此我给出了这条简单的建议。在学习 Git 的过程中,请养成下面这些步骤的习惯:

  1. 随时使用 git status!
  2. 只更改那些你真正想更改的文件。
  3. git add -A 会是你的朋友。
  4. 随时使用命令 git commit -m "meaningful messages"。
  5. 做任何推送(push)之前先使用命令 git pull,但是这需要在你提交过一些更改之后。
  6. 最后,git push推送提交的更改。

嘿!你还在看这篇文章吗?你已经看了很久了,休息一下吧!

休息好了吗?好的!让我们来处理一些错误。如果你不小心更改了一些你本不应该更改的文件后怎么办呢?不需要担心,只需要使用 git checkout。让我们在文件 pineapple.txt 里更改一些内容:在文件中加入一行,比方说,“Steve is mega-awesome!” 。然后保存更改并用 git status 检查一下:

On branch master
Your branch is up-to-date with 'origin/master'.
Changes not staged for commit:
  (use "git add <file>..." to update what will be committed)
  (use "git checkout -- <file>..." to discard changes in working directory)

modified:   pineapple.txt

no changes added to commit (use "git add" and/or "git commit -a")

正如预料的那样,它已经被记录为一次更改了。但是,假如 Steve 实际上并不是很优秀呢?假如 Steve 很差劲呢?不用担心!最简单的还原更改的方式是运行命令:

git checkout -- pineapple.txt

现在你会看到文件已经恢复到了先前的状态。

但是假如你玩砸了呢?我是说,事情已经变得混乱,并且需要把所有东西重置到与 “origin” 一样的状态。也不需要担心,在这种紧急情况下我们可以享受 Git 的美妙之处:

git reset --hard

git reset 命令和 --hard 选项一起可以抛弃自上次提交以来的所有更改,有些时候真的很好用。


最后,我想鼓励你尽可能多地使用 Git。这是能够熟练使用它的最好学习方式。除此之外,养成阅读 Git 文档的习惯。一开始可能会有些云里雾里,但是过段时间后你就会明白它的窍门了。

希望你们(小伙子和姑娘们)读这篇文章的时候会和我写它时一样的开心。如果你认为这篇文章对别人有用,你尽可以与别人分享它。或者,如果你喜欢这篇文章,你可以在下面点下赞以便让更多的人看到这篇文章。


via: https://hackernoon.com/how-to-master-the-art-of-git-68e1050f3147

作者:Adnan Rahić 译者:zhousiyu325 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

机器学习是你的简历中必需的一门技能。我们简要概括一下使用 Python 来进行机器学习的一些步骤。

 title=

你想知道如何开始机器学习吗?在这篇文章中,我将简要概括一下使用 Python 来开始机器学习的一些步骤。Python 是一门流行的开源程序设计语言,也是在人工智能及其它相关科学领域中最常用的语言之一。机器学习简称 ML,是人工智能的一个分支,它是利用算法从数据中进行学习,然后作出预测。机器学习有助于帮助我们预测我们周围的世界。

从无人驾驶汽车到股市预测,再到在线学习,机器学习通过预测来进行自我提高的方法几乎被用在了每一个领域。由于机器学习的实际运用,目前它已经成为就业市场上最有需求的技能之一。另外,使用 Python 来开始机器学习很简单,因为有大量的在线资源,以及许多可用的 Python 机器学习库。

你需要如何开始使用 Python 进行机器学习呢?让我们来总结一下这个过程。

提高你的 Python 技能

由于 Python 在工业界和科学界都非常受欢迎,因此你不难找到 Python 的学习资源。如果你是一个从未接触过 Python 的新手,你可以利用在线资源,比如课程、书籍和视频来学习 Python。比如下面列举的一些资源:

安装 Anaconda

下一步是安装 Anacona。有了 Anaconda ,你将可以开始使用 Python 来探索机器学习的世界了。Anaconda 的默认安装库包含了进行机器学习所需要的工具。

基本的机器学习技能

有了一些基本的 Python 编程技能,你就可以开始学习一些基本的机器学习技能了。一个实用的学习方法是学到一定技能便开始进行练习。然而,如果你想深入学习这个领域,那么你需要准备投入更多的学习时间。

一个获取技能的有效方法是在线课程。吴恩达的 Coursera 机器学习课程 是一个不错的选择。其它有用的在线训练包括:

你也可以在 LiveEdu.tv 上观看机器学习视频,从而进一步了解这个领域。

学习更多的 Python 库

当你对 Python 和机器学习有一个好的感觉之后,可以开始学习一些开源的 Python 库。科学的 Python 库将会使完成一些简单的机器学习任务变得很简单。然而,选择什么库是完全主观的,并且在业界内许多人有很大的争论。

一些实用的 Python 库包括:

  • Scikit-learn :一个优雅的机器学习算法库,可用于数据挖掘和数据分析任务。
  • Tensorflow :一个易于使用的神经网络库。
  • Theano : 一个强大的机器学习库,可以帮助你轻松的评估数学表达式。
  • Pattern : 可以帮助你进行自然语言处理、数据挖掘以及更多的工作。
  • Nilearn :基于 Scikit-learn,它可以帮助你进行简单快速的统计学习。

探索机器学习

对基本的 Python、机器学习技能和 Python 库有了一定理解之后,就可以开始探索机器学习了。接下来,尝试探索一下 Scikit-learn 库。一个不错的教程是 Jake VanderPlas 写的 Scikit-learn 简介。

然后,进入中级主题,比如 K-均值聚类算法简介、线性回归、决策树和逻辑回归。

最后,深入高级机器学习主题,比如向量机和复杂数据转换。

就像学习任何新技能一样,练习得越多,就会学得越好。你可以通过练习不同的算法,使用不同的数据集来更好的理解机器学习,并提高解决问题的整体能力。

使用 Python 进行机器学习是对你的技能的一个很好的补充,并且有大量免费和低成本的在线资源可以帮助你。你已经掌握机器学习技能了吗?可以在下面留下你的评论,或者提交一篇文章来分享你的故事。

(题图:opensource.com)


作者简介:

Michael J. Garbade 博士是旧金山 LiveEdu Inc(Livecoding.tv)的创始人兼首席执行官。Livecoding.tv 是世界上观看工程师直播编代码最先进的直播平台。你可以通过观看工程师们写网站、移动应用和游戏,来将你的技能提升到一个新的水平。MichaelJ. Garbade 博士拥有金融学博士学位,并且是一名自学成才的工程师,他喜欢 Python、Django、Sencha Touch 和视频流。


via: https://opensource.com/article/17/5/python-machine-learning-introduction

作者:Michael J. Garbade 译者:ucasFL 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

这是调试器的工作原理系列文章的第三篇。阅读这篇文章之前应当先阅读第一篇与第二篇。

这篇文章的主要内容

本文将解释调试器是如何在机器码中查找它将 C 语言源代码转换成机器语言代码时所需要的 C 语言函数、变量、与数据。

调试信息

现代编译器能够将有着各种缩进或嵌套的程序流程、各种数据类型的变量的高级语言代码转换为一大堆称之为机器码的 0/1 数据,这么做的唯一目的是尽可能快的在目标 CPU 上运行程序。通常来说一行 C 语言代码能够转换为若干条机器码。变量被分散在机器码中的各个部分,有的在堆栈中,有的在寄存器中,或者直接被优化掉了。数据结构与对象在机器码中甚至不“存在”,它们只是用于将数据按一定的结构编码存储进缓存。

那么调试器怎么知道,当你需要在某个函数入口处暂停时,程序要在哪停下来呢?它怎么知道当你查看某个变量值时,它怎么找到这个值?答案是,调试信息。

编译器在生成机器码时同时会生成相应的调试信息。调试信息代表了可执行程序与源代码之间的关系,并以一种提前定义好的格式,同机器码存放在一起。过去的数年里,人们针对不同的平台与可执行文件发明了很多种用于存储这些信息的格式。不过我们这篇文章不会讲这些格式的历史,而是将阐述这些调试信息是如何工作的,所以我们将专注于一些事情,比如 DWARF。DWARF 如今十分广泛的用作 Linux 和类 Unix 平台上的可执行文件的调试格式。

ELF 中的 DWARF

根据它的维基百科 所描述,虽然 DWARF 是同 ELF 一同设计的(DWARF 是由 DWARF 标准委员会推出的开放标准。上文中展示的图标就来自这个网站。),但 DWARF 在理论上来说也可以嵌入到其他的可执行文件格式中。

DWARF 是一种复杂的格式,它吸收了过去许多年各种不同的架构与操作系统的格式的经验。正是因为它解决了一个在任何平台与 ABI (应用二进制接口)上为任意高级语言产生调试信息这样棘手的难题,它也必须很复杂。想要透彻的讲解 DWARF 仅仅是通过这单薄的一篇文章是远远不够的,说实话我也并没有充分地了解 DWARF 到每一个微小的细节,所以我也不能十分透彻的讲解 (如果你感兴趣的话,文末有一些能够帮助你的资源。建议从 DWARF 教程开始上手)。这篇文章中我将以浅显易懂的方式展示 DWARF,以说明调试信息是如何实际工作的。

ELF 文件中的调试部分

首先让我们看看 DWARF 处在 ELF 文件中的什么位置。ELF 定义了每一个生成的目标文件中的每一节。 节头表 section header table 声明并定义了每一节及其名字。不同的工具以不同的方式处理不同的节,例如连接器会寻找连接器需要的部分,调试器会查找调试器需要的部分。

我们本文的实验会使用从这个 C 语言源文件构建的可执行文件,编译成 tracedprog2:

#include <stdio.h>

void do_stuff(int my_arg)、
{
    int my_local = my_arg + 2;
    int i;

    for (i = 0; i < my_local; ++i)
        printf("i = %d\n", i);
}

int main()
{
    do_stuff(2);
    return 0;
}

使用 objdump -h 命令检查 ELF 可执行文件中的 节头 section header ,我们会看到几个以 .debug_ 开头的节,这些就是 DWARF 的调试部分。

26 .debug_aranges 00000020  00000000  00000000  00001037
                 CONTENTS, READONLY, DEBUGGING
27 .debug_pubnames 00000028  00000000  00000000  00001057
                 CONTENTS, READONLY, DEBUGGING
28 .debug_info   000000cc  00000000  00000000  0000107f
                 CONTENTS, READONLY, DEBUGGING
29 .debug_abbrev 0000008a  00000000  00000000  0000114b
                 CONTENTS, READONLY, DEBUGGING
30 .debug_line   0000006b  00000000  00000000  000011d5
                 CONTENTS, READONLY, DEBUGGING
31 .debug_frame  00000044  00000000  00000000  00001240
                 CONTENTS, READONLY, DEBUGGING
32 .debug_str    000000ae  00000000  00000000  00001284
                 CONTENTS, READONLY, DEBUGGING
33 .debug_loc    00000058  00000000  00000000  00001332
                 CONTENTS, READONLY, DEBUGGING

每个节的第一个数字代表了该节的大小,最后一个数字代表了这个节开始位置距离 ELF 的偏移量。调试器利用这些信息从可执行文件中读取节。

现在让我们看看一些在 DWARF 中查找有用的调试信息的实际例子。

查找函数

调试器的最基础的任务之一,就是当我们在某个函数处设置断点时,调试器需要能够在入口处暂停。为此,必须为高级代码中的函数名称与函数在机器码中指令开始的地址这两者之间建立起某种映射关系。

为了获取这种映射关系,我们可以查找 DWARF 中的 .debug_info 节。在我们深入之前,需要一点基础知识。DWARF 中每一个描述类型被称之为调试信息入口(DIE)。每个 DIE 都有关于它的类型、属性之类的标签。DIE 之间通过兄弟节点或子节点相互连接,属性的值也可以指向其它的 DIE。

运行以下命令:

objdump --dwarf=info tracedprog2

输出文件相当的长,为了方便举例我们只关注这些行(从这里开始,无用的冗长信息我会以 (...)代替,方便排版):

<1><71>: Abbrev Number: 5 (DW_TAG_subprogram)
    <72>   DW_AT_external    : 1
    <73>   DW_AT_name        : (...): do_stuff
    <77>   DW_AT_decl_file   : 1
    <78>   DW_AT_decl_line   : 4
    <79>   DW_AT_prototyped  : 1
    <7a>   DW_AT_low_pc      : 0x8048604
    <7e>   DW_AT_high_pc     : 0x804863e
    <82>   DW_AT_frame_base  : 0x0      (location list)
    <86>   DW_AT_sibling     : <0xb3>

<1><b3>: Abbrev Number: 9 (DW_TAG_subprogram)
    <b4>   DW_AT_external    : 1
    <b5>   DW_AT_name        : (...): main
    <b9>   DW_AT_decl_file   : 1
    <ba>   DW_AT_decl_line   : 14
    <bb>   DW_AT_type        : <0x4b>
    <bf>   DW_AT_low_pc      : 0x804863e
    <c3>   DW_AT_high_pc     : 0x804865a
    <c7>   DW_AT_frame_base  : 0x2c     (location list)

上面的代码中有两个带有 DW_TAG_subprogram 标签的入口,在 DWARF 中这是对函数的指代。注意,这是两个节的入口,其中一个是 do_stuff 函数的入口,另一个是主(main)函数的入口。这些信息中有很多值得关注的属性,但其中最值得注意的是 DW_AT_low_pc。它代表了函数开始处程序指针的值(在 x86 平台上是 EIP)。此处 0x8048604 代表了 do_stuff 函数开始处的程序指针。下面我们将利用 objdump -d 命令对可执行文件进行反汇编。来看看这块地址中都有什么:

08048604 <do_stuff>:
 8048604:       55           push   ebp
 8048605:       89 e5        mov    ebp,esp
 8048607:       83 ec 28     sub    esp,0x28
 804860a:       8b 45 08     mov    eax,DWORD PTR [ebp+0x8]
 804860d:       83 c0 02     add    eax,0x2
 8048610:       89 45 f4     mov    DWORD PTR [ebp-0xc],eax
 8048613:       c7 45 (...)  mov    DWORD PTR [ebp-0x10],0x0
 804861a:       eb 18        jmp    8048634 <do_stuff+0x30>
 804861c:       b8 20 (...)  mov    eax,0x8048720
 8048621:       8b 55 f0     mov    edx,DWORD PTR [ebp-0x10]
 8048624:       89 54 24 04  mov    DWORD PTR [esp+0x4],edx
 8048628:       89 04 24     mov    DWORD PTR [esp],eax
 804862b:       e8 04 (...)  call   8048534 <printf@plt>
 8048630:       83 45 f0 01  add    DWORD PTR [ebp-0x10],0x1
 8048634:       8b 45 f0     mov    eax,DWORD PTR [ebp-0x10]
 8048637:       3b 45 f4     cmp    eax,DWORD PTR [ebp-0xc]
 804863a:       7c e0        jl     804861c <do_stuff+0x18>
 804863c:       c9           leave
 804863d:       c3           ret

显然,0x8048604 是 do_stuff 的开始地址,这样一来,调试器就可以建立函数与其在可执行文件中的位置间的映射关系。

查找变量

假设我们当前在 do_staff 函数中某个位置上设置断点停了下来。我们想通过调试器取得 my_local 这个变量的值。调试器怎么知道在哪里去找这个值呢?很显然这要比查找函数更为困难。变量可能存储在全局存储区、堆栈、甚至是寄存器中。此外,同名变量在不同的作用域中可能有着不同的值。调试信息必须能够反映所有的这些变化,当然,DWARF 就能做到。

我不会逐一去将每一种可能的状况,但我会以调试器在 do_stuff 函数中查找 my_local 变量的过程来举个例子。下面我们再看一遍 .debug_info 中 do_stuff 的每一个入口,这次连它的子入口也要一起看。

<1><71>: Abbrev Number: 5 (DW_TAG_subprogram)
    <72>   DW_AT_external    : 1
    <73>   DW_AT_name        : (...): do_stuff
    <77>   DW_AT_decl_file   : 1
    <78>   DW_AT_decl_line   : 4
    <79>   DW_AT_prototyped  : 1
    <7a>   DW_AT_low_pc      : 0x8048604
    <7e>   DW_AT_high_pc     : 0x804863e
    <82>   DW_AT_frame_base  : 0x0      (location list)
    <86>   DW_AT_sibling     : <0xb3>
 <2><8a>: Abbrev Number: 6 (DW_TAG_formal_parameter)
    <8b>   DW_AT_name        : (...): my_arg
    <8f>   DW_AT_decl_file   : 1
    <90>   DW_AT_decl_line   : 4
    <91>   DW_AT_type        : <0x4b>
    <95>   DW_AT_location    : (...)       (DW_OP_fbreg: 0)
 <2><98>: Abbrev Number: 7 (DW_TAG_variable)
    <99>   DW_AT_name        : (...): my_local
    <9d>   DW_AT_decl_file   : 1
    <9e>   DW_AT_decl_line   : 6
    <9f>   DW_AT_type        : <0x4b>
    <a3>   DW_AT_location    : (...)      (DW_OP_fbreg: -20)
<2><a6>: Abbrev Number: 8 (DW_TAG_variable)
    <a7>   DW_AT_name        : i
    <a9>   DW_AT_decl_file   : 1
    <aa>   DW_AT_decl_line   : 7
    <ab>   DW_AT_type        : <0x4b>
    <af>   DW_AT_location    : (...)      (DW_OP_fbreg: -24)

看到每个入口处第一对尖括号中的数字了吗?这些是嵌套的等级,在上面的例子中,以 <2> 开头的入口是以 <1> 开头的子入口。因此我们得知 my_local 变量(以 DW_TAG_variable 标签标记)是 do_stuff 函数的局部变量。除此之外,调试器也需要知道变量的数据类型,这样才能正确的使用与显示变量。上面的例子中 my_local 的变量类型指向另一个 DIE <0x4b>。如果使用 objdump 命令查看这个 DIE 的话,我们会发现它是一个有符号 4 字节整型数据。

而为了在实际运行的程序内存中查找变量的值,调试器需要使用到 DW_AT_location 属性。对于 my_local 而言,是 DW_OP_fbreg: -20。这个代码段的意思是说 my_local 存储在距离它所在函数起始地址偏移量为 -20 的地方。

do_stuff 函数的 DW_AT_frame_base 属性值为 0x0 (location list)。这意味着这个属性的值需要在 location list 中查找。下面我们来一起看看。

$ objdump --dwarf=loc tracedprog2

tracedprog2:     file format elf32-i386

Contents of the .debug_loc section:

    Offset   Begin    End      Expression
    00000000 08048604 08048605 (DW_OP_breg4: 4 )
    00000000 08048605 08048607 (DW_OP_breg4: 8 )
    00000000 08048607 0804863e (DW_OP_breg5: 8 )
    00000000 <End of list>
    0000002c 0804863e 0804863f (DW_OP_breg4: 4 )
    0000002c 0804863f 08048641 (DW_OP_breg4: 8 )
    0000002c 08048641 0804865a (DW_OP_breg5: 8 )
    0000002c <End of list>

我们需要关注的是第一列(do_stuff 函数的 DW_AT_frame_base 属性包含 location list 中 0x0 的偏移量。而 main 函数的相同属性包含 0x2c 的偏移量,这个偏移量是第二套地址列表的偏移量)。对于调试器可能定位到的每一个地址,它都会指定当前栈帧到变量间的偏移量,而这个偏移就是通过寄存器来计算的。对于 x86 平台而言,bpreg4 指向 esp,而 bpreg5 指向 ebp。

让我们再看看 do_stuff 函数的头几条指令。

08048604 <do_stuff>:
 8048604:       55          push   ebp
 8048605:       89 e5       mov    ebp,esp
 8048607:       83 ec 28    sub    esp,0x28
 804860a:       8b 45 08    mov    eax,DWORD PTR [ebp+0x8]
 804860d:       83 c0 02    add    eax,0x2
 8048610:       89 45 f4    mov    DWORD PTR [ebp-0xc],eax

只有当第二条指令执行后,ebp 寄存器才真正存储了有用的值。当然,前两条指令的基址是由上面所列出来的地址信息表计算出来的。一但 ebp 确定了,计算偏移量就十分方便了,因为尽管 esp 在操作堆栈的时候需要移动,但 ebp 作为栈底并不需要移动。

究竟我们应该去哪里找 my_local 的值呢?在 0x8048610 这块地址后, my_local 的值经过在 eax 中的计算后被存在了内存中,从这里开始我们才需要关注 my_local 的值。调试器会利用 DW_OP_breg5: 8 这个栈帧来查找。我们回想下,my_local 的 DW_AT_location 属性值为 DW_OP_fbreg: -20。所以应当从基址中 -20 ,同时由于 ebp 寄存器需要 +8,所以最终结果为 ebp - 12。现在再次查看反汇编代码,来看看数据从 eax 中被移动到哪里了。当然,这里 my_local 应当被存储在了 ebp - 12 的地址中。

查看行号

当我们谈到在调试信息寻找函数的时候,我们利用了些技巧。当调试 C 语言源代码并在某个函数出放置断点的时候,我们并不关注第一条“机器码”指令(函数的调用准备工作已经完成而局部变量还没有初始化)。我们真正关注的是函数的第一行“C 代码”。

这就是 DWARF 完全覆盖映射 C 源代码中的行与可执行文件中机器码地址的原因。下面是 .debug_line 节中所包含的内容,我们将其转换为可读的格式展示如下。

$ objdump --dwarf=decodedline tracedprog2

tracedprog2:     file format elf32-i386

Decoded dump of debug contents of section .debug_line:

CU: /home/eliben/eli/eliben-code/debugger/tracedprog2.c:
File name           Line number    Starting address
tracedprog2.c                5           0x8048604
tracedprog2.c                6           0x804860a
tracedprog2.c                9           0x8048613
tracedprog2.c               10           0x804861c
tracedprog2.c                9           0x8048630
tracedprog2.c               11           0x804863c
tracedprog2.c               15           0x804863e
tracedprog2.c               16           0x8048647
tracedprog2.c               17           0x8048653
tracedprog2.c               18           0x8048658

很容易就可以看出其中 C 源代码与反汇编代码之间的对应关系。第 5 行指向 do_stuff 函数的入口,0x8040604。第 6 行,指向 0x804860a ,正是调试器在调试 do_stuff 函数时需要停下来的地方。这里已经完成了函数调用的准备工作。上面的这些信息形成了行号与地址间的双向映射关系。

  • 当在某一行设置断点的时候,调试器会利用这些信息去查找相应的地址来做断点工作(还记得上篇文章中的 int 3 指令吗?)
  • 当指令造成段错误时,调试器会利用这些信息来查看源代码中发生问题的行。

libdwarf - 用 DWARF 编程

尽管使用命令行工具来获得 DWARF 很有用,但这仍然不够易用。作为程序员,我们希望知道当我们需要这些调试信息时应当怎么编程来获取这些信息。

自然我们想到的第一种方法就是阅读 DWARF 规范并按规范操作阅读使用。有句话说的好,分析 HTML 应当使用库函数,永远不要手工分析。对于 DWARF 来说正是如此。DWARF 比 HTML 要复杂得多。上面所展示出来的只是冰山一角。更糟糕的是,在实际的目标文件中,大部分信息是以非常紧凑的压缩格式存储的,分析起来更加复杂(信息中的某些部分,例如位置信息与行号信息,在某些虚拟机下是以指令的方式编码的)。

所以我们要使用库来处理 DWARF。下面是两种我熟悉的主要的库(还有些不完整的库这里没有写)

  1. BFD (libbfd),包含了 objdump (对,就是这篇文章中我们一直在用的这货),ld(GNU 连接器)与 as(GNU 编译器)。BFD 主要用于 GNU binutils。
  2. libdwarf ,同它的哥哥 libelf 一同用于 Solaris 与 FreeBSD 中的调试信息分析。

相比较而言我更倾向于使用 libdwarf,因为我对它了解的更多,并且 libdwarf 的开源协议更开放(LGPL 对比 GPL)。

因为 libdwarf 本身相当复杂,操作起来需要相当多的代码,所以我在这不会展示所有代码。你可以在 这里 下载代码并运行试试。运行这些代码需要提前安装 libelfand 与 libdwarf ,同时在使用连接器的时候要使用参数 -lelf 与 -ldwarf。

这个示例程序可以接受可执行文件并打印其中的函数名称与函数入口地址。下面是我们整篇文章中使用的 C 程序经过示例程序处理后的输出。

$ dwarf_get_func_addr tracedprog2
DW_TAG_subprogram: 'do_stuff'
low pc  : 0x08048604
high pc : 0x0804863e
DW_TAG_subprogram: 'main'
low pc  : 0x0804863e
high pc : 0x0804865a

libdwarf 的文档很棒,如果你花些功夫,利用 libdwarf 获得这篇文章中所涉及到的 DWARF 信息应该并不困难。

结论与计划

原理上讲,调试信息是个很简单的概念。尽管实现细节可能比较复杂,但经过了上面的学习我想你应该了解了调试器是如何从可执行文件中获取它需要的源代码信息的了。对于程序员而言,程序只是代码段与数据结构;对可执行文件而言,程序只是一系列存储在内存或寄存器中的指令或数据。但利用调试信息,调试器就可以将这两者连接起来,从而完成调试工作。

此文与这系列的前两篇,一同介绍了调试器的内部工作过程。利用这里所讲到的知识,再敲些代码,应该可以完成一个 Linux 中最简单、基础但也有一定功能的调试器。

下一步我并不确定要做什么,这个系列文章可能就此结束,也有可能我要讲些堆栈调用的事情,又或者讲 Windows 下的调试。你们有什么好的点子或者相关材料,可以直接评论或者发邮件给我。

参考


via: http://eli.thegreenplace.net/2011/02/07/how-debuggers-work-part-3-debugging-information

作者:Eli Bendersky 译者:YYforymj 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

快速测试 - 下面的代码输出什么?

vals := make([]int, 5)  
for i := 0; i < 5; i++ {  
  vals = append(vals, i)
}
fmt.Println(vals)  

在 Go Playground 运行一下

如果你猜测的是 [0 0 0 0 0 0 1 2 3 4],那你是对的。

等等,什么? 为什么不是 [0 1 2 3 4]?

如果你在测试中做错了,你也不用担心。这是在过渡到 Go 语言的过程中相当常见的错误,在这篇文章中,我们将说明为什么输出不是你预期的,以及如何利用 Go 的细微差别来使你的代码更有效率。

切片 vs 数组

在 Go 中同时有数组(array)和切片(slice)。这可能令人困惑,但一旦你习惯了,你会喜欢上它。请相信我。

切片和数组之间存在许多差异,但我们要在本文中重点介绍的内容是数组的大小是其类型的一部分,而切片可以具有动态大小,因为它们是围绕数组的封装。

这在实践中意味着什么?那么假设我们有数组 val a [10]int。该数组具有固定大小,且无法更改。如果我们调用 len(a),它总是返回 10,因为这个大小是类型的一部分。因此,如果你突然需要在数组中超过 10 个项,则必须创建一个完全不同类型的新对象,例如 val b [11]int,然后将所有值从 a 复制到 b。

在特定情况下,含有集合大小的数组是有价值的,但一般而言,这不是开发人员想要的。相反,他们希望在 Go 中使用类似于数组的东西,但是随着时间的推移,它们能够随时增长。一个粗略的方式是创建一个比它需要大得多的数组,然后将数组的一个子集视为数组。下面的代码是个例子。

var vals [20]int  
for i := 0; i < 5; i++ {  
  vals[i] = i * i
}
subsetLen := 5

fmt.Println("The subset of our array has a length of:", subsetLen)

// Add a new item to our array
vals[subsetLen] = 123  
subsetLen++  
fmt.Println("The subset of our array has a length of:", subsetLen)  

在 Go Playground 中运行

在代码中,我们有一个长度为 20 的数组,但是由于我们只使用一个子集,代码中我们可以假定数组的长度是 5,然后在我们向数组中添加一个新的项之后是 6。

这是(非常粗略地说)切片是如何工作的。它们包含一个具有设置大小的数组,就像我们前面的例子中的数组一样,它的大小为 20。

它们还跟踪程序中使用的数组的子集 - 这就是 append 属性,它类似于上一个例子中的 subsetLen 变量。

最后,一个切片还有一个 capacity,类似于前面例子中我们的数组的总长度(20)。这是很有用的,因为它会告诉你的子集在无法容纳切片数组之前可以增长的大小。当发生这种情况时,需要分配一个新的数组,但所有这些逻辑都隐藏在 append 函数的后面。

简而言之,使用 append 函数组合切片给我们一个非常类似于数组的类型,但随着时间的推移,它可以处理更多的元素。

我们再来看一下前面的例子,但是这次我们将使用切片而不是数组。

var vals []int  
for i := 0; i < 5; i++ {  
  vals = append(vals, i)
  fmt.Println("The length of our slice is:", len(vals))
  fmt.Println("The capacity of our slice is:", cap(vals))
}

// Add a new item to our array
vals = append(vals, 123)  
fmt.Println("The length of our slice is:", len(vals))  
fmt.Println("The capacity of our slice is:", cap(vals))

// Accessing items is the same as an array
fmt.Println(vals[5])  
fmt.Println(vals[2])  

在 Go Playground 中运行

我们仍然可以像数组一样访问我们的切片中的元素,但是通过使用切片和 append 函数,我们不再需要考虑背后数组的大小。我们仍然可以通过使用 len 和 cap 函数来计算出这些东西,但是我们不用担心太多。简洁吧?

回到测试

记住这点,让我们回顾前面的测试,看下什么出错了。

vals := make([]int, 5)  
for i := 0; i < 5; i++ {  
  vals = append(vals, i)
}
fmt.Println(vals)  

当调用 make 时,我们允许最多传入 3 个参数。第一个是我们分配的类型,第二个是类型的“长度”,第三个是类型的“容量”(这个参数是可选的)。

通过传递参数 make([]int, 5),我们告诉程序我们要创建一个长度为 5 的切片,在这种情况下,默认的容量与长度相同 - 本例中是 5。

虽然这可能看起来像我们想要的那样,这里的重要区别是我们告诉我们的切片,我们要将“长度”和“容量”设置为 5,假设你想要在初始的 5 个元素之后添加新的元素,我们接着调用 append 函数,那么它会增加容量的大小,并且会在切片的最后添加新的元素。

如果在代码中添加一条 Println() 语句,你可以看到容量的变化。

vals := make([]int, 5)  
fmt.Println("Capacity was:", cap(vals))  
for i := 0; i < 5; i++ {  
  vals = append(vals, i)
  fmt.Println("Capacity is now:", cap(vals))
}

fmt.Println(vals)  

在 Go Playground 中运行

最后,我们最终得到 [0 0 0 0 0 0 1 2 3 4] 的输出而不是希望的 [0 1 2 3 4]。

如何修复它呢?好的,这有几种方法,我们将讲解两种,你可以选取任何一种在你的场景中最有用的方法。

直接使用索引写入而不是 append

第一种修复是保留 make 调用不变,并且显式地使用索引来设置每个元素。这样,我们就得到如下的代码:

vals := make([]int, 5)  
for i := 0; i < 5; i++ {  
  vals[i] = i
}
fmt.Println(vals)  

在 Go Playground 中运行

在这种情况下,我们设置的值恰好与我们要使用的索引相同,但是你也可以独立跟踪索引。

比如,如果你想要获取 map 的键,你可以使用下面的代码。

package main

import "fmt"

func main() {  
  fmt.Println(keys(map[string]struct{}{
    "dog": struct{}{},
    "cat": struct{}{},
  }))
}

func keys(m map[string]struct{}) []string {  
  ret := make([]string, len(m))
  i := 0
  for key := range m {
    ret[i] = key
    i++
  }
  return ret
}

在 Go Playground 中运行

这样做很好,因为我们知道我们返回的切片的长度将与 map 的长度相同,因此我们可以用该长度初始化我们的切片,然后将每个元素分配到适当的索引中。这种方法的缺点是我们必须跟踪 i,以便了解每个索引要设置的值。

这就让我们引出了第二种方法……

使用 0 作为你的长度并指定容量

与其跟踪我们要添加的值的索引,我们可以更新我们的 make 调用,并在切片类型之后提供两个参数。第一个,我们的新切片的长度将被设置为 0,因为我们还没有添加任何新的元素到切片中。第二个,我们新切片的容量将被设置为 map 参数的长度,因为我们知道我们的切片最终会添加许多字符串。

这会如前面的例子那样仍旧会在背后构建相同的数组,但是现在当我们调用 append 时,它会将它们放在切片开始处,因为切片的长度是 0。

package main

import "fmt"

func main() {  
  fmt.Println(keys(map[string]struct{}{
    "dog": struct{}{},
    "cat": struct{}{},
  }))
}

func keys(m map[string]struct{}) []string {  
  ret := make([]string, 0, len(m))
  for key := range m {
    ret = append(ret, key)
  }
  return ret
}

在 Go Playground 中运行

如果 append 处理它,为什么我们还要担心容量呢?

接下来你可能会问:“如果 append 函数可以为我增加切片的容量,那我们为什么要告诉程序容量呢?”

事实是,在大多数情况下,你不必担心这太多。如果它使你的代码变得更复杂,只需用 var vals []int 初始化你的切片,然后让 append 函数处理接下来的事。

但这种情况是不同的。它并不是声明容量困难的例子,实际上这很容易确定我们的切片的最后容量,因为我们知道它将直接映射到提供的 map 中。因此,当我们初始化它时,我们可以声明切片的容量,并免于让我们的程序执行不必要的内存分配。

如果要查看额外的内存分配情况,请在 Go Playground 上运行以下代码。每次增加容量,程序都需要做一次内存分配。

package main

import "fmt"

func main() {  
  fmt.Println(keys(map[string]struct{}{
    "dog":       struct{}{},
    "cat":       struct{}{},
    "mouse":     struct{}{},
    "wolf":      struct{}{},
    "alligator": struct{}{},
  }))
}

func keys(m map[string]struct{}) []string {  
  var ret []string
  fmt.Println(cap(ret))
  for key := range m {
    ret = append(ret, key)
    fmt.Println(cap(ret))
  }
  return ret
}

在 Go Playground 中运行

现在将此与相同的代码进行比较,但具有预定义的容量。

package main

import "fmt"

func main() {  
  fmt.Println(keys(map[string]struct{}{
    "dog":       struct{}{},
    "cat":       struct{}{},
    "mouse":     struct{}{},
    "wolf":      struct{}{},
    "alligator": struct{}{},
  }))
}

func keys(m map[string]struct{}) []string {  
  ret := make([]string, 0, len(m))
  fmt.Println(cap(ret))
  for key := range m {
    ret = append(ret, key)
    fmt.Println(cap(ret))
  }
  return ret
}

在 Go Playground 中运行

在第一个代码示例中,我们的容量从 0 开始,然后增加到 1、 2、 4, 最后是 8,这意味着我们不得不分配 5 次数组,最后一个容纳我们切片的数组的容量是 8,这比我们最终需要的要大。

另一方面,我们的第二个例子开始和结束都是相同的容量(5),它只需要在 keys() 函数的开头分配一次。我们还避免了浪费任何额外的内存,并返回一个能放下这个数组的完美大小的切片。

不要过分优化

如前所述,我通常不鼓励任何人做这样的小优化,但如果最后大小的效果真的很明显,那么我强烈建议你尝试为切片设置适当的容量或长度。

这不仅有助于提高程序的性能,还可以通过明确说明输入的大小和输出的大小之间的关系来帮助澄清你的代码。

总结

你好!我写了很多关于Go、Web 开发和其他我觉得有趣的话题。

如果你想跟上最新的文章,请注册我的邮件列表。我会给你发送我新书的样例、Go 的 Web 开发、以及每当有新文章(通常每周 1-2 次)会给你发送邮件。

哦,我保证不会发垃圾邮件。我像你一样讨厌它 :)

本文并不是对切片或数组之间差异的详细讨论,而是简要介绍了容量和长度如何影响切片,以及它们在方案中的用途。

为了进一步阅读,我强烈推荐 Go 博客中的以下文章:


作者简介:

Jon 是一名软件顾问,也是 《Web Development with Go》 一书的作者。在此之前,他创立了 EasyPost,一家 Y Combinator 支持的创业公司,并在 Google 工作。

https://www.usegolang.com


via: https://www.calhoun.io/how-to-use-slice-capacity-and-length-in-go

作者:Jon Calhoun 译者:geekpi 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出