构建你的数据科学作品集:机器学习项目
这是这个系列发布的第三篇关于如何构建数据 科学作品集 的文章。如果你喜欢这个系列并且想继续关注,你可以在订阅页面的底部找到链接。
数据科学公司在决定雇佣时越来越关注你在数据科学方面的 作品集 。这其中的一个原因是,这样的作品集是判断某人的实际技能的最好的方法。好消息是构建这样的作品集完全要看你自己。只要你在这方面付出了努力,你一定可以取得让这些公司钦佩的作品集。
构建高质量的作品集的第一步就是知道需要什么技能。公司想要在数据科学方面拥有的、他们希望你能够运用的主要技能有:
- 沟通能力
- 协作能力
- 技术能力
- 数据推理能力
- 动机和主动性
任何好的作品集都由多个项目表现出来,其中每个都能够表现出以上一到两点。这是本系列的第三篇,本系列我们主要讲包括如何打造面面俱到的数据科学作品集。在这一篇中,我们主要涵盖了如何构建组成你的作品集的第二个项目,以及如何创建一个端对端的机器学习项目。在最后,我们将拥有一个展示你的数据推理能力和技术能力的项目。如果你想看一下的话,这里有一个完整的例子。
一个端到端的项目
作为一个数据科学家,有时候你会拿到一个数据集并被问如何用它来讲故事。在这个时候,沟通就是非常重要的,你需要用它来完成这个事情。像我们在前一篇文章中用过的,类似 Jupyter notebook 这样的工具,将对你非常有帮助。在这里你能找到一些可以用的报告或者总结文档。
不管怎样,有时候你会被要求创建一个具有操作价值的项目。具有操作价值的项目将直接影响到公司的日常业务,它会使用不止一次,经常是许多人使用。这个任务可能像这样 “创建一个算法来预测周转率”或者“创建一个模型来自动对我们的文章打标签”。在这种情况下,技术能力比讲故事更重要。你必须能够得到一个数据集,并且理解它,然后创建脚本处理该数据。这个脚本要运行的很快,占用系统资源很小。通常它可能要运行很多次,脚本的可使用性也很重要,并不仅仅是一个演示版。可使用性是指整合进操作流程,并且甚至是是面向用户的。
端对端项目的主要组成部分:
- 理解背景
- 浏览数据并找出细微差别
- 创建结构化项目,那样比较容易整合进操作流程
- 运行速度快、占用系统资源小的高性能代码
- 写好安装和使用文档以便其他人用
为了有效的创建这种类型的项目,我们可能需要处理多个文件。强烈推荐使用 Atom 这样的文本编辑器或者 PyCharm 这样的 IDE。这些工具允许你在文件间跳转,编辑不同类型的文件,例如 markdown 文件,Python 文件,和 csv 文件等等。结构化你的项目还利于版本控制,并上传一个类似 Github 这样的协作开发工具上也很有用。
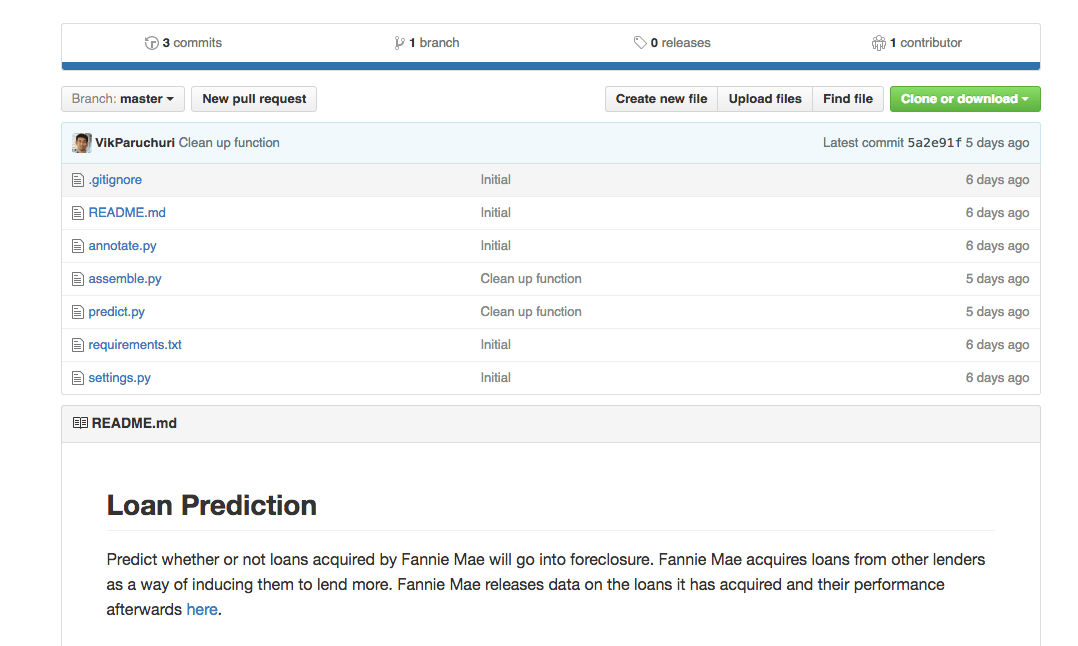
Github 上的这个项目
在这一节中我们将使用 Pandas 和 scikit-learn 这样的库,我们还将大量用到 Pandas DataFrames,它使得 python 读取和处理表格数据更加方便。
找到好的数据集
为一个端到端的作品集项目的找到好的数据集很难。在内存和性能的限制下,数据集需要尽量的大。它还需要是实际有用的。例如,这个数据集,它包含有美国院校的录取标准、毕业率以及毕业以后的收入,是个很好的可以讲故事的数据集。但是,不管你如何看待这个数据,很显然它不适合创建端到端的项目。比如,你能告诉人们他们去了这些大学以后的未来收入,但是这个快速检索却并不足够呈现出你的技术能力。你还能找出院校的招生标准和更高的收入相关,但是这更像是常理而不是你的技术结论。
这里还有内存和性能约束的问题,比如你有几千兆的数据,而且当你需要找到一些差异时,就需要对数据集一遍遍运行算法。
一个好的可操作的数据集可以让你构建一系列脚本来转换数据、动态地回答问题。一个很好的例子是股票价格数据集,当股市关闭时,就会给算法提供新的数据。这可以让你预测明天的股价,甚至预测收益。这不是讲故事,它带来的是真金白银。
一些找到数据集的好地方:
- /r/datasets – 有上百的有趣数据的 subreddit(Reddit 是国外一个社交新闻站点,subreddit 指该论坛下的各不同版块)。
- Google Public Datasets – 通过 Google BigQuery 使用的公开数据集。
- Awesome datasets – 一个数据集列表,放在 Github 上。
当你查看这些数据集时,想一下人们想要在这些数据集中得到什么答案,哪怕这些问题只想过一次(“房价是如何与标准普尔 500 指数关联的?”),或者更进一步(“你能预测股市吗?”)。这里的关键是更进一步地找出问题,并且用相同的代码在不同输入(不同的数据)上运行多次。
对于本文的目标,我们来看一下 房利美 贷款数据。房利美是一家在美国的政府赞助的企业抵押贷款公司,它从其他银行购买按揭贷款,然后捆绑这些贷款为贷款证券来转卖它们。这使得贷款机构可以提供更多的抵押贷款,在市场上创造更多的流动性。这在理论上会带来更多的住房和更好的贷款期限。从借款人的角度来说,它们大体上差不多,话虽这样说。
房利美发布了两种类型的数据 – 它获得的贷款的数据,和贷款偿还情况的数据。在理想的情况下,有人向贷款人借钱,然后还款直到还清。不管怎样,有些人多次不还,从而丧失了抵押品赎回权。抵押品赎回权是指没钱还了被银行把房子给收走了。房利美会追踪谁没还钱,并且哪个贷款需要收回抵押的房屋(取消赎回权)。每个季度会发布此数据,发布的是滞后一年的数据。当前可用是 2015 年第一季度数据。
“贷款数据”是由房利美发布的贷款发放的数据,它包含借款人的信息、信用评分,和他们的家庭贷款信息。“执行数据”,贷款发放后的每一个季度公布,包含借贷人的还款信息和是否丧失抵押品赎回权的状态,一个“贷款数据”的“执行数据”可能有十几行。可以这样理解,“贷款数据”告诉你房利美所控制的贷款,“执行数据”包含该贷款一系列的状态更新。其中一个状态更新可以告诉我们一笔贷款在某个季度被取消赎回权了。
一个没有及时还贷的房子就这样的被卖了
选择一个角度
这里有几个我们可以去分析房利美数据集的方向。我们可以:
- 预测房屋的销售价格。
- 预测借款人还款历史。
- 在获得贷款时为每一笔贷款打分。
最重要的事情是坚持单一的角度。同时关注太多的事情很难做出效果。选择一个有着足够细节的角度也很重要。下面的角度就没有太多细节:
- 找出哪些银行将贷款出售给房利美的多数被取消赎回权。
- 计算贷款人的信用评分趋势。
- 找到哪些类型的家庭没有偿还贷款的能力。
- 找到贷款金额和抵押品价格之间的关系。
上面的想法非常有趣,如果我们关注于讲故事,那是一个不错的角度,但是不是很适合一个操作性项目。
在房利美数据集中,我们将仅使用申请贷款时有的那些信息来预测贷款是否将来会被取消赎回权。实际上, 我们将为每一笔贷款建立“分数”来告诉房利美买还是不买。这将给我们打下良好的基础,并将组成这个漂亮的作品集的一部分。
理解数据
我们来简单看一下原始数据文件。下面是 2012 年 1 季度前几行的贷款数据:
100000853384|R|OTHER|4.625|280000|360|02/2012|04/2012|31|31|1|23|801|N|C|SF|1|I|CA|945||FRM|
100003735682|R|SUNTRUST MORTGAGE INC.|3.99|466000|360|01/2012|03/2012|80|80|2|30|794|N|P|SF|1|P|MD|208||FRM|788
100006367485|C|PHH MORTGAGE CORPORATION|4|229000|360|02/2012|04/2012|67|67|2|36|802|N|R|SF|1|P|CA|959||FRM|794
下面是 2012 年 1 季度的前几行执行数据:
100000853384|03/01/2012|OTHER|4.625||0|360|359|03/2042|41860|0|N||||||||||||||||
100000853384|04/01/2012||4.625||1|359|358|03/2042|41860|0|N||||||||||||||||
100000853384|05/01/2012||4.625||2|358|357|03/2042|41860|0|N||||||||||||||||
在开始编码之前,花些时间真正理解数据是值得的。这对于操作性项目优为重要,因为我们没有交互式探索数据,将很难察觉到细微的差别,除非我们在前期发现他们。在这种情况下,第一个步骤是阅读房利美站点的资料:
在看完这些文件后后,我们了解到一些能帮助我们的关键点:
- 从 2000 年到现在,每季度都有一个贷款和执行文件,因数据是滞后一年的,所以到目前为止最新数据是 2015 年的。
- 这些文件是文本格式的,采用管道符号
|进行分割。 - 这些文件是没有表头的,但我们有个文件列明了各列的名称。
- 所有一起,文件包含 2200 万个贷款的数据。
- 由于执行数据的文件包含过去几年获得的贷款的信息,在早些年获得的贷款将有更多的执行数据(即在 2014 获得的贷款没有多少历史执行数据)。
这些小小的信息将会为我们节省很多时间,因为这样我们就知道如何构造我们的项目和利用这些数据了。
构造项目
在我们开始下载和探索数据之前,先想一想将如何构造项目是很重要的。当建立端到端项目时,我们的主要目标是:
- 创建一个可行解决方案
- 有一个快速运行且占用最小资源的解决方案
- 容易可扩展
- 写容易理解的代码
- 写尽量少的代码
为了实现这些目标,需要对我们的项目进行良好的构造。一个结构良好的项目遵循几个原则:
- 分离数据文件和代码文件
- 从原始数据中分离生成的数据。
- 有一个
README.md文件帮助人们安装和使用该项目。 - 有一个
requirements.txt文件列明项目运行所需的所有包。 有一个单独的
settings.py文件列明其它文件中使用的所有的设置- 例如,如果从多个
Python脚本读取同一个文件,让它们全部import设置并从一个集中的地方获得文件名是有用的。
- 例如,如果从多个
- 有一个
.gitignore文件,防止大的或密码文件被提交。 分解任务中每一步可以单独执行的步骤到单独的文件中。
- 例如,我们将有一个文件用于读取数据,一个用于创建特征,一个用于做出预测。
保存中间结果,例如,一个脚本可以输出下一个脚本可读取的文件。
- 这使我们无需重新计算就可以在数据处理流程中进行更改。
我们的文件结构大体如下:
loan-prediction
├── data
├── processed
├── .gitignore
├── README.md
├── requirements.txt
├── settings.py
创建初始文件
首先,我们需要创建一个 loan-prediction 文件夹,在此文件夹下面,再创建一个 data 文件夹和一个 processed 文件夹。data 文件夹存放原始数据,processed 文件夹存放所有的中间计算结果。
其次,创建 .gitignore 文件,.gitignore 文件将保证某些文件被 git 忽略而不会被推送至 GitHub。关于这个文件的一个好的例子是由 OSX 在每一个文件夹都会创建的 .DS_Store 文件,.gitignore 文件一个很好的范本在这里。我们还想忽略数据文件,因为它们实在是太大了,同时房利美的条文禁止我们重新分发该数据文件,所以我们应该在我们的文件后面添加以下 2 行:
data
processed
这里是该项目的一个关于 .gitignore 文件的例子。
再次,我们需要创建 README.md 文件,它将帮助人们理解该项目。后缀 .md 表示这个文件采用 markdown 格式。Markdown 使你能够写纯文本文件,同时还可以添加你想要的神奇的格式。这里是关于 markdown 的导引。如果你上传一个叫 README.md 的文件至 Github,Github 会自动处理该 markdown,同时展示给浏览该项目的人。例子在这里。
至此,我们仅需在 README.md 文件中添加简单的描述:
Loan Prediction
-----------------------

Predict whether or not loans acquired by Fannie Mae will go into foreclosure.  Fannie Mae acquires loans from other lenders as a way of inducing them to lend more.  Fannie Mae releases data on the loans it has acquired and their performance afterwards [here](http://www.fanniemae.com/portal/funding-the-market/data/loan-performance-data.html).
现在,我们可以创建 requirements.txt 文件了。这会帮助其它人可以很方便地安装我们的项目。我们还不知道我们将会具体用到哪些库,但是以下几个库是需要的:
pandas
matplotlib
scikit-learn
numpy
ipython
scipy
以上几个是在 python 数据分析任务中最常用到的库。可以认为我们将会用到大部分这些库。这里是该项目 requirements.txt 文件的一个例子。
创建 requirements.txt 文件之后,你应该安装这些包了。我们将会使用 python3。如果你没有安装 python,你应该考虑使用 Anaconda,它是一个 python 安装程序,同时安装了上面列出的所有包。
最后,我们可以建立一个空白的 settings.py 文件,因为我们的项目还没有任何设置。
获取数据
一旦我们有了项目的基本架构,我们就可以去获得原始数据。
房利美对获取数据有一些限制,所以你需要去注册一个账户。在创建完账户之后,你可以找到在这里的下载页面,你可以按照你所需要的下载或多或少的贷款数据文件。文件格式是 zip,在解压后当然是非常大的。
为了达到我们这个文章的目的,我们将要下载从 2012 年 1 季度到 2015 年 1 季度的所有数据。接着我们需要解压所有的文件。解压过后,删掉原来的 .zip 格式的文件。最后,loan-prediction 文件夹看起来应该像下面的一样:
loan-prediction
├── data
│   ├── Acquisition_2012Q1.txt
│   ├── Acquisition_2012Q2.txt
│   ├── Performance_2012Q1.txt
│   ├── Performance_2012Q2.txt
│   └── ...
├── processed
├── .gitignore
├── README.md
├── requirements.txt
├── settings.py
在下载完数据后,你可以在 shell 命令行中使用 head 和 tail 命令去查看文件中的行数据,你看到任何的不需要的数据列了吗?在做这件事的同时查阅列名称的 pdf 文件可能有帮助。
读入数据
有两个问题让我们的数据难以现在就使用:
- 贷款数据和执行数据被分割在多个文件中
- 每个文件都缺少列名标题
在我们开始使用数据之前,我们需要首先明白我们要在哪里去存一个贷款数据的文件,同时到哪里去存储一个执行数据的文件。每个文件仅仅需要包括我们关注的那些数据列,同时拥有正确的列名标题。这里有一个小问题是执行数据非常大,因此我们需要尝试去修剪一些数据列。
第一步是向 settings.py 文件中增加一些变量,这个文件中同时也包括了我们原始数据的存放路径和处理出的数据存放路径。我们同时也将添加其他一些可能在接下来会用到的设置数据:
DATA_DIR = "data"
PROCESSED_DIR = "processed"
MINIMUM_TRACKING_QUARTERS = 4
TARGET = "foreclosure_status"
NON_PREDICTORS = [TARGET, "id"]
CV_FOLDS = 3
把路径设置在 settings.py 中使它们放在一个集中的地方,同时使其修改更加的容易。当在多个文件中用到相同的变量时,你想改变它的话,把他们放在一个地方比分散放在每一个文件时更加容易。这里的是一个这个工程的示例 settings.py 文件
第二步是创建一个文件名为 assemble.py,它将所有的数据分为 2 个文件。当我们运行 Python assemble.py,我们在处理数据文件的目录会获得 2 个数据文件。
接下来我们开始写 assemble.py 文件中的代码。首先我们需要为每个文件定义相应的列名标题,因此我们需要查看列名称的 pdf 文件,同时创建在每一个贷款数据和执行数据的文件的数据列的列表:
HEADERS = {
    "Acquisition": [
        "id",
        "channel",
        "seller",
        "interest_rate",
        "balance",
        "loan_term",
        "origination_date",
        "first_payment_date",
        "ltv",
        "cltv",
        "borrower_count",
        "dti",
        "borrower_credit_score",
        "first_time_homebuyer",
        "loan_purpose",
        "property_type",
        "unit_count",
        "occupancy_status",
        "property_state",
        "zip",
        "insurance_percentage",
        "product_type",
        "co_borrower_credit_score"
    ],
    "Performance": [
        "id",
        "reporting_period",
        "servicer_name",
        "interest_rate",
        "balance",
        "loan_age",
        "months_to_maturity",
        "maturity_date",
        "msa",
        "delinquency_status",
        "modification_flag",
        "zero_balance_code",
        "zero_balance_date",
        "last_paid_installment_date",
        "foreclosure_date",
        "disposition_date",
        "foreclosure_costs",
        "property_repair_costs",
        "recovery_costs",
        "misc_costs",
        "tax_costs",
        "sale_proceeds",
        "credit_enhancement_proceeds",
        "repurchase_proceeds",
        "other_foreclosure_proceeds",
        "non_interest_bearing_balance",
        "principal_forgiveness_balance"
    ]
}
接下来一步是定义我们想要保留的数据列。因为我们要预测一个贷款是否会被撤回,我们可以丢弃执行数据中的许多列。我们将需要保留贷款数据中的所有数据列,因为我们需要尽量多的了解贷款发放时的信息(毕竟我们是在预测贷款发放时这笔贷款将来是否会被撤回)。丢弃数据列将会使我们节省下内存和硬盘空间,同时也会加速我们的代码。
SELECT = {
    "Acquisition": HEADERS["Acquisition"],
    "Performance": [
        "id",
        "foreclosure_date"
    ]
}
下一步,我们将编写一个函数来连接数据集。下面的代码将:
- 引用一些需要的库,包括
settings。 定义一个函数
concatenate,目的是:- 把所有的 DataFrame 共同连接在一起。
- 把已经连接好的 DataFrame 写回一个文件。
import os
import settings
import pandas as pd

def concatenate(prefix="Acquisition"):
    files = os.listdir(settings.DATA_DIR)
    full = []
    for f in files:
        if not f.startswith(prefix):
            continue

        data = pd.read_csv(os.path.join(settings.DATA_DIR, f), sep="|", header=None, names=HEADERS[prefix], index_col=False)
        data = data[SELECT[prefix]]
        full.append(data)

    full = pd.concat(full, axis=0)

    full.to_csv(os.path.join(settings.PROCESSED_DIR, "{}.txt".format(prefix)), sep="|", header=SELECT[prefix], index=False)
我们可以通过调用上面的函数,通过传递的参数 Acquisition 和 Performance 两次以将所有的贷款和执行文件连接在一起。下面的代码将:
- 仅在命令行中运行
python assemble.py时执行。 将所有的数据连接在一起,并且产生 2 个文件:
processed/Acquisition.txtprocessed/Performance.txt
if __name__ == "__main__":
    concatenate("Acquisition")
    concatenate("Performance")
我们现在拥有了一个漂亮的,划分过的 assemble.py 文件,它很容易执行,也容易建立。通过像这样把问题分解为一块一块的,我们构建工程就会变的容易许多。不用一个可以做所有工作的凌乱脚本,我们定义的数据将会在多个脚本间传递,同时使脚本间完全的彼此隔离。当你正在一个大的项目中工作时,这样做是一个好的想法,因为这样可以更加容易修改其中的某一部分而不会引起其他项目中不关联部分产生预料之外的结果。
一旦我们完成 assemble.py 脚本文件,我们可以运行 python assemble.py 命令。你可以在这里查看完整的 assemble.py 文件。
这将会在 processed 目录下产生 2 个文件:
loan-prediction
├── data
│   ├── Acquisition_2012Q1.txt
│   ├── Acquisition_2012Q2.txt
│   ├── Performance_2012Q1.txt
│   ├── Performance_2012Q2.txt
│   └── ...
├── processed
│   ├── Acquisition.txt
│   ├── Performance.txt
├── .gitignore
├── assemble.py
├── README.md
├── requirements.txt
├── settings.py
计算来自执行数据的值
接下来我们会计算来自 processed/Performance.txt 中的值。我们要做的就是推测这些资产是否被取消赎回权。如果能够计算出来,我们只要看一下关联到贷款的执行数据的参数 foreclosure_date 就可以了。如果这个参数的值是 None,那么这些资产肯定没有收回。为了避免我们的样例中只有少量的执行数据,我们会为每个贷款计算出执行数据文件中的行数。这样我们就能够从我们的训练数据中筛选出贷款数据,排除了一些执行数据。
下面是我认为贷款数据和执行数据的关系:
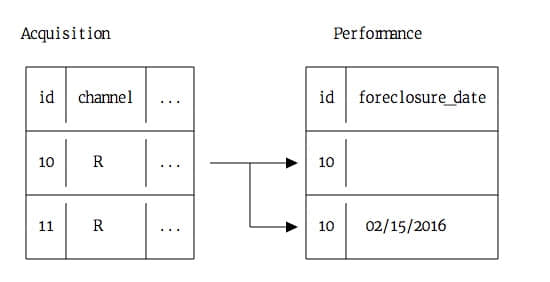
在上面的表格中,贷款数据中的每一行数据都关联到执行数据中的多行数据。在执行数据中,在取消赎回权的时候 foreclosure_date 就会出现在该季度,而之前它是空的。一些贷款还没有被取消赎回权,所以与执行数据中的贷款数据有关的行在 foreclosure_date 列都是空格。
我们需要计算 foreclosure_status 的值,它的值是布尔类型,可以表示一个特殊的贷款数据 id 是否被取消赎回权过,还有一个参数 performance_count ,它记录了执行数据中每个贷款 id 出现的行数。
计算这些行数有多种不同的方法:
我们能够读取所有的执行数据,然后我们用 Pandas 的 groupby 方法在 DataFrame 中计算出与每个贷款
id有关的行的行数,然后就可以查看贷款id的foreclosure_date值是否为None。- 这种方法的优点是从语法上来说容易执行。
- 它的缺点需要读取所有的 129236094 行数据,这样就会占用大量内存,并且运行起来极慢。
我们可以读取所有的执行数据,然后在贷款 DataFrame 上使用 apply 去计算每个贷款
id出现的次数。- 这种方法的优点是容易理解。
- 缺点是需要读取所有的 129236094 行数据。这样会占用大量内存,并且运行起来极慢。
我们可以在迭代访问执行数据中的每一行数据,而且会建立一个单独的计数字典。
- 这种方法的优点是数据不需要被加载到内存中,所以运行起来会很快且不需要占用内存。
- 缺点是这样的话理解和执行上可能有点耗费时间,我们需要对每一行数据进行语法分析。
加载所有的数据会非常耗费内存,所以我们采用第三种方法。我们要做的就是迭代执行数据中的每一行数据,然后为每一个贷款 id 在字典中保留一个计数。在这个字典中,我们会计算出贷款 id 在执行数据中出现的次数,而且看看 foreclosure_date 是否是 None 。我们可以查看 foreclosure_status 和 performance_count 的值 。
我们会新建一个 annotate.py 文件,文件中的代码可以计算这些值。我们会使用下面的代码:
- 导入需要的库
定义一个函数
count_performance_rows。- 打开
processed/Performance.txt文件。这不是在内存中读取文件而是打开了一个文件标识符,这个标识符可以用来以行为单位读取文件。 - 迭代文件的每一行数据。
- 使用分隔符
|分开每行的不同数据。 检查
loan_id是否在计数字典中。- 如果不存在,把它加进去。
loan_id的performance_count参数自增 1 次,因为我们这次迭代也包含其中。- 如果
date不是None ,我们就会知道贷款被取消赎回权了,然后为foreclosure\_status` 设置合适的值。
- 打开
import os
import settings
import pandas as pd

def count_performance_rows():
    counts = {}
    with open(os.path.join(settings.PROCESSED_DIR, "Performance.txt"), 'r') as f:
        for i, line in enumerate(f):
            if i == 0:
                # Skip header row
                continue
            loan_id, date = line.split("|")
            loan_id = int(loan_id)
            if loan_id not in counts:
                counts[loan_id] = {
                    "foreclosure_status": False,
                    "performance_count": 0
                }
            counts[loan_id]["performance_count"] += 1
            if len(date.strip()) > 0:
                counts[loan_id]["foreclosure_status"] = True
    return counts
获取值
只要我们创建了计数字典,我们就可以使用一个函数通过一个 loan_id 和一个 key 从字典中提取到需要的参数的值:
def get_performance_summary_value(loan_id, key, counts):
    value = counts.get(loan_id, {
        "foreclosure_status": False,
        "performance_count": 0
    })
    return value[key]
上面的函数会从 counts 字典中返回合适的值,我们也能够为贷款数据中的每一行赋一个 foreclosure_status 值和一个 performance_count 值。如果键不存在,字典的 get 方法会返回一个默认值,所以在字典中不存在键的时候我们就可以得到一个可知的默认值。
转换数据
我们已经在 annotate.py 中添加了一些功能,现在我们来看一看数据文件。我们需要将贷款到的数据转换到训练数据集来进行机器学习算法的训练。这涉及到以下几件事情:
- 转换所有列为数字。
- 填充缺失值。
- 为每一行分配
performance_count和foreclosure_status。 - 移除出现执行数据很少的行(
performance_count计数低)。
我们有几个列是文本类型的,看起来对于机器学习算法来说并不是很有用。然而,它们实际上是分类变量,其中有很多不同的类别代码,例如 R,S 等等. 我们可以把这些类别标签转换为数值:
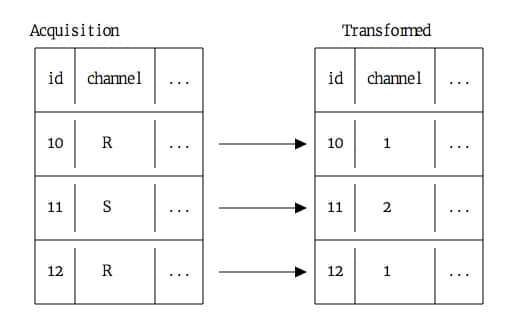
通过这种方法转换的列我们可以应用到机器学习算法中。
还有一些包含日期的列 (first_payment_date 和 origination_date)。我们可以将这些日期放到两个列中:
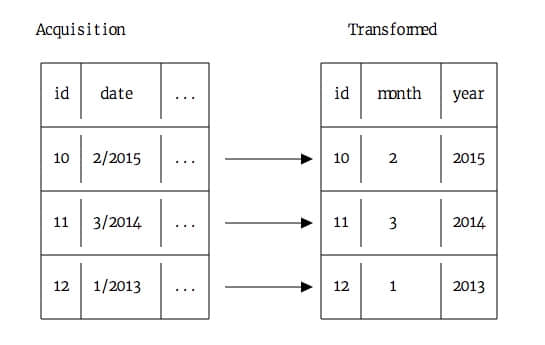
在下面的代码中,我们将转换贷款数据。我们将定义一个函数如下:
- 在
acquisition中创建foreclosure_status列,并从counts字典中得到值。 - 在
acquisition中创建performance_count列,并从counts字典中得到值。 将下面的列从字符串转换为整数:
channelsellerfirst_time_homebuyerloan_purposeproperty_typeoccupancy_statusproperty_stateproduct_type
将
first_payment_date和origination_date分别转换为两列:- 通过斜杠分离列。
- 将第一部分分离成
month列。 - 将第二部分分离成
year列。 - 删除该列。
- 最后,我们得到
first_payment_month、first_payment_year、rigination_month和origination_year。
- 所有缺失值填充为
-1。
def annotate(acquisition, counts):
    acquisition["foreclosure_status"] = acquisition["id"].apply(lambda x: get_performance_summary_value(x, "foreclosure_status", counts))
    acquisition["performance_count"] = acquisition["id"].apply(lambda x: get_performance_summary_value(x, "performance_count", counts))
    for column in [
        "channel",
        "seller",
        "first_time_homebuyer",
        "loan_purpose",
        "property_type",
        "occupancy_status",
        "property_state",
        "product_type"
    ]:
        acquisition[column] = acquisition[column].astype('category').cat.codes

    for start in ["first_payment", "origination"]:
        column = "{}_date".format(start)
        acquisition["{}_year".format(start)] = pd.to_numeric(acquisition[column].str.split('/').str.get(1))
        acquisition["{}_month".format(start)] = pd.to_numeric(acquisition[column].str.split('/').str.get(0))
        del acquisition[column]

    acquisition = acquisition.fillna(-1)
    acquisition = acquisition[acquisition["performance_count"] > settings.MINIMUM_TRACKING_QUARTERS]
    return acquisition
聚合到一起
我们差不多准备就绪了,我们只需要再在 annotate.py 添加一点点代码。在下面代码中,我们将:
- 定义一个函数来读取贷款的数据。
- 定义一个函数来写入处理过的数据到
processed/train.csv。 如果该文件在命令行以
python annotate.py的方式运行:- 读取贷款数据。
- 计算执行数据的计数,并将其赋予
counts。 - 转换
acquisitionDataFrame。 - 将
acquisitionDataFrame 写入到train.csv。
def read():
    acquisition = pd.read_csv(os.path.join(settings.PROCESSED_DIR, "Acquisition.txt"), sep="|")
    return acquisition

def write(acquisition):
    acquisition.to_csv(os.path.join(settings.PROCESSED_DIR, "train.csv"), index=False)

if __name__ == "__main__":
    acquisition = read()
    counts = count_performance_rows()
    acquisition = annotate(acquisition, counts)
    write(acquisition)
修改完成以后,确保运行 python annotate.py 来生成 train.csv 文件。 你可以在这里找到完整的 annotate.py 文件。
现在文件夹看起来应该像这样:
loan-prediction
├── data
│   ├── Acquisition_2012Q1.txt
│   ├── Acquisition_2012Q2.txt
│   ├── Performance_2012Q1.txt
│   ├── Performance_2012Q2.txt
│   └── ...
├── processed
│   ├── Acquisition.txt
│   ├── Performance.txt
│   ├── train.csv
├── .gitignore
├── annotate.py
├── assemble.py
├── README.md
├── requirements.txt
├── settings.py
找到误差标准
我们已经完成了训练数据表的生成,现在我们需要最后一步,生成预测。我们需要找到误差的标准,以及该如何评估我们的数据。在这种情况下,因为有很多的贷款没有被取消赎回权,所以根本不可能做到精确的计算。
我们需要读取训练数据,并且计算 foreclosure_status 列的计数,我们将得到如下信息:
import pandas as pd
import settings

train = pd.read_csv(os.path.join(settings.PROCESSED_DIR, "train.csv"))
train["foreclosure_status"].value_counts()
False    4635982
True        1585
Name: foreclosure_status, dtype: int64
因为只有很少的贷款被取消赎回权,只需要检查正确预测的标签的百分比就意味着我们可以创建一个机器学习模型,来为每一行预测 False,并能取得很高的精确度。相反,我们想要使用一个度量来考虑分类的不平衡,确保我们可以准确预测。我们要避免太多的误报率(预测贷款被取消赎回权,但是实际没有),也要避免太多的漏报率(预测贷款没有别取消赎回权,但是实际被取消了)。对于这两个来说,漏报率对于房利美来说成本更高,因为他们买的贷款可能是他们无法收回投资的贷款。
所以我们将定义一个漏报率,就是模型预测没有取消赎回权但是实际上取消了,这个数除以总的取消赎回权数。这是“缺失的”实际取消赎回权百分比的模型。下面看这个图表:
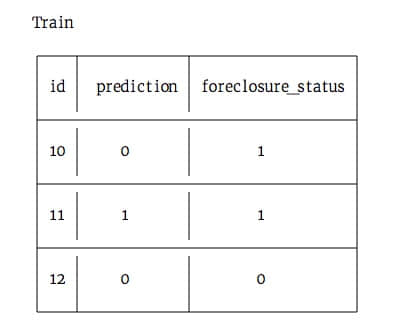
通过上面的图表,有 1 个贷款预测不会取消赎回权,但是实际上取消了。如果我们将这个数除以实际取消赎回权的总数 2,我们将得到漏报率 50%。 我们将使用这个误差标准,因此我们可以评估一下模型的行为。
设置机器学习分类器
我们使用交叉验证预测。通过交叉验证法,我们将数据分为3组。按照下面的方法来做:
- 用组 1 和组 2 训练模型,然后用该模型来预测组 3
- 用组 1 和组 3 训练模型,然后用该模型来预测组 2
- 用组 2 和组 3 训练模型,然后用该模型来预测组 1
将它们分割到不同的组,这意味着我们永远不会用相同的数据来为其预测训练模型。这样就避免了过拟合。如果过拟合,我们将错误地拉低了漏报率,这使得我们难以改进算法或者应用到现实生活中。
Scikit-learn 有一个叫做 crossvalpredict ,它可以帮助我们理解交叉算法.
我们还需要一种算法来帮我们预测。我们还需要一个分类器来做二元分类。目标变量 foreclosure_status 只有两个值, True 和 False。
这里我们用 逻辑回归算法,因为它能很好的进行二元分类,并且运行很快,占用内存很小。我们来说一下它是如何工作的:不使用像随机森林一样多树结构,也不像支持向量机一样做复杂的转换,逻辑回归算法涉及更少的步骤和更少的矩阵。
我们可以使用 scikit-learn 实现的逻辑回归分类器算法。我们唯一需要注意的是每个类的权重。如果我们使用等权重的类,算法将会预测每行都为 false,因为它总是试图最小化误差。不管怎样,我们重视有多少贷款要被取消赎回权而不是有多少不能被取消。因此,我们给逻辑回归类的 class_weight 关键字传递 balanced 参数,让算法可以为不同 counts 的每个类考虑不同的取消赎回权的权重。这将使我们的算法不会为每一行都预测 false,而是两个类的误差水平一致。
做出预测
既然完成了前期准备,我们可以开始准备做出预测了。我将创建一个名为 predict.py 的新文件,它会使用我们在最后一步创建的 train.csv 文件。下面的代码:
- 导入所需的库
创建一个名为
cross_validate的函数:- 使用正确的关键词参数创建逻辑回归分类器
- 创建用于训练模型的数据列的列表,移除
id和foreclosure_status列 - 交叉验证
trainDataFrame - 返回预测结果
import os
import settings
import pandas as pd
from sklearn import cross_validation
from sklearn.linear_model import LogisticRegression
from sklearn import metrics

def cross_validate(train):
    clf = LogisticRegression(random_state=1, class_weight="balanced")

    predictors = train.columns.tolist()
    predictors = [p for p in predictors if p not in settings.NON_PREDICTORS]

    predictions = cross_validation.cross_val_predict(clf, train[predictors], train[settings.TARGET], cv=settings.CV_FOLDS)
    return predictions
预测误差
现在,我们仅仅需要写一些函数来计算误差。下面的代码:
创建函数
compute_error:- 使用 scikit-learn 计算一个简单的精确分数(与实际
foreclosure_status值匹配的预测百分比)
- 使用 scikit-learn 计算一个简单的精确分数(与实际
创建函数
compute_false_negatives:- 为了方便,将目标和预测结果合并到一个 DataFrame
查找漏报率
- 找到原本应被预测模型取消赎回权,但实际没有取消的贷款数目
- 除以没被取消赎回权的贷款总数目
def compute_error(target, predictions):
    return metrics.accuracy_score(target, predictions)

def compute_false_negatives(target, predictions):
    df = pd.DataFrame({"target": target, "predictions": predictions})
    return df[(df["target"] == 1) & (df["predictions"] == 0)].shape[0] / (df[(df["target"] == 1)].shape[0] + 1)

def compute_false_positives(target, predictions):
    df = pd.DataFrame({"target": target, "predictions": predictions})
    return df[(df["target"] == 0) & (df["predictions"] == 1)].shape[0] / (df[(df["target"] == 0)].shape[0] + 1)
聚合到一起
现在,我们可以把函数都放在 predict.py。下面的代码:
- 读取数据集
- 计算交叉验证预测
- 计算上面的 3 个误差
- 打印误差
def read():
    train = pd.read_csv(os.path.join(settings.PROCESSED_DIR, "train.csv"))
    return train

if __name__ == "__main__":
    train = read()
    predictions = cross_validate(train)
    error = compute_error(train[settings.TARGET], predictions)
    fn = compute_false_negatives(train[settings.TARGET], predictions)
    fp = compute_false_positives(train[settings.TARGET], predictions)
    print("Accuracy Score: {}".format(error))
    print("False Negatives: {}".format(fn))
    print("False Positives: {}".format(fp))
一旦你添加完代码,你可以运行 python predict.py 来产生预测结果。运行结果向我们展示漏报率为 .26,这意味着我们没能预测 26% 的取消贷款。这是一个好的开始,但仍有很多改善的地方!
你可以在这里找到完整的 predict.py 文件。
你的文件树现在看起来像下面这样:
loan-prediction
├── data
│   ├── Acquisition_2012Q1.txt
│   ├── Acquisition_2012Q2.txt
│   ├── Performance_2012Q1.txt
│   ├── Performance_2012Q2.txt
│   └── ...
├── processed
│   ├── Acquisition.txt
│   ├── Performance.txt
│   ├── train.csv
├── .gitignore
├── annotate.py
├── assemble.py
├── predict.py
├── README.md
├── requirements.txt
├── settings.py
撰写 README
既然我们完成了端到端的项目,那么我们可以撰写 README.md 文件了,这样其他人便可以知道我们做的事,以及如何复制它。一个项目典型的 README.md 应该包括这些部分:
- 一个高水准的项目概览,并介绍项目目的
- 任何必需的数据和材料的下载地址
安装命令
- 如何安装要求依赖
使用命令
- 如何运行项目
- 每一步之后会看到的结果
如何为这个项目作贡献
- 扩展项目的下一步计划
这里 是这个项目的一个 README.md 样例。
下一步
恭喜你完成了端到端的机器学习项目!你可以在这里找到一个完整的示例项目。一旦你完成了项目,把它上传到 Github 是一个不错的主意,这样其他人也可以看到你的文件夹的部分项目。
这里仍有一些留待探索数据的角度。总的来说,我们可以把它们分割为 3 类: 扩展这个项目并使它更加精确,发现其他可以预测的列,并探索数据。这是其中一些想法:
- 在
annotate.py中生成更多的特性 - 切换
predict.py中的算法 - 尝试使用比我们发表在这里的更多的房利美数据
- 添加对未来数据进行预测的方法。如果我们添加更多数据,我们所写的代码仍然可以起作用,这样我们可以添加更多过去和未来的数据。
尝试看看是否你能预测一个银行原本是否应该发放贷款(相对地,房利美是否应该获得贷款)
移除
train中银行在发放贷款时间的不知道的任何列- 当房利美购买贷款时,一些列是已知的,但之前是不知道的
- 做出预测
探索是否你可以预测除了
foreclosure_status的其他列- 你可以预测在销售时资产值是多少?
探索探索执行数据更新之间的细微差别
- 你能否预测借款人会逾期还款多少次?
- 你能否标出的典型贷款周期?
将数据按州或邮政编码标出
- 你看到一些有趣的模式了吗?
如果你建立了任何有趣的东西,请在评论中让我们知道!
如果你喜欢这篇文章,或许你也会喜欢阅读“构建你的数据科学作品集”系列的其他文章:
via: https://www.dataquest.io/blog/data-science-portfolio-machine-learning/
作者:Vik Paruchuri 译者:kokialoves, zky001, vim-kakali, cposture, ideas4u 校对:wxy