分类 技术 下的文章

在 Jupyter 里使用 Python 来分析日历,以了解你是如何使用时间的。
 title=

Python 在探索数据方面具有令人难以置信的可扩展性。利用 Pandas 或 Dask,你可以将 Jupyter 扩展到大数据领域。但是小数据、个人资料、私人数据呢?

JupyterLab 和 Jupyter Notebook 为我提供了一个绝佳的环境,可以让我审视我的笔记本电脑生活。

我的探索是基于以下事实:我使用的几乎每个服务都有一个 Web API。我使用了诸多此类服务:待办事项列表、时间跟踪器、习惯跟踪器等。还有一个几乎每个人都会使用到:日历。相同的思路也可以应用于其他服务,但是日历具有一个很酷的功能:几乎所有 Web 日历都支持的开放标准 —— CalDAV。

在 Jupyter 中使用 Python 解析日历

大多数日历提供了导出为 CalDAV 格式的方法。你可能需要某种身份验证才能访问这些私有数据。按照你的服务说明进行操作即可。如何获得凭据取决于你的服务,但是最终,你应该能够将这些凭据存储在文件中。我将我的凭据存储在根目录下的一个名为 .caldav 的文件中:

import os
with open(os.path.expanduser("~/.caldav")) as fpin:
    username, password = fpin.read().split()

切勿将用户名和密码直接放在 Jupyter Notebook 的笔记本中!它们可能会很容易因 git push 的错误而导致泄漏。

下一步是使用方便的 PyPI caldav 库。我找到了我的电子邮件服务的 CalDAV 服务器(你可能有所不同):

import caldav
client = caldav.DAVClient(url="https://caldav.fastmail.com/dav/", username=username, password=password)

CalDAV 有一个称为 principal(主键)的概念。它是什么并不重要,只要知道它是你用来访问日历的东西就行了:

principal = client.principal()
calendars = principal.calendars()

从字面上讲,日历就是关于时间的。访问事件之前,你需要确定一个时间范围。默认一星期就好:

from dateutil import tz
import datetime
now = datetime.datetime.now(tz.tzutc())
since = now - datetime.timedelta(days=7)

大多数人使用的日历不止一个,并且希望所有事件都在一起出现。itertools.chain.from_iterable 方法使这一过程变得简单:

import itertools

raw_events = list(
    itertools.chain.from_iterable(
        calendar.date_search(start=since, end=now, expand=True)
        for calendar in calendars
    )
)

将所有事件读入内存很重要,以 API 原始的本地格式进行操作是重要的实践。这意味着在调整解析、分析和显示代码时,无需返回到 API 服务刷新数据。

但 “原始” 真的是原始,事件是以特定格式的字符串出现的:

print(raw_events[12].data)
    BEGIN:VCALENDAR
    VERSION:2.0
    PRODID:-//CyrusIMAP.org/Cyrus
     3.3.0-232-g4bdb081-fm-20200825.002-g4bdb081a//EN
    BEGIN:VEVENT
    DTEND:20200825T230000Z
    DTSTAMP:20200825T181915Z
    DTSTART:20200825T220000Z
    SUMMARY:Busy
    UID:
     1302728i-040000008200E00074C5B7101A82E00800000000D939773EA578D601000000000
     000000010000000CD71CC3393651B419E9458134FE840F5
    END:VEVENT
    END:VCALENDAR

幸运的是,PyPI 可以再次使用另一个辅助库 vobject 解围:

import io
import vobject

def parse_event(raw_event):
    data = raw_event.data
    parsed = vobject.readOne(io.StringIO(data))
    contents = parsed.vevent.contents
    return contents
parse_event(raw_events[12])
    {'dtend': [<DTEND{}2020-08-25 23:00:00+00:00>],
     'dtstamp': [<DTSTAMP{}2020-08-25 18:19:15+00:00>],
     'dtstart': [<DTSTART{}2020-08-25 22:00:00+00:00>],
     'summary': [<SUMMARY{}Busy>],
     'uid': [<UID{}1302728i-040000008200E00074C5B7101A82E00800000000D939773EA578D601000000000000000010000000CD71CC3393651B419E9458134FE840F5>]}

好吧,至少好一点了。

仍有一些工作要做,将其转换为合理的 Python 对象。第一步是 拥有 一个合理的 Python 对象。attrs 库提供了一个不错的开始:

import attr
from __future__ import annotations
@attr.s(auto_attribs=True, frozen=True)
class Event:
    start: datetime.datetime
    end: datetime.datetime
    timezone: Any
    summary: str

是时候编写转换代码了!

第一个抽象从解析后的字典中获取值,不需要所有的装饰:

def get_piece(contents, name):
    return contents[name][0].value
get_piece(_, "dtstart")
    datetime.datetime(2020, 8, 25, 22, 0, tzinfo=tzutc())

日历事件总有一个“开始”、有一个“结束”、有一个 “持续时间”。一些谨慎的解析逻辑可以将两者协调为同一个 Python 对象:

def from_calendar_event_and_timezone(event, timezone):
    contents = parse_event(event)
    start = get_piece(contents, "dtstart")
    summary = get_piece(contents, "summary")
    try:
        end = get_piece(contents, "dtend")
    except KeyError:
        end = start + get_piece(contents, "duration")
    return Event(start=start, end=end, summary=summary, timezone=timezone)

将事件放在 本地 时区而不是 UTC 中很有用,因此使用本地时区:

my_timezone = tz.gettz()
from_calendar_event_and_timezone(raw_events[12], my_timezone)
    Event(start=datetime.datetime(2020, 8, 25, 22, 0, tzinfo=tzutc()), end=datetime.datetime(2020, 8, 25, 23, 0, tzinfo=tzutc()), timezone=tzfile('/etc/localtime'), summary='Busy')

既然事件是真实的 Python 对象,那么它们实际上应该具有附加信息。幸运的是,可以将方法添加到类中。

但是要弄清楚哪个事件发生在哪一天不是很直接。你需要在 本地 时区中选择一天:

def day(self):
    offset = self.timezone.utcoffset(self.start)
    fixed = self.start + offset
    return fixed.date()
Event.day = property(day)
print(_.day)
    2020-08-25

事件在内部始终是以“开始”/“结束”的方式表示的,但是持续时间是有用的属性。持续时间也可以添加到现有类中:

def duration(self):
    return self.end - self.start
Event.duration = property(duration)
print(_.duration)
    1:00:00

现在到了将所有事件转换为有用的 Python 对象了:

all_events = [from_calendar_event_and_timezone(raw_event, my_timezone)
              for raw_event in raw_events]

全天事件是一种特例,可能对分析生活没有多大用处。现在,你可以忽略它们:

# ignore all-day events
all_events = [event for event in all_events if not type(event.start) == datetime.date]

事件具有自然顺序 —— 知道哪个事件最先发生可能有助于分析:

all_events.sort(key=lambda ev: ev.start)

现在,事件已排序,可以将它们加载到每天:

import collections
events_by_day = collections.defaultdict(list)
for event in all_events:
    events_by_day[event.day].append(event)

有了这些,你就有了作为 Python 对象的带有日期、持续时间和序列的日历事件。

用 Python 报到你的生活

现在是时候编写报告代码了!带有适当的标题、列表、重要内容以粗体显示等等,有醒目的格式是很意义。

这就是一些 HTML 和 HTML 模板。我喜欢使用 Chameleon:

template_content = """
<html><body>
<div tal:repeat="item items">
<h2 tal:content="item[0]">Day</h2>
<ul>
    <li tal:repeat="event item[1]"><span tal:replace="event">Thing</span></li>
</ul>
</div>
</body></html>"""

Chameleon 的一个很酷的功能是使用它的 html 方法渲染对象。我将以两种方式使用它:

  • 摘要将以粗体显示
  • 对于大多数活动,我都会删除摘要(因为这是我的个人信息)
def __html__(self):
    offset = my_timezone.utcoffset(self.start)
    fixed = self.start + offset
    start_str = str(fixed).split("+")[0]
    summary = self.summary
    if summary != "Busy":
        summary = "&lt;REDACTED&gt;"
    return f"<b>{summary[:30]}</b> -- {start_str} ({self.duration})"
Event.__html__ = __html__

为了简洁起见,将该报告切成每天的:

import chameleon
from IPython.display import HTML
template = chameleon.PageTemplate(template_content)
html = template(items=itertools.islice(events_by_day.items(), 3, 4))
HTML(html)

渲染后,它将看起来像这样:

2020-08-25

  • -- 2020-08-25 08:30:00 (0:45:00)
  • -- 2020-08-25 10:00:00 (1:00:00)
  • -- 2020-08-25 11:30:00 (0:30:00)
  • -- 2020-08-25 13:00:00 (0:25:00)
  • Busy -- 2020-08-25 15:00:00 (1:00:00)
  • -- 2020-08-25 15:00:00 (1:00:00)
  • -- 2020-08-25 19:00:00 (1:00:00)
  • -- 2020-08-25 19:00:12 (1:00:00)

Python 和 Jupyter 的无穷选择

通过解析、分析和报告各种 Web 服务所拥有的数据,这只是你可以做的事情的表面。

为什么不对你最喜欢的服务试试呢?


via: https://opensource.com/article/20/9/calendar-jupyter

作者:Moshe Zadka 选题:lujun9972 译者:stevenzdg988 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

了解如何在 Bash 中编写定制程序以自动执行重复性操作任务。

 title=

Unix 最初的希望之一是,让计算机的日常用户能够微调其计算机,以适应其独特的工作风格。几十年来,人们对计算机定制的期望已经降低,许多用户认为他们的应用程序和网站的集合就是他们的 “定制环境”。原因之一是许多操作系统的组件未不开源,普通用户无法使用其源代码。

但是对于 Linux 用户而言,定制程序是可以实现的,因为整个系统都围绕着可通过终端使用的命令啦进行的。终端不仅是用于快速命令或深入排除故障的界面;也是一个脚本环境,可以通过为你处理日常任务来减少你的工作量。

如何学习编程

如果你以前从未进行过任何编程,可能面临考虑两个不同的挑战:一个是了解怎样编写代码,另一个是了解要编写什么代码。你可以学习 语法,但是如果你不知道 语言 中有哪些可用的关键字,你将无法继续。在实践中,要同时开始学习这两个概念,是因为如果没有关键字的堆砌就无法学习语法,因此,最初你要使用基本命令和基本编程结构来编写简单的任务。一旦熟悉了基础知识,就可以探索更多编程语言的内容,从而使你的程序能够做越来越重要的事情。

在 Bash 中,你使用的大多数 关键字 是 Linux 命令。 语法 就是 Bash。如果你已经频繁地使用过了 Bash,则向 Bash 编程的过渡相对容易。但是,如果你不曾使用过 Bash,你会很高兴地了解到它是一种为清晰和简单而构建的简单语言。

交互设计

有时,学习编程时最难搞清楚的事情就是计算机可以为你做些什么。显然,如果一台计算机可以自己完成你要做的所有操作,那么你就不必再碰计算机了。但是现实是,人类很重要。找到你的计算机可以帮助你的事情的关键是注意到你一周内需要重复执行的任务。计算机特别擅长于重复的任务。

但是,为了能告知计算机为你做某事,你必须知道怎么做。这就是 Bash 擅长的领域:交互式编程。在终端中执行一个动作时,你也在学习如何编写脚本。

例如,我曾经负责将大量 PDF 书籍转换为低墨和友好打印的版本。一种方法是在 PDF 编辑器中打开 PDF,从数百张图像(页面背景和纹理都算作图像)中选择每张图像,删除它们,然后将其保存到新的 PDF中。仅仅是一本书,这样就需要半天时间。

我的第一个想法是学习如何编写 PDF 编辑器脚本,但是经过数天的研究,我找不到可以编写编辑 PDF 应用程序的脚本(除了非常丑陋的鼠标自动化技巧)。因此,我将注意力转向了从终端内找出完成任务的方法。这让我有了几个新发现,包括 GhostScript,它是 PostScript 的开源版本(PDF 基于的打印机语言)。通过使用 GhostScript 处理了几天的任务,我确认这是解决我的问题的方法。

编写基本的脚本来运行命令,只不过是复制我用来从 PDF 中删除图像的命令和选项,并将其粘贴到文本文件中而已。将这个文件作为脚本运行,大概也会产生同样的结果。

向 Bash 脚本传参数

在终端中运行命令与在 Shell 脚本中运行命令之间的区别在于前者是交互式的。在终端中,你可以随时进行调整。例如,如果我刚刚处理 example_1.pdf 并准备处理下一个文档,以适应我的命令,则只需要更改文件名即可。

Shell 脚本不是交互式的。实际上,Shell 脚本 存在的唯一原因是让你不必亲自参与。这就是为什么命令(以及运行它们的 Shell 脚本)会接受参数的原因。

在 Shell 脚本中,有一些预定义的可以反映脚本启动方式的变量。初始变量是 $0,它代表了启动脚本的命令。下一个变量是 $1 ,它表示传递给 Shell 脚本的第一个 “参数”。例如,在命令 echo hello 中,命令 echo 为 $0,,关键字 hello 为 $1,而 world 是 $2。

在 Shell 中交互如下所示:

$ echo hello world
hello world

在非交互式 Shell 脚本中,你 可以 以非常直观的方式执行相同的操作。将此文本输入文本文件并将其另存为 hello.sh:

echo hello world

执行这个脚本:

$ bash hello.sh
hello world

同样可以,但是并没有利用脚本可以接受输入这一优势。将 hello.sh 更改为:

echo $1

用引号将两个参数组合在一起来运行脚本:

$ bash hello.sh "hello bash"
hello bash

对于我的 PDF 瘦身项目,我真的需要这种非交互性,因为每个 PDF 都花了几分钟来压缩。但是通过创建一个接受我的输入的脚本,我可以一次将几个 PDF 文件全部提交给脚本。该脚本按顺序处理了每个文件,这可能需要半小时或稍长一点时间,但是我可以用半小时来完成其他任务。

流程控制

创建 Bash 脚本是完全可以接受的,从本质上讲,这些脚本是你开始实现需要重复执行任务的准确过程的副本。但是,可以通过控制信息流的方式来使脚本更强大。管理脚本对数据响应的常用方法是:

  • if/then 选择结构语句
  • for 循环结构语句
  • while 循环结构语句
  • case 语句

计算机不是智能的,但是它们擅长比较和分析数据。如果你在脚本中构建一些数据分析,则脚本会变得更加智能。例如,基本的 hello.sh 脚本运行后不管有没有内容都会显示:

$ bash hello.sh foo
foo
$ bash hello.sh

$

如果在没有接收输入的情况下提供帮助消息,将会更加容易使用。如下是一个 if/then 语句,如果你以一种基本的方式使用 Bash,则你可能不知道 Bash 中存在这样的语句。但是编程的一部分是学习语言,通过一些研究,你将了解 if/then 语句:

if [ "$1" = "" ]; then
        echo "syntax: $0 WORD"
        echo "If you provide more than one word, enclose them in quotes."
else
        echo "$1"
fi

运行新版本的 hello.sh 输出如下:

$ bash hello.sh
syntax: hello.sh WORD
If you provide more than one word, enclose them in quotes.
$ bash hello.sh "hello world"
hello world

利用脚本工作

无论你是从 PDF 文件中查找要删除的图像,还是要管理混乱的下载文件夹,抑或要创建和提供 Kubernetes 镜像,学习编写 Bash 脚本都需要先使用 Bash,然后学习如何将这些脚本从仅仅是一个命令列表变成响应输入的东西。通常这是一个发现的过程:你一定会找到新的 Linux 命令来执行你从未想象过可以通过文本命令执行的任务,你会发现 Bash 的新功能,使你的脚本可以适应所有你希望它们运行的不同方式。

学习这些技巧的一种方法是阅读其他人的脚本。了解人们如何在其系统上自动化死板的命令。看看你熟悉的,并寻找那些陌生事物的更多信息。

另一种方法是下载我们的 Bash 编程入门 电子书。它向你介绍了特定于 Bash 的编程概念,并且通过学习的构造,你可以开始构建自己的命令。当然,它是免费的,并根据 创作共用许可证 进行下载和分发授权,所以今天就来获取它吧。


via: https://opensource.com/article/20/4/bash-programming-guide

作者:Seth Kenlon 选题:lujun9972 译者:stevenzdg988 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

为你的朋友、家人、同事或其他任何拥有廉价发烧设备的人播放音乐。

 title=

在过去的 10 年里,我大部分时间都是远程工作,但当我走进办公室时,我坐在一个充满内向的同伴的房间里,他们很容易被环境噪音和谈话所干扰。我们发现,听音乐可以抑制办公室的噪音,让声音不那么扰人,用愉快的音乐提供一个愉快的工作环境。

起初,我们的一位同事带来了一些老式的有源电脑音箱,把它们连接到他的桌面电脑上,然后问我们想听什么。它可以工作,但音质不是很好,而且只有当他在办公室的时候才可以使用。接下来,我们又买了一对 Altec Lansing 音箱。音质有所改善,但没有什么灵活性。

不久之后,我们得到了一台通用 ARM 单板计算机(SBC),这意味着任何人都可以通过 Web 界面控制播放列表和音箱。但一块普通的 ARM 开发板意味着我们不能使用流行的音乐设备软件。由于非标准的内核,更新操作系统是一件很痛苦的事情,而且 Web 界面也经常出现故障。

当团队壮大并搬进更大的房间后,我们开始梦想着有更好音箱和更容易处理软件和硬件组合的方法。

为了用一种相对便宜、灵活、音质好的方式解决我们的问题,我们用树莓派、音箱和开源软件开发了一个办公室 HiFi。

HiFi 硬件

用一个专门的 PC 来播放背景音乐就有点过分了。它昂贵、嘈杂(除非是静音的,但那就更贵了),而且不环保。即使是最便宜的 ARM 板也能胜任这个工作,但从软件的角度来看,它们往往存在问题。树莓派还是比较便宜的,虽然不是标准的计算机,但在硬件和软件方面都有很好的支持。

接下来的问题是:用什么音箱。质量好的、有源的音箱很贵。无源音箱的成本较低,但需要一个功放,这需要为这套设备增加另一个盒子。它们还必须使用树莓派的音频输出;虽然可以工作,但并不是最好的,特别是当你已经在高质量的音箱和功放上投入资金的时候。

幸运的是,在数以千计的树莓派硬件扩展中,有内置数字模拟转换器(DAC)的功放。我们选择了 HiFiBerry 的 Amp。它在我们买来后不久就停产了(被采样率更好的 Amp+ 型号取代),但对于我们的目的来说,它已经足够好了。在开着空调的情况下,我想无论如何你也听不出 48kHz 或 192kHz 的 DAC 有什么不同。

音箱方面,我们选择了 Audioengine P4,是在某店家清仓大甩卖的时候买的,价格超低。它很容易让我们的办公室房间充满了声音而不失真(并且还能传到我们的房间之外,有一些失真,隔壁的工程师往往不喜欢)。

HiFi 软件

在我们旧的通用 ARM SBC 上我们需要维护一个 Ubuntu,使用一个固定的、古老的、在软件包仓库外的系统内核,这是有问题的。树莓派操作系统包括一个维护良好的内核包,使其成为一个稳定且易于更新的基础系统,但它仍然需要我们定期更新 Python 脚本来访问 Spotify 和 YouTube。对于我们的目的来说,这有点过于高维护。

幸运的是,使用树莓派作为基础意味着有许多现成的软件设备可用。

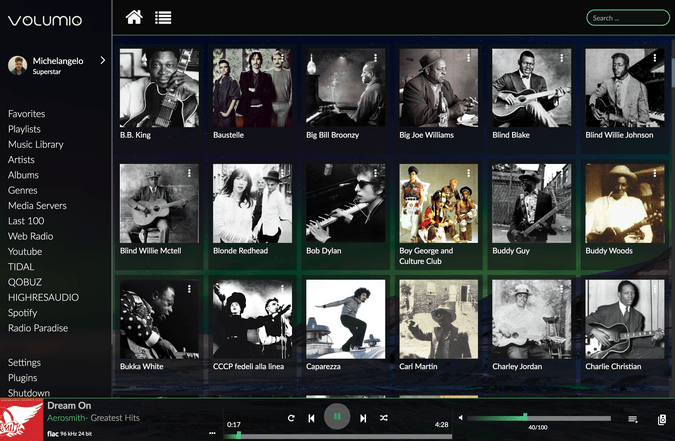
我们选择了 Volumio,这是一个将树莓派变成音乐播放设备的开源项目。安装是一个简单的一步步完成的过程。安装和升级是完全无痛的,而不用辛辛苦苦地安装和维护一个操作系统,并定期调试破损的 Python 代码。配置 HiFiBerry 功放不需要编辑任何配置文件,你只需要从列表中选择即可。当然,习惯新的用户界面需要一定的时间,但稳定性和维护的便捷性让这个改变是值得的。

 title=

播放音乐并体验

虽然大流行期间我们都在家里办公,不过我把办公室的 HiFi 安装在我的家庭办公室里,这意味着我可以自由支配它的运行。一个不断变化的用户界面对于一个团队来说会很痛苦,但对于一个有研发背景的人来说,自己玩一个设备,变化是很有趣的。

我不是一个程序员,但我有很强的 Linux 和 Unix 系统管理背景。这意味着,虽然我觉得修复坏掉的 Python 代码很烦人,但 Volumio 对我来说却足够完美,足够无聊(这是一个很好的“问题”)。幸运的是,在树莓派上播放音乐还有很多其他的可能性。

作为一个终端狂人(我甚至从终端窗口启动 LibreOffice),我主要使用 Music on Console(MOC)来播放我的网络存储(NAS)中的音乐。我有几百张 CD,都转换成了 FLAC 文件。而且我还从 BandCamp 或 Society of Sound 等渠道购买了许多数字专辑。

另一个选择是 音乐播放器守护进程(MPD)。把它运行在树莓派上,我可以通过网络使用 Linux 和 Android 的众多客户端之一与我的音乐进行远程交互。

音乐不停歇

正如你所看到的,创建一个廉价的 HiFi 系统在软件和硬件方面几乎是无限可能的。我们的解决方案只是众多解决方案中的一个,我希望它能启发你建立适合你环境的东西。


via: https://opensource.com/article/21/1/raspberry-pi-hifi

作者:Peter Czanik 选题:lujun9972 译者:wxy 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

了解如何在 FreeDOS 中创建,编辑和命名文件。

 title=

开源操作系统 FreeDOS 是一个久经考验的项目,可帮助用户玩复古游戏、更新固件、运行过时但受欢迎的应用以及研究操作系统设计。FreeDOS 提供了有关个人计算历史的见解(因为它实现了 80 年代初的事实上的操作系统),但是它是在现代环境中进行的。在本文中,我将使用 FreeDOS 来解释文件名和扩展名是如何发展的。

了解文件名和 ASCII 文本

FreeDOS 文件名遵循所谓的 8.3 惯例。这意味着所有的 FreeDOS 文件名都有两个部分,分别包含最多八个和三个字符。第一部分通常被称为文件名(这可能会让人有点困惑,因为文件名和文件扩展名的组合也被称为文件名)。这一部分可以有一个到八个字符。之后是扩展名,可以有零到三个字符。这两部分之间用一个点隔开。

文件名可以使用任何字母或数字。键盘上的许多其他字符也是允许的,但不是所有的字符。这是因为许多其他字符在 FreeDOS 中被指定了特殊用途。一些可以出现在 FreeDOS 文件名中的字符有:

~ ! @ # $ % ^ & ( ) _ - { } `

扩展 ASCII 字符集中也有一些字符可以使用,例如 �。

在 FreeDOS 中具有特殊意义的字符,因此不能用于文件名中,包括:

* / + | \ = ? [ ] ; : " . < > ,

另外,你不能在 FreeDOS 文件名中使用空格。FreeDOS 控制台使用空格将命令的与选项和参数分隔。

FreeDOS 是不区分大小写的,所以不管你是使用大写字母还是小写字母都无所谓。所有的字母都会被转换为大写字母,所以无论你做什么,你的文件最终都会在名称中使用大写字母。

文件扩展名

FreeDOS 中的文件不需要有扩展名,但文件扩展名确实有一些用途。某些文件扩展名在 FreeDOS 中有内置的含义,例如:

  • EXE:可执行文件
  • COM:命令文件
  • SYS:系统文件
  • BAT:批处理文件

特定的软件程序使用其他扩展名,或者你可以在创建文件时使用它们。这些扩展名没有绝对的文件关联,因此如果你使用 FreeDOS 的文字处理器,你的文件使用什么扩展名并不重要。如果你愿意,你可以发挥创意,将扩展名作为你的文件系统的一部分。例如,你可以用 *.JAN、*.FEB、*.MAR、*.APR 等等来命名你的备忘录。

编辑文件

FreeDOS 自带的 Edit 应用可以快速方便地进行文本编辑。它是一个简单的编辑器,沿屏幕顶部有一个菜单栏,可以方便地访问所有常用的功能(如复制、粘贴、保存等)。

 title=

正如你所期望的那样,还有很多其他的文本编辑器可以使用,包括小巧但用途广泛的 e3 编辑器。你可以在 GitLab 上找到各种各样的 FreeDOS 应用 。

创建文件

你可以在 FreeDOS 中使用 touch 命令创建空文件。这个简单的工具可以更新文件的修改时间或创建一个新文件。

C:\>touch foo.txt
C:\>dir
FOO      TXT    0  01-12-2021 10:00a

你也可以直接从 FreeDOS 控制台创建文件,而不需要使用 Edit 文本编辑器。首先,使用 copy 命令将控制台中的输入(简称 con)复制到一个新的文件对象中。用 Ctrl+Z 终止输入,然后按回车键:

C:\>copy con test.txt
con => test.txt
This is a test file.
^Z

Ctrl+Z 字符在控制台中显示为 ^Z。它并没有被复制到文件中,而是作为文件结束(EOF)的分隔符。换句话说,它告诉 FreeDOS 何时停止复制。这是一个很好的技巧,可以用来做快速的笔记或开始一个简单的文档,以便以后工作。

文件和 FreeDOS

FreeDOS 是开源的、免费的且 易于安装。探究 FreeDOS 如何处理文件,可以帮助你了解多年来计算的发展,不管你平时使用的是什么操作系统。启动 FreeDOS,开始探索现代复古计算吧!

本文中的部分信息曾发表在 DOS 课程 7:DOS 文件名;ASCII 中(CC BY-SA 4.0)。


via: https://opensource.com/article/21/3/files-freedos

作者:Kevin O'Brien 选题:lujun9972 译者:geekpi 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

在众多可用于简化 Node.js 开发的工具中,以下 9 种是最佳选择。

 title=

我最近在 StackOverflow 上读到了一项调查,该调查称超过 49% 的开发人员在其项目中使用了 Node.js。这结果对我来说并不意外。

作为一个狂热的技术使用者,我可以肯定地说 Node.js 的引入引领了软件开发的新时代。现在,它是软件开发最受欢迎的技术之一,仅次于JavaScript。

Node.js 是什么,为什么如此受欢迎?

Node.js 是一个跨平台的开源运行环境,用于在浏览器之外执行 JavaScript 代码。它也是建立在 Chrome 的 JavaScript 运行时之上的首选运行时环境,主要用于构建快速、可扩展和高效的网络应用程序。

我记得当时我们要花费几个小时来协调前端和后端开发人员,他们分别编写不同脚本。当 Node.js 出现后,所有这些都改变了。我相信,促使开发人员采用这项技术是因为它的双向效率。

使用 Node.js,你可以让你的代码同时运行在客户端和服务器端,从而加快了整个开发过程。Node.js 弥合了前端和后端开发之间的差距,并使开发过程更加高效。

Node.js 工具浪潮

对于 49% 的开发人员(包括我)来说,Node.js 处于在前端和后端开发的金字塔顶端。有大量的 Node.js 用例 帮助我和我的团队在截止日期之内交付复杂的项目。幸运的是,Node.js 的日益普及也产生了一系列开源项目和工具,以帮助开发人员使用该环境。

近来,对使用 Node.js 构建的项目的需求突然增加。有时,我发现管理这些项目,并同时保持交付高质量项目的步伐非常具有挑战性。因此,我决定使用为 Node.js 开发人员提供的许多开源工具中一些最高效的,使某些方面的开发自动化。

根据我在 Node.js 方面的丰富经验,我使用了许多的工具,这些工具对整个开发过程都非常有帮助:从简化编码过程,到监测再到内容管理。

为了帮助我的 Node.js 开发同道,我整理了这个列表,其中包括我最喜欢的 9 个简化 Node.js 开发的开源工具。

Webpack

Webpack 是一个容易使用的 JavaScript 模块捆绑程序 module bundler ,用于简化前端开发。它会检测具有依赖的模块,并将其转换为描述模块的静态 素材 asset 。

可以通过软件包管理器 npm 或 Yarn 安装该工具。

利用 npm 命令安装如下:

npm install --save-dev webpack

利用 Yarn 命令安装如下:

yarn add webpack --dev

Webpack 可以创建在运行时异步加载的单个捆绑包或多个素材链。不必单独加载。使用 Webpack 工具可以快速高效地打包这些素材并提供服务,从而改善用户整体体验,并减少开发人员在管理加载时间方面的困难。

Strapi

Strapi 是一个开源的 无界面 headless 内容管理系统(CMS)。无界面 CMS 是一种基础软件,可以管理内容而无需预先构建好的前端。它是一个使用 RESTful API 函数的只有后端的系统。

可以通过软件包管理器 Yarn 或 npx 安装 Strapi。

利用 Yarn 命令安装如下:

yarn create strapi-app my-project --quickstart

利用 npx 命令安装如下:

npx create-strapi-app my-project --quickstart

Strapi 的目标是在任何设备上以结构化的方式获取和交付内容。CMS 可以使你轻松管理应用程序的内容,并确保它们是动态的,可以在任何设备上访问。

它提供了许多功能,包括文件上传、内置的电子邮件系统、JSON Web Token(JWT)验证和自动生成文档。我发现它非常方便,因为它简化了整个 CMS,并为我提供了编辑、创建或删除所有类型内容的完全自主权。

另外,通过 Strapi 构建的内容结构非常灵活,因为你可以创建和重用内容组和可定制的 API。

Broccoli

Broccoli 是一个功能强大的构建工具,运行在 ES6 模块上。构建工具是一种软件,可让你将应用程序或网站中的所有各种素材(例如图像、CSS、JavaScript 等)组合成一种可分发的格式。Broccoli 将自己称为 “雄心勃勃的应用程序的素材管道”。

使用 Broccoli 你需要一个项目目录。有了项目目录后,可以使用以下命令通过 npm 安装 Broccoli:

npm install --save-dev broccoli
npm install --global broccoli-cli

你也可以使用 Yarn 进行安装。

当前版本的 Node.js 就是使用该工具的最佳版本,因为它提供了长期支持。它可以帮助你避免进行更新和重新安装过程中的麻烦。安装过程完成后,可以在 Brocfile.js 文件中包含构建规范。

在 Broccoli 中,抽象单位是“树”,该树将文件和子目录存储在特定子目录中。因此,在构建之前,你必须有一个具体的想法,你希望你的构建是什么样子的。

最好的是,Broccoli 带有用于开发的内置服务器,可让你将素材托管在本地 HTTP 服务器上。Broccoli 非常适合流线型重建,因为其简洁的架构和灵活的生态系统可提高重建和编译速度。Broccoli 可让你井井有条,以节省时间并在开发过程中最大限度地提高生产力。

Danger

Danger 是一个非常方便的开源工具,用于简化你的 拉取请求 pull request (PR)检查。正如 Danger 库描述所说,该工具可通过管理 PR 检查来帮助 “正规化” 你的代码审查系统。Danger 可以与你的 CI 集成在一起,帮助你加快审核过程。

将 Danger 与你的项目集成是一个简单的逐步过程:你只需要包括 Danger 模块,并为每个项目创建一个 Danger 文件。然而,创建一个 Danger 帐户(通过 GitHub 或 Bitbucket 很容易做到),并且为开源软件项目设置访问令牌更加方便。

可以通过 NPM 或 Yarn 安装 Danger。要使用 Yarn,请添加 danger -D 到 package.JSON 中。

将 Danger 添加到 CI 后,你可以:

  • 高亮显示重要的创建工件
  • 通过强制链接到 Trello 和 Jira 之类的工具来管理 sprint
  • 强制生成更新日志
  • 使用描述性标签
  • 以及更多

例如,你可以设计一个定义团队文化并为代码审查和 PR 检查设定特定规则的系统。根据 Danger 提供的元数据及其广泛的插件生态系统,可以解决常见的 议题 issue 。

Snyk

网络安全是开发人员的主要关注点。Snyk 是修复开源组件中漏洞的最著名工具之一。它最初是一个用于修复 Node.js 项目漏洞的项目,并且已经演变为可以检测并修复 Ruby、Java、Python 和 Scala 应用程序中的漏洞。Snyk 主要分四个阶段运行:

  • 查找漏洞依赖性
  • 修复特定漏洞
  • 通过 PR 检查预防安全风险
  • 持续监控应用程序

Snyk 可以集成在项目的任何阶段,包括编码、CI/CD 和报告。我发现这对于测试 Node.js 项目非常有帮助,可以测试或构建 npm 软件包时检查是否存在安全风险。你还可以在 GitHub 中为你的应用程序运行 PR 检查,以使你的项目更安全。Synx 还提供了一系列集成,可用于监控依赖关系并解决特定问题。

要在本地计算机上运行 Snyk,可以通过 NPM 安装它:

npm install -g snyk

Migrat

Migrat 是一款使用纯文本的数据迁移工具,非常易于使用。 它可在各种软件堆栈和进程中工作,从而使其更加实用。你可以使用简单的代码行安装 Migrat:

$ npm install -g migrat

Migrat 并不需要特别的数据库引擎。它支持多节点环境,因为迁移可以在一个全局节点上运行,也可以在每个服务器上运行一次。Migrat 之所以方便,是因为它便于向每个迁移传递上下文。

你可以定义每个迁移的用途(例如,数据库集、连接、日志接口等)。此外,为了避免随意迁移,即多个服务器在全局范围内进行迁移,Migrat 可以在进程运行时进行全局锁定,从而使其只能在全局范围内运行一次。它还附带了一系列用于 SQL 数据库、Slack、HipChat 和 Datadog 仪表盘的插件。你可以将实时迁移状况发送到这些平台中的任何一个。

Clinic.js

Clinic.js 是一个用于 Node.js 项目的开源监视工具。它结合了三种不同的工具 Doctor、Bubbleprof 和 Flame,帮助你监控、检测和解决 Node.js 的性能问题。

你可以通过运行以下命令从 npm 安装 Clinic.js:

$ npm install clinic

你可以根据要监视项目的某个方面以及要生成的报告,选择要使用的 Clinic.js 包含的三个工具中的一个:

  • Doctor 通过注入探针来提供详细的指标,并就项目的总体运行状况提供建议。
  • Bubbleprof 非常适合分析,并使用 async_hooks 生成指标。
  • Flame 非常适合发现代码中的热路径和瓶颈。

PM2

监视是后端开发过程中最重要的方面之一。PM2 是一款 Node.js 的进程管理工具,可帮助开发人员监视项目的多个方面,例如日志、延迟和速度。该工具与 Linux、MacOS 和 Windows 兼容,并支持从 Node.js 8.X 开始的所有 Node.js 版本。

你可以使用以下命令通过 npm 安装 PM2:

$ npm install pm2 --g

如果尚未安装 Node.js,则可以使用以下命令安装:

wget -qO- https://getpm2.com/install.sh | bash

安装完成后,使用以下命令启动应用程序:

$ pm2 start app.js

关于 PM2 最好的地方是可以在集群模式下运行应用程序。可以同时为多个 CPU 内核生成一个进程。这样可以轻松增强应用程序性能并最大程度地提高可靠性。PM2 也非常适合更新工作,因为你可以使用 “热重载” 选项更新应用程序并以零停机时间重新加载应用程序。总体而言,它是为 Node.js 应用程序简化进程管理的好工具。

Electrode

Electrode 是 Walmart Labs 的一个开源应用程序平台。该平台可帮助你以结构化方式构建大规模通用的 React/Node.js 应用程序。

Electrode 应用程序生成器使你可以构建专注于代码的灵活内核,提供一些出色的模块以向应用程序添加复杂功能,并附带了广泛的工具来优化应用程序的 Node.js 包。

可以使用 npm 安装 Electrode。安装完成后,你可以使用 Ignite 启动应用程序,并深入研究 Electrode 应用程序生成器。

你可以使用 NPM 安装 Electrode:

npm install -g electrode-ignite xclap-cli

你最喜欢哪一个?

这些只是不断增长的开源工具列表中的一小部分,在使用 Node.js 时,这些工具可以在不同阶段派上用场。你最喜欢使用哪些开源 Node.js 工具?请在评论中分享你的建议。


via: https://opensource.com/article/20/1/open-source-tools-nodejs

作者:Hiren Dhadhuk 选题:lujun9972 译者:stevenzdg988 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

使用 GNU 调试器来解决你的代码问题。

 title=

GNU 调试器常以它的命令 gdb 称呼它,它是一个交互式的控制台,可以帮助你浏览源代码、分析执行的内容,其本质上是对错误的应用程序中出现的问题进行逆向工程。

故障排除的麻烦在于它很复杂。GNU 调试器 并不是一个特别复杂的应用程序,但如果你不知道从哪里开始,甚至不知道何时和为何你可能需要求助于 GDB 来进行故障排除,那么它可能会让人不知所措。如果你一直使用 print、echo 或 printf 语句来调试你的代码,当你开始思考是不是还有更强大的东西时,那么本教程就是为你准备的。

有错误的代码

要开始使用 GDB,你需要一些代码。这里有一个用 C++ 写的示例应用程序(如果你一般不使用 C++ 编写程序也没关系,在所有语言中原理都是一样的),其来源于 猜谜游戏系列 中的一个例子。

#include <iostream>
#include <stdlib.h> //srand
#include <stdio.h>  //printf

using namespace std;

int main () {

srand (time(NULL));
int alpha = rand() % 8;
cout << "Hello world." << endl;
int beta = 2;

printf("alpha is set to is %s\n", alpha);
printf("kiwi is set to is %s\n", beta);

 return 0;
} // main

这个代码示例中有一个 bug,但它确实可以编译(至少在 GCC 5 的时候)。如果你熟悉 C++,你可能已经看到了,但这是一个简单的问题,可以帮助新的 GDB 用户了解调试过程。编译并运行它就可以看到错误:

$ g++ -o buggy example.cpp
$ ./buggy
Hello world.
Segmentation fault

排除段故障

从这个输出中,你可以推测变量 alpha 的设置是正确的,因为否则的话,你就不会看到它后面的那行代码执行。当然,这并不总是正确的,但这是一个很好的工作理论,如果你使用 printf 作为日志和调试器,基本上也会得出同样的结论。从这里,你可以假设 bug 在于成功打印的那一行之后的某行。然而,不清楚错误是在下一行还是在几行之后。

GNU 调试器是一个交互式的故障排除工具,所以你可以使用 gdb 命令来运行错误的代码。为了得到更好的结果,你应该从包含有调试符号的源代码中重新编译你的错误应用程序。首先,看看 GDB 在不重新编译的情况下能提供哪些信息:

$ gdb ./buggy
Reading symbols from ./buggy...done.
(gdb) start
Temporary breakpoint 1 at 0x400a44
Starting program: /home/seth/demo/buggy

Temporary breakpoint 1, 0x0000000000400a44 in main ()
(gdb)

当你以一个二进制可执行文件作为参数启动 GDB 时,GDB 会加载该应用程序,然后等待你的指令。因为这是你第一次在这个可执行文件上运行 GDB,所以尝试重复这个错误是有意义的,希望 GDB 能够提供进一步的见解。很直观,GDB 用来启动它所加载的应用程序的命令就是 start。默认情况下,GDB 内置了一个断点,所以当它遇到你的应用程序的 main 函数时,它会暂停执行。要让 GDB 继续执行,使用命令 continue:

(gdb) continue
Continuing.
Hello world.

Program received signal SIGSEGV, Segmentation fault.
0x00007ffff71c0c0b in vfprintf () from /lib64/libc.so.6
(gdb)

毫不意外:应用程序在打印 “Hello world” 后不久就崩溃了,但 GDB 可以提供崩溃发生时正在发生的函数调用。这有可能就足够你找到导致崩溃的 bug,但为了更好地了解 GDB 的功能和一般的调试过程,想象一下,如果问题还没有变得清晰,你想更深入地挖掘这段代码发生了什么。

用调试符号编译代码

要充分利用 GDB,你需要将调试符号编译到你的可执行文件中。你可以用 GCC 中的 -g 选项来生成这个符号:

$ g++ -g -o debuggy example.cpp
$ ./debuggy
Hello world.
Segmentation fault

将调试符号编译到可执行文件中的结果是得到一个大得多的文件,所以通常不会分发它们,以增加便利性。然而,如果你正在调试开源代码,那么用调试符号重新编译测试是有意义的:

$ ls -l *buggy* *cpp
-rw-r--r--    310 Feb 19 08:30 debug.cpp
-rwxr-xr-x  11624 Feb 19 10:27 buggy*
-rwxr-xr-x  22952 Feb 19 10:53 debuggy*

用 GDB 调试

加载新的可执行文件(本例中为 debuggy)以启动 GDB:

$ gdb ./debuggy
Reading symbols from ./debuggy...done.
(gdb) start
Temporary breakpoint 1 at 0x400a44
Starting program: /home/seth/demo/debuggy

Temporary breakpoint 1, 0x0000000000400a44 in main ()
(gdb)

如前所述,使用 start 命令进行:

(gdb) start
Temporary breakpoint 1 at 0x400a48: file debug.cpp, line 9.
Starting program: /home/sek/demo/debuggy

Temporary breakpoint 1, main () at debug.cpp:9
9       srand (time(NULL));
(gdb)

这一次,自动的 main 断点可以指明 GDB 暂停的行号和该行包含的代码。你可以用 continue 恢复正常操作,但你已经知道应用程序在完成之前就会崩溃,因此,你可以使用 next 关键字逐行步进检查你的代码:

(gdb) next
10  int alpha = rand() % 8;
(gdb) next
11  cout << "Hello world." << endl;
(gdb) next
Hello world.
12  int beta = 2;
(gdb) next
14      printf("alpha is set to is %s\n", alpha);
(gdb) next

Program received signal SIGSEGV, Segmentation fault.
0x00007ffff71c0c0b in vfprintf () from /lib64/libc.so.6
(gdb)

从这个过程可以确认,崩溃不是发生在设置 beta 变量的时候,而是执行 printf 行的时候。这个 bug 在本文中已经暴露了好几次(破坏者:向 printf 提供了错误的数据类型),但暂时假设解决方案仍然不明确,需要进一步调查。

设置断点

一旦你的代码被加载到 GDB 中,你就可以向 GDB 询问到目前为止代码所产生的数据。要尝试数据自省,通过再次发出 start 命令来重新启动你的应用程序,然后进行到第 11 行。一个快速到达 11 行的简单方法是设置一个寻找特定行号的断点:

(gdb) start
The program being debugged has been started already.
Start it from the beginning? (y or n) y
Temporary breakpoint 2 at 0x400a48: file debug.cpp, line 9.
Starting program: /home/sek/demo/debuggy

Temporary breakpoint 2, main () at debug.cpp:9
9       srand (time(NULL));
(gdb) break 11
Breakpoint 3 at 0x400a74: file debug.cpp, line 11.

建立断点后,用 continue 继续执行:

(gdb) continue
Continuing.

Breakpoint 3, main () at debug.cpp:11
11      cout << "Hello world." << endl;
(gdb)

现在暂停在第 11 行,就在 alpha 变量被设置之后,以及 beta 被设置之前。

用 GDB 进行变量自省

要查看一个变量的值,使用 print 命令。在这个示例代码中,alpha 的值是随机的,所以你的实际结果可能与我的不同:

(gdb) print alpha
$1 = 3
(gdb)

当然,你无法看到一个尚未建立的变量的值:

(gdb) print beta
$2 = 0

使用流程控制

要继续进行,你可以步进代码行来到达将 beta 设置为一个值的位置:

(gdb) next
Hello world.
12  int beta = 2;
(gdb) next
14  printf("alpha is set to is %s\n", alpha);
(gdb) print beta
$3 = 2

另外,你也可以设置一个观察点,它就像断点一样,是一种控制 GDB 执行代码流程的方法。在这种情况下,你知道 beta 变量应该设置为 2,所以你可以设置一个观察点,当 beta 的值发生变化时提醒你:

(gdb) watch beta > 0
Hardware watchpoint 5: beta > 0
(gdb) continue
Continuing.

Breakpoint 3, main () at debug.cpp:11
11      cout << "Hello world." << endl;
(gdb) continue
Continuing.
Hello world.

Hardware watchpoint 5: beta > 0

Old value = false
New value = true
main () at debug.cpp:14
14      printf("alpha is set to is %s\n", alpha);
(gdb)

你可以用 next 手动步进完成代码的执行,或者你可以用断点、观察点和捕捉点来控制代码的执行。

用 GDB 分析数据

你可以以不同格式查看数据。例如,以八进制值查看 beta 的值:

(gdb) print /o beta
$4 = 02

要查看其在内存中的地址:

(gdb) print /o &beta
$5 = 0x2

你也可以看到一个变量的数据类型:

(gdb) whatis beta
type = int

用 GDB 解决错误

这种自省不仅能让你更好地了解什么代码正在执行,还能让你了解它是如何执行的。在这个例子中,对变量运行的 whatis 命令给了你一个线索,即你的 alpha 和 beta 变量是整数,这可能会唤起你对 printf 语法的记忆,使你意识到在你的 printf 语句中,你必须使用 %d 来代替 %s。做了这个改变,就可以让应用程序按预期运行,没有更明显的错误存在。

当代码编译后发现有 bug 存在时,特别令人沮丧,但最棘手的 bug 就是这样,如果它们很容易被发现,那它们就不是 bug 了。使用 GDB 是猎取并消除它们的一种方法。

下载我们的速查表

生活的真相就是这样,即使是最基本的编程,代码也会有 bug。并不是所有的错误都会导致应用程序无法运行(甚至无法编译),也不是所有的错误都是由错误的代码引起的。有时,bug 是基于一个特别有创意的用户所做的意外的选择组合而间歇性发生的。有时,程序员从他们自己的代码中使用的库中继承了 bug。无论原因是什么,bug 基本上无处不在,程序员的工作就是发现并消除它们。

GNU 调试器是一个寻找 bug 的有用工具。你可以用它做的事情比我在本文中演示的要多得多。你可以通过 GNU Info 阅读器来了解它的许多功能:

$ info gdb

无论你是刚开始学习 GDB 还是专业人员的,提醒一下你有哪些命令是可用的,以及这些命令的语法是什么,都是很有帮助的。


via: https://opensource.com/article/21/3/debug-code-gdb

作者:Seth Kenlon 选题:lujun9972 译者:wxy 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出