分类 技术 下的文章

我自己已经用树莓派几年了,从 3B+ 版本到 4B 版本,这样一个低功耗的 Linux 发行版非常适用于做下载机,来满足 PT、BT 等一些长时间挂机下载/做种的需求。它还可以搭配 SMB 分享、FTP 内网穿透实现个人 NAS 的一些功能。接下来我将介绍自己使用 Transmission 工具搭建的树莓派下载机。

Transmission 安装

Transmission 是一款流行的 BT 下载软件,比其他客户端使用更少的资源,守护程序非常适合服务器,并且可以通过桌面 GUI、Web 界面和终端程序进行远程控制,支持本地对等发现、完全加密、DHT、µTP、PEX 和 Magnet Link 等。

首先,通过 apt 安装软件包,这里注意安装的是 transmisson-daemon:

sudo apt-get update
sudo apt-get install transmisson-daemon

然后在 /etc/transmission-daemon/ 目录下修改配置文件 settings.json。修改设置前需要先关闭 transmission 服务:

sudo systemctl stop transmission-daemon.service
cd /etc/transmission-daemon/
sudo nano settings.json

settings.json 文件内容如下,# 后为我补充的需要修改字段的注释:

{
    "alt-speed-down": 50,
    "alt-speed-enabled": false,
    "alt-speed-time-begin": 540,
    "alt-speed-time-day": 127,
    "alt-speed-time-enabled": false,
    "alt-speed-time-end": 1020,
    "alt-speed-up": 50,
    "bind-address-ipv4": "0.0.0.0",
    "bind-address-ipv6": "::",
    "blocklist-enabled": false,
    "blocklist-url": "http://www.example.com/blocklist",
    "cache-size-mb": 4,
    "dht-enabled": true,
    "download-dir": "/home/pi/complete", # 下载目录 
    "download-limit": 100,
    "download-limit-enabled": 0,
    "download-queue-enabled": true,
    "download-queue-size": 30,
    "encryption": 1,
    "idle-seeding-limit": 30,
    "idle-seeding-limit-enabled": false,
    "incomplete-dir": "/home/pi/incomplete", # 下载未完成文件目录
    "incomplete-dir-enabled": true,
    "lpd-enabled": false,
    "max-peers-global": 200,
    "message-level": 1,
    "peer-congestion-algorithm": "",
    "peer-id-ttl-hours": 6,
    "peer-limit-global": 1000,
    "peer-limit-per-torrent": 50,
    "peer-port": 51413,
    "peer-port-random-high": 65535,
    "peer-port-random-low": 49152,
    "peer-port-random-on-start": false,
    "peer-socket-tos": "default",
    "pex-enabled": true,
    "port-forwarding-enabled": false,
    "preallocation": 1,
    "prefetch-enabled": true,
    "queue-stalled-enabled": true,
    "queue-stalled-minutes": 30,
    "ratio-limit": 2,
    "ratio-limit-enabled": false,
    "rename-partial-files": true,
    "rpc-authentication-required": true,
    "rpc-bind-address": "0.0.0.0",
    "rpc-enabled": true,
    "rpc-host-whitelist": "",
    "rpc-host-whitelist-enabled": true,
    "rpc-password": "{525a44ba546f85ef59189a202b8d45357d17589686ReudqW", # 将双引号内修改为你要设定的密码,输入密码明文,重新启动程序后会自动加密,再打开看到的就是这样的密文了。
    "rpc-port": 9091, # 默认 Web 访问端口
    "rpc-url": "/transmission/",
    "rpc-username": "raspberrypi", # 将双引号内修改为你要设定的用户名
    "rpc-whitelist": "*.*.*.*",
    "rpc-whitelist-enabled": true,
    "scrape-paused-torrents-enabled": true,
    "script-torrent-done-enabled": false,
    "script-torrent-done-filename": "",
    "seed-queue-enabled": false,
    "seed-queue-size": 10,
    "speed-limit-down": 2048,
    "speed-limit-down-enabled": false,
    "speed-limit-up": 5,
    "speed-limit-up-enabled": true,
    "start-added-torrents": true,
    "trash-original-torrent-files": false,
    "umask": 18,
    "upload-limit": 100,
    "upload-limit-enabled": 0,
    "upload-slots-per-torrent": 14,
    "utp-enabled": true # 允许 Web 登录
}

settings.json 修改完成后,保存配置文件,重启 transmission 服务:

sudo systemctl start transmission-daemon.service

这样在浏览器中登录树莓派 ip:9091 就可以访问 Transmission Web 管理界面了。

Transmission Web 管理界面

如果下载中遇到写入权限问题,需要将目录设置为权限开放:

sudo chmod -R a+rw /home/pi/complete

在树莓派上挂载移动硬盘

树莓派的存储设备为 SD 卡,存储容量不会很大,不适合做 BT 的存储器,最好还是外接移动硬盘。

这里要注意的是由于树莓派供电的问题。树莓派 3B 供电不能直接外接移动硬盘,需要一个可接电源的 USB HUB 对移动硬盘单独供电。树莓派 4B 可以直接外接固态硬盘。

可以先在要挂载的目录下新建一个文件夹,然后将移动硬盘挂载即可。为了能够在树莓派重启的时候自动完成挂载操作,可以将挂载设置为系统服务。

下面是我设置的移动硬盘挂载服务,请参考 home-pi-M_disk.mount:

[Unit]
Description=Auto mount USB disk
DefaultDependencies=no
ConditionPathExists=/home/pi/M_disk
Before=sysinit.target

[Mount]
What=/dev/sda1
Where=/home/pi/M_disk
Type=ntfs

[Install]
WantedBy=multi-user.target

上述挂载服务会在树莓派启动后自动将移动硬盘 /dev/sda1(设备名称可以将移动硬盘插入树莓派后通过 sudo fdisk -l 查看),挂载到 /home/pi/M_disk(此目录为新建的挂载目录)目录下。

结语

这样就完成了树莓派下载机的搭建,搭配之前介绍的 SMB 分享、 FTP 内网穿透,还是能够满足个人 NAS 的一些简单需求。 Enjoy!

哦!Ubuntu 20.10 将不再收到任何更新。如果你还在使用它,你的系统将面临风险,请考虑升级到 Ubuntu 21.04!

Ubuntu 20.10(Groovy Gorilla)2021 年 7 月 22 日停止支持啦。它是一个非长期支持发行版本,带来了一些令人兴奋的新特性。

通常,非长期支持发行版维护 9 个月,所以生命周期结束意味着Ubuntu 20.10 用户将没有安全和维护更新。

你也会错过已安装应用的更新,使用 apt 命令 安装新软件也会面临问题。如果不手动修改 sources.list(不推荐),使用软件中心也将是个问题。

支持周期的结束会影响所有的其他 Ubuntu 特色版本,像 Kubuntu、Lubuntu、MATE 等。

但是像 Linux Mint 和 elementary OS 这样的发行版不依赖于非长期支持发行版,你不必有任何担心。

使用下面的命令在终端 检查下你安装的 Ubuntu 版本是个好主意:

lsb_release -a

升级到 Ubuntu 21.04(Hirsute Hippo):正是时候!

毫无疑问,你需要升级到 Ubuntu 21.04 才能获得最新的更新和安全改进。

Ubuntu 21.10 版本 将在几个月后发布,所以你也可以尝试到时升级到这个版本。

现在,你可以按照我们的 Ubuntu 升级教程来开始升级。

我推荐你备份一下,以防升级过程中出现问题。

如果你想重新安装,也可以。

还在用 Ubuntu 20.10?

从技术上来说,你可以继续使用不受支持的版本,如果你不想安全问题蔓延,建议还是升级到最新的版本,比如 Ubuntu 21.04。

Ubuntu 21.04 将会提供支持到 2022 年 1 月,升级前你可能想看下 Ubuntu 21.04 的特性。


via: https://news.itsfoss.com/ubuntu-20-10-end-of-life/

作者:Ankush Das 选题:lujun9972 译者:zd200572 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

我使用 Vim 来写小说。我是这样配置它的。

在我的第一个专栏中,我谈到了我为什么把 我的写作工作迁移到了 Vim 上 —— 远离了现代写作者们的标准工具,如文字处理器(MS Word 及它的开源替代方案)、文本编辑器(记事本,因为直到去年我一直是 Windows 用户)和云存储技术。如果你是一个写作者,在继续下面的内容前,我建议你先阅读一下 那篇文章的第一部分 。

基本上可以说,你使用的设备越多,你需要的写作工具就越多,最终你的工作流程就越复杂。这一点对我来说是很贴切的,因为我有四台设备,包括一部安卓手机,一台日常用的运行 Linux 的主力笔记本电脑,还有两台旧的笔记本电脑,其中一台是 Mac,我去户外拍摄时会带着它。

Vim 对于我和我的工作方式来说是一个完美的解决方案;虽然我不会说我的新的工作流程是现代写作者工作的最佳方式,但我可以说的是,对于写作者来说,拥有一个能在我们所有设备上工作的工具非常重要的,并且这个工具要足够强大以满足我们写作者每天从事的不同类型的写作需求。

从这个角度来看,Vim 的主要优势是它是跨平台的 —— 无论在什么设备上,Vim 都能工作。在苹果生态系统中使用 Vim 的情况我就不细说了,但粗略地看一下 这个应用程序 的评论,我就会知道,总会有人在各种地方使用 Vim,不管他们使用的是什么设备。

现在我们假设你是一个想开始使用 Vim 的写作者。当你安装了它,你该从哪里开始呢?

我在这一部分给你的并不算是教程,而是一系列的建议,包含对一个用于诗歌写作的 .vimrc 配置文件的解读。只要有可能,我就会链接到我学习相应内容时用到的 YouTube 上的教程。

对于 Linux 用户来说,系统已经预装了 Vim —— 通过你喜欢的终端模拟器就可以启动它。对于 Windows 和 Mac 用户,你可以从 Vim 官方网站 下载它。

建议

安装/启用 Vim 后

  • 通过终端打开 Vim Tutor。(Mac 用户可以用这种方式启动,而 Windows 用户也可以用这种方法启动。[LCTT 译注:原文这里本应该有链接,可能作者忘记添加了。无论如何,在终端中, Linux 中的命令是 vimtutor,Windows 在安装目录下找到 vimtutor.bat 命令并运行;Mac?应该与 Linux 一样?我没 Mac 呀!])在这个阶段,你不会使用 Vim 进行任何写作 —— 相反,你要每天花 15 分钟做 Vim 教程。不要多花一分钟或少花一分钟;看看在规定的 15 分钟内,你能在教程中取得多大的进展。你会发现,每天你都会在教程中取得更大的进步。在一个月内,你应该能够利用这些 15 分钟完成整个教程。
  • 成为一个更好的打字员对 Vim 的使用来说有极大的好处。这不是必须的,但我正在重新学习打字,它的副作用是使 Vim 变得更加有用了。我每次都以花 15 分钟练习打字开始,作为进入 Vim 教程前的热身。

在每一天的开始,我分配了 30 分钟的时间做这两项练习进行热身,而每天晚上睡觉前再分配 30 分钟进行练习以让我安定下来。这样的做法帮我快速从旧的工具包过渡到了 Vim,但你的安排可能有所不同。

我再次强调,除了 Vim Tutor 之外,上述步骤都是可选的;这完全取决于你个人的动机水平。

现在我们来到了这篇文章的重点:如何配置 Vim ,使它对写作者友好?

如何配置用于写作的 .vimrc

在开始之前,我想在这里提醒各位读者,我不是一个技术人员 —— 我是一个小说家 —— 你在下面看到的任何错误都是我自己的;我希望有经验的 Vim 用户能提供反馈,告诉我如何进一步完善我的配置文件。

下面是我的 .vimrc 文件。你可以从我的 GitHub 上下载,并进一步完善它:

syntax on

set noerrorbells " 取消 Vim 的错误警告铃声,关闭它以免打扰到我们 "
set textwidth=100 " 确保每一行不超过 100 字符 "
set tabstop=4 softtabstop=4
set shiftwidth=4
set expandtab
set smartindent
set linebreak
set number
set showmatch
set showbreak=+++
set smartcase
set noswapfile
set undodir=~/.vim/undodir
set undofile
set incsearch
set spell
set showmatch
set confirm
set ruler
set autochdir
set autowriteall
set undolevels=1000
set backspace=indent,eol,start

" 下面的设置确保按写作者而不是程序员喜欢的方式折行 "

set wrap
nnoremap <F5> :set linebreak<CR>
nnoremap <C-F5> :set nolinebreak<CR>


call plug#begin('~/.vim/plugged')

"   这是颜色风格插件 "

Plug 'colepeters/spacemacs-theme.vim'
Plug 'sainnhe/gruvbox-material'
Plug 'phanviet/vim-monokai-pro'
Plug 'flazz/vim-colorschemes'
Plug 'chriskempson/base16-vim'
Plug 'gruvbox-community/gruvbox'

"   这是为了更容易的诗歌写作选择的一些插件 "

Plug 'dpelle/vim-LanguageTool'
Plug 'ron89/thesaurus_query.vim'
Plug 'junegunn/goyo.vim'
Plug 'junegunn/limelight.vim'
Plug 'reedes/vim-pencil'
Plug 'reedes/vim-wordy'


"   这一部分是为了更容易地与机器集成,用了 vim-airline 这类插件 "

Plug 'vim-airline/vim-airline'

"   这一部分外理工作区和会话管理 "

Plug 'thaerkh/vim-workspace'

"   与上面插件相关, 下面的代码将你的所有的会话文件保存到一个你工作区之外的目录 "

let g:workspace_session_directory = $HOME . '/.vim/sessions/'


"   与上面插件相关,这是一个 Vim 活动的跟踪器 "

Plug 'wakatime/vim-wakatime'

"   一个干扰因素:我在这里使用了一些 Emacs 的功能,特别是 org-mode "

Plug 'jceb/vim-orgmode'


"  这是文件格式相关插件 "

Plug 'plasticboy/vim-markdown'


call plug#end()

colorscheme pacific
set background=dark

if executable('rg')
    let g:rg_derive_root='true'
endif

学习如何安装 Vim 插件时,这个教程帮助了我。我使用 Vim Plugged 插件管理器是因为在我看来它是最简单、最优雅的。

对于写作者的 .vimrc 选项的整理

  • syntax on:这可以确保 Vim 知道我在使用什么语法。做笔记、写这种文章时我主要使用 Markdown;而在写小说的时候,纯文本是我的首选格式。
  • set noerrorbells:为了你的精神状态,我强烈建议打开这个选项。
  • set textwidth=100:为了便于阅读,没有人愿意横向滚动一个文本文件。
  • set spell:如果有拼写错误的话提醒你。
  • set wrap:确保文本以写作者而不是程序员的方式进行折行。

你会注意到,我没有花更多时间讨论其他一些基本配置选项,因为我并不觉得那些对写作者来说有多重要。因为我做一些业余的编码工作,所以我的 .vimrc 配置反映了这一点。如果你只想在 Vim 上写作,那么上述配置就应该能让你顺利开始。

从这点上来说,你的 .vimrc 是一个活的文档,它能生动地反映你想用 Vim 做什么,以及你希望 Vim 如何为你做这些事情。

关于插件的说明

第 43-98 行之间是我对插件的配置。如果你已经学习了关于如何安装 Vim 插件的教程,我强烈推荐你从以下专为写作开发的 Vim 插件开始:

  • vim-LanguageTool
  • thesaurus_query.vim
  • vim-pencil
  • vim-wordy
  • vim-goyo
  • vim-markdown

总结

在这篇文章中,我们简单地介绍了写作者可以怎样开始使用 Vim,以及一个在写作工作中需要的 .vimrc 入门配置。除了我的 .vimrc 之外,我还将在这里链接到我在 GitHub 上发现的其他写作者的 .vimrc,它们是我自己配置时的灵感来源。

请劳记,这只是一个写作者的 .vimrc 的入门配置。你会发现,随着你的需求的发展,Vim 也可以随之发展。因此,投入一些时间学习配置你的 .vimrc 是值得的。

在下一篇文章中,我将会检视我在写作时的工作流程的具体细节,这个工作流程中我使用了 Vim 和 Git 及 GitHub。


via: https://news.itsfoss.com/configuring-vim-writing/

作者:Theena 选题:lujun9972 译者:piaoshi 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

进一步学习自然语言处理的基本概念

 title=

在 之前的文章 里,我介绍了 自然语言处理 natural language processing (NLP)和宾夕法尼亚大学研发的 自然语言处理工具包 Natural Language Toolkit (NLTK)。我演示了用 Python 解析文本和定义 停顿词 stopword 的方法,并介绍了 语料库 corpus 的概念。语料库是由文本构成的数据集,通过提供现成的文本数据来辅助文本处理。在这篇文章里,我将继续用各种语料库对文本进行对比和分析。

这篇文章主要包括以下部分:

  • 词网 WordNet 和 同义词集 synset
  • 相似度比较 Similarity comparison
  • 树 Tree 和 树库 treebank
  • 命名实体识别 Named entity recognition

词网和同义词集

词网 WordNet 是 NLTK 里的一个大型词汇数据库语料库。词网包含各单词的诸多 认知同义词 cognitive synonyms (认知同义词常被称作“ 同义词集 synset ”)。在词网里,名词、动词、形容词和副词,各自被组织成一个同义词的网络。

词网是一个很有用的文本分析工具。它有面向多种语言的版本(汉语、英语、日语、俄语和西班牙语等),也使用多种许可证(从开源许可证到商业许可证都有)。初代版本的词网由普林斯顿大学研发,面向英语,使用 类 MIT 许可证 MIT-like license 。

因为一个词可能有多个意义或多个词性,所以可能与多个同义词集相关联。每个同义词集通常提供下列属性:

属性定义例子
名称 Name 此同义词集的名称单词 code 有 5 个同义词集,名称分别是 code.n.01、 code.n.02、 code.n.03、code.v.01 和 code.v.02
词性 POS 此同义词集的词性单词 code 有 3 个名词词性的同义词集和 2 个动词词性的同义词集
定义 Definition 该词作对应词性时的定义动词 code 的一个定义是:(计算机科学)数据或计算机程序指令的 象征性排列 symbolic arrangement
例子 Example 使用该词的例子code 一词的例子:We should encode the message for security reasons
词元 Lemma 与该词相关联的其他同义词集(包括那些不一定严格地是该词的同义词,但可以大体看作同义词的);词元直接与其他词元相关联,而不是直接与 单词 word 相关联code.v.02 的词元是 code.v.02.encipher、code.v.02.cipher、code.v.02.cypher、code.v.02.encrypt、code.v.02.inscribe 和 code.v.02.write_in_code
反义词 Antonym 意思相反的词词元 encode.v.01.encode 的反义词是 decode.v.01.decode
上义词 Hypernym 该词所属的一个范畴更大的词code.v.01 的一个上义词是 tag.v.01
分项词 Meronym 属于该词组成部分的词computer 的一个分项词是 chip
总项词 Holonym 该词作为组成部分所属的词window 的一个总项词是 computer screen

同义词集还有一些其他属性,在 <你的 Python 安装路径>/Lib/site-packages 下的 nltk/corpus/reader/wordnet.py,你可以找到它们。

下面的代码或许可以帮助理解。

这个函数:

from nltk.corpus import wordnet

def synset_info(synset):
    print("Name", synset.name())
    print("POS:", synset.pos())
    print("Definition:", synset.definition())
    print("Examples:", synset.examples())
    print("Lemmas:", synset.lemmas())
    print("Antonyms:", [lemma.antonyms() for lemma in synset.lemmas() if len(lemma.antonyms()) > 0])
    print("Hypernyms:", synset.hypernyms())
    print("Instance Hypernyms:", synset.instance_hypernyms())
    print("Part Holonyms:", synset.part_holonyms())
    print("Part Meronyms:", synset.part_meronyms())
    print()


synsets = wordnet.synsets('code')
print(len(synsets), "synsets:")
for synset in synsets:
    synset_info(synset)

将会显示:

5 synsets:
Name code.n.01
POS: n
Definition: a set of rules or principles or laws (especially written ones)
Examples: []
Lemmas: [Lemma('code.n.01.code'), Lemma('code.n.01.codification')]
Antonyms: []
Hypernyms: [Synset('written_communication.n.01')]
Instance Hpernyms: []
Part Holonyms: []
Part Meronyms: []

...

Name code.n.03
POS: n
Definition: (computer science) the symbolic arrangement of data or instructions in a computer program or the set of such instructions
Examples: []
Lemmas: [Lemma('code.n.03.code'), Lemma('code.n.03.computer_code')]
Antonyms: []
Hypernyms: [Synset('coding_system.n.01')]
Instance Hpernyms: []
Part Holonyms: []
Part Meronyms: []

...

Name code.v.02
POS: v
Definition: convert ordinary language into code
Examples: ['We should encode the message for security reasons']
Lemmas: [Lemma('code.v.02.code'), Lemma('code.v.02.encipher'), Lemma('code.v.02.cipher'), Lemma('code.v.02.cypher'), Lemma('code.v.02.encrypt'), Lemma('code.v.02.inscribe'), Lemma('code.v.02.write_in_code')]
Antonyms: []
Hypernyms: [Synset('encode.v.01')]
Instance Hpernyms: []
Part Holonyms: []
Part Meronyms: []

同义词集 synset 和 词元 lemma 在词网里是按照树状结构组织起来的,下面的代码会给出直观的展现:

def hypernyms(synset):
    return synset.hypernyms()

synsets = wordnet.synsets('soccer')
for synset in synsets:
    print(synset.name() + " tree:")
    pprint(synset.tree(rel=hypernyms))
    print()
code.n.01 tree:
[Synset('code.n.01'),
 [Synset('written_communication.n.01'),
   ...

code.n.02 tree:
[Synset('code.n.02'),
 [Synset('coding_system.n.01'),
   ...

code.n.03 tree:
[Synset('code.n.03'),
   ...

code.v.01 tree:
[Synset('code.v.01'),
 [Synset('tag.v.01'),
   ...

code.v.02 tree:
[Synset('code.v.02'),
 [Synset('encode.v.01'),
   ...

词网并没有涵盖所有的单词和其信息(现今英语有约 17,0000 个单词,最新版的 词网 涵盖了约 15,5000 个),但它开了个好头。掌握了“词网”的各个概念后,如果你觉得它词汇少,不能满足你的需要,可以转而使用其他工具。或者,你也可以打造自己的“词网”!

自主尝试

使用 Python 库,下载维基百科的 “open source” 页面,并列出该页面所有单词的 同义词集 synset 和 词元 lemma 。

相似度比较

相似度比较的目的是识别出两篇文本的相似度,在搜索引擎、聊天机器人等方面有很多应用。

比如,相似度比较可以识别 football 和 soccer 是否有相似性。

syn1 = wordnet.synsets('football')
syn2 = wordnet.synsets('soccer')

# 一个单词可能有多个 同义词集,需要把 word1 的每个同义词集和 word2 的每个同义词集分别比较
for s1 in syn1:
    for s2 in syn2:
        print("Path similarity of: ")
        print(s1, '(', s1.pos(), ')', '[', s1.definition(), ']')
        print(s2, '(', s2.pos(), ')', '[', s2.definition(), ']')
        print("   is", s1.path_similarity(s2))
        print()
Path similarity of:
Synset('football.n.01') ( n ) [ any of various games played with a ball (round or oval) in which two teams try to kick or carry or propel the ball into each other's goal ]
Synset('soccer.n.01') ( n ) [ a football game in which two teams of 11 players try to kick or head a ball into the opponents' goal ]
   is 0.5

Path similarity of:
Synset('football.n.02') ( n ) [ the inflated oblong ball used in playing American football ]
Synset('soccer.n.01') ( n ) [ a football game in which two teams of 11 players try to kick or head a ball into the opponents' goal ]
   is 0.05

两个词各个同义词集之间 路径相似度 path similarity 最大的是 0.5,表明它们关联性很大( 路径相似度 path similarity 指两个词的意义在 上下义关系的词汇分类结构 hypernym/hypnoym taxonomy 中的最短距离)。

那么 code 和 bug 呢?这两个计算机领域的词的相似度是:

Path similarity of:
Synset('code.n.01') ( n ) [ a set of rules or principles or laws (especially written ones) ]
Synset('bug.n.02') ( n ) [ a fault or defect in a computer program, system, or machine ]
   is 0.1111111111111111
...
Path similarity of:
Synset('code.n.02') ( n ) [ a coding system used for transmitting messages requiring brevity or secrecy ]
Synset('bug.n.02') ( n ) [ a fault or defect in a computer program, system, or machine ]
   is 0.09090909090909091
...
Path similarity of:
Synset('code.n.03') ( n ) [ (computer science) the symbolic arrangement of data or instructions in a computer program or the set of such instructions ]
Synset('bug.n.02') ( n ) [ a fault or defect in a computer program, system, or machine ]
   is 0.09090909090909091

这些是这两个词各同义词集之间 路径相似度 path similarity 的最大值,这些值表明两个词是有关联性的。

NLTK 提供多种 相似度计分器 similarity scorers ,比如:

  • path\_similarity
  • lch\_similarity
  • wup\_similarity
  • res\_similarity
  • jcn\_similarity
  • lin\_similarity

要进一步了解这些 相似度计分器 similarity scorers ,请查看 WordNet Interface 的 Similarity 部分。

自主尝试

使用 Python 库,从维基百科的 Category: Lists of computer terms 生成一个术语列表,然后计算各术语之间的相似度。

树和树库

使用 NLTK,你可以把文本表示成树状结构以便进行分析。

这里有一个例子:

这是一份简短的文本,对其做预处理和词性标注:

import nltk

text = "I love open source"
# Tokenize to words
words = nltk.tokenize.word_tokenize(text)
# POS tag the words
words_tagged = nltk.pos_tag(words)

要把文本转换成树状结构,你必须定义一个 语法 grammar 。这个例子里用的是一个基于 Penn Treebank tags 的简单语法。

# A simple grammar to create tree
grammar = "NP: {&lt;JJ&gt;&lt;NN&gt;}"

然后用这个 语法 grammar 创建一颗 树 tree :

# Create tree
parser = nltk.RegexpParser(grammar)
tree = parser.parse(words_tagged)
pprint(tree)

运行上面的代码,将得到:

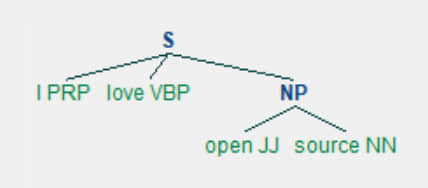
Tree('S', [('I', 'PRP'), ('love', 'VBP'), Tree('NP', [('open', 'JJ'), ('source', 'NN')])])

你也可以图形化地显示结果。

tree.draw()
 title=

这个树状结构有助于准确解读文本的意思。比如,用它可以找到文本的 主语):

subject_tags = ["NN", "NNS", "NP", "NNP", "NNPS", "PRP", "PRP$"]
def subject(sentence_tree):
    for tagged_word in sentence_tree:
        # A crude logic for this case -  first word with these tags is considered subject
        if tagged_word[1] in subject_tags:
            return tagged_word[0]

print("Subject:", subject(tree))

结果显示主语是 I:

Subject: I

这是一个比较基础的文本分析步骤,可以用到更广泛的应用场景中。 比如,在聊天机器人方面,如果用户告诉机器人:“给我妈妈 Jane 预订一张机票,1 月 1 号伦敦飞纽约的”,机器人可以用这种分析方法解读这个指令:

动作: 预订
动作的对象: 机票
乘客: Jane
出发地: 伦敦
目的地: 纽约
日期: (明年)1 月 1 号

树库 treebank 指由许多预先标注好的 树 tree 构成的语料库。现在已经有面向多种语言的树库,既有开源的,也有限定条件下才能免费使用的,以及商用的。其中使用最广泛的是面向英语的宾州树库。宾州树库取材于 华尔街日报 Wall Street Journal 。NLTK 也包含了宾州树库作为一个子语料库。下面是一些使用 树库 treebank 的方法:

words = nltk.corpus.treebank.words()
print(len(words), "words:")
print(words)

tagged_sents = nltk.corpus.treebank.tagged_sents()
print(len(tagged_sents), "sentences:")
print(tagged_sents)

100676 words:
['Pierre', 'Vinken', ',', '61', 'years', 'old', ',', ...]
3914 sentences:
[[('Pierre', 'NNP'), ('Vinken', 'NNP'), (',', ','), ('61', 'CD'), ('years', 'NNS'), ('old', 'JJ'), (',', ','), ('will', 'MD'), ('join', 'VB'), ('the', 'DT'), ('board', 'NN'), ('as', 'IN'), ('a', 'DT'), ('nonexecutive', 'JJ'), ('director', 'NN'), ...]

查看一个句子里的各个 标签 tags :

sent0 = tagged_sents[0]
pprint(sent0)
[('Pierre', 'NNP'),
 ('Vinken', 'NNP'),
 (',', ','),
 ('61', 'CD'),
 ('years', 'NNS'),
...

定义一个 语法 grammar 来把这个句子转换成树状结构:

grammar = '''
    Subject: {<NNP><NNP>}
    SubjectInfo: {<CD><NNS><JJ>}
    Action: {<MD><VB>}
    Object: {<DT><NN>}
    Stopwords: {<IN><DT>}
    ObjectInfo: {<JJ><NN>}
    When: {<NNP><CD>}
'''
parser = nltk.RegexpParser(grammar)
tree = parser.parse(sent0)
print(tree)
(S
  (Subject Pierre/NNP Vinken/NNP)
  ,/,
  (SubjectInfo 61/CD years/NNS old/JJ)
  ,/,
  (Action will/MD join/VB)
  (Object the/DT board/NN)
  as/IN
  a/DT
  (ObjectInfo nonexecutive/JJ director/NN)
  (Subject Nov./NNP)
  29/CD
  ./.)

图形化地显示:

tree.draw()

 title=

树 trees 和 树库 treebanks 的概念是文本分析的一个强大的组成部分。

自主尝试

使用 Python 库,下载维基百科的 “open source” 页面,将得到的文本以图形化的树状结构展现出来。

命名实体识别

无论口语还是书面语都包含着重要数据。文本处理的主要目标之一,就是提取出关键数据。几乎所有应用场景所需要提取关键数据,比如航空公司的订票机器人或者问答机器人。 NLTK 为此提供了一个 命名实体识别 named entity recognition 的功能。

这里有一个代码示例:

sentence = 'Peterson first suggested the name "open source" at Palo Alto, California'

验证这个句子里的 人名 name 和 地名 place 有没有被识别出来。照例先预处理:

import nltk

words = nltk.word_tokenize(sentence)
pos_tagged = nltk.pos_tag(words)

运行 命名实体标注器 named-entity tagger :

ne_tagged = nltk.ne_chunk(pos_tagged)
print("NE tagged text:")
print(ne_tagged)
print()
NE tagged text:
(S
  (PERSON Peterson/NNP)
  first/RB
  suggested/VBD
  the/DT
  name/NN
  ``/``
  open/JJ
  source/NN
  ''/''
  at/IN
  (FACILITY Palo/NNP Alto/NNP)
  ,/,
  (GPE California/NNP))

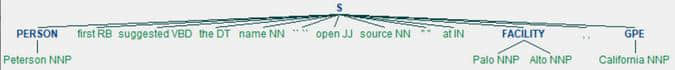
上面的结果里,命名实体被识别出来并做了标注;只提取这个 树 tree 里的命名实体:

print("Recognized named entities:")
for ne in ne_tagged:
    if hasattr(ne, "label"):
        print(ne.label(), ne[0:])
Recognized named entities:
PERSON [('Peterson', 'NNP')]
FACILITY [('Palo', 'NNP'), ('Alto', 'NNP')]
GPE [('California', 'NNP')]

图形化地显示:

ne_tagged.draw()
 title=

NLTK 内置的 命名实体标注器 named-entity tagger ,使用的是宾州法尼亚大学的 Automatic Content Extraction(ACE)程序。该标注器能够识别 组织机构 ORGANIZATION 、人名 PERSON 、地名 LOCATION 、设施 FACILITY 和 地缘政治实体 geopolitical entity 等常见 实体 entites 。

NLTK 也可以使用其他 标注器 tagger ,比如 Stanford Named Entity Recognizer. 这个经过训练的标注器用 Java 写成,但 NLTK 提供了一个使用它的接口(详情请查看 nltk.parse.stanford 或 nltk.tag.stanford)。

自主尝试

使用 Python 库,下载维基百科的 “open source” 页面,并识别出对 开源 open source 有影响力的人的名字,以及他们为 开源 open source 做贡献的时间和地点。

高级实践

如果你准备好了,尝试用这篇文章以及此前的文章介绍的知识构建一个 超级结构 superstructure 。

使用 Python 库,下载维基百科的 “Category: Computer science page”,然后:

  • 找出其中频率最高的 单词 unigrams 、二元搭配 bigrams 和 三元搭配 trigrams ,将它们作为一个关键词列表或者技术列表。相关领域的学生或者工程师需要了解这样一份列表里的内容。
  • 图形化地显示这个领域里重要的人名、技术、日期和地点。这会是一份很棒的信息图。
  • 构建一个搜索引擎。你的搜索引擎性能能够超过维基百科吗?

下一步?

自然语言处理是 应用构建 application building 的典型支柱。NLTK 是经典、丰富且强大的工具集,提供了为现实世界构建有吸引力、目标明确的应用的工作坊。

在这个系列的文章里,我用 NLTK 作为例子,展示了自然语言处理可以做什么。自然语言处理和 NLTK 还有太多东西值得探索,这个系列的文章只是帮助你探索它们的切入点。

如果你的需求增长到 NLTK 已经满足不了了,你可以训练新的模型或者向 NLTK 添加新的功能。基于 NLTK 构建的新的自然语言处理库正在不断涌现,机器学习也正被深度用于自然语言处理。


via: https://opensource.com/article/20/8/nlp-python-nltk

作者:Girish Managoli 选题:lujun9972 译者:tanloong 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出
每种编程语言都有其独特的完成任务的方式,这也说明了为什么有这么多语言可供选择。

 title=

在 Jim Hall 的《不同的编程语言如何完成相同的事情》文章中,他演示了 13 种不同的语言如何使用不同的语法来完成同一个任务。经验是,编程语言往往有很多相似之处。一旦你了解了一种编程语言,你就可以通过理解它的语法和结构来学习另一种。

本着同样的精神,Jim 的文章比较了不同编程语言如何读写数据。无论数据来自配置文件还是用户创建的文件,在存储设备上处理数据都是程序员的常见任务。以这种方式涵盖所有编程语言是不切实际的,但最近的 Opensource.com 系列文章提供了对这些编程语言采用的不同方法的深入了解:

读写数据

用计算机读写数据的过程和你在现实生活中读写数据的过程类似。要访问书中的数据,你首先要打开它,然后阅读单词或将生词写入书中,然后合上书。

当程序需要从文件中读取数据时,你向程序传入一个文件位置,然后计算机将该数据读入内存中并解析它。同样,当程序需要将数据写入文件时,计算机会将新数据放入系统的内存写入缓冲区,然后将其同步到存储设备上的文件中。

下面是这些操作的一些伪代码:

  1. 在内存中加载文件。
  2. 读取文件内容,或将数据写入文件。
  3. 关闭文件。

从文件中读取数据

从 Opensource.com 系列文章的语言中,你可以看到读取文件的三种趋势。

C

在 C 语言中,打开文件可能涉及检索单个字符(直到 EOF 指示符,表示文件结束)或一个数据块,具体取决于你的需求和方法。根据你的目标,它可能感觉像一个主要是手工的过程,但这正是其他语言所模仿的。

FILE *infile;
int ch;

infile = fopen(argv[1], "r");
 
do {
  ch = fgetc(infile);
  if (ch != EOF) {
    printf("%c", ch);
  }
 } while (ch != EOF);

fclose(infile);

你还可以选择将文件的某些部分加载到系统缓冲区中,然后在缓冲区外工作。

FILE *infile;
char buffer[300];
 
infile = fopen(argv[1], "r");

while (!feof(infile)) {
  size_t buffer_length;
  buffer_length = fread(buffer, sizeof(char), 300, infile);
}

printf("%s", buffer);
fclose(infile);

C++

C++ 简化了一些步骤,允许你将数据解析为字符串。

std::string sFilename = "example.txt";

std::ifstream fileSource(sFilename);
std::string buffer;

while (fileSource >> buffer) {
  std::cout << buffer << std::endl;
}

Java

Java 和 Groovy 类似于 C++。它们使用名为 Scanner 的类来设置数据流或对象,这样就会包含你选择的文件内容。你可以通过标记(字节、行、整数等)扫描文件。

File myFile = new File("example.txt");

Scanner myScanner = new Scanner(myFile);
  while (myScanner.hasNextLine()) {
    String line = myScanner.nextLine();
    System.out.println(line);
  }

myScanner.close();

Groovy

def myFile = new File('example.txt')

def myScanner = new Scanner(myFile)
  while (myScanner.hasNextLine()) {
    def line = myScanner.nextLine()
    println(line)
  }

myScanner.close()

Lua

Lua 和 Python 进一步抽象了整个过程。你不必有意识地创建数据流,你只需给一个变量赋值为 open 函数的返回值,然后解析该变量的内容。这种方式快速,最简且容易。

myFile = io.open('example.txt', 'r')

lines = myFile:read("*all")
print(lines)

myFile:close()

Python

f = open('example.tmp', 'r')

for line in f:
    print(line)

f.close()

向文件中写入数据

就写代码来说,写入是读取的逆过程。因此,将数据写入文件的过程与从文件中读取数据基本相同,只是使用了不同的函数。

C

在 C 语言中,你可以使用 fputc 函数将字符写入文件:

fputc(ch, outfile);

或者,你可以使用 fwrite 将数据写入缓冲区。

fwrite(buffer, sizeof(char), buffer_length, outfile);

C++

因为 C++ 使用 ifstream 库为数据打开缓冲区,所以你可以像 C 语言那样将数据写入缓冲区(C++ 库除外)。

std::cout << buffer << std::endl;

Java

在 Java 中,你可以使用 FileWriter 类来创建一个可以写入数据的对象。它的工作方式与 Scanner 类非常相似,只是方向相反。

FileWriter myFileWriter = new FileWriter("example.txt", true);
myFileWriter.write("Hello world\n");
myFileWriter.close();

Groovy

类似地,Groovy 使用 FileWriter,但使用了稍微 “groovy” 的语法。

new FileWriter("example.txt", true).with {
  write("Hello world\n")
  flush()
}

Lua

Lua 和 Python 很相似,都使用名为 open 的函数来加载文件,writer 函数来写入数据,close 函数用于关闭文件。

myFile = io.open('example.txt', 'a')
io.output(myFile)
io.write("hello world\n")
io.close(myFile)

Python

myFile = open('example.txt', 'w')
myFile.write('hello world')
myFile.close()

File 模式

许多语言在打开文件时会指定一个“模式”。模式有很多,但这是常见的定义:

  • w 表示写入
  • r 表示读取
  • r+ 表示可读可写
  • a 表示追加

某些语言,例如 Java 和 Groovy,允许你根据用于加载文件的类来确定模式。

无论编程语言以何种方式来确定文件模式,你都需要确保你是在 追加 数据,除非你打算用新数据覆盖文件。编程语言不像文件选择器那样,没有内置的提示来警告你防止数据丢失。

新语言和旧把戏

每种编程语言都有其独特完成任务的方式,这就是为什么有这么多语言可供选择。你可以而且应该选择最合适你的语言。但是,你一旦了解了编程的基本结构,你可以随意尝试其他语言,而不必担心不知道如何完成基本任务。通常情况下,实现目标的途径是相似的,所以只要你牢记基本概念,它们就很容易学习。


via: https://opensource.com/article/21/7/programming-read-write

作者:Alan Smithee 选题:lujun9972 译者:MjSeven 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

当编写程序时,我花费了大量时间在编写好的示例上。我从未见过有人写过关于如何写出好的示例,所以我就写了一下如何写出一份好的示例。

基础思路就是从你写的真实代码开始,然后删除不相关的细节,使其成为一个独立的例子,而不是无中生有地想出一些例子。

我将会谈论两种示例:基于真实案例的示例和奇怪的示例

好的示例是真实的

为了说明为什么好的案例应该是真实的,我们就先讨论一个不真实的案例。假设我们在试图解释 Python 的 lambda 函数(这只是我想到的第一个概念)。你可以举一个例子,使用 map 和 lambda 来让一组数字变为原先的两倍。

numbers = [1, 2, 3, 4]
squares = map(lambda x: x * x, numbers)

我觉得这个示例不是真实的,有如下两方面的原因:

  • 将一组数字作平方运算不是在真实的程序中完成的事,除非是欧拉项目或某种东西(更多的可能是针对列表的操作)
  • map 在 Python 中并不常用,即便是做这个我也更愿意写 [x*x for x in numbers]

一个更加真实的 Python lambdas 的示例是使用 sort 函数,就像这样:

children = [{"name": "ashwin", "age": 12}, {"name": "radhika", "age": 3}]
sorted_children = sorted(children, key=lambda x: x['age'])

但是这个示例是被精心设计的(为什么我们需要对这些孩子按照年龄进行排序呢?)。所以我们如何来做一个真实的示例呢?

如何让你的示例真实起来:看你所写实际代码

我认为最简单的来生成一个例子的方法就是,不是凭空出现一个例子(就像我用那个儿童的例子),而只是从真正的代码开始!

举一个例子吧,如果我要用 sort.+key 来编写一串 Python 代码,我会发现很多我按某个标准对列表进行排序的真实例子,例如:

  • tasks.sort(key=lambda task: task['completed_time'])
  • emails = reversed(sorted(emails, key=lambda x:x['receivedAt']))
  • sorted_keysizes = sorted(scores.keys(), key=scores.get)
  • shows = sorted(dates[date], key=lambda x: x['time']['performanceTime'])

在这里很容易看到一个规律——这些基本是按时间排序的!因此,你可以明白如何将按时间排序的某些对象(电子邮件、事件等)的简单实例轻松地放在一起。

现实的例子有助于“布道”你试图解释的概念

当我试图去解释一个想法(就好比 Python Lambdas)的时候,我通常也会试图说服读者,说这是值得学习的想法。Python lambdas 是如此的有用!当我去试图说服某个人 lambdas 是很好用的时候,让他想象一下 lambdas 如何帮助他们完成一项他们将要去做的任务或是以及一项他们以前做过的任务,对说服他会很有帮助。

从真实代码中提炼出示例可能需要很长时间

我给出如何使用 lambda 和 sort 函数的解释例子是十分简单的,它并不需要花费我很长时间来想出来,但是将真实的代码提炼出为一个独立的示例则是会需要花费很长的时间!

举个例子,我想在这篇文章中融入一些奇怪的 CSS 行为的例子来说明创造一个奇怪的案例是十分有趣的。我花费了两个小时来解决我这周遇到的一个实际的问题,确保我理解 CSS 的实际情况,并将其变成一个小示例。

最后,它“仅仅”用了 五行 HTML 和一点点的 CSS 来说明了这个问题,看起来并不想是我花费了好多小时写出来的。但是最初它却是几百行的 JS/CSS/JavaScript,它需要花费很长时间来将所有的代码化为核心的很少的代码。

但我认为花点时间把示例讲得非常简单明了是值得的——如果有成百上千的人在读你的示例,你就节省了他们这么多时间!

就这么多了!

我觉得还有更多关于示例可以去讲的——几种不同类型的有用示例,例如:

  • 可以更多的改变人的思维而不是直接提供使用的惊喜读者的示例代码
  • 易于复制粘贴以用作初始化的示例

也许有一天我还会再写一些呢? :smiley:


via: https://jvns.ca/blog/2021/07/08/writing-great-examples/

作者:Julia Evans 选题:lujun9972 译者:zepoch 校对:turbokernel

本文由 LCTT 原创编译,Linux中国 荣誉推出