2020年11月

设置一个本地开发环境,或者直接用这些工具尝试容器编排平台。

Kubernetes 是一个开源的容器编排平台。它由 Google 开发,为自动化部署、扩展和管理容器化应用提供了一个开源系统。虽然大多数人在云环境中运行 Kubernetes,但在本地运行 Kubernetes 集群不仅是可能的,它还至少有两个好处:

  • 在决定使用 Kubernetes 作为主要平台部署应用之前,你可以快速试用它。
  • 在将任何东西推送到公共云之前,你可以将其设置为本地开发环境,从而实现开发环境和生产环境之间的分离。

无论你的情况如何,将本地 Kubernetes 环境设置为你的开发环境都是推荐的选择,因为这种设置可以创建一个安全而敏捷的应用部署流程。

幸运的是,有多个平台可以让你尝试在本地运行 Kubernetes,它们都是开源的,并且都是 Apache 2.0 许可。

  • Minikube 的主要目标是成为本地 Kubernetes 应用开发的最佳工具,并支持所有适合的 Kubernetes 特性。
  • kind 使用 Docker 容器“节点”运行本地 Kubernetes 集群。
  • CodeReady Containers(CRC)用来管理为测试和开发目的优化的本地 OpenShift 4.x 集群。
  • Minishift 通过在虚拟机 (VM) 内运行单节点的 OpenShift 集群,帮助你在本地运行 OpenShift 3.x 集群。

Minikube

 title=

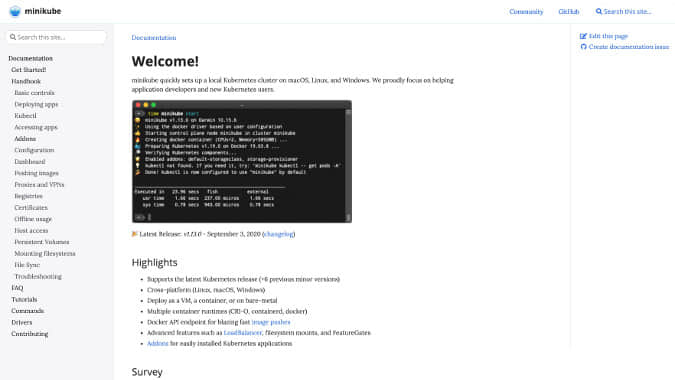
Minikube 是在本地计算机上运行 Kubernetes 环境的最知名、最流行的选择。无论你使用什么操作系统,Minikube 的文档都会为你提供一个简单的安装指南。一般来说,安装 Minikube 只需运行两条命令:

$ curl -LO https://storage.googleapis.com/minikube/releases/latest/minikube-PLATFORM-amd64
$ sudo install minikube-PLATFORM-amd64 /usr/local/bin/minikube

Minikube 可在 Linux、macOS 或 Windows 上快速设置本地 Kubernetes 集群,其功能如下:

  • 支持最新的 Kubernetes 版本(包括 6 个以前的小版本)
  • 跨平台(Linux、macOS、Windows)
  • 以虚拟机、容器或裸机的形式部署
  • 支持多个容器运行时(CRI-O、containerd、Docker)
  • 用于快速推送镜像的 Docker API 端点
  • 负载均衡器、文件系统挂载、FeatureGates 和其他高级功能
  • 用于轻松安装 Kubernetes 应用的附加组件

因为 Minikube 是一个开源项目,你可以对它的源代码做贡献。

kind

 title=

kind 的开发者将其描述为“一个使用 Docker 容器‘节点’运行本地 Kubernetes 集群的工具”。它是为测试 Kubernetes 而设计的,但也可能用于本地开发或持续集成。

kind 支持:

  • 多节点(包括高可用性)集群
  • 从源码构建 Kubernetes 版本
  • Make/Bash/Docker 或 Bazel,以及预发布构建
  • Linux、MacOS 和 Windows

此外,kind 是一个经过云原生计算基金会(CNCF)认证的 Kubernetes 合规安装程序。因为它是开源的,你可以在它的 GitHub 仓库中找到 kind 的源码。

CodeReady Container (CRC)

 title=

如果你想在本地尝试最新版本的 OpenShift,可以尝试红帽的 CodeReady Containers (CRC)。CRC 将一个最小的 OpenShift 4.x 集群带到你的本地计算机上,为开发和测试目的提供一个最小的环境。CRC 主要针对开发者的桌面使用。

你可以在 GitHub 上找到 CodeReady Container 的源码,也是在 Apache 2.0 许可下提供的。

Minishift

 title=

Minishift 项目帮助你在本地用 OKD 在虚拟机内的单节点 OpenShift 集群运行一个版本的 OpenShift。你可以用它来尝试 OpenShift,或者在你的本地主机上为云开发。

和这个列表中的其他工具一样,Minishift 也是开源的,你可以在 GitHub 上访问它的源码。

为人服务的 Kubernetes

正如你所看到的,有几种方法可以在本地环境中试用 Kubernetes。我有遗漏么?欢迎留言提问或提出建议。


via: https://opensource.com/article/20/11/run-kubernetes-locally

作者:Bryant Son 选题:lujun9972 译者:geekpi 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

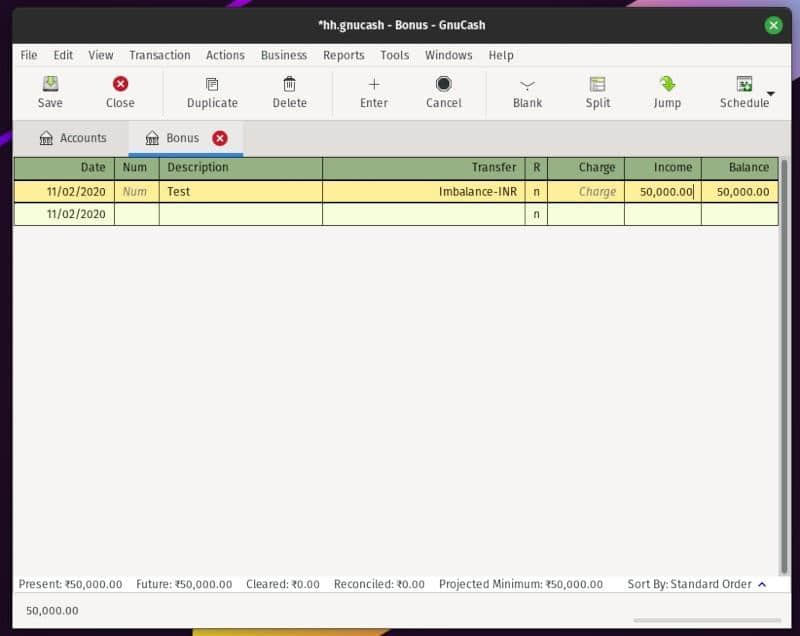
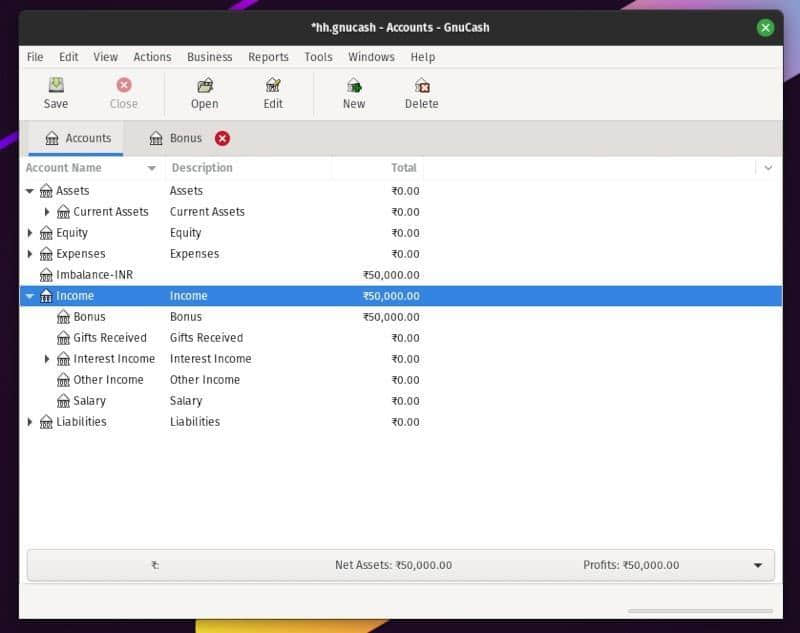
GnuCash 是一款流行的自由开源的会计软件,可用于管理个人财务和商业交易。

考虑到管理个人财务和商业交易的复杂性,你会发现有很多旨在简化这些的在线服务或软件工具。有些工具只是让你添加支出和收入来跟踪你的储蓄,而其他一些工具则提供不同的功能。

我在过去已经介绍过几个开源会计软件。在这里,我将重点介绍其中一个 — GnuCash,它是一款很流行的免费会计软件,为所有用户提供了很多功能。

GnuCash: 自由开源的会计软件

GnuCash 是一款为专业需求量身定做的免费会计软件,可以追踪交易、股票等。它适用于 Linux、BSD、macOS 和 Windows。

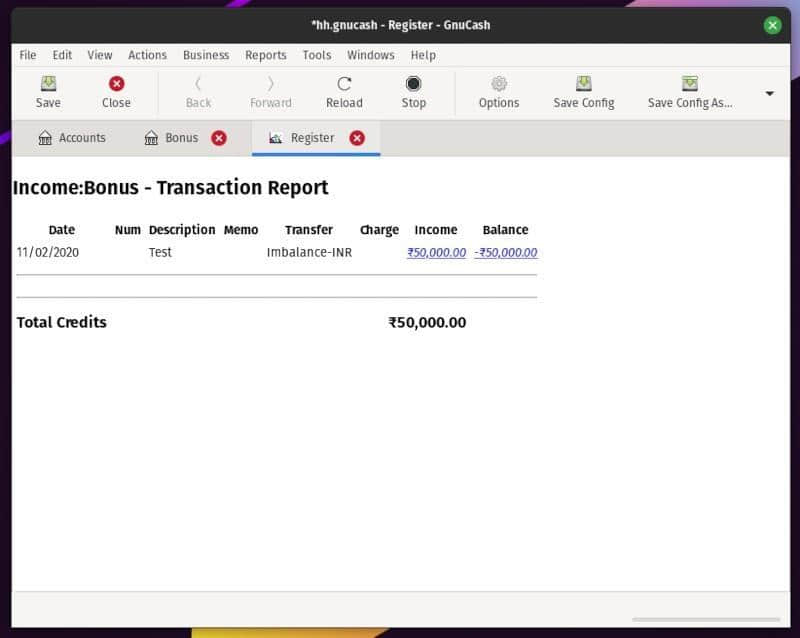
虽然刚开始使用可能会让人不知所措,但对于管理个人交易而言很容易使用。在你开始管理一个账户,并添加交易后,你可以得到一个详细的报告。

GnuCash 的功能

正如我前面提到的,GnuCash 带来了一大堆功能,这对于一个刚接触会计的人来说可能会让人不知所措,但我认为它应该是值得的:

  • 复式记账
  • 股票/债券/共同基金账户
  • 有税务支持的小企业会计(如印度的商品和服务税)
  • 详细的分类报告
  • 便于分析的图表
  • 支持财务计算
  • 自动保存功能
  • 彩色编码
  • 网上银行向导
  • 日志
  • 贷款还款计算器
  • 用于快速计算的价格数据库
  • 每个类别的预算平衡表、流程、图表
  • 能够以 CSV 格式导出
  • 分别添加客户、供应商和雇员记录。
  • 计划交易记录
  • 制定预算的能力
  • 配置账单生成器,以简化会计程序。

我不是专家,但这只是冰山一角。你会发现有很多选项可以根据你的会计需求进行定制和设置。

在 Linux 上安装 GnuCash

你可以在你的 Linux 发行版的软件中心找到 GnuCash。从那里安装或使用发行版的软件包管理器。

对于那些想要最新版本的人来说,还可以使用 Flatpak 包。如果你不知道它,我建议你去看看我们的 Flatpak 指南。

另外,你也可以从源码构建,或者你可以前往他们的官方下载页面来探索适合你的 Linux 发行版选项。

总结

对于基本的个人理财来说,这对我来说有点复杂,因为我更喜欢安卓应用的简单。不过,如果你试上几分钟,就会发现它很容易理解,GnuCash 似乎可以灵活地满足大多数要求。

如果你想管理自己或企业的财务,你可以尝试一下。它绝对比在电子表格中保存数据要好。 :smiley:


via: https://itsfoss.com/gnucash/

作者:Ankush Das 选题:lujun9972 译者:geekpi 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

阅读本文并下载我们的免费备忘单,去使用开源的数据库吧。
当你写一个程序或配置一个服务时,你最终都要持久化存储信息。有时候,你只需要一个 INI 或者 YAML 配置文件就够了。而有时候,一个自定义格式的 XML 或者 JSON 或其他类似的文件会更好。

但也有时候你需要校验输入、快速查询信息、关联数据、通常还要熟练地处理你的用户的请求。这就是设计数据库的目的,而 MariaDB(由 MySQL 的原始开发人员开发的一个分支) 是一个极佳的选项。在本文中我使用的是 MariaDB,但这些信息同样适用于 MySQL。

通过编程语言与数据库进行交互是很普遍的。正因如此,出现了大量 Java、Python、Lua、PHP、Ruby、C++ 和其他语言的 SQL 库。然而,在使用这些库之前,理解数据库引擎做了什么以及为什么选择数据库是重要的对我们会很有帮助。本文介绍 MariaDB 和 mysql 命令来帮助你熟悉数据库处理数据的基本原理。

如果你还没有安装 MariaDB,请查阅我的文章 在 Linux 上安装 MariaDB。如果你没有使用 Linux,请参照 MariaDB 下载页面提供的指导方法。

与 MariaDB 交互

你可以使用 mysql 命令与 MariaDB 进行交互。首先使用子命令 ping 确认你的服务是运行着的,在提示后输入密码:

$ mysqladmin -u root -p ping
Enter password:
mysqld is alive

为了易于读者理解,打开一个交互式的 MariaDB 会话:

$ mysql -u root -p
Enter password:
Welcome to the MariaDB monitor.
Commands end with ; or \g.
[...]
Type 'help;' or '\h' for help.
Type '\c' to clear the current input statement.

MariaDB [(none)]>

你现在是在一个 MariaDB 子 shell 中,提示符是 MariaDB 提示符。普通的 Bash 命令在这里不能使用,只能用 MariaDB 命令。输入 help (或 ?)查看命令列表。这些是你的 MariaDB shell 的管理命令,使用它们可以定制你的 shell,但它们不属于 SQL 语言。

学习 SQL 基本知识

结构化查询语言是基于它们的能力定义的:一种通过有规则且一致的语法来查询数据库中的内容以得到有用的结果的方法。SQL 看起来像是普通的英文语句,有一点点生硬。例如,如果你登入数据库服务器,想查看有哪些库,输入 SHOW DATABASES; 并回车就能看到结果。

SQL 命令以分号作为结尾。如果你忘记输入分号,MariaDB 会认为你是想在下一行继续输入你的查询命令,在下一行你可以继续输入命令也可以输入分号结束命令。

MariaDB [(NONE)]> SHOW DATABASES;
+--------------------+
| DATABASE           |
+--------------------+
| information_schema |
| mysql              |
| performance_schema |
| test               |
+--------------------+
4 ROWS IN SET (0.000 sec)

上面的例子显示当前有四个数据库:information_schema、mysql、performance_schema 和 test。你必须指定 MariaDB 使用哪个库,才能对该库使用查询语句。指定数据库的命令是 use。当你选择了一个库后,MariaDB 提示框会切换为选择的库。

MariaDB [(NONE)]> USE test;
MariaDB [(test)]>

显示数据库的表

数据库里有表,与电子表格类似:有一系列的行(在数据库中称为记录)和列。一个行和一个列唯一确定一个字段。

查看一个数据库中可用的表(可以理解为多表单电子表格中的一页),使用 SQL 关键字 SHOW:

MariaDB [(test)]> SHOW TABLES;
empty SET

test 数据库是空的,所以使用 use 命令切换到 mysql 数据库:

MariaDB [(test)]> USE mysql;
MariaDB [(mysql)]> SHOW TABLES;

+---------------------------+
| Tables_in_mysql           |
+---------------------------+
| column_stats              |
| columns_priv              |
| db                        |
[...]
| time_zone_transition_type |
| transaction_registry      |
| USER                      |
+---------------------------+
31 ROWS IN SET (0.000 sec)

这个数据库中有很多表!mysql 数据库是这个 MariaDB 实例的系统管理数据库。它里面包含重要数据,比如用来管理数据库权限的用户结构。这个数据库很重要,你不需要经常直接与它交互,但是使用 SQL 脚本来操作它却很常见。当你学习 MariaDB 时理解 mysql 数据库很有用,因为它有助于说明一些基本的 SQL 命令。

检查一个表

这个实例的 mysql 数据库的最后一个表名为 USER。这个表包含了可以访问这个数据库的用户。当前里面只有一个 root 用户,但是你可以添加不同权限的用户,赋予它们查看、更新或创建数据的权限。你可以查看一个表的列首来了解一个 MariaDB 用户的所有属性:

> SHOW COLUMNS IN USER;
MariaDB [mysql]> SHOW COLUMNS IN USER;
+-------------+---------------+------+-----+----------+
| FIELD       | TYPE          | NULL | KEY | DEFAULT  |
+-------------+---------------+------+-----+----------+
| Host        | CHAR(60)      | NO   | PRI |          |
| USER        | CHAR(80)      | NO   | PRI |          |
| Password    | CHAR(41)      | NO   |     |          |
| Select_priv | enum('N','Y') | NO   |     | N        |
| Insert_priv | enum('N','Y') | NO   |     | N        |
| Update_priv | enum('N','Y') | NO   |     | N        |
| Delete_priv | enum('N','Y') | NO   |     | N        |
| Create_priv | enum('N','Y') | NO   |     | N        |
| Drop_priv   | enum('N','Y') | NO   |     | N        |
[...]
47 ROWS IN SET (0.001 sec)

创建一个新的用户

不论你是否需要一个普通的账号来管理数据库或者为计算机配置数据库(例如安装 WordPress、Drupal 或 Joomla时),在 MariaDB 中多建一个用户账号是很普遍的。你可以通过向 mysql 数据库的 USER 表中添加一个用户或使用 SQL 关键字 CREATE 来提示 MariaDB 创建一个 MariaDB 用户。使用 CREATE 来创建新用户会默认执行一些有用的方法,因此你不需要手动生成所有的信息:

> CREATE USER 'tux'@'localhost' IDENTIFIED BY 'really_secure_password';

查看表的字段

你可以使用 SELECT 关键字来查看数据库表的字段和值。这本例中,你创建了一个名为 tux 的用户,因此查询 USER 表中的列:

> SELECT USER,host FROM USER;
+------+------------+
| USER | host       |
+------+------------+
| root | localhost  |
[...]
| tux  | localhost  |
+------+------------+
7 ROWS IN SET (0.000 sec)

为一个用户赋予权限

通过查看 USER 表列出的信息,你可以看到用户的状态。例如,新用户 tux 对这个数据库没有任何权限。使用 WHERE 语句你可以只查 tux 那一条记录。

> SELECT USER,select_priv,insert_priv,update_priv FROM USER WHERE USER='tux';
+------+-------------+-------------+-------------+
| USER | select_priv | insert_priv | update_priv |
+------+-------------+-------------+-------------+
| tux  | N           | N           | N           |
+------+-------------+-------------+-------------+

使用 GRANT 命令修改用户的权限:

> GRANT SELECT ON *.* TO 'tux'@'localhost';
> FLUSH PRIVILEGES;

验证你的修改:

> SELECT USER,select_priv,insert_priv,update_priv FROM USER WHERE USER='tux';
+------+-------------+-------------+-------------+
| USER | select_priv | insert_priv | update_priv |
+------+-------------+-------------+-------------+
| tux  | Y           | N           | N           |
+------+-------------+-------------+-------------+

tux 用户现在有了从所有表中查询记录的权限。

创建自定义的数据库

到目前为止,你一直在与默认的数据库进行交互。除了用户管理,大部分人很少会与默认的数据库进行交互。通常,你会用自定义的数据来填充创建的数据库。

创建一个 MariaDB 数据库

你可能已经可以自己在 MariaDB 中创建新数据库了。创建数据库跟新建用户差不多。

> CREATE DATABASE example;
Query OK, 1 ROW affected (0.000 sec)
> SHOW DATABASES;
+--------------------+
| DATABASE           |
+--------------------+
| example            |
[...]

使用 use 命令来把这个新建的数据库作为当前使用的库:

> USE example;

创建一个表

创建表比创建数据库要复杂,因为你必须定义列首。MariaDB 提供了很多方便的函数,可以用于创建列,引入数据类型定义,自增选项,对空值的约束,自动时间戳等等。

下面是用来描述一系列用户的一个简单的表:

> CREATE TABLE IF NOT EXISTS member (
    -> id INT AUTO_INCREMENT PRIMARY KEY,
    -> name VARCHAR(128) NOT NULL,
    -> startdate TIMESTAMP DEFAULT CURRENT_TIMESTAMP);
Query OK, 0 ROWS affected (0.030 sec)

这个表通过使用一个自动递增的方法来唯一标识每一行。表示用户名字的字段不能为空(或 null),每一行被创建时会自动生成时间戳。

使用 SQL 关键字 INSERT 向这个表填充一些示例数据:

> INSERT INTO member (name) VALUES ('Alice');
Query OK, 1 ROW affected (0.011 sec)
> INSERT INTO member (name) VALUES ('Bob');
Query OK, 1 ROW affected (0.011 sec)
> INSERT INTO member (name) VALUES ('Carol');
Query OK, 1 ROW affected (0.011 sec)
> INSERT INTO member (name) VALUES ('David');
Query OK, 1 ROW affected (0.011 sec)

验证一下表里的数据:

> SELECT * FROM member;
+----+-------+---------------------+
| id | name  | startdate           |
+----+-------+---------------------+
|  1 | Alice | 2020-10-03 15:25:06 |
|  2 | Bob   | 2020-10-03 15:26:43 |
|  3 | Carol | 2020-10-03 15:26:46 |
|  4 | David | 2020-10-03 15:26:51 |
+----+-------+---------------------+
4 ROWS IN SET (0.000 sec)

同时增加多行数据

再创建一个表:

> CREATE TABLE IF NOT EXISTS linux (
    -> id INT AUTO_INCREMENT PRIMARY KEY,
    -> distro VARCHAR(128) NOT NULL);
Query OK, 0 ROWS affected (0.030 sec)

填充一些示例数据,这次使用 VALUES 快捷方式,这样你可以一次添加多行数据。VALUES 关键字需要一个用括号包围的列表作为参数,也可以用逗号分隔的多个列表作为参数。

> INSERT INTO linux (distro)
 -> VALUES ('Slackware'), ('RHEL'),('Fedora'),('Debian');
Query OK, 4 ROWS affected (0.011 sec)
Records: 4  Duplicates: 0  Warnings: 0
> SELECT * FROM linux;
+----+-----------+
| id | distro    |
+----+-----------+
|  1 | Slackware |
|  2 | RHEL      |
|  3 | Fedora    |
|  4 | Debian    |
+----+-----------+

关联多个表

现在你有两个表,之间没有关联。两个表的数据是独立的,但是你可能需要表一中的一个值来识别表二的记录。

你可以在表一中新增一列对应表二中的值。因为两个表都有唯一的标识符(自动递增的 id 字段),关联的它们的最简单的方式是,使用表一中的 id 字段作为表二的查询条件。

在表一中创建一列用来表示表二中的一个值:

> ALTER TABLE member ADD COLUMN (os INT);
Query OK, 0 ROWS affected (0.012 sec)
Records: 0  Duplicates: 0  Warnings: 0
> DESCRIBE member;
DESCRIBE member;
+-----------+--------------+------+-----+---------+------+
| FIELD     | TYPE         | NULL | KEY | DEFAULT | Extra|
+-----------+--------------+------+-----+---------+------+
| id        | INT(11)      | NO   | PRI | NULL    | auto_|
| name      | VARCHAR(128) | NO   |     | NULL    |      |
| startdate | TIMESTAMP    | NO   |     | cur[...]|      |
| os        | INT(11)      | YES  |     | NULL    |      |
+-----------+--------------+------+-----+---------+------+

把 linux 表中的唯一 ID 分配给每个成员。因为记录已经存在,使用 UPDATE 关键字而不是 INSERT。尤其是当你想查询某行然后再更新某列值时。语法上,表达方式有点倒装,先更新后查询:

> UPDATE member SET os=1 WHERE name='Alice';
Query OK, 1 ROW affected (0.007 sec)
ROWS matched: 1  Changed: 1  Warnings: 0

要填充数据,请对其他名字重复执行这个过程。为了数据的多样性,在四行记录中分配三个不同的值。

连接表

现在这两个表彼此有了关联,你可以使用 SQL 来展示关联的数据。数据库中有很多种连接方式,你可以尽请尝试。下面的例子是关联 member 表中 os 字段和 linux 表中 id 字段:

SELECT * FROM member JOIN linux ON member.os=linux.id;
+----+-------+---------------------+------+----+-----------+
| id | name  | startdate           | os   | id | distro    |
+----+-------+---------------------+------+----+-----------+
|  1 | Alice | 2020-10-03 15:25:06 |    1 |  1 | Slackware |
|  2 | Bob   | 2020-10-03 15:26:43 |    3 |  3 | Fedora    |
|  4 | David | 2020-10-03 15:26:51 |    3 |  3 | Fedora    |
|  3 | Carol | 2020-10-03 15:26:46 |    4 |  4 | Debian    |
+----+-------+---------------------+------+----+-----------+
4 ROWS IN SET (0.000 sec)

连接 os 和 id 字段。

在图形化的应用中,你可以想象 os 字段可以在下拉菜单中设置,值的来源是 linux 表中的 distro 字段。通过使用多个表中独立却有关联的数据,你可以保证数据的一致性和有效性,使用 SQL 你可以动态地关联它们。

下载 MariaDB 和 MySQL 备忘单

MariaDB 是企业级的数据库。它是健壮、强大、高效的数据库引擎。学习它是你向管理 web 应用和编写语言库迈出的伟大的一步。你可以下载 MariaDB 和 MySQL 备忘单,在你使用 MariaDB 时可以快速参考。


via: https://opensource.com/article/20/10/mariadb-mysql-cheat-sheet

作者:Seth Kenlon 选题:lujun9972 译者:lxbwolf 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出
当 Linux 系统连接到 SAN(存储区域网络)后,你需要重新扫描 iSCSI 服务以发现新的 LUN。

要做到这一点,你必须向存储团队提供 Linux 主机的 WWN 号和所需的 LUN 大小。

这篇文章将帮助你查找 Linux 主机的 WWN 号。

当存储团队将 LUN 与给定的 Linux 主机进行了映射,他们将为你提供新的 LUN 详细信息。

LUN 在存储术语中被称为 LUN 的串行十六进制。

你需要扫描 SCSI 主机来寻找存储团队分配的新 LUN。

这可以通过两种方式进行,扫描每个 scsi 主机设备或运行 rescan-scsi-bus.sh 脚本来检测新磁盘。

扫描后可以在 /dev/disk/by-id 目录下找到它们。

# ll /dev/disk/by-id

total 0
lrwxrwxrwx 1 root root 10 Jul 9 17:52 scsi-60a98000486e542d4f5a2f47694d684b -> ../../sdah
lrwxrwxrwx 1 root root 9 Jul 9 17:52 scsi-60a98000486e542d4f5a2f47694d684c -> ../../sdw
.
.
lrwxrwxrwx 1 root root 10 Jul 9 17:52 scsi-60a98000486e542d4f5a2f47694d684d -> ../../sdjk
lrwxrwxrwx 1 root root 10 Jul 9 17:52 scsi-60a98000486e542d4f5a2f47694d684e -> ../../sdaa
lrwxrwxrwx 1 root root 9 Jul 9 17:52 scsi-60a98000486e542d4f5a2f47694d684f -> ../../sdh

另外,如果你已经用 multipath 配置了它们,那么可以用 multipath 命令找到。

`multipath 主要是配置到 Oracle 数据库服务器中,以提高性能。

# multipath -ll

60a98000486e542d4f5a2f47694d684b dm-37 NETAPP,LUN C-Mode
size=512G features='3 queue_if_no_path pg_init_retries 50' hwhandler='1 alua' wp=rw
|-+- policy='round-robin 0' prio=50 status=active
| |- 1:0:4:18 sdoe 128:416 active ready running
| |- 0:0:4:18 sdpq 131:256 active ready running
| |- 0:0:5:18 sdsr 135:496 active ready running
| `- 1:0:5:18 sdsq 135:480 active ready running
`-+- policy='round-robin 0' prio=10 status=enabled
|- 1:0:1:18 sdfw 131:32 active ready running
|- 1:0:0:18 sdci 69:96 active ready running
|- 0:0:1:18 sdbz 68:208 active ready running
|- 0:0:0:18 sds 65:32 active ready running
|- 1:0:3:18 sdmd 69:336 active ready running
|- 1:0:2:18 sdjj 8:464 active ready running
|- 0:0:3:34 sdjt 65:368 active ready running
`- 0:0:2:34 sdgi 131:224 active ready running

这个过程适用于基于 Red Hat 6.x、7.x 和 8.x(RHEL - Red Hat Enterprise Linux)的系统,如 CentOS 和 Oracle Linux。

方法 1:如何使用 /sys 类文件在 Linux 上扫描新的 LUN 和 SCSI 磁盘

sysfs 文件系统是一个伪文件系统,它为内核数据结构提供了一个接口。

sysfs 下的文件提供了关于设备、内核模块、文件系统和其他内核组件的信息。

sysfs 文件系统通常被挂载在 /sys。通常,它是由系统自动挂载的。

你可以使用 echo 命令来扫描每个 SCSI 主机设备,如下所示:

# echo "- - -" > /sys/class/scsi_host/host[n]/scan

当你运行上面的重新扫描所有的命令时,三个破折号(- – -)指的是通配符选项。这些值如下:

# echo "c t l" > /sys/class/scsi_host/host[n]/scan

这里:

  • c:HBA 上的通道
  • t:SCSI 目标 ID
  • l:LUN ID
  • n:HBA 编号

运行下面的命令来查找系统中所有的主机总线编号:

# ls /sys/class/scsi_host
host0 host1 host2

得到主机总线编号后,运行以下命令来发现新的磁盘:

# echo "- - -" > /sys/class/scsi_host/host0/scan
# echo "- - -" > /sys/class/scsi_host/host1/scan
# echo "- - -" > /sys/class/scsi_host/host2/scan

另外,还可以用 for 循环用一条命令进行扫描。

# for host in ls /sys/class/scsi_host/;do echo "- - -" >/sys/class/scsi_host/${host}/scan; done

你可以使用文章开头提到的 ls 命令来检查它们。

# ls /dev/disk/by-id | grep -i "serial-hex of LUN"

方法 2:如何使用 rescan-scsi-bus.sh 脚本在 Linux 上扫描新的 LUN 和 SCSI 磁盘

确保你已经安装了 sg3_utils 包来使用这个脚本。否则,运行以下命令来安装它。

对于 RHEL/CentOS 6/7 系统,使用 yum 命令安装 sg3_utils。

# yum install -y sg3_utils

对于 RHEL/CentOS 8 和 Fedora 系统,使用 dnf 命令安装 sg3\_utils。

# dnf install -y sg3_utils

现在你可以使用 rescan-scsi-bus.sh 脚本重新扫描 LUN。

# ./rescan-scsi-bus.sh

via: https://www.2daygeek.com/scan-detect-luns-scsi-disks-on-redhat-centos-oracle-linux/

作者:Magesh Maruthamuthu 选题:lujun9972 译者:geekpi 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出
VizTracer 工具可以可视化并跟踪 Python 代码,让你可以更深入地了解其工作原理。

随着 Python 项目变得越来越大、越复杂,理解起它来就变得充满挑战性。即使是你自己独自编写了整个项目,也不可能完全知道项目是如何工作的。为了能更好的理解你的代码,调试和分析代码变得至关重要。

VizTracer 是一个这样的工具,它通过跟踪和可视化 Python 代码的执行过程,来帮助你对代码的理解。无需对源代码进行任何更改,VizTracer 即可记录函数的入口 / 出口,函数参数 / 返回值以及任意变量,然后通过 Trace-Viewer 使用直观的谷歌前端界面来显示数据。

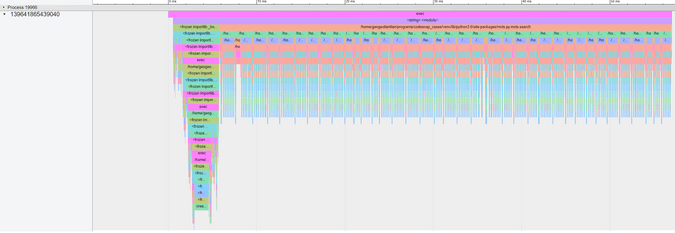
下面是一个运行蒙特卡洛树搜索的例子:

 title=

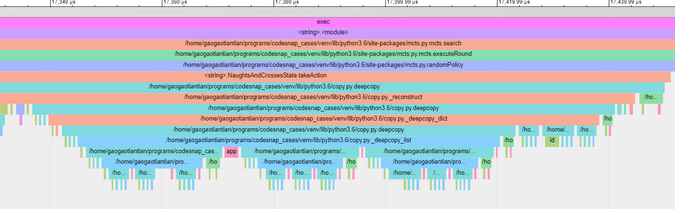
每个函数都在时间线上以堆栈的形式记录和可视化,这样你就可以看到在运行程序时发生了什么。你可以放大查看任意特定点的详细信息:

 title=

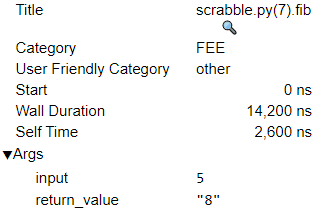
VizTracer 还可以自动记录函数参数和返回值。你可以单击函数条目并查看详细信息:

 title=

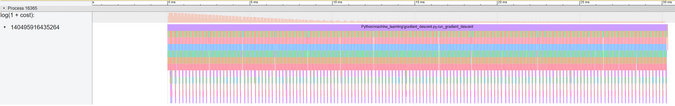
或者你可以创建一个全新的信号,并用它来记录变量。例如,这显示了执行梯度下降时的成本值:

 title=

与其他设置复杂的工具相比,VizTracer 使用起来非常简单,并且没有任何依赖关系。你可以从 pip 安装它:

pip install viztracer

你也可以通过输入来跟踪你的程序(<your_script.py> 是你脚本的名称):

viztracer <your_script.py>

VizTracer 将在你的工作目录中生成一个 HTML 报告,你可以在 Chrome 浏览器中打开它。

VizTracer 还提供了其他高级功能,比如过滤器功能,你可以使用它过滤掉不想跟踪的函数,获得更清晰的报告。例如,要仅包含文件中的函数,你需要:

viztracer include_files ./ --run <your_script.py>

记录函数参数和返回值:

viztracer --log_function_args --log_return_value <your_script.py>

记录与某个正则表达式匹配的任意变量:

# log variables starts with a
viztracer --log_var a.* --run &lt;your_script.py&gt;

你可以通过对源代码进行较小的修改来获得其他功能,例如自定义事件来记录数值和对象。

VizTracer 还包括一个虚拟调试器(vdb),它可以调试 VizTracer 的日志文件。可以用 vdb 调试你运行中的代码(与 pdb 非常相似)以便你了解代码流。有用的是,它还支持时间回溯,因为它知道发生的一切。

与一些原型不同,VizTracer 使用纯 C 语言实现其核心,这将极大地减少开销,使其达到类似于 cProfile 的水平。

VizTracer 是开源的,在 Apache 2.0 许可下发布,支持所有常见的操作系统平台(Linux、macOS 和 Windows)。你可以在 GitHub 上了解关于它的更多特性并访问源代码。


via: https://opensource.com/article/20/11/python-code-viztracer

作者:Tian Gao 选题:lujun9972 译者:xiao-song-123 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出
混合信道架构是最好的多信道选择,但它并不总是最佳的选择。当需要可靠的 Wi-Fi 时,单信道和混合 AP 提供了令人信服的替代方案。

我曾与许多实施数字项目的公司合作过,结果却发现它们失败了。正确的想法,健全地施行,现存的市场机遇。哪里是薄弱的环节?是 Wi-Fi 网络。

例如,一家大型医院希望通过将遥测信息发送到移动设备,来提高临床医生对患者警报的响应时间。如果没有这个系统,护士了解病人警报的唯一途径就是通过声音警报。在所有嘈杂的背景音中,通常很难分辨噪音来自哪里。问题是这家医院中的 Wi-Fi 网络已经很多年未升级了,这导致信息传递严重延迟(通常需要 4~5 分钟)。过长的信息传递导致人们对该系统失去信心,因此许多临床医生停止使用该系统,转而使用手动警报。最终,人们认为这个项目是失败的。

我曾在制造业、K-12 教育、娱乐和其他行业中见过类似的案例。企业竞争的基础是客户体验,而竞争的动力来自不断扩展又无处不在的无线优势。好的 Wi-Fi 并不意味着市场领导地位,但是劣质的 Wi-Fi 将会对客户和员工产生负面影响。而在当今竞争激烈的环境下,这是灾难的根源。

Wi-Fi 性能历来不一致

Wi-Fi 的问题在于它本身就很脆弱。我相信每个阅读这篇文章的人都经历过下载失败、连接中断、性能不一致以及连接公用热点的漫长等待时间等缺陷。

想象一下,你在一个会议上,在一个主题演讲之前,你可以随意地发推特、发电子邮件、浏览网页以及做其他事情。然后主讲人上台,所有观众开始拍照,上传并流传信息——然后网络崩溃了。我发现这不仅仅是一个例外,更是一种常态,强调了对无损 Wi-Fi的需求。

对于网络技术人员的问题是如何让一个地方的 Wi-Fi 达到全部时间都保持不间断。有人说只要加强现存的网络可以做到,这也许可以,但在某些情况下,Wi-Fi 的类型可能并不合适。

最常见的 Wi-Fi 部署类型是多信道,也称为微蜂窝,每个客户端通过无线信道连接到接入点(AP)。高质量的通话体验基于两点:良好的信号强度和最小的干扰。有几个因素会导致干扰,例如接入点距离太近、布局问题或者来自其他设备的干扰。为了最大程度地减少干扰,企业需要投入大量的时间和资金在现场调查中规划最佳的信道地图,但即使这些做得很好,Wi-Fi 故障仍然可能发生。

多通道 Wi-Fi 并非总是最佳选择

对于许多铺着地毯的办公室来说,多通道 Wi-Fi 可能是可靠的,但在某些环境中,外部环境会影响性能。一个很好的例子是多租户建筑,其中有多个 Wi-Fi 网络在同一信道上传输并相互干扰。另一个例子是医院,这里有许多工作人员在多个接入点间流动。客户端将试图连接到最佳接入点,导致客户端不断断开连接并重新连接,从而导致会话中断。还有一些环境,例如学校、机场和会议设施,那里存在大量的瞬态设备,而多通道则难以跟上。

单通道 Wi-Fi 提供更好的可靠性但与此同时性能会受到影响

网络管理器要做什么?不一致的 Wi-Fi 只是一个既成事实吗?多信道是一种标准,但它并非是为动态物理环境或那些需要可靠的连接环境而设计的。

几年前提出了一项解决这些问题的替代架构。顾名思义,“单信道”Wi-Fi 在网络中为所有接入点使用单一的无线频道。可以把它想象成在一个信道上运行的单个 Wi-Fi 结构。这种架构中,接入点的位置无关紧要,因为它们都利用相同的通道,因此不会互相干扰。这有一个显而易见的简化优势,比如,如果覆盖率很低,那就没有理由再做一次昂贵的现场调查。相反,只需在需要的地方布置接入点就可以了。

单通道的缺点之一是总网络吞吐量低于多通道,因为只能使用一个通道。在可靠性高于性能的环境中,这可能会很好,但许多组织希望二者兼而有之。

混合接入点提供了两全其美的优势

单信道系统制造商最近进行了创新,将信道架构混合在一起,创造了一种“两全其美”的部署,可提供多信道的吞吐量和单信道的可靠性。举个例子,Allied Telesis 提供了混合接入点,可以同时在多信道和单信道模式下运行。这意味着可以分配一些 Web 客户端到多信道以获得最大的吞吐量,而其他的 Web 客户端则可使用单信道来获得无缝漫游体验。

这种混合的实际用例可能是物流设施,办公室工作人员使用多通道,但叉车操作员在整个仓库移动时使用单一通道持续连接。

Wi-Fi 曾是一个便利的网络,但如今它或许是所有网络中最关键的任务。传统的多信道体系也许可以工作,但应该做一些尽职调查来看看它在重负下如何运转。IT 领导者需要了解 Wi-Fi 对数字转型计划的重要性,并进行适当的测试,以确保它不是基础设施链中的薄弱环节,并为当今环境选择最佳技术。


via: https://www.networkworld.com/article/3386376/when-wi-fi-is-mission-critical-a-mixed-channel-architecture-is-the-best-option.html#tk.rss_all

作者:Zeus Kerravala 选题:lujun9972 译者:chenmu-kk 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出