2020年2月

在 Ubuntu 上安装 Git 非常容易。它存在于 Ubuntu 的主仓库中,你可以像这样使用 apt 命令安装它:

sudo apt install git

很简单?是不是?

只有一点点小问题(这可能根本不是问题),就是它安装的 Git 版本。

在 LTS 系统上,软件稳定性至关重要,这就是为什么 Ubuntu 18.04 和其他发行版经常提供较旧但稳定的软件版本的原因,它们都经过发行版的良好测试。

这就是为什么当你检查 Git 版本时,会看到安装的版本会比 Git 网站上当前最新 Git 版本旧:

$ git --version
git version 2.17.1

在编写本教程时,网站上提供的版本为 2.25。那么,如何在 Ubuntu 上安装最新的 Git?

在基于 Ubuntu 的 Linux 发行版上安装最新的 Git

一种方法是从源代码安装。这种很酷又老派的方法不适合所有人。值得庆幸的是,Ubuntu Git 维护团队提供了 PPA,莫可以使用它轻松地安装最新的稳定 Git 版本。

sudo add-apt-repository ppa:git-core/ppa
sudo apt update
sudo apt install git

即使你以前使用 apt 安装了 Git,它也将更新为最新的稳定版本。

$ git --version
git version 2.25.0

使用PPA 的好处在于,如果发布了新的 Git 稳定版本,那么就可以通过系统更新获得它。仅更新 Ubuntu 来获取最新的 Git 稳定版本。

配置 Git (推荐给开发者)

如果你出于开发目的安装了 Git,你会很快开始克隆仓库,进行更改并提交更改。

如果你尝试提交代码,那么你可能会看到 “Please tell me who you are” 这样的错误:

$ git commit -m "update readme"

*** Please tell me who you are.

Run

  git config --global user.email "[email protected]"
  git config --global user.name "Your Name"

to set your account's default identity.
Omit --global to set the identity only in this repository.

fatal: unable to auto-detect email address (got 'abhishek@itsfoss.(none)')

这是因为你还没配置必要的个人信息。

正如错误已经暗示的那样,你可以像这样设置全局 Git 配置:

git config --global user.name "Your Name"
git config --global user.email "[email protected]"

你可以使用以下命令检查 Git 配置:

git config --list

它应该显示如下输出:

[email protected]
user.name=Your Name

配置保存在 ~/.gitconfig 中。你可以手动修改配置。

结尾

我希望这个小教程可以帮助你在 Ubuntu 上安装 Git。使用 PPA,你可以轻松获得最新的 Git 版本。

如果你有任何疑问或建议,请随时在评论部分提问。也欢迎直接写“谢谢” :)


via: https://itsfoss.com/install-git-ubuntu/

作者:Abhishek Prakash 选题:lujun9972 译者:geekpi 校对:wxy
本文由 LCTT 原创编译,Linux中国 荣誉推出

让我们看看可以用在你自己的 NLP 应用中的十几个工具吧。

在过去的几年里,自然语言处理(NLP)推动了聊天机器人、语音助手、文本预测等这些渗透到我们的日常生活中的语音或文本应用程技术的发展。目前有着各种各样开源的 NLP 工具,所以我决定调查一下当前开源的 NLP 工具来帮助你制定开发下一个基于语音或文本的应用程序的计划。

尽管我并不熟悉所有工具,但我将从我所熟悉的编程语言出发来介绍这些工具(对于我不熟悉的语言,我无法找到大量的工具)。也就是说,出于各种原因,我排除了三种我熟悉的语言之外的工具。

R 语言可能是没有被包含在内的最重要的语言,因为我发现的大多数库都有一年多没有更新了。这并不一定意味着它们没有得到很好的维护,但我认为它们应该得到更多的更新,以便和同一领域的其他工具竞争。我还选择了最有可能用在生产场景中的语言和工具(而不是在学术界和研究中使用),而我主要是使用 R 作为研究和发现工具。

我也惊讶地发现 Scala 的很多库都没有更新了。我上次使用 Scala 已经过去了两年了,当时它非常流行。但是大多数库从那个时候就再没有更新过,或者只有少数一些有更新。

最后,我排除了 C++。 这主要是因为我上次使用 C++ 编写程序已经有很多年了,而我所工作的组织还没有将 C++ 用于 NLP 或任何数据科学方面的工作。

Python 工具

自然语言工具包(NLTK)

毋庸置疑,自然语言工具包(NLTK)是我调研过的所有工具中功能最完善的一个。它几乎实现了自然语言处理中多数功能组件,比如分类、令牌化、词干化、标注、分词和语义推理。每一个都有多种不同的实现方式,所以你可以选择具体的算法和方式。同时,它也支持不同的语言。然而,它以字符串的形式表示所有的数据,对于一些简单的数据结构来说可能很方便,但是如果要使用一些高级的功能来说就可能有点困难。它的使用文档有点复杂,但也有很多其他人编写的使用文档,比如这本很棒的书。和其他的工具比起来,这个工具库的运行速度有点慢。但总的来说,这个工具包非常不错,可以用于需要具体算法组合的实验、探索和实际应用当中。

SpaCy

SpaCy 可能是 NLTK 的主要竞争者。在大多数情况下都比 NLTK 的速度更快,但是 SpaCy 的每个自然语言处理的功能组件只有一个实现。SpaCy 把所有的东西都表示为一个对象而不是字符串,从而简化了应用构建接口。这也方便它与多种框架和数据科学工具的集成,使得你更容易理解你的文本数据。然而,SpaCy 不像 NLTK 那样支持多种语言。它确实接口简单,具有简化的选项集和完备的文档,以及用于语言处理和分析各种组件的多种神经网络模型。总的来说,对于需要在生产中表现出色且不需要特定算法的新应用程序,这是一个很不错的工具。

TextBlob

TextBlob 是 NLTK 的一个扩展库。你可以通过 TextBlob 用一种更简单的方式来使用 NLTK 的功能,TextBlob 也包括了 Pattern 库中的功能。如果你刚刚开始学习,这将会是一个不错的工具,可以用于对性能要求不太高的生产环境的应用。总体来说,TextBlob 适用于任何场景,但是对小型项目尤佳。

Textacy

这个工具是我用过的名字最好听的。先重读“ex”再带出“cy”,多读“Textacy”几次试试。它不仅仅是名字读起来好,同时它本身也是一个很不错的工具。它使用 SpaCy 作为它自然语言处理核心功能,但它在处理过程的前后做了很多工作。如果你想要使用 SpaCy,那么最好使用 Textacy,从而不用去编写额外的附加代码就可以处理不同种类的数据。

PyTorch-NLP

PyTorch-NLP 才出现短短的一年,但它已经有一个庞大的社区了。它适用于快速原型开发。当出现了最新的研究,或大公司或者研究人员推出了完成新奇的处理任务的其他工具时,比如图像转换,它就会被更新。总体来说,PyTorch 的目标用户是研究人员,但它也能用于原型开发,或使用最先进算法的初始生产载荷中。基于此基础上的创建的库也是值得研究的。

Node.js 工具

Retext

Retext 是 Unified 集合的一部分。Unified 是一个接口,能够集成不同的工具和插件以便它们能够高效的工作。Retext 是 Unified 工具中使用的三种语法之一,另外的两个分别是用于 Markdown 的 Remark 和用于 HTML 的 Rehype。这是一个非常有趣的想法,我很高兴看到这个社区的发展。Retext 没有涉及很多的底层技术,更多的是使用插件去完成你在 NLP 任务中想要做的事情。拼写检查、字形修复、情绪检测和增强可读性都可以用简单的插件来完成。总体来说,如果你不想了解底层处理技术又想完成你的任务的话,这个工具和社区是一个不错的选择。

Compromise

Compromise 显然不是最复杂的工具,如果你正在找拥有最先进的算法和最完备的系统的话,它可能不适合你。然而,如果你想要一个性能好、功能广泛、还能在客户端运行的工具的话,Compromise 值得一试。总体来说,它的名字(“折中”)是准确的,因为作者更关注更具体功能的小软件包,而在功能性和准确性上有所折中,这些小软件包得益于用户对使用环境的理解。

Natural

Natural 包含了常规自然语言处理库所具有的大多数功能。它主要是处理英文文本,但也包括一些其它语言,它的社区也欢迎支持其它的语言。它能够进行令牌化、词干化、分类、语音处理、词频-逆文档频率计算(TF-IDF)、WordNet、字符相似度计算和一些变换。它和 NLTK 有的一比,因为它想要把所有东西都包含在一个包里头,但它更易于使用,而且不一定专注于研究。总的来说,这是一个非常完整的库,目前仍在活跃开发中,但可能需要对底层实现有更多的了解才能完全发挥效力。

Nlp.js

Nlp.js 建立在其他几个 NLP 库之上,包括 Franc 和 Brain.js。它为许多 NLP 组件提供了一个很好的接口,比如分类、情感分析、词干化、命名实体识别和自然语言生成。它也支持一些其它语言,在你处理英语之外的语言时能提供一些帮助。总之,它是一个不错的通用工具,并且提供了调用其他工具的简化接口。在你需要更强大或更灵活的工具之前,这个工具可能会在你的应用程序中用上很长一段时间。

Java 工具

OpenNLP

OpenNLP 是由 Apache 基金会管理的,所以它可以很方便地集成到其他 Apache 项目中,比如 Apache Flink、Apache NiFi 和 Apache Spark。这是一个通用的 NLP 工具,包含了所有 NLP 组件中的通用功能,可以通过命令行或者以包的形式导入到应用中来使用它。它也支持很多种语言。OpenNLP 是一个很高效的工具,包含了很多特性,如果你用 Java 开发生产环境产品的话,它是个很好的选择。

Stanford CoreNLP

Stanford CoreNLP 是一个工具集,提供了统计 NLP、深度学习 NLP 和基于规则的 NLP 功能。这个工具也有许多其他编程语言的版本,所以可以脱离 Java 来使用。它是由高水平的研究机构创建的一个高效的工具,但在生产环境中可能不是最好的。此工具采用双许可证,具有可以用于商业目的的特定许可证。总之,在研究和实验中它是一个很棒的工具,但在生产系统中可能会带来一些额外的成本。比起 Java 版本来说,读者可能对它的 Python 版本更感兴趣。同样,在 Coursera 上最好的机器学习课程之一是斯坦福教授提供的,点此访问其他不错的资源。

CogCompNLP

CogCompNLP 由伊利诺斯大学开发的一个工具,它也有一个相似功能的 Python 版本。它可以用于处理文本,包括本地处理和远程处理,能够极大地缓解你本地设备的压力。它提供了很多处理功能,比如令牌化、词性标注、断句、命名实体标注、词型还原、依存分析和语义角色标注。它是一个很好的研究工具,你可以自己探索它的不同功能。我不确定它是否适合生产环境,但如果你使用 Java 的话,它值得一试。


你最喜欢的开源 NLP 工具和库是什么?请在评论区分享文中没有提到的工具。


via: https://opensource.com/article/19/3/natural-language-processing-tools

作者:Dan Barker 选题:lujun9972 译者:zxp 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

我是会话管理器的铁粉,它是 Chrome 和 Chromium 的小插件,可以保存所有打开的选项卡,为会话命名,并在需要时恢复会话。

它非常有用,特别是如果你像我一样,白天的时候需要在多个“思维活动”之间切换——研究、开发或者阅读新闻。或者你只是单纯地希望记住几天前的工作流(和选项卡)。

在我决定放弃 chromium 上除了 uBlock Origin 之外的所有扩展后,就必须寻找一些替代品了。我的主要目标是使之与浏览器无关,同时会话链接必须保存在文本文件中,这样我就可以享受所有纯文本的好处了。还有什么比 org 模式更好呢 ;)

很久以前我就发现了这个小诀窍:通过命令行获取当前在谷歌 Chrome 中打开的标签 再加上些 elisp 代码:

(require 'cl-lib)

(defun save-chromium-session ()
  "Reads chromium current session and generate org-mode heading with items."
  (interactive)
  (save-excursion
    (let* ((cmd "strings ~/'.config/chromium/Default/Current Session' | 'grep' -E '^https?://' | sort | uniq")
           (ret (shell-command-to-string cmd)))
      (insert
       (concat
        "* "
        (format-time-string "[%Y-%m-%d %H:%M:%S]")
        "\n"
        (mapconcat 'identity
                   (cl-reduce (lambda (lst x)
                                (if (and x (not (string= "" x)))
                                    (cons (concat "  - " x) lst)
                                  lst))
                              (split-string ret "\n")
                              :initial-value (list))
                   "\n"))))))

(defun restore-chromium-session ()
  "Restore session, by openning each link in list with (browse-url).
Make sure to put cursor on date heading that contains list of urls."
  (interactive)
  (save-excursion
    (beginning-of-line)
    (when (looking-at "^\\*")
      (forward-line 1)
      (while (looking-at "^[ ]+-[ ]+\\(http.?+\\)$")
        (let* ((ln (thing-at-point 'line t))
               (ln (replace-regexp-in-string "^[ ]+-[ ]+" "" ln))
               (ln (replace-regexp-in-string "\n" "" ln)))
          (browse-url ln))
        (forward-line 1)))))

那么,它的工作原理是什么呢?

运行上述代码,打开一个新 org 模式文件并调用 M-x save-chromium-session。它会创建类似这样的东西:

* [2019-12-04 12:14:02]
  - https://www.reddit.com/r/emacs/comments/...
  - https://www.reddit.com/r/Clojure
  - https://news.ycombinator.com

也就是任何在 chromium 实例中运行着的 URL。要还原的话,则将光标置于所需日期上然后运行 M-x restore-chromium-session。所有标签都应该恢复了。

以下是我的使用案例,其中的数据是随机生成的:

#+TITLE: Browser sessions

* [2019-12-01 23:15:00]...
* [2019-12-02 18:10:20]...
* [2019-12-03 19:00:12]
  - https://www.reddit.com/r/emacs/comments/...
  - https://www.reddit.com/r/Clojure
  - https://news.ycombinator.com

* [2019-12-04 12:14:02]
  - https://www.reddit.com/r/emacs/comments/...
  - https://www.reddit.com/r/Clojure
  - https://news.ycombinator.com

请注意,用于读取 Chromium 会话的方法并不完美:strings 将从二进制数据库中读取任何类似 URL 字符串的内容,有时这将产生不完整的 URL。不过,你可以很方便地地编辑它们,从而保持会话文件简洁。

为了真正打开标签,elisp 代码中使用到了 browse-url,它可以通过 browse-url-browser-function 变量进一步定制成运行 Chromium、Firefox 或任何其他浏览器。请务必阅读该变量的相关文档。

别忘了把会话文件放在 git、mercurial 或 svn 中,这样你就再也不会丢失会话历史记录了 :)

那么 Firefox 呢?

如果你正在使用 Firefox(最近的版本),并且想要获取会话 URL,下面是操作方法。

首先,下载并编译 lz4json,这是一个可以解压缩 Mozilla lz4json 格式的小工具,Firefox 以这种格式来存储会话数据。会话数据(在撰写本文时)存储在 $HOME/.mozilla/firefox/<unique-name>/sessionstore-backup /recovery.jsonlz4 中。

如果 Firefox 没有运行,则没有 recovery.jsonlz4,这种情况下用 previous.jsonlz4 代替。

要提取网址,尝试在终端运行:

$ lz4jsoncat recovery.jsonlz4 | grep -oP '"(http.+?)"' | sed 's/"//g' | sort | uniq

然后更新 save-chromium-session 为:

(defun save-chromium-session ()
  "Reads chromium current session and converts it to org-mode chunk."
  (interactive)
  (save-excursion
    (let* ((path "~/.mozilla/firefox/<unique-name>/sessionstore-backups/recovery.jsonlz4")
           (cmd (concat "lz4jsoncat " path " | grep -oP '\"(http.+?)\"' | sed 's/\"//g' | sort | uniq"))
           (ret (shell-command-to-string cmd)))
...
;; rest of the code is unchanged

更新本函数的文档字符串、函数名以及进一步的重构都留作练习。


via: https://acidwords.com/posts/2019-12-04-handle-chromium-and-firefox-sessions-with-org-mode.html

作者:Sanel Z 选题:lujun9972 译者:lujun9972 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

对许多开源程序员来说,夜间的工作计划是创造力和生产力来源的关键。

如果你问大多数开发人员更喜欢在什么时候工作,大部人会说他们最高效的时间在晚上。这对于那些在工作之余为开源项目做贡献的人来说更是如此(尽管如此,希望在他们的健康范围内避免透支)。

有些人喜欢从晚上开始,一直工作到凌晨,而另一些人则很早就起床(例如,凌晨 4 点),以便在开始日常工作之前完成大部分编程工作。

这种工作习惯可能会使许多开发人员看起来像个怪人,不合时宜。但是,为什么有这么多的程序员喜欢在非正常时间工作,原因有很多:

制造者日程

根据 保罗·格雷厄姆 Paul Graham 的观点,“生产东西”的人倾向于遵守 制造者日程 —— 他们更愿意以半天或更长时间为单位使用时间。事实上,大多数开发人员也有相同的偏好。(LCTT 译注:保罗·格雷厄姆有一篇文章述及制造者日程和管理者日程。)

一方面,开发人员从事大型抽象系统工作,需要思维空间来处理整个模型。将他们的日程分割成 15 分钟或 30 分钟的时间段来处理电子邮件、会议、电话以及来自同事的打断,工作效果只会适得其反。

另一方面,通常不可能以小时为单位进行有效编程。因为这么短的时间几乎不够让你把思绪放在手头的任务上并开始工作。

上下文切换也会对编程产生不利影响。在晚上工作,开发人员可以避免尽可能多的干扰。在没有不断的干扰的情况下,他们可以花几个小时专注于手头任务,并尽可能提高工作效率。

平和安静的环境

由于晚上或凌晨不太会有来自各种活动的噪音(例如,办公室闲谈、街道上的交通),这使许多程序员感到放松,促使他们更具创造力和生产力,特别是在处理诸如编码之类的精神刺激任务时。

独处与平静,加上他们知道自己将有几个小时不被中断的工作时间,通常会使他们摆脱白天工作计划相关的时间压力,从而产出高质量的工作。

更不用说了,当解决了一个棘手的问题后,没有什么比尽情享受自己最喜欢的午夜小吃更美好的事情了!

沟通

与在公司内工作的程序员相比,从事开源项目的开发人员可以拥有不同的沟通节奏。大多数开源项目的沟通都是通过邮件或 GitHub 上的评论等渠道异步完成的。很多时候,其他程序员在不同的国家和时区,因此实时交流通常需要开发人员变成一个夜猫子。

昏昏欲睡的大脑

这听起来可能违反直觉,但是随着时间的推移,大脑会变得非常疲倦,因此只能专注于一项任务。晚上工作从根本上消除了多任务处理,而这是保持专注和高效的主要障碍。当大脑处于昏昏欲睡的状态时,你是无法保持专注的!

此外,许多开发人员在入睡时思考要解决的问题通常会取得重大进展。潜意识开始工作,答案通常在他们半睡半醒的凌晨时分就出现了。

这不足为奇,因为睡眠可增强大脑功能,可帮助我们理解新信息并进行更有创造性的思考。当解决方案在凌晨出现时,这些开发人员便会起来开始工作,不错过任何机会。

灵活和创造性思考

许多程序员体会到晚上创造力会提升。前额叶皮层,即大脑中与集中能力有关的部分,在一天结束时会感到疲倦。这似乎为某些人提供了更灵活和更具创造性的思考。

匹兹堡大学医学院精神病学助理教授 Brant Hasler 表示:“由于自上而下的控制和‘认知抑制’的减少,大脑可能会解放出来进行更发散的思考,从而使人们更容易地将不同概念之间的联系建立起来。” 结合轻松环境所带来的积极情绪,开发人员可以更轻松地产生创新想法。

此外,在没有干扰的情况下集中精力几个小时,“沉浸在你做的事情中”。这可以帮助你更好地专注于项目并参与其中,而不必担心周围发生的事情。

明亮的电脑屏幕

因为整天看着明亮的屏幕, 许多程序员的睡眠周期被延迟。电脑屏幕发出的蓝光扰乱我们的昼夜节律,延迟了释放诱发睡眠的褪黑激素和提高人的机敏性,并将人体生物钟重置到更晚的时间。从而导致,开发人员往往睡得越来越晚。

来自过去的影响

过去,大多数开发人员是出于必要在晚上工作,因为在白天当公司其他人都在使用服务器时,共享服务器的计算能力支撑不了编程工作,所以开发人员需要等到深夜才能执行白天无法进行的任务,例如测试项目、运行大量的“编码-编译-运行-调试”周期以及部署新代码。现在尽管服务器功能变强大了,大多数可以满足需求,但夜间工作的趋势仍是这种文化的一部分。

结语

尽管开发人员喜欢在晚上工作的原因很多,但请记住,做为夜猫子并不意味着你应该克扣睡眠时间。睡眠不足会导致压力和焦虑,并最终导致倦怠。

获得足够质量的睡眠是维持良好身体健康和大脑功能的关键。例如,它可以帮助你整合新信息、巩固记忆、创造性思考、清除身体积聚的毒素、调节食欲并防止过早衰老。

无论你是哪种日程,请确保让你的大脑得到充分的休息,这样你就可以在一整天及每天的工作中发挥最大的作用!


via: https://opensource.com/article/20/2/why-developers-code-night

作者:Matt Shealy 选题:lujun9972 译者:Morisun029 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

无论你是手动安装还是通过包管理器安装,插件都可以帮助你在工作流中打造一个完美的 Vim 。

虽然 Vim 是快速且高效的,但在默认情况下,它仅仅只是一个文本编辑器。至少,这就是没有插件的情况 Vim 应当具备的样子,插件构建在 Vim 之上,并添加额外的功能,使 Vim 不仅仅是一个输入文本的窗口。有了合适的插件组合,你可以控制你的生活,形成你自己独特的 Vim 体验。你可以自定义你的主题,你可以添加语法高亮,代码 linting,版本跟踪器等等。

怎么安装 Vim 插件

Vim 可以通过插件进行扩展,但很长一段时间以来,并没有官方的安装方式去安装这些插件。从 Vim 8 开始,有一个关于插件如何安装和加载的结构。你可能会在网上或项目自述文件中遇到旧的说明,但只要你运行 Vim 8 或更高版本,你应该根据 Vim 的官方插件安装方法安装或使用 Vim 包管理器。你可以使用包管理器,无论你运行的是什么版本(包括比 8.x 更老的版本),这使得安装过程比你自己维护更新更容易。

手动和自动安装方法都值得了解,所以请继续阅读以了解这两种方法。

手动安装插件(Vim 8 及以上版本)

所谓的 “Vim 包”是一个包含一个或多个插件的目录。默认情况下,你的 Vim 设置包含在 ~/.vim 中,这是 Vim 在启动时寻找插件的地方。(下面的示例使用了通用名称 vendor 来表示插件是从其它地方获得的。)

当你启动 Vim 时,它首先处理你的 .vimrc文件,然后扫描 ~/.vim 中的所有目录,查找包含在 pack/*/start 中的插件。

默认情况下,你的 ~/.vim 目录(如果你有的话)中没有这样的文件结构,所以设置为:

$ mkdir -p ~/.vim/pack/vendor/start

现在,你可以将 Vim 插件放在 ~/.vim/pack/vendor/start 中,它们会在你启动 Vim 时自动加载。

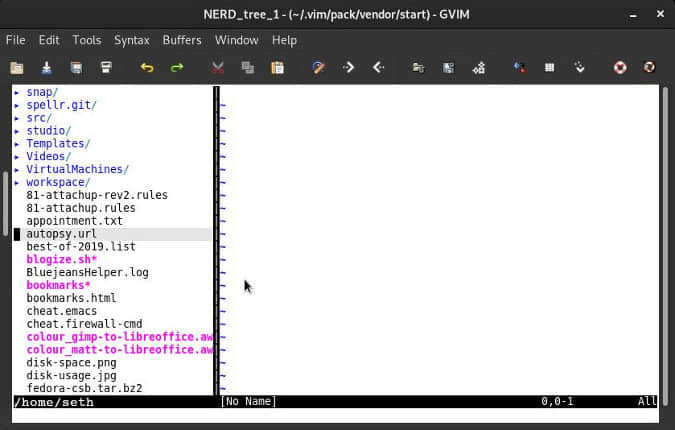
例如,尝试安装一下 NERDTree,这是一个基于文本的 Vim 文件管理器。首先,使用 Git 克隆 NERDTree 存储库的快照:

$ git clone --depth 1 \
  https://github.com/preservim/nerdtree.git \
  ~/.vim/pack/vendor/start/nerdtree

启动 Vim 或者 gvim,然后键入如下命令:

:NERDTree

Vim 窗口左侧将打开一个文件树。

 title=

如果你不想让一个插件每次启动 Vim 时都自动加载,你可以在 ~/.vim/pack/vendor 中创建 opt 文件夹:

$ mkdir ~/.vim/pack/vendor/opt

任何安装到 opt 的插件都可被 Vim 使用,但是只有当你使用 packadd 命令将它们添加到一个会话中时,它们才会被加载到内存中。例如,一个虚构的叫 foo 的插件:

:packadd foo

Vim 官方建议每个插件项目在 ~/.Vim/pack 中创建自己的目录。例如,如果你要安装 NERDTree 插件和假想的 foo 插件,你需要创建这样的目录结构:

$ mkdir -p ~/.vim/pack/NERDTree/start/
$ git clone --depth 1 \
  https://github.com/preservim/nerdtree.git \
  ~/.vim/pack/NERDTree/start/NERDTree
$ mkdir -p ~/.vim/pack/foo/start/
$ git clone --depth 1 \
  https://notabug.org/foo/foo.git \
  ~/.vim/pack/foo/start/foo

这样做是否方便取决于你。

使用 Vim 包管理器(任何 Vim 版本)

自从 Vim 8 以后,包管理器变得不那么有用了,但是一些用户仍然喜欢它们,因为它们能够自动更新一些插件。有几个包管理器可供选择,并且它们各不相同,但是 vim-plug 有一些很棒的特性和最好的文档,这使我们很容易开始并在以后深入研究。

使用 vim-plug 安装插件

安装 vim-plug,以便它在启动时自动加载:

$ curl -fLo ~/.vim/autoload/plug.vim --create-dirs \
  https://raw.githubusercontent.com/junegunn/vim-plug/master/plug.vim

创建一个 ~/.vimrc 文件(如果你还没有这个文件),然后输入以下文本:

call plug#begin()
Plug 'preservim/NERDTree'
call plug#end()

每次要安装插件时,都必须在 plug#begin() 和 plug#end() 之间输入插件的名称和位置(上面以 NERDTree 文件管理器为例)。如果你所需的插件未托管在 GitHub 上,你可以提供完整的 URL,而不仅仅是 GitHub 的用户名和项目 ID。你甚至可以在 ~/.vim 目录之外“安装”本地插件。

最后,启动 Vim 并提示 vim-plug 安装 ~/.vimrc 中列出的插件:

:PlugInstall

等待插件下载。

通过 vim-plug 更新插件

与手动安装过程相比,编辑 ~/.vimrc 并使用命令来进行安装可能看起来并没有多省事,但是 vim-plug 的真正优势在更新。更新所有安装的插件,使用这个 Vim 命令:

:PlugUpdate

如果你不想更新所有的插件,你可以通过添加插件的名字来更新任何插件:

:PlugUpdate NERDTree

恢复插件

vim-plug 的另一个优点是它的导出和恢复功能。Vim 用户都知道,正是插件的缘故,通常每个用户使用 Vim 的工作方式都是独一无二的。一旦你安装和配置了正确的插件组合,你最不想要的局面就是再也找不到它们。

Vim-plug 有这个命令来生成一个脚本来恢复所有当前的插件:

:PlugSnapshot ~/vim-plug.list

vim-plug 还有许多其他的功能,所以请参考它的项目页面以获得完整的文档。

打造一个完美的 Vim

当你整天都在做一个项目时,你希望每一个小细节都能为你提供最好的服务。了解 Vim 和它的许多插件,直到你为你所做的事情构建出一个完美的应用程序。

有喜欢的 Vim 插件吗?请在评论中告诉我们吧!


via: https://opensource.com/article/20/2/how-install-vim-plugins

作者:Seth Kenlon 选题:lujun9972 译者:qianmingtian 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

Microsoft Defender ATP 将保护所有现代工作场所环境

微软宣布了针对 Linux 的 Microsoft Defender 高级威胁防护 ( Advanced Threat Protection ) (ATP)防病毒软件的公开预览版,正如 ZDNet 报道的那样,它将在 2020 年的某个时候发布。

在微软去年增加了对 macOS 的支持并将其名称从 Windows Defender ATP 更改为 Microsoft Defender ATP 之后,新的 Defender Linux 端点保护软件在桌面上进一步完善了 Microsoft Defender ATP。

接下来,微软希望增加对移动设备的支持,将 Microsoft Defender 引入 iOS 和 Android,并将在本周的 RSA Conference上 发布预览版。

微软威胁防护产品的副总裁 Moti Gindi 表示:“我们的目标是将保护带到所有现代工作场所环境,无论是微软环境还是非微软环境。我们正在保护 Mac 上的端点设备,而今天,我们要将端点保护延伸到 Linux 以及 iOS 和 Android 上。”

MTP 全面可用

微软还宣布了 Microsoft Threat Protection(MTP)全面可用,该服务捆绑包包括了 Microsoft Defender ATP、Office ATP、Azure ATP 及其云应用程序安全套件。

“我们正在努力在与微软平台直接或间接相关的端点设备、身份、数据和应用程序上保持整体性。”Gindi 说,“当然,许多组织使用 Windows 以及 Office 和 Active Directory 作为协作系统的基础这一事实也意味着我们需要保护这些系统。”

MTP 要依赖于微软对大量信息的访问,这些信息来自不同端点设备、电子邮件帐户、Azure Active Directory 身份和 Office 365 等应用程序。MTP 服务有望通过在单个仪表板上提供安全专家的信息来帮助安全运营中心团队了解这些领域的威胁。

“你必须是该领域的专家,但你还需要成为跨领域的专家——跨端点设备、电子邮件、云、身份和应用程序来将数据统合起来,为检测提供数据基础,甚至是更重要的是补救和预防。”Gindi 解释说。

MTP 还向微软的 Azure Sentinel 提供数据,Azure Sentinel 是基于云的安全信息和事件管理器(SIEM),它是去年 9 月公开发布的。

Sentinel 从操作系统、应用程序、防病毒、数据库和服务器日志等来源收集信息,以为安全团队构建威胁情报。MTP 与 Sentinel 共享这些警报和威胁情报,使安全团队可以查看和管理微软和第三方安全产品中的威胁。

客户可以在 Microsoft 365 E5、Microsoft 365 E5 Security、Office 365 E5、Enterprise Mobility + Security E5 和 Windows E5 上使用 MTP。

微软还通过云计算竞争对手 AWS 来吸引客户。在 2020 年 6 月之前,微软将提供从 AWS CloudTrail data 到 Sentinel 的免费数据导入。AWS CloudTrail data 包括 AWS 服务中所有事件历史记录的日志,90 天后会收取数据保留费,Sentinel 服务旨在帮助安全团队识别和响应 AWS 环境中的威胁。