2019年12月

本文是 24 天 Linux 桌面特别系列的一部分。Openbox 窗口管理器占用很小的系统资源、易于配置、使用愉快。

你可能不知道你使用过 Openbox 桌面:尽管 Openbox 本身是一个出色的窗口管理器,但它还是 LXDE 和 LXQT 等桌面环境的窗口管理器“引擎”,它甚至可以管理 KDE 和 GNOME。除了作为多个桌面的基础之外,Openbox 可以说是最简单的窗口管理器之一,可以为那些不想学习那么多配置选项的人配置。通过使用基于菜单的 obconf 的配置应用,可以像在 GNOME 或 KDE 这样的完整桌面中一样轻松地设置所有常用首选项。

安装 Openbox

你可能会在 Linux 发行版的软件仓库中找到 Openbox,也可以在 Openbox.org 中找到它。如果你已经在运行其他桌面,那么可以安全地在同一系统上安装 Openbox,因为 Openbox 除了几个配置面板之外,不包括任何捆绑的应用。

安装后,退出当前桌面会话,以便你可以登录 Openbox 桌面。默认情况下,会话管理器(KDM、GDM、LightDM 或 XDM,这取决于你的设置)将继续登录到以前的桌面,因此你必须在登录之前覆盖该选择。

要使用 GDM 覆盖它:

 title=

要使用 SDDM 覆盖它:

 title=

配置 Openbox 桌面

默认情况下,Openbox 包含 obconf 应用,你可以使用它来选择和安装主题、修改鼠标行为、设置桌面首选项等。你可能会在仓库中发现其他配置应用,如 obmenu,用于配置窗口管理器的其他部分。

 title=

构建你自己的桌面环境相对容易。它有一些所有常见的桌面组件,例如系统托盘 stalonetray、任务栏 Tint2 或 Xfce4-panel 等几乎你能想到的。任意组合应用,直到拥有梦想的开源桌面为止。

 title=

为何使用 Openbox

Openbox 占用的系统资源很小、易于配置、使用起来很愉悦。它基本不会让你感觉到阻碍,会是一个容易熟悉的系统。你永远不会知道你面前的桌面环境秘密使用了 Openbox 作为窗口管理器(知道如何自定义它会不会很高兴?)。如果开源吸引你,那么试试看 Openbox。


via: https://opensource.com/article/19/12/openbox-linux-desktop

作者:Seth Kenlon 选题:lujun9972 译者:geekpi 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

Python 2 气数将尽,是时候将你的项目从 Python 2 迁移到 Python 3 了。

Python 2.x 很快就要失去官方支持了,尽管如此,从 Python 2 迁移到 Python 3 却并没有想象中那么难。我在上周用了一个晚上的时间将一个 3D 渲染器的前端代码及其对应的 PySide 迁移到 Python 3,回想起来,尽管在迁移过程中无可避免地会遇到一些牵一发而动全身的修改,但整个过程相比起痛苦的重构来说简直是出奇地简单。

每个人都别无选择地有各种必须迁移的原因:或许是觉得已经拖延太久了,或许是依赖了某个在 Python 2 下不再维护的模块。但如果你仅仅是想通过做一些事情来对开源做贡献,那么把一个 Python 2 应用迁移到 Python 3 就是一个简单而又有意义的做法。

无论你从 Python 2 迁移到 Python 3 的原因是什么,这都是一项重要的任务。按照以下三个步骤,可以让你把任务完成得更加清晰。

1、使用 2to3

从几年前开始,Python 在你或许还不知道的情况下就已经自带了一个名叫 2to3 的脚本,它可以帮助你实现大部分代码从 Python 2 到 Python 3 的自动转换。

下面是一段使用 Python 2.6 编写的代码:

#!/usr/bin/env python
# -*- coding: utf-8 -*-
mystring = u'abcdé'
print ord(mystring[-1])

对其执行 2to3 脚本:

$ 2to3 example.py
RefactoringTool: Refactored example.py
--- example.py     (original)
+++ example.py     (refactored)
@@ -1,5 +1,5 @@
 #!/usr/bin/env python
 # -*- coding: utf-8 -*-
 
-mystring = u'abcdé'
-print ord(mystring[-1])
+mystring = 'abcdé'
+print(ord(mystring[-1]))
RefactoringTool: Files that need to be modified:
RefactoringTool: example.py

在默认情况下,2to3 只会对迁移到 Python 3 时必须作出修改的代码进行标示,在输出结果中显示的 Python 3 代码是直接可用的,但你可以在 2to3 加上 -w 或者 --write 参数,这样它就可以直接按照给出的方案修改你的 Python 2 代码文件了。

$ 2to3 -w example.py
[...]
RefactoringTool: Files that were modified:
RefactoringTool: example.py

2to3 脚本不仅仅对单个文件有效,你还可以把它用于一个目录下的所有 Python 文件,同时它也会递归地对所有子目录下的 Python 文件都生效。

2、使用 Pylint 或 Pyflakes

有一些不良的代码在 Python 2 下运行是没有异常的,在 Python 3 下运行则会或多或少报出错误,这种情况并不鲜见。因为这些不良代码无法通过语法转换来修复,所以 2to3 对它们没有效果,但一旦使用 Python 3 来运行就会产生报错。

要找出这种问题,你需要使用 Pylint、Pyflakes(或 flake8 封装器)这类工具。其中我更喜欢 Pyflakes,它会忽略代码风格上的差异,在这一点上它和 Pylint 不同。尽管代码优美是 Python 的一大特点,但在代码迁移的层面上,“让代码功能保持一致”无疑比“让代码风格保持一致”重要得多。

以下是 Pyflakes 的输出样例:

$ pyflakes example/maths
example/maths/enum.py:19: undefined name 'cmp'
example/maths/enum.py:105: local variable 'e' is assigned to but never used
example/maths/enum.py:109: undefined name 'basestring'
example/maths/enum.py:208: undefined name 'EnumValueCompareError'
example/maths/enum.py:208: local variable 'e' is assigned to but never used

上面这些由 Pyflakes 输出的内容清晰地给出了代码中需要修改的问题。相比之下,Pylint 会输出多达 143 行的内容,而且多数是诸如代码缩进这样无关紧要的问题。

值得注意的是第 19 行这个容易产生误导的错误。从输出来看你可能会以为 cmp 是一个在使用前未定义的变量,实际上 cmp 是 Python 2 的一个内置函数,而它在 Python 3 中被移除了。而且这段代码被放在了 try 语句块中,除非认真检查这段代码的输出值,否则这个问题很容易被忽略掉。

    try:
        result = cmp(self.index, other.index)
    except:
        result = 42
       
    return result

在代码迁移过程中,你会发现很多原本在 Python 2 中能正常运行的函数都发生了变化,甚至直接在 Python 3 中被移除了。例如 PySide 的绑定方式发生了变化、importlib 取代了 imp 等等。这样的问题只能见到一个解决一个,而涉及到的功能需要重构还是直接放弃,则需要你自己权衡。但目前来说,大多数问题都是已知的,并且有完善的文档记录。所以难的不是修复问题,而是找到问题,从这个角度来说,使用 Pyflake 是很有必要的。

3、修复被破坏的 Python 2 代码

尽管 2to3 脚本能够帮助你把代码修改成兼容 Python 3 的形式,但对于一个完整的代码库,它就显得有点无能为力了,因为一些老旧的代码在 Python 3 中可能需要不同的结构来表示。在这样的情况下,只能人工进行修改。

例如以下代码在 Python 2.6 中可以正常运行:

class CLOCK_SPEED:
        TICKS_PER_SECOND = 16
        TICK_RATES = [int(i * TICKS_PER_SECOND)
                      for i in (0.5, 1, 2, 3, 4, 6, 8, 11, 20)]

class FPS:
        STATS_UPDATE_FREQUENCY = CLOCK_SPEED.TICKS_PER_SECOND

类似 2to3 和 Pyflakes 这些自动化工具并不能发现其中的问题,但如果上述代码使用 Python 3 来运行,解释器会认为 CLOCK_SPEED.TICKS_PER_SECOND 是未被明确定义的。因此就需要把代码改成面向对象的结构:

class CLOCK_SPEED:
        def TICKS_PER_SECOND():
                TICKS_PER_SECOND = 16
                TICK_RATES = [int(i * TICKS_PER_SECOND)
                        for i in (0.5, 1, 2, 3, 4, 6, 8, 11, 20)]
                return TICKS_PER_SECOND

class FPS:
        STATS_UPDATE_FREQUENCY = CLOCK_SPEED.TICKS_PER_SECOND()

你也许会认为如果把 TICKS_PER_SECOND() 改写为一个构造函数(用 __init__ 函数设置默认值)能让代码看起来更加简洁,但这样就需要把这个方法的调用形式从 CLOCK_SPEED.TICKS_PER_SECOND() 改为 CLOCK_SPEED() 了,这样的改动或多或少会对整个库造成一些未知的影响。如果你对整个代码库的结构烂熟于心,那么你确实可以随心所欲地作出这样的修改。但我通常认为,只要我做出了修改,都可能会影响到其它代码中的至少三处地方,因此我更倾向于不使代码的结构发生改变。

坚持信念

如果你正在尝试将一个大项目从 Python 2 迁移到 Python 3,也许你会觉得这是一个漫长的过程。你可能会费尽心思也找不到一条有用的报错信息,这种情况下甚至会有将代码推倒重建的冲动。但从另一个角度想,代码原本在 Python 2 中就可以运行,要让它能在 Python 3 中继续运行,你需要做的只是对它稍加转换而已。

但只要你完成了迁移,你就得到了这个模块或者整个应用程序的 Python 3 版本,外加 Python 官方的长期支持。


via: https://opensource.com/article/19/12/update-apps-python-3

作者:Seth Kenlon 选题:lujun9972 译者:HankChow 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

Ksnip 让你能轻松地在 Linux 中创建和标记截图。

我最近从 MacOS 切换到了 Elementary OS,这是一个专注于易用性和隐私性的 Linux 发行版。作为用户体验设计师和自由软件支持者,我会经常截图并进行注释。在尝试了几种不同的工具之后,到目前为止,我最喜欢的工具是 Ksnip,它是 GPLv2 许可下的一种开源工具。

 title=

安装

使用你首选的包管理器安装 Ksnip。我通过 Apt 安装了它:

sudo apt-get install ksnip

配置

Ksnip 有许多配置选项,包括:

  • 保存截图的地方
  • 默认截图的文件名
  • 图像采集器行为
  • 光标颜色和宽度
  • 文字字体

你也可以将其与你的 Imgur 帐户集成。

 title=

用法

Ksnip 提供了大量的功能。我最喜欢的 Ksnip 部分是它拥有我需要的所有注释工具(还有一个我没想到的工具!)。

你可以使用以下注释:

  • 钢笔
  • 记号笔
  • 矩形
  • 椭圆
  • 文字

你还可以模糊区域来移除敏感信息。还有使用我最喜欢的新工具:用于在界面上表示步骤的带数字的点。

关于作者

我非常喜欢 Ksnip,因此我联系了作者 Damir Porobic 来了解有关该项目的更多信息。

当我问到是什么启发了他编写 Ksnip 时,他说:

“几年前我从 Windows 切换到 Linux,却没有了在 Windows 中常用的 Windows Snipping Tool。当时的所有其他截图工具要么很大(很多按钮和复杂功能),要么缺少诸如注释等关键功能,所以我决定编写一个简单的 Windows Snipping Tool 克隆版,但是随着时间的流逝,它开始有越来越多的功能。“

这正是我在评估截图工具时发现的。他花时间构建解决方案并免费共享给他人使用,这真是太好了。

至于 Ksnip 的未来,Damir 希望添加全局快捷方式(至少对于 Windows 是这样)和用于新截图的选项卡,并允许该应用在后台运行。GitHub 上的功能请求列表也越来越多。

帮助的方式

Damir 最需要的是帮助开发 Ksnip。他和他的妻子很快就会有孩子了,所以他将没有太多的时间放在这个项目上。不过,他可以检查和接受拉取请求。

此外,此项目还可以通过 Snap 、Flatpak 以及 MacOS 安装包、Windows 安装包等其他安装方式安装。如果你想提供帮助,请查看 Ksnip 的 README 的 Contribution 部分。


此文章最初发表在 Agaric Tech Cooperative 的博客上,并经允许重新发布。

via: https://opensource.com/article/19/12/annotate-screenshots-linux-ksnip

作者:Clayton Dewey 选题:lujun9972 译者:geekpi 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

对于框架、库或者工具来说,怎样做才算是“简单”?也许有很多的定义,但我的理解通常是易于调试。我经常见到人们宣传某个特定的程序、框架、库、文件格式或者其它什么东西是简单的,因为他们会说“看,我只需要这么一点工作量就能够完成某项工作,这太简单了”。非常好,但并不完善。

你可能只编写一次软件,但几乎总要经历好几个调试周期。注意我说的调试周期并不意味着“代码里面有 bug 你需要修复”,而是说“我需要再看一下这份代码来修复 bug”。为了调试代码,你需要理解它,因此“易于调试”延伸来讲就是“易于理解”。

抽象使得程序易于编写,但往往是以难以理解为代价。有时候这是一个很好的折中,但通常不是。大体上,如果能使程序在日后易于理解和调试,我很乐意花更多的时间来写一些东西,因为这样实际上更省时间。

简洁并不是让程序易于调试的唯一方法,但它也许是最重要的。良好的文档也是,但不幸的是好的文档太少了。(注意,质量并不取决于字数!)

这种影响是真是存在的。难以调试的程序会有更多的 bug,即使最初的 bug 数量与易于调试的程序完全相同,而是因为修复 bug 更加困难、更花时间。

在公司的环境中,把时间花在难以修复的 bug 上通常被认为是不划算的投资。而在开源的环境下,人们花的时间会更少。(大多数项目都有一个或多个定期的维护者,但成百上千的贡献者提交的仅只是几个补丁)


这并不全是 1974 年由 Brian W. Kernighan 和 P. J. Plauger 合著的《 编程风格的元素 The Elements of Programming Style 》中的观点:

每个人都知道调试比起编写程序困难两倍。当你写程序的时候耍小聪明,那么将来应该怎么去调试?

我见过许多看起来写起来“极尽精妙”,但却导致难以调试的代码。我会在下面列出几种样例。争论这些东西本身有多坏并不是我的本意,我仅想强调对于“易于使用”和“易于调试”之间的折中。

  • ORM 对象关系映射 库可以让数据库查询变得简单,代价是一旦你想解决某个问题,事情就变得难以理解。
  • 许多测试框架让调试变得困难。Ruby 的 rspec 就是一个很好的例子。有一次我不小心使用错了,结果花了很长时间搞清楚究竟哪里出了问题(因为它给出错误提示非常含糊)。

我在《测试并非万能》这篇文章中写了更多关于以上的例子。

  • 我用过的许多 JavaScript 框架都很难完全理解。Clever(LCTT 译注:一种 JS 框架)的语句一向很有逻辑,直到某条语句不能如你预期的工作,这时你就只能指望 Stack Overflow 上的某篇文章或 GitHub 上的某个回帖来帮助你了。

这些函数库确实让任务变得非常简单,使用它们也没有什么错。但通常人们都过于关注“易于使用”而忽视了“易于调试”这一点。

  • Docker 非常棒,并且让许多事情变得非常简单,直到你看到了这条提示:
ERROR: for elasticsearch Cannot start service elasticsearch:
oci runtime error: container_linux.go:247: starting container process caused "process_linux.go:258:
applying cgroup configuration for process caused \"failed to write 898 to cgroup.procs: write
/sys/fs/cgroup/cpu,cpuacct/docker/b13312efc203e518e3864fc3f9d00b4561168ebd4d9aad590cc56da610b8dd0e/cgroup.procs:
invalid argument\""

或者这条:

ERROR: for elasticsearch Cannot start service elasticsearch: EOF

那么…你怎么看?

  • Systemd 比起 SysV、init.d 脚本更加简单,因为编写 systemd 单元文件比起编写 shell 脚本更加方便。这也是 Lennart Poetterin 在他的 systemd 神话 中解释 systemd 为何简单时使用的论点。

我非常赞同 Poettering 的观点——也可以看 shell 脚本陷阱 这篇文章。但是这种角度并不全面。单元文件简单的背后意味着 systemd 作为一个整体要复杂的多,并且用户确实会受到它的影响。看看我遇到的这个问题和为它所做的修复。看起来很简单吗?


via: https://arp242.net/weblog/easy.html

作者:Martin Tournoij 选题:lujun9972 译者:LuuMing 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

每当需要在线共享代码片段时,我们想到的第一个便是 Pastebin.com,这是 Paul Dixon 于 2002 年推出的在线文本共享网站。现在,有几种可供选择的文本共享服务可以上传和共享文本片段、错误日志、配置文件、命令输出或任何类型的文本文件。如果你碰巧经常使用各种类似于 Pastebin 的服务来共享代码,那么这对你来说确实是个好消息。向 Wgetpaste 打个招呼吧,它是一个命令行 BASH 实用程序,可轻松地将文本摘要上传到类似 Pastebin 的服务中。使用 Wgetpaste 脚本,任何人都可以与自己的朋友、同事或想在类似 Unix 的系统中的命令行中查看/使用/审查代码的人快速共享文本片段。

安装 Wgetpaste

Wgetpaste 在 Arch Linux [Community] 存储库中可用。要将其安装在 Arch Linux 及其变体(如 Antergos 和 Manjaro Linux)上,只需运行以下命令:

$ sudo pacman -S wgetpaste

对于其他发行版,请从 Wgetpaste 网站 获取源代码,并按如下所述手动安装。

首先下载最新的 Wgetpaste tar 文件:

$ wget http://wgetpaste.zlin.dk/wgetpaste-2.28.tar.bz2

提取它:

$ tar -xvjf wgetpaste-2.28.tar.bz2

它将 tar 文件的内容提取到名为 wgetpaste-2.28 的文件夹中。

转到该目录:

$ cd wgetpaste-2.28/

将 wgetpaste 二进制文件复制到 $PATH 中,例如 /usr/local/bin/。

$ sudo cp wgetpaste /usr/local/bin/

最后,使用命令使其可执行:

$ sudo chmod +x /usr/local/bin/wgetpaste

将文本片段上传到类似 Pastebin 的服务中

使用 Wgetpaste 上传文本片段很简单。让我向你展示一些示例。

1、上传文本文件

要使用 Wgetpaste 上传任何文本文件,只需运行:

$ wgetpaste mytext.txt

此命令将上传 mytext.txt 文件的内容。

示例输出:

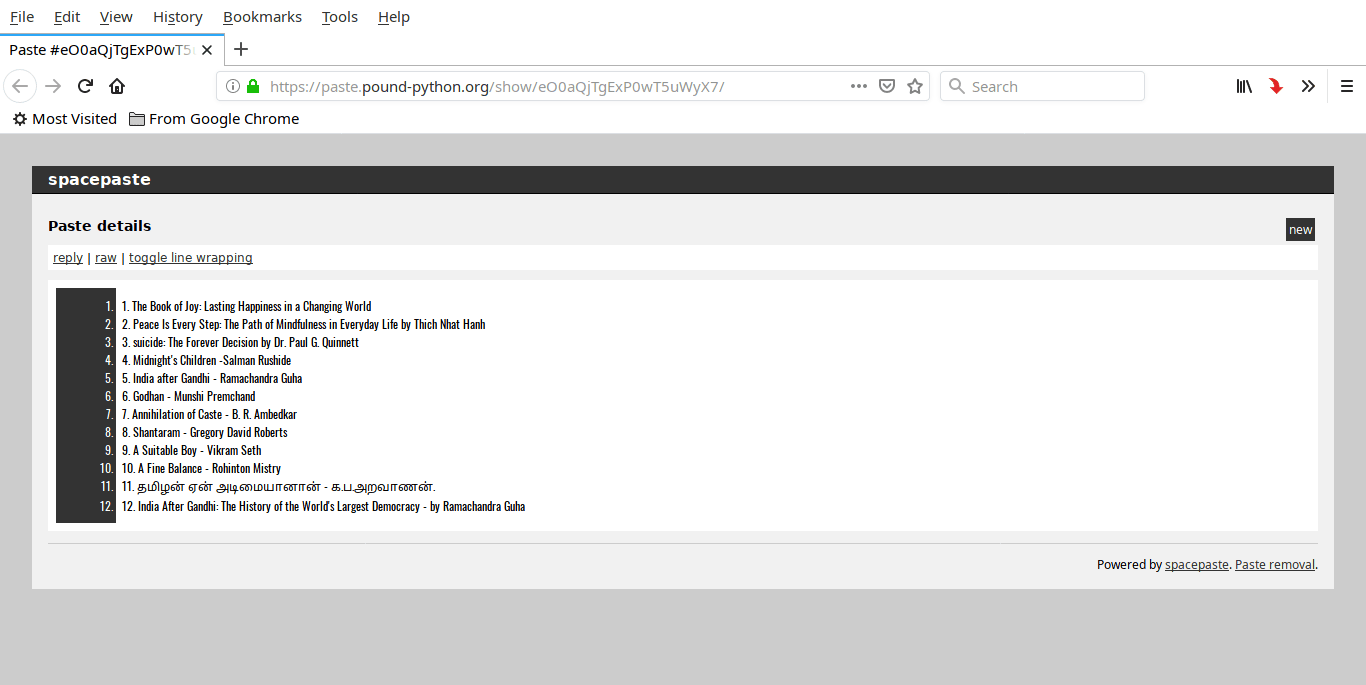
Your paste can be seen here: https://paste.pound-python.org/show/eO0aQjTgExP0wT5uWyX7/

你可以通过邮件、短信、whatsapp 或 IRC 等任何媒体共享 pastebin 的 URL。拥有此 URL 的人都可以访问它,并在他们选择的 Web 浏览器中查看文本文件的内容。

这是 Web 浏览器中 mytext.txt 文件的内容:

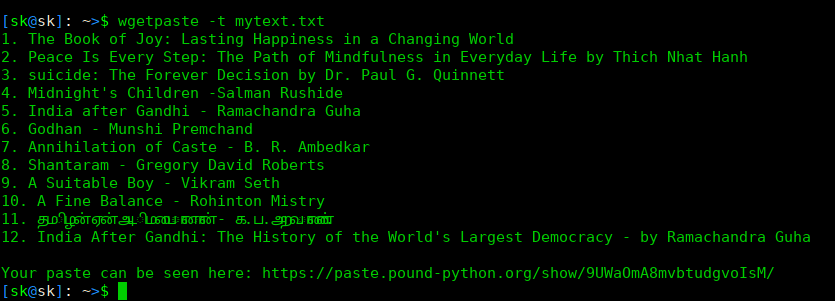
你也可以使用 tee 命令显示粘贴的内容,而不是盲目地上传它们。

为此,请使用如下的 -t 选项。

$ wgetpaste -t mytext.txt

2、将文字片段上传到其他服务

默认情况下,Wgetpaste 会将文本片段上传到 poundpython(https://paste.pound-python.org/)服务。

要查看支持的服务列表,请运行:

$ wgetpaste -S

示例输出:

Services supported: (case sensitive):
Name: | Url:
=============|=================
bpaste | https://bpaste.net/
codepad | http://codepad.org/
dpaste | http://dpaste.com/
gists | https://api.github.com/gists
*poundpython | https://paste.pound-python.org/

在这里,* 表示默认服务。

如你所见,Wgetpaste 当前支持五种文本共享服务。我并没有全部尝试,但是我相信所有服务都可以使用。

要将内容上传到其他服务,例如 bpaste.net,请使用如下所示的 -s 选项。

$ wgetpaste -s bpaste mytext.txt
Your paste can be seen here: https://bpaste.net/show/5199e127e733

3、从标准输入读取输入

Wgetpaste 也可以从标准输入读取。

$ uname -a | wgetpaste

此命令将上传 uname -a 命令的输出。

4、上传命令及命令的输出

有时,你可能需要粘贴命令及其输出。为此,请在如下所示的引号内指定命令的内容。

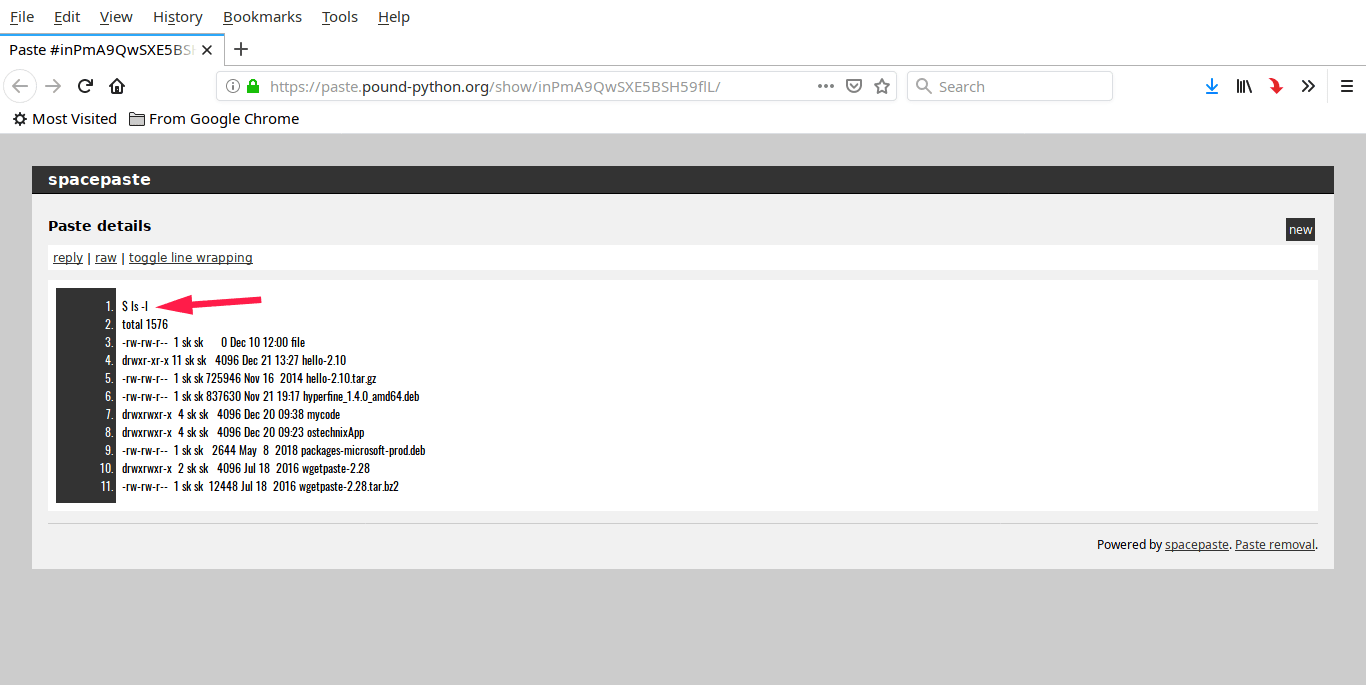
$ wgetpaste -c 'ls -l'

这会将命令 ls -l 及其输出上传到 pastebin 服务。

当你想让其他人清楚地知道你刚运行的确切命令及其输出时,此功能很有用。

如你在输出中看到的,我运行了 ls -l 命令。

5、上载系统日志文件、配置文件

就像我已经说过的,我们可以上载你的系统中任何类型的文本文件,而不仅仅是普通的文本文件,例如日志文件、特定命令的输出等。例如,你刚刚更新了 Arch Linux 机器,最后系统损坏了。你问你的同事该如何解决此问题,他(她)想阅读 pacman.log 文件。 这是上传 pacman.log 文件内容的命令:

$ wgetpaste /var/log/pacman.log

与你的同事共享 pastebin URL,以便他/她可以查看 pacman.log,并通过查看日志文件来帮助你解决问题。

通常,日志文件的内容可能太长,你不希望全部共享它们。在这种情况下,只需使用 cat 命令读取输出,然后使用 tail -n 命令定义要共享的行数,最后将输出通过管道传递到 Wgetpaste,如下所示。

$ cat /var/log/pacman.log | tail -n 50 | wgetpaste

上面的命令将仅上传 pacman.log 文件的“最后 50 行”。

6、将输入网址转换为短链接

默认情况下,Wgetpaste 将在输出中显示完整的 pastebin URL。如果要将输入 URL 转换为短链接,只需使用 -u 选项。

$ wgetpaste -u mytext.txt
Your paste can be seen here: http://tinyurl.com/y85d8gtz

7、设定语言

默认情况下,Wgetpaste 将上传“纯文本”中的文本片段。

要列出指定服务支持的语言,请使用 -L 选项。

$ wgetpaste -L

该命令将列出默认服务(poundpython https://paste.pound-python.org/)支持的所有语言。

我们可以使用 -l 选项来改变它。

$ wgetpaste -l Bash mytext.txt

8、在输出中禁用语法突出显示或 html

如上所述,文本片段将以特定的语言格式(纯文本、Bash 等)显示。

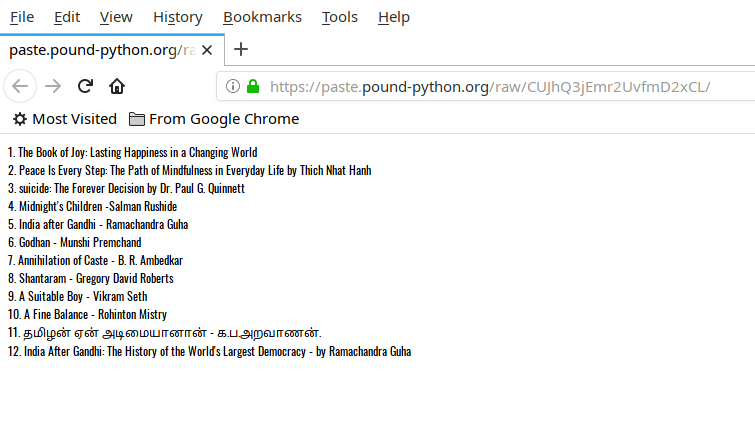
但是,你可以更改此行为,以使用 -r 选项显示原始文本摘要。

$ wgetpaste -r mytext.txt
Your raw paste can be seen here: https://paste.pound-python.org/raw/CUJhQ3jEmr2UvfmD2xCL/

如你在上面的输出中看到的,没有语法突出显示,没有 html 格式。只是原始输出。

9、更改 Wgetpaste 默认值

所有默认值(DEFAULT_{NICK,LANGUAGE,EXPIRATION}[_${SERVICE}] 和 DEFAULT_SERVICE)都可以在 /etc/wgetpaste.conf 中全局更改,也可以在 ~/.wgetpaste.conf 文件中针对每个用户更改。但是,这些文件在我的系统中默认情况下并不存在。我想我们需要手动创建它们。开发人员已经在这里和这里为这两个文件提供了示例内容。只需使用给定的样本内容手动创建这些文件,并相应地修改参数即可更改 Wgetpaste 的默认设置。

10、获得帮助

要显示帮助部分,请运行:

$ wgetpaste -h

via: https://www.ostechnix.com/how-to-easily-upload-text-snippets-to-pastebin-like-services-from-commandline/

作者:SK 选题:lujun9972 译者:wxy 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

随着新一波的区块链热潮,许多同学怀着巨大的热情进入了这个领域,同时也会遇到不少疑惑,区块链开发需要哪些知识?怎么学习?从哪里学习?遇到问题怎么办?本文将试图给区块链领域新人一个快速实用的指引。

一、基本 IT 技能

区块链堪称“黑科技”,本身具有大量的技术元素,有志于从技术角度切入区块链的人,应该具备或掌握基本的 IT 技能,达到至少是常规级别“程序员”或“系统管理员”的技能水平。
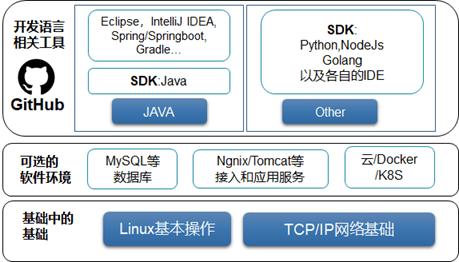
首先需要熟练的 Linux 操作系统知识

大多数区块链系统是可以跑在 Linux 上的,包括 CentOS 和 Ubuntu 等,你至少要会一些基本的 Linux 操作指令,比如 ls 查看目录、ps 或 top 查看进程、find 查找文件、netstat 查看网络、ulimit 检查系统参数限制、df/du 查看磁盘空间、用 apt/yum 安装软件等等,如果这些基本命令都不掌握,在 Linux 上操作肯定是举步维艰的。

这方面的书和资料都很多,相信一星期就能上手。另外,善于 Linux 的 man 指令,可以获得每个命令的详细帮助。如果学会写 shell 脚本,那更如虎添翼,可以把大量的繁琐操作给自动化了。

要有清晰的网络概念

区块链本来是分布式系统,节点之间一定是通过网络相连的,只是跑起来的话,不需要多高深的网络知识,只需要了解什么是 TCP/IP;公网、内网、本地地址的区别;端口如何配置;节点和节点、SDK 和节点之间的互联是否会被防火墙和网络策略挡住;采用 ifconfig、telnet、ping、netstat 等命令检查网络信息和进行探测、定位网络问题。一般来说,Linux 书籍也都会介绍这部分内容。

区块链周边的支持,如浏览器、中间件、业务应用,会依赖一些第三方基础软件,如 MySQL/MariaDB 数据库、Nginx 服务、Tomcat 服务等,至少懂得怎么去安装指定版本的软件,掌握修改这些软件的配置文件并使之生效的基本操作,了解各款软件的密码、权限配置和网络安全策略,以保护自身安全。

如果是基于云、Docker 或者 k8s 等容器环境构建,需要了解使用的服务商或容器的功能、性能、配置方式,包括对资源的分配:CPU、内存、带宽、存储等,以及安全和权限的配置、网络策略配置、运维方式,达到轻松分发构建的同时,还能保持其稳定性和可用性。

各种云服务商和容器解决方案都有周全的文档和客服服务渠道,可以帮助用户顺畅地使用。

到编程语言阶段,可以根据自己的学习路径,选择不同的语言

如果是使用 Java 语言,那就应该熟练掌握 Eclipse、IntelliJ IDEA 等集成 IDE,熟悉 Gradle 为主的工程管理软件,熟悉 Spring、Springboot 等 Java 的基础开发组件,熟悉在 IDE 或命令行下对资源路径如 ApplicationContext 等路径的定义,或许还有 myBatis 等流行的组件,这些都可以在 Java 相关的社区和网站找到资料和书籍。

在熟练使用 Java 语言的情况下,采用 Java SDK 接入到区块链,跑起一个演示示例,将是非常轻松写意的事情。

如果是采用其他语言,我们也提供了 Python、Node.js、Golang 等语言的区块链 SDK。

不同的语言,其安装包有不同的稳定版本,会采用不同的环境和依赖安装配置方法,会有不同的 IDE 和调试方法,就不在本文一一罗列,相信学习和使用语言这件事本身,于程序员已经是最基本的技能了。

最后,作为在开源世界里冲浪的玩家,“全球最大同性交友网站”——GitHub 一定是要上的了

注册 GitHub 账号,掌握 Git 版本管理工具的基本操作,克隆和拉取开源软件代码,提交议题,提交自己的修改,给开源项目提交拉取请求,再顺手点个星标,激情而有范儿,在开源世界里留下你的姓名。

二、区块链领域的基础知识栈

以下部分的知识和区块链或区块链某一个平台更加相关,从底到上依次是:
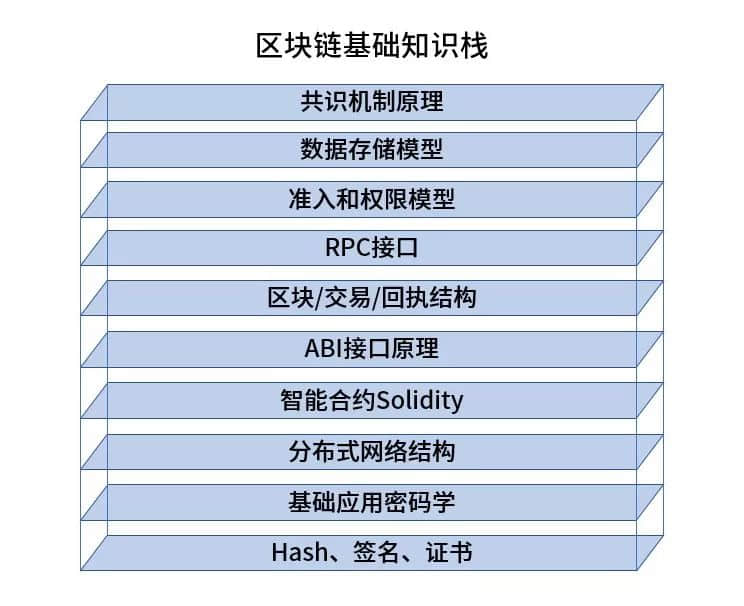
HASH(哈希算法)、签名、证书

严格来说,这并不是区块链领域的专有知识,只是必须具备的基础知识,包括 SHA3/SHA256/RIPEMD160 等摘要算法,以及这些算法和“区块链地址”的关系,基于公私钥的数字签名和验证方法,数字证书的概念和格式,比如 X.509 证书,以及保存证书/公私钥的文件格式,如 PEM 文件、keystore文件等。

基础应用密码学

基础应用密码学其实范围很广,作为入门者,至少要了解对称和非对称加密的常见算法,如 AES 对称加密,RSA、ECDSA 椭圆曲线等非对称加密算法,以及这些算法在签名验签、数据加密、通信协商和保护方面的作用。如果要使用国密,那么需要了解 SM2~SM9 一系列算法的概念和使用。

分布式网络结构

区块链是先天的“分布式网络系统”,节点和节点通过网络的 P2P 端口互连,客户端、SDK 通过 RPC/通道端口互连,首先要保证网络之间是互通的,监听的地址和端口是对的,端口是开放的,防火墙和网络策略是正确的,用于安全连接的证书已经到位,才能保证区块链的“通则不痛”。

这也要求使用者具备基本的网络知识、网络工具,同时了解区块链特有的节点类型(共识节点、观察节点、轻节点等)、互连方式(点对点双向连接、JSON RPC 的 HTTP 短连接、通道长连接等)。详情点击参考《FISCO BCOS 网络端口讲解》。

智能合约

智能合约可说是应用开发者直面区块链的一道大门,入得此门,精彩无穷。流行的智能合约语言是 Solidity 语言,这门源自以太坊,从诞生开始就是为区块链而来的。

Solidity 语言更新活跃、文档完备,具有良好的一致性和事务性,功能足够实现中型的商业应用。

当然,它在实时调试、第三库支持、运行速度等方面还比不上成熟的语言,如果开发者想要用 C++ 等语言编写智能合约,那就要对区块链上的计算范式进行深入了解,避免写出无法共识的智能合约来,一般是建议有深入的了解后再采用 Solidity 之外的其他语言编写合约。

要掌握 Solidity 合约,当然是通读文档,并动手尝试。具体参考该文档。

ABI 接口原理

在采用 EVM 作为虚拟机的区块链上,EVM 执行的是 Solidity 语言的合约。合约编译会生成后缀名为 ABI 的文件,其实里面就是该合约接口定义的 JSON 文本,可以用文本查看器查阅,了解你写的合约如何翻译成 ABI 里的接口,接口返回类型,参数列表,参数类型等,只要有合约的 ABI 文件,就可以调用区块链 SDK 的接口,解析这个合约相关的交易、返回值、回执等。

区块数据结构

区块 ( Block ) 有区块头和区块体。区块体有交易列表,交易列表里的每个 交易 ( Transaction ) (Tx)有发起方、目标地址、调用方法和参数,以及发送者签名。交易的结果会生成一个“ 回执 ( Receipt ) ”,回执里包含被调用方法的返回值、运行过程生成的 EventLog 等……

了解这些,基本上就掌握了区块链数据的脉络,还可以继续深究数据结构里的梅克尔根以及对应的梅克尔树是如何生成的,有什么作用(如用于 SPV:Simplified PaymentVerification)。具体参考该文档。

RPC 接口

这里把区块链节点暴露的功能接口统称为“RPC 接口”。查看链上数据,包括区块、交易、回执、系统信息、配置信息,向链上发起交易,以调用智能合约、修改系统配置等,或者通过 AMOP 协议发送消息、监听事件,都是通过 RPC 接口。

几十个 RPC 接口建议一一走读,或善用搜索,以发现自己想要的接口。

接口通信采用的协议可能是 JSON RPC,或者是 FISCO BCOS 独创的通道协议,SDK 基本上已经对接口和协议进行了良好的包装,也可以在深入理解 ABI 和 RLP 等编码模式前提下自行开发接口客户端。具体参考该文档。

准入和权限模型

联盟链强调安全可控,节点准入是第一步,在链初始化后,其他节点或者 SDK 配置了相应的证书,才能接入到既有的联盟链上。

链上的角色用权限模型控制,包括管理员权限、发布合约的权限、创建表的权限、参数配置权限等,以避免角色之间操作混淆,某些角色既当运动员又当裁判员。

初学者需要仔细阅读区块链平台提供的技术文档了解原理,遵循操作手册的步骤进行操作。具体参考该文档。

数据存储模型

区块链节点会采用文件数据库(LevelDB 或 RocksDB),或者关系型数据库如 MySQL 保存数据,所以,链上是真的有“数据库”的。

写入数据库的数据包括区块、交易、回执、合约产生的状态数据等,是否写入“调用合约产生的历史数据”根据不同的平台而定, FISCO BCOS 默认只保存最新的状态值,可以选择性地将修改记录写入“回执”或“历史表”里进行追踪。

FISCO BCOS 还提供方案,将历史数据导出到链下数据库进行关联分析。具体参考该文档。

共识机制原理

联盟链通常采用插件化共识机制实现,FISCO BCOS 提供 PBFT 和 RAFT 两种高效共识算法,而不会采用“挖矿”这些高耗能低效率的共识。

共识机制是区块链的灵魂,对共识机制进行深入学习,才可以深入理解区块链通过多方协作、达成高度一致性、支持交易事务性、防篡改防作恶的功效。具体参考该文档。

区块链的知识包罗万象,更深层次的知识还有分布式系统理论、博弈论、前沿密码学、经济学、社会学等,掌握以上的基础知识,再深入学习,举一反三,用场景去验证和探索创新式应用,方可发挥技术的潜力,感受分布式商业的魅力。

三、做一个怎样的学习者

在这个过程中,希望学习者做到:

读文档的耐心

我们的开源项目文档足有 20 万字以上的篇幅,公众号里还有大量的技术解析和科普文章,这都是程序员们在编码之外,用尽自己仅有的语文储备,码出的海量文字,是一笔巨大的技术财富,涵盖了相关开源项目的方方面面。如果能通读,或者记住文档结构和标题,需要时快速打开,足以解惑且深入。

搜资料的能力

文档、公众号都有搜索功能,当想起和开源社区有关的问题时,可以随手用关键字搜索,一般都能找到答案。如果有语言不详之处,可以向开源项目团队提出,或者根据自己的理解进行补充。通用的知识点,如操作系统、网络等,通过公网搜索引擎,一般都能找到答案。

排查环境和依赖问题的能力

开源软件牵涉的系统环境、第三方软件、软件的版本等常常有错综复杂的依赖关系,太高或太低的版本都可能会有一些问题,请注意阅读项目文档对软硬件环境和依赖的描述,保证自己的环境符合要求,并善用配置管理工具、软件安装工具获取和设置合适的版本。

调试能力

如上所述,Solidity 语言的调试工具完善程度尚未达到完美,但可以善用合约的返回值、EventLog 等方式,通过 WeBASE、控制台等趁手的工具进行调试,并查阅 Solidity 文档,了解问题可能出在哪里。

区块链节点的日志开启 debug 级别后,也会打印详细的信息,可以查阅运行日志,获取运行信息和可能的错误信息,将这些信息与自己所做的操作比如发交易的流程结合起来进行分析,提高调试效率。

同时,目前的开源软件通常会在屏幕上打印错误原因和解决问题的提示,仔细查看操作反馈,大概率能了解错误原因和解决方案。

代码阅读能力

开源软件的最大效能是把代码毫无遗漏的摊到了开发者和学习者面前,了解代码结构,查阅代码里的关键流程,用关键字去搜索代码里的对应实现,都可以深入系统细节,挖掘设计思想,定位问题,寻找优化方法。一个好学且硬核的程序员,足可通过代码,和世界对话。

问问题的方式方法

“一个好问题,比答案还重要”。我们的社区非常活跃,大家都很热情地答复和解决问题。我们鼓励在社区里公开提出问题,一方面使大家都可以分享问题,找到解决方案,另一方面提问者也可以得到更多人的帮助。同时,希望提问者提出问题时,一次性描述详尽,把相关的操作步骤、系统环境、软件版本、出错提示以及希望得到的解决方案都提出来。

如果是通用性的问题,可以先搜索再提问,有利于培养独立解决问题的能力。希望提问者能向社区反馈更深层次的问题,以帮助社区快速优化。对很多典型问题,社区也积累了一些行之有效的解决方案,我们会整理和公布出来,以便查阅。

从新人到老鸟的路也许漫漫,如果能参考这篇小文的一些方法,可以少踩许多坑,多写一些应用。Enjoy blockchain,社区与你共同进步。

资源链接