2017年9月

26 日,Facebook 发布了 React 16,并如之前承诺的,将 React 16 JavaScript 库以及 GraphQL 查询语言的许可证从原来的 BSD + 专利条款改为更受欢迎的 MIT 许可证。

正如 Facebook 工程总监 Adam Wolff 上周说的,“Facebook 未能说服开发者社区其 BSD + 专利条款的许可证是与开源需求所兼容的”,因此,在招致社区的抗议和抛弃,尤其是在发生了 Apache 基金会将 React 的许可证列入“X 类别”和 WordPress 弃用 React 事件之后,Facebook 表示愿意将这个重要的 JavaScript 基础框架更换成大家更欢迎的 MIT 许可证。

作为最广泛使用的用于构建 Web 用户界面的基础框架,React 的这一许可证的修改得到了社区的强烈反响,虽然有些不同意见,但是大部分人还是表示喜闻乐见——一方面代表了社区的胜利,另外一方面也可以避免大量的采用 React 的项目重写。

不过,也有一些人对 Facebook 采用 MIT 许可证表达了不同的看法。RedMonk 的创始人 Stephen O'Grady 表示,Facebook 采用不包括专利条款的 MIT 许可证,而没有采用包含了更弱的专利条款的 Apache 许可证,相比于原来的 BSD + 专利条款,按倒了葫芦起了瓢。“问题是,通过选择这种方式,Facebook 并没有像在 Apache 许可证下一样在 MIT 许可证中传达任何专利授权……如果 Facebook 在 React 申请了专利,换句话说,该软件的用户并没有被 MIT 许可证授予明确的许可,只有一个未经测试的隐含许可”。

此外,除了 React 16 换用了新的 MIT 之外, Facebook 也将前一天发布的 React 15.6.2 换用了 MIT 许可证,以便那些不方便升级 React 16 的用户使用。

而曾经被 Gitlab 由于该许可证条款而放弃的 GraphQL 也被修改了许可证。作为一个用于规定实现标准的规范,其现在被放在 开放式网络基金会协议 ( Open Web Foundation Agreement (OWFa) v1.0 ) 之下,并且现在 Facebook 的 GraphQL 实现也采用了 MIT 许可证发布。

作为一个广泛使用 JavaScript 框架,这次 React 16 的升级只有很少的破坏性改变,虽然其中大部分库都经过了重写。而新的 React 16 支持异步渲染,允许处理大型组件树而不会阻塞主执行线程。此外,还增加了一些屡屡被要求而难以添加的功能,比如使用错误边界进行异常捕获,和从渲染器返回多个组件。

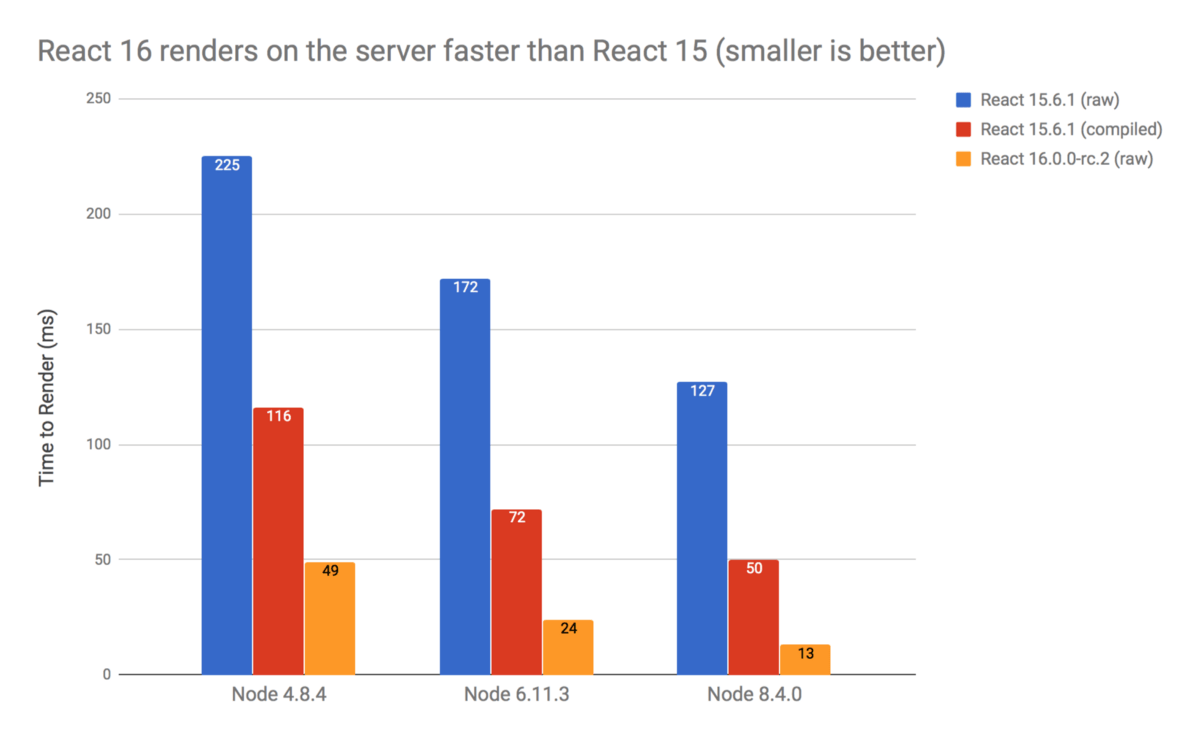
而 React 16 中的服务器端渲染也要比之前的版本快得多,测试表明,其比 Node 4 快 2.4 倍,比 Node 6 快 3 倍,比 Node 8.4 快 3.8 倍。

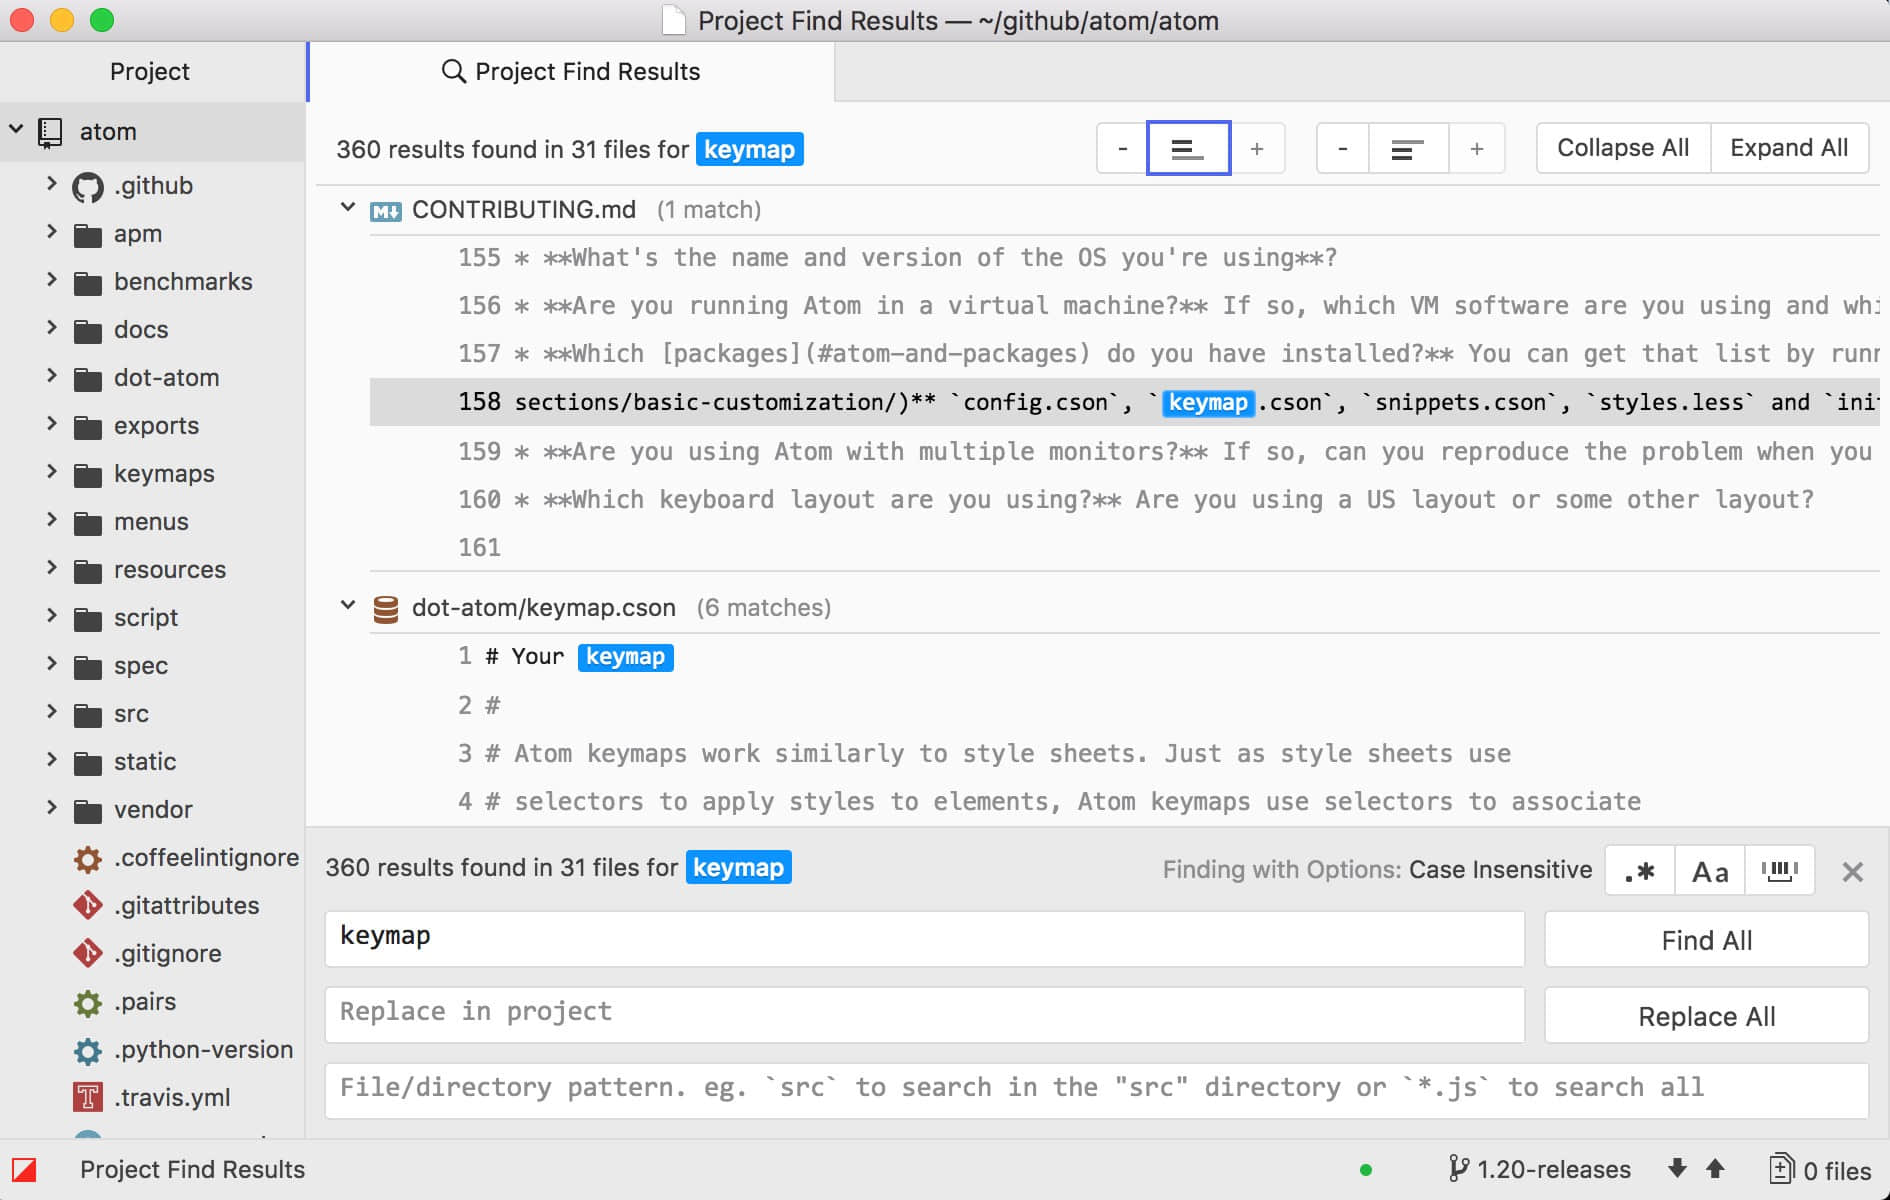
GitHub 和 Facebook 最近发起了一套工具集,它可以让你将你的可魔改 Atom 文本编辑器变身成为 IDE(集成开发环境),他们将这个项目叫做 Atom-IDE。

上周 Atom 1.21 Beta 发布之后,GitHub 引入了 语言服务器协议 ( Language Server Protocol ) 支持以集成其全新打造的 Atom-IDE 项目,它内置带有 5 个流行的语言服务器,包括 JavaScript、TypeScript、 PHP、Java、 C# 和 Flow,而更多的语言服务器正在赶来……

GitHub 的 Damien Guard 解释说:“该 IDE 的每个软件包都提供了基于底层的语言服务器的功能选择,并在打开它所支持的文件时激活。你至少需要安装两个包:Atom IDE 的用户界面和支持该语言的软件包。”

将 Atom 变成 Atom-IDE

如果你想要体验下 Atom 的 IDE 功能,在 Atom-IDE 项目的帮助下这很容易。你只需要在 Atom 的设置窗口中打开安装软件包对话框,并在其中搜索和安装 atom-ide-ui 软件包即可。

这将在你的 Atom 中呈现 IDE 界面,但是要成为一个完全可工作的 IDE ,你还需要安装你的语言服务器支持。目前,你可以从以下五种语言中选择:ide-typescript (TypeScript & JavaScript)、 ide-php (PHP)、 ide-java (Java)、 ide-csharp (C#)以及 ide-flowtype (Flow)。

当然,这些功能需要你安装使用 Atom 1.21 Beta 才能使用,它目前还是 Beta 版本,下个月才会发布正式版本。

旨在推行和保护开源软件的 开源计划 ( Open Source Initiative ) (OSI)26 日宣布,微软最近成为了其白金赞助者。

OSI 的主要目标是通过培训和合作,以及通过基础设施来促进开源技术和开源软件项目发展。没有像 OSI 这样的开源组织,整个开源运动将没有机会成功地成为软件行业的一等公民,而现在专有软件仍占用有利地位。而现在,微软的加入将进一步促进开源软件的发展。

OSI 总经理兼董事 Patrick Masson 说,“广义地说,这是 OSI 和开源软件运动的一个重要里程碑。我觉得没有比这个更能证明开源软件的成熟、生存能力、关注和成功,它不仅得到了微软的认可,而且是作为赞助商支持,以及他们作为贡献者参与这么多开放源项目和社区。”

微软是开源软件项目的领先贡献者

据 OSI,微软是一个领先的贡献者。它对开源社区的贡献是众所周知的,包括与 Canonical 合作定制 Azure 的 ubuntu 内核, 以及 Windows 上的 Linux 子系统(WSL)。

微软也与 Red Hat 和 SUSE 以及 Linux 基金会在各种项目上展开了合作,并与 OSI 成员 FreeBSD 基金会合作,在该公司的 Azure 云平台上支持其 FreeBSD 操作系统。通过加入 OSI,微软会更多地在其产品中集成开源软件。

你可能在各种应用中听说过 机器学习 machine learning (ML),比如垃圾邮件过滤、光学字符识别(OCR)和计算机视觉。

开启机器学习之旅是一个涉及多方面的漫长旅途。对于新手,有很多的书籍,有学术论文,有指导练习,有独立项目。在这些众多的选择里面,很容易迷失你最初想学习的目标。

所以在今天的文章中,我会列出 7 个步骤(和 50 多个资源)帮助你开启这个令人兴奋的计算机科学领域的大门,并逐渐成为一个机器学习高手。

请注意,这个资源列表并不详尽,只是为了让你入门。 除此之外,还有更多的资源。

1、 学习必要的背景知识

你可能还记得 DataCamp 网站上的学习数据科学这篇文章里面的信息图:数学和统计学是开始机器学习(ML)的关键。 基础可能看起来很容易,因为它只有三个主题。 但不要忘记这些实际上是三个广泛的话题。

在这里需要记住两件非常重要的事情:

  • 首先,你一定会需要一些进一步的指导,以了解开始机器学习需要覆盖哪些知识点。
  • 其次,这些是你进一步学习的基础。 不要害怕花时间,有了这些知识你才能构建一切。

第一点很简单:学习线性代数和统计学是个好主意。这两门知识是必须要理解的。但是在你学习的同时,也应该尝试学习诸如最优化和高等微积分等主题。当你越来越深入 ML 的时候,它们就能派上用场。

如果是从零开始的,这里有一些入门指南可供参考:

统计学是学习 ML 的关键之一

如果你更多喜欢阅读书籍,请参考以下内容:

然而,在大多数情况下,你已经对统计学和数学有了一个初步的了解。很有可能你已经浏览过上面列举的的那些资源。

在这种情况下,诚实地回顾和评价你的知识是一个好主意,是否有一些领域是需要复习的,或者现在掌握的比较好的?

如果你一切都准备好了,那么现在是时候使用 R 或者 Python 应用这些知识了。作为一个通用的指导方针,选择一门语言开始是个好主意。另外,你仍然可以将另一门语言加入到你的技能池里。

为什么这些编程知识是必需的?

嗯,你会看到上面列出的课程(或你在学校或大学学习的课程)将为你提供关于数学和统计学主题的更理论性的介绍(而不是应用性的)。 然而,ML 非常便于应用,你需要能够应用你所学到的所有主题。 所以最好再次复习一遍之前的材料,但是这次需要付诸应用。

如果你想掌握 R 和 Python 的基础,可以看以下课程:

当你打牢基础知识后,请查看 DataCamp 上的博客 Python 统计学:40+ 数据科学资源。 这篇文章提供了统计学方面的 40 多个资源,这些资源都是你开始数据科学(以及 ML)需要学习的。

还要确保你查看了关于向量和数组的 这篇 SciPy 教程文章,以及使用 Python 进行科学计算的研讨会。

要使用 Python 和微积分进行实践,你可以了解下 SymPy 软件包。

2、 不要害怕在 ML 的“理论”上浪费时间

很多人并不会花很多精力去浏览理论材料,因为理论是枯燥的、无聊的。但从长远来看,在理论知识上投入时间是至关重要的、非常值得的。 你将会更好地了解机器学习的新进展,也能和背景知识结合起来。 这将有助于你保持学习积极性。

此外,理论并不会多无聊。 正如你在介绍中所看到的,你可以借助非常多的资料深入学习。

书籍是吸收理论知识的最佳途径之一。 它们可以让你停下来想一会儿。 当然,看书是一件非常平静的事情,可能不符合你的学习风格。 不过,请尝试阅读下列书籍,看看它是否适合你:

  • 机器学习教程 Machine Learning textbook , Tom Mitchell 著,书可能比较旧,但是却很经典。这本书很好的解释介绍了机器学习中最重要的课题,步骤详尽,逐层深入。
  • 机器学习: 使数据有意义的算法艺术和科学 Machine Learning: The Art and Science of Algorithms that Make Sense of Data (你可以在这里看到这本书的幻灯片版本):这本书对初学者来说非常棒。 里面讨论了许多实践中的应用程序,其中有一些是在 Tom Mitchell 的书中缺少的。
  • 机器学习之向往 Machine Learning Yearning :这本书由 吴恩达 Andrew Ng 编写的,仍未完本,但对于那些正在学习 ML 的学生来说,这一定是很好的参考资料。
  • 算法与数据结构 Algorithms and Data Structures 由 Jurg Nievergelt 和 Klaus Hinrichs 著。
  • 也可以参阅 Matthew North 的 面向大众的数据挖掘 Data Mining for the Masses 。 你会发现这本书引导你完成一些最困难的主题。
  • 机器学习介绍 Introduction to Machine Learning 由 Alex Smola 和 S.V.N. Vishwanathan 著。

花些时间看书并研究其中涵盖的资料

视频和慕课对于喜欢边听边看来学习的人来说非常棒。 慕课和视频非常的多,多到可能你都很难找到适合你的。 下面列出了最知名的几个:

在这一点上,重要的是要将各种独立的技术融会贯通,形成整体的结构图。 首先了解关键的概念: 监督学习 supervised learning 和 无监督学习 unsupervised learning 的区别、分类和回归等。 手动(书面)练习可以派上用场,能帮你了解算法是如何工作的以及如何应用这些算法。 在大学课程里你经常会找到一些书面练习,可以看看波特兰州立大学的 ML 课程。

3、 开始动手

通过看书和看视频了解理论和算法都非常好,但是需要超越这一阶段,就要开始做一些练习。你要学着去实现这些算法,应用学到的理论。

首先,有很多介绍 Python 和 R 方面的机器学习的基础知识。当然最好的方法就是使用交互式教程:

还请查看以下静态的(非互动的)教程,这些需要你在 IDE 中操作:

除了教程之外,还有一些课程。参加课程可以帮助你系统性地应用学到的概念。 经验丰富的导师很有帮助。 以下是 Python 和机器学习的一些互动课程:
  • 用 scikit-learn 做监督学习: 学习如何构建预测模型,调整参数,并预测在未知数据上执行的效果。你将使用 Scikit-Learn 操作真实世界的数据集。
  • 用 Python 做无监督学习: 展示给你如何从未标记的数据集进行聚类、转换、可视化和提取关键信息。 在课程结束时,还会构建一个推荐系统。
  • Python 深度学习: 你将获得如何使用 Keras 2.0 进行深度学习的实践知识,Keras 2.0 是前沿的 Python 深度学习库 Keras 的最新版本。
  • 在 Python 中应用机器学习: 将学习者引入到机器学习实践中,更多地关注技术和方法,而不是这些方法背后的统计学知识。

理论学习之后,花点时间来应用你所学到的知识。

对于那些正在学习 R 语言机器学习的人,还有这些互动课程:

  • 机器学习介绍 可以让你宏观了解机器学习学科最常见的技术和应用,还可以更多地了解不同机器学习模型的评估和训练。这门课程剩下的部分重点介绍三个最基本的机器学习任务: 分类、回归和聚类。
  • R 语言无监督学习 ,用 R 语言从 ML 角度提供聚类和降维的基本介绍。 可以让你尽快获得数据的关键信息。
  • 实操机器学习涵盖了构建和应用预测功能的基本组成部分,其重点是实际应用。

最后,还有很多书籍以偏向实践的方式介绍了 ML 主题。 如果你想借助书籍内容和 IDE 来学习,请查看这些书籍:

4、 练习

实践比使用 Python 进行练习和修改材料更重要。 这一步对我来说可能是最难的。 在做了一些练习后看看其他人是如何实现 ML 算法的。 然后,开始你自己的项目,阐述你对 ML 算法和理论的理解。

最直接的方法之一就是将练习的规模做得更大些。 要做一个更大的练习,就需要你做更多的数据清理和功能工程。
熟能生巧。

5、 项目

虽然做一些小的练习也不错,但是在最后,您需要做一个项目,可以在其中展示您对使用到的 ML 算法的理解。

最好的练习是实现你自己的 ML 算法。 您可以在以下页面中阅读更多关于为什么您应该做这样的练习,以及您可以从中学到什么内容:

接下来,您可以查看以下文章和仓库。 可以从中获得一些灵感,并且了解他们是如何实现 ML 算法的。
开始时项目可能会很难,但是可以极大增加你的理解。

6、 不要停止

对 ML 的学习永远不能停止,即使你在这个领域工作了十年,总是有新的东西要学习,许多人都将会证实这一点。

例如,ML 趋势,比如 深度学习 deep learning 现在就很受欢迎。你也可以专注于那些现在不怎么火,但是将来会火的话题上。如果你想了解更多,可以看看这个有趣的问题和答案。

当你苦恼于掌握基础知识时,你最先想到的可能不是论文。 但是它们是你紧跟最新研究的一个途径。 论文并不适合刚刚开始学习的人,但是绝对适合高级人员。

其他技术也是需要考虑的。 但是当你刚开始学习时,不要担心这些。 例如,您可以专注于 Python 或 R 语言 (取决于你已经知道哪一个),并把它到你的技能池里。 你可以通过这篇文章来查找一些感兴趣的资源。

如果您还想转向大数据,您可以考虑研究 Spark。 这里有一些有趣的资源:

其他编程语言,比如 Java、JavaScript、C 和 C++ 在 ML 中越来越重要。 从长远来看,您可以考虑将其中一种语言添加到学习列表中。 你可以使用这些博客文章来指导你选择:
学无止境。

7、 利用一切可以利用的资源

机器学习是一个充满难度的话题,有时候可能会让你失去动力。 或者也许你觉得你需要点改变。 在这种情况下,请记住,有很多资源可以让你打消掉这种想法。 查看以下资源:

播客是可以让你继续你的 ML 旅程,紧跟这个领域最新的发展的伟大资源:

当然,还有更多的播客。

文档和软件包源代码是深入了解 ML 算法的实现的两种方法。 查看这些仓库:

  • Scikit-Learn:知名的 Python ML 软件包
  • Keras: Python 深度学习软件包
  • caret: 非常受欢迎的用于分类和回归训练 R 软件包

可视化是深入 ML 理论的最新也是最流行的方式之一。 它们对初学者来说非常棒,但对于更高级的学习者来说也是非常有趣的。 你肯定会被下面这些可视化资源所吸引,它们能让你更加了解 ML 的工作原理:

学习中的一些变化更加能激励你。

现在你可以开始了

现在一切都取决于你自己了。学习机器学习是一个持续的过程,所以开始的越早就会越好。 运用你手边的一切工具开始吧。 祝你好运,并确保让我们知道你的进步。

这篇文章是我基于 Quora 问题(小白该如何开始机器学习)给出的答案。


作者简介:

Karlijn Willems,数据科学记者


via: https://medium.freecodecamp.org/how-machines-learn-a-practical-guide-203aae23cafb

作者:Karlijn Willems 译者:Flowsnow 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出
在开发和部署云原生应用程序时,运行容器化负载的 Kubernetes 平台起到了重大作用。

自然而然的,开发和部署云原生应用程序已经变得非常受欢迎。对于一个允许快速部署和连续交付的 bug 修复和新功能的流程来说,它有明显的优势,但是没有人会谈到鸡和鸡蛋问题:怎样才能达成这样的目的呢?从头开始构建基础设施和开发流程来开发和维护云原生应用程序是个不简单的、耗时的任务。

Kubernetes 是一个相对较新的运行容器化负载的平台,它解决了这些问题。它原本是 Google 内部的一个项目,Kubernetes 在 2015 年被捐赠给了云原生计算基金会,并吸引了来自世界各地开源社区的开发人员。 Kubernetes 的设计基于 Google 15 年的在生产和开发环境运维的经验。由于它是开源的,任何人都可以下载并使用它,并实现其带来的优势。

那么为什么 Kubernetes 会有这么大的惊喜呢?我认为它在像 OpenStack 这样的基础架构即服务(IaaS)和完整的平台即服务 (PaaS)的资源之间达到了最佳平衡,它的底层运行时实现完全由供应商控制。Kubernetes 提供了两个优势:对管理基础设施的抽象,以及深入裸机进行故障排除的工具和功能。

IaaS 与 PaaS

OpenStack 被大多数人归类为 IaaS 解决方案,其中物理资源池(如处理器、网络和存储)在不同用户之间分配和共享。它使用传统的基于硬件的虚拟化实现用户之间的隔离。

OpenStack 的 REST API 允许使用代码自动创建基础架构,但是这就是问题所在。IaaS 产品输出的也是基础设施。其创建后,支持和管理那些更多的基础设施的服务方式并不多。在一定程度上,OpenStack 生产的底层基础架构(如服务器和 IP 地址)成为管理工作的重中之重。一个众所周知的结果是虚拟机(VM)的无序蔓延,而同样的情况也出现于网络、加密密钥和存储卷方面。这样,开发人员建立和维护应用程序的时间就更少了。

像其它基于集群的解决方案一样,Kubernetes 以单个服务器级别的方式运行,以实现水平缩放。它可以轻松添加新的服务器,并立即在新硬件上安排负载。类似地,当服务器没有被有效利用或需要维护时,可以从集群中删除服务器。其它 Kubernetes 可以自动处理的其他任务是编排活动,如工作调度、健康监测和维护高可用性。

网络是另一个可能难以在 IaaS 环境中可靠编排的领域。微服务之间通过 IP 地址通信可能是很棘手的。Kubernetes 实现了 IP 地址管理、负载均衡、服务发现和 DNS 名称注册,以在集群内提供无痛、透明的网络环境。

专为部署而设计

一旦创建了运行应用程序的环境,部署就是一件小事了。可靠地部署一个应用程序是说起来容易做起来难的任务 —— 它并不是最简单的。Kubernetes 相对其他环境的巨大优势是,部署是一等公民。

使用一个单独的 Kubernetes 命令行界面(CLI)的命令,可以描述应用程序并将其安装在群集上。Kubernetes 从初始部署、推出新版本以及(当一个关键功能出现问题时)进行回滚,实现了应用程序的整个生命周期。运行中的部署也可以暂停和恢复。拥有现成的、内置的工具和支持应用程序部署,而不用自己构建部署系统,这是不容小觑的优点。Kubernetes 用户既不必重新发明应用程序部署的轮子,也不会发现这是一项艰巨的任务。

Kubernetes 还可以监控运行中的部署的状态。虽然你可以在 IaaS 环境中像编写部署过程一样编写这个功能,但这是一个非常困难的任务,而这样的情况还比比皆是。

专为 DevOps 而设计

随着你在开发和部署 Kubernetes 应用程序方面获得更多经验,你将沿着与 Google 和其他前行者相同的路径前行。你将发现有几种 Kubernetes 功能对于多服务应用程序的有效开发和故障排除是非常重要的。

首先,Kubernetes 能够通过日志或 SSH(安全 shell)轻松检查正在运行的服务的能力非常重要。通过一条命令行调用,管理员可以检查在 Kubernetes 下运行的服务的日志。这可能听起来像一个简单的任务,但在 IaaS 环境中,除非你已经做了一些工作,否则这并不容易。大型应用程序通常具有专门用于日志收集和分析的硬件和人员。在Kubernetes 中的日志可能不能替代完整功能的日志和指标解决方案,但它足以提供基本的故障排除。

第二,Kubernetes 提供内置的密钥管理。从头开发过自己的部署系统的团队知道的另一个问题是,将敏感数据(如密码和 API 令牌)安全地部署到虚拟机上很困难。通过将密钥管理变成一等公民,Kubernetes 可以避免你的团队发明自己的不安全的、错误的密钥分发系统或在部署脚本中硬编码凭据。

最后,Kubernetes 有一些用于自动进行缩放、负载均衡和重新启动应用程序的功能。同样,这些功能是开发人员在使用 IaaS 或裸机时要自己编写的。你的 Kubernetes 应用程序的缩放和运行状况检查在服务定义中进行声明,而 Kubernetes 会确保正确数量的实例健康运行。

总结

IaaS 和 PaaS 系统之间的差异是巨大的,包括 PaaS 可以节省大量的开发和调试时间。作为一种 PaaS,Kubernetes 实现了强大而有效的功能,可帮助你开发、部署和调试云原生应用程序。它的架构和设计代表了数十年的难得的经验,而你的团队能够免费获得该优势。

(题图:squarespace.com)


作者简介:

Tim Potter - Tim 是 Hewlett Packard Enterprise 的高级软件工程师。近二十年来,他一直致力于自由和开源软件的开发工作,其中包括 Samba、Wireshark、OpenPegasus 和 Docker 等多个项目。Tim 博客在 https://elegantinfrastructure.com/ ,关于 Docker、Kubernetes 和其他基础设施相关主题。


via: https://opensource.com/article/17/6/introducing-kubernetes

作者:Tim Potter 译者:geekpi 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出
本地化 Localization (L10N)在适应项目方面为世界各地的用户发挥着关键作用。

 title=

本地化在定制开源项目以适应世界各地用户的需求方面发挥着核心作用。 除了代码之外,语言翻译也是世界各地人们贡献和参与开源项目的主要方式之一。

有专门针对语言服务行业特有的工具(听到这件事是不是很惊讶?),这使得高品质的本地化过程可以很顺畅。 本地化工具的类别包括:

  • 计算机辅助翻译工具(CAT)
  • 机器翻译引擎(MT)
  • 翻译管理系统(TMS)
  • 术语管理工具
  • 本地化自动化工具

这些工具的专有版本可能相当昂贵。一个 SDL Trados Studio (领先的 CAT 工具)的许可证可能要花费数千欧元,即使这样,它只能一个人使用,并且定制功能也是有限的(注意,它们的费用也很高)。开源项目希望本地化到多种语言,简化本地化过程,所以希望找到开源工具来节省资金,并可以通过定制获得所需的灵活性。我对许多开源本地化工具项目进行了深入的调查,以帮助您决定使用什么。

计算机辅助翻译工具(CAT)

 title=

OmegaT CAT 工具。在这里您可以发现翻译记忆(模糊匹配)和术语回顾(术语表)特性。OmegaT 在 GPL v3 许可证之下发布。

CAT 工具是语言服务行业的主要工具。 顾名思义,CAT 工具可以帮助翻译人员尽快完成翻译、双语审查和单语审查的任务,并通过重用翻译内容(也称为翻译记忆),达到尽可能高的一致性。 翻译记忆 translation memory 和 术语回忆 terminology recall 是 CAT 工具的两个主要特性。它们能够使译者在新项目中重用以前项目中翻译的内容。这使得他们可以在较短的时间内翻译大量的文字,同时通过术语和风格的一致性保持较高水平的质量。这对于本地化特别方便,因为许多软件和 web UI 中的文本在平台和应用程序中通常是相同的。 尽管 CAT 工具是独立的软件,但需要翻译人员在本地使用它们并合并到中央存储库。

可用工具:

机器翻译引擎(MT)

apertium_screenshot.png

机器翻译引擎自动将文本从一种语言翻译到另一种语言。机器翻译引擎被分成三种主要的方法:基于规则、统计式和神经网络式(这是新技术)。最广泛的机器翻译引擎方法是统计式,简而言之,通过使用 n-gram 模型 对带注释的双语语料库数据进行统计分析,得出关于两种语言之间的相互关联性。当将新的源语言短语引入到引擎进行翻译时,它会在其分析的语料库数据中查找与目标语言产生统计相关的对等物。机器翻译引擎可以作为翻译人员的生产力辅助工具,将他们的主要任务从将源文本转换为目标文本,改变为对机器翻译引擎的目标语言输出结果的后期编辑。我不建议在本地化工作中使用原始的机器翻译引擎输出结果,但是如果您的社区接受了后期编辑的培训,那么机器翻译引擎可以成为一个有用的工具,帮助他们做出大量的贡献。

可用工具:

翻译管理系统(TMS)

 title=

如上是 Mozilla 的 Pontoon 翻译管理系统用户界面。使用所见即所得编辑方式,您可以在上下文根据语境翻译内容,在翻译的同时保证质量。 Pontoon 在 BSD 3 句版许可证(新款或修订版)之下发布。

翻译管理系统工具是基于 web 的平台,允许您管理本地化项目,并使翻译人员和审阅人员能够做他们最擅长的事情。 大多数翻译管理系统工具旨在通过包括版本控制系统(VCS)集成、云服务集成、项目报告以及标准的翻译记忆和术语回忆功能,实现本地化过程中的许多手工部分的自动化。这些工具最适合于社区本地化或翻译项目,因为它们允许大量的翻译人员和审阅人员为一个项目做出贡献。一些人还使用所见即所得编辑器为他们的翻译者提供翻译语境。这种增加的语境可以提高翻译的准确性,减少译者在用户界面里翻译和审查翻译之间需要等待的时间。

可用工具:

术语管理工具

 title=

杨百翰大学 (Brigham Young University) 的 BaseTerm 工具显示了新术语条目的对话窗口。 BaseTerm 在 Eclipse 公共许可证之下发布。

术语管理工具为您提供 GUI 来创建术语资源(称为术语库)以添加语境并确保翻译的一致性。这些资源在帮助翻译人员的翻译过程中用于 CAT 工具和 TMS 平台。 对于一个术语基于语境可以是名词或动词的语言,术语管理工具允许您添加标记其词性、方言、单语定义以及上下文线索的术语元数据。 术语管理通常是本地化过程中使用不多的部分,但也是同样重要的部分。 在开源软件和专有软件的生态系统中,只有少量的可选产品。

查看工具

自动本地化工具

 title=

Okapi 框架的 Ratel 和 Rainbow 组件。 图片由 Okapi 框架提供。Okapi 框架在 Apache 许可证 2.0 之下发布。

自动本地化工具便于您处理本地化数据。这可以包括文本提取、文件格式转换、标记化、VCS 同步、术语提取、预翻译和对通用的本地化标准文件格式的各种质量检查。在一些工具套件中,如 Okapi 框架,您可以创建用于执行各种本地化任务的自动化流程。这对于各种情况都非常有用,但是它们的主要功能是通过自动化许多任务来节省时间。它们还可以让你更接近一个根据连续的本地化流程。

查看工具

为什么开源是关键

本地化在开源时是最强力有效的。 这些工具应该让您和您的社区能够将您的项目本地化为尽可能多的语言。

想了解更多吗? 看看这些附加资源:

(题图: opensource.com)


作者简介:

Jeff Beatty - Jeff Beatty 是 Mozilla 公司本地化的负责人, Mozilla 是流行的开源 web 浏览器 Firefox 的制造商。 他拥有利默里克大学(University of Limerick)多语言计算和本地化专业硕士学位。 Jeff 还在全球知名刊物中担任本地化专家,如 《经济学人》 ( The Economist ) 、 《世界报》 ( El Universal ) 、多语种杂志等。 Jeff 旨在展示 Mozilla 的本地化程序,创建颠覆性的开源翻译技术,并充当传播桥梁。


via: https://opensource.com/article/17/6/open-source-localization-tools

作者:Jeff Beatty 译者:TimeBear 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出