2017年2月

PHP 配置默认允许服务器在 HTTP 响应头 X-Powered-By 中显示安装在服务器上的 PHP 版本。

出于服务器安全原因(虽然不是主要的要担心的威胁),建议你禁用或隐藏此信息,避免那些针对你的服务器的攻击者知道你是否运行了 PHP。
假设你服务器上安装的特定版本的 PHP 具有安全漏洞,而攻击者了解到这一点,他们将更容易利用漏洞并通过脚本访问服务器。

在我以前的文章中,我已经展示了如何隐藏 apache 版本号,你已经看到如何不再显示 apache 的安装版本。但是如果你在你的 apache 服务器上运行 PHP,你还需要隐藏 PHP 的安装版本,这我们将在本文中展示。

因此,在本文中,我们将解释如何隐藏或关闭服务器 HTTP 响应头中的 PHP 版本号。

此设置可以在加载的 PHP 配置文件中配置。如果你不知道此配置文件在服务器上的位置,请运行以下命令找到它:

$ php -i | grep "Loaded Configuration File"

PHP 配置文件位置

---------------- 在 CentOS/RHEL/Fedora 上---------------- 
Loaded Configuration File => /etc/php.ini
---------------- 在 Debian/Ubuntu/Linux Mint 上---------------- 
Loaded Configuration File => /etc/php/7.0/cli/php.ini

在对 PHP 配置文件进行任何更改之前,我建议您首先备份您的 PHP 配置文件,如下所示:

----------------在 CentOS/RHEL/Fedora 上---------------- 
$ sudo cp /etc/php.ini /etc/php.ini.orig
---------------- 在 Debian/Ubuntu/Linux Mint 上---------------- 
$ sudo cp /etc/php/7.0/cli/php.ini  /etc/php/7.0/cli/php.ini.orig  

用你最喜欢的编辑器,使用超级用户权限打开文件:

---------------- 在 CentOS/RHEL/Fedora 上---------------- 
$ sudo vi /etc/php.ini
----------------在 Debian/Ubuntu/Linux Mint 上---------------- 
$ sudo vi /etc/php/7.0/cli/php.ini

定位到关键词 expose_php,并将值设置成 Off:

expose_php = Off

保存并退出文件。之后,重启 web 服务器:

---------------- 使用 SystemD ---------------- 
$ sudo systemctl restart httpd  
或
$ sudo systemctl restart apache2 
---------------- 使用 SysVInit ---------------- 
$ sudo service httpd restart  
或
$ sudo service apache2 restart

最后,不过同样重要,使用下面的命令检查服务器 HTTP 响应头是否仍然显示你的 PHP 版本号。

$ lynx -head -mime_header http://localhost 
或者
$ lynx -head -mime_header http://server-address

这里的标志含义是:

  • -head – 发送一个请求 mime 报头的 HEAD 请求。
  • -mime_header – 打印所提取文档的 MIME 标头及其源代码。

注意: 确保你系统中已经安装了命令行 web 浏览器 lynx。

就是这样了!在本文中,我们解释了如何隐藏服务器 HTTP 响应头中的 PHP 版本号以保护 web 服务器免受可能的攻击。你可以在下面的评论栏中留下你的想法或者相关的问题。


作者简介:

Aaron Kili 是 Linux 和 F.O.S.S 爱好者,将来的 Linux SysAdmin 及 web 开发者,目前是 TecMint 的内容创作者,他喜欢用电脑工作,并坚信分享知识。


via: http://www.tecmint.com/hide-php-version-http-header/

作者:Aaron Kili 译者:geekpi 校对:jasminepeng
本文由 LCTT 原创编译,Linux中国 荣誉推出

当远程请求发送到你的 Apache Web 服务器时,在默认情况下,一些有价值的信息,如 web 服务器版本号、服务器操作系统详细信息、已安装的 Apache 模块等等,会随服务器生成的文档发回客户端。

这给攻击者利用漏洞并获取对 web 服务器的访问提供了很多有用的信息。为了避免显示 web 服务器信息,我们将在本文中演示如何使用特定的 Apache 指令隐藏 Apache Web 服务器的信息。

推荐阅读: 13 个有用的 Apache 服务器安全贴士。

两个重要的指令是:

ServerSignature

这允许在服务器生成的文档(如错误消息、modproxy 的 ftp 目录列表、modinfo 输出等等)下添加一个显示服务器名称和版本号的页脚行。

它有三个可能的值:

  • On - 允许在服务器生成的文档中添加尾部页脚行,
  • Off - 禁用页脚行
  • EMail - 创建一个 “mailto:” 引用;用于将邮件发送到所引用文档的 ServerAdmin。

ServerTokens

它决定了发送回客户端的服务器响应头字段是否包含服务器操作系统类型的描述和有关已启用的 Apache 模块的信息。

此指令具有以下可能的值(以及在设置特定值时发送到客户端的示例信息):

ServerTokens   Full (或者不指定) 

发送给客户端的信息: Server: Apache/2.4.2 (Unix) PHP/4.2.2 MyMod/1.2

ServerTokens   Prod[uctOnly] 

发送给客户端的信息: Server: Apache

ServerTokens   Major 

发送给客户端的信息: Server: Apache/2

ServerTokens   Minor 

发送给客户端的信息: Server: Apache/2.4

ServerTokens   Min[imal]

发送给客户端的信息:Server: Apache/2.4.2

ServerTokens   OS 

发送给客户端的信息: Server: Apache/2.4.2 (Unix)

注意:在 Apache 2.0.44 之后,ServerTokens 也控制由 ServerSignature 指令提供的信息。

推荐阅读: 5 个加速 Apache Web 服务器的贴士。

为了隐藏 web 服务器版本号、服务器操作系统细节、已安装的 Apache 模块等等,使用你最喜欢的编辑器打开 Apache 配置文件:

$ sudo vi /etc/apache2/apache2.conf        #Debian/Ubuntu systems
$ sudo vi /etc/httpd/conf/httpd.conf       #RHEL/CentOS systems 

添加/修改/附加下面的行:

ServerTokens Prod
ServerSignature Off 

保存并退出文件,重启你的 Apache 服务器:

$ sudo systemctl apache2 restart  #SystemD
$ sudo sevice apache2 restart     #SysVInit

本篇中,我们解释了如何使用特定的 Apache 指令隐藏Apache web 服务器版本号及其他信息。

如果你在 Apache 中运行 PHP,我建议你隐藏 PHP 版本号。

如往常一样,你可以在评论栏中写下你的想法。


作者简介:

Aaron Kili 是 Linux 和 F.O.S.S 爱好者,将来的 Linux SysAdmin 及 web 开发者,目前是 TecMint 的内容创作者,他喜欢用电脑工作,并坚信分享知识。


via: http://www.tecmint.com/hide-apache-web-server-version-information/

作者:Aaron Kili 译者:geekpi 校对:jasminepeng
本文由 LCTT 原创编译,Linux中国 荣誉推出

无论多么有经验的程序员,开发的任何软件都不可能完全没有 bug。因此,排查及修复 bug 成为软件开发周期中最重要的任务之一。有许多办法可以排查 bug(测试、代码自审等等),但是还有一些专用软件(称为调试器)可以帮助准确定位问题的所在,以便进行修复。

如果你是 C/C++ 程序员,或者使用 Fortran 和 Modula-2 编程语言开发软件,那么你将会很乐意知道有这么一款优秀的调试器 - GDB - 可以帮你更轻松地调试代码 bug 以及其它问题。在这篇文章中,我们将讨论一下 GDB 调试器的基础知识,包括它提供的一些有用的功能/选项。

在我们开始之前,值得一提的是,文章中的所有说明和示例都已经在 Ubuntu 14.04 LTS 中测试过。教程中的示例代码都是 C 语言写的;使用的 shell 为 bash(4.3.11);GDB 版本为 7.7.1。

GDB 调试器基础

通俗的讲,GDB 可以让你看到程序在执行过程时的内部流程,并帮你明确问题的所在。我们将在下一节通过一个有效的示例来讨论 GDB 调试器的用法,但在此之前,我们先来探讨一些之后对你有帮助的基本要点。

首先,为了能够顺利使用类似 GDB 这样的调试器,你必须以指定的方式编译程序,让编译器产生调试器所需的调试信息。例如,在使用 gcc 编译器(我们将在本教程之后的章节用它来编译 C 程序示例)编译代码的时候,你需要使用 -g 命令行选项。

想要了解 gcc 编译器手册页中关于 -g 命令行选项相关的内容,请看这里。

下一步,确保在你的系统中已经安装 GDB 调试器。如果没有安装,而且你使用的是基于 Debian 的系统(如 Ubuntu),那么你就可以使用以下命令轻松安装该工具:

sudo apt-get install gdb

在其他发行版上的安装方法,请看这里。

现在,当你按照上述的方式编译完程序(gcc -g 命令行选项),同时也已经安装好 GDB 调试器,那么你就可以使用以下命令让程序在调试模式中运行:

gdb [可执行程序的名称]

这样做会初始化 GDB 调试器,但你的可执行程序此时还不会被启动。在这个时候你就可以定义调试相关的设置。例如,你可以在特定行或函数中设置一个断点让 GDB 在该行暂停程序的执行。

接着,为了启动你的程序,你必须输入执行以下 gdb 命令:

run

在这里,值得一提的是,如果你的程序需要一些命令行参数,那么你可以在这里指定这些参数。例如:

run [参数]

GDB 提供了很多有用的命令,在调试的时候总是能派的上用场。我们将在下一节讨论其中一部分命令。

GDB 调试器用例

现在我们对 GDB 及其用法有了基本的概念。因此,让我们举例来应用所学的知识。这是一段示例代码:

#include <stdio.h>

int main()
{
    int out = 0, tot = 0, cnt = 0;
    int val[] = {5, 54, 76, 91, 35, 27, 45, 15, 99, 0};

    while(cnt < 10)
    {
        out = val[cnt];
        tot = tot + 0xffffffff/out;
        cnt++;
    }

    printf("\n Total = [%d]\n", tot);
    return 0;
}

简单说明一下这段代码要做什么事。获取 val 数组中每一个值,将其赋值给 out 变量,然后将 tot 之前的值与 0xffffffff/out 的结果值累加,赋值给 tot 变量。

这里遇到的问题是,当执行这段代码编译后的可执行程序时,产生以下错误:

$ ./gdb-test
Floating point exception (core dumped)

因此,要调试这段代码,第一步是使用 -g 选项编译程序。命令如下:

gcc -g -Wall gdb-test.c -o gdb-test

接着,让我们运行 GDB 调试器并指定要调试的可执行程序。命令如下:

gdb ./gdb-test

现在,我刚才得到的错误是 Floating point exception,大部分人可能已经知道,这是因为 n % x,当 x 为 0 时导致的错误。所以,考虑到这一点,我在 11 行代码除法运算的位置处添加了一个断点。如下:

(gdb)&;break 11

注意 (gdb) 是调试器的提示信息,我只输入了 break 11 命令。

现在,让 GDB 开始运行程序:

run

当断点第一次被命中时,GDB 显示如下输出:

Breakpoint 1, main () at gdb-test.c:11
11 tot = tot + 0xffffffff/out;
(gdb)

正如你所看到的那样,调试器会显示断点所在的行代码。现在,让我们打印出此时 out 的值。如下:

(gdb) print out
$1 = 5
(gdb)

如上所示,值 5 被打印出来了。这个时候一切都还是正常的。让调试器继续执行程序直到命中下一个断点,可以通过使用 c 命令来完成:

c

重复上述操作,直到 out 值变为 0 时。

...
...
...
Breakpoint 1, main () at gdb-test.c:11
11 tot = tot + 0xffffffff/out;
(gdb) print out
$2 = 99
(gdb) c
Continuing.

Breakpoint 1, main () at gdb-test.c:11
11 tot = tot + 0xffffffff/out;
(gdb) print out
$3 = 0
(gdb)

现在,为了进一步确认问题,我使用 GDB 的 s(或 step) 命令代替 c 命令。因为,我只想让当前程序在第 11 行之后暂停,再一步步执行,看看这个时候是否会发生崩溃。

以下是执行之后输出信息:

(gdb) s

Program received signal SIGFPE, Arithmetic exception.
0x080484aa in main () at gdb-test.c:11
11 tot = tot + 0xffffffff/out;

是的,如上输出的第一行内容所示,这就是抛出异常的地方。当我再次尝试运行 s 命令时,问题最终也得到了确认:

(gdb) s

Program terminated with signal SIGFPE, Arithmetic exception.
The program no longer exists.

通过这种方式,你就可以使用 GDB 调试你的程序。

总结

GDB 提供了很多功能供用户研究和使用,在这里,我们仅仅只介绍了很少一部分内容。通过 GDB 的手册页可以进一步了解这个工具,当你在调试代码的时候,尝试使用一下它。GDB 调试器有一定的学习难度,但是它很值得你下功夫学习。


via: https://www.howtoforge.com/tutorial/how-to-debug-c-programs-in-linux-using-gdb/

作者:Ansh 译者:zhb127 校对:jasminepeng

本文由 LCTT 原创编译,Linux中国 荣誉推出

网站可靠性工程师 ( Site Reliability Engineer ) 是近来越来越多看到的一个职位。它是什么意思?它来自哪里?让我们从 Google SRE 团队来学习。

本文为 Niall Richard Murphy、Jennifer Petoff、Chris Jones、Betsy Beyer 编辑的 《网站可靠性工程》 Site Reliability Engineering 一书的摘录。

SRE( 网站可靠性工程 ( Site Reliability Engineering ) )在 11 月 7-10 日在阿姆斯特丹举办的 O'Reilly Velocity 会议上也有提到。

介绍

希望不是一种策略。 ( Hope is not a strategy. )

—— 传统的 SRE 如是说

一个公认的事实是系统不会自己运行。 那么,一个系统 — 尤其是复杂大规模系统 — 应该怎么运行呢?

系统管理员的服务管理方法

以前,公司雇用系统管理员来运行复杂的计算系统。

系统管理员(或者称为 sysadmin)这种方式包括整合现有软件组件,使之互相协作来完成一个服务。系统管理员的任务是运行服务,响应事件,并在事件发生时进行更新。随着系统复杂度的增长和流量的增长,事件和更新也相应增长,导致管理员团队也越来越庞大才能完成更多的工作。由于系统管理员的角色需要的技能与产品开发人员有很大不同,开发和系统管理员被分为不同的团队:“开发”和“运维”。

系统管理员模式的服务管理有几个优点。对于决定该如何运行和服务的公司而言,这种方法相对容易实现:它作为一个已被人们所熟悉的行业范例,有很多例子可以从中学习和效仿。相关人才库已经广泛普及。有一系列现有的工具,软件组件(现成的或其他)和集成公司可用于帮助运行这些组装的系统,所以新手系统管理团队不必重新发明轮子以及从头设计系统。

此方式将公司开发和运维分离,也有一些缺点和困难。主要有两类:直接代价和间接代价。

直接代价很显而易见了。利用依靠手工干预来进行变更管理和事件处理的团队进行服务管理,当服务和/或流量增长时,成本是很昂贵的,因为团队随着系统负载的增长也在相应增长。

开发/运维分离的间接代价可能不那么明显,但常常比直接代价还要昂贵。代价来自于两个团队背景,技术,激励都非常不同。他们使用不同的词汇来描述所面临的情境;对技术方案的风险和可能性他们持不同的假设;对产品稳定性的目标级别也会有不同的争议。团队的分离很容易导致不只是激励的不同,还有沟通、目标的不同,以及最终,信任和尊重的分离。这是一种恶性循环。

因此,传统运营团队及其在产品开发中的同行往往会发生冲突,最突出的是如何将软件发布到生产环境。在开发团队的核心上,他们希望推出新功能,并看到它们被用户采纳。在运维团队的核心上, 他们希望确保服务在运行中不会中断。因为大多数中断是由某种变化引起的 - 新的配置、新的功能发布或者新的用户流量类型 - 这两个团队的目标基本上处于紧张状态。

两个团队都明白,以最想要的条款(“我们可以没有阻碍地在任何时间发布任何东西”以及“我们不想在系统工作后改变任何东西”)来表达他们的利益是不可接受的。因为他们的词汇和风险假设都不同,两个团体经常采用常见的斗争形式来提高他们的利益。 运维团队试图通过提高发布和变更门槛来保护运行中的系统免受更改的风险。例如,发布审查可能包含对每个问题的显式审查,这些问题过去都曾经引起过服务中断 - 它可能是一个任意长度的列表,并且不是所有检查元素都一样重要。开发团队很快学会了如何回应。他们通过较少的“发布”和更多的“功能切换”、“增量更新”或 “选择性失明”来规避。他们采取诸如分割产品功能的策略,以便更少的功能受到发布审查。

Google 的服务管理方法:网站可靠性工程

冲突不是提供软件服务的必然部分。Google 选择以不同的方式运行自己的系统:我们的网站可靠性工程团队专注于雇佣软件工程师来运行我们的产品,并创建系统来完成那些本来由系统工程师手动完成的工作。

什么是 网站可靠性工程 ( Site Reliability Engineering ) ,是如它在谷歌定义的那样么?我的解释很简单:SRE 是当你要求一位软件工程师设计一个运维团队时所发生的结果。当我在 2003 年加入 Google 并负责运行一个由 7 名工程师组成的“生产团队”时,那时我工作的全部都是软件工程。所以我以自己是一名 SRE 的方式,设计和管理了一个我想要的团队的样子。这个团队已经成为了 Google 的目前的 SRE 团队,它仍如最初一名终生软件工程师所想象的那个样子。

Google 服务管理方法的主要构成部分是由每个 SRE 团队组成的。作为一个整体,SRE 可以分为两大类。

50-60% 的人是 Google 软件工程师,或者更确切地说,是通过 Google 软件工程师的标准程序招聘的人。其他 40-50% 的候选人非常接近 Google 软件工程师资格(即拥有所需技能集的 85-99%),以及一些具有大多数软件工程师没有的一些 SRE 技术技能的人。到目前为止,UNIX 系统底层和网络(第 1 层到第 3 层)的专业知识是我们寻求的两种最常见的替代技术技能。

所有的 SRE 的共同点是有开发软件系统以解决复杂问题的信念和能力。在 SRE 中,我们密切跟踪两个团队的职业发展,并且迄今为止发现在两种工程师之间的表现没有实际差异。事实上,SRE 团队的多样性背景经常产生聪明、高质量的系统,这显然是几个技能集合成的产物。

我们这样招聘 SRE 的结果是,我们有了这样一个团队:(a)手动执行任务很快会变得无聊。(b)他们有必要的技能集来写出软件以取代以前的手动操作,即使解决方案很复杂。SRE 还会与其他开发部门分享学术以及知识背景。因此,SRE 从根本上做了一个运维团队历来做的工作,但它使用具有软件专业知识的工程师,并期望这些内在倾向于使用软件并且有能力用软件的人用软件设计并实现自动化来代替人力劳动。

按照设计,至关重要的是 SRE 团队专注于工程。没有恒定的工程,运维工作增加,团队将需要更多的人来上工作量。最终,传统的以运维为中心的团队与服务规模呈线性关系:如果服务支持的产品成功,运维工作将随着流量而增长。这意味着雇用更多的人一遍又一遍地完成相同的任务。

为了避免这种命运,负责管理服务的团队需要写代码,否则就会被工作淹没。因此,Google 为 SRE 们设置了一个 “运维” 工作的上限,如任务单、紧急呼叫、手动任务最多只占 50% 工作量。此上限确保 SRE 团队在其计划中有足够的时间使服务稳定及可操作。50% 是上限;随着时间的推移,除了自己的设备,SRE 团队应该只有很少的运维工作,他们几乎可以完全从事开发任务,因为服务基本上可以运行和维修自己:我们想要的系统是自动的,而不只是自动化。在实践中,规模和新功能始终是 SRE 要考虑的。

Google 的经验法则是,SRE 团队必须花费剩余的 50% 的时间来进行实际开发。那么我们该如何执行这个阈值呢?首先,我们必须测量 SRE 如何花费时间。通过测量,我们确保团队不断花费不到 50% 的时间用于开发改变他们实践的工作上。通常这意味着会将一些运维负担转移回开发团队,或者给团队添加新的员工,而不指派该团队额外的运维责任。意识到在运维和开发工作之间保持这种平衡使我们能保证 SRE 具有参与创造性的自主工程的空间,同时仍然保留从运维那学来的智慧。

我们发现 Google SRE 的运行大规模系统的方法有很多优点。由于 SRE 是直接修改代码以使 Google 的系统可以运行自己,SRE 团队的特点是快速创新以及大量接受变革。这样的团队能相对价廉地支持相同的服务,面向运维的团队需要大量的人。相反,运行、维护和改进系统所需的 SRE 的数量随系统的大小而线性收敛。最后,SRE 不仅规避了开发/运维分裂的障碍,而且这种结构也改善了我们的产品开发团队:产品开发和 SRE 团队之间的轻松转移交叉训练了整个团队,并且提高了那些在学习构建百万级别分布式系统上有困难的开发人员的技能。

尽管有这些好处,SRE 模型的特点是其自身独特的挑战。 Google 面临的一个持续挑战是招聘 SRE:SRE 不仅与产品开发招聘流程竞争相同的候选人,而且我们将招聘人员的编码和系统工程技能都设置得如此之高,这意味着我们的招聘池必然很小。由于我们的学科相对新颖独特,在如何建立和管理 SRE 团队方面没有太多的行业信息(不过希望这本书能朝着这个方向迈进!)。一旦 SRE 团队到位,他们潜在的非正统的服务管理方法需要强有力的管理支持。例如,一旦错误预估耗尽,除非是管理层的强制要求, 否则在季度剩余的时间里决定停止发布可能不会被产品开发团队所接受。

DevOps 或者 SRE?

“DevOps” 这个术语在 2008 年末出现,并在写这篇文章时(2016 年早期)仍在发生变动。 其核心原则:IT 部门在系统设计和开发的每个阶段的参与、严重依赖自动化与人力投入、工程实践和工具在操作任务中的应用,与许多 SRE 的原则和实践一致。 人们可以将 DevOps 视为几种核心 SRE原则向更广泛的组织,管理结构和人员的推广。 可以等价地将 SRE 视为具有某些特殊扩展的 DevOps 的特定实现。


作者简介:Benjamin Treynor Sloss 创造了“ 网站可靠性工程 ( Site Reliability Engineering ) ”一词,他自 2003 年以来一直负责 Google 的全球运营、网络和生产工程。截至 2016 年,他管理着全球范围内一个大约 4000 名软硬件和网络工程师团队。


via: https://www.oreilly.com/ideas/what-is-sre-site-reliability-engineering

作者:Benjamin Treynor 译者:geekpi 校对:jasminepeng

本文由 LCTT 原创编译,Linux中国 荣誉推出

假设你在只有自己使用的计算机上运行 Linux 系统,比如在笔记本电脑上,在每次调用 sudo 时需要输入密码,长期下来就会觉得很乏味。因此,在本指南中,我们将描述如何配置 sudo 命令在运行时而不输入密码。

此设置在 /etc/sudoers 文件中完成,这是使用 sudo 命令的默认安全策略;在用户权限指定部分。

重要:在 sudeors 文件中,默认打开的 authenticate 参数用于验证目的。如果设置了它,用户必须通过密码(或其他身份验证方法)进行身份验证,然后才能使用 sudo 运行命令。

但是,可以使用 NOPASSWD(当用户调用 sudo 命令时不需要密码)标记来覆盖此默认值。

配置用户权限的语法如下:

user_list host_list=effective_user_list tag_list command_list

其中:

  1. user_list - 用户列表或已经设置的用户别名。
  2. host_list - 主机列表或用户可以在其上运行 sudo 的主机别名。
  3. effective_user_list - 以该用户或别名运行的用户列表
  4. tag_list - 标签列表,如 NOPASSWD。
  5. command_list - 用户使用 sudo 运行的命令或命令别名列表。

要允许用户(下面的示例中的 aaronkilik)使用 sudo 不输入密码即可运行所有命令,请打开 sudoers 文件:

$ sudo visudo

添加下面的行:

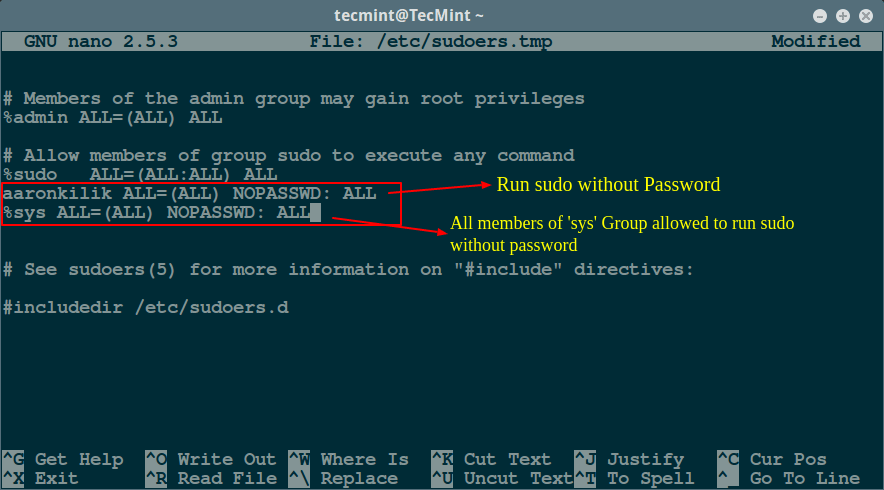
aaronkilik ALL=(ALL) NOPASSWD: ALL

对于组而言,在组名前面使用 % 字符;这意味着 sys 组的所有成员都可以不用密码使用 sudo。

%sys ALL=(ALL) NOPASSWD: ALL

要允许用户不用密码使用 sudo 运行指定命令(/bin/kill),添加下面的行:

aaronkilik ALL=(ALL) NOPASSWD: /bin/kill

下面的行会让 sys 组成员在使用 sudo 运行命令:/bin/kill、/bin/rm 时不用输入密码:

%sys ALL=(ALL) NOPASSWD: /bin/kill, /bin/rm

Run sudo Without Password

不用密码运行 sudo

对于更多的 sudo 配置和其他使用选项,请阅读我们有更多例子描述的文章,:

在本篇中,我们讨论了如何配置 sudo 命令来不用输入密码运行。不要忘记在评论栏中给我们提供你关于这份指导的想法和其他对于 Linux 系统管理员有用的 sudoers 配置。


作者简介:

Aaron Kili 是 Linux 和 F.O.S.S 爱好者,将来的 Linux SysAdmin 及 web 开发者,目前是 TecMint 的内容创作者,他喜欢用电脑工作,并坚信分享知识。


via: http://www.tecmint.com/run-sudo-command-without-password-linux/

作者:Aaron Kili 译者:geekpi 校对:jasminepeng

本文由 LCTT 原创编译,Linux中国 荣誉推出

雷鸟 ( Thunderbird ) 是一个开源自由的跨平台的基于 web 的电子邮件、新闻和聊天客户端应用程序,其旨在用于管理多个电子邮件帐户和新闻源。

Install Thunderbird in Linux

在 2016 年 12 月 28 日,Mozilla 团队宣布 Thunderbird 45.6.0 的发布。这个新版本带有如下功能:

Thunderbird 45.6.0 功能

  1. 每次启动 Thunderbird 时都会显示系统集成对话框
  2. 各种错误修复和性能改进。
  3. 各种安全修复。

查看更多关于 Thunderbird 45.6.0 版本的新功能和已知问题在 Thunderbird 发行说明中有。

本文将解释如何在 Linux 发行版(如 Fedora、Ubuntu 及其衍生版)中安装 Thunderbird 邮件客户端。

在许多 Linux 发行版中,Thunderbird 包已经默认包含在内,并且可以使用默认包管理系统来安装,这样可以:

  1. 确保你具有所有需要的库
  2. 添加桌面快捷方式以启动 Thunderbird
  3. 使 Thunderbird 可供计算机上的所有系统用户访问
  4. 它可能不会为你提供最新版本的 Thunderbird

在 Linux 中安装 Thunderbird 邮件客户端

要从系统默认仓库中安装 Thunderbird:

$ sudo apt-get install thunderbird   [在基于 Ubuntu 的系统中]
$ dnf install thunderbird            [在基于 Fedora 的系统中]

如我所说,从默认仓库中安装的话将带给你的是旧版本 Thunderbird。如果要安装最新版本的 Mozilla Thunderbird,可以使用 Mozilla 团队维护的 PPA。

在 Ubuntu 及其衍生版中使用 CTRL + ALT + T 从桌面打开终端并添加 Thunderbird 仓库。

$ sudo add-apt-repository ppa:ubuntu-mozilla-security/ppa

接下来,使用 apt-get update 命令升级软件包。

$ sudo apt-get update

系统升级完成后,使用下面的命令安装。

$ sudo apt-get install thunderbird

就是这样了,你已经成功在 Linux 中安装了 Thunderbird 45.6.0。在 Thunderbird 下载页中 Thunderbird 还有用于其他操作系统的软件包。


作者简介:

我是 Ravi Saive,TecMint 的创建者。一个喜欢在互联网上分享技巧和提示的计算机 Geek 和 Linux 大师。我的大多数服务器运行在 Linux 开源平台上。在 Twitter、Facebook 和 Google+ 上关注我。


via: http://www.tecmint.com/install-thunderbird-in-ubuntu-fedora-linux/

作者:Ravi Saive 译者:geekpi 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出