2016年10月

你想使用 React 来构建应用吗?“入门”是很容易的,可是接下来呢?

React 是一个构建用户界面的库,而它只是组成一个应用的一部分。应用还有其他的部分——风格、路由器、npm 模块、ES6 代码、捆绑和更多——这就是为什么使用它们的开发者不断流失的原因。这被称为 JavaScript 疲劳。尽管存在这种复杂性,但是使用 React 的用户依旧继续增长。

社区应对这一挑战的方法是共享模版文件。这些模版文件展示出开发者们架构选择的多样性。官方的“开始入门”似乎离一个实际可用的应用程序相去甚远。

新的,零配置体验

受开发者来自 Ember.js 和 Elm 的经验启发,Facebook 的人们想要提供一个简单、直接的方式。他们发明了一个新的开发 React 应用的方法 :create-react-app。在初始的公开版发布的三个星期以来,它已经受到了极大的社区关注(超过 8000 个 GitHub 粉丝)和支持(许多的拉取请求)。

create-react-app 是不同于许多过去使用模板和开发启动工具包的尝试。它的目标是零配置的惯例-优于-配置,使开发者关注于他们的应用的不同之处。

零配置一个强大的附带影响是这个工具可以在后台逐步成型。零配置奠定了工具生态系统的基础,创造的自动化和喜悦的开发远远超越 React 本身。

将零配置部署到 Heroku 上

多亏了 create-react-app 中打下的零配置基础,零配置的目标看起来快要达到了。因为这些新的应用都使用一个公共的、默认的架构,构建的过程可以被自动化,同时可以使用智能的默认项来配置。因此,我们创造这个社区构建包来体验在 Heroku 零配置的过程。

在两分钟内创造和发布 React 应用

你可以免费在 Heroku 上开始构建 React 应用。

npm install -g create-react-app
create-react-app my-app
cd my-app
git init
heroku create -b https://github.com/mars/create-react-app-buildpack.git
git add .
git commit -m "react-create-app on Heroku"
git push heroku master
heroku open

使用构建包文档亲自试试吧。

从零配置出发

create-react-app 非常的新(目前版本是 0.2),同时因为它的目标是简洁的开发者体验,更多高级的使用情景并不支持(或者肯定不会支持)。例如,它不支持服务端渲染或者自定义捆绑。

为了支持更好的控制,create-react-app 包括了 npm run eject 命令。Eject 将所有的工具(配置文件和 package.json 依赖库)解压到应用所在的路径,因此你可以按照你心中的想法定做。一旦被弹出,你做的改变或许有必要选择一个特定的用 Node.js 或静态的构建包来布署。总是通过一个分支/拉取请求来使类似的工程改变生效,因此这些改变可以轻易撤销。Heroku 的预览应用对测试发布的改变是完美的。

我们将会追踪 create-react-app 的进度,当它们可用时,同时适配构建包来支持更多的高级使用情况。发布万岁!


via: https://blog.heroku.com/deploying-react-with-zero-configuration

作者:Mars Hall 译者:zky001 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

如果你在开源项目中花费了很多时间的话,你可能会看到使用的术语 “copyleft”(GNU 官方网站上的释义:中文,英文)。虽然这个术语使用比较普遍,但是很多人却不理解它。软件许可是一个至少不亚于文件编辑器和打包格式的激烈辩论的主题。专家们对 copyleft 的理解可能会充斥在好多书中,但是这篇文章可以作为你理解 copyleft 启蒙之路的起点。

什么是 copyright?

在我们可以理解 copyleft 之前,我们必须先介绍一下 copyright 的概念。copyleft 并不是一个脱离于 copyright 的法律框架,copyleft 存在于 copyright 规则中。那么,什么是 copyright?

它的准确定义随着司法权的不同而不同,但是其本质就是:作品的作者对于作品的 复制 ( copying ) (因此这个术语称之为 “copyright”:copy 's right)、表现等有一定的垄断性。在美国,其宪法明确地阐述了美国国会的任务就是制定版权法律来“促进科学和实用艺术的进步”。

不同于以往,版权会立刻附加到作品上——而且不需要注册。默认情况下,所有的权力都是保留的。也就是说,没有经过作者的允许,没有人可以重新出版、表现或者修改作品。这种“允许”就是一种许可,可能还会附加有一定的条件。

如果希望得到对于 copyright 更彻底的介绍,Coursera 上的教育工作者和图书管理员的著作权是一个非常优秀的课程。

什么是 copyleft?

先不要着急,在我们讨论 copyleft 是什么之前,还有一步。首先,让我们解释一下 开源 ( open source ) 意味着什么。所有的开源许可协议,按照 开源倡议的定义 ( Open Source Inititative's definition ) (规定),除其他形式外,必须以源码的形式发放。获得开源软件的任何人都有权利查看并修改源码。

copyleft 许可和所谓的 “ 自由 ( permissive ) ” 许可不同的地方在于,其衍生的作品中,也需要相同的 copyleft 许可。我倾向于通过这种方式来区分两者不同: 自由 ( permissive ) 许可向直接下游的开发者提供了最大的自由(包括能够在闭源项目中使用开源代码的权力),而 copyleft 许可则向最终用户提供最大的自由。

GNU 项目为 copyleft 提供了这个简单的定义(中文,英文):“ 规则就是当重新分发该程序时,你不可以添加限制来否认其他人对于[自由软件]的自由。 ( the rule that when redistributing the program, you cannot add restrictions to deny other people the central freedoms [of free software]. ) ”这可以被认为权威的定义,因为 GNU 通用许可证 ( GNU General Public License,GPL ) 的各种版本的依然是最广泛使用的 copyleft 许可。

软件中的 copyleft

GPL 家族是最出名的 copyleft 许可,但是它们并不是唯一的。 Mozilla 公共许可协议 ( Mozilla Public License,MPL ) 和 Eclipse 公共许可协议 ( Eclipse Public License,EPL ) 也很出名。很多其它的 copyleft 许可 也有较少的采用。

就像之前章节介绍的那样,一个 copyleft 许可意味着下游的项目不可以在软件的使用上添加额外的限制。这最好用一个例子来说明。如果我写了一个名为 MyCoolProgram 的程序,并且使用 copyleft 许可来发布,你将有使用和修改它的自由。你可以发布你修改后的版本,但是你必须让你的用户拥有我给你的同样的自由。(但)如果我使用 “ 自由 ( permissive ) ” 许可,你将可以将它自由地合并到一个不提供源码的闭源软件中。

对于我的 MyCoolProgram 程序,和你必须能做什么同样重要的是你必须不能做什么。你不必用和我完全一样的许可协议,只要它们相互兼容就行(但一般的为了简单起见,下游的项目也使用相同的许可)。你不必向我贡献出你的修改,但是你这么做的话,通常被认为一个很好的形式,尤其是这些修改是 bug 修复的话。

非软件中的 copyleft

虽然,copyleft 的概念起始于软件世界,但是它也存在于之外的世界。“做你想做的,只要你保留其他人也有做同样的事的权力”的概念是应用于文字创作、视觉艺术等方面的知识共享署名许可(中文,英文)的一个显著的特点(CC BY-SA 4.0 是贡献于 Opensource.com 默认的许可,也是很多开源网站,包括 Linux.cn 在内所采用的内容许可协议)。GNU 自由文档许可证是另一个非软件协议中 copyleft 的例子。在非软件中使用软件协议通常不被建议。

我是否需要选择一种 copyleft 许可?

关于项目应该使用哪一种许可,可以用(已经有了)成篇累牍的文章在阐述。我的建议是首先将许可列表缩小,以满足你的哲学信条和项目目标。GitHub 的 choosealicense.com 是一种查找满足你的需求的许可协议的好方法。tl;drLegal 使用平实的语言来解释了许多常见和不常见的软件许可。而且也要考虑你的项目所在的生态系统,围绕一种特定语言和技术的项目经常使用相同或者相似的许可。如果你希望你的项目可以运行的更出色,你可能需要确保你选择的许可是兼容的。

关于更多 copyleft 的信息,请查看 copyleft 指南。

(题图来自:behance.net)


via: https://opensource.com/resources/what-is-copyleft

作者:Ben Cotton 译者:yangmingming 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

Instagram 目前部署了世界上最大规模的 Django Web 框架(该框架完全使用 Python 编写)。我们最初选用 Python 是因为它久负盛名的简洁性与实用性,这非常符合我们的哲学思想——“先做简单的事情”。但简洁性也会带来效率方面的折衷。Instagram 的规模在过去两年中已经翻番,并且最近已突破 5 亿用户,所以急需最大程度地提升 web 服务效率以便我们的平台能够继续顺利地扩大。在过去的一年,我们已经将 效率计划 ( efficiency program ) 提上日程,并在过去的六个月,我们已经能够做到无需向我们的 Django 层 ( Django tiers ) 添加新的容量来维持我们的用户增长。我们将在本文分享一些由我们构建的工具以及如何使用它们来优化我们的日常部署流程。
为何需要提升效率?

Instagram,正如所有的软件,受限于像服务器和数据中心能源这样的物理限制。鉴于这些限制,在我们的效率计划中有两个我们希望实现的主要目标:

  1. Instagram 应当能够利用持续代码发布正常地提供通信服务,防止因为自然灾害、区域性网络问题等造成某一个数据中心区丢失。
  2. Instagram 应当能够自由地滚动发布新产品和新功能,不必因容量而受阻。

想要实现这些目标,我们意识到我们需要持续不断地监控我们的系统并与 回归 ( regressions ) 进行战斗。

定义效率

Web services 的瓶颈通常在于每台服务器上可用的 CPU 时间。在这种环境下,效率就意味着利用相同的 CPU 资源完成更多的任务,也就是说, 每秒处理更多的用户请求 ( requests per second,RPS ) 。当我们寻找优化方法时,我们面临的第一个最大的挑战就是尝试量化我们当前的效率。到目前为止,我们一直在使用“每次请求的平均 CPU 时间”来评估效率,但使用这种指标也有其固有限制:

  1. 设备多样性。使用 CPU 时间来测量 CPU 资源并非理想方案,因为它同时受到 CPU 型号与 CPU 负载的影响。
  2. 请求影响数据。测量每次请求的 CPU 资源并非理想方案,因为在使用 每次请求测量 ( per-request measurement ) 方案时,添加或移除轻量级或重量级的请求也会影响到效率指标。

相对于 CPU 时间来说,CPU 指令是一种更好的指标,因为对于相同的请求,它会报告相同的数字,不管 CPU 型号和 CPU 负载情况如何。我们选择使用了一种叫做” 每个活动用户 ( per active user ) “的指标,而不是将我们所有的数据关联到每个用户请求上。我们最终采用“ 每个活动用户在高峰期间的 CPU 指令 ( CPU instruction per active user during peak minute ) ”来测量效率。我们建立好新的度量标准后,下一步就是通过对 Django 的分析来更多的了解一下我们的回归。

Django web services 分析

通过分析我们的 Django web services,我们希望回答两个主要问题:

  1. CPU 回归会发生吗?
  2. 是什么导致了 CPU 回归发生以及我们该怎样修复它?

想要回答第一个问题,我们需要追踪“ 每个活动用户的 CPU 指令 ( CPU-instruction-per-active-user ) ”指标。如果该指标增加,我们就知道已经发生了一次 CPU 回归。

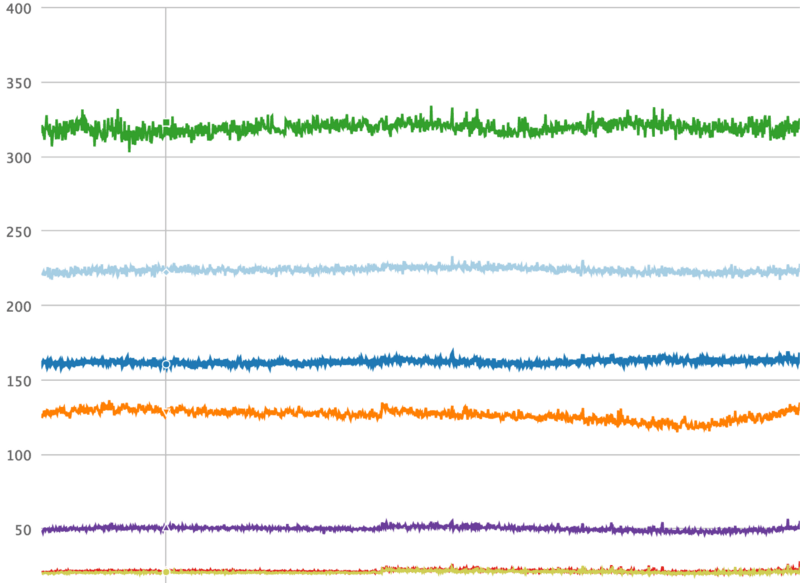
我们为此构建的工具叫做 Dynostats。Dynostats 利用 Django 中间件以一定的速率采样用户请求,记录关键的效率以及性能指标,例如 CPU 总指令数、端到端请求时延、花费在访问内存缓存(memcache)和数据库服务的时间等。另一方面,每个请求都有很多可用于聚合的 元数据 ( metadata ) ,例如端点名称、HTTP 请求返回码、服务该请求的服务器名称以及请求中最新提交的 哈希值 ( hash ) 。对于单个请求记录来说,有两个方面非常强大,因为我们可以在不同的维度上进行切割,那将帮助我们减少任何导致 CPU 回归的原因。例如,我们可以根据它们的端点名称聚合所有请求,正如下面的时间序列图所示,从图中可以清晰地看出在特定端点上是否发生了回归。
CPU 指令对测量效率很重要——当然,它们也很难获得。Python 并没有支持直接访问 CPU 硬件计数器(CPU 硬件计数器是指可编程 CPU 寄存器,用于测量性能指标,例如 CPU 指令)的公共库。另一方面,Linux 内核提供了 perf_event_open 系统调用。通过 Python ctypes 桥接技术能够让我们调用标准 C 库的系统调用函数 syscall,它也为我们提供了兼容 C 的数据类型,从而可以编程硬件计数器并从它们读取数据。

使用 Dynostats,我们已经可以找出 CPU 回归,并探究 CPU 回归发生的原因,例如哪个端点受到的影响最多,谁提交了真正会导致 CPU 回归的变更等。然而,当开发者收到他们的变更已经导致一次 CPU 回归发生的通知时,他们通常难以找出问题所在。如果问题很明显,那么回归可能就不会一开始就被提交!

这就是为何我们需要一个 Python 分析器,(一旦 Dynostats 发现了它)从而使开发者能够使用它找出回归发生的根本原因。不同于白手起家,我们决定对一个现成的 Python 分析器 cProfile 做适当的修改。cProfile 模块通常会提供一个统计集合来描述程序不同的部分执行时间和执行频率。我们将 cProfile 的 定时器 ( timer ) 替换成了一个从硬件计数器读取的 CPU 指令计数器,以此取代对时间的测量。我们在采样请求后产生数据并把数据发送到数据流水线。我们也会发送一些我们在 Dynostats 所拥有的类似元数据,例如服务器名称、集群、区域、端点名称等。

在数据流水线的另一边,我们创建了一个消费数据的 尾随者 ( tailer ) 。尾随者的主要功能是解析 cProfile 的统计数据并创建能够表示 Python 函数级别的 CPU 指令的实体。如此,我们能够通过 Python 函数来聚合 CPU 指令,从而更加方便地找出是什么函数导致了 CPU 回归。

监控与警报机制

在 Instagram,我们每天部署 30-50 次后端服务。这些部署中的任何一个都能发生 CPU 回归的问题。因为每次发生通常都包含至少一个 差异 ( diff ) ,所以找出任何回归是很容易的。我们的效率监控机制包括在每次发布前后都会在 Dynostats 中扫描 CPU 指令,并且当变更超出某个阈值时发出警告。对于长期会发生 CPU 回归的情况,我们也有一个探测器为负载最繁重的端点提供日常和每周的变更扫描。

部署新的变更并非触发一次 CPU 回归的唯一情况。在许多情况下,新的功能和新的代码路径都由 全局环境变量 ( global environment variables,GEV ) 控制。 在一个计划好的时间表上,给一部分用户发布新功能是很常见事情。我们在 Dynostats 和 cProfile 统计数据中为每个请求添加了这个信息作为额外的元数据字段。按这些字段将请求分组可以找出由全局环境变量(GEV)改变导致的可能的 CPU 回归问题。这让我们能够在它们对性能造成影响前就捕获到 CPU 回归。

接下来是什么?

Dynostats 和我们定制的 cProfile,以及我们建立的支持它们的监控和警报机制能够有效地找出大多数导致 CPU 回归的元凶。这些进展已经帮助我们恢复了超过 50% 的不必要的 CPU 回归,否则我们就根本不会知道。

我们仍然还有一些可以提升的方面,并很容易将它们地加入到 Instagram 的日常部署流程中:

  1. CPU 指令指标应该要比其它指标如 CPU 时间更加稳定,但我们仍然观察了让我们头疼的差异。保持“ 信噪比 ( signal:noise ratio ) ”合理地低是非常重要的,这样开发者们就可以集中于真实的回归上。这可以通过引入 置信区间 ( confidence intervals ) 的概念来提升,并在信噪比过高时发出警报。针对不同的端点,变化的阈值也可以设置为不同值。
  2. 通过更改 GEV 来探测 CPU 回归的一个限制就是我们要在 Dynostats 中手动启用这些比较的日志输出。当 GEV 的数量逐渐增加,开发了越来越多的功能,这就不便于扩展了。相反,我们能够利用一个自动化框架来调度这些比较的日志输出,并对所有的 GEV 进行遍历,然后当检查到回归时就发出警告。
  3. cProfile 需要一些增强以便更好地处理封装函数以及它们的子函数。

鉴于我们在为 Instagram 的 web service 构建效率框架中所投入的工作,所以我们对于将来使用 Python 继续扩展我们的服务很有信心。我们也开始向 Python 语言本身投入更多,并且开始探索从 Python 2 转移 Python 3 之道。我们将会继续探索并做更多的实验以继续提升基础设施与开发者效率,我们期待着很快能够分享更多的经验。

本文作者 Min Ni 是 Instagram 的软件工程师。

(题图来自:nostarch.com)


via: https://engineering.instagram.com/web-service-efficiency-at-instagram-with-python-4976d078e366#.tiakuoi4p

作者:Min Ni 译者:ChrisLeeGit 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出