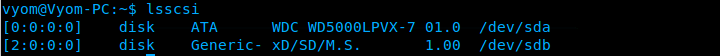2016年1月

要使用 grep 命令来搜索多个字符串或单词,我们该怎么做?例如我想要查找 /path/to/file 文件中的 word1、word2、word3 等单词,我怎么样命令 grep 查找这些单词呢?

grep 命令支持正则表达式匹配模式。要使用多单词搜索,请使用如下语法:

grep 'word1\|word2\|word3' /path/to/file

下的例子中,要在一个名叫 /var/log/messages 的文本日志文件中查找 warning、error 和 critical 这几个单词,输入:

$ grep 'warning\|error\|critical' /var/log/messages

仅仅只是要匹配单词(即该词两侧是单词分界符,针对西方以空格分隔的语言而言)的话,可以加上 -w 选项参数:

$ grep -w 'warning\|error\|critical' /var/log/messages

egrep 命令可以跳过上面的语法格式,其使用的语法格式如下:

$ egrep -w 'warning|error|critical' /var/log/messages

我建义您们加上 -i (忽略大小写) 和 --color 选项参数,如下示:

$ egrep -wi --color 'warning|error|critical' /var/log/messages

输出示例:

Fig.01: Linux / Unix egrep Command Search Multiple Words Demo Output

图一: Linux / Unix egrep 命令查找多个单词输出例子


via: http://www.cyberciti.biz/faq/searching-multiple-words-string-using-grep/

作者:Vivek Gite 译者:runningwater 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

开源界爆发了一场“Linux基金会到底是姓‘企业’还是姓‘草根’?”的争论。

Linux 圈一直以来争议不断,无论 Sarah Sharp 愤而离开了 Linux 内核邮件列表(LKML),还是 Matthew Garrett 去单干了,往往连这些顶级开发者都深陷争议之中。甚至连 Linus Torvalds 也是以口无遮拦著称,对看不上的代码就破口大骂。

Linux 基金会

而最近成为争议焦点的 Linux 基金会 ( The Linux Foundation ) 不但是一个支持 Linux 的非盈利组织,而且也支持了越来越多的开源项目,比如 SDN 方面的 OpenDaylight、容器方面的 Open Container Initiative ( 开放容器计划 ) ,以及 R 语言方面的 R Consortium ( R 语言联盟 ) 等。

CoreOS 的安全开发人员 Garrett 最近披露,Linux 基金会悄悄修改了其法律条款,不再允许基金会的个人会员选举董事成员。Garrett 写到,“Linux 基金会的董事主要是由其企业会员选出的:10个来自白金会员(年费50万美金),3个来自金牌会员(年费10万美金),1个来自银牌会员(根据公司规模不同,年费在5千到2万美金)。直到最近,个人会员(年费99美元)还能够选举两位董事成员,以在董事会层面代表社区的意见。”

为什么 Linux 基金会要这样做?Garrett 猜测是因为 Karen Sandler,她是 软件自由保护协会 ( Software Freedom Conservancy (SFC)的执行董事,该组织致力于非常重要的 GPL 开源许可证的执法工作,她正在谋求竞选 Linux 基金会的董事。Garrett 说,“Linux 基金会的‘ 个人会员 ( Individual membership ) ’被悄然改为‘ 个人支持者 ( Individual supporter ) ’,而之前承诺的可以参选和选举董事的权利被删除了(可以比较新版本和旧版本)。”

Garrett 指出,“(Linux 基金会)一直以来就对 GPL 执法并不热心,而 SFC 正在资助一起针对其董事会成员(VMware)违反了 GPL 的诉讼。时间上也许是巧合,但是看起来像是 Linux 基金会为了避免在董事会内出现关于 GPL 方面的执法提案而扔掉了其代表了社区的伪装。”

由于 Linux 基金会主席 Jim Zemlin 前几天在中国开会,访问互联网和收发电子邮件受限,所以对这两天社区里面发生的争论没有及时回复。

Zemlin 对此反驳道:“Linux 基金会的董事会结构没有改变过。个人仍然可以成为董事,来自企业和个人的董事比例也没有变化。我们做这件事之前经过了长期讨论,这十年来的首次改变可以为个人支持者带来更多的价值。而招募来自社区的董事的流程会变得和业界其它的顶尖组织一样。”

Zemlin 继续说道:“董事会投票继续留任 Larry Augustin [SugarCRM 的 CEO] 和 Bdale Garbee [惠普企业 的 CTO 办公室研究员] 作为个人 非执行董事 ( At-Large Director ) ,以表彰他们对社区的长期服务及对 Linux 基金会的个人参与。内核开发者们也会继续任命一位董事,我们欢迎并认可 Grant Likely 继续以这种身份参与进来。随着时间的推移,Linux 基金会董事会也许会从日益增长的社区增加更多的个人董事。”

他补充道:“我们知道社区政策很重要,而且当发生改变时会有不同的观点碰撞。这是正常的、健康的。但是经常在开发者社区中爆发的‘口水战’则是不健康的。不幸的是,现在发生的事情就是这样,对 Linux 基金会的这个政策改变的争论现在变成了个人的、不合适的攻击,尤其是针对我们社区中的某些成员,特别是 Karen Sandler 的攻击。”

“Karen,” Zemlin 继续说,“在她的职业生涯中致力于推动和捍卫自由软件。因为这些线上的讨论和攻击关系到了 Linux 基金会,我觉得有必要毫不含糊的指出,Linux 基金会对此绝不容忍,并随时会针对这种放任自流的网上行为作出斗争!”

我完全赞同 Zemlin 的这番反对的立场,但是我觉得 Garrett 和 Zemlin 说的不是一个事情,眼前的问题是:“Sandler 是否仍然可以竞选董事?”,我问过 Linux 基金会,但是没有得到答案。

在我看来,这场争论背后的真正的问题是,是谁在控制 Linux 基金会?是用户还是公司?

Garrett 认为 Linux 基金会正在远离社区而投入企业的怀抱。Zemlin 并没有特别谈到这个问题,但是令人注意的是,他说“招募来自社区的董事的流程会变得和业界其它的顶尖组织一样。”

此外,正如 Garrett 指出的,个人不再有“竞选和投票支持 Linux 基金会董事会席位的能力,从而影响基金会的发展方向。”

就个人而言,我认为这是 Linux 基金会进一步走向了被企业控制。不过,正如俗话说的,谁请客谁买单,这也没什么好奇怪的。

开源用户喜欢“社区”这个概念,然而这十来年,“社区”已经变成了企业高管和公司雇员了。只有最理想化的开源开发者和领导者,(令人感到讽刺的是,)以及开源最热切的敌人们仍然认为 Linux 和开源项目是由个人所创建和控制的。

此外,Linux 基金会的绝大多数董事会成员都是由公司选择的。不过,对于 Linux 基金会的这个决定我看的不顺眼。Linux 始于个人项目,其迅猛发展得益于大量程序员的支持,总应该在 Linux 基金会里面有一个为个人而不是为公司说话的地方。

我希望 Sandler,这位强力、才华横溢的开源领袖,不仅能被允许参与竞选,而且能赢得董事会席位。我也希望 Linux 基金会恢复个人参选和投票董事的权利。这要求并不多,这将恢复人们对 Linux 基金会的信心,让我们觉得它并不仅仅只有大公司的位置,也有小小的个人的位置。

在 Linux 、类 Unix 系统中我该如何使用 Grep 命令的正则表达式呢?

Linux 附带有 GNU grep 命令工具,它支持 扩展正则表达式 ( extended regular expressions ) ,而且 GNU grep 在所有的 Linux 系统中都是默认有的。Grep 命令被用于搜索定位存储在您服务器或工作站上的任何信息。

正则表达式

正则表达式就是用于匹配每行输入的一种模式,模式是指一串字符序列。下面是范例:

^w1
w1|w2
[^ ]

grep 正则表达式示例

在 /etc/passswd 目录中搜索 'vivek'

grep vivek /etc/passwd

输出例子:

vivek:x:1000:1000:Vivek Gite,,,:/home/vivek:/bin/bash
vivekgite:x:1001:1001::/home/vivekgite:/bin/sh
gitevivek:x:1002:1002::/home/gitevivek:/bin/sh

搜索大小写任意的 vivek(即不区分大小写的搜索)

grep -i -w vivek /etc/passwd

搜索大小写任意的 vivek 或 raj

grep -E -i -w 'vivek|raj' /etc/passwd

上面最后的例子显示的,就是一个扩展的正则表达式的模式。

锚点

你可以分别使用 ^ 和 $ 符号来正则匹配输入行的开始或结尾。下面的例子搜索显示仅仅以 vivek 开始的输入行:

grep ^vivek /etc/passwd

输出例子:

vivek:x:1000:1000:Vivek Gite,,,:/home/vivek:/bin/bash
vivekgite:x:1001:1001::/home/vivekgite:/bin/sh

你可以仅仅只搜索出以单词 vivek 开始的行,即不显示 vivekgit、vivekg 等(LCTT 译注:即该单词后面是空格、符号等英文的单词分隔符。)

grep -w ^vivek /etc/passwd

找出以单词 word 结尾的行:

grep 'foo$' 文件名

匹配仅仅只包含 foo 的行:

grep '^foo$' 文件名

如下所示的例子可以搜索空行:

grep '^$' 文件名

字符类

匹配 Vivek 或 vivek:

grep '[vV]ivek' 文件名

或者

grep '[vV][iI][Vv][Ee][kK]' 文件名

也可以匹配数字 (即匹配 vivek1 或 Vivek2 等等):

grep -w '[vV]ivek[0-9]' 文件名

可以匹配两个数字字符(即 foo11、foo12 等):

grep 'foo[0-9][0-9]' 文件名

不仅仅局限于数字,也能匹配至少一个字母的:

grep '[A-Za-z]' 文件名

显示含有 "w" 或 "n" 字符的所有行:

grep [wn] 文件名

放在括号内的表达式,即包在 "[:" 和 ":]" 之间的字符类的名字,它表示的是属于此类的所有字符列表。标准的字符类名称如下:

  • [:alnum:] - 字母数字字符
  • [:alpha:] - 字母字符
  • [:blank:] - 空字符: 空格键符 和 制表符
  • [:digit:] - 数字: '0 1 2 3 4 5 6 7 8 9'
  • [:lower:] - 小写字母: 'a b c d e f g h i j k l m n o p q r s t u v w x y z'
  • [:space:] - 空格字符: 制表符、换行符、垂直制表符、换页符、回车符和空格键符
  • [:upper:] - 大写字母: 'A B C D E F G H I J K L M N O P Q R S T U V W X Y Z'

在这个例子所示的是匹配所有大写字母:

grep '[:upper:]' 文件名

通配符

你可以使用 "." 来匹配单个字符。例子中匹配以 "b" 开头以 "t" 结尾的3个字符的单词:

grep '\<b.t\>' 文件名

在这儿,

  • \< 匹配单词前面的空字符串
  • \> 匹配单词后面的空字符串

打印出只有两个字符的所有行:

grep '^..$' 文件名

显示以一个点和一个数字开头的行:

grep '^\.[0-9]' 文件名

点字符转义

下面要匹配到 IP 地址为 192.168.1.254 的正则式是不正确的:(LCTT 译注:可以匹配到该 IP 地址,但是也有可能匹配到间隔符号不是点的类似格式)

grep '192.168.1.254' /etc/hosts

三个点字符都需要转义:

grep '192\.168\.1\.254' /etc/hosts

下面的例子只能匹配出 IP 地址:(LCTT 译注:实际上由于 IP 地址中数字的取值范围,该正则表达式并不精确)

egrep '[[:digit:]]{1,3}\.[[:digit:]]{1,3}\.[[:digit:]]{1,3}\.[[:digit:]]{1,3}' 文件名

怎么样搜索以“-” 符号开头的匹配模式?

要使用 -e 选项来搜索匹配 '--test--' 字符串,如果不使用 -e 选项,grep 命令会试图把 '--test--' 当作自己的选项参数来解析:

grep -e '--test--' 文件名

怎么使用 grep 的“或”匹配?

使用如下的语法:

grep -E 'word1|word2' 文件名
或
egrep 'word1|word2' 文件名

或者是

grep 'word1\|word2' 文件名

怎么使用 grep 的“和”匹配?

使用下面的语法来显示既包含 'word1' 又包含 'word2' 的所有行

grep 'word1' 文件名 | grep 'word2'

怎么样使用序列检测?

使用如下的语法,您可以检测一个字符在序列中重复出现次数:

{N}
{N,}
{min,max}

要匹配字符 “v" 出现两次:

egrep "v{2}" 文件名

下面的命令能匹配到 "col" 和 "cool" :

egrep 'co{1,2}l' 文件名

下面的命令将会匹配出至少有三个 'c' 字符的所有行。

egrep 'c{3,}' 文件名

下面的例子会匹配 91-1234567890(即二个数字-十个数字) 这种格式的手机号。

grep "[[:digit:]]\{2\}[ -]\?[[:digit:]]\{10\}" 文件名

怎么样使 grep 命令高亮显示?

使用如下的语法:

grep --color 正则表达式 文件名

怎么样仅仅只显示匹配出的字符,而不是匹配出的行?

使用如下语法:

grep -o 正则表达式 文件名

正则表达式限定符

限定符描述
.匹配任意的一个字符。
?匹配前面的子表达式,最多一次。
*匹配前面的子表达式零次或多次。
+匹配前面的子表达式一次或多次。
{N}匹配前面的子表达式 N 次。
{N,}匹配前面的子表达式 N 次到多次。
{N,M}匹配前面的子表达式 N 到 M 次,至少 N 次至多 M 次。
-只要不是在序列开始、结尾或者序列的结束点上,表示序列范围。
^匹配一行开始的空字符串;也表示字符不在要匹配的列表中。
$匹配一行末尾的空字符串。
\b匹配一个单词前后的空字符串。
\B匹配一个单词中间的空字符串。
\<匹配单词前面的空字符串。
\>匹配单词后面的空字符串。

grep 和 egrep

egrep 等同于 grep -E 。它会以扩展的正则表达式的模式来解释模式。下面来自 grep 的帮助页:

基本的正则表达式元字符 ?、+、 {、 |、 ( 和 ) 已经失去了它们原来的意义,要使用的话用反斜线的版本 ?、+、{、|、( 和 ) 来代替。 传统的 egrep 并不支持 { 元字符,一些 egrep 的实现是以 { 替代的,所以一个可移植的脚本应该避免在 grep -E 使用 { 符号,要匹配字面的 { 应该使用 [}]。

GNU grep -E 试图支持传统的用法,如果 { 出在在无效的间隔规范字符串这前,它就会假定 { 不是特殊字符。

例如,grep -E '{1' 命令搜索包含 {1 两个字符的串,而不会报出正则表达式语法错误。

POSIX.2 标准允许这种操作的扩展,但在可移植脚本文件里应该避免这样使用。

参考:

  • grep 和 regex 帮助手册页(7)
  • grep 的 info 页

via: http://www.cyberciti.biz/faq/grep-regular-expressions/

作者:Vivek Gite 译者:runningwater 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

我想大多数人听说过 Node.js,但是你听说过 NodeOS 吗?没错,NodeOS,一个用 Node.js 写的操作系统。好吧,实话说,NodeOS 用 Linux 内核来处理各种底层任务,比如硬件通讯什么的,但是除此之外,使用的都是 Node.js。NodeOS 的开发始于两年前,创建者的目的很简单,他只是好奇,“是否有可能仅使用 Node.js 创建一个操作系统呢?”
是否有可能仅使用 Node.js 创建一个操作系统呢?

这个主意怎么样?

我们已经看到了 Node.js 在这几年已经取得如此迅猛的发展,那么我们为何不让它更酷一些呢?比如用它做个操作系统。

用户自主的独立文件系统

NodeOS 引入了一个有趣的特性:所有的用户都有一个独立的文件系统,他们在一个简单的文件系统中完成各种工作。因为他们的“主目录”事实上就是他们自己的文件系统的根(root),所以他们可以不需要任何超级权限就可以将软件包安装到系统中,也不需要配置什么,因为软件包默认就安装在他们自己的主目录里面。此外,这样也提供了良好的安全性,如果黑客攻入到了某个账户,那么只能访问到该用户所在的部分,最终的结果就是黑客并不能由此影响到整个系统。

Node.js 和 NPM

你可以想想,如果一个操作系统使用 Node.js,那就意味着所有在 NPM 中可用的包同时也都是 NodeOS 的软件包。在写作本文时,已经有了超过 21 万的软件包,而且每分每秒都在不断增长。如果几年以后,NodeOS 有了一百万应用,那也没什么好奇怪的。

基于 Linux 内核

这看起来并不算什么,Linux 是大多数服务器所采用的操作系统。因为 NodeOS 是基于 Linux 内核的,所以你只需要很少的修改就可以使用那些给其它的 Linux 发行版开发的应用了。

不好的消息

我非常希望 NodeOS 是一个已经完成的作品,但是,它现在还不是。它仍然缺少一些服务器操作系统所必需的关键功能。比如,缺失完整的 BASH 工具集,包括 ps、tail、nano 和 grep 等都没有。更糟糕的是,你也不能把它当成桌面操作系统使用,因为它没有 GUI。当然,你可以实现一些缺失的功能,只需要使用一点点 JavaScript,但是默认情况下,这些功能现在都还没有,真糟糕。

好吧,那我可以试试 NodeOS 吗?

使用 Docker 来体验

最容易、最快捷的体验 NodeOS 的方法如下:

  1. 一台运行 Mac OSX 或 Linux 计算机,也许 Windows 也可以,但是我没试过。
  2. Docker。

当你安装好 Docker 之后,运行一个 NodeOS 实例是很容易的。你只需要执行如下命令就可以了, Docker 会为你完成这魔法般的一切:

sudo docker run -t -i nodeos/nodeos
最容易、最快捷的体验 NodeOS 的方法是通过 Docker。

当你运行了上述命令,Docker 会自动从仓库下载 NodeOS 的镜像,并将其安装到一个虚拟环境中。安装好之后,会打开一个连接到 NodeOS 的 SSH 会话。

不用 docker 呢?

有些情况下你也许不能使用 Docker 来体验,或者是你想体验一下最新版本的 NodeOS 。在写作本文时,NodeOS 的镜像已经是两个月前生成的了,而开发版本则是六天前更新的。所以,如果你希望使用最新版本,你应该从源代码开始。这也不算很难,但是要花费一些时间。你需要:

  1. 一台运行 Linux 的计算机。你可以在 OS X 上编译它,但是跨平台编译需要花费很多时间,对于 Windows 也如此。
  2. Linux 编译构建相关的工具(make、g++、gcc、autoconf)。
  3. Qemu。
  4. 时间,真的需要很多。

如果万事俱备,你就可以从源代码开始编译了:

  1. 下载项目源代码:bash git clone [email protected]:NodeOS/NodeOS.git。
  2. 使用下列命令编译: cd NodeOS 并 npm install。
  3. 我逐字引用了其官方文档的话:“拿上爆米花去看场电影吧,不开玩笑,真的。”,是的,它需要很多时间,做些有意思的事情去吧。
  4. 执行 bash npm start 来在 Qemu 中运行 NodeOS。

可以工作了吗?

当安装完成后,我们可以通过在 NodeOS 的 shell 中执行 ls命令来看看它是否工作了。输出类似如下:

[ 'etc', 'lib', 'lib64', 'root', 'bin', 'sys', 'usr', 'share', 'proc' ]

如果显示如上,说明一些基本的命令可以工作了。但是如果我们想要知道网卡地址呢?在 Linux 下,这个命令是 ifconfig ,让我们试试:

command not found: ifconfig

看起来没有 ifconfig 命令。这是因为 NodeOS 默认没有 ifconfig命令。现在怎么办?很简单,NodeOS 有一个集成的包管理器(类似 apt 或 yum) ,叫做 npkg,它是基于 Node 的 NPM 的,很容易使用。可以通过如下命令很方便的安装 ifconfig :

npkg install bin-ifconfig

如果一切正常, ifconfig 命令现在就可以在 shell 中使用了。我们再次试着执行一下,输出类似如下:(我替换了其中的 MAC 地址):

eth0: flags=8863<UP,BROADCAST,SMART,RUNNING,SIMPLEX,MULTICAST> mtu 1500
  ether 01:23:45:67:89:ab 
  inet6 f0cd::ef01:0203:0405:181%en1 prefixlen 64 scopeid 0x5 
  inet 192.168.0.21 netmask 0xffffff00 broadcast 192.168.0.21
  nd6 options=1<PERFORMNUD>
  media: autoselect
  status: active

如果你的输出也类似如上,那说明它可以工作了。你已经成功地安装了你的第一个 NodeOS 应用: ifconfig。

它是可以工作了,然而我们可以用这个操作系统做什么呢?

如果我们只能拿这个用 Node.js 写的操作系统做到你在 Ubuntu 或其它 Linux 发行版上一样的(或更少的)事情,那它有什么价值?其实,整个事情中最有趣的地方是所有的东西都是 Node.js 开发的。这意味着我们可以只需要使用 Node.js 就可以开发我们的应用了。比如,NodeOS 里没有默认实现的 man 命令,它用于显示其它命令的帮助信息。不用担心,实现它很简单。
使用 Node.js 构建一个 NodeOS 应用

首先让我们来安装一个叫做 Hipster 的文本编辑器,以便我们可以创建和编辑文件。执行如下命令: npm install -g [email protected]。这个文本编辑器很简单,除了用作文本编辑之外啥也干不了,不过对于我们来说足够了。

用 Hipster 创建文件很简单,运行 hip filename即可,如: hip package.json。要保存文件请按下 Ctrl + s ,退出按下 Ctrl + q。

在这里,我们使用了一个 NodeOS 的主开发人员所开发的代码,我自己并没有真的去开发这个应用。我们例子中的原始代码可以在 node-bin-man Git 仓库中找到。

让我们回过头来创建我们的第一个 NodeOS 应用。像每个 Node.js 应用(或 NPM 包)一样,我们从创建一个 package.json 文件开始,内容如下:

{
  "name": "bin-man",
  "version": "0.0.1",
  "description": "Format and display manual pages",
  "bin": {
    "man": "man.js"
  },
  "repository": "https://github.com/groundwater/node-bin-man",
  "author": "groundwater",
  "license": "MIT",
  "dependencies": {
    "blessed": "~0.0.22"
  }
}

这些参数 name、version、 author、 repository、 license和 description 是其意自明的。这个 bin 集合是一个 JSON 的键值对对象,包含了命令名及其关联的 JavaScript 文件。在我们的例子中, man 命令关联到 man.js文件。而 dependencies集合包含了这个应用所需要的 NPM 包的列表。在我们的例子中,代码的作者包含了 Blessed 包,这是一个类 curses 的库,可以让 Node.js 支持高级终端界面的 API。

现在我们进入了主要的部分,实际的代码。

#!/usr/bin/env node

这个部分叫做 释伴 ( shebang ) 。NodeOS 实际上并不需要它,但是它用于告诉操作系统如何执行下面的代码。在这里的意思是,它告诉系统下面的每行代码都需要通过 /usr/bin/env node命令来解释执行。

var fs = require('fs');
var blessed = require('blessed');

像在 Node.js 中一样, require() 函数加载选定的包到内存中,并将其保存为特定的变量。

var arg = process.argv[2] || 'bin-man';

man 命令的标准行为是如果没有指定要查看的命令时,就显示它自己的帮助信息。在我们的代码示例中也一样:如果没有给出第二个参数(第一个参数是 man 本身),那么该参数的默认值是 bin-man。

var path = process.env.HOME + "/lib/node_modules/" + arg + "/README.md";

try{
  var readme = fs.readFileSync(path, 'utf-8');
}catch(e){
  console.log('No README.md for Package ',arg);
  process.exit(-1);
}

在这里,程序检查给定的应用是否有一个 readme 文件。在 NodeOS 中,每个应用的安装路径是其主目录(/)下的 lib/node_modules。如果 README.md 文件存在,就将其内容保存到 readme变量中。否则,显示一个错误信息并退出。

// Create a screen object.
var screen = blessed.screen();

var box = blessed.box({
  content: readme,
  alwaysScroll:true,
  scrollable: true,
});

// Append our box to the screen.
screen.append(box);

Blessed 有一个非常简单的 API,要显示一个文件的内容很容易,只需要创建一个 box ,然后载入内容即可。

screen.key(['escape', 'q', 'C-c'], function(ch, key) {
  return process.exit(0);
});

现在,让我们找个退出 man 应用的方法。我们组合了 escape、 q 或 emacs 风格的 C-c 来退出应用。

screen.key(['space','f','j','n'], function(ch, key) {
  box.scroll(box.height);
  screen.render();
});

screen.key(['down'], function(ch, key) {
  box.scroll(1);
  screen.render();
});

screen.key(['up'], function(ch, key) {
  box.scroll(-1);
  screen.render();
});

screen.key(['b','k','p'], function(ch, key) {
  box.scroll(-box.height);
  screen.render();
});

我们使用方向键来上滚和下滚,用 space、 f、 j 或 n 向下翻页,b、 k 或 p 向上翻页。

box.focus();
screen.render();

最后,我们让应用将输入焦点放到 box ,我们在这里创建和渲染所有内容。

把上面编辑的这个文件存放到 /lib/node_modules/bin-man 目录下(名字是 man.js),并加一个简单的 README.md ,类似如下:

# Man

Author: @groundwater

## Install

npkg install bin-man

## Usage

Usage: man PKGNAME

Display a packages README.md file

我们已经基本完成了我们的第一个 NodeOS 定制应用。最后剩下一小步了,我们需要创建一个 NodeOS 应用需要的配置文件。很简单,把它创建到 /etc/bin-man/config.json ,内容只是一个空的 JSON 对象: {}。

现在我们可以试试我们的新应用了。在 NodeOS 中运行 man ,它将展示我们之前创建的 readme 文件。

总结

如你所见,在 NodeOS 中实现任何东西都很简单,你只需要懂得 Node.js 即可。

NodeOS 很有潜力,我认为当实现了更多的功能之后它会成为一个伟大的操作系统。目前仍然需要很多工作,但是在整个Node.js 生态系统兴盛发展的形势下,万一哪天它很快地成为一个流行的操作系统也没什么好惊奇的。

你怎么看?发表你的评论让我们知道。
有许多命令可以用来查看 Linux 系统上的硬件信息。有些命令只能够打印出像 CPU 和内存这一特定的硬件组件信息,另外一些命令可以查看多种硬件组件的信息。

这个教程可以带大家快速了解一下查看各种硬件设备的信息和配置详情的最常用的命令。

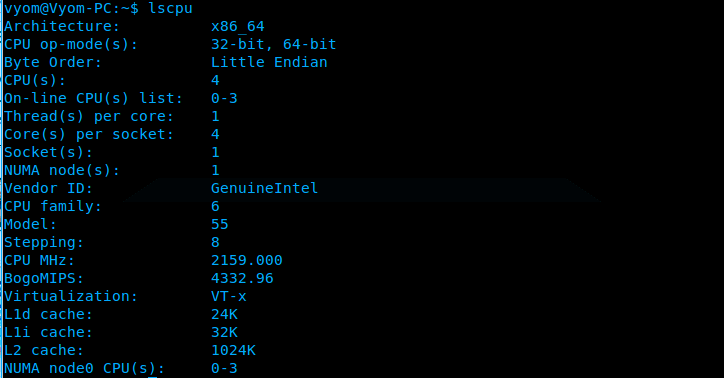
lscpu

lscpu命令能够查看 CPU 和处理单元的信息。该命令没有任何其他选项或者别的功能。

lscpu

运行该命令会看到下面输出:

hdd_info_lscpu

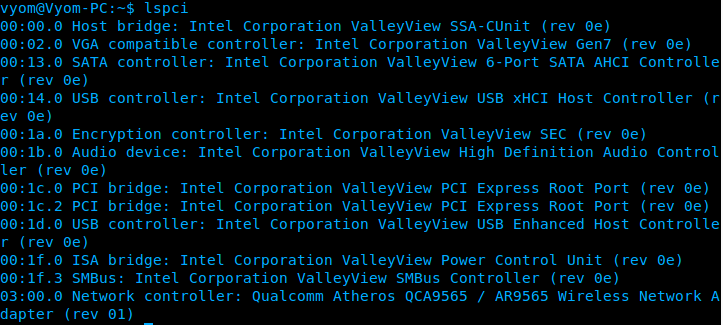
lspci

lspci是另一个命令行工具,可以用来列出所有的 PCI 总线,还有与 PCI 总线相连的设备的详细信息,比如 VGA 适配器、显卡、网络适配器、usb 端口、SATA 控制器等。

lspci

你可以看到类似下图的输出信息。

hdd_info_lspci

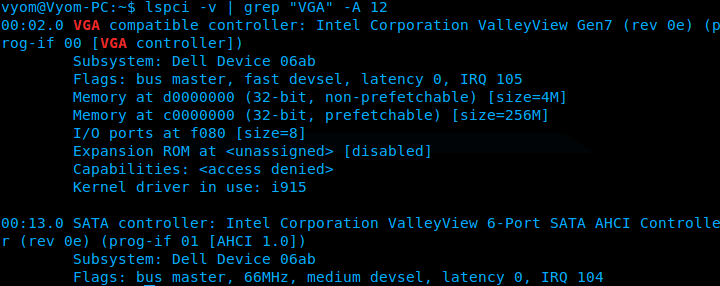
可以通过运行下面的命令来过滤出特定设备的信息:

lspci -v | grep "VGA" -A 12

运行上面的命令可以看到类似下图的关于显卡的信息。

hdd_info_lspci_vga

lshw

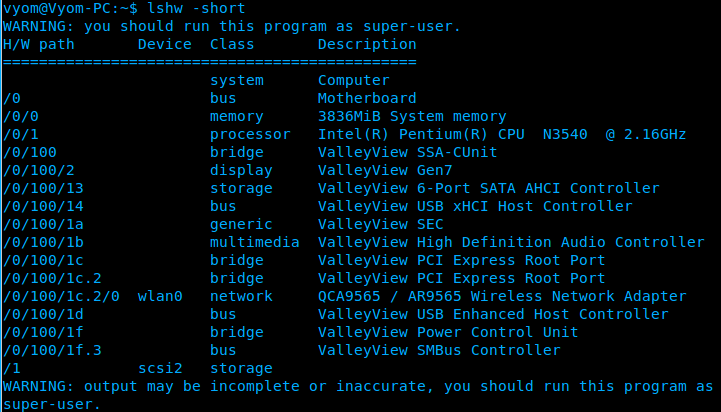
lshw是一个通用的工具,可以列出多种硬件单元的详细或者概要的信息,比如 CPU、内存、usb 控制器、硬盘等。lshw能够从各个“/proc”文件中提取出相关的信息。

lshw -short

通过运行上面的命令可以看到下面的信息。

hdd_info_lshw

lsscsi

通过运行下面的命令可以列出像硬盘和光驱等 scsi/sata 设备的信息:

lsscsi

会得到类似下面的输出。

hdd_info_lsscsi

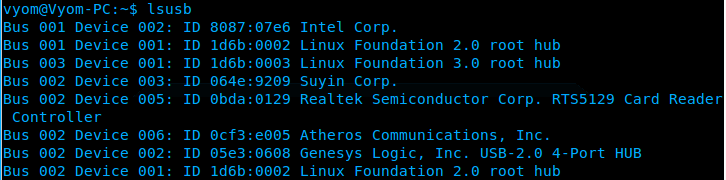
lsusb

lsusb命令能够列出 USB 控制器和与 USB 控制器相连的设备的详细信息。默认情况下,lsusb命令只打印出概要信息。可以通过使用-v参数打印每一个usb端口的详细信息。

lsusb

可以看到下面输出。

hdd_info_lsusb

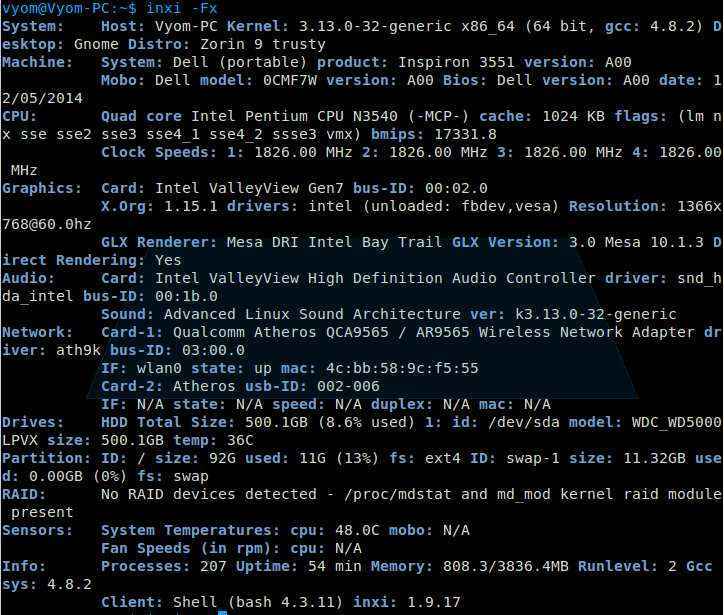
Inxi

Inxi是一个 bash 脚本,能够从系统的多个来源和命令获取硬件信息,并打印出一个非技术人员也能看懂的友好的报告。

默认情况下,Ubuntu 上没有安装inxi。可以通过运行下面命令来安装Inxi:

sudo apt-get install inxi

安装完Inxi之后,通过运行下面命令能够得到硬件相关的信息:

inxi -Fx

能够得到类似下图的输出。

hdd_info_inxi

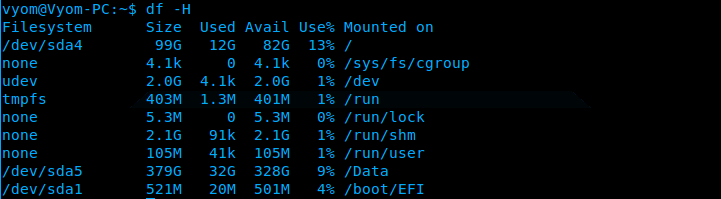
df

df命令能够列出不同分区的概要信息、挂载点、已用的和可用的空间。

可以在使用df命令的时候加上-H参数。

df -H

会得到下面的输出。

hdd_info_df

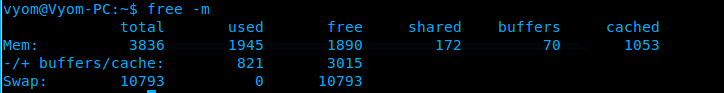
Free

通过使用free命令可以查看系统中使用的、闲置的和 RAM 的总体数量。

free -m

会看到下面输出。

hdd_info_free

Dmidecode

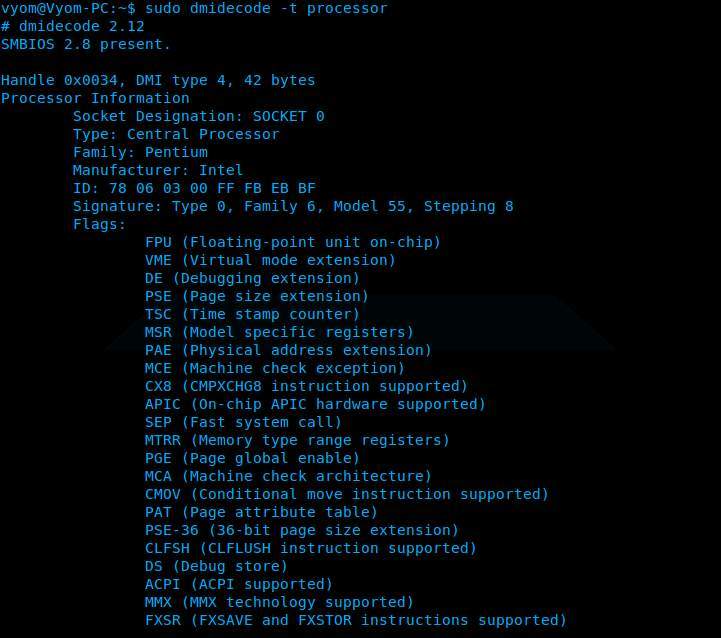
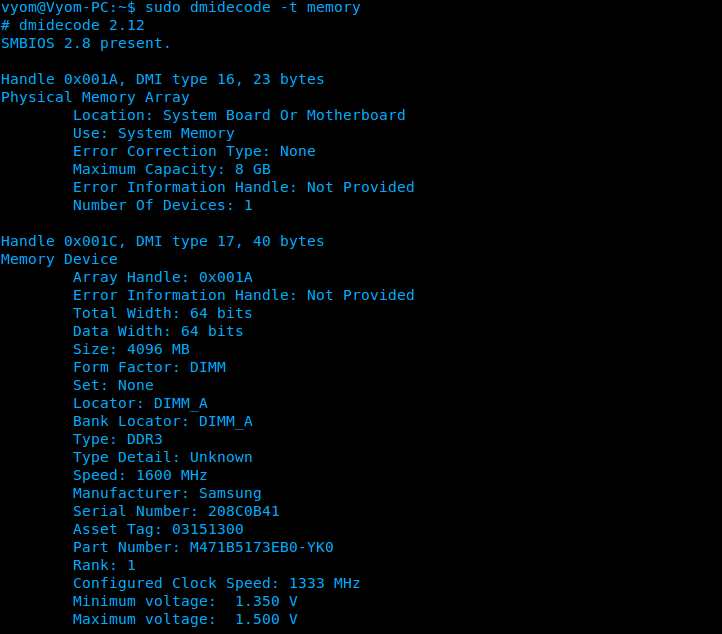
dmidecode命令与其他命令不同。该命令是从硬件中的 DMI 表中读取信息的。

要查看处理器的信息,运行下面命令:

sudo dmidecode -t processor

hdd_info_dmi_processor

要查看内存的信息,运行下面命令:

sudo dmidecode -t memory

hdd_info_dmi_memory

要查看 bios 的信息,运行下面命令:

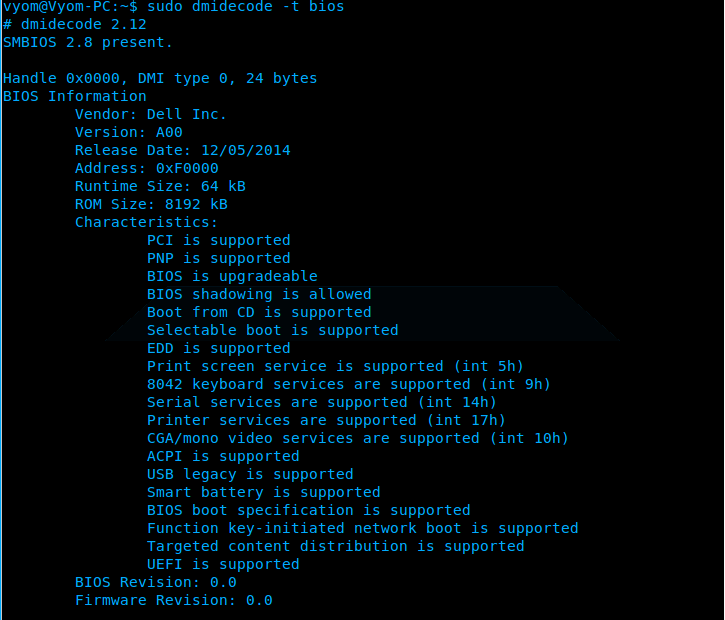
sudo dmidecode -t bios

hdd_info_dmi_bios

Hdparm

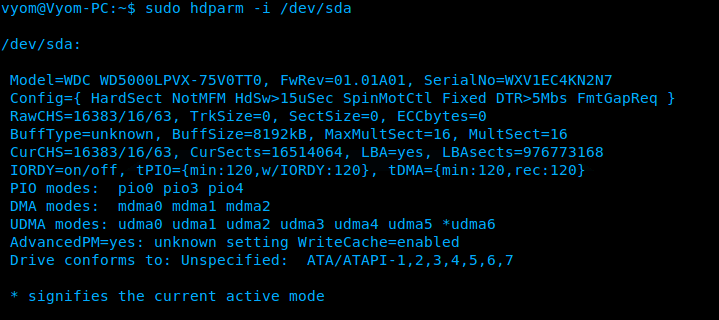
hdparm命令可以用来显示像硬盘这样的 sata 设备的信息。

sudo hdparm

可以看到下面的输出。

hdd_info_hdparm

总结

每个命令都有不同的方式来获取硬件的信息。在查看特定的硬件信息的时候,可以尝试使用不同的方式。上面所有的命令行工具在大部分的 Linux 发行版本中都是可以使用的,可以很容易的从仓库中获取安装。


via: https://www.maketecheasier.com/check-hardware-information-linux/

作者:Hitesh Jethva 译者:sonofelice 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

我该怎样在 Linux、Apple OS X 及其他类 UNIX 系统中使用 grep 命令,你能给我展示一些简单的例子吗?

grep 命令用来搜索文本,或从给定的文件中搜索行内包含了给定字符串或单词的文件。通常来说,grep 显示匹配到的行。使用 grep 来搜索包括一个或多个正则表达式匹配到的文本行,然后只显示匹配到的行。grep 被视作在 Linux/ Unix 系统中最有用的命令之一。

你知道吗

grep 这个名字,来源于一个 Unix/Linux 中的古老的行编辑器 ed) 中执行相似操作的命令:

g/re/p

grep 命令的语法

语法如下所示:

grep 'word' 文件名
grep 'word' 文件1 文件2 文件3
grep 'word1\|word2' 文件名
cat 某个文件 | grep '某个东西'
command | grep '某个东西'
command 选项1 | grep '数据'
grep --color '数据' 文件名

怎么样使用 grep 来搜索一个文件

搜索 /etc/passwd 文件下的 boo 用户,输入:

$ grep boo /etc/passwd

输出内容:

foo:x:1000:1000:foo,,,:/home/foo:/bin/ksh

可以使用 grep 去强制忽略大小写。例如,使用 -i 选项可以匹配 boo, Boo, BOO 和其他组合:

$ grep -i "boo" /etc/passwd

递归使用 grep

你可以递归地使用 grep 进行搜索。例如,在文件目录下面搜索所有包含字符串“192.168.1.5”的文件

$ grep -r "192.168.1.5" /etc/

或者是:

$ grep -R "192.168.1.5" /etc/

示例输出:

/etc/ppp/options:# ms-wins 192.168.1.50
/etc/ppp/options:# ms-wins 192.168.1.51
/etc/NetworkManager/system-connections/Wired connection 1:addresses1=192.168.1.5;24;192.168.1.2;

你会看到搜索到 192.168.1.5 的结果每一行都前缀以找到匹配的文件名(例如:/etc/ppp/options)。输出之中包含的文件名可以加 -h 选项来禁止输出:

$ grep -h -R "192.168.1.5" /etc/

或者

$ grep -hR "192.168.1.5" /etc/

示例输出:

# ms-wins 192.168.1.50
# ms-wins 192.168.1.51
addresses1=192.168.1.5;24;192.168.1.2;

使用 grep 去搜索文本

当你搜索 boo 时,grep 命令将会匹配 fooboo,boo123, barfoo35 和其他所有包含 boo 的字符串,你可以使用 -w 选项去强制只输出那些仅仅包含那个整个单词的行(LCTT译注:即该字符串两侧是英文单词分隔符,如空格,标点符号,和末端等,因此对中文这种没有断字符号的语言并不适用。)。

$ grep -w "boo" file

使用 grep 命令去搜索两个不同的单词

使用 egrep 命令如下:

$ egrep -w 'word1|word2' /path/to/file

(LCTT 译注:这里使用到了正则表达式,因此使用的是 egrep 命令,即扩展的 grep 命令。)

统计文本匹配到的行数

grep 命令可以通过加 -c 参数显示每个文件中匹配到的次数:

$ grep -c 'word' /path/to/file

传递 -n 选项可以输出的行前加入匹配到的行的行号:

$ grep -n 'root' /etc/passwd

示例输出:

1:root:x:0:0:root:/root:/bin/bash
1042:rootdoor:x:0:0:rootdoor:/home/rootdoor:/bin/csh
3319:initrootapp:x:0:0:initrootapp:/home/initroot:/bin/ksh

反转匹配(不匹配)

可以使用 -v 选项来输出不包含匹配项的内容,输出内容仅仅包含那些不含给定单词的行,例如输出所有不包含 bar 单词的行:

$ grep -v bar /path/to/file

UNIX/Linux 管道与 grep 命令

grep 常常与管道一起使用,在这个例子中,显示硬盘设备的名字:

# dmesg | egrep '(s|h)d[a-z]'

显示 CPU 型号:

# cat /proc/cpuinfo | grep -i 'Model'

然而,以上命令也可以按照以下方法使用,不使用管道:

# grep -i 'Model' /proc/cpuinfo

示例输出:

model       : 30
model name  : Intel(R) Core(TM) i7 CPU       Q 820  @ 1.73GHz
model       : 30
model name  : Intel(R) Core(TM) i7 CPU       Q 820  @ 1.73GHz

如何仅仅显示匹配到内容的文件名字?

使用 -l 选项去显示那些文件内容中包含 main() 的文件名:

$ grep -l 'main' *.c

最后,你可以强制 grep 以彩色输出:

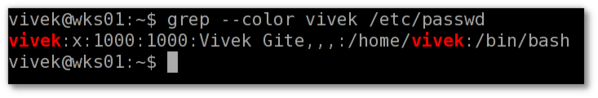
$ grep --color vivek /etc/passwd

示例输出:

Grep command in action


via: http://www.cyberciti.biz/faq/howto-use-grep-command-in-linux-unix/

作者:Vivek Gite 译者:zky001 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出