标签 serverless 下的文章

无服务 serverless 是 托管服务 managed service 发展方向的又一步,并且与 Ansible 的无代理体系结构相得益彰。

Ansible 被设计为实际工作中的最简化的部署工具。这意味着它不是一个完整的编程语言。你需要编写定义任务的 YAML 模板,并列出任何需要自动完成的任务。

大多数人认为 Ansible 是一种更强大的“处于 for 循环中的 SSH”,在简单的使用场景下这是真的。但其实 Ansible 是任务,而非 SSH。在很多情况下,我们通过 SSH 进行连接,但它也支持 Windows 机器上的 Windows 远程管理(WinRM),以及作为云服务的通用语言的 HTTPS API 之类的东西。

在云中,Ansible 可以在两个独立的层面上操作: 控制面 control plane 和 实例资源 on-instance resource 。控制面由所有没有运行在操作系统上的东西组成。包括设置网络、新建实例、供给更高级别的服务,如亚马逊的 S3 或 DynamoDB,以及保持云基础设施安全和服务客户​​所需的一切。

实例上的工作是你已经知道 Ansible 可以做的:启动和停止服务、配置文件 模版化 templating 、安装软件包以及通过 SSH 执行的所有与操作系统相关的操作。

现在,什么是 无服务 serverless 呢?这要看你问谁,无服务要么是对公有云的无限延伸,或者是一个全新的范例,其中所有的东西都是 API 调用,以前从来没有这样做过。

Ansible 采取第一种观点。在 “无服务” 是专门术语之前,用户不得不管理和配置 EC2 实例、虚拟私有云 (VPC) 网络以及其他所有内容。无服务是托管服务方向迈出的另一步,并且与 Ansible 的无代理体系结构相得益彰。

在我们开始 Lambda 示例之前,让我们来看一个简单的配置 CloudFormation 栈任务:

- name: Build network
  cloudformation:
    stack_name: prod-vpc
    state: present
    template: base_vpc.yml

编写这样的任务只需要几分钟,但它是构建基础架构所涉及的最后的半手动步骤 - 点击 “Create Stack” - 这将 playbook 与其他放在一起。现在你的 VPC 只是在建立新区域时可以调用的另一项任务了。

由于云提供商是你帐户中发生些什么的真相来源,因此 Ansible 有许多方法来取回并使用 ID、名称和其他参数来过滤和查询运行的实例或网络。以 cloudformation_facts 模块为例,我们可以从我们刚刚创建的模板中得到子网 ID、网络范围和其他数据。

- name: Pull all new resources back in as a variable
  cloudformation_facts:
    stack_name: prod-vpc
  register: network_stack

对于无服务应用,除了 DynamoDB 表,S3 bucket 和其他任何其他功能之外,你肯定还需要一个 Lambda 函数的补充。幸运的是,通过使用 lambda 模块, Lambda 函数可以以上次任务的堆栈相同的方式创建:

- lambda:
    name: sendReportMail
    zip_file: "{{ deployment_package }}"
    runtime: python3.6
    handler: report.send
    memory_size: 1024
    role: "{{ iam_exec_role }}"
  register: new_function

如果你有其他想用来交付无服务应用的工具,这也是可以的。开源的无服务框架有自己的 Ansible 模块,它也可以工作:

- serverless:
    service_path: '{{ project_dir }}'
    stage: dev
  register: sls
- name: Serverless uses CloudFormation under the hood, so you can easily pull info back into Ansible
  cloudformation_facts:
    stack_name: "{{ sls.service_name }}"
  register: sls_facts

这不是你需要的全部,因为无服务项目也必须存在,你将在那里大量的定义你的函数和事件源。对于此例,我们将制作一个响应 HTTP 请求的函数。无服务框架使用 YAML 作为其配置语言(和 Ansible 一样),所以这应该看起来很熟悉。

# serverless.yml
service: fakeservice

provider:
  name: aws
  runtime: python3.6

functions:
  main:
    handler: test_function.handler
    events:
      - http:
          path: /
          method: get

在 AnsibleFest 中,我将介绍这个例子和其他深入的部署策略,以最大限度地利用你已经拥有的 playbook 和基础设施,还有新的无服务实践。无论你是否能到,我希望这些例子可以让你开始使用 Ansible,无论你是否有任何服务要管理。

AnsibleFest 是一个单日会议,汇集了数百名 Ansible 用户、开发人员和行业合作伙伴。加入我们吧,这里有产品更新、鼓舞人心的交谈、技术深度潜水,动手演示和整天的网络。

(题图: opensource.com)


via: https://opensource.com/article/17/8/ansible-serverless-applications

作者:Ryan Scott Brown 译者:geekpi 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

今年像动态插件,Serverless Go 以及 HTTP/2 这些创新对你的开发意味着什么?

Go 1.8 刚刚发布,它有几个新功能,包括:

这些新功能的影响力取决于你和开发团队如何使用 Go。 自从 Go 1.0 于 2012 年发布以来,其简单性、并发性和内置支持使其保持普及度不断增长,所以对“Go 擅长什么”的答案一直在增长。

这里我会提供一些想法,包括新到来的版本及 Go 世界最近其它吸引我的地方。这不是一个详尽的列表,所以请让我知道你认为在 2017 年 Go 还会发生哪些重要的事。

Go 的超级可部署性 + 插件 = 容器、任何东西?

1.8 版本已经发布,我已经与其中几个人交谈过添加动态插件会如何影响像容器之类的事物,动态插件是为了加载在编译时不是程序一部分的共享库的代码。 动态插件使容器中的高并发微服务变得更加简单。 你可以轻松地以外部进程的方式加载插件,同时具备在容器中微服务的所有好处:保护你的主进程不会崩溃,并且没有任何东西会搞乱你的内存空间。 对插件的动态支持应该是在 Go 中使用容器的福音。

关于专家现场 Go 培训,请注册 Go Beyond the Basics。

跨平台支持仍在吸引开发人员

在 Go 开源之后的 7 年里,它已被全球采用。Daniel Whitenack 是一名数据科学家和工程师,他为 Jupyter 维护 Go 内核,告诉我最近他在西伯利亚做数据科学和 Go 语言培训,(是的,在西伯利亚!数据科学和 Go - 之后再细讲一下...)并 “很惊讶地看到那里 Go 社区是如此活跃和积极。” 人们继续在项目中采取 Go 的另一个很大的原因是交叉编译,对此,几个 Go 专家解释说这在 Go 1.5 版本中变得更容易了。来自其他语言(如 Python)的开发人员应该发现,在没有 VM 的目标平台上,能够为多个操作系统构建捆绑的、可部署的应用程序是在 Go 中工作的关键。

在 1.8 版本中对跨平台的支持,再加上提升了 15% 的编译速度,你就可以看到为什么 Go 是初创公司最喜欢的语言。

有兴趣了解 Go 的基础知识吗?查看 Go 基础学习路径 让 O’Reilly 专家来带你开始。

Go 解释器在开发中;再见 Read-Eval-Print-Loop

有一些聪明的家伙正在做一个 Go 解释器,我一定会持续关注它。如你所知的那样,有几个 Read-Eval-Print-Loop(REPL)的解决方案可以用来评估表达式,以确保代码如你预期的工作,但那些方法通常意味着容忍一些不便,或需要费力从几个方案中找到一个适合你的用例的。有一个健壮、一致的解释器就太好了,一旦我了解到更多消息,我会告诉你们。

在开发中使用 Go 复杂特性?观看 O'Reilly 的视频训练 中级 Go 。

Go 的 serverless - 会是什么样子?

是的,现在围绕 serverless 架构(功能即服务(FaaS))有很多炒作。但有时候也有些捉摸不定的地方,那么关于 Go 的 serverless 发生了什么?我们能在今年看到一个 Go 语言原生支持的 serverless 服务么?

AWS Lambda 是最知名的 serverless 提供商,不过 Google 最近也推出了 Google Cloud Functions。这两个 FaaS 解决方案使你可以在无须管理服务器的情况下运行代码,你的代码存储在别人为你管理的服务器集群上,并且仅在触发事件调用它时运行。AWS Lambda 目前支持 JavaScript、Python 和 Java,还可以启动 Go、Ruby 和 bash 进程。 Google Cloud Functions 只支持 JavaScript,但很可能不久将支持 Java 和 Python。许多物联网设备已经使用 serverless 方案,随着 Go 越来越多地被创业公司采用,serverless 似乎是一个可能的增长点,所以我在关注这些 serverless 解决方案中 Go 的开发情况。

已经有几个框架可以支持 AWS Lambdas:

  • λ Gordon - 使用 CloudFormation 创建、连接及部署 AWS Lambdas
  • Apex - 构建、部署及管理 AWS Lambda 函数
  • Sparta - AWS Lambda 微服务的 Go 框架

还有一个 AWS Lambda 替代品支持 Go:

  • Iron.io:建立在 Docker 和 Go 之上;语言未知;支持 Golang、Python、Ruby、PHP 和 .NET

有关 serverless 架构的更多信息,请观看 Mike Roberts 在旧金山 O'Reilly 软件架构会议上的演讲主题:serverless介绍。

数据科学中的 Go

我在本文开头暗示了这一点:也许令人惊讶的是很多人都在使用 Go 进行数据科学和机器学习。关于它是否适合还有一些争论,但基于像 《Gopher 学院之 2016 年终》那样的年度文章中,你会注意到 30 篇文章中至少有 4 篇是关于机器学习或分布式数据处理,它们正在像我们走来。

我之前关于 Go 的易部署性的观点可能是数据科学家使用 Go 的一个关键原因:他们可以更轻松地在易读而可用于生产环境的应用程序中向他人展示数据模型。与此相结合的是 Go 的广泛使用(正如我前面提到的,它正变得越来越流行!),而且有数据专家创建“可用并且与其它程序配合”的程序。任何使用 Go 构建的应用数据科学家会在公司其他部分使用相同的语言,或者至少它非常适合现代架构。

更多关于 Go 的数据科学,Daniel Whitenack 写了一个很好的概述,解释了如何使用它: Data Science Gophers。


作者简介:

O'Reilly Media 的监督编辑,与编辑团队合作,涵盖各种各样的编程主题。


via: https://medium.com/@sconant/5-things-to-watch-in-go-programming-in-2017-39cd7a7e58e3#.8t4to5jr1

作者:Susan Conant 译者:geekpi 校对:jasminepeng

本文由 LCTT 原创编译,Linux中国 荣誉推出

近来,在计算领域出现了很多关于 serverless 的讨论。serverless 是一个概念,它允许你提供代码或可执行程序给某个服务,由服务来为你执行它们,而你无需自己管理服务器。这就是所谓的 执行即服务 ( execution-as-a-service ) ,它带来了很多机会,同时也遇到了它独有的挑战。

简短回忆下计算领域的发展

早期,出现了……好吧,这有点复杂。很早的时候,出现了机械计算机,后来又有了埃尼阿克 ENIAC(Electronic Numerical Integrator And Computer,很早的电子计算机),但是都没有规模生产。直到大型机出现后,计算领域才快速发展。
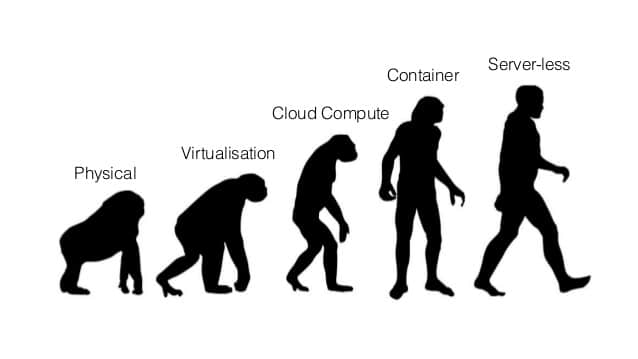
  • 上世纪 50 年代 - 大型机
  • 上世纪 60 年代 - 微型机
  • 1994 - 机架服务器
  • 2001 - 刀片服务器
  • 本世纪初 - 虚拟服务器
  • 2006 - 服务器云化
  • 2013 - 容器化
  • 2014 - serverless(计算资源服务化)
这些日期是大概的发布或者流行日期,无需和我争论时间的准确性。

计算领域的演进趋势是执行的功能单元越来越小。每一次演进通常都意味着运维负担的减小和运维灵活性的增加。

发展前景

喔,Serverless!但是,serverless 能给我们带来什么好处? 我们将面临什么挑战呢?

未执行代码时无需付费。我认为,这是个巨大的卖点。当无人访问你的站点或用你的 API 时,你无需付钱。没有持续支出的基础设施成本,仅仅支付你需要的部分。换句话说,这履行了云计算的承诺:“仅仅支付你真正用的资源”。

无需维护服务器,也无需考虑服务器安全。服务器的维护和安全将由你的服务提供商来处理(当然,你也可以架设自己的 serverless 主机,只是这似乎是在向错误的方向前进)。由于你的执行时间也是受限的,安全补丁也被简化了,因为完全不需要重启。这些都应该由你的服务提供商无缝地处理。

无限的可扩展性。这是又一个大的好处。假设你又开发了一个 Pokemon Go, 与其频繁地把站点下线维护升级,不如用 serverless 来不断地扩展。当然,这也是个双刃剑,大量的账单也会随之而来。如果你的业务的利润强依赖于站点上线率的话,serverless 确实能帮上忙。

强制的微服务架构。这也有两面性,一方面,微服务似乎是一种好的构建灵活可扩展的、容错的架构的方式。另一方面,如果你的业务没有按照这种方式设计,你将很难在已有的架构中引入 serverless。

但是现在你被限制在他们的平台上

受限的环境。你只能用服务提供商提供的环境,你想在 Rust 中用 serverless?你可能不会太幸运。

受限的预装包。你只有提供商预装的包。但是你或许能够提供你自己的包。

受限的执行时间。你的 Function 只可以运行这么长时间。如果你必须处理 1TB 的文件,你可能需要有一个解决办法或者用其他方案。

强制的微服务架构。参考上面的描述。

受限的监视和诊断能力。例如,你的代码在干什么? 在 serverless 中,基本不可能在调试器中设置断点和跟踪流程。你仍然可以像往常一样记录日志并发出统计度量,但是这带来的帮助很有限,无法定位在 serverless 环境中发生的难点问题。

竞争领域

自从 2014 年出现 AWS Lambda 以后,serverless 的提供商已经增加了一些。下面是一些主流的服务提供商:

  • AWS Lambda - 起步最早的
  • OpenWhisk - 在 IBM 的 Bluemix 云上可用
  • Google Cloud Functions
  • Azure Functions

这些平台都有它们的相对优势和劣势(例如,Azure 支持 C#,或者紧密集成在其他提供商的平台上)。这里面最大的玩家是 AWS。

通过 AWS 的 Lambda 和 API Gateway 构建你的第一个 API

我们来试一试 serverless。我们将用 AWS Lambda 和 API Gateway 来构建一个能返回 Jimmy 所说的“Guru Meditations”的 API。

所有代码在 GitHub 上可以找到。

API文档:

POST /
{
    "status": "success",
    "meditation": "did u mention banana cognac shower"
}

怎样组织工程文件

文件结构树:

.
├── LICENSE
├── README.md
├── server
│   ├── __init__.py
│   ├── meditate.py
│   └── swagger.json
├── setup.py
├── tests
│   └── test_server
│       └── test_meditate.py
└── tools
    ├── deploy.py
    ├── serve.py
    ├── serve.sh
    ├── setup.sh
    └── zip.sh

AWS 中的信息(想了解这里究竟在做什么的详细信息,可查看源码 tools/deploy.py)。

  • API。实际构建的对象。它在 AWS 中表示为一个单独的对象。
  • 执行角色。在 AWS 中,每个 Function 作为一个单独的角色执行。在这里就是 meditations。
  • 角色策略。每个 Function 作为一个角色执行,每个角色需要权限来干活。我们的 Lambda Function 不干太多活,故我们只添加一些日志记录权限。
  • Lambda Function。运行我们的代码的地方。
  • Swagger。 Swagger 是 API 的规范。API Gateway 支持解析 swagger 的定义来为 API 配置大部分资源。
  • 部署。API Gateway 提供部署的概念。我们只需要为我们的 API 用一个就行(例如,所有的都用生产或者 yolo等),但是得知道它们是存在的,并且对于真正的产品级服务,你可能想用开发和暂存环境。
  • 监控。在我们的业务崩溃的情况下(或者因为使用产生大量账单时),我们想以云告警查看方式为这些错误和费用添加一些监控。注意你应该修改 tools/deploy.py 来正确地设置你的 email。

代码

Lambda Function 将从一个硬编码列表中随机选择一个并返回 guru meditations,非常简单:

import logging
import random

logger = logging.getLogger()
logger.setLevel(logging.INFO)

def handler(event, context):

    logger.info(u"received request with id '{}'".format(context.aws_request_id))

    meditations = [
    "off to a regex/",
    "the count of machines abides",
    "you wouldn't fax a bat",
    "HAZARDOUS CHEMICALS + RKELLY",
    "your solution requires a blood eagle",
    "testing is broken because I'm lazy",
    "did u mention banana cognac shower",
    ]

    meditation = random.choice(meditations)

    return {
        "status": "success",
        "meditation": meditation,
    }

deploy.py 脚本

这个脚本相当长,我没法贴在这里。它基本只是遍历上述“AWS 中的信息”下的项目,确保每项都存在。

我们来部署这个脚本

只需运行 ./tools/deploy.py。

基本完成了。不过似乎在权限申请上有些问题,由于 API Gateway 没有权限去执行你的 Function,所以你的 Lambda Function 将不能执行,报错应该是“Execution failed due to configuration error: Invalid permissions on Lambda function”。我不知道怎么用 botocore 添加权限。你可以通过 AWS console 来解决这个问题,找到你的 API, 进到 /POST 端点,进到“integration request”,点击“Lambda Function”旁边的编辑图标,修改它,然后保存。此时将弹出一个窗口提示“You are about to give API Gateway permission to invoke your Lambda function”, 点击“OK”。

当你完成后,记录下 ./tools/deploy.py 打印出的 URL,像下面这样调用它,然后查看你的新 API 的行为:

$ curl -X POST https://a1b2c3d4.execute-api.us-east-1.amazonaws.com/prod/
{"status": "success", "meditation": "the count of machines abides"}

本地运行

不幸的是,AWS Lambda 没有好的方法能在本地运行你的代码。在这个例子里,我们将用一个简单的 flask 服务器来在本地托管合适的端点,并调用 handler 函数。

from __future__ import absolute_import

from flask import Flask, jsonify

from server.meditate import handler

app = Flask(__name__)

@app.route("/", methods=["POST"])
def index():

    class FakeContext(object):
        aws_request_id = "XXX"

    return jsonify(**handler(None, FakeContext()))

app.run(host="0.0.0.0")

你可以在仓库中用 ./tools/serve.sh 运行它,像这样调用:

$ curl -X POST http://localhost:5000/
{
    "meditation": "your solution requires a blood eagle",
    "status": "success"
}

测试

你总是应该测试你的代码。我们的测试方法是导入并运行我们的 handler 函数。这是最基本的 python 测试方法:

from __future__ import absolute_import

import unittest

from server.meditate import handler

class SubmitTestCase(unittest.TestCase):

    def test_submit(self):

        class FakeContext(object):

            aws_request_id = "XXX"

        response = handler(None, FakeContext())

        self.assertEquals(response["status"], "success")
        self.assertTrue("meditation" in response)

你可以在仓库里通过 nose2 运行这个测试代码。

更多前景

  • 和 AWS 服务的无缝集成。通过 boto,你可以完美地轻易连接到任何其他的 AWS 服务。你可以轻易地让你的执行角色用 IAM 访问这些服务。你可以从 S3 取文件或放文件到 S3,连接到 Dynamo DB,调用其他 Lambda Function,等等。
  • 访问数据库。你也可以轻易地访问远程数据库。在你的 Lambda handler 模块的最上面连接数据库,并在handler 函数中执行查询。你很可能必须从它的安装位置上传相关的包内容才能使它正常工作。可能你也需要静态编译某些库。
  • 调用其他 webservices。API Gateway 也是一种把 webservices 的输出从一个格式转换成另一个格式的方法。你可以充分利用这个特点通过不同的 webservices 来代理调用,或者当业务变更时提供后向兼容能力。

via: http://blog.ryankelly.us/2016/08/07/going-serverless-with-aws-lambda-and-api-gateway.html

作者:Ryan Kelly 译者:messon007 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出
当今世界会时不时地出现一波波科技浪潮,将以前的技术拍死在海滩上。针对 serverless 应用的概念我们已经谈了很多,它是指将你的应用程序按功能来部署,这些功能在被用到时才会启动。你不用费心去管理服务器和程序规模,因为它们会在需要的时候在一个集群中启动并运行。

但是 serverless 并不意味着没有 Docker 什么事儿,事实上 Docker 就是 serverless 的。你可以使用 Docker 来容器化这些功能,然后在 Swarm 中按需求来运行它们。serverless 是一项构建分布式应用的技术,而 Docker 是它们完美的构建平台。

从 servers 到 serverless

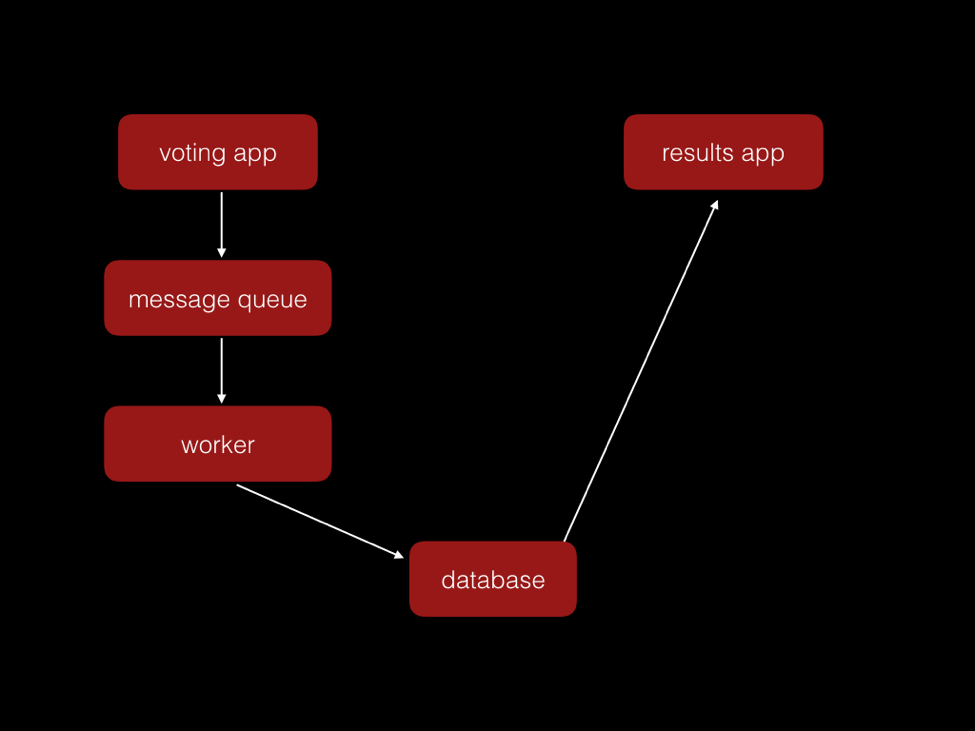
那如何才能写一个 serverless 应用呢?来看一下我们的例子,5个服务组成的投票系统:

投票系统由下面5个服务组成:

  • 两个 web 前端
  • 一个后台处理投票的进程
  • 一个计票的消息队列
  • 一个数据库

后台处理投票的进程很容易转换成 serverless 构架,我们可以使用以下代码来实现:

import dockerrun
client = dockerrun.from_env()
client.run("bfirsh/serverless-record-vote-task", [voter_id, vote], detach=True)

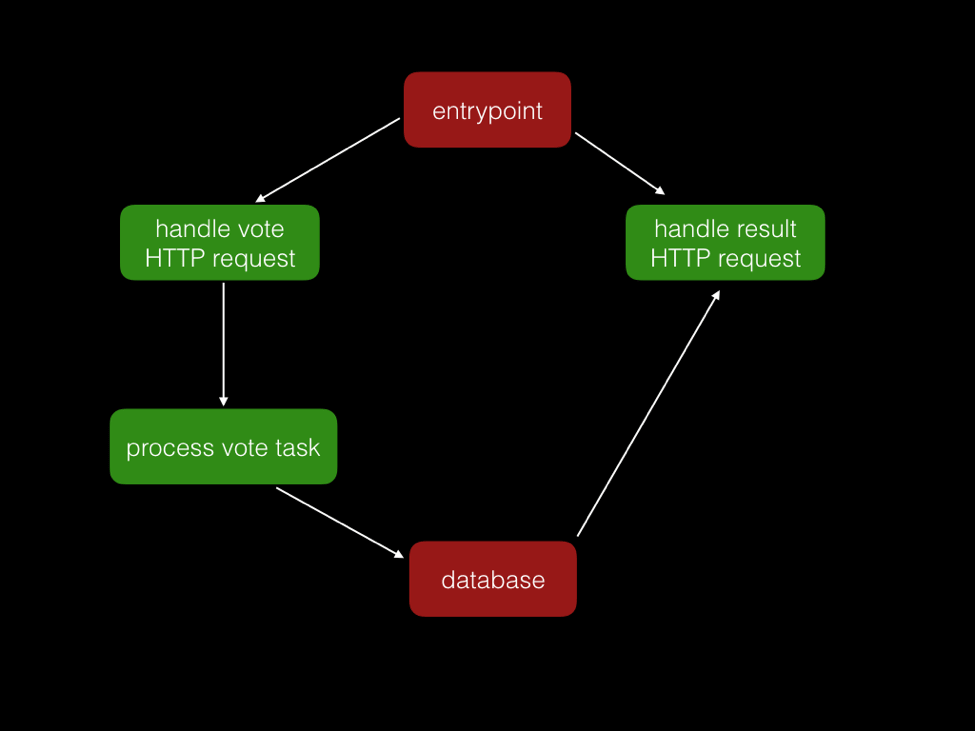
这个投票处理进程和消息队列可以用运行在 Swarm 上的 Docker 容器来代替,并实现按需自动部署。

我们也可以用容器替换 web 前端,使用一个轻量级 HTTP 服务器来触发容器响应一个 HTTP 请求。Docker 容器代替长期运行的 HTTP 服务器来挑起响应请求的重担,这些容器可以自动扩容来支撑更大访问量。

新的架构就像这样:

红色框内是持续运行的服务,绿色框内是按需启动的容器。这个架构里需要你来管理的长期运行服务更少,并且可以自动扩容(最大容量由你的 Swarm 决定)。

我们可以做点什么?

你可以在你的应用中使用3种技术:

  1. 在 Docker 容器中按需运行代码。
  2. 使用 Swarm 来部署集群。
  3. 通过使用 Docker API 套接字在容器中运行容器。

结合这3种技术,你可以有很多方法搭建你的应用架构。用这种方法来部署后台环境真是非常有效,而在另一些场景,也可以这么玩,比如说:

  • 由于存在延时,使用容器实现面向用户的 HTTP 请求可能不是很合适,但你可以写一个负载均衡器,使用 Swarm 来对自己的 web 前端进行自动扩容。
  • 实现一个 MongoDB 容器,可以自检 Swarm 并且启动正确的分片和副本(LCTT 译注:分片技术为大规模并行检索提供支持,副本技术则是为数据提供冗余)。

下一步怎么做

我们提供了这些前卫的工具和概念来构建应用,并没有深入发掘它们的功能。我们的架构里还是存在长期运行的服务,将来我们需要使用 Swarm 来把所有服务都用按需扩容的方式实现。

希望本文能在你搭建架构时给你一些启发,但我们还是需要你的帮助。我们提供了所有的基本工具,但它们还不是很完善,我们需要更多更好的工具、库、应用案例、文档以及其他资料。

我们在这里发布了工具、库和文档。如果想了解更多,请贡献给我们一些你知道的资源,以便我们能够完善这篇文章。

玩得愉快。

更多关于 Docker 的资料


via: https://blog.docker.com/2016/06/building-serverless-apps-with-docker/

作者:Ben Firshman 译者:bazz2 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出