标签 Kubernetes 下的文章

Constellation 是第一个始终加密的 kubernetes(K8S)。在这个 K8S 中,你的所有工作负载和控制平面都被完全屏蔽起来,你可以使用加密证书远程确认这一点。

Constellation Kubernetes 引擎使用 秘密计算 secret computing 和 机密虚拟机 confidential VM ,将 Kubernetes 集群与云架构的其余部分隔离开来。因此,无论是在静态还是在内存中,数据总是被加密的,并创建了一个 机密上下文 confidential context 。根据创建 Constellation 的公司 Edgeless Systems 的说法,由于它为在公共云上运行的数据和工作流增加了安全性和保密性,因此机密计算是云计算的未来。

Kubernetes 节点在使用 Constellation 的私有虚拟机中运行。根据 Edgeless Systems 的说法,机密虚拟机是安全飞地的演变,它将机密计算的三个原则——运行时加密、隔离和远程证明——扩展到整个虚拟系统。机密虚拟机(TDX)使用底层硬件对私有计算的特殊支持,例如 AMD 安全加密虚拟化(AEM)、SEV-安全嵌套分页(SEV-SNP)和英特尔信任域扩展。此外,ARM 去年还发布了名为 Realms 的新 V9 架构。此设计包括私有 VM 功能。

Constellation 尝试在集群级别提供证明或通过加密证书进行验证,以及“始终在线”加密。 Constellation 中的机密 VMS 使用了 Fedora CoreOS,它构建在一个不可变的文件系统之上,是面向容器而设计的。Constellation 还利用 Sigstore 来保护 DevOps 信任链。

使用秘密计算时,性能可能会令人担忧。是的,加密会影响性能,但 AMD 和微软的联合基准测试发现,这只会导致 2% 到 8% 之间的微小性能损失。Edgeless Systems 声称 Constellation 将在繁重的工作负载下表现类似。

鉴于 Constellation 已通过 CNCF 认证,并且可与包括 GCP 和 Azure 在内的所有主要云服务互操作,这应保证其与其他 Kubernetes 工作负载和工具的互操作性。


via: https://www.opensourceforu.com/2022/09/kubernetes-to-soon-support-confidential-computing/

作者:Laveesh Kocher 选题:lkxed 译者:littlebirdnest 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

了解 Kubernetes 架构中不同组件是如何组合在一起的,这样你就可以更好地排查问题、维护一个健康的集群,以及优化工作流。

 title=

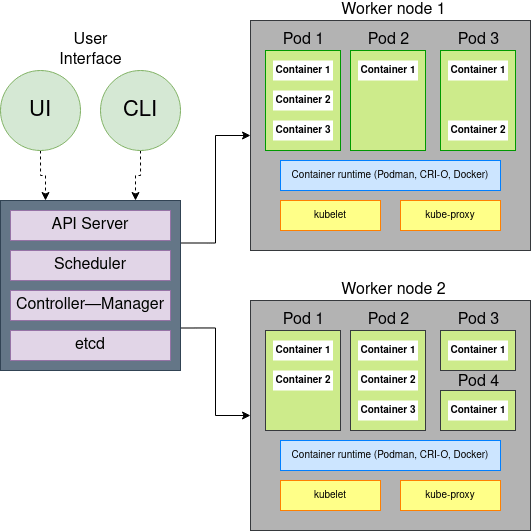
使用 Kubernetes 来编排容器,这种描述说起来简单,但理解它的实际含义以及如何实现它完全是另外一回事。如果你正在运行或管理 Kubernetes 集群,那么你就会知道 Kubernetes 由一台称为 “ 控制平面 control plane ” 的机器和许多其他 工作节点 worker node 机器组成。每种类型都有一个复杂但稳定的堆栈,这使编排成为可能,熟悉每个组件有助于理解它是如何工作的。

 title=

(Nived Velayudhan, CC BY-SA 4.0)

控制平面组件

Kubernetes 安装在一个称为“ 控制平面 control plane ”的机器上,它会运行 Kubernetes 守护进程,并在启动容器和 容器组 pod 时与之通信。下面介绍控制平面的各个组件。

etcd

etcd 是一种快速、分布式一致性键值存储器,用作 Kubernetes 对象数据的持久存储,如容器组、副本控制器、密钥和服务。etcd 是 Kubernetes 存储集群状态和元数据的唯一地方。唯一与 etcd 直连的组件是 Kubernetes API 服务器。其他所有组件都通过 API 服务器间接的从 etcd 读写数据。

etcd 还实现了一个监控功能,它提供了一个基于事件的接口,用于异步监控键的更改。一旦你更改了一个键,它的监控者就会收到通知。API 服务器组件严重依赖于此来获得通知,并将 etcd 变更至期望状态。

为什么 etcd 实例的数量应该是奇数?

你通常会运行三个、五个或七个 etcd 实例实现高可用(HA)环境,但这是为什么呢?因为 etcd 是分布式数据存储,可以水平扩展它,但你需要确保每个实例中的数据是一致的。因此,需要为系统当前状态达成共识,etcd 为此使用 RAFT 共识算法。

RAFT 算法需要经过选举(或仲裁)集群才能进入下一个状态。如果你只有两个 etcd 实例并且他们其中一个失败的话,那么 etcd 集群无法转换到新的状态,因为不存在过半这个概念。如果你有三个 etcd 实例,一个实例可能会失败,但仍有 2 个实例可用于进行选举。

API 服务器

API 服务器是 Kubernetes 中唯一直接与 etcd 交互的组件。Kubernetes 中的其他所有组件都必须通过 API 服务器来处理集群状态,包括客户端(kubectl)。API 服务器具有以下功能:

  • 提供在 etcd 中存储对象的一致方式。
  • 执行验证对象,防止客户端存储配置不正确的对象(如果它们直接写入 etcd 数据存储,可能会发生这种情况)。
  • 提供 RESTful API 来创建、更新、修改或删除资源。
  • 提供 乐观并发锁,在发生更新时,其他客户端永远不会有机会重写对象。
  • 对客户端发送的请求进行身份验证和授权。它使用插件提取客户端的用户名、ID、所属组,并确定通过身份验证的用户是否可以对请求的资源执行请求的操作。
  • 如果请求试图创建、修改或删除资源,则负责 权限控制。例如,AlwaysPullImages、DefaultStorageClass 和 ResourceQuota。
  • 实现了一种监控机制(类似于 etcd),用户客户端监控更改。这允许调度器和控制器管理器等组件以松耦合的方式与 API 服务器交互。

控制器管理器

在 Kubernetes 中,控制器持续监控集群状态,然后根据需要进行或请求更改。每个控制器都尝试将当前集群状态变更至期望状态。控制器至少跟踪一种 Kubernetes 资源类型,这些对象均有一个字段来表示期望的状态。

控制器示例:

  • 副本管理器(管理 副本控制器 ReplicationController 资源的控制器)
  • 副本集 ReplicaSet 、守护进程集DaemonSet 和任务控制器
  • 部署控制器
  • 有状态负载控制器
  • 节点控制器
  • 服务控制器
  • 接入点控制器
  • 命名空间控制器
  • 持久卷 PersistentVolume 控制器

控制器通过监控机制来获得变更通知。它们监视 API 服务器对资源的变更,对每次更改执行操作,无论是新建对象还是更新或删除现有对象。大多数时候,这些操作包括创建其他资源或更新监控的资源本身。不过,由于使用监控并不能保证控制器不会错过任何事件,它们还会定期执行一系列操作,确保没有错过任何事件。

控制器管理器还执行生命周期功能。例如命名空间创建和生命周期、事件垃圾收集、已终止容器组垃圾收集、级联删除垃圾收集 和节点垃圾收集。有关更多信息,参考 云控制器管理器。

调度器

调度器是一个将容器组分配给节点的控制平面进程。它会监视新创建没有分配节点的容器组。调度器会给每个发现的容器组分配运行它的最佳节点。

满足容器组调度要求的节点称为可调度节点。如果没有合适的节点,那么容器组会一直处于未调度状态,直到调度器可以安置它。一旦找到可调度节点,它就会运行一组函数来对节点进行评分,并选择得分最高的节点,然后它会告诉 API 服务器所选节点的信息。这个过程称为绑定。

节点的选择分为两步:

  1. 过滤所有节点的列表,获得可以调度容器组的节点列表(例如,PodFitsResources 过滤器检查候选节点是否有足够的可用资源来满足容器组的特定资源请求)。
  2. 对第一步得到的节点列表进行评分和排序,选择最佳节点。如果得分最高的有多个节点,循环过程可确保容器组会均匀地部署在所有节点上。

调度决策要考虑的因素包括:

  • 容器组是否请求硬件/软件资源?节点是否报告内存或磁盘压力情况?
  • 节点是否有与容器组规范中的节点选择器匹配的标签?
  • 如果容器组请求绑定到特定地主机端口,该端口是否可用?
  • 容器组是否容忍节点的污点?
  • 容器组是否指定节点亲和性或反亲和性规则?

调度器不会指示所选节点运行容器组。调度器所做的就是通过 API 服务器更新容器组定义。然后 API 服务器通过监控机制通知 kubelet 容器组已被调度,然后目标节点上的 kubelet 服务看到容器组被调度到它的节点,它创建并运行容器组。

工作节点组件

工作节点运行 kubelet 代理,这允许控制平面接纳它们来处理负载。与控制平面类似,工作节点使用几个不同的组件来实现这一点。 以下部分描述了工作节点组件。

Kubelet

Kubelet 是一个运行在集群中每个节点上的代理,负责在工作节点上运行的所有事情。它确保容器在吊舱中运行。

kubelet服务的主要功能有:

  • 通过在 API 服务器中创建节点资源来注册它正在运行的节点。
  • 持续监控 API 服务器上调度到节点的容器组。
  • 使用配置的容器运行时启动容器组的容器。
  • 持续监控正在运行的容器,并将其状态、事件和资源消耗报告给 API 服务器。
  • 运行容器存活探测,在探测失败时重启容器,当 API 服务器中删除容器组时终止(通知服务器容器组终止的消息)。

服务代理

服务代理(kube-proxy)在每个节点上运行,确保一个容器组可以与另一个容器组通讯,一个节点可以与另一个节点对话,一个容器可以与另一个容器对话。它负责监视 API 服务器对服务和容器组定义的更改,以保持整个网络配置是最新的。当一项服务得到多个容器组的支持时,代理会在这些容器组之间执行负载平衡。

kube-proxy 之所以叫代理,是因为它最初实际上是一个代理服务器,用于接受连接并将它们代理到容器组。当前的实现是使用 iptables 规则将数据包重定向到随机选择的后端容器组,而无需通过实际的代理服务器。

关于它工作原理的高级视图:

  • 当你创建一个服务时,会立即分配一个虚拟 IP 地址。
  • API 服务器会通知在工作节点上运行的 kube-proxy 代理有一个新服务。
  • 每个 kube-proxy 通过设置 iptables 规则使服务可寻址,确保截获每个服务 IP/端口对,并将目的地址修改为支持服务的一个容器组。
  • 监控 API 服务器对服务或其端点对象的更改。

容器运行时

容器运行时有两类:

  • 较低级别的容器运行时: 它们主要关注运行中的容器并为容器设置命名空间和 控制组 cgroup 。
  • 更高级别的容器运行时(容器引擎): 它们专注于格式、解包、管理、共享镜像以及为开发人员提供 API。

容器运行时负责:

  • 如果容器镜像本地不存在,则从镜像仓库中提取。
  • 将镜像解压到写时复制文件系统,所有容器层叠加创建一个合并的文件系统。
  • 准备一个容器挂载点。
  • 设置容器镜像的元数据,如覆盖命令、用户输入的入口命令,并设置 SECCOMP 规则,确保容器按预期运行。
  • 通知内核将进程、网络和文件系统等隔离分配给容器。
  • 通知内核分配一些资源限制,如 CPU 或内存限制。
  • 将系统调用(syscall)传递给内核启动容器。
  • 确保 SElinux/AppArmor 设置正确。

协同

系统级组件协同工作,确保 Kubernetes 集群的每个部分都能实现其目和执行其功能。当你深入编辑 YAML 文件 时,有时很难理解请求是如何在集群中通信的。现在你已经了解了各个部分是如何组合在一起的,你可以更好地理解 Kubernetes 内部发生了什么,这有助于诊断问题、维护健康的集群并优化你的工作流。


via: https://opensource.com/article/22/2/kubernetes-architecture

作者:Nived Velayudhan 选题:lujun9972 译者:MjSeven 校对:turbokernel

本文由 LCTT 原创编译,Linux中国 荣誉推出

通过查看创建一个吊舱或一个部署时的 10 个步骤,可以更好地了解 Kubernetes。

 title=

当你在 Kubernetes 上使用容器时,你经常把应用程序组合在一个 吊舱 pod 中。当你把一个容器或一个吊舱发布到生产环境中时,它被称为一个 部署 deployment 。如果你每天甚至每周都在使用 Kubernetes,你可能已经这样做过几百次了,但你有没有想过,当你创建一个吊舱或一个部署时到底会发生什么?

我发现在高层次上了解事件链条是有帮助的。当然,你不一定要理解它。即使你不知道为什么,它仍然在工作。我不打算列出每一件发生的小事,但我的目标是涵盖所有重要的事情。

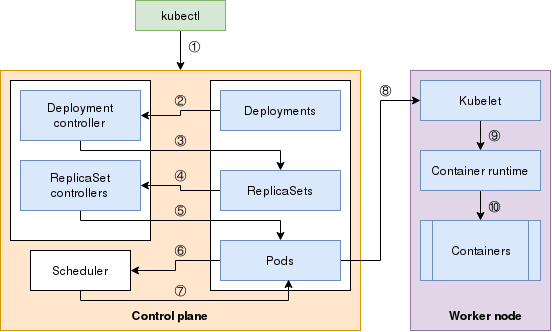
这里有一张 Kubernetes 不同组件如何互动的视觉地图。

 title=

你可能注意到,在上图中,我没有包括 etcd。API 服务器是唯一能够直接与 etcd 对话的组件,而且只有它能够对 etcd 进行修改。因此,你可以认为 etcd 在这张图中存在于(隐藏的)API 服务器后面。

另外,我在这里只讲到了两个主要的控制器( 部署控制器 Deployment controller 和 复制集控制器 ReplicaSet controller )。其他的控制器的工作方式类似。

下面的步骤描述了当你执行 kubectl create 命令时会发生什么。

步骤 1

当你使用 kubectl create 命令时,一个 HTTP POST 请求被发送到 API 服务器,其中包含部署清单。API 服务器将其存储在 etcd 数据存储中,并返回一个响应给 kubectl。

步骤 2 和 3

API 服务器有一个观察机制,所有观察它的客户都会得到通知。客户端通过打开与 API 服务器的 HTTP 连接来观察变化,API 服务器会流式地发出通知。其中一个客户端是部署控制器。部署控制器检测到一个 部署 Deployment 对象,它用部署的当前规格创建一个 复制集 ReplicaSet 。该资源被送回 API 服务器,并存储在 etcd 数据存储中。

步骤 4 和 5

与上一步类似,所有观察者都会收到关于 API 服务器中的变化的通知。这一次,复制集控制器会接收这一变化。该控制器了解所需的副本数量和对象规格中定义的吊舱选择器,创建吊舱资源,并将这些信息送回 API 服务器,存储在 etcd 数据存储中。

步骤 6 和 7

Kubernetes 现在拥有运行吊舱所需的所有信息,但吊舱应该在哪个节点上运行? 调度器 Scheduler 观察那些还没有分配到节点的吊舱,并开始对所有节点进行过滤和排序,以选择最佳节点来运行吊舱。一旦节点被选中,该信息将被添加到吊舱规格中。而且它被送回 API 服务器并存储在 etcd 数据存储中。

步骤 8、9 和 10

到目前为止的所有步骤都发生在 控制平面 control plane 本身。 工作节点 worker node 还没有做任何工作。不过,吊舱的创建并不是由控制平面处理的。相反,在所有节点上运行的 kubelet 服务观察 API 服务器中的吊舱规格,以确定它是否需要创建任何吊舱。在调度器选择的节点上运行的 kubelet 服务获得吊舱规格,并指示工作节点上的容器运行时创建容器。这时就会下载一个容器镜像(如果它还不存在的话),容器就会实际开始运行。

理解 Kubernetes 的部署

对这个一般流程的理解可以帮助你理解 Kubernetes 中的许多事件。考虑一下 Kubernetes 中的 守护进程集 DaemonSet 或 状态集 StatefulSet 。除了使用不同的控制器外,吊舱的创建过程是一样的。

课后作业:如果部署被修改为有三个应用程序的副本,导致创建吊舱的事件链条会是什么样子?你可以参考图表或列出的步骤,但你肯定有你需要弄清楚的知识。知识就是力量,你现在有了了解 Kubernetes 的一个重要组成部分。


via: https://opensource.com/article/22/3/visual-map-kubernetes-deployment

作者:Nived Velayudhan 选题:lujun9972 译者:wxy 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

无论你是在家庭实验室里试验 Kubernetes,还是想成为一个成为 Kubernetes 的维护者,这里都有适合你的资源。

 title=

2021 年对于 Kubernetes 来说是令人兴奋的一年,这些文章证明了这一点。从有趣的界面到家庭实验室再到开发环境,看看我在 2021 年最喜欢的 K8s 文章。

如果你对基本原理感兴趣,这篇 介绍 Linux 上的容器 的文章从内到外阐明了 Linux 容器的工作原理。你是否想获取一些乐趣?安装 minikube 并开始使用 DOOM 游戏作为界面 来管理它。另一个选择是 kubectl,这是一个更传统的 Kubernetes 控制 CLI。

即使你只在你的 Linux 家庭实验室 上运行 Kubernetes,你也可以使用 Terraform 和 Helm 等工具来自动化日常操作。这创造了一个 更好地掌握 Terraform 的机会。

生活中可以确定的几件事之一是,计算机会以奇怪而有趣的方式出错。用 Prometheus 和 Grafana 监控你的 Kubernetes 集群,看看它是如何出错的。使用 Grafana Tempo 的分布式跟踪来监控里面运行的应用。通过引入 Chaos Mesh 在 Kubernetes 中造成有意的混乱,来监控你监控的性能。

如果你正在开发在 Kubernetes 上运行的应用,Quarkus 可以帮助你开发和测试。使用 Java 的开发者 可以在 Kubernetes 上使用容器运行 应用。像 Tackle-DiVA 这样的工具有助于将应用移植到容器中。

像所有成功的开源项目一样,Kubernetes 的部分价值是一个强大的 生态系统。比如 KubeEdge 项目,它有助于将计算和数据更接近终端用户。在使用 Kubernetes 一段时间后,你甚至可能想 成为 Kubernetes 维护者。

有这么多有趣的 Kubernetes 内容可供学习,可能很难将它们全部看完。不过,对于系统管理员和开发人员来说,优秀的 Kubernetes 资源是必须的。请阅读这些精选的内容。


via: https://opensource.com/article/21/12/learn-kubernetes-2022

作者:Moshe Zadka 选题:lujun9972 译者:geekpi 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

探索 Kubernetes 中不同容器日志记录模式的工作原理。
 title=

服务器和应用程序日志记录是开发人员、运维人员和安全团队了解应用程序在其生产环境中运行状态的重要工具。

日志记录使运维人员能够确定应用程序和所需组件是否运行平稳,并检测是否发生了异常情况,以便他们能够对这种情况做出反应。

对于开发人员,日志记录提供了在开发期间和之后对代码进行故障排除的可见性。在生产环境中,开发人员通常依赖于没有调试工具的日志记录工具。在加上系统的日志记录,开发人员可以与运维人员携手合作,有效地解决问题。

日志记录工具最重要的受益者是安全团队,尤其是在云原生的环境中。能够从应用程序和系统日志中收集信息使得安全团队能够分析来自身份验证、应用程序访问恶意软件活动的数据,并在需要时进行响应。

Kubernetes 是领先的容器平台,越来越多的应用程序通过 Kubernetes 部署到生产环境。我相信了解 Kubernetes 的日志架构是一项非常重要的工作,每个开发、运维和安全团队都需要认真对待。

在本文中,我将讨论 Kubernetes 中不同容器日志记录模式的工作原理。

系统日志记录和应用日志记录

在深入研究 Kubernetes 日志记录架构之前,我想探索不同的日志记录方法以及这两种功能如何成为 Kubernetes 日志记录的关键特性。

有两种类型的系统组件:在容器中运行的组件和不在容器中运行的组件。例如:

  • Kubernetes 调度者和 kube-proxy 运行在容器中。
  • kubelet 和容器运行时不在容器中运行。

与容器日志类似,系统容器日志存储在 /var/log 目录中,你应该定期轮换它们。

在这里,我研究的是容器日志记录。首先,我看一下集群级别的日志记录以及为什么它对集群运维人员很重要。集群日志提供有关集群如何执行的信息。诸如为什么 吊舱 Pod 被下线或节点死亡之类的信息。集群日志记录还可以捕获诸如集群和应用程序访问以及应用程序如何利用计算资源等信息。总体而言,集群日志记录工具为集群运维人员提供操作集群和安全有用的信息。

捕获容器日志的另一种方法是通过应用程序的本机日志记录工具。现代应用程序设计很可能具有日志记录机制,可帮助开发人员通过标准输出 (stdout) 和错误流 (stderr) 解决应用程序性能问题。

为了拥有有效的日志记录工具,Kubernetes 实现需要应用程序和系统日志记录组件。

Kubernetes 容器日志的 3 种类型

如今,在大多数的 Kubernetes 实现中,你可以看到三种主要的集群级日志记录方法。

  1. 节点级日志代理
  2. 用于日志记录的 挎斗 Sidecar 容器应用程序
  3. 将应用程序日志直接暴露给日志后端

节点级日志代理

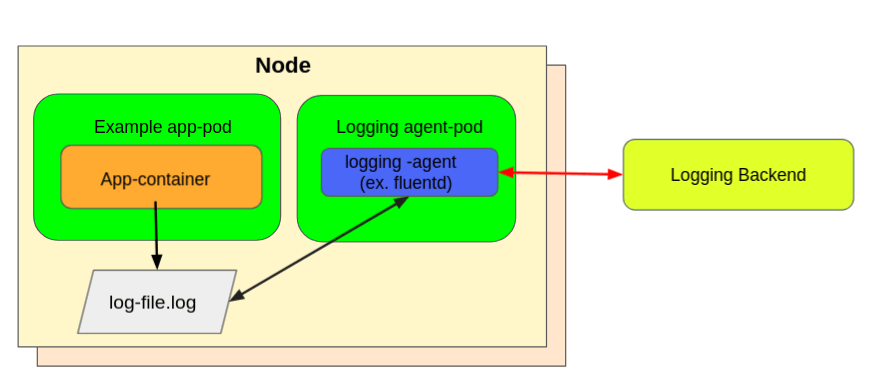
我想考虑节点级日志代理。你通常使用 DaemonSet 作为部署策略来实现这些,以便在所有 Kubernetes 节点中部署一个吊舱(充当日志代理)。然后,该日志代理被配置为从所有 Kubernetes 节点读取日志。你通常将代理配置为读取节点 /var/logs 目录捕获 stdout/stderr 流并将其发送到日志记录后端存储。

下图显示了在所有节点中作为代理运行的节点级日志记录。
 title=

以使用 fluentd 方法为例设置节点级日志记录,你需要执行以下操作:

1、首先,你需要创建一个名为 fluentdd 的服务账户。Fluentd 吊舱使用此服务账户来访问 Kubernetes API,你需要在日志命名空间中使用标签 app: fluentd 创建它们:

#fluentd-SA.yaml
apiVersion: v1
kind: ServiceAccount
metadata:
  name: fluentd
  namespace: logging
  labels:
    app: fluentd  

你可以在此 仓库 中查看完整示例。

2、接着,你需要创建一个名称为 fluentd-configmap 的 ConfigMap。这为 fluentd daemonset 提供了一个配置文件,其中包含所有必需的属性。

#fluentd-daemonset.yaml
apiVersion: extensions/v1beta1
kind: DaemonSet
metadata:
  name: fluentd
  namespace: logging
  labels:
    app: fluentd
    kubernetes.io/cluster-service: "true"
spec:
  selector:
    matchLabels:
      app: fluentd
      kubernetes.io/cluster-service: "true"
  template:
    metadata:
      labels:
        app: fluentd
        kubernetes.io/cluster-service: "true"
    spec:
      serviceAccount: fluentd
      containers:
      - name: fluentd
        image: fluent/fluentd-kubernetes-daemonset:v1.7.3-debian-elasticsearch7-1.0
        env:
          - name: FLUENT_ELASTICSEARCH_HOST
            value: "elasticsearch.logging.svc.cluster.local"
          - name: FLUENT_ELASTICSEARCH_PORT
            value: "9200"
          - name: FLUENT_ELASTICSEARCH_SCHEME
            value: "http"
          - name: FLUENT_ELASTICSEARCH_USER
            value: "elastic"
          - name: FLUENT_ELASTICSEARCH_PASSWORD
            valueFrom:
              secretKeyRef:
                name: efk-pw-elastic
                key: password
          - name: FLUENT_ELASTICSEARCH_SED_DISABLE
            value: "true"
        resources:
          limits:
            memory: 512Mi
          requests:
            cpu: 100m
            memory: 200Mi
        volumeMounts:
        - name: varlog
          mountPath: /var/log
        - name: varlibdockercontainers
          mountPath: /var/lib/docker/containers
          readOnly: true
        - name: fluentconfig
          mountPath: /fluentd/etc/fluent.conf
          subPath: fluent.conf
      terminationGracePeriodSeconds: 30
      volumes:
      - name: varlog
        hostPath:
          path: /var/log
      - name: varlibdockercontainers
        hostPath:
          path: /var/lib/docker/containers
      - name: fluentconfig
        configMap:
          name: fluentdconf

你可以在此 仓库 中查看完整示例。

现在,我们来看看如何将 fluentd daemonset 部署为日志代理的代码。

#fluentd-daemonset.yaml
apiVersion: extensions/v1beta1
kind: DaemonSet
metadata:
  name: fluentd
  namespace: logging
  labels:
    app: fluentd
    kubernetes.io/cluster-service: "true"
spec:
  selector:
    matchLabels:
      app: fluentd
      kubernetes.io/cluster-service: "true"
  template:
    metadata:
      labels:
        app: fluentd
        kubernetes.io/cluster-service: "true"
    spec:
      serviceAccount: fluentd
      containers:
      - name: fluentd
        image: fluent/fluentd-kubernetes-daemonset:v1.7.3-debian-elasticsearch7-1.0
        env:
          - name: FLUENT_ELASTICSEARCH_HOST
            value: "elasticsearch.logging.svc.cluster.local"
          - name: FLUENT_ELASTICSEARCH_PORT
            value: "9200"
          - name: FLUENT_ELASTICSEARCH_SCHEME
            value: "http"
          - name: FLUENT_ELASTICSEARCH_USER
            value: "elastic"
          - name: FLUENT_ELASTICSEARCH_PASSWORD
            valueFrom:
              secretKeyRef:
                name: efk-pw-elastic
                key: password
          - name: FLUENT_ELASTICSEARCH_SED_DISABLE
            value: "true"
        resources:
          limits:
            memory: 512Mi
          requests:
            cpu: 100m
            memory: 200Mi
        volumeMounts:
        - name: varlog
          mountPath: /var/log
        - name: varlibdockercontainers
          mountPath: /var/lib/docker/containers
          readOnly: true
        - name: fluentconfig
          mountPath: /fluentd/etc/fluent.conf
          subPath: fluent.conf
      terminationGracePeriodSeconds: 30
      volumes:
      - name: varlog
        hostPath:
          path: /var/log
      - name: varlibdockercontainers
        hostPath:
          path: /var/lib/docker/containers
      - name: fluentconfig
        configMap:
          name: fluentdconf

将这些放在一起执行:

kubectl apply -f fluentd-SA.yaml \
              -f fluentd-configmap.yaml \
              -f fluentd-daemonset.yaml

用于日志记录的挎斗容器应用程序

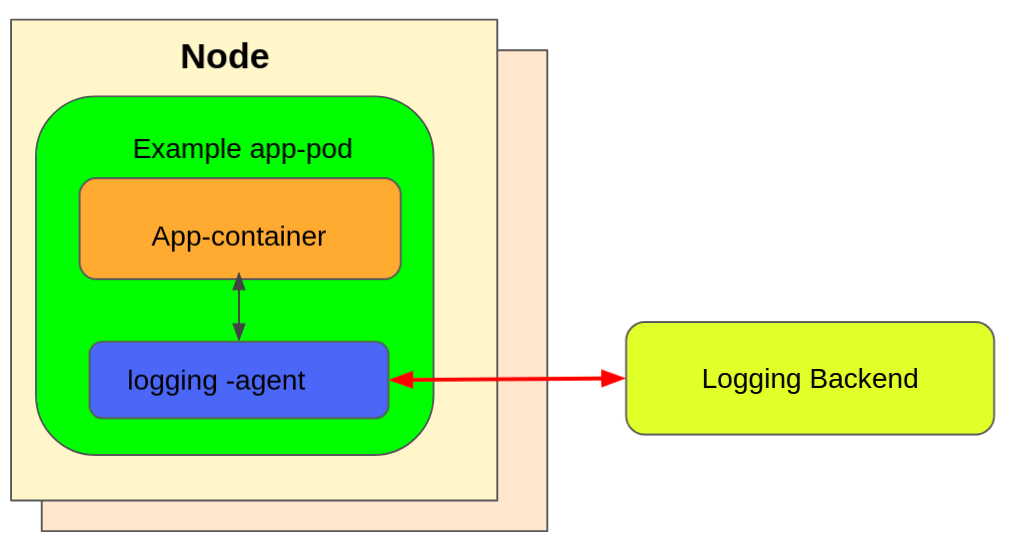
另一种方法是使用带有日志代理的专用挎斗容器。容器最常见的实现是使用 Fluentd 作为日志收集器。在企业部署中(你无需担心一点计算资源开销),使用 fluentd(或类似)实现的挎斗容器提供了集群级日志记录的灵活性。这是因为你可以根据需要捕获的日志类型、频率和其它可能的调整来调整和配置收集器代理。

下图展示了作为日志代理的挎斗容器。
 title=

例如,一个吊舱运行单个容器,容器使用两种不同的格式写入两个不同的日志文件。吊舱的配置文件如下:

#log-sidecar.yaml
apiVersion: v1
kind: Pod
metadata:
  name: counter
spec:
  containers:
  - name: count
    image: busybox
    args:
   - /bin/sh
    - -c
    - >
     i=0;
      while true;
      do
        echo "$i: $(date)" >> /var/log/1.log;
        echo "$(date) INFO $i" >> /var/log/2.log;
        i=$((i+1));
        sleep 1;
      done
    volumeMounts:
    - name: varlog
      mountPath: /var/log
  - name: count-log
    image: busybox
    args: [/bin/sh, -c, 'tail -n+1 -f /var/log/1.log']
    volumeMounts:
    - name: varlog
      mountPath: /var/log
  volumes:
  - name: varlog
    emptyDir: {}

把它们放在一起,你可以运行这个吊舱:

$ kubectl apply -f log-sidecar.yaml

要验证挎斗容器是否用作日志代理,你可以执行以下操作:

$ kubectl logs counter count-log

预期的输出如下所示:

$ kubectl logs counter count-log-1

Thu 04 Nov 2021 09:23:21 NZDT
Thu 04 Nov 2021 09:23:22 NZDT
Thu 04 Nov 2021 09:23:23 NZDT
Thu 04 Nov 2021 09:23:24 NZDT

将应用程序日志直接暴露给日志后端

第三种方法(在我看来)是 Kubernetes 容器和应用程序日志最灵活的日志记录解决方案,是将日志直接推送到日志记录后端解决方案。尽管此模式不依赖于原生 Kubernetes 功能,但它提供了大多数企业需要的灵活性,例如:

  1. 扩展对网络协议和输出格式的更广泛支持。
  2. 提供负载均衡能力并提高性能。
  3. 可配置为通过上游聚合接受复杂的日志记录要求。

因为这第三种方法通过直接从每个应用程序推送日志来依赖非 Kubernetes 功能,所以它超出了 Kubernetes 的范围。

结论

Kubernetes 日志记录工具是企业部署 Kubernetes 集群的一个非常重要的组件。我讨论了三种可能的可用模式。你需要找到适合你需求的模式。

如上所述,使用 daemonset 的节点级日志记录是最容易使用的部署模式,但它也有一些限制,可能不适合你的组织的需要。另一方面,挎斗 模式提供了灵活性和自定义,允许你自定义要捕获的日志类型,但是会提高计算机的资源开销。最后,将应用程序日志直接暴露给后端日志工具是另一种允许进一步定制的诱人方法。

选择在你,你只需要找到适合你组织要求的方法。


via: https://opensource.com/article/21/11/cluster-logging-kubernetes

作者:Mike Calizo 选题:lujun9972 译者:perfiffer 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出
复制控制器负责管理吊舱的生命周期并确保在任何时候运行着所需的指定数量的吊舱。

 title=

你有没有想过,谁负责监督和管理 Kubernetes 集群内运行的“ 吊舱 pod ”的确切数量?Kubernetes 可以通过多种方式做到这一点,但一个常见的方法是使用 “ 复制控制器 ReplicationController (RC)”。RC 负责管理吊舱的生命周期,并确保在任何时候运行着所需的指定数量的吊舱。但另一方面,它不负责高级的集群能力,如执行自动扩展、准备度和活跃探测以及其他高级的复制能力。Kubernetes 集群中的其他组件可以更好地执行这些功能。

简而言之,RC 的职责有限,通常用于不需要复杂逻辑就能达到某些要求的具体实现(例如,确保所需的吊舱数量总是与指定的数量相符)。如果超过了所需的数量,RC 会删除多余的,并确保即使在节点故障或吊舱终止的情况下,也有相同数量的存在。

简单的事情不需要复杂的解决方案,对我来说,这就是 RC 如何被使用的一个完美的比喻。

如何创建一个 RC

像大多数 Kubernetes 资源一样,你可以使用 YAML 或 JSON 格式创建一个 RC,然后将其发布到 Kubernetes API 端点。

$ kubectl create -f rcexample.yaml
 replicationcontroller/rcexample created

现在,我将深入一下 rcexample.yaml 的样子。

apiVersion: v1
kind: ReplicationController   →  RC 描述符    
metadata:
 name: rcexample            →  复制控制器名字              
spec:
 replicas: 3                 → 预期的吊舱数量      
 selector:                  → 这个 RC 的吊舱选择器
   app: nginx                        
 template:                  → 用于创建新吊舱的模板    
   metadata:                        
     labels:                        
       app: nginx                    
   spec:                            
     containers:                    
     - name: nginx                  
       image: nginx

进一步解释,这个文件在执行时创建了一个名为 rcexample 的 RC,确保三个名为 nginx 的吊舱实例一直在运行。如果一个或所有的 app=nginx 吊舱没有运行,新的吊舱将根据定义的吊舱模板创建。

一个 RC 有三个部分:

  • 复制品:3
  • 吊舱模板:app=nginx
  • 吊舱选择器:app=nginx

注意,吊舱模板要与吊舱选择器相匹配,以防止 RC 一直创建吊舱。如果你创建的 RC 的吊舱选择器与模板不匹配,Kubernetes API 服务器会给你一个错误。

为了验证 RC rcexample 是否被创建:

$ kubectl get po
NAME     READY   STATUS       RESTARTS  AGE
rcexample-53thy  0/1  Running         0     10s
rcexample-k0xz6  0/1  Running         0     10s
rcexample-q3vkg  0/1  Running         0     10s

要删除 RC:

$ kubectl delete rc rcexample
 replicationcontroller "rcexample" deleted

注意,你可以对 RC 中的服务使用 滚动更新 策略,逐个替换吊舱。

其他复制容器的方法

在 Kubernetes 部署中,有多种方法可以实现容器的复制。Kubernetes 成为容器平台的主要选择的主要原因之一是复制容器以获得可靠性、负载平衡和扩展的原生能力。

我在上面展示了你如何轻松地创建一个 RC,以确保在任何时候都有一定数量的吊舱可用。你可以通过更新副本的数量来手动扩展吊舱。

另一种可能的方法是通过使用 “ 复制集 ReplicaSet (RS)”来达到复制的目的。

(kind: ReplicaSet)

RS 的功能几乎与 RC 相同。主要区别在于,RS 不允许滚动更新策略。

另一种实现复制的方法是通过使用 “ 部署 Deployments ”。

(kind: Deployment)

部署是一种更高级的容器复制方法。从功能上讲,部署提供了相同的功能,但在需要时可以推出和回滚变化。这种功能之所以能够实现,是因为部署有 “ 策略类型 StrategyType ” 规范来用新的吊舱替换旧的吊舱。你可以定义两种类型的部署策略:“ 重新创建 Recreate ” 和 “ 滚动更新 RollingUpdate ”。你可以如下指定部署策略:

StrategyType: RollingUpdate

总结

容器的复制功能是大多数企业考虑采用 Kubernetes 的主要原因之一。复制可以让你达到大多数关键应用程序需要的可靠性和可扩展性,作为生产的最低要求。

了解在 Kubernetes 集群中使用哪些方法来实现复制,对于决定哪种方法最适合你的应用架构考虑非常重要。


via: https://opensource.com/article/21/11/kubernetes-replicationcontroller

作者:Mike Calizo 选题:lujun9972 译者:geekpi 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出