标签 集群 下的文章

在本文中,我们将介绍如何在 RHEL 9/8 上使用 Pacemaker 设置两节点高可用性 Apache 集群。

Pacemaker 是适用于类 Linux 操作系统的高可用性集群软件。Pacemaker 被称为“集群资源管理器”,它通过在集群节点之间进行资源故障转移来提供集群资源的最大可用性。Pacemaker 使用 Corosync 进行集群组件之间的心跳和内部通信,Corosync 还负责集群中的投票选举(Quorum)。

先决条件

在我们开始之前,请确保你拥有以下内容:

  • 两台 RHEL 9/8 服务器
  • Red Hat 订阅或本地配置的仓库
  • 通过 SSH 访问两台服务器
  • root 或 sudo 权限
  • 互联网连接

实验室详情:

事不宜迟,让我们深入了解这些步骤。

1、更新 /etc/hosts 文件

在两个节点上的 /etc/hosts 文件中添加以下条目:

192.168.1.6  node1.example.com
192.168.1.7  node2.example.com

2、安装高可用包 Pacemaker

Pacemaker 和其他必需的包在 RHEL 9/8 的默认包仓库中不可用。因此,我们必须启用高可用仓库。在两个节点上运行以下订阅管理器命令。

对于 RHEL 9 服务器:

$ sudo subscription-manager repos --enable=rhel-9-for-x86_64-highavailability-rpms

对于 RHEL 8 服务器:

$ sudo subscription-manager repos --enable=rhel-8-for-x86_64-highavailability-rpms

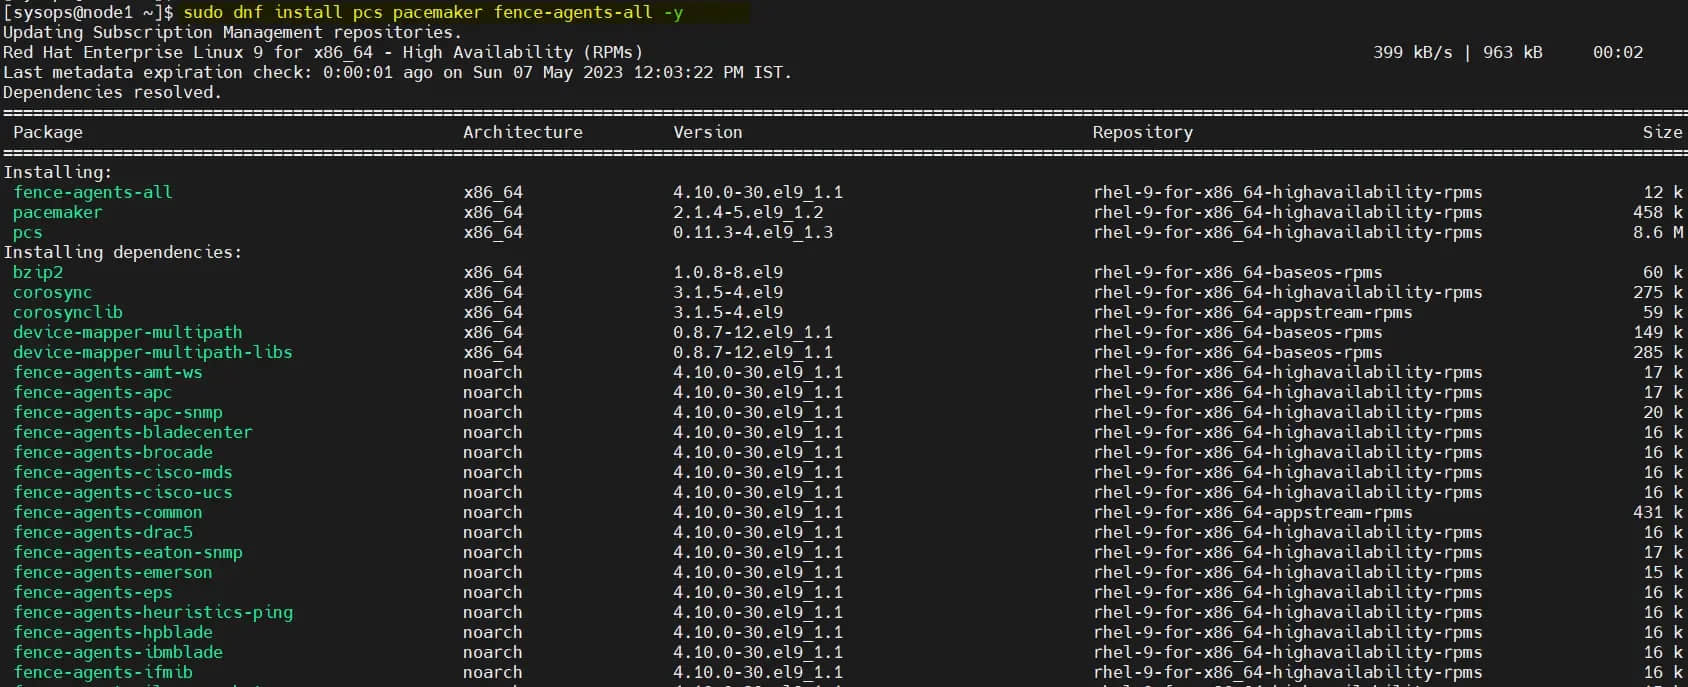
启用仓库后,运行命令在两个节点上安装 pacemaker 包:

$ sudo dnf install pcs pacemaker fence-agents-all -y
3、在防火墙中允许高可用端口

要允许防火墙中的高可用端口,请在每个节点上运行以下命令:

$ sudo firewall-cmd --permanent --add-service=high-availability
$ sudo firewall-cmd --reload

4、为 hacluster 用户设置密码并启动 pcsd 服务

在两台服务器上为 hacluster 用户设置密码,运行以下 echo 命令:

$ echo "<Enter-Password>" | sudo passwd --stdin hacluster

执行以下命令在两台服务器上启动并启用集群服务:

$ sudo systemctl start pcsd.service
$ sudo systemctl enable pcsd.service

5、创建高可用集群

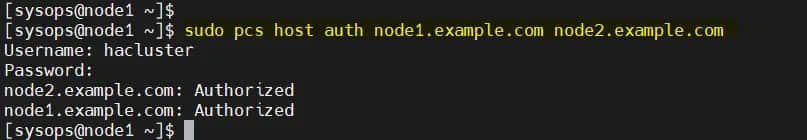
使用 pcs 命令对两个节点进行身份验证,从任何节点运行以下命令。在我的例子中,我在 node1 上运行它:

$ sudo pcs host auth node1.example.com node2.example.com

使用 hacluster 用户进行身份验证。
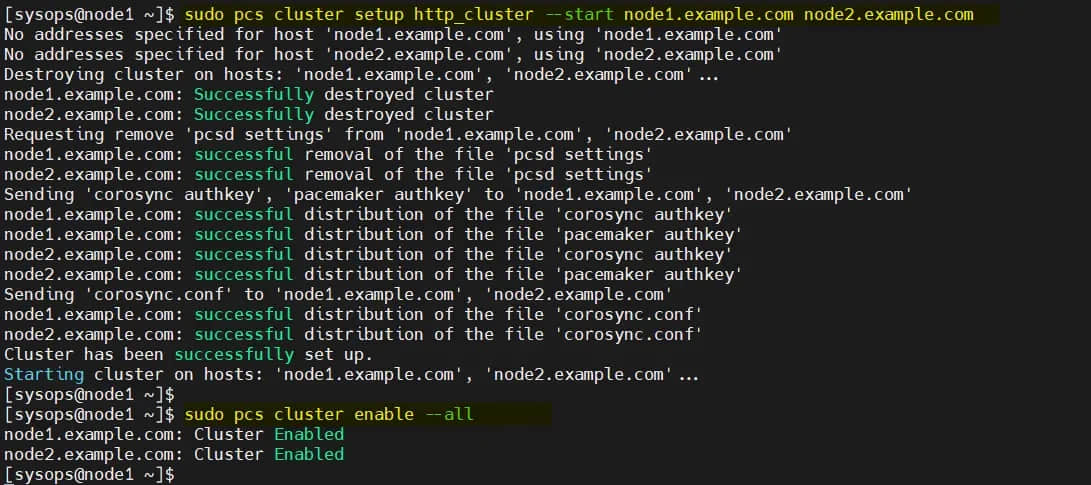
使用下面的 pcs cluster setup 命令将两个节点添加到集群,这里我使用的集群名称为 http_cluster。仅在 node1 上运行命令:

$ sudo pcs cluster setup http_cluster --start node1.example.com node2.example.com
$ sudo pcs cluster enable --all

这两个命令的输出如下所示:
从任何节点验证初始集群状态:

$ sudo pcs cluster status
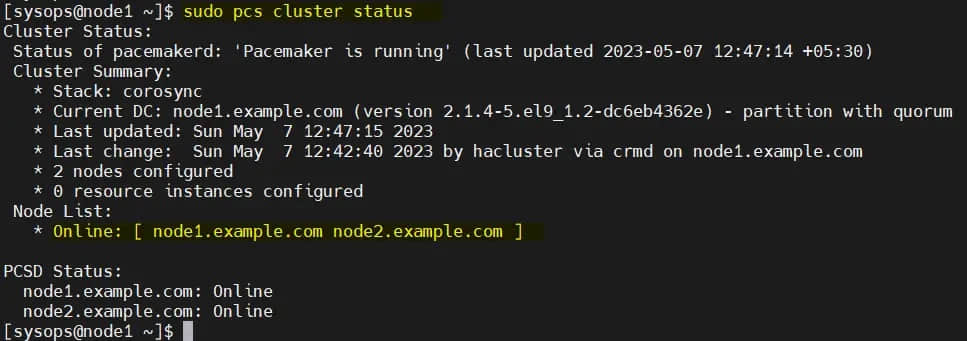
注意:在我们的实验室中,我们没有任何防护设备,因此我们将其禁用。但在生产环境中,强烈建议配置防护。

$ sudo pcs property set stonith-enabled=false
$ sudo pcs property set no-quorum-policy=ignore

6、为集群配置共享卷

在服务器上,挂载了一个大小为 2GB 的共享磁盘(/dev/sdb)。因此,我们将其配置为 LVM 卷并将其格式化为 XFS 文件系统。

在开始创建 LVM 卷之前,编辑两个节点上的 /etc/lvm/lvm.conf 文件。

将参数 #system_id_source = "none" 更改为 system_id_source = "uname":

$ sudo sed -i 's/# system_id_source = "none"/ system_id_source = "uname"/g' /etc/lvm/lvm.conf

在 node1 上依次执行以下一组命令创建 LVM 卷:

$ sudo pvcreate /dev/sdb
$ sudo vgcreate --setautoactivation n vg01 /dev/sdb
$ sudo lvcreate -L1.99G -n lv01 vg01
$ sudo lvs /dev/vg01/lv01
$ sudo mkfs.xfs /dev/vg01/lv01
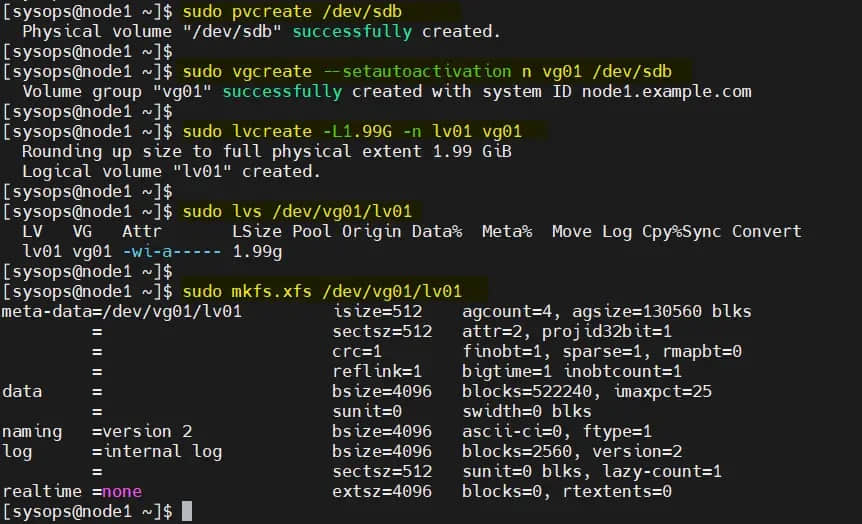
将共享设备添加到集群第二个节点(node2.example.com)上的 LVM 设备文件中,仅在 node2 上运行以下命令:

[sysops@node2 ~]$ sudo lvmdevices --adddev /dev/sdb

7、安装和配置 Apache Web 服务器(httpd)

在两台服务器上安装 Apache web 服务器(httpd),运行以下 dnf 命令:

$ sudo dnf install -y httpd wget

并允许防火墙中的 Apache 端口,在两台服务器上运行以下 firewall-cmd 命令:

$ sudo firewall-cmd --permanent --zone=public --add-service=http
$ sudo firewall-cmd --permanent --zone=public --add-service=https
$ sudo firewall-cmd --reload

在两个节点上创建 status.conf 文件,以便 Apache 资源代理获取 Apache 的状态:

$ sudo bash -c 'cat <<-END > /etc/httpd/conf.d/status.conf
<Location /server-status>
    SetHandler server-status
    Require local
</Location>
END'
$

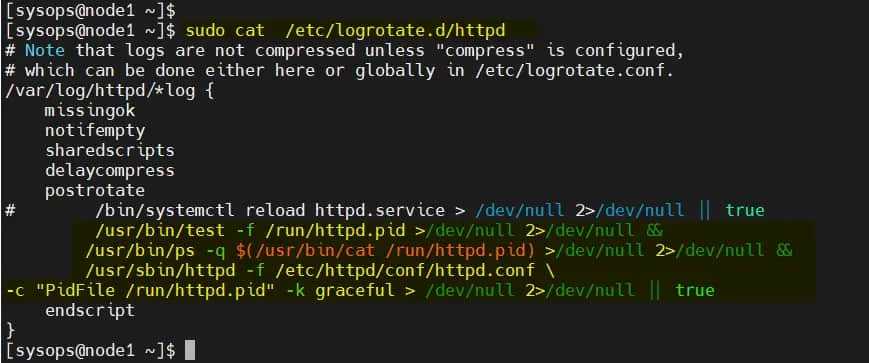
修改两个节点上的 /etc/logrotate.d/httpd:

替换下面的行

/bin/systemctl reload httpd.service > /dev/null 2>/dev/null || true

为

/usr/bin/test -f /run/httpd.pid >/dev/null 2>/dev/null &&
/usr/bin/ps -q $(/usr/bin/cat /run/httpd.pid) >/dev/null 2>/dev/null &&
/usr/sbin/httpd -f /etc/httpd/conf/httpd.conf \
-c "PidFile /run/httpd.pid" -k graceful > /dev/null 2>/dev/null || true

保存并退出文件。
8、为 Apache 创建一个示例网页

仅在 node1 上执行以下命令:

$ sudo lvchange -ay vg01/lv01
$ sudo mount /dev/vg01/lv01 /var/www/
$ sudo mkdir /var/www/html
$ sudo mkdir /var/www/cgi-bin
$ sudo mkdir /var/www/error
$ sudo bash -c ' cat <<-END >/var/www/html/index.html
<html>
<body>High Availability Apache Cluster - Test Page </body>
</html>
END'
$
$ sudo umount /var/www

注意:如果启用了 SElinux,则在两台服务器上运行以下命令:

$ sudo restorecon -R /var/www

9、创建集群资源和资源组

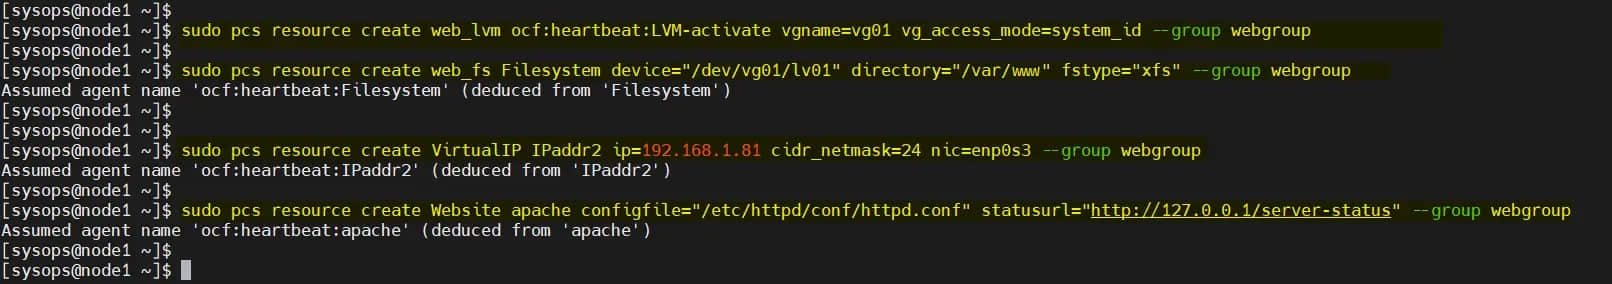
为集群定义资源组和集群资源。在我的例子中,我们使用 webgroup 作为资源组。

  • web_lvm 是共享 LVM 卷的资源名称(/dev/vg01/lv01)
  • web_fs 是将挂载在 /var/www 上的文件系统资源的名称
  • VirtualIP 是网卡 enp0s3 的 VIP(IPadd2)资源
  • Website 是 Apache 配置文件的资源。

从任何节点执行以下命令集。

$ sudo pcs resource create web_lvm ocf:heartbeat:LVM-activate vgname=vg01 vg_access_mode=system_id --group webgroup
$ sudo pcs resource create web_fs Filesystem device="/dev/vg01/lv01" directory="/var/www" fstype="xfs" --group webgroup
$ sudo pcs resource create VirtualIP IPaddr2 ip=192.168.1.81 cidr_netmask=24 nic=enp0s3 --group webgroup
$ sudo pcs resource create Website apache configfile="/etc/httpd/conf/httpd.conf" statusurl="http://127.0.0.1/server-status" --group webgroup
现在验证集群资源状态,运行:

$ sudo pcs status
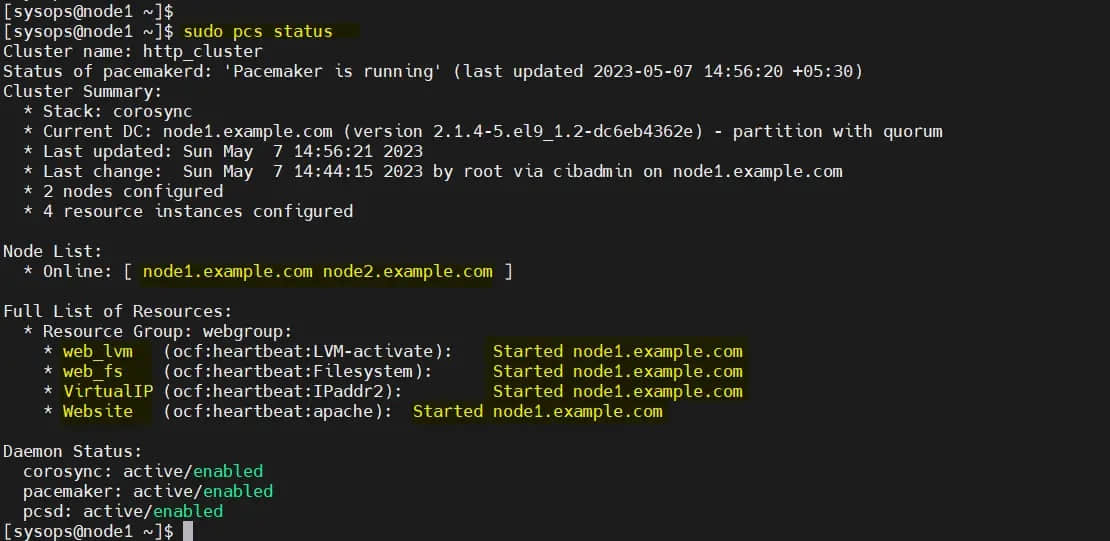
很好,上面的输出显示所有资源都在 node1 上启动。

10、测试 Apache 集群

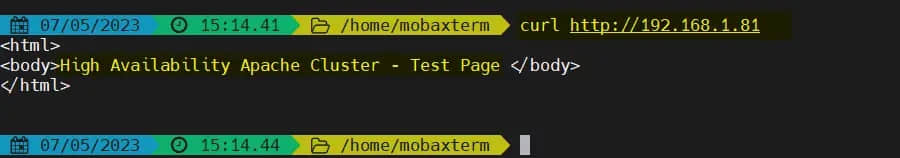
尝试使用 VIP(192.168.1.81)访问网页。

使用 curl 命令或网络浏览器访问网页:

$ curl http://192.168.1.81
或者

完美!以上输出确认我们能够访问我们高可用 Apache 集群的网页。

让我们尝试将集群资源从 node1 移动到 node2,运行:

$ sudo pcs node standby node1.example.com
$ sudo pcs status
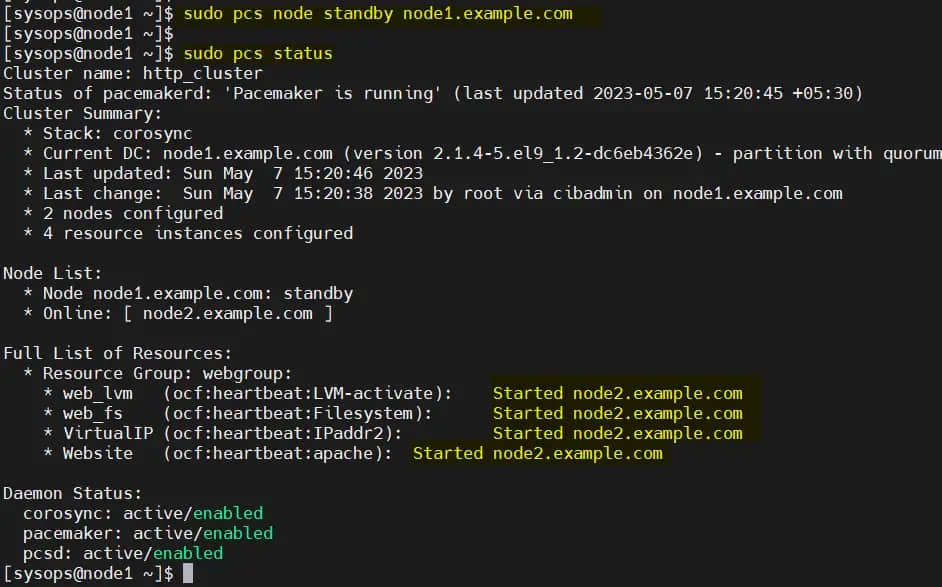
完美,以上输出确认集群资源已从 node1 迁移到 node2。

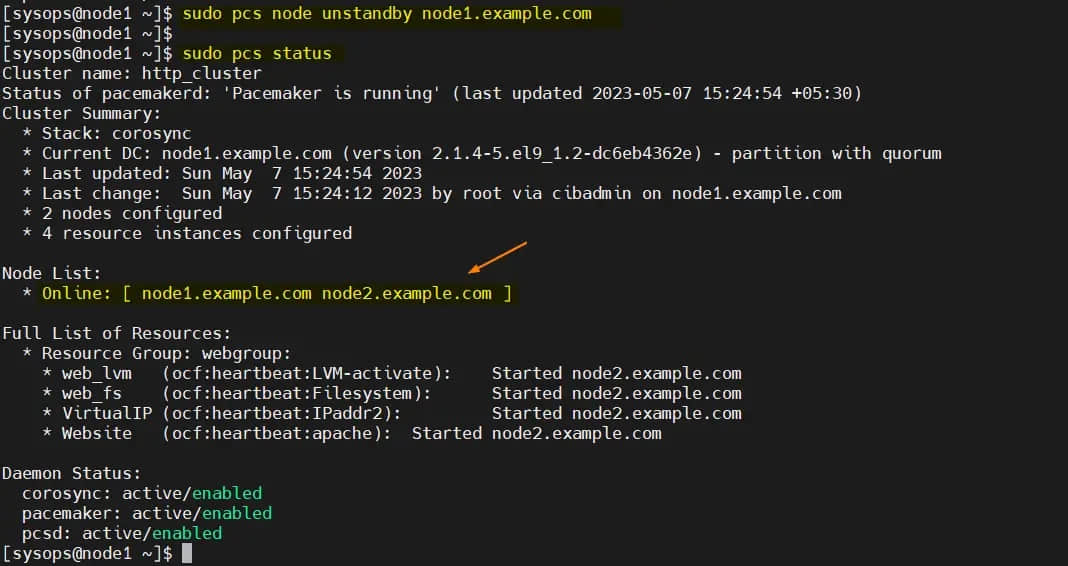
要从备用节点(node1.example.com)中删除节点,运行以下命令:

$ sudo pcs node unstandby node1.example.com
以上就是这篇文章的全部内容,我希望你发现它提供了丰富的信息,请在下面的评论部分中发表你的疑问和反馈。

(题图:MJ/3bf8c775-72ed-4e44-a28d-c872c7c8632f)


via: https://www.linuxtechi.com/high-availability-apache-cluster-on-rhel/

作者:Pradeep Kumar 选题:lkxed 译者:geekpi 校对:wxy
本文由 LCTT 原创编译,Linux中国 荣誉推出

这个使用树莓派集群的学术实验向远程教育学生介绍了并行和分布式计算(PDC)的概念。

自从树莓派推出以来,创造者们已经在这个简陋的袖珍芯片系统上开展了无数的计算机科学教育项目。其中包括许多探索低成本树莓派集群的项目,以介绍 并行和分布式计算 Parallel and Distributed Computing (PDC)概念。

英国 开放大学 Open University (OU)为不同年龄、经历和背景的学生提供远程教育,这就提出了一些在更传统的大学中没有面临的问题。开放大学使用树莓派集群向远程教育学生介绍 PDC 概念的实验始于 2019 年,并在一篇 学术论文 中进行了介绍,但值得更广泛地了解。

该项目使用基于 OctaPi 教程 的树莓派集群,该指令由 GCHQ 在知识共享许可协议下发布。八个树莓派使用一个路由器和一个交换机连接在一个私人网络中。其中一个树莓派充当主控,而其他的是服务器,将结果反馈给主控设备。用 Python 编写的程序运行在主控树莓派,而 dispy 包将活动分发在集群的各个处理核心上。

OctaPi 教程

他们为该集群开发了三个程序,你可以从 Git 仓库 下载它们。

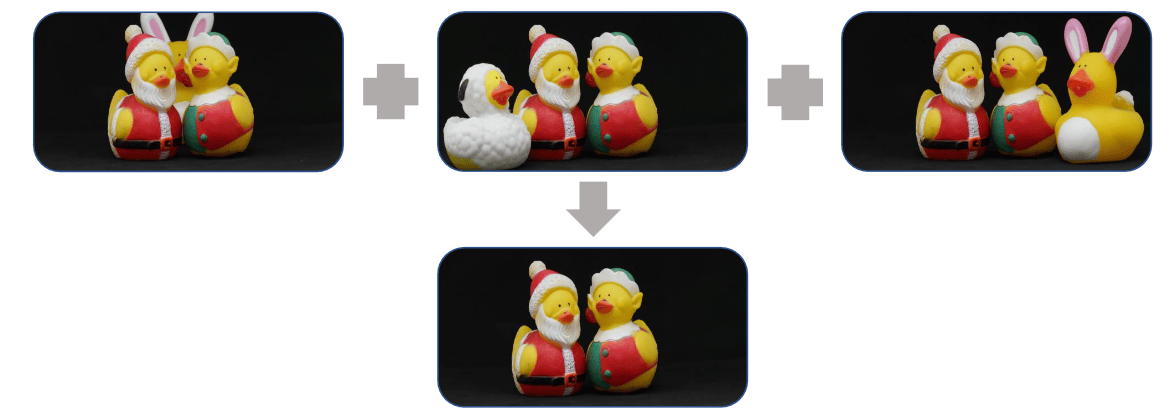
其中两个程序是基于文本的,并与搜索问题有关:旅行推销员和密码散列。作为完整的搜索问题,这些是教授 PDC 概念的理想选择。第三个程序是图形化的。图像组合器将三幅图像作为输入,其中有不重叠的障碍物。它通过对三幅图像的 RGBA 值进行逐个像素的比较并选择中位数来构建一个没有任何障碍物的图像。

使用集群

开放大学是一个远程学习机构,所以学生通过网页界面访问集群。对集群的远程访问使用大学的 OpenSTEM 实验室的基础设施。10 个集群(8 个用树莓派 4 构建,2 个用树莓派 3B+ 建造)被安装在机架上,用网络摄像头对准每个集群。

学生们选择要运行的程序,使用的核心数量,以及所选程序的参数。作为输出,他们可以看到该程序在单个树莓派上运行的时间与使用所选核数的集群的时间相比。学生还可以看到程序的输出,如密码散列结果、最小和最大的旅行推销员路线,或未遮挡的图像。

Generating a fourth image from information in three images

网络摄像头显示了集群的实时流。主控树莓派有一个 LED 显示屏,显示程序运行时的状态。网络摄像头让学生清楚地知道,他们是在用真正的专用硬件做实验,而不是得到模拟的或预先录制的结果。

Raspberry Pi cluster

每个程序都有两个与之相关的活动,描述了程序设计和 PDC 操作的不同方面。其中一个主要的学习点是,PDC 计算可以提供显著的性能优势,但代价是划分和分发问题以及反过来重新组合结果所花费的时间和资源。第二个学习点是,效率受程序设计的影响很大。

学生喜欢

目前,树莓派集群的使用是可选的。不过根据目前的研究结果,学生们很喜欢它,并因能远程接触到物理硬件而受到激励。

一位学生说:“能够使用真正的集群,而不是让它虚拟化,这真的很有趣”。

另一名学生补充说:“能够真正看到集群的工作,看到多核工作的真实效果,这真的很令人兴奋。能够亲自尝试,而不仅仅是阅读有关理论,这真是太好了!”

学生们正在使用集群开展旨在教授 PDC 原理的学习活动,而不是编写和运行他们自己的程序。开发低成本的树莓派集群供远程大学学生使用的经验表明,远程实践活动对教授 PDC 概念和吸引学生有好处。

当我向该项目背后的团队成员之一 Daniel Gooch 询问时,他说:“对我来说,我们的不同之处在于,我们采用了一套现有的树莓派教程,并致力于整合更多外围材料,以确保它能够应对我们操作的距离和规模。”


via: https://opensource.com/article/23/3/parallel-distributed-computing-raspberry-pi-clusters

作者:Peter Cheer 选题:lkxed 译者:geekpi 校对:wxy
本文由 LCTT 原创编译,Linux中国 荣誉推出

MySQL Cluster.me 开始提供基于 Galera Replication 技术的 MySQL 和 MariaDB 集群服务。

在本文中我们将会讨论 MySQL 和 MariaDB 集群服务的主要特性。

MySQL集群服务

MySQL 集群服务

什么是 MySQL 集群

如果你曾经疑惑过如何提升 MySQL 数据库的可靠性和可扩展性,或许你会发现其中一个解决办法就是通过基于 Galera Cluster 技术的 MySQL 集群解决方案。

这项技术使得你可以在一个或者多个数据中心的多个服务器上获得经过同步的完整 MySQL 数据副本。这可以实现数据库的高可用性 - 当你的一个或者多个数据库服务器崩溃后,仍然能够从其它剩余服务器上获得完整的服务。

需要注意的是在 MySQL 集群中需要至少 3 台服务器,因为当其中一台服务器从崩溃中恢复的时候需要从仍然存活的两台服务器中选择一个捐赠者拷贝一份数据,所以为了能够从崩溃中顺利恢复数据,必须要保证两台在线服务器以便从中恢复数据。(LCTT 译注:在捐赠者提供复制数据时,另外一台可以不停顿地提供服务)

同样,MariaDB 集群和 MySQL 集群在本质上是相同的,因为 MariaDB 是基于 MySQL 开发的一个更新、更优化的版本。

MySQL集群与Galera复制技术

MySQL 集群与 Galera 复制技术

什么是 MySQL 和 MariaDB 集群服务?

MySQL 集群服务提供了能够同时解决可靠性和可扩展性的方案。

首先,集群服务使你能够忽略任何数据中心引起的问题,并能获得高达 100% 正常运行时间的数据库高可用性。

其次,将乏味无趣的 MySQL 集群相关管理工作外包出去,能够使你更加专注于业务工作。

事实上,独立管理一个集群需要你能够完成以下所有工作:

  1. 安装和设置集群 – 这可能需要一个有经验的数据库管理员花费数小时来设置一个可用的集群。
  2. 集群监控 – 必须使用一种方案 24 * 7 监控集群运作,因为很多问题都可能发生-集群不同步、服务器崩溃、硬盘空间满等。
  3. 优化及调整集群大小 – 当你管理了很大的数据库时,调整集群大小将会是一个巨大的挑战。处理这个任务时需要格外小心。
  4. 备份管理 – 为了防止集群失败带来的危险,你需要备份集群数据。
  5. 解决问题 – 你需要一个经验丰富的工程师来对集群进行优化及解决相关问题。

但是现在你只需要通过使用 MySQLcluster.me 团队提供的 MySQL 集群服务就可以节省大量的时间和金钱。

MySQLcluster.me 提供的 MySQL 集群服务包括了哪些内容?

除了很多高可用性数据服务提供的 100% 可用性外,你还将获得如下保证:

  1. 任何时候都可以调整 MySQL 集群大小 – 你可以增加或者减少集群资源(包括 RAM、CPU、DISK)以便满足业务尖峰需求。
  2. 优化硬盘和数据库的性能 – 硬盘能够达到10000 IOPS,这对数据库操作十分重要。
  3. 数据中心选择 – 你可以选择将集群布置在哪个数据中心。当前支持的数据中心有:Digital Ocean、 Amazon AWS、 RackSpace、 Google Compute Engine。
  4. 24×7 集群服务支持 – 我们的团队能够为你集群上发生的任何问题提供支持,甚至包括对你的集群架构提供建议。
  5. 集群备份 – 我们团队会为你设置备份,这样你的集群数据能够每天备份到安全的地方。
  6. 集群监控 – 我们团队设置了自动监控以便能够及时发现你的集群出现的问题,并提供支持,哪怕你并没有在值班。

拥有自己的 MySQL 集群会有很多优势,但是需要你足够耐心和有经验才行。

与 MySQL Cluster 团队联系以便找到适合你的工具包.


作者简介:

我是 Ravi Saive,开发了 TecMint。电脑极客和 Linux 专家,喜欢分享关于互联网的建议和点子。我的大部分服务都运行在开源平台 Linux 上。关注我的 Twitter、Facebook 和 Google+。


via: http://www.tecmint.com/getting-started-with-mysql-clusters-as-a-service/

作者:Ravi Saive 译者:beyondworld 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

大家好,今天我们来研究一下如何使用Docker Machine部署Swarm集群。Docker Machine提供了标准的Docker API 支持,所以任何可以与Docker守护进程进行交互的工具都可以使用Swarm来(透明地)扩增到多台主机上。Docker Machine可以用来在个人电脑、云端以及的数据中心里创建Docker主机。它为创建服务器,安装Docker以及根据用户设定来配置Docker客户端提供了便捷化的解决方案。我们可以使用任何驱动来部署swarm集群,并且swarm集群将由于使用了TLS加密具有极好的安全性。

下面是我提供的简便方法。

1. 安装Docker Machine

Docker Machine 在各种Linux系统上都支持的很好。首先,我们需要从Github上下载最新版本的Docker Machine。我们使用curl命令来下载最先版本Docker Machine ie 0.2.0。

64位操作系统:

# curl -L https://github.com/docker/machine/releases/download/v0.2.0/docker-machine_linux-amd64 > /usr/local/bin/docker-machine

32位操作系统:

# curl -L https://github.com/docker/machine/releases/download/v0.2.0/docker-machine_linux-i386 > /usr/local/bin/docker-machine

下载了最先版本的Docker Machine之后,我们需要对 /usr/local/bin/ 目录下的docker-machine文件的权限进行修改。命令如下:

# chmod +x /usr/local/bin/docker-machine

在做完上面的事情以后,我们要确保docker-machine已经安装正确。怎么检查呢?运行docker-machine -v指令,该指令将会给出我们系统上所安装的docker-machine版本。

# docker-machine -v

为了让Docker命令能够在我们的机器上运行,必须还要在机器上安装Docker客户端。命令如下。

# curl -L https://get.docker.com/builds/linux/x86_64/docker-latest > /usr/local/bin/docker
# chmod +x /usr/local/bin/docker

2. 创建Machine

在将Docker Machine安装到我们的设备上之后,我们需要使用Docker Machine创建一个machine。在这篇文章中,我们会将其部署在Digital Ocean Platform上。所以我们将使用“digitalocean”作为它的Driver API,然后将docker swarm运行在其中。这个Droplet会被设置为Swarm主控节点,我们还要创建另外一个Droplet,并将其设定为Swarm节点代理。

创建machine的命令如下:

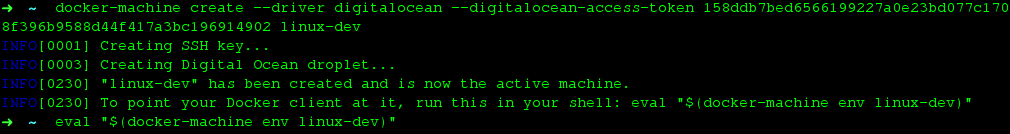
# docker-machine create --driver digitalocean --digitalocean-access-token <API-Token> linux-dev

备注: 假设我们要创建一个名为“linux-dev”的machine。是用户在Digital Ocean Cloud Platform的Digital Ocean控制面板中生成的密钥。为了获取这个密钥,我们需要登录我们的Digital Ocean控制面板,然后点击API选项,之后点击Generate New Token,起个名字,然后在Read和Write两个选项上打钩。之后我们将得到一个很长的十六进制密钥,这个就是了。用其替换上面那条命令中的API-Token字段。

现在,运行下面的指令,将Machine 的配置变量加载进shell里。

# eval "$(docker-machine env linux-dev)"

Docker Machine Digitalocean Cloud

然后,我们使用如下命令将我们的machine标记为ACTIVE状态。

# docker-machine active linux-dev

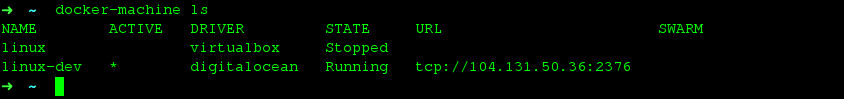
现在,我们检查它(指machine)是否被标记为了 ACTIVE "*"。

# docker-machine ls

Docker Machine Active List

3. 运行Swarm Docker镜像

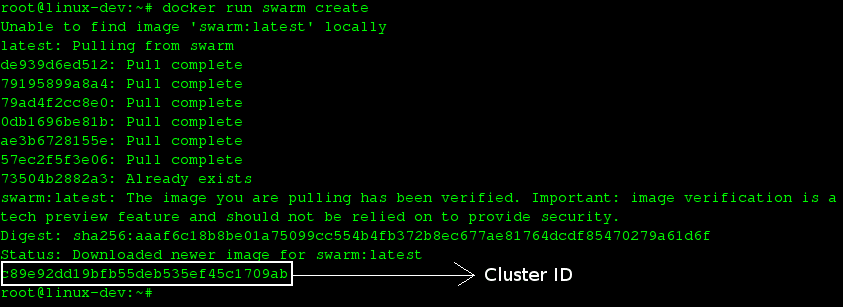
现在,在我们创建完成了machine之后。我们需要将swarm docker镜像部署上去。这个machine将会运行这个docker镜像,并且控制Swarm主控节点和从节点。使用下面的指令运行镜像:

# docker run swarm create

Docker Machine Swarm Create

如果你想要在32位操作系统上运行swarm docker镜像。你需要SSH登录到Droplet当中。

# docker-machine ssh
# docker run swarm create
# exit

4. 创建Swarm主控节点

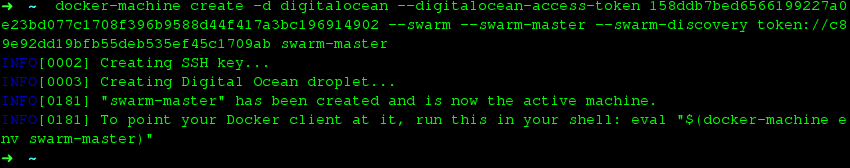
在我们的swarm image已经运行在machine当中之后,我们将要创建一个Swarm主控节点。使用下面的语句,添加一个主控节点。

# docker-machine create \
-d digitalocean \
--digitalocean-access-token <DIGITALOCEAN-TOKEN>
--swarm \
--swarm-master \
--swarm-discovery token://<CLUSTER-ID> \
swarm-master

Docker Machine Swarm Master Create

5. 创建Swarm从节点

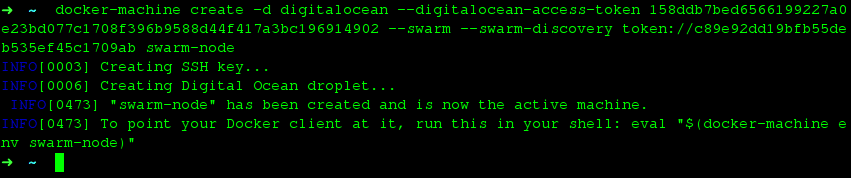
现在,我们将要创建一个swarm从节点,此节点将与Swarm主控节点相连接。下面的指令将创建一个新的名为swarm-node的droplet,其与Swarm主控节点相连。到此,我们就拥有了一个两节点的swarm集群了。

# docker-machine create \
-d digitalocean \
--digitalocean-access-token <DIGITALOCEAN-TOKEN>
--swarm \
--swarm-discovery token://<TOKEN-FROM-ABOVE> \
swarm-node

Docker Machine Swarm Nodes

6. 与Swarm主控节点连接

现在,我们连接Swarm主控节点以便我们可以依照需求和配置文件在节点间部署Docker容器。运行下列命令将Swarm主控节点的Machine配置文件加载到环境当中。

# eval "$(docker-machine env --swarm swarm-master)"

然后,我们就可以跨节点地运行我们所需的容器了。在这里,我们还要检查一下是否一切正常。所以,运行docker info命令来检查Swarm集群的信息。

# docker info

总结

我们可以用Docker Machine轻而易举地创建Swarm集群。这种方法有非常高的效率,因为它极大地减少了系统管理员和用户的时间消耗。在这篇文章中,我们以Digital Ocean作为驱动,通过创建一个主控节点和一个从节点成功地部署了集群。其他类似的驱动还有VirtualBox,Google Cloud Computing,Amazon Web Service,Microsoft Azure等等。这些连接都是通过TLS进行加密的,具有很高的安全性。如果你有任何的疑问,建议,反馈,欢迎在下面的评论框中注明以便我们可以更好地提高文章的质量!


via: http://linoxide.com/linux-how-to/provision-swarm-clusters-using-docker-machine/

作者:Arun Pyasi 译者:DongShuaike 校对:wxy

本文由 LCTT 原创翻译,Linux中国 荣誉推出

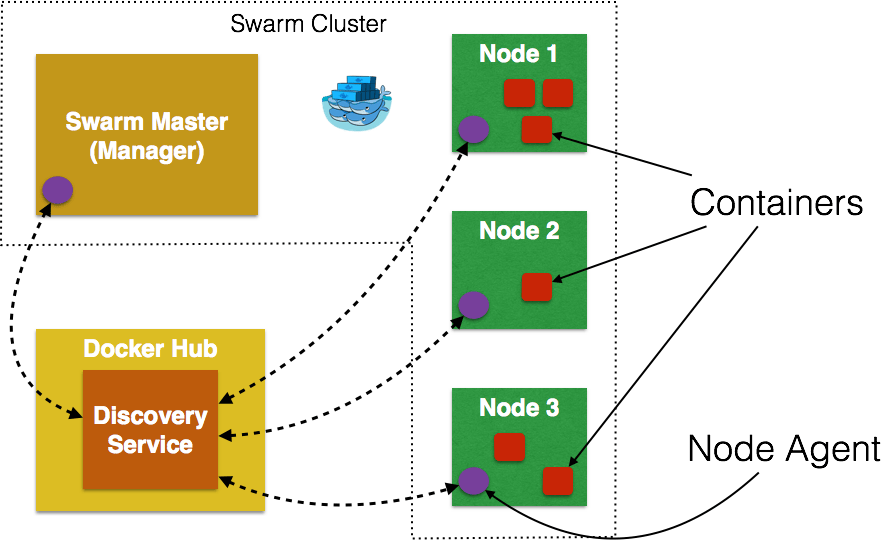
嗨,大家好。今天我们来学一学Swarm相关的内容吧,我们将学习通过Swarm来创建Docker原生集群。Docker Swarm是用于Docker的原生集群项目,它可以将一个Docker主机池转换成单个的虚拟主机。Swarm工作于标准的Docker API,所以任何可以和Docker守护进程通信的工具都可以使用Swarm来透明地伸缩到多个主机上。就像其它Docker项目一样,Swarm遵循“内置电池,并可拆卸”的原则(LCTT 译注:batteries included,内置电池原来是 Python 圈里面对 Python 的一种赞誉,指自给自足,无需外求的丰富环境;but removable,并可拆卸应该指的是非强制耦合)。它附带有一个开箱即用的简单的后端调度程序,而且作为初始开发套件,也为其开发了一个可插拔不同后端的API。其目标在于为一些简单的使用情况提供一个平滑的、开箱即用的体验,并且它允许切换为更强大的后端,如Mesos,以用于大规模生产环境部署。Swarm配置和使用极其简单。

这里给大家提供Swarm 0.2开箱的即用一些特性。

  1. Swarm 0.2.0大约85%与Docker引擎兼容。
  2. 它支持资源管理。
  3. 它具有一些带有限制和类同功能的高级调度特性。
  4. 它支持多个发现后端(hubs,consul,etcd,zookeeper)
  5. 它使用TLS加密方法进行安全通信和验证。

那么,我们来看一看Swarm的一些相当简单而简用的使用步骤吧。

1. 运行Swarm的先决条件

我们必须在所有节点安装Docker 1.4.0或更高版本。虽然各个节点的IP地址不需要要公共地址,但是Swarm管理器必须可以通过网络访问各个节点。

注意:Swarm当前还处于beta版本,因此功能特性等还有可能发生改变,我们不推荐你在生产环境中使用。

2. 创建Swarm集群

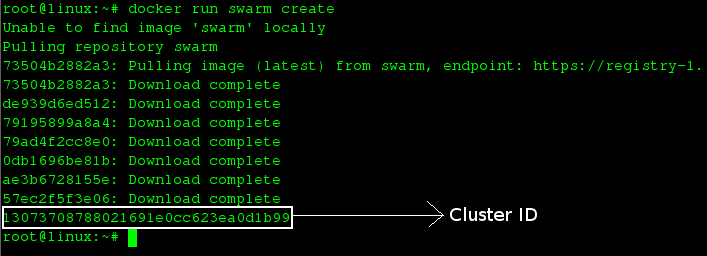
现在,我们将通过运行下面的命令来创建Swarm集群。各个节点都将运行一个swarm节点代理,该代理会注册、监控相关的Docker守护进程,并更新发现后端获取的节点状态。下面的命令会返回一个唯一的集群ID标记,在启动节点上的Swarm代理时会用到它。

在集群管理器上运行:

# docker run swarm create

Creating Swarm Cluster

3. 启动各个节点上的Docker守护进程

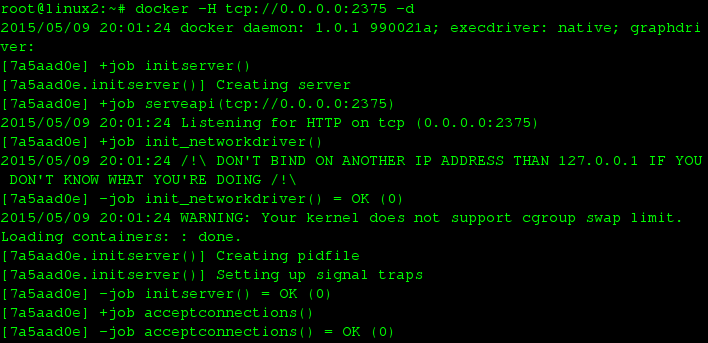
我们需要登录进我们将用来创建集群的每个节点,并在其上使用-H标记启动Docker守护进程。它会保证Swarm管理器能够通过TCP访问到各个节点上的Docker远程API。要启动Docker守护进程,我们需要在各个节点内部运行以下命令。

# docker -H tcp://0.0.0.0:2375 -d

Starting Docker Daemon

4. 添加节点

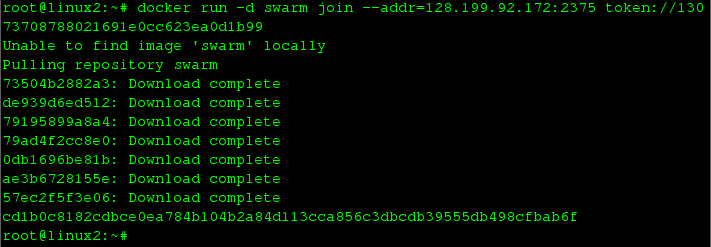
在启用Docker守护进程后,我们需要添加Swarm节点到发现服务,我们必须确保节点IP可从Swarm管理器访问到。要完成该操作,我们需要在各个节点上运行以下命令。

# docker run -d swarm join --addr=<node_ip>:2375 token://<cluster_id>

Adding Nodes to Cluster

注意:我们需要用步骤2中获取到的节点IP地址和集群ID替换这里的和。

5. 开启Swarm管理器

现在,由于我们已经获得了连接到集群的节点,我们将启动swarm管理器。我们需要在集群管理器中运行以下命令。

# docker run -d -p <swarm_port>:2375 swarm manage token://<cluster_id>

Starting Swarm Manager

6. 检查配置

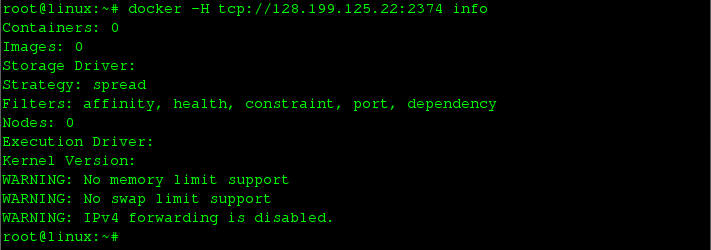
一旦管理运行起来后,我们可以通过运行以下命令来检查配置。

# docker -H tcp://<manager_ip:manager_port> info

Accessing Swarm Clusters

注意:我们需要替换为运行swarm管理器的主机的IP地址和端口。

7. 使用docker CLI来访问节点

在一切都像上面说得那样完美地完成后,这一部分是Docker Swarm最为重要的部分。我们可以使用Docker CLI来访问节点,并在节点上运行容器。

# docker -H tcp://<manager_ip:manager_port> info
# docker -H tcp://<manager_ip:manager_port> run ...

8. 监听集群中的节点

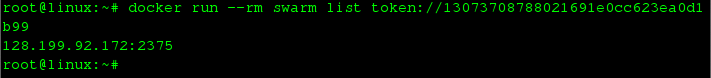
我们可以使用swarm list命令来获取所有运行中节点的列表。

# docker run --rm swarm list token://<cluster_id>

Listing Swarm Nodes

尾声

Swarm真的是一个有着相当不错的功能的docker,它可以用于创建和管理集群。它相当易于配置和使用,当我们在它上面使用限制器和类同器时它更为出色。高级调度程序是一个相当不错的特性,它可以应用过滤器来通过端口、标签、健康状况来排除节点,并且它使用策略来挑选最佳节点。那么,如果你有任何问题、评论、反馈,请在下面的评论框中写出来吧,好让我们知道哪些材料需要补充或改进。谢谢大家了!尽情享受吧 :-)


via: http://linoxide.com/linux-how-to/configure-swarm-clustering-docker/

作者:Arun Pyasi 译者:GOLinux 校对:wxy

本文由 LCTT 原创翻译,Linux中国 荣誉推出

本文以两台机器实现双集热备高可用集群,主机名node1的IP为192.168.122.168 ,主机名node2的IP为192.168.122.169 。

一、安装集群软件

必须软件pcs,pacemaker,corosync,fence-agents-all,如果需要配置相关服务,也要安装对应的软件

二、配置防火墙

1、禁止防火墙和selinux

# systemctl disable firewalld
# systemctl stop firewalld

修改/etc/sysconfig/selinux确保SELINUX=disabled,然后执行setenforce 0或者reboot服务器以生效

2、设置防火墙规则

# firewall-cmd --permanent --add-service=high-availability
# firewall-cmd --add-service=high-availability

三、各节点之间主机名互相解析

分别修改2台主机名分别为node1和node2,在centos 7中直接修改/etc/hostname加入本机主机名和主机表,然后重启网络服务即可。

#vi /etc/hostname
node1

#systemctl restart network.service
#hostname
node1

配置2台主机的主机表,在/etc/hosts中加入

192.168.122.168 node1
192.168.122.169 node2

四、各节点之间时间同步

在node1和node2分别进行时间同步,可以使用ntp实现。

[root@node1 ~]# ntpdate 172.16.0.1 //172.16.0.1 为时间服务器 

五、各节点之间配置ssh的无密码密钥访问。

下面的操作需要在各个节点上操作。

# ssh-keygen -t rsa -P ‘’   #这个生成一个密码为空的公钥和一个密钥,把公钥复制到对方节点上即可
# ssh-copy-id -i /root/.ssh/id_rsa.pub root@node2 #对方主机名用登录用户名

两台主机都要互相可以通信,所以两台主机都得互相生成密钥和复制公钥,相互的节点上的hosts文件是都要解析对方的主机名, 192.168.122.168 node1 192.168.122.169 node2

# ssh node2 ‘date’;date #测试一下是否已经互信 

六、通过pacemaker来管理高可用集群

1、创建集群用户

为了有利于各节点之间通信和配置集群,在每个节点上创建一个hacluster的用户,各个节点上的密码必须是同一个。

# passwd hacluster

Changing password for user hacluster.
New password:
Retype new password:
passwd: all authentication tokens updated successfully.

2、设置pcsd开机自启动

# systemctl start pcsd.service
# systemctl enable pcsd.service

3、集群各节点之间进行认证

# pcs cluster auth node1 node2Username: hacluster Password: node1: Authorized node2: Authorized

4、创建并启动集群

[root@z1 ~]# pcs cluster setup --start --name my_cluster node1 node2

node1: Succeeded
node1: Starting Cluster...
node2: Succeeded
node2: Starting Cluster...

5、设置集群自启动

# pcs cluster enable –all

6、查看集群状态信息

[root@z1 ~]# pcs cluster status

7、设置fence设备

这个可以参考

corosync默认启用了stonith,而当前集群并没有相应的stonith设备,因此此默 认配置目前尚不可用,这可以通过如下命令验证:

#crm_verify -L -V

可以通过如下面命令禁用stonith:

#pcs property set stonith-enabled=false(默认是true)

8、配置存储

高可用集群既可以使用本地磁盘来构建纯软件的镜像型集群系统,也可以使用专门的共享磁盘装置来构建大规模的共享磁盘型集群系统,充分满足客户的不同需求。

共享磁盘主要有iscsi或DBRD。本文并没有使用共享磁盘。

9、配置浮点IP

不管集群服务在哪运行,我们要一个固定的地址来提供服务。在这里我选择192.168.122.101作为浮动IP,给它取一个好记的名字 ClusterIP 并且告诉集群 每30秒检查它一次。

# pcs resource create VIP ocf:heartbeat:IPaddr2 ip=192.168.122.170 cidr_netmask=24 op monitor interval=30s
# pcs update VIP op monitor interval=15s

10、配置apache服务

在node1和node2上安装httpd ,确认httpd开机被禁用

# systemctl status httpd.service;

配置httpd监控页面(貌似不配置也可以通过systemd监控),分别在node1和node2上执行

# cat > /etc/httpd/conf.d/status.conf << EOF
SetHandler server-status
Order deny,allow
Deny from all
Allow from localhost
EOF

首先我们为Apache创建一个主页。在centos上面默认的Apache docroot是/var/www/html,所以我们在这个目录下面建立一个主页。

node1节点修改如下:

[root@node1 ~]# cat <<-END >/var/www/html/index.html
<html>
<body>Hello node1</body>
</html>

END

node2节点修改如下:

[root@node2 ~]# cat <<-END >/var/www/html/index.html 
<html>
<body>Hello node2</body>
</html>

END

下面语句是将httpd作为资源添加到集群中:

#pcs resource create WEB apache configfile="/etc/httpd/conf/httpd.conf" statusurl="http://127.0.0.1/server-status"

11、创建group

将VIP和WEB resource捆绑到这个group中,使之作为一个整体在集群中切换。(此配置为可选)

# pcs resource group add MyGroup VIP
# pcs resource group add MyGroup WEB

12、配置服务启动顺序

以避免出现资源冲突,语法:(pcs resource group add的时候也可以根据加的顺序依次启动,此配置为可选)

# pcs constraint order [action] then [action]
# pcs constraint order start VIP then start WEB

13、指定优先的 Location (此配置为可选)

Pacemaker 并不要求你机器的硬件配置是相同的,可能某些机器比另外的机器配置要好。这种状况下我们会希望设置:当某个节点可用时,资源就要跑在上面之类的规则。为了达到这个效果我们创建location约束。同样的,我们给他取一个描述性的名字(prefer-node1),指明我们想在上面跑WEB 这个服务,多想在上面跑(我们现在指定分值为50,但是在双节点的集群状态下,任何大于0的值都可以达到想要的效果),以及目标节点的名字:

# pcs constraint location WEB prefers node1=50
# pcs constraint location WEB prefers node2=45

这里指定分值越大,代表越想在对应的节点上运行。

14、资源粘性(此配置为可选)

一些环境中会要求尽量避免资源在节点之间迁移。迁移资源通常意味着一段时间内无法提供服务,某些复杂的服务,比如Oracle数据库,这个时间可能会很长。

为了达到这个效果,Pacemaker 有一个叫做“资源粘性值”的概念,它能够控制一个服务(资源)有多想呆在它正在运行的节点上。

Pacemaker为了达到最优分布各个资源的目的,默认设置这个值为0。我们可以为每个资源定义不同的粘性值,但一般来说,更改默认粘性值就够了。资源粘性表示资源是否倾向于留在当前节点,如果为正整数,表示倾向,负数则会离开,-inf表示负无穷,inf表示正无穷。

# pcs resource defaults resource-stickiness=100

常用命令汇总:

查看集群状态:#pcs status

查看集群当前配置:#pcs config

开机后集群自启动:#pcs cluster enable –all

启动集群:#pcs cluster start –all

查看集群资源状态:#pcs resource show

验证集群配置情况:#crm\_verify -L -V

测试资源配置:#pcs resource debug-start resource

设置节点为备用状态:#pcs cluster standby node1