Docker 引擎的 Swarm 模式:入门教程
Swarm,听起来像是一个朋克摇滚乐队。但它确实是个新的编排机制,抑或者是,一个 Docker 现有编排体制的改进。简单来讲,如果你在用一个旧版本的 Docker,你必须手动配置 Swarm 来创建 Docker 集群。从 1.12 版开始,Docker 引擎集成了一个原生的实现(LCTT 译注:见下文)来支持无缝的集群设置。也就是为什么会有这篇文章。
在这篇教程中,我将带你体验一下编排后的 Docker 将能做的事情。这篇文章并不是包含所有细节(如 BnB 一般)或是让你对其全知全能,但它能带你踏上你的集群之路。在我的带领下开始吧。
技术概要
如果把 Docker 详细而又好用的文档照搬到这里那将太丢人了,所以我将简要概括下这个技术的概要。我们已经有了 Docker,对吧。现在,你想要更多的服务器作为 Docker 主机,但同时你希望它们属于同一个逻辑上的实体。也就是说,你想建立一个集群。
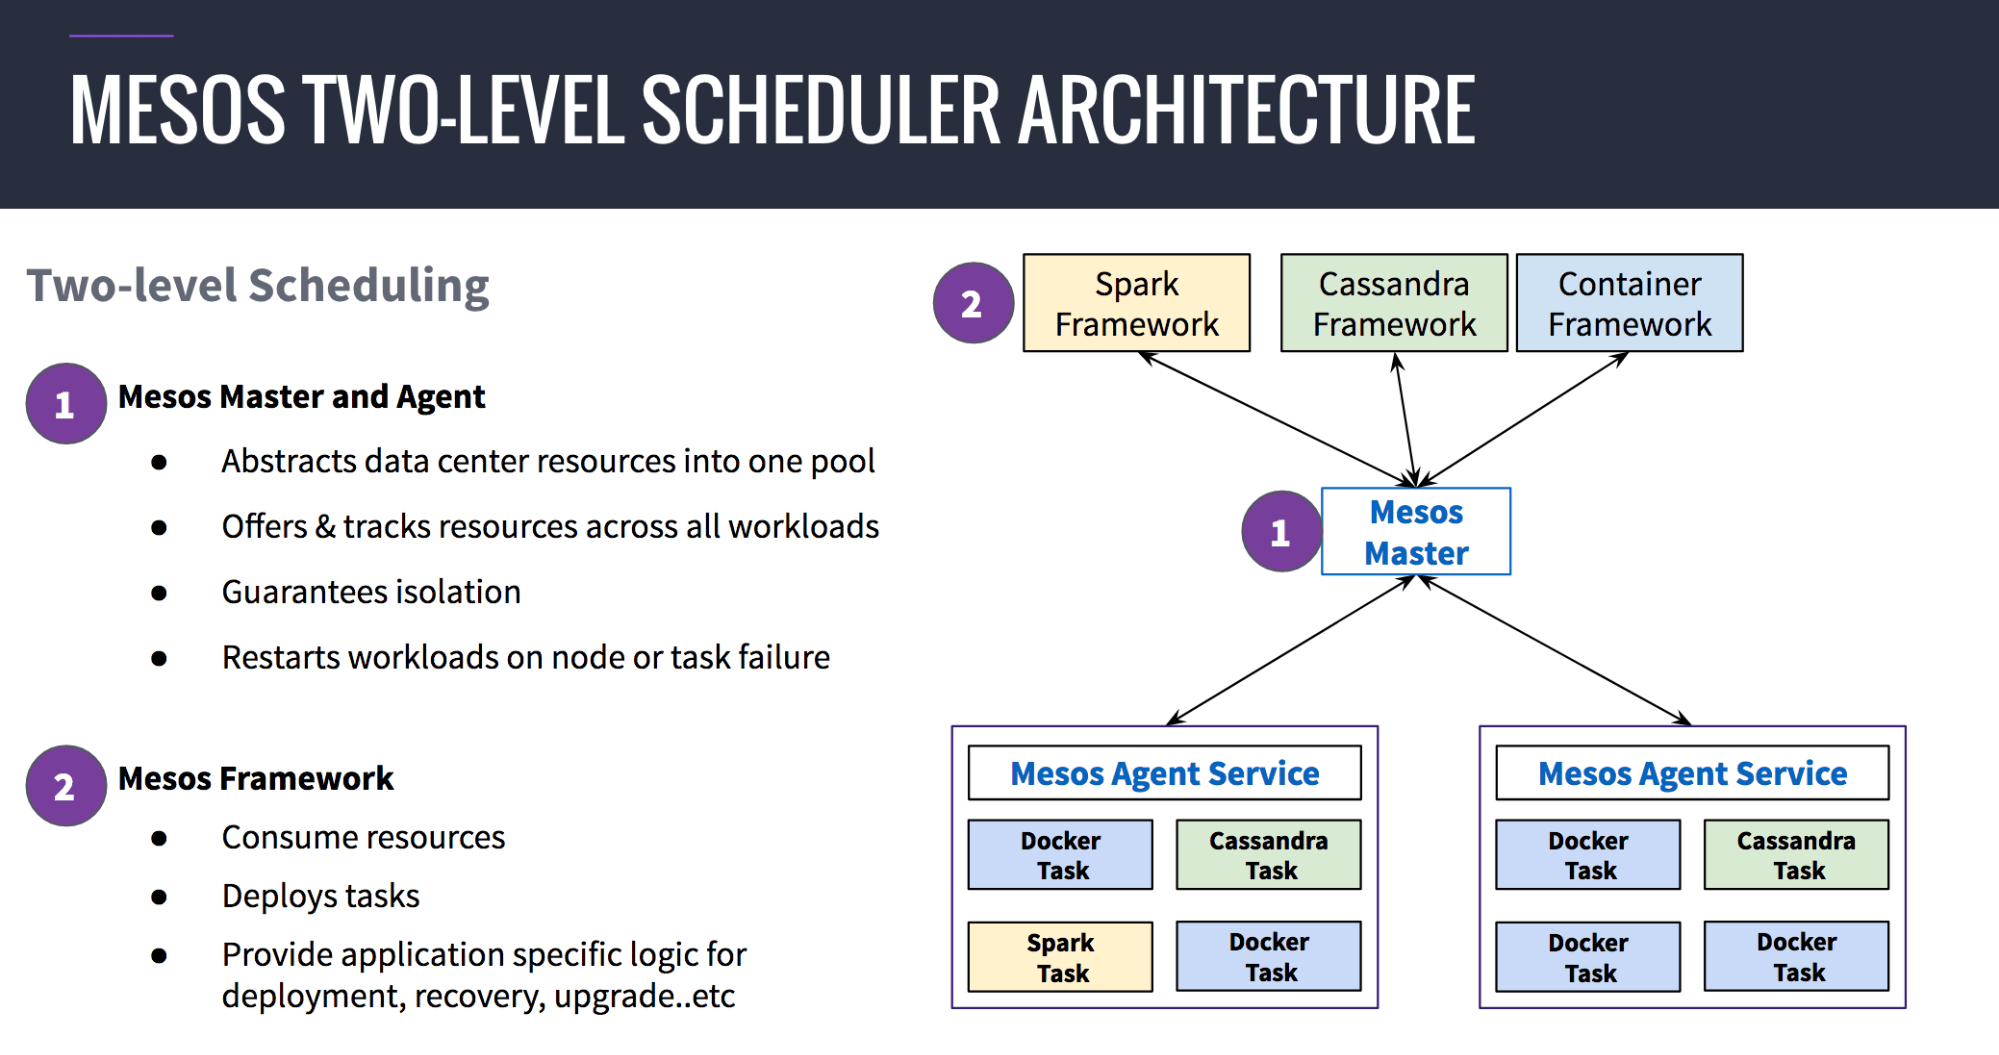
我们先从一个主机组成的集群开始。当你在一个主机上初始化一个 Swarm 集群,这台主机将成为这个集群的 管理者 。从技术角度来讲,它成为了 共识组 中的一个 节点 。其背后的数学逻辑建立在 Raft 算法之上。 管理者 负责调度任务。而具体的任务则会委任给各个加入了 Swarm 集群的 工作者 节点。这些操作将由 Node API 所管理。虽说我讨厌 API 这个词汇,但我必须在这里用到它。
Service API 是这个实现中的第二个组件。它允许 管理者 节点在所有的 Swarm 集群节点上创建一个分布式的服务。这个服务可以 被复制 ,也就是说它们(LCTT 译注:指这些服务)会由平衡机制被分配到集群中(LCTT 译注:指 replicated 模式,多个容器实例将会自动调度任务到集群中的一些满足条件的节点),或者可以分配给全局(LCTT 译注:指 global 模式),也就是说每个节点都会运行一个容器实例。
此外还有更多的功课需要做,但这些信息已经足够你上路了。现在,我们开始整些实际的。我们的目标平台是 CentOS 7.2,有趣的是在我写这篇教程的时候,它的软件仓库中只有 1.10 版的 Docker,也就是说我必须手动更新以使用 Swarm。我们将在另一篇教程中讨论这个问题。接下来我们还有一个跟进的指南,其中涵盖了如何将新的节点加入我们现有的集群(LCTT 译注:指刚刚建立的单节点集群),并且我们将使用 Fedora 进行一个非对称的配置。至此,请确保正确的配置已经就位,并有一个工作的集群启动并正在运行(LCTT 译注:指第一个节点的 Docker 已经安装并已进入 Swarm 模式,但到这里笔者并没有介绍如何初始化 Swarm 集群,不过别担心下章会讲)。
配置镜像和服务
我将尝试配置一个负载均衡的 Apache 服务,并使用多个容器实例通过唯一的 IP 地址提供页面内容。挺标准的吧(LCTT 译注:指这个负载均衡的网页服务器)。这个例子同时也突出了你想要使用集群的大多数原因:可用性、冗余、横向扩展以及性能。当然,你同时需要考虑网络和储存这两块,但它们超出了这篇指南所涉及的范围了。
这个 Dockerfile 模板其实可以在官方镜像仓库里的 httpd 下找到。你只需一个最简单的设置来起步。至于如何下载或创建自己的镜像,请参考我的入门指南,链接可以在这篇教程的顶部可以找到。
docker build -t my-apache2 .
Sending build context to Docker daemon 2.048 kB
Step 1 : FROM httpd:2.4
Trying to pull repository docker.io/library/httpd ...
2.4: Pulling from docker.io/library/httpd

8ad8b3f87b37: Pull complete
c95e1f92326d: Pull complete
96e8046a7a4e: Pull complete
00a0d292c371: Pull complete
3f7586acab34: Pull complete
Digest: sha256:3ad4d7c4f1815bd1c16788a57f81b413...a915e50a0d3a4
Status: Downloaded newer image for docker.io/httpd:2.4
 ---> fe3336dd034d
Step 2 : COPY ../public-html/ /usr/local/apache2/htdocs/
...
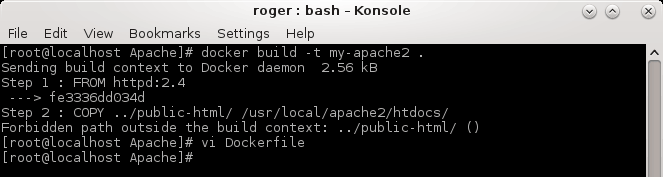
在你继续下面的步骤之前,你应该确保你能无错误的启动一个容器实例并能链接到这个网页服务器上(LCTT 译注:使用下面的命令)。一旦你确保你能连上,我们就可以开始着手创建一个分布式的服务。
docker run -dit --name my-running-app my-apache2
将这个 IP 地址输入浏览器,看看会出现什么。
Swarm 初始化和配置
下一步就是启动 Swarm 集群了。你将需要这些最基础的命令来开始,它们与 Docker 博客中的例子非常相似:
docker service create --name frontend --replicas 5 -p 80:80/tcp my-apache2:latest
这里我们做了什么?我们创建了一个叫做 frontent 的服务,它有五个容器实例。同时我们还将主机的 80 端口和这些容器的 80 端口相绑定。我们将使用刚刚新创建的 Apache 镜像来做这个测试。然而,当你在自己的电脑上直接键入上面的指令时,你将看到下面的错误:
docker service create --name frontend --replicas 5 -p 80:80/tcp my-apache2:latest
Error response from daemon: This node is not a swarm manager. Use "docker swarm init" or "docker swarm join" to connect this node to swarm and try again.
这意味着你没有将你的主机(节点)配置成一个 Swarm 管理者 。你可以在这台主机上初始化 Swarm 集群或是让它加入一个现有的集群。由于我们目前还没有一个现成的集群,我们将初始化它(LCTT 译注:指初始化 Swarm 集群并使当前节点成为 manager):
docker swarm init
Swarm initialized: current node (dm58mmsczqemiikazbfyfwqpd) is now a manager.
为了向这个 Swarm 集群添加一个 工作者 ,请执行下面的指令:
docker swarm join \
--token SWMTKN-1-4ofd46a2nfyvrqwu8w5oeetukrbylyznxla
9srf9vxkxysj4p8-eu5d68pu5f1ci66s7w4wjps1u \
10.0.2.15:2377
为了向这个 Swarm 集群添加一个 管理者 ,请执行 docker swarm join-token manager 并按照指示操作。
操作后的输出不用解释已经很清楚明了。我们成功的创建了一个 Swarm 集群。新的节点们将需要正确的 令牌 来加入这个 Swarm 集群。如果你需要配置防火墙,你还需找到它的 IP 地址和端口(LCTT 译注:指 Docker 的 Swarm 模式通讯所需的端口,默认 2377)。此外,你还可以向 Swarm 集群中添加管理者节点。现在,重新执行刚刚的服务创建指令:
docker service create --name frontend --replicas 5 -p 80:80/tcp my-apache2:latest
6lrx1vhxsar2i50is8arh4ud1
测试连通性
现在,我们来验证下我们的服务是否真的工作了。从某些方面讲,这很像我们在 Vagrant 和 coreOS 中做的事情那样。毕竟它们的原理几乎相同。相同指导思想的不同实现罢了(LCTT 译注:笔者观点,无法苟同)。首先需要确保 docker ps 能够给出正确的输出。你应该能看到所创建服务的多个容器副本。
docker ps
CONTAINER ID        IMAGE               COMMAND              CREATED             STATUS              PORTS
NAMES
cda532f67d55        my-apache2:latest   "httpd-foreground"
2 minutes ago       Up 2 minutes        80/tcp              frontend.1.2sobjfchdyucschtu2xw6ms9a
75fe6e0aa77b        my-apache2:latest   "httpd-foreground"
2 minutes ago       Up 2 minutes        80/tcp              frontend.4.ag77qtdeby9fyvif5v6c4zcpc
3ce824d3151f        my-apache2:latest   "httpd-foreground"
2 minutes ago       Up 2 minutes        80/tcp              frontend.2.b6fqg6sf4hkeqs86ps4zjyq65
eda01569181d        my-apache2:latest   "httpd-foreground"
2 minutes ago       Up 2 minutes        80/tcp              frontend.5.0rmei3zeeh8usagg7fn3olsp4
497ef904e381        my-apache2:latest   "httpd-foreground"
2 minutes ago       Up 2 minutes        80/tcp              frontend.3.7m83qsilli5dk8rncw3u10g5a
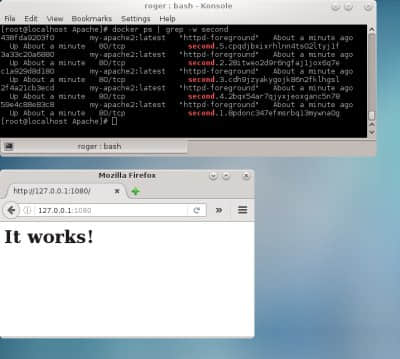
我也测试了不同的、非常规的端口,它们都能正常工作。对于你如何连接服务器和收取请求你将会有很多可配置的余地。你可以使用 localhost 或者 Docker 网络接口(笔者注:应该是指 Docker 的默认网桥 docker0,其网关为 172.17.0.1) 的 IP 地址的正确端口去访问。下面的例子使用了端口 1080:
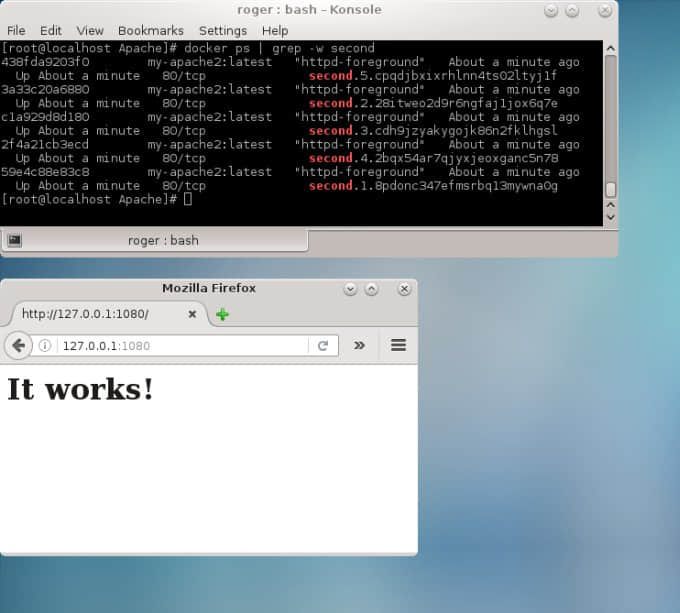
至此,这是一个非常粗略、简单的开始。真正的挑战是创建一个优化过的、可扩展的服务,但是它们需要一个准确的技术用例。此外,你还会用到 docker info 和 docker service(还有 inspect 和 ps)命令来详细了解你的集群是如何工作的。
可能会遇到的问题
你可能会在把玩 Docker 和 Swarm 时遇到一些小的问题(也许没那么小)。比如 SELinux 也许会抱怨你正在执行一些非法的操作(LCTT 译注:指在强制访问控制策略中没有权限的操作)。然而,这些错误和警告应该不会对你造成太多阻碍。
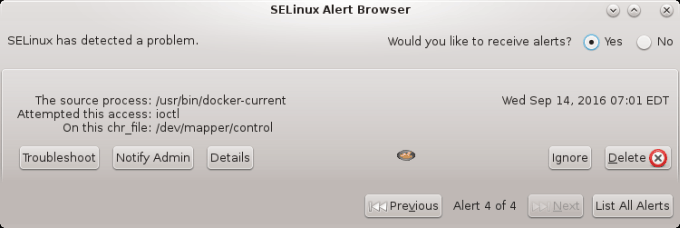
docker service不是一条命令(docker service is not a docker command)
当你尝试执行必须的命令去创建一个 复制模式 的服务时,你可能会遇到一条错误说 docker: 'service' is not a docker command(LCTT 译注:见下面的例子)。这表示你的 Docker 版本不对(使用 -v 选项来检查)。我们将在将来的教程讨论如何修复这个问题。
docker service create --name frontend --replicas 5 -p 80:80/tcp my-apache2:latest
docker: 'service' is not a docker command.
docker tag无法识别(docker tag not recognized)
你也许会看到下面的错误:
docker service create -name frontend -replicas 5 -p 80:80/tcp my-apache2:latest
Error response from daemon: rpc error: code = 3 desc = ContainerSpec: "-name" is not a valid repository/tag
关于这个错误已经有多个相关的讨论和帖子了。其实这个错误也许相当无辜。你也许是从浏览器粘贴的命令,在浏览器中的横线也许没被正确解析(笔者注:应该用 --name 而不是 -name)。就是这么简单的原因所导致的。
扩展阅读
关于这个话题还有很多可谈的,包含 1.12 版之前的 Swarm 集群实现(笔者注:旧的 Swarm 集群实现,下文亦作独立版本,需要 Consul 等应用提供服务发现),以及当前的 Docker 版本提供的(笔者注:新的 Swarm 集群实现,亦被称为 Docker 引擎的 Swarm 模式)。也就是说,请别偷懒花些时间阅读以下内容:
- Docker Swarm 概述(独立版本的 Swarm 集群安装)
- 构建一个生产环境的 Swarm 集群(独立版本安装)
- 安装并创建一个 Docker Swarm 集群(独立版本安装)
- Docker 引擎 Swarm 概述(对于 1.12 版)
- Swarm 模式入门(对于 1.12 版)
总结
你总算看到这里了。到这里仍然无法保证你学到了什么,但我相信你还是会觉得这篇文章有些用的。它涵盖了一些基础的概念,以及一个 Swarm 集群模式是如何工作的以及它能做什么的概述,与此同时我们也成功的下载了并创建了我们的网页服务器的镜像,并且在之后基于它运行了多个集群式的容器实例。虽然我们目前只在单一节点做了以上实验,但是我们会在将来解释清楚(LCTT 译注:以便解释清楚多节点的 Swarm 集群操作)。并且我们解决了一些常见的问题。
我希望你能认为这篇指南足够有趣。结合着我过去所写的关于 Docker 的文章,这些文章应该能给你一个像样的解释,包括:怎么样操作镜像、网络栈、储存、以及现在的集群。就当热身吧。的确,请享受并期待在新的 Docker 教程中与你见面。我控几不住我记几啊。
祝你愉快。
via: http://www.dedoimedo.com/computers/docker-swarm-intro.html