标签 性能 下的文章

Instagram 目前部署了世界上最大规模的 Django Web 框架(该框架完全使用 Python 编写)。我们最初选用 Python 是因为它久负盛名的简洁性与实用性,这非常符合我们的哲学思想——“先做简单的事情”。但简洁性也会带来效率方面的折衷。Instagram 的规模在过去两年中已经翻番,并且最近已突破 5 亿用户,所以急需最大程度地提升 web 服务效率以便我们的平台能够继续顺利地扩大。在过去的一年,我们已经将 效率计划 ( efficiency program ) 提上日程,并在过去的六个月,我们已经能够做到无需向我们的 Django 层 ( Django tiers ) 添加新的容量来维持我们的用户增长。我们将在本文分享一些由我们构建的工具以及如何使用它们来优化我们的日常部署流程。

为何需要提升效率?

Instagram,正如所有的软件,受限于像服务器和数据中心能源这样的物理限制。鉴于这些限制,在我们的效率计划中有两个我们希望实现的主要目标:

  1. Instagram 应当能够利用持续代码发布正常地提供通信服务,防止因为自然灾害、区域性网络问题等造成某一个数据中心区丢失。
  2. Instagram 应当能够自由地滚动发布新产品和新功能,不必因容量而受阻。

想要实现这些目标,我们意识到我们需要持续不断地监控我们的系统并与 回归 ( regressions ) 进行战斗。

定义效率

Web services 的瓶颈通常在于每台服务器上可用的 CPU 时间。在这种环境下,效率就意味着利用相同的 CPU 资源完成更多的任务,也就是说, 每秒处理更多的用户请求 ( requests per second,RPS ) 。当我们寻找优化方法时,我们面临的第一个最大的挑战就是尝试量化我们当前的效率。到目前为止,我们一直在使用“每次请求的平均 CPU 时间”来评估效率,但使用这种指标也有其固有限制:

  1. 设备多样性。使用 CPU 时间来测量 CPU 资源并非理想方案,因为它同时受到 CPU 型号与 CPU 负载的影响。
  2. 请求影响数据。测量每次请求的 CPU 资源并非理想方案,因为在使用 每次请求测量 ( per-request measurement ) 方案时,添加或移除轻量级或重量级的请求也会影响到效率指标。

相对于 CPU 时间来说,CPU 指令是一种更好的指标,因为对于相同的请求,它会报告相同的数字,不管 CPU 型号和 CPU 负载情况如何。我们选择使用了一种叫做” 每个活动用户 ( per active user ) “的指标,而不是将我们所有的数据关联到每个用户请求上。我们最终采用“ 每个活动用户在高峰期间的 CPU 指令 ( CPU instruction per active user during peak minute ) ”来测量效率。我们建立好新的度量标准后,下一步就是通过对 Django 的分析来更多的了解一下我们的回归。

Django web services 分析

通过分析我们的 Django web services,我们希望回答两个主要问题:

  1. CPU 回归会发生吗?
  2. 是什么导致了 CPU 回归发生以及我们该怎样修复它?

想要回答第一个问题,我们需要追踪“ 每个活动用户的 CPU 指令 ( CPU-instruction-per-active-user ) ”指标。如果该指标增加,我们就知道已经发生了一次 CPU 回归。

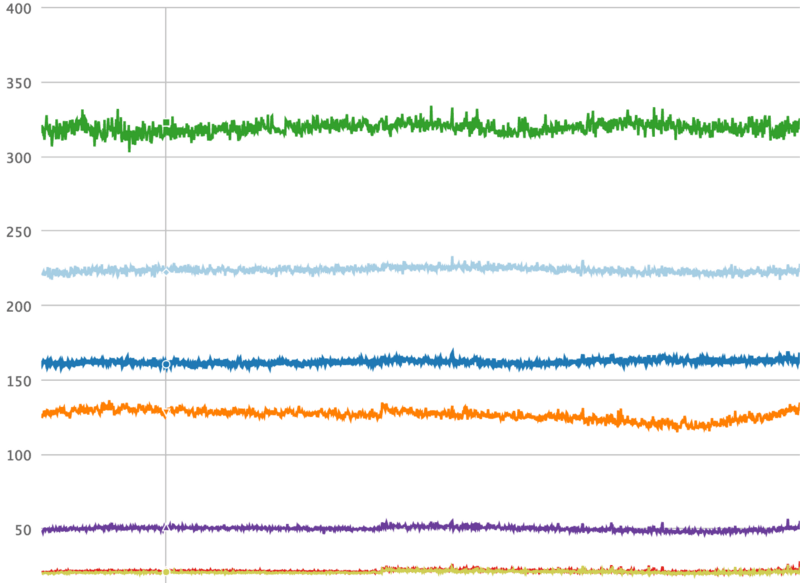
我们为此构建的工具叫做 Dynostats。Dynostats 利用 Django 中间件以一定的速率采样用户请求,记录关键的效率以及性能指标,例如 CPU 总指令数、端到端请求时延、花费在访问内存缓存(memcache)和数据库服务的时间等。另一方面,每个请求都有很多可用于聚合的 元数据 ( metadata ) ,例如端点名称、HTTP 请求返回码、服务该请求的服务器名称以及请求中最新提交的 哈希值 ( hash ) 。对于单个请求记录来说,有两个方面非常强大,因为我们可以在不同的维度上进行切割,那将帮助我们减少任何导致 CPU 回归的原因。例如,我们可以根据它们的端点名称聚合所有请求,正如下面的时间序列图所示,从图中可以清晰地看出在特定端点上是否发生了回归。

CPU 指令对测量效率很重要——当然,它们也很难获得。Python 并没有支持直接访问 CPU 硬件计数器(CPU 硬件计数器是指可编程 CPU 寄存器,用于测量性能指标,例如 CPU 指令)的公共库。另一方面,Linux 内核提供了 perf_event_open 系统调用。通过 Python ctypes 桥接技术能够让我们调用标准 C 库的系统调用函数 syscall,它也为我们提供了兼容 C 的数据类型,从而可以编程硬件计数器并从它们读取数据。

使用 Dynostats,我们已经可以找出 CPU 回归,并探究 CPU 回归发生的原因,例如哪个端点受到的影响最多,谁提交了真正会导致 CPU 回归的变更等。然而,当开发者收到他们的变更已经导致一次 CPU 回归发生的通知时,他们通常难以找出问题所在。如果问题很明显,那么回归可能就不会一开始就被提交!

这就是为何我们需要一个 Python 分析器,(一旦 Dynostats 发现了它)从而使开发者能够使用它找出回归发生的根本原因。不同于白手起家,我们决定对一个现成的 Python 分析器 cProfile 做适当的修改。cProfile 模块通常会提供一个统计集合来描述程序不同的部分执行时间和执行频率。我们将 cProfile 的 定时器 ( timer ) 替换成了一个从硬件计数器读取的 CPU 指令计数器,以此取代对时间的测量。我们在采样请求后产生数据并把数据发送到数据流水线。我们也会发送一些我们在 Dynostats 所拥有的类似元数据,例如服务器名称、集群、区域、端点名称等。

在数据流水线的另一边,我们创建了一个消费数据的 尾随者 ( tailer ) 。尾随者的主要功能是解析 cProfile 的统计数据并创建能够表示 Python 函数级别的 CPU 指令的实体。如此,我们能够通过 Python 函数来聚合 CPU 指令,从而更加方便地找出是什么函数导致了 CPU 回归。

监控与警报机制

在 Instagram,我们每天部署 30-50 次后端服务。这些部署中的任何一个都能发生 CPU 回归的问题。因为每次发生通常都包含至少一个 差异 ( diff ) ,所以找出任何回归是很容易的。我们的效率监控机制包括在每次发布前后都会在 Dynostats 中扫描 CPU 指令,并且当变更超出某个阈值时发出警告。对于长期会发生 CPU 回归的情况,我们也有一个探测器为负载最繁重的端点提供日常和每周的变更扫描。

部署新的变更并非触发一次 CPU 回归的唯一情况。在许多情况下,新的功能和新的代码路径都由 全局环境变量 ( global environment variables,GEV ) 控制。 在一个计划好的时间表上,给一部分用户发布新功能是很常见事情。我们在 Dynostats 和 cProfile 统计数据中为每个请求添加了这个信息作为额外的元数据字段。按这些字段将请求分组可以找出由全局环境变量(GEV)改变导致的可能的 CPU 回归问题。这让我们能够在它们对性能造成影响前就捕获到 CPU 回归。

接下来是什么?

Dynostats 和我们定制的 cProfile,以及我们建立的支持它们的监控和警报机制能够有效地找出大多数导致 CPU 回归的元凶。这些进展已经帮助我们恢复了超过 50% 的不必要的 CPU 回归,否则我们就根本不会知道。

我们仍然还有一些可以提升的方面,并很容易将它们地加入到 Instagram 的日常部署流程中:

  1. CPU 指令指标应该要比其它指标如 CPU 时间更加稳定,但我们仍然观察了让我们头疼的差异。保持“ 信噪比 ( signal:noise ratio ) ”合理地低是非常重要的,这样开发者们就可以集中于真实的回归上。这可以通过引入 置信区间 ( confidence intervals ) 的概念来提升,并在信噪比过高时发出警报。针对不同的端点,变化的阈值也可以设置为不同值。
  2. 通过更改 GEV 来探测 CPU 回归的一个限制就是我们要在 Dynostats 中手动启用这些比较的日志输出。当 GEV 的数量逐渐增加,开发了越来越多的功能,这就不便于扩展了。相反,我们能够利用一个自动化框架来调度这些比较的日志输出,并对所有的 GEV 进行遍历,然后当检查到回归时就发出警告。
  3. cProfile 需要一些增强以便更好地处理封装函数以及它们的子函数。

鉴于我们在为 Instagram 的 web service 构建效率框架中所投入的工作,所以我们对于将来使用 Python 继续扩展我们的服务很有信心。我们也开始向 Python 语言本身投入更多,并且开始探索从 Python 2 转移 Python 3 之道。我们将会继续探索并做更多的实验以继续提升基础设施与开发者效率,我们期待着很快能够分享更多的经验。

本文作者 Min Ni 是 Instagram 的软件工程师。

(题图来自:nostarch.com)


via: https://engineering.instagram.com/web-service-efficiency-at-instagram-with-python-4976d078e366#.tiakuoi4p

作者:Min Ni 译者:ChrisLeeGit 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

提高 web 应用的性能从来没有比现在更重要过。网络经济的比重一直在增长;全球经济超过 5% 的价值是在因特网上产生的(数据参见下面的资料)。这个时刻在线的超连接世界意味着用户对其的期望值也处于历史上的最高点。如果你的网站不能及时的响应,或者你的 app 不能无延时的工作,用户会很快的投奔到你的竞争对手那里。

举一个例子,一份亚马逊十年前做过的研究可以证明,甚至在那个时候,网页加载时间每减少100毫秒,收入就会增加1%。另一个最近的研究特别强调一个事实,即超过一半的网站拥有者在调查中承认它们会因为应用程序性能的问题流失用户。

网站到底需要多快呢?对于页面加载,每增加1秒钟就有4%的用户放弃使用。顶级的电子商务站点的页面在第一次交互时可以做到1秒到3秒加载时间,而这是提供最高舒适度的速度。很明显这种利害关系对于 web 应用来说很高,而且在不断的增加。

想要提高效率很简单,但是看到实际结果很难。为了在你的探索之旅上帮助到你,这篇文章会给你提供10条最高可以提升10倍网站性能的建议。这是一系列介绍提高应用程序性能的第一篇文章,包括充分测试的优化技术和一点 NGINX 的帮助。这个系列也给出了潜在的提高安全性的帮助。

Tip #1: 通过反向代理来提高性能和增加安全性

如果你的 web 应用运行在单个机器上,那么这个办法会明显的提升性能:只需要换一个更快的机器,更好的处理器,更多的内存,更快的磁盘阵列,等等。然后新机器就可以更快的运行你的 WordPress 服务器, Node.js 程序, Java 程序,以及其它程序。(如果你的程序要访问数据库服务器,那么解决方法依然很简单:添加两个更快的机器,以及在两台电脑之间使用一个更快的链路。)

问题是,机器速度可能并不是问题。web 程序运行慢经常是因为计算机一直在不同的任务之间切换:通过成千上万的连接和用户交互,从磁盘访问文件,运行代码,等等。应用服务器可能会 抖动 ( thrashing ) -比如说内存不足、将内存数据交换到磁盘,以及有多个请求要等待某个任务完成,如磁盘I/O。

你可以采取一个完全不同的方案来替代升级硬件:添加一个反向代理服务器来分担部分任务。反向代理服务器 位于运行应用的机器的前端,是用来处理网络流量的。只有反向代理服务器是直接连接到互联网的;和应用服务器的通讯都是通过一个快速的内部网络完成的。

使用反向代理服务器可以将应用服务器从等待用户与 web 程序交互解放出来,这样应用服务器就可以专注于为反向代理服务器构建网页,让其能够传输到互联网上。而应用服务器就不需要等待客户端的响应,其运行速度可以接近于优化后的性能水平。

添加反向代理服务器还可以给你的 web 服务器安装带来灵活性。比如,一个某种类型的服务器已经超载了,那么就可以轻松的添加另一个相同的服务器;如果某个机器宕机了,也可以很容易替代一个新的。

因为反向代理带来的灵活性,所以反向代理也是一些性能加速功能的必要前提,比如:

  • 负载均衡 (参见 Tip #2) – 负载均衡运行在反向代理服务器上,用来将流量均衡分配给一批应用。有了合适的负载均衡,你就可以添加应用服务器而根本不用修改应用。
  • 缓存静态文件 (参见 Tip #3) – 直接读取的文件,比如图片或者客户端代码,可以保存在反向代理服务器,然后直接发给客户端,这样就可以提高速度、分担应用服务器的负载,可以让应用运行的更快。
  • 网站安全 – 反向代理服务器可以提高网站安全性,以及快速的发现和响应攻击,保证应用服务器处于被保护状态。

NGINX 软件为用作反向代理服务器而专门设计,也包含了上述的多种功能。NGINX 使用事件驱动的方式处理请求,这会比传统的服务器更加有效率。NGINX plus 添加了更多高级的反向代理特性,比如应用的健康度检查,专门用来处理请求路由、高级缓冲和相关支持。
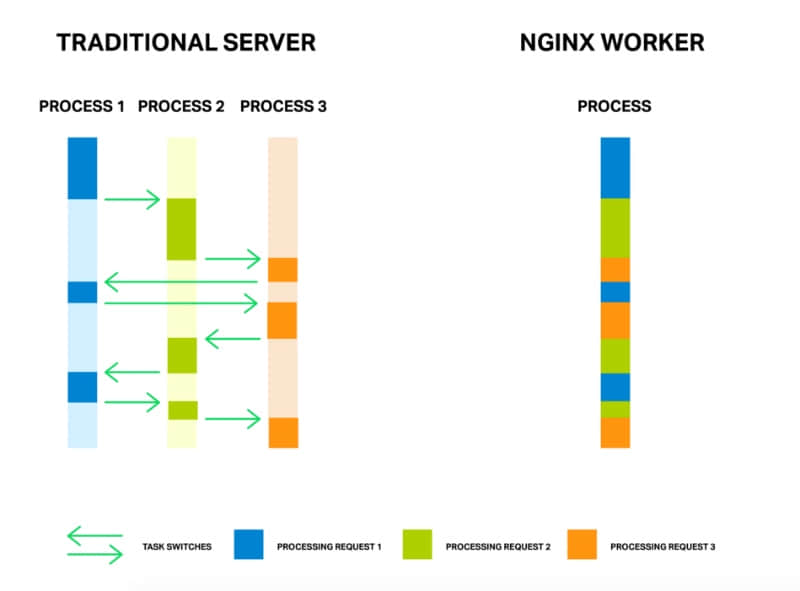
NGINX Worker Process helps increase application performance

Tip #2: 添加负载平衡

添加一个负载均衡服务器 是一个相当简单的用来提高性能和网站安全性的的方法。与其将核心 Web 服务器变得越来越大和越来越强,不如使用负载均衡将流量分配到多个服务器。即使程序写的不好,或者在扩容方面有困难,仅是使用负载均衡服务器就可以很好的提高用户体验。

负载均衡服务器首先是一个反向代理服务器(参见Tip #1)——它接受来自互联网的流量,然后转发请求给另一个服务器。特别是负载均衡服务器支持两个或多个应用服务器,使用分配算法将请求转发给不同服务器。最简单的负载均衡方法是 轮转法 ( round robin ) ,每个新的请求都会发给列表里的下一个服务器。其它的复制均衡方法包括将请求发给活动连接最少的服务器。NGINX plus 拥有将特定用户的会话分配给同一个服务器的能力。

负载均衡可以很好的提高性能是因为它可以避免某个服务器过载而另一些服务器却没有需要处理的流量。它也可以简单的扩展服务器规模,因为你可以添加多个价格相对便宜的服务器并且保证它们被充分利用了。

可以进行负载均衡的协议包括 HTTP、HTTPS、SPDY、HTTP/2、WebSocket、FastCGI、SCGI、uwsgi、 memcached 等,以及几种其它的应用类型,包括基于 TCP 的应用和其它的第4层协议的程序。分析你的 web 应用来决定你要使用哪些以及哪些地方性能不足。

相同的服务器或服务器群可以被用来进行负载均衡,也可以用来处理其它的任务,如 SSL 末端服务器,支持客户端的 HTTP/1.x 和 HTTP/2 请求,以及缓存静态文件。

NGINX 经常被用于进行负载均衡;要想了解更多的情况,可以下载我们的电子书《选择软件负载均衡器的五个理由》。你也可以从 《使用 NGINX 和 NGINX Plus 配置负载均衡,第一部分》中了解基本的配置指导,在 NGINX Plus 管理员指南中有完整的 NGINX 负载均衡的文档。。我们的商业版本 NGINX Plus 支持更多优化了的负载均衡特性,如基于服务器响应时间的加载路由和 Microsoft’s NTLM 协议上的负载均衡。

Tip #3: 缓存静态和动态的内容

缓存可以通过加速内容的传输速度来提高 web 应用的性能。它可以采用以下几种策略:当需要的时候预处理要传输的内容,保存数据到速度更快的设备,把数据存储在距离客户端更近的位置,或者将这几种方法结合起来使用。

有两种不同类型数据的缓冲:

  • 静态内容缓存。不经常变化的文件,比如图像(JPEG、PNG) 和代码(CSS,JavaScript),可以保存在外围服务器上,这样就可以快速的从内存和磁盘上提取。
  • 动态内容缓存。很多 web 应用会针对每次网页请求生成一个新的 HTML 页面。在短时间内简单的缓存生成的 HTML 内容,就可以很好的减少要生成的内容的数量,而且这些页面足够新,可以满足你的需要。

举个例子,如果一个页面每秒会被浏览10次,你将它缓存 1 秒,90%请求的页面都会直接从缓存提取。如果你分开缓存静态内容,甚至新生成的页面可能都是由这些缓存构成的。

下面由是 web 应用发明的三种主要的缓存技术:

  • 缩短数据与用户的网络距离。把一份内容的拷贝放的离用户更近的节点来减少传输时间。
  • 提高内容服务器的速度。内容可以保存在一个更快的服务器上来减少提取文件的时间。
  • 从过载服务器上移走数据。机器经常因为要完成某些其它的任务而造成某个任务的执行速度比测试结果要差。将数据缓存在不同的机器上可以提高缓存资源和非缓存资源的性能,而这是因为主机没有被过度使用。

对 web 应用的缓存机制可以在 web 应用服务器内部实现。首先,缓存动态内容是用来减少应用服务器加载动态内容的时间。其次,缓存静态内容(包括动态内容的临时拷贝)是为了更进一步的分担应用服务器的负载。而且缓存之后会从应用服务器转移到对用户而言更快、更近的机器,从而减少应用服务器的压力,减少提取数据和传输数据的时间。

改进过的缓存方案可以极大的提高应用的速度。对于大多数网页来说,静态数据,比如大图像文件,构成了超过一半的内容。如果没有缓存,那么这可能会花费几秒的时间来提取和传输这类数据,但是采用了缓存之后不到1秒就可以完成。

举一个在实际中缓存是如何使用的例子, NGINX 和 NGINX Plus 使用了两条指令来设置缓存机制:proxy\_cache\_path 和 proxy\_cache。你可以指定缓存的位置和大小、文件在缓存中保存的最长时间和其它一些参数。使用第三条(而且是相当受欢迎的一条)指令 proxy\_cache\_use\_stale,如果提供新鲜内容的服务器忙碌或者挂掉了,你甚至可以让缓存提供较旧的内容,这样客户端就不会一无所得。从用户的角度来看这可以很好的提高你的网站或者应用的可用时间。

NGINX plus 有个高级缓存特性,包括对缓存清除的支持和在仪表盘上显示缓存状态信息。

要想获得更多关于 NGINX 的缓存机制的信息可以浏览 NGINX Plus 管理员指南中的《参考文档》和《NGINX 内容缓存》。

注意:缓存机制分布于应用开发者、投资决策者以及实际的系统运维人员之间。本文提到的一些复杂的缓存机制从 DevOps 的角度来看很具有价值,即对集应用开发者、架构师以及运维操作人员的功能为一体的工程师来说可以满足它们对站点功能性、响应时间、安全性和商业结果(如完成的交易数)等需要。

Tip #4: 压缩数据

压缩是一个具有很大潜力的提高性能的加速方法。现在已经有一些针对照片(JPEG 和PNG)、视频(MPEG-4)和音乐(MP3)等各类文件精心设计和高压缩率的标准。每一个标准都或多或少的减少了文件的大小。

文本数据 —— 包括HTML(包含了纯文本和 HTML 标签),CSS 和代码,比如 Javascript —— 经常是未经压缩就传输的。压缩这类数据会在对应用程序性能的感觉上,特别是处于慢速或受限的移动网络的客户端,产生更大的影响。

这是因为文本数据经常是用户与网页交互的有效数据,而多媒体数据可能更多的是起提供支持或者装饰的作用。智能的内容压缩可以减少 HTML,Javascript,CSS和其它文本内容对带宽的要求,通常可以减少 30% 甚至更多的带宽和相应的页面加载时间。

如果你使用 SSL,压缩可以减少需要进行 SSL 编码的的数据量,而这些编码操作会占用一些 CPU 时间而抵消了压缩数据减少的时间。

压缩文本数据的方法很多,举个例子,在 HTTP/2 中,小说文本的压缩模式就特别调整了头部数据。另一个例子是可以在 NGINX 里打开使用 GZIP 压缩。你在你的服务里预先压缩文本数据之后,你就可以直接使用 gzip\_static 指令来处理压缩过的 .gz 版本。

Tip #5: 优化 SSL/TLS

安全套接字(SSL) 协议和它的下一代版本传输层安全(TLS)协议正在被越来越多的网站采用。SSL/TLS 对从原始服务器发往用户的数据进行加密提高了网站的安全性。影响这个趋势的部分原因是 Google 正在使用 SSL/TLS,这在搜索引擎排名上是一个正面的影响因素。

尽管 SSL/TLS 越来越流行,但是使用加密对速度的影响也让很多网站望而却步。SSL/TLS 之所以让网站变的更慢,原因有二:

  1. 任何一个连接第一次连接时的握手过程都需要传递密钥。而采用 HTTP/1.x 协议的浏览器在建立多个连接时会对每个连接重复上述操作。
  2. 数据在传输过程中需要不断的在服务器端加密、在客户端解密。

为了鼓励使用 SSL/TLS,HTTP/2 和 SPDY(在下一章会描述)的作者设计了新的协议来让浏览器只需要对一个浏览器会话使用一个连接。这会大大的减少上述第一个原因所浪费的时间。然而现在可以用来提高应用程序使用 SSL/TLS 传输数据的性能的方法不止这些。

web 服务器有对应的机制优化 SSL/TLS 传输。举个例子,NGINX 使用 OpenSSL 运行在普通的硬件上提供了接近专用硬件的传输性能。NGINX 的 SSL 性能 有详细的文档,而且把对 SSL/TLS 数据进行加解密的时间和 CPU 占用率降低了很多。

更进一步,参考这篇文章了解如何提高 SSL/TLS 性能的更多细节,可以总结为一下几点:

  • 会话缓冲。使用指令 ssl\_session\_cache 可以缓存每个新的 SSL/TLS 连接使用的参数。
  • 会话票据或者 ID。把 SSL/TLS 的信息保存在一个票据或者 ID 里可以流畅的复用而不需要重新握手。
  • OCSP 分割。通过缓存 SSL/TLS 证书信息来减少握手时间。

NGINX 和 NGINX Plus 可以被用作 SSL/TLS 服务端,用于处理客户端流量的加密和解密,而同时以明文方式和其它服务器进行通信。要设置 NGINX 和 NGINX Plus 作为 SSL/TLS 服务端,参看 《HTTPS 连接》 和《加密的 TCP 连接》。

Tip #6: 使用 HTTP/2 或 SPDY

对于已经使用了 SSL/TLS 的站点,HTTP/2 和 SPDY 可以很好的提高性能,因为每个连接只需要一次握手。而对于没有使用 SSL/TLS 的站点来说,从响应速度的角度来说 HTTP/2 和 SPDY 将让迁移到 SSL/TLS 没有什么压力(原本会降低效率)。

Google 在2012年开始把 SPDY 作为一个比 HTTP/1.x 更快速的协议来推荐。HTTP/2 是目前 IETF 通过的标准,是基于 SPDY 的。SPDY 已经被广泛的支持了,但是很快就会被 HTTP/2 替代。

SPDY 和 HTTP/2 的关键是用单一连接来替代多路连接。单个连接是被复用的,所以它可以同时携带多个请求和响应的分片。

通过使用单一连接,这些协议可以避免像在实现了 HTTP/1.x 的浏览器中一样建立和管理多个连接。单一连接在对 SSL 特别有效,这是因为它可以最小化 SSL/TLS 建立安全链接时的握手时间。

SPDY 协议需要使用 SSL/TLS,而 HTTP/2 官方标准并不需要,但是目前所有支持 HTTP/2 的浏览器只有在启用了 SSL/TLS 的情况下才能使用它。这就意味着支持 HTTP/2 的浏览器只有在网站使用了 SSL 并且服务器接收 HTTP/2 流量的情况下才会启用 HTTP/2。否则的话浏览器就会使用 HTTP/1.x 协议。

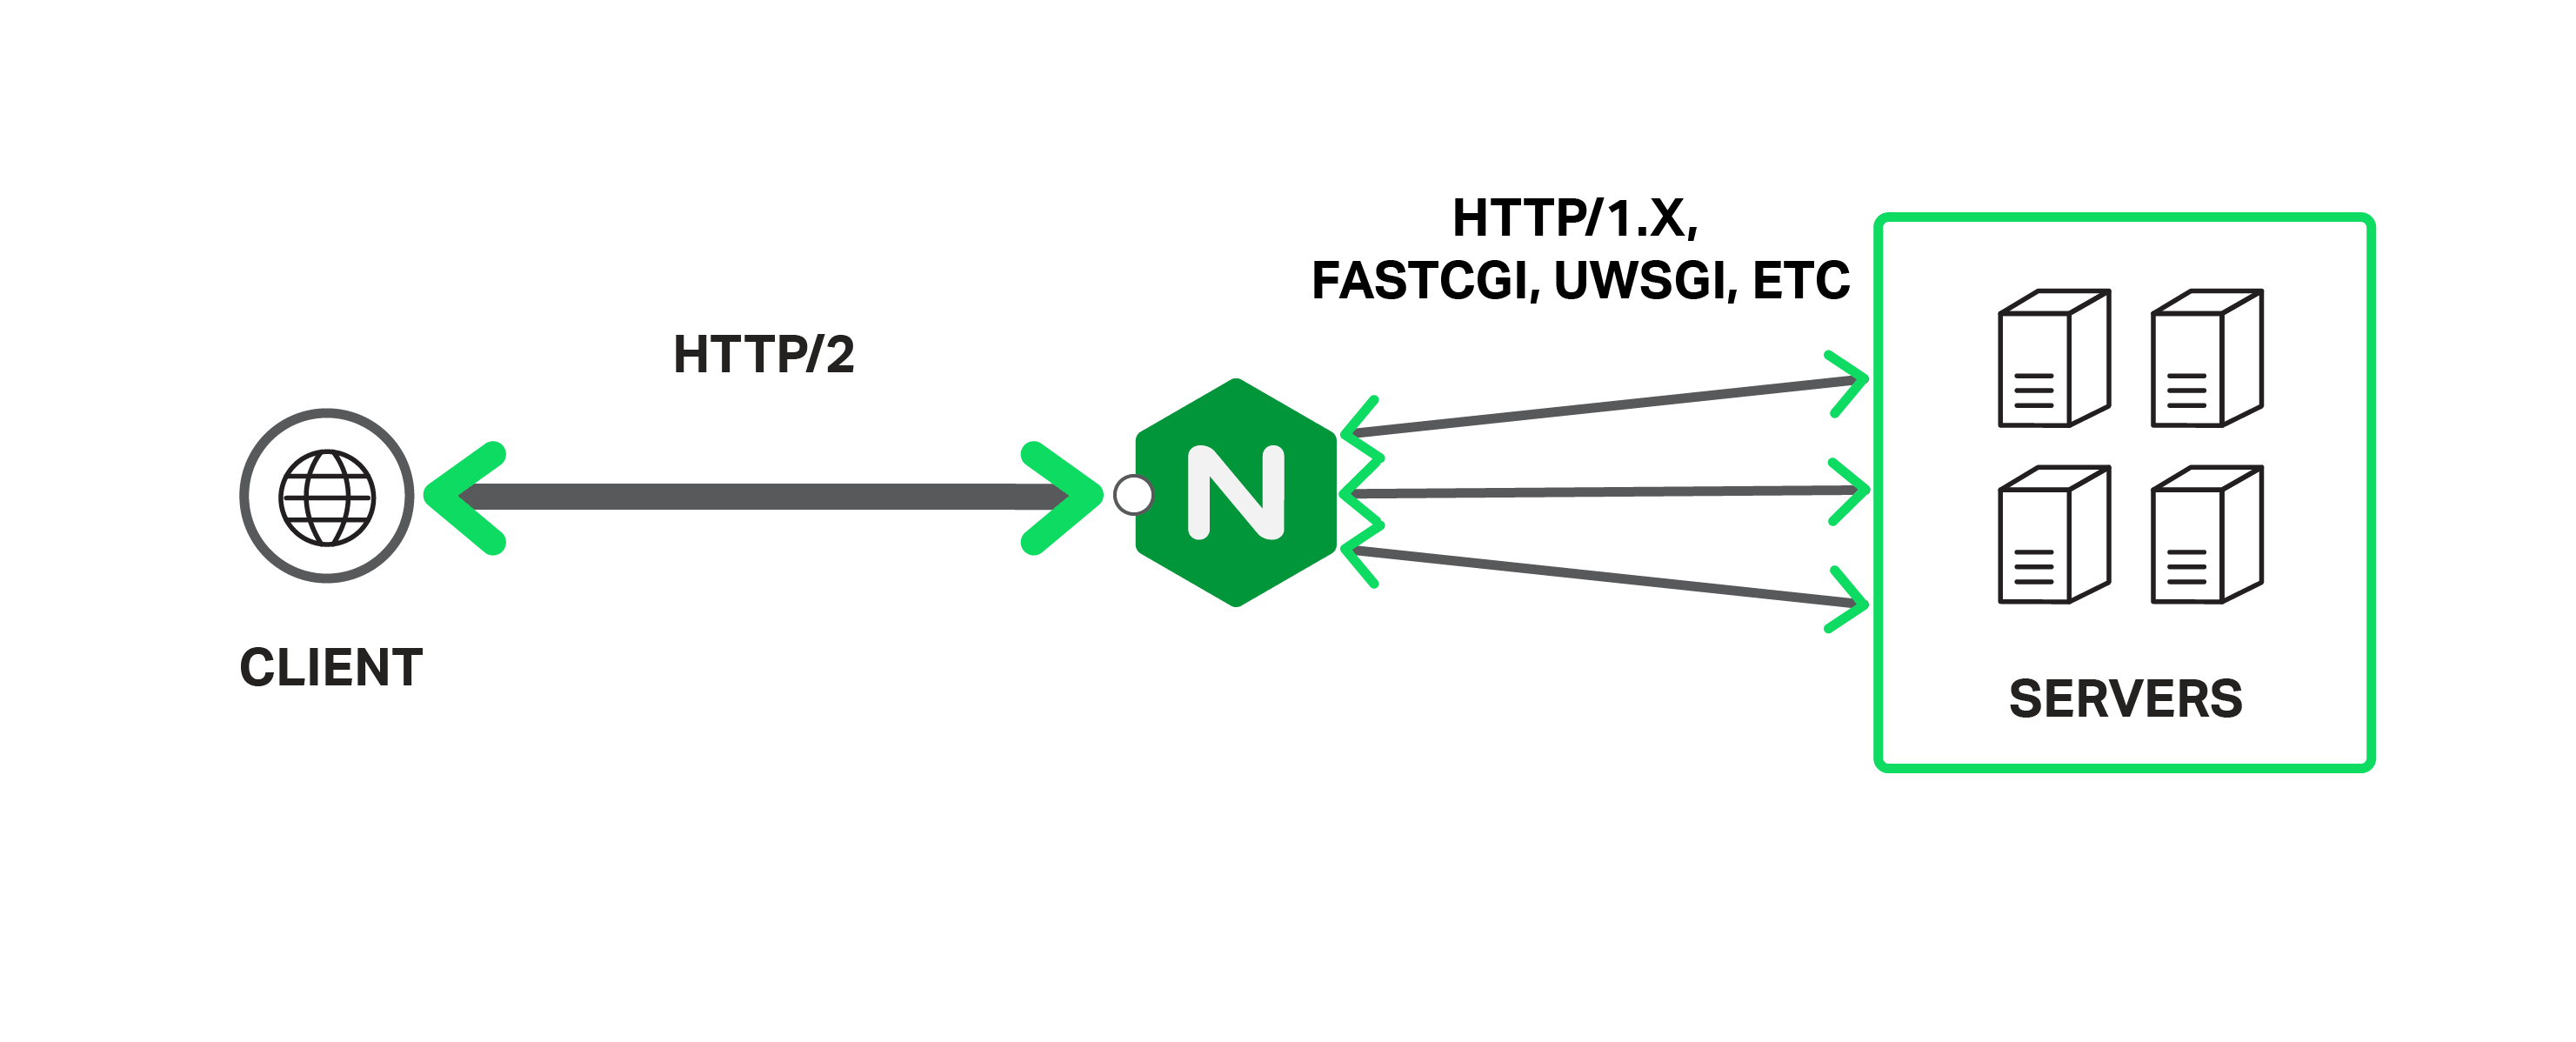
当你实现 SPDY 或者 HTTP/2 时,你不再需要那些常规的 HTTP 性能优化方案,比如按域分割、资源聚合,以及图像拼合。这些改变可以让你的代码和部署变得更简单和更易于管理。要了解 HTTP/2 带来的这些变化可以浏览我们的《白皮书》。
NGINX Supports SPDY and HTTP/2 for increased web application performance

作为支持这些协议的一个样例,NGINX 已经从一开始就支持了 SPDY,而且大部分使用 SPDY 协议的网站都运行的是 NGINX。NGINX 同时也很早对 HTTP/2 的提供了支持,从2015 年9月开始,开源版 NGINX 和 NGINX Plus 就支持它了。

经过一段时间,我们 NGINX 希望更多的站点完全启用 SSL 并且向 HTTP/2 迁移。这将会提高安全性,同时也会找到并实现新的优化手段,简化的代码表现的会更加优异。

Tip #7: 升级软件版本

一个提高应用性能的简单办法是根据软件的稳定性和性能的评价来选在你的软件栈。进一步说,因为高性能组件的开发者更愿意追求更高的性能和解决 bug ,所以值得使用最新版本的软件。新版本往往更受开发者和用户社区的关注。更新的版本往往会利用到新的编译器优化,包括对新硬件的调优。

稳定的新版本通常比旧版本具有更好的兼容性和更高的性能。一直进行软件更新,可以非常简单的保持软件保持最佳的优化,解决掉 bug,以及提高安全性。

一直使用旧版软件也会阻止你利用新的特性。比如上面说到的 HTTP/2,目前要求 OpenSSL 1.0.1。在2016 年中期开始将会要求1.0.2 ,而它是在2015年1月才发布的。

NGINX 用户可以开始迁移到 NGINX 最新的开源软件 或者 NGINX Plus;它们都包含了最新的能力,如 socket 分割和线程池(见下文),这些都已经为性能优化过了。然后好好看看的你软件栈,把它们升级到你能升级到的最新版本吧。

Tip #8: Linux 系统性能调优

Linux 是大多数 web 服务器使用的操作系统,而且作为你的架构的基础,Linux 显然有不少提高性能的可能。默认情况下,很多 Linux 系统都被设置为使用很少的资源,以符合典型的桌面应用使用。这就意味着 web 应用需要一些微调才能达到最大效能。

这里的 Linux 优化是专门针对 web 服务器方面的。以 NGINX 为例,这里有一些在加速 Linux 时需要强调的变化:

  • 缓冲队列。如果你有挂起的连接,那么你应该考虑增加 net.core.somaxconn 的值,它代表了可以缓存的连接的最大数量。如果连接限制太小,那么你将会看到错误信息,而你可以逐渐的增加这个参数直到错误信息停止出现。
  • 文件描述符。NGINX 对一个连接使用最多2个文件描述符。如果你的系统有很多连接请求,你可能就需要提高sys.fs.file\_max ,以增加系统对文件描述符数量整体的限制,这样才能支持不断增加的负载需求。
  • 临时端口。当使用代理时,NGINX 会为每个上游服务器创建临时端口。你可以设置net.ipv4.ip\_local\_port\_range 来提高这些端口的范围,增加可用的端口号。你也可以减少非活动的端口的超时判断来重复使用端口,这可以通过 net.ipv4.tcp\_fin\_timeout 来设置,这可以快速的提高流量。

对于 NGINX 来说,可以查阅 《NGINX 性能调优指南》来学习如果优化你的 Linux 系统,这样它就可以很好的适应大规模网络流量而不会超过工作极限。

Tip #9: web 服务器性能调优

无论你是用哪种 web 服务器,你都需要对它进行优化来提高性能。下面的推荐手段可以用于任何 web 服务器,但是一些设置是针对 NGINX 的。关键的优化手段包括:

  • 访问日志。不要把每个请求的日志都直接写回磁盘,你可以在内存将日志缓存起来然后批量写回磁盘。对于NGINX 来说,给指令 access\_log 添加参数 buffer=size 可以让系统在缓存满了的情况下才把日志写到磁盘。如果你添加了参数 flush=time ,那么缓存内容会每隔一段时间再写回磁盘。
  • 缓存。缓存会在内存中存放部分响应,直到满了为止,这可以让与客户端的通信更加高效。内存放不下的响应会写回磁盘,而这就会降低效能。当 NGINX 启用了缓存机制后,你可以使用指令 proxy\_buffer\_size 和 proxy\_buffers 来管理缓存。
  • 客户端保活。保活连接可以减少开销,特别是使用 SSL/TLS 时。对于 NGINX 来说,你可以从 keepalive\_requests 的默认值 100 开始增加最大连接数,这样一个客户端就可以在一个指定的连接上请求多次,而且你也可以通过增加 keepalive\_timeout 的值来允许保活连接存活更长时间,这样就可以让后来的请求处理的更快速。
  • 上游保活。上游的连接——即连接到应用服务器、数据库服务器等机器的连接——同样也会受益于连接保活。对于上游连接来说,你可以增加 keepalive,即每个工人进程的空闲保活连接个数。这就可以提高连接的复用次数,减少需要重新打开全新连接的次数。更多关于保活连接的信息可以参见这篇“ HTTP 保活连接和性能”。
  • 限制。限制客户端使用的资源可以提高性能和安全性。对于 NGINX 来说,指令 limit\_conn 和 limit\_conn\_zone 限制了给定来源的连接数量,而 limit\_rate 限制了带宽。这些限制都可以阻止合法用户扒取资源,同时也避免了攻击。指令 limit\_req 和 limit\_req\_zone 限制了客户端请求。对于上游服务器来说,可以在 upstream 的配置块里的 server 指令使用 max\_conns 参数来限制连接到上游服务器的连接数。 这样可以避免服务器过载。关联的 queue 指令会创建一个队列来在连接数抵达 max\_connS 限制时在指定长度的时间内保存特定数量的请求。
  • 工人进程。工人进程负责处理请求。NGINX 采用事件驱动模型和操作系统特定的机制来有效的将请求分发给不同的工人进程。这条建议推荐设置 worker\_processes 为每个 CPU 一个 。worker\_connections 的最大数(默认512)可以在大部分系统上根据需要增加,实验性地找到最适合你的系统的值。
  • 套接字分割。通常一个套接字监听器会把新连接分配给所有工人进程。套接字分割会为每个工人进程创建一个套接字监听器,这样一来以当套接字监听器可用时,内核就会将连接分配给它。这可以减少锁竞争,并且提高多核系统的性能,要启用套接字分隔需要在 listen 指令里面加上 reuseport 参数。
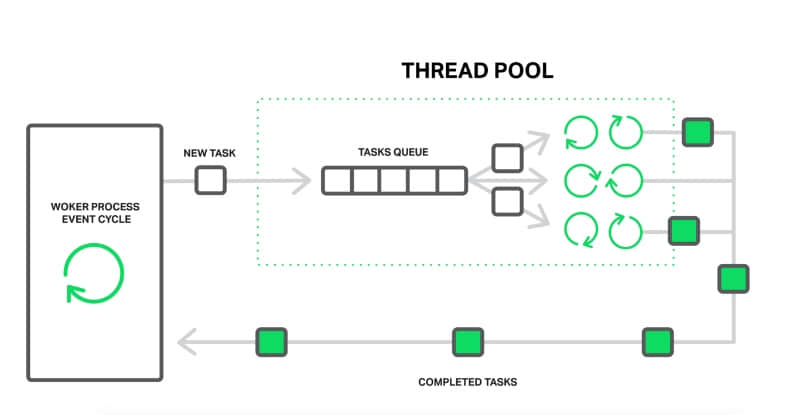
  • 线程池。计算机进程可能被一个单一的缓慢的操作所占用。对于 web 服务器软件来说,磁盘访问会影响很多更快的操作,比如计算或者在内存中拷贝。使用了线程池之后慢操作可以分配到不同的任务集,而主进程可以一直运行快速操作。当磁盘操作完成后结果会返回给主进程的循环。在 NGINX 里有两个操作——read() 系统调用和 sendfile() ——被分配到了线程池
Thread pools help increase application performance by assigning a slow operation to a separate set of tasks

技巧。当改变任何操作系统或支持服务的设置时,一次只改变一个参数然后测试性能。如果修改引起问题了,或者不能让你的系统更快,那么就改回去。

在《调优 NGINX 性能》里可以看到更详细的 NGINX 调优方法。

Tip #10: 监视系统活动来解决问题和瓶颈

在应用开发中要使得系统变得非常高效的关键是监视你的系统在现实世界运行的性能。你必须能通过特定的设备和你的 web 基础设施上监控程序活动。

监视活动是最积极的——它会告诉你发生了什么,把问题留给你发现和最终解决掉。

监视可以发现几种不同的问题。它们包括:

  • 服务器宕机。
  • 服务器出问题一直在丢失连接。
  • 服务器出现大量的缓存未命中。
  • 服务器没有发送正确的内容。

应用的总体性能监控工具,比如 New Relic 和 Dynatrace,可以帮助你监控到从远程加载网页的时间,而 NGINX 可以帮助你监控到应用交付端。当你需要考虑为基础设施添加容量以满足流量需求时,应用性能数据可以告诉你你的优化措施的确起作用了。

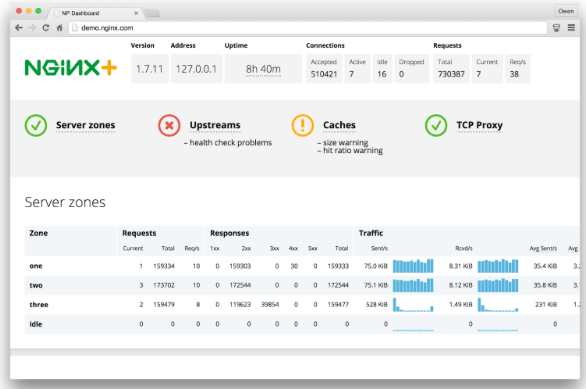
为了帮助开发者快速的发现、解决问题,NGINX Plus 增加了应用感知健康度检查 ——对重复出现的常规事件进行综合分析并在问题出现时向你发出警告。NGINX Plus 同时提供会话过滤功能,这可以阻止当前任务完成之前接受新的连接,另一个功能是慢启动,允许一个从错误恢复过来的服务器追赶上负载均衡服务器群的进度。当使用得当时,健康度检查可以让你在问题变得严重到影响用户体验前就发现它,而会话过滤和慢启动可以让你替换服务器,并且这个过程不会对性能和正常运行时间产生负面影响。下图就展示了内建的 NGINX Plus 模块实时活动监视的仪表盘,包括了服务器群,TCP 连接和缓存信息等 Web 架构信息。
Use real-time application performance monitoring tools to identify and resolve issues quickly

总结: 看看10倍性能提升的效果

这些性能提升方案对任何一个 web 应用都可用并且效果都很好,而实际效果取决于你的预算、你能花费的时间、目前实现方案的差距。所以你该如何对你自己的应用实现10倍性能提升?

为了指导你了解每种优化手段的潜在影响,这里是上面详述的每个优化方法的关键点,虽然你的情况肯定大不相同:

  • 反向代理服务器和负载均衡。没有负载均衡或者负载均衡很差都会造成间歇的性能低谷。增加一个反向代理,比如 NGINX ,可以避免 web 应用程序在内存和磁盘之间波动。负载均衡可以将过载服务器的任务转移到空闲的服务器,还可以轻松的进行扩容。这些改变都可以产生巨大的性能提升,很容易就可以比你现在的实现方案的最差性能提高10倍,对于总体性能来说可能提高的不多,但是也是有实质性的提升。
  • 缓存动态和静态数据。如果你有一个负担过重的 web 服务器,那么毫无疑问肯定是你的应用服务器,只通过缓存动态数据就可以在峰值时间提高10倍的性能。缓存静态文件可以提高几倍的性能。
  • 压缩数据。使用媒体文件压缩格式,比如图像格式 JPEG,图形格式 PNG,视频格式 MPEG-4,音乐文件格式 MP3 可以极大的提高性能。一旦这些都用上了,然后压缩文件数据可以将初始页面加载速度提高两倍。
  • 优化 SSL/TLS。安全握手会对性能产生巨大的影响,对它们的优化可能会对初始响应产生2倍的提升,特别是对于大量文本的站点。优化 SSL/TLS 下媒体文件只会产生很小的性能提升。
  • 使用 HTTP/2 和 SPDY。当你使用了 SSL/TLS,这些协议就可以提高整个站点的性能。
  • 对 Linux 和 web 服务器软件进行调优。比如优化缓存机制,使用保活连接,分配时间敏感型任务到不同的线程池可以明显的提高性能;举个例子,线程池可以加速对磁盘敏感的任务近一个数量级。

我们希望你亲自尝试这些技术。我们希望知道你说取得的各种性能提升案例。请在下面评论栏分享你的结果或者在标签 #NGINX 和 #webperf 下 tweet 你的故事。

网上资源


via: https://www.nginx.com/blog/10-tips-for-10x-application-performance/

作者:Floyd Smith 译者:Ezio 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出
你能快速定位CPU性能回退的问题么? 如果你的工作环境非常复杂且变化快速,那么使用现有的工具是来定位这类问题是很具有挑战性的。当你花掉数周时间把根因找到时,代码已经又变更了好几轮,新的性能问题又冒了出来。

幸亏有了CPU火焰图(flame graphs),CPU使用率的问题一般都比较好定位。但要处理性能回退问题,就要在修改前后的火焰图之间,不断切换对比,来找出问题所在,这感觉就是像在太阳系中搜寻冥王星。虽然,这种方法可以解决问题,但我觉得应该会有更好的办法。

所以,下面就隆重介绍红/蓝差分火焰图(red/blue differential flame graphs):

上面是一副交互式SVG格式图片(链接)。图中使用了两种颜色来表示状态,红色表示增长,蓝色表示衰减。

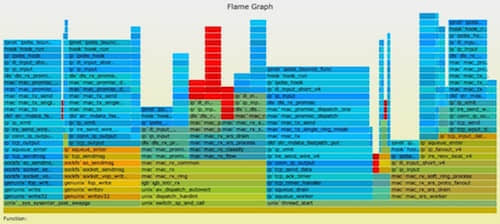
这张火焰图中各火焰的形状和大小都是和第二次抓取的profile文件对应的CPU火焰图是相同的。(其中,y轴表示栈的深度,x轴表示样本的总数,栈帧的宽度表示了profile文件中该函数出现的比例,最顶层表示正在运行的函数,再往下就是调用它的栈)

在下面这个案例展示了,在系统升级后,一个工作载荷的CPU使用率上升了。 下面是对应的CPU火焰图(SVG格式)

通常,在标准的火焰图中栈帧和栈塔的颜色是随机选择的。 而在红/蓝差分火焰图中,使用不同的颜色来表示两个profile文件中的差异部分。

在第二个profile中deflate\_slow()函数以及它后续调用的函数运行的次数要比前一次更多,所以在上图中这个栈帧被标为了红色。可以看出问题的原因是ZFS的压缩功能被启用了,而在系统升级前这项功能是关闭的。

这个例子过于简单,我甚至可以不用差分火焰图也能分析出来。但想象一下,如果是在分析一个微小的性能下降,比如说小于5%,而且代码也更加复杂的时候,问题就为那么好处理了。

红/蓝差分火焰图

这个事情我已经讨论了好几年了,最终我自己编写了一个我个人认为有价值的实现。它的工作原理是这样的:

  1. 抓取修改前的堆栈profile1文件
  2. 抓取修改后的堆栈profile2文件
  3. 使用profile2来生成火焰图。(这样栈帧的宽度就是以profile2文件为基准的)
  4. 使用“2 - 1”的差异来对火焰图重新上色。上色的原则是,如果栈帧在profile2中出现出现的次数更多,则标为红色,否则标为蓝色。色彩是根据修改前后的差异来填充的。

这样做的目的是,同时使用了修改前后的profile文件进行对比,在进行功能验证测试或者评估代码修改对性能的影响时,会非常有用。新的火焰图是基于修改后的profile文件生成(所以栈帧的宽度仍然显示了当前的CPU消耗),通过颜色的对比,就可以了解到系统性能差异的原因。

只有对性能产生直接影响的函数才会标注颜色(比如说,正在运行的函数),它所调用的子函数不会重复标注。

生成红/蓝差分火焰图

我已经把一个简单的代码实现推送到github上(见火焰图),其中新增了一个程序脚本,difffolded.pl。为了展示工具是如何工作的,用Linux perf\_events 来演示一下操作步骤。(你也可以使用其他profiler)

抓取修改前的profile 1文件:

# perf record -F 99 -a -g -- sleep 30
# perf script > out.stacks1

一段时间后 (或者程序代码修改后), 抓取profile 2文件:

# perf record -F 99 -a -g -- sleep 30
# perf script > out.stacks2

现在将 profile 文件进行折叠(fold), 再生成差分火焰图:

$ git clone --depth 1 http://github.com/brendangregg/FlameGraph
$ cd FlameGraph
$ ./stackcollapse-perf.pl ../out.stacks1 > out.folded1
$ ./stackcollapse-perf.pl ../out.stacks2 > out.folded2
$ ./difffolded.pl out.folded1 out.folded2 | ./flamegraph.pl > diff2.svg

difffolded.p只能对“折叠”过的堆栈profile文件进行操作,折叠操作是由前面的stackcollapse系列脚本完成的。(见链接火焰图)。 脚本共输出3列数据,其中一列代表折叠的调用栈,另两列为修改前后profile文件的统计数据。

func_a;func_b;func_c 31 33
[...]

在上面的例子中"funca()->funcb()->func\_c()" 代表调用栈,这个调用栈在profile1文件中共出现了31次,在profile2文件中共出现了33次。然后,使用flamegraph.pl脚本处理这3列数据,会自动生成一张红/蓝差分火焰图。

其他选项

再介绍一些有用的选项:

difffolded.pl -n:这个选项会把两个profile文件中的数据规范化,使其能相互匹配上。如果你不这样做,抓取到所有栈的统计值肯定会不相同,因为抓取的时间和CPU负载都不同。这样的话,看上去要么就是一片红(负载增加),要么就是一片蓝(负载下降)。-n选项对第一个profile文件进行了平衡,这样你就可以得到完整红/蓝图谱。

difffolded.pl -x: 这个选项会把16进制的地址删掉。 profiler时常会无法将地址转换为符号,这样的话栈里就会有16进制地址。如果这个地址在两个profile文件中不同,这两个栈就会认为是不同的栈,而实际上它们是相同的。遇到这样的问题就用-x选项搞定。

flamegraph.pl --negate: 用于颠倒红/蓝配色。 在下面的章节中,会用到这个功能。

不足之处

虽然我的红/蓝差分火焰图很有用,但实际上还是有一个问题:如果一个代码执行路径完全消失了,那么在火焰图中就找不到地方来标注蓝色。你只能看到当前的CPU使用情况,而不知道为什么会变成这样。

一个办法是,将对比顺序颠倒,画一个相反的差分火焰图。例如:

上面的火焰图是以修改前的profile文件为基准,颜色表达了将要发生的情况。右边使用蓝色高亮显示的部分,从中可以看出修改后CPU Idle消耗的CPU时间会变少。(其实,我通常会把cpuidle给过滤掉,使用命令行grep -v cpuidle)

图中把消失的代码也突显了出来(或者应该是说,没有突显),因为修改前并没有使能压缩功能,所以它没有出现在修改前的profile文件了,也就没有了被表为红色的部分。

下面是对应的命令行:

$ ./difffolded.pl out.folded2 out.folded1 | ./flamegraph.pl --negate > diff1.svg

这样,把前面生成diff2.svg一并使用,我们就能得到:

  • diff1.svg: 宽度是以修改前profile文件为基准,颜色表明将要发生的情况
  • diff2.svg: 宽度是以修改后profile文件为基准,颜色表明已经发生的情况

如果是在做功能验证测试,我会同时生成这两张图。

CPI 火焰图

这些脚本开始是被使用在CPI火焰图的分析上。与比较修改前后的profile文件不同,在分析CPI火焰图时,可以分析CPU工作周期与停顿周期的差异变化,这样可以凸显出CPU的工作状态来。

其他的差分火焰图

也有其他人做过类似的工作。Robert Mustacchi在不久前也做了一些尝试,他使用的方法类似于代码检视时的标色风格:只显示了差异的部分,红色表示新增(上升)的代码路径,蓝色表示删除(下降)的代码路径。一个关键的差别是栈帧的宽度只体现了差异的样本数。右边是一个例子。这个是个很好的主意,但在实际使用中会感觉有点奇怪,因为缺失了完整profile文件的上下文作为背景,这张图显得有些难以理解。

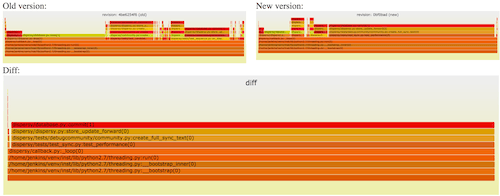
Cor-Paul Bezemer也制作了一种差分显示方法flamegraphdiff,他同时将3张火焰图放在同一张图中,修改前后的标准火焰图各一张,下面再补充了一张差分火焰图,但栈帧宽度也是差异的样本数。 上图是一个例子。在差分图中将鼠标移到栈帧上,3张图中同一栈帧都会被高亮显示。这种方法中补充了两张标准的火焰图,因此解决了上下文的问题。

我们3人的差分火焰图,都各有所长。三者可以结合起来使用:Cor-Paul方法中上方的两张图,可以用我的diff1.svg 和 diff2.svg。下方的火焰图可以用Robert的方式。为保持一致性,下方的火焰图可以用我的着色方式:蓝->白->红。

火焰图正在广泛传播中,现在很多公司都在使用它。如果大家知道有其他的实现差分火焰图的方式,我也不会感到惊讶。(请在评论中告诉我)

结论

如果你遇到了性能回退问题,红/蓝差分火焰图是找到根因的最快方式。这种方式抓取了两张普通的火焰图,然后进行对比,并对差异部分进行标色:红色表示上升,蓝色表示下降。 差分火焰图是以当前(“修改后”)的profile文件作为基准,形状和大小都保持不变。因此你通过色彩的差异就能够很直观的找到差异部分,且可以看出为什么会有这样的差异。

差分火焰图可以应用到项目的每日构建中,这样性能回退的问题就可以及时地被发现和修正。


via: http://www.brendangregg.com/blog/2014-11-09/differential-flame-graphs.html

作者:Brendan Gregg 译者:coloka 校对:wxy

本文由 LCTT 原创翻译,Linux中国 荣誉推出

一段时间以来,我们在网上向读者介绍了如何为Linux以及类Linux操作系统配置多种不同的性能监控工具。在这篇文章中我们将罗列一系列使用最频繁的性能监控工具,并对介绍到的每一个工具提供了相应的简介链接,大致将其划分为两类,基于命令行的和提供图形化接口的。

基于命令行的性能监控工具

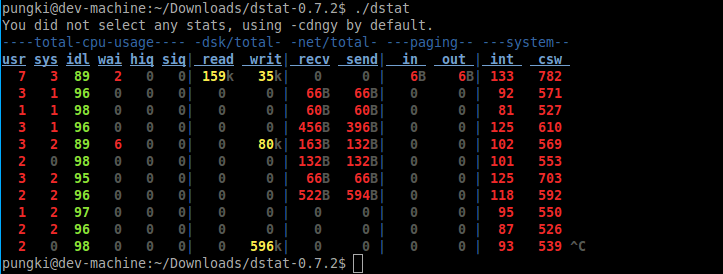
1. dstat - 多类型资源统计工具

该命令整合了vmstat,iostat和ifstat三种命令。同时增加了新的特性和功能可以让你能及时看到各种的资源使用情况,从而能够使你对比和整合不同的资源使用情况。通过不同颜色和区块布局的界面帮助你能够更加清晰容易的获取信息。它也支持将信息数据导出到cvs格式文件中,从而用其他应用程序打开,或者导入到数据库中。你可以用该命令来监控cpu,内存和网络状态随着时间的变化。

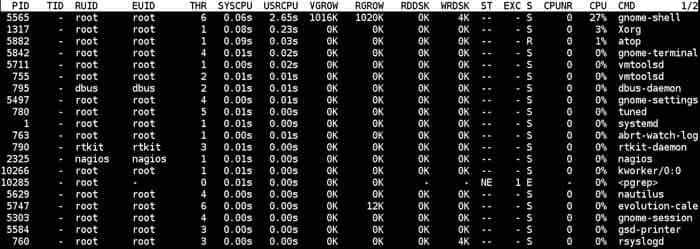
2. atop - 相比top更好的ASCII码体验

这个使用ASCII码显示方式的命令行工具是一个显示所有进程活动的性能监控工具。它可以展示每日的系统日志以进行长期的进程活动分析,并高亮显示过载的系统使用资源。它包含了CPU,内存,交换空间,磁盘和网络层的度量指标。所有这些功能只需在终端运行atop即可。

# atop

当然你也可以使用交互界面来显示数据并进行排序。

3. Nmon - 类Unix系统的性能监控

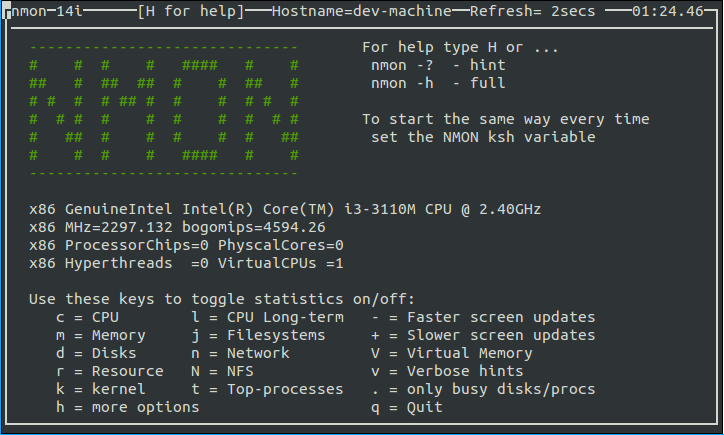
Nmon是Nigel's Monitor缩写,它最早开发用来作为AIX的系统监控工具。如果使用在线模式,可以使用光标键在屏幕上操作实时显示在终端上的监控信息。使用捕捉模式能够将数据保存为CSV格式,方便进一步的处理和图形化展示。

更多的信息参考使用nmon进行性能监控的文章。

4. slabtop - 显示内核slab缓存信息

这个应用能够显示缓存分配器是如何管理Linux内核中缓存的不同类型的对象。这个命令类似于top命令,区别是它的重点是实时显示内核slab缓存信息。它能够显示按照不同排序条件来排序显示缓存列表。它同时也能够显示一个slab层信息的统计信息的题头。举例如下:

# slabtop --sort=a
# slabtop -s b
# slabtop -s c
# slabtop -s l
# slabtop -s v
# slabtop -s n
# slabtop -s o

更多的信息参考监控内核slab缓存的文章。

5. sar - 性能监控和瓶颈检查

sar 命令可以将操作系统上所选的累积活动计数器内容信息输出到标准输出上。其基于计数值和时间间隔参数的审计系统,会按照指定的时间间隔输出指定次数的监控信息。如果时间间隔参数为设置为0,那么sar命令将会显示系统从开机到当时时刻的平均统计信息。有用的命令如下:

# sar -u 2 3
# sar -u -f /var/log/sa/sa05
# sar -P ALL 1 1
# sar -r 1 3
# sar -W 1 3

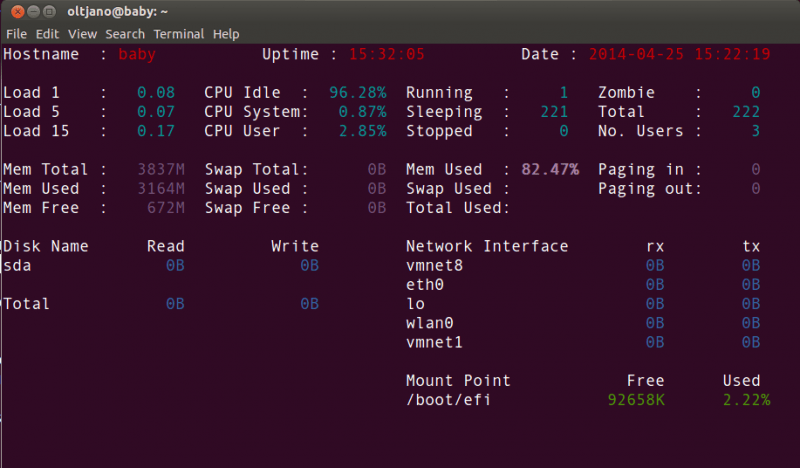
6. Saidar - 简单的统计监控工具

Saidar是一个简单且轻量的系统信息监控工具。虽然它无法提供大多性能报表,但是它能够通过一个简单明了的方式显示最有用的系统运行状况数据。你可以很容易地看到运行时间、平均负载、CPU、内存、进程、磁盘和网络接口统计信息。

Usage: saidar [-d delay] [-c] [-v] [-h]

-d 设置更新时间(秒)
-c 彩色显示
-v 显示版本号
-h 显示本帮助

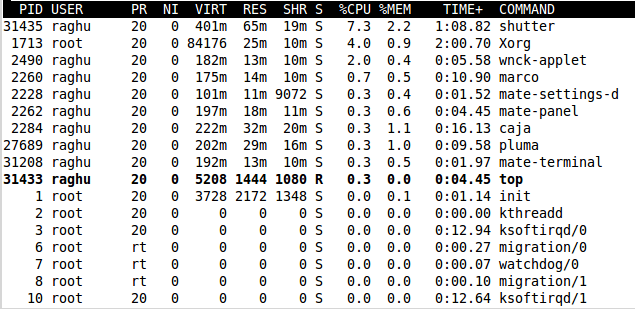
7. top - 经典的Linux任务管理工具

作为一个广为人知的Linux工具,top是大多数的类Unix操作系统任务管理器。它可以显示当前正在运行的进程的列表,用户可以按照不同的条件对该列表进行排序。它主要显示了系统进程对CPU和内存的使用状况。top可以快速检查是哪个或哪几个进程挂起了你的系统。你可以在这里看到top使用的例子。 你可以在终端输入top来运行它并进入到交互模式:

交互模式的一些快捷操作:

    全局命令: <回车/空格> ?, =, A, B, d, G, h, I, k, q, r, s, W, Z
    统计区的命令: l, m, t, 1
    任务区的命令:
         外观: b, x, y, z 内容: c, f, H, o, S, u 大小: #, i, n 排序: <, >, F, O, R
    色彩方案: <Ret>, a, B, b, H, M, q, S, T, w, z, 0 - 7
    窗口命令:  -, _, =, +, A, a, G, g, w

8. Sysdig - 系统进程的高级视图

Sysdig是一个能够让系统管理员和开发人员以前所未有方式洞察其系统行为的监控工具。其开发团队希望改善系统级的监控方式,通过提供关于存储,进程,网络和内存子系统的统一有序以及粒度可见的方式来进行错误排查,并可以创建系统活动记录文件以便你可以在任何时间轻松分析。

简单例子:

# sysdig proc.name=vim
# sysdig -p"%proc.name %fd.name" "evt.type=accept and proc.name!=httpd"
# sysdig evt.type=chdir and user.name=root
# sysdig -l
# sysdig -L
# sysdig -c topprocs_net
# sysdig -c fdcount_by fd.sport "evt.type=accept"
# sysdig -p"%proc.name %fd.name" "evt.type=accept and proc.name!=httpd"
# sysdig -c topprocs_file
# sysdig -c fdcount_by proc.name "fd.type=file"
# sysdig -p "%12user.name %6proc.pid %12proc.name %3fd.num %fd.typechar %fd.name" evt.type=open
# sysdig -c topprocs_cpu
# sysdig -c topprocs_cpu evt.cpu=0
# sysdig -p"%evt.arg.path" "evt.type=chdir and user.name=root"
# sysdig evt.type=open and fd.name contains /etc

更多的信息参考:如何利用sysdig改善系统层次的监控和错误排查。

9. netstat - 显示开放的端口和连接

它是Linux管理员使用来显示各种网络信息的工具,如查看什么端口开放和什么网络连接已经建立以及何种进程运行在该连接之上。同时它也显示了不同程序间打开的Unix套接字的信息。作为大多数Linux发行版本的一部分,netstat的许多命令在netstat和它的不同输出中有详细的描述。最为常用的如下:

$ netstat | head -20
$ netstat -r
$ netstat -rC
$ netstat -i
$ netstat -ie
$ netstat -s
$ netstat -g
$ netstat -tapn

10. tcpdump - 洞察网络封包

tcpdump可以用来查看网络连接的封包内容。它显示了传输过程中封包内容的各种信息。为了使得输出信息更为有用,它允许使用者通过不同的过滤器获取自己想要的信息。可以参照的例子如下:

# tcpdump -i eth0 not port 22
# tcpdump -c 10 -i eth0
# tcpdump -ni eth0 -c 10 not port 22
# tcpdump -w aloft.cap -s 0
# tcpdump -r aloft.cap
# tcpdump -i eth0 dst port 80

更多的信息可以在使用topdump捕捉包中找到详细描述。

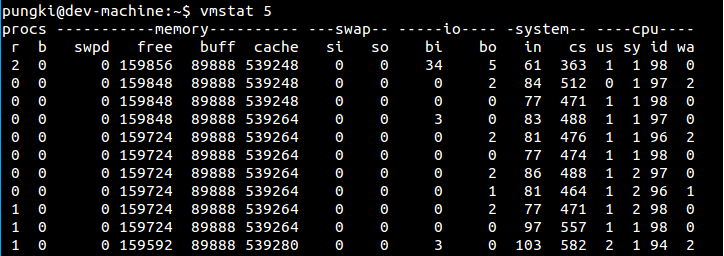
11. vmstat - 虚拟内存统计信息

vmstat是虚拟内存(virtual memory statistics)的缩写,作为一个内存监控工具,它收集和显示关于内存,进程,终端和分页和I/O阻塞的概括信息。作为一个开源程序,它可以在大部分Linux发行版本中找到,包括Solaris和FreeBSD。它用来诊断大部分的内存性能问题和其他相关问题。

更多的信息参考vmstat命令的文章。

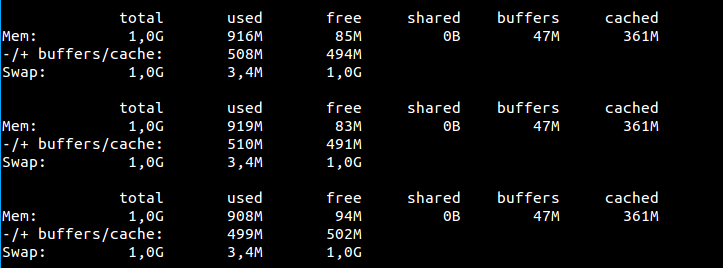
12. free - 内存统计信息

free是另一个能够在终端中显示内存和交换空间使用的命令行工具。由于它的简易,它经常用于快速查看内存使用或者是应用于不同的脚本和应用程序中。在这里你可以看到这个小程序的许多应用。几乎所有的系统管理员日常都会用这个工具。:-)

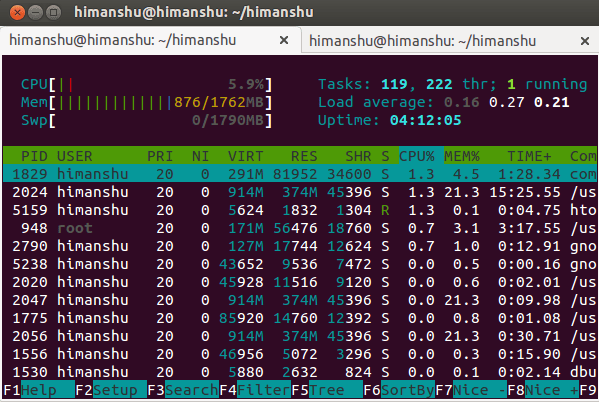
13. Htop - 更加友好的top

Htop基本上是一个top改善版本,它能够以更加多彩的方式显示更多的统计信息,同时允许你采用不同的方式进行排序,它提供了一个用户友好的接口。

更多的信息参考我们的文章:“关于htop和top的比较”。

14. ss - 网络管理的现代替代品

ss是iproute2包的一部分。iproute2是用来替代一整套标准的Unix网络工具组件,它曾经用来完成网络接口配置,路由表和管理ARP表任务。ss工具用来记录套接字统计信息,它可以显示类似netstat一样的信息,同时也能显示更多TCP和状态信息。一些例子如下:

# ss -tnap
# ss -tnap6
# ss -tnap
# ss -s
# ss -tn -o state established -p

15. lsof - 列表显示打开的文件

lsof命令,意为“list open files”, 用于在许多类Unix系统中显示所有打开的文件及打开它们的进程。在大部分Linux发行版和其他类Linux操作系统中系统管理员用它来检查不同的进程打开了哪些文件。

# lsof +p process_id
# lsof | less
# lsof –u username
# lsof /etc/passwd
# lsof –i TCP:ftp
# lsof –i TCP:80

更多的信息参考我们的文章:lsof 的使用。

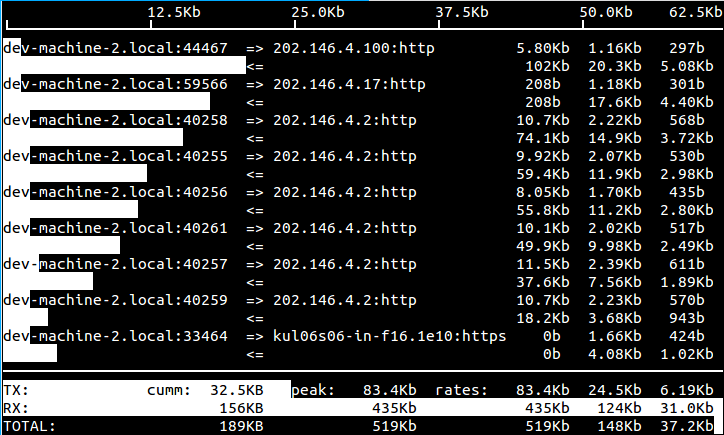
16. iftop - 类似top的了网络连接工具

iftop是另一个基于网络信息的类似top的程序。它能够显示当前时刻按照带宽使用量或者上传或者下载量排序的网络连接状况。它同时提供了下载文件的预估完成时间。

更多的信息参考Linux流量监控工具:iftop。

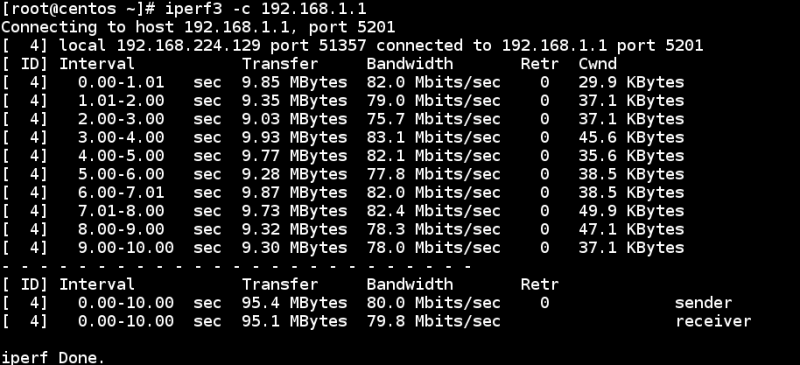
17. iperf - 网络性能工具

iperf是一个网络测试工具,能够创建TCP和UDP数据连接并在网络上测量它们的传输性能。它支持调节关于时间,协议和缓冲等不同的参数。对于每一个测试,它会报告带宽,丢包和其他的一些参数。

如果你想用使用这个工具,可以参考这篇文章: 如何安装和使用iperf。

18. Smem - 高级内存报表工具

Smem是最先进的Linux命令行工具之一,它提供关于系统中已经使用的和共享的实际内存大小,试图提供一个更为可靠的当前内存使用数据。

$ smem -m
$ smem -m -p | grep firefox
$ smem -u -p
$ smem -w -p

参考我们的文章:Smem更多的例子。

图形化或基于Web的性能工具

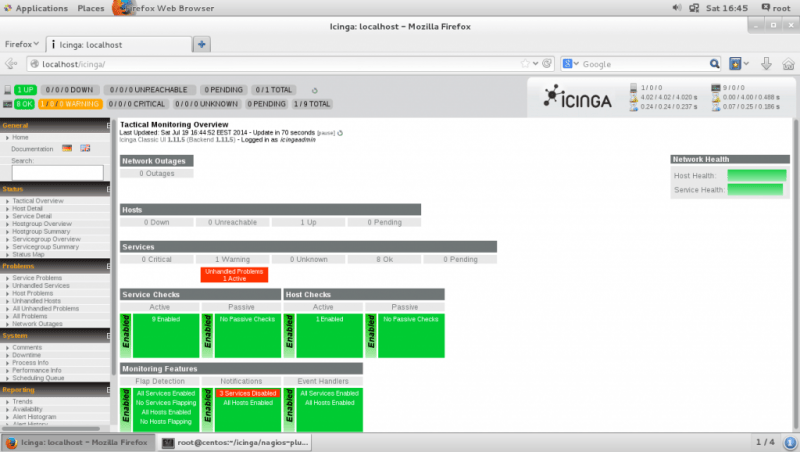
19. Icinga - Nagios的社区分支版本

Icinga是一个开源免费的网络监控程序,作为Nagios的分支,它继承了前者现有的大部分功能,同时基于这些功能又增加了社区用户要求已久的功能和补丁。

更多信息请参考安装和配置lcinga文章。

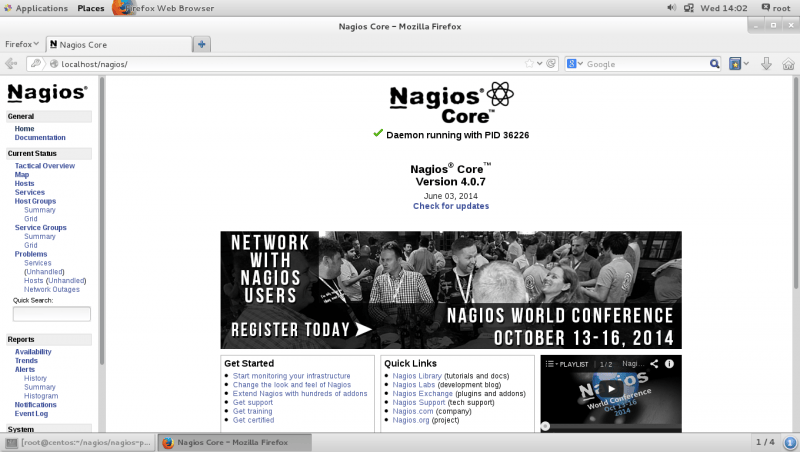
20. Nagios - 最为流行的监控工具

作为在Linux上使用最为广泛和最为流行的监控方案,它有一个守护程序用来收集不同进程和远程主机的信息,这些收集到的信息都通过功能强大的web界面进行呈现。

你可以在文章“如何安装nagios”里面找到更多的信息。

21. Linux process explorer - Linux下的procexp

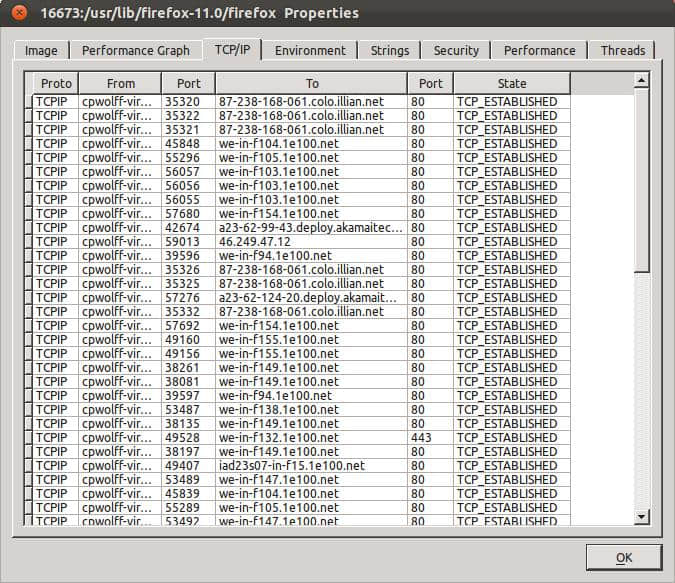
Linux process explorer是一个Linux下的图形化进程浏览工具。它能够显示不同的进程信息,如进程数,TCP/IP连接和每一个进程的性能指标。作为Windows下procexp在Linux的替代品,是由Sysinternals开发的,其目标是比top和ps提供更好用户体验。

查看 linux process explorer 的文章获取更多信息。

22. Collectl - 性能监控工具

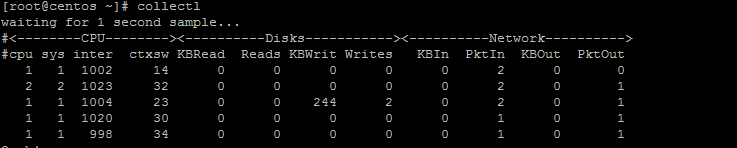
你可以既可以通过交互的方式使用这个性能监控工具,也可以用它把报表写到磁盘上,并通过web服务器来访问。它以一种易读易管理的格式,显示了CPU,磁盘,内存,网络,网络文件系统,进程,slabs等统计信息。

更多信息请参看Collectl的文章。

23. MRTG - 经典网络流量监控图形工具

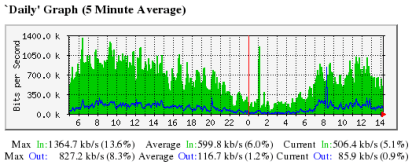
这是一个采用rrdtool的生成图形的流量监控工具。作为最早的提供图形化界面的流量监控工具,它被广泛应用在类Unix的操作系统中。查看我们关于如何使用MRTG的文章获取更多关于安装和配置的信息。

24. Monit - 简单易用的监控工具

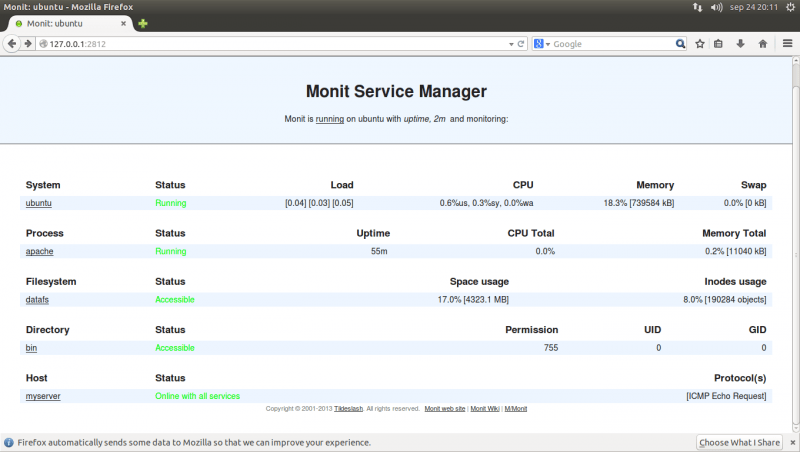
Monit是一个用来监控进程,系统加载,文件系统和目录文件等的开源的Linux工具。你能够让它自动化维护和修复,也能够在运行错误的情景下执行特定动作或者发邮件报告提醒系统管理员。

如果你想要用这个工具,你可以查看如何使用Monit的文章。

25. Munin - 为服务器提供监控和提醒服务

作为一个网络资源监控工具,Munin能够帮助分析资源趋势和查看薄弱环节以及导致产生性能问题的原因。开发此软件的团队希望它能够易用和用户体验友好。该软件是用Perl开发的,并采用rrdtool来绘制图形,使用了web界面进行呈现。开发人员推广此应用时声称当前已有500多个监控插件可以“即插即用”。

更多信息可以在关于Munin的文章中找到。


via: http://linoxide.com/monitoring-2/linux-performance-monitoring-tools/

作者:Adrian Dinu 译者:andyxue 校对:wxy

本文由 LCTT 原创翻译,Linux中国 荣誉推出

$1, Raid和Cache Memory

通常,出於二個目標:安全和性能,我們在生產環境的服務器上會設置Raid功能。最常見的場景是,我們會由於安全性的考慮將磁盤設置成Raid 1 或Raid 5、Raid6等模式保障在一塊或多塊硬盤故障時數據不丟失。或者是由於Dis IO性能上的考慮將硬盤設置成Raid 0或Raid 10來擴展有限的IO。

無論DELL/HP/IBM等服務器廠商,都會OEM一些Raid控制器在實現Raid功能,而為了保障和提升讀寫性能,Raid控制卡裏都會內置128MB 至 1GB不等的Cache Memory,而我們對磁盤的讀和寫操作都會通過事先在Cache Memory中Hit或緩存,這樣一來就可以大大提高了實際IO性能。

OS也認為只要讀或寫到Cache Memory以後即算操作成功,而Cache Memory中的數據如何Flush到物理磁盤中的Policy控制則由Raid控制器來解決。這種通過寫入Cache Memory的Policy我們稱為WriteBack,而如果不通過Cache Memory直接寫入磁盤的Policy我們稱為WriteThrough。

任何一條數據寫入Memory和寫入磁盤的性能差別之巨大,不用比較都可想像得到是天壤之別。特別是當我們遇到MySQL等數據庫或其他IO要求壓力非常大的環境,這是我們實際生產環境中不得不要考慮的因素。

$2, BBU,TBBU在實際應用中的問題和運維

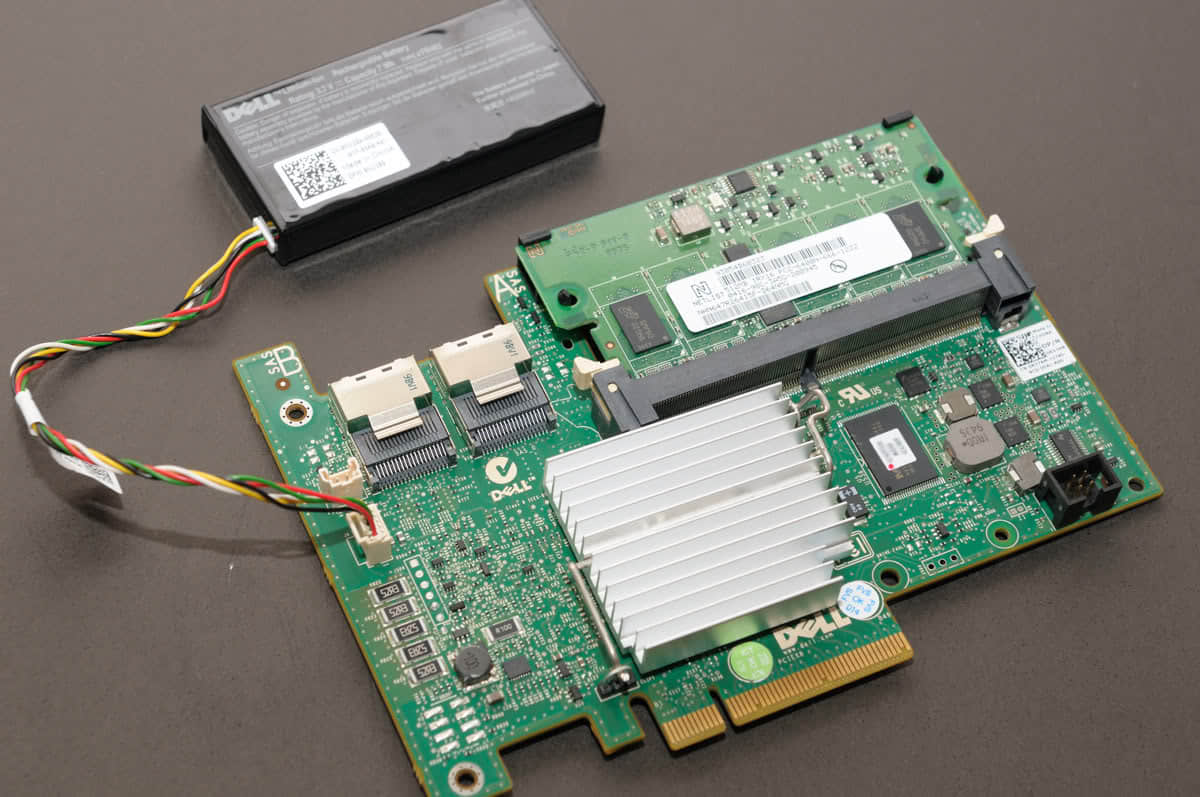
什麼是BBU/TBBU呢?其實BBU就是Raid卡中的一個電池備用模塊,因為之前我們說到在Raid的環境下很多情況下數據都是通過Cache Memory和磁盤交換的,而Memory本身並無法保障數據持久性,萬一電源中斷,而數據沒來得及flush到物理磁盤上,就會造成數據丟失的悲劇。為此硬件廠商提供了BBU和TBBU,其中包含了一塊鋰電池來保障萬一電源中斷的情況下,Cache Memory中的數據不至於丟失,直至電源恢復。TBBU的不同區別是Cache Memory和電池是做成一個模塊,以防止Raid控制器如果硬件故障的時候,在更換Raid控制卡過程中可以不更換TBBU及其中的Cache Memory,防止這一過程中的數據不丟失。

就是這麼樣的一個模塊,如圖:

正是由於使用電池做為持續Memory是數據的可靠性,而存在一個尷尬的隱患。以目前的技術水平,電池是不可以長期不充放電的,否則會造成電池損壞而無法起到保護數據的特性。所以Raid卡廠商在設計BBU/TBBU中加入了一個自動充放電的維護過程,每過一段時間(通常是數個月左右)會自動對電池放電,然後再自動充電,以保證電池的可用性。

而在電池放電的時候,出於數據安全性的考慮,Cache Policy默認從WriteBack改成WriteThrough。這段時間會持續數小時或更久,IO性能會因此大幅下降,如果正好這個時間你有數據庫或其他大量IO壓力的服務,性能會急劇下降,如果系統沒有足夠的Capacity的話,嚴重的話會導致服務可用性的賁潰。

為了防止出現這種情況,通常業內大家會使用各種想法:

a) 給系統留出足夠的Capacity,即使WriteThrough的時候也可以保障服務的性能是可接受的

b) 自動或半自動的地設定在系統負載最低的時候提前去觸發電池的充放電過程

c) 將Cache Policy設置為CachedBadBBU,也就是即使在充放電過程中,還是使用寫入Cache的WriteBack,而不是默認的WriteThrough,這存在的風險是這一過程中的服務器電源中斷會造成數據丟失,這不是一個最安全的選擇,但如果業務上可以接受這個風險,如果Data Center的供電足夠安全,如果服務器有冗餘的電源的話,未必不是一個好的選擇。

d) 當A服務器發生這一情況時能自動或半自動地切換到Backup的節點上,必竟二臺服務器同時發生這一自動維護過程是不太可能的,但同一批次的服務器是有可能的,並且這可以從時間和過程中去人工調節。

e) 從軟件、業務程序上來保障對數據持久性或一致性的取捨。

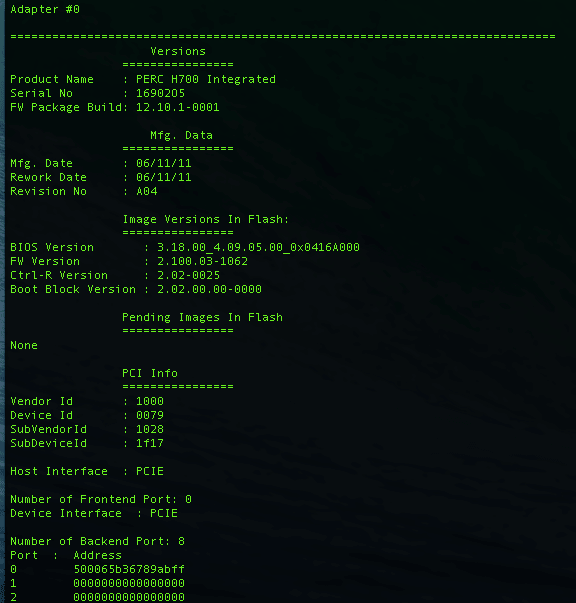
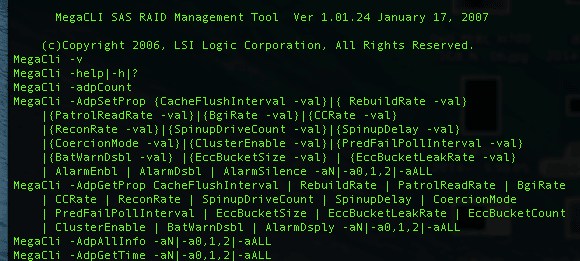
目前國內大家常用的DELL和HP服務器多數都已經集成了LSI公司的Raid控制器,以上的這些狀態和Policy的調整在Linux中都可以通過其MegaCLI工具包操作:

$3, ZMCP,CacheCade技術的原理和應用

單從硬件運維角度來看,BBU和TBBU帶來的Cache Policy問題如果在幾百臺或上千臺服務器環境下維護將會是一個非常繁瑣的過程,除非從軟件上來對安全性和數據一致性的取捨。

所以新的一代的Raid控制器出現了另一種選擇。其中Adaptec公司提供了ZMCP模塊,而LSI公司提供了CacheCade的軟件支持。

ZMCP就是Zero-Maintenance Cache Protection的意思,在支持ZMCP的Raid控制器上加裝一個ZMCP模塊將不再依賴電池對Cache Memory的保護,而是通過SLC的Flash NAND和電容來保證在電力中斷時數據的可靠性:

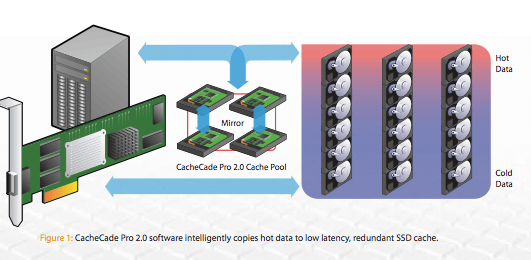
而LSI的CacheCade是一個軟件的License,可以支持通過SSD來持久化Cache Memory,而不是通過不能持久化的Memory。優點是可以讓Cache Memory更大,並缺點也顯而易見。

從性能上的測試來看明顯ZMCP會占有優勢,但同時也是成本上的劣勢。而且無論是哪種新的技術都暫時性地會帶來相對BBU/TBBU技術的成本增加,出於成本上的考慮,所以目前大部分DELL/HP服務器依舊會OEM原有的方案。

但是從更專業的業務環境下去定制的服務器上,在軟件、性能、硬件等方面做更合適自己的取舎將是給每個人更自由的選擇範圍。在此希望我在實踐和看到的information希望能給到大家有益的幫助。

$4, 引用和參考資料

现在我们做的是Intel Haswell的虚拟化基准测试。我们在Intel酷睿i7 4770K的“Haswell”处理器上使用搭载了最新软件组件的Fedora 19,来进行KVM,Xen和VirtualBox的基准测试。

自从上个月推出Haswell以来,我们已经发布了许多和这款全新的英特尔处理器相关的基准测试,但我们直到这篇文章发布前,一直没有涵盖虚拟化方面的性能测试。这里,启用了英特尔硬件虚拟化后,将在一个纯净的Fedora 19 的64位操作系统上,分别安装KVM,Xen和Virtualbox,并进行比较。

目前Fedora 19拥有搭载GCC 4.8.1的Linux 3.9.8版本内核,Mesa 9.2.0开发库和一个EXT4文件系统。所有的虚拟化组件都从Fedora 19的仓库中获取的,包括QEMU 1.4.2,Xen 4.2.2和libvirt/virt-manager组件。Xen和KVM的虚拟化通过virt-manager来建立。VirtualBox 4.2.16则是通过VirtualBox.org获取并安装在Fedora 19中。

这个英特尔酷睿i7 4770K机器拥有16GB的内存和240GB的OCZ Vertex 3 固态硬盘。在测试中,每一个虚拟机能够使用全部八个逻辑核心(四个物理核心加上超线程)、16GB内存中的12GB以及16GB的虚拟磁盘。

在采用英特尔酷睿i7 “Haswell”处理器的Linux 3.9版本内核的Fedora 19上安装的KVM,Xen和VirtualBox的性能也和在没有任何形式的虚拟化或其它抽象层上运行基准测试的“裸机(Bare Metal)”的性能进行了对比。VMWare的产品没有在这篇文章里被测试,因为它们的EULA特性限制了这种公开基准测试(尽管VMware在过去可以让我们正常地做这样的基准测试),并且它们的试用软件只能限制运行在四核CPU上。但以后的另外一篇文章会比较下在其它硬件上XEN/KVM/VMware的性能。

全部的Linux虚拟化基准测试采用完全自动化和可重复的方式进行处理,使用开源软件Phoronix Test Suite并由OpenBenchmarking.org支持。在使用虚拟磁盘而且Xen/KVM都没有一个可靠的访问主机驱动或GPU的方法以使用3D功能的情况下,这篇文章里的大部分基准测试都是集中在不同Linux虚拟化方法计算性能开销上。

磁盘测试在这里并不是虚拟化测试的一个重点,因为只有一个虚拟磁盘被主机的文件系统使用。然而,当把这三种Linux虚拟化方法与裸机结果进行比较时,运行在Linux 3.9内核上的KVM性能最好,其次是Xen。Oracle的Virtual仅仅跑出了主机上PostMark邮件服务器性能的66%,而KVM跑出了性能的96%,Xen是83%。

对于Dolfyn计算流体动力学的工作量,当运行在KVM或Xen上时,和裸机的运行结果相比并没有任何重大的变化。然而,VirtualBox则是明显变慢了。

FFTE和HMMer的结果和Dolfyn类似:Xen和KVM用很小的开销获得很好的性能,但Oracle的VirtualBox则慢得多。

当John The Ripper这个破解密码的程序在VirtualBox中运行时,则直接崩溃了。

运行TTSIOD渲染器时,在Linux 3.9 内核的Fedora 19上运行的Xen虚拟化方法获得了它的第一次性能比拼的胜利。

总之,运行在搭载英特尔酷睿i7 4770K处理器Fedora 19上的Xen和KVM虚拟化技术工作良好。这些虚拟化方法在Haswell处理器上的性能开销是最小的。当Xen和KVM在这款全新的英特尔处理器上运行良好的时候,Oracle的VirtualBox(最新版本,v4.2.16)相对慢得多。虽然VirtualBox的一个优点是支持客户机3D加速,但这会在未来的一篇Phoronix文章中再次进行测试。而把Haswell和前几代的英特尔处理器和AMD处理器比较不同虚拟化方法的性能开销也会在不久之后在Phoronix上进行测试。


via: http://www.phoronix.com/scan.php?page=article&item=intel_haswell_virtualization

译者:KayGuoWhu 校对:wxy

本文由 LCTT 原创翻译,Linux中国 荣誉推出