分类 软件开发 下的文章

Grafana Tempo 是一个新的开源、大容量分布式跟踪后端。

 title=

Grafana 的 Tempo 是出自 Grafana 实验室的一个简单易用、大规模的、分布式的跟踪后端。Tempo 集成了 Grafana、Prometheus 以及 Loki,并且它只需要对象存储进行操作,因此成本低廉,操作简单。

我从一开始就参与了这个开源项目,所以我将介绍一些关于 Tempo 的基础知识,并说明为什么云原生社区会注意到它。

分布式跟踪

想要收集对应用程序请求的遥测数据是很常见的。但是在现在的服务器中,单个应用通常被分割为多个微服务,可能运行在几个不同的节点上。

分布式跟踪是一种获得关于应用的性能细粒度信息的方式,该应用程序可能由离散的服务组成。当请求到达一个应用时,它提供了该请求的生命周期的统一视图。Tempo 的分布式跟踪可以用于单体应用或微服务应用,它提供 请求范围的信息,使其成为可观察性的第三个支柱(另外两个是度量和日志)。

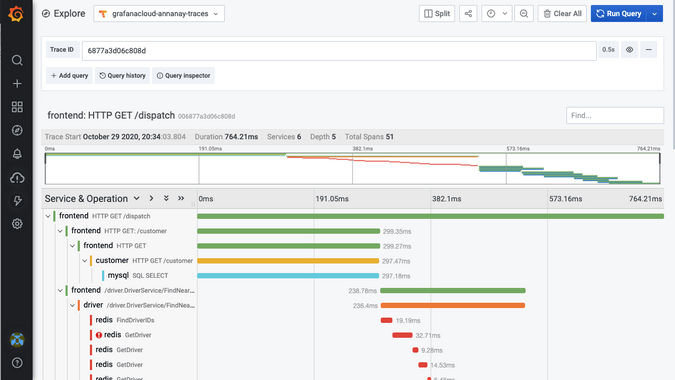
接下来是一个分布式跟踪系统生成应用程序甘特图的示例。它使用 Jaeger HotROD 的演示应用生成跟踪,并把它们存到 Grafana 云托管的 Tempo 上。这个图展示了按照服务和功能划分的请求处理时间。

 title=

减少索引的大小

在丰富且定义良好的数据模型中,跟踪包含大量信息。通常,跟踪后端有两种交互:使用元数据选择器(如服务名或者持续时间)筛选跟踪,以及筛选后的可视化跟踪。

为了加强搜索,大多数的开源分布式跟踪框架会对跟踪中的许多字段进行索引,包括服务名称、操作名称、标记和持续时间。这会导致索引很大,并迫使你使用 Elasticsearch 或者 Cassandra 这样的数据库。但是,这些很难管理,而且大规模运营成本很高,所以我在 Grafana 实验室的团队开始提出一个更好的解决方案。

在 Grafana 中,我们的待命调试工作流从使用指标报表开始(我们使用 Cortex 来存储我们应用中的指标,它是一个云原生基金会孵化的项目,用于扩展 Prometheus),深入研究这个问题,筛选有问题服务的日志(我们将日志存储在 Loki 中,它就像 Prometheus 一样,只不过 Loki 是存日志的),然后查看跟踪给定的请求。我们意识到,我们过滤时所需的所有索引信息都可以在 Cortex 和 Loki 中找到。但是,我们需要一个强大的集成,以通过这些工具实现跟踪的可发现性,并需要一个很赞的存储,以根据跟踪 ID 进行键值查找。

这就是 Grafana Tempo 项目的开始。通过专注于给定检索跟踪 ID 的跟踪,我们将 Tempo 设计为最小依赖性、大容量、低成本的分布式跟踪后端。

操作简单,性价比高

Tempo 使用对象存储后端,这是它唯一的依赖。它既可以被用于单一的二进制下,也可以用于微服务模式(请参考仓库中的 例子,了解如何轻松上手)。使用对象存储还意味着你可以存储大量的应用程序的痕迹,而无需任何采样。这可以确保你永远不会丢弃那百万分之一的出错或具有较高延迟的请求的跟踪。

与开源工具的强大集成

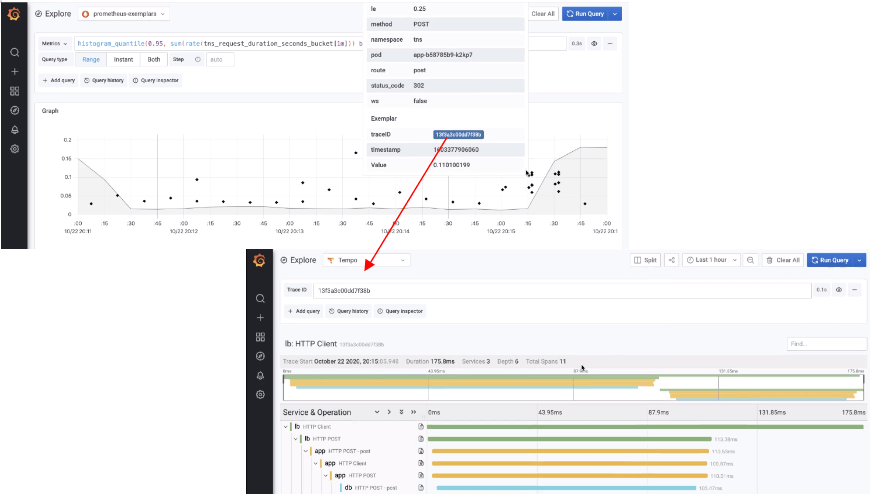
Grafana 7.3 包括了 Tempo 数据源,这意味着你可以在 Grafana UI 中可视化来自Tempo 的跟踪。而且,Loki 2.0 的新查询特性 使得 Tempo 中的跟踪更简单。为了与 Prometheus 集成,该团队正在添加对 范例 exemplar 的支持,范例是可以添加到时间序列数据中的高基数元数据信息。度量存储后端不会对它们建立索引,但是你可以在 Grafana UI 中检索和显示度量值。尽管范例可以存储各种元数据,但是在这个用例中,存储跟踪 ID 是为了与 Tempo 紧密集成。

这个例子展示了使用带有请求延迟直方图的范例,其中每个范例数据点都链接到 Tempo 中的一个跟踪。

 title=

元数据一致性

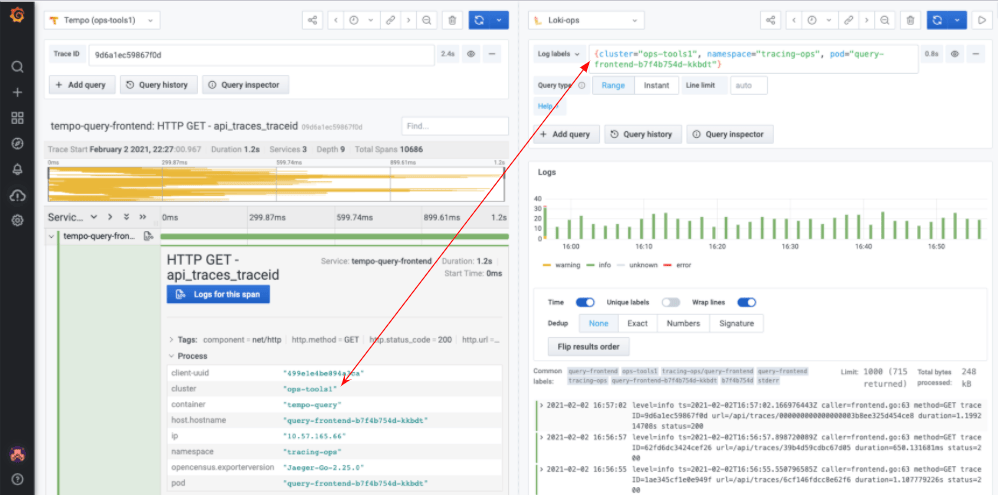
作为容器化应用程序运行的应用发出的遥测数据通常具有一些相关的元数据。这可以包括集群 ID、命名空间、吊舱 IP 等。这对于提供基于需求的信息是好的,但如果你能将元数据中包含的信息用于生产性的东西,那就更好了。 例如,你可以使用 Grafana 云代理将跟踪信息导入 Tempo 中,代理利用 Prometheus 服务发现机制轮询 Kubernetes API 以获取元数据信息,并且将这些标记添加到应用程序发出的跨域数据中。由于这些元数据也在 Loki 中也建立了索引,所以通过元数据转换为 Loki 标签选择器,可以很容易地从跟踪跳转到查看给定服务的日志。

下面是一个一致元数据的示例,它可用于Tempo跟踪中查看给定范围的日志。

云原生

Grafana Tempo 可以作为容器化应用,你可以在如 Kubernetes、Mesos 等编排引擎上运行它。根据获取/查询路径上的工作负载,各种服务可以水平伸缩。你还可以使用云原生的对象存储,如谷歌云存储、Amazon S3 或者 Tempo Azure 博客存储。更多的信息,请阅读 Tempo 文档中的 架构部分。

试一试 Tempo

如果这对你和我们一样有用,可以 克隆 Tempo 仓库试一试。


via: https://opensource.com/article/21/2/tempo-distributed-tracing

作者:Annanay Agarwal 选题:lujun9972 译者:RiaXu 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

在 Jupyter 里使用 Python 来分析日历,以了解你是如何使用时间的。
 title=

Python 在探索数据方面具有令人难以置信的可扩展性。利用 Pandas 或 Dask,你可以将 Jupyter 扩展到大数据领域。但是小数据、个人资料、私人数据呢?

JupyterLab 和 Jupyter Notebook 为我提供了一个绝佳的环境,可以让我审视我的笔记本电脑生活。

我的探索是基于以下事实:我使用的几乎每个服务都有一个 Web API。我使用了诸多此类服务:待办事项列表、时间跟踪器、习惯跟踪器等。还有一个几乎每个人都会使用到:日历。相同的思路也可以应用于其他服务,但是日历具有一个很酷的功能:几乎所有 Web 日历都支持的开放标准 —— CalDAV。

在 Jupyter 中使用 Python 解析日历

大多数日历提供了导出为 CalDAV 格式的方法。你可能需要某种身份验证才能访问这些私有数据。按照你的服务说明进行操作即可。如何获得凭据取决于你的服务,但是最终,你应该能够将这些凭据存储在文件中。我将我的凭据存储在根目录下的一个名为 .caldav 的文件中:

import os
with open(os.path.expanduser("~/.caldav")) as fpin:
    username, password = fpin.read().split()

切勿将用户名和密码直接放在 Jupyter Notebook 的笔记本中!它们可能会很容易因 git push 的错误而导致泄漏。

下一步是使用方便的 PyPI caldav 库。我找到了我的电子邮件服务的 CalDAV 服务器(你可能有所不同):

import caldav
client = caldav.DAVClient(url="https://caldav.fastmail.com/dav/", username=username, password=password)

CalDAV 有一个称为 principal(主键)的概念。它是什么并不重要,只要知道它是你用来访问日历的东西就行了:

principal = client.principal()
calendars = principal.calendars()

从字面上讲,日历就是关于时间的。访问事件之前,你需要确定一个时间范围。默认一星期就好:

from dateutil import tz
import datetime
now = datetime.datetime.now(tz.tzutc())
since = now - datetime.timedelta(days=7)

大多数人使用的日历不止一个,并且希望所有事件都在一起出现。itertools.chain.from_iterable 方法使这一过程变得简单:

import itertools

raw_events = list(
    itertools.chain.from_iterable(
        calendar.date_search(start=since, end=now, expand=True)
        for calendar in calendars
    )
)

将所有事件读入内存很重要,以 API 原始的本地格式进行操作是重要的实践。这意味着在调整解析、分析和显示代码时,无需返回到 API 服务刷新数据。

但 “原始” 真的是原始,事件是以特定格式的字符串出现的:

print(raw_events[12].data)
    BEGIN:VCALENDAR
    VERSION:2.0
    PRODID:-//CyrusIMAP.org/Cyrus
     3.3.0-232-g4bdb081-fm-20200825.002-g4bdb081a//EN
    BEGIN:VEVENT
    DTEND:20200825T230000Z
    DTSTAMP:20200825T181915Z
    DTSTART:20200825T220000Z
    SUMMARY:Busy
    UID:
     1302728i-040000008200E00074C5B7101A82E00800000000D939773EA578D601000000000
     000000010000000CD71CC3393651B419E9458134FE840F5
    END:VEVENT
    END:VCALENDAR

幸运的是,PyPI 可以再次使用另一个辅助库 vobject 解围:

import io
import vobject

def parse_event(raw_event):
    data = raw_event.data
    parsed = vobject.readOne(io.StringIO(data))
    contents = parsed.vevent.contents
    return contents
parse_event(raw_events[12])
    {'dtend': [<DTEND{}2020-08-25 23:00:00+00:00>],
     'dtstamp': [<DTSTAMP{}2020-08-25 18:19:15+00:00>],
     'dtstart': [<DTSTART{}2020-08-25 22:00:00+00:00>],
     'summary': [<SUMMARY{}Busy>],
     'uid': [<UID{}1302728i-040000008200E00074C5B7101A82E00800000000D939773EA578D601000000000000000010000000CD71CC3393651B419E9458134FE840F5>]}

好吧,至少好一点了。

仍有一些工作要做,将其转换为合理的 Python 对象。第一步是 拥有 一个合理的 Python 对象。attrs 库提供了一个不错的开始:

import attr
from __future__ import annotations
@attr.s(auto_attribs=True, frozen=True)
class Event:
    start: datetime.datetime
    end: datetime.datetime
    timezone: Any
    summary: str

是时候编写转换代码了!

第一个抽象从解析后的字典中获取值,不需要所有的装饰:

def get_piece(contents, name):
    return contents[name][0].value
get_piece(_, "dtstart")
    datetime.datetime(2020, 8, 25, 22, 0, tzinfo=tzutc())

日历事件总有一个“开始”、有一个“结束”、有一个 “持续时间”。一些谨慎的解析逻辑可以将两者协调为同一个 Python 对象:

def from_calendar_event_and_timezone(event, timezone):
    contents = parse_event(event)
    start = get_piece(contents, "dtstart")
    summary = get_piece(contents, "summary")
    try:
        end = get_piece(contents, "dtend")
    except KeyError:
        end = start + get_piece(contents, "duration")
    return Event(start=start, end=end, summary=summary, timezone=timezone)

将事件放在 本地 时区而不是 UTC 中很有用,因此使用本地时区:

my_timezone = tz.gettz()
from_calendar_event_and_timezone(raw_events[12], my_timezone)
    Event(start=datetime.datetime(2020, 8, 25, 22, 0, tzinfo=tzutc()), end=datetime.datetime(2020, 8, 25, 23, 0, tzinfo=tzutc()), timezone=tzfile('/etc/localtime'), summary='Busy')

既然事件是真实的 Python 对象,那么它们实际上应该具有附加信息。幸运的是,可以将方法添加到类中。

但是要弄清楚哪个事件发生在哪一天不是很直接。你需要在 本地 时区中选择一天:

def day(self):
    offset = self.timezone.utcoffset(self.start)
    fixed = self.start + offset
    return fixed.date()
Event.day = property(day)
print(_.day)
    2020-08-25

事件在内部始终是以“开始”/“结束”的方式表示的,但是持续时间是有用的属性。持续时间也可以添加到现有类中:

def duration(self):
    return self.end - self.start
Event.duration = property(duration)
print(_.duration)
    1:00:00

现在到了将所有事件转换为有用的 Python 对象了:

all_events = [from_calendar_event_and_timezone(raw_event, my_timezone)
              for raw_event in raw_events]

全天事件是一种特例,可能对分析生活没有多大用处。现在,你可以忽略它们:

# ignore all-day events
all_events = [event for event in all_events if not type(event.start) == datetime.date]

事件具有自然顺序 —— 知道哪个事件最先发生可能有助于分析:

all_events.sort(key=lambda ev: ev.start)

现在,事件已排序,可以将它们加载到每天:

import collections
events_by_day = collections.defaultdict(list)
for event in all_events:
    events_by_day[event.day].append(event)

有了这些,你就有了作为 Python 对象的带有日期、持续时间和序列的日历事件。

用 Python 报到你的生活

现在是时候编写报告代码了!带有适当的标题、列表、重要内容以粗体显示等等,有醒目的格式是很意义。

这就是一些 HTML 和 HTML 模板。我喜欢使用 Chameleon:

template_content = """
<html><body>
<div tal:repeat="item items">
<h2 tal:content="item[0]">Day</h2>
<ul>
    <li tal:repeat="event item[1]"><span tal:replace="event">Thing</span></li>
</ul>
</div>
</body></html>"""

Chameleon 的一个很酷的功能是使用它的 html 方法渲染对象。我将以两种方式使用它:

  • 摘要将以粗体显示
  • 对于大多数活动,我都会删除摘要(因为这是我的个人信息)
def __html__(self):
    offset = my_timezone.utcoffset(self.start)
    fixed = self.start + offset
    start_str = str(fixed).split("+")[0]
    summary = self.summary
    if summary != "Busy":
        summary = "&lt;REDACTED&gt;"
    return f"<b>{summary[:30]}</b> -- {start_str} ({self.duration})"
Event.__html__ = __html__

为了简洁起见,将该报告切成每天的:

import chameleon
from IPython.display import HTML
template = chameleon.PageTemplate(template_content)
html = template(items=itertools.islice(events_by_day.items(), 3, 4))
HTML(html)

渲染后,它将看起来像这样:

2020-08-25

  • -- 2020-08-25 08:30:00 (0:45:00)
  • -- 2020-08-25 10:00:00 (1:00:00)
  • -- 2020-08-25 11:30:00 (0:30:00)
  • -- 2020-08-25 13:00:00 (0:25:00)
  • Busy -- 2020-08-25 15:00:00 (1:00:00)
  • -- 2020-08-25 15:00:00 (1:00:00)
  • -- 2020-08-25 19:00:00 (1:00:00)
  • -- 2020-08-25 19:00:12 (1:00:00)

Python 和 Jupyter 的无穷选择

通过解析、分析和报告各种 Web 服务所拥有的数据,这只是你可以做的事情的表面。

为什么不对你最喜欢的服务试试呢?


via: https://opensource.com/article/20/9/calendar-jupyter

作者:Moshe Zadka 选题:lujun9972 译者:stevenzdg988 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出
在众多可用于简化 Node.js 开发的工具中,以下 9 种是最佳选择。

 title=

我最近在 StackOverflow 上读到了一项调查,该调查称超过 49% 的开发人员在其项目中使用了 Node.js。这结果对我来说并不意外。

作为一个狂热的技术使用者,我可以肯定地说 Node.js 的引入引领了软件开发的新时代。现在,它是软件开发最受欢迎的技术之一,仅次于JavaScript。

Node.js 是什么,为什么如此受欢迎?

Node.js 是一个跨平台的开源运行环境,用于在浏览器之外执行 JavaScript 代码。它也是建立在 Chrome 的 JavaScript 运行时之上的首选运行时环境,主要用于构建快速、可扩展和高效的网络应用程序。

我记得当时我们要花费几个小时来协调前端和后端开发人员,他们分别编写不同脚本。当 Node.js 出现后,所有这些都改变了。我相信,促使开发人员采用这项技术是因为它的双向效率。

使用 Node.js,你可以让你的代码同时运行在客户端和服务器端,从而加快了整个开发过程。Node.js 弥合了前端和后端开发之间的差距,并使开发过程更加高效。

Node.js 工具浪潮

对于 49% 的开发人员(包括我)来说,Node.js 处于在前端和后端开发的金字塔顶端。有大量的 Node.js 用例 帮助我和我的团队在截止日期之内交付复杂的项目。幸运的是,Node.js 的日益普及也产生了一系列开源项目和工具,以帮助开发人员使用该环境。

近来,对使用 Node.js 构建的项目的需求突然增加。有时,我发现管理这些项目,并同时保持交付高质量项目的步伐非常具有挑战性。因此,我决定使用为 Node.js 开发人员提供的许多开源工具中一些最高效的,使某些方面的开发自动化。

根据我在 Node.js 方面的丰富经验,我使用了许多的工具,这些工具对整个开发过程都非常有帮助:从简化编码过程,到监测再到内容管理。

为了帮助我的 Node.js 开发同道,我整理了这个列表,其中包括我最喜欢的 9 个简化 Node.js 开发的开源工具。

Webpack

Webpack 是一个容易使用的 JavaScript 模块捆绑程序 module bundler ,用于简化前端开发。它会检测具有依赖的模块,并将其转换为描述模块的静态 素材 asset 。

可以通过软件包管理器 npm 或 Yarn 安装该工具。

利用 npm 命令安装如下:

npm install --save-dev webpack

利用 Yarn 命令安装如下:

yarn add webpack --dev

Webpack 可以创建在运行时异步加载的单个捆绑包或多个素材链。不必单独加载。使用 Webpack 工具可以快速高效地打包这些素材并提供服务,从而改善用户整体体验,并减少开发人员在管理加载时间方面的困难。

Strapi

Strapi 是一个开源的 无界面 headless 内容管理系统(CMS)。无界面 CMS 是一种基础软件,可以管理内容而无需预先构建好的前端。它是一个使用 RESTful API 函数的只有后端的系统。

可以通过软件包管理器 Yarn 或 npx 安装 Strapi。

利用 Yarn 命令安装如下:

yarn create strapi-app my-project --quickstart

利用 npx 命令安装如下:

npx create-strapi-app my-project --quickstart

Strapi 的目标是在任何设备上以结构化的方式获取和交付内容。CMS 可以使你轻松管理应用程序的内容,并确保它们是动态的,可以在任何设备上访问。

它提供了许多功能,包括文件上传、内置的电子邮件系统、JSON Web Token(JWT)验证和自动生成文档。我发现它非常方便,因为它简化了整个 CMS,并为我提供了编辑、创建或删除所有类型内容的完全自主权。

另外,通过 Strapi 构建的内容结构非常灵活,因为你可以创建和重用内容组和可定制的 API。

Broccoli

Broccoli 是一个功能强大的构建工具,运行在 ES6 模块上。构建工具是一种软件,可让你将应用程序或网站中的所有各种素材(例如图像、CSS、JavaScript 等)组合成一种可分发的格式。Broccoli 将自己称为 “雄心勃勃的应用程序的素材管道”。

使用 Broccoli 你需要一个项目目录。有了项目目录后,可以使用以下命令通过 npm 安装 Broccoli:

npm install --save-dev broccoli
npm install --global broccoli-cli

你也可以使用 Yarn 进行安装。

当前版本的 Node.js 就是使用该工具的最佳版本,因为它提供了长期支持。它可以帮助你避免进行更新和重新安装过程中的麻烦。安装过程完成后,可以在 Brocfile.js 文件中包含构建规范。

在 Broccoli 中,抽象单位是“树”,该树将文件和子目录存储在特定子目录中。因此,在构建之前,你必须有一个具体的想法,你希望你的构建是什么样子的。

最好的是,Broccoli 带有用于开发的内置服务器,可让你将素材托管在本地 HTTP 服务器上。Broccoli 非常适合流线型重建,因为其简洁的架构和灵活的生态系统可提高重建和编译速度。Broccoli 可让你井井有条,以节省时间并在开发过程中最大限度地提高生产力。

Danger

Danger 是一个非常方便的开源工具,用于简化你的 拉取请求 pull request (PR)检查。正如 Danger 库描述所说,该工具可通过管理 PR 检查来帮助 “正规化” 你的代码审查系统。Danger 可以与你的 CI 集成在一起,帮助你加快审核过程。

将 Danger 与你的项目集成是一个简单的逐步过程:你只需要包括 Danger 模块,并为每个项目创建一个 Danger 文件。然而,创建一个 Danger 帐户(通过 GitHub 或 Bitbucket 很容易做到),并且为开源软件项目设置访问令牌更加方便。

可以通过 NPM 或 Yarn 安装 Danger。要使用 Yarn,请添加 danger -D 到 package.JSON 中。

将 Danger 添加到 CI 后,你可以:

  • 高亮显示重要的创建工件
  • 通过强制链接到 Trello 和 Jira 之类的工具来管理 sprint
  • 强制生成更新日志
  • 使用描述性标签
  • 以及更多

例如,你可以设计一个定义团队文化并为代码审查和 PR 检查设定特定规则的系统。根据 Danger 提供的元数据及其广泛的插件生态系统,可以解决常见的 议题 issue 。

Snyk

网络安全是开发人员的主要关注点。Snyk 是修复开源组件中漏洞的最著名工具之一。它最初是一个用于修复 Node.js 项目漏洞的项目,并且已经演变为可以检测并修复 Ruby、Java、Python 和 Scala 应用程序中的漏洞。Snyk 主要分四个阶段运行:

  • 查找漏洞依赖性
  • 修复特定漏洞
  • 通过 PR 检查预防安全风险
  • 持续监控应用程序

Snyk 可以集成在项目的任何阶段,包括编码、CI/CD 和报告。我发现这对于测试 Node.js 项目非常有帮助,可以测试或构建 npm 软件包时检查是否存在安全风险。你还可以在 GitHub 中为你的应用程序运行 PR 检查,以使你的项目更安全。Synx 还提供了一系列集成,可用于监控依赖关系并解决特定问题。

要在本地计算机上运行 Snyk,可以通过 NPM 安装它:

npm install -g snyk

Migrat

Migrat 是一款使用纯文本的数据迁移工具,非常易于使用。 它可在各种软件堆栈和进程中工作,从而使其更加实用。你可以使用简单的代码行安装 Migrat:

$ npm install -g migrat

Migrat 并不需要特别的数据库引擎。它支持多节点环境,因为迁移可以在一个全局节点上运行,也可以在每个服务器上运行一次。Migrat 之所以方便,是因为它便于向每个迁移传递上下文。

你可以定义每个迁移的用途(例如,数据库集、连接、日志接口等)。此外,为了避免随意迁移,即多个服务器在全局范围内进行迁移,Migrat 可以在进程运行时进行全局锁定,从而使其只能在全局范围内运行一次。它还附带了一系列用于 SQL 数据库、Slack、HipChat 和 Datadog 仪表盘的插件。你可以将实时迁移状况发送到这些平台中的任何一个。

Clinic.js

Clinic.js 是一个用于 Node.js 项目的开源监视工具。它结合了三种不同的工具 Doctor、Bubbleprof 和 Flame,帮助你监控、检测和解决 Node.js 的性能问题。

你可以通过运行以下命令从 npm 安装 Clinic.js:

$ npm install clinic

你可以根据要监视项目的某个方面以及要生成的报告,选择要使用的 Clinic.js 包含的三个工具中的一个:

  • Doctor 通过注入探针来提供详细的指标,并就项目的总体运行状况提供建议。
  • Bubbleprof 非常适合分析,并使用 async_hooks 生成指标。
  • Flame 非常适合发现代码中的热路径和瓶颈。

PM2

监视是后端开发过程中最重要的方面之一。PM2 是一款 Node.js 的进程管理工具,可帮助开发人员监视项目的多个方面,例如日志、延迟和速度。该工具与 Linux、MacOS 和 Windows 兼容,并支持从 Node.js 8.X 开始的所有 Node.js 版本。

你可以使用以下命令通过 npm 安装 PM2:

$ npm install pm2 --g

如果尚未安装 Node.js,则可以使用以下命令安装:

wget -qO- https://getpm2.com/install.sh | bash

安装完成后,使用以下命令启动应用程序:

$ pm2 start app.js

关于 PM2 最好的地方是可以在集群模式下运行应用程序。可以同时为多个 CPU 内核生成一个进程。这样可以轻松增强应用程序性能并最大程度地提高可靠性。PM2 也非常适合更新工作,因为你可以使用 “热重载” 选项更新应用程序并以零停机时间重新加载应用程序。总体而言,它是为 Node.js 应用程序简化进程管理的好工具。

Electrode

Electrode 是 Walmart Labs 的一个开源应用程序平台。该平台可帮助你以结构化方式构建大规模通用的 React/Node.js 应用程序。

Electrode 应用程序生成器使你可以构建专注于代码的灵活内核,提供一些出色的模块以向应用程序添加复杂功能,并附带了广泛的工具来优化应用程序的 Node.js 包。

可以使用 npm 安装 Electrode。安装完成后,你可以使用 Ignite 启动应用程序,并深入研究 Electrode 应用程序生成器。

你可以使用 NPM 安装 Electrode:

npm install -g electrode-ignite xclap-cli

你最喜欢哪一个?

这些只是不断增长的开源工具列表中的一小部分,在使用 Node.js 时,这些工具可以在不同阶段派上用场。你最喜欢使用哪些开源 Node.js 工具?请在评论中分享你的建议。


via: https://opensource.com/article/20/1/open-source-tools-nodejs

作者:Hiren Dhadhuk 选题:lujun9972 译者:stevenzdg988 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出
使用 GNU 调试器来解决你的代码问题。

 title=

GNU 调试器常以它的命令 gdb 称呼它,它是一个交互式的控制台,可以帮助你浏览源代码、分析执行的内容,其本质上是对错误的应用程序中出现的问题进行逆向工程。

故障排除的麻烦在于它很复杂。GNU 调试器 并不是一个特别复杂的应用程序,但如果你不知道从哪里开始,甚至不知道何时和为何你可能需要求助于 GDB 来进行故障排除,那么它可能会让人不知所措。如果你一直使用 print、echo 或 printf 语句来调试你的代码,当你开始思考是不是还有更强大的东西时,那么本教程就是为你准备的。

有错误的代码

要开始使用 GDB,你需要一些代码。这里有一个用 C++ 写的示例应用程序(如果你一般不使用 C++ 编写程序也没关系,在所有语言中原理都是一样的),其来源于 猜谜游戏系列 中的一个例子。

#include <iostream>
#include <stdlib.h> //srand
#include <stdio.h>  //printf

using namespace std;

int main () {

srand (time(NULL));
int alpha = rand() % 8;
cout << "Hello world." << endl;
int beta = 2;

printf("alpha is set to is %s\n", alpha);
printf("kiwi is set to is %s\n", beta);

 return 0;
} // main

这个代码示例中有一个 bug,但它确实可以编译(至少在 GCC 5 的时候)。如果你熟悉 C++,你可能已经看到了,但这是一个简单的问题,可以帮助新的 GDB 用户了解调试过程。编译并运行它就可以看到错误:

$ g++ -o buggy example.cpp
$ ./buggy
Hello world.
Segmentation fault

排除段故障

从这个输出中,你可以推测变量 alpha 的设置是正确的,因为否则的话,你就不会看到它后面的那行代码执行。当然,这并不总是正确的,但这是一个很好的工作理论,如果你使用 printf 作为日志和调试器,基本上也会得出同样的结论。从这里,你可以假设 bug 在于成功打印的那一行之后的某行。然而,不清楚错误是在下一行还是在几行之后。

GNU 调试器是一个交互式的故障排除工具,所以你可以使用 gdb 命令来运行错误的代码。为了得到更好的结果,你应该从包含有调试符号的源代码中重新编译你的错误应用程序。首先,看看 GDB 在不重新编译的情况下能提供哪些信息:

$ gdb ./buggy
Reading symbols from ./buggy...done.
(gdb) start
Temporary breakpoint 1 at 0x400a44
Starting program: /home/seth/demo/buggy

Temporary breakpoint 1, 0x0000000000400a44 in main ()
(gdb)

当你以一个二进制可执行文件作为参数启动 GDB 时,GDB 会加载该应用程序,然后等待你的指令。因为这是你第一次在这个可执行文件上运行 GDB,所以尝试重复这个错误是有意义的,希望 GDB 能够提供进一步的见解。很直观,GDB 用来启动它所加载的应用程序的命令就是 start。默认情况下,GDB 内置了一个断点,所以当它遇到你的应用程序的 main 函数时,它会暂停执行。要让 GDB 继续执行,使用命令 continue:

(gdb) continue
Continuing.
Hello world.

Program received signal SIGSEGV, Segmentation fault.
0x00007ffff71c0c0b in vfprintf () from /lib64/libc.so.6
(gdb)

毫不意外:应用程序在打印 “Hello world” 后不久就崩溃了,但 GDB 可以提供崩溃发生时正在发生的函数调用。这有可能就足够你找到导致崩溃的 bug,但为了更好地了解 GDB 的功能和一般的调试过程,想象一下,如果问题还没有变得清晰,你想更深入地挖掘这段代码发生了什么。

用调试符号编译代码

要充分利用 GDB,你需要将调试符号编译到你的可执行文件中。你可以用 GCC 中的 -g 选项来生成这个符号:

$ g++ -g -o debuggy example.cpp
$ ./debuggy
Hello world.
Segmentation fault

将调试符号编译到可执行文件中的结果是得到一个大得多的文件,所以通常不会分发它们,以增加便利性。然而,如果你正在调试开源代码,那么用调试符号重新编译测试是有意义的:

$ ls -l *buggy* *cpp
-rw-r--r--    310 Feb 19 08:30 debug.cpp
-rwxr-xr-x  11624 Feb 19 10:27 buggy*
-rwxr-xr-x  22952 Feb 19 10:53 debuggy*

用 GDB 调试

加载新的可执行文件(本例中为 debuggy)以启动 GDB:

$ gdb ./debuggy
Reading symbols from ./debuggy...done.
(gdb) start
Temporary breakpoint 1 at 0x400a44
Starting program: /home/seth/demo/debuggy

Temporary breakpoint 1, 0x0000000000400a44 in main ()
(gdb)

如前所述,使用 start 命令进行:

(gdb) start
Temporary breakpoint 1 at 0x400a48: file debug.cpp, line 9.
Starting program: /home/sek/demo/debuggy

Temporary breakpoint 1, main () at debug.cpp:9
9       srand (time(NULL));
(gdb)

这一次,自动的 main 断点可以指明 GDB 暂停的行号和该行包含的代码。你可以用 continue 恢复正常操作,但你已经知道应用程序在完成之前就会崩溃,因此,你可以使用 next 关键字逐行步进检查你的代码:

(gdb) next
10  int alpha = rand() % 8;
(gdb) next
11  cout << "Hello world." << endl;
(gdb) next
Hello world.
12  int beta = 2;
(gdb) next
14      printf("alpha is set to is %s\n", alpha);
(gdb) next

Program received signal SIGSEGV, Segmentation fault.
0x00007ffff71c0c0b in vfprintf () from /lib64/libc.so.6
(gdb)

从这个过程可以确认,崩溃不是发生在设置 beta 变量的时候,而是执行 printf 行的时候。这个 bug 在本文中已经暴露了好几次(破坏者:向 printf 提供了错误的数据类型),但暂时假设解决方案仍然不明确,需要进一步调查。

设置断点

一旦你的代码被加载到 GDB 中,你就可以向 GDB 询问到目前为止代码所产生的数据。要尝试数据自省,通过再次发出 start 命令来重新启动你的应用程序,然后进行到第 11 行。一个快速到达 11 行的简单方法是设置一个寻找特定行号的断点:

(gdb) start
The program being debugged has been started already.
Start it from the beginning? (y or n) y
Temporary breakpoint 2 at 0x400a48: file debug.cpp, line 9.
Starting program: /home/sek/demo/debuggy

Temporary breakpoint 2, main () at debug.cpp:9
9       srand (time(NULL));
(gdb) break 11
Breakpoint 3 at 0x400a74: file debug.cpp, line 11.

建立断点后,用 continue 继续执行:

(gdb) continue
Continuing.

Breakpoint 3, main () at debug.cpp:11
11      cout << "Hello world." << endl;
(gdb)

现在暂停在第 11 行,就在 alpha 变量被设置之后,以及 beta 被设置之前。

用 GDB 进行变量自省

要查看一个变量的值,使用 print 命令。在这个示例代码中,alpha 的值是随机的,所以你的实际结果可能与我的不同:

(gdb) print alpha
$1 = 3
(gdb)

当然,你无法看到一个尚未建立的变量的值:

(gdb) print beta
$2 = 0

使用流程控制

要继续进行,你可以步进代码行来到达将 beta 设置为一个值的位置:

(gdb) next
Hello world.
12  int beta = 2;
(gdb) next
14  printf("alpha is set to is %s\n", alpha);
(gdb) print beta
$3 = 2

另外,你也可以设置一个观察点,它就像断点一样,是一种控制 GDB 执行代码流程的方法。在这种情况下,你知道 beta 变量应该设置为 2,所以你可以设置一个观察点,当 beta 的值发生变化时提醒你:

(gdb) watch beta > 0
Hardware watchpoint 5: beta > 0
(gdb) continue
Continuing.

Breakpoint 3, main () at debug.cpp:11
11      cout << "Hello world." << endl;
(gdb) continue
Continuing.
Hello world.

Hardware watchpoint 5: beta > 0

Old value = false
New value = true
main () at debug.cpp:14
14      printf("alpha is set to is %s\n", alpha);
(gdb)

你可以用 next 手动步进完成代码的执行,或者你可以用断点、观察点和捕捉点来控制代码的执行。

用 GDB 分析数据

你可以以不同格式查看数据。例如,以八进制值查看 beta 的值:

(gdb) print /o beta
$4 = 02

要查看其在内存中的地址:

(gdb) print /o &beta
$5 = 0x2

你也可以看到一个变量的数据类型:

(gdb) whatis beta
type = int

用 GDB 解决错误

这种自省不仅能让你更好地了解什么代码正在执行,还能让你了解它是如何执行的。在这个例子中,对变量运行的 whatis 命令给了你一个线索,即你的 alpha 和 beta 变量是整数,这可能会唤起你对 printf 语法的记忆,使你意识到在你的 printf 语句中,你必须使用 %d 来代替 %s。做了这个改变,就可以让应用程序按预期运行,没有更明显的错误存在。

当代码编译后发现有 bug 存在时,特别令人沮丧,但最棘手的 bug 就是这样,如果它们很容易被发现,那它们就不是 bug 了。使用 GDB 是猎取并消除它们的一种方法。

下载我们的速查表

生活的真相就是这样,即使是最基本的编程,代码也会有 bug。并不是所有的错误都会导致应用程序无法运行(甚至无法编译),也不是所有的错误都是由错误的代码引起的。有时,bug 是基于一个特别有创意的用户所做的意外的选择组合而间歇性发生的。有时,程序员从他们自己的代码中使用的库中继承了 bug。无论原因是什么,bug 基本上无处不在,程序员的工作就是发现并消除它们。

GNU 调试器是一个寻找 bug 的有用工具。你可以用它做的事情比我在本文中演示的要多得多。你可以通过 GNU Info 阅读器来了解它的许多功能:

$ info gdb

无论你是刚开始学习 GDB 还是专业人员的,提醒一下你有哪些命令是可用的,以及这些命令的语法是什么,都是很有帮助的。


via: https://opensource.com/article/21/3/debug-code-gdb

作者:Seth Kenlon 选题:lujun9972 译者:wxy 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出
Python & Poetry on Fedora

Python 开发人员经常创建一个新的虚拟环境来分离项目依赖,然后用 pip、pipenv 等工具来管理它们。Poetry 是一个简化 Python 中依赖管理和打包的工具。这篇文章将向你展示如何在 Fedora 上使用 Poetry 来管理你的 Python 项目。

与其他工具不同,Poetry 只使用一个配置文件来进行依赖管理、打包和发布。这消除了对不同文件的需求,如 Pipfile、MANIFEST.in、setup.py 等。这也比使用多个工具更快。

下面详细介绍一下开始使用 Poetry 时使用的命令。

在 Fedora 上安装 Poetry

如果你已经使用 Fedora 32 或以上版本,你可以使用这个命令直接从命令行安装 Poetry:

$ sudo dnf install poetry

编者注:在 Fedora Silverblue 或 CoreOs上,Python 3.9.2 是核心提交的一部分,你可以用下面的命令安装 Poetry:

rpm-ostree install poetry

初始化一个项目

使用 new 命令创建一个新项目:

$ poetry new poetry-project

用 Poetry 创建的项目结构是这样的:

├── poetry_project
│   └── init.py
├── pyproject.toml
├── README.rst
└── tests
    ├── init.py
    └── test_poetry_project.py

Poetry 使用 pyproject.toml 来管理项目的依赖。最初,这个文件看起来类似于这样:

[tool.poetry]
name = "poetry-project"
version = "0.1.0"
description = ""
authors = ["Kadermiyanyedi <[email protected]>"]

[tool.poetry.dependencies]
python = "^3.9"

[tool.poetry.dev-dependencies]
pytest = "^5.2"

[build-system]
requires = ["poetry>=0.12"]
build-backend = "poetry.masonry.api"

这个文件包含 4 个部分:

  • 第一部分包含描述项目的信息,如项目名称、项目版本等。
  • 第二部分包含项目的依赖。这些依赖是构建项目所必需的。
  • 第三部分包含开发依赖。
  • 第四部分描述的是符合 PEP 517 的构建系统。

如果你已经有一个项目,或者创建了自己的项目文件夹,并且你想使用 Poetry,请在你的项目中运行 init 命令。

$ poetry init

在这个命令之后,你会看到一个交互式的 shell 来配置你的项目。

创建一个虚拟环境

如果你想创建一个虚拟环境或激活一个现有的虚拟环境,请使用以下命令:

$ poetry shell

Poetry 默认在 /home/username/.cache/pypoetry 项目中创建虚拟环境。你可以通过编辑 Poetry 配置来更改默认路径。使用下面的命令查看配置列表:

$ poetry config --list

cache-dir = "/home/username/.cache/pypoetry"
virtualenvs.create = true
virtualenvs.in-project = true
virtualenvs.path = "{cache-dir}/virtualenvs"

修改 virtualenvs.in-project 配置变量,在项目目录下创建一个虚拟环境。Poetry 命令是:

$ poetry config virtualenv.in-project true

添加依赖

使用 poetry add 命令为项目安装一个依赖:

$ poetry add django

你可以使用带有 --dev 选项的 add 命令来识别任何只用于开发环境的依赖:

$ poetry add black --dev

add 命令会创建一个 poetry.lock 文件,用来跟踪软件包的版本。如果 poetry.lock 文件不存在,那么会安装 pyproject.toml 中所有依赖项的最新版本。如果 poetry.lock 存在,Poetry 会使用文件中列出的确切版本,以确保每个使用这个项目的人的软件包版本是一致的。

使用 poetry install 命令来安装当前项目中的所有依赖:

$ poetry install

通过使用 --no-dev 选项防止安装开发依赖:

$ poetry install --no-dev

列出软件包

show 命令会列出所有可用的软件包。--tree 选项将以树状列出软件包:

$ poetry show --tree

django 3.1.7 A high-level Python Web framework that encourages rapid development and clean, pragmatic design.
├── asgiref >=3.2.10,<4
├── pytz *
└── sqlparse >=0.2.2

包含软件包名称,以列出特定软件包的详细信息:

$ poetry show requests

name         : requests
version      : 2.25.1
description  : Python HTTP for Humans.

dependencies
 - certifi >=2017.4.17
 - chardet >=3.0.2,<5
 - idna >=2.5,<3
 - urllib3 >=1.21.1,<1.27

最后,如果你想知道软件包的最新版本,你可以通过 --latest 选项:

$ poetry show --latest

idna     2.10      3.1    Internationalized Domain Names in Applications
asgiref  3.3.1     3.3.1  ASGI specs, helper code, and adapters

更多信息

Poetry 的更多详情可在文档中获取。


via: https://fedoramagazine.org/how-to-use-poetry-to-manage-your-python-projects-on-fedora/

作者:Kader Miyanyedi 选题:lujun9972 译者:geekpi 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出
抵制在 Git 中添加一些会增加管理难度的东西的冲动;这里有替代方法。

 title=

有权访问源代码使对安全性的分析以及应用程序的安全成为可能。但是,如果没有人真正看过代码,问题就不会被发现,即使人们主动地看代码,通常也要看很多东西。幸运的是,GitHub 拥有一个活跃的安全团队,最近,他们 发现了已提交到多个 Git 仓库中的特洛伊木马病毒,甚至仓库的所有者也偷偷溜走了。尽管我们无法控制其他人如何管理自己的仓库,但我们可以从他们的错误中吸取教训。为此,本文回顾了将文件添加到自己的仓库中的一些最佳实践。

了解你的仓库

 title=

这对于安全的 Git 仓库来可以说是头号规则。作为项目维护者,无论是你自己创建的还是采用别人的,你的工作是了解自己仓库中的内容。你可能无法记住代码库中每一个文件,但是你需要了解你所管理的内容的基本组成部分。如果在几十个合并后出现一个游离的文件,你会很容易地发现它,因为你不知道它的用途,你需要检查它来刷新你的记忆。发生这种情况时,请查看该文件,并确保准确了解为什么它是必要的。

禁止二进制大文件

 title=

Git 是为文本而生的,无论是用纯文本编写的 C 或 Python 还是 Java 文本,亦或是 JSON、YAML、XML、Markdown、HTML 或类似的文本。Git 对于二进制文件不是很理想。

两者之间的区别是:

$ cat hello.txt
This is plain text.
It's readable by humans and machines alike.
Git knows how to version this.

$ git diff hello.txt
diff --git a/hello.txt b/hello.txt
index f227cc3..0d85b44 100644
--- a/hello.txt
+++ b/hello.txt
@@ -1,2 +1,3 @@
 This is plain text.
+It's readable by humans and machines alike.
 Git knows how to version this.

和

$ git diff pixel.png
diff --git a/pixel.png b/pixel.png
index 563235a..7aab7bc 100644
Binary files a/pixel.png and b/pixel.png differ

$ cat pixel.png
�PNG
▒
IHDR7n�$gAMA��
              �abKGD݊�tIME�

                          -2R��
IDA�c`�!�3%tEXtdate:create2020-06-11T11:45:04+12:00��r.%tEXtdate:modify2020-06-11T11:45:04+12:00��ʒIEND�B`�

二进制文件中的数据不能像纯文本一样被解析,因此,如果二进制文件发生任何更改,则必须重写整个内容。一个版本与另一个版本之间唯一的区别就是全部不同,这会快速增加仓库大小。

更糟糕的是,Git 仓库维护者无法合理地审计二进制数据。这违反了头号规则:应该对仓库的内容了如指掌。

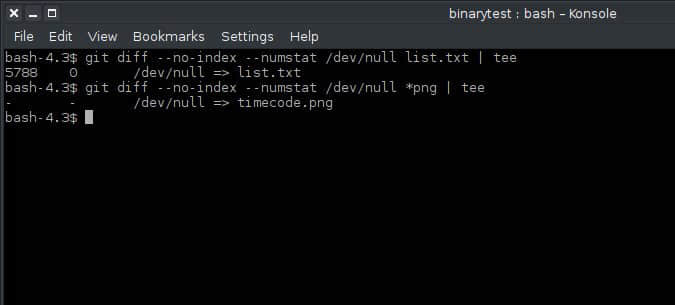
除了常用的 POSIX 工具之外,你还可以使用 git diff 检测二进制文件。当你尝试使用 --numstat 选项来比较二进制文件时,Git 返回空结果:

$ git diff --numstat /dev/null pixel.png | tee
-     -   /dev/null => pixel.png
$ git diff --numstat /dev/null file.txt | tee
5788  0   /dev/null => list.txt

如果你正在考虑将二进制大文件(BLOB)提交到仓库,请停下来先思考一下。如果它是二进制文件,那它是由什么生成的。是否有充分的理由不在构建时生成它们,而是将它们提交到仓库?如果你认为提交二进制数据是有意义的,请确保在 README 文件或类似文件中指明二进制文件的位置、为什么是二进制文件的原因以及更新它们的协议是什么。必须谨慎对其更新,因为你每提交一个二进制大文件的变化,它的存储空间实际上都会加倍。

让第三方库留在第三方

第三方库也不例外。尽管它是开源的众多优点之一,你可以不受限制地重用和重新分发不是你编写的代码,但是有很多充分的理由不把第三方库存储在你自己的仓库中。首先,除非你自己检查了所有代码(以及将来的合并),否则你不能为第三方完全担保。其次,当你将第三方库复制到你的 Git 仓库中时,会将焦点从真正的上游源代码中分离出来。从技术上讲,对库有信心的人只对该库的主副本有把握,而不是对随机仓库的副本有把握。如果你需要锁定特定版本的库,请给开发者提供一个合理的项目所需的发布 URL,或者使用 Git 子模块。

抵制盲目的 git add

 title=

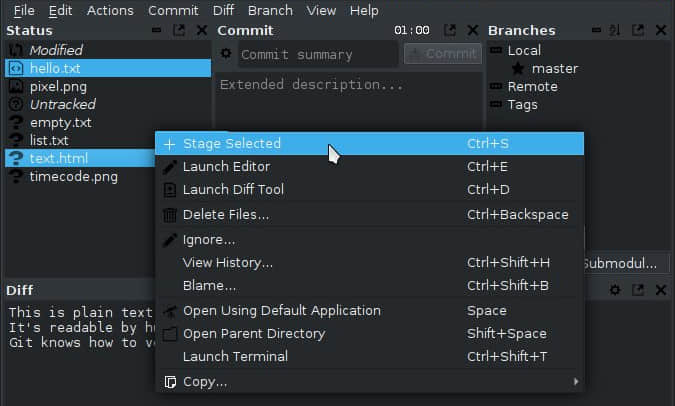
如果你的项目已编译,请抵制住使用 git add . 的冲动(其中 . 是当前目录或特定文件夹的路径),因为这是一种添加任何新东西的简单方法。如果你不是手动编译项目,而是使用 IDE 为你管理项目,这一点尤其重要。用 IDE 管理项目时,跟踪添加到仓库中的内容会非常困难,因此仅添加你实际编写的内容非常重要,而不是添加项目文件夹中出现的任何新对象。

如果你使用了 git add .,请在推送之前检查暂存区里的内容。如果在运行 make clean 或等效命令后,执行 git status 时在项目文件夹中看到一个陌生的对象,请找出它的来源,以及为什么仍然在项目的目录中。这是一种罕见的构建工件,不会在编译期间重新生成,因此在提交前请三思。

使用 Git ignore

 title=

许多为程序员打造的便利也非常杂乱。任何项目的典型项目目录,无论是编程的,还是艺术的或其他的,到处都是隐藏的文件、元数据和遗留的工件。你可以尝试忽略这些对象,但是 git status 中的提示越多,你错过某件事的可能性就越大。

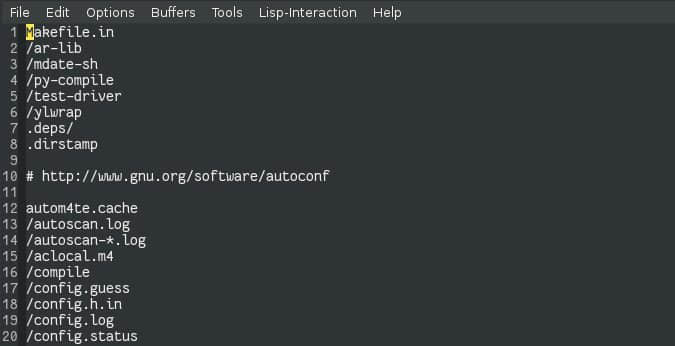
你可以通过维护一个良好的 gitignore 文件来为你过滤掉这种噪音。因为这是使用 Git 的用户的共同要求,所以有一些入门级的 gitignore 文件。Github.com/github/gitignore 提供了几个专门创建的 gitignore 文件,你可以下载这些文件并将其放置到自己的项目中,Gitlab.com 在几年前就将gitignore 模板集成到了仓库创建工作流程中。使用这些模板来帮助你为项目创建适合的 gitignore 策略并遵守它。

查看合并请求

 title=

当你通过电子邮件收到一个合并/拉取请求或补丁文件时,不要只是为了确保它能正常工作而进行测试。你的工作是阅读进入代码库的新代码,并了解其是如何产生结果的。如果你不同意这个实现,或者更糟的是,你不理解这个实现,请向提交该实现的人发送消息,并要求其进行说明。质疑那些希望成为版本库永久成员的代码并不是一种社交失误,但如果你不知道你把什么合并到用户使用的代码中,那就是违反了你和用户之间的社交契约。

Git 责任

社区致力于开源软件良好的安全性。不要鼓励你的仓库中不良的 Git 实践,也不要忽视你克隆的仓库中的安全威胁。Git 功能强大,但它仍然只是一个计算机程序,因此要以人为本,确保每个人的安全。


via: https://opensource.com/article/20/7/git-repos-best-practices

作者:Seth Kenlon 选题:lujun9972 译者:stevenzdg988 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出