分类 软件开发 下的文章

你想使用 React 来构建应用吗?“入门”是很容易的,可是接下来呢?

React 是一个构建用户界面的库,而它只是组成一个应用的一部分。应用还有其他的部分——风格、路由器、npm 模块、ES6 代码、捆绑和更多——这就是为什么使用它们的开发者不断流失的原因。这被称为 JavaScript 疲劳。尽管存在这种复杂性,但是使用 React 的用户依旧继续增长。

社区应对这一挑战的方法是共享模版文件。这些模版文件展示出开发者们架构选择的多样性。官方的“开始入门”似乎离一个实际可用的应用程序相去甚远。

新的,零配置体验

受开发者来自 Ember.js 和 Elm 的经验启发,Facebook 的人们想要提供一个简单、直接的方式。他们发明了一个新的开发 React 应用的方法 :create-react-app。在初始的公开版发布的三个星期以来,它已经受到了极大的社区关注(超过 8000 个 GitHub 粉丝)和支持(许多的拉取请求)。

create-react-app 是不同于许多过去使用模板和开发启动工具包的尝试。它的目标是零配置的惯例-优于-配置,使开发者关注于他们的应用的不同之处。

零配置一个强大的附带影响是这个工具可以在后台逐步成型。零配置奠定了工具生态系统的基础,创造的自动化和喜悦的开发远远超越 React 本身。

将零配置部署到 Heroku 上

多亏了 create-react-app 中打下的零配置基础,零配置的目标看起来快要达到了。因为这些新的应用都使用一个公共的、默认的架构,构建的过程可以被自动化,同时可以使用智能的默认项来配置。因此,我们创造这个社区构建包来体验在 Heroku 零配置的过程。

在两分钟内创造和发布 React 应用

你可以免费在 Heroku 上开始构建 React 应用。

npm install -g create-react-app
create-react-app my-app
cd my-app
git init
heroku create -b https://github.com/mars/create-react-app-buildpack.git
git add .
git commit -m "react-create-app on Heroku"
git push heroku master
heroku open

使用构建包文档亲自试试吧。

从零配置出发

create-react-app 非常的新(目前版本是 0.2),同时因为它的目标是简洁的开发者体验,更多高级的使用情景并不支持(或者肯定不会支持)。例如,它不支持服务端渲染或者自定义捆绑。

为了支持更好的控制,create-react-app 包括了 npm run eject 命令。Eject 将所有的工具(配置文件和 package.json 依赖库)解压到应用所在的路径,因此你可以按照你心中的想法定做。一旦被弹出,你做的改变或许有必要选择一个特定的用 Node.js 或静态的构建包来布署。总是通过一个分支/拉取请求来使类似的工程改变生效,因此这些改变可以轻易撤销。Heroku 的预览应用对测试发布的改变是完美的。

我们将会追踪 create-react-app 的进度,当它们可用时,同时适配构建包来支持更多的高级使用情况。发布万岁!


via: https://blog.heroku.com/deploying-react-with-zero-configuration

作者:Mars Hall 译者:zky001 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

Instagram 目前部署了世界上最大规模的 Django Web 框架(该框架完全使用 Python 编写)。我们最初选用 Python 是因为它久负盛名的简洁性与实用性,这非常符合我们的哲学思想——“先做简单的事情”。但简洁性也会带来效率方面的折衷。Instagram 的规模在过去两年中已经翻番,并且最近已突破 5 亿用户,所以急需最大程度地提升 web 服务效率以便我们的平台能够继续顺利地扩大。在过去的一年,我们已经将 效率计划 ( efficiency program ) 提上日程,并在过去的六个月,我们已经能够做到无需向我们的 Django 层 ( Django tiers ) 添加新的容量来维持我们的用户增长。我们将在本文分享一些由我们构建的工具以及如何使用它们来优化我们的日常部署流程。

为何需要提升效率?

Instagram,正如所有的软件,受限于像服务器和数据中心能源这样的物理限制。鉴于这些限制,在我们的效率计划中有两个我们希望实现的主要目标:

  1. Instagram 应当能够利用持续代码发布正常地提供通信服务,防止因为自然灾害、区域性网络问题等造成某一个数据中心区丢失。
  2. Instagram 应当能够自由地滚动发布新产品和新功能,不必因容量而受阻。

想要实现这些目标,我们意识到我们需要持续不断地监控我们的系统并与 回归 ( regressions ) 进行战斗。

定义效率

Web services 的瓶颈通常在于每台服务器上可用的 CPU 时间。在这种环境下,效率就意味着利用相同的 CPU 资源完成更多的任务,也就是说, 每秒处理更多的用户请求 ( requests per second,RPS ) 。当我们寻找优化方法时,我们面临的第一个最大的挑战就是尝试量化我们当前的效率。到目前为止,我们一直在使用“每次请求的平均 CPU 时间”来评估效率,但使用这种指标也有其固有限制:

  1. 设备多样性。使用 CPU 时间来测量 CPU 资源并非理想方案,因为它同时受到 CPU 型号与 CPU 负载的影响。
  2. 请求影响数据。测量每次请求的 CPU 资源并非理想方案,因为在使用 每次请求测量 ( per-request measurement ) 方案时,添加或移除轻量级或重量级的请求也会影响到效率指标。

相对于 CPU 时间来说,CPU 指令是一种更好的指标,因为对于相同的请求,它会报告相同的数字,不管 CPU 型号和 CPU 负载情况如何。我们选择使用了一种叫做” 每个活动用户 ( per active user ) “的指标,而不是将我们所有的数据关联到每个用户请求上。我们最终采用“ 每个活动用户在高峰期间的 CPU 指令 ( CPU instruction per active user during peak minute ) ”来测量效率。我们建立好新的度量标准后,下一步就是通过对 Django 的分析来更多的了解一下我们的回归。

Django web services 分析

通过分析我们的 Django web services,我们希望回答两个主要问题:

  1. CPU 回归会发生吗?
  2. 是什么导致了 CPU 回归发生以及我们该怎样修复它?

想要回答第一个问题,我们需要追踪“ 每个活动用户的 CPU 指令 ( CPU-instruction-per-active-user ) ”指标。如果该指标增加,我们就知道已经发生了一次 CPU 回归。

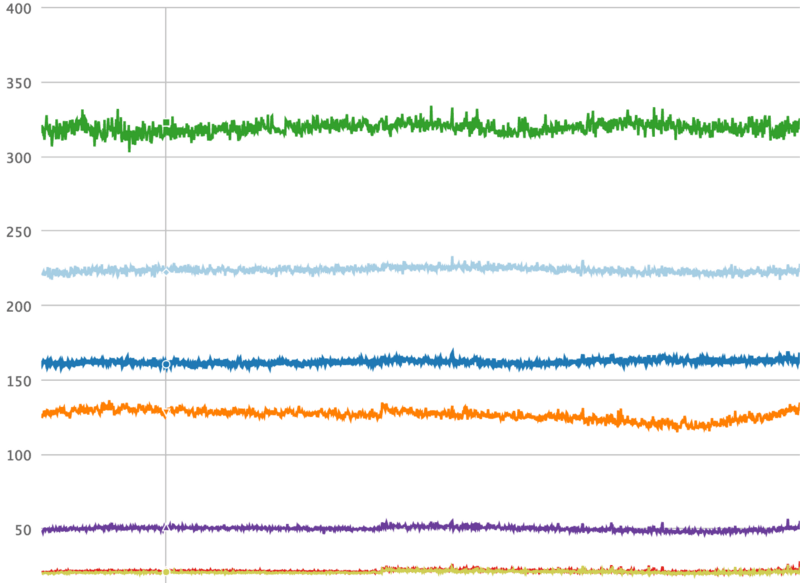
我们为此构建的工具叫做 Dynostats。Dynostats 利用 Django 中间件以一定的速率采样用户请求,记录关键的效率以及性能指标,例如 CPU 总指令数、端到端请求时延、花费在访问内存缓存(memcache)和数据库服务的时间等。另一方面,每个请求都有很多可用于聚合的 元数据 ( metadata ) ,例如端点名称、HTTP 请求返回码、服务该请求的服务器名称以及请求中最新提交的 哈希值 ( hash ) 。对于单个请求记录来说,有两个方面非常强大,因为我们可以在不同的维度上进行切割,那将帮助我们减少任何导致 CPU 回归的原因。例如,我们可以根据它们的端点名称聚合所有请求,正如下面的时间序列图所示,从图中可以清晰地看出在特定端点上是否发生了回归。

CPU 指令对测量效率很重要——当然,它们也很难获得。Python 并没有支持直接访问 CPU 硬件计数器(CPU 硬件计数器是指可编程 CPU 寄存器,用于测量性能指标,例如 CPU 指令)的公共库。另一方面,Linux 内核提供了 perf_event_open 系统调用。通过 Python ctypes 桥接技术能够让我们调用标准 C 库的系统调用函数 syscall,它也为我们提供了兼容 C 的数据类型,从而可以编程硬件计数器并从它们读取数据。

使用 Dynostats,我们已经可以找出 CPU 回归,并探究 CPU 回归发生的原因,例如哪个端点受到的影响最多,谁提交了真正会导致 CPU 回归的变更等。然而,当开发者收到他们的变更已经导致一次 CPU 回归发生的通知时,他们通常难以找出问题所在。如果问题很明显,那么回归可能就不会一开始就被提交!

这就是为何我们需要一个 Python 分析器,(一旦 Dynostats 发现了它)从而使开发者能够使用它找出回归发生的根本原因。不同于白手起家,我们决定对一个现成的 Python 分析器 cProfile 做适当的修改。cProfile 模块通常会提供一个统计集合来描述程序不同的部分执行时间和执行频率。我们将 cProfile 的 定时器 ( timer ) 替换成了一个从硬件计数器读取的 CPU 指令计数器,以此取代对时间的测量。我们在采样请求后产生数据并把数据发送到数据流水线。我们也会发送一些我们在 Dynostats 所拥有的类似元数据,例如服务器名称、集群、区域、端点名称等。

在数据流水线的另一边,我们创建了一个消费数据的 尾随者 ( tailer ) 。尾随者的主要功能是解析 cProfile 的统计数据并创建能够表示 Python 函数级别的 CPU 指令的实体。如此,我们能够通过 Python 函数来聚合 CPU 指令,从而更加方便地找出是什么函数导致了 CPU 回归。

监控与警报机制

在 Instagram,我们每天部署 30-50 次后端服务。这些部署中的任何一个都能发生 CPU 回归的问题。因为每次发生通常都包含至少一个 差异 ( diff ) ,所以找出任何回归是很容易的。我们的效率监控机制包括在每次发布前后都会在 Dynostats 中扫描 CPU 指令,并且当变更超出某个阈值时发出警告。对于长期会发生 CPU 回归的情况,我们也有一个探测器为负载最繁重的端点提供日常和每周的变更扫描。

部署新的变更并非触发一次 CPU 回归的唯一情况。在许多情况下,新的功能和新的代码路径都由 全局环境变量 ( global environment variables,GEV ) 控制。 在一个计划好的时间表上,给一部分用户发布新功能是很常见事情。我们在 Dynostats 和 cProfile 统计数据中为每个请求添加了这个信息作为额外的元数据字段。按这些字段将请求分组可以找出由全局环境变量(GEV)改变导致的可能的 CPU 回归问题。这让我们能够在它们对性能造成影响前就捕获到 CPU 回归。

接下来是什么?

Dynostats 和我们定制的 cProfile,以及我们建立的支持它们的监控和警报机制能够有效地找出大多数导致 CPU 回归的元凶。这些进展已经帮助我们恢复了超过 50% 的不必要的 CPU 回归,否则我们就根本不会知道。

我们仍然还有一些可以提升的方面,并很容易将它们地加入到 Instagram 的日常部署流程中:

  1. CPU 指令指标应该要比其它指标如 CPU 时间更加稳定,但我们仍然观察了让我们头疼的差异。保持“ 信噪比 ( signal:noise ratio ) ”合理地低是非常重要的,这样开发者们就可以集中于真实的回归上。这可以通过引入 置信区间 ( confidence intervals ) 的概念来提升,并在信噪比过高时发出警报。针对不同的端点,变化的阈值也可以设置为不同值。
  2. 通过更改 GEV 来探测 CPU 回归的一个限制就是我们要在 Dynostats 中手动启用这些比较的日志输出。当 GEV 的数量逐渐增加,开发了越来越多的功能,这就不便于扩展了。相反,我们能够利用一个自动化框架来调度这些比较的日志输出,并对所有的 GEV 进行遍历,然后当检查到回归时就发出警告。
  3. cProfile 需要一些增强以便更好地处理封装函数以及它们的子函数。

鉴于我们在为 Instagram 的 web service 构建效率框架中所投入的工作,所以我们对于将来使用 Python 继续扩展我们的服务很有信心。我们也开始向 Python 语言本身投入更多,并且开始探索从 Python 2 转移 Python 3 之道。我们将会继续探索并做更多的实验以继续提升基础设施与开发者效率,我们期待着很快能够分享更多的经验。

本文作者 Min Ni 是 Instagram 的软件工程师。

(题图来自:nostarch.com)


via: https://engineering.instagram.com/web-service-efficiency-at-instagram-with-python-4976d078e366#.tiakuoi4p

作者:Min Ni 译者:ChrisLeeGit 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

解析器是一种超级有用的软件库。从概念上简单的说,它们的实现很有挑战性,并且在计算机科学中经常被认为是黑魔法。在这个系列的博文中,我会向你们展示为什么你不需要成为哈利波特就能够精通解析器这种魔法。但是为了以防万一带上你的魔杖吧!

我们将探索一种叫做 Ohm 的新的开源库,它使得搭建解析器很简单并且易于重用。在这个系列里,我们使用 Ohm 去识别数字,构建一个计算器等等。在这个系列的最后你将已经用不到 200 行的代码发明了一种完整的编程语言。这个强大的工具将让你能够做到一些你可能过去认为不可能的事情。

为什么解析器很困难?

解析器非常有用。在很多时候你可能需要一个解析器。或许有一种你需要处理的新的文件格式,但还没有人为它写了一个库;又或许你发现了一种古老格式的文件,但是已有的解析器不能在你的平台上构建。我已经看到这样的事发生无数次。 Code 在或者不在, Data 就在那里,不增不减。

从根本上来说,解析器很简单:只是把一个数据结构转化成另一个。所以你会不会觉得你要是邓布利多校长就好了?

解析器历来是出奇地难写,所面临的挑战是绝大多数现有的工具都很老,并且需要一定的晦涩难懂的计算机科学知识。如果你在大学里上过编译器课程,那么课本里也许还有从上世纪七十年传下来的技术。幸运的是,解析器技术从那时候起已经提高了很多。

典型的,解析器是通过使用一种叫作 形式语法 ( formal grammar ) 的特殊语法来定义你想要解析的东西来创造的,然后你需要把它放入像 Bison 和 Yacc 的工具中,这些工具能够产生一堆 C 代码,这些代码你需要修改或者链接到你实际写入的编程语言中。另外的选择是用你更喜欢的语言亲自动手写一个解析器,这很慢且很容易出错,在你能够真正使用它之前还有许多额外的工作。

想像一下,是否你关于你想要解析的东西的语法描述也是解析器?如果你能够只是直接运行这些语法,然后仅在你需要的地方增加一些 挂钩 ( hook ) 呢?那就是 Ohm 所可以做到的事。

Ohm 简介

Ohm 是一种新的解析系统。它类似于你可能已经在课本里面看到过的语法,但是它更强大,使用起来更简单。通过 Ohm, 你能够使用一种灵活的语法在一个 .ohm 文件中来写你自己的格式定义,然后使用你的宿主语言把语义加入到里面。在这篇博文里,我们将用 JavaScript 作为宿主语言。

Ohm 建立于一个为创造更简单、更灵活的解析器的多年研究基础之上。VPRI 的 STEPS program (pdf) 使用 Ohm 的前身 Ometa 为许多特殊的任务创造了专门的语言(比如一个有 400 行代码的平行制图描绘器)。

Ohm 有许多有趣的特点和符号,但是相比于全部解释它们,我认为我们只需要深入其中并构建一些东西就行了。

解析整数

让我们来解析一些数字。这看起来会很简单,只需在一个文本串中寻找毗邻的数字,但是让我们尝试去处理所有形式的数字:整数和浮点数、十六进制数和八进制数、科学计数、负数。解析数字很简单,正确解析却很难。

亲自构建这个代码将会很困难,会有很多问题,会伴随有许多特殊的情况,比如有时会相互矛盾。正则表达式或许可以做的这一点,但是它会非常丑陋而难以维护。让我们用 Ohm 来试试。

用 Ohm 构建的解析器涉及三个部分: 语法 ( grammar ) 、 语义 ( semantics ) 和 测试 ( tests ) 。我通常挑选问题的一部分为它写测试,然后构建足够的语法和语义来使测试通过。然后我再挑选问题的另一部分,增加更多的测试、更新语法和语义,从而确保所有的测试能够继续通过。即使我们有了新的强大的工具,写解析器从概念上来说依旧很复杂。测试是用一种合理的方式来构建解析器的唯一方法。现在,让我们开始工作。

我们将从整数开始。一个整数由一系列相互毗邻的数字组成。让我们把下面的内容放入一个叫做 grammar.ohm 的文件中:

CoolNums {
   // just a basic integer
   Number = digit+
}

这创造了一条匹配一个或多个数字(digit)叫作 Number 的单一规则。+ 意味着一个或更多,就在正则表达式中一样。当有一个或更多的数字时,这个规则将会匹配它们,如果没有数字或者有一些不是数字的东西将不会匹配。“数字(digit)”的定义是从 0 到 9 其中的一个字符。digit 也是像 Number 一样的规则,但是它是 Ohm 的其中一条构建规则因此我们不需要去定义它。如果我们想的话可以推翻它,但在这时候这没有任何意义,毕竟我们不打算去发明一种新的数。

现在,我们可以读入这个语法并用 Ohm 库来运行它。

把它放入 test1.js:

var ohm = require('ohm-js');
var fs = require('fs');
var assert = require('assert');
var grammar = ohm.grammar(fs.readFileSync('src/blog_numbers/syntax1.ohm').toString());

Ohm.grammar 调用将读入该文件并解析成一个语法对象。现在我们可以增加一些语义。把下面内容增加到你的 JavaScript 文件中:

var sem = grammar.createSemantics().addOperation('toJS', {
    Number: function(a) {
        return parseInt(this.sourceString,10);
    }
});

这通过 toJS 操作创造了一个叫作 sem 的语法集。这些语义本质上是一些对应到语法中每个规则的函数。每个函数当与之相匹配的语法规则被解析时将会被调用。上面的 Number 函数将会在语法中的 Number 规则被解析时被调用。 语法 ( grammar ) 定义了在语言中这些代码是什么, 语义 ( semantics ) 定义了当这些代码被解析时应该做什么。

语义函数能够做我们想做的任何事,比如打印出故障信息、创建对象,或者在任何子节点上递归调用 toJS。此时我们仅仅想把匹配的文本转换成真正的 JavaScript 整数。

所有的语义函数有一个内含的 this 对象,带有一些有用的属性。其 source 属性代表了输入文本中和这个节点相匹配的部分。this.sourceString 是一个匹配输入的串,调用内置在 JavaScript 中的 parseInt 函数会把这个串转换成一个数。传给 parseInt 的 10 这个参数告诉 JavaScript 我们输入的是一个以 10 为基底(10 进制)的数。如果少了这个参数, JavaScript 也会假定以 10 为基底,但是我们把它包含在里面因为后面我们将支持以 16 为基底的数,所以使之明确比较好。

既然我们有一些语法,让我们来实际解析一些东西看一看我们的解析器是否能够工作。如何知道我们的解析器可以工作?通过测试,许多许多的测试,每一个可能的边缘情况都需要一个测试。

使用标准的断言 assert API,以下这个测试函数能够匹配一些输入并运用我们的语义把它转换成一个数,然后把这个数和我们期望的输入进行比较。

   function test(input, answer) {
     var match = grammar.match(input);
     if(match.failed()) return console.log("input failed to match " + input + match.message);     
     var result = sem(match).toJS();
     assert.deepEqual(result,answer);
     console.log('success = ', result, answer);
    }

就是如此。现在我们能够为各种不同的数写一堆测试。如果匹配失败我们的脚本将会抛出一个例外。否则就打印成功信息。让我们尝试一下,把下面这些内容加入到脚本中:

    test("123",123);
    test("999",999);
    test("abc",999);

然后用 node test1.js 运行脚本。

你的输出应该是这样:

success =  123 123
success =  999 999
input failed to match abcLine 1, col 1:
> 1 | abc
      ^
Expected a digit

真酷。正如预期的那样,前两个成功了,第三个失败了。更好的是,Ohm 自动给了我们一个很棒的错误信息指出匹配失败。

浮点数

我们的解析器工作了,但是它做的工作不是很有趣。让我们把它扩展成既能解析整数又能解析浮点数。改变 grammar.ohm 文件使它看起来像下面这样:

CoolNums {
  // just a basic integer
  Number = float | int
  int    = digit+
  float  = digit+ "." digit+
}

这把 Number 规则改变成指向一个浮点数(float)或者一个整数(int)。这个 | 代表着“或”。我们把这个读成“一个 Number 由一个浮点数或者一个整数构成。”然后整数(int)定义成 digit+,浮点数(float)定义成 digit+ 后面跟着一个句号然后再跟着另一个 digit+。这意味着在句号前和句号后都至少要有一个数字。如果一个数中没有一个句号那么它就不是一个浮点数,因此就是一个整数。

现在,让我们再次看一下我们的语义功能。由于我们现在有了新的规则所以我们需要新的功能函数:一个作为整数的,一个作为浮点数的。

var sem = grammar.createSemantics().addOperation('toJS', {
    Number: function(a) {
        return a.toJS();
    },
    int: function(a) {
        console.log("doing int", this.sourceString);
        return parseInt(this.sourceString,10);
    },
    float: function(a,b,c) {
        console.log("doing float", this.sourceString);
        return parseFloat(this.sourceString);
    }
});

这里有两件事情需要注意。首先,整数(int)、浮点数(float)和数(Number)都有相匹配的语法规则和函数。然而,针对 Number 的功能不再有任何意义。它接收子节点 a 然后返回该子节点的 toJS 结果。换句话说,Number 规则简单的返回相匹配的子规则。由于这是在 Ohm 中任何规则的默认行为,因此实际上我们不用去考虑 Number 的作用,Ohm 会替我们做好这件事。

其次,整数(int)有一个参数 a,然而浮点数有三个:a、b 和 c。这是由于规则的 实参数量 ( arity ) 决定的。 实参数量 ( arity ) 意味着一个规则里面有多少参数。如果我们回过头去看语法,浮点数(float)的规则是:

  float  = digit+ "." digit+

浮点数规则通过三个部分来定义:第一个 digit+、.、以及第二个 digit+。这三个部分都会作为参数传递给浮点数的功能函数。因此浮点数必须有三个参数,否则 Ohm 库会给出一个错误。在这种情况下我们不用在意参数,因为我们仅仅直接攫取了输入串,但是我们仍然需要参数列在那里来避免编译器错误。后面我们将实际使用其中一些参数。

现在我们可以为新的浮点数支持添加更多的测试。

test("123",123);
test("999",999);
//test("abc",999);
test('123.456',123.456);
test('0.123',0.123);
test('.123',0.123);

注意最后一个测试将会失败。一个浮点数必须以一个数开始,即使它就是个 0,.123 不是有效的,实际上真正的 JavaScript 语言也有相同的规则。

十六进制数

现在我们已经有了整数和浮点数,但是还有一些其它的数的语法最好可以支持:十六进制数和科学计数。十六进制数是以 16 为基底的整数。十六进制数的数字能从 0 到 9 和从 A 到 F。十六进制数经常用在计算机科学中,当用二进制数据工作时,你可以仅仅使用两个数字表示 0 到 255 的数。

在绝大多数源自 C 的编程语言(包括 JavaScript),十六进制数通过在前面加上 0x 来向编译器表明后面跟的是一个十六进制数。为了让我们的解析器支持十六进制数,我们只需要添加另一条规则。

  Number = hex | float | int
  int    = digit+
  float  = digit+ "." digit+
  hex    = "0x" hexDigit+
  hexDigit := "0".."9" | "a".."f" | "A".."F"

我实际上已经增加了两条规则。十六进制数(hex)表明它是一个 0x 后面一个或多个十六进制数字(hexDigits)的串。一个十六进制数字(hexDigit)是从 0 到 9,或从 a 到 f,或 A 到 F(包括大写和小写的情况)的一个字符。我也修改了 Number 规则来识别十六进制数作为另外一种可能的情况。现在我们只需要另一条针对十六进制数的功能规则。

    hex: function(a,b) {
        return parseInt(this.sourceString,16);
    }

注意到,在这种情况下,我们把 16 作为基底传递给 parseInt,因为我们希望 JavaScript 知道这是一个十六进制数。

我略过了一些很重要需要注意的事。hexDigit 的规则像下面这样:

  hexDigit := "0".."9" | "a".."f" | "A".."F"

注意我使用的是 := 而不是 =。在 Ohm 中,:= 是当你需要推翻一条规则的时候使用。这表明 Ohm 已经有了一条针对 hexDigit 的默认规则,就像 digit、space 等一堆其他的东西。如果我使用了 =, Ohm 将会报告一个错误。这是一个检查,从而避免我无意识的推翻一个规则。由于新的 hexDigit 规则和 Ohm 的构建规则一样,所以我们可以把它注释掉,然后让 Ohm 自己来实现它。我留下这个规则只是因为这样我们可以看到它实际上是如何进行的。

现在,我们可以添加更多的测试然后看到十六进制数真的能工作:

test('0x456',0x456);
test('0xFF',255);

科学计数

最后,让我们来支持科学计数。科学计数是针对非常大或非常小的数的,比如 1.8×10^3。在大多数编程语言中,科学计数法表示的数会写成这样:1.8e3 表示 18000,或者 1.8e-3 表示 .018。让我们增加另外一对规则来支持这个指数表示:

    float  = digit+ "." digit+ exp?
    exp    = "e" "-"? digit+

上面在浮点数规则末尾增加了一个指数(exp)规则和一个 ?。? 表示没有或有一个,所以指数(exp)是可选的,但是不能超过一个。增加指数(exp)规则也改变了浮点数规则的实参数量,所以我们需要为浮点数功能增加另一个参数,即使我们不使用它。

    float: function(a,b,c,d) {
        console.log("doing float", this.sourceString);
        return parseFloat(this.sourceString);
    },

现在我们的测试可以通过了:

test('4.8e10',4.8e10);
test('4.8e-10',4.8e-10);

结论

Ohm 是构建解析器的一个很棒的工具,因为它易于上手,并且你可以递增的增加规则。Ohm 也还有其他我今天没有写到的很棒的特点,比如调试观察仪和子类化。

到目前为止,我们已经使用 Ohm 来把字符串翻译成 JavaScript 数,并且 Ohm 经常用于把一种表示方式转化成另外一种。然而,Ohm 还有更多的用途。通过放入不同的语义功能集,你可以使用 Ohm 来真正处理和计算东西。一个单独的语法可以被许多不同的语义使用,这是 Ohm 的魔法之一。

在这个系列的下一篇文章中,我将向你们展示如何像真正的计算机一样计算像 (4.85 + 5 * (238 - 68)/2) 这样的数学表达式,不仅仅是解析数。

额外的挑战:你能够扩展语法来支持八进制数吗?这些以 8 为基底的数能够只用 0 到 7 这几个数字来表示,前面加上一个数字 0 或者字母 o。看看针对下面这些测试情况是够正确。下次我将给出答案。

test('0o77',7*8+7);
test('0o23',0o23);

via: https://www.pubnub.com/blog/2016-08-30-javascript-parser-ohm-makes-creating-a-programming-language-easy/

作者:Josh Marinacci 译者:ucasFL 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出
现在我们将要学习如何搭建 git 服务器,如何编写自定义的 Git 钩子来在特定的事件触发相应的动作(例如通知),或者是发布你的代码到一个站点。

直到现在,我们主要讨论的还是以一个使用者的身份与 Git 进行交互。这篇文章中我将讨论 Git 的管理,并且设计一个灵活的 Git 框架。你可能会觉得这听起来是 “高阶 Git 技术” 或者 “只有狂热粉才能阅读”的一句委婉的说法,但是事实是这里面的每个任务都不需要很深的知识或者其他特殊的训练,就能基本理解 Git 的工作原理,有可能需要一丁点关于 Linux 的知识。

共享 Git 服务器

创建你自己的共享 Git 服务器意外地简单,而且在很多情况下,遇到的这点麻烦是完全值得的。不仅仅是因为它保证你有权限查看自己的代码,它还可以通过扩展为 Git 的使用敞开了一扇大门,例如个人 Git 钩子、无限制的数据存储、和持续集成与分发(CI & CD)。

如果你知道如何使用 Git 和 SSH,那么你已经知道怎么创建一个 Git 服务器了。Git 的设计方式,就是让你在创建或者 clone 一个仓库的时候,就完成了一半服务器的搭建。然后允许用 SSH 访问仓库,而且任何有权限访问的人都可以使用你的仓库作为 clone 的新仓库的基础。

但是,这是一个小的 点对点环境 ( ad-hoc ) 。按照一些方案你可以创建一些带有同样的功能的设计优良的 Git 服务器,同时有更好的拓展性。

首要之事:确认你的用户们,现在的用户以及之后的用户都要考虑。如果你是唯一的用户那么没有任何改动的必要。但是如果你试图邀请其他的代码贡献者使用,那么你应该允许一个专门的分享系统用户给你的开发者们。

假定你有一个可用的服务器(如果没有,这不成问题,Git 会帮忙解决,CentOS 的 树莓派 3 是个不错的开始),然后第一步就是只允许使用 SSH 密钥认证的 SSH 登录。这比使用密码登录安全得多,因为这可以免于暴力破解,也可以通过直接删除用户密钥而禁用用户。

一旦你启用了 SSH 密钥认证,创建 gituser 用户。这是给你的所有授权的用户们的公共用户:

$ su -c 'adduser gituser'

然后切换到刚创建的 gituser 用户,创建一个 ~/.ssh 的框架,并设置好合适的权限。这很重要,如果权限设置得太开放会使自己所保护的 SSH 没有意义。

$ su - gituser
$ mkdir .ssh && chmod 700 .ssh
$ touch .ssh/authorized_keys
$ chmod 600 .ssh/authorized_keys

authorized_keys 文件里包含所有你的开发者们的 SSH 公钥,你开放权限允许他们可以在你的 Git 项目上工作。他们必须创建他们自己的 SSH 密钥对然后把他们的公钥给你。复制公钥到 gituser 用户下的 authorized_keys 文件中。例如,为一个叫 Bob 的开发者,执行以下命令:

$ cat ~/path/to/id_rsa.bob.pub >> /home/gituser/.ssh/authorized_keys

只要开发者 Bob 有私钥并且把相对应的公钥给你,Bob 就可以用 gituser 用户访问服务器。

但是,你并不是想让你的开发者们能使用服务器,即使只是以 gituser 的身份访问。你只是想给他们访问 Git 仓库的权限。因为这个特殊的原因,Git 提供了一个限制的 shell,准确的说是 git-shell。以 root 身份执行以下命令,把 git-shell 添加到你的系统中,然后设置成 gituser 用户的默认 shell。

# grep git-shell /etc/shells || su -c "echo `which git-shell` >> /etc/shells"
# su -c 'usermod -s git-shell gituser'

现在 gituser 用户只能使用 SSH 来 push 或者 pull Git 仓库,并且无法使用任何一个可以登录的 shell。你应该把你自己添加到和 gituser 一样的组中,在我们的样例服务器中这个组的名字也是 gituser。

举个例子:

# usermod -a -G gituser seth

仅剩下的一步就是创建一个 Git 仓库。因为没有人能在服务器上直接与 Git 交互(也就是说,你之后不能 SSH 到服务器然后直接操作这个仓库),所以创建一个空的仓库 。如果你想使用这个放在服务器上的仓库来完成工作,你可以从它的所在处 clone 下来,然后在你的 home 目录下进行工作。

严格地讲,你不是必须创建这个空的仓库;它和一个正常的仓库一样工作。但是,一个空的仓库没有工作分支(working tree) (也就是说,使用 checkout 并没有任何分支显示)。这很重要,因为不允许远程使用者们 push 到一个有效的分支上(如果你正在 dev 分支工作然后突然有人把一些变更 push 到你的工作分支,你会有怎么样的感受?)。因为一个空的仓库可以没有有效的分支,所以这不会成为一个问题。

你可以把这个仓库放到任何你想放的地方,只要你想要放开权限给用户和用户组,让他们可以在仓库下工作。千万不要保存目录到比如说一个用户的 home 目录下,因为那里有严格的权限限制。保存到一个常规的共享地址,例如 /opt 或者 /usr/local/share。

以 root 身份创建一个空的仓库:

# git init --bare /opt/jupiter.git
# chown -R gituser:gituser /opt/jupiter.git
# chmod -R 770 /opt/jupiter.git

现在任何一个用户,只要他被认证为 gituser 或者在 gituser 组中,就可以从 jupiter.git 库中读取或者写入。在本地机器尝试以下操作:

$ git clone [email protected]:/opt/jupiter.git jupiter.clone
Cloning into 'jupiter.clone'...
Warning: you appear to have cloned an empty repository.

谨记:开发者们一定要把他们的 SSH 公钥加入到 gituser 用户下的 authorized_keys 文件里,或者说,如果他们有服务器上的用户(如果你给了他们用户),那么他们的用户必须属于 gituser 用户组。

Git 钩子

运行你自己的 Git 服务器最赞的一件事之一就是可以使用 Git 钩子。Git 托管服务有时提供一个钩子类的接口,但是他们并不会给你真正的 Git 钩子来让你访问文件系统。Git 钩子是一个脚本,它将在一个 Git 过程的某些点运行;钩子可以运行在当一个仓库即将接收一个 commit 时、或者接受一个 commit 之后,或者即将接收一次 push 时,或者一次 push 之后等等。

这是一个简单的系统:任何放在 .git/hooks 目录下的脚本、使用标准的命名体系,就可按设计好的时间运行。一个脚本是否应该被运行取决于它的名字; pre-push 脚本在 push 之前运行,post-receive 脚本在接受 commit 之后运行等等。这或多或少的可以从名字上看出来。

脚本可以用任何语言写;如果在你的系统上有可以执行的脚本语言,例如输出 ‘hello world’ ,那么你就可以这个语言来写 Git 钩子脚本。Git 默认带了一些例子,但是并不有启用。

想要动手试一个?这很简单。如果你没有现成的 Git 仓库,首先创建一个 Git 仓库:

$ mkdir jupiter
$ cd jupiter
$ git init .

然后写一个 “hello world” 的 Git 钩子。因为我为了支持老旧系统而使用 tsch,所以我仍然用它作为我的脚本语言,你可以自由的使用自己喜欢的语言(Bash,Python,Ruby,Perl,Rust,Swift,Go):

$ echo "#\!/bin/tcsh" > .git/hooks/post-commit
$ echo "echo 'POST-COMMIT SCRIPT TRIGGERED'" >> ~/jupiter/.git/hooks/post-commit
$ chmod +x ~/jupiter/.git/hooks/post-commit

现在测试它的输出:

$ echo "hello world" > foo.txt
$ git add foo.txt
$ git commit -m 'first commit'
! POST-COMMIT SCRIPT TRIGGERED
[master (root-commit) c8678e0] first commit
1 file changed, 1 insertion(+)
create mode 100644 foo.txt

现在你已经实现了:你的第一个有功能的 Git 钩子。

有名的 push-to-web 钩子

Git 钩子最流行的用法就是自动 push 更改的代码到一个正在使用中的产品级 Web 服务器目录下。这是摆脱 FTP 的很好的方式,对于正在使用的产品保留完整的版本控制,整合并自动化内容的发布。

如果操作正确,网站发布工作会像以前一样很好的完成,而且在某种程度上,很精准。Git 真的好棒。我不知道谁最初想到这个主意,但是我是从 Emacs 和 Git 方面的专家,IBM 的 Bill von Hagen 那里第一次听到它的。他的文章包含关于这个过程的权威介绍:Git 改变了分布式网页开发的游戏规则。

Git 变量

每一个 Git 钩子都有一系列不同的变量对应触发钩子的不同 Git 行为。你需不需要这些变量,主要取决于你写的程序。如果你只是需要一个当某人 push 代码时候的通用邮件通知,那么你就不需要什么特殊的东西,甚至也不需要编写额外的脚本,因为已经有现成的适合你的样例脚本。如果你想在邮件里查看 commit 信息和 commit 的作者,那么你的脚本就会变得相对麻烦些。

Git 钩子并不是被用户直接执行,所以要弄清楚如何收集可能会混淆的重要信息。事实上,Git 钩子脚本类似于其他的脚本,像 BASH、Python、C++ 等等一样从标准输入读取参数。不同的是,我们不会给它提供这个输入,所以,你在使用的时候,需要知道可能的输入参数。

在写 Git 钩子之前,看一下 Git 在你的项目目录下 .git/hooks 目录中提供的一些例子。举个例子,在这个 pre-push.sample 文件里,注释部分说明了如下内容:

# $1 -- 即将 push 的远程仓库的名字
# $2 -- 即将 push 的远程仓库的 URL
# 如果 push 的时候,并没有一个命名的远程仓库,那么这两个参数将会一样。
#
# 提交的信息将以下列形式按行发送给标准输入
# <local ref> <local sha1> <remote ref> <remote sha1>

并不是所有的例子都是这么清晰,而且关于钩子获取变量的文档依旧缺乏(除非你去读 Git 的源码)。但是,如果你有疑问,你可以从线上其他用户的尝试中学习,或者你只是写一些基本的脚本,比如 echo $1, $2, $3 等等。

分支检测示例

我发现,对于生产环境来说有一个共同的需求,就是需要一个只有在特定分支被修改之后,才会触发事件的钩子。以下就是如何跟踪分支的示例。

首先,Git 钩子本身是不受版本控制的。 Git 并不会跟踪它自己的钩子,因为对于钩子来说,它是 Git 的一部分,而不是你仓库的一部分。所以,Git 钩子可以监控你的 Git 服务器上的一个空仓库的 commit 记录和 push 记录,而不是你本地仓库的一部分。

我们来写一个 post-receive(也就是说,在 commit 被接受之后触发)钩子。第一步就是需要确定分支名:

#!/bin/tcsh

foreach arg ( $< )
  set argv = ( $arg )
  set refname = $1
end

这个 for 循环用来读入第一个参数 $1 ,然后循环用第二个参数 $2 去覆盖它,然后用第三个参数 $3 再这样。在 Bash 中有一个更好的方法,使用 read 命令,并且把值放入数组里。但是,这里是 tcsh,并且变量的顺序可以预测的,所以,这个方法也是可行的。

当我们有了 commit 记录的 refname,我们就能使用 Git 去找到这个分支的供人看的名字:

set branch = `git rev-parse --symbolic --abbrev-ref $refname`
echo $branch #DEBUG

然后把这个分支名和我们想要触发的事件的分支名关键字进行比较:

if ( "$branch" == "master" ) then
  echo "Branch detected: master"
  git \
    --work-tree=/path/to/where/you/want/to/copy/stuff/to \
    checkout -f $branch || echo "master fail"
else if ( "$branch" == "dev" ) then
  echo "Branch detected: dev"
  Git \
    --work-tree=/path/to/where/you/want/to/copy/stuff/to \
    checkout -f $branch || echo "dev fail"
  else
    echo "Your push was successful."
    echo "Private branch detected. No action triggered."
endif

给这个脚本分配可执行权限:

$ chmod +x ~/jupiter/.git/hooks/post-receive

现在,当一个用户提交到服务器的 master 分支,那些代码就会被复制到一个生产环境的目录,提交到 dev 分支则会被复制到另外的地方,其他分支将不会触发这些操作。

同时,创造一个 pre-commit 脚本也很简单。比如,判断一个用户是否在他们不该 push 的分支上 push 代码,或者对 commit 信息进行解析等等。

Git 钩子也可以变得复杂,而且它们因为 Git 的工作流的抽象层次不同而变得难以理解,但是它们确实是一个强大的系统,让你能够在你的 Git 基础设施上针对所有的行为进行对应的操作。如果你是一个 Git 重度用户,或者一个全职 Git 管理员,那么 Git 钩子是值得学习的,只有当你熟悉这个过程,你才能真正掌握它。

在我们这个系列下一篇也是最后一篇文章中,我们将会学习如何使用 Git 来管理非文本的二进制数据,比如音频和图片。


via: https://opensource.com/life/16/8/how-construct-your-own-git-server-part-6

作者:Seth Kenlon 译者:maywanting 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出
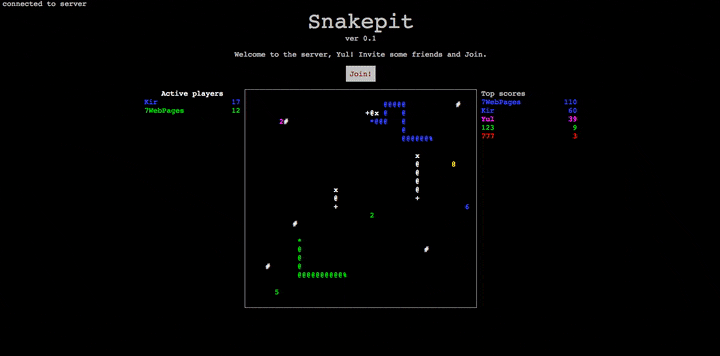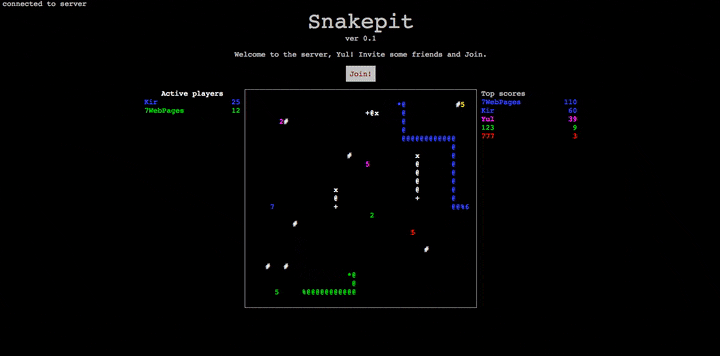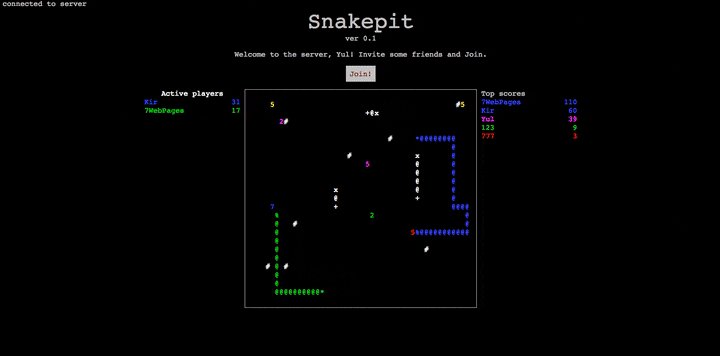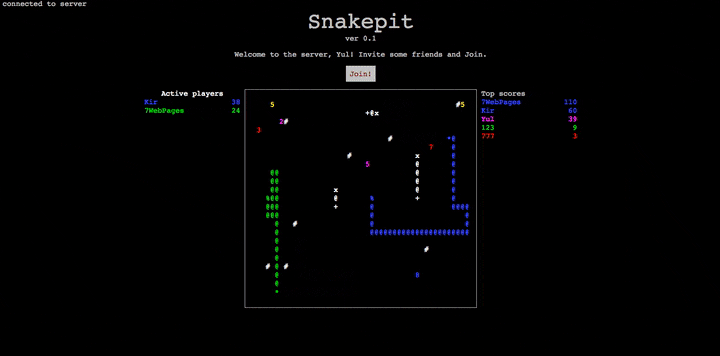
在这个系列中,我们基于多人游戏 贪吃蛇 来制作一个异步的 Python 程序。上一篇文章聚焦于编写游戏循环上,而本系列第 1 部分则涵盖了如何异步化。

4、制作一个完整的游戏

4.1 工程概览

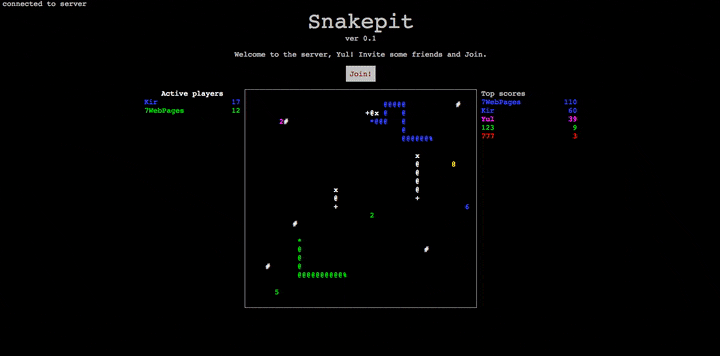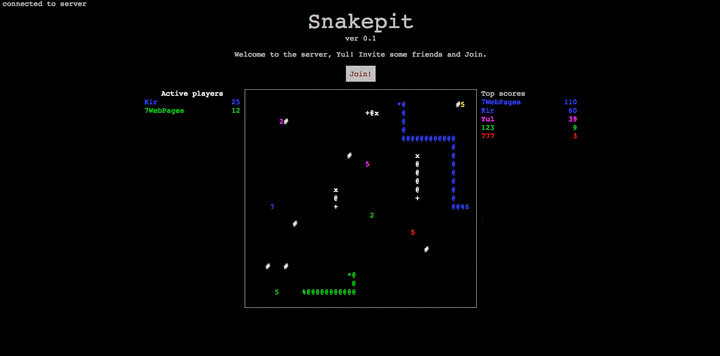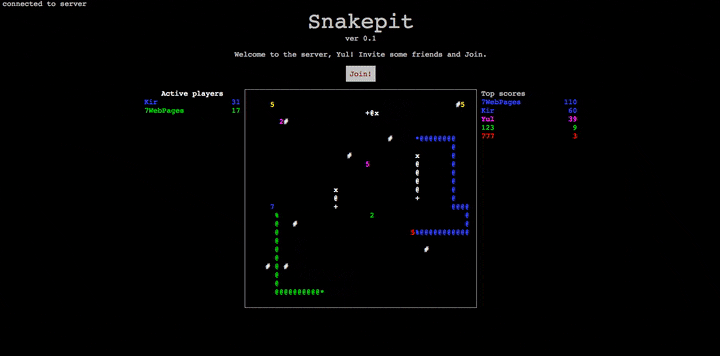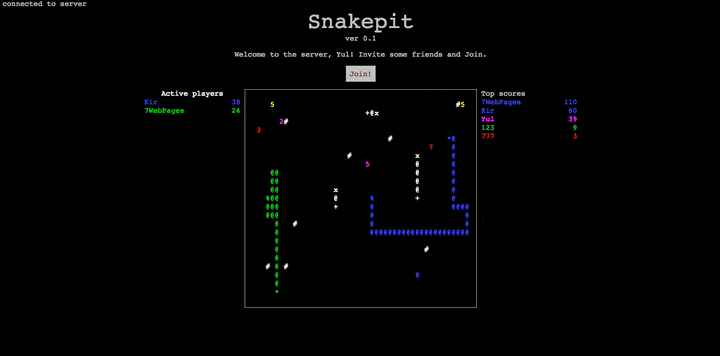
在此部分,我们将回顾一个完整在线游戏的设计。这是一个经典的贪吃蛇游戏,增加了多玩家支持。你可以自己在 (http://snakepit-game.com) 亲自试玩。源码在 GitHub 的这个仓库。游戏包括下列文件:

  • server.py - 处理主游戏循环和连接。
  • game.py - 主要的 Game 类。实现游戏的逻辑和游戏的大部分通信协议。
  • player.py - Player 类,包括每一个独立玩家的数据和蛇的展现。这个类负责获取玩家的输入并相应地移动蛇。
  • datatypes.py - 基本数据结构。
  • settings.py - 游戏设置,在注释中有相关的说明。
  • index.html - 客户端所有的 html 和 javascript代码都放在一个文件中。

4.2 游戏循环内窥

多人的贪吃蛇游戏是个用于学习十分好的例子,因为它简单。所有的蛇在每个帧中移动到一个位置,而且帧以非常低的频率进行变化,这样就可以让你就观察到游戏引擎到底是如何工作的。因为速度慢,对于玩家的按键不会立马响应。按键先是记录下来,然后在一个游戏循环迭代的最后计算下一帧时使用。

现代的动作游戏帧频率更高,而且通常服务端和客户端的帧频率是不相等的。客户端的帧频率通常依赖于客户端的硬件性能,而服务端的帧频率则是固定的。一个客户端可能根据一个游戏“嘀嗒”的数据渲染多个帧。这样就可以创建平滑的动画,这个受限于客户端的性能。在这个例子中,服务端不仅传输物体的当前位置,也要传输它们的移动方向、速度和加速度。客户端的帧频率称之为 FPS( 每秒帧数 ( frames per second ) ),服务端的帧频率称之为 TPS( 每秒滴答数 ( ticks per second ) )。在这个贪吃蛇游戏的例子中,二者的值是相等的,在客户端显示的一帧是在服务端的一个“嘀嗒”内计算出来的。

我们使用类似文本模式的游戏区域,事实上是 html 表格中的一个字符宽的小格。游戏中的所有对象都是通过表格中的不同颜色字符来表示。大部分时候,客户端将按键的码发送至服务端,然后每个“滴答”更新游戏区域。服务端一次更新包括需要更新字符的坐标和颜色。所以我们将所有游戏逻辑放置在服务端,只将需要渲染的数据发送给客户端。此外,我们通过替换通过网络发送的数据来减少游戏被破解的概率。

4.3 它是如何运行的?

这个游戏中的服务端出于简化的目的,它和例子 3.2 类似。但是我们用一个所有服务端都可访问的 Game 对象来代替之前保存了所有已连接 websocket 的全局列表。一个 Game 实例包括一个表示连接到此游戏的玩家的 Player 对象的列表(在 self._players 属性里面),以及他们的个人数据和 websocket 对象。将所有游戏相关的数据存储在一个 Game 对象中,会方便我们增加多个游戏房间这个功能——如果我们要增加这个功能的话。这样,我们维护多个 Game 对象,每个游戏开始时创建一个。

客户端和服务端的所有交互都是通过编码成 json 的消息来完成。来自客户端的消息仅包含玩家所按下键码对应的编号。其它来自客户端消息使用如下格式:

[command, arg1, arg2, ... argN ]

来自服务端的消息以列表的形式发送,因为通常一次要发送多个消息 (大多数情况下是渲染的数据):

[[command, arg1, arg2, ... argN ], ... ]

在每次游戏循环迭代的最后会计算下一帧,并且将数据发送给所有的客户端。当然,每次不是发送完整的帧,而是发送两帧之间的变化列表。

注意玩家连接上服务端后不是立马加入游戏。连接开始时是 观望者 ( spectator ) 模式,玩家可以观察其它玩家如何玩游戏。如果游戏已经开始或者上一个游戏会话已经在屏幕上显示 “game over” (游戏结束),用户此时可以按下 “Join”(参与),来加入一个已经存在的游戏,或者如果游戏没有运行(没有其它玩家)则创建一个新的游戏。后一种情况下,游戏区域在开始前会被先清空。

游戏区域存储在 Game._field 这个属性中,它是由嵌套列表组成的二维数组,用于内部存储游戏区域的状态。数组中的每一个元素表示区域中的一个小格,最终小格会被渲染成 html 表格的格子。它有一个 Char 的类型,是一个 namedtuple ,包括一个字符和颜色。在所有连接的客户端之间保证游戏区域的同步很重要,所以所有游戏区域的更新都必须依据发送到客户端的相应的信息。这是通过 Game.apply_render() 来实现的。它接受一个 Draw 对象的列表,其用于内部更新游戏区域和发送渲染消息给客户端。

我们使用 namedtuple 不仅因为它表示简单数据结构很方便,也因为用它生成 json 格式的消息时相对于 dict 更省空间。如果你在一个真实的游戏循环中需要发送复杂的数据结构,建议先将它们序列化成一个简单的、更短的格式,甚至打包成二进制格式(例如 bson,而不是 json),以减少网络传输。

Player 对象包括用 deque 对象表示的蛇。这种数据类型和 list 相似,但是在两端增加和删除元素时效率更高,用它来表示蛇很理想。它的主要方法是 Player.render_move(),它返回移动玩家的蛇至下一个位置的渲染数据。一般来说它在新的位置渲染蛇的头部,移除上一帧中表示蛇的尾巴的元素。如果蛇吃了一个数字变长了,在相应的多个帧中尾巴是不需要移动的。蛇的渲染数据在主类的 Game.next_frame() 中使用,该方法中实现所有的游戏逻辑。这个方法渲染所有蛇的移动,检查每一个蛇前面的障碍物,而且生成数字和“石头”。每一个“嘀嗒”,game_loop() 都会直接调用它来生成下一帧。

如果蛇头前面有障碍物,在 Game.next_frame() 中会调用 Game.game_over()。它后通知所有的客户端那个蛇死掉了 (会调用 player.render_game_over() 方法将其变成石头),然后更新表中的分数排行榜。Player 对象的 alive 标记被置为 False,当渲染下一帧时,这个玩家会被跳过,除非他重新加入游戏。当没有蛇存活时,游戏区域会显示 “game over” (游戏结束)。而且,主游戏循环会停止,设置 game.running 标记为 False。当某个玩家下次按下 “Join” (加入)时,游戏区域会被清空。

在渲染游戏的每个下一帧时也会产生数字和石头,它们是由随机值决定的。产生数字或者石头的概率可以在 settings.py 中修改成其它值。注意数字的产生是针对游戏区域每一个活的蛇的,所以蛇越多,产生的数字就越多,这样它们都有足够的食物来吃掉。

4.4 网络协议

从客户端发送消息的列表:

命令参数描述
new\_player[name]设置玩家的昵称
join 玩家加入游戏

从服务端发送消息的列表:

命令参数描述
handshake[id]给一个玩家指定 ID
world[[(char, color), ...], ...]初始化游戏区域(世界地图)
reset\_world 清除实际地图,替换所有字符为空格
render[x, y, char, color]在某个位置显示字符
p\_joined[id, name, color, score]新玩家加入游戏
p\_gameover[id]某个玩家游戏结束
p\_score[id, score]给某个玩家计分
top\_scores[[name, score, color], ...]更新排行榜

典型的消息交换顺序:

客户端 -> 服务端服务端 -> 客户端服务端 -> 所有客户端备注
new\_player 名字传递给服务端
handshake 指定 ID
world 初始化传递的世界地图
top\_scores 收到传递的排行榜
join 玩家按下“Join”,游戏循环开始
reset\_world命令客户端清除游戏区域
render, render, ...第一个游戏“滴答”,渲染第一帧
(key code) 玩家按下一个键
render, render, ...渲染第二帧
p\_score蛇吃掉了一个数字
render, render, ...渲染第三帧
... 重复若干帧 ...
p\_gameover试着吃掉障碍物时蛇死掉了
top\_scores更新排行榜(如果需要更新的话)

5. 总结

说实话,我十分享受 Python 最新的异步特性。新的语法做了改善,所以异步代码很容易阅读。可以明显看出哪些调用是非阻塞的,什么时候发生 greenthread 的切换。所以现在我可以宣称 Python 是异步编程的好工具。

SnakePit 在 7WebPages 团队中非常受欢迎。如果你在公司想休息一下,不要忘记给我们在 Twitter 或者 Facebook 留下反馈。


via: https://7webpages.com/blog/writing-online-multiplayer-game-with-python-and-asyncio-part-3/

作者:Kyrylo Subbotin 译者:chunyang-wen 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出
(题图来自:wallpaperinhd.net-wallpaper.html))

你在 Python 中用过异步编程吗?本文中我会告诉你怎样做,而且用一个能工作的例子来展示它:这是一个流行的贪吃蛇游戏,而且是为多人游戏而设计的。

介绍和理论部分参见“第一部分 异步化”。

3、编写游戏循环主体

游戏循环是每一个游戏的核心。它持续地运行以读取玩家的输入、更新游戏的状态,并且在屏幕上渲染游戏结果。在在线游戏中,游戏循环分为客户端和服务端两部分,所以一般有两个循环通过网络通信。通常客户端的角色是获取玩家输入,比如按键或者鼠标移动,将数据传输给服务端,然后接收需要渲染的数据。服务端处理来自玩家的所有数据,更新游戏的状态,执行渲染下一帧的必要计算,然后将结果传回客户端,例如游戏中对象的新位置。如果没有可靠的理由,不混淆客户端和服务端的角色是一件很重要的事。如果你在客户端执行游戏逻辑的计算,很容易就会和其它客户端失去同步,其实你的游戏也可以通过简单地传递客户端的数据来创建。

游戏循环的一次迭代称为一个 嘀嗒 ( tick ) 。嘀嗒是一个事件,表示当前游戏循环的迭代已经结束,下一帧(或者多帧)的数据已经就绪。

在后面的例子中,我们使用相同的客户端,它使用 WebSocket 从一个网页上连接到服务端。它执行一个简单的循环,将按键码发送给服务端,并显示来自服务端的所有信息。客户端代码戳这里。

例子 3.1:基本游戏循环

我们使用 aiohttp 库来创建游戏服务器。它可以通过 asyncio 创建网页服务器和客户端。这个库的一个优势是它同时支持普通 http 请求和 websocket。所以我们不用其他网页服务器来渲染游戏的 html 页面。

下面是启动服务器的方法:

app = web.Application()
app["sockets"] = []

asyncio.ensure_future(game_loop(app))

app.router.add_route('GET', '/connect', wshandler)
app.router.add_route('GET', '/', handle)

web.run_app(app)

web.run_app 是创建服务主任务的快捷方法,通过它的 run_forever() 方法来执行 asyncio 事件循环。建议你查看这个方法的源码,弄清楚服务器到底是如何创建和结束的。

app 变量就是一个类似于字典的对象,它用于在所连接的客户端之间共享数据。我们使用它来存储连接的套接字的列表。随后会用这个列表来给所有连接的客户端发送消息。asyncio.ensure_future() 调用会启动主游戏循环的任务,每隔2 秒向客户端发送嘀嗒消息。这个任务会在同样的 asyncio 事件循环中和网页服务器并行执行。

有两个网页请求处理器:handle 是提供 html 页面的处理器;wshandler 是主要的 websocket 服务器任务,处理和客户端之间的交互。在事件循环中,每一个连接的客户端都会创建一个新的 wshandler 任务。这个任务会添加客户端的套接字到列表中,以便 game_loop 任务可以给所有的客户端发送消息。然后它将随同消息回显客户端的每个击键。

在启动的任务中,我们在 asyncio 的主事件循环中启动 worker 循环。任务之间的切换发生在它们之间任何一个使用 await语句来等待某个协程结束时。例如 asyncio.sleep 仅仅是将程序执行权交给调度器一段指定的时间;ws.receive 等待 websocket 的消息,此时调度器可能切换到其它任务。

在浏览器中打开主页,连接上服务器后,试试随便按下键。它们的键值会从服务端返回,每隔 2 秒这个数字会被游戏循环中发给所有客户端的嘀嗒消息所覆盖。

我们刚刚创建了一个处理客户端按键的服务器,主游戏循环在后台做一些处理,周期性地同时更新所有的客户端。

例子 3.2: 根据请求启动游戏

在前一个例子中,在服务器的生命周期内,游戏循环一直运行着。但是现实中,如果没有一个人连接服务器,空运行游戏循环通常是不合理的。而且,同一个服务器上可能有不同的“游戏房间”。在这种假设下,每一个玩家“创建”一个游戏会话(比如说,多人游戏中的一个比赛或者大型多人游戏中的副本),这样其他用户可以加入其中。当游戏会话开始时,游戏循环才开始执行。

在这个例子中,我们使用一个全局标记来检测游戏循环是否在执行。当第一个用户发起连接时,启动它。最开始,游戏循环没有执行,标记设置为 False。游戏循环是通过客户端的处理方法启动的。

  if app["game_is_running"] == False:
        asyncio.ensure_future(game_loop(app))

当 game_loop() 运行时,这个标记设置为 True;当所有客户端都断开连接时,其又被设置为 False。

例子 3.3:管理任务

这个例子用来解释如何和任务对象协同工作。我们把游戏循环的任务直接存储在游戏循环的全局字典中,代替标记的使用。在像这样的一个简单例子中并不一定是最优的,但是有时候你可能需要控制所有已经启动的任务。

    if app["game_loop"] is None or \
       app["game_loop"].cancelled():
        app["game_loop"] = asyncio.ensure_future(game_loop(app))

这里 ensure_future() 返回我们存放在全局字典中的任务对象,当所有用户都断开连接时,我们使用下面方式取消任务:

    app["game_loop"].cancel()

这个 cancel() 调用将通知调度器不要向这个协程传递执行权,而且将它的状态设置为已取消:cancelled,之后可以通过 cancelled() 方法来检查是否已取消。这里有一个值得一提的小注意点:当你持有一个任务对象的外部引用时,而这个任务执行中发生了异常,这个异常不会抛出。取而代之的是为这个任务设置一个异常状态,可以通过 exception() 方法来检查是否出现了异常。这种悄无声息地失败在调试时不是很有用。所以,你可能想用抛出所有异常来取代这种做法。你可以对所有未完成的任务显式地调用 result() 来实现。可以通过如下的回调来实现:

    app["game_loop"].add_done_callback(lambda t: t.result())

如果我们打算在我们代码中取消这个任务,但是又不想产生 CancelError 异常,有一个检查 cancelled 状态的点:

    app["game_loop"].add_done_callback(lambda t: t.result()
                                       if not t.cancelled() else None)

注意仅当你持有任务对象的引用时才需要这么做。在前一个例子,所有的异常都是没有额外的回调,直接抛出所有异常。

例子 3.4:等待多个事件

在许多场景下,在客户端的处理方法中你需要等待多个事件的发生。除了来自客户端的消息,你可能需要等待不同类型事件的发生。比如,如果你的游戏时间有限制,那么你可能需要等一个来自定时器的信号。或者你需要使用管道来等待来自其它进程的消息。亦或者是使用分布式消息系统的网络中其它服务器的信息。

为了简单起见,这个例子是基于例子 3.1。但是这个例子中我们使用 Condition 对象来与已连接的客户端保持游戏循环的同步。我们不保存套接字的全局列表,因为只在该处理方法中使用套接字。当游戏循环停止迭代时,我们使用 Condition.notify_all() 方法来通知所有的客户端。这个方法允许在 asyncio 的事件循环中使用发布/订阅的模式。

为了等待这两个事件,首先我们使用 ensure_future() 来封装任务中这个可等待对象。

    if not recv_task:
        recv_task = asyncio.ensure_future(ws.receive())
    if not tick_task:
        await tick.acquire()
        tick_task = asyncio.ensure_future(tick.wait())

在我们调用 Condition.wait() 之前,我们需要在它后面获取一把锁。这就是我们为什么先调用 tick.acquire() 的原因。在调用 tick.wait() 之后,锁会被释放,这样其他的协程也可以使用它。但是当我们收到通知时,会重新获取锁,所以在收到通知后需要调用 tick.release() 来释放它。

我们使用 asyncio.wait() 协程来等待两个任务。

    done, pending = await asyncio.wait(
        [recv_task,
         tick_task],
        return_when=asyncio.FIRST_COMPLETED)

程序会阻塞,直到列表中的任意一个任务完成。然后它返回两个列表:执行完成的任务列表和仍然在执行的任务列表。如果任务执行完成了,其对应变量赋值为 None,所以在下一个迭代时,它可能会被再次创建。

例子 3.5: 结合多个线程

在这个例子中,我们结合 asyncio 循环和线程,在一个单独的线程中执行主游戏循环。我之前提到过,由于 GIL 的存在,Python 代码的真正并行执行是不可能的。所以使用其它线程来执行复杂计算并不是一个好主意。然而,在使用 asyncio 时结合线程有原因的:当我们使用的其它库不支持 asyncio 时就需要。在主线程中调用这些库会阻塞循环的执行,所以异步使用他们的唯一方法是在不同的线程中使用他们。

我们使用 asyncio 循环的run_in_executor() 方法和 ThreadPoolExecutor 来执行游戏循环。注意 game_loop() 已经不再是一个协程了。它是一个由其它线程执行的函数。然而我们需要和主线程交互,在游戏事件到来时通知客户端。asyncio 本身不是线程安全的,它提供了可以在其它线程中执行你的代码的方法。普通函数有 call_soon_threadsafe(),协程有 run_coroutine_threadsafe()。我们在 notify() 协程中增加了通知客户端游戏的嘀嗒的代码,然后通过另外一个线程执行主事件循环。

def game_loop(asyncio_loop):
    print("Game loop thread id {}".format(threading.get_ident()))
    async def notify():
        print("Notify thread id {}".format(threading.get_ident()))
        await tick.acquire()
        tick.notify_all()
        tick.release()

    while 1:
        task = asyncio.run_coroutine_threadsafe(notify(), asyncio_loop)
        # blocking the thread
        sleep(1)
        # make sure the task has finished
        task.result()

当你执行这个例子时,你会看到 “Notify thread id” 和 “Main thread id” 相等,因为 notify() 协程在主线程中执行。与此同时 sleep(1) 在另外一个线程中执行,因此它不会阻塞主事件循环。

例子 3.6:多进程和扩展

单线程的服务器可能运行得很好,但是它只能使用一个 CPU 核。为了将服务扩展到多核,我们需要执行多个进程,每个进程执行各自的事件循环。这样我们需要在进程间交互信息或者共享游戏的数据。而且在一个游戏中经常需要进行复杂的计算,例如路径查找之类。这些任务有时候在一个游戏嘀嗒中没法快速完成。在协程中不推荐进行费时的计算,因为它会阻塞事件的处理。在这种情况下,将这个复杂任务交给其它并行执行的进程可能更合理。

最简单的使用多个核的方法是启动多个使用单核的服务器,就像之前的例子中一样,每个服务器占用不同的端口。你可以使用 supervisord 或者其它进程控制的系统。这个时候你需要一个像 HAProxy 这样的负载均衡器,使得连接的客户端分布在多个进程间。已经有一些可以连接 asyncio 和一些流行的消息及存储系统的适配系统。例如:

你可以在 github 或者 pypi 上找到其它的软件包,大部分以 aio 开头。

使用网络服务在存储持久状态和交换某些信息时可能比较有效。但是如果你需要进行进程间通信的实时处理,它的性能可能不足。此时,使用标准的 unix 管道可能更合适。asyncio 支持管道,在aiohttp仓库有个 使用管道的服务器的非常底层的例子。

在当前的例子中,我们使用 Python 的高层类库 multiprocessing 来在不同的核上启动复杂的计算,使用 multiprocessing.Queue 来进行进程间的消息交互。不幸的是,当前的 multiprocessing 实现与 asyncio 不兼容。所以每一个阻塞方法的调用都会阻塞事件循环。但是此时线程正好可以起到帮助作用,因为如果在不同线程里面执行 multiprocessing 的代码,它就不会阻塞主线程。所有我们需要做的就是把所有进程间的通信放到另外一个线程中去。这个例子会解释如何使用这个方法。和上面的多线程例子非常类似,但是我们从线程中创建的是一个新的进程。

def game_loop(asyncio_loop):
    # coroutine to run in main thread
    async def notify():
        await tick.acquire()
        tick.notify_all()
        tick.release()

    queue = Queue()

    # function to run in a different process
    def worker():
        while 1:
            print("doing heavy calculation in process {}".format(os.getpid()))
            sleep(1)
            queue.put("calculation result")

    Process(target=worker).start()

    while 1:
        # blocks this thread but not main thread with event loop
        result = queue.get()
        print("getting {} in process {}".format(result, os.getpid()))
        task = asyncio.run_coroutine_threadsafe(notify(), asyncio_loop)
        task.result()

这里我们在另外一个进程中运行 worker() 函数。它包括一个执行复杂计算并把计算结果放到 queue 中的循环,这个 queue 是 multiprocessing.Queue 的实例。然后我们就可以在另外一个线程的主事件循环中获取结果并通知客户端,就和例子 3.5 一样。这个例子已经非常简化了,它没有合理的结束进程。而且在真实的游戏中,我们可能需要另外一个队列来将数据传递给 worker。

有一个项目叫 aioprocessing,它封装了 multiprocessing,使得它可以和 asyncio 兼容。但是实际上它只是和上面例子使用了完全一样的方法:从线程中创建进程。它并没有给你带来任何方便,除了它使用了简单的接口隐藏了后面的这些技巧。希望在 Python 的下一个版本中,我们能有一个基于协程且支持 asyncio 的 multiprocessing 库。

注意!如果你从主线程或者主进程中创建了一个不同的线程或者子进程来运行另外一个 asyncio 事件循环,你需要显式地使用 asyncio.new_event_loop() 来创建循环,不然的话可能程序不会正常工作。

via: https://7webpages.com/blog/writing-online-multiplayer-game-with-python-and-asyncio-writing-game-loop/

作者:Kyrylo Subbotin 译者:chunyang-wen 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出
(题图来自:deviantart.com)