分类 容器与云 下的文章

探索 Kubernetes 中不同容器日志记录模式的工作原理。

 title=

服务器和应用程序日志记录是开发人员、运维人员和安全团队了解应用程序在其生产环境中运行状态的重要工具。

日志记录使运维人员能够确定应用程序和所需组件是否运行平稳,并检测是否发生了异常情况,以便他们能够对这种情况做出反应。

对于开发人员,日志记录提供了在开发期间和之后对代码进行故障排除的可见性。在生产环境中,开发人员通常依赖于没有调试工具的日志记录工具。在加上系统的日志记录,开发人员可以与运维人员携手合作,有效地解决问题。

日志记录工具最重要的受益者是安全团队,尤其是在云原生的环境中。能够从应用程序和系统日志中收集信息使得安全团队能够分析来自身份验证、应用程序访问恶意软件活动的数据,并在需要时进行响应。

Kubernetes 是领先的容器平台,越来越多的应用程序通过 Kubernetes 部署到生产环境。我相信了解 Kubernetes 的日志架构是一项非常重要的工作,每个开发、运维和安全团队都需要认真对待。

在本文中,我将讨论 Kubernetes 中不同容器日志记录模式的工作原理。

系统日志记录和应用日志记录

在深入研究 Kubernetes 日志记录架构之前,我想探索不同的日志记录方法以及这两种功能如何成为 Kubernetes 日志记录的关键特性。

有两种类型的系统组件:在容器中运行的组件和不在容器中运行的组件。例如:

  • Kubernetes 调度者和 kube-proxy 运行在容器中。
  • kubelet 和容器运行时不在容器中运行。

与容器日志类似,系统容器日志存储在 /var/log 目录中,你应该定期轮换它们。

在这里,我研究的是容器日志记录。首先,我看一下集群级别的日志记录以及为什么它对集群运维人员很重要。集群日志提供有关集群如何执行的信息。诸如为什么 吊舱 Pod 被下线或节点死亡之类的信息。集群日志记录还可以捕获诸如集群和应用程序访问以及应用程序如何利用计算资源等信息。总体而言,集群日志记录工具为集群运维人员提供操作集群和安全有用的信息。

捕获容器日志的另一种方法是通过应用程序的本机日志记录工具。现代应用程序设计很可能具有日志记录机制,可帮助开发人员通过标准输出 (stdout) 和错误流 (stderr) 解决应用程序性能问题。

为了拥有有效的日志记录工具,Kubernetes 实现需要应用程序和系统日志记录组件。

Kubernetes 容器日志的 3 种类型

如今,在大多数的 Kubernetes 实现中,你可以看到三种主要的集群级日志记录方法。

  1. 节点级日志代理
  2. 用于日志记录的 挎斗 Sidecar 容器应用程序
  3. 将应用程序日志直接暴露给日志后端

节点级日志代理

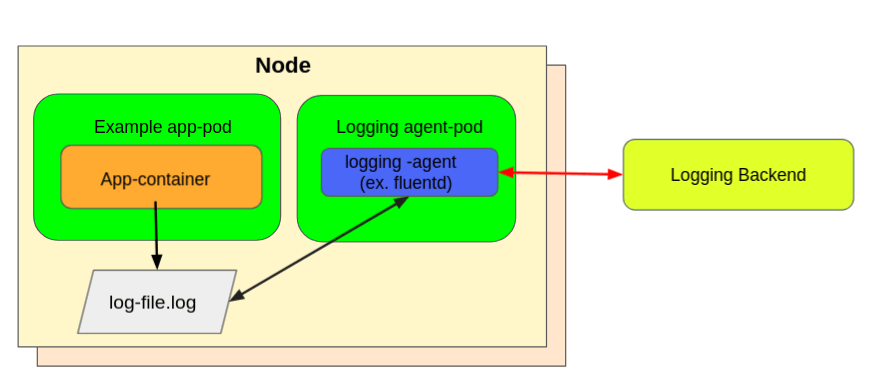
我想考虑节点级日志代理。你通常使用 DaemonSet 作为部署策略来实现这些,以便在所有 Kubernetes 节点中部署一个吊舱(充当日志代理)。然后,该日志代理被配置为从所有 Kubernetes 节点读取日志。你通常将代理配置为读取节点 /var/logs 目录捕获 stdout/stderr 流并将其发送到日志记录后端存储。

下图显示了在所有节点中作为代理运行的节点级日志记录。
 title=

以使用 fluentd 方法为例设置节点级日志记录,你需要执行以下操作:

1、首先,你需要创建一个名为 fluentdd 的服务账户。Fluentd 吊舱使用此服务账户来访问 Kubernetes API,你需要在日志命名空间中使用标签 app: fluentd 创建它们:

#fluentd-SA.yaml
apiVersion: v1
kind: ServiceAccount
metadata:
  name: fluentd
  namespace: logging
  labels:
    app: fluentd  

你可以在此 仓库 中查看完整示例。

2、接着,你需要创建一个名称为 fluentd-configmap 的 ConfigMap。这为 fluentd daemonset 提供了一个配置文件,其中包含所有必需的属性。

#fluentd-daemonset.yaml
apiVersion: extensions/v1beta1
kind: DaemonSet
metadata:
  name: fluentd
  namespace: logging
  labels:
    app: fluentd
    kubernetes.io/cluster-service: "true"
spec:
  selector:
    matchLabels:
      app: fluentd
      kubernetes.io/cluster-service: "true"
  template:
    metadata:
      labels:
        app: fluentd
        kubernetes.io/cluster-service: "true"
    spec:
      serviceAccount: fluentd
      containers:
      - name: fluentd
        image: fluent/fluentd-kubernetes-daemonset:v1.7.3-debian-elasticsearch7-1.0
        env:
          - name: FLUENT_ELASTICSEARCH_HOST
            value: "elasticsearch.logging.svc.cluster.local"
          - name: FLUENT_ELASTICSEARCH_PORT
            value: "9200"
          - name: FLUENT_ELASTICSEARCH_SCHEME
            value: "http"
          - name: FLUENT_ELASTICSEARCH_USER
            value: "elastic"
          - name: FLUENT_ELASTICSEARCH_PASSWORD
            valueFrom:
              secretKeyRef:
                name: efk-pw-elastic
                key: password
          - name: FLUENT_ELASTICSEARCH_SED_DISABLE
            value: "true"
        resources:
          limits:
            memory: 512Mi
          requests:
            cpu: 100m
            memory: 200Mi
        volumeMounts:
        - name: varlog
          mountPath: /var/log
        - name: varlibdockercontainers
          mountPath: /var/lib/docker/containers
          readOnly: true
        - name: fluentconfig
          mountPath: /fluentd/etc/fluent.conf
          subPath: fluent.conf
      terminationGracePeriodSeconds: 30
      volumes:
      - name: varlog
        hostPath:
          path: /var/log
      - name: varlibdockercontainers
        hostPath:
          path: /var/lib/docker/containers
      - name: fluentconfig
        configMap:
          name: fluentdconf

你可以在此 仓库 中查看完整示例。

现在,我们来看看如何将 fluentd daemonset 部署为日志代理的代码。

#fluentd-daemonset.yaml
apiVersion: extensions/v1beta1
kind: DaemonSet
metadata:
  name: fluentd
  namespace: logging
  labels:
    app: fluentd
    kubernetes.io/cluster-service: "true"
spec:
  selector:
    matchLabels:
      app: fluentd
      kubernetes.io/cluster-service: "true"
  template:
    metadata:
      labels:
        app: fluentd
        kubernetes.io/cluster-service: "true"
    spec:
      serviceAccount: fluentd
      containers:
      - name: fluentd
        image: fluent/fluentd-kubernetes-daemonset:v1.7.3-debian-elasticsearch7-1.0
        env:
          - name: FLUENT_ELASTICSEARCH_HOST
            value: "elasticsearch.logging.svc.cluster.local"
          - name: FLUENT_ELASTICSEARCH_PORT
            value: "9200"
          - name: FLUENT_ELASTICSEARCH_SCHEME
            value: "http"
          - name: FLUENT_ELASTICSEARCH_USER
            value: "elastic"
          - name: FLUENT_ELASTICSEARCH_PASSWORD
            valueFrom:
              secretKeyRef:
                name: efk-pw-elastic
                key: password
          - name: FLUENT_ELASTICSEARCH_SED_DISABLE
            value: "true"
        resources:
          limits:
            memory: 512Mi
          requests:
            cpu: 100m
            memory: 200Mi
        volumeMounts:
        - name: varlog
          mountPath: /var/log
        - name: varlibdockercontainers
          mountPath: /var/lib/docker/containers
          readOnly: true
        - name: fluentconfig
          mountPath: /fluentd/etc/fluent.conf
          subPath: fluent.conf
      terminationGracePeriodSeconds: 30
      volumes:
      - name: varlog
        hostPath:
          path: /var/log
      - name: varlibdockercontainers
        hostPath:
          path: /var/lib/docker/containers
      - name: fluentconfig
        configMap:
          name: fluentdconf

将这些放在一起执行:

kubectl apply -f fluentd-SA.yaml \
              -f fluentd-configmap.yaml \
              -f fluentd-daemonset.yaml

用于日志记录的挎斗容器应用程序

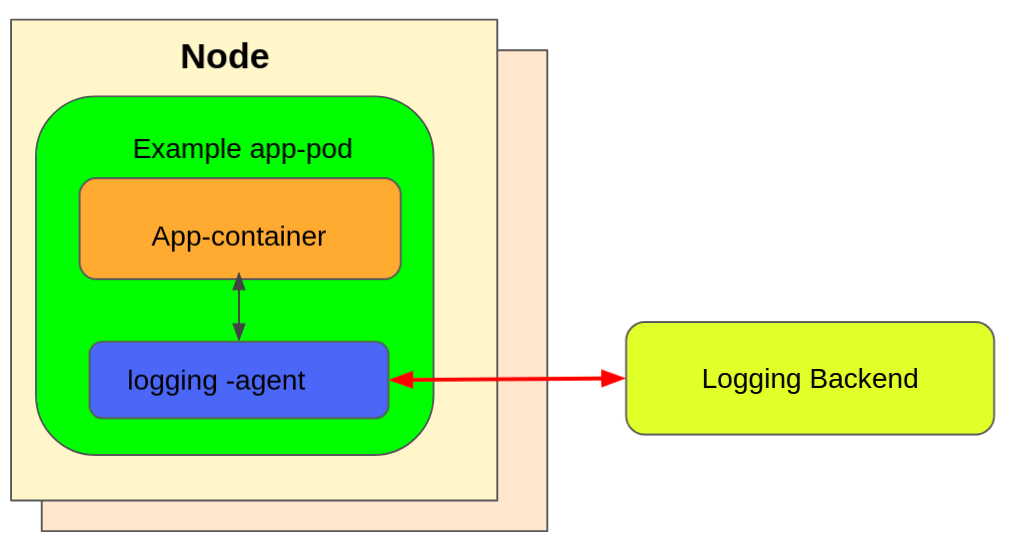
另一种方法是使用带有日志代理的专用挎斗容器。容器最常见的实现是使用 Fluentd 作为日志收集器。在企业部署中(你无需担心一点计算资源开销),使用 fluentd(或类似)实现的挎斗容器提供了集群级日志记录的灵活性。这是因为你可以根据需要捕获的日志类型、频率和其它可能的调整来调整和配置收集器代理。

下图展示了作为日志代理的挎斗容器。
 title=

例如,一个吊舱运行单个容器,容器使用两种不同的格式写入两个不同的日志文件。吊舱的配置文件如下:

#log-sidecar.yaml
apiVersion: v1
kind: Pod
metadata:
  name: counter
spec:
  containers:
  - name: count
    image: busybox
    args:
   - /bin/sh
    - -c
    - >
     i=0;
      while true;
      do
        echo "$i: $(date)" >> /var/log/1.log;
        echo "$(date) INFO $i" >> /var/log/2.log;
        i=$((i+1));
        sleep 1;
      done
    volumeMounts:
    - name: varlog
      mountPath: /var/log
  - name: count-log
    image: busybox
    args: [/bin/sh, -c, 'tail -n+1 -f /var/log/1.log']
    volumeMounts:
    - name: varlog
      mountPath: /var/log
  volumes:
  - name: varlog
    emptyDir: {}

把它们放在一起,你可以运行这个吊舱:

$ kubectl apply -f log-sidecar.yaml

要验证挎斗容器是否用作日志代理,你可以执行以下操作:

$ kubectl logs counter count-log

预期的输出如下所示:

$ kubectl logs counter count-log-1

Thu 04 Nov 2021 09:23:21 NZDT
Thu 04 Nov 2021 09:23:22 NZDT
Thu 04 Nov 2021 09:23:23 NZDT
Thu 04 Nov 2021 09:23:24 NZDT

将应用程序日志直接暴露给日志后端

第三种方法(在我看来)是 Kubernetes 容器和应用程序日志最灵活的日志记录解决方案,是将日志直接推送到日志记录后端解决方案。尽管此模式不依赖于原生 Kubernetes 功能,但它提供了大多数企业需要的灵活性,例如:

  1. 扩展对网络协议和输出格式的更广泛支持。
  2. 提供负载均衡能力并提高性能。
  3. 可配置为通过上游聚合接受复杂的日志记录要求。

因为这第三种方法通过直接从每个应用程序推送日志来依赖非 Kubernetes 功能,所以它超出了 Kubernetes 的范围。

结论

Kubernetes 日志记录工具是企业部署 Kubernetes 集群的一个非常重要的组件。我讨论了三种可能的可用模式。你需要找到适合你需求的模式。

如上所述,使用 daemonset 的节点级日志记录是最容易使用的部署模式,但它也有一些限制,可能不适合你的组织的需要。另一方面,挎斗 模式提供了灵活性和自定义,允许你自定义要捕获的日志类型,但是会提高计算机的资源开销。最后,将应用程序日志直接暴露给后端日志工具是另一种允许进一步定制的诱人方法。

选择在你,你只需要找到适合你组织要求的方法。


via: https://opensource.com/article/21/11/cluster-logging-kubernetes

作者:Mike Calizo 选题:lujun9972 译者:perfiffer 校对:wxy
本文由 LCTT 原创编译,Linux中国 荣誉推出

复制控制器负责管理吊舱的生命周期并确保在任何时候运行着所需的指定数量的吊舱。

 title=

你有没有想过,谁负责监督和管理 Kubernetes 集群内运行的“ 吊舱 pod ”的确切数量?Kubernetes 可以通过多种方式做到这一点,但一个常见的方法是使用 “ 复制控制器 ReplicationController (RC)”。RC 负责管理吊舱的生命周期,并确保在任何时候运行着所需的指定数量的吊舱。但另一方面,它不负责高级的集群能力,如执行自动扩展、准备度和活跃探测以及其他高级的复制能力。Kubernetes 集群中的其他组件可以更好地执行这些功能。

简而言之,RC 的职责有限,通常用于不需要复杂逻辑就能达到某些要求的具体实现(例如,确保所需的吊舱数量总是与指定的数量相符)。如果超过了所需的数量,RC 会删除多余的,并确保即使在节点故障或吊舱终止的情况下,也有相同数量的存在。

简单的事情不需要复杂的解决方案,对我来说,这就是 RC 如何被使用的一个完美的比喻。

如何创建一个 RC

像大多数 Kubernetes 资源一样,你可以使用 YAML 或 JSON 格式创建一个 RC,然后将其发布到 Kubernetes API 端点。

$ kubectl create -f rcexample.yaml
 replicationcontroller/rcexample created

现在,我将深入一下 rcexample.yaml 的样子。

apiVersion: v1
kind: ReplicationController   →  RC 描述符    
metadata:
 name: rcexample            →  复制控制器名字              
spec:
 replicas: 3                 → 预期的吊舱数量      
 selector:                  → 这个 RC 的吊舱选择器
   app: nginx                        
 template:                  → 用于创建新吊舱的模板    
   metadata:                        
     labels:                        
       app: nginx                    
   spec:                            
     containers:                    
     - name: nginx                  
       image: nginx

进一步解释,这个文件在执行时创建了一个名为 rcexample 的 RC,确保三个名为 nginx 的吊舱实例一直在运行。如果一个或所有的 app=nginx 吊舱没有运行,新的吊舱将根据定义的吊舱模板创建。

一个 RC 有三个部分:

  • 复制品:3
  • 吊舱模板:app=nginx
  • 吊舱选择器:app=nginx

注意,吊舱模板要与吊舱选择器相匹配,以防止 RC 一直创建吊舱。如果你创建的 RC 的吊舱选择器与模板不匹配,Kubernetes API 服务器会给你一个错误。

为了验证 RC rcexample 是否被创建:

$ kubectl get po
NAME     READY   STATUS       RESTARTS  AGE
rcexample-53thy  0/1  Running         0     10s
rcexample-k0xz6  0/1  Running         0     10s
rcexample-q3vkg  0/1  Running         0     10s

要删除 RC:

$ kubectl delete rc rcexample
 replicationcontroller "rcexample" deleted

注意,你可以对 RC 中的服务使用 滚动更新 策略,逐个替换吊舱。

其他复制容器的方法

在 Kubernetes 部署中,有多种方法可以实现容器的复制。Kubernetes 成为容器平台的主要选择的主要原因之一是复制容器以获得可靠性、负载平衡和扩展的原生能力。

我在上面展示了你如何轻松地创建一个 RC,以确保在任何时候都有一定数量的吊舱可用。你可以通过更新副本的数量来手动扩展吊舱。

另一种可能的方法是通过使用 “ 复制集 ReplicaSet (RS)”来达到复制的目的。

(kind: ReplicaSet)

RS 的功能几乎与 RC 相同。主要区别在于,RS 不允许滚动更新策略。

另一种实现复制的方法是通过使用 “ 部署 Deployments ”。

(kind: Deployment)

部署是一种更高级的容器复制方法。从功能上讲,部署提供了相同的功能,但在需要时可以推出和回滚变化。这种功能之所以能够实现,是因为部署有 “ 策略类型 StrategyType ” 规范来用新的吊舱替换旧的吊舱。你可以定义两种类型的部署策略:“ 重新创建 Recreate ” 和 “ 滚动更新 RollingUpdate ”。你可以如下指定部署策略:

StrategyType: RollingUpdate

总结

容器的复制功能是大多数企业考虑采用 Kubernetes 的主要原因之一。复制可以让你达到大多数关键应用程序需要的可靠性和可扩展性,作为生产的最低要求。

了解在 Kubernetes 集群中使用哪些方法来实现复制,对于决定哪种方法最适合你的应用架构考虑非常重要。


via: https://opensource.com/article/21/11/kubernetes-replicationcontroller

作者:Mike Calizo 选题:lujun9972 译者:geekpi 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

在你通过 Kubernetes 部署一个应用之前,了解 Kubernetes 的网络策略是一个基本的要求。

 title=

随着越来越多的云原生应用程序通过 Kubernetes 部署到生产环境,安全性是你必须在早期就需要考虑的一个重要检查项。在设计云原生应用程序时,预先嵌入安全策略非常重要。不这样做会导致后续的安全问题,从而导致项目延迟,并最终给你带来不必要的压力和金钱投入。

这么多年来,人们总是把安全留到最后,直到他们的部署即将发布到生产环境时才考虑安全。这种做法会导致项目交付的延迟,因为每个组织都有要遵守的安全标准,这些规定被绕过或不遵守,并承受大量的风险才得以实现可交付成果。

对于刚开始学习 Kubernetes 实施的人来说,理解 Kubernetes 网络策略 NetworkPolicy 可能会令人生畏。但这是在将应用程序部署到 Kubernetes 集群之前必须了解的基本要求之一。在学习 Kubernetes 和云原生应用程序时,请把“不要把安全抛在脑后!”定为你的口号。

NetworkPolicy 概念

网络策略 NetworkPolicy 取代了你所知道的数据中心环境中的防火墙设备 —— 如 吊舱 Pod 之于计算实例、网络插件之于路由器和交换机,以及卷之于存储区域网络(SAN)。

默认情况下,Kubernetes 网络策略允许 吊舱 Pod 从任何地方接收流量。如果你不担心吊舱的安全性,那么这可能没问题。但是,如果你正在运行关键工作负载,则需要保护吊舱。控制集群内的流量(包括入口和出口流量),可以通过网络策略来实现。

要启用网络策略,你需要一个支持网络策略的网络插件。否则,你应用的任何规则都将变得毫无用处。

Kubernetes.io 上列出了不同的网络插件:

  • CNI 插件:遵循 容器网络接口 Container Network Interface (CNI)规范,旨在实现互操作性。

    • Kubernetes 遵循 CNI 规范的 v0.4.0 版本。
  • Kubernetes 插件:使用桥接器和主机本地 CNI 插件实现基本的 cbr0。

应用网络策略

要应用网络策略,你需要一个工作中的 Kubernetes 集群,并有支持网络策略的网络插件。

但首先,你需要了解如何在 Kubernetes 的环境使用网络策略。Kubernetes 网络策略允许 吊舱 从任何地方接收流量。这并不是理想情况。为了吊舱安全,你必须了解吊舱是可以在 Kubernetes 架构内进行通信的端点。

1、使用 podSelector 进行吊舱间的通信:

 - namespaceSelector:
    matchLabels:
      project: myproject 

2、使用 namespaceSelector 和/或 podSelector 和 namespaceSelector 的组合进行命名空间之间的通信和命名空间到吊舱的通信。:

 - namespaceSelector:
    matchLabels:
      project: myproject
 - podSelector:
    matchLabels:
      role: frontend 

3、对于吊舱的 IP 块通信,使用 ipBlock 定义哪些 IP CIDR 块决定源和目的。

 - ipBlock:
        cidr: 172.17.0.0/16
        except:
        - 172.17.1.0/24 

注意吊舱、命名空间和基于 IP 的策略之间的区别。对于基于吊舱和命名空间的网络策略,使用选择器来控制流量,而对基于 IP 的网络策略,使用 IP 块(CIDR 范围)来定义控制。

把它们放在一起,一个网络策略应如下所示:

apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: test-network-policy
  namespace: default
spec:
  podSelector:
    matchLabels:
      app: backend
  policyTypes:
  - Ingress
  - Egress
  ingress:
  - from:
    - ipBlock:
        cidr: 172.17.0.0/16
        except:
        - 192.168.1.0/24
    - namespaceSelector:
        matchLabels:
          project: myproject
    - podSelector:
        matchLabels:
          role: frontend
    ports:
    - protocol: TCP
      port: 6379
  egress:
  - to:
    - ipBlock:
        cidr: 10.0.0.0/24
    ports:
    - protocol: TCP
      port: 5978

参考上面的网络策略,请注意 spec 部分。在此部分下,带有标签 app=backend 的 podSelector 是我们的网络策略的目标。简而言之,网络策略保护给定命名空间内称为 backend 的应用程序。

此部分也有 policyTypes 定义。此字段指示给定策略是否适用于选定吊舱的入口流量、选定吊舱的出口流量,或两者皆有。

spec:
  podSelector:
    matchLabels:
      app: backend
  policyTypes:
  - Ingress
  - Egress

现在,请看 Ingress(入口)和 Egress(出口)部分。该定义规定了网络策略的控制。

首先,检查 ingress from 部分。

此实例中,网络策略允许从以下位置进行吊舱连接:

  • ipBlock

    • 允许 172.17.0.0/16
    • 拒绝 192.168.1.0/24
  • namespaceSelector

    • myproject: 允许来自此命名空间并具有相同标签 project=myproject 的所有吊舱。
  • podSelector

    • frontend: 允许与标签 role=frontend 匹配的吊舱。
ingress:
 - from:
  - ipBlock:
      cidr: 172.17.0.0/16
      except:
      - 192.168.1.0/24
  - namespaceSelector:
      matchLabels:
        project: myproject
  - podSelector:
      matchLabels:
        role: frontend

现在,检查 egress to 部分。这决定了从吊舱出去的连接:

  • ipBlock

    • 10.0.0.0/24: 允许连接到此 CIDR
    • Ports: 允许使用 TCP 和端口 5978 进行连接
egress:
 - to:
  - ipBlock:
      cidr: 10.0.0.0/24
  ports:
  - protocol: TCP
    port: 5978

网络策略的限制

仅靠网络策略无法完全保护你的 Kubernetes 集群。你可以使用操作系统组件或 7 层网络技术来克服已知限制。你需要记住,网络策略只能解决 IP 地址和端口级别的安全问题 —— 即开放系统互联(OSI)中的第 3 层或第 4 层。

为了解决网络策略无法处理的安全要求,你需要使用其它安全解决方案。以下是你需要知道的一些 用例,在这些用例中,网络策略需要其他技术的增强。

总结

了解 Kubernetes 的网络策略很重要,因为它是实现(但不是替代)你通常在数据中心设置中使用的防火墙角色的一种方式,但适用于 Kubernetes。将此视为容器安全的第一层,仅仅依靠网络策略并不是一个完整的安全解决方案。

网络策略使用选择器和标签在吊舱和命名空间上实现安全性。此外,网络策略还可以通过 IP 范围实施安全性。

充分理解网络策略是在 Kubernetes 环境中安全采用容器化的一项重要技能。


via: https://opensource.com/article/21/10/kubernetes-networkpolicy

作者:Mike Calizo 选题:lujun9972 译者:perfiffer 校对:wxy
本文由 LCTT 原创编译,Linux中国 荣誉推出

Vagrant 可以帮助你在你的电脑上运行其他操作系统,这意味着你可以构建、测试、疯狂折腾而不毁坏你的系统。

 title=

我使用 Vagrant 已经很长时间了。我使用几种 DevOps 工具,把它们全安装在一个系统上会搞得很乱。Vagrant 可以让你在不破坏系统的情况下随意折腾,因为你根本不需要在生产系统上做实验。

如果你熟悉 VirtualBox 或 GNOME Boxes,那么学习 Vagrant 很容易。Vagrant 有一个简单而干净的界面用于管理虚拟机。一个名为 Vagrantfile 的配置文件,允许你定制你的虚拟机(称为 “Vagrant 盒子 box ”)。一个简单的命令行界面让你启动、停止、暂停或销毁你的“盒子”。

考虑一下这个简单的例子。

假设你想写 Ansible 或 shell 脚本,在一个新的服务器上安装 Nginx。你不能在你自己的系统上这样做,因为你运行的可能不是你想测试的操作系统,或者没有所有的依赖项。启动新的云服务器进行测试可能会很费时和昂贵。这就是 Vagrant 派上用处的地方。你可以用它来启动一个虚拟机,用你的脚本来 配备 provision 它,并证明一切按预期工作。然后,你可以删除这个“盒子”,重新配备它,并重新运行你的脚本来验证它。你可以多次重复这个过程,直到你确信你的脚本在所有条件下都能工作。你可以将你的 Vagrantfile 提交给 Git,以确保你的团队正在测试完全相同的环境(因为他们将使用完全相同的测试机)。不会再有“但它在我的机器上运行良好!”这事了。

开始使用

首先,在你的系统上安装 Vagrant,然后创建一个新的文件夹进行实验。在这个新文件夹中,创建一个名为 Vagrantfile 的新文件,内容如下:

Vagrant.configure("2") do |config|

 config.vm.box = "ubuntu/hirsute64"

end

你也可以运行 vagrant init ubuntu/hirsute64,它将为你生成一个新的 Vagrant 文件。现在运行 vagrant up。这个命令将从 Vagrant 仓库中下载 ubuntu/hirsuite64 镜像。

Bringing machine 'default' up with 'virtualbox' provider...
==> default: Importing base box 'ubuntu/hirsute64'...
==> default: Matching MAC address for NAT networking...
==> default: Checking if box 'ubuntu/hirsute64' version '20210820.0.0' is up to date...
==> default: Setting the name of the VM: a_default_1630204214778_76885
==> default: Clearing any previously set network interfaces...
==> default: Preparing network interfaces based on configuration...
    default: Adapter 1: nat
    default: Adapter 2: hostonly
==> default: Forwarding ports...
    default: 22 (guest) => 2222 (host) (adapter 1)
==> default: Running 'pre-boot' VM customizations...
==> default: Booting VM...
==> default: Waiting for machine to boot. This may take a few minutes...
    default: SSH address: 127.0.0.1:2222
    default: SSH username: vagrant
    default: SSH auth method: private key
    default: Warning: Remote connection disconnect. Retrying...
    default: Warning: Connection reset. Retrying...
    default:
    default: Vagrant insecure key detected. Vagrant will automatically replace
    default: this with a newly generated keypair for better security.
    default:
    default: Inserting generated public key within guest...
    default: Removing insecure key from the guest if it's present...
    default: Key inserted! Disconnecting and reconnecting using new SSH key...
==> default: Machine booted and ready!

此时,如果你打开你的 Vagrant 后端(如 VirtualBox 或 virt-manager),你会看到你的“盒子”已经有了。接下来,运行 vagrant ssh 登录到“盒子”。如果你能看到 Vagrant 的提示符,那么你就进入了!

~ vagrant ssh
Welcome to Ubuntu 21.04 (GNU/Linux 5.11.0-31-generic x86_64)

* Documentation: <https://help.ubuntu.com>
* Management:   <https://landscape.canonical.com>
* Support:    <https://ubuntu.com/advantage>

 System information as of Sun Aug 29 02:33:51 UTC 2021

 System load: 0.01       Processes:        110
 Usage of /:  4.1% of 38.71GB  Users logged in:     0
 Memory usage: 17%        IPv4 address for enp0s3: 10.0.2.15
 Swap usage:  0%        IPv4 address for enp0s8: 192.168.1.20

0 updates can be applied immediately.

vagrant@ubuntu-hirsute:~$

Vagrant 使用“基础盒子”来建立你的本地机器。在我们的例子中,Vagrant 从 Hashicorp 的 Vagrant 目录下载 ubuntu/hirsuite64 镜像,并插入 VirtualBox 来创建实际的“盒子”。

共享文件夹

Vagrant 将你的当前文件夹映射到 Vagrant “盒子”中的 /vagrant。这允许你在你的系统和“盒子”里保持文件同步。这很适合测试 Nginx 网站,通过将你的文件根目录指向 /vagrant。你可以使用 IDE 进行修改,“盒子”里的 Nginx 会提供这些修改。

Vagrant 命令

有几个 Vagrant 命令,你可以用它们来控制你的“盒子”。

其中一些重要的命令是:

  • vagrant up:启动一个“盒子”。
  • vagrant status:显示当前“盒子”的状态。
  • vagrant suspend:暂停当前的“盒子”。
  • vagrant resume:恢复当前的“盒子”。
  • vagrant halt:关闭当前的“盒子”。
  • vagrant destroy:销毁当前的“盒子”。通过运行此命令,你将失去存储在“盒子”上的任何数据。
  • vagrant snapshot:对当前的“盒子”进行快照。

试试 Vagrant

Vagrant 是一个使用 DevOps 原则进行虚拟机管理的工具,久经时间考验。配置你的测试机,与你的团队分享配置,并在一个可预测和可重复的环境中测试你的项目。如果你正在开发软件,那么通过使用 Vagrant 进行测试,你将为你的用户提供良好的服务。如果你不开发软件,但你喜欢尝试新版本的操作系统,那么没有比这更简单的方法了。今天就试试 Vagrant 吧!

这篇文章最初发表在 作者的个人博客 上,经许可后被改编。


via: https://opensource.com/article/21/9/test-vagrant

作者:Ayush Sharma 选题:lujun9972 译者:geekpi 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

Lima 可以帮助克服在 Mac 上运行容器的挑战。

 title=

在你的 Mac 上运行容器可能是一个挑战。毕竟,容器是基于 Linux 特有的技术,如控制组和命名空间。

幸运的是,macOS 拥有一个内置的 虚拟机监控程序 hypervisor ,允许在 Mac 上运行虚拟机(VM)。虚拟机监控程序是一个底层的内核功能,而不是一个面向用户的功能。

hyperkit 是一个可以使用 macOS 虚拟机监控程序运行虚拟机的 开源项目。hyperkit 被设计成一个“极简化”的虚拟机运行器。与 VirtualBox 不同,它没有花哨的 UI 功能来管理虚拟机。

你可以获取 hyperkit,这是一个运行容器管理器的极简 Linux 发行版,并将所有部分组合在一起。但这将有很多变动组件,且听起来像有很多工作。特别是如果你想通过使用 vpnkit (一个开源项目,用于创建感觉更像是主机网络一部分的虚拟机网络)使网络连接更加无缝。

Lima

当 lima 项目 已经解决了这些细节问题时,就没有理由再去做这些努力了。让 lima 运行的最简单方法之一是使用 Homebrew。你可以用这个命令安装 lima:

$ brew install lima

安装后,可能需要一些时间,就享受一些乐趣了。为了让 lima 知道你已经准备好了,你需要启动它。下面是命令:

$ limactl start

如果这是你第一次运行,你会被问到是否喜欢默认值,或者是否要改变其中的任何一项。默认值是非常安全的,但我喜欢生活在疯狂的一面。这就是为什么我跳进一个编辑器,从以下地方进行修改:

- location: "~"
  # CAUTION: `writable` SHOULD be false for the home directory.
  # Setting `writable` to true is possible but untested and dangerous.
  writable: false

变成:

 - location: "~"
  # I *also* like to live dangerously -- Austin Powers
  writable: true

正如评论中所说,这可能是危险的。可悲的是,许多现有的工作流程都依赖于挂载是可读写的。

默认情况下,lima 运行 containerd 来管理容器。containerd 管理器也是一个非常简洁的管理器。虽然使用一个包装的守护程序,如 dockerd,来增加这些漂亮的工效是很常见的,但也有另一种方法。

nerdctl 工具

nerdctl 工具是 Docker 客户端的直接替换,它将这些功能放在客户端,而不是服务器上。lima 工具允许无需在本地安装就可以直接从虚拟机内部运行 nerdctl。

做完这些后,可以运行一个容器了!这个容器将运行一个 HTTP 服务器。你可以在你的 Mac 上创建这些文件:

$ ls
index.html
$ cat index.html
hello

现在,挂载并转发端口:

$ lima nerdctl run --rm -it -p 8000:8000 -v $(pwd):/html --entrypoint bash python
root@9486145449ab:/#

在容器内,运行一个简单的 Web 服务器:

$ lima nerdctl run --rm -it -p 8000:8000 -v $(pwd):/html --entrypoint bash python
root@9486145449ab:/# cd /html/
root@9486145449ab:/html# python -m http.server 8000
Serving HTTP on 0.0.0.0 port 8000 (<http://0.0.0.0:8000/>) ...

在另一个终端,你可以检查一切看起来都很好:

$ curl localhost:8000
hello

回到容器上,有一条记录 HTTP 客户端连接的日志信息:

10.4.0.1 - - [09/Sep/2021 14:59:08] "GET / HTTP/1.1" 200 -

一个文件是不够的,所以还要做些优化。 在服务器上执行 CTRL-C,并添加另一个文件:

^C
Keyboard interrupt received, exiting.
root@9486145449ab:/html# echo goodbye &gt; foo.html
root@9486145449ab:/html# python -m http.server 8000
Serving HTTP on 0.0.0.0 port 8000 (http://0.0.0.0:8000/) ...

检查你是否能看到新的文件:

$ curl localhost:8000/foo.html
goodbye

总结

总结一下,安装 lima 需要一些时间,但完成后,你可以做以下事情:

  • 运行容器。
  • 将你的主目录中的任意子目录挂载到容器中。
  • 编辑这些目录中的文件。
  • 运行网络服务器,在 Mac 程序看来,它们是在 localhost 上运行的。

这些都是通过 lima nerdctl 实现的。


via: https://opensource.com/article/21/9/run-containers-mac-lima

作者:Moshe Zadka 选题:lujun9972 译者:geekpi 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

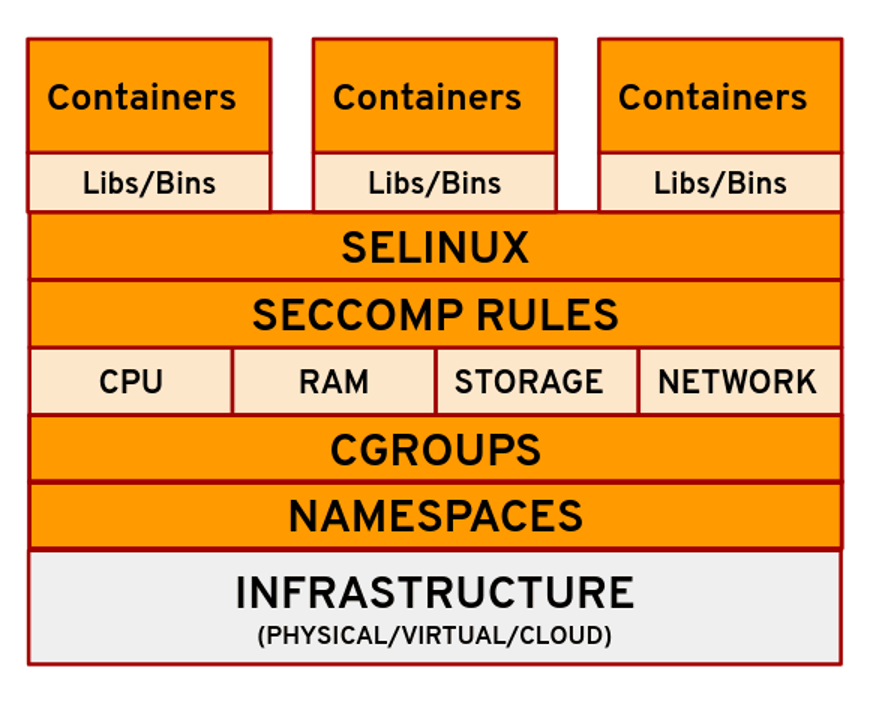
命名空间、控制组、seccomp 和 SELinux 构成了在系统上构建和运行一个容器进程的 Linux 技术基础。

 title=

在以前的文章中,我介绍过 容器镜像 及其 运行时。在本文中,我研究了容器是如何在一些特殊的 Linux 技术基础上实现的,这其中包括命名空间和控制组。

 title=

图1:对容器有贡献的 Linux 技术(Nived Velayudhan, CC BY-SA 4.0)

这些 Linux 技术构成了在系统上构建和运行容器进程的基础:

  1. 命名空间
  2. 控制组(cgroups)
  3. Seccomp
  4. SELinux

命名空间

命名空间 namespace 为容器提供了一个隔离层,给容器提供了一个看起来是独占的 Linux 文件系统的视图。这就限制了进程能访问的内容,从而限制了它所能获得的资源。

在创建容器时,Docker 或 Podman 和其他容器技术使用了 Linux 内核中的几个命名空间:

[nivedv@homelab ~]$ docker container run alpine ping 8.8.8.8
[nivedv@homelab ~]$ sudo lsns -p 29413

        NS TYPE   NPROCS   PID USER COMMAND
4026531835 cgroup    299     1 root /usr/lib/systemd/systemd --switched...
4026531837 user      278     1 root /usr/lib/systemd/systemd --switched...
4026533105 mnt         1 29413 root ping 8.8.8.8
4026533106 uts         1 29413 root ping 8.8.8.8
4026533107 ipc         1 29413 root ping 8.8.8.8
4026533108 pid         1 29413 root ping 8.8.8.8
4026533110 net         1 29413 root ping 8.8.8.8

用户

用户(user)命名空间将用户和组隔离在一个容器内。这是通过分配给容器与宿主系统有不同的 UID 和 GID 范围来实现的。用户命名空间使软件能够以 root 用户的身份在容器内运行。如果入侵者攻击容器,然后逃逸到宿主机上,他们就只能以受限的非 root 身份运行了。

挂载

挂载(mnt)命名空间允许容器有自己的文件系统层次结构视图。你可以在 Linux 系统中的 /proc/<PID>/mounts 位置找到每个容器进程的挂载点。

UTS

Unix 分时系统 Unix Timeharing System (UTS)命名空间允许容器拥有一个唯一主机名和域名。当你运行一个容器时,即使使用 - name 标签,也会使用一个随机的 ID 作为主机名。你可以使用 unshare 命令 来了解一下这个工作原理。

nivedv@homelab ~]$ docker container run -it --name nived alpine sh
/ # hostname 
9c9a5edabdd6
/ # 
nivedv@homelab ~]$ sudo unshare -u sh
sh-5.0# hostname isolated.hostname 
sh-5.0# hostname
isolated.hostname
sh-5.0# 
sh-5.0# exit
exit
[nivedv@homelab ~]$ hostname
homelab.redhat.com

IPC

进程间通信 Inter-Process Communication (IPC)命名空间允许不同的容器进程之间,通过访问共享内存或使用共享消息队列来进行通信。

[root@demo /]# ipcmk -M 10M
Shared memory id: 0
[root@demo /]# ipcmk -M 20M
Shared memory id: 1
[root@demo /]# 
[root@demo /]# ipcs
------ Message Queues --------
key        msqid      owner      perms      used-bytes   messages    
------ Shared Memory Segments --------
key        shmid      owner      perms      bytes      nattch     status      
0xd1df416a 0          root       644        10485760   0                       
0xbd487a9d 1          root       644        20971520   0                       
------ Semaphore Arrays --------
key        semid      owner      perms      nsems

PID

进程 ID Process ID (PID)命名空间确保运行在容器内的进程与外部隔离。当你在容器内运行 ps 命令时,由于这个命名空间隔离的存在,你只能看到在容器内运行的进程,而不是在宿主机上。

网络

网络(net)命名空间允许容器有自己网络接口、IP 地址、路由表、端口号等视图。容器如何能够与外部通信?你创建的所有容器都会被附加到一个特殊的虚拟网络接口上进行通信。

[nivedv@homelab ~]$ docker container run --rm -it alpine sh
/ # ping 8.8.8.8
PING 8.8.8.8 (8.8.8.8): 56 data bytes
64 bytes from 8.8.8.8: seq=0 ttl=119 time=21.643 ms
64 bytes from 8.8.8.8: seq=1 ttl=119 time=20.940 ms
^C
[root@homelab ~]# ip link show veth84ea6fc
veth84ea6fc@if22: <BROADCAST,MULTICAST,UP,LOWER_UP> mtu 1500 qdisc noqueue 
master docker0 state UP mode DEFAULT group default

控制组

控制组(cgroup)是组成一个容器的基本模块。控制组会分配和限制容器所使用的资源,如 CPU、内存、网络 I/O 等。容器引擎会自动创建每种类型的控制组文件系统,并在容器运行时为每个容器设置配额。

[root@homelab ~]# lscgroup | grep docker
cpuset:/docker
net_cls,net_prio:/docker
cpu,cpuacct:/docker
hugetlb:/docker
devices:/docker
freezer:/docker
memory:/docker
perf_event:/docker
blkio:/docker
pids:/docker

容器运行时为每个容器设置了控制组值,所有信息都存储在 /sys/fs/cgroup/*/docker。下面的命令将确保容器可以使用 50000 微秒的 CPU 时间片,并将内存的软、硬限制分别设置为 500M 和 1G。

[root@homelab ~]# docker container run -d --name test-cgroups --cpus 0.5 --memory 1G --memory-reservation 500M httpd
[root@homelab ~]# lscgroup cpu,cpuacct:/docker memory:/docker
cpu,cpuacct:/docker/
cpu,cpuacct:/docker/c3503ac704dafea3522d3bb82c77faff840018e857a2a7f669065f05c8b2cc84
memory:/docker/
memory:/docker/c3503ac704dafea3522d3bb82c77faff840018e857a2a7f669065f05c8b2cc84
[root@homelab c....c84]# cat cpu.cfs_period_us 
100000
[root@homelab c....c84]# cat cpu.cfs_quota_us 
50000
[root@homelab c....c84]# cat memory.soft_limit_in_bytes 
524288000
[root@homelab c....c84]# cat memory.limit_in_bytes 
1073741824

SECCOMP

Seccomp 意思是“ 安全计算 secure computing ”。它是一项 Linux 功能,用于限制应用程序进行的系统调用的集合。例如,Docker 的默认 seccomp 配置文件禁用了大约 44 个系统调用(总计超过 300 个)。

这里的思路是让容器只访问所必须的资源。例如,如果你不需要容器改变主机上的时钟时间,你可能不会使用 clock_adjtime 和 clock_settime 系统调用,屏蔽它们是合理的。同样地,你不希望容器改变内核模块,所以没有必要让它们使用 create_module、 delete_module 系统调用。

SELinux

SELinux 是“ 安全增强的 Linux security-enhanced Linux ”的缩写。如果你在你的宿主机上运行的是 Red Hat 发行版,那么 SELinux 是默认启用的。SELinux 可以让你限制一个应用程序只能访问它自己的文件,并阻止任何其他进程访问。因此,如果一个应用程序被破坏了,它将限制该应用程序可以影响或控制的文件数量。通过为文件和进程设置上下文环境以及定义策略来实现,这些策略将限制一个进程可以访问和更改的内容。

容器的 SELinux 策略是由 container-selinux 包定义的。默认情况下,容器以 container_t 标签运行,允许在 /usr 目录下读取(r)和执行(x),并从 /etc 目录下读取大部分内容。标签container_var_lib_t 是与容器有关的文件的通用标签。

总结

容器是当今 IT 基础设施的一个重要组成部分,也是一项相当有趣的技术。即使你的工作不直接涉及容器化,了解一些基本的容器概念和方法,也能让你体会到它们如何帮助你的组织。容器是建立在开源的 Linux 技术之上的,这使它们变得更加美好。

本文基于 techbeatly 的文章,并经授权改编。


via: https://opensource.com/article/21/8/container-linux-technology

作者:Nived V 选题:lujun9972 译者:wxy 校对:turbokernel

本文由 LCTT 原创编译,Linux中国 荣誉推出