分类 容器与云 下的文章

1、概述

现在能够在 Windows 10 和 Windows 服务器上运行 Docker 容器了,它是以 Ubuntu 作为宿主基础的。

想象一下,使用你喜欢的 Linux 发行版——比如 Ubuntu——在 Windows 上运行你自己的 Linux 应用。

现在,借助 Docker 技术和 Windows 上的 Hyper-V 虚拟化的力量,这一切成为了可能。
2、前置需求

你需要一个 8GB 内存的 64 位 x86 PC,运行 Windows 10 或 Windows Server。

只有加入了 Windows 预览体验计划(Insider),才能运行带有 Hyper-V 支持的 Linux 容器。该计划可以让你测试预发布软件和即将发布的 Windows。

如果你特别在意稳定性和隐私(Windows 预览体验计划允许微软收集使用信息),你可以考虑等待 2017 年 10 月发布的Windows 10 Fall Creator update,这个版本可以让你无需 Windows 预览体验身份即可使用带有 Hyper-V 支持的 Docker 技术。

你也需要最新版本的 Docker,它可以从 http://dockerproject.org 下载得到。

最后,你还需要确认你安装了 XZ 工具,解压 Ubuntu 宿主容器镜像时需要它。

3、加入 Windows 预览体验计划(Insider)

如果你已经是 Windows 预览体验计划(Insider)成员,你可以跳过此步。否则在浏览器中打开如下链接:

https://insider.windows.com/zh-cn/getting-started/
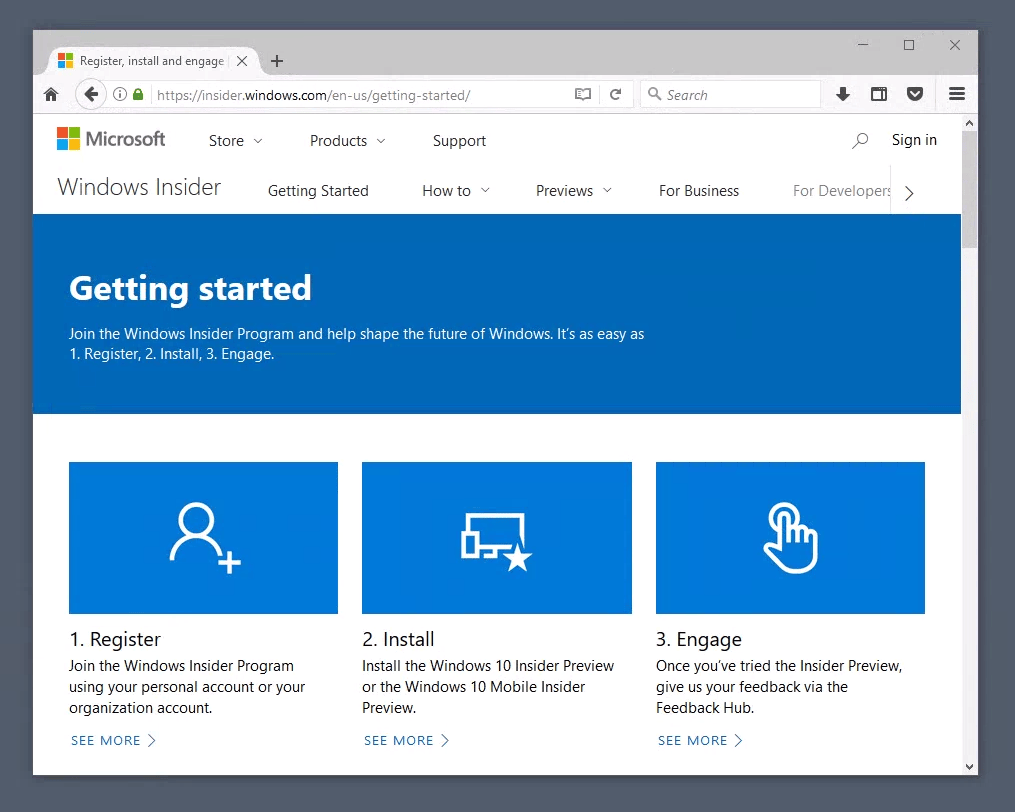
要注册该计划,使用你在 Windows 10 中的微软个人账户登录,并在预览体验计划首页点击“注册”,接受条款并完成注册。

然后你需要打开 Windows 开始菜单中的“更新和安全”菜单,并在菜单左侧选择“Windows 预览体验计划”。
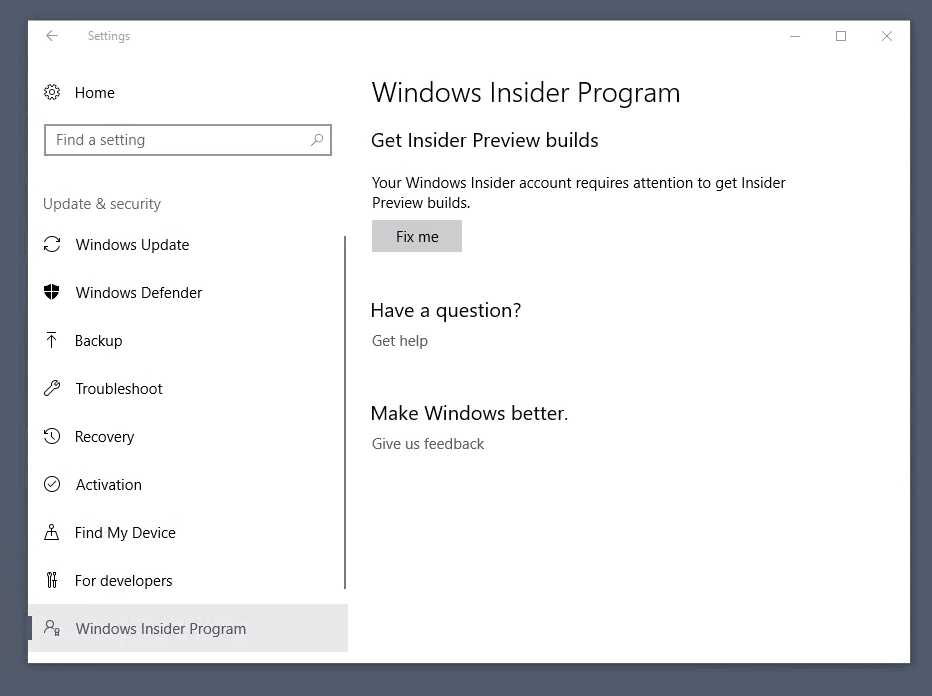
如果需要的话,在 Windows 提示“你的 Windows 预览体验计划账户需要关注”时,点击“修复”按钮。

4、 Windows 预览体验(Insider)的内容

从 Windows 预览体验计划面板,选择“开始使用”。如果你的微软账户没有关联到你的 Windows 10 系统,当提示时使用你要关联的账户进行登录。

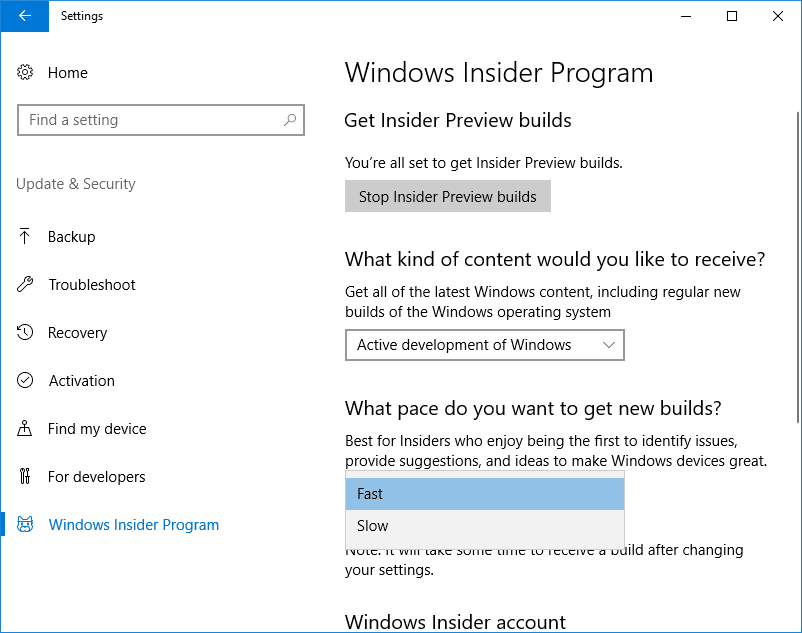
然后你可以选择你希望从 Windows 预览体验计划中收到何种内容。要得到 Docker 技术所需要的 Hyper-V 隔离功能,你需要加入“快圈”,两次确认后,重启 Windows。重启后,你需要等待你的机器安装各种更新后才能进行下一步。
5、安装 Docker for Windows

从 Docker Store 下载 Docker for Windows。
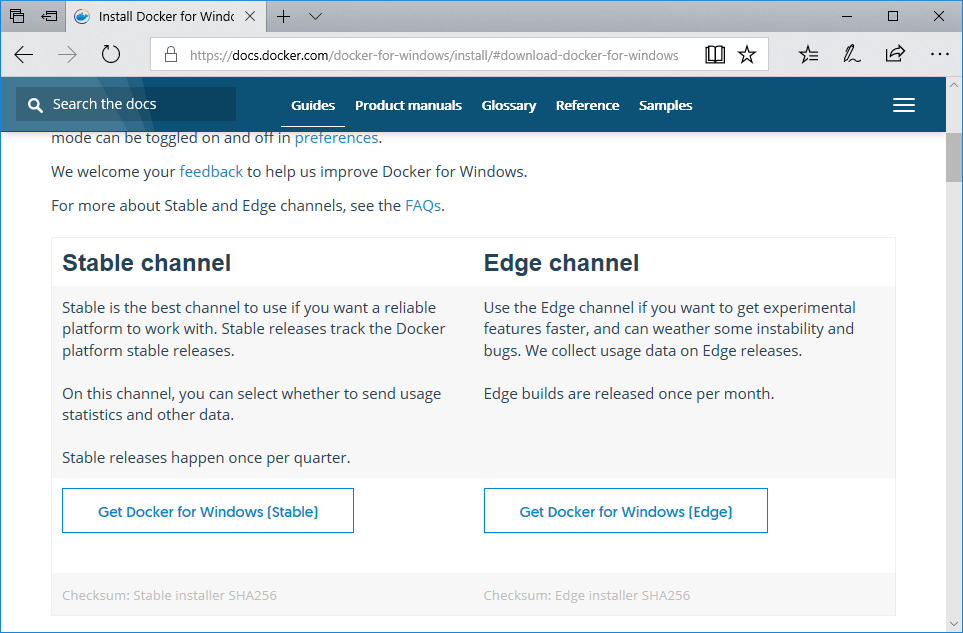
下载完成后,安装,并在需要时重启。
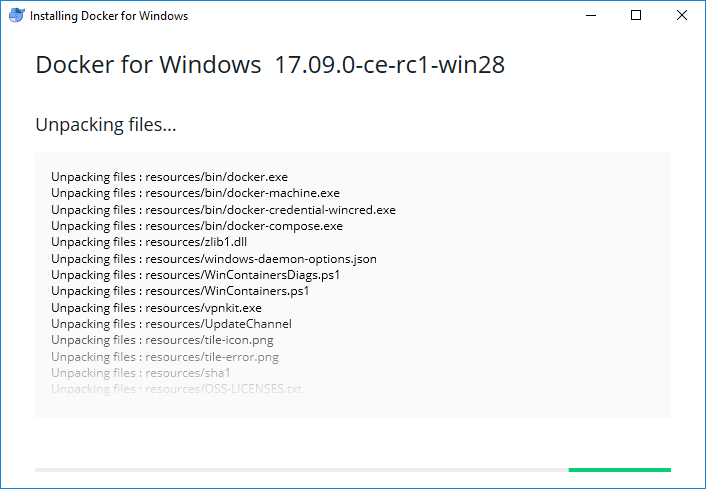
重启后,Docker 就已经启动了。Docker 要求启用 Hyper-V 功能,因此它会提示你启用并重启。点击“OK”来为 Docker 启用它并重启系统。

6、下载 Ubuntu 容器镜像

从 Canonical 合作伙伴镜像网站下载用于 Windows 的最新的 Ubuntu 容器镜像。

下载后,使用 XZ 工具解压:

C:\Users\mathi\> .\xz.exe -d xenial-container-hyper-v.vhdx.xz
C:\Users\mathi\>

7、准备容器环境

首先创建两个目录:

创建 C:\lcow,它将用于 Docker 准备容器时的临时空间。
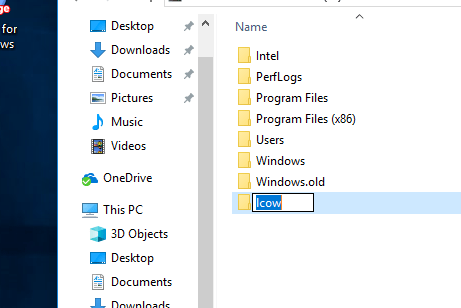
再创建一个 C:\Program Files\Linux Containers ,这是存放 Ubuntu 容器镜像的地方。

你需要给这个目录额外的权限以允许 Docker 在其中使用镜像。在管理员权限的 Powershell 窗口中运行如下 Powershell 脚本:

param(
[string] $Root
)
# Give the virtual machines group full control
$acl = Get-Acl -Path $Root
$vmGroupRule = new-object System.Security.AccessControl.FileSystemAccessRule("NT VIRTUAL MACHINE\Virtual Machines", "FullControl","ContainerInherit,ObjectInherit", "None", "Allow")
$acl.SetAccessRule($vmGroupRule)
Set-Acl -AclObject $acl -Path $Root

将其保存为set_perms.ps1并运行它。

提示,你也许需要运行 Set-ExecutionPolicy -Scope process unrestricted 来允许运行未签名的 Powershell 脚本。
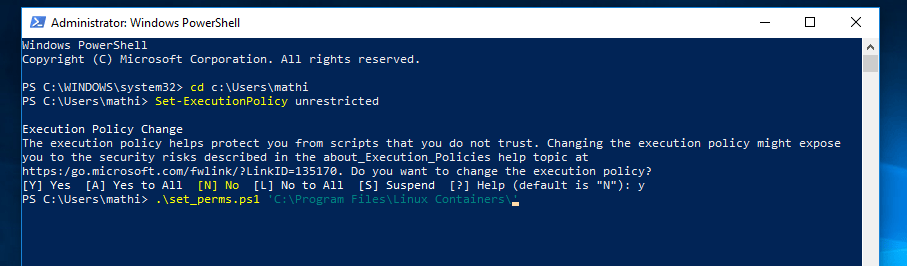
C:\Users\mathi\> .\set_perms.ps1 "C:\Program Files\Linux Containers"
C:\Users\mathi\>

现在,将上一步解压得到的 Ubuntu 容器镜像(.vhdx)复制到 C:\Program Files\Linux Containers 下的 uvm.vhdx。

8、更多的 Docker 准备工作

Docker for Windows 要求一些预发布的功能才能与 Hyper-V 隔离相配合工作。这些功能在之前的 Docker CE 版本中还不可用,这些所需的文件可以从 master.dockerproject.org 下载。

从 master.dockerproject.org 下载 dockerd.exe 和 docker.exe,并将其放到安全的地方,比如你自己的文件夹中。它们用于在下一步中启动 Ubuntu 容器。

9、 在 Hyper-V 上运行 Ubuntu 容器

你现在已经准备好启动你的容器了。首先以管理员身份打开命令行(cmd.exe),然后以正确的环境变量启动 dockerd.exe。

C:\Users\mathi\> set LCOW_SUPPORTED=1
C:\Users\mathi\> .\dockerd.exe -D --data-root C:\lcow

然后,以管理员身份启动 Powershell 窗口,并运行 docker.exe 为你的容器拉取镜像:

C:\Users\mathi\> .\docker.exe pull ubuntu
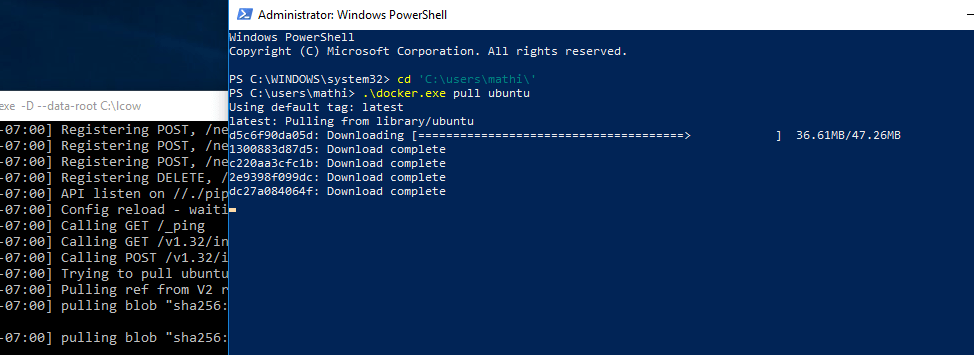
现在你终于启动了容器,再次运行 docker.exe,让它运行这个新镜像:

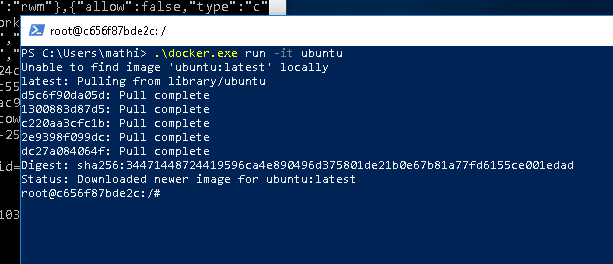
C:\Users\mathi\> .\docker.exe run -it ubuntu

恭喜你!你已经成功地在 Windows 上让你的系统运行了带有 Hyper-V 隔离的容器,并且跑的是你非常喜欢的 Ubuntu 容器。

10、获取帮助

如果你需要一些 Hyper-V Ubuntu 容器的起步指导,或者你遇到一些问题,你可以在这里寻求帮助:

介绍

想在笔记本电脑上尝试 MongoDB?只需执行一个命令,你就会有一个轻量级的、独立的沙箱。完成后可以删除你所做的所有痕迹。

想在多个环境中使用相同的 程序栈 application stack 副本?构建你自己的容器镜像,让你的开发、测试、运维和支持团队使用相同的环境克隆。

容器正在彻底改变整个软件生命周期:从最早的技术性实验和概念证明,贯穿了开发、测试、部署和支持。

编排工具用来管理如何创建、升级多个容器,并使之高可用。编排还控制容器如何连接,以从多个微服务容器构建复杂的应用程序。

丰富的功能、简单的工具和强大的 API 使容器和编排功能成为 DevOps 团队的首选,将其集成到连续集成(CI) 和连续交付 (CD) 的工作流程中。

这篇文章探讨了在容器中运行和编排 MongoDB 时遇到的额外挑战,并说明了如何克服这些挑战。

MongoDB 的注意事项

使用容器和编排运行 MongoDB 有一些额外的注意事项:

  • MongoDB 数据库节点是有状态的。如果容器发生故障并被重新编排,数据则会丢失(能够从副本集的其他节点恢复,但这需要时间),这是不合需要的。为了解决这个问题,可以使用诸如 Kubernetes 中的 数据卷 volume 抽象等功能来将容器中临时的 MongoDB 数据目录映射到持久位置,以便数据在容器故障和重新编排过程中存留。
  • 一个副本集中的 MongoDB 数据库节点必须能够相互通信 - 包括重新编排后。副本集中的所有节点必须知道其所有对等节点的地址,但是当重新编排容器时,可能会使用不同的 IP 地址重新启动。例如,Kubernetes Pod 中的所有容器共享一个 IP 地址,当重新编排 pod 时,IP 地址会发生变化。使用 Kubernetes,可以通过将 Kubernetes 服务与每个 MongoDB 节点相关联来处理,该节点使用 Kubernetes DNS 服务提供“主机名”,以保持服务在重新编排中保持不变。
  • 一旦每个单独的 MongoDB 节点运行起来(每个都在自己的容器中),则必须初始化副本集,并添加每个节点到其中。这可能需要在编排工具之外提供一些额外的处理。具体来说,必须使用目标副本集中的一个 MongoDB 节点来执行 rs.initiate 和 rs.add 命令。
  • 如果编排框架提供了容器的自动化重新编排(如 Kubernetes),那么这将增加 MongoDB 的弹性,因为这可以自动重新创建失败的副本集成员,从而在没有人为干预的情况下恢复完全的冗余级别。
  • 应该注意的是,虽然编排框架可能监控容器的状态,但是不太可能监视容器内运行的应用程序或备份其数据。这意味着使用 MongoDB Enterprise Advanced 和 MongoDB Professional 中包含的 MongoDB Cloud Manager 等强大的监控和备份解决方案非常重要。可以考虑创建自己的镜像,其中包含你首选的 MongoDB 版本和 MongoDB Automation Agent。

使用 Docker 和 Kubernetes 实现 MongoDB 副本集

如上节所述,分布式数据库(如 MongoDB)在使用编排框架(如 Kubernetes)进行部署时,需要稍加注意。本节将介绍详细介绍如何实现。

我们首先在单个 Kubernetes 集群中创建整个 MongoDB 副本集(通常在一个数据中心内,这显然不能提供地理冗余)。实际上,很少有必要改变成跨多个集群运行,这些步骤将在后面描述。

副本集的每个成员将作为自己的 pod 运行,并提供一个公开 IP 地址和端口的服务。这个“固定”的 IP 地址非常重要,因为外部应用程序和其他副本集成员都可以依赖于它在重新编排 pod 的情况下保持不变。

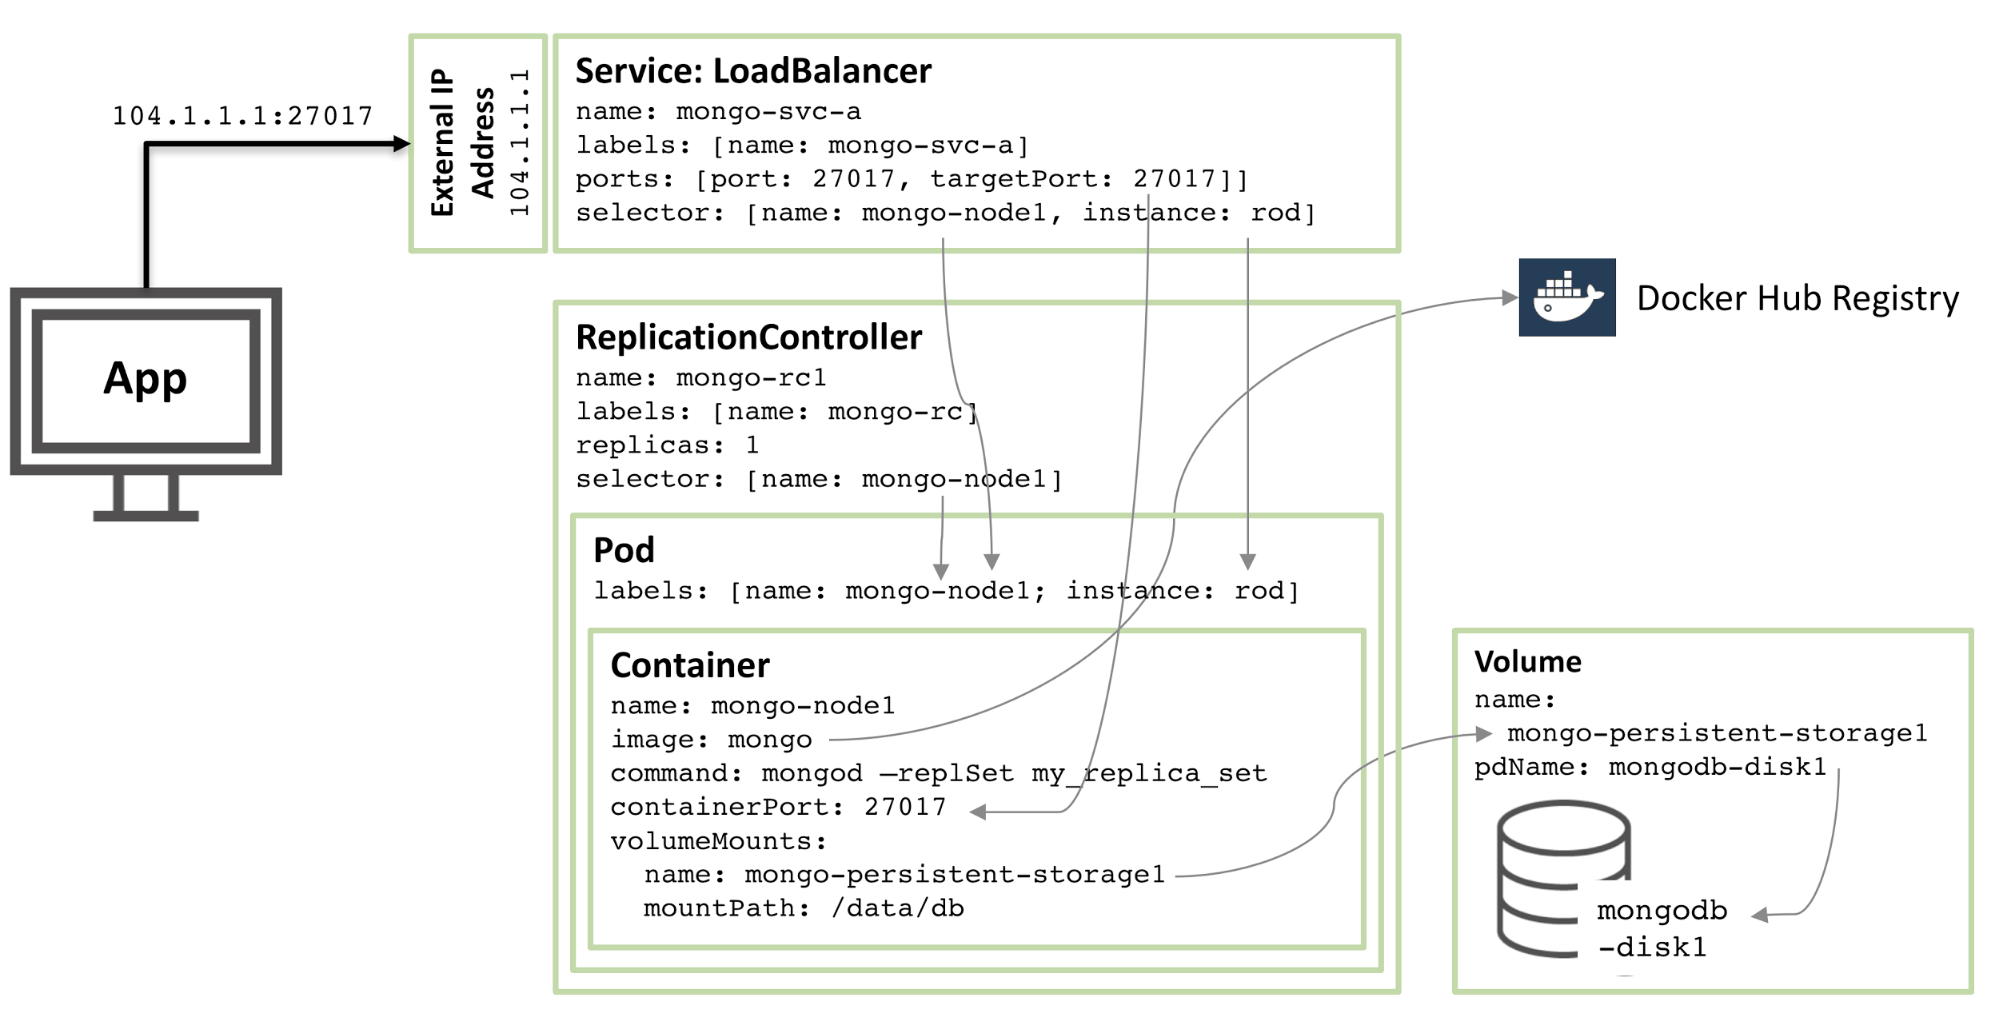
下图说明了其中一个 pod 以及相关的复制控制器和服务。

图 1:MongoDB 副本集成员被配置为 Kubernetes Pod 并作为服务公开

逐步介绍该配置中描述的资源:

  • 从核心开始,有一个名为 mongo-node1 的容器。mongo-node1 包含一个名为 mongo 的镜像,这是一个在 Docker Hub 上托管的一个公开可用的 MongoDB 容器镜像。容器在集群中暴露端口 27107。
  • Kubernetes 的数据卷功能用于将连接器中的 /data/db 目录映射到名为 mongo-persistent-storage1 的永久存储上,这又被映射到在 Google Cloud 中创建的名为 mongodb-disk1 的磁盘中。这是 MongoDB 存储其数据的地方,这样它可以在容器重新编排后保留。
  • 容器保存在一个 pod 中,该 pod 中有标签命名为 mongo-node,并提供一个名为 rod 的(任意)示例。
  • 配置 mongo-node1 复制控制器以确保 mongo-node1 pod 的单个实例始终运行。
  • 名为 mongo-svc-a 的 负载均衡 服务给外部开放了一个 IP 地址以及 27017 端口,它被映射到容器相同的端口号上。该服务使用选择器来匹配 pod 标签来确定正确的 pod。外部 IP 地址和端口将用于应用程序以及副本集成员之间的通信。每个容器也有本地 IP 地址,但是当容器移动或重新启动时,这些 IP 地址会变化,因此不会用于副本集。

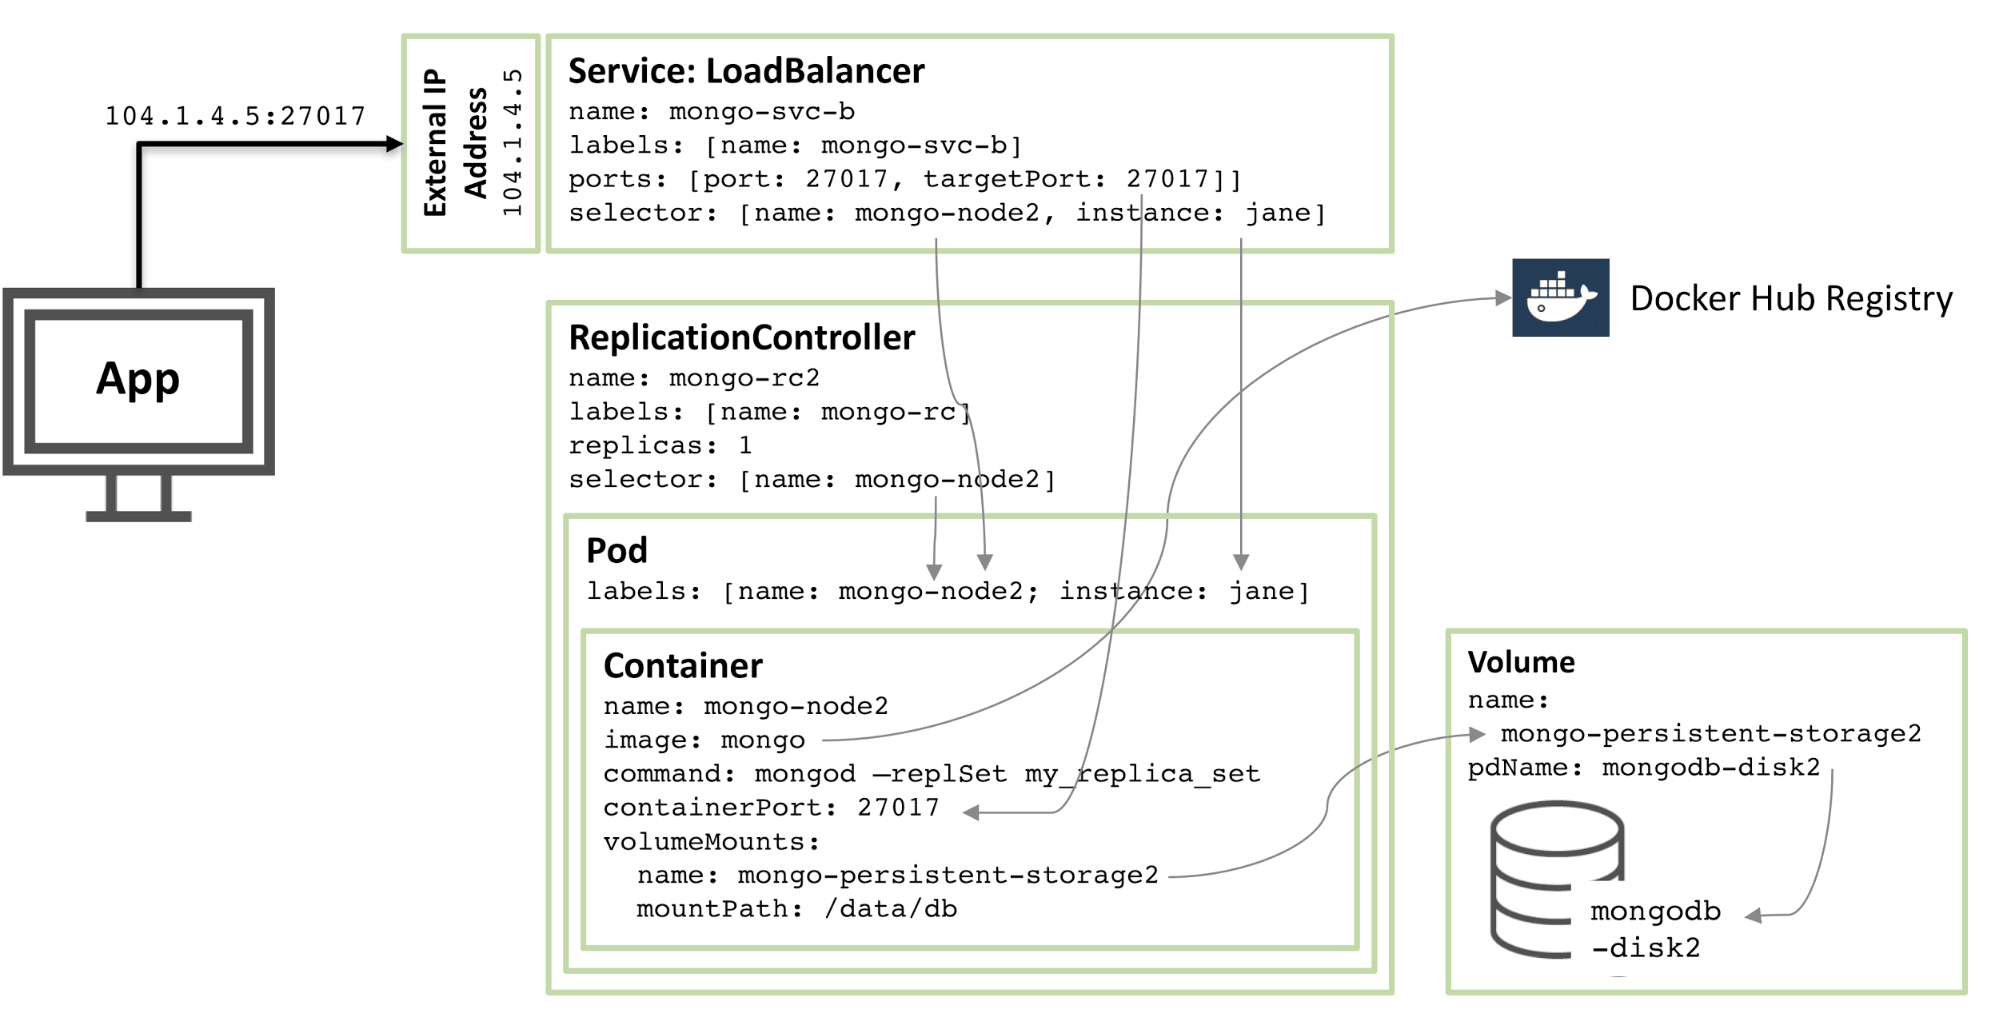
下一个图显示了副本集的第二个成员的配置。

图 2:第二个 MongoDB 副本集成员配置为 Kubernetes Pod

90% 的配置是一样的,只有这些变化:

  • 磁盘和卷名必须是唯一的,因此使用的是 mongodb-disk2 和 mongo-persistent-storage2
  • Pod 被分配了一个 instance: jane 和 name: mongo-node2 的标签,以便新的服务可以使用选择器与图 1 所示的 rod Pod 相区分。
  • 复制控制器命名为 mongo-rc2
  • 该服务名为mongo-svc-b,并获得了一个唯一的外部 IP 地址(在这种情况下,Kubernetes 分配了 104.1.4.5)

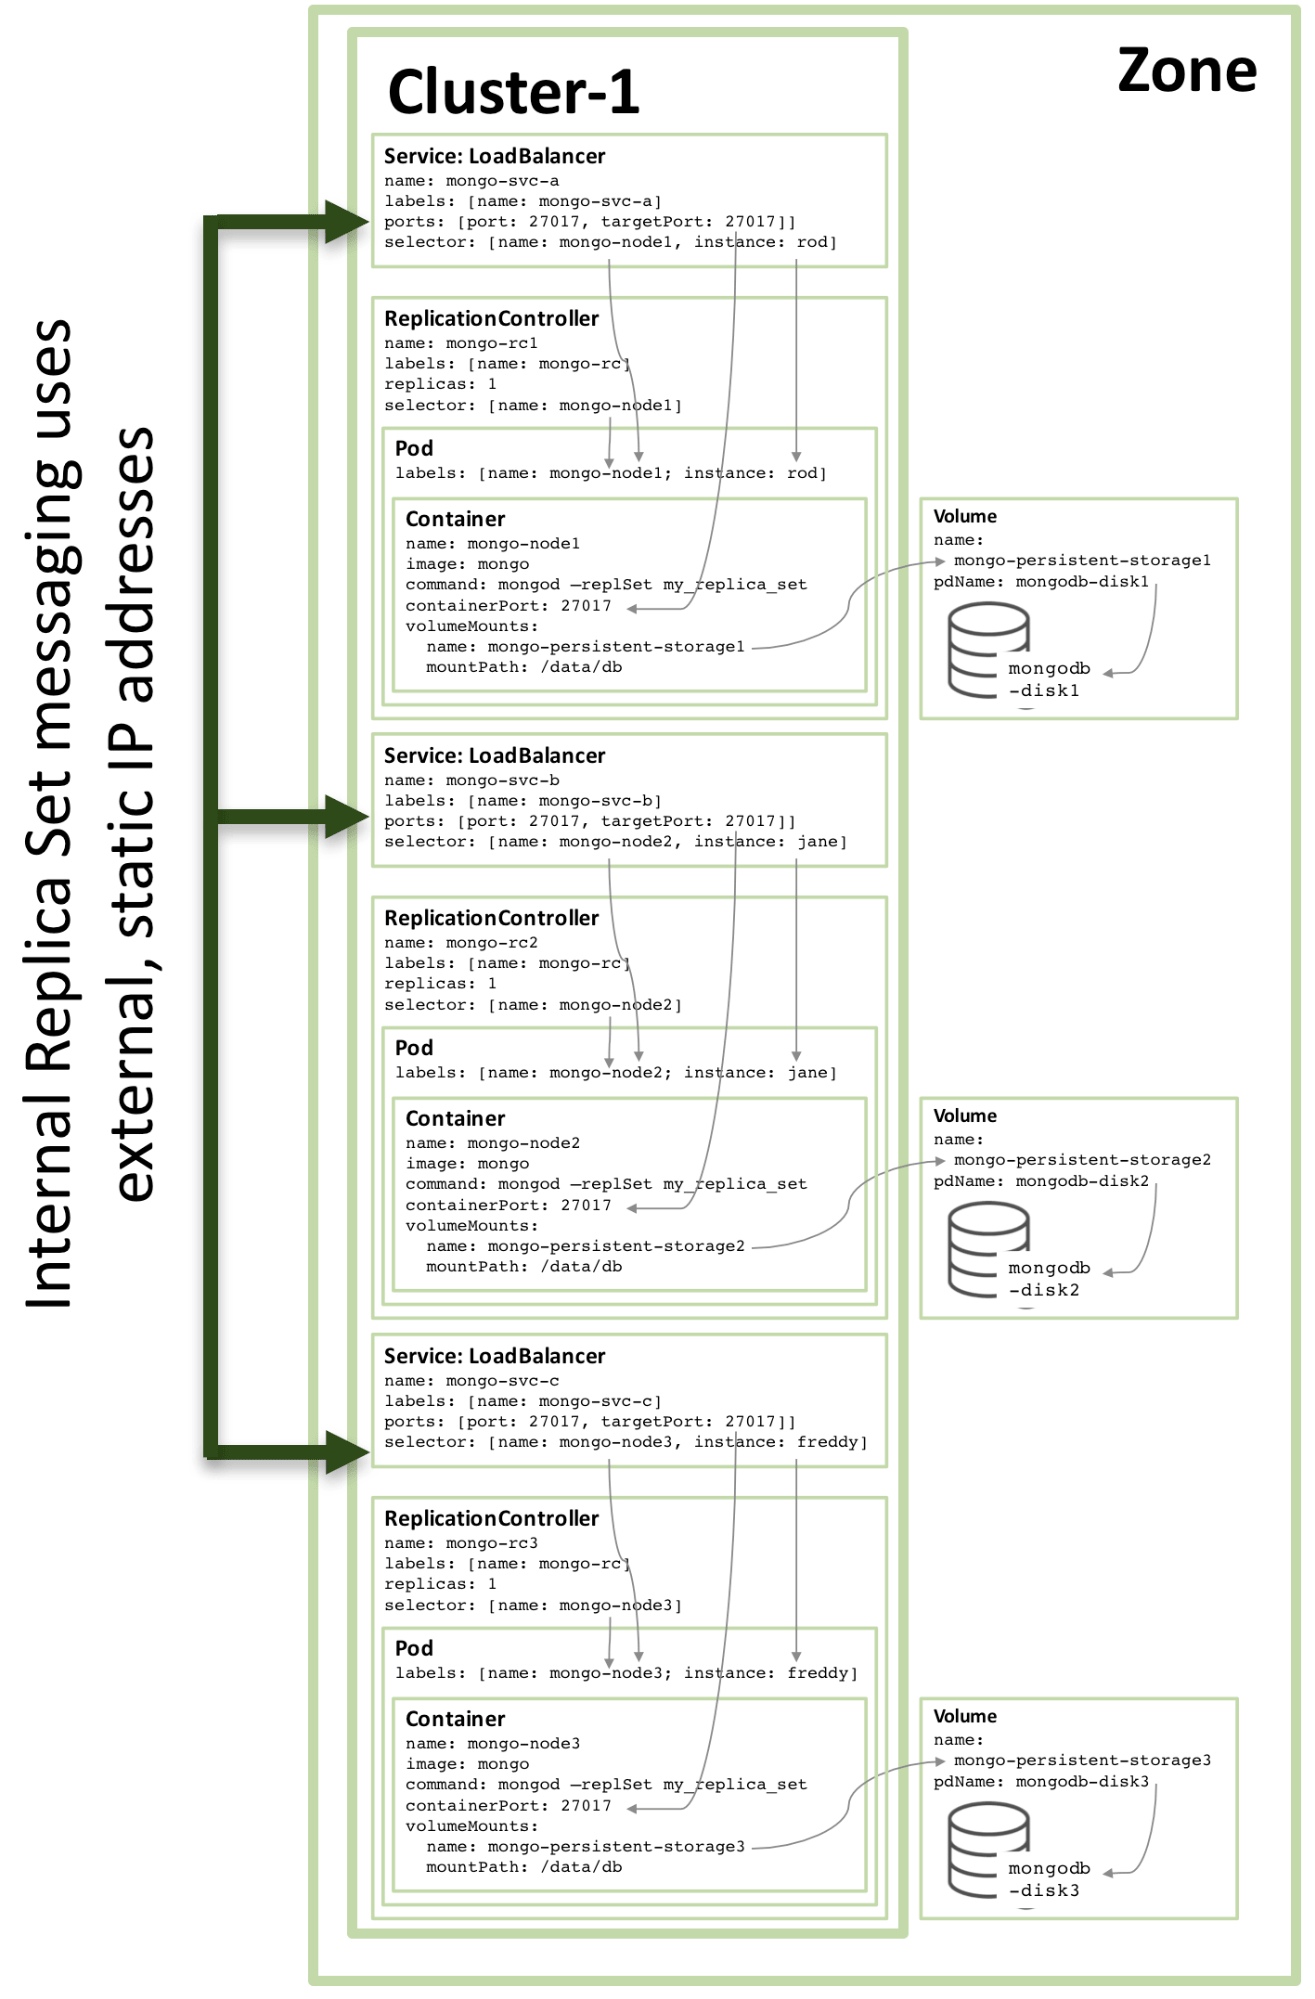
第三个副本成员的配置遵循相同的模式,下图展示了完整的副本集:

图 3:配置为 Kubernetes 服务的完整副本集成员

请注意,即使在三个或更多节点的 Kubernetes 群集上运行图 3 所示的配置,Kubernetes 可能(并且经常会)在同一主机上编排两个或多个 MongoDB 副本集成员。这是因为 Kubernetes 将三个 pod 视为属于三个独立的服务。

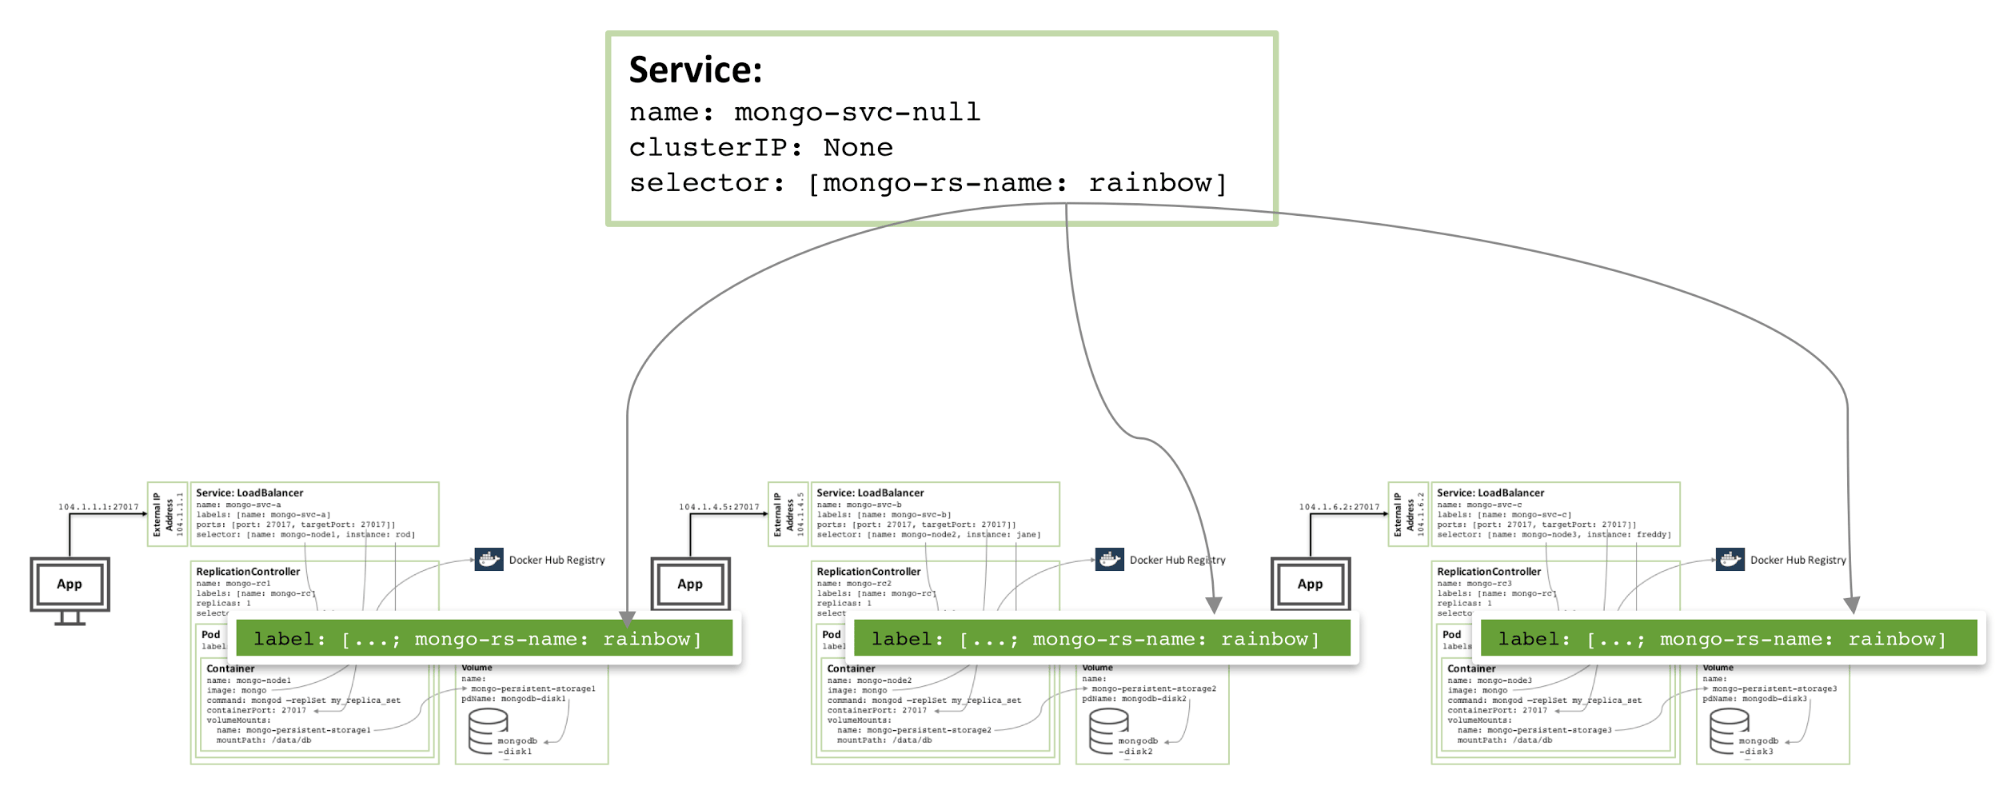
为了在区域内增加冗余,可以创建一个附加的 headless 服务。新服务不向外界提供任何功能(甚至不会有 IP 地址),但是它可以让 Kubernetes 通知三个 MongoDB pod 形成一个服务,所以 Kubernetes 会尝试在不同的节点上编排它们。

图 4:避免同一 MongoDB 副本集成员的 Headless 服务

配置和启动 MongoDB 副本集所需的实际配置文件和命令可以在白皮书《启用微服务:阐述容器和编排》中找到。特别的是,需要一些本文中描述的特殊步骤来将三个 MongoDB 实例组合成具备功能的、健壮的副本集。

多个可用区 MongoDB 副本集

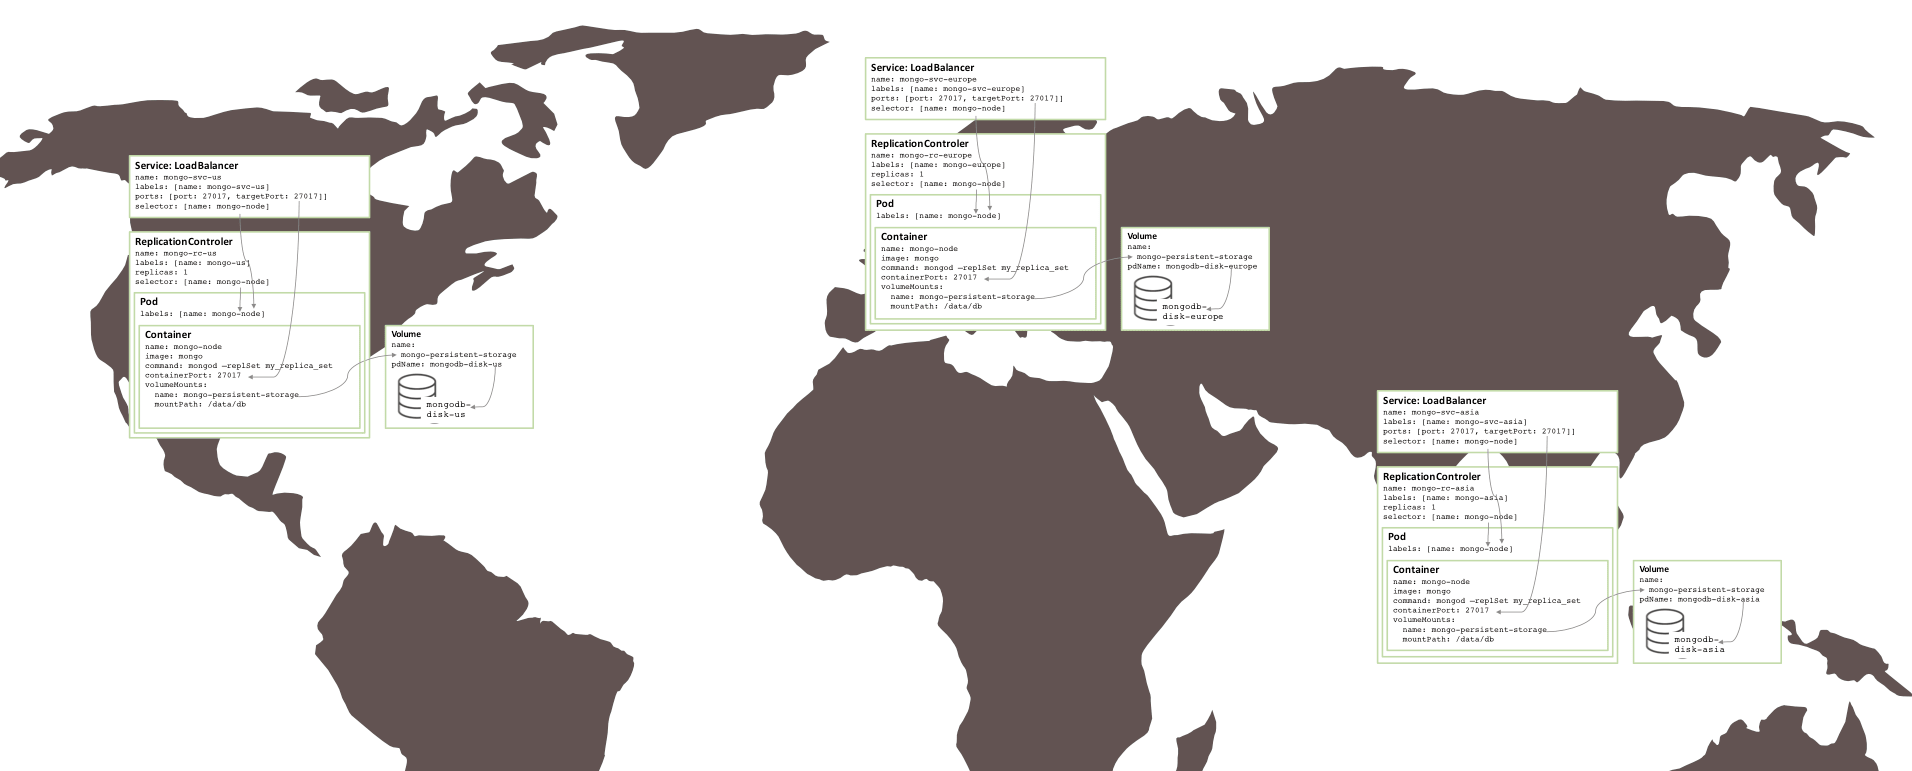
上面创建的副本集存在风险,因为所有内容都在相同的 GCE 集群中运行,因此都在相同的 可用区 availability zone 中。如果有一个重大事件使可用区离线,那么 MongoDB 副本集将不可用。如果需要地理冗余,则三个 pod 应该在三个不同的可用区或地区中运行。

令人惊奇的是,为了创建在三个区域之间分割的类似的副本集(需要三个集群),几乎不需要改变。每个集群都需要自己的 Kubernetes YAML 文件,该文件仅为该副本集中的一个成员定义了 pod、复制控制器和服务。那么为每个区域创建一个集群,永久存储和 MongoDB 节点是一件很简单的事情。

图 5:在多个可用区域上运行的副本集

下一步

要了解有关容器和编排的更多信息 - 所涉及的技术和所提供的业务优势 - 请阅读白皮书《启用微服务:阐述容器和编排》。该文件提供了获取本文中描述的副本集,并在 Google Container Engine 中的 Docker 和 Kubernetes 上运行的完整的说明。


作者简介:

Andrew 是 MongoDB 的产品营销总经理。他在去年夏天离开 Oracle 加入 MongoDB,在 Oracle 他花了 6 年多的时间在产品管理上,专注于高可用性。他可以通过 @andrewmorgan 或者在他的博客(clusterdb.com)评论联系他。


via: https://www.mongodb.com/blog/post/running-mongodb-as-a-microservice-with-docker-and-kubernetes

作者:Andrew Morgan 译者:geekpi 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

Kubernetes,简称 k8s(k,8 个字符,s——明白了?)或者 “kube”,是一个开源的 Linux 容器自动化运维平台,它消除了容器化应用程序在部署、伸缩时涉及到的许多手动操作。换句话说,你可以将多台主机组合成集群来运行 Linux 容器,而 Kubernetes 可以帮助你简单高效地管理那些集群。构成这些集群的主机还可以跨越公有云、私有云以及混合云。

Kubernetes 最开始是由 Google 的工程师设计开发的。Google 作为 Linux 容器技术的早期贡献者之一,曾公开演讲介绍 Google 如何将一切都运行于容器之中(这是 Google 的云服务背后的技术)。Google 一周内的容器部署超过 20 亿次,全部的工作都由内部平台 Borg 支撑。Borg 是 Kubernetes 的前身,几年来开发 Borg 的经验教训也成了影响 Kubernetes 中许多技术的主要因素。

趣闻: Kubernetes logo 中的七个辐条来源于项目原先的名称, “Seven of Nine 项目”(LCTT 译注:Borg 是「星际迷航」中的一个宇宙种族,Seven of Nine 是该种族的一名女性角色)。

红帽作为最早与 Google 合作开发 Kubernetes 的公司之一(甚至早于 Kubernetes 的发行),已经是 Kubernetes 上游项目的第二大贡献者。Google 在 2015 年把 Kubernetes 项目捐献给了新成立的 云计算基金会 Cloud Native Computing Foundation (CNCF)。

为什么你需要 Kubernetes ?

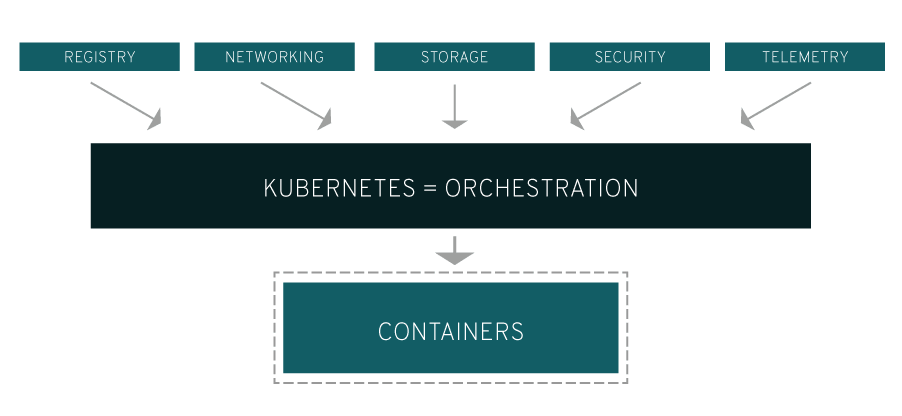
真实的生产环境应用会包含多个容器,而这些容器还很可能会跨越多个服务器主机部署。Kubernetes 提供了为那些工作负载大规模部署容器的编排与管理能力。Kubernetes 编排让你能够构建多容器的应用服务,在集群上调度或伸缩这些容器,以及管理它们随时间变化的健康状态。

Kubernetes 也需要与网络、存储、安全、监控等其它服务集成才能提供综合性的容器基础设施。

 title=

当然,这取决于你如何在你的环境中使用容器。一个初步的 Linux 容器应用程序把容器视作高效、快速的虚拟机。一旦把它部署到生产环境或者扩展为多个应用,很显然你需要许多组托管在相同位置的容器合作提供某个单一的服务。随着这些容器的累积,你的运行环境中容器的数量会急剧增加,复杂度也随之增长。

Kubernetes 通过将容器分类组成 “pod” 来解决了容器增殖带来的许多常见问题。pod 为容器分组提供了一层抽象,以此协助你调度工作负载以及为这些容器提供类似网络与存储这类必要的服务。Kubernetes 的其它组件帮助你对 pod 进行负载均衡,以保证有合适数量的容器支撑你的工作负载。

正确实施的 Kubernetes,结合类似 Atomic Registry、Open vSwitch、heapster、OAuth 和 SELinux 的开源项目,让你可以管理你自己的整个容器基础设施。

Kubernetes 能做些什么?

在生产环境中使用 Kubernetes 的主要优势在于它提供了在物理机或虚拟机集群上调度和运行容器的平台。更宽泛地说,它能帮你在生产环境中实现可以依赖的基于容器的基础设施。而且,由于 Kubernetes 本质上就是运维任务的自动化平台,你可以执行一些其它应用程序平台或管理系统支持的操作,只不过操作对象变成了容器。

有了 Kubernetes,你可以:

  • 跨主机编排容器。
  • 更充分地利用硬件资源来最大化地满足企业应用的需求。
  • 控制与自动化应用的部署与升级。
  • 为有状态的应用程序挂载和添加存储器。
  • 线上扩展或裁剪容器化应用程序与它们的资源。
  • 声明式的容器管理,保证所部署的应用按照我们部署的方式运作。
  • 通过自动布局、自动重启、自动复制、自动伸缩实现应用的状态检查与自我修复。

然而 Kubernetes 依赖其它项目来提供完整的编排服务。结合其它开源项目作为其组件,你才能充分感受到 Kubernetes 的能力。这些必要组件包括:

  • 仓库:Atomic Registry、Docker Registry 等。
  • 网络:OpenvSwitch 和智能边缘路由等。
  • 监控:heapster、kibana、hawkular 和 elastic。
  • 安全:LDAP、SELinux、 RBAC 与 支持多租户的 OAUTH。
  • 自动化:通过 Ansible 的 playbook 进行集群的安装和生命周期管理。
  • 服务:大量事先创建好的常用应用模板。

红帽 OpenShift 为容器部署预先集成了上面这些组件。

Kubernetes 入门

和其它技术一样,大量的专有名词有可能成为入门的障碍。下面解释一些通用的术语,希望帮助你理解 Kubernetes。

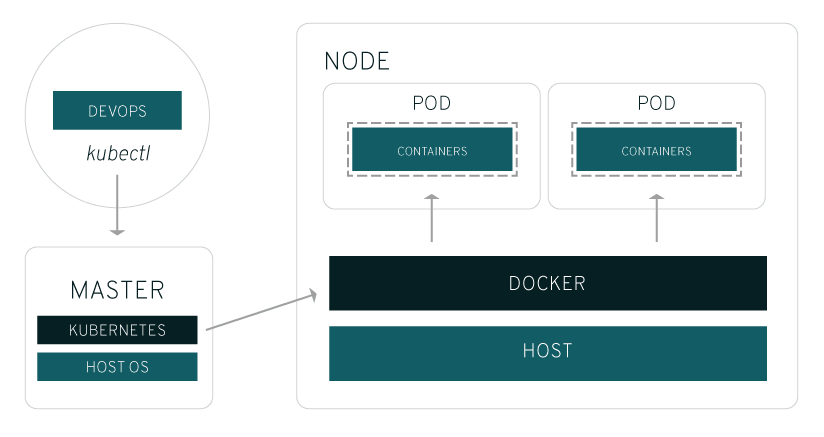
  • Master(主节点): 控制 Kubernetes 节点的机器,也是创建作业任务的地方。
  • Node(节点): 这些机器在 Kubernetes 主节点的控制下执行被分配的任务。
  • Pod: 由一个或多个容器构成的集合,作为一个整体被部署到一个单一节点。同一个 pod 中的容器共享 IP 地址、进程间通讯(IPC)、主机名以及其它资源。Pod 将底层容器的网络和存储抽象出来,使得集群内的容器迁移更为便捷。
  • Replication controller(复制控制器): 控制一个 pod 在集群上运行的实例数量。
  • Service(服务): 将服务内容与具体的 pod 分离。Kubernetes 服务代理负责自动将服务请求分发到正确的 pod 处,不管 pod 移动到集群中的什么位置,甚至可以被替换掉。
  • Kubelet: 这个守护进程运行在各个工作节点上,负责获取容器列表,保证被声明的容器已经启动并且正常运行。
  • kubectl: 这是 Kubernetes 的命令行配置工具。

上面这些知识就足够了吗?不,这仅仅是一小部分,更多内容请查看 Kubernetes 术语表。

生产环境中使用 Kubernetes

Kubernetes 是开源的,所以没有正式的技术支持机构为你的商业业务提供支持。如果在生产环境使用 Kubernetes 时遇到问题,你恐怕不会太愉快,当然你的客户也不会太高兴。

这就是红帽 OpenShift 要解决的问题。OpenShift 是为企业提供的 Kubernetes ——并且集成了更多的组件。OpenShift 包含了强化 Kubernetes 功能、使其更适用于企业场景的额外部件,包括仓库、网络、监控、安全、自动化和服务在内。OpenShift 使得开发者能够在具有伸缩性、控制和编排能力的云端开发、托管和部署容器化的应用,快速便捷地把想法转变为业务。

而且,OpenShift 还是由头号开源领导公司红帽支持和开发的。

Kubernetes 如何适用于你的基础设施

 title=

Kubernetes 运行在操作系统(例如 Red Hat Enterprise Linux Atomic Host)之上,操作着该节点上运行的容器。Kubernetes 主节点(master)从管理员(或者 DevOps 团队)处接受命令,再把指令转交给附属的节点。这种带有大量服务的切换工作自动决定最适合该任务的节点,然后在该节点上分配资源并指派 pod 来完成任务请求。

所以从基础设施的角度,管理容器的方式发生了一点小小的变化。对容器的控制在更高的层次进行,提供了更佳的控制方式,而无需用户微观管理每个单独的容器或者节点。必要的工作则主要集中在如何指派 Kubernetes 主节点、定义节点和 pod 等问题上。

docker 在 Kubernetes 中的角色

Docker 技术依然执行它原本的任务。当 kubernetes 把 pod 调度到节点上,节点上的 kubelet 会指示 docker 启动特定的容器。接着,kubelet 会通过 docker 持续地收集容器的信息,然后提交到主节点上。Docker 如往常一样拉取容器镜像、启动或停止容器。不同点仅仅在于这是由自动化系统控制而非管理员在每个节点上手动操作的。


via: https://www.redhat.com/en/containers/what-is-kubernetes

作者:www.redhat.com 译者:haoqixu 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

如果你的运维团队在使用 Docker 和 Kubernetes,那么建议开发上采用相同或相似的技术。这将减少不兼容性和可移植性问题的数量,并使每个人都会认识到应用程序容器是开发和运维团队的共同责任。

这篇博客文章介绍了 Kubernetes 在开发模式中的用法,它的灵感来自于一个视频教程,你可以在“无痛 Docker 教程”中找到它。

Minikube 是一个允许开发人员在本地使用和运行 Kubernetes 集群的工具,从而使开发人员的生活变得轻松。

在这篇博客中,对于我测试的例子,我使用的是 Linux Mint 18,但其它 Linux 发行版在安装部分没有区别。

cat /etc/lsb-release 
DISTRIB_ID=LinuxMint
DISTRIB_RELEASE=18.1
DISTRIB_CODENAME=serena
DISTRIB_DESCRIPTION=”Linux Mint 18.1 Serena”

先决条件

为了与 Minkube 一起工作,我们应该安装 Kubectl 和 Minikube 和一些虚拟化驱动程序。

curl -LO https://storage.googleapis.com/kubernetes-release/release/$(curl -s https://storage.googleapis.com/kubernetes-release/release/stable.txt)/bin/darwin/amd64/kubectl

chmod +x ./kubectl

sudo mv ./kubectl /usr/local/bin/kubectl

curl -Lo minikube https://storage.googleapis.com/minikube/releases/v0.21.0/minikube-darwin-amd64 && chmod +x minikube && sudo mv minikube /usr/local/bin/
  • 对于 Windows,安装 VirtualBox 或者 Hyper-V,然后再安装 Kubectl 和 Minkube。
curl -LO https://storage.googleapis.com/kubernetes-release/release/v1.7.0/bin/windows/amd64/kubectl.exe

将二进制文件添加到你的 PATH 中(这篇文章解释了如何修改 PATH)

下载 minikube-windows-amd64.exe,将其重命名为 minikube.exe,并将其添加到你的 PATH 中。在这可以找到最新版本。

  • 对于 Linux,安装 VirtualBox 或者 KVM,然后再安装 Kubectl 和 Minkube。
curl -LO https://storage.googleapis.com/kubernetes-release/release/$(curl -s https://storage.googleapis.com/kubernetes-release/release/stable.txt)/bin/linux/amd64/kubectl

chmod +x ./kubectl

sudo mv ./kubectl /usr/local/bin/kubectl

curl -Lo minikube https://storage.googleapis.com/minikube/releases/v0.21.0/minikube-linux-amd64 && chmod +x minikube && sudo mv minikube /usr/local/bin/

使用 Minikube

我们先从这个 Dockerfile 创建一个镜像:

FROM busybox
ADD index.html /www/index.html
EXPOSE 8000
CMD httpd -p 8000 -h /www; tail -f /dev/null

添加你希望在 index.html 中看到的内容。

构建镜像:

docker build -t eon01/hello-world-web-server .

我们来运行容器来测试它:

docker run -d --name webserver -p 8000:8000 eon01/hello-world-web-server

这是 docker ps 的输出:

docker ps

CONTAINER ID        IMAGE                          COMMAND                  CREATED             STATUS              PORTS                    NAMES
2ad8d688d812        eon01/hello-world-web-server   "/bin/sh -c 'httpd..."   3 seconds ago       Up 2 seconds        0.0.0.0:8000->8000/tcp   webserver

让我们提交镜像并将其上传到公共 Docker Hub 中。你也可以使用自己的私有仓库:

docker commit webserver
docker push eon01/hello-world-web-server

删除容器,因为我们将与 Minikube 一起使用它。

docker rm -f webserver

启动 Minikube:

minkube start

检查状态:

minikube status

我们运行一个单一节点:

kubectl get node

运行 webserver:

kubectl run webserver --image=eon01/hello-world-web-server --port=8000

webserver 应该会暴露它的端口:

kubectl expose deployment webserver --type=NodePort

为了得到服务 url 输入:

minikube service webserver --url

使用下面的命令得到 Web 页面的内容:

curl $(minikube service webserver --url)

显示运行中集群的摘要:

kubectl cluster-info

更多细节:

kubectl cluster-info dump

我们还可以使用以下方式列出 pod:

kubectl get pods

使用下面的方式访问面板:

minikube dashboard

如果你想访问 Web 程序的前端,输入:

kubectl proxy

如果我们要在容器内部执行一个命令,请使用以下命令获取 pod id:

kubetctl get pods

然后像这样使用:

kubectl exec webserver-2022867364-0v1p9 -it -- /bin/sh

最后完成了,请删除所有部署:

kubectl delete deployments --all

删除所有 pod:

kubectl delete pods --all

并且停止 Minikube。

minikube stop

我希望你享受这个介绍。

更加深入

如果你对本文感到共鸣,您可以在无痛 Docker 教程中找到更多有趣的内容。

我们 Eralabs 将很乐意为你的 Docker 和云计算项目提供帮助,联系我们,我们将很乐意听到你的项目。

请订阅 DevOpsLinks:成千上万的 IT 专家和 DevOps 爱好者在线社区。

你可能也有兴趣加入我们的新闻订阅 Shipped,一个专注于容器,编排和无服务技术的新闻订阅。

你可以在 Twitter、Clarity 或我的网站上找到我,你也可以看看我的书:SaltStack For DevOps。

不要忘记加入我的最后一个项目 DevOps 的职位!

如果你喜欢本文,请推荐它,并与你的关注者分享。


作者简介:

Aymen El Amri - 云和软件架构师、企业家、作者、www.eralabs.io 的 CEO、www.devopslinks.com 的创始人,个人页面:www.aymenelamri.com


via: https://medium.com/devopslinks/using-kubernetes-minikube-for-local-development-c37c6e56e3db

作者:Aymen El Amri 译者:geekpi 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

无服务 serverless 是 托管服务 managed service 发展方向的又一步,并且与 Ansible 的无代理体系结构相得益彰。

Ansible 被设计为实际工作中的最简化的部署工具。这意味着它不是一个完整的编程语言。你需要编写定义任务的 YAML 模板,并列出任何需要自动完成的任务。

大多数人认为 Ansible 是一种更强大的“处于 for 循环中的 SSH”,在简单的使用场景下这是真的。但其实 Ansible 是任务,而非 SSH。在很多情况下,我们通过 SSH 进行连接,但它也支持 Windows 机器上的 Windows 远程管理(WinRM),以及作为云服务的通用语言的 HTTPS API 之类的东西。

在云中,Ansible 可以在两个独立的层面上操作: 控制面 control plane 和 实例资源 on-instance resource 。控制面由所有没有运行在操作系统上的东西组成。包括设置网络、新建实例、供给更高级别的服务,如亚马逊的 S3 或 DynamoDB,以及保持云基础设施安全和服务客户​​所需的一切。

实例上的工作是你已经知道 Ansible 可以做的:启动和停止服务、配置文件 模版化 templating 、安装软件包以及通过 SSH 执行的所有与操作系统相关的操作。

现在,什么是 无服务 serverless 呢?这要看你问谁,无服务要么是对公有云的无限延伸,或者是一个全新的范例,其中所有的东西都是 API 调用,以前从来没有这样做过。

Ansible 采取第一种观点。在 “无服务” 是专门术语之前,用户不得不管理和配置 EC2 实例、虚拟私有云 (VPC) 网络以及其他所有内容。无服务是托管服务方向迈出的另一步,并且与 Ansible 的无代理体系结构相得益彰。

在我们开始 Lambda 示例之前,让我们来看一个简单的配置 CloudFormation 栈任务:

- name: Build network
  cloudformation:
    stack_name: prod-vpc
    state: present
    template: base_vpc.yml

编写这样的任务只需要几分钟,但它是构建基础架构所涉及的最后的半手动步骤 - 点击 “Create Stack” - 这将 playbook 与其他放在一起。现在你的 VPC 只是在建立新区域时可以调用的另一项任务了。

由于云提供商是你帐户中发生些什么的真相来源,因此 Ansible 有许多方法来取回并使用 ID、名称和其他参数来过滤和查询运行的实例或网络。以 cloudformation_facts 模块为例,我们可以从我们刚刚创建的模板中得到子网 ID、网络范围和其他数据。

- name: Pull all new resources back in as a variable
  cloudformation_facts:
    stack_name: prod-vpc
  register: network_stack

对于无服务应用,除了 DynamoDB 表,S3 bucket 和其他任何其他功能之外,你肯定还需要一个 Lambda 函数的补充。幸运的是,通过使用 lambda 模块, Lambda 函数可以以上次任务的堆栈相同的方式创建:

- lambda:
    name: sendReportMail
    zip_file: "{{ deployment_package }}"
    runtime: python3.6
    handler: report.send
    memory_size: 1024
    role: "{{ iam_exec_role }}"
  register: new_function

如果你有其他想用来交付无服务应用的工具,这也是可以的。开源的无服务框架有自己的 Ansible 模块,它也可以工作:

- serverless:
    service_path: '{{ project_dir }}'
    stage: dev
  register: sls
- name: Serverless uses CloudFormation under the hood, so you can easily pull info back into Ansible
  cloudformation_facts:
    stack_name: "{{ sls.service_name }}"
  register: sls_facts

这不是你需要的全部,因为无服务项目也必须存在,你将在那里大量的定义你的函数和事件源。对于此例,我们将制作一个响应 HTTP 请求的函数。无服务框架使用 YAML 作为其配置语言(和 Ansible 一样),所以这应该看起来很熟悉。

# serverless.yml
service: fakeservice

provider:
  name: aws
  runtime: python3.6

functions:
  main:
    handler: test_function.handler
    events:
      - http:
          path: /
          method: get

在 AnsibleFest 中,我将介绍这个例子和其他深入的部署策略,以最大限度地利用你已经拥有的 playbook 和基础设施,还有新的无服务实践。无论你是否能到,我希望这些例子可以让你开始使用 Ansible,无论你是否有任何服务要管理。

AnsibleFest 是一个单日会议,汇集了数百名 Ansible 用户、开发人员和行业合作伙伴。加入我们吧,这里有产品更新、鼓舞人心的交谈、技术深度潜水,动手演示和整天的网络。

(题图: opensource.com)


via: https://opensource.com/article/17/8/ansible-serverless-applications

作者:Ryan Scott Brown 译者:geekpi 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

你有没有问过自己,我应该在哪里运行 OpenShift?答案是任何地方 - 它可以在裸机、虚拟机、私有云或公共云中很好地运行。但是,这里有一些为什么人们正迁移到围绕全栈和资源消耗自动化相关的私有云和公有云的原因。传统的操作系统一直是关于硬件资源的展示和消耗 - 硬件提供资源,应用程序消耗它们,操作系统一直是交通警察。但传统的操作系统一直局限于单机 注1 。

那么,在原生云的世界里,现在意味着这个概念扩展到包括多个操作系统实例。这就是 OpenStack 和 OpenShift 所在。在原生云世界,虚拟机、存储卷和网段都成为动态配置的构建块。我们从这些构建块构建我们的应用程序。它们通常按小时或分钟付费,并在不再需要时被取消配置。但是,你需要将它们视为应用程序的动态配置能力。 OpenStack 在动态配置能力(展示)方面非常擅长,OpenShift 在动态配置应用程序(消费)方面做的很好,但是我们如何将它们结合在一起来提供一个动态的、高度可编程的多节点操作系统呢?

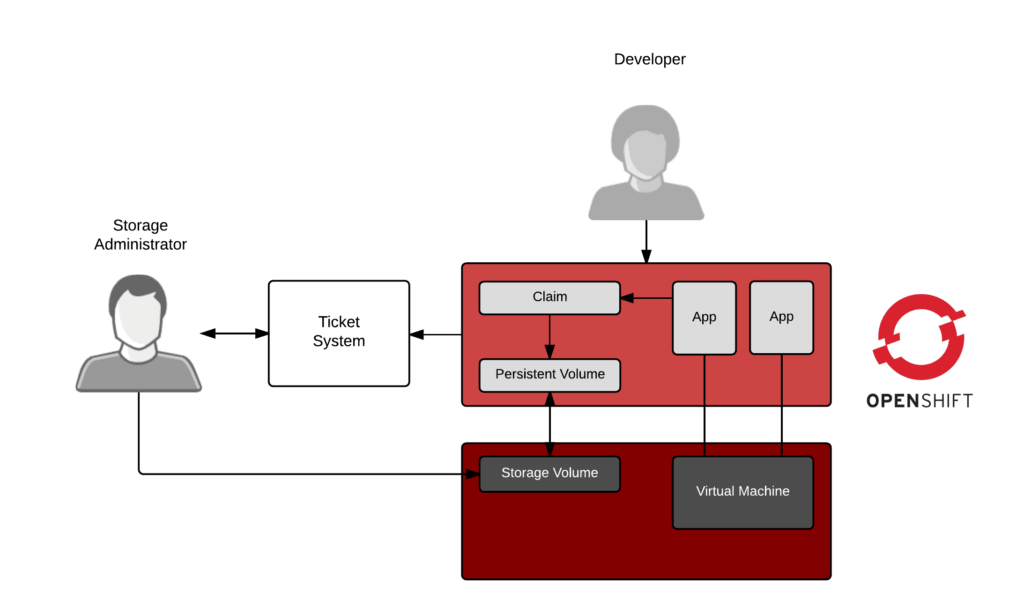
要理解这个,让我们来看看如果我们在传统的环境中安装 OpenShift 会发生什么 - 想像我们想要为开发者提供动态访问来创建新的应用程序,或者想象我们想要提供业务线,使其能够访问现有应用程序的新副本以满足合同义务。每个应用程序都需要访问持久存储。持久存储不是临时的,在传统的环境中,这通过提交一张工单实现。没关系,我们可以连到 OpenShift,每次需要存储时都会提交一张工单。存储管理员可以登录企业存储阵列并根据需要删除卷,然后将其移回 OpenShift 以满足应用程序。但这将是一个非常慢的手动过程,而且你可能会遇到存储管理员辞职。

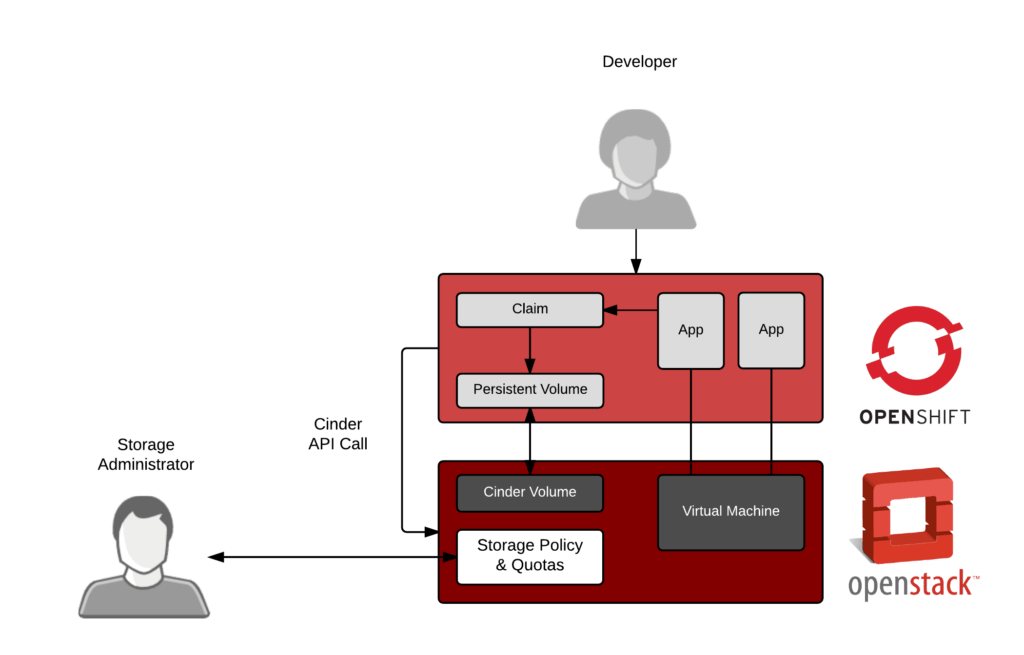
在原生云的世界里,我们应该将其视为一个策略驱动的自动化流程。存储管理员变得更加战略性、设置策略、配额和服务级别(银、黄金等),但实际配置变得动态。

动态过程可扩展到多个应用程序 - 这可能是开发者测试的业务线甚至新应用程序。从 10 多个应用程序到 1000 个应用程序,动态配置提供原生云体验。

下面的演示视频展示了动态存储配置如何与 Red Hat OpenStack 平台(Cinder 卷)以及 Red Hat OpenShift 容器平台配合使用,但动态配置并不限于存储。想象一下,随着 OpenShift 的一个实例需要更多的容量、节点自动扩展的环境。想象一下,推送一个敏感的程序更改前,将网段划分为负载测试 OpenShift 的特定实例。这些是你为何需要动态配置 IT 构建块的原因。OpenStack 实际上是以 API 驱动的方式实现的。

OpenShift 和 OpenStack 一起更好地交付应用程序。OpenStack 动态提供资源,而 OpenShift 会动态地消耗它们。它们一起为你所有的容器和虚拟机需求提供灵活的原生云解决方案。

注1:高可用性集群和一些专门的操作系统在一定程度上弥合了这一差距,但在计算中通常是一个边缘情况。


via: https://blog.openshift.com/openshift-on-openstack-delivering-applications-better-together/

作者:SCOTT MCCARTY 译者:geekpi 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出