分类 技术 下的文章

Linux 桌面从开始的简陋到现在走了很长的路。在我早期使用 Linux 的那段日子里,掌握命令行是最基本的 —— 即使是在桌面版。不过现在变了,很多人可能从没用过命令行。但对于 Linux 系统管理员来说,可不能这样。实际上,对于任何 Linux 管理员(不管是服务器还是桌面),命令行仍是必须的。从管理网络到系统安全,再到应用和系统设定 —— 没有什么工具比命令行更强大。

但是,实际上……你可以在 Linux 系统里找到非常多命令。比如只看 /usr/bin 目录,你就可以找到很多命令执行文件(你可以运行 ls/usr/bin/ | wc -l 看一下你的系统里这个目录下到底有多少命令)。当然,它们并不全是针对用户的执行文件,但是可以让你感受下 Linux 命令数量。在我的 Elementary OS 系统里,目录 /usr/bin 下有 2029 个可执行文件。尽管我只会用到其中的一小部分,我要怎么才能记住这一部分呢?

幸运的是,你可以使用一些工具和技巧,这样你就不用每天挣扎着去记忆这些命令了。我想和大家分享几个这样的小技巧,希望能让你们能稍微有效地使用命令行(顺便节省点脑力)。

我们从一个系统内置的工具开始介绍,然后再介绍两个可以安装的非常实用的程序。

Bash 命令历史

不管你知不知道,Bash(最流行的 Linux shell)会保留你执行过的命令的历史。想实际操作下看看吗?有两种方式。打开终端窗口然后按向上方向键。你应该可以看到会有命令出现,一个接一个。一旦你找到了想用的命令,不用修改的话,可以直接按 Enter 键执行,或者修改后再按 Enter 键。

要重新执行(或修改一下再执行)之前运行过的命令,这是一个很好的方式。我经常用这个功能。它不仅仅让我不用去记忆一个命令的所有细节,而且可以不用一遍遍重复地输入同样的命令。

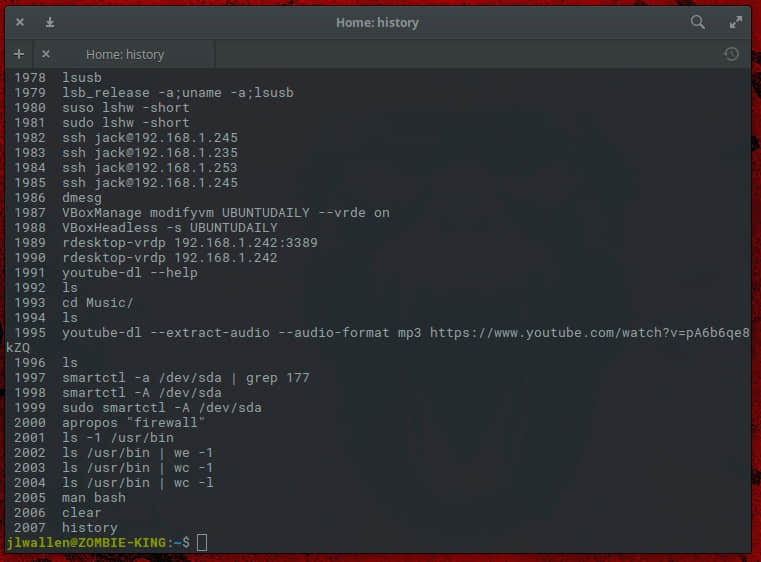
说到 Bash 的命令历史,如果你执行命令 history,你可以列出你过去执行过的命令列表(图 1)。

 title=

图 1: 你能找到我敲的命令里的错误吗?

你的 Bash 命令历史保存的历史命令的数量可以在 ~/.bashrc 文件里设置。在这个文件里,你可以找到下面两行:

HISTSIZE=1000

HISTFILESIZE=2000

HISTSIZE 是命令历史列表里记录的命令的最大数量,而 HISTFILESIZE 是命令历史文件的最大行数。

显然,默认情况下,Bash 会记录你的 1000 条历史命令。这已经很多了。有时候,这也被认为是一个安全漏洞。如果你在意的话,你可以随意减小这个数值,在安全性和实用性之间平衡。如果你不希望 Bash 记录你的命令历史,可以将 HISTSIZE 设置为 0。

如果你修改了 ~/.bashrc 文件,记得要登出后再重新登录(否则改动不会生效)。

apropos

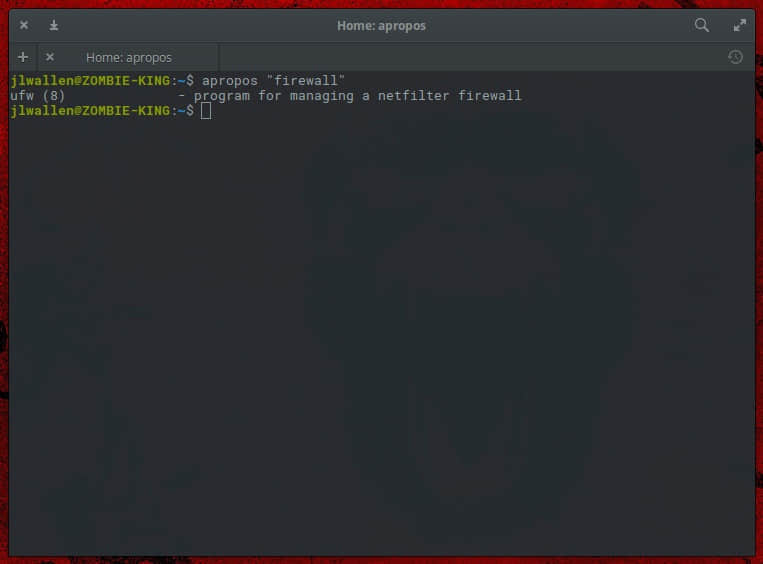
这是第一个我要介绍的工具,可以帮助你记忆 Linux 命令。apropos (意即“关于”)能够搜索 Linux 帮助文档来帮你找到你想要的命令。比如说,你不记得你用的发行版用的什么防火墙工具了。你可以输入 apropos “firewall” ,然后这个工具会返回相关的命令(图 2)。

 title=

图 2: 你用的什么防火墙?

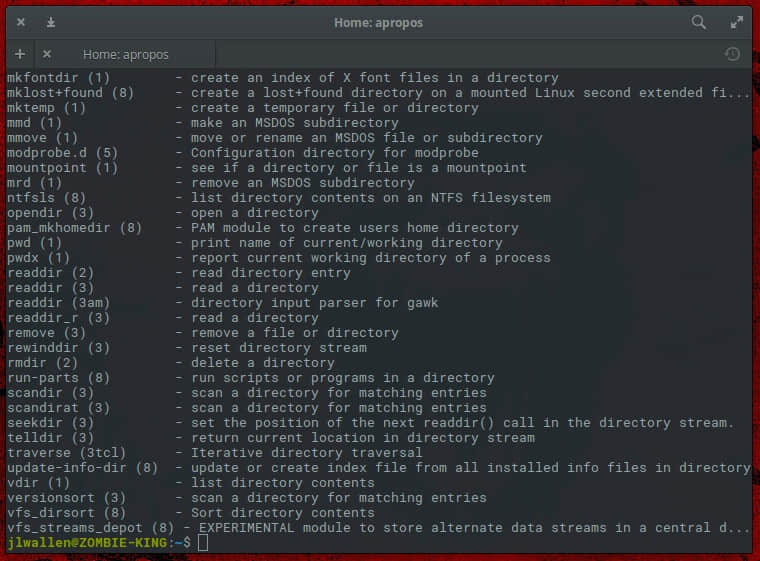
再假如你需要一个操作目录的命令,但是完全不知道要用哪个呢?输入 apropos “directory” 就可以列出在帮助文档里包含了字符 “directory” 的所有命令(图 3)。

 title=

图 3: 可以操作目录的工具有哪些呢?

apropos 工具在几乎所有 Linux 发行版里都会默认安装。

Fish

还有另一个能帮助你记忆命令的很好的工具。Fish 是 Linux/Unix/Mac OS 的一个命令行 shell,有一些很好用的功能。

  • 自动推荐
  • VGA 颜色
  • 完美的脚本支持
  • 基于网页的配置
  • 帮助文档自动补全
  • 语法高亮
  • 以及更多

自动推荐功能让 fish 非常方便(特别是你想不起来一些命令的时候)。

你可能觉得挺好,但是 fish 没有被默认安装。对于 Ubuntu(以及它的衍生版),你可以用下面的命令安装:

sudo apt-add-repository ppa:fish-shell/release-2
sudo apt update
sudo apt install fish

对于类 CentOS 系统,可以这样安装 fish。用下面的命令增加仓库:

sudo -s
cd /etc/yum.repos.d/
wget http://download.opensuse.org/repositories/shells:fish:release:2/CentOS_7/shells:fish:release:2.repo

用下面的命令更新仓库:

yum repolist
yum update

然后用下面的命令安装 fish:

yum install fish

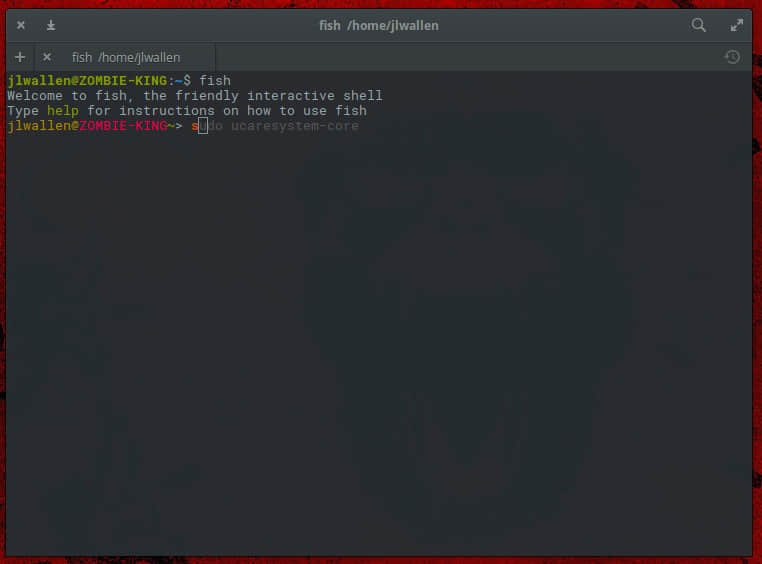
fish 用起来可能没你想象的那么直观。记住,fish 是一个 shell,所以在使用命令之前你得先登录进去。在你的终端里,运行命令 fish 然后你就会看到自己已经打开了一个新的 shell(图 4)。

 title=

图 4: fish 的交互式 shell。

在开始输入命令的时候,fish 会自动补齐命令。如果推荐的命令不是你想要的,按下键盘的 Tab 键可以浏览更多选择。如果正好是你想要的,按下键盘的向右键补齐命令,然后按下 Enter 执行。在用完 fish 后,输入 exit 来退出 shell。

Fish 还可以做更多事情,但是这里只介绍用来帮助你记住命令,自动推荐功能足够了。

保持学习

Linux 上有太多的命令了。但你也不用记住所有命令。多亏有 Bash 命令历史以及像 apropos 和 fish 这样的工具,你不用消耗太多记忆来回忆那些帮你完成任务的命令。


via: https://www.linux.com/learn/intro-to-linux/2017/10/3-tools-help-you-remember-linux-commands

作者:JACK WALLEN 译者:zpl1025 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

前段时间新的重大版本的 PostgreSQL 10 发布了! 强烈建议阅读公告、发布说明和“新功能”概述可以在这里、这里和这里。像往常一样,已经有相当多的博客覆盖了所有新的东西,但我猜每个人都有自己认为重要的角度,所以与 9.6 版一样我再次在这里列出我印象中最有趣/相关的功能。

与往常一样,升级或初始化一个新集群的用户将获得更好的性能(例如,更好的并行索引扫描、合并 join 和不相关的子查询,更快的聚合、远程服务器上更加智能的 join 和聚合),这些都开箱即用,但本文中我想讲一些不能开箱即用,实际上你需要采取一些步骤才能从中获益的内容。下面重点展示的功能是从 DBA 的角度来汇编的,很快也有一篇文章从开发者的角度讲述更改。

升级注意事项

首先有些从现有设置升级的提示 - 有一些小的事情会导致从 9.6 或更旧的版本迁移时引起问题,所以在真正的升级之前,一定要在单独的副本上测试升级,并遍历发行说明中所有可能的问题。最值得注意的缺陷是:

  • 所有包含 “xlog” 的函数都被重命名为使用 “wal” 而不是 “xlog”。

后一个命名可能与正常的服务器日志混淆,因此这是一个“以防万一”的更改。如果使用任何第三方备份/复制/HA 工具,请检查它们是否为最新版本。

  • 存放服务器日志(错误消息/警告等)的 pg\_log 文件夹已重命名为 “log”。

确保验证你的日志解析或 grep 脚本(如果有)可以工作。

  • 默认情况下,查询将最多使用 2 个后台进程。

如果在 CPU 数量较少的机器上在 postgresql.conf 设置中使用默认值 10,则可能会看到资源使用率峰值,因为默认情况下并行处理已启用 - 这是一件好事,因为它应该意味着更快的查询。如果需要旧的行为,请将 max_parallel_workers_per_gather 设置为 0。

  • 默认情况下,本地主机的复制连接已启用。

为了简化测试等工作,本地主机和本地 Unix 套接字复制连接现在在 pg_hba.conf 中以“ 信任 trust ”模式启用(无密码)!因此,如果其他非 DBA 用户也可以访问真实的生产计算机,请确保更改配置。

从 DBA 的角度来看我的最爱

  • 逻辑复制

这个期待已久的功能在你只想要复制一张单独的表、部分表或者所有表时只需要简单的设置而性能损失最小,这也意味着之后主要版本可以零停机升级!历史上(需要 Postgres 9.4+),这可以通过使用第三方扩展或缓慢的基于触发器的解决方案来实现。对我而言这是 10 最好的功能。

  • 声明分区

以前管理分区的方法通过继承并创建触发器来把插入操作重新路由到正确的表中,这一点很烦人,更不用说性能的影响了。目前支持的是 “range” 和 “list” 分区方案。如果有人在某些数据库引擎中缺少 “哈希” 分区,则可以使用带表达式的 “list” 分区来实现相同的功能。

  • 可用的哈希索引

哈希索引现在是 WAL 记录的,因此是崩溃安全的,并获得了一些性能改进,对于简单的搜索,它们比在更大的数据上的标准 B 树索引快。也支持更大的索引大小。

  • 跨列优化器统计

这样的统计数据需要在一组表的列上手动创建,以指出这些值实际上是以某种方式相互依赖的。这将能够应对计划器认为返回的数据很少(概率的乘积通常会产生非常小的数字)从而导致在大量数据下性能不好的的慢查询问题(例如选择“嵌套循环” join)。

  • 副本上的并行快照

现在可以在 pg\_dump 中使用多个进程(-jobs 标志)来极大地加快备用服务器上的备份。

  • 更好地调整并行处理 worker 的行为

参考 max_parallel_workers 和 min_parallel_table_scan_size/min_parallel_index_scan_size 参数。我建议增加一点后两者的默认值(8MB、512KB)。

  • 新的内置监控角色,便于工具使用

新的角色 pg_monitor、pg_read_all_settings、pg_read_all_stats 和 pg_stat_scan_tables 能更容易进行各种监控任务 - 以前必须使用超级用户帐户或一些 SECURITY DEFINER 包装函数。

  • 用于更安全的副本生成的临时 (每个会话) 复制槽
  • 用于检查 B 树索引的有效性的一个新的 Contrib 扩展

这两个智能检查发现结构不一致和页面级校验未覆盖的内容。希望不久的将来能更加深入。

  • Psql 查询工具现在支持基本分支(if/elif/else)

例如下面的将启用具有特定版本分支(对 pg\_stat* 视图等有不同列名)的单个维护/监视脚本,而不是许多版本特定的脚本。

SELECT :VERSION_NAME = '10.0' AS is_v10 \gset 
\if :is_v10
SELECT 'yippee' AS msg;
\else
SELECT 'time to upgrade!' AS msg;
\endif

这次就这样了!当然有很多其他的东西没有列出,所以对于专职 DBA,我一定会建议你更全面地看发布记录。非常感谢那 300 多为这个版本做出贡献的人!


via: http://www.cybertec.at/best-of-postgresql-10-for-the-dba/

作者:Kaarel Moppel 译者:geekpi 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

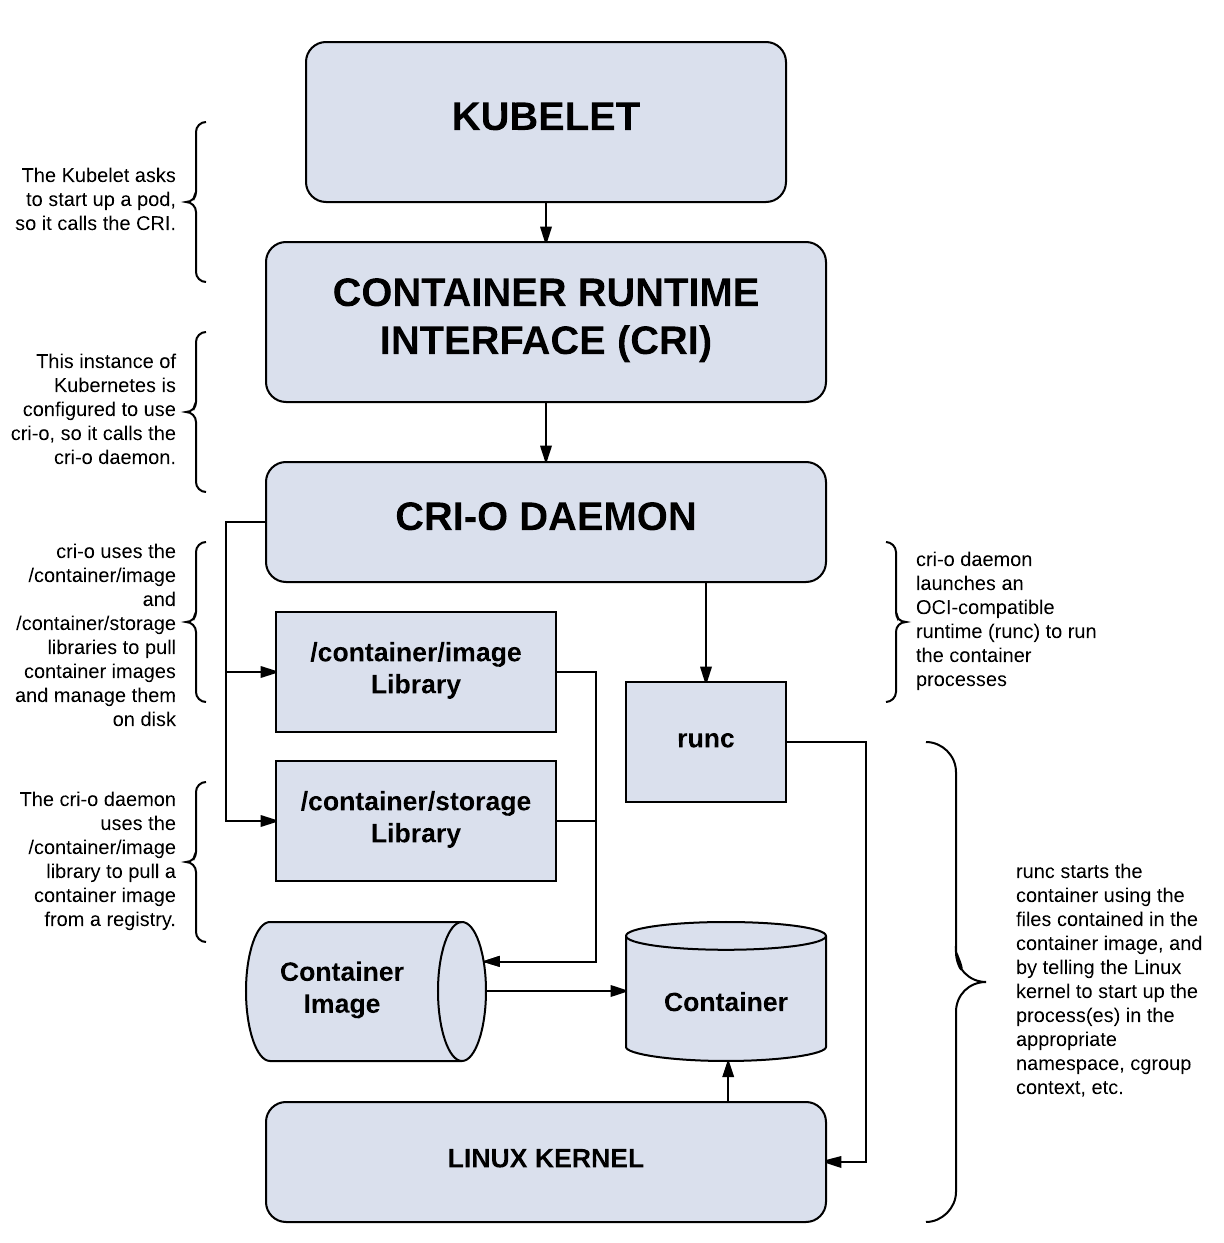
去年,Kubernetes 项目推出了 容器运行时接口 Container Runtime Interface (CRI):这是一个插件接口,它让 kubelet(用于创建 pod 和启动容器的集群节点代理)有使用不同的兼容 OCI 的容器运行时的能力,而不需要重新编译 Kubernetes。在这项工作的基础上,CRI-O 项目(原名 OCID)准备为 Kubernetes 提供轻量级的运行时。

那么这个真正的是什么意思?

CRI-O 允许你直接从 Kubernetes 运行容器,而不需要任何不必要的代码或工具。只要容器符合 OCI 标准,CRI-O 就可以运行它,去除外来的工具,并让容器做其擅长的事情:加速你的新一代原生云程序。

在引入 CRI 之前,Kubernetes 通过“一个内部的易失性接口”与特定的容器运行时相关联。这导致了上游 Kubernetes 社区以及在编排平台之上构建解决方案的供应商的大量维护开销。

使用 CRI,Kubernetes 可以与容器运行时无关。容器运行时的提供者不需要实现 Kubernetes 已经提供的功能。这是社区的胜利,因为它让项目独立进行,同时仍然可以共同工作。

在大多数情况下,我们不认为 Kubernetes 的用户(或 Kubernetes 的发行版,如 OpenShift)真的关心容器运行时。他们希望它工作,但他们不希望考虑太多。就像你(通常)不关心机器上是否有 GNU Bash、Korn、Zsh 或其它符合 POSIX 标准 shell。你只是要一个标准的方式来运行你的脚本或程序而已。

CRI-O:Kubernetes 的轻量级容器运行时

这就是 CRI-O 提供的。该名称来自 CRI 和开放容器计划(OCI),因为 CRI-O 严格关注兼容 OCI 的运行时和容器镜像。

现在,CRI-O 支持 runc 和 Clear Container 运行时,尽管它应该支持任何遵循 OCI 的运行时。它可以从任何容器仓库中拉取镜像,并使用 容器网络接口 Container Network Interface (CNI)处理网络,以便任何兼容 CNI 的网络插件可与该项目一起使用。

当 Kubernetes 需要运行容器时,它会与 CRI-O 进行通信,CRI-O 守护程序与 runc(或另一个符合 OCI 标准的运行时)一起启动容器。当 Kubernetes 需要停止容器时,CRI-O 会来处理。这没什么令人兴奋的,它只是在幕后管理 Linux 容器,以便用户不需要担心这个关键的容器编排。

 title=

CRI-O 不是什么

值得花一点时间了解下 CRI-O 不是什么。CRI-O 的范围是与 Kubernetes 一起工作来管理和运行 OCI 容器。这不是一个面向开发人员的工具,尽管该项目确实有一些面向用户的工具进行故障排除。

例如,构建镜像超出了 CRI-O 的范围,这些留给像 Docker 的构建命令、 Buildah 或 OpenShift 的 Source-to-Image(S2I)这样的工具。一旦构建完镜像,CRI-O 将乐意运行它,但构建镜像留给其他工具。

虽然 CRI-O 包含命令行界面 (CLI),但它主要用于测试 CRI-O,而不是真正用于在生产环境中管理容器的方法。

下一步

现在 CRI-O 1.0 发布了,我们希望看到它作为一个稳定功能在下一个 Kubernetes 版本中发布。1.0 版本将与 Kubernetes 1.7.x 系列一起使用,即将发布的 CRI-O 1.8-rc1 适合 Kubernetes 1.8.x。

我们邀请您加入我们,以促进开源 CRI-O 项目的开发,并感谢我们目前的贡献者为达成这一里程碑而提供的帮助。如果你想贡献或者关注开发,就去 CRI-O 项目的 GitHub 仓库,然后关注 CRI-O 博客。


via: https://www.redhat.com/en/blog/introducing-cri-o-10

作者:Joe Brockmeier 译者:geekpi 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

QEMU 和 FreeDOS 使得很容易在 Linux 中运行老的 DOS 程序

传统的 DOS 操作系统支持的许多非常优秀的应用程序: 文字处理,电子表格,游戏和其它的程序。但是一个应用程序太老了,并不意味着它没用了。

如今有很多理由去运行一个旧的 DOS 应用程序。或许是从一个遗留的业务应用程序中提取一个报告,或者是想玩一个经典的 DOS 游戏,或者只是因为你对“传统计算机”很好奇。你不需要去双引导你的系统去运行 DOS 程序。取而代之的是,你可以在 Linux 中在一个 PC 仿真程序和 FreeDOS 的帮助下去正确地运行它们。

FreeDOS 是一个完整的、免费的、DOS 兼容的操作系统,你可以用它来玩经典的游戏、运行旧式业务软件,或者开发嵌入式系统。任何工作在 MS-DOS 中的程序也可以运行在 FreeDOS 中。

在那些“过去的时光”里,你安装的 DOS 是作为一台计算机上的独占操作系统。 而现今,它可以很容易地安装到 Linux 上运行的一台虚拟机中。 QEMU ( 快速仿真程序 Quick EMUlator 的缩写) 是一个开源的虚拟机软件,它可以在 Linux 中以一个“ 访客 guest ”操作系统来运行 DOS。许多流行的 Linux 系统都默认包含了 QEMU 。

通过以下四步,很容易地在 Linux 下通过使用 QEMU 和 FreeDOS 去运行一个老的 DOS 程序。

第 1 步:设置一个虚拟磁盘

你需要一个地方来在 QEMU 中安装 FreeDOS,为此你需要一个虚拟的 C: 驱动器。在 DOS 中,字母A: 和 B: 是分配给第一和第二个软盘驱动器的,而 C: 是第一个硬盘驱动器。其它介质,包括其它硬盘驱动器和 CD-ROM 驱动器,依次分配 D:、E: 等等。

在 QEMU 中,虚拟磁盘是一个镜像文件。要初始化一个用做虚拟 C: 驱动器的文件,使用 qemu-img 命令。要创建一个大约 200 MB 的镜像文件,可以这样输入:

qemu-img create dos.img 200M

与现代计算机相比, 200MB 看起来非常小,但是早在 1990 年代, 200MB 是非常大的。它足够安装和运行 DOS。

第 2 步: QEMU 选项

与 PC 仿真系统 VMware 或 VirtualBox 不同,你需要通过 QEMU 命令去增加每个虚拟机的组件来 “构建” 你的虚拟系统 。虽然,这可能看起来很费力,但它实际并不困难。这些是我们在 QEMU 中用于去引导 FreeDOS 的参数:

qemu-system-i386QEMU 可以仿真几种不同的系统,但是要引导到 DOS,我们需要有一个 Intel 兼容的 CPU。 为此,使用 i386 命令启动 QEMU。
-m 16我喜欢定义一个使用 16MB 内存的虚拟机。它看起来很小,但是 DOS 工作不需要很多的内存。在 DOS 时代,计算机使用 16MB 或者 8MB 内存是非常普遍的。
-k en-us从技术上说,这个 -k 选项是不需要的,因为 QEMU 会设置虚拟键盘去匹配你的真实键盘(在我的例子中, 它是标准的 US 布局的英语键盘)。但是我还是喜欢去指定它。
-rtc base=localtime每个传统的 PC 设备有一个实时时钟 (RTC) 以便于系统可以保持跟踪时间。我发现它是设置虚拟 RTC 匹配你的本地时间的最简单的方法。
-soundhw sb16,adlib,pcspk如果你需要声音,尤其是为了玩游戏时,我更喜欢定义 QEMU 支持 SoundBlaster 16 声音硬件和 AdLib 音乐。SoundBlaster 16 和 AdLib 是在 DOS 时代非常常见的声音硬件。一些老的程序也许使用 PC 喇叭发声; QEMU 也可以仿真这个。
-device cirrus-vga要使用图像,我喜欢去仿真一个简单的 VGA 视频卡。Cirrus VGA 卡是那时比较常见的图形卡, QEMU 可以仿真它。
-display gtk对于虚拟显示,我设置 QEMU 去使用 GTK toolkit,它可以将虚拟系统放到它自己的窗口内,并且提供一个简单的菜单去控制虚拟机。
-boot order=你可以告诉 QEMU 从多个引导源来引导虚拟机。从软盘驱动器引导(在 DOS 机器中一般情况下是 A: )指定 order=a。 从第一个硬盘驱动器引导(一般称为 C:) 使用 order=c。 或者去从一个 CD-ROM 驱动器(在 DOS 中经常分配为 D: ) 使用 order=d。 你可以使用组合字母去指定一个特定的引导顺序, 比如 order=dc 去第一个使用 CD-ROM 驱动器,如果 CD-ROM 驱动器中没有引导介质,然后使用硬盘驱动器。

第 3 步: 引导和安装 FreeDOS

现在 QEMU 已经设置好运行虚拟机,我们需要一个 DOS 系统来在那台虚拟机中安装和引导。 FreeDOS 做这个很容易。它的最新版本是 FreeDOS 1.2, 发行于 2016 年 12 月。

从 FreeDOS 网站上下载 FreeDOS 1.2 的发行版。 FreeDOS 1.2 CD-ROM “standard” 安装器 (FD12CD.iso) 可以很好地在 QEMU 上运行,因此,我推荐使用这个版本。

安装 FreeDOS 很简单。首先,告诉 QEMU 使用 CD-ROM 镜像并从其引导。 记住,第一个硬盘驱动器是 C: 驱动器,因此, CD-ROM 将以 D: 驱动器出现。

qemu-system-i386 -m 16 -k en-us -rtc base=localtime -soundhw sb16,adlib -device cirrus-vga -display gtk -hda dos.img -cdrom FD12CD.iso -boot order=d

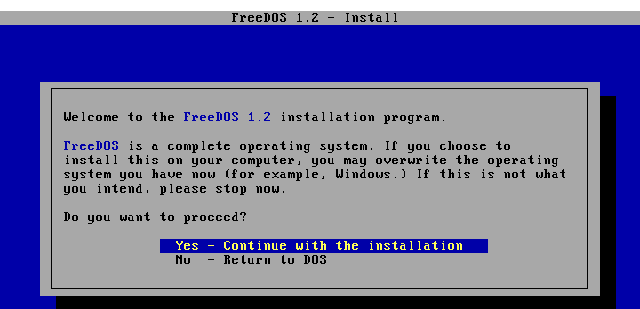
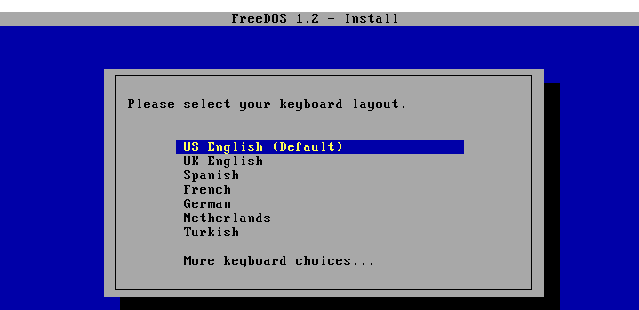
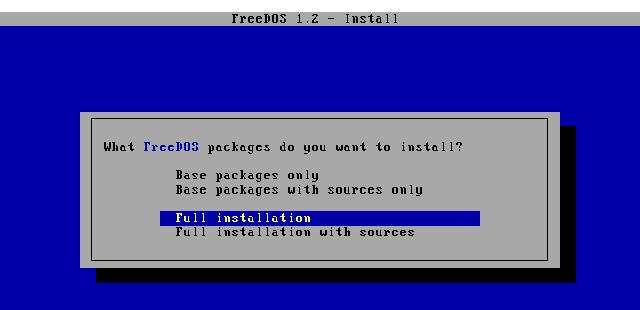
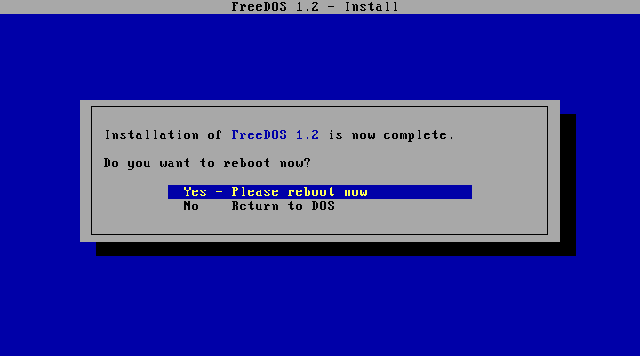
正如下面的提示,你将在几分钟内安装完成 FreeDOS 。

 title=

 title=

 title=

 title=

在你安装完成之后,关闭窗口退出 QEMU。

第 4 步:安装并运行你的 DOS 应用程序

一旦安装完 FreeDOS,你可以在 QEMU 中运行各种 DOS 应用程序。你可以在线上通过各种档案文件或其它网站找到老的 DOS 程序。

QEMU 提供了一个在 Linux 上访问本地文件的简单方法。比如说,想去用 QEMU 共享 dosfiles/ 文件夹。 通过使用 -drive 选项,简单地告诉 QEMU 去使用这个文件夹作为虚拟的 FAT 驱动器。 QEMU 将像一个硬盘驱动器一样访问这个文件夹。

-drive file=fat:rw:dosfiles/

现在,你可以使用合适的选项去启动 QEMU,加上一个外部的虚拟 FAT 驱动器:

qemu-system-i386 -m 16 -k en-us -rtc base=localtime -soundhw sb16,adlib -device cirrus-vga -display gtk -hda dos.img -drive file=fat:rw:dosfiles/ -boot order=c

一旦你引导进入 FreeDOS,你保存在 D: 驱动器中的任何文件将被保存到 Linux 上的 dosfiles/ 文件夹中。可以从 Linux 上很容易地直接去读取该文件;然而,必须注意的是,启动 QEMU 后,不能从 Linux 中去改变 dosfiles/ 这个文件夹。 当你启动 QEMU 时,QEMU 一次性构建一个虚拟的 FAT 表,如果你在启动 QEMU 之后,在 dosfiles/ 文件夹中增加或删除文件,仿真程序可能会很困惑。

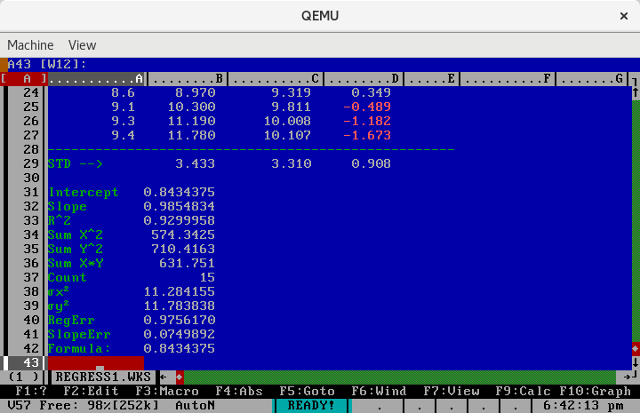
我使用 QEMU 像这样运行一些我收藏的 DOS 程序, 比如 As-Easy-As 电子表格程序。这是一个在上世纪八九十年代非常流行的电子表格程序,它和现在的 Microsoft Excel 和 LibreOffice Calc 或和以前更昂贵的 Lotus 1-2-3 电子表格程序完成的工作是一样的。 As-Easy-As 和 Lotus 1-2-3 都保存数据为 WKS 文件,最新版本的 Microsoft Excel 不能读取它,但是,根据兼容性, LibreOffice Calc 可以支持它。

 title=

As-Easy-As 电子表格程序

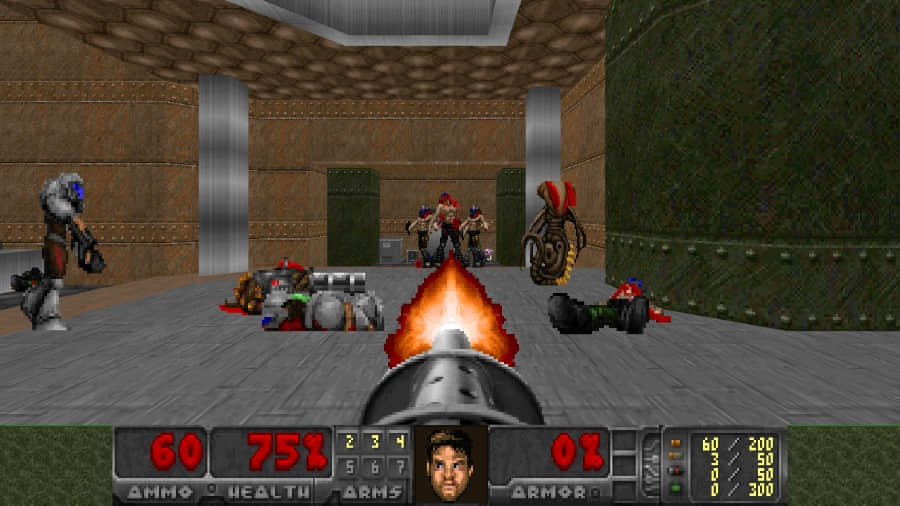
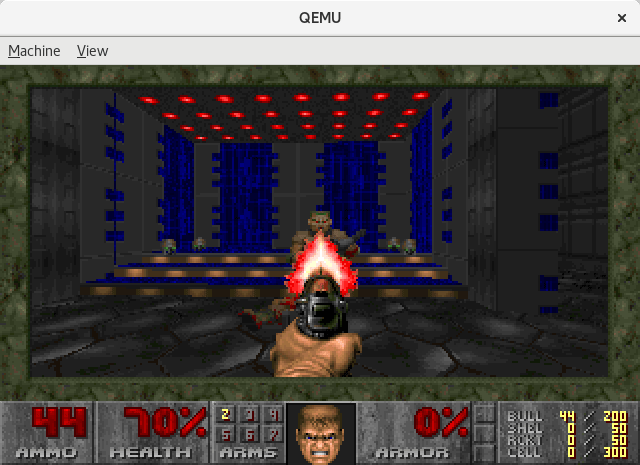
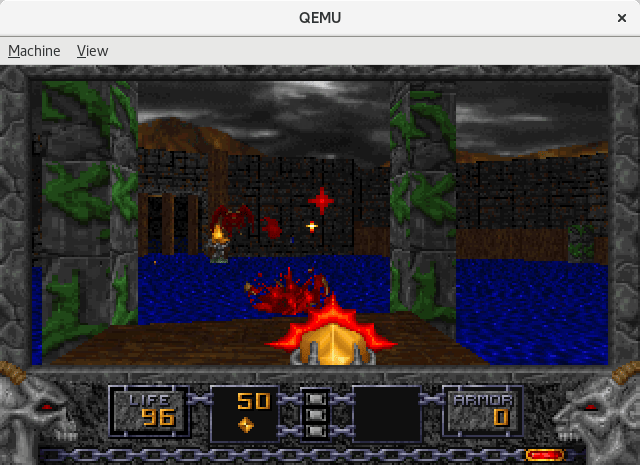
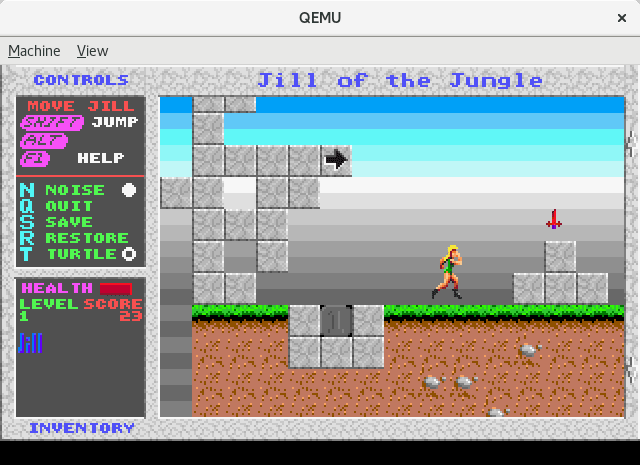
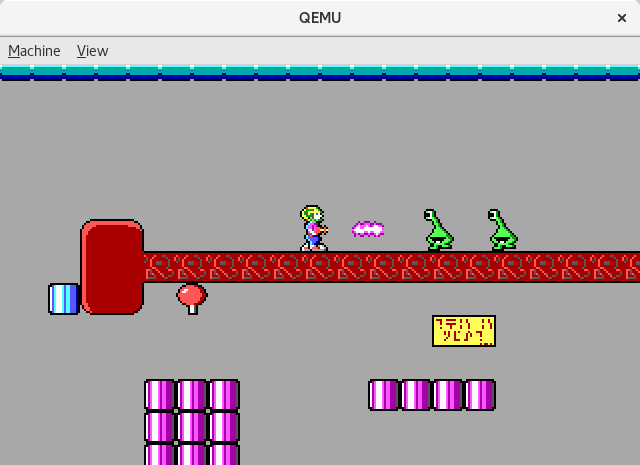
我也喜欢在 QEMU中引导 FreeDOS 去玩一些收藏的 DOS 游戏,比如原版的 Doom。这些老的 DOS 游戏玩起来仍然非常有趣, 并且它们现在在 QEMU 上运行的非常好。

 title=

Doom

 title=

Heretic

 title=

Jill of the Jungle

 title=

Commander Keen

QEMU 和 FreeDOS 使得在 Linux 上运行老的 DOS 程序变得很容易。你一旦设置好了 QEMU 作为虚拟机仿真程序并安装了 FreeDOS,你将可以在 Linux 上运行你收藏的经典的 DOS 程序。

所有图片要致谢 FreeDOS.org。


作者简介:

Jim Hall 是一位开源软件的开发者和支持者,可能最广为人知的是他是 FreeDOS 的创始人和项目协调者。 Jim 也非常活跃于开源软件适用性领域,作为 GNOME Outreachy 适用性测试的导师,同时也作为一名兼职教授,教授一些开源软件适用性的课程,从 2016 到 2017, Jim 在 GNOME 基金会的董事会担任董事,在工作中, Jim 是本地政府部门的 CIO。


via: https://opensource.com/article/17/10/run-dos-applications-linux

作者:Jim Hall 译者:qhwdw 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

了解应用程序的输入/输出(I/O)模型意味着理解应用程序处理其数据的载入差异,并揭示其在真实环境中表现。或许你的应用程序很小,在不承受很大的负载时,这并不是个严重的问题;但随着应用程序的流量负载增加,可能因为使用了低效的 I/O 模型导致承受不了而崩溃。

和大多数情况一样,处理这种问题的方法有多种方式,这不仅仅是一个择优的问题,而是对权衡的理解问题。 接下来我们来看看 I/O 到底是什么。
Cover Photo: Server-side I/O: Node vs. PHP vs. Java vs. Go

在本文中,我们将对 Node、Java、Go 和 PHP + Apache 进行对比,讨论不同语言如何构造其 I/O ,每个模型的优缺点,并总结一些基本的规律。如果你担心你的下一个 Web 应用程序的 I/O 性能,本文将给你最优的解答。

I/O 基础知识: 快速复习

要了解 I/O 所涉及的因素,我们首先深入到操作系统层面复习这些概念。虽然看起来并不与这些概念直接打交道,但你会一直通过应用程序的运行时环境与它们间接接触。了解细节很重要。

系统调用

首先是系统调用,其被描述如下:

  • 程序(所谓“ 用户端 user land ”)必须请求操作系统内核代表它执行 I/O 操作。
  • “ 系统调用 syscall ”是你的程序要求内核执行某些操作的方法。这些实现的细节在操作系统之间有所不同,但基本概念是相同的。有一些具体的指令会将控制权从你的程序转移到内核(类似函数调用,但是使用专门用于处理这种情况的专用方式)。一般来说,系统调用会被阻塞,这意味着你的程序会等待内核返回(控制权到)你的代码。
  • 内核在所需的物理设备( 磁盘、网卡等 )上执行底层 I/O 操作,并回应系统调用。在实际情况中,内核可能需要做许多事情来满足你的要求,包括等待设备准备就绪、更新其内部状态等,但作为应用程序开发人员,你不需要关心这些。这是内核的工作。
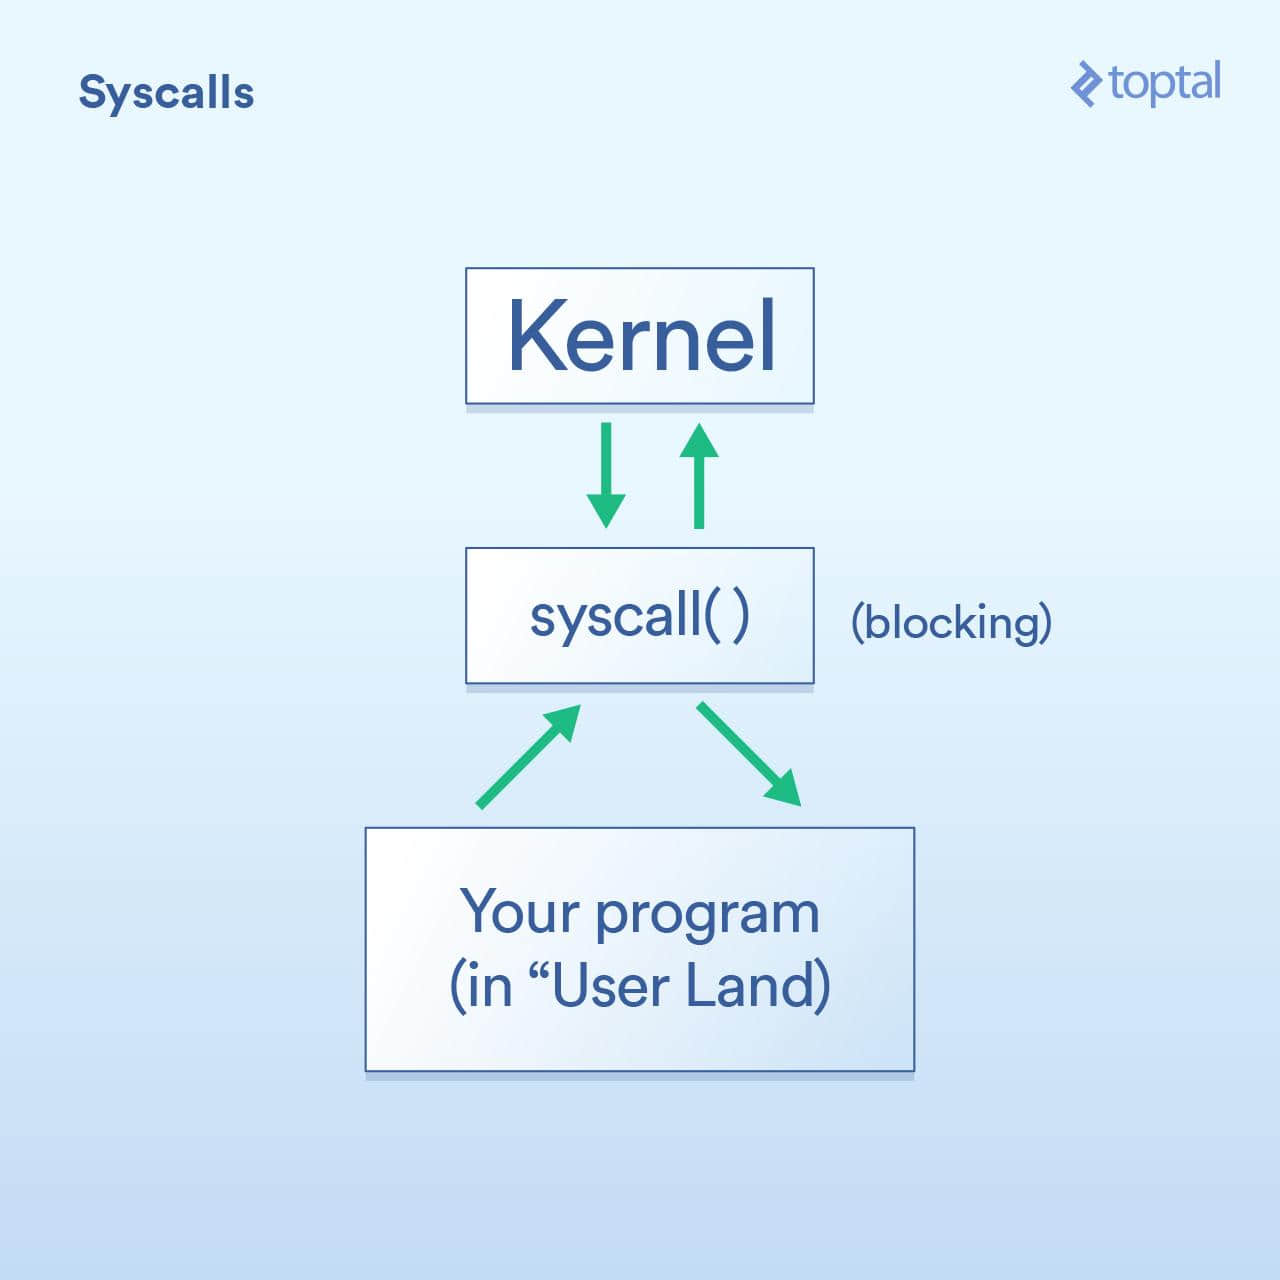
Syscalls Diagram

阻塞与非阻塞

上面我们提到过,系统调用是阻塞的,一般来说是这样的。然而,一些调用被归类为“非阻塞”,这意味着内核会接收你的请求,将其放在队列或缓冲区之类的地方,然后立即返回而不等待实际的 I/O 发生。所以它只是在很短的时间内“阻塞”,只需要排队你的请求即可。

举一些 Linux 系统调用的例子可能有助于理解:

  • read() 是一个阻塞调用 - 你传递一个句柄,指出哪个文件和缓冲区在哪里传送它所读取的数据,当数据就绪时,该调用返回。这种方式的优点是简单友好。
  • 分别调用 epoll_create()、epoll_ctl() 和 epoll_wait() ,你可以创建一组句柄来侦听、添加/删除该组中的处理程序、然后阻塞直到有任何事件发生。这允许你通过单个线程有效地控制大量的 I/O 操作,但是现在谈这个还太早。如果你需要这个功能当然好,但须知道它使用起来是比较复杂的。

了解这里的时间差异的数量级是很重要的。假设 CPU 内核运行在 3GHz,在没有进行 CPU 优化的情况下,那么它每秒执行 30 亿次 周期 cycle (即每纳秒 3 个周期)。非阻塞系统调用可能需要几十个周期来完成,或者说 “相对少的纳秒” 时间完成。而一个被跨网络接收信息所阻塞的系统调用可能需要更长的时间 - 例如 200 毫秒(1/5 秒)。这就是说,如果非阻塞调用需要 20 纳秒,阻塞调用需要 2 亿纳秒。你的进程因阻塞调用而等待了 1000 万倍的时长!
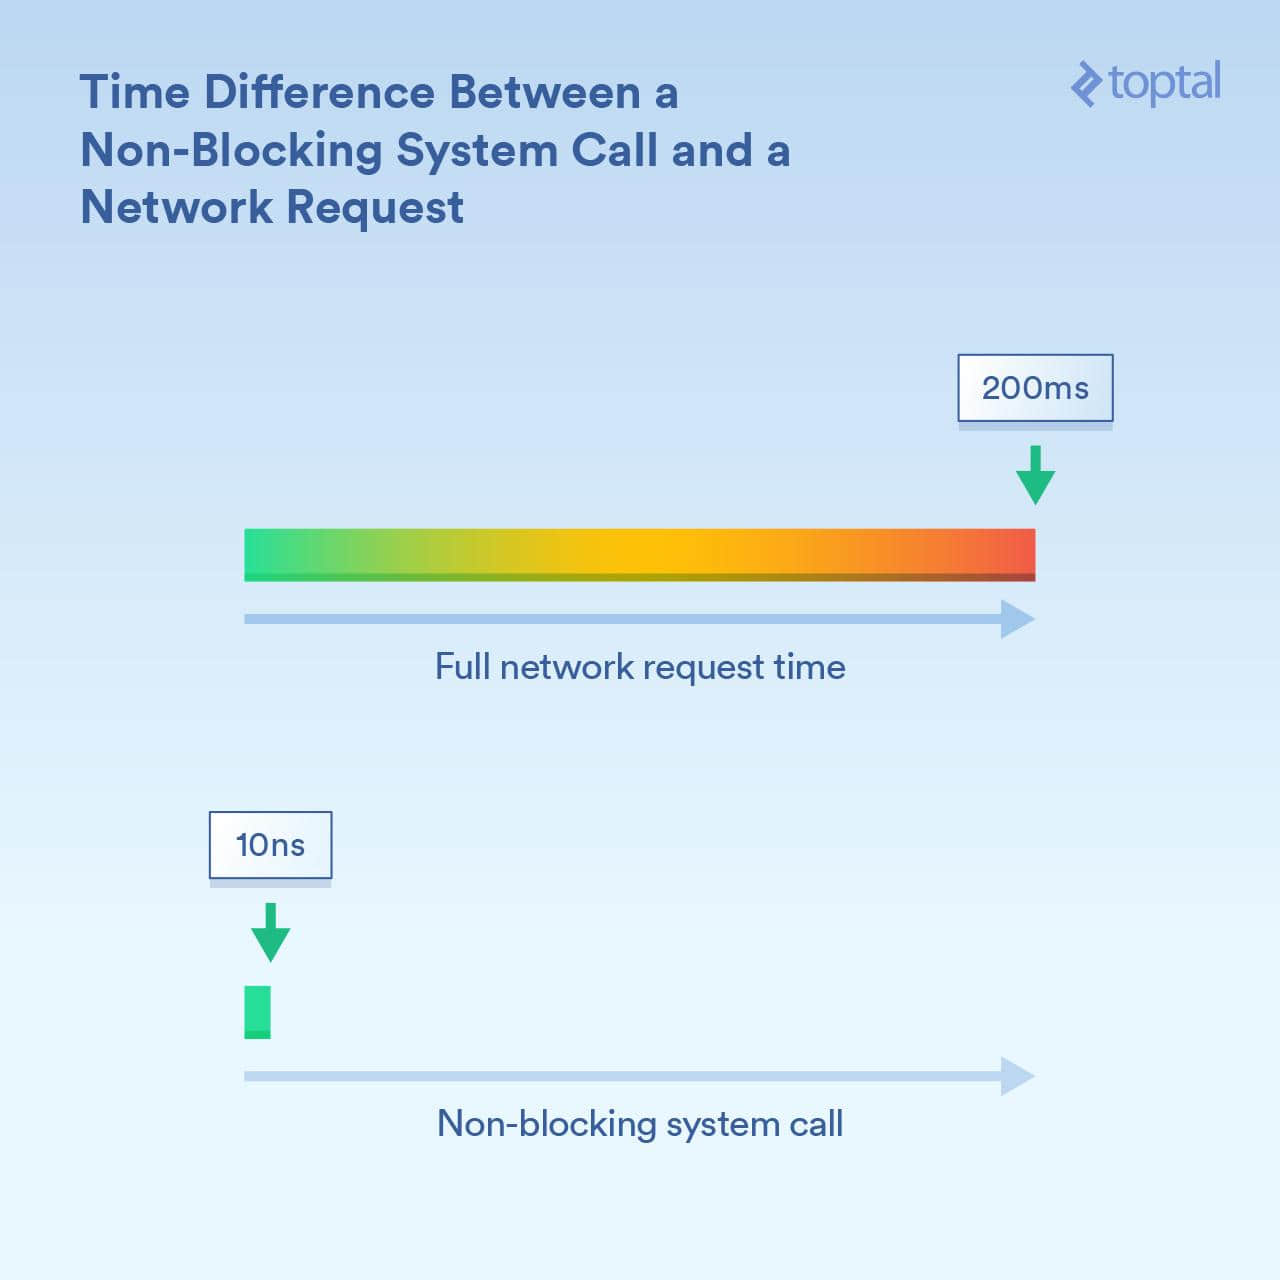
Blocking vs. Non-blocking Syscalls

内核既提供了阻塞 I/O (“从网络连接读取并给出数据”),也提供了非阻塞 I/O (“告知我何时这些网络连接具有新数据”)的方法。使用的是哪种机制对调用进程的阻塞时长有截然不同的影响。

调度

关键的第三件事是当你有很多线程或进程开始阻塞时会发生什么。

根据我们的理解,线程和进程之间没有很大的区别。在现实生活中,最显著的性能相关的差异在于,由于线程共享相同的内存,而进程每个都有自己的内存空间,使得单独的进程往往占用更多的内存。但是当我们谈论 调度 Scheduling 时,它真正归结为一类事情(线程和进程类同),每个都需要在可用的 CPU 内核上获得一段执行时间。如果你有 300 个线程运行在 8 个内核上,则必须将时间分成几份,以便每个线程和进程都能分享它,每个运行一段时间,然后交给下一个。这是通过 “ 上下文切换 context switch ” 完成的,可以使 CPU 从运行到一个线程/进程到切换下一个。

这些上下文切换也有相关的成本 - 它们需要一些时间。在某些快速的情况下,它可能小于 100 纳秒,但根据实际情况、处理器速度/体系结构、CPU 缓存等,偶见花费 1000 纳秒或更长时间。

而线程(或进程)越多,上下文切换就越多。当我们涉及数以千计的线程时,每个线程花费数百纳秒,就会变得很慢。

然而,非阻塞调用实质上是告诉内核“仅在这些连接之一有新的数据或事件时再叫我”。这些非阻塞调用旨在有效地处理大量 I/O 负载并减少上下文交换。

这些你明白了么?现在来到了真正有趣的部分:我们来看看一些流行的语言对那些工具的使用,并得出关于易用性和性能之间权衡的结论,以及一些其他有趣小东西。

声明,本文中显示的示例是零碎的(片面的,只能体现相关的信息); 数据库访问、外部缓存系统( memcache 等等)以及任何需要 I/O 的东西都将执行某种类型的 I/O 调用,其实质与上面所示的简单示例效果相同。此外,对于将 I/O 描述为“阻塞”( PHP、Java )的情况,HTTP 请求和响应读取和写入本身就是阻塞调用:系统中隐藏着更多 I/O 及其伴生的性能问题需要考虑。

为一个项目选择编程语言要考虑很多因素。甚至当你只考虑效率时,也有很多因素。但是,如果你担心你的程序将主要受到 I/O 的限制,如果 I/O 性能影响到项目的成败,那么这些是你需要了解的。

“保持简单”方法:PHP

早在 90 年代,很多人都穿着 Converse 鞋,用 Perl 写着 CGI 脚本。然后 PHP 来了,就像一些人喜欢咒骂的一样,它使得动态网页更容易。

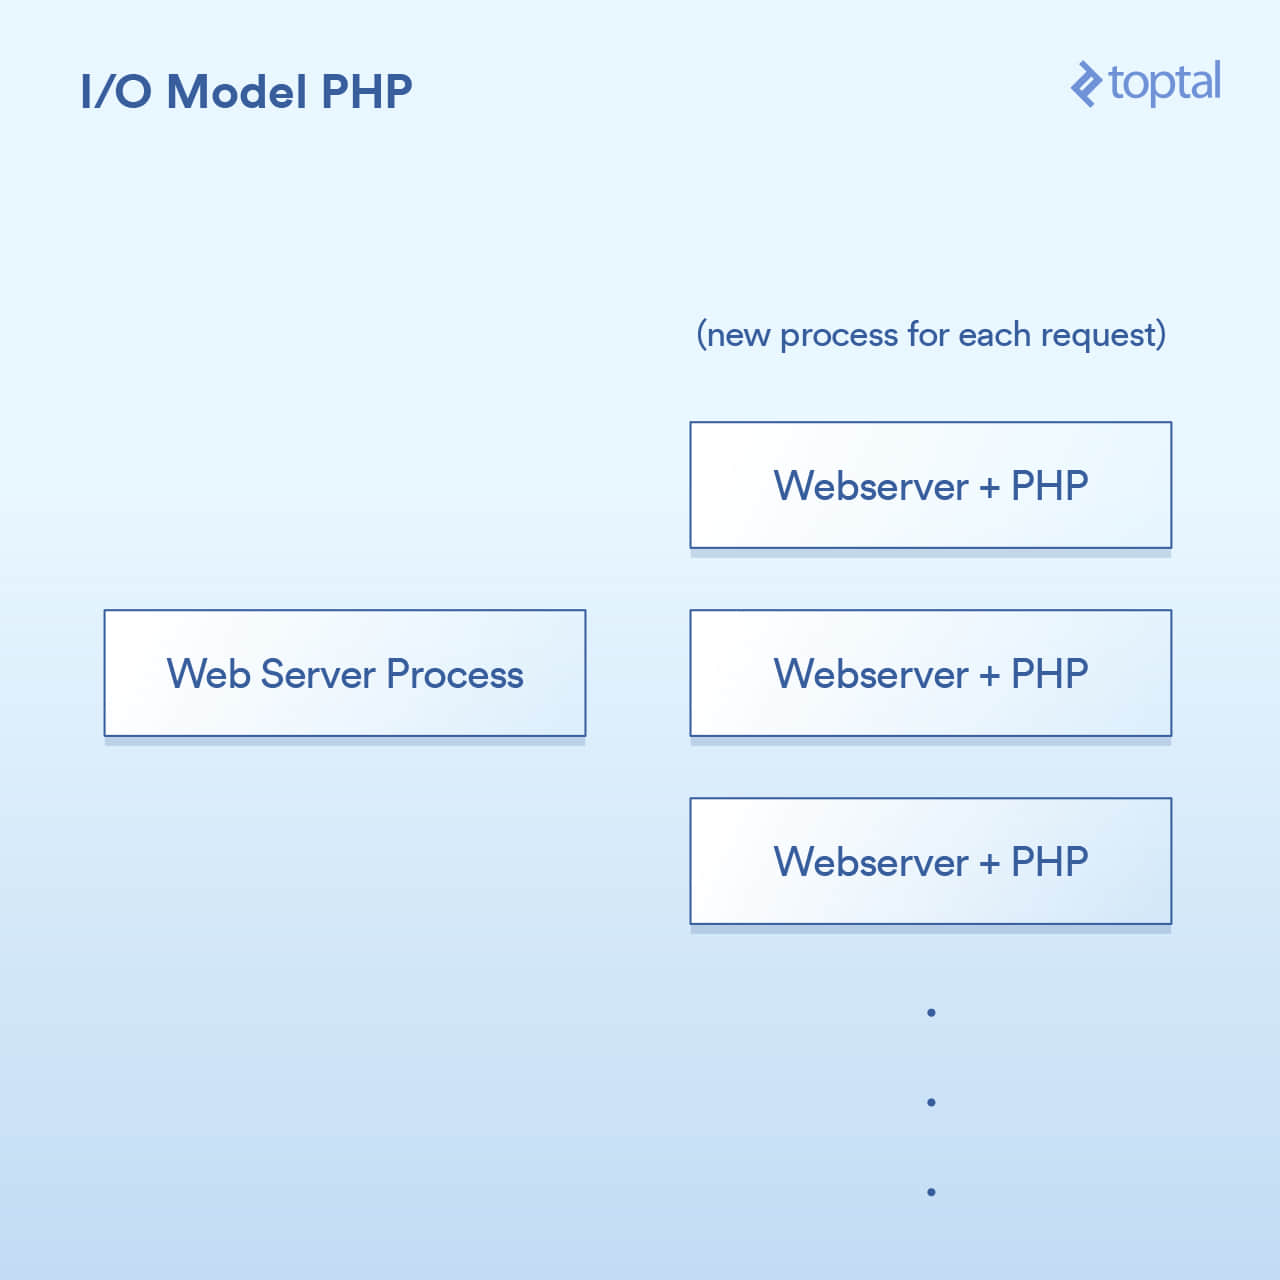
PHP 使用的模型相当简单。虽有一些出入,但你的 PHP 服务器基本上是这样:

HTTP 请求来自用户的浏览器,并访问你的 Apache Web 服务器。Apache 为每个请求创建一个单独的进程,有一些优化方式可以重新使用它们,以最大限度地减少创建次数( 相对而言,创建进程较慢 )。Apache 调用 PHP 并告诉它运行磁盘上合适的 .php 文件。PHP 代码执行并阻塞 I/O 调用。你在 PHP 中调用 file_get_contents() ,其底层会调用 read() 系统调用并等待结果。

当然,实际的代码是直接嵌入到你的页面,并且该操作被阻塞:

<?php

// blocking file I/O
$file_data = file_get_contents(‘/path/to/file.dat’);

// blocking network I/O
$curl = curl_init('http://example.com/example-microservice');
$result = curl_exec($curl);

// some more blocking network I/O
$result = $db->query('SELECT id, data FROM examples ORDER BY id DESC limit 100');

?>

关于如何与系统集成,就像这样:
I/O Model PHP

很简单:每个请求一个进程。 I/O 调用就阻塞。优点是简单可工作,缺点是,同时与 20,000 个客户端连接,你的服务器将会崩溃。这种方法不能很好地扩展,因为内核提供的用于处理大容量 I/O (epoll 等) 的工具没有被使用。 雪上加霜的是,为每个请求运行一个单独的进程往往会使用大量的系统资源,特别是内存,这通常是你在这样的场景中遇到的第一个问题。

注意:Ruby 使用的方法与 PHP 非常相似,在大致的方面上,它们可以被认为是相同的。

多线程方法: Java

就在你购买你的第一个域名,在某个句子后很酷地随机说出 “dot com” 的那个时候,Java 来了。而 Java 具有内置于该语言中的多线程功能,它非常棒(特别是在创建时)。

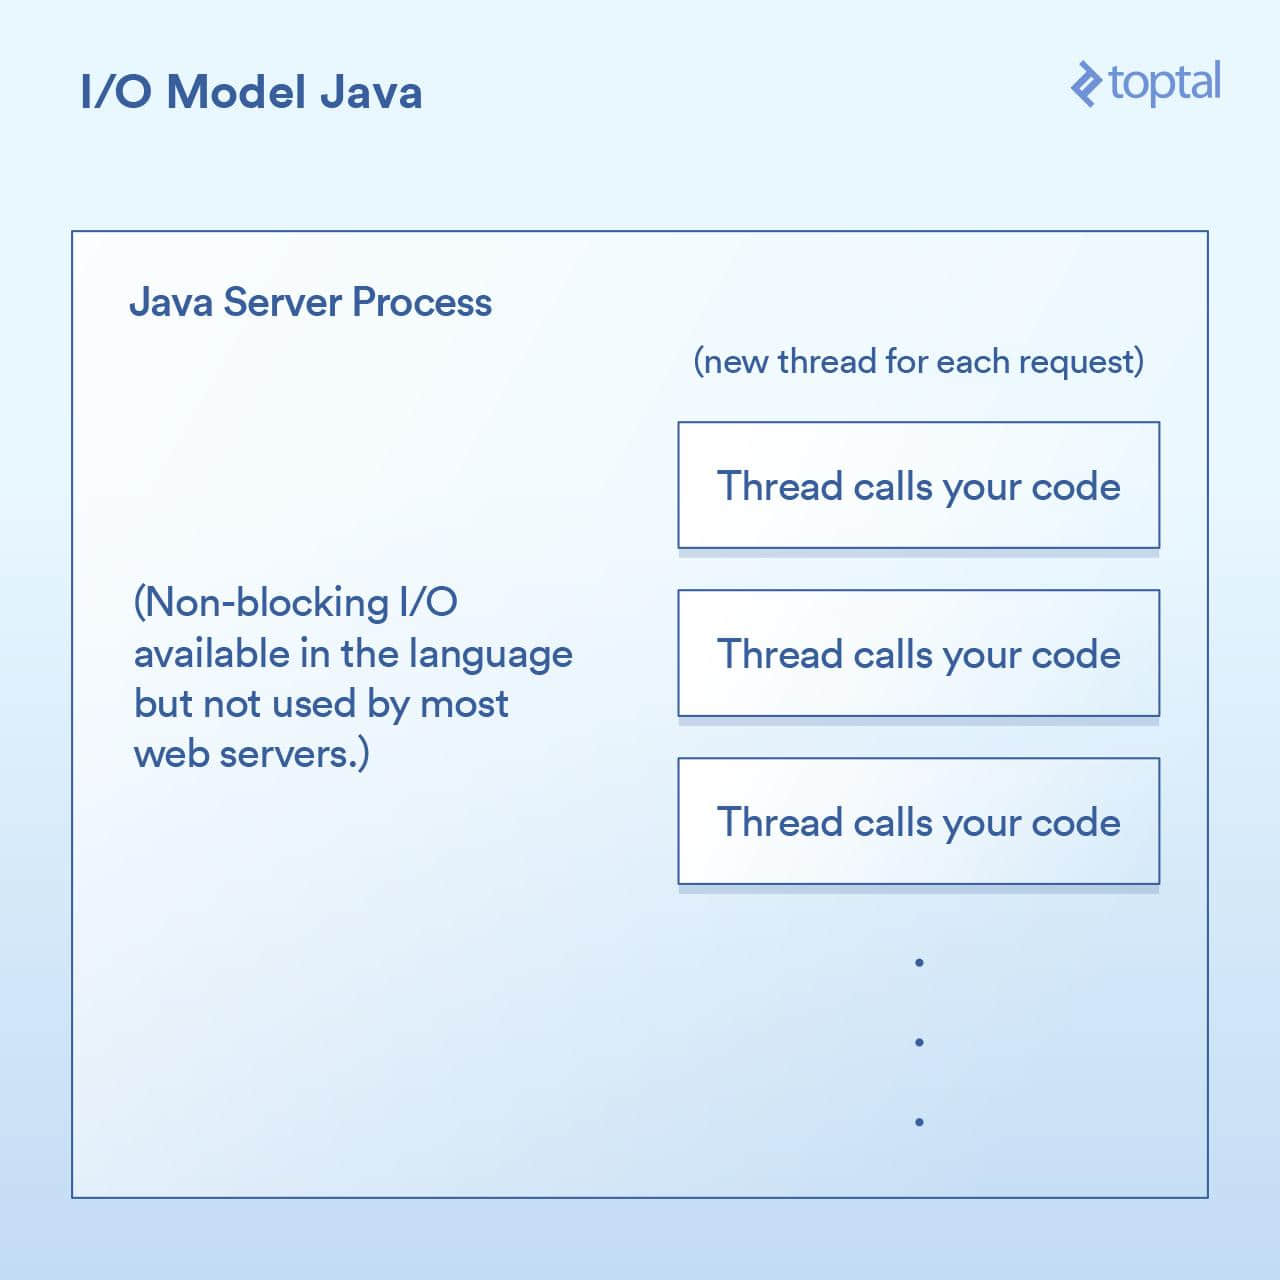
大多数 Java Web 服务器通过为每个请求启动一个新的执行线程,然后在该线程中最终调用你(作为应用程序开发人员)编写的函数。

在 Java Servlet 中执行 I/O 往往看起来像:

public void doGet(HttpServletRequest request,
    HttpServletResponse response) throws ServletException, IOException
{

    // blocking file I/O
    InputStream fileIs = new FileInputStream("/path/to/file");

    // blocking network I/O
    URLConnection urlConnection = (new URL("http://example.com/example-microservice")).openConnection();
    InputStream netIs = urlConnection.getInputStream();

    // some more blocking network I/O
out.println("...");
}

由于我们上面的 doGet 方法对应于一个请求,并且在其自己的线程中运行,而不是每个请求一个单独的进程,申请自己的内存。这样有一些好处,比如在线程之间共享状态、缓存数据等,因为它们可以访问彼此的内存,但是它与调度的交互影响与之前的 PHP 的例子几乎相同。每个请求获得一个新线程,该线程内的各种 I/O 操作阻塞在线程内,直到请求被完全处理为止。线程被池化以最小化创建和销毁它们的成本,但是数千个连接仍然意味着数千个线程,这对调度程序是不利的。

重要的里程碑出现在 Java 1.4 版本(以及 1.7 的重要升级)中,它获得了执行非阻塞 I/O 调用的能力。大多数应用程序、web 应用和其它用途不会使用它,但至少它是可用的。一些 Java Web 服务器尝试以各种方式利用这一点;然而,绝大多数部署的 Java 应用程序仍然如上所述工作。
I/O Model Java

肯定有一些很好的开箱即用的 I/O 功能,Java 让我们更接近,但它仍然没有真正解决当你有一个大量的 I/O 绑定的应用程序被数千个阻塞线程所压垮的问题。

无阻塞 I/O 作为一等公民: Node

当更好的 I/O 模式来到 Node.js,阻塞才真正被解决。任何一个曾听过 Node 简单介绍的人都被告知这是“非阻塞”,可以有效地处理 I/O。这在一般意义上是正确的。但在细节中则不尽然,而且当在进行性能工程时,这种巫术遇到了问题。

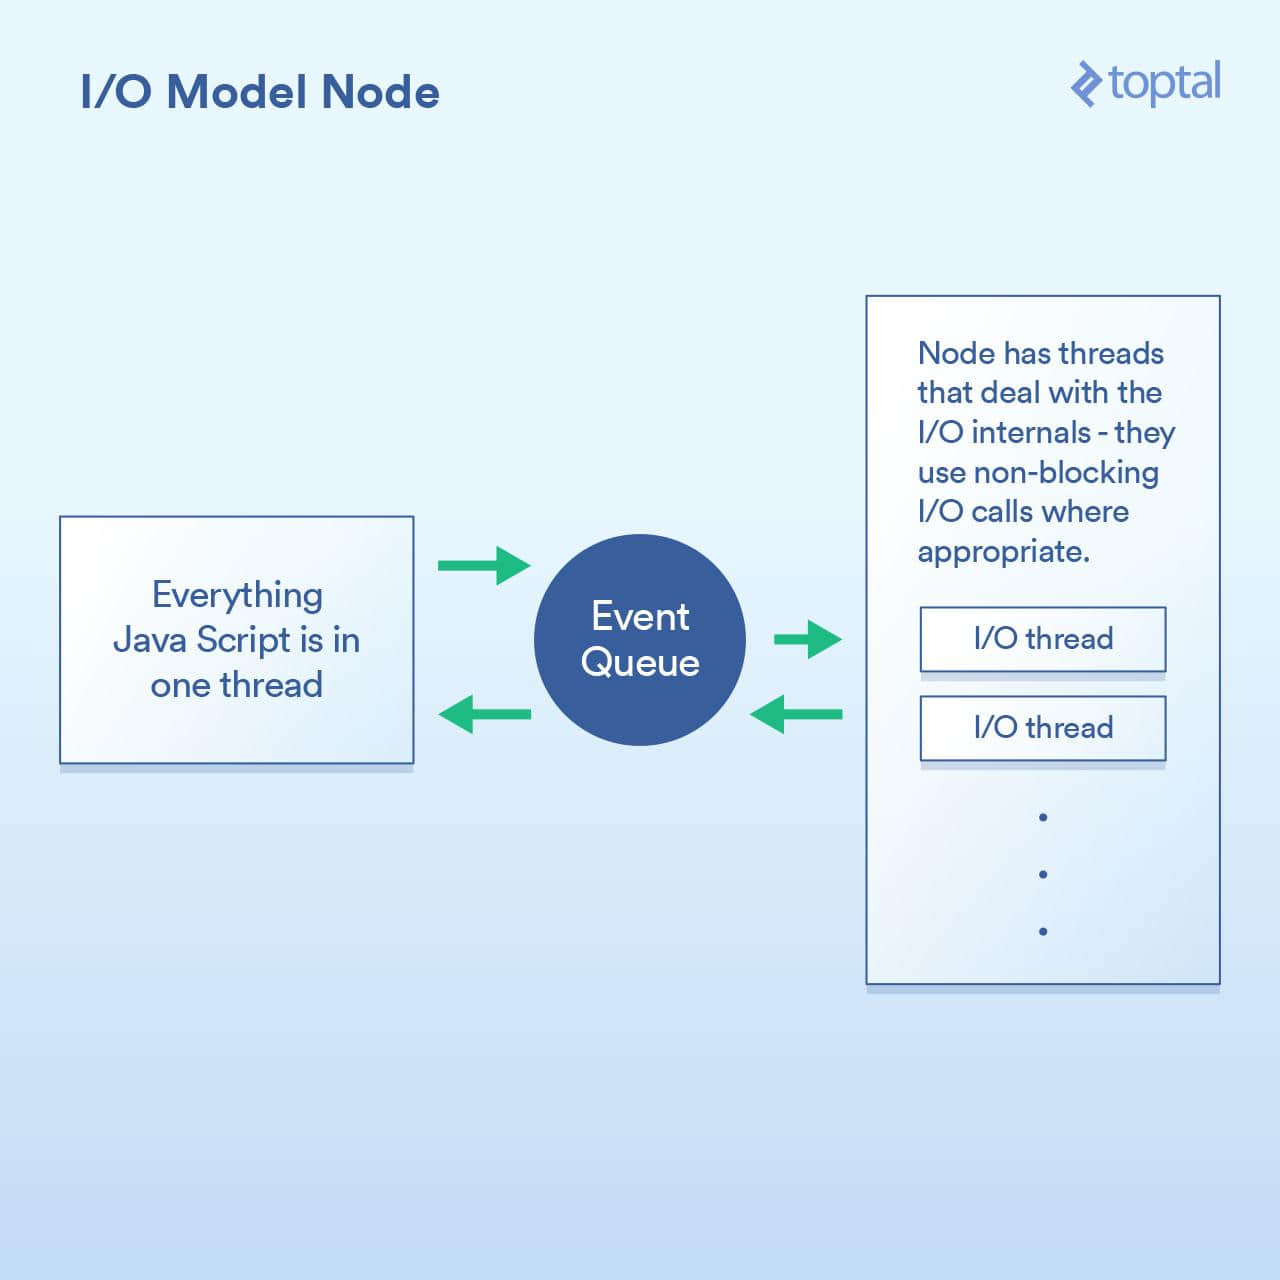
Node 实现的范例基本上不是说 “在这里写代码来处理请求”,而是说 “在这里写代码来开始处理请求”。每次你需要做一些涉及到 I/O 的操作,你会创建一个请求并给出一个回调函数,Node 将在完成之后调用该函数。

在请求中执行 I/O 操作的典型 Node 代码如下所示:

http.createServer(function(request, response) {
    fs.readFile('/path/to/file', 'utf8', function(err, data) {
        response.end(data);
    });
});

你可以看到,这里有两个回调函数。当请求开始时,第一个被调用,当文件数据可用时,第二个被调用。

这样做的基本原理是让 Node 有机会有效地处理这些回调之间的 I/O 。一个更加密切相关的场景是在 Node 中进行数据库调用,但是我不会在这个例子中啰嗦,因为它遵循完全相同的原则:启动数据库调用,并给 Node 一个回调函数,它使用非阻塞调用单独执行 I/O 操作,然后在你要求的数据可用时调用回调函数。排队 I/O 调用和让 Node 处理它然后获取回调的机制称为“事件循环”。它工作的很好。
I/O Model Node.js

然而,这个模型有一个陷阱,究其原因,很多是与 V8 JavaScript 引擎(Node 用的是 Chrome 浏览器的 JS 引擎)如何实现的有关 注1 。你编写的所有 JS 代码都运行在单个线程中。你可以想想,这意味着当使用高效的非阻塞技术执行 I/O 时,你的 JS 可以在单个线程中运行计算密集型的操作,每个代码块都会阻塞下一个。可能出现这种情况的一个常见例子是以某种方式遍历数据库记录,然后再将其输出到客户端。这是一个示例,展示了其是如何工作:

var handler = function(request, response) {

    connection.query('SELECT ...', function (err, rows) {

        if (err) { throw err };

        for (var i = 0; i < rows.length; i++) {
            // do processing on each row
        }

        response.end(...); // write out the results

    })

};

虽然 Node 确实有效地处理了 I/O ,但是上面的例子中 for 循环是在你的唯一的一个主线程中占用 CPU 周期。这意味着如果你有 10,000 个连接,则该循环可能会使你的整个应用程序像爬行般缓慢,具体取决于其会持续多久。每个请求必须在主线程中分享一段时间,一次一段。

这整个概念的前提是 I/O 操作是最慢的部分,因此最重要的是要有效地处理这些操作,即使这意味着要连续进行其他处理。这在某些情况下是正确的,但不是全部。

另一点是,虽然这只是一个观点,但是写一堆嵌套的回调可能是相当令人讨厌的,有些则认为它使代码更难以追踪。在 Node 代码中看到回调嵌套 4 层、5 层甚至更多层并不罕见。

我们再次来权衡一下。如果你的主要性能问题是 I/O,则 Node 模型工作正常。然而,它的关键是,你可以在一个处理 HTTP 请求的函数里面放置 CPU 密集型的代码,而且不小心的话会导致每个连接都很慢。

最自然的非阻塞:Go

在我进入 Go 部分之前,我应该披露我是一个 Go 的粉丝。我已经在许多项目中使用过它,我是一个其生产力优势的公开支持者,我在我的工作中使用它。

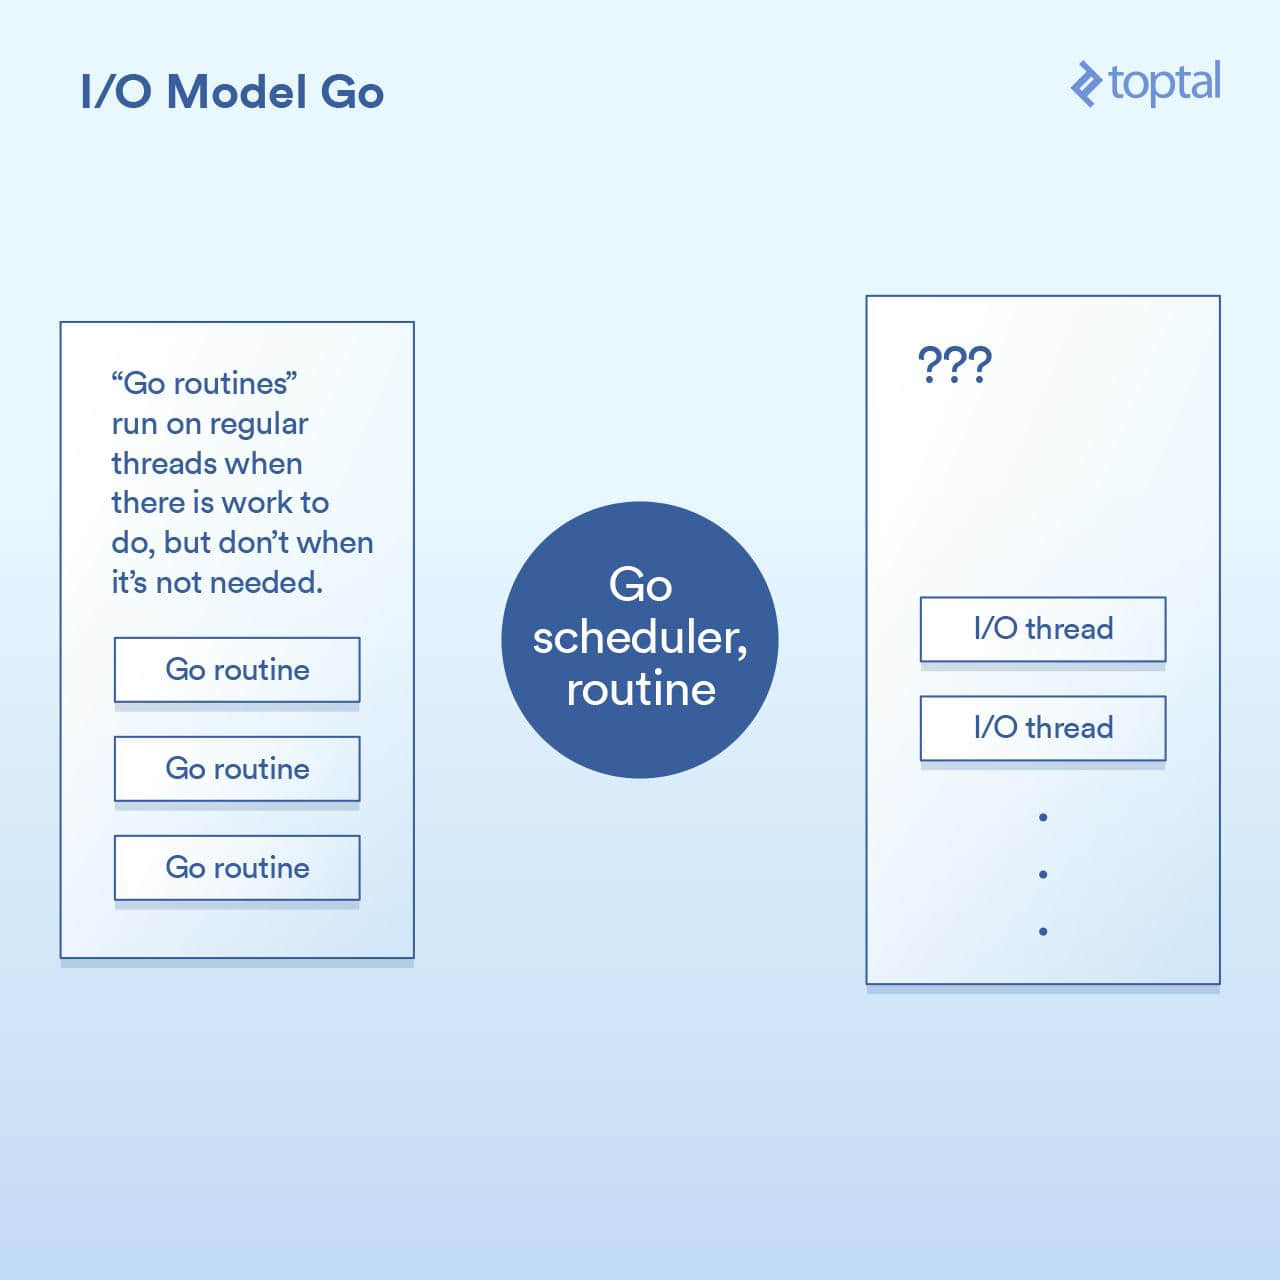
那么,让我们来看看它是如何处理 I/O 的。Go 语言的一个关键特征是它包含自己的调度程序。在 Go 中,不是每个执行线程对应于一个单一的 OS 线程,其通过一种叫做 “ 协程 goroutine ” 的概念来工作。而 Go 的运行时可以将一个协程分配给一个 OS 线程,使其执行或暂停它,并且它不与一个 OS 线程相关联——这要基于那个协程正在做什么。来自 Go 的 HTTP 服务器的每个请求都在单独的协程中处理。

调度程序的工作原理如图所示:
I/O Model Go

在底层,这是通过 Go 运行时中的各个部分实现的,它通过对请求的写入/读取/连接等操作来实现 I/O 调用,将当前协程休眠,并当采取进一步动作时唤醒该协程。

从效果上看,Go 运行时做的一些事情与 Node 做的没有太大不同,除了回调机制是内置到 I/O 调用的实现中,并自动与调度程序交互。它也不会受到必须让所有处理程序代码在同一个线程中运行的限制,Go 将根据其调度程序中的逻辑自动将协程映射到其认为适当的 OS 线程。结果是这样的代码:

func ServeHTTP(w http.ResponseWriter, r *http.Request) {

    // the underlying network call here is non-blocking
    rows, err := db.Query("SELECT ...")

    for _, row := range rows {
        // do something with the rows,
// each request in its own goroutine
    }

    w.Write(...) // write the response, also non-blocking

}

如上所述,我们重构基本的代码结构为更简化的方式,并在底层仍然实现了非阻塞 I/O。

在大多数情况下,最终是“两全其美”的。非阻塞 I/O 用于所有重要的事情,但是你的代码看起来像是阻塞,因此更容易理解和维护。Go 调度程序和 OS 调度程序之间的交互处理其余部分。这不是完整的魔法,如果你建立一个大型系统,那么值得我们来看看有关它的工作原理的更多细节;但与此同时,你获得的“开箱即用”的环境可以很好地工作和扩展。

Go 可能有其缺点,但一般来说,它处理 I/O 的方式不在其中。

谎言,可恶的谎言和基准

对这些各种模式的上下文切换进行准确的定时是很困难的。我也可以认为这对你来说不太有用。相反,我会给出一些比较这些服务器环境的整个 HTTP 服务器性能的基本基准。请记住,影响整个端到端 HTTP 请求/响应路径的性能有很多因素,这里提供的数字只是我将一些样本放在一起进行基本比较的结果。

对于这些环境中的每一个,我写了适当的代码在一个 64k 文件中读取随机字节,在其上运行了一个 SHA-256 哈希 N 次( N 在 URL 的查询字符串中指定,例如 .../test.php?n=100),并打印出结果十六进制散列。我选择这样做,是因为使用一些一致的 I/O 和受控的方式来运行相同的基准测试是一个增加 CPU 使用率的非常简单的方法。

有关使用的环境的更多细节,请参阅 基准说明 。

首先,我们来看一些低并发的例子。运行 2000 次迭代,300 个并发请求,每个请求只有一个散列(N = 1),结果如下:
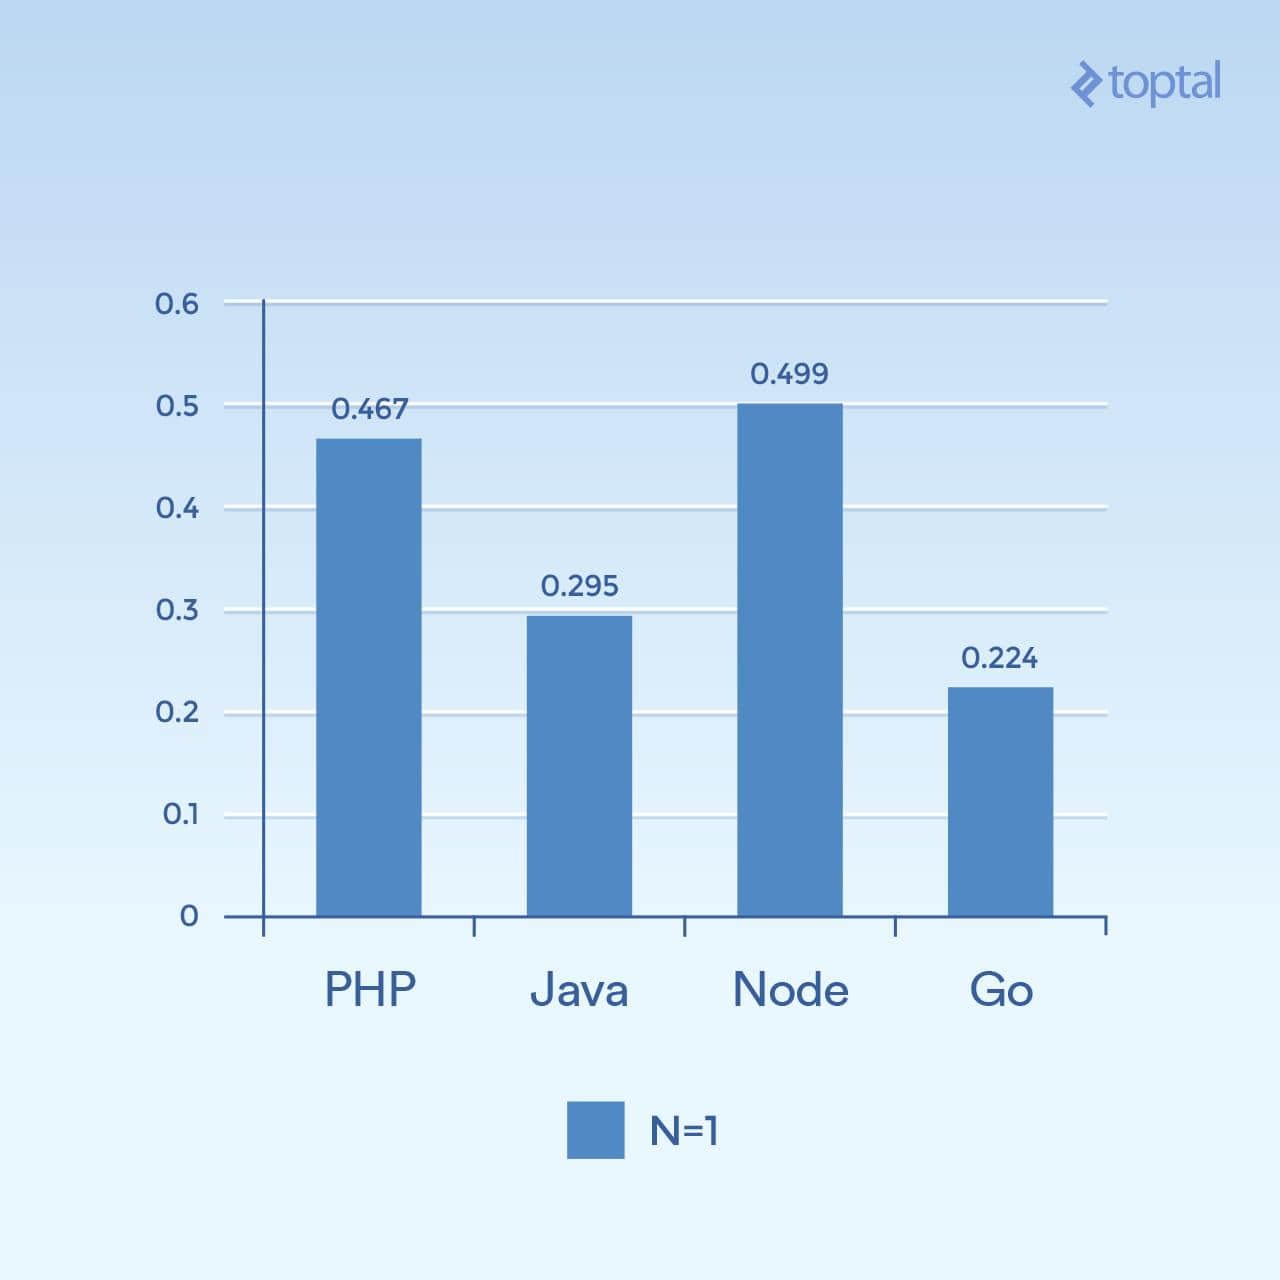
Mean number of milliseconds to complete a request across all concurrent requests, N=1

时间是在所有并发请求中完成请求的平均毫秒数。越低越好。

仅从一张图很难得出结论,但是对我来说,似乎在大量的连接和计算量上,我们看到时间更多地与语言本身的一般执行有关,对于 I/O 更是如此。请注意,那些被视为“脚本语言”的语言(松散类型,动态解释)执行速度最慢。

但是,如果我们将 N 增加到 1000,仍然有 300 个并发请求,相同的任务,但是哈希迭代是 1000 倍(显着增加了 CPU 负载):
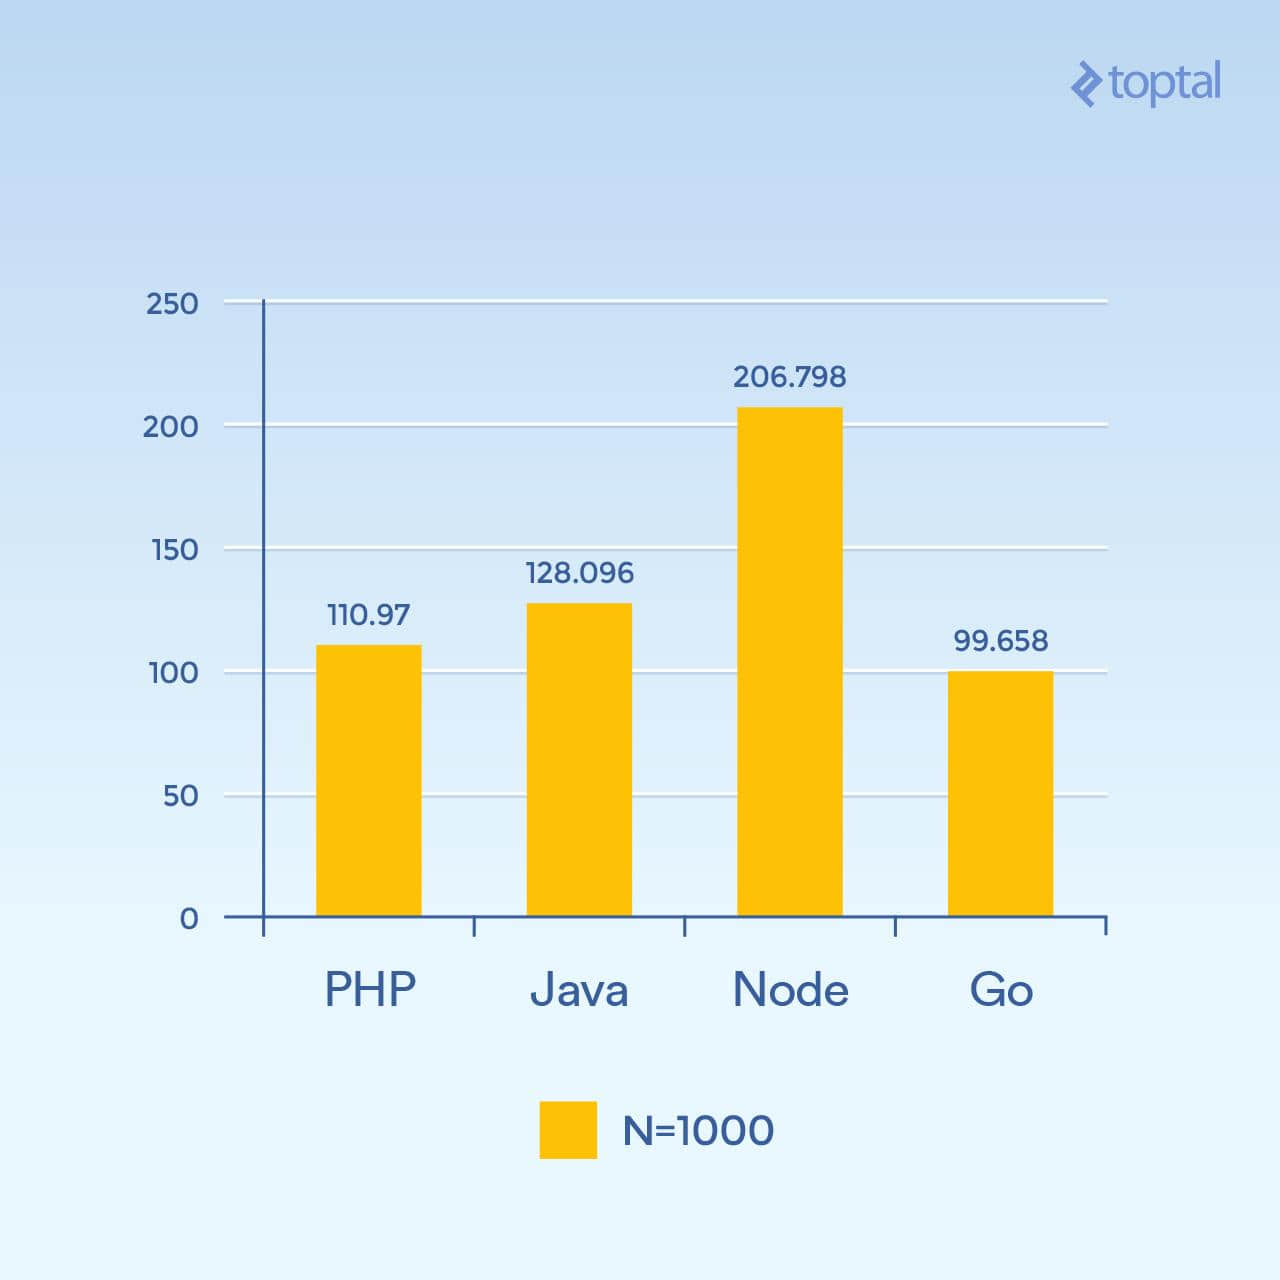
Mean number of milliseconds to complete a request across all concurrent requests, N=1000

时间是在所有并发请求中完成请求的平均毫秒数。越低越好。

突然间, Node 性能显著下降,因为每个请求中的 CPU 密集型操作都相互阻塞。有趣的是,在这个测试中,PHP 的性能要好得多(相对于其他的),并且打败了 Java。(值得注意的是,在 PHP 中,SHA-256 实现是用 C 编写的,在那个循环中执行路径花费了更多的时间,因为现在我们正在进行 1000 个哈希迭代)。

现在让我们尝试 5000 个并发连接(N = 1) - 或者是我可以发起的最大连接。不幸的是,对于大多数这些环境,故障率并不显着。对于这个图表,我们来看每秒的请求总数。 越高越好 :
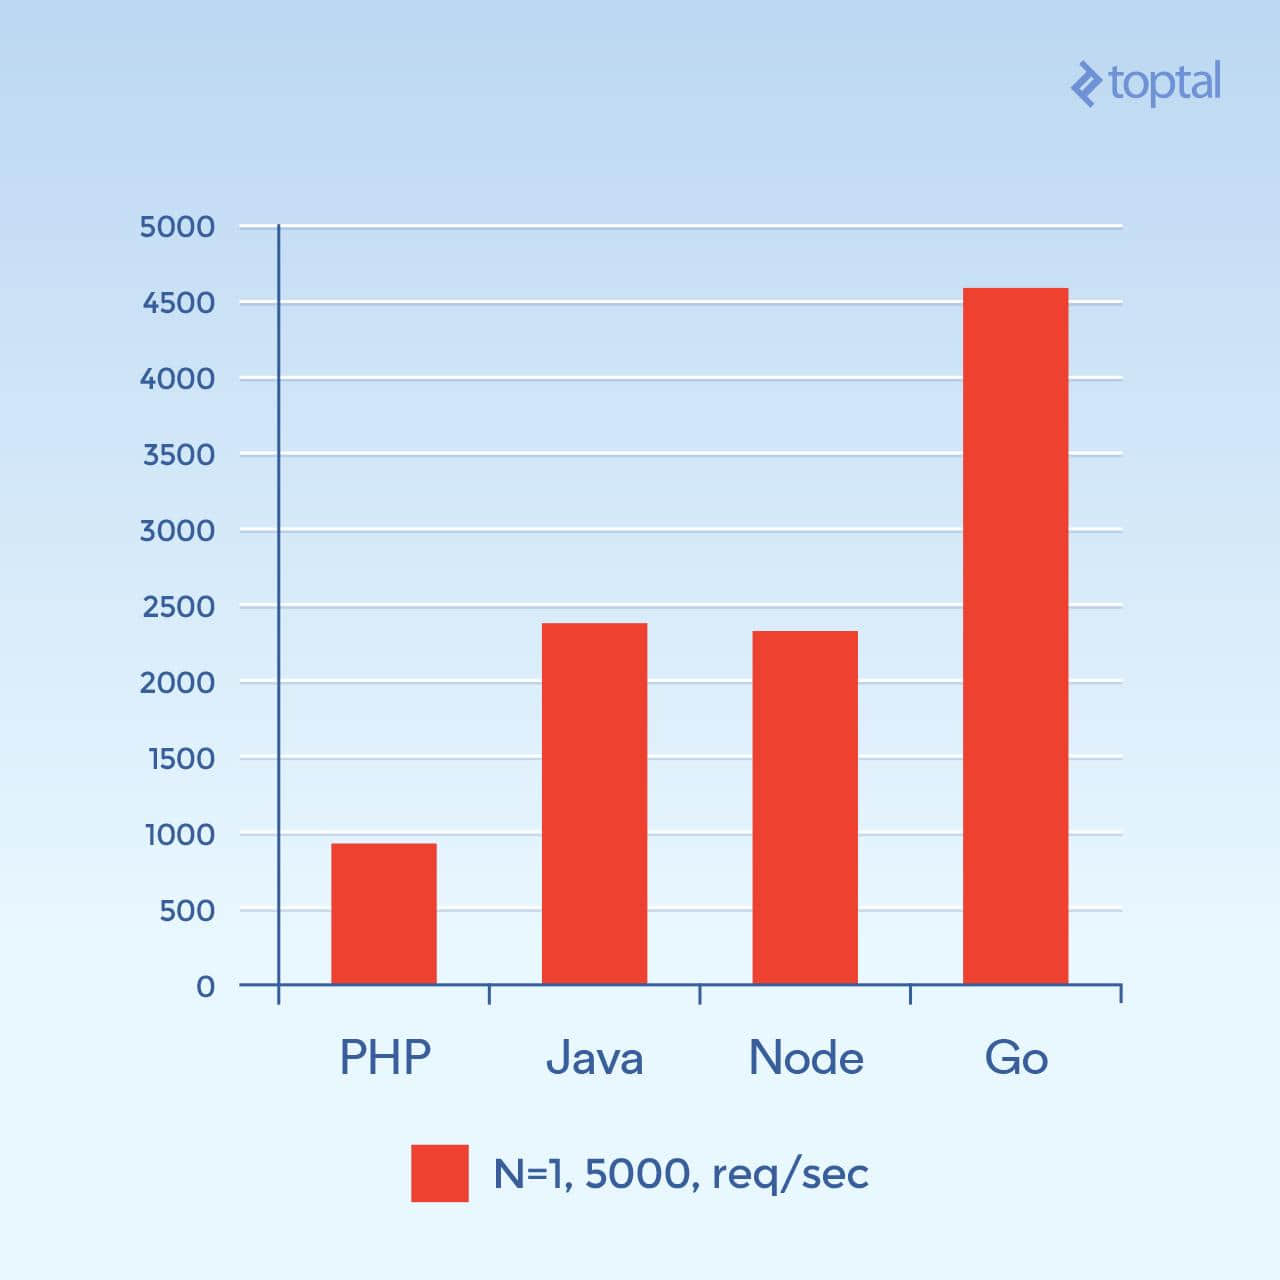
Total number of requests per second, N=1, 5000 req/sec

每秒请求数。越高越好。

这个图看起来有很大的不同。我猜测,但是看起来像在高连接量时,产生新进程所涉及的每连接开销以及与 PHP + Apache 相关联的附加内存似乎成为主要因素,并阻止了 PHP 的性能。显然,Go 是这里的赢家,其次是 Java,Node,最后是 PHP。

虽然与你的整体吞吐量相关的因素很多,并且在应用程序之间也有很大的差异,但是你对底层发生什么的事情以及所涉及的权衡了解更多,你将会得到更好的结果。

总结

以上所有这一切,很显然,随着语言的发展,处理大量 I/O 的大型应用程序的解决方案也随之发展。

为了公平起见,PHP 和 Java,尽管这篇文章中的描述,确实 实现了 在 web 应用程序 中 可使用的 非阻塞 I/O 。但是这些方法并不像上述方法那么常见,并且需要考虑使用这种方法来维护服务器的随之而来的操作开销。更不用说你的代码必须以与这些环境相适应的方式进行结构化;你的 “正常” PHP 或 Java Web 应用程序通常不会在这样的环境中进行重大修改。

作为比较,如果我们考虑影响性能和易用性的几个重要因素,我们得出以下结论:

语言线程与进程非阻塞 I/O使用便捷性
PHP进程否
Java线程可用需要回调
Node.js线程是需要回调
Go线程 (协程)是不需要回调

线程通常要比进程有更高的内存效率,因为它们共享相同的内存空间,而进程则没有。结合与非阻塞 I/O 相关的因素,我们可以看到,至少考虑到上述因素,当我们从列表往下看时,与 I/O 相关的一般设置得到改善。所以如果我不得不在上面的比赛中选择一个赢家,那肯定会是 Go。

即使如此,在实践中,选择构建应用程序的环境与你的团队对所述环境的熟悉程度以及你可以实现的总体生产力密切相关。因此,每个团队都深入并开始在 Node 或 Go 中开发 Web 应用程序和服务可能就没有意义。事实上,寻找开发人员或你内部团队的熟悉度通常被认为是不使用不同语言和/或环境的主要原因。也就是说,过去十五年来,时代已经发生了变化。

希望以上内容可以帮助你更清楚地了解底层发生的情况,并为你提供如何处理应用程序的现实可扩展性的一些想法。


via: https://www.toptal.com/back-end/server-side-io-performance-node-php-java-go

作者:BRAD PEABODY 译者:MonkeyDEcho 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出
一次掌握一个技巧,更好地学习安卓

距离安迪·鲁宾和他的团队着手开发一个希望颠覆传统手机操作模式的操作系统已经过去 12 年了,这套系统有可能让手机或者智能机给消费者以及软件开发人员带来全新的体验。之前的智能机仅限于收发短信和查看电子邮件(当然还可以打电话),给用户和开发者带来很大的限制。

安卓,作为打破这个枷锁的系统,拥有非常优秀的框架设计,给大家提供的不仅仅是一组有限的功能,更多的是自由的探索。有人会说 iPhone 才是手机产业的颠覆产品,不过我们说的不是 iPhone 有多么酷(或者多么贵,是吧?),它还是有限制的,而这是我们从来都不希望有的。

不过,就像本大叔说的,能力越大责任越大,我们也需要更加认真对待安卓应用的设计方式。我看到很多教程都忽略了向初学者传递这个理念,在动手之前请先充分理解系统架构。他们只是把一堆的概念和代码丢给读者,却没有解释清楚相关的优缺点,它们对系统的影响,以及该用什么不该用什么等等。

在这篇文章里,我们将介绍一些初学者以及中级开发人员都应该掌握的技巧,以帮助更好地理解安卓框架。后续我们还会在这个系列里写更多这样的关于实用技巧的文章。我们开始吧。

1、 @+id 和 @id 的区别

要在 Java 代码里访问一个图形控件(或组件),或者是要让它成为其他控件的依赖,我们需要一个唯一的值来引用它。这个唯一值用 android:id 属性来定义,本质上就是把用户提供的 id 附加到 @+id/ 后面,写入到 id 资源文件,供其他控件使用。一个 Toolbar 的 id 可以这样定义,

android:id="@+id/toolbar"

然后这个 id 值就能被 findViewById(…) 识别,这个函数会在资源文件里查找 id,或者直接从 R.id 路径引用,然后返回所查找的 View 的类型。

而另一种,@id,和 findViewById(…) 行为一样 - 也会根据提供的 id 查找组件,不过仅限于布局时使用。一般用来布置相关控件。

android:layout_below="@id/toolbar"

2、 使用 @string 资源为 XML 提供字符串

简单来说,就是不要在 XML 里直接用字符串。原因很简单。当我们在 XML 里直接使用了字符串,我们一般会在其它地方再次用到同样的字符串。想像一下当我们需要在不同的地方调整同一个字符串的噩梦,而如果使用字符串资源就只改一个地方就够了。另一个好处是,使用资源文件可以提供多国语言支持,因为可以为不同的语言创建相应的字符串资源文件。

android:text="My Awesome Application"

当你直接使用字符串时,你会在 Android Studio 里收到警告,提示说应该把写死的字符串改成字符串资源。可以点击这个提示,然后按下 ALT + ENTER 打开字符串编辑。你也可以直接打开 res 目录下的 values 目录里的 strings.xml 文件,然后像下面这样声明一个字符串资源。

<string name="app_name">My Awesome Application</string>

然后用它来替换写死的字符串,

android:text="@string/app_name"

3、 使用 @android 和 ?attr 常量

尽量使用系统预先定义的常量而不是重新声明。举个例子,在布局中有几个地方要用白色或者 #ffffff 颜色值。不要每次都直接用 #ffffff 数值,也不要自己为白色重新声明资源,我们可以直接用这个,

@android:color/white

安卓预先定义了很多常用的颜色常量,比如白色,黑色或粉色。最经典的应用场景是透明色:

@android:color/transparent

另一个引用常量的方式是 ?attr,用来将预先定义的属性值赋值给不同的属性。举个自定义 Toolbar 的例子。这个 Toolbar 需要定义宽度和高度。宽度通常可以设置为 MATCH_PARENT,但高度呢?我们大多数人都没有注意设计指导,只是简单地随便设置一个看上去差不多的值。这样做不对。不应该随便自定义高度,而应该这样做,

android:layout_height="?attr/actionBarSize"

?attr 的另一个应用是点击视图时画水波纹效果。SelectableItemBackground 是一个预定义的 drawable,任何视图需要增加波纹效果时可以将它设为背景:

android:background="?attr/selectableItemBackground"

也可以用这个:

android:background="?attr/selectableItemBackgroundBorderless"

来显示无边框波纹。

4、 SP 和 DP 的区别

虽然这两个没有本质上的区别,但知道它们是什么以及在什么地方适合用哪个很重要。

SP 的意思是缩放无关像素,一般建议用于 TextView,首先文字不会因为显示密度不同而显示效果不一样,另外 TextView 的内容还需要根据用户设定做拉伸,或者只调整字体大小。

其他需要定义尺寸和位置的地方,可以使用 DP,也就是密度无关像素。之前说过,DP 和 SP 的性质是一样的,只是 DP 会根据显示密度自动拉伸,因为安卓系统会动态计算实际显示的像素,这样就可以让使用 DP 的组件在不同显示密度的设备上都可以拥有相同的显示效果。

5、 Drawable 和 Mipmap 的应用

这两个最让人困惑的是 - drawable 和 mipmap 有多少差异?

虽然这两个好像有同样的用途,但它们设计目的不一样。mipmap 是用来储存图标的,而 drawable 用于任何其他格式。我们可以看一下系统内部是如何使用它们的,就知道为什么不能混用了。

你可以看到你的应用里有几个 mipmap 和 drawable 目录,每一个分别代表不同的显示分辨率。当系统从 drawable 目录读取资源时,只会根据当前设备的显示密度选择确定的目录。然而,在读取 mipmap 时,系统会根据需要选择合适的目录,而不仅限于当前显示密度,主要是因为有些启动器会故意显示较大的图标,所以系统会使用较大分辨率的资源。

总之,用 mipmap 来存放图标或标记图片,可以在不同显示密度的设备上看到分辨率变化,而其它根据需要显示的图片资源都用 drawable。

比如说,Nexus 5 的显示分辨率是 xxhdpi。当我们把图标放到 mipmap 目录里时,所有 mipmap 目录都将读入内存。而如果放到 drawable 里,只有 drawable-xxhdpi 目录会被读取,其他目录都会被忽略。

6、 使用矢量图形

为了支持不同显示密度的屏幕,将同一个资源的多个版本(大小)添加到项目里是一个很常见的技巧。这种方式确实有用,不过它也会带来一定的性能开支,比如更大的 apk 文件以及额外的开发工作。为了消除这种影响,谷歌的安卓团队发布了新增的矢量图形。

矢量图形是用 XML 描述的 SVG(可拉伸矢量图形),是用点、直线和曲线组合以及填充颜色绘制出的图形。正因为矢量图形是由点和线动态画出来的,在不同显示密度下拉伸也不会损失分辨率。而矢量图形带来的另一个好处是更容易做动画。往一个 AnimatedVectorDrawable 文件里添加多个矢量图形就可以做出动画,而不用添加多张图片然后再分别处理。

<vector xmlns:android="http://schemas.android.com/apk/res/android"
    android:width="24dp" 
    android:height="24dp" 
    android:viewportWidth="24.0" 
    android:viewportHeight="24.0">

    <path android:fillColor="#69cdff" android:pathData="M3,18h18v-2L3,16v2zM3,13h18v-2L3,11v2zM3,6v2h18L21,6L3,6z"/>

</vector>

上面的向量定义可以画出下面的图形,

要在你的安卓项目里添加矢量图形,可以右键点击你项目里的应用模块,然后选择 New >> Vector Assets。然后会打开 Assets Studio,你可以有两种方式添加矢量图形。第一种是从 Material 图标里选择,另一种是选择本地的 SVG 或 PSD 文件。

谷歌建议与应用相关都使用 Material 图标,来保持安卓的连贯性和统一体验。这里有全部图标,记得看一下。

7、 设定边界的开始和结束

这是人们最容易忽略的地方之一。边界!增加边界当然很简单,但是如果要考虑支持很旧的平台呢?

边界的“开始”和“结束”分别是“左”和“右”的超集,所以如果应用的 minSdkVersion 是 17 或更低,边界和填充的“开始”和“结束”定义是旧的“左”/“右”所需要的。在那些没有定义“开始”和“结束”的系统上,这两个定义可以被安全地忽略。可以像下面这样声明:

android:layout_marginEnd="20dp"
android:paddingStart="20dp"

8、 使用 Getter/Setter 生成工具

在创建一个容器类(只是用来简单的存放一些变量数据)时很烦的一件事情是写多个 getter 和 setter,复制/粘贴该方法的主体再为每个变量重命名。

幸运的是,Android Studio 有一个解决方法。可以这样做,在类里声明你需要的所有变量,然后打开 Toolbar >> Code。快捷方式是 ALT + Insert。点击 Code 会显示 Generate,点击它会出来很多选项,里面有 Getter 和 Setter 选项。在保持焦点在你的类页面然后点击,就会为当前类添加所有的 getter 和 setter(有需要的话可以再去之前的窗口操作)。很爽吧。

9、 使用 Override/Implement 生成工具

这是另一个很好用的生成工具。自定义一个类然后再扩展很容易,但是如果要扩展你不熟悉的类呢。比如说 PagerAdapter,你希望用 ViewPager 来展示一些页面,那就需要定制一个 PagerAdapter 并实现它的重载方法。但是具体有哪些方法呢?Android Studio 非常贴心地为自定义类强行添加了一个构造函数,或者可以用快捷键(ALT + Enter),但是父类 PagerAdapter 里的其他(虚拟)方法需要自己手动添加,我估计大多数人都觉得烦。

要列出所有可以重载的方法,可以点击 Code >> Generate and Override methods 或者 Implement methods,根据你的需要。你还可以为你的类选择多个方法,只要按住 Ctrl 再选择方法,然后点击 OK。

10、 正确理解 Context

Context 有点恐怖,我估计许多初学者从没有认真理解过 Context 类的结构 - 它是什么,为什么到处都要用到它。

简单地说,它将你能从屏幕上看到的所有内容都整合在一起。所有的视图(或者它们的扩展)都通过 Context 绑定到当前的环境。Context 用来管理应用层次的资源,比如说显示密度,或者当前的关联活动。活动、服务和应用都实现了 Context 类的接口来为其他关联组件提供内部资源。举个添加到 MainActivity 的 TextView 的例子。你应该注意到了,在创建一个对象的时候,TextView 的构造函数需要 Context 参数。这是为了获取 TextView 里定义到的资源。比如说,TextView 需要在内部用到 Roboto 字体。这样的话,TextView 需要 Context。而且在我们将 Context(或者 this)传递给 TextView 的时候,也就是告诉它绑定当前活动的生命周期。

另一个 Context 的关键应用是初始化应用层次的操作,比如初始化一个库。库的生命周期和应用是不相关的,所以它需要用 getApplicationContext() 来初始化,而不是用 getContext 或 this 或 getActivity()。掌握正确使用不同 Context 类型非常重要,可以避免内存泄漏。另外,要用到 Context 来启动一个活动或服务。还记得 startActivity(…) 吗?当你需要在一个非活动类里切换活动时,你需要一个 Context 对象来调用 startActivity 方法,因为它是 Context 类的方法,而不是 Activity 类。

getContext().startActivity(getContext(), SecondActivity.class);

如果你想了解更多 Context 的行为,可以看看这里或这里。第一个是一篇关于 Context 的很好的文章,介绍了在哪些地方要用到它。而另一个是安卓关于 Context 的文档,全面介绍了所有的功能 - 方法,静态标识以及更多。

奖励 #1: 格式化代码

有人会不喜欢整齐,统一格式的代码吗?好吧,几乎我们每一个人,在写一个超过 1000 行的类的时候,都希望我们的代码能有合适的结构。而且,并不仅仅大的类才需要格式化,每一个小模块类也需要让代码保持可读性。

使用 Android Studio,或者任何 JetBrains IDE,你都不需要自己手动整理你的代码,像增加缩进或者 = 之前的空格。就按自己希望的方式写代码,在想要格式化的时候,如果是 Windows 系统可以按下 ALT + CTRL + L,Linux 系统按下 ALT + CTRL + SHIFT + L。代码就自动格式化好了

奖励 #2: 使用库

面向对象编程的一个重要原则是增加代码的可重用性,或者说减少重新发明轮子的习惯。很多初学者错误地遵循了这个原则。这条路有两个方向,

  • 不用任何库,自己写所有的代码。
  • 用库来处理所有事情。

不管哪个方向走到底都是不对的。如果你彻底选择第一个方向,你将消耗大量的资源,仅仅是为了满足自己拥有一切的骄傲。很可能你的代码没有做过替代库那么多的测试,从而增加模块出问题的可能。如果资源有限,不要重复发明轮子。直接用经过测试的库,在有了明确目标以及充分的资源后,可以用自己的可靠代码来替换这个库。

而彻底走向另一个方向,问题更严重 - 别人代码的可靠性。不要习惯于所有事情都依赖于别人的代码。在不用太多资源或者自己能掌控的情况下尽量自己写代码。你不需要用库来自定义一个 TypeFaces(字体),你可以自己写一个。

所以要记住,在这两个极端中间平衡一下 - 不要重新创造所有事情,也不要过分依赖外部代码。保持中立,根据自己的能力写代码。

这篇文章最早发布在 What’s That Lambda 上。请访问网站阅读更多关于 Android、Node.js、Angular.js 等等类似文章。


via: https://android.jlelse.eu/12-practices-every-android-beginner-should-know-cd43c3710027

作者:Nilesh Singh 译者:zpl1025 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出