分类 技术 下的文章

在向你展示如何在 Linux 中更改 MAC 地址之前,让我们首先讨论为什么要更改它。

可能有几个原因。也许你不希望在公共网络上公开你的实际 MAC 地址(也称为物理地址)?还有可能是网络管理员可能已在路由器或防火墙中阻止了特定的 MAC 地址。

一个实用的“好处”是某些公共网络(例如机场 WiFi)允许在有限的时间内免费上网。如果你还想继续使用,那么伪造 Mac 地址可能会欺骗网络,让它认为是一台新设备。这也是一个有名的原因。
我将展示更改 MAC 地址(也称为欺骗/伪造 MAC 地址)的步骤。

在 Linux 中更改 MAC 地址

让我们一步步来:

查找你的 MAC 地址和网络接口

让我们找出一些关于 Linux 中网卡的细节。使用此命令获取网络接口详细信息:

ip link show

在输出中,你将看到一些详细信息以及 MAC 地址:

1: lo: <LOOPBACK,UP,LOWER_UP> mtu 65536 qdisc noqueue state UNKNOWN mode DEFAULT group default qlen 1000
    link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00
2: eno1: <NO-CARRIER,BROADCAST,MULTICAST,UP> mtu 1500 qdisc fq_codel state DOWN mode DEFAULT group default qlen 1000
    link/ether 94:c6:f8:a7:d7:30 brd ff:ff:ff:ff:ff:ff
3: enp0s31f6: <BROADCAST,MULTICAST,UP,LOWER_UP> mtu 1500 qdisc noqueue state UP mode DORMANT group default qlen 1000
    link/ether 38:42:f8:8b:a7:68 brd ff:ff:ff:ff:ff:ff
4: docker0: <NO-CARRIER,BROADCAST,MULTICAST,UP> mtu 1500 qdisc noqueue state DOWN mode DEFAULT group default
    link/ether 42:02:07:8f:a7:38 brd ff:ff:ff:ff:ff:ff

如你所见,在这里,我的网络接口称为 enp0s31f6,MAC 地址为 38:42:f8:8b:a7:68。

你可能需要在安全的地方记录下来,以便稍后还原到该原始 MAC 地址。

现在你可以继续更改 MAC 地址。

注意!

如果在当前使用的网络接口上执行此操作,那么可能会中断你的网络连接。因此,请在其他网卡上尝试使用此方法,或者准备重启网络。

方法 1:使用 Macchanger 更改 MAC 地址
Macchanger 是查看、修改和操作网卡 MAC 地址的简单程序。它几乎在所有 GNU/Linux 操作系统中都可用,你可以使用发行版的包安装程序进行安装。

在 Arch Linux 或 Manjaro 上:

sudo pacman -S macchanger

在 Fedora、CentOS 和 RHEL 上:

sudo dnf install macchanger

在 Debian、Ubuntu、Linux Mint、Kali Linux 上:

sudo apt install macchanger

重要!系统会要求你选择是否应将 macchanger 设置为在每次启动或关闭网络设备时自动运行。每当你接到网线或重启 WiFi 时,它都会提供一个新的 MAC 地址。
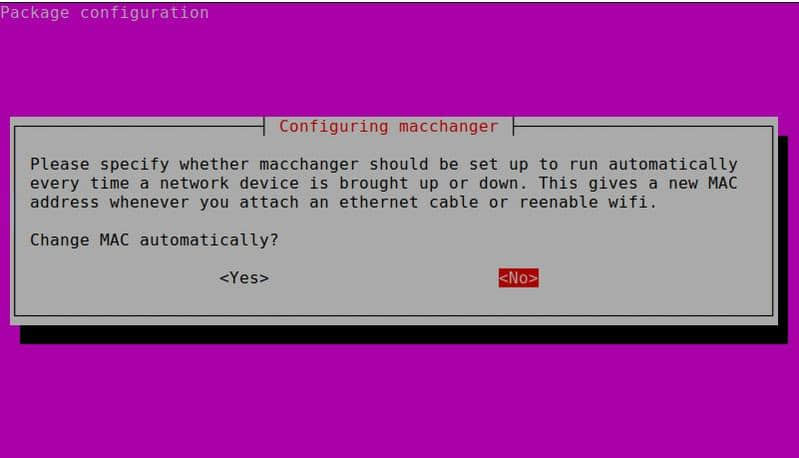
Not a good idea to run it automatically

我建议不要自动运行它,除非你确实需要每次更改 MAC 地址。因此,选择“No”(按 Tab 键),然后按回车键继续。

如何使用 Macchanger 更改 MAC 地址

你还记得网络接口名称吗?你在前面的步骤中获得了它。

现在,要将随机 MAC 地址分配给该网卡,请使用:

sudo macchanger -r enp0s31f6

更改 MAC 后,使用以下命令进行验证:

ip addr

现在你将看到已经伪造 MAC。

要将 MAC 地址更改为特定值,请使用以下命令指定自定义 MAC 地址:

macchanger --mac=XX:XX:XX:XX:XX:XX

其中 XX:XX:XX:XX:XX:XX 是你要更改的新 MAC。

最后,要将 MAC 地址恢复为其原始硬件值,请运行以下命令:

macchanger -p enp0s31f6

但是,你不必如此。重启系统后,更改将自动丢失,并且实际的 MAC 地址将再次恢复。

你可以随时查看手册页以获取更多详细信息。

方法 2:使用 iproute2 更改 Mac 地址(中级知识)

我建议你使用 macchanger,但如果你不想使用它,那么可以使用另一种方法在 Linux 中更改 MAC 地址。

首先,使用以下命令关闭网卡:

sudo ip link set dev enp0s31f6 down

接下来,使用以下命令设置新的 MAC:

sudo ip link set dev enp0s31f6 address XX:XX:XX:XX:XX:XX

最后,使用以下命令重新打开网络:

sudo ip link set dev enp0s31f6 up

现在,验证新的 MAC 地址:

ip link show enp0s31f6

就是这些了。你已经成功地在 Linux 中修改了 MAC 地址。敬请期待 FOSS 更多有关 Linux 教程和技巧的文章。


via: https://itsfoss.com/change-mac-address-linux/

作者:Dimitrios Savvopoulos 选题:lujun9972 译者:geekpi 校对:wxy
本文由 LCTT 原创编译,Linux中国 荣誉推出

去杂货店“采购”这些命令,你需要用这些 Kubernetes 工具来入门。

最近,我丈夫告诉我他即将要去参加一个工作面试,面试时他需要在计算机上运行一些基本命令。他对这场面试感到焦虑,但是对于他来说,学习和记住事情的最好方法是将不了解的事物比喻为非常熟悉的事物。因为我们的谈话是在我逛杂货店试图决定当晚要烹饪的食物之后进行的,所以这启发我用一次去杂货店的行程来介绍 kubectl 和 helm 命令。

Helm(“舵轮”)是在 Kubernetes(来自希腊语,意思是“舵手” 或 “领航员”)中管理应用程序的工具。你可以轻松地使用你的应用程序信息来部署“ 海图 chart ”,从而可以在你的 Kubernetes 环境中几分钟之内让它们就绪并预配置好。在学习新知识时,查看示例的“海图”以了解其用法总是很有帮助的,因此,如果有时间,请查看这些成型的“海图”。(LCTT 译注:Kubernetes 生态中大量使用了和航海有关的比喻,因此本文在翻译时也采用了这些比喻)

kubectl 是与 Kubernetes 环境交互的命令行界面,允许你配置和管理集群。它需要一些配置才能在环境中工作,因此请仔细阅读其文档以了解你需要做什么。

我会在示例中使用命名空间,你可以在我的文章《Kubernetes 命名空间入门》中了解它。

现在我们已经准备好了,让我们开始 kubectl和 helm 基本命令的购物之旅!

用 Helm 列出清单

你去商店之前要做的第一件事是什么?好吧,如果你做事有条理,会创建一个“清单”。同样,这是我将解释的第一个基本的 Helm 命令。

在一个用 Helm 部署的应用程序中,list 命令提供有关应用程序当前版本的详细信息。在此示例中,我有一个已部署的应用程序:Jenkins CI/CD 应用程序。运行基本的 list 命令总是会显示默认的命名空间。由于我没有在默认的命名空间中部署任何内容,因此不会显示任何内容:

$helm list
NAME    NAMESPACE    REVISION    UPDATED    STATUS    CHART    APP VERSION

但是,如果运行带有额外标志的命令,则会显示我的应用程序和信息:

$helm list --all-namespaces
NAME     NAMESPACE  REVISION  UPDATED                   STATUS      CHART           APP  VERSION
jenkins  jenkins        1         2020-01-18 16:18:07 EST   deployed    jenkins-1.9.4   lts

最后,我可以指示 list 命令只检查我想从中获取信息的命名空间:

$helm list --namespace jenkins
NAME     NAMESPACE  REVISION  UPDATED                   STATUS    CHART          APP VERSION
jenkins    jenkins      1              2020-01-18 16:18:07 EST  deployed  jenkins-1.9.4  lts    

现在我有了一个清单,并且知道该清单上有什么,我可以使用 get 命令来“获取”我的物品!我会从 Kubernetes 集群开始,看看我能从中获取到什么?

用 Kubectl 获取物品

kubectl get 命令提供了有关 Kubernetes 中许多事物的信息,包括“ 吊舱 Pod ”、节点和命名空间。同样,如果没有指定命名空间标志,就会使用默认的命名空间。首先,我获取集群中的命名空间以查看正在运行的命名空间:

$kubectl get namespaces
NAME             STATUS   AGE
default          Active   53m
jenkins          Active   44m
kube-node-lease  Active   53m
kube-public      Active   53m
kube-system      Active   53m

现在我已经知道了在我的环境中运行的有哪些命名空间了,接下来获取节点并查看有多少个节点正在运行:

$kubectl get nodes
NAME       STATUS   ROLES       AGE   VERSION
minikube   Ready    master  55m   v1.16.2

我有一个节点正在运行,这主要是因为我的 Minikube 运行在一台小型服务器上。要得到在我的这一个节点上运行的“吊舱”可以这样:

$kubectl get pods
No resources found in default namespace.

啊哦,它是空的。我将通过以下方式获取 Jenkins 命名空间中的内容:

$kubectl get pods --namespace jenkins
NAME                      READY  STATUS   RESTARTS  AGE
jenkins-7fc688c874-mh7gv  1/1    Running  0         40m

好消息!这里发现了一个“吊舱”,它还没有重新启动过,已运行了 40 分钟了。好的,如今我知道“吊舱”已经装好,所以我想看看用 Helm 命令可以得到什么。

用 Helm 获取信息

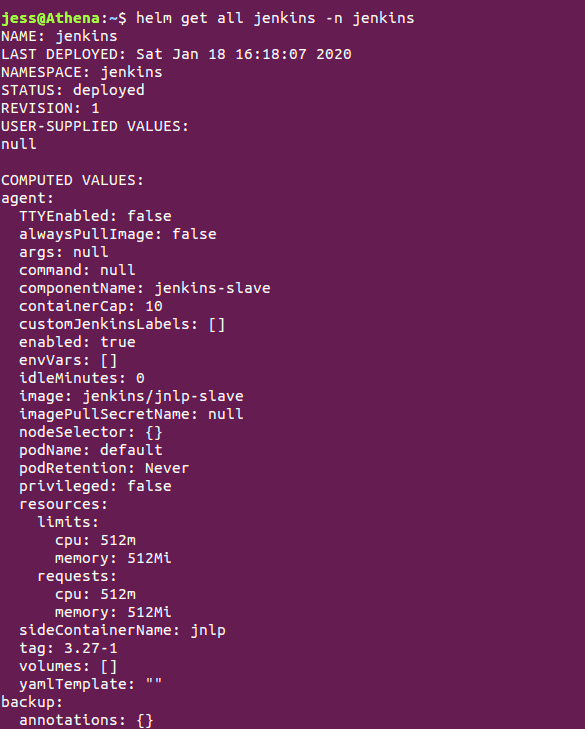
helm get 命令稍微复杂一点,因为这个“获取”命令所需要的不仅仅是一个应用程序名称,而且你可以从应用程序中请求多个内容。我会从获取用于制作该应用程序的值开始,然后展示“获取全部”的操作结果的片段,该操作将提供与该应用程序相关的所有数据。

$helm get values jenkins -n jenkins
USER-SUPPLIED VALUES:
null

由于我只安装了最小限度的稳定版,因此配置没有更改。如果我运行“获取全部”命令,我将得到所有的“海图”:

$helm get all jenkins -n jenkins

 title=

这会产生大量数据,因此我始终建议保留一份 Helm “海图”的副本,以便你可以查看“海图”中的模板。我还创建自己的值来了解自己所拥有的。

现在,我把所有的商品都放在购物车中了,我会检查一下“描述”它们包含什么的标签。这些示例仅与 kubectl 命令有关,它们描述了我通过 Helm 部署的内容。

用 kubectl 查看描述

正如我使用“获取”命令(该命令可以描述 Kubernetes 中的几乎所有内容)所做的那样,我将示例限定到命名空间、“吊舱”和节点上。由于我知道它们每一个是什么,因此这很容易。

$kubectl describe ns jenkins
Name:           jenkins
Labels:         &lt;none&gt;
Annotations:  &lt;none&gt;
Status:         Active
No resource quota.
No resource limits.

我可以看到我的命名空间的名称,并且它是活动的,没有资源或限额限制。

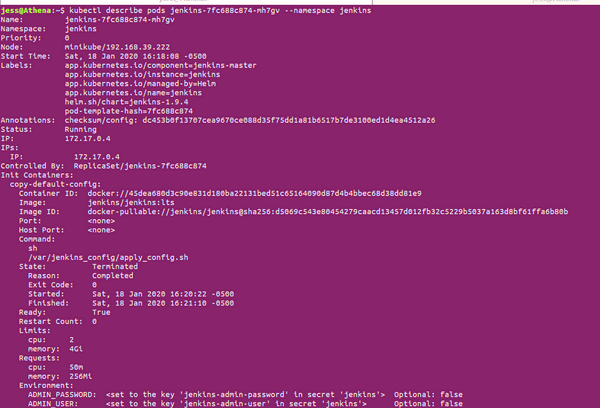
describe pods 命令会产生大量信息,因此我这里提供的是一小段输出。如果你在不使用“吊舱”名称的情况下运行该命令,它将返回名称空间中所有“吊舱”的信息,这可能会很麻烦。因此,请确保在此命令中始终包含“吊舱”名称。例如:

$kubectl describe pods jenkins-7fc688c874-mh7gv --namespace jenkins

 title=

这会提供容器的状态、管理方式、标签以及“吊舱”中所使用的镜像(还有很多其它信息)。没有在这个简化过的输出中包括的数据有:在 Helm 配置值文件中应用的各种条件下的资源请求和限制、初始化容器和存储卷信息。如果你的应用程序由于资源不足而崩溃,或者是一个需要运行前置脚本进行配置的初始配置容器,或者生成不应该存储于纯文本 YAML 文件中的隐藏密码,则此数据很有用。

最后,我将使用 describe node 命令,当然,它是用来描述节点的。由于本示例只有一个名为 Minikube 的示例,因此我将使用这个名字。如果你的环境中有多个节点,则必须包含你想查找的的节点名称。

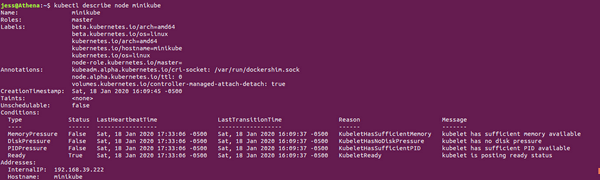
与“吊舱”一样,这个节点的命令会产生大量数据,因此我将仅包括输出片段。

$kubectl describe node minikube

 title=

注意,describe node 是更重要的基本命令之一。如此图所示,该命令返回统计信息,该信息指示节点何时资源用尽,并且该数据非常适合在需要扩展时(如果你的环境中没有自动扩展)向你发出警报。此输出片段中未包含的其它内容包括:对所有资源和限制的请求所占的百分比,以及资源的使用期限和分配(例如,对于我的应用程序而言)。

买单

使用这些命令,我完成了“购物”并得到了我想要的一切。希望这些基本命令也能在你使用 Kubernetes 的日常工作中提供帮助。

我鼓励你经常使用命令行并学习“帮助”部分中的速记标志,你可以通过运行以下命令来查看这些标志:

$helm --help

或

$kubectl -h

花生酱和果冻

有些东西像花生酱和果冻一样混在一起。Helm 和 kubectl 就有点像那样交错在一起。

我经常在自己的环境中使用这些工具。因为它们在很多地方都有很多相似之处,所以在使用其中一个之后,我通常需要跟进另一个。例如,我可以进行 Helm 部署,并使用 kubectl 观察它是否失败。一起试试它们,看看它们能为你做什么。


via: https://opensource.com/article/20/2/kubectl-helm-commands

作者:Jessica Cherry 选题:lujun9972 译者:wxy 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

这些树莓派项目均旨在简化你的生活并提高生产力。

没有什么比体验树莓派创作结果更令人兴奋了。经过数小时的编程、测试和徒手构建,你的项目终于开始成形,你不禁大喊 “哇哦!”树莓派可以带给日常生活的可能性让我着迷。无论你是想学习新知识、尝试提高效率还是只是乐在其中,本文总有一个树莓派项目适合你。

设置 VPN 服务器

本教程教你如何使用树莓派添加一个网络安全层。这个项目不仅有实际好处,而且还能为你带来很多乐趣。额外的安全性使你可以放心地做其它项目,例如下面列出的项目。

创建一个物体跟踪摄像机

树莓派之所以具有吸引力,是因为它提供了较低的入门门槛来学习机器学习等新技术。这份分步指南提供了详尽的说明,说明了如何构建一个全景摄像头,以便使用 TensorFlow 和树莓派跟踪运动。

使用照片幻灯片展示你最喜欢的回忆

你是否曾经问过自己:“我应该怎么处理这些数码照片?”。如果你像我一样这样想过,那么答案是“是”。在朋友和家人圈子中,我被公认为摄像爱好者。这就是为什么我喜欢这个树莓派项目。在本教程中,你将学习如何设置照片幻灯片,以便轻松地在家里展示自己喜欢的回忆,而无需打印机!

玩复古电子游戏

如果你对复古游戏系统怀有怀旧之情,那么可以尝试本教程。了解包括树莓派在内的哪些设备可以运行 Amiga 模拟器。完成设置后,你将可在树莓派上玩自己喜欢的 Amiga 游戏。

为你的娱乐中心搭建时钟

在过去的十年中,家庭娱乐中心发生了很大的变化。我的家人完全依靠流媒体服务来观看节目和电影。我之所以爱它是因为我可以通过移动设备或语音助手控制电视。但是,当你不再能一眼看到时钟时,便会失去一定程度的便利!请遵循这些步骤,使用树莓派从头开始搭建自己的时钟显示。

扩大自制啤酒的生产规模

在本教程中,经验丰富的家庭酿酒师分享了他建立电动啤酒酿造系统的经验。该项目需要在硬件和零件上进行更多的前期投资,但由此产生的效率和一致性让这些值得。为此祝贺!

如果你是像我这样的树莓派新手,那么我建议你阅读我们这些可下载的树莓派指南。我们的单页速查表提供了入门指南。有关更多技巧和教程,我们的综合指南涵盖了一些主题,例如选择树莓派、保持更新、为社区做出贡献等。

你会尝试哪个树莓派项目?让我们在评论中知道。


via: https://opensource.com/article/20/3/raspberry-pi-tutorials

作者:Lauren Pritchett 选题:lujun9972 译者:geekpi 校对:wxy
本文由 LCTT 原创编译,Linux中国 荣誉推出

下面六件事情你可能都没有意识到可以在 Emacs 下完成。此外还有我们的新备忘单,拿去,充分利用 Emacs 的功能吧。

想象一下使用 Python 的 IDLE 界面来编辑文本。你可以将文件加载到内存中,编辑它们,并保存更改。但是你执行的每个操作都由 Python 函数定义。例如,调用 upper() 来让一个单词全部大写,调用 open 打开文件,等等。文本文档中的所有内容都是 Python 对象,可以进行相应的操作。从用户的角度来看,这与其他文本编辑器的体验一致。对于 Python 开发人员来说,这是一个丰富的 Python 环境,只需在配置文件中添加几个自定义函数就可以对其进行更改和开发。

这就是 Emacs 对 1958 年的编程语言 Lisp) 所做的事情。在 Emacs 中,运行应用程序的 Lisp 引擎与输入文本之间无缝结合。对 Emacs 来说,一切都是 Lisp 数据,因此一切都可以通过编程进行分析和操作。

这造就了一个强大的用户界面(UI)。但是,如果你是 Emacs 的普通用户,你可能对它的能力知之甚少。下面是你可能没有意识到 Emacs 可以做的六件事。

使用 Tramp 模式进行云端编辑

Emacs 早在网络流行化之前就实现了透明的网络编辑能力了,而且时至今日,它仍然提供了最流畅的远程编辑体验。Emacs 中的 Tramp 模式(以前称为 RPC 模式)代表着 “ 透明的远程(文件)访问,多协议 Transparent Remote (file) Access,Multiple Protocol ”,这准确说明了它提供的功能:通过最流行的网络协议轻松访问你希望编辑的远程文件。目前最流行、最安全的能用于远程编辑的协议是 OpenSSH,因此 Tramp 使用它作为默认的协议。

在 Emacs 22.1 或更高版本中已经包含了 Tramp,因此要使用 Tramp,只需使用 Tramp 语法打开一个文件。在 Emacs 的 “File” 菜单中,选择 “Open File”。当在 Emacs 窗口底部的小缓冲区中出现提示时,使用以下语法输入文件名:

/ssh:[email protected]:/path/to/file

如果需要交互式登录,Tramp 会提示你输入密码。但是,Tramp 直接使用 OpenSSH,所以为了避免交互提示,你可以将主机名、用户名和 SSH 密钥路径添加到你的 ~/.ssh/config 文件。与 Git 一样,Emacs 首先使用你的 SSH 配置,只有在出现错误时才会停下来询问更多信息。

Tramp 非常适合编辑并没有放在你的计算机上的文件,它的用户体验与编辑本地文件没有明显的区别。下次,当你 SSH 到服务器启动 Vim 或 Emacs 会话时,请尝试使用 Tramp。

日历

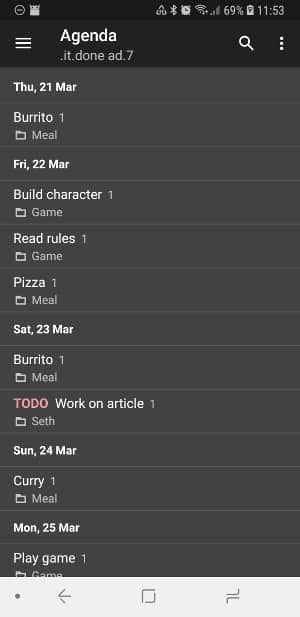
如果你喜欢文本多过图形界面,那么你一定会很高兴地知道,可以使用 Emacs 以纯文本的方式安排你的日程(或生活),而且你依然可以在移动设备上使用开源的 Org 模式查看器来获得华丽的通知。

这个过程需要一些配置,以创建一个方便的方式来与移动设备同步你的日程(我使用 Git,但你可以调用蓝牙、KDE Connect、Nextcloud,或其他文件同步工具),此外你必须在移动设备上安装一个 Org 模式查看器(如 Orgzly)以及 Git 客户程序。但是,一旦你搭建好了这些基础,该流程就会与你常用的(或正在完善的,如果你是新用户)Emacs 工作流完美地集成在一起。你可以在 Emacs 中方便地查阅日程、更新日程,并专注于任务上。议程上的变化将会反映在移动设备上,因此即使在 Emacs 不可用的时候,你也可以保持井然有序。

感兴趣了?阅读我的关于使用 Org mode 和 Git 进行日程安排的逐步指南。

访问终端

有许多终端模拟器可用。尽管 Emacs 中的 Elisp 终端仿真器不是最强大的通用仿真器,但是它有两个显著的优点:

  1. 打开在 Emacs 缓冲区之中:我使用 Emacs 的 Elisp shell,因为它在 Emacs 窗口中打开很方便,我经常全屏运行该窗口。这是一个小而重要的优势,只需要输入 Ctrl+x+o(或用 Emacs 符号来表示就是 C-x o)就能使用终端了,而且它还有一个特别好的地方在于当运行漫长的作业时能够一瞥它的状态报告。
  2. 在没有系统剪贴板的情况下复制和粘贴特别方便:无论是因为懒惰不愿将手从键盘移动到鼠标,还是因为在远程控制台运行 Emacs 而无法使用鼠标,在 Emacs 中运行终端有时意味着可以从 Emacs 缓冲区中很快地传输数据到 Bash。

要尝试 Emacs 终端,输入 Alt+x(用 Emacs 符号表示就是 M-x),然后输入 shell,然后按回车。

使用 Racket 模式

Racket 是一种激动人心的新兴 Lisp 方言,拥有动态编程环境、GUI 工具包和充满激情的社区。学习 Racket 的默认编辑器是 DrRacket,它的顶部是定义面板,底部是交互面板。使用该设置,用户可以编写影响 Racket 运行时环境的定义。就像旧的 Logo Turtle#Turtle_and_graphics) 程序,但是有一个终端而不是仅仅一个海龟。

Racket-mode

由 PLT 提供的 LGPL 示例代码

基于 Lisp 的 Emacs 为资深 Racket 编程人员提供了一个很好的集成开发环境(IDE)。它尚未附带 Racket 模式,但你可以使用 Emacs 包安装程序安装 Racket 模式和辅助扩展。要安装它,按下 Alt+X(用 Emacs 符号表示就是 M-x),键入 package-install,然后按回车。接着输入要安装的包 racet-mode,按回车。

使用 M-x racket-mode 进入 Racket 模式。如果你是 Racket 新手,而对 Lisp 或 Emacs 比较熟悉,可以从这份优秀的图解 Racket 入手。

脚本

你可能知道,Bash 脚本在自动化和增强 Linux 或 Unix 体验方面很流行。你可能听说过 Python 在这方面也做得很好。但是你知道 Lisp 脚本可以用同样的方式运行吗?有时人们会对 Lisp 到底有多有用感到困惑,因为许多人是通过 Emacs 来了解 Lisp 的,因此有一种潜在的印象,即在 21 世纪运行 Lisp 的惟一方法是在 Emacs 中运行。幸运的是,事实并非如此,Emacs 是一个很好的 IDE,它支持将 Lisp 脚本作为一般的系统可执行文件来运行。

除了 Elisp 之外,还有两种流行的现代 Lisp 可以很容易地用来作为独立脚本运行。

  1. Racket:你可以通过在系统上运行 Racket 来提供运行 Racket 脚本所需的运行时支持,或者你可以使用 raco exe 产生一个可执行文件。raco exe 命令将代码和运行时支持文件一起打包,以创建可执行文件。然后,raco distribution 命令将可执行文件打包成可以在其他机器上工作的发行版。Emacs 有许多 Racket 工具,因此在 Emacs 中创建 Racket 文件既简单又有效。
  2. GNU Guile:GNU Guile( GNU 通用智能语言扩展 GNU Ubiquitous Intelligent Language for Extensions 的缩写)是 Scheme) 编程语言的一个实现,它可以用于为桌面、互联网、终端等创建应用程序和游戏。Emacs 中的 Scheme 扩展众多,使用任何一个扩展来编写 Scheme 都很容易。例如,这里有一个用 Guile 编写的 “Hello world” 脚本:
#!/usr/bin/guile -s
!#

(display "hello world")
     (newline)

用 guile 编译并允许它:

$ guile ./hello.scheme
;;; compiling /home/seth/./hello.scheme
;;; compiled [...]/hello.scheme.go
hello world
$ guile ./hello.scheme
hello world

无需 Emacs 允许 Elisp

Emacs 可以作为 Elisp 的运行环境,但是你无需按照传统印象中的必须打开 Emacs 来运行 Elisp。--script 选项可以让你使用 Emacs 作为引擎来执行 Elisp 脚本,而无需运行 Emacs 图形界面(甚至也无需使用终端)。下面这个例子中,-Q 选项让 Emacs 忽略 .emacs 文件,从而避免由于执行 Elisp 脚本时产生延迟(若你的脚本依赖于 Emacs 配置中的内容,那么请忽略该选项)。

emacs -Q --script ~/path/to/script.el

下载 Emacs 备忘录

Emacs 许多重要功能都不是只能通过 Emacs 来实现的;Org 模式是 Emacs 扩展也是一种格式标准,流行的 Lisp 方言大多不依赖于具体的应用,我们甚至可以在没有可见或可交互式 Emacs 实例的情况下编写和运行 Elisp。然后若你对为什么模糊代码和数据之间的界限能够引发创新和效率感到好奇的话,那么 Emacs 是一个很棒的工具。

幸运的是,现在是 21 世纪,Emacs 有了带有传统菜单的图形界面以及大量的文档,因此学习曲线不再像以前那样。然而,要最大化 Emacs 对你的好处,你需要学习它的快捷键。由于 Emacs 支持的每个任务都是一个 Elisp 函数,Emacs 中的任何功能都可以对应一个快捷键,因此要描述所有这些快捷键是不可能完成的任务。你只要学习使用频率 10 倍于不常用功能的那些快捷键即可。

我们汇聚了最常用的 Emacs 快捷键成为一份 Emacs 备忘录以便你查询。将它挂在屏幕附近或办公室墙上,把它作为鼠标垫也行。让它触手可及经常翻阅一下。每次翻两下可以让你获得十倍的学习效率。而且一旦开始编写自己的函数,你一定不会后悔获取了这个免费的备忘录副本的!


via: https://opensource.com/article/20/1/emacs-cheat-sheet

作者:Seth Kenlon 选题:lujun9972 译者:lujun9972 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

使用 less 文件查看器的一些技巧。

最近,我正在拜读 Scott Nesbitt 的文章《在 Linux 命令行中使用 less 来查看文本文件》,并受到了一些启发,所以我想分享一些使用 less 命令的技巧。

LESS 环境变量

如果你定义了环境变量 LESS(例如在 .bashrc 中),那么 less 会将其视为一个选项列表,就像在命令行中传递给它一样。

我这样定义:

LESS='-C -M -I -j 10 -# 4'

它的意思是:

  • -C – 通过不从底部滚动来加快全屏打印速度。
  • -M – 在最后一行(状态行)显示更多信息。你可以使用 -PM 来自定义显示的信息,但我通常只用 -M。
  • -I – 忽略搜索中的大小写。
  • -j 10 – 在终端的第 10 行而不是第一行显示搜索结果。这样,每次按 n 或(N) 跳到下一个(或上一个)匹配项时,就会有 10 条上下文。
  • -# 4 – 当按下向右或向左的箭头时,会向右或向左跳四个字符。默认情况时跳转半个屏幕,我觉得太多了。一般来说,less 似乎(至少部分)是按最初开发它时的环境优化的,那时使用慢速调制解调器和低带宽的互联网连接,所以跳过半个屏幕是有意义的。

PAGER 环境变量

许多程序使用在 PAGER 环境变量中的命令来显示信息。因此,你可以在 .bashrc 中设置 PAGER=less,然后让程序运行 less。查看手册页(man 7 environ)中是否有其它此类变量。

-S

-S 告诉 less 将长行切断而不是将它们换行。除非我在(或我要)查看文件,否则我很少需要这样做。幸运的是,你可以在 less 中输入所有命令行选项,就像它们是键盘命令一样。因此,如果我想在文件已经打开的情况下隔断长行,我可以简单地输入 -S。(LCTT 译注:注意大写 S ,并按回车)

这是我经常使用的一个例子:

su - postgres
export PAGER=less  # 因为我不用在所有的机器上编辑 postgres 的 .bashrc
psql

有时当我查看一个 SELECT 命令的输出非常宽时,我会输入 -S 以便将其格式化的漂亮一些。如果当我按下右箭头想查看更多内容时它跳得太远(因为我没有设置 -#),则可以输入 -#8,那么每次按下右箭头都会向右移动八个字符。

有时在多次输入 -S 之后,我会退出 psql 并设置环境变量后再次运行它:

export LESS=-S

F

命令 F 可以使 less 像 tail -f 一样工作,等待更多的数据被添加到文件后再显示它们。与 tail -f 相比,它的一个优点是,高亮显示搜索匹配仍然有效。因此,你可以输入 less /var/log/logfile,搜索某些内容时,它将高亮显示所有出现的内容(除非你使用了 -g),然后按下 F 键,当更多数据写入到日志时,less 将显示它并高亮新的匹配项。

按下 F 后,可以按 Ctrl+C 来停止其查找新数据(这不会干掉它),这样你可以返回文件查看旧内容,搜索其它内容等,然后再次按 F 键来查看更多新数据。

搜索

搜索使用系统的正则表达式库,这通常意味着你可以使用扩展正则表达式。特别是,搜索 one|two|three 可以找到并高亮所有的 one、two 或 three。

我经常使用的另一种模式是 .*someting.*,特别是对于一些很长的日志行(例如,跨越多个终端宽度的行),它会高亮整行。这种模式使查看一行的起始和结束位置变得更加容易。我还会结合其它内容,例如 .*one thing.*|.*another thing.*,或者使用 key: .*|.*marker.* 来查看 key 的内容。例如,一个日志文件中包含一些字典/哈希的转储。它会高亮相关的标记行,这样我就看到上下文了,甚至,如果我知道这个值被引号引起来的话,就可以:

key: '[^']*'|.*marker.*

less 会保留你的搜索项的历史纪录,并将其保存到磁盘中以备将来调用。当你按下 / 或 ? 时,可以使用向上或向下箭头浏览历史记录(以及进行基本的行编辑)。

在撰写本文时,我无意间看了下 less 手册页,发现了一个非常有用的功能:使用 &!pattern 跳过无关的行。例如,当我在 /var/log/messages 中寻找内容时,经常会一个个迭代使用以下命令:

cat /var/log/messages | egrep -v 'systemd: Started Session' | less
cat /var/log/messages | egrep -v 'systemd: Started Session|systemd: Starting Session' | less
cat /var/log/messages | egrep -v 'systemd: Started Session|systemd: Starting Session|User Slice' | less
cat /var/log/messages | egrep -v 'systemd: Started Session|systemd: Starting Session|User Slice|dbus' | less
cat /var/log/messages | egrep -v 'systemd: Started Session|systemd: Starting Session|User Slice|dbus|PackageKit Daemon' | less

但是现在我知道如何在 less 中做同样的事情。例如,我可以输入 &!systemd: Started Session,然后想要隐藏 systemd: Starting Session,所以我输入 &!,并使用向上箭头从历史记录中获得上一次搜索的结果。然后我接着输入 |systemd: Starting Session 并按下回车,继续以相同的方式添加更多条目,直到我过滤掉足够多的条目,看到更有趣的内容。

=

命令 = 显示有关文件和位置的更多信息,甚至比 -M 更多。如果文件非常大,计算 = 花费的时间太长,可以按下 Ctrl+C,它将停止尝试计算。

如果你正在查看的内容来自管道而不是文件,则 =(和 -M)不会显示未知内容,包括文件中的行数和字节数。要查看这些数据,如果你知道管道命令将很快结束,则可以使用 G 跳到最后,然后 less 将开始显示这些信息。

如果按下 G 并且写入管道的命令花费的时间比预期的长,你可以按下 Ctrl+C,该命令将被终止。即使你没有按 G,Ctrl+C 键也会杀死它。因此,如果你不想终止命令,请不要意外按下 Ctrl+C。出于这个原因,如果命令执行了某些操作(不仅是显示信息),通常更安全的做法是将其输出写入文件并在单独的终端中查看文件,而不是使用管道。

为什么你需要 less

less 是一个非常强大的程序,与该领域中较新的竞争者(例如 most 和 more)不同,你可能会在几乎所有的系统上找到它,就像 vi 一样。因此,即使你使用 GUI 查看器或编辑器,花一些时间浏览 less 手册页也是值得的,至少可以了解一下它的用处。这样,当你需要做一些已有的功能可能提供的工作时,就会知道如何要搜索手册页或互联网来找到所需的内容。

有关更多信息,访问 less 主页。该网站有一个不错的常见问题解答,其中包含更多提示和技巧。


via: https://opensource.com/article/18/5/advanced-use-less-text-file-viewer

作者:Yedidyah Bar David 选题:lujun9972 译者:MjSeven 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

我将在本系列的第二篇中深入研究由多个文件组成的 C 程序的结构。

在第一篇中,我设计了一个名为喵呜喵呜的多文件 C 程序,该程序实现了一个玩具编解码器。我也提到了程序设计中的 Unix 哲学,即在一开始创建多个空文件,并建立一个好的结构。最后,我创建了一个 Makefile 文件夹并阐述了它的作用。在本文中将另一个方向展开:现在我将介绍简单但具有指导性的喵呜喵呜编解码器的实现。

当读过我的《如何写一个好的 C 语言 main 函数》后,你会觉得喵呜喵呜编解码器的 main.c 文件的结构很熟悉,其主体结构如下:

/* main.c - 喵呜喵呜流式编解码器 */

/* 00 系统包含文件 */
/* 01 项目包含文件 */
/* 02 外部声明 */
/* 03 定义 */
/* 04 类型定义 */
/* 05 全局变量声明(不要用)*/
/* 06 附加的函数原型 */
   
int main(int argc, char *argv[])
{
  /* 07 变量声明 */
  /* 08 检查 argv[0] 以查看该程序是被如何调用的 */
  /* 09 处理来自用户的命令行选项 */
  /* 10 做点有用的事情 */
}
   
/* 11 其它辅助函数 */

包含项目头文件

位于第二部分中的 /* 01 项目包含文件 */ 的源代码如下:

/* main.c - 喵呜喵呜流式编解码器 */
...
/* 01 项目包含文件 */
#include "main.h"
#include "mmecode.h"
#include "mmdecode.h"

#include 是 C 语言的预处理命令,它会将该文件名的文件内容拷贝到当前文件中。如果程序员在头文件名称周围使用双引号(""),编译器将会在当前目录寻找该文件。如果文件被尖括号包围(<>),编译器将在一组预定义的目录中查找该文件。

main.h 文件中包含了 main.c 文件中用到的定义和类型定义。我喜欢尽可能多将声明放在头文件里,以便我在我的程序的其他位置使用这些定义。

头文件 mmencode.h 和 mmdecode.h 几乎相同,因此我以 mmencode.h 为例来分析。

/* mmencode.h - 喵呜喵呜流编解码器 */
  
#ifndef _MMENCODE_H
#define _MMENCODE_H
  
#include <stdio.h>
  
int mm_encode(FILE *src, FILE *dst);
  
#endif /* _MMENCODE_H */

#ifdef、#define、#endif 指令统称为 “防护” 指令。其可以防止 C 编译器在一个文件中多次包含同一文件。如果编译器在一个文件中发现多个定义/原型/声明,它将会产生警告。因此这些防护措施是必要的。

在这些防护内部,只有两个东西:#include 指令和函数原型声明。我在这里包含了 stdio.h 头文件,以便于能在函数原型中使用 FILE 定义。函数原型也可以被包含在其他 C 文件中,以便于在文件的命名空间中创建它。你可以将每个文件视为一个独立的命名空间,其中的变量和函数不能被另一个文件中的函数或者变量使用。

编写头文件很复杂,并且在大型项目中很难管理它。不要忘记使用防护。

喵呜喵呜编码的最终实现

该程序的功能是按照字节进行 MeowMeow 字符串的编解码,事实上这是该项目中最简单的部分。截止目前我所做的工作便是支持允许在适当的位置调用此函数:解析命令行,确定要使用的操作,并打开将要操作的文件。下面的循环是编码的过程:

/* mmencode.c - 喵呜喵呜流式编解码器 */
...
   while (!feof(src)) {

     if (!fgets(buf, sizeof(buf), src))
       break;

     for(i=0; i<strlen(buf); i++) {
       lo = (buf[i] & 0x000f);
       hi = (buf[i] & 0x00f0) >> 4;
       fputs(tbl[hi], dst);
       fputs(tbl[lo], dst);
     }
   }

简单的说,当文件中还有数据块时( feof(3) ),该循环读取(feof(3) )文件中的一个数据块。然后将读入的内容的每个字节分成两个 hi 和 lo 的 半字节 nibble 。半字节是半个字节,即 4 个位。这里的奥妙之处在于可以用 4 个位来编码 16 个值。我将 hi 和 lo 用作 16 个字符串查找表 tbl 的索引,表中包含了用半字节编码的 MeowMeow 字符串。这些字符串使用 fputs(3) 函数写入目标 FILE 流,然后我们继续处理缓存区的下一个字节。

该表使用 table.h 中的宏定义进行初始化,在没有特殊原因(比如:要展示包含了另一个项目的本地头文件)时,我喜欢使用宏来进行初始化。我将在未来的文章中进一步探讨原因。

喵呜喵呜解码的实现

我承认在开始工作前花了一些时间。解码的循环与编码类似:读取 MeowMeow 字符串到缓冲区,将编码从字符串转换为字节

 /* mmdecode.c - 喵呜喵呜流式编解码器 */
 ...
 int mm_decode(FILE *src, FILE *dst)
 {
   if (!src || !dst) {
     errno = EINVAL;
     return -1;
   }
   return stupid_decode(src, dst);
 }

这不符合你的期望吗?

在这里,我通过外部公开的 mm_decode() 函数公开了 stupid_decode() 函数细节。我上面所说的“外部”是指在这个文件之外。因为 stupid_decode() 函数不在该头文件中,因此无法在其他文件中调用它。

当我们想发布一个可靠的公共接口时,有时候会这样做,但是我们还没有完全使用函数解决问题。在本例中,我编写了一个 I/O 密集型函数,该函数每次从源中读取 8 个字节,然后解码获得 1 个字节写入目标流中。较好的实现是一次处理多于 8 个字节的缓冲区。更好的实现还可以通过缓冲区输出字节,进而减少目标流中单字节的写入次数。

/* mmdecode.c - 喵呜喵呜流式编解码器 */
...
int stupid_decode(FILE *src, FILE *dst)
{
  char           buf[9];
  decoded_byte_t byte;
  int            i;
    
  while (!feof(src)) {
    if (!fgets(buf, sizeof(buf), src))
      break;
    byte.field.f0 = isupper(buf[0]);
    byte.field.f1 = isupper(buf[1]);
    byte.field.f2 = isupper(buf[2]);
    byte.field.f3 = isupper(buf[3]);
    byte.field.f4 = isupper(buf[4]);
    byte.field.f5 = isupper(buf[5]);
    byte.field.f6 = isupper(buf[6]);
    byte.field.f7 = isupper(buf[7]);
      
    fputc(byte.value, dst);
  }
  return 0;
}

我并没有使用编码器中使用的位移方法,而是创建了一个名为 decoded_byte_t 的自定义数据结构。

/* mmdecode.c - 喵呜喵呜流式编解码器 */
...

typedef struct {
  unsigned char f7:1;
  unsigned char f6:1;
  unsigned char f5:1;
  unsigned char f4:1;
  unsigned char f3:1;
  unsigned char f2:1;
  unsigned char f1:1;
  unsigned char f0:1;
} fields_t;
  
typedef union {
  fields_t      field;
  unsigned char value;
} decoded_byte_t;

初次看到代码时可能会感到有点儿复杂,但不要放弃。decoded_byte_t 被定义为 fields_t 和 unsigned char 的 联合。可以将联合中的命名成员看作同一内存区域的别名。在这种情况下,value 和 field 指向相同的 8 位内存区域。将 field.f0 设置为 1 也将会设置 value 中的最低有效位。

虽然 unsigned char 并不神秘,但是对 fields_t 的类型定义(typedef)也许看起来有些陌生。现代 C 编译器允许程序员在结构体中指定单个位字段的值。字段所在的类型是一个无符号整数类型,并在成员标识符后紧跟一个冒号和一个整数,该整数指定了位字段的长度。

这种数据结构使得按字段名称访问字节中的每个位变得简单,并可以通过联合中的 value 字段访问组合后的值。我们依赖编译器生成正确的移位指令来访问字段,这可以在调试时为你节省不少时间。

最后,因为 stupid_decode() 函数一次仅从源 FILE 流中读取 8 个字节,所以它效率并不高。通常我们尝试最小化读写次数,以提高性能和降低调用系统调用的开销。请记住:少量的读取/写入大的块比大量的读取/写入小的块好得多。

总结

用 C 语言编写一个多文件程序需要程序员要比只是是一个 main.c 做更多的规划。但是当你添加功能或者重构时,只需要多花费一点儿努力便可以节省大量时间以及避免让你头痛的问题。

回顾一下,我更喜欢这样做:多个文件,每个文件仅有简单功能;通过头文件公开那些文件中的小部分功能;把数字常量和字符串常量保存在头文件中;使用 Makefile 而不是 Bash 脚本来自动化处理事务;使用 main() 函数来处理命令行参数解析并作为程序主要功能的框架。

我知道我只是蜻蜓点水般介绍了这个简单的程序,并且我很高兴知道哪些事情对你有所帮助,以及哪些主题需要详细的解释。请在评论中分享你的想法,让我知道。


via: https://opensource.com/article/19/7/structure-multi-file-c-part-2

作者:Erik O'Shaughnessy 选题:lujun9972 译者:萌新阿岩 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出