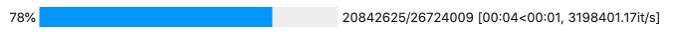分类 技术 下的文章

想学习 Git?看看这个最重要的术语和命令的快速总结。

 title=

如今,对于任何希望跟踪他们的变化的人来说,版本控制是一个重要的工具。它对程序员、系统管理员和 网站可靠性工程师 site reliability engineers (SRE)都特别有用。确保可以从错误中恢复到已知的良好状态是一个巨大的胜利,比以前给复制的文件添加 .old 后缀的策略更友好。

但学习 Git 这件事往往被告诉大家“投身开源”的好心同行们过度简化了。在你还不明白之前,就有人要你给一个从 上游 upstream 变基 rebase 的 拉取请求 pull request (PR)或 合并请求 merge request (MR),然后他们才能从你的 远程版本库 remote 合并 —— 而且一定会删除 合并提交 merge commits 。无论你想给开源项目做出什么好的贡献,当你看到这些你不认识的单词时,都会觉得难以融入。
 title=

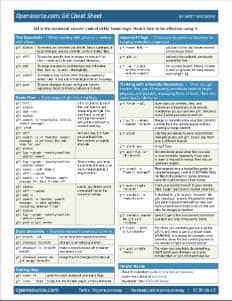
  • 下载 我们的 Git 速查表。

如果你有一两个月的时间和足够的好奇心,Git SCM 是你需要学习所有术语的权威来源。但如果你正在寻找来自实践的总结,请继续阅读。

提交就是提醒

对我来说,Git 最难理解的部分是 Git 最简单的概念:一个 提交 commit 就是一个内容的集合,包括一个关于描述的信息,以及之前的提交。没有固有的代码发布策略,甚至没有内置的明确建议。这个内容甚至不一定是代码 —— 可以是任何你想添加到版本库的东西。 提交消息 commit message 会对这些内容进行注释。

我喜欢把提交信息看作是给未来的自己的礼物:它可能会提到你编辑的文件,但更重要的是它提醒你修改这些文件的意图。添加更多关于你为什么编辑这些内容的信息,可以帮助任何使用你的版本库的人,即使那个人是你。

origin/master 在哪里?

要知道自己在 Git 项目中的位置,首先把它想成一棵树。所有 Git 项目都有一个根目录,类似于文件系统的根目录。所有的提交都是这个根目录下的分支。这样一来,分支只是一个提交的指针。按照惯例,master 是根目录下默认的分支名称。(LCTT 译注:世界变得快,原文发表于 2019 年,而现在有些地方开始用 main 替代这个名字。)

由于 Git 是一个分布式的版本控制系统,同一个代码库分布在多个地方,所以人们经常用 版本库 repository 这个词来表示同一个项目的所有副本。(LCTT 译注:“repository” 英文原意是仓库、存储库,在计算机环境中,常用于版本控制、软件分发等方面,有时候会统一译作“仓库”、“存储库”。但我们认为,应该根据不同语境采用更有指向性的译法。在 Git 等版本控制语境中,采用“版本库”;在软件分发方面,采用“软件库”;其它泛指或不确定的语境中,可采用“仓库”、“存储库”译法。)有 本地版本库 local repository ,这是你编辑代码的地方(稍后会有更多的介绍),还有 远程版本库 remote repository ,这是你完成后想把代码发送到的地方。远程版本库可以在任何地方,甚至在你的本地版本库所在的同一台计算机上,但它们通常托管在 GitLab 或 GitHub 等版本库服务上。

我在哪里?

虽然不是官方的卖点,但迷路也是 Git 仓库的“乐趣”之一。你可以通过这套可靠的命令来找到自己的方向:

  • git branch —— 找到你所在的分支。
  • git log —— 查看你正在进行的提交。
  • git status —— 查看自上次提交以来你所做的编辑。
  • git remote —— 查看你正在跟踪的远程仓库。

用这些命令来定位自己的方向,当你被卡住的时候,会让你有一种方向感。

我是否已将我的提交暂存或缓存起来?

你电脑上的代码俗称为你的 工作空间 workspace 。但不是很明显的是,当你在 Git 仓库中时,你还有两个(是的,两个!)其他位置: 索引 index 和 暂存 stash 。当你写了一些内容,然后添加时,你是把它添加到索引中,也就是准备提交的缓存内容。有的时候,你的索引中的文件还没有准备好提交,但你想查看另一个分支。这时,暂存就派上用场了。你可以使用 git stash 将索引了但尚未提交的文件存储到暂存区中。当你准备好取回文件时,运行 git stash pop 将更改带回索引中。

下面是一些你需要使用暂存区和缓存区的命令:

  • git diff ...origin/master —— 显示最近的本地提交和远程的 origin 版本库的 master 分支之间的差异。
  • git diff --cached —— 显示最近的本地提交与添加到本地索引的内容之间的任何差异。
  • git stash —— 将索引的(已添加但未提交的)文件放在暂存区堆栈中。
  • git stash list —— 显示暂存区堆栈中的变化。
  • git stash pop —— 将最近的变化从暂存库中删除。

无头骑士

Git 里面有各种比喻。当我想到 HEAD 是哪里的时候,我就会想到火车线路。如果你最终处于 脱离的 HEAD detached HEAD 模式,就意味着你已经脱离了这个隐喻的轨道。

HEAD 是指向当前签出分支中最近一次提交的指针。默认的“签出checkout”是指当你创建一个 Git 仓库并进入到 master 分支的时候。每次创建或修改到另一个分支时,你都会切换到该分支行。如果你在当前分支的某处进行 git checkout <commit>,HEAD 就会移动到该提交。如果没有提交历史记录将你的当前提交连接到已签出的提交,那么你将处于脱离的 HEAD 状态。如果你找不到 HEAD 的位置,你可以随时用 git reset --hard origin/master 来删除修改,回到已知状态。警告:这将删除你上次推送到 master 后的任何改动。

你是上游还是下游?

你的项目的本地副本被认为是你的本地版本库,它可能有也可能没有远程版本库 —— 远程版本库的副本是用于协作或保存的。也可能还有一个 上游 upstream 版本库,在那里,项目的第三个副本由不同的贡献者托管和维护。

例如,假设我想为 Kubernetes 做贡献。我会首先将 kubernetes/kubernetes 项目 复刻 fork 到我的账户下 mbbroberg/kubernetes。然后我会将我的项目克隆到我的本地工作区。在这种情况下,我的本地克隆是我的本地仓库,mbbroberg/kubernetes 是我的远程仓库,kubernetes/kubernetes 是上游。

合并的隐喻

当你深入 Git 分支时,根系统的视觉效果就会和火车轨道的形象合二为一。分支通常被用作开发一个新功能的方式,最终你想把它 合并 merge 到主分支中。当这样做时,Git 会按顺序保留共同的提交历史,然后将你的分支的新提交追加到历史中。这个过程有一大堆的细节:是否 变基 rebase ,是否添加一个 合并提交 merge commit ,Brent Laster 在《如何在 Git 中重置、恢复和返回之前的状态》中会有更详细的探讨。

我想现在就去 Git

要掌握 Git 命令的世界,有大量的术语和需要探索的地方。我希望这篇关于日常使用术语的第一人称探索能帮助你适应这一切。如果你觉得自己被卡住了或者遇到了挫折,欢迎在 Twitter @mbbroberg 上联系我。

回顾

  • 提交 Commit —— 将当前索引的内容保存在一个新的提交中,并附上用户描述更改的日志信息。
  • 分支 Branch —— 指向一个提交的指针。
  • master —— 第一个分支的默认名称。
  • HEAD —— 指向当前分支上最近一次提交的指针。
  • 合并 Merge —— 合并两个或多个提交的历史。
  • 工作空间 Workspace —— Git 仓库本地副本的通俗名称。
  • 工作树 Working tree —— 工作区中的当前分支;任何时候你都可以在 git status 的输出中看到这个。
  • 缓存 Cache —— 用于临时存储未提交的变更的空间。
  • 索引 Index —— 变更提交前存储其变化的缓存。
  • 跟踪和未跟踪的文件 —— 没有被索引缓存的文件或尚未加入其中的文件。
  • 暂存 Stash —— 另一个缓存,作为一个堆栈,在这里可以存储更改而不需要提交它们。
  • origin —— 远程版本库的默认名称。
  • 本地仓库 Local repository —— 也就是你在工作站上保存 Git 仓库副本的地方。
  • 远程存储库 Remote repository —— Git 存储库的第二副本,你可以在这里推送变更以便协作或备份。
  • 上游存储库 Upstream repository —— 你跟踪的远程存储库的通俗说法。
  • 拉取请求 Pull request —— 这是 GitHub 的专用术语,用于让其他人知道你推送到仓库分支的变化。
  • 合并请求 Merge request —— 这是 GitLab 的专用术语,用于让其他人知道你推送到仓库分支的变化。
  • origin/master —— 远程版本库及其主要分支的默认名称。

后记:双关语是 Git 最好的部分之一,愿你喜欢。


via: https://opensource.com/article/19/2/git-terminology

作者:Matthew Broberg 选题:lujun9972 译者:wxy 校对:wxy
本文由 LCTT 原创编译,Linux中国 荣誉推出

Sed 缺少通常的文本框,而是按照用户的命令直接写入到文件上。

sed 命令是为 AT&T 最初的 Unix 操作系统第 7 版创建的,此后,可能每一个 Unix 和 Linux 操作系统都包含了它。sed 应用程序是一个 流编辑器,与文本编辑器不同的是,它不会打开一个视觉缓冲区,将文件的数据加载到其中进行处理。相反,它根据在终端输入的命令或脚本中的一系列命令,逐行对文件进行操作。

安装

如果你使用的是 Linux、BSD 或 macOS,那么你已经安装了 GNU 或 BSD 版的 sed。这是两个不同的原始 sed 命令的重新实现,虽然它们很相似,但也有一些小的区别。GNU sed 通常被认为是功能最丰富的 sed,而且它在这些平台上都可以广泛使用。

如果你找不到 GNU sed(在非 Linux 系统上通常被称为 gsed),那么你可以从 GNU 网站上下载它的源代码。安装 GNU sed 的好处是,可以使用它的额外功能,但它也可以被限制为只符合 sed 的 POSIX 规范,如果你需要移植性的话。

在 Windows 上,你可以用 Chocolatey 来安装 GNU sed。

Sed 如何工作

sed 应用程序一次只处理一行。因为它没有视觉显示,所以它在内存中创建了一个模式空间:一个包含输入流的当前行的空间(去掉任何尾部的换行符)。一旦填充了模式空间,你对 sed 的指令就会被执行。有时你的指令是有条件的,有时是无条件的,所以这些指令的结果取决于你如何使用 sed。

当命令结束时,sed 会将模式空间的内容打印到输出流中。默认的输出流是标准输出,但可以将其重定向到一个文件,甚至使用 --in-place=.bak 选项重定向到同一个文件中。

然后再从下一个输入行开始循环。

sed命令的语法是:

$ sed --options [optional SCRIPT] [INPUT FILE or STREAM]

找到你要编辑的内容

在可视化编辑器中,你通常不需要考虑太多,就能在文本文件中找到你想要修改的内容。你的眼睛(或屏幕阅读器)会扫描文本,找到你想改变的单词或你想插入或删除文本的地方,然后你就可以开始输入了。而 sed 没有交互模式,所以你需要告诉它必须满足什么条件才能运行特定的命令。

在这些例子中,假设一个名为 example.txt 的文件包含了这样的文字:

hello
world
This is line three.
Here is the final line.

行号

指定行号告诉 sed 只对文件中的那一行进行操作。

例如,下面这条命令选择文件的第 1 行并打印出来。因为 sed 在处理后的默认操作也是打印一行到标准输出,这样做的效果就是重复第一行:

$ sed '1p' example.txt
hello
hello
world
This is line three.
Here is the final line.

你也可以步进式指定行号。例如,1~2 表示每两行选择一行(“从第一行开始每两行选择一行”)。指令 1~3 表示从第一行开始,每三行选择一行:

$ sed '1p' example.txt
hello
hello
world
This is line three.
Here is the final line.

行定位

你可以通过使用 $ 作为选择器,只对文件的最后一行进行操作:

$ sed '$p' example.txt
hello
world
This is line three.
Here is the final line.

在 GNU sed 中,你可以选择多行(例如,sed '1,$p' 打印第一行和最后一行)。

反转

任何数字或位置的选择,你都可以用感叹号(!)字符反转。下面这将选择除第一行以外的所有行:

$ sed '1!p' example.txt
hello
world
world
This is line three.
This is line three.
Here is the final line.

模式匹配

你可以把模式匹配想象成文字处理器或浏览器中的查找操作。你提供一个词(一个 模式),然后选择了结果。模式匹配的语法是 /pattern/:

$ sed '/hello/p' example.txt
hello
hello
world
This is line three.
Here is the final line.
$ sed '/line/p' example.txt
hello
world
This is line three.
This is line three.
Here is the final line.

用 Sed 编辑

一旦你找到了你要编辑的内容,你就可以执行你想要的任何操作。你可以用 sed 中的命令来执行编辑。sed 中的命令不是 sed 命令本身。如果这样说有帮助的话,可以把它们看作是“动作”或“动词”或“指令”。

sed 中的命令是单个字母,例如前面例子中使用的打印命令的 p。它们一开始可能很难记忆,但和所有事情一样,你会随着练习而了解它们。

p 代表打印

p 指令打印当前模式空间中的任何内容。

d 用于删除

d 指令删除模式空间:

$ sed '$d' example.txt
hello
world
This is line three.
$ sed '1d' example.txt
world
This is line three.
Here is the final line.

s 用于搜索和替换

s 命令搜索一个模式并将其替换为其他东西。这可能是 sed 最流行和最随意的用法,而且它通常是用户学习的第一个(有时也是唯一的)sed 命令。几乎可以肯定它是文本编辑中最有用的命令:

$ sed 's/world/opensource.com/' example.txt
hello
opensource.com
This is line three.
Here is the final line.

在你的替换文本中,也可以使用一些特殊的功能。例如,\L 将替换文本转换为小写,\l 则只转换下一个字符。还有其他一些功能,列在 sed 文档中(你可以用 info sed 命令查看)。

替换子句中的特殊字符 & 指的是匹配到的模式:

$ sed 's/is/\U&/' example.txt
hello
world
ThIS is line three.
Here IS the final line.

你也可以通过特殊的标志来影响 s 如何处理它找到的内容。g(应该是指 全局)标志告诉 s 对行上找到的所有匹配项进行替换,而不仅仅是第一个匹配项:

$ sed 's/is/\U&/g' example.txt
hello
world
ThIS IS line three.
Here IS the final line.

其他重要的标志还包括用一个数字来表示要影响第几个出现的匹配模式:

$ sed 's/is/\U&/2' example.txt
hello
world
This IS line three.
Here is the final line.

w 标志,后面跟着一个文件名,\_只有\_在有变化的情况下,才会将匹配的行写入文件:

$ sed 's/is/\U&/w sed.log' example.txt
hello
world
ThIS is line three.
Here IS the final line.
$ cat sed.log
ThIS is line three.
Here IS the final line.

标志可以组合:

$ sed 's/is/\U&/2w sed.log' example.txt
hello
world
This IS line three.
Here is the final line.
$ cat sed.log
This IS line three.

脚本

有很多很棒的网站都有 sed “单行脚本”,它们给你提供了面向任务的 sed 命令来解决常见的问题。然而,自己学习 sed 可以让你写出自己的单行脚本,而且这些单行脚本可以根据你的具体需求来定制。

sed 的脚本可以在终端中写成一行,也可以保存到文件中,然后用 sed 本身执行。我倾向于把小脚本写成一个命令,因为我发现自己在现实生活中很少重复使用 sed 命令。当我写一个 sed 脚本时,通常都是针对一个文件的。例如,在写完这篇文章的初稿后,我用 sed 来规范 “sed” 的大小写,而这是我可能永远也不会再做的任务。

你可以向 sed 发出一系列不同的命令,用分号(;)分开。

$ sed '3t ; s/line/\U&/' example.txt
hello
world
This is LINE three.
This is the final line.

带括号的范围改变

你也可以用大括号({})限制哪些结果受到影响。当你将 sed 命令用大括号括起来时,它们只适用于特定的选择。例如,“line” 字出现在样本文本的两行中。你可以通过声明所需的匹配条件($ 表示最后一行),并将你希望执行的 s 命令放在紧随其后的括号中,强制 sed 只影响最后一行:

$ sed '$ {s/line/\U&/}' example.txt
hello
world
This is line three.
This is the final LINE.

学习 Sed

你可以用 sed 做的事情比本文所解释的多得多。我甚至还没有涉及到分支(b)、测试(t)、保留空格(H)和许多其他功能。就像 ed 一样,sed 可能不是你要用来创建文档的文本编辑器,甚至不是你需要做的每一个脚本任务中使用的文本编辑器,但它是你作为 POSIX 用户的一个强大的选择。学习 sed 命令的结构以及如何编写简短的脚本可以快速修改大量的文本。阅读 GNU sed 的info 页面,或者 BSD sed 的手册页,看看 sed 能为你做什么。


via: https://opensource.com/article/20/12/sed

作者:Seth Kenlon 选题:lujun9972 译者:wxy 校对:wxy
本文由 LCTT 原创编译,Linux中国 荣誉推出

如果你的程序需要一段时间才能显示结果,可通过显示它的进度来避免让用户感到沮丧。

阿拉米语,希伯来语和阿拉伯语中的闪米特语根 q-d-m 通常与前进或进度有关。阿拉伯语 taqaddum (تقدّم)的意思是“进度”。进度是很重要的。正如每部感觉良好的电影都会告诉你,旅程和目的地同样重要。

大多数程序都有一个明确的目标,一个期望的最终状态。有时,计算这个最终状态可能需要很长的时间。虽然计算机没有感情不在乎,但人却在乎。人类并不乐意坐在原地等待,而看不到任何明显的进展迹象。疑问不断蔓延。程序崩溃了吗?磁盘性能是否抖动?操作系统是否把所有的计算资源都分配给了其他任务?

就像正义一样,进度必须被看到,而不仅仅是完成。Python 库 tqdm 有助于使进度变得明确。

tqdm 模块可在控制台下工作,但它也专门支持了我最喜欢的环境之一 Jupyter。要在 Jupyter 中使用 tqdm,你需要导入 notebook 子模块并安装 ipywidgets。notebook 子模块与 tqdm 接口兼容。

这意味着你可以做一些导入时操作来导入正确的模块,同时保持 tqdm 的用法不变。诀窍是检查 __main__ 模块是否具有全局变量 get_ipython。虽然这只是一个启发式的方法,但却是一个相当准确的方法:

import sys
if hasattr(sys.modules["__main__"], "get_ipython"):
    from tqdm import notebook as tqdm
else:
    import tqdm

最简单的情况是,某件事情需要运行一定的迭代次数(事先已知),而每一次迭代的时间都差不多。例如,有一个计算任何数字的平方根的算法,通过从 1 作为猜测值开始,然后计算出一个改进后的猜测值:

def improve_guess(rt, n):
    return (rt + n/rt) / 2

一点点的改进可以让你更加接近该平方根。例如,你可以计算 2 的平方根:

guess = 1
target = 2
for i in tqdm.trange(10):
    guess = improve_guess(guess, target)

 title=

精确了到小数点后 10 位!

round(2 - guess*guess, 10)
0.0

一个稍微复杂一点的例子是,当元素的数量是已知的,而处理每个元素需要类似的时间。例如,你可以计算一些数字的乘积。为此,你需要一些随机数:

import random
numbers = [random.uniform(0, 2.8) for i in range(100)]
numbers[:5]
[2.6575636572230916,
0.1286674965830302,
1.0634250104041332,
1.1760969844376505,
0.45192978568125486]

现在有了这些数字,可以将它们相乘了。使用 tqdm 最简单的方法是包装一个 Python 迭代函数。数值是一样的,但是 tqdm 会显示一个进度条:

result = 1
for num in tqdm.tqdm(numbers):
    result *= num
result
2.4081854901728303

 title=

然而,并不是所有的事情都可以预测。最不容易预测的事情之一就是网络速度。当你下载一个大文件时,衡量进度的唯一方法就是检查已经下载了多少:

url = "https://www.python.org/ftp/python/3.9.0/Python-3.9.0.tgz"
import httpx
with httpx.stream("GET", url) as response:
    total = int(response.headers["Content-Length"])
    with tqdm.tqdm(total=total) as progress:
        for chunk in response.iter_bytes():
            progress.update(len(chunk))

 title=

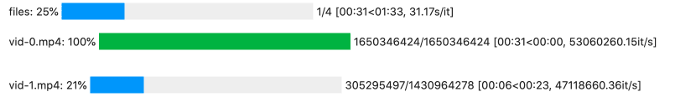
有时,“嵌套”进度条是有意义的。例如,如果你要下载一个目录,你就需要一个进度条来跟踪文件,并为每个文件设置一个进度条。

下面是一个例子(但没有实际下载一个目录):

files = [f"vid-{i}.mp4" for i in range(4)]
for fname in tqdm.tqdm(files, desc="files"):
    total = random.randrange(10**9, 2 * 10**9)
    with tqdm.tqdm(total=total, desc=fname) as progress:
        current = 0
        while current &lt; total:
            chunk_size = min(random.randrange(10**3, 10**5), total - current)
            current += chunk_size
            if random.uniform(0, 1) &lt; 0.01:
                time.sleep(0.1)
            progress.update(chunk_size)

 title=

所以,如果你的程序需要一段时间才能显示最终结果,为避免让你的用户感到沮丧。请显示它的进度!


via: https://opensource.com/article/20/12/tqdm-python

作者:Moshe Zadka 选题:lujun9972 译者:geekpi 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

Loki 扩展了 Prometheus 用于度量监测和日志聚合的模型。

Loki 是一个 Apache 2.0 许可的开源日志聚合框架,由 Grafana 实验室设计,并在不断发展的社区的巨大支持之下建立。它也是我每天为之努力的项目。在这篇文章中,我将不只是谈论 Loki 如何工作,而是提供一个实际操作的介绍,以解决实际问题。

问题:一个持久的集中式 Shell 历史记录

我喜欢我的 shell 历史,一直是 CTRL+R 的狂热用户。大约一年前,我的终端生活发生了翻天覆地的变化,我的同行 Dieter Plaetinck 向我介绍了命令行模糊查找器 fzf。

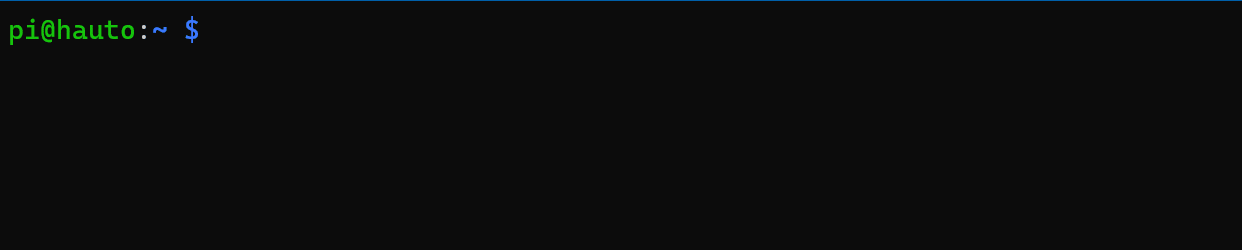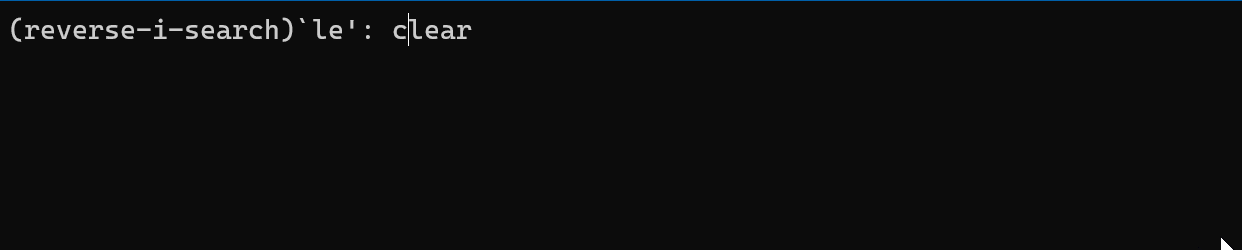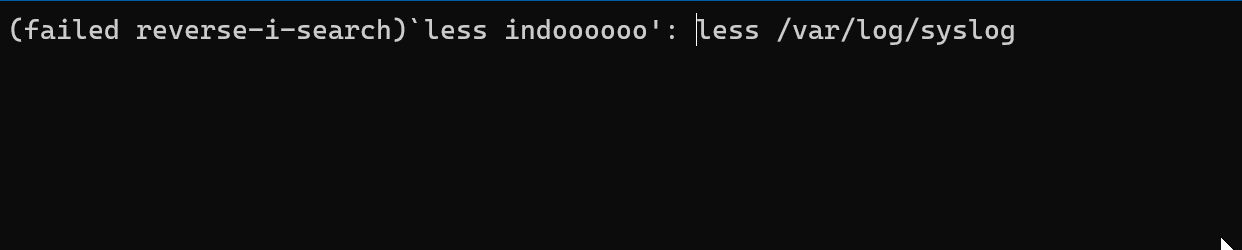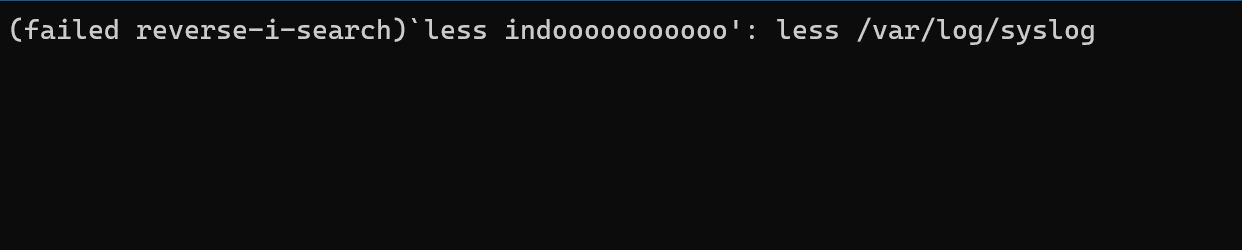
突然间,在命令中搜索就从这样:

 title=

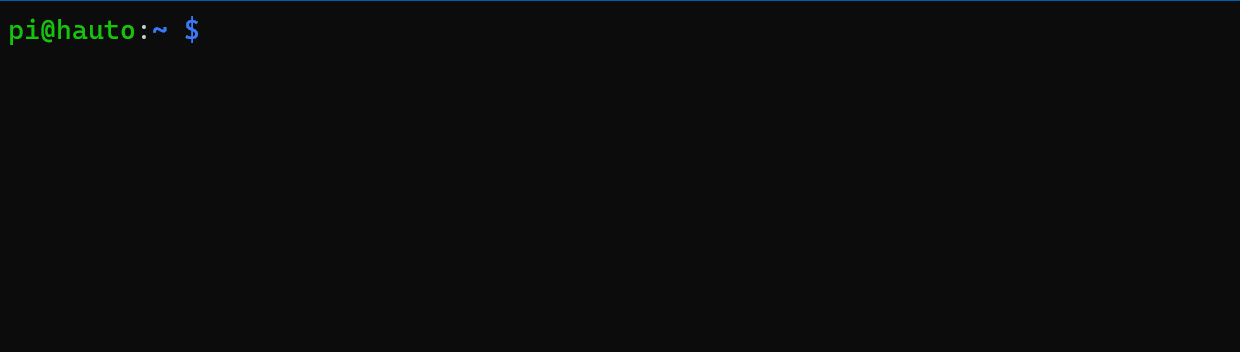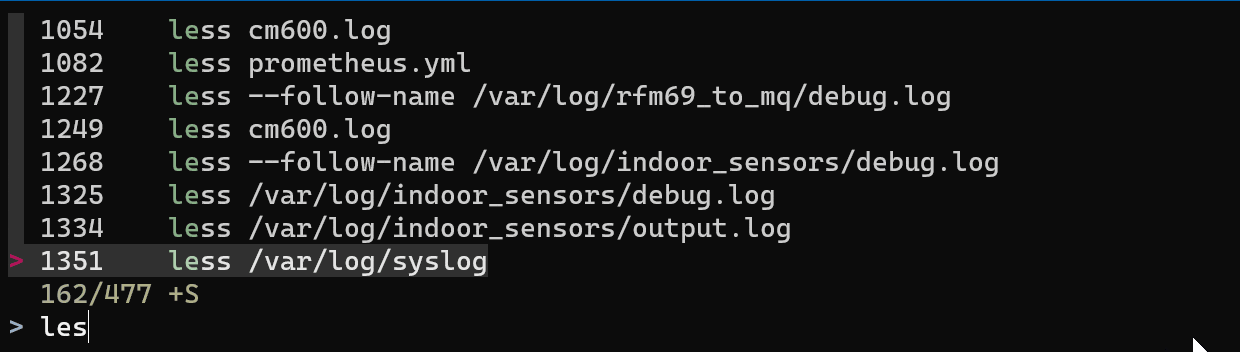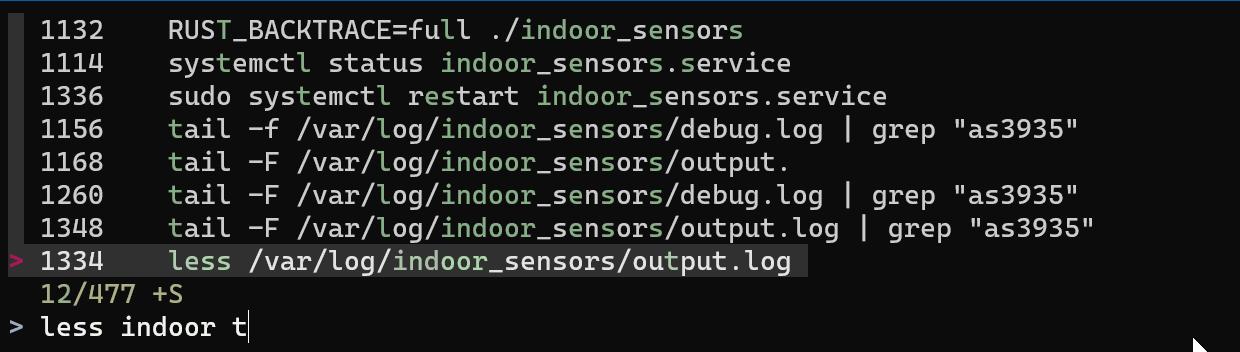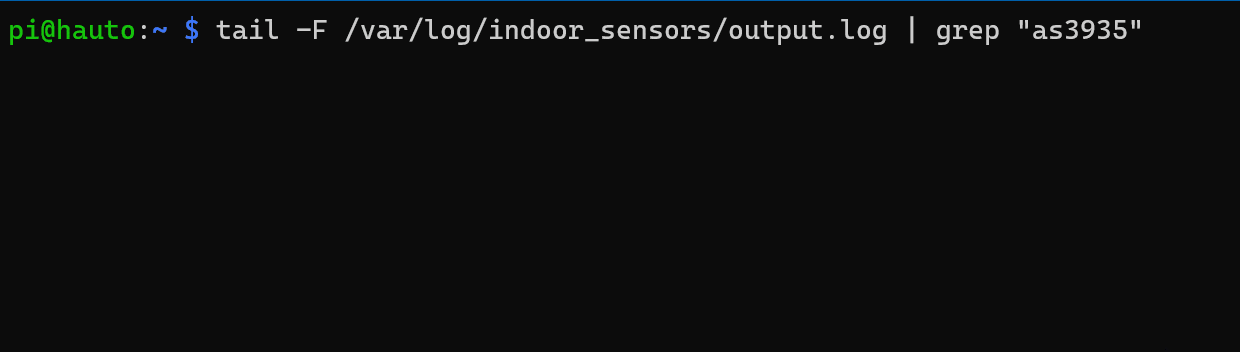
变成了这样:

 title=

虽然 fzf 极大地提高了我的生活质量,但围绕着我的 shell 历史记录,还是缺少了一些片段:

  • 终端突然关闭、电脑崩溃、死机、整盘加密密钥被遗忘等情况下会丢失 shell 历史记录。
  • 想从我的所有电脑上访问我的 shell 历史记录。

我认为我的 shell 历史记录是文件:它是一个重要的故事,我不想失去。将 Loki 与我的 shell 历史结合起来,有助于解决这些问题和更多问题。

关于 Loki

Loki 采用了开源 Prometheus 项目用于度量的直观的标签模型,并将其扩展到日志聚合的世界。这使得开发人员和运维人员能够使用相同的标签集在他们的度量和日志之间无缝切换。即使你没有使用 Prometheus,也有很多理由说明 Loki 可能很适合你的日志存储需求:

  • 低开销: Loki 不做全文日志索引;它只创建你放在日志上的标签的索引。保持小的索引大大降低了 Loki 的运维要求。我在 树莓派 上运行我的 loki-shell 项目,该项目使用 Loki 来存储 shell 历史记录,只使用了 50MB 多一点的内存。
  • *成本低:**日志内容被压缩并存储在对象存储中,如 Amazon S3、Google 云存储、Azure Blob,甚至可以直接存储在文件系统中。我们的目标是使用价格低廉且持久的存储。
  • 灵活性: Loki 以单个二进制文件的形式提供,可以直接下载并运行,也可以作为 Docker 镜像在任何容器环境中运行。在 Kubernetes 中可以用一个 Helm 海图 快速上手。如果你对日志工具的要求很高,可以看看运行在 Grafana 实验室的 生产环境。它使用开源的 Jsonnet 和 Tanka 部署了同样的 Loki 镜像作为离散的构件,以实现大规模的水平扩展、高可用性、复制、读写路径的分别扩展、高度可并行的查询等。

总而言之,Loki 的方法是保留一个关于你的日志元数据的小索引(标签),并将未索引的、压缩的日志内容存储在廉价的对象存储中,以使操作更容易和更便宜。该应用程序被构建为单进程运行,并很容易演变成一个高可用的分布式系统。你可以通过并行化和查询的分片,在较大的日志工作负载上获得较高的查询性能 —— 有点像为你的日志设计的 MapReduce。

此外,这个功能是任何人都可以免费使用的。与其 Grafana 开放观测性平台一样,Grafana 实验室致力于将 Loki 打造成一个任何人都可以使用的全功能、全开放的日志聚合软件。

开始吧

我在树莓派上运行 Loki,并将我的 shell 历史记录异地存储在 S3 bucket 中。

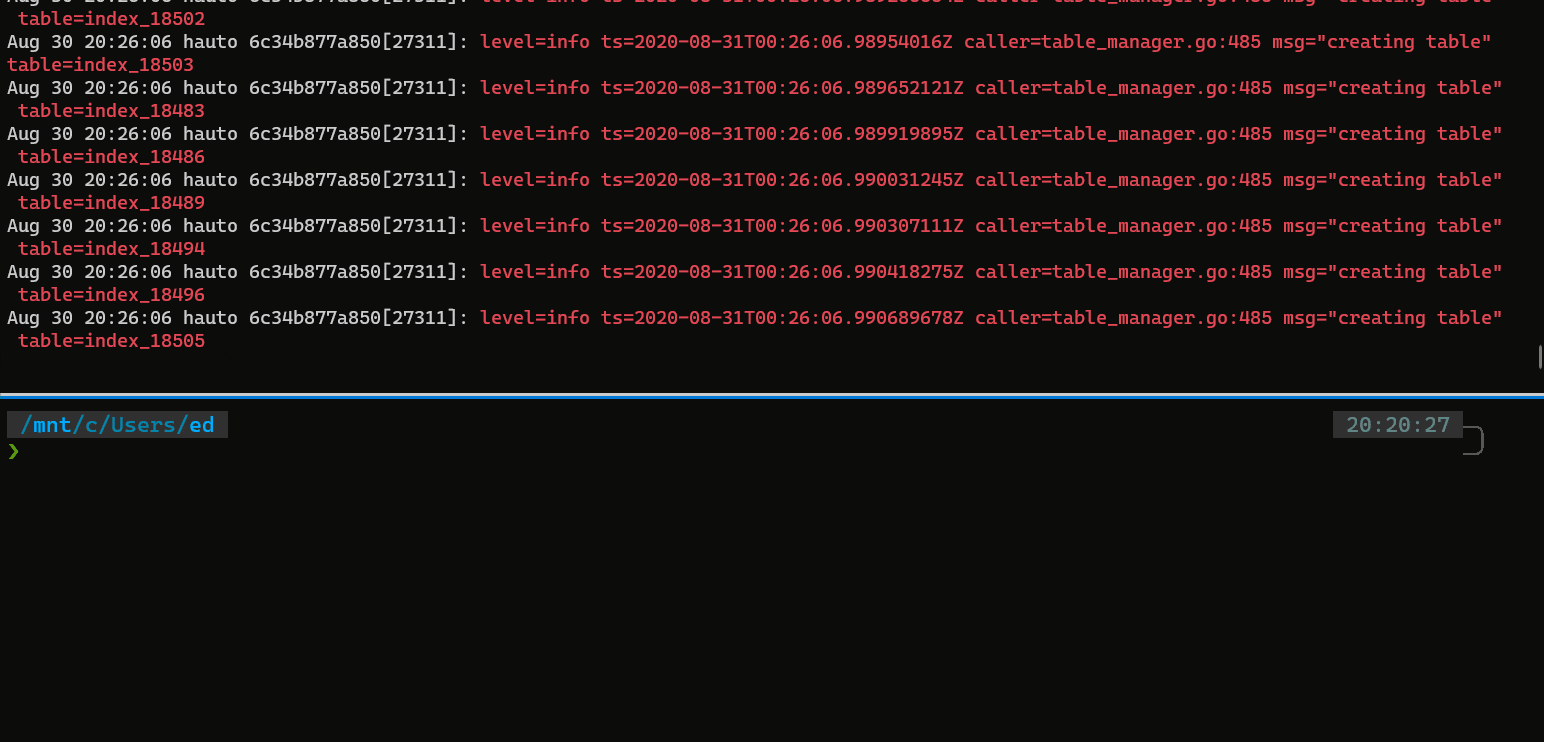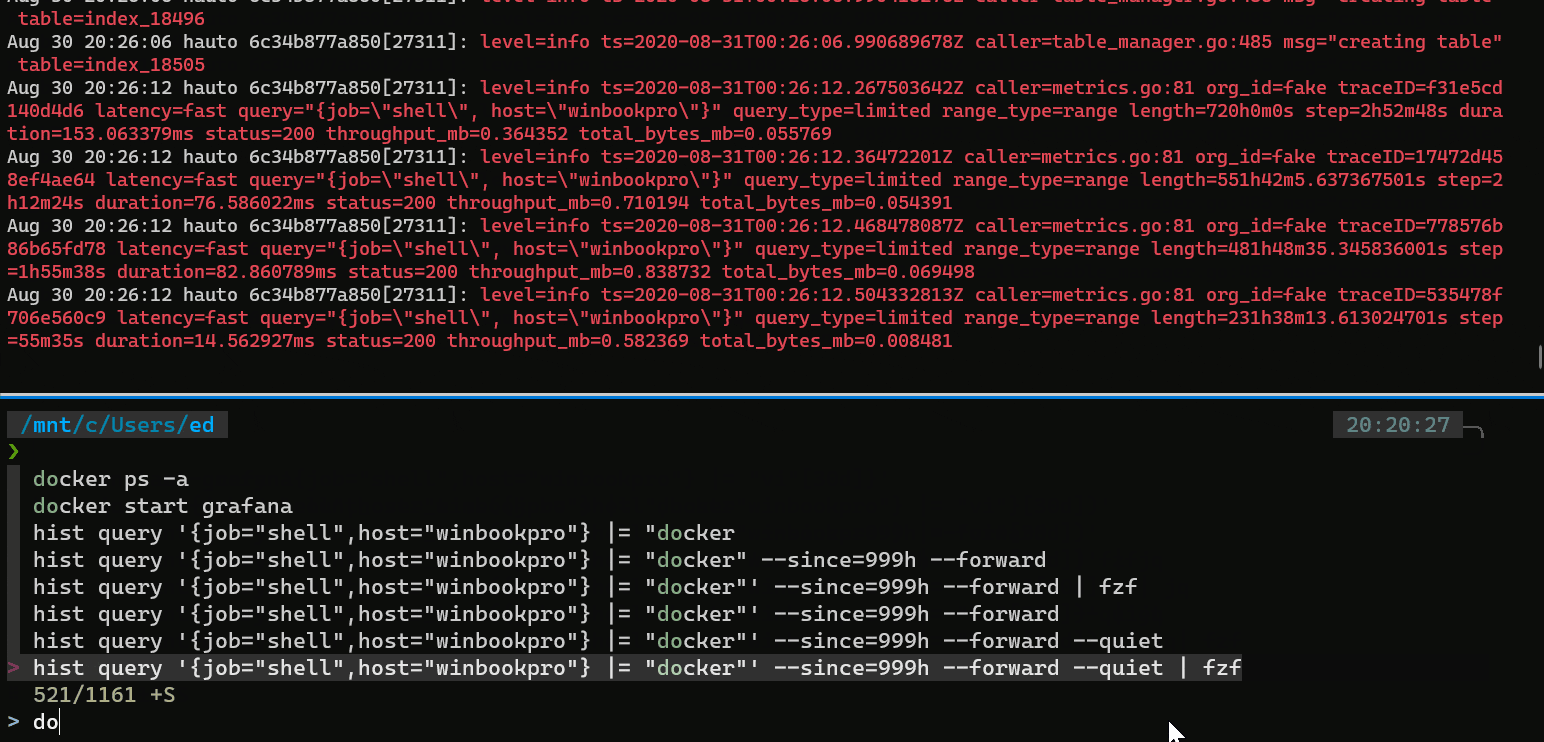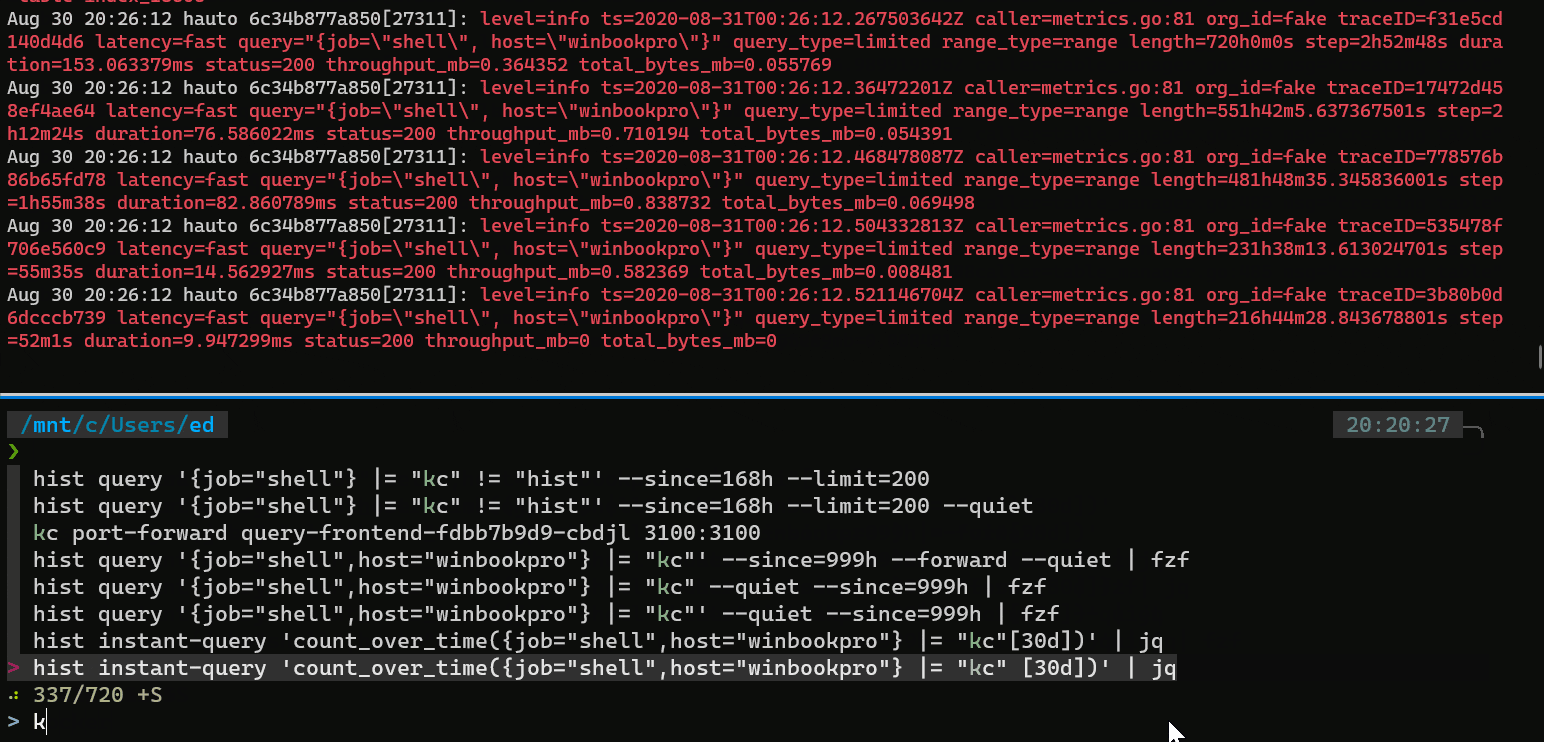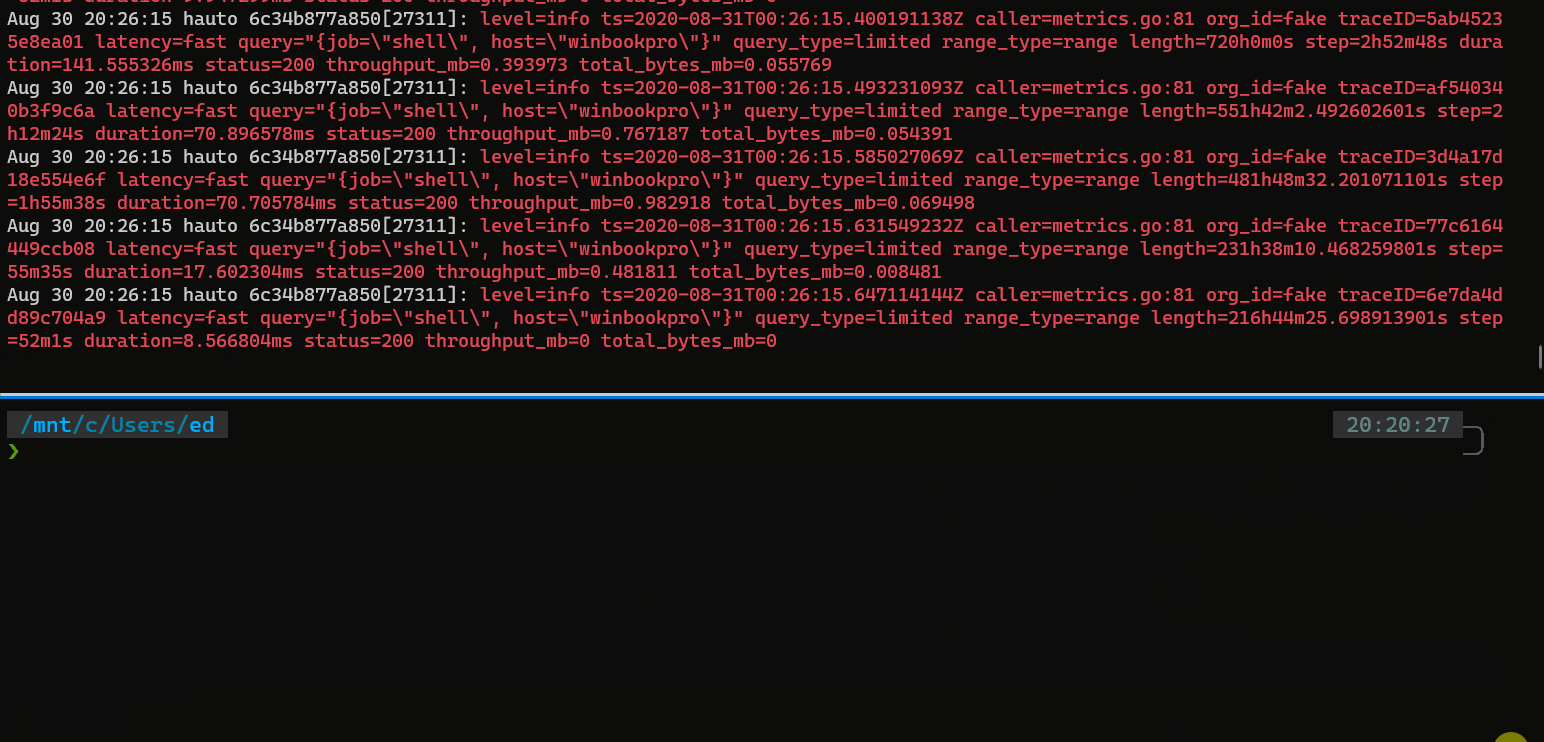
当我按下 CTRL+R,Loki 的 LogCLI 命令行界面会发起几个批处理请求,传输至 fzf。下面是一个例子,上半部分显示的是树莓派上的 Loki 服务器日志。

 title=

准备试试?下面的指南将帮助你设置和运行 Loki,与你的 shell 历史记录集成。为了让本教程保持简洁,此设置将 Loki 本地运行在你的计算机上,并在文件系统上存储所有文件。

在 loki-shell 的 GitHub 版本库,你可以找到所有这一切,以及如何设置一个更复杂的安装的信息。

请注意,本教程不会改变任何围绕你的历史记录的现有行为,所以 你现有的 shell 历史记录命令和历史记录设置不会被触动。相反,这将用 Bash 中的 $PROMPT_COMMAND 和 Zsh 中的 precmd 复制命令历史记录到 Loki。在 CTRL+R 方面,它重载了 fzf 用来访问 CTRL+R 命令的函数。因此试一试是安全的,如果你觉得不喜欢它,只需按照 GitHub 版本库中的 卸载步骤 来删除所有痕迹。你的 shell 历史记录不会被触及。

第一步:安装 fzf

安装 fzf 有几种方法,但我更喜欢 Git 方法:

git clone --depth 1 https://github.com/junegunn/fzf.git ~/.fzf
~/.fzf/install

对所有的问题提示说 yes。

如果你已经安装了 fzf,确保你已经启用了键绑定(即,确保当你输入 CTRL+R 时,fzf 会弹出)。如果有必要的话,你可以重新运行 fzf 安装过程来启用键绑定。

第二步:安装 loki-shell

和 fzf 一样,loki-shell 也有一个 Git 版本库和安装脚本:

git clone --depth 1 https://github.com/slim-bean/loki-shell.git ~/.loki-shell
~/.loki-shell/install

首先,该脚本创建了 ~/.loki-shell 目录,所有的文件都将保存在该目录下(包括 Loki 数据),接下来,它将下载 Promtail、LogCLI 和 Loki 的二进制文件。

然后它会问:

Do you want to install Loki? ([y]/n)

如果你已经为 Loki-shell 运行了一个集中化的 Loki,你可以回答 n;然而,对于本教程,回答 y 或按回车键。

在本地运行 Loki 有两种方式:作为一个 Docker 镜像或作为一个单一的二进制文件(支持添加为 systemd 服务)。如果可以,我建议使用 Docker,因为我认为它稍微简化了操作,但这两者都可以工作。

使用 Docker 运行

将 Loki 作为 Docker 镜像运行:

[y] to run Loki in Docker, [n] to run Loki as a binary ([y]/n) y
Error: No such object: loki-shell
Error response from daemon: No such container: loki-shell
Error: No such container: loki-shell
54843ff3392f198f5cac51a6a5071036f67842bbc23452de8c3efa392c0c2e1e

如果这是你第一次运行这个安装程序,你可以忽略错误信息。这个脚本将停止和替换运行的 Loki 容器,如果版本不匹配,你可以重新运行此脚本升级 Loki。

就是这样!Loki 现在作为一个 Docker 容器运行了。

Loki 的数据将存储在 ~/.loki-shell/data 中。

由于带着 -restart=unless-stopped 标志运行该镜像,所以它会在系统重启时重启该服务,但如果你运行 docker stop loki-shell 则会保持停止。

(如果你使用的是 Docker,你可以跳到 “Shell 集成”一节。)

以二进制文件运行

在 Linux 系统上运行二进制文件的方法有很多。这个脚本可以安装一个 systemd 服务。如果你没有 systemd,你也可以使用二进制安装:

[y] to run Loki in Docker, [n] to run Loki as a binary ([y]/n) n

Run Loki with systemd? ([y]/n) n

This is as far as this script can take you
You will need to setup an auto-start for Loki
It can be run with this command: /home/username/.loki-shell/bin/loki -config.file=/home/username/.loki-shell/config/loki-binary-config.yaml

脚本会输出你需要用来运行 Loki 的命令,你可以自己设置一个 init 脚本或其他方法来自动启动它。

如果你想的话,你可以直接运行该命令,从你当前的 shell 运行 Loki。

如果你有 systemd,你可以选择让脚本安装 systemd 服务或显示出你自己运行它的命令:

Run Loki with systemd? ([y]/n) y

Installing the systemd service requires root permissions.
[y] to run these commands with sudo [n] to print out the commands and you can run them yourself. ([y]/n) n
sudo cp /home/ed/.loki-shell/config/loki-shell.service /etc/systemd/system/loki-shell.service
sudo systemctl daemon-reload
sudo systemctl enable loki-shell
sudo systemctl start loki-shell
Copy these commands and run them when the script finishes. (press enter to continue)
Shell 集成

无论你如何安装 Loki,你现在应该看到一个提示:

Enter the URL for your Loki server or press enter for default (http://localhost:4100)

如果你已经设置了一个中心化的 Loki,你应在这里输入其 URL。然而,这个演示只是使用了默认的 URL,所以你可以按回车键。

它会输出很多文本来解释添加到你的 ~.bashrc 或 ~.zshrc(或两者)的所有条目。

好了!

Finished. Restart your shell or reload config file.
   source ~/.bashrc  # bash
   source ~/.zshrc   # zsh

第三步:试试吧!

开始使用你的 shell,并使用 CTRL+R 查看你的命令。

打开多个终端窗口,在一个窗口中输入命令,在另一个窗口中输入 CTRL+R,你会看到你的命令立即可用。

另外,请注意,当你在终端之间切换并输入命令时,使用 CTRL+R 可以立即使用它们,但向上箭头的操作在终端之间不受影响。(如果你安装了 Oh My Zsh,情况可能就不一样了,因为它会自动将所有命令追加到历史记录中。)

多次按下 CTRL+R 可以在按时间排序和按相关性排序之间切换。

请注意,此配置将只显示当前主机的查询历史记录,即使你正在从多个主机向 Loki 发送 shell 数据。我认为默认情况下这是最合理的。如果你想改变这种行为,有很多地方可以调整;请参见 loki-shell 版本库了解更多。

它还安装了一个名为 hist 的别名。

alias hist="$HOME/.loki-shell/bin/logcli --addr=$LOKI_URL"

LogCLI 可以用来直接在 Loki 上查询和搜索你的历史,也允许你搜索其他主机。查看 LogCLI 的入门指南,了解更多关于查询的信息。

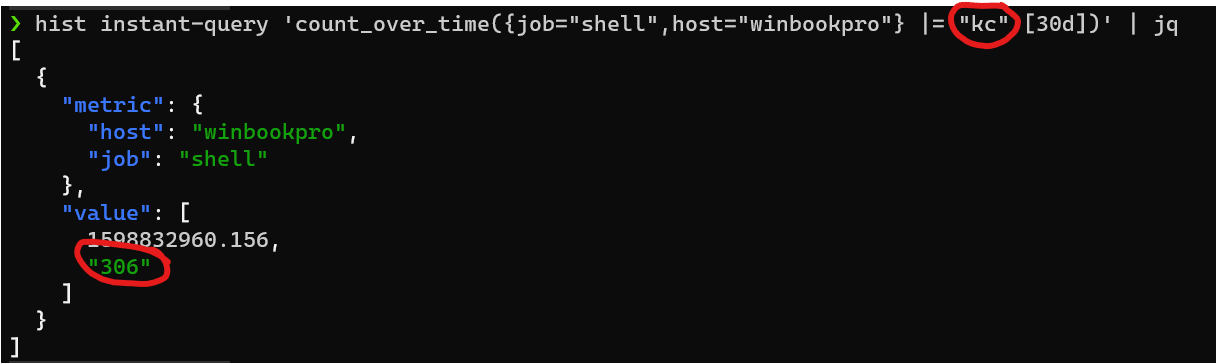
Loki 的日志查询语言(LogQL)提供了度量查询,可以让你做一些有趣的事情,例如,我可以看到在过去 30 天里我发出了多少次 kc 命令(我对 kubectl 的别名)。

 title=

额外增强

安装 Grafana,摆弄一下你的 shell 历史记录。

docker run -d -p 3000:3000 --name=grafana grafana/grafana

打开 Web 浏览器,访问 http://localhost:3000,使用默认的 admin/admin 用户名和密码登录。

在左边,导航到“ 配置 Configuration -> 数据源 Datasources ”,点击“ 添加数据源 Add Datasource ”按钮,然后选择 “Loki”。

对于 URL,你应该可以使用 http://localhost:4100(然而,在我的 WSL2 机器上,我必须使用计算机的实际 IP 地址)。

单击“ 保存并测试 Save and Test ”。你应该看到连接了数据源并找到了标签。

点击左边的“ 管理器 Explore ”图标,确保选择 Loki 数据源,并尝试这个查询:

{job="shell"}

如果发送 shell 命令的主机较多,可以使用“ 主机 Host ”标签将结果限制在某个主机上:

{job="shell", hostname="myhost"}.

你也可以用过滤表达式寻找特定的命令:

{job="shell"} |= "docker"

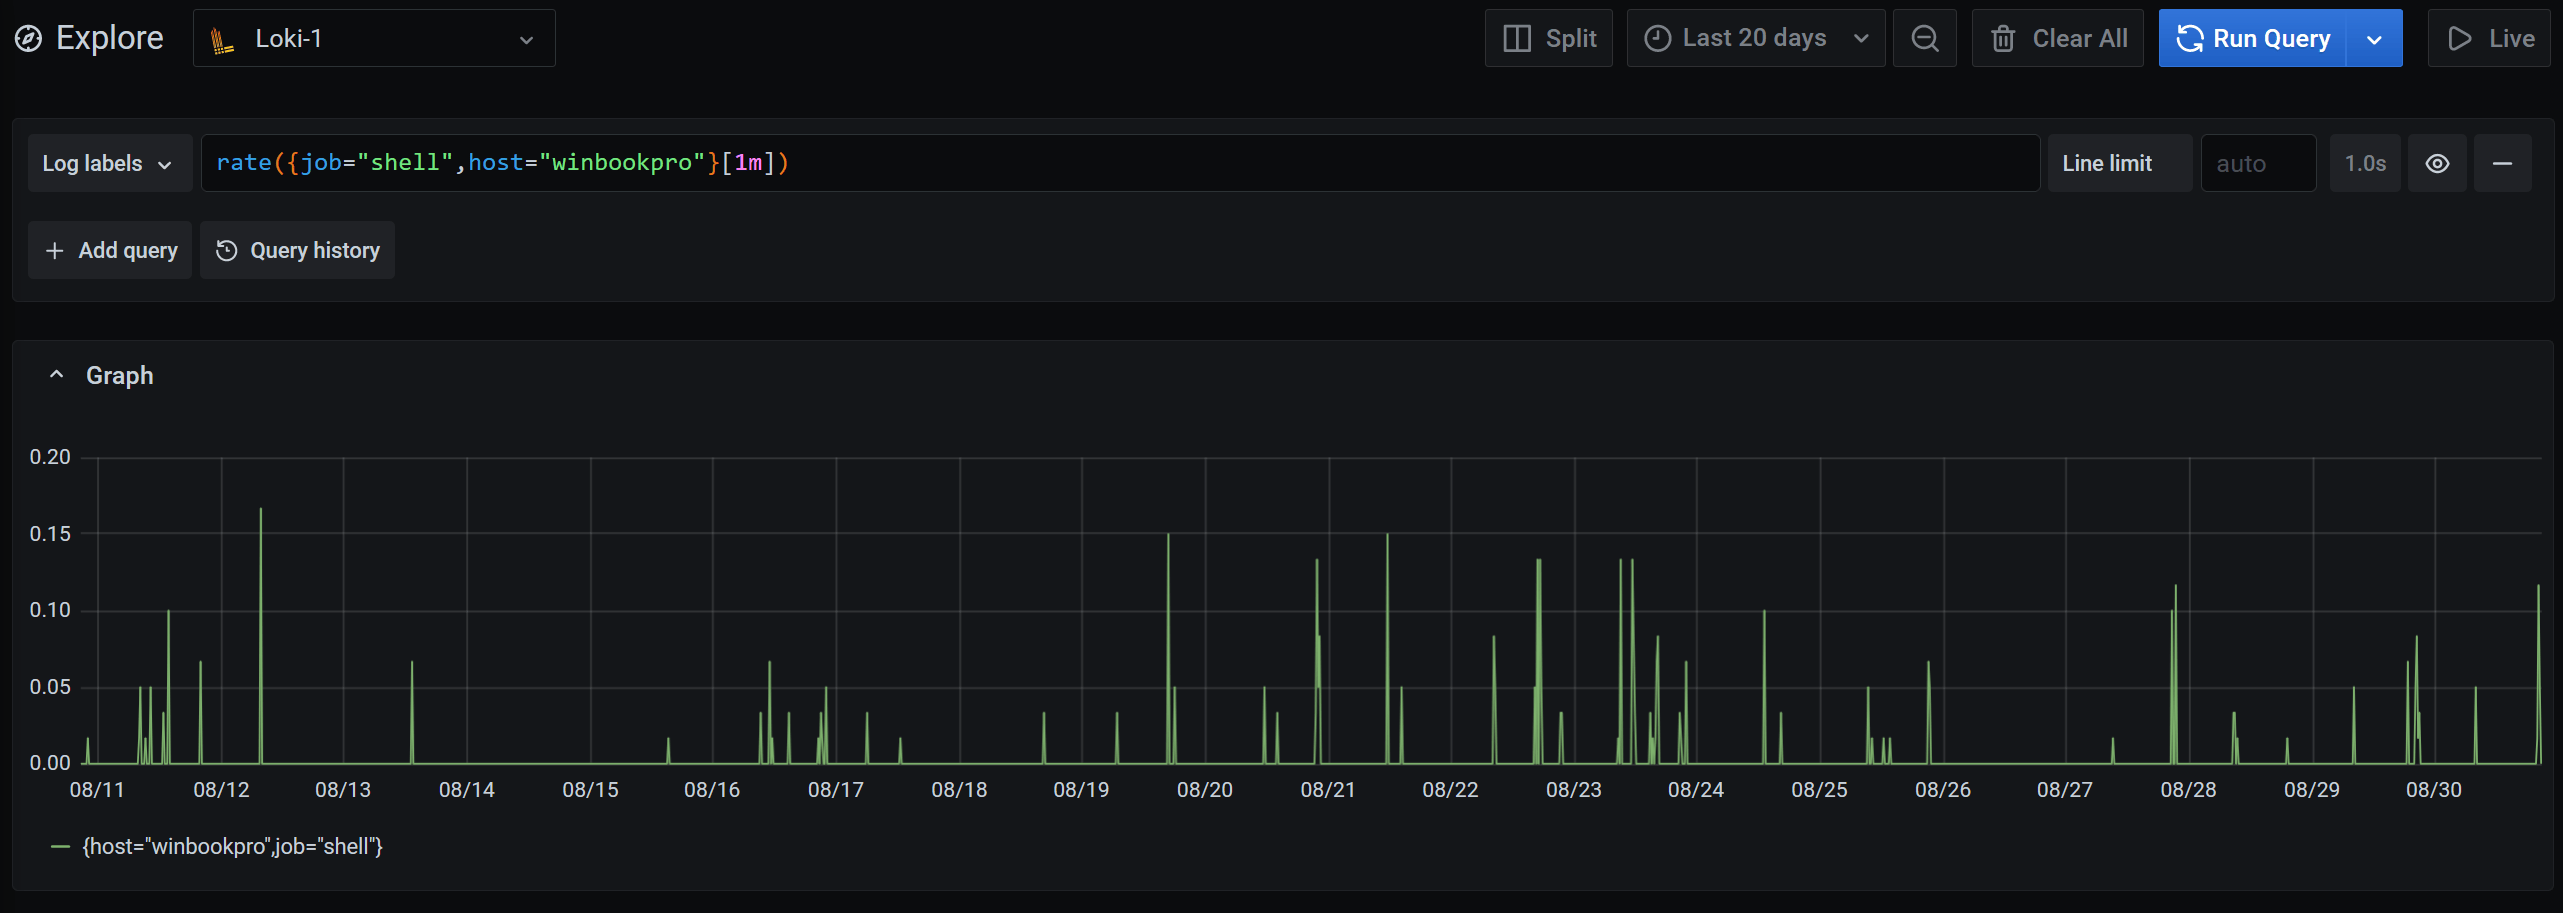
或者你可以从日志中探索度量的世界,看看你使用 shell 的频率:

rate({job="shell"}[1m])

 title=

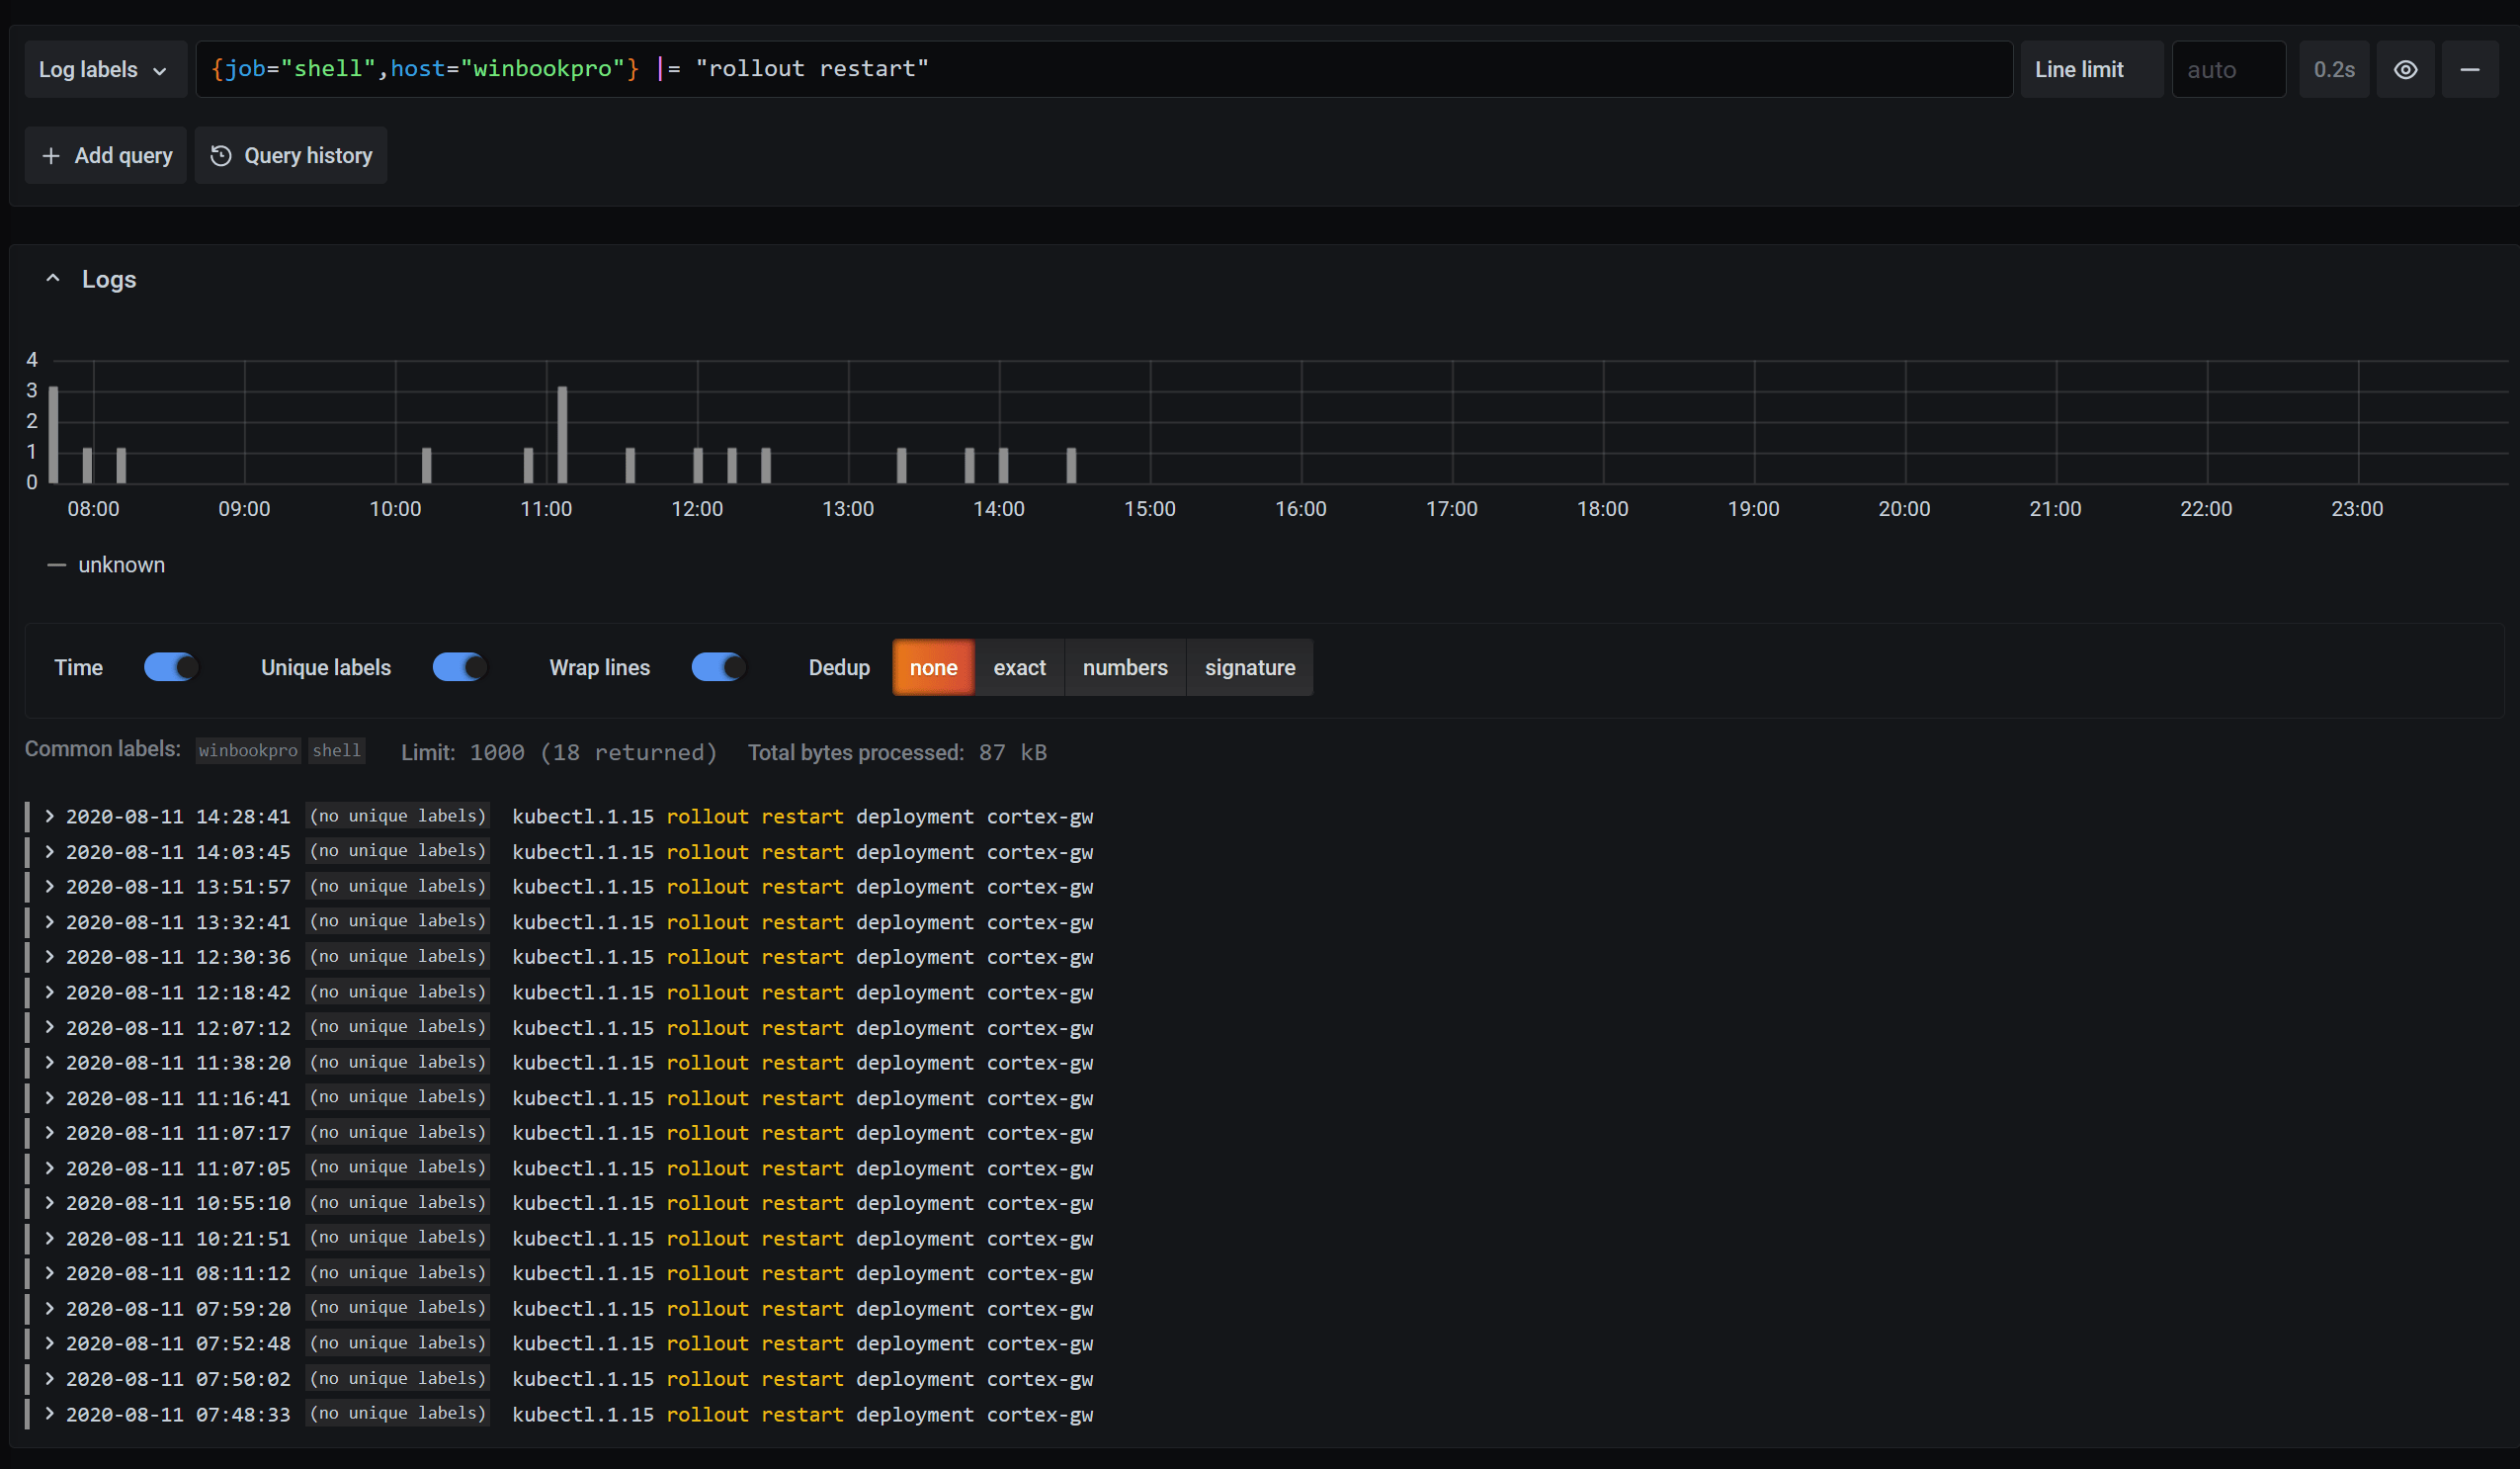
想从一个事件中重建一个时间线?你可以通过特定的命令进行过滤,查看它的运行时间:

 title=

要想知道你还能做什么,并了解更多关于 Loki 查询语言的信息,请查看 LogQL 指南。

总结

更多的想法、故障排除和更新,请关注该 GitHub 版本库。这仍然是一项正在进行中的工作,所以请在那里报告发现的任何问题。

要了解更多关于 Loki 的信息,请查看文档、博客文章和该 GitHub 版本库,或者在 Grafana Cloud 中试用。


特别感谢我的同事 Jack Baldry 为这个想法播下的种子。我有 Loki 的知识来实现这个想法,但如果不是他的建议,我想我永远也不会做到这一点。


via: https://opensource.com/article/20/10/shell-history-loki-fzf

作者:Ed Welch 选题:lujun9972 译者:wxy 校对:wxy
本文由 LCTT 原创编译,Linux中国 荣誉推出

在 Ubuntu 或 Debian 中通过命令行来安装应用是一件很简单的事,你只需要执行 apt install package_name 就可以了。

但如果你想在安装一个软件包之前或之后知晓这个软件包的依赖,那该怎么办呢?

在本教程中,我将向你展示多种方法来在 Ubuntu 或其他使用 APT 包管理器 的 Debian 系 Linux 发行版中查看一个软件包的依赖。

什么是 Ubuntu 中的包依赖?

当你在 Linux 中安装一个软件包,有时这个软件包还需要其他的软件包来使它工作正常。这些额外的软件包就叫作这个包的依赖。假如这些软件包之前没有在系统中被安装,那么这些依赖在安装这个软件包的同时会被自动安装上。

举个例子,用来转换视频格式的 GUI 工具 HandBrake 需要 FFmpeg、GStreamer 软件包。所以对于 HandBrake 来说, FFmpeg 和 GStreamer 就是它的包依赖。

假如在你的系统上这些软件包没有被安装,则当你 在 Ubuntu 上安装 HandBrake 时,就会自动安装上它们。

在 Ubuntu 和基于 Debian 的发行版中查看一个软件包的依赖

正如在 Linux 上经常发生的那样,有多种方法来达到相同的目标。下面让我们一起瞧瞧查看一个软件包依赖的多种方法。

使用 apt show 来查看依赖

你可以使用 apt show 命令 来展示一个包的详细信息。其中依赖信息就是其中一部分,你可以在以 “Depends” 打头的那些行中看到它们。

例如,下面展示的是使用 apt show 展示 ubuntu-restricted-extras 这个包的详细信息:

abhishek@itsfoss:~$ apt show ubuntu-restricted-extras 
Package: ubuntu-restricted-extras
Version: 67
Priority: optional
Section: multiverse/metapackages
Origin: Ubuntu
Maintainer: Ubuntu Developers <[email protected]>
Bugs: https://bugs.launchpad.net/ubuntu/+filebug
Installed-Size: 14.3 kB
Depends: ubuntu-restricted-addons
Recommends: libavcodec-extra, ttf-mscorefonts-installer, unrar
Download-Size: 3,200 B
APT-Manual-Installed: yes
APT-Sources: http://us.archive.ubuntu.com/ubuntu focal/multiverse amd64 Packages
Description: Commonly used media codecs and fonts for Ubuntu
 This collection of packages includes:
  - MP3 and other audio codec software to play various audio formats
    (GStreamer plugins)
  - software to install the Microsoft Web fonts
  - the Adobe Flash plugin
  - LAME, software to create compressed audio files.
 .
 This software does not include libdvdcss2, and will not let you play
 encrypted DVDs. For more information, see
 https://help.ubuntu.com/community/RestrictedFormats/PlayingDVDs
 .
 These software packages are from the Multiverse channel, restricted by
 copyright or legal issues in some countries. For more information, see
 http://www.ubuntu.com/ubuntu/licensing

如你所见,ubuntu-restricted-extras 包依赖于 ubuntu-restricted-addons 这个软件包。

但你得小心的是依赖包还可能依赖于其他包,这样一直循环往复直到尽头。但幸好 APT 包管理器可以为你处理这些复杂的依赖关系,自动地安装所有的依赖(大多数情况下)。

什么是推荐包?

你注意到了上面结果输出中以 “Recommends” 开头的那些行了吗?

推荐包不是软件包的直接依赖,但它们可以开启软件包的一些额外功能。

正如你上面看到的那样, ubuntu-restricted-extras 包有 ttf-mscorefonts-installer 这个推荐包,用来在 Ubuntu 上安装 Microsoft 的字体。

这些推荐包也会默认被一同安装上,假如你想显式地禁止这些推荐包的安装,你可以像下面这样使用 –-no-install-recommends 选项。

sudo apt install --no-install-recommends package_name

使用 apt-cache 来直接获取依赖信息

上面通过 apt show 的方式会获取到大量信息,假如你想在脚本中获取到依赖信息,那么 apt-cache 命令将会给你一个更好且更简洁的输出结果。

apt-cache depends package_name

下面的输出看起来更加干净,不是吗?

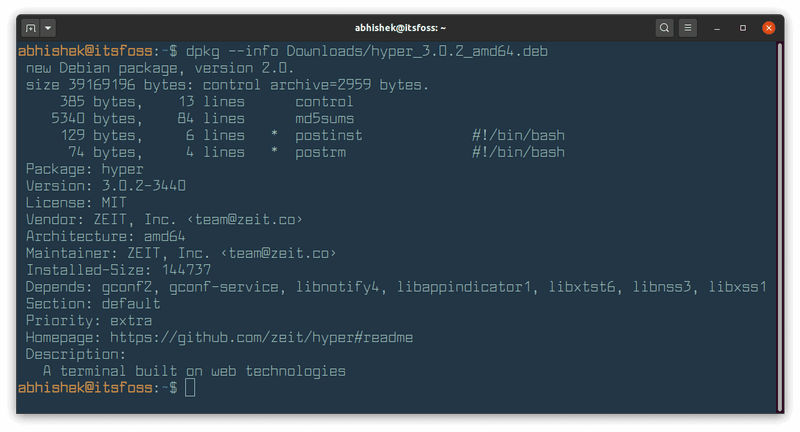
使用 dpkg 来查看一个 DEB 文件的依赖

apt 和 apt-cache 都作用于软件仓库中的软件包,但假如你下载了一个 DEB 文件,那么这两个命令就不起作用了。

在这种情形下,你可以使用 dpkg 命令的 -I 或 --info 选项。

dpkg -I path_to_deb_file

依赖信息就可以在以 “Depends” 开头的那些行中找到。

使用 apt-rdepends 来查看依赖及依赖的依赖

假如你想查看更多关于依赖的信息,那么你可以使用 apt-rdepends 工具。这个工具可以创建完整的依赖树。这样你就可以得到一个软件包的依赖以及这些依赖的依赖。

它不是一个常规的 apt 命令,所以你需要从 universe 软件仓库中安装上它:

sudo apt install apt-rdepends

这个命令的输出通常很多,取决于依赖树的大小。

Reading package lists... Done
Building dependency tree
Reading state information... Done
shutter
  Depends: procps
  Depends: xdg-utils
imagemagick
  Depends: imagemagick-6.q16 (>= 8:6.9.2.10+dfsg-2~)
imagemagick-6.q16
  Depends: hicolor-icon-theme
  Depends: libc6 (>= 2.4)
  Depends: libmagickcore-6.q16-6 (>= 8:6.9.10.2)
  Depends: libmagickwand-6.q16-6 (>= 8:6.9.10.2)
hicolor-icon-theme
libc6
  Depends: libcrypt1 (>= 1:4.4.10-10ubuntu4)
  Depends: libgcc-s1
libcrypt1
  Depends: libc6 (>= 2.25)

apt-rdepends 工具的功能非常多样,它还可以用来计算反向依赖。这意味着你可以查看某个特定的包被哪些软件包依赖。

apt-rdepends -r package_name

输出可能会非常多,因为它将打印出反向依赖树。

abhishek@itsfoss:~$ apt-rdepends -r ffmpeg
Reading package lists... Done
Building dependency tree       
Reading state information... Done
ffmpeg
  Reverse Depends: ardour-video-timeline (>= 1:5.12.0-3ubuntu4)
  Reverse Depends: deepin-screen-recorder (5.0.0-1build2)
  Reverse Depends: devede (4.15.0-2)
  Reverse Depends: dvd-slideshow (0.8.6.1-1)
  Reverse Depends: green-recorder (>= 3.2.3)

我希望这个快速的教程可以帮助你提高一点儿你的命令行知识。为了知晓更多类似小知识点,请保持关注。


via: https://itsfoss.com/check-dependencies-package-ubuntu/

作者:Abhishek Prakash 选题:lujun9972 译者:FSSlc 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

C++ 语言很复杂,但它可以教会你很多关于数据类型、内存管理和代码链接的知识。

学习一门编程语言有几种方法。如果你是编码新手,你通常会学习一些基本的计算机编码概念,并尝试应用它们。如果你已经知道如何用另一种语言进行编码,你可以重新学习编码概念在新语言中是如何表达的。

不管是哪种情况,学习这些新原理的便捷方法是创建一个简单的猜谜游戏。这会迫使你了解一门语言如何接收输入和发送输出,如何比较数据,如何控制程序的流程,以及如何利用条件来影响结果。它还确保你知道一门语言是如何组织其代码的;例如,Lua 或 Bash 可以很容易地作为脚本运行,而 Java 则需要你创建一个类。

在本文中,我将演示如何用 C++ 在终端上实现猜谜游戏。

安装依赖关系

要跟上本文的步伐,你需要 C++ 和一个编译器。

在 Linux 上,你可以通过从你的发行版软件仓库中安装 Qt Creator IDE 来获得你所需要的一切。

在 Fedora、CentOS 或 RHEL 上:

$ sudo dnf install qt-creator

在 Debian、Ubuntu、Chromebook 或类似的系统上:

$ sudo apt install qtcreator

本文并没有使用 Qt Creator IDE,但它是一个安装你所需要的一切的简单方法,对于复杂的 C++ 项目(包括那些带有 GUI 的项目),它是一个必不可少的工具。在 macOS 或 Windows 上,按照 Qt 网站上的安装说明进行安装。

设置包含和命名空间

C++ 的核心语言是精简的。即使是一个简单的应用程序也需要使用额外的库。这个应用程序使用 iostream 来获得对 cout 和 cin 关键字的访问。

另外,确保程序使用 std 命名空间:

#include <iostream>

using namespace std;

这并不是绝对必要,但如果不将命名空间设置为 std,所有来自 iostream 库的关键字都需要一个命名空间前缀。例如,我不能写作 cout,而是要写作 std::cout。

C++ 中的语句以分号结束。

创建一个函数

每个 C++ 应用程序至少需要一个函数。一个 C++ 应用程序的主函数必须称为 main,它必须返回一个整数(int),这符合 POSIX 的期望,即一个进程在成功时返回 0,而在失败时返回其他值。你可以通过为它提供返回类型和名称来创建一个新函数。

int main() {
 // code goes here
}

实现程序逻辑

游戏代码必须首先产生一个随机数供玩家猜测。在 C++ 中,你可以通过建立一个用于生成伪随机数的种子来实现。一个简单的种子就是当前的时间。一旦有了种子,你就可以得到一个在 1 和 100 之间的数字。通过调用 rand 函数,并设置上限值 100 来产生一个从 0 到 99 的随机数,所以无论选择了什么数字都要加 1,并将结果分配给一个名为 number 的变量。你还必须声明一个变量来保存玩家的猜测值。为了清楚起见,我称这个变量为 guess。

这个示例代码还包括一个调试语句,告诉你随机数到底是什么。这对于猜测游戏来说不是很好,但它使测试速度快了很多。以后,你可以删除这一行,或者直接在行前面用 // 注释出来:

 srand (time(NULL));
 int number = rand() % 100+1;
 int guess = 0;

 cout << number << endl; //debug

增加 do-while 和 if 语句

C++ 中的 do-while 语句以关键字 do 开头,并将你希望 C++ 做的所有事情用括号括起来。用 while 关键字结束语句,后面是必须满足的条件(括号内):

do {
 // code here
} while ( number != guess );

游戏代码出现在 if、else if 和 else 语句之间,为玩家提供提示。

首先,用 cout 语句提示玩家猜测。cout 函数将输出打印到 stdout 上。因为 cout 语句没有连着 endl(endline)函数,所以没有换行。紧接着这个 cout 语句,通过使用 cin 函数告诉 C++ 等待输入。正如你所猜测的那样,cin 等待来自 stdin 的输入。

接下来,程序进入 if 控制语句。如果玩家的猜测大于 number 变量中包含的伪随机数,那么程序就会打印出一个提示,后面是一个换行符。这就中断了 if 语句,但 C++ 仍然被困在 do-while 循环中,因为它的条件(number 变量等于 guess)还没有满足。

如果玩家的猜测小于 number 变量中包含的伪随机数,那么程序就会打印出一个提示,后面是一个换行符。这再次中断了 if 语句,但程序仍然被困在 do-while 循环中。

当 guess 等于 number 时,最终满足关键条件,触发 else 语句,do-while 循环结束,程序结束:

do {
  cout << "Guess a number between 1 and 100: ";
  cin >> guess;

  if ( guess > number) { cout << "Too high.\n" << endl; }
  else if ( guess < number ) { cout << "Too low.\n" << endl; }
  else {
    cout << "That's right!\n" << endl;
    exit(0);
  } // fi
 } while ( number != guess );
return 0;
} // main

构建代码和玩游戏

你可以用 GCC 构建你的应用程序:

$ g++ -o guess.bin guess.cpp

运行二进制文件试试:

$ ./guess.bin
74
Guess a number between 1 and 100: 76
Too high.

Guess a number between 1 and 100: 1
Too low.

Guess a number between 1 and 100: 74
That's right!

成功了!

试试 C++ 吧

C++ 语言很复杂。为终端编写 C++ 应用程序可以让你学到很多关于数据类型、内存管理和代码链接的知识。试着用 C++ 编写一个有用的实用程序,看看你能发现什么!


via: https://opensource.com/article/20/12/learn-c-game

作者:Seth Kenlon 选题:lujun9972 译者:wxy 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出