分类 技术 下的文章

通过深入了解容器运行时,理解容器环境是如何建立的。

 title=

在学习 容器镜像 时,我们讨论了容器的基本原理,但现在是深入研究容器 运行时 runtime 的时候了,从而了解容器环境是如何构建的。本文的部分信息摘自 开放容器计划 Open Container Initiative (OCI)的 官方文档,所以无论使用何种容器引擎,这些信息都是一致的。

容器运行机制

那么,当你运行 podman run 或 docker run 命令时,在后台到底发生了什么?一个分步的概述如下:

  1. 如果本地没有镜像,则从镜像 登记仓库 registry 拉取镜像
  2. 镜像被提取到一个写时复制(COW)的文件系统上,所有的容器层相互堆叠以形成一个合并的文件系统
  3. 为容器准备一个挂载点
  4. 从容器镜像中设置元数据,包括诸如覆盖 CMD、来自用户输入的 ENTRYPOINT、设置 SECCOMP 规则等设置,以确保容器按预期运行
  5. 提醒内核为该容器分配某种隔离,如进程、网络和文件系统( 命名空间 namespace )
  6. 提醒内核为改容器分配一些资源限制,如 CPU 或内存限制( 控制组 cgroup )
  7. 传递一个 系统调用 syscall 给内核用于启动容器
  8. 设置 SELinux/AppArmor

容器运行时负责上述所有的工作。当我们提及容器运行时,想到的可能是 runc、lxc、containerd、rkt、cri-o 等等。嗯,你没有错。这些都是容器引擎和容器运行时,每一种都是为不同的情况建立的。

容器运行时 Container runtime 更侧重于运行容器,为容器设置命名空间和控制组(cgroup),也被称为底层容器运行时。高层的容器运行时或容器引擎专注于格式、解包、管理和镜像共享。它们还为开发者提供 API。

开放容器计划(OCI)

开放容器计划 Open Container Initiative (OCI)是一个 Linux 基金会的项目。其目的是设计某些开放标准或围绕如何与容器运行时和容器镜像格式工作的结构。它是由 Docker、rkt、CoreOS 和其他行业领导者于 2015 年 6 月建立的。

它通过两个规范来完成如下任务:

1、镜像规范

该规范的目标是创建可互操作的工具,用于构建、传输和准备运行的容器镜像。

该规范的高层组件包括:

2、运行时规范

该规范用于定义容器的配置、执行环境和生命周期。config.json 文件为所有支持的平台提供了容器配置,并详细定义了用于创建容器的字段。在详细定义执行环境时也描述了为容器的生命周期定义的通用操作,以确保在容器内运行的应用在不同的运行时环境之间有一个一致的环境。

Linux 容器规范使用了各种内核特性,包括 命名空间 namespace 、 控制组 cgroup 、 权能 capability 、LSM 和文件系统 隔离 jail 等来实现该规范。

小结

容器运行时是通过 OCI 规范管理的,以提供一致性和互操作性。许多人在使用容器时不需要了解它们是如何工作的,但当你需要排除故障或优化时,了解容器是一个宝贵的优势。

本文基于 techbeatly 的文章,并经授权改编。


via: https://opensource.com/article/21/9/container-runtimes

作者:Nived V 选题:lujun9972 译者:geekpi 校对:turbokernel

本文由 LCTT 原创编译,Linux中国 荣誉推出

外部库填补了 Java 核心库中的一些功能空白。

 title=

Java 自带有一组核心库,其中包含了定义常用数据类型和相关行为的库(例如 String 和 Date)、与主机操作系统交互的实用程序(例如 System 和 File),以及一些用来管理安全性、处理网络通信、创建或解析 XML的有用的子系统。鉴于核心库的丰富性,程序员通常很容易在其中找到有用的组件,以减少需要编写的代码量。

即便如此,核心库仍有一些功能上的不足,因此发现这些不足的程序员们还额外创建了很多有趣的 Java 库。例如,Apache Commons“是一个专注于可重用 Java 组件所有方面的 Apache 项目”,提供了大约 43 个开源库的集合(截至撰写本文时),涵盖了 Java 核心库之外的一系列功能 (例如 geometry 或 statistics),并增强或替换了 Java 核心库中的原有功能(例如 math 或 numbers)。

另一种常见的 Java 库类型是系统组件的接口(例如数据库系统接口),本文会着眼于使用此类接口连接到 PostgreSQL 数据库,并得到一些有趣的信息。首先,我们来回顾一下库的重要部分。

什么是库?

库 library 里自然包含的是一些有用的代码。但为了发挥用处,代码需要以特定方式进行组织,特定的方式使 Java 程序员可以访问其中组件来解决手头问题。

可以说,一个库最重要的部分是它的应用程序编程接口(API)文档。这种文档很多人都熟悉,通常是由 Javadoc 生成的。Javadoc 读取代码中的结构化注释并以 HTML 格式输出文档,通常 API 的 包 package 在页面左上角的面板中显示, 类 class 在左下角显示,同时右侧会有库、包或类级别的详细文档(具体取决于在主面板中选择的内容)。例如,Apache Commons Math 的顶级 API 文档 如下所示:

 title=

单击主面板中的包会显示该包中定义的 Java 类和接口。例如,org.apache.commons.math4.analysis.solvers 显示了诸如 BisectionSolver 这样的类,该类用于使用二分算法查找单变量实函数的零点。单击 BisectionSolver 链接会列出 BisectionSolver 类的所有方法。

这类文档可用作参考文档,不适合作为学习如何使用库的教程。比如,如果你知道什么是单变量实函数并查看包 org.apache.commons.math4.analysis.function,就可以试着使用该包来组合函数定义,然后使用 org.apache.commons.math4.analysis.solvers 包来查找刚刚创建的函数的零点。但如果你不知道,就可能需要更多学习向的文档,也许甚至是一个实际例子,来读懂参考文档。

这种文档结构还有助于阐明 包 package (相关 Java 类和接口定义的集合)的含义,并显示特定库中捆绑了哪些包。

这种库的代码通常是在 .jar 文件) 中,它基本上是由 Java 的 jar 命令创建的 .zip 文件,其中还包含一些其他有用的信息。.jar 文件通常被创建为构建过程的端点,该构建过程编译了所定义包中的所有 .java 文件。

要访问外部库提供的功能,有两个主要步骤:

  1. 确保通过类路径(或者命令行中的 -cp 参数或者 CLASSPATH 环境变量),库可用于 Java 编译步骤(javac)和执行步骤(java)。
  2. 使用恰当的 import 语句访问程序源代码中的包和类。

其余的步骤就与使用 String 等 Java核心类相同,使用库提供的类和接口定义来编写代码。很简单对吧?不过也没那么简单。首先,你需要了解库组件的预期使用模式,然后才能编写代码。

示例:连接 PostgreSQL 数据库

在数据库系统中访问数据的典型使用步骤是:

  1. 访问正在使用的特定数据库软件代码。
  2. 连接到数据库服务器。
  3. 构建查询字符串。
  4. 执行查询字符串。
  5. 针对返回的结果,做需要的处理。
  6. 断开与数据库服务器的连接。

所有这些面向程序员的部分由接口包 java.sql 提供,它独立于数据库,定义了核心客户端 Java 数据库连接(JDBC)API。java.sql 包是 Java 核心库的一部分,因此无需提供 .jar 文件即可编译。但每个数据库提供者都会创建自己的 java.sql 接口实现(例如 Connection 接口),并且必须在运行步骤中提供这些实现。

接下来我们使用 PostgreSQL,看看这一过程是如何进行的。

访问特定数据库的代码

以下代码使用 Java 类加载器(Class.forName() 调用)将 PostgreSQL 驱动程序代码加载到正在执行的虚拟机中:

import java.sql.*;

public class Test1 {

    public static void main(String args[]) {

        // Load the driver (jar file must be on class path) [1]

        try {
            Class.forName("org.postgresql.Driver");
            System.out.println("driver loaded");
        } catch (Exception e1) {
            System.err.println("couldn't find driver");
            System.err.println(e1);
            System.exit(1);
        }

        // If we get here all is OK

        System.out.println("done.");
    }
}

因为类加载器可能失败,失败时会抛出异常,所以将对 Class.forName() 的调用放在 try-catch 代码块中。

如果你使用 javac 编译上面的代码,然后用 java 运行,会报异常:

me@mymachine:~/Test$ javac Test1.java
me@mymachine:~/Test$ java Test1
couldn't find driver
java.lang.ClassNotFoundException: org.postgresql.Driver
me@mymachine:~/Test$

类加载器要求类路径中有包含 PostgreSQL JDBC 驱动程序实现的 .jar 文件:

me@mymachine:~/Test$ java -cp ~/src/postgresql-42.2.5.jar:. Test1
driver loaded
done.
me@mymachine:~/Test$

连接到数据库服务器

以下代码实现了加载 JDBC 驱动程序和创建到 PostgreSQL 数据库的连接:

import java.sql.*;

public class Test2 {

        public static void main(String args[]) {

                // Load the driver (jar file must be on class path) [1]

                try {
                        Class.forName("org.postgresql.Driver");
                        System.out.println("driver loaded");
                } catch (Exception e1) {
                        System.err.println("couldn't find driver");
                        System.err.println(e1);
                        System.exit(1);
                }

                // Set up connection properties [2]

                java.util.Properties props = new java.util.Properties();
                props.setProperty("user","me");
                props.setProperty("password","mypassword");
                String database = "jdbc:postgresql://myhost.org:5432/test";

                // Open the connection to the database [3]

                try (Connection conn = DriverManager.getConnection(database, props)) {
                        System.out.println("connection created");
                } catch (Exception e2) {
                        System.err.println("sql operations failed");
                        System.err.println(e2);
                        System.exit(2);
                }
                System.out.println("connection closed");

                // If we get here all is OK

                System.out.println("done.");
        }
}

编译并运行上述代码:

me@mymachine:~/Test$ javac Test2.java
me@mymachine:~/Test$ java -cp ~/src/postgresql-42.2.5.jar:. Test2
driver loaded
connection created
connection closed
done.
me@mymachine:~/Test$

关于上述的一些注意事项:

  • 注释 [2] 后面的代码使用系统属性来设置连接参数(在本例中参数为 PostgreSQL 用户名和密码)。代码也可以从 Java 命令行获取这些参数并将所有参数作为参数包传递,同时还有一些其他 Driver.getConnection() 选项可用于单独传递参数。
  • JDBC 需要一个用于定义数据库的 URL,它在上述代码中被声明为 String database 并与连接参数一起传递给 Driver.getConnection() 方法。
  • 代码使用 try-with-resources 语句,它会在 try-catch 块中的代码完成后自动关闭连接。Stack Overflow 上对这种方法进行了长期的讨论。
  • try-with-resources 语句提供对 Connection 实例的访问,并可以在其中执行 SQL 语句;所有错误都会被同一个 catch 语句捕获。

用数据库的连接处理一些有趣的事情

日常工作中,我经常需要知道为给定的数据库服务器实例定义了哪些用户,这里我使用这个 简便的 SQL 来获取所有用户的列表:

import java.sql.*;

public class Test3 {

        public static void main(String args[]) {

                // Load the driver (jar file must be on class path) [1]

                try {
                        Class.forName("org.postgresql.Driver");
                        System.out.println("driver loaded");
                } catch (Exception e1) {
                        System.err.println("couldn't find driver");
                        System.err.println(e1);
                        System.exit(1);
                }

                // Set up connection properties [2]

                java.util.Properties props = new java.util.Properties();
                props.setProperty("user","me");
                props.setProperty("password","mypassword");
                String database = "jdbc:postgresql://myhost.org:5432/test";

                // Open the connection to the database [3]

                try (Connection conn = DriverManager.getConnection(database, props)) {
                        System.out.println("connection created");

                        // Create the SQL command string [4]

                        String qs = "SELECT " +
                                "       u.usename AS \"User name\", " +
                                "       u.usesysid AS \"User ID\", " +
                                "       CASE " +
                                "       WHEN u.usesuper AND u.usecreatedb THEN " +
                                "               CAST('superuser, create database' AS pg_catalog.text) " +
                        "       WHEN u.usesuper THEN " +
                                "               CAST('superuser' AS pg_catalog.text) " +
                                "       WHEN u.usecreatedb THEN " +
                                "               CAST('create database' AS pg_catalog.text) " +
                                "       ELSE " +
                                "               CAST('' AS pg_catalog.text) " +
                                "       END AS \"Attributes\" " +
                                "FROM pg_catalog.pg_user u " +
                                "ORDER BY 1";

                        // Use the connection to create a statement, execute it,
                        // analyze the results and close the result set [5]

                        Statement stat = conn.createStatement();
                        ResultSet rs = stat.executeQuery(qs);
                        System.out.println("User name;User ID;Attributes");
                        while (rs.next()) {
                                System.out.println(rs.getString("User name") + ";" +
                                                rs.getLong("User ID") + ";" +
                                                rs.getString("Attributes"));
                        }
                        rs.close();
                        stat.close();
               
                } catch (Exception e2) {
                        System.err.println("connecting failed");
                        System.err.println(e2);
                        System.exit(1);
                }
                System.out.println("connection closed");

                // If we get here all is OK

                System.out.println("done.");
        }
}

在上述代码中,一旦有了 Connection 实例,它就会定义一个查询字符串(上面的注释 [4]),创建一个 Statement 实例并用其来执行查询字符串,然后将其结果放入一个 ResultSet 实例。程序可以遍历该 ResultSet 实例来分析返回的结果,并以关闭 ResultSet 和 Statement 实例结束(上面的注释 [5])。

编译和执行程序会产生以下输出:

me@mymachine:~/Test$ javac Test3.java
me@mymachine:~/Test$ java -cp ~/src/postgresql-42.2.5.jar:. Test3
driver loaded
connection created
User name;User ID;Attributes
fwa;16395;superuser
vax;197772;
mbe;290995;
aca;169248;
connection closed
done.
me@mymachine:~/Test$

这是在一个简单的 Java 应用程序中使用 PostgreSQL JDBC 库的(非常简单的)示例。要注意的是,由于 java.sql 库的设计方式,它不需要在代码中使用像 import org.postgresql.jdbc.*; 这样的 Java 导入语句,而是使用 Java 类加载器在运行时引入 PostgreSQL 代码的方式,也正因此无需在代码编译时指定类路径。


via: https://opensource.com/article/20/2/external-libraries-java

作者:Chris Hermansen 选题:lujun9972 译者:unigeorge 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

获取到任何文件或文件系统的所有信息,仅需要一条 Linux 命令。

 title=

在 GNU coreutils 软件包中包含 stat 命令,它提供了关于文件和文件系统包括文件大小、节点位置、访问权限和 SELinux 上下文,以及创建和修改时间等各种元数据。通常情况下,你需要多个不同命令获取的信息,而这一个命令就可以实现。

在 Linux 上安装 stat 命令

在 Linux 系统中,可能已经预装了 stat 命令,因为它属于核心功能软件包,通常默认包含在 Linux 发行版里。

如果系统中没有安装 stat 命令,你可以使用包管理器安装 coreutils 软件包。

另外,你可以 通过源码编译安装 coreutils 包。

获取文件状态

运行 stat 命令可以获取指定文件或目录易读的状态信息。

$ stat planets.xml
  File: planets.xml
  Size: 325      Blocks: 8     IO Block: 4096   regular file
Device: fd03h/64771d    Inode: 140217      Links: 1
Access: (0664/-rw-rw-r--)  Uid: (1000/tux)   Gid: (100/users)
Context: unconfined_u:object_r:user_home_t:s0
Access: 2021-08-17 18:26:57.281330711 +1200
Modify: 2021-08-17 18:26:58.738332799 +1200
Change: 2021-08-17 18:26:58.738332799 +1200
 Birth: 2021-08-17 18:26:57.281330711 +1200

输出的信息易懂,但是包含了很多的信息,这里是 stat 所包含的项:

  • File:文件名
  • Size:文件大小,以字节表示
  • Blocks:在硬盘驱动器上为文件保留的数据块的数量
  • IO Block:文件系统块大小
  • regular file:文件类型(普通文件、目录、文件系统)
  • Device:文件所在的设备
  • Inode:文件所在的 Inode 号
  • Links:文件的链接数
  • Access、UID、GID:文件权限、用户和组的所有者
  • Context:SELinux 上下文
  • Access、Modify、Change、Birth:文件被访问、修改、更改状态以及创建时的时间戳

精简输出

对于精通输出或者想要使用其它工具(例如:awk)解析输出的人,这里可以使用 --terse(短参数为 -t)参数,实现没有标题或换行符的格式化输出。

$ stat --terse planets.xml
planets.xml 325 8 81b4 100977 100 fd03 140217 1 0 0 1629181617 1629181618 1629181618 1629181617 4096 unconfined_u:object_r:user_home_t:s0

自定义格式

你可以使用 --printf 参数以及与 printf 类似的语法定义自己的输出格式。stat 的每一个属性都有一个格式序列(%C 表示 SELinux 上下文,%n 表示文件名等等),所以,你可以定义输出格式。

$ stat --printf="%n\n%C\n" planets.xml
planets.xml
unconfined_u:object_r:user_home_t:s0
$ $ stat --printf="Name: %n\nModified: %y\n" planets.xml
Name: planets.xml
Modified: 2021-08-17 18:26:58.738332799 +1200

下面是一些常见的格式序列:

  • %a 访问权限
  • %F 文件类型
  • %n 文件名
  • %U 用户名
  • %u 用户 ID
  • %g 组 ID
  • %w 创建时间
  • %y 修改时间

在 stat 手册和 coreutils 信息页中都有完整的格式化序列列表。

文件信息

如果你曾尝试解析过 ls -l 的输出,那么,你会很喜欢 stat 命令的灵活性。你并不是每次都需要 stat 提供的所有信息,但是,当你需要其中一些或全部的时候它是非常有用的。不管你是读取默认输出,还是你自己创建的查询输出,stat 命令都可以查看所需的数据。


via: https://opensource.com/article/21/8/linux-stat-file-status

作者:Seth Kenlon 选题:lujun9972 译者:New-World-2019 校对:turbokernel

本文由 LCTT 原创编译,Linux中国 荣誉推出

容器镜像包含一个打包的应用,以及它的依赖关系,还有它在启动时运行的进程信息。

 title=

容器是当今 IT 运维的一个关键部分。 容器镜像 container image 包含了一个打包的应用,以及它的依赖关系,还有它在启动时运行的进程信息。

你可以通过提供一组特殊格式的指令来创建容器镜像,可以是提交给 注册中心 Registry ,或者是作为 Dockerfile 保存。例如,这个 Dockerfile 为 PHP Web 应用创建了一个容器:

FROM registry.access.redhat.com/ubi8/ubi:8.1

RUN yum --disableplugin=subscription-manager -y module enable php:7.3 \
  && yum --disableplugin=subscription-manager -y install httpd php \
  && yum --disableplugin=subscription-manager clean all

ADD index.php /var/www/html

RUN sed -i 's/Listen 80/Listen 8080/' /etc/httpd/conf/httpd.conf \
  && sed -i 's/listen.acl_users = apache,nginx/listen.acl_users =/' /etc/php-fpm.d/www.conf \
  && mkdir /run/php-fpm \
  && chgrp -R 0 /var/log/httpd /var/run/httpd /run/php-fpm \
  && chmod -R g=u /var/log/httpd /var/run/httpd /run/php-fpm

EXPOSE 8080
USER 1001
CMD php-fpm & httpd -D FOREGROUND

这个文件中的每条指令都会在容器镜像中增加一个 层 layer 。每一层只增加与下面一层的区别,然后,所有这些堆叠在一起,形成一个只读的容器镜像。

它是如何工作的?

你需要知道一些关于容器镜像的事情,按照这个顺序理解这些概念很重要:

  1. 联合文件系统
  2. 写入时复制(COW)
  3. 叠加文件系统
  4. 快照器

联合文件系统

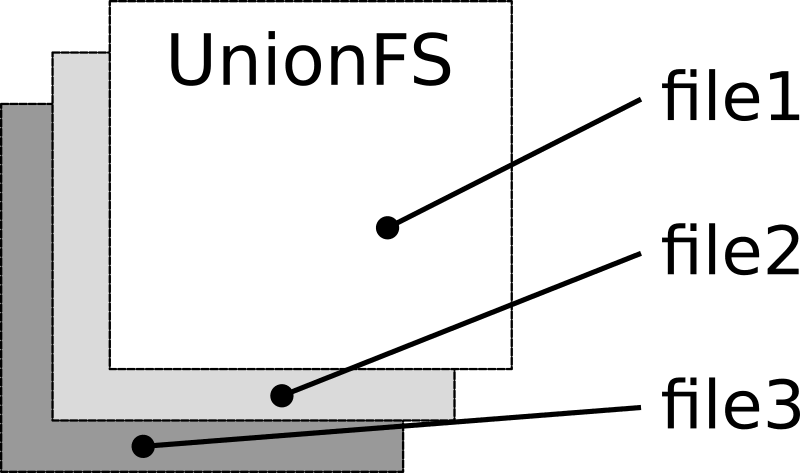
联合文件系统 Union File System (UnionFS)内置于 Linux 内核中,它允许将一个文件系统的内容与另一个文件系统的内容合并,同时保持“物理”内容的分离。其结果是一个统一的文件系统,即使数据实际上是以分支形式组织。

这里的想法是,如果你有多个镜像有一些相同的数据,不是让这些数据再次复制过来,而是通过使用一个叫做 层 layer 的东西来共享。

 title=

每一层都是一个可以在多个容器中共享的文件系统,例如,httpd 基础层是 Apache 的官方镜像,可以在任何数量的容器中使用。想象一下,由于我们在所有的容器中使用相同的基础层,我们节省了多少磁盘空间。

这些镜像层总是只读的,但是当我们用这个镜像创建一个新的容器时,我们会在它上面添加一个薄的可写层。这个可写层是你创建、修改、删除或进行每个容器所需的其他修改的地方。

写时复制(COW)

当你启动一个容器时,看起来好像这个容器有自己的整个文件系统。这意味着你在系统中运行的每个容器都需要自己的文件系统副本。这岂不是要占用大量的磁盘空间,而且还要花费大量的时间让容器启动?不是的,因为每个容器都不需要它自己的文件系统副本!

容器和镜像使用 写时复制 copy-on-write (COW)机制来实现这一点。写时复制策略不是复制文件,而是将同一个数据实例分享给多个进程,并且只在一个进程需要修改或写入数据时进行复制。所有其他进程将继续使用原始数据。

Docker 对镜像和容器都使用了写时复制的机制。为了做到这一点,在旧版本中,镜像和运行中的容器之间的变化是通过 图驱动 graph driver 来跟踪的,现在则是通过 快照器 snapshotter 来跟踪。

在运行中的容器中执行任何写操作之前,要修改的文件的副本被放在容器的可写层上。这就是发生 写 的地方。现在你知道为什么它被称为“写时复制”了么。

这种策略既优化了镜像磁盘空间的使用,也优化了容器启动时间的性能,并与 UnionFS 一起工作。

叠加文件系统

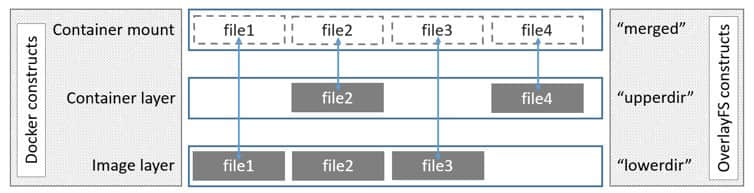
叠加文件系统 Overlay File System 位于现有文件系统的顶部,结合了上层和下层的目录树,并将它们作为一个单一的目录来呈现。这些目录被称为 层 layer 。下层保持不被修改。每一层只增加与下一层的差异(计算机术语为 “diff”),这种统一的过程被称为 联合挂载 union mount 。

最低的目录或镜像层被称为 下层目录 lowerdir ,上面的目录被称为 上层目录 upperdir 。最后的覆盖层或统一层被称为 合并层 merged 。

 title=

常见的术语包括这些层的定义:

  • 基础层 Base layer :是你的文件系统的文件所在的地方。就容器镜像而言,这个层就是你的基础镜像。
  • 叠加层 Overlay layer :通常被称为 容器层 container layer ,因为对运行中的容器所做的所有改变,如添加、删除或修改文件,都会写到这个可写层。对这一层所做的所有修改都存储在下一层,是基础层和差异层的联合视图。
  • 差异层 Diff layer 包含了在叠加层所作的所有修改。如果你写的东西已经在基础层了,那么叠加文件系统就会把文件复制到差异层,并做出你想写的修改。这被称为写时复制。

快照器

通过使用层和图驱动,容器可以将其更改作为其容器文件系统的一部分来构建、管理和分发。但是使用 图驱动 graph driver 的工作真的很复杂,而且容易出错。 快照器 SnapShotter 与图驱动不同,因为它们不用了解镜像或容器。

快照器的工作方式与 Git 非常相似,比如有树的概念,并跟踪每次提交对树的改变。一个 快照 snapshot 代表一个文件系统状态。快照有父子关系,使用一组目录。可以在父级和其快照之间进行差异比较(diff),以创建一个层。

快照器提供了一个用于分配、快照和挂载抽象的分层文件系统的 API。

总结

你现在对什么是容器镜像以及它们的分层方法如何使容器可移植有了很好的认识。接下来,我将介绍容器的运行机制和内部结构。

本文基于 techbeatly 的文章,经许可后改编。


via: https://opensource.com/article/21/8/container-image

作者:Nived V 选题:lujun9972 译者:geekpi 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

使用 ncurses 的灵活性和强大功能在 Linux 上创建一个猜数字游戏。

 title=

在我的 上一篇文章,我简要介绍了使用 ncurses 库通过 C 语言编写文本模式交互式应用程序。使用 ncurses,我们可以控制文本在终端上的显示位置和方式。如果你通过阅读手册页探索 ncurses 库函数,你会发现显示文本有很多不同的方式,包括粗体文本、颜色、闪烁文本、窗口、边框、图形字符和其它功能,这些都可以使你的应用脱颖而出。

如果你想探索一个更高级的程序来演示其中一些有趣的功能,有一个简单的“猜数字”游戏,我已更新为使用 ncurses 编写的了。该程序在一个范围内选择一个随机数,然后要求用户进行重复猜测,直到他们猜到这个秘密数字。当用户进行猜测时,程序会告知他们猜测的数字是太低还是太高。

请注意,程序限定可能的数字范围是 0 到 7。将值保持在有限的个位数数字范围内,可以更轻松的使用 getch() 函数从用户读取单个数字。我还使用了 getrandom 内核系统调用来生成随机数,设定数字最大值为 7,以从 0 (二进制 0000)到 7 (二进制 0111)中选择一个随机数。

#include <curses.h>;
#include <string.h>;          /* for strlen */
#include <sys/random.h>;      /* for getrandom */

int
random0_7()
{
   int num;
   getrandom(&num, sizeof(int), GRND_NONBLOCK);
   return (num & 7); /* from 0000 to 0111 */
}

int
read_guess()
{
  int ch;

  do {
    ch = getch();
  } while ((ch < '0') || (ch > '7'));

  return (ch - '0'); /* turn into a number */
}

通过使用 ncurses,我们可以增加一些有趣的视觉体验。通过添加函数,我们可以在屏幕顶部显示重要的文本信息,在屏幕底部显示状态消息行:

void
print_header(const char *text)
{
  move(0, 0);
  clrtoeol();

  attron(A_BOLD);
  mvaddstr(0, (COLS / 2) - (strlen(text) / 2), text);
  attroff(A_BOLD);
  refresh();
}

void
print_status(const char *text)
{
  move(LINES - 1, 0);
  clrtoeol();
 
  attron(A_REVERSE);
  mvaddstr(LINES - 1, 0, text);
  attroff(A_REVERSE);
  refresh();
}

通过这些函数,我们就可以构建猜数字游戏的主要部分。首先,程序为 ncurses 设置终端,然后从 0 到 7 中选择一个随机数。显示数字刻度后,程序启动一个循环,询问用户的猜测。

当用户进行猜测时,程序会在屏幕上提供反馈。如果猜测太低,程序会在屏幕上的数字下方打印一个左方括号。如果猜测太高,程序会在屏幕上的数字下方打印一个右方括号。这有助于用户缩小他们的选择范围,直到他们猜出正确的数字。

int
main()
{
  int number, guess;

  initscr();
  cbreak();
  noecho();

  number = random0_7();
  mvprintw(1, COLS - 1, "%d", number); /* debugging */

  print_header("Guess the number 0-7");

  mvaddstr(9, (COLS / 2) - 7, "0 1 2 3 4 5 6 7");

  print_status("Make a guess...");

  do {
    guess = read_guess();

    move(10, (COLS / 2) - 7 + (guess * 2));

    if (guess < number) {
      addch('[');
      print_status("Too low");
    }

    else if (guess > number) {
      addch(']');
      print_status("Too high");
    }

    else {
      addch('^');
    }
  } while (guess != number);

  print_header("That's right!");
  print_status("Press any key to quit");
  getch();

  endwin();

  return 0;
}

复制这个程序,自己尝试编译它。不要忘记你需要告诉 GCC 编译器链接到 ncurses 库:

$ gcc -o guess guess.c -lncurses

我留下了一个调试行,所以你可以看到屏幕右上角附近的秘密数字:

guess number game interface

图1:猜数字游戏。注意右上角的秘密数字。

开始使用 ncurses

该程序使用了 ncurses 的许多其它函数,你可以从这些函数开始。例如,print_header 函数在屏幕顶部居中以粗体文本打印消息,print_status 函数在屏幕左下角以反向文本打印消息。使用它来帮助你开始使用 ncurses 编程。


via: https://opensource.com/article/21/8/guess-number-game-ncurses-linux

作者:Jim Hall 选题:lujun9972 译者:perfiffer 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

无论新手老手,这 20 个 Linux 命令都能让你的操作更轻松。

 title=

在黝黑的终端窗口中输入命令,这样的方式对某些人群来说可能好像过时了,但对许多专业计算机人员来说,这几乎是计算机完成能够执行的所有任务的最有效、最简便和最清晰的方式。如今,一些项目将开源命令引入了 macOS 和 Windows 等非开放平台,因此终端命令不仅仅是针对 Linux 和 BSD 用户,更是与每个人都息息相关。你可能会惊讶地发现,在一台普通的 POSIX 计算机上安装了数千个命令,当然,其中很多命令并不是真的有用,至少不是直接或经常性被使用。而其中的一部分命令虽然不是有效终端必须使用的命令,但相比其他命令而言使用频率较高,值得大家学习一下。

以下是终端用户最可能会使用的前 20 个命令:

cd

在终端外,你可以单击图标从一个文件夹移动到另一个文件夹,但在终端中,你需要使用 cd。cd 命令代表 变更目录 change directory ,是用户在 Linux 系统中移动的方式。这是 Linux 中从一个地方到另一个地方最快、最直接的路线。

例如,在桌面上,当你想从你的主目录(你保存所有文件夹的地方)移动到一个名为 presentations 的文件夹时,你首先要打开你的 Documents 文件夹,然后打开一个名叫 work 的文件夹,然后是 projects 文件夹,然后是 conference 文件夹,最后是 presentations 文件夹,里面存放的是 LibreOffice Impress 幻灯片。这个过程包含了很多次的双击操作。同时屏幕上还需要许多鼠标移动动作,这取决于新窗口出现的位置,以及大脑需要跟踪的许多路径点。许多人通过将 所有文件 都放在桌面上来避免这个看似微不足道的任务。

而终端用户只需键入以下内容即可避免此问题:

$ cd ~/Documents/work/projects/conference/presentations

一些有经验的终端用户甚至都懒得输入所有这些,而是使用 Tab 键自动完成单词填充。更甚者,有时你都不必依赖自动完成,而是改用通配符:

$ cd ~/Doc*/work/*/conf*/p*

pwd

用 Buckaroo Banzai 的话来说:“无论你走到哪里,你就在那里。”

当你想弄清楚确切位置时,就可以使用 pwd 命令。pwd 代表 打印工作目录 print working directory ,这正是它的作用。--physical(在某些情况时缩写为 -P)显示解析所有符号链接后的确切位置。

$ pwd
/home/tux/presentation

$ pwd --physical
/home/tux/Documents/work/projects/conference/presentations

sed

流编辑器 sed 更广为人知的是一个强大的批量 查找和替换 命令,但它同时也是一个正当合理的文本编辑器。你可以通过阅读我的 介绍性文章 来学习使用它,然后通过我的 高级教程和备忘录 成为老手。

grep

grep 命令使用很普遍,以至于经常被用作动词(例如 “我会对一些文件进行 grep”)和动名词(例如 “grep 一些输出”)。无论是查看日志文件还是解析其他命令的输出,它都是在 shell 中解析文本时的关键组件。这是忙碌的用户专注于特定信息的一种方式。考虑一下计算世界中的数据量,grep 命令的流行就见怪不怪了。你可以通过阅读我的 介绍性文章 了解 grep,然后下载 备忘录 学习。

file

当你需要知道文件包含什么类型的数据时,请使用 file 命令:

$ file example.foo
example.foo: RIFF (little-endian) data, Web/P image [...]

$ file example.bar
example.bar: ELF 64-bit LSB executable, x86-64 [...]

当然,file 命令并不神奇。它只不过是根据文件如何标识自身而进行输出的,并且文件可能是错误的、损坏的或伪装的。使用 hexdump 进行严格检查的方式确定性更强,但对于日常使用而言,file 命令非常方便。

awk

awk 不仅仅是一个命令,它还是一种字面意义上的 编程语言。点此下载我们的免费 Awk 电子书 进行学习,你可能会写出远超你想象的脚本。

curl

curl 命令是用于终端的 非交互式 Web 浏览器。它是面向 Web 和 API 开发人员的 开发工具。它是一个复杂灵活的命令,但如果你想从你的终端顺利地与 Web 服务交互,该命令是很值得学习的。

下载我们免费的 curl 备忘录,你可以从中学会 curl 的许多选项。

ps

管理系统资源主要由内核负责,当你更喜欢或更需要手动管理时,可以使用 ps 命令。读者可以在我的 使用 procps-ng 监控 Linux 系统 文章中了解 ps。

cat

cat 命令 是 连接 concatenate 的缩写,它曾因为能将若干小文件合并而显得非常有用,这些小文件可能是由于大小限制而(使用 split 命令)拆分的。如今,cat 主要是用来将文本文件的内容转储到终端中以供快速阅读,除非你为此专门去使用 head、tail、more 或 less 等命令。

尽管它的原始用途几乎已被弃用,并且其他几个命令也主要提供了其次要功能,但 cat 仍然是一个有用的工具。例如,它可以是复制(cp)命令的替代品:

$ cat myfile.ogg > /backups/myfile.ogg

它可以显示文件中不便观察的隐形字符。例如,使用 --show-tabs 选项,分割 YAML 的 Tab 字符就会显示为 ^I:

$ cat --show-tabs my.yaml

---

- hosts: all
  tasks:
  - name: Make sure the current version of 'sysstat' is installed.
    dnf:
     name:
^I- sysstat
^I- httpd
^I- mariadb-server
     state: latest

它还可以用 --show-nonprinting 显示非打印字符,用 --show-ends 标记行尾,用 --number 提供行号,等等。

find

find 命令可以用来查找文件,但它还有许多选项,这些选项可以帮助你通过各种过滤器和参数查找文件。读者可以从我的 介绍性文章 中学习该命令的基础知识。

如果你一直想知道为什么最基本的、不起眼的 ls 命令,不在本文列表中,那是因为 find 的灵活性。它不仅可以列表文件:

$ find .
./bar.txt
./baz.xml
./foo.txt
[...]

它还可以提供包含详细信息的长列表功能:

$ find . -ls
3014803  464 -rw-rw-r--   1 tux users  473385 Jul 26 07:25 ./foo.txt
3014837  900 -rwxrwxr-x   1 tux users  918217 Nov  6  2019 ./baz.xml
3026891  452 -rw-rw-r--   1 tux users  461354 Aug 10 13:41 ./foo.txt
[...]

这是一个技术问题,但也是很一个巧妙的技巧。

tar

人们有时会引用 BSD 的 tar 语法来拿 Linux 命令开玩笑。尽管有这样的名声,但 tar 命令实际上非常直观。读者可以阅读我的 如何解压缩 tar.gz 文件 文章,了解在需要时使用 tar 命令的简单知识。

more、less 和 most

这些统称为分页命令。分页命令与 cat 类似,但前者会在屏幕底部暂停输出,直到你向下滚动查看更多内容。这些命令比较简单,但每个之间都有细微差别。用户是用箭头键还是空格键滚动?是必须手动退出,还是在显示的文件末尾自动退出?用户的首选搜索行为是什么样的?选择你最喜欢的分页命令并将其设置在 .bashrc 中吧!

ssh 和 scp

OpenSSH 不仅有助于保护与远程系统的连接安全,还可以用于启用其他命令。例如,对于许多用户来说,有了 .ssh 目录,他们才能与 Git 存储库顺利交互、将更新发布到网站、登录云控制平台。

mv

mv 命令有双重作用:它既可以 移动文件 又可以 重命名文件。它有几个可用的保护措施,例如 --interactive 和 --no-clobber 选项避免破坏现有文件,--backup 命令确保数据在新位置验证之前被保留,以及 --update 选项确保旧版本不会替换新版本文件。

sudo

当某个用户账户的用户名已知,且具有 全部 系统权限时,该用户很快就会成为黑客攻击的目标。sudo 命令消除了对字面上 root 用户的需求,从而优雅地移除了有关系统的重要信息。不过这还不是全部,使用 sudo 你还可以轻松地管理单个命令、用户和组的权限。你可以在选定的命令上启用无密码执行、记录用户会话、使用摘要验证来验证命令,等等。

alias

使用 alias 命令将长命令变成易于记忆的快捷方式:

$ alias ls='ls --classify --almost-all --ignore-backups --color'

clear

有时终端会显得很混乱,输入 clear(或在某些 shell 中按 Ctrl+L)后,你就能得到漂亮、刷新的屏幕了。

setfacl

传统上,POSIX 文件权限由 chown 和 chmod 决定。然而,如今系统变得更加复杂,因此有一个灵活性更高的命令。setfacl 命令允许创建一个 访问控制列表(ACL),可以配置任意用户所需权限,并可以为文件夹及其中创建的内容设置默认权限。

netcat

可能需要使用 netcat(nc)的人不多,但这些使用它的人确离不开它。nc 命令是一个通用的网络连接工具。

它可以连接到一个端口,类似于 telnet 命令:

$ nc -u 192.168.0.12 80

它可以 ping 一个端口,类似于 ping 命令:

$ nc -zvn 192.168.0.12 25

它可以探测开放端口,类似于 nmap 命令:

$ nc -zv 192.168.0.12 25-80

以上仅是该命令的一小部分用途。

你自己构建的命令

在某种程度上,Linux 终端是一个创造性解决问题的平台。当你学习命令时,你也在学习可用于创建自己的命令的组块。我的 shell 历史 中的许多命令都是自己编写的 shell 脚本,从而实现了根据自己想要的工作方式定制工作流程。你为自己的效率和舒适度而设计的命令也可以作为 shell 中的基本命令。花些时间了解一些很棒的命令,然后试着构建自己的命令吧。当你构建出的命令非常好用时,把它开源,这样就可以与他人分享你的想法啦!


via: https://opensource.com/article/21/9/essential-linux-commands

作者:Seth Kenlon 选题:lujun9972 译者:unigeorge 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出