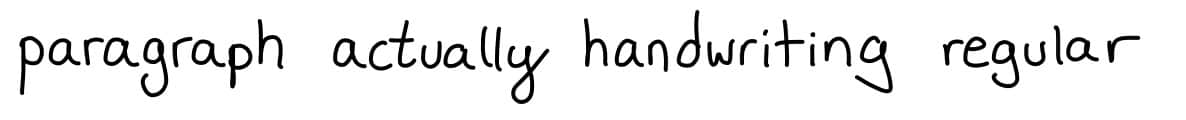Julia Evans 发布的文章

这又是一篇关于我很喜欢的一个命令行工具的文章。

昨晚,出于官僚原因,我需要扫描一些文档。我以前从来没有在 Linux 上使用过扫描仪,我担心会花上好几个小时才弄明白。我从使用 gscan2pdf 开始,但在用户界面上遇到了麻烦。我想同时扫描两面(我知道我们的扫描仪支持),但无法使它工作。

遇到 scanimage!

scanimage 是一个命令行工具,在 sane-utils Debian 软件包中。我想所有的 Linux 扫描工具都使用 sane (“scanner access now easy”) 库,所以我猜测它和其他扫描软件有类似的能力。在这里,我不需要 OCR,所以我不打算谈论 OCR。

用 scanimage -L 得到你的扫描仪的名字

scanimage -L 列出了你所有的扫描设备。

一开始我不能让它工作,我有点沮丧,但事实证明,我把扫描仪连接到了我的电脑上,但没有插上电源。

插上后,它马上就能工作了。显然我们的扫描仪叫 fujitsu:ScanSnap S1500:2314。万岁!

用 --help 列出你的扫描仪选项

显然每个扫描仪有不同的选项(有道理!),所以我运行这个命令来获取我的扫描仪的选项:

scanimage --help -d 'fujitsu:ScanSnap S1500:2314'

我发现我的扫描仪支持 --source 选项(我可以用它来启用双面扫描)和 --resolution 选项(我把它改为 150,以减少文件大小,使扫描更快)。

scanimage 不支持输出 PDF 文件(但你可以写一个小脚本)

唯一的缺点是:我想要一个 PDF 格式的扫描文件,而 scanimage 似乎不支持 PDF 输出。

所以我写了这个 5 行的 shell 脚本在一个临时文件夹中扫描一堆 PNG 文件,并将结果保存到 PDF 中。

#!/bin/bash
set -e

DIR=`mktemp -d`
CUR=$PWD
cd $DIR
scanimage -b --format png  -d 'fujitsu:ScanSnap S1500:2314' --source 'ADF Front' --resolution 150
convert *.png $CUR/$1

我像这样运行脚本:scan-single-sided output-file-to-save.pdf

你可能需要为你的扫描仪设置不同的 -d 和 -source。

这真是太简单了!

我一直以为在 Linux 上使用打印机/扫描仪是一个噩梦,我真的很惊讶 scanimage 可以工作。我可以直接运行我的脚本 scan-single-sided receipts.pdf,它将扫描文档并将其保存到 receipts.pdf!


via: https://jvns.ca/blog/2020/07/11/scanimage--scan-from-the-command-line/

作者:Julia Evans 选题:lujun9972 译者:geekpi 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

今天,我开始了一个 Recurse Center 的班次学习!我认识了一些人,并开始了一个小小的有趣的 Rails 项目。我想我今天不会谈太多关于这个项目的实际内容,但这里有一些关于 Rails 一天的快速笔记。

一些关于开始的笔记

在建立 Rails 项目的过程中,我学到的主要是:

  1. 它默认使用 sqlite,你必须告诉它使用 Postgres。
  2. Rails 默认包含了大量的东西,你可以禁用。

我安装并 rm -rf Rails 大概 7 次后才满意,最后用了这个咒语:

rails new . -d postgresql --skip-sprockets --skip-javascript

主要是因为我想用 Postgres 而不是 sqlite,而且跳过 sprockets 和 javascript 似乎能让安装 Rails 的速度更快,而且我想如果我决定要它们的话,我可以在以后再安装。

官方的 Rails 指南真的很不错

我在创建我的 Rails 入门应用时主要参考了 2 个资源:

一个神秘的错误信息:undefined method 'user'

我喜欢 bug,所以今天我遇到了一个奇怪的 Rails 错误! 我有一些看起来像这样的代码:

@user = User.new(user_params)
@user.save

很简单吧?但当这段代码运行时,我得到了这个令人费解的错误信息:

undefined method `user' for #<User:0x00007fb6f4012ab8> Did you mean? super

我对这里发生的事情感到超级困惑,因为我没有调用一个叫做 user 的方法。我调用的是 .save。什么嘛?!我对此感到困惑和沮丧,大概呆了 20 分钟,最后我看了看我的 User 模型,发现了这段代码:

class User < ApplicationRecord
  has_secure_password

  validates :user, presence: true, uniqueness: true
end

validates :user... 应该是一些 Rails 魔法,验证每个 User 都有一个 username,而且用户名必须是唯一的。但我犯了一个错,我写的是 user 而不是 username。我把这个问题解决了,然后一切都正常了!万岁。

我仍然不明白我应该如何调试这个问题:堆栈跟踪告诉我问题出在 @user.save 行,根本没有提到 validates :user 的事情。我觉得一定有办法调试这个问题,但我不知道是什么办法。

我学 Rails 的目的就是想看看 Rails 的魔力在实践中是如何发挥的,所以这是个很有意思的 bug,早早的就掉坑里了。

一个简单的用户管理系统

我决定在我的玩具应用中加入用户。我在网上搜索了一下,发现有一个非常流行的叫做 devise 的工具可以处理用户。我发现它的 README 有点让人不知所措,而且我知道想要在我的玩具应用中建立一个非常简陋的用户管理系统,所以我遵循了这个名为《Rails 5.2 中从零开始进行用户验证》的指南,到目前为止,这个指南似乎还不错。Rails 似乎已经有了一大堆管理用户的内置东西,我真的很惊讶于这本指南的短小和我需要写的代码之少。

我在实现用户功能的时候了解到,Rails 有一个内置的神奇的会话管理系统(参见 Rails 会话如何工作。默认情况下,所有的会话数据似乎都存储在用户电脑上的 cookie 中,不过我想如果 cookie 太大了,你也可以把会话数据存储在数据库中。

已经有了会话管理系统,有了 cookie 和用户,却不太清楚到底发生了什么,这肯定是有点奇怪的,但也是挺好玩的!我们会看看情况如何。我们将拭目以待。

明天:更多的 Rails!

也许明天我可以在实现我的有趣的 rails 应用的想法上取得一些进展!


via: https://jvns.ca/blog/2020/11/09/day-1--a-little-rails-/

作者:Julia Evans 选题:lujun9972 译者:wxy 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出
大家好!每隔一段时间,我就会发现一款我非常喜欢的新软件,今天我想说说我最近喜欢的一款软件:ninja!

增量构建很有用

我做了很多小项目,在这些项目中,我想设置增量构建。例如,现在我正在写一本关于 bash 的杂志,杂志的每一页都有一个 .svg文件。我需要将 SVG 转换为 PDF,我的做法是这样的:

for i in *.svg
do
    svg2pdf $i $i.pdf # or ${i/.svg/.pdf} if you want to get really fancy
done

这很好用,但是我的 svg2pdf 脚本有点慢(它使用 Inkscape),而且当我刚刚只更新了一页的时候,必须等待 90 秒或者其他什么时间来重建所有的 PDF 文件,这很烦人。

构建系统是让人困惑的

在过去,我对使用 make 或 bazel 这样的构建系统来做我的小项目一直很反感,因为 bazel 是个大而复杂的东西,而 make 对我来说感觉有点神秘。我真的不想使用它们中的任何一个。

所以很长时间以来,我只是写了一个 bash 脚本或者其他的东西来进行构建,然后就认命了,有时候只能等一分钟。

ninja 是一个极其简单的构建系统

但 ninja 并不复杂!以下是我所知道的关于 ninja 构建文件的语法:创建一个 rule 和一个 build:

rule 有一个命令(command)和描述(description)参数(描述只是给人看的,所以你可以知道它在构建你的代码时在做什么)。

rule svg2pdf
  command = inkscape $in --export-text-to-path --export-pdf=$out
  description = svg2pdf $in $out

build 的语法是 build output_file: rule_name input_files。下面是一个使用 svg2pdf 规则的例子。输出在规则中的 $out 里,输入在 $in 里。

build pdfs/variables.pdf: svg2pdf variables.svg

这就完成了!如果你把这两个东西放在一个叫 build.ninja 的文件里,然后运行 ninja,ninja 会运行 inkscape variables.svg --export-text-to-path --export-pdf=pdfs/variables.pdf。然后如果你再次运行它,它不会运行任何东西(因为它可以告诉你已经构建了 pdfs/variables.pdf,而且是最新的)。

Ninja 还有一些更多的功能(见手册),但我还没有用过。它最初是为 Chromium 构建的,所以即使只有一个小的功能集,它也能支持大型构建。

ninja 文件通常是自动生成的

ninja 的神奇之处在于,你不必使用一些混乱的构建语言,它们很难记住,因为你不经常使用它(比如 make),相反,ninja 语言超级简单,如果你想做一些复杂的事情,那么你只需使用任意编程语言生成你想要的构建文件。

我喜欢写一个 build.py 文件,或者像这样的文件,创建 ninja 的构建文件,然后运行 ninja:

with open('build.ninja', 'w') as ninja_file:
    # write some rules
    ninja_file.write("""
rule svg2pdf
  command = inkscape $in --export-text-to-path --export-pdf=$out
  description = svg2pdf $in $out
""")

    # some for loop with every file I need to build
    for filename in things_to_convert:
        ninja_file.write(f"""
build {filename.replace('svg', 'pdf')}: svg2pdf {filename}
""")

# run ninja
import subprocess
subprocess.check_call(['ninja'])

我相信有一堆 ninja 的最佳实践,但我不知道。对于我的小项目而言,我发现它很好用。

meson 是一个生成 ninja 文件的构建系统

我对 Meson 还不太了解,但最近我在构建一个 C 程序 (plocate,一个比 locate 更快的替代方案)时,我注意到它有不同的构建说明,而不是通常的 ./configure; make; make install:

meson builddir
cd builddir
ninja

看起来 Meson 是一个可以用 ninja 作为后端的 C/C++/Java/Rust/Fortran 构建系统。

就是这些!

我使用 ninja 已经有几个月了。我真的很喜欢它,而且它几乎没有给我带来让人头疼的构建问题,这让我感觉非常神奇。


via: https://jvns.ca/blog/2020/10/26/ninja--a-simple-way-to-do-builds/

作者:Julia Evans 选题:lujun9972 译者:geekpi 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

其实我对这个实验的结果并不是特别满意,但我还是想分享一下,因为摆弄字体是件非常简单和有趣的事情。而且有人问我怎么做,我告诉她我会写一篇博文来介绍一下 :smiley:

背景:原本的手写体

先交代一些背景信息:我有一个我自己的手写字体,我已经在我的电子杂志中使用了好几年了。我用一个叫 iFontMaker 的令人愉快的应用程序制作了它。他们在网站上自诩为“你可以在 5 分钟内只用手指就能制作出你的手工字体”。根据我的经验,“5 分钟”的部分比较准确 —— 我可能花了更多的时间,比如 15 分钟。我对“只用手指”的说法持怀疑态度 —— 我用的是 Apple Pencil,它的精确度要好得多。但是,使用该应用程序制作你的笔迹的 TTF 字体是非常容易的,如果你碰巧已经有了 Apple Pencil 和 iPad,我认为这是一个有趣的方式,我只花了 7.99 美元。

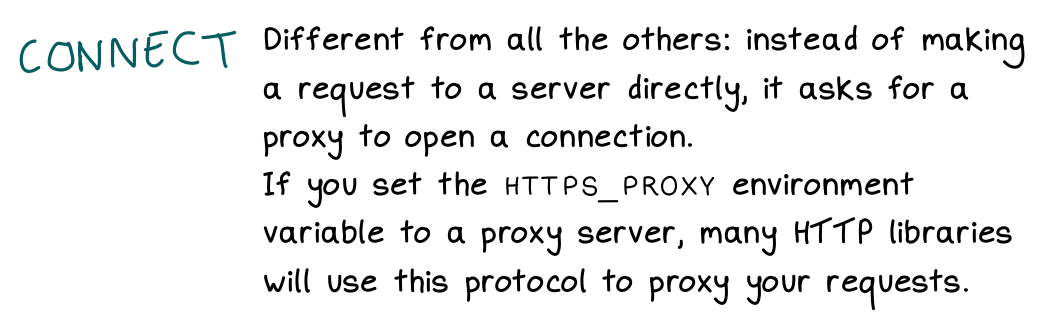
下面是我的字体的样子。左边的“CONNECT”文字是我的实际笔迹,右边的段落是字体。其实有 2 种字体 —— 有一种是普通字体,一种是手写的“等宽”字体。(其实实际并不是等宽,我还没有想好如何在 iFontMaker 中制作一个实际的等宽字体)

目标:在字体上做更多的字符变化

在上面的截图中,很明显可以看出这是一种字体,而不是实际的笔迹。当你有两个相同的字母相邻时,就最容易看出来,比如“HTTP”。

所以我想,使用一些 OpenType 的功能,以某种方式为这个字体引入更多的变化,比如也许两个 “T” 可以是不同的。不过我不知道该怎么做!

来自 Tristan Hume 的主意:使用 OpenType!

然后我在 5 月份的 !!Con 2020 上(所有的演讲录音都在这里!)看到了 Tristan Hume 的这个演讲:关于使用 OpenType 通过特殊的字体将逗号插入到大的数字中。他的演讲和博文都很棒,所以这里有一堆链接 —— 下面现场演示也许是最快看到他的成果的方式。

基本思路:OpenType 允许你根据上下文替换字符

我一开始对 OpenType 到底是什么非常困惑。目前我仍然不甚了然,但我知道到你可以编写极其简单的 OpenType 规则来改变字体的外观,而且你甚至不需要真正了解字体。

下面是一个规则示例:

sub a' b by other_a;

这里 sub a' b by other_a; 的意思是:如果一个 a 字形是在一个 b 之前,那么替换 a 为字形 other_a。

所以这意味着我可以让 ab 和 ac 在字体中出现不同的字形。这并不像手写体那样随机,但它确实引入了一点变化。

OpenType 参考文档:真棒

我找到的最好的 OpenType 文档是这个 OpenType™ 特性文件规范 资料。里面有很多你可以做的很酷的事情的例子,比如用一个连字替换 “ffi”。

如何应用这些规则:fonttools

为字体添加新的 OpenType 规则是超容易的。有一个 Python 库叫 fonttools,这 5 行代码会把放在 rules.fea 中的 OpenType 规则列表应用到字体文件 input.ttf 中。

from fontTools.ttLib import TTFont
from fontTools.feaLib.builder import addOpenTypeFeatures

ft_font = TTFont('input.ttf')
addOpenTypeFeatures(ft_font, 'rules.fea', tables=['GSUB'])
ft_font.save('output.ttf')

fontTools 还提供了几个名为 ttx 和 fonttools 的命令行工具。ttx 可以将 TTF 字体转换为 XML 文件,这对我很有用,因为我想重新命名我的字体中的一些字形,但我对字体一无所知。所以我只是将我的字体转换为 XML 文件,使用 sed 重命名字形,然后再次使用 ttx 将 XML 文件转换回 ttf。

fonttools merge 可以让我把我的 3 个手写字体合并成 1 个,这样我就在 1 个文件中得到了我需要的所有字形。

代码

我把我的极潦草的代码放在一个叫 font-mixer 的存储库里。它大概有 33 行代码,我认为它不言自明。(都在 run.sh 和 combine.py 中)

结果

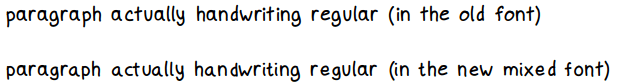
下面是旧字体和新字体的小样。我不认为新字体的“感觉”更像手写体 —— 有更多的变化,但还是比不上实际的手写体文字(在下面)。

我觉得稍微有点不可思议,它明明还是一种字体,但它却要假装成不是字体:

而这是实际手写的同样的文字的样本:

如果我在制作另外 2 种手写字体的时候,把原来的字体混合在一起,再仔细一点,可能效果会更好。

添加 OpenType 规则这么容易,真酷!

这里最让我欣喜的是,添加 OpenType 规则来改变字体的工作方式是如此的容易,比如你可以很容易地做出一个“the”单词总是被“teh”代替的字体(让错别字一直留着!)。

不过我还是不知道如何做出更逼真的手写字体:)。我现在还在用旧的那个字体(没有额外的变化),我对它很满意。


via: https://jvns.ca/blog/2020/08/08/handwritten-font/

作者:Julia Evans 选题:lujun9972 译者:wxy 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出
这是一篇简短的文章。我是最近才发现 entr 的,我很惊奇从来没有人告诉过我?!因此,如果你和我一样,那么我告诉你它是什么。

entr 的网站上对它已经有很好的解释,也有很多示例。

总结在其头部:entr 是一个命令行工具,当每次更改一组指定文件中的任何一个时,都能运行一个任意命令。你在标准输入给它传递要监控的文件列表,如下所示:

git ls-files | entr bash my-build-script.sh

或者

find . -name *.rs | entr cargo test

或者任何你希望的。

快速反馈很棒

就像世界上的每个程序员一样,我发现每次更改代码时都必须手动重新运行构建/测试非常烦人。

许多工具(例如 hugo 和 flask)都有一个内置的系统,可以在更改文件时自动重建,这很棒!

但是通常我会自己编写一些自定义的构建过程(例如 bash build.sh),而 entr 让我有了一种神奇的构建经验,我只用一行 bash 就能得到即时反馈,知道我的改变是否修复了那个奇怪的 bug。万岁!

重启服务器(entr -r)

但是如果你正在运行服务器,并且每次都需要重新启动服务器怎么办?如果你传递 -r,那么 entr 会帮你的

git ls-files | entr -r python my-server.py

清除屏幕(entr -c)

另一个简洁的标志是 -c,它让你可以在重新运行命令之前清除屏幕,以免被前面构建的输出分散注意力。

与 git ls-files 一起使用

通常,我要跟踪的文件集和我在 git 中的文件列表大致相同,因此将 git ls-files 传递给 entr 是很自然的事情。

我现在有一个项目,有时候我刚创建的文件还没有在 git 里。那么如果你想包含未被跟踪的文件怎么办呢?这些 git 命令行参数就可以做到(我是从一个读者的邮件中得到的,谢谢你!):

git ls-files -cdmo --exclude-standard  | entr your-build-script

有人给我发了邮件,说他们做了一个 git-entr 命令,可以执行:

git ls-files -cdmo --exclude-standard | entr -d "$@"

我觉得这真是一个很棒的主意。

每次添加新文件时重启:entr -d

git ls-files 的另一个问题是有时候我添加一个新文件,当然它还没有在 git 中。entr 为此提供了一个很好的功能。如果你传递 -d,那么如果你在 entr 跟踪的任何目录中添加新文件,它就会退出。

我将它与一个 while 循环配合使用,它将重启 entr 来包括新文件,如下所示:

while true
do
{ git ls-files; git ls-files . --exclude-standard --others; } | entr -d your-build-scriot
done

entr 在 Linux 上的工作方式:inotify

在 Linux 中,entr 使用 inotify(用于跟踪文件更改这样的文件系统事件的系统)工作。如果用 strace 跟踪它,那么你会看到每个监控文件的 inotify_add_watch 系统调用,如下所示:

inotify_add_watch(3, "static/stylesheets/screen.css", IN_ATTRIB|IN_CLOSE_WRITE|IN_CREATE|IN_DELETE_SELF|IN_MOVE_SELF) = 1152

就这样了

我希望这可以帮助一些人了解 entr!


via: https://jvns.ca/blog/2020/06/28/entr/

作者:Julia Evans 选题:lujun9972 译者:geekpi 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出
在编辑“容器如何工作”爱好者杂志的能力页面时,我想试着解释一下为什么 strace 在 Docker 容器中无法工作。

这里的问题是 —— 如果我在笔记本上的 Docker 容器中运行 strace,就会出现这种情况:

$ docker run  -it ubuntu:18.04 /bin/bash
$ # ... install strace ...
[email protected]:/# strace ls
strace: ptrace(PTRACE_TRACEME, ...): Operation not permitted

strace 通过 ptrace 系统调用起作用,所以如果不允许使用 ptrace,它肯定是不能工作的! 这个问题很容易解决 —— 在我的机器上,是这样解决的:

docker run --cap-add=SYS_PTRACE  -it ubuntu:18.04 /bin/bash

但我对如何修复它不感兴趣,我想知道为什么会出现这种情况。为什么 strace 不能工作,为什么--cap-add=SYS_PTRACE 可以解决这个问题?

假设 1:容器进程缺少 CAP_SYS_PTRACE 能力。

我一直以为原因是 Docker 容器进程默认不具备 CAP_SYS_PTRACE 能力。这和它可以被 --cap-add=SYS_PTRACE 修复是一回事,是吧?

但这实际上是不合理的,原因有两个。

原因 1:在实验中,作为一个普通用户,我可以对我的用户运行的任何进程进行 strace。但如果我检查我的当前进程是否有 CAP_SYS_PTRACE 能力,则没有:

$ getpcaps $$
Capabilities for `11589': =

原因 2:capabilities 的手册页对 CAP_SYS_PTRACE 的介绍是:

CAP_SYS_PTRACE
       * Trace arbitrary processes using ptrace(2);

所以,CAP_SYS_PTRACE 的作用是让你像 root 一样,可以对任何用户拥有的任意进程进行 ptrace。你不需要用它来对一个只是由你的用户拥有的普通进程进行 ptrace 。

我用第三种方法测试了一下(LCTT 译注:此处可能原文有误) —— 我用 docker run --cap-add=SYS_PTRACE -it ubuntu:18.04 /bin/bash 运行了一个 Docker 容器,去掉了 CAP_SYS_PTRACE 能力,但我仍然可以跟踪进程,虽然我已经没有这个能力了。什么?为什么?!

假设 2:关于用户命名空间的事情?

我的下一个(没有那么充分的依据的)假设是“嗯,也许这个过程是在不同的用户命名空间里,而 strace 不能工作,因为某种原因而行不通?”这个问题其实并不相关,但这是我观察时想到的。

容器进程是否在不同的用户命名空间中?嗯,在容器中:

root@e27f594da870:/# ls /proc/$$/ns/user -l
... /proc/1/ns/user -> 'user:[4026531837]'

在宿主机:

bork@kiwi:~$ ls /proc/$$/ns/user -l
... /proc/12177/ns/user -> 'user:[4026531837]'

因为用户命名空间 ID(4026531837)是相同的,所以容器中的 root 用户和主机上的 root 用户是完全相同的用户。所以,绝对没有理由不能够对它创建的进程进行 strace!

这个假设并没有什么意义,但我(之前)没有意识到 Docker 容器中的 root 用户和主机上的 root 用户同一个,所以我觉得这很有意思。

假设 3:ptrace 系统的调用被 seccomp-bpf 规则阻止了

我也知道 Docker 使用 seccomp-bpf 来阻止容器进程运行许多系统调用。而 ptrace 在被 Docker 默认的 seccomp 配置文件阻止的系统调用列表中!(实际上,允许的系统调用列表是一个白名单,所以只是ptrace 不在默认的白名单中。但得出的结果是一样的。)

这很容易解释为什么 strace 在 Docker 容器中不能工作 —— 如果 ptrace 系统调用完全被屏蔽了,那么你当然不能调用它,strace 就会失败。

让我们来验证一下这个假设 —— 如果我们禁用了所有的 seccomp 规则,strace 能在 Docker 容器中工作吗?

$ docker run --security-opt seccomp=unconfined -it ubuntu:18.04  /bin/bash
$ strace ls
execve("/bin/ls", ["ls"], 0x7ffc69a65580 /* 8 vars */) = 0
... it works fine ...

是的,很好用!很好。谜底解开了,除了…..

为什么 --cap-add=SYS_PTRACE 能解决问题?

我们还没有解释的是:为什么 --cap-add=SYS_PTRACE 可以解决这个问题?

docker run 的手册页是这样解释 --cap-add 参数的。

--cap-add=[]
   Add Linux capabilities

这跟 seccomp 规则没有任何关系! 怎么回事?

我们来看看 Docker 源码

当文档没有帮助的时候,唯一要做的就是去看源码。

Go 语言的好处是,因为依赖关系通常是在一个 Go 仓库里,你可以通过 grep 来找出做某件事的代码在哪里。所以我克隆了 github.com/moby/moby,然后对一些东西进行 grep,比如 rg CAP_SYS_PTRACE。

我认为是这样的。在 containerd 的 seccomp 实现中,在 contrib/seccomp/seccomp/seccomp\_default.go 中,有一堆代码来确保如果一个进程有一个能力,那么它也会(通过 seccomp 规则)获得访问权限,以使用与该能力相关的系统调用。

case "CAP_SYS_PTRACE":
       s.Syscalls = append(s.Syscalls, specs.LinuxSyscall{
           Names: []string{
               "kcmp",
               "process_vm_readv",
               "process_vm_writev",
               "ptrace",
           },
           Action: specs.ActAllow,
           Args:   []specs.LinuxSeccompArg{},
       })

在 moby 中的 profile/seccomp/seccomp.go 和 默认的 seccomp 配置文件中,也有一些其他的代码似乎做了一些非常类似的事情,所以有可能就是这个代码在做这个事情。

所以我想我们有答案了!

Docker 中的 --cap-add 做的事情比它说的要多

结果似乎是,--cap-add 并不像手册页里说的那样,它更像是 --cap-add-and-also-whiteelist-some-extra-system-calls-if-required。这很有意义! 如果你具有一个像 --CAP_SYS_PTRACE 这样的能力,可以让你使用 process_vm_readv 系统调用,但是该系统调用被 seccomp 配置文件阻止了,那对你没有什么帮助!

所以当你给容器 CAP_SYS_PTRACE 能力时,允许使用 process_vm_readv 和 ptrace 系统调用似乎是一个合理的选择。

就这样!

这是个有趣的小事情,我认为这是一个很好的例子,说明了容器是由许多移动的部件组成的,它们以不完全显而易见的方式一起工作。


via: https://jvns.ca/blog/2020/04/29/why-strace-doesnt-work-in-docker/

作者:Julia Evans 选题:lujun9972 译者:wxy 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出