Jim Hall 发布的文章

使用我最喜欢的工具在 Linux 上截屏,可以节省时间。

在写开源软件时,我更喜欢展示一些截图来帮助演示我在说什么。古语有云,一图胜千言。如果你能展示一件事,那通常比试图用言语描述它要好。

有几种方法可以在 Linux 中截图。以下是我在 Linux 上用于捕获截图的三种方法:

1、GNOME

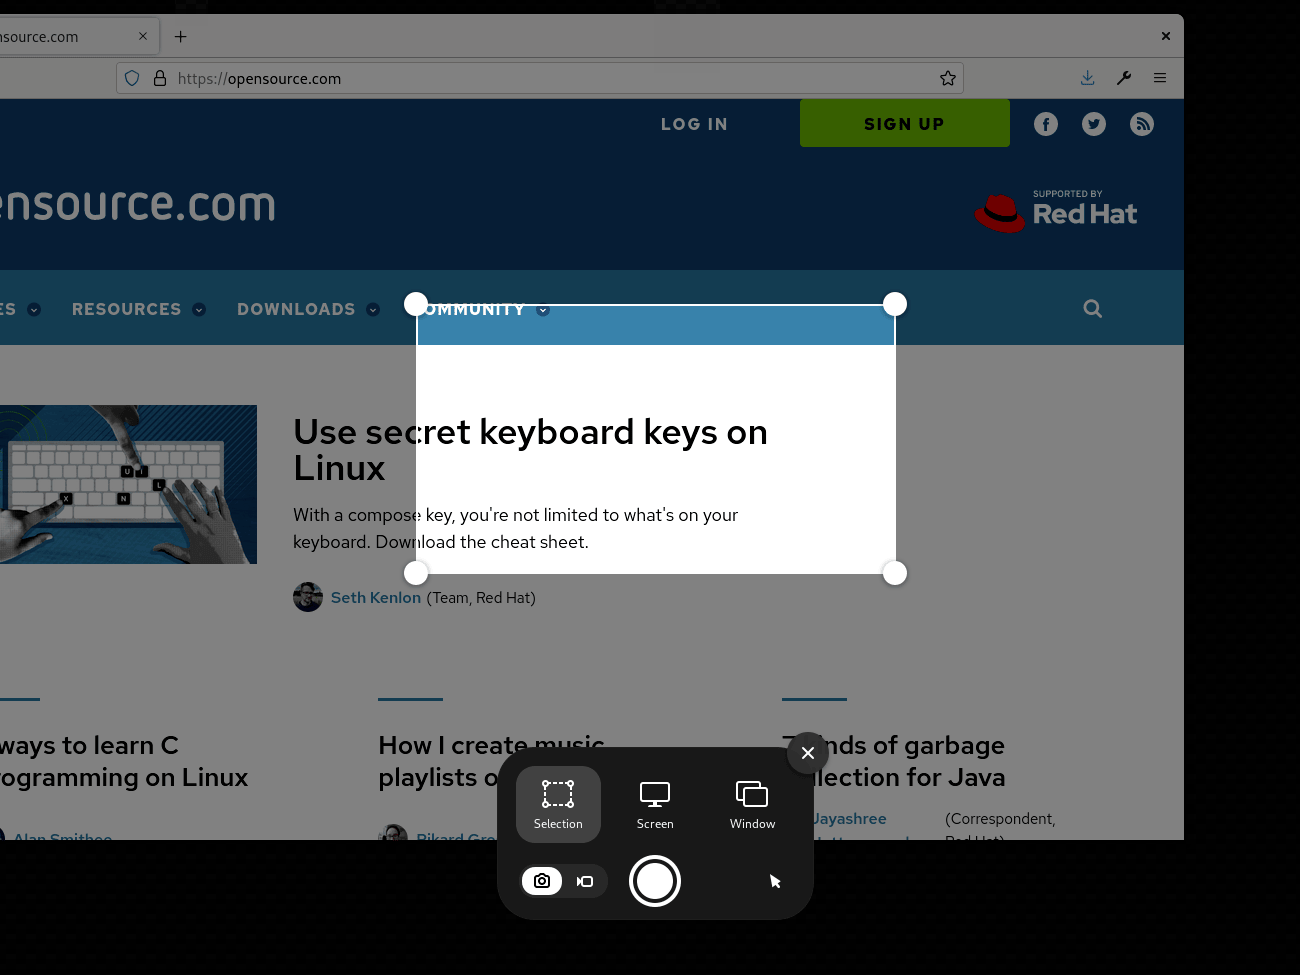
GNOME 有一个很棒的内置截图工具。只需按下键盘上的 PrtScr 键,GNOME 就会显示一个截图对话框:

Image of GNOME screenshot tool

默认操作是抓取区域的截图。这是一种在你制作截图时裁剪截图的非常有用的方法。只需将高亮显示框移动到你需要的位置,然后使用“抓取”角来更改大小。或选择其他图标之一以截取整个屏幕或系统上的单个窗口。点击“圆圈”图标进行截图,类似于手机上的“拍照”按钮。 GNOME 截图工具将截图保存在图片文件夹内的截图文件夹中。

2、GIMP

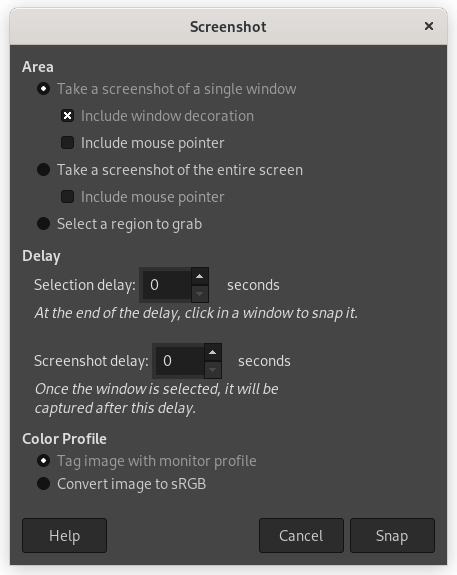
如果你需要更多截图选项,你可以使用流行的图像编辑器 GIMP 截图。要进行截图,请选择“ 文件 File ”并选择“ 创建 Create ”子菜单,然后选择“ 截图 Screenshot ”。

Image of the GIMP screenshot menu

该对话框允许你截取单个窗口、整个屏幕或仅一个区域的屏幕截图。我喜欢这个工具可以让你设置一个延迟:选择窗口后多长时间,按下截图后多长时间。当我想截取菜单操作的截图时,我经常使用此功能,因此我有足够的时间去窗口打开菜单。

GIMP 将截图作为新图像打开,你可以对其进行编辑并保存到你喜欢的位置。

3、Firefox

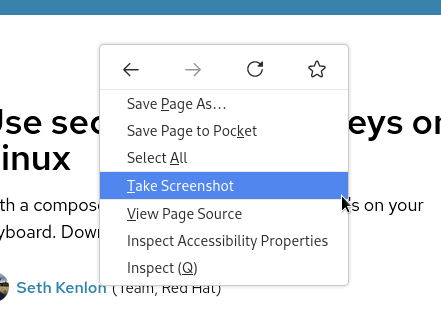
如果你需要截取网站的截图,请尝试使用 Firefox 的内置截图程序。右键单击网页正文中的任意位置,然后从菜单中选择“ 截图 Take Screenshot ”:

Image of screenshot utility

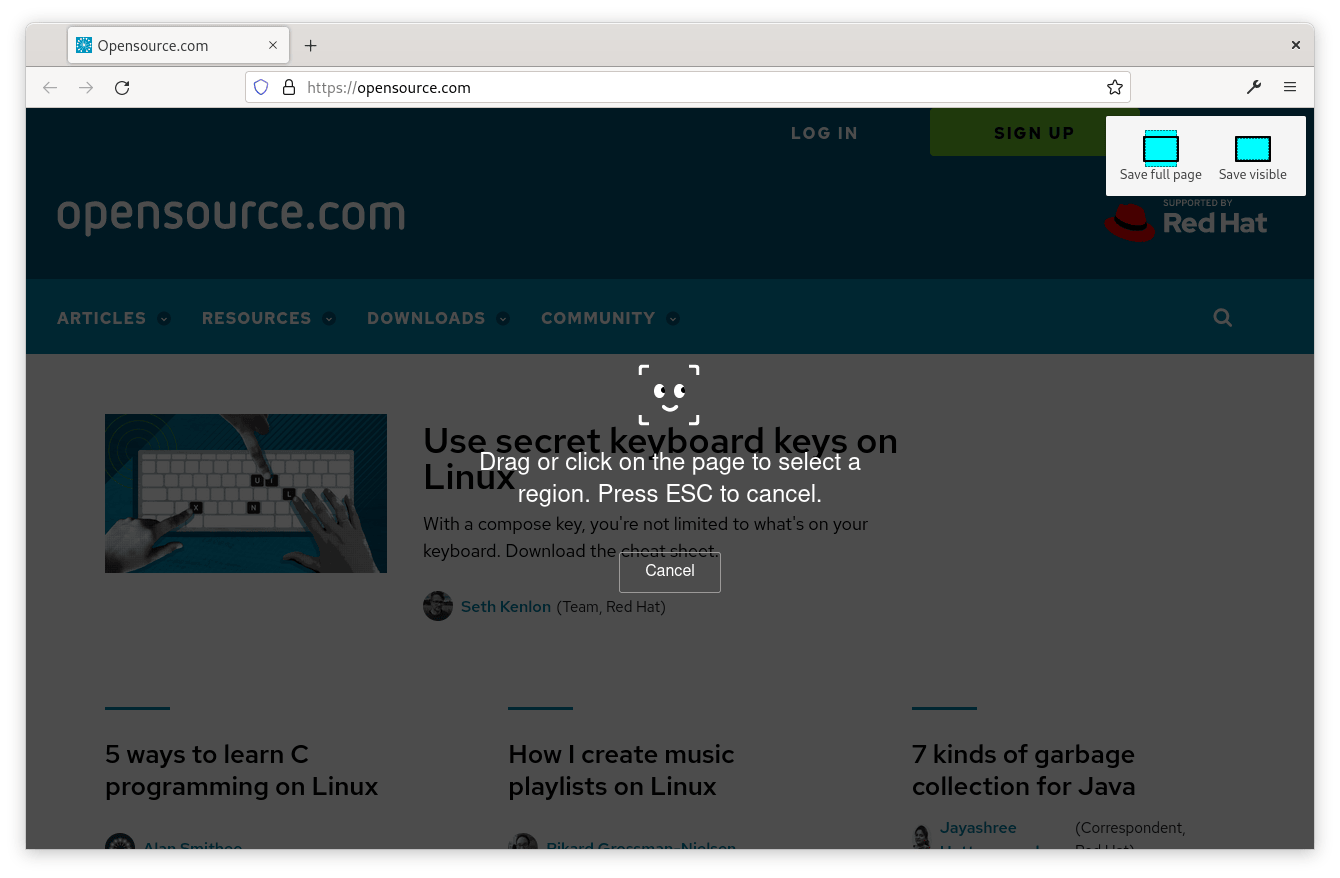
Firefox 切换到模态显示,并提示你单击或拖动页面以选择区域,或使用其中一个图标保存整个页面的副本,或仅在浏览器中可见的内容:

Image of Firefox modal display

当你在屏幕上移动鼠标时,你可能会注意到 Firefox 会高亮显示某些区域。这些是页面上的块元素,例如 <div> 或其他块元素。单击该元素以对其进行截图。 Firefox 将截图保存到你的下载文件夹,或你设置为“下载”位置的任何位置。

如果你尝试记录流程,那么截图可以为你节省大量时间。

尝试使用其中一种方法在 Linux 上截图。

(图片来源:Jim Hall,CC BY-SA 40)


via: https://opensource.com/article/22/8/screenshots-linux

作者:Jim Hall 选题:lkxed 译者:geekpi 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

以下是从 Linux 命令行自动编辑文件的一些提示和技巧。

当我使用 Linux 命令行时,无论是在台式机上编写新程序还是在 Web 服务器上管理网站,我经常需要处理文本文件。Linux 提供了强大的工具,我可以利用这些工具来完成我的工作。我经常使用 sed,一个可以根据模式修改文本的编辑器。

sed 代表 流编辑器 Stream EDitor ,它编辑文件中的文本并打印结果。使用 sed 的一种方法是识别一个字符串在文件中的几次出现,并将它们替换为不同的字符串。使用 sed 来处理文本文件的方式似乎是无穷无尽的,但我想分享一些使用 sed 来帮助我管理文件的方法。

在 Linux 上搜索和替换文件中的文本

要使用 sed,你需要使用一个正则表达式。正则表达式是定义模式的一组特殊字符。我最常使用 sed 的例子是替换文件中的文本。替换文本的语法如下:s/originaltext/newtext。s 告诉 sed 执行文本替换或交换出现的文本。在斜线之间提供原始文本和新文本。

此语法将仅替换每行中第一次出现的 originaltext。要替换每个匹配项,即使在一行中原始文本出现了不止一次,要将 g 追加到表达式的末尾。例如:s/originaltext/newtext/g。

要在 sed 中使用此表达式,请使用 -e 选项指定此正则表达式:

$ sed -e 's/originaltext/newtext/g'

例如,假设我有一个名为 game 程序的 Makefile 文件,该程序模拟了康威的《生命游戏》:

.PHONY: all run clean

all: game

game: game.o
        $(CC) $(CFLAGS) -o game game.o $(LDFLAGS)

run: game
        ./game

clean:
        $(RM) *~
        $(RM) *.o
        $(RM) game

game 这个名字并不是很有描述性,所以我想会把它改名为 life。将 game.c 源文件重命名为 life.c 非常简单,但现在我需要修改 Makefile 以使用新名称。我可以使用 sed 来将所有的 game 更改为 life:

$ sed -e 's/game/life/g' Makefile
.PHONY: all run clean

all: life

life: life.o
        $(CC) $(CFLAGS) -o life life.o $(LDFLAGS)

run: life
        ./life

clean:
        $(RM) *~
        $(RM) *.o
        $(RM) life

sed 会将输出打印到屏幕上,这是检查文本替换是否符合你要求的好方法。要对 Makefile 进行这些更改,首先,备份文件,然后运行 sed 并将输出保存到原始文件名:

$ cp Makefile Makefile.old
$ sed -e 's/game/life/g' Makefile.old > Makefile

如果你确信你的更改正是你想要的,请使用 -i 或 --in-place 选项来编辑文件。但是,我建议添加一个备份文件后缀,如 --in-place=.old,用来备份原始文件,以备日后需要恢复时使用。它看起来像这样:

$ sed --in-place=.old -e 's/game/life/g' Makefile
$ ls Makefile*
Makefile  Makefile.old

在 Linux 上使用 sed 引用文件

你可以使用正则表达式的其它功能来匹配特定的文本实例。例如,你可能需要替换出现在行首的文本。使用 sed,你可以用上尖号 ^ 来匹配行的开头。

我使用“行首”来替换文本的一种方式是当我需要在电子邮件中引用一个文件时。假设我想在电子邮件中共享我的 Makefile,但我不想将其作为文件附件包含在内。相反,我更喜欢在电子邮件正文中“引用”文件,在每行之前使用 >。我可以使用以下 sed 命令将编辑后的版本打印到我的终端,并将其复制粘贴到新的电子邮件中:

$ sed -e 's/^/>/' Makefile
>.PHONY: all run clean
>
>all: life
>
>life: life.o
>       $(CC) $(CFLAGS) -o life life.o $(LDFLAGS)
>
>run: life
>       ./life
>
>clean:
>       $(RM) *~
>       $(RM) *.o
>       $(RM) life

s/^/>/ 正则表达式匹配每行的开头(^),并在那里放置一个 >。实际上,这相当于每行都以 > 符号开始。

制表符可能无法在电子邮件中正确显示,但我可以通过添加另一个正则表达式将 Makefile 中的所有制表符替换为几个空格:

$ sed -e 's/^/>/' -e 's/\t/  /g' Makefile
>.PHONY: all run clean
>
>all: life
>
>life: life.o
>  $(CC) $(CFLAGS) -o life life.o $(LDFLAGS)
>
>run: life
>  ./life
>
>clean:
>  $(RM) *~
>  $(RM) *.o
>  $(RM) life

\t 表示文字制表符,因此 s/\t/ /g 告诉 sed 用输出中的两个空格替换输入中的所有制表符。

如果你需要对文件进行大量编辑,你可以将 -e 命令保存在文件中,并使用 -f 选项来告诉 sed 将该文件用作“脚本”。如果你需要经常进行相同的编辑,这种方法特别有用。我已经准备了 quotemail.sed 的脚本文件来在我的电子邮件中引用 Makefile:

$ cat quotemail.sed
s/^/>/
s/\t/  /g
$ sed -f quotemail.sed Makefile
>.PHONY: all run clean
>
>all: life
>
>life: life.o
>  $(CC) $(CFLAGS) -o life life.o $(LDFLAGS)
>
>run: life
>  ./life
>
>clean:
>  $(RM) *~
>  $(RM) *.o
>  $(RM) life

学习在 Linux 上使用 sed

sed 是一个很好的工具,可以保存在你的 Linux 命令行工具包中。浏览 sed 手册页并了解有关如何使用它的更多信息。在命令行中键入 man sed 以获取有关不同命令行选项的完整文档,以及如何使用 sed 处理文本文件。


via: https://opensource.com/article/22/8/automate-file-edits-sed-linux

作者:Jim Hall 选题:lkxed 译者:perfiffer 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

如果你更喜欢用终端与系统交互,请了解一下我最喜欢的管理文件的命令。
在如 GNOME 或 KDE 等图形桌面中使用鼠标点击管理文件。你点击文件的图标,将它移动到另一个文件夹中,或者移动到回收站里。图形交互使得桌面计算机便于使用。

但是在 Linux 中,我们并不总是与图形界面交互。如果你在服务器上工作,那么你可能需要使用命令行来解决问题。即使像我这样使用桌面的用户,可能也更喜欢使用终端和命令行和系统交互。我倾向于通过命令行运行命令来管理我的文件:

使用 ls 显示文件

ls

对任何使用命令行的人来说,如果不知道有什么文件,工作将很难进行下去。ls 命令 会罗列出文件夹中的文件。例如,要查看 Web 服务器的文档根目录 /var/www/html 中的内容,你可以键入:

ls /var/www/html

大多数情况,我使用 ls 命令查看当前文件夹内的文件。只需要输入 ls 即可查看所有文件。例如,当我在我的网页项目的根目录时,输入 ls 后可以看到这些:

$ ls
about  fontawesome      fonts   index.php  styles
docs   fontawesome.zip  images  prism

ls 命令包含 60 种选项,可以以任意方式显示文件和目录。-l 是一个很有用的选项,可以详细的显示文件,包含权限、文件大小以及所有者等信息。

$ ls -l

total 6252
drwxrwxr-x. 2 jhall jhall    4096 Jun 22 16:18 about
drwxr-xr-x. 2 jhall jhall    4096 Jun 25 16:35 docs
drwxr-xr-x. 2 jhall jhall    4096 Jun  7 00:00 fontawesome
-rw-r--r--. 1 jhall jhall 6365962 Jun  2 16:26 fontawesome.zip
drwxrwxr-x. 2 jhall jhall    4096 Jun 22 16:17 fonts
drwxr-xr-x. 2 jhall jhall    4096 Jun 25 13:03 images
-rw-rw-r--. 1 jhall jhall     327 Jun 22 16:38 index.php
drwxrwxr-x. 2 jhall jhall    4096 Jun 22 16:18 prism
drwxrwxr-x. 2 jhall jhall    4096 Jun 22 16:17 styles

上方的文件大小是以字节为单位,或许看起来有点吃力。想要以方便我们阅读的格式查看文件大小,只需要添加 -h 或 --human-readable 选项,能以 G 、M 、K 为单位显示文件大小。

$ ls -l --human-readable
total 6.2M
drwxrwxr-x. 2 jhall jhall 4.0K Jun 22 16:18 about
drwxr-xr-x. 2 jhall jhall 4.0K Jun 25 16:35 docs
drwxr-xr-x. 2 jhall jhall 4.0K Jun  7 00:00 fontawesome
-rw-r--r--. 1 jhall jhall 6.1M Jun  2 16:26 fontawesome.zip
drwxrwxr-x. 2 jhall jhall 4.0K Jun 22 16:17 fonts
drwxr-xr-x. 2 jhall jhall 4.0K Jun 25 13:03 images
-rw-rw-r--. 1 jhall jhall  327 Jun 22 16:38 index.php
drwxrwxr-x. 2 jhall jhall 4.0K Jun 22 16:18 prism
drwxrwxr-x. 2 jhall jhall 4.0K Jun 22 16:17 styles

现在,ls 将 zip 文件显示为 6.1M 或刚刚超过 6 MB 的文件大小,而不是 6365962。

使用 cat、head 和 tail 命令查看文件

cat
head
tail

当显示出文件后,需要检查文件夹中的内容。使用很少几个命令即可做到。以我的 Web 服务器中的 docs 文件夹为例:

$ ls docs
chapter1.tex  chapter4.tex  chapter7.tex  lorem.txt
chapter2.tex  chapter5.tex  chapter8.tex  readme.txt
chapter3.tex  chapter6.tex  chapter9.tex  workbook.tex

这些文件是什么?我不知道,幸运的是该目录中有一个 readme.txt 文件,我猜它包含了这个项目目录中文件的描述。如果该文件不是很长,那我可以使用 cat 命令查看它:

$ cat docs/readme.txt 
This is the workbook for the C programming self-paced
video series. The main file is the workbook.tex file,
which includes the other chapters.

如果这个文件很长,则可以使用 head 命令查看文件的前几行。该命令通常显示前 10 行的内容,不过你也可以使用 -n 或者 --lines 选项来指定行数。例如,使用这两个 head 命令的选项查看 lorem.txt 文件的前三行:

$ head -n 3 docs/lorem.txt 
Lorem ipsum dolor sit amet, consectetur adipiscing
elit. Nullam at ligula eget nunc feugiat pharetra. Nullam
nec vulputate augue. Suspendisse tincidunt aliquet

$ head --lines=3 docs/lorem.txt 
Lorem ipsum dolor sit amet, consectetur adipiscing
elit. Nullam at ligula eget nunc feugiat pharetra. Nullam
nec vulputate augue. Suspendisse tincidunt aliquet

如果我想要查看文件的最后几行的内容,可以以相同方式使用 tail 命令。同样,这两个 tail 命令分别显示 lorem.txt 文件的最后三行:

$ tail -n 3 docs/lorem.txt 
egestas sodales. Vivamus tincidunt ex sed tellus tincidunt
varius. Nunc commodo volutpat risus, vitae luctus lacus
malesuada tempor. Nulla facilisi.

$ tail --lines=3 docs/lorem.txt 
egestas sodales. Vivamus tincidunt ex sed tellus tincidunt
varius. Nunc commodo volutpat risus, vitae luctus lacus
malesuada tempor. Nulla facilisi.

使用 head 和 tail 命令在服务器中查看日志文件十分有用。我有一个小型 Web 服务器运行在家庭网络,用于在网站上线前的测试。最近我发现 Web 服务器的日志很长,我好奇它存在多久了。使用 head 命令,我只打印第一行,可以看到该日志文件是在 2020 年 12 月创建的:

$ ls -l --human-readable /var/log/httpd
total 13M
-rw-r--r--. 1 root root 13M Jun 25 16:23 access_log
-rw-r--r--. 1 root root 45K Jun  2 00:00 error_log

$ sudo head -n 1 /var/log/httpd/access_log
10.0.0.177 - - [05/Dec/2020:14:58:35 -0600] "GET / HTTP/1.1" 403 5564 "-" "Mozilla/5.0 (X11; Fedora; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/87.0.4280.88 Safari/537.36"

使用 rm 命令删除文件

rm

在包含示例文本文件的目录中,lorem.txt 文件中包含 “ 乱数假文 Lorem Ipsum ” 文本。这只是印刷行业中使用的虚拟文本,因此 lorem.txt 文件并不属于该项目。让我们用 rm 命令删除这样的文件:

$ ls docs
chapter1.tex  chapter4.tex  chapter7.tex  lorem.txt
chapter2.tex  chapter5.tex  chapter8.tex  readme.txt
chapter3.tex  chapter6.tex  chapter9.tex  workbook.tex

$ rm docs/lorem.txt 

$ ls docs
chapter1.tex  chapter4.tex  chapter7.tex  readme.txt
chapter2.tex  chapter5.tex  chapter8.tex  workbook.tex
chapter3.tex  chapter6.tex  chapter9.tex

由于用 rm 命令删除的文件会直接删除,而不会放入回收站,因此它很危险。安装 trash 命令比较安全,例如 trashy 或 trash-cli 命令。这样你可以在文件永久删除前,将其放入暂存区。

$ rm docs/lorem.txt

只需很少的命令即可在命令行中管理文件。使用 ls 命令显示目录中的文件,使用 cat 、head 和 tail 命令查看文件中的内容。使用 rm 或者安全的 trash 命令将不需要的文件删除。这五个命令足以帮你在 Linux 中管理文件。想要了解更多,可以使用 --help 选项来查看如何使用这些命令。例如使用 ls --help 查看 ls 命令如何使用。


via: https://opensource.com/article/22/7/manage-files-linux-command-line

作者:Jim Hall 选题:lkxed 译者:Donkey 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

使用 LibreOffice 模板快速开始在 Linux 上写作。

任何办公软件套件中的主要部件都是文字处理器。无论你的需求如何,从记笔记到写书,文字处理器都能完成工作。大多数 Linux 发行版都包含 LibreOffice 套件,我使用 LibreOffice Writer 作为我的文字处理器。

LibreOffice Writer 通过其工具栏、键盘快捷键和菜单提供了很大的灵活性。但是,如果你只是想轻松地开始一个文档,你可以使用其中一个预加载的模板。以下是如何使用 LibreOffice Writer 模板让你的工作更轻松。

开始一个新文档

LibreOffice Writer 从一个空白文档开始。大多数人就从这里开始写作,但这也是从模板创建新文档的地方。

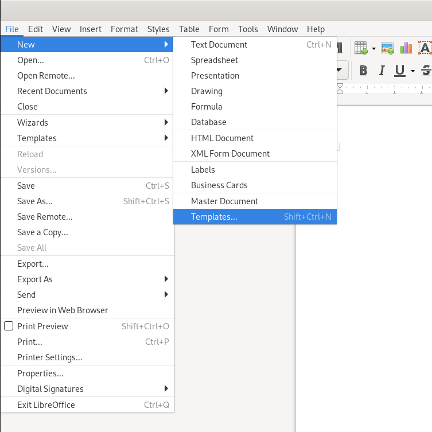
首先,打开“ 文件 File ”菜单,然后选择“ 新建 New ”、“ 模板 Templetes ”。此选项会打开模板选择对话框:

Open templates from the File menu

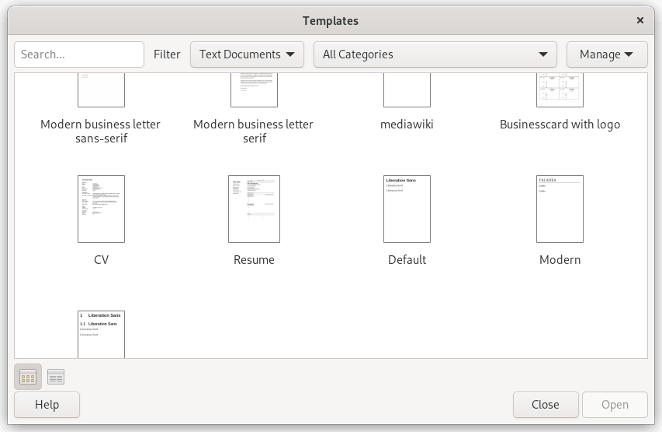
模板选择对话框显示系统上可用的不同模板。默认的 LibreOffice Writer 安装包括用于不同类型的商务信函、简历和其他文档的模板。你可以使用对话框顶部的过滤器选项浏览列表或缩小结果范围。

Select a template

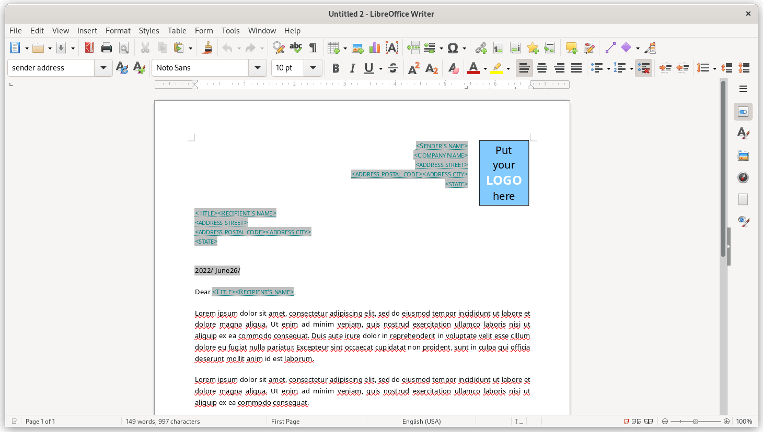
单击你想要的模板,然后单击“ 打开 Open ”以使用此模板开始一个新的 Writer 文档。一些模板包括样板文本或其他示例材料,你可以使用这些材料开始编写新文档。例如,现代商务信函由以下 “lorem ipsum” 示例文本组成:

Modern business letter template

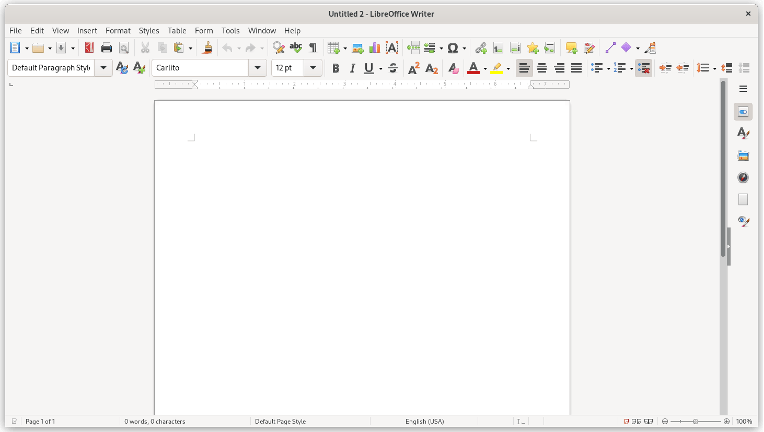
其他文档模板只是为你提供了一个具有一些漂亮的默认设置的空文档的起点。例如,现代文档模板对文本正文使用无衬线字体(例如 Linux 系统上的 Carlito):

Modern template

下载模板

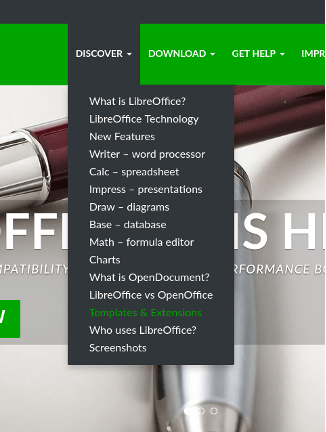
如果你在内置选项中没有找到所需的模板,你可以从 LibreOffice 的网站下载合适的文档模板。进入 LibreOffice 扩展以开始使用 LibreOffice 扩展和模板库。

Templates and extensions options

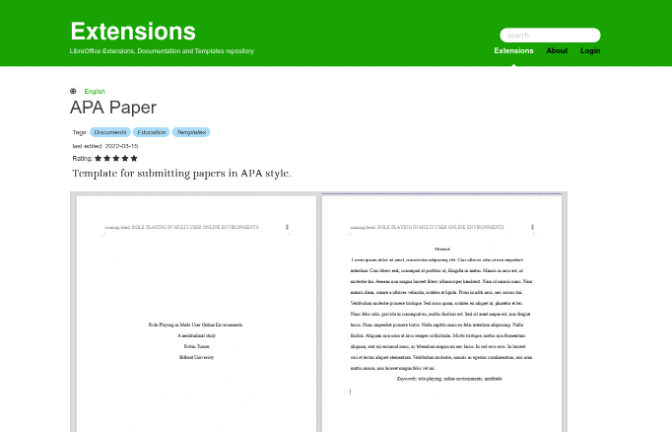
在框中输入搜索词以查找你需要的文档模板。例如,学生可能会搜索 “APA” 来查找为 APA 样式设置的文档模板,这是学术论文的常见样式。

APA format template

总结

如果你需要编写文档,请浏览 LibreOffice 模板以找到适合你的模板。使用模板意味着你可以花费更少的时间来设置文档以使其具有某种外观,并且可以更快地工作。在支持你的工作的 LibreOffice 扩展和模板库中查找其他文档模板。

(图片来源:Jim Hall,CC BY-SA 4.0)


via: https://opensource.com/article/22/7/libreoffice-writer-templates

作者:Jim Hall 选题:lkxed 译者:geekpi 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出
使用位字段和掩码是不用数据结构组合数据的常用方法。

 title=

假设你在用 C 语言写一个国际象棋游戏。追踪棋盘上棋子的一种方法是定义一个结构,该结构定义了棋盘上每个可能的棋子及其颜色,因此每个格子都包含该结构中的一个元素。例如,你可以将结构定义成下面这样:

struct chess_pc {
   int piece;
   int is_black;
}

有了这个数据结构,你的程序就会知道每个格子里是什么棋子及棋子的颜色。你可以快速识别出棋子是兵、车、马、象、后还是王,以及棋子是黑还是白。但是,有一种更直接的方法来跟踪这些信息,同时只用更少的数据和内存。与为棋盘上的每个方格存储两个 int 值的结构不同,我们可以存储单个 int 值,并使用二进制位字段和掩码来标识每个方格中的棋子和颜色。

比特和二进制

当使用位字段表示数据时,我们最好像计算机一样思考。让我们从列出可能的棋子开始,并为每个棋子分配一个数字。让我们进入下一个步骤,用二进制表示这个数字,也就是按照计算机追踪它的方式。记住,二进制数是由比特组成的,比特要么是 0,要么是 1。

  • 00000000: 空(0)
  • 00000001: 兵(1)
  • 00000010: 车(2)
  • 00000011: 马(3)
  • 00000100: 象(4)
  • 00000101: 后(5)
  • 00000110: 王(6)

要列出一个棋盘上的所有棋子,我们只需要三个比特从右到左依次代表值 1、2 和 4。例如,数字 6 是二进制的 110。6 的二进制表示中的其他所有位都是 0。

一个聪明一点的方法:我们可以使用那些额外的总是为零的比特来跟踪一个棋子是黑还是白。我们可以使用数字 8(二进制 00001000)来表示棋子是否为黑色。如果这一位是 1,则代表该棋子是黑色;如果是 0,则代表该棋子是白色。这被称为位字段,稍后我们可以使用二进制掩码将其取出。

用位字段存储数据

要编写一个使用位字段和掩码的国际象棋程序,我们可以从以下定义开始:

/* 棋子 */

#define EMPTY 0   // 空
#define PAWN 1    // 兵
#define ROOK 2    // 车
#define KNIGHT 3  // 马
#define BISHOP 4  // 象
#define QUEEN 5   // 后
#define KING 6    // 王

/* 棋色 */

#define BLACK 8   // 黑
#define WHITE 0   // 白

/* 掩码 */

#define PIECE 7

当你为一个棋格赋值时,比如初始化棋盘,你可以赋一个 int 类型的值来跟踪棋子及其颜色。例如,要在棋盘的 0,0 位置存储棋子黑车,你可以使用下面的代码:

  int board[8][8];
..
  board[0][0] = BLACK | ROOK;

| 是二进制“或”(OR)操作符,这意味着计算机将合并两个数字的比特。对于每个比特的位置,如果任意一个数字的比特为 1,该位置比特的结果也是 1。BLACK 的值(8,即二进制下的 00001000)和 ROOK 的值(2,即二进制下的 00000010)的二进制或结果是二进制下的 00001010,即 10:

    00001000 = 8
 OR 00000010 = 2
    ________
    00001010 = 10

类似地,要在棋盘的 6,0 位置存储一个白色兵,你可以这样做:

  board[6][0] = WHITE | PAWN;

这样存储的值就是 WHITE(0)和 PAWN(1)的二进制或的结果,也即是 1。

    00000000 = 0
 OR 00000001 = 1
    ________
    00000001 = 1

用掩码获取数据

在下棋过程中,程序需要知道棋格中的棋子和它的颜色。我们可以使用二进制掩码来分离这部分。

举个例子,程序可能需要知道棋局中棋盘上特定棋格的内容,例如位于 board[5][3] 的数组元素。这个是什么棋子,是黑的还是白的?为了识别棋子,使用二进制“与”(AND)操作符将元素的值与掩码 PIECE 结合起来:

  int board[8][8];
  int piece;
..
  piece = board[5][3] & PIECE;

二进制“与”(AND)操作符(&)将两个二进制值结合,这样对于任意位,如果两个数字中的那个位都是 1,那么结果也是 1。例如,如果 board[5][3] 的值是 11(二进制下的 00001011),那么 11 和 掩码 PIECE(7,二进制下的 00000111)二进制与的结果为二进制下的 00000011,也即 3。这代表马,马的值是 3。

    00001011 = 11
AND 00000111 = 7
    ________
    00000011 = 3

解析棋子的颜色是一个简单的事情,只需要将棋子的值与 BLACK 位字段进行二进制与操作。比如,你可以写一个名为 is_black 的函数来确定棋子是黑还是白:

int
is_black(int piece)
{
  return (piece & BLACK);
}

之所以可以这样,是因为 BLACK 的值为 8(二进制下的 00001000)。在 C 语言中,任何非零值都被视为 True,零总是 False。所以如果 5,3 处的棋子是黑色的,则 is_black(board[5][3]) 返回 True 值(8);如果是白色的,则返回 False 值(0)。

位字段

使用位字段和掩码是不使用结构组合数据的常用方法。它们值得被程序员收藏到“工具包”中。虽然数据结构对于需要跟踪相关数据的有序编程是一种有价值的工具,但是使用单独的元素来跟踪单个的开或闭值(例如棋子的颜色)的效率较低。在这些情况下,可以考虑使用位字段和掩码来更高效地组合数据。


via: https://opensource.com/article/21/8/binary-bit-fields-masks

作者:Jim Hall 选题:lujun9972 译者:FYJNEVERFOLLOWS 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

fmt 命令是一个简单的文本格式化程序。我将在这里展示如何使用它来格式化文本和邮件回复。

当我为项目编写文档时,我经常以纯文本的形式编写自述文件和安装说明。我不需要使用 HTML 或者 Markdown 之类的标记语言来描述项目的功能或如何编译它。但是维护这样的文档可能会很痛苦。如果我需要更新我的 Readme 文件中的一个句子的中间位置,我需要重新格式化文本,以避免在我的其它文本中间出现一个很长或很短的行,而其它的行的格式是整整齐齐的 75 列。一些编辑器包含可以自动重新格式化文本以填充段落的功能,但并非所有的编辑器都这样做。这就是 Linux fmt 命令的用武之地。

使用 Linux fmt 命令格式化文本

fmt 命令是一个简单的文本格式化程序;它收集单词并填充段落,但不应用任何其它文本样式,例如斜体或粗体。这一切都是纯文本。使用 fmt 命令,你可以快速调整文本,使其更易于阅读。让我们从这个熟悉的示例文本开始:

$ cat trek.txt 
Space: the final
frontier. These are the voyages
of the starship Enterprise. Its
continuing mission: to explore
strange new worlds. To
seek out new life and new
civilizations. To boldly go
where no one has gone before!

在这个实例文件中,每行都有不同的长度,并且它们以一种奇怪的方式换行。如果你对纯文本文件进行大量更改,你可以会遇到类似的奇怪的换行。要重新格式化此文本,你可以使用 fmt 命令将段落的行填充为统一长度:

$ fmt trek.txt 
Space: the final frontier. These are the voyages of the starship
Enterprise. Its continuing mission: to explore strange new worlds. To
seek out new life and new civilizations. To boldly go where no one has
gone before!

默认情况下,fmt 会将文本格式化为 75 的列宽大小,但你可以使用 -w 或 --width 选项进行更改:

$ fmt -w 60 trek.txt 
Space: the final frontier. These are the voyages of
the starship Enterprise. Its continuing mission: to
explore strange new worlds. To seek out new life and new
civilizations. To boldly go where no one has gone before!

使用 Linux fmt 命令格式化电子邮件回复

我加入了一个邮件列表,这里更喜欢纯文本电子邮件,这使得在列表服务器上归档电子邮件变得更加容易。但现实是并非每个人都以纯文本形式发送电子邮件。有时候,当我以纯文本形式回复这些电子邮件时,我的电子邮件客户端会将整个段落放在一行中。这使得在电子邮件中“引用”回复变得困难。

这是一个简单的例子。当我以纯文本形式回复电子邮件时,我的电子邮件客户端通过在每行前添加 > 字符来“引用”对方的电子邮件。对于一条短消息,可能如下所示:

> I like the idea of the interim development builds.

没有正确“换行”的长行将无法在我的纯文本电子邮件回复中正确显示,因为它只是前面带有 > 字符的长行,如下所示:

> I like the idea of the interim development builds. This should be a great way to test new changes that everyone can experiment with.

为了解决这个问题,我打开了一个终端并将引用的文本复制并粘贴到一个新文件中。然后我使用 -p 或 --prefix 选项来告诉 fmt 在每一行之前使用什么字符作为“前缀”。

$ cat > email.txt
> I like the idea of the interim development builds. This should be a great way to test new changes that everyone can experiment with.
^D
$ fmt -p '>' email.txt
> I like the idea of the interim development builds. This should be a
> great way to test new changes that everyone can experiment with.

fmt 命令是一个非常简单的文本格式化程序,但它可以做很多有用的事情,可以帮助以纯文本形式编写和更新文档。要了解其它选项,例如 -c 或 --crown-margin 以匹配段落前两行缩进,例如项目列表。还可以尝试使用 -t 或者 --tagged-paragraph 来保留段落中第一行的缩进,就像缩进的段落一样。-u 或 --uniform-spacing 选项在单词之间使用一个空格,在句子之间使用两个空格。


via: https://opensource.com/article/22/7/fmt-trivial-text-formatter

作者:Jim Hall 选题:lkxed 译者:perfiffer 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出