2023年12月

1 Chrome 还有打击广告拦截器的下一个武器

为了打击浏览器上的广告拦截器,Chrome 不但计划在 2024 年 6 月推出限制广告拦截的 Manifest V3 扩展平台,而且还会限制扩展更新过滤规则的方式,以延迟扩展开发者快速响应变化的能力。YouTube 可以立即更换广告投放系统,但一旦 Manifest V3 成为强制规定,扩展开发者就无法立即做出响应。如今,广告拦截器和隐私应用可以自行更新过滤列表,通常使用的是巨大的开源社区的列表。Manifest V3 将通过限制谷歌所说的 “远程托管代码” 来阻止这种情况。所有更新,即使是像过滤列表这样的良性更新,都需要通过 Chrome 商店进行全面的扩展更新。这些更新都需要经过 Chrome 网上应用商店的审核过程,而这将带来很大的时间延迟。

消息来源:Ars Technica
老王点评:对谷歌的反垄断审查更严厉些吧。

2 Java 尝试使用多线程的新方法

在 Java 21 的预览版本中,Java 尝试了多线程的新方法:结构化并发。该方法允许开发者使用结构化编程语法来使用多个线程。从本质上讲,它提供了一种使用熟悉的程序流程和结构编写并发软件的方法。这样,开发人员就可以专注于手头的业务,而不是线程的协调。虚拟线程现已成为 Java 的一项正式功能,它为廉价生成线程以获得并发性能提供了可能。结构化并发为此提供了简单的语法。因此,Java 现在拥有了一个独特的、高度优化的、易于理解的线程系统。

消息来源:Info World
老王点评:这是一个很好的消息,值得关注。

3 研究称 GPT-4 没有通过图灵测试

在一篇题为 《GPT-4 通过图灵测试了吗?》的预印本研究论文中,研究人员将 GPT-4 人工智能语言模型与人类参与者、GPT-3.5 和 ELIZA 进行了对比。其中,ELIZA 是一个上世纪 60 年代开发的基于规则的对话程序。研究人员建立了一个名为 turingtest.live 的网站,他们在该网站上通过互联网举办了一场双人图灵测试。通过该网站,人类审讯者与代表其他人类或人工智能模型的各种 “人工智能证人” 进行互动。令人惊讶的是,ELIZA 在研究中得分相对较高,成功率达到 27%,超过了 GPT-3.5 的 14% 成功率。GPT-4 的成功率为 41%,但就连 GPT-4 也不符合图灵测试的成功标准,既没有达到 50% 的成功率,也没有超过人类参与者的成功率。

消息来源:Ars Technica
老王点评:虽然这个结果令人吃惊,但是我倾向于研究方法有误,比如没有很好地设计符合 GPT 方式的提示语。

Roundcube 现在正与 Nextcloud 合作以迎接未来。

Roundcube,作为最好的 开源网页邮箱服务 之一,决定与 Nextcloud 合作,后者是一个倍受欢迎的开源协作平台,以其协作工具套件而知名。

电子邮件的重要性与日俱增 ,而谷歌和微软等公司正试图垄断市场,这一联手合作的决定显得颇有战略意义。

让我来详细介绍一下。

Roundcube 的新家

这就是 Nextcloud 的 CEO,Frank Karlitschek,关于此次合作的描述:

未来,Nextcloud 将提供必要的资源,比如 项目托管 、引入人才的投资 、帮助开发,以及围绕 Roundcube 培育社区。

最重要的是,Roundcube 不会取代 Nextcloud Mail;它们将作为独立的网页邮箱解决方案并存。

Frank 强调 Roundcube 是一个被许多人使用的重要的开源项目,而 Nextcloud Mail 是一款强大的邮箱客户端,但是没有合并它们的计划。

你可能会好奇,为什么会发生这个变化?

嗯,Roundcube 的创始人和维护者 Thomas Brüderli 作出了退出的决定。当被问到原因时,他如此回答:

自从孩子出生后,我如何安排我非工作的时间的关注力显然转向了家庭生活,因此我逐渐停止了贡献,也对项目的新动态失去了跟踪。

Roundcube 项目需要一个更好,更专注的领导,因此是时候让我退后,放手了。

许多人都能理解这种情况,很高兴看到 Thomas 将他心爱的项目交给了能够维持它发展的人。

我必须说,我对这个消息感到惊讶,作为多年来一直在工作场所使用 Roundcube 作为网页邮箱的用户,我亲眼见证了它自 2018 年以来的成长与变迁。

我很高兴这个项目得到了它应得的关注和关怀。

此外,我建议你浏览一下 官方博客 以及链接在其中的采访,以了解更多关于此次合并的信息。

? 你怎么看?这将如何影响未来的运作?


via: https://news.itsfoss.com/nextcloud-roundcube/

作者:Sourav Rudra 选题:lujun9972 译者:ChatGPT 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

在本系列的 上一篇文章 中,我们回顾了人工智能的历史,然后详细地讨论了矩阵。在本系列的第三篇文章中,我们将了解更多的矩阵操作,同时再介绍几个人工智能 Python 库。

在进入主题之前,我们先讨论几个人工智能和机器学习中常用的重要术语。 人工神经网络 artificial neural network (通常简称为 神经网络 neural network ,NN)是机器学习和深度学习的核心。顾名思义,它是受人脑的生物神经网络启发而设计的计算模型。本文中我没有插入神经网络模型的图片,因为在互联网上很容易找到它们。我相信任何对人工智能感兴趣的人应该都见过它们,左边是输入层,中间是一个或多个隐藏层,右边是输出层。各层之间的边上的 权重 weight 会随着训练不断变化。它是机器学习和深度学习应用成功的关键。

监督学习 supervised learning 和 无监督学习 unsupervised learning 是两个重要的机器学习模型。从长远来看,任何立志于从事人工智能或机器学习领域工作的人都需要学习它们,并了解实现它们的各种技术。这里我认为有必要简单说明两种模型之间的区别了。假设有两个人分别叫 A 和 B,他们要把苹果和橘子分成两组。他们从未见过苹果或橘子。他们都通过 100 张苹果和橘子的图片来学习这两种水果的特征(这个过程称为模型的训练)。不过 A 还有照片中哪些是苹果哪些是橘子的额外信息(这个额外信息称为标签)。这里 A 就像是一个监督学习模型,B 就像是无监督学习模型。你认为在是识别苹果和橘子的任务上,谁的效果更好呢?大多数人可能会认为 A 的效果更好。但是根据机器学习的理论,情况并非总是如此。如果这 100 张照片中只有 5 张是苹果,其它都是橘子呢?那么 A 可能根本就不熟悉苹果的特征。或者如果部分标签是错误的呢?在这些情况下,B 的表现可能比 A 更好。

在实际的机器学习应用中会发生这样的情况吗?是的!训练模型用的数据集可能是不充分的或者不完整的。这是两种模型都仍然在人工智能和机器学习领域蓬勃发展的众多原因之一。在后续文章中,我们将更正式地讨论它们。下面我们开始学习使用 JupyterLab,它是一个用于开发人工智能程序的强大工具。

JupyterLab 入门

在本系列的前几篇文章中,为了简单起见,我们一直使用 Linux 终端运行 Python 代码。现在要介绍另一个强大的人工智能工具——JupyterLab。在本系列的第一篇文章中,我们对比了几个候选项,最终决定使用 JupyterLab。它比 Jupyter Notebook 功能更强大,为我们预装了许多库和包,并且易于团队协作。还有一些其它原因,我们将在后续适时探讨它们。

在本系列的第一篇文章中,我们已经学习了如何安装 JupyterLab。假设你已经按文中的步骤安装好了 JupyterLab,使用 jupyter lab 或 jupyter-lab 命令在会默认浏览器(如 Mozilla Firefox、谷歌 Chrome 等)中打开 JupyterLab。(LCTT 译注:没有安装 JupyterLab 也不要紧,你可以先 在线试用 JupyterLab)图 1 是在浏览器中打开的 JupyterLab 启动器的局部截图。JupyterLab 使用一个名为 IPython(交互式 Python)的 Python 控制台。注意,IPython 其实可以独立使用,在 Linux 终端运行 ipython 命令就可以启动它。
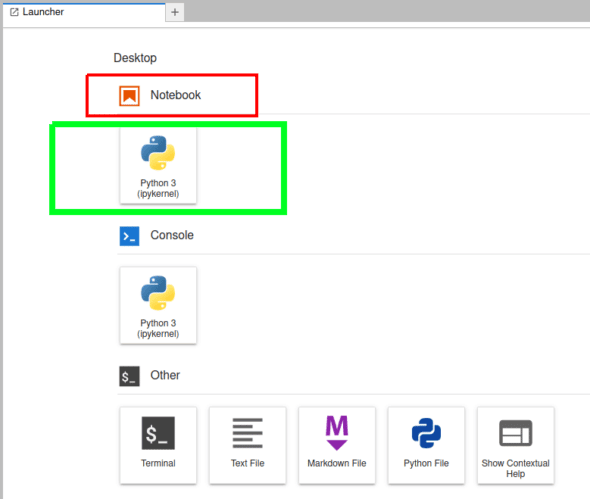
图 1:JupyterLab 启动器

现阶段我们使用 JupyterLab 中的 Jupyter Notebook 功能。点击图 1 中用绿框标记的按钮,打开 Jupyter Notebook。这时可能会要求你选择内核。如果你按照本系列第一篇的步骤安装 JupyterLab,那么唯一的可选项就是 Python 3(ipykernel)。请注意,你还可以在 JupyterLab 中安装其它编程语言的内核,比如 C++、R、MATLAB、Julia 等。事实上 Jupyter 的内核相当丰富,你可以访问 Jupyter 内核清单 了解更多信息。
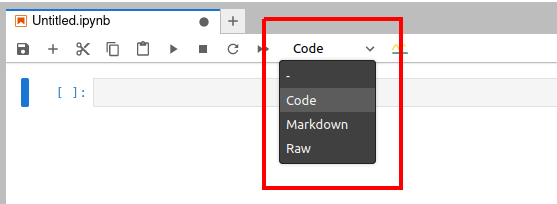
图 2:Jupyter Notebook 窗口

下面我们快速了解一下 Jupyter Notebook 的使用。图 2 显示的是一个在浏览器中打开的 Jupyter Notebook 窗口。从浏览器标签页的标题可以看出,Jupyter Notebook 打开的文件的扩展名是 .ipynb。

在图 2 处可以看到有三个选项,它们表示 Jupyter Notebook 中可以使用的三种类型的单元。“Code”(绿色框) 表示代码单元,它是用来执行代码的。“Markdown” 单元可用于输入说明性的文本。如果你是一名计算机培训师,可以用代码单元和 Markdown 单元来创建交互式代码和解释性文本,然后分享给你的学员。“Raw”(红色框)表示原始数据单元,其中的内容不会被格式化或转换。

和在终端中不同,在 Jupyter Notebook 中你可以编辑并重新运行代码,这在处理简单的拼写错误时特别方便。图 3 是在 Jupyter Notebook 中执行 Python 代码的截图。
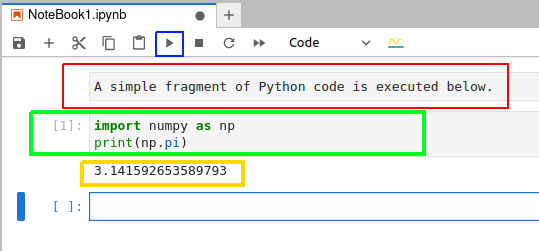
图 3:在 Jupyter Notebook 中执行 Python 代码

要在执行代码单元中的代码,先选中该单元格,然后点击蓝框标记的按钮。图 3 中用红框标记的是 Markdown 单元,用绿框标记的是代码单元,用黄框标记的执行代码的输出。在这个例子中,Python 代码输出的是 π 的值。

前面提到,JupyterLab 默认安装了许多库和包,我们不用自己安装了。你可以使用 import 命令将这些库导入到代码中。使用 !pip freeze 命令可以列出 JupyterLab 中目前可用的所有库和包。如果有库或包没有安装,大多数情况下都可以通过 pip install <全小写的库或者包的名称> 来安装它们。例如安装 TensorFlow 的命令是 pip install tensorflow。如果后面有库的安装命令不遵循这个格式,我会进行特别说明。随着本系列的继续,我们还会看到 Jupyter Notebook 和 JupyterLab 更多强大的功能。

复杂的矩阵运算

通过下面的代码,我们来了解一些更复杂的矩阵运算或操作。为了节省空间,我没有展示代码的输出。

import numpy as np
A = np.arr ay([[1,2,3],[4,5,6],[7,8,88]])
B = np.arr ay([[1,2,3],[4,5,6],[4,5,6]])
print(A.T)
print(A.T.T)
print(np.trace(A))
print(np.linalg.det(A))
C = np.linalg.inv(A)
print(C)
print(A@C)

下面我逐行来解释这些代码:

  1. 导入 NumPy 包。
  2. 创建矩阵 A。
  3. 创建矩阵 B。
  4. 打印矩阵 A 的 转置 transpose 。通过比较矩阵 A 与 A 的转置,你用该可以大致理解转置操作到底做了什么。
  5. 打印 A 的转置的转置。可以看到它和矩阵 A 是相同的。这又提示了转置操作的含义。
  6. 打印矩阵 A 的 迹 trace 。迹是矩阵的对角线(也称为主对角线)元素的和。矩阵 A 的主对角线元素是 1、5 和 88,所以输出的值是 94。
  7. 打印 A 的 行列式 determinant 。当执行代码的结果是 -237.00000000000009(在你的电脑中可能略有区别)。因为行列式不为 0,所以称 A 为 非奇异矩阵 non-singular matrix 。
  8. 将矩阵 A 的 逆 inverse 保存到矩阵 C 中。
  9. 打印矩阵 C。
  10. 打印矩阵 A 和 C 的乘积。仔细观察,你会看到乘积是一个 单位矩阵 identity matrix ,也就是一个所有对角线元素都为 1,所有其它元素都为 0 的矩阵。请注意,输出中打印出的不是精确的 1 和 0。在我得到的答案中,有像 -3.81639165e-17 这样的数字。这是浮点数的科学记数法,表示 -3.81639165 × 10 -17, 即小数的 -0.0000000000000000381639165,它非常接近于零。同样输出中的其它数字也会有这种情况。我强烈建议你了解计算机是怎样表示浮点数的,这对你会有很大帮助。

根据第一篇文章中的惯例,可以将代码分成基本 Python 代码和人工智能代码。在这个例子中,除了第 1 行和第 9 行之外的所有代码行都可以被看作是人工智能代码。

现在将第 4 行到第 10 行的操作应用到矩阵 B 上。从第 4 行到第 6 行代码的输出没有什么特别之处。然而运行第 7 行时,矩阵 B 的行列式为 0,因此它被称为 奇异矩阵 singular matrix 。运行第 8 行代码会给产生一个错误,因为只有非奇异矩阵才存在逆矩阵。你可以尝试对本系列前一篇文章中的 8 个矩阵都应用相同的操作。通过观察输出,你会发现矩阵的行列式和求逆运算只适用于方阵。

方阵就是行数和列数相等的矩阵。在上面的例子中我只是展示了对矩阵执行各种操作,并没有解释它们背后的理论。如果你不知道或忘记了矩阵的转置、逆、行列式等知识的话,你最好自己学习它们。同时你也应该了解一下不同类型的矩阵,比如单位矩阵、对角矩阵、三角矩阵、对称矩阵、斜对称矩阵。维基百科上的相关文章是不错的入门。

现在让我们来学习 矩阵分解 matrix decomposition ,它是更复杂的矩阵操作。矩阵分解与整数的因子分解类似,就是把一个矩阵被写成其它矩阵的乘积。下面我通过图 4 中整数分解的例子来解释矩阵分解的必要性。代码单元开头的 %time 是 Jupyter Notebook 的 魔法命令 magic command ,它会打印代码运行所花费的时间。** 是 Python 的幂运算符。基本的代数知识告诉我们,变量 a 和 b 的值都等于 (6869 x 7873) 100。但图 4 显示计算变量 b 的速度要快得多。事实上,随着底数和指数的增大,执行时间的减少会越来越明显。
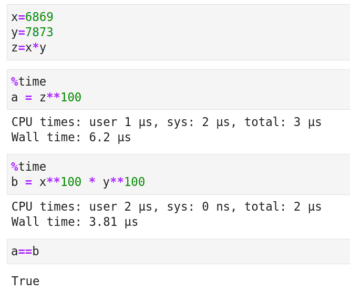
图 4:Python 代码的执行耗时

在几乎所有的矩阵分解技术技术中,原始矩阵都会被写成更稀疏的矩阵的乘积。 稀疏矩阵 sparse matrix 是指有很多元素值为零的矩阵。在分解后,我们可以处理稀疏矩阵,而不是原始的具有大量非零元素的 密集矩阵 dense matrix 。在本文中将介绍三种矩阵分解技术——LUP 分解、 特征分解 eigen decomposition 和 奇异值分解 singular value decomposition (SVD)。

为了执行矩阵分解,我们需要另一个强大的 Python 库,SciPy。SciPy 是基于 NumPy 库的科学计算库,它提供了线性代数、积分、微分、优化等方面的函数。首先,让我们讨论 LUP 分解。任何方阵都能进行 LUP 分解。LUP 分解有一种变体,称为 LU 分解。但并不是所有方阵都能 LU 分解。因此这里我们只讨论 LUP 分解。

在 LUP 分解中,矩阵 A 被写成三个矩阵 L、U 和 P 的乘积。其中 L 是一个 下三角矩阵 lower triangular matrix ,它是主对角线以上的所有元素都为零的方阵。U 是一个 上三角矩阵 upper triangular matrix ,它是主对角线以下所有元素为零的方阵。P 是一个 排列矩阵 permutation matrix 。这是一个方阵,它的每一行和每一列中都有一个元素为 1,其它元素的值都是 0。

现在看下面的 LUP 分解的代码。

import numpy as np
import scipy as sp
A=np.array([[11,22,33],[44,55,66],[77,88,888]])
P, L, U = sp.linalg.lu(A)
print(P)
print(L)
print(U)
print(P@L@U)

图 5 显示了代码的输出。第 1 行和第 2 行导入 NumPy 和 SciPy 包。在第 3 行创建矩阵 A。请记住,我们在本节中会一直使用矩阵 A。第 4 行将矩阵 A 分解为三个矩阵——P、L 和 U。第 5 行到第 7 行打印矩阵 P、L 和 U。从图 5 中可以清楚地看出,P 是一个置换矩阵,L 是一个下三角矩阵,U 是一个上三角矩阵。最后在第 8 行将这三个矩阵相乘并打印乘积矩阵。从图 5 可以看到乘积矩阵 P@L@U 等于原始矩阵 A,满足矩阵分解的性质。此外,图 5 也验证了矩阵 L、U 和 P 比矩阵 A 更稀疏。
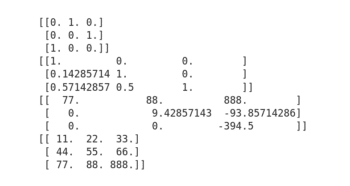
图 5:用 SciPy 进行 LUP 分解

下面我们讨论特征分解,它是将一个方阵是用它的 特征值 eigenvalue 和 特征向量 eigenvector 来表示。用 Python 计算特征值和特征向量很容易。关于特征值和特征向量的理论解释超出了本文的讨论范围,如果你不知道它们是什么,我建议你通过维基百科等先了解它们,以便对正在执行的操作有一个清晰的概念。图 6 中是特征分解的代码。
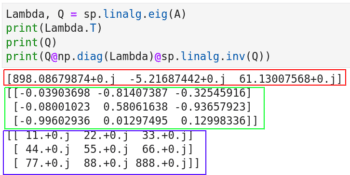
图6:用 SciPy 进行特征分解

在图 6 中,第 1 行计算特征值和特征向量。第 2 行和第 3 行输出它们。注意,使用 NumPy 也能获得类似的效果,Lambda, Q = np.linalg.eig(A)。这也告诉我们 NumPy 和 SciPy 的功能之间有一些重叠。第 4 行重建了原始矩阵 A。第 4 行中的代码片段 np.diag(Lambda) 是将特征值转换为对角矩阵(记为 Λ)。对角矩阵是主对角线以外的所有元素都为 0 的矩阵。第 4 行的代码片段 sp.linalg.inv(Q) 是求 Q 的逆矩阵(记为 Q -1)。最后,将三个矩阵 Q、Λ、Q -1 相乘得到原始矩阵 A。也就是在特征分解中 A=QΛQ -1。

图 6 还显示了执行的代码的输出。红框标记的是特征值,用绿框标记的是特征向量,重构的矩阵 A 用蓝框标记。你可能会感到奇怪,输出中像 11.+0.j 这样的数字是什么呢?其中的 j 是虚数单位。11.+0.j 其实就是 11.0+0.0j,即整数 11 的复数形式。

现在让我们来看奇异值分解(SVD),它是特征分解的推广。图 7 显示了 SVD 的代码和输出。第 1 行将矩阵 A 分解为三个矩阵 U、S 和 V。第 2 行中的代码片段 np.diag(S) 将 S 转换为对角矩阵。最后,将这三个矩阵相乘重建原始矩阵 A。奇异值分解的优点是它可以对角化非方阵。但非方阵的奇异值分解的代码稍微复杂一些,我们暂时不在这里讨论它。
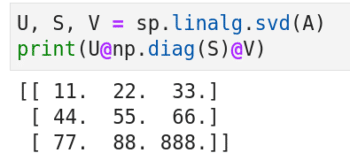
图 7:用 SciPy 进行 奇异值分解

其它人工智能和机器学习的 Python 库

当谈到人工智能时,普通人最先想到的场景可能就是电影《终结者》里机器人通过视觉识别一个人。 计算机视觉 computer vision 是人工智能和机器学习技术被应用得最广泛的领域之一。下面我将介绍两个计算机视觉相关的库:OpenCV 和 Matplotlib。OpenCV 是一个主要用于实时计算机视觉的库,它由 C 和 C++ 开发。C++ 是 OpenCV 的主要接口,它通过 OpenCV-Python 向用户提供 Python 接口。Matplotlib 是基于 Python 的绘图库。我曾在 OSFY 上的一篇早期 文章 中详细介绍了 Matplotlib 的使用。

前面我一直在强调矩阵的重要性,现在我用一个实际的例子来加以说明。图 8 展示了在 Jupyter Notebook 中使用 Matplotlib 读取和显示图像的代码和输出。如果你没有安装 Matplotlib,使用 pip install matplotlib 命令安装 Matplotlib。
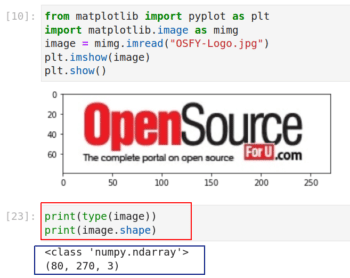
图 8:用 Matplotlib 读取和显示图像

在图 8 中,第 1 行和第 2 行从 Matplotlib 导入了一些函数。注意你可以从库中导入单个函数或包,而不用导入整个库。这两行是基本的 Python 代码。第 3 行从我的计算机中读取标题为 OSFY-Logo.jpg 的图像。我从 OSFY 门户网站的首页下载了这张图片。此图像高 80 像素,宽 270 像素。第 4 行和第 5 行在 Jupyter Notebook 窗口中显示图像。请注意图像下方用红框标记的两行代码,它的输出告诉我们变量 image 实际上是一个 NumPy 数组。具体来说,它是一个 80 x 270 x 3 的三维数组。

数组尺寸中的 80 x 270 就是图片的大小,这一点很容易理解。但是第三维度表示什么呢?这是因计算机像通常用 RGB 颜色模型来存储的彩色图。它有三层,分别用于表示红绿蓝三种原色。我相信你还记得学生时代的实验,把原色混合成不同的颜色。例如,红色和绿色混合在一起会得到黄色。在 RGB 模型中,每种颜色的亮度用 0 到 255 的数字表示。0 表示最暗,255 表示最亮。因此值为 (255,255,255) 的像素表示纯白色。

现在,执行代码 print(image), Jupyter Notebook 会将整个数组的一部分部分打印出来。你可以看到数组的开头有许多 255。这是什么原因呢?如果你仔细看 OSFY 的图标会发现,图标的边缘有很多白色区域,因此一开始就印了很多 255。顺便说一句,你还可以了解一下其他颜色模型,如 CMY、CMYK、HSV 等。

现在我们反过来从一个数组创建一幅图像。首先看图 9 中所示的代码。它展示了如何生成两个 3 x 3 的随机矩阵,它的元素是 0 到 255 之间的随机值。注意,虽然相同的代码执行了两次,但生成的结果是不同的。这是通过调用 NumPy 的伪随机数生成器函数 randint 实现的。实际上,我中彩票的几率都比这两个矩阵完全相等的几率大得多。
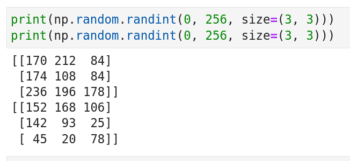
图 8:两个随机矩阵

接下来我们要生成一个形状为 512 x 512 x 3 的三维数组,然后将它转换为图像。为此我们将用到 OpenCV。注意,安装 OpenCV 命令是 pip install opencv-python。看下面的代码:

import cv2
img = np.random.randint(0, 256, size=(512, 512, 3))
cv2.imwrite('img.jpg', img)

第 1 行导入库 OpenCV。注意导入语句是 import cv2,这与大多数其他包的导入不同。第 3 行将矩阵 img 转换为名为 img.jpg 的图像。图 10 显示了由 OpenCV 生成的图像。在系统中运行这段代码,将图像将被保存在 Jupyter Notebook 的同一目录下。如果你查看这张图片的属性,你会看到它的高度是 512 像素,宽度是 512 像素。通过这些例子,很容易看出,任何处理计算机视觉任务的人工智能和机器学习程序使用了大量的数组、向量、矩阵以及线性代数中的思想。这也是本系列用大量篇幅介绍数组、向量和矩阵的原因。
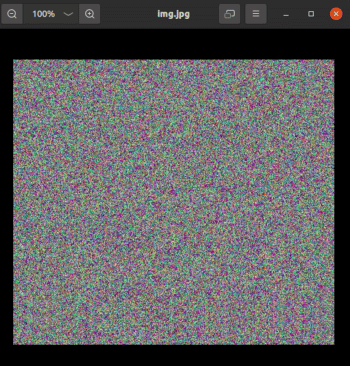
图 10:OpenCV 生成的图像

最后,考虑下面显示的代码。image.jpg 输出图像会是什么样子?我给你两个提示。函数 zeros 在第 4 行和第 5 行创建了两个 512 x 512 的数组,其中绿色和蓝色填充了零。第 7 行到第 9 行用来自数组 red、green 和 blue 的值填充三维数组 img1。

import numpy as np
import cv2
red = np.random.randint(0, 256, size=(512, 512))
green = np.zeros([512, 512], dtype=np.uint8)
blue = np.zeros([512, 512], dtype=np.uint8)
img1 = np.zeros([512,512,3], dtype=np.uint8)
img1[:,:,0] = blue
img1[:,:,1] = green
img1[:,:,2] = red
cv2.imwrite(‘image.jpg’, img1)

本期的内容就到此结束了。在下一篇文章中,我们将开始简单地学习 张量 tensor ,然后安装和使用 TensorFlow。TensorFlow 是人工智能和机器学习领域的重要参与者。之后,我们将暂时放下矩阵、向量和线性代数,开始学习概率论。概率论跟线性代数一样是人工智能的重要基石。

(题图:MJ/ec8e9a02-ae13-4924-b6cb-74ef96ab8af9)


via: https://www.opensourceforu.com/2023/07/ai-a-few-more-useful-python-libraries/

作者:Deepu Benson 选题:lujun9972 译者:toknow-gh 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出
1 巴西城市颁布由 ChatGPT 编写的法令

巴西南部第二大城市 阿雷格里港 Porto Alegre 于 10 月份通过了一项法令,旨在防止该市在水表被盗时向纳税人收取更换水表的费用。但议员们不知道的是,该提案是议员 拉米罗·罗萨里奥 Ramiro Rosário 通过 ChatGPT 拟定的,他仅仅输入了 49 个字的提示语,在几秒钟内就返回了完整的提案草案,还包括理由说明。该提案被提交给了议会中的 35 位同僚,没有做任何改动就一致通过了该提案。对提案来源保密是有意为之,罗萨里奥说,“如果我在此之前透露了这一消息,该提案肯定不会被付诸表决。”他并不是世界上第一个测试 ChatGPT 能力的立法者。其他一些人也在更有限的范围内进行了测试,或取得了不太成功的结果。

消息来源:AP News
老王点评:其实不必惊讶,AI 以后就是和办公软件、拼写检查工具一样的工具。

2 研究人员量化生成人工智能图像的碳足迹

Hugging Face 和卡内基梅隆大学的研究人员发现,使用人工智能生成图像的碳足迹相当于给智能手机充电,生成文本所消耗的能量相当于智能手机充电至约 16%。他们使用 30 个数据集对 88 种不同的模型进行了实验。研究结果表明,最耗能的任务是那些要求人工智能模型生成新内容的任务,无论是文本生成、摘要、图像标题还是图像生成。图像生成产生的排放量最高,而文本分类则被列为能耗最低的任务。

消息来源:Engadget
老王点评:如果从节省的时间和成本来看,降低的碳足迹更多。

3 Servo 浏览器引擎继续走嵌入式友好之路

Servo 项目现在是欧洲 Linux 基金会的一项工作,他们在持续改进 Servo 的嵌入可能性。Servo 项目正在加快构建速度、改进离屏渲染、支持多个网页视图以及其他工作。如果 Servo 能够成为一个适合嵌入式环境的网络引擎,这将是 Servo 取得成功和发展的主要领域之一。

消息来源:Phoronix
老王点评:确实,在目前浏览器市场几乎被 Chromium 引擎统治的情况下,面向独特的领域发展更好。

通过定义目标并创建指标,衡量你的社区活动的成效。

活动是保持开源社区健康的重要组成部分。一个正面的活动体验可以激励当前的贡献者,并吸引新的参与者。但你如何判断自己的活动是否成功呢?

为了维护所涉及社区的健康,我们 CHAOSS ( 社区健康分析开源软件 Community Health Analytics Open Source Software )的 应用生态系统工作组 已经针对我们的活动考虑了这个问题。CHAOSS 应用生态系统包括一些针对 Linux 平台开发应用的项目。虽然现在主要由 GNOME 和 KDE 社区主导,但并不由它们定义。就当前而言,应用生态系统主要是由志愿者驱动的,他们是围绕自由软件的原则组织起来的。我们在此分享的工作是我们 2020 年 11 月 针对开源活动的成功指标 文章的更新。

我们遵循“目标-问题-指标”的方法论。首先,我们确定个人或组织可能设定的几个目标。然后,我们找出实现这些目标所需要回答的问题。最后,我们对每个问题设计可以提供答案的可量化指标。对于活动组织者,我们设定了四个目标。

目标 1:保留并吸引贡献者

贡献者是任何开源项目或生态的命脉,而活动则是贡献者体验中的核心。它们为吸引新贡献者提供了机会,同时也能够建立和巩固与现有贡献者的关系。活动应着眼于创造一个和谐而积极的氛围,以便与项目、生态和社区建立深远的关系。

我们需要考虑的一个问题是,参加活动的人在社区停留的时长是多久。如果活动的价值在于加强维持贡献者的关系,我们应当有办法去测量这个效果。要回答这个问题,需要对贡献和活动参与的长期数据进行分析。值得庆幸的是,许多项目已经拥有这些历史数据。

另一个问题是,活动参加者在我们的开源项目中扮演的是什么角色。活动通常都很专业化,可能并不能吸引那些想在 非代码角色 中贡献的人,如设计、文档编写和市场营销。如果项目能够跟踪非代码贡献,尽管这通常很有挑战性,你就可以对其与活动参与者名单进行对应。这些信息可以帮助活动组织者策划能吸引更广泛参与者群体的活动。

目标 2:举办有参与度的活动

活动不仅仅是演讲。它们为社区成员集结起来提供了空间。如果成员之间没有进行交流,那么这次活动就失去了其存在的价值。这也反映在所谓的走廊交谈中,即人们在走廊或会议日程安排之外进行的交流。一些会议甚至为那些没有打算参加任何环节,但希望在走廊里与他人交流的人减价售票。我们需要解决的问题是,如何衡量一个活动在推动参与者之间的交流上的成效。

要衡量会议时间的参与度,我们可以计算在问答环节中提出的问题数量。虽然这个指标直接受每个演讲者的影响,但活动组织者可以采取行动来鼓励问答环节的参与度。例如,活动组织者可以使用他们的早晨主题演讲来鼓励所有人通过提问来表示对演讲者的赞赏。

我们也考虑了在走廊交谈中的参与情况。一种衡量方法是观察人们在非会议时间的行为。另一种方法是在活动结束后的调查中询问参与者的非会议时间的体验。

最后,我们考虑了在虚拟空间的参与情况。一种衡量方法是通过计算在社交媒体上使用活动标签或者来源于我们知道正在参加活动的人发出的信息数量。另一种可能性,无论在线还是现场,都可以设置一种表情符,参与者只需单击即可反映对会议环节、主题演讲和整个会议体验的反应。

目标 3:深入了解公司的贡献

企业和其他机构对活动,甚至社区活动的贡献是极其重要的。他们可能提供赞助、派遣员工去帮助组织,或者只是派员工去参加活动。确保公司在他们的贡献中找到价值是很重要的,但我们必须以不排斥社区贡献的方式来做这件事。我们研究了公司对社区活动的期望,以及我们可以通过何种方式的衡量来提高公司的贡献。

有些开源活动被认为比其他活动更具有公司味,所以你可能会问,有多少比例的参与者是被他们的雇主派遣去参加的,而不是作为志愿者参加的。有时,这种差异体现在门票定价上。否则,这是一个可以在注册调查中轻松问到的问题。虽然这些信息很有用,但这并不是一个完美的指标,因为付费的开源贡献者通常会在他们的工作职责之外参加活动。

我们还考虑了几个指标,比如哪些公司参加活动,除了派遣员工(例如,金钱赞助活动),公司在做什么,以及公司是否会重复参与。认识到这一点对培养长期关系很重要。

最后,我们考虑了具有相似范畴的活动的竞争格局。公司在活动上的预算有限。尽管我们喜欢类似的活动,但他们都从同一池子里的潜在赞助商中吸引人。了解哪些其他活动正在寻求赞助可以帮助组织者更好地区分他们自己的活动。

目标 4:关注多元化和技能差距

由全球各地的人们构建和发展起来的国际社区,这些人来自多种多样的背景,是开源项目的一个重要组成部分。这些社区贡献他们的想法,为共同的目标合作,帮助项目扩大和开拓新的方向。

面对面活动对于项目和组织来说是一个独特的机会,可以让他们的贡献者聚集在一起,让他们交流并分享各种多元的经验,进而推动创新,以不同的视角促进增长。这也是一个培养和强化共享文化的机会,重点在于增加多元化和包容性。这些指标应该能衡量活动对于培养这种多元性,以及在社区中填补技能缺口的贡献有多大。

我们首先考虑我们在活动中有哪些技能培训,以及这些培训包含多广泛的技能。技能培训可以包括教程,动手实践的工作坊,黑客马拉松,或者其他很多形式。我们在编码之外的技能上有技能培训吗?有很多对开源项目有价值的技能和角色,比如组织活动所需要的技能。

然后,有助于看看我们在我们的社区内需要哪些技能,而哪些技能又是缺失的。项目领导和参与培训的人通常是获取此类信息的良好来源。通过将我们拥有的技能培训与社区需要的技能进行比较,我们可以更好地设计未来活动的培训项目。

参与其中

CHAOSS 应用生态系统工作组对与活动组织者共同细化并实施指标表示感兴趣。KDE 和 GNOME 活动的组织者已经讨论了怎样改变他们的活动以更好地捕捉到这些指标。我们为活动组织者的工作也 以 PDF 形式提供.pdf)。

CHAOSS 应用生态系统工作组还挑战了定义开源软件应用生态系统内的市场营销和通信功能指标。朝向这个目标的第一步是和 KDE 和 GNOME 扮演这个角色的人们进行的一次对话。这次对话可以在 CHAOSScast Episode #31: Marketing Metrics for OSS Foundations and Projects 中找到。我们将从这次对话中得到的学习经验转化为目标-问题-指标,如上述对活动组织者指标的描述。

在我们对推广和通信团队的工作之后,我们计划解决财务团队、社区经理、发布经理、跨项目协调人和导师的指标。我们的工作才刚刚开始,我们欢迎反馈和新的贡献者。

你被邀请参与 CHAOSS 应用生态系统工作组的工作。你可以在我们的 GitHub 页面 上找到更多的信息。

(题图:MJ/187d7b91-9f02-47a2-a433-ea5adbbe1ac6)


via: https://opensource.com/article/22/9/measure-success-your-open-source-event

作者:Shaun McCance 选题:lkxed 译者:ChatGPT 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出
经过了一段时间的等待,Paru 2.0 版本终于发布了。

如果你不熟悉 Paru,它其实是一个 AUR 帮助程序,可以自动完成手动构建 PKGBUILD 的过程,方便在 Arch Linux 中安装软件包。

现新版 Paru 2.0 正式发布,此次更新中包含了一些重要的改进。

不过在深入了解之前,你需要确保自己知道如何解决在使用 AUR 帮助程序构建软件包时可能遇到的问题。如果你刚接触 Linux,我们建议你坚持使用你熟悉的包管理器。

? Paru 2.0: 有什么新变化?

Paru 2.0 版本是一次重大更新,目标是带来一些主要的改变,尤其是为了满足高级用户的需求。

该版本距离上个重大版本的发布已经过去了一年多。开发者表示由于时间不足,需要完成的改变还有很多。

由于很长一段时间没有发布版本,所以开发者提到了这个版本的很多内容都没有经过严格的测试,可能随后会发布 .1 补丁。

现在,我们来看看 Paru 2.0 版本的重要改进点。

首先,现在你可以把非 AUR 的 PKGBUILD 集成到构建引擎中。你可以在你的 paru.conf 中加入其他的 pkgbuild 仓库,具体命令如下:

[repo_name]
Url = https://path/to/git/repo

然后运行下列命令,同步这个新加入的仓库:

paru -Sy --pkgbuilds

此外,你还可以指定一个本地路径,指向你的本地 pkgbuild 仓库。

这些新加入的仓库比 AUR 具有优先级,并且它们还允许包含 AUR 的依赖项。

而新加入的另一项特性就是一个名为 . 的新的自动 pkgbuild 仓库,这个新的仓库在 paru.conf 中是无法看到的。

这个新的特性允许执行 paru -S ./foo 命令,其中 foo 是当前目录下的某个包的名字。

这样你就能在同一个目录中管理一系列相互依赖的 pkgbuild,通过上面的命令,你可以构建其中任何一个pkgbuild。

当你开始构建它们时,Paru 将会自动解决和构建该路径下的 pkgbuild 包的依赖问题。

?️ 其他的改变和优化

除了上述的改变,本次更新还带来了其他一些变动:

  • 修复了在运行 paru -Sc 时没有 sudo 的问题。
  • 日期现在会显示为你的系统的本地时区。
  • 改进了搜索功能,现在默认是启用状态。
  • 在最后的 Paru 确认后,无需再额外对 pacman 确认安装。
  • --chroot 现在无需本地的仓库,当然,如果有的话它会工作得更好。

对于这个版本的更深入的了解,你可以参阅 发布说明。

? 获取 Paru 2.0

如果你是从 AUR 安装的 Paru,你可以直接在 AUR 中升级到 2.0 版本。但如果你是自己构建的 Paru ,那可以试试使用 -U 命令进行更新,或者重新构建一次。

如果你是第一次安装 Paru ,你可以前往其 GitHub 仓库 ,按照里面的安装说明操作就可以了。

Paru 2.0(GitHub)

如果你想要了解更多关于 Paru 的信息,或者想学习如何安装 Paru,我强烈建议你浏览我们关于 Paru AUR 帮助程序 的文章:

Paru - 基于 Yay 的 AUR 助手和 Pacman 封装器

? Arch 用户,你对这次的 Paru 版本升级感到兴奋吗?分享一下你的想法吧!


via: https://news.itsfoss.com/aur-helper-paru-2-0/

作者:Sourav Rudra 选题:lujun9972 译者:ChatGPT 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出