2018年7月

找出 Human Connection 是如何将透明度和社区放在首位的。

如今,开源软件具有深远的意义,在推动数字经济创新方面发挥着关键作用。世界正在快速彻底地改变。世界各地的人们需要一个专门的、中立的、透明的在线平台来迎接我们这个时代的挑战。

开放的原则也许是让我们达成这一目标的方法。如果我们用开放的思维方式将数字创新与社会创新结合在一起,会发生什么?

这个问题是我们在 Human Connection 工作的核心,这是一个具有前瞻性的,以德国为基础的知识和行动网络,其使命是创建一个服务于全球的真正的社交网络。我们受到这样一种观念为指引,即人类天生慷慨而富有同情心,并且他们在慈善行为上茁壮成长。但我们还没有看到一个完全支持我们的自然趋势,与乐于助人和合作以促进共同利益的社交网络。Human Connection 渴望成为让每个人都成为积极变革者的平台。

为了实现一个以解决方案为导向的平台的梦想,让人们通过与慈善机构、社区团体和社会变革活动人士的接触,围绕社会公益事业采取行动,Human Connection 将开放的价值观作为社会创新的载体。

以下是有关它如何工作的。

首先是透明

透明是 Human Connection 的指导原则之一。Human Connection 邀请世界各地的程序员通过在 Github 上提交他们的源代码共同开发平台的源代码(JavaScript、Vue、nuxt),并通过贡献代码或编程附加功能来支持真正的社交网络。

但我们对透明的承诺超出了我们的发展实践。事实上,当涉及到建立一种新的社交网络,促进那些让世界变得更好的人之间的真正联系和互动,分享源代码只是迈向透明的一步。

为促进公开对话,Human Connection 团队举行定期在线公开会议。我们在这里回答问题,鼓励建议并对潜在的问题作出回应。我们的 Meet The Team 活动也会记录下来,并在事后向公众开放。通过对我们的流程,源代码和财务状况完全透明,我们可以保护自己免受批评或其他潜在的不利影响。

对透明的承诺意味着,所有在 Human Connection 上公开分享的用户贡献者将在 Creative Commons 许可下发布,最终作为数据包下载。通过让大众知识变得可用,特别是以一种分散的方式,我们创造了一个多元化社会的机会。

有一个问题指导我们所有的组织决策:“它是否服务于人民和更大的利益?”我们用 联合国宪章 UN Charter 和“ 世界人权宣言 Universal Declaration of Human Rights ”作为我们价值体系的基础。随着我们的规模越来越大,尤其是即将推出的公测版,我们必须对此任务负责。我甚至愿意邀请 Chaos Computer Club (LCTT 译注:这是欧洲最大的黑客联盟)或其他黑客俱乐部通过随机检查我们的平台来验证我们的代码和行为的完整性。

一个合作的社会

以一种以社区为中心的协作方法来编写 Human Connection 平台是超越社交网络实际应用理念的基础。我们的团队是通过找到问题的答案来驱动:“是什么让一个社交网络真正地社会化?”

一个抛弃了以利润为导向的算法、为最终用户而不是广告商服务的网络,只能通过转向对等生产和协作的过程而繁荣起来。例如,像 Code Alliance 和 Code for America 这样的组织已经证明了如何在一个开源环境中创造技术,造福人类并变革现状。社区驱动的项目,如基于地图的报告平台 FixMyStreet,或者为 Humanitarian OpenStreetMap 而建立的 Tasking Manager,已经将众包作为推动其使用的一种方式。

我们建立 Human Connection 的方法从一开始就是合作。为了收集关于必要功能和真正社交网络的目的的初步数据,我们与巴黎 索邦大学 University Sorbonne 的 国家东方语言与文明研究所 National Institute for Oriental Languages and Civilizations (INALCO)和德国 斯图加特媒体大学 Stuttgart Media University 合作。这两个项目的研究结果都被纳入了 Human Connection 的早期开发。多亏了这项研究,用户将拥有一套全新的功能,让他们可以控制自己看到的内容以及他们如何与他人的互动。由于早期的支持者被邀请到网络的 alpha 版本,他们可以体验到第一个可用的值得注意的功能。这里有一些:

  • 将信息与行动联系起来是我们研究会议的一个重要主题。当前的社交网络让用户处于信息阶段。这两所大学的学生团体都认为,需要一个以行动为导向的组件,以满足人类共同解决问题的本能。所以我们在平台上构建了一个“Can Do”功能。这是一个人在阅读了某个话题后可以采取行动的一种方式。“Can Do” 是用户建议的活动,在“ 采取行动 Take Action ”领域,每个人都可以实现。
  • “Versus” 功能是另一个成果。在传统社交网络仅限于评论功能的地方,我们的学生团体认为需要采用更加结构化且有用的方式进行讨论和争论。“Versus” 是对公共帖子的反驳,它是单独显示的,并提供了一个机会来突出围绕某个问题的不同意见。
  • 今天的社交网络并没有提供很多过滤内容的选项。研究表明,情绪过滤选项可以帮助我们根据日常情绪驾驭社交空间,并可能通过在我们希望仅看到令人振奋的内容的那一天时,不显示悲伤或难过的帖子来潜在地保护我们的情绪健康。

Human Connection 邀请改革者合作开发一个网络,有可能动员世界各地的个人和团体将负面新闻变成 “Can Do”,并与慈善机构和非营利组织一起参与社会创新项目。

订阅我们的每周时事通讯以了解有关开放组织的更多信息。


via: https://opensource.com/open-organization/18/3/open-social-human-connection

作者:Dennis Hack 译者:MjSeven 校对:wxy
本文由 LCTT 原创编译,Linux中国 荣誉推出

以及 3 个有趣的 RFC。

阅读源码是开源软件的重要组成部分。这意味着用户可以查看代码并了解做了什么。

但“阅读源码”并不仅适用于代码。理解代码实现的标准同样重要。这些标准编写在由 互联网工程任务组 Internet Engineering Task Force (IETF)发布的称为“ 意见征集 Requests for Comment ”(RFC)的文档中。多年来已经发布了数以千计的 RFC,因此我们收集了一些我们的贡献者认为必读的内容。

6 个必读的 RFC

RFC 2119 - 在 RFC 中用于指示需求级别的关键字

这是一个快速阅读,但它对了解其它 RFC 非常重要。 RFC 2119 定义了后续 RFC 中使用的需求级别。 “MAY” 究竟意味着什么?如果标准说 “SHOULD”,你真的必须这样做吗?通过为需求提供明确定义的分类,RFC 2119 有助于避免歧义。

RFC 3339 - 互联网上的日期和时间:时间戳

时间是全世界程序员的祸根。 RFC 3339 定义了如何格式化时间戳。基于 ISO 8601 标准,3339 为我们提供了一种表达时间的常用方法。例如,像星期几这样的冗余信息不应该包含在存储的时间戳中,因为它很容易计算。

RFC 1918 - 私有互联网的地址分配

有属于每个人的互联网,也有只属于你的互联网。私有网络一直在使用,RFC 1918 定义了这些网络。当然,你可以在路由器上设置在内部使用公网地址,但这是一个坏主意。或者,你可以将未使用的公共 IP 地址视为内部网络。在任何一种情况下都表明你从未阅读过 RFC 1918。

RFC 1912 - 常见的 DNS 操作和配置错误

一切都是 #@%@ 的 DNS 问题,对吧? RFC 1912 列出了管理员在试图保持互联网运行时所犯的错误。虽然它是在 1996 年发布的,但 DNS(以及人们犯的错误)并没有真正改变这么多。为了理解我们为什么首先需要 DNS,如今我们再来看看 RFC 289 - 我们希望正式的主机列表是什么样子的 就知道了。

RFC 2822 — 互联网邮件格式

想想你知道什么是有效的电子邮件地址么?如果你知道有多少个站点不接受我邮件地址中 “+” 的话,你就知道你知道不知道了。 RFC 2822 定义了有效的电子邮件地址。它还详细介绍了电子邮件的其余部分。

RFC 7231 - 超文本传输​​协议(HTTP/1.1):语义和内容

想想看,几乎我们在网上做的一切都依赖于 HTTP。 RFC 7231 是该协议的最新更新。它有超过 100 页,定义了方法、请求头和状态代码。

3 个应该阅读的 RFC

好吧,并非每个 RFC 都是严肃的。

RFC 1149 - 在禽类载体上传输 IP 数据报的标准

网络以多种不同方式传递数据包。 RFC 1149 描述了鸽子载体的使用。当我距离州际高速公路一英里以外时,它们的可靠性不会低于我的移动提供商。

RFC 2324 — 超文本咖啡壶控制协议(HTCPCP/1.0)

咖啡对于完成工作非常重要,当然,我们需要一个用于管理咖啡壶的程序化界面。 RFC 2324 定义了一个用于与咖啡壶交互的协议,并添加了 HTTP 418(“我是一个茶壶”)。

RFC 69 — M.I.T.的分发列表更改

RFC 69 是否是第一个误导取消订阅请求的发布示例?

你必须阅读的 RFC 是什么(无论它们是否严肃)?在评论中分享你的列表。


via: https://opensource.com/article/18/7/requests-for-comments-to-know

作者:Ben Cotton 选题:lujun9972 译者:geekpi 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

这个分步指导教程教你通过在 Kubernetes 上部署一个简单的 Python 应用程序来学习部署的流程。

Kubernetes 是一个具备部署、维护和可伸缩特性的开源平台。它在提供可移植性、可扩展性以及自我修复能力的同时,简化了容器化 Python 应用程序的管理。

不论你的 Python 应用程序是简单还是复杂,Kubernetes 都可以帮你高效地部署和伸缩它们,在有限的资源范围内滚动升级新特性。

在本文中,我将描述在 Kubernetes 上部署一个简单的 Python 应用程序的过程,它包括:

  • 创建 Python 容器镜像
  • 发布容器镜像到镜像注册中心
  • 使用持久卷
  • 在 Kubernetes 上部署 Python 应用程序

必需条件

你需要 Docker、kubectl 以及这个 源代码。

Docker 是一个构建和承载已发布的应用程序的开源平台。可以参照 官方文档 去安装 Docker。运行如下的命令去验证你的系统上运行的 Docker:

$ docker info
Containers: 0
Images: 289
Storage Driver: aufs
 Root Dir: /var/lib/docker/aufs
 Dirs: 289
Execution Driver: native-0.2
Kernel Version: 3.16.0-4-amd64
Operating System: Debian GNU/Linux 8 (jessie)
WARNING: No memory limit support
WARNING: No swap limit support

kubectl 是在 Kubernetes 集群上运行命令的一个命令行界面。运行下面的 shell 脚本去安装 kubectl:

curl -LO https://storage.googleapis.com/kubernetes-release/release/$(curl -s https://storage.googleapis.com/kubernetes-release/release/stable.txt)/bin/linux/amd64/kubectl

部署到 Kubernetes 的应用要求必须是一个容器化的应用程序。我们来回顾一下 Python 应用程序的容器化过程。

一句话了解容器化

容器化是指将一个应用程序所需要的东西打包进一个自带操作系统的容器中。这种完整机器虚拟化的好处是,一个应用程序能够在任何机器上运行而无需考虑它的依赖项。

我们以 Roman Gaponov 的 文章 为参考,来为我们的 Python 代码创建一个容器。

创建一个 Python 容器镜像

为创建这些镜像,我们将使用 Docker,它可以让我们在一个隔离的 Linux 软件容器中部署应用程序。Docker 可以使用来自一个 Dockerfile 中的指令来自动化构建镜像。

这是我们的 Python 应用程序的 Dockerfile:

FROM python:3.6
MAINTAINER XenonStack

# Creating Application Source Code Directory
RUN mkdir -p /k8s_python_sample_code/src

# Setting Home Directory for containers
WORKDIR /k8s_python_sample_code/src

# Installing python dependencies
COPY requirements.txt /k8s_python_sample_code/src
RUN pip install --no-cache-dir -r requirements.txt

# Copying src code to Container
COPY . /k8s_python_sample_code/src/app

# Application Environment variables
ENV APP_ENV development

# Exposing Ports
EXPOSE 5035

# Setting Persistent data
VOLUME ["/app-data"]

# Running Python Application
CMD ["python", "app.py"]

这个 Dockerfile 包含运行我们的示例 Python 代码的指令。它使用的开发环境是 Python 3.5。

构建一个 Python Docker 镜像

现在,我们可以使用下面的这个命令按照那些指令来构建 Docker 镜像:

docker build -t k8s_python_sample_code .

这个命令为我们的 Python 应用程序创建了一个 Docker 镜像。

发布容器镜像

我们可以将我们的 Python 容器镜像发布到不同的私有/公共云仓库中,像 Docker Hub、AWS ECR、Google Container Registry 等等。本教程中我们将发布到 Docker Hub。

在发布镜像之前,我们需要给它标记一个版本号:

docker tag k8s_python_sample_code:latest k8s_python_sample_code:0.1

推送镜像到一个云仓库

如果使用一个 Docker 注册中心而不是 Docker Hub 去保存镜像,那么你需要在你本地的 Docker 守护程序和 Kubernetes Docker 守护程序上添加一个容器注册中心。对于不同的云注册中心,你可以在它上面找到相关信息。我们在示例中使用的是 Docker Hub。

运行下面的 Docker 命令去推送镜像:

docker push k8s_python_sample_code

使用 CephFS 持久卷

Kubernetes 支持许多的持久存储提供商,包括 AWS EBS、CephFS、GlusterFS、Azure Disk、NFS 等等。我在示例中使用 CephFS 做为 Kubernetes 的持久卷。

为使用 CephFS 存储 Kubernetes 的容器数据,我们将创建两个文件:

persistent-volume.yml :

apiVersion: v1
kind: PersistentVolume
metadata:
  name: app-disk1
  namespace: k8s_python_sample_code
spec:
  capacity:
  storage: 50Gi
  accessModes:
  - ReadWriteMany
  cephfs:
  monitors:
    - "172.17.0.1:6789"
  user: admin
  secretRef:
    name: ceph-secret
  readOnly: false

persistent_volume_claim.yaml:

apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: appclaim1
  namespace: k8s_python_sample_code
spec:
  accessModes:
  - ReadWriteMany
  resources:
  requests:
    storage: 10Gi

现在,我们将使用 kubectl 去添加持久卷并声明到 Kubernetes 集群中:

$ kubectl create -f persistent-volume.yml
$ kubectl create -f persistent-volume-claim.yml

现在,我们准备去部署 Kubernetes。

在 Kubernetes 上部署应用程序

为管理部署应用程序到 Kubernetes 上的最后一步,我们将创建两个重要文件:一个服务文件和一个部署文件。

使用下列的内容创建服务文件,并将它命名为 k8s_python_sample_code.service.yml:

apiVersion: v1
kind: Service
metadata:
  labels:
  k8s-app: k8s_python_sample_code
  name: k8s_python_sample_code
  namespace: k8s_python_sample_code
spec:
  type: NodePort
  ports:
  - port: 5035
  selector:
  k8s-app: k8s_python_sample_code

使用下列的内容创建部署文件并将它命名为 k8s_python_sample_code.deployment.yml:

apiVersion: extensions/v1beta1
kind: Deployment
metadata:
  name: k8s_python_sample_code
  namespace: k8s_python_sample_code
spec:
  replicas: 1
  template:
  metadata:
    labels:
    k8s-app: k8s_python_sample_code
  spec:
    containers:
    - name: k8s_python_sample_code
      image: k8s_python_sample_code:0.1
      imagePullPolicy: "IfNotPresent"
      ports:
      - containerPort: 5035
      volumeMounts:
        - mountPath: /app-data
          name: k8s_python_sample_code
     volumes: 
         - name: <name of application>
           persistentVolumeClaim:
             claimName: appclaim1

最后,我们使用 kubectl 将应用程序部署到 Kubernetes:

$ kubectl create -f k8s_python_sample_code.deployment.yml $ kubectl create -f k8s_python_sample_code.service.yml

现在,你的应用程序已经成功部署到 Kubernetes。

你可以通过检查运行的服务来验证你的应用程序是否在运行:

kubectl get services

或许 Kubernetes 可以解决未来你部署应用程序的各种麻烦!

想学习更多关于 Python 的知识?Nanjekye 的书,和平共处的 Python 2 和 3 提供了完整的方法,让你写的代码在 Python 2 和 3 上完美运行,包括如何转换已有的 Python 2 代码为能够可靠运行在 Python 2 和 3 上的代码的详细示例。

关于作者

Joannah Nanjekye - Straight Outta 256,只要结果不问原因,充满激情的飞行员,喜欢用代码说话。关于我的更多信息


via: https://opensource.com/article/18/1/running-python-application-kubernetes

作者:Joannah Nanjekye 译者:qhwdw 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

跟踪您的库存和需要的材料,用这些供应链管理工具制造产品。

本文最初发表于 2016 年 1 月 14 日,最后的更新日期为 2018 年 3 月 2 日。

如果你正在管理着处理实体货物的业务,供应链管理 是你的业务流程中非常重要的一部分。不论你是经营着一个只有几个客户的小商店,还是在世界各地拥有数以百万计客户和成千上万产品的世界财富 500 强的制造商或零售商,很清楚地知道你的库存和制造产品所需要的零部件,对你来说都是非常重要的事情。

保持对货品、供应商、客户的持续跟踪,而且所有与它们相关的变动部分都会受益于这些用来帮助管理工作流的专门软件,而在某些情况下需要完全依赖这些软件。在本文中,我们将去了解一些自由及开源的供应链管理方面的软件,以及它们的其中一些功能。

供应链管理比单纯的库存管理更为强大。它能帮你去跟踪货物流以降低成本,以及为可能发生的各种糟糕的变化来制定应对计划。它能够帮你对出口合规性进行跟踪,不论是否是出于法律要求、最低品质要求、还是社会和环境责任。它能够帮你计划最低供应量,让你能够在订单数量和交付时间之间做出明智的决策。

由于其本质决定了许多供应链管理软件是与类似的软件捆绑在一起的,比如,客户关系管理(CRM)和 企业资源计划管理 (ERP)。因此,当你选择哪个工具更适合你的组织时,你可能会考虑与其它工具集成作为你的决策依据之一。

Apache OFBiz

Apache OFBiz 是一套帮你管理多种业务流程的相关工具。虽然它能管理多种相关问题,比如,分类、电子商务网站、会计和 POS,它在供应链管理方面的主要功能关注于仓库管理、履行、订单和生产管理。它的可定制性很强,但是,对应的它需要大量的规划去设置和集成到你现有的流程中。这就是它适用于中大型业务的原因之一。项目的功能构建于三个层面:展示层、业务层和数据层,它是一个弹性很好的解决方案,但是,再强调一遍,它也很复杂。

Apache OFBiz 的源代码在其 项目仓库 中可以找到。Apache OFBiz 是用 Java 写的,并且它是按 Apache 2.0 许可证 授权的。

如果你对它感兴趣,你也可以去查看 opentaps,它是在 OFBiz 之上构建的。Opentaps 强化了 OFBiz 的用户界面,并且添加了 ERP 和 CRM 的核心功能,包括仓库管理、采购和计划。它是按 AGPL 3.0 授权使用的,对于不接受开源授权的组织,它也提供了商业授权。

OpenBoxes

OpenBoxes 是一个供应链管理和存货管理项目,最初的主要设计目标是为了医疗行业中的药品跟踪管理,但是,它可以通过修改去跟踪任何类型的货品和相关的业务流。它有一个需求预测工具,可以基于历史订单数量、存储跟踪、支持多种场所、过期日期跟踪、销售点支持等进行预测,并且它还有许多其它功能,这使它成为医疗行业的理想选择,但是,它也可以用于其它行业。

它在 Eclipse 公开许可证 下可用,OpenBoxes 主要是由 Groovy 写的,它的源代码可以在 GitHub 上看到。

OpenLMIS

与 OpenBoxes 类似,OpenLMIS 也是一个医疗行业的供应链管理工具,但是,它专用设计用于在非洲的资源缺乏地区使用,以确保有限的药物和医疗用品能够用到需要的病人上。它是 API 驱动的,这样用户可以去定制和扩展 OpenLMIS,同时还能维护一个与通用基准代码的连接。它是由洛克菲勒基金会开发的,其它的贡献者包括联合国、美国国际开发署、和比尔 & 梅林达·盖茨基金会。

OpenLMIS 是用 Java 和 JavaScript 的 AngularJS 写的。它在 AGPL 3.0 许可证 下使用,它的源代码在 GitHub 上可以找到。

Odoo

你可能在我们以前的 ERP 项目 榜的文章上见到过 Odoo。事实上,根据你的需要,一个全功能的 ERP 对你来说是最适合的。Odoo 的供应链管理工具主要围绕存货和采购管理,同时还与电子商务网站和 POS 连接,但是,它也可以与其它的工具连接,比如,与 frePPLe 连接,它是一个开源的生产计划工具。

Odoo 既有软件即服务(SaaS)的解决方案,也有开源的社区版本。开源的版本是以 LGPL 版本 3 下发行的,源代码在 GitHub 上可以找到。Odoo 主要是用 Python 来写的。

xTuple

xTuple 标称自己是“为成长中的企业提供供应链管理软件”,它专注于已经超越了其传统的小型企业 ERP 和 CRM 解决方案的企业。它的开源版本称为 Postbooks,添加了一些存货、分销、采购、以及供应商报告的功能,它提供的核心功能是会计、CRM、以及 ERP 功能,而它的商业版本扩展了制造和分销的 功能。

xTuple 在 CPAL 下使用,这个项目欢迎开发者去复刻它,为基于存货的制造商去创建其它的业务软件。它的 Web 应用核心是用 JavaScript 写的,它的源代码在 GitHub 上可以找到。

就这些,当然了,还有其它的可以帮你处理供应链管理的开源软件。如果你知道还有更好的软件,请在下面的评论区告诉我们。


via: https://opensource.com/tools/supply-chain-management

作者:Jason Baker 译者:qhwdw 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

如何在崩溃的局面中集中精力寻找解决方案。

如果你在 IT 领域工作,你知道事情永远不会像你想象的那样完好。在某些时候,你会遇到错误或出现问题,你最终必须解决问题。这就是系统管理员的工作。

作为人类,我们都会犯错误。我们不是已经犯错,就是即将犯错。结果,我们最终还必须解决自己的错误。总是这样。我们都会失误、敲错字母或犯错。

作为一名年轻的系统管理员,我艰难地学到了这一课。我犯了一个大错。但是多亏了上级的指导,我学会了不去纠缠于我的错误,而是制定一个“错误策略”来做正确的事情。从错误中吸取教训。克服它,继续前进。

我的第一份工作是一家小公司的 Unix 系统管理员。真的,我是一名生嫩的系统管理员,但我大部分时间都独自工作。我们是一个小型 IT 团队,只有我们三个人。我是 20 或 30 台 Unix 工作站和服务器的唯一系统管理员。另外两个支持 Windows 服务器和桌面。

任何阅读这篇文章的系统管理员都不会对此感到意外,作为一个不成熟的初级系统管理员,我最终在错误的目录中运行了 rm 命令——作为 root 用户。我以为我正在为我们的某个程序删除一些陈旧的缓存文件。相反,我错误地清除了 /etc 目录中的所有文件。糟糕。

我意识到犯了错误是看到了一条错误消息,“rm 无法删除某些子目录”。但缓存目录应该只包含文件!我立即停止了 rm 命令,看看我做了什么。然后我惊慌失措。一下子,无数个想法涌入了我的脑中。我刚刚销毁了一台重要的服务器吗?系统会怎么样?我会被解雇吗?

幸运的是,我运行的是 rm * 而不是 rm -rf *,因此我只删除了文件。子目录仍在那里。但这并没有让我感觉更好。

我立刻去找我的主管告诉她我做了什么。她看到我对自己的错误感到愚蠢,但这是我犯的。尽管紧迫,她花了几分钟时间跟我做了一些指导。 她说:“你不是第一个这样做的人,在你这种情况下,别人会怎么做?”这帮助我平静下来并专注。我开始更少考虑我刚刚做的愚蠢事情,而更多地考虑我接下来要做的事情。

我做了一个简单的策略:不要重启服务器。使用相同的系统作为模板,并重建 /etc 目录。

制定了行动计划后,剩下的就很容易了。只需运行正确的命令即可从另一台服务器复制 /etc 文件并编辑配置,使其与系统匹配。多亏了我对所有东西都做记录的习惯,我使用已有的文档进行最后的调整。我避免了完全恢复服务器,这意味着一个巨大的宕机事件。

可以肯定的是,我从这个错误中吸取了教训。在接下来作为系统管理员的日子中,我总是在运行任何命令之前确认我所在的目录。

我还学习了构建“错误策略”的价值。当事情出错时,恐慌并思考接下来可能发生的所有坏事是很自然的。这是人性。但是制定一个“错误策略”可以帮助我不再担心出了什么问题,而是专注于让事情变得更好。我仍然会想一下,但是知道我接下来的步骤可以让我“克服它”。


via: https://opensource.com/article/18/7/my-first-sysadmin-mistake

作者:Jim Hall 选题:lujun9972 译者:geekpi 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出

无论是研究还是娱乐,安装一个最新的显卡驱动都能提升你的计算机性能,并且使你能全方位地实现新功能。本安装指南使用 Fedora 28 的新的第三方仓库来安装 NVIDIA 驱动。它将引导您完成硬件和软件两方面的安装,并且涵盖需要让你的 NVIDIA 显卡启动和运行起来的一切知识。这个流程适用于任何支持 UEFI 的计算机和任意新的 NVIDIA 显卡。

准备

本指南依赖于下面这些材料:

  • 一台使用 UEFI 的计算机,如果你不确定你的电脑是否有这种固件,请运行 sudo dmidecode -t 0。如果输出中出现了 “UEFI is supported”,你的安装过程就可以继续了。不然的话,虽然可以在技术上更新某些电脑来支持 UEFI,但是这个过程的要求很苛刻,我们通常不建议你这么使用。
  • 一个现代的、支持 UEFI 的 NVIDIA 的显卡
  • 一个满足你的 NVIDIA 显卡的功率和接线要求的电源(有关详细信息,请参考“硬件和修改”的章节)
  • 网络连接
  • Fedora 28 系统

安装实例

这个安装示例使用的是:

硬件和修改

电源(PSU)

打开你的台式机的机箱,检查印刷在电源上的最大输出功率。然后,查看你的 NVIDIA 显卡的文档,确定推荐的最小电源功率要求(以瓦特为单位)。除此之外,检查你的显卡,看它是否需要额外的接线,例如 6 针连接器,大多数的入门级显卡只从主板获取电力,但是有一些显卡需要额外的电力,如果出现以下情况,你需要升级你的电源:

  1. 你的电源的最大输出功率低于显卡建议的最小电源功率。注意:根据一些显卡厂家的说法,比起推荐的功率,预先构建的系统可能会需要更多或更少的功率,而这取决于系统的配置。如果你使用的是一个特别耗电或者特别节能的配置,请灵活决定你的电源需求。
  2. 你的电源没有提供必须的接线口来为你的显卡供电。

电源的更换很容易,但是在你拆除你当前正在使用的电源之前,请务必注意你的接线布局。除此之外,请确保你选择的电源适合你的机箱。

CPU

虽然在大多数老机器上安装高性能的 NVIDIA 显卡是可能的,但是一个缓慢或受损的 CPU 会阻碍显卡性能的发挥,如果要计算在你的机器上瓶颈效果的影响,请点击这里。了解你的 CPU 性能来避免高性能的显卡和 CPU 无法保持匹配是很重要的。升级你的 CPU 是一个潜在的考虑因素。

主板

在继续进行之前,请确认你的主板和你选择的显卡是兼容的。你的显卡应该插在最靠近散热器的 PCI-E x16 插槽中。确保你的设置为显卡预留了足够的空间。此外,请注意,现在大部分的显卡使用的都是 PCI-E 3.0 技术。虽然这些显卡如果插在 PCI-E 3.0 插槽上会运行地最好,但如果插在一个旧版的插槽上的话,性能也不会受到太大的影响。

安装

1、 首先,打开终端更新你的包管理器(如果没有更新的话):

sudo dnf update

2、 然后,使用这条简单的命令进行重启:

reboot

3、 在重启之后,安装 Fedora 28 的工作站的仓库:

sudo dnf install fedora-workstation-repositories

4、 接着,设置 NVIDIA 驱动的仓库:

sudo dnf config-manager --set-enabled rpmfusion-nonfree-nvidia-driver

5、 然后,再次重启。

6、 在这次重启之后,通过下面这条命令验证是否添加了仓库:

sudo dnf repository-packages rpmfusion-nonfree-nvidia-driver info

如果加载了多个 NVIDIA 工具和它们各自的 spec 文件,请继续进行下一步。如果没有,你可能在添加新仓库的时候遇到了一个错误。你应该再试一次。

7、 登录,连接到互联网,然后打开“软件”应用程序。点击“加载项>硬件驱动> NVIDIA Linux 图形驱动>安装”。

如果你使用更老的显卡或者想使用多个显卡,请进一步查看 RPMFusion 指南。最后,要确保启动成功,设置 /etc/gdm/custom.conf 中的 WaylandEnable=false,确认避免使用安全启动。 接着,再一次重启。

8、这个过程完成后,关闭所有的应用并关机。拔下电源插头,然后按下电源按钮以释放余电,避免你被电击。如果你对电源有开关,关闭它。

9、 最后,安装显卡,拔掉老的显卡并将新的显卡插入到正确的 PCI-E x16 插槽中。成功安装新的显卡之后,关闭你的机箱,插入电源 ,然后打开计算机,它应该会成功启动。

注意: 要禁用此安装中使用的 NVIDIA 驱动仓库,或者要禁用所有的 Fedora 工作站仓库,请参考这个 Fedora Wiki 页面。

验证

1、 如果你新安装的 NVIDIA 显卡已连接到你的显示器并显示正确,则表明你的 NVIDIA 驱动程序已成功和显卡建立连接。

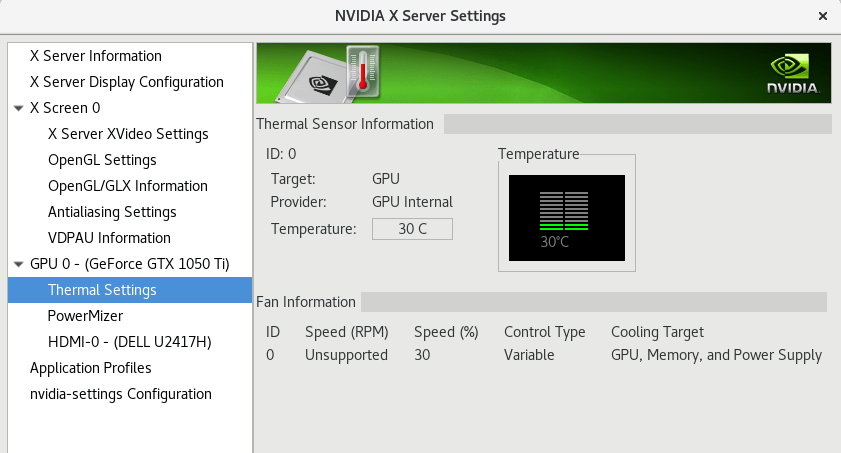
如果你想去查看你的设置,或者验证驱动是否在正常工作(这里,主板上安装了两块显卡),再次打开 “NVIDIA X 服务器设置应用程序”。这次,你应该不会得到错误信息提示,并且系统会给出有关 X 的设置文件和你的 NVIDIA 显卡的信息。(请参考下面的屏幕截图)

 title=

通过这个应用程序,你可以根据你的需要需改 X 配置文件,并可以监控显卡的性能,时钟速度和温度信息。

2、 为确保新显卡以满功率运行,显卡性能测试是非常必要的。GL Mark 2,是一个提供后台处理、构建、照明、纹理等等有关信息的标准工具。它提供了一个优秀的解决方案。GL Mark 2 记录了各种各样的图形测试的帧速率,然后输出一个总体的性能评分(这被称为 glmark2 分数)。

注意: glxgears 只会测试你的屏幕或显示器的性能,不会测试显卡本身,请使用 GL Mark 2。

要运行 GLMark2:

  1. 打开终端并关闭其他所有的应用程序
  2. 运行 sudo dnf install glmark2 命令
  3. 运行 glmark2 命令
  4. 允许运行完整的测试来得到最好的结果。检查帧速率是否符合你对这块显卡的预期。如果你想要额外的验证,你可以查阅网站来确认是否已有你这块显卡的 glmark2 测试评分被公布到网上,你可以比较这个分数来评估你这块显卡的性能。
  5. 如果你的帧速率或者 glmark2 评分低于预期,请思考潜在的因素。CPU 造成的瓶颈?其他问题导致?

如果诊断的结果很好,就开始享受你的新显卡吧。

参考链接


via: https://fedoramagazine.org/install-nvidia-gpu/

作者:Justice del Castillo 选题:lujun9972 译者:hopefully2333 校对:wxy

本文由 LCTT 原创编译,Linux中国 荣誉推出